
O que "Meta Muse para garantia de qualidade do suporte" realmente significa
Eu atendo a fila de suporte da eesel todos os dias, e o que me tira o sono na IA de suporte não é o bot que diz "não sei". É o bot que responde com total confiança e está errado. Então, quando uma equipe me pergunta como fazer QA do agente de WhatsApp da Meta, o primeiro passo é esclarecer de qual produto da Meta se fala.
"Meta Muse" são três produtos, e só um deles fala com seus clientes:
| Produto | O que é | Papel na QA de suporte |
|---|---|---|
| Muse | O agente pessoal de consumo da Meta | Nenhum |
| Muse Spark API | O modelo da Meta, chamável a partir do seu próprio código | Um avaliador que você mesmo poderia construir |
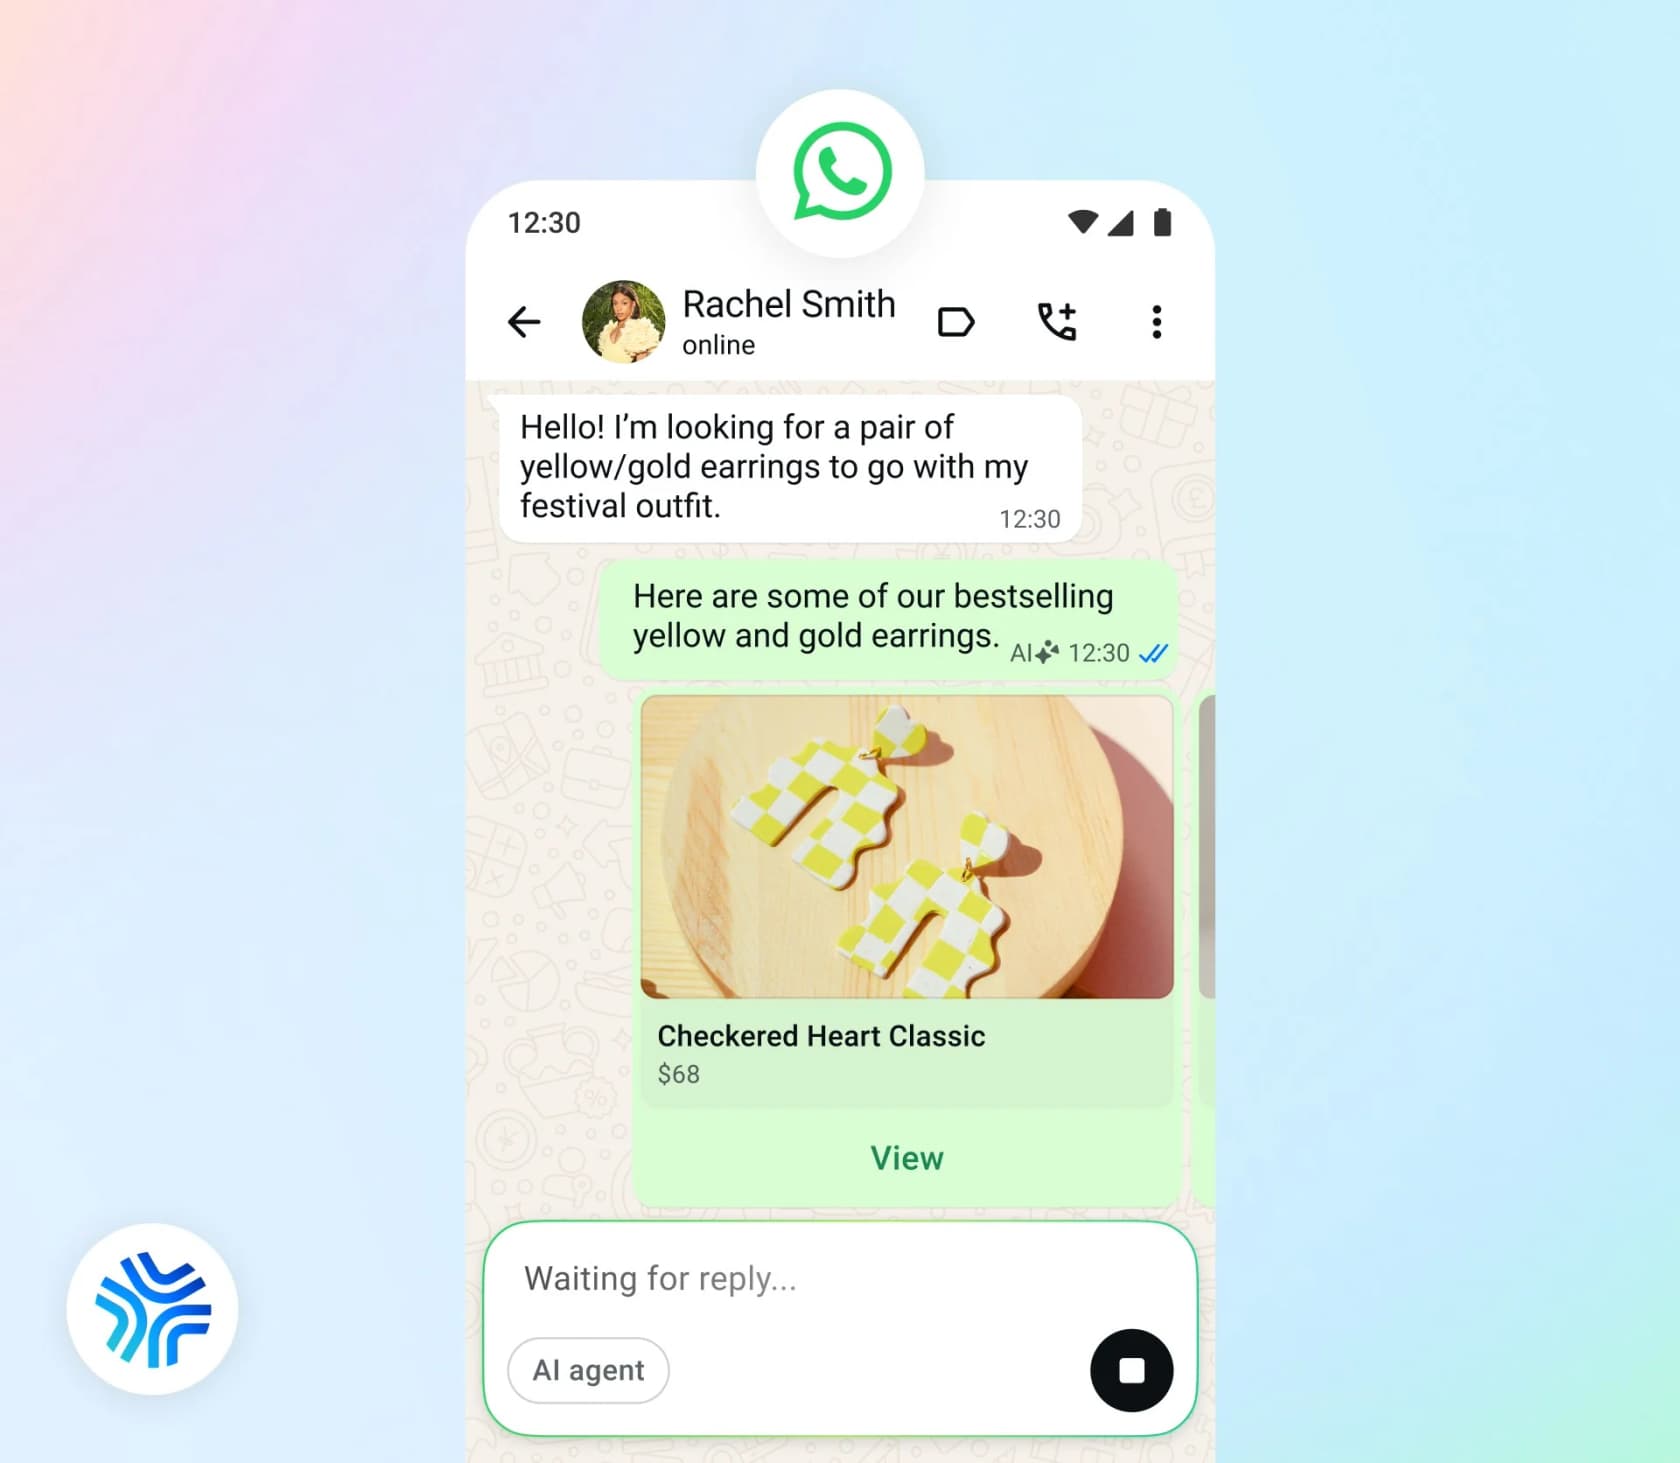
| Meta Business Agent | A IA empresarial voltada ao cliente da Meta, lançada em 3 de junho de 2026 | O que você está revisando, mais suas ferramentas de teste |
O Business Agent vem em uma versão self-service dentro do Meta Business Suite e do app WhatsApp Business, e como Business Agent Platform para empresas na API da WhatsApp Business Platform. O detalhamento completo do produto está no meu hub Meta Muse for customer support, e o app de consumo tem seu próprio post sobre o Meta Muse Agent.
Por garantia de qualidade do suporte entendo o trabalho de sempre: verificar se as respostas estão corretas, dentro da política e alinhadas à marca, se o agente escala quando deve e se o mesmo erro não se repete. Se você é iniciante, minha introdução à QA de suporte com IA cobre o básico. A pergunta aqui é mais estreita: o que a Meta oferece para fazer esse trabalho?
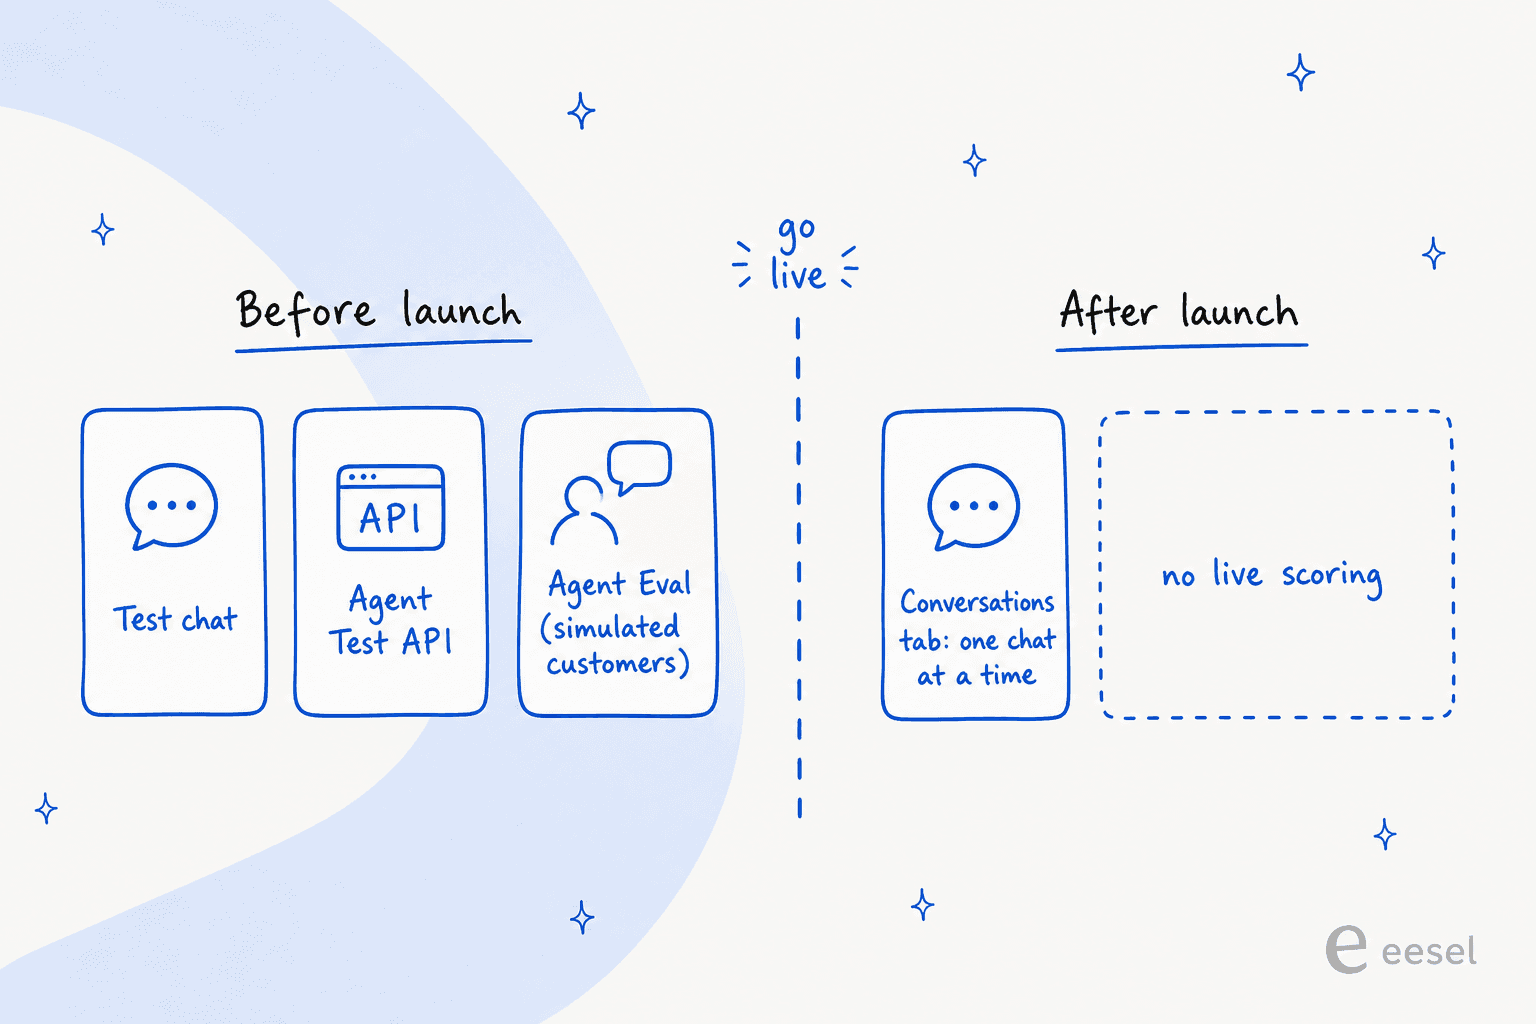
As ferramentas de QA da Meta são feitas para antes do lançamento
Depois de ler a documentação e as páginas de ajuda do Business Agent da Meta, eu resumiria assim. São três ferramentas de teste, e as três verificam o agente contra conversas que você inventa.
Test chat e "Improve AI response" (self-service)
No Meta Business Suite, "Under Test chat, you can chat with your Meta Business Agent as if you were a customer and give feedback on the responses you see" (Meta Business Help). Se uma resposta estiver errada, você clica em Improve AI response e informa a resposta correta ou uma instrução. O mesmo botão funciona em mensagens reais passadas da IA na caixa de entrada.
Dois detalhes importam para a QA. A Meta diz que o agente "will not respond using your exact words", então uma correção é orientação, não uma resposta fixa. E "Existing responses will not be updated", ou seja, um ajuste muda apenas respostas futuras. Você também pode passar o mouse sobre qualquer resposta e clicar em View sources para ver qual conhecimento a gerou (Meta Business Help), que é o recurso de QA mais útil da faixa self-service.
A API Agent Test
Na Platform, o Agent Test permite "send free test messages to the agent without affecting live customer conversations" (Capabilities). Você faz POST de um user_msg e devolve o conversation_id para continuar uma troca de vários turnos. É a versão em API do Test chat, então dá para automatizar com scripts.
Agent Eval: um LLM juiz avaliando clientes simulados
O Agent Eval é a peça mais interessante. Um caso de eval tem um scenario, descrito como "Free-form text defining the task and constraints for the user simulator", mais success_criteria e max_turns. POST /run "runs simulation, evaluation, and optionally insights across multiple cases."
O que volta é rico. Cada conversa recebe um score geral "from the judge LLM", rótulos por turno e reasons com categoria, nota, descrição e ações recomendadas. O relatório-resumo traz avg_conversation_score e avg_turn_score em escala de 1 a 5, um resumo em linguagem natural, destaques e top_failure_categories.
É um bom arcabouço de regressão, e eu o usaria. Mas note o que está sendo avaliado: uma conversa entre o seu agente e um cliente simulado que você descreveu. Ele diz que o agente lida com os casos em que você pensou. Não diz nada sobre os casos em que você não pensou.
O plano de testes que a Meta recomenda (e a frase que vale emoldurar)
O guia de agente de atendimento ao cliente da Meta inclui um plano de testes de dez linhas para um agente de varejo: perguntas de política, "Onde está meu pedido?" sem número de referência, devoluções dentro e fora do prazo, um espelho quebrado, "Quero reembolso e quero hoje", "Só me passe para alguém" e uma pergunta sem resposta documentada, além de "É a terceira vez que escrevo."
O guia diz que as últimas quatro "are the ones worth automating as a regression suite. They are where an agent that is trying to be helpful does the most damage." E aí vem a frase que eu colocaria sobre toda mesa de QA de suporte:
"A support agent is judged on its worst answers rather than its average one, and the failures that matter are confident answers to questions it had no basis to answer."
Concordo com cada palavra, e é também o melhor argumento de por que testes pré-lançamento não bastam. Suas piores respostas vêm de perguntas que ninguém previu, e um conjunto de eval só contém perguntas que alguém previu.
Os demais conselhos do guia relevantes para QA também são sólidos: escreva os gatilhos de escalonamento como uma lista nomeada ("damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person"), dê ao agente apenas ações reversíveis e calcule a elegibilidade de devolução no seu próprio sistema em vez de deixar o agente comparar datas, porque "it tends to err generously." Se você escreve sua própria suíte, minhas notas sobre testes adversariais ajudam com os casos difíceis.
Depois do lançamento: uma conversa por vez
Com o agente no ar, é isto que você tem para fazer QA.
Faixa self-service. A aba Conversations "is where you can click into each chat to review your Meta Business Agent's responses", com View sources em cada resposta (Meta Business Help). A Meta também observa que "does not start storing conversation logs until a customer has opened the chat." Os clientes podem "long press on any Meta Business Agent message to provide feedback" (Meta Business Help), mas não encontrei nenhum relatório ou exportação documentada desse feedback para a empresa.
Faixa Platform. Não há endpoint que devolva conversas passadas do agente. Verifiquei todas as páginas de referência que a documentação linka. A única forma de levar transcrições para o seu sistema são os webhooks standby, que enviam as mensagens do cliente, cópias das respostas do agente e confirmações de leitura. "Standby is off by default", a empresa precisa conceder visibilidade ao seu app, e as cópias do agente trazem "the send-time parameters exactly as passed to the Send Message API - not the rendered content."
Então, se você não ligar o standby desde o primeiro dia, as conversas que você mais quer auditar se perdem, pelo menos para qualquer revisão em massa. É a única etapa de configuração que eu jamais pularia.
Também existe o Business Agent Usage Insights, mas ele informa mensagens cobráveis, tokens e custo, não qualidade (Usage Insights). Para métricas de volume em geral, meu guia de analytics de chatbot cobre o que vale acompanhar.
QA de escalonamento: você avalia, mas não define
Escalonamentos perdidos são a falha de QA mais difícil de pegar, e na Platform da Meta os gatilhos não são seus. O agente "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" (Capabilities). A aba Personality do self-service permite descrever com palavras as condições de repasse.
O que você pode medir é o próprio repasse. O evento control_passed dispara quando o controle passa da IA para uma pessoa, com uma string metadata opcional de até 2.000 caracteres (Thread control). O conselho da própria Meta é "Track the share of conversations handed off and the time to first human reply alongside it", e nenhum endpoint da Meta devolve qualquer um dos números. Meus guias sobre qualidade de escalonamento e gestão de escalonamento com IA aprofundam o tema.
Há uma falha de escalonamento que a própria Meta aponta. Se o agente abre tickets por um conector e essa chamada falha, "A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." Os logs do conector mostram taxa de sucesso e latência apenas dos últimos sete dias, então eu configuraria alertas para falhas em vez de checar à mão.
O que a Meta não avalia: seus agentes humanos
A maioria dos programas de QA avalia pessoas além de bots. A Meta não tem nada para isso. A caixa de entrada do Business Suite tem etiquetas, notas privadas, atribuição e uma pasta Done (Meta Business Help), e o Insights mostra "response rate and response time" (Meta Business Help). Sem scorecard, sem fila de revisão, sem calibração.
Há também um ângulo de privacidade que líderes de QA devem conhecer. Depois de um repasse, os termos do Business Agent dizem que o agente fica silenciado "but may continue to observe the content being shared in the chat", e esse conteúdo conta como Content licenciado à Meta. Assim, as respostas dos seus agentes em threads escaladas, justamente as que mais interessam à QA, também ficam sob os termos da Meta.
Para avaliar as pessoas, você vai querer uma ferramenta de QA de suporte separada e um scorecard. Meu post sobre critérios de scorecard de QA do Zendesk e os exemplos de feedback de QA servem para qualquer helpdesk.
As falhas que uma simulação não pega
Agora a parte desconfortável. As respostas que mais machucam parecem normais numa transcrição.
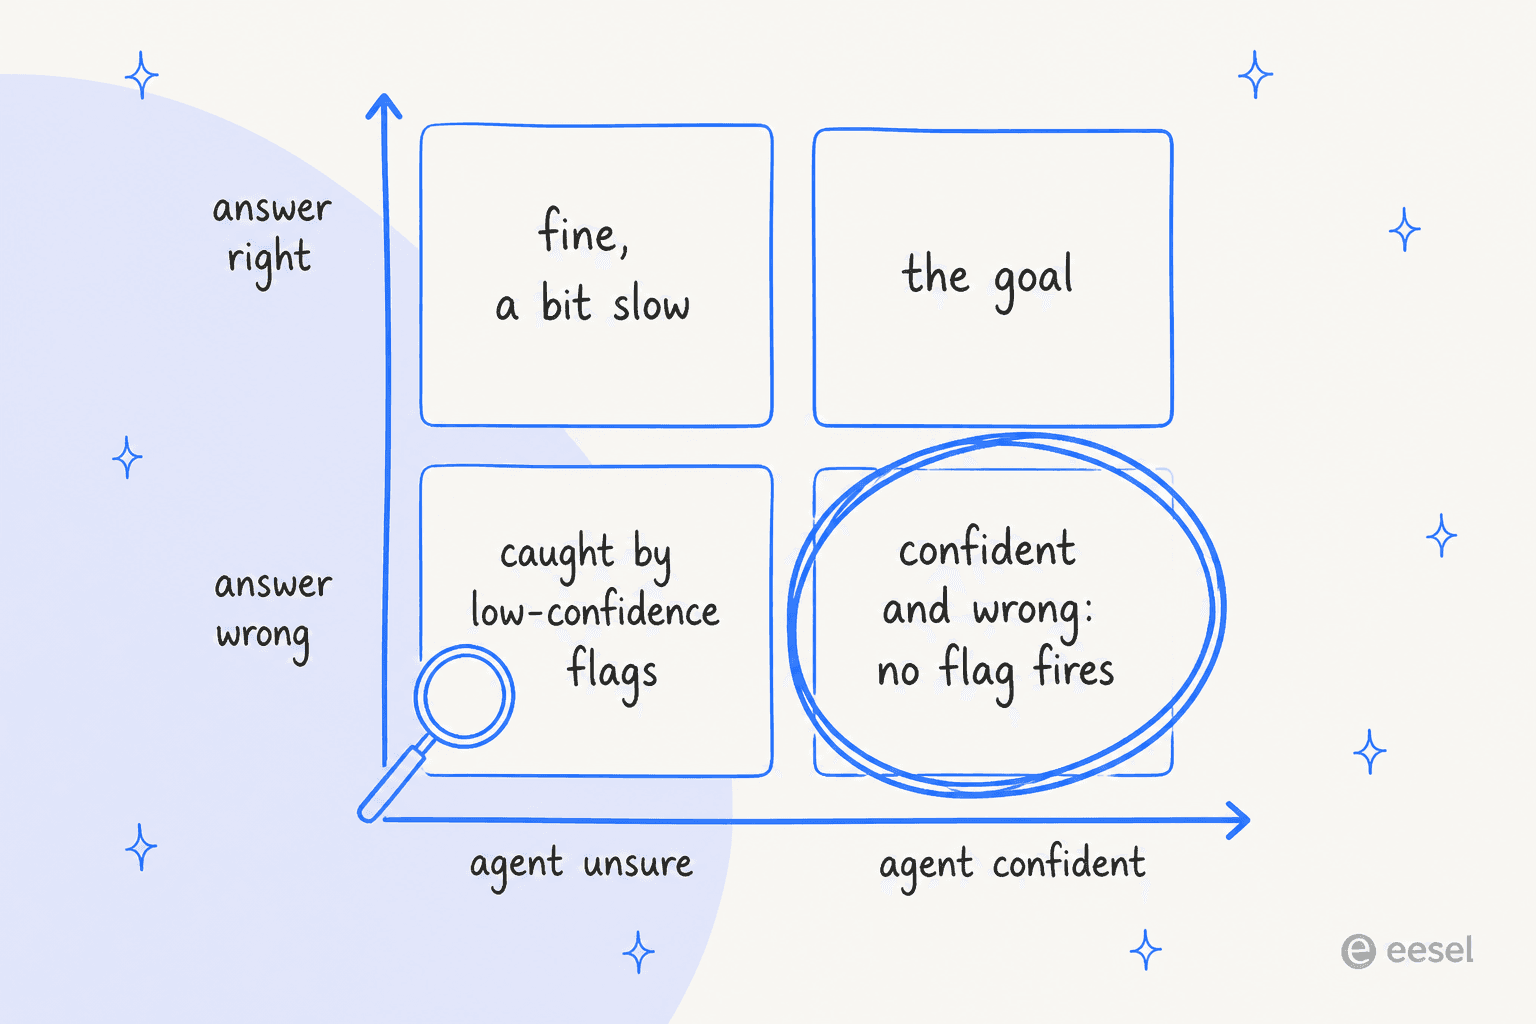
Já vi isso na eesel, e não é uma lembrança agradável. No início do ano, vários clientes pagantes tinham bots que inventavam respostas para clientes reais quando a base de conhecimento não tinha nada relevante. Um inventou termos de assinatura para os clientes de uma empresa de energia. Outro respondeu a um cliente com "Oxygen", tirado da tabela periódica. Uma equipe B2B de telemática, numa das chamadas de vendas da eesel, temia o espelho disso: a central de ajuda dizia "we support all models", então o bot confirmava alegremente marcas de carro que eles não suportavam. Nada nessas respostas parecia inseguro. Por isso a eesel agora testa cada implantação com os tickets históricos reais da equipe antes de o bot falar com alguém.
Quem opera agentes em produção descreve o mesmo padrão:
"The thing that moved us off confidence sampling is that the worst answers are confident. What actually surfaced them was downstream signals: user rephrased the same question, contacted again within 48 hours, a human took over, or an action got reversed."

E sobre escalonamentos perdidos em específico:
"A conversation where the agent should have escalated and didn't looks completely normal in the transcript, so no confidence threshold and no reviewer reading outputs will flag it."
Sobre o agente da Meta em particular, um consultor de WhatsApp que teve acesso antecipado apontou a consistência:
"Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up."
Para ser justo, ele também escreveu na mesma thread que ainda gosta da ferramenta e que a Meta vai melhorar o ferramental. E o próprio histórico de suporte da Meta mostra por que ferramentas de teste importam: quando seu bot de suporte com IA foi enganado para enviar links de redefinição de senha em junho de 2026, um comentarista do Hacker News resumiu assim: "they didn't really evaluate whether tools intended for conscientious human use should be provided directly to the LLM that replaced the former support agents" (semiquaver, Hacker News). Para mais sobre prevenção, veja meu guia de prevenção de alucinações.
Construindo você mesmo um ciclo de QA ao vivo
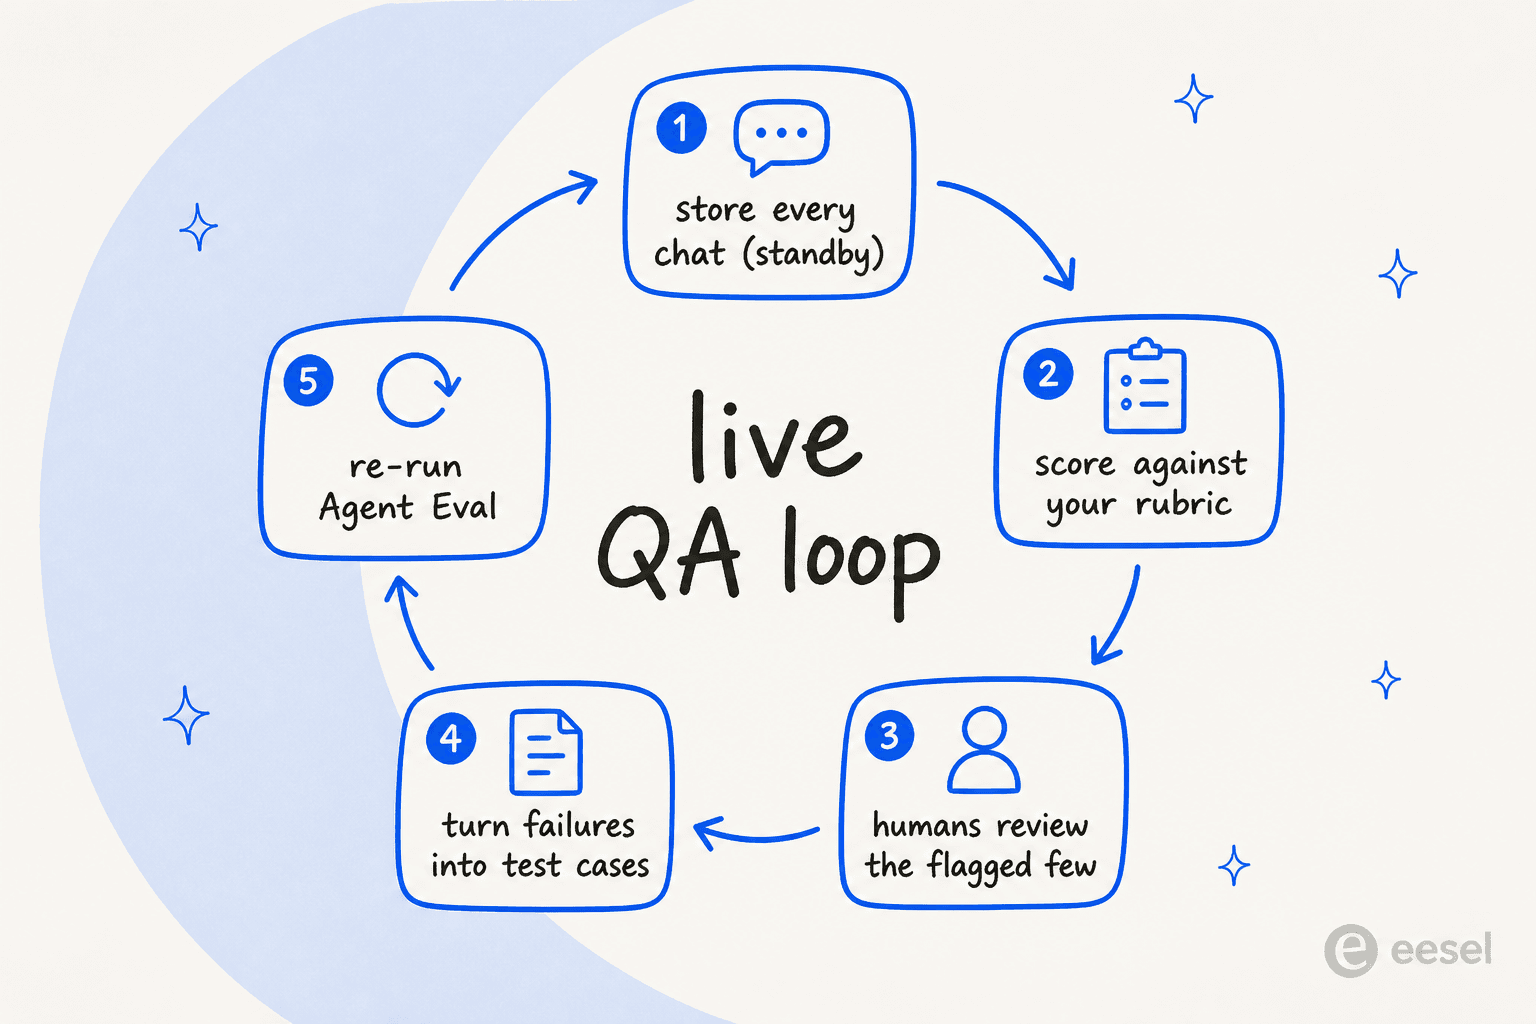
Se você está na faixa Platform e tem engenheiros, pode fechar a lacuna. O formato que eu construiria é um ciclo, não uma auditoria única.
A etapa de avaliação pode usar o próprio modelo da Meta. A faixa padrão do Muse Spark custa $1.25 por 1M de tokens de entrada e $4.25 por 1M de tokens de saída, e aceita saída em JSON Schema para que cada veredito volte no mesmo formato (tratado na minha análise do Muse Spark 1.3). Um exemplo aproximado, com tamanhos que eu assumi e não da Meta: 10.000 transcrições de 2.000 tokens cada são 20M de tokens de entrada ($25.00), e um veredito de 200 tokens cada são 2M de tokens de saída ($8.50). Dá cerca de $34 por mês para avaliar tudo, muito mais barato que uma pessoa lendo 1% disso.
Duas regras antes de começar:
- Não use a faixa contributor, mais barata, em transcrições. A página de ajuda da Meta diz "You must not submit sensitive, confidential, or personal information to the Discounted Services" (Meta Model API). Chats de suporte estão cheios de nomes, telefones e IDs de pedido.
- Não há endpoint de QA pronto. Você escreve a rubrica, o esquema, os limites e a fila de revisão.
Uma rubrica com que eu começaria tem cinco campos: correta segundo as fontes, na política atual, deveria ter escalado, tom e resolvida. Avalie a recuperação separadamente da resposta, porque uma fonte errada costuma ser escolhida alguns turnos antes de algo soar errado. O guia de QA de suporte com IA tem mais ideias de rubrica, e meu comparativo da melhor IA para QA de suporte cobre ferramentas que fazem isso por você.
A última etapa é a que as equipes pulam. Toda falha confirmada deve virar um novo caso de Agent Eval, para que a próxima mudança de instruções seja testada contra o que quebrou no mês passado. Um profissional disse com simplicidade: "Every time someone rejected an agent output, that was information" (u/Spdload, Reddit).
Os limites da Meta para garantia de qualidade do suporte
Para uma pequena empresa que vive no WhatsApp, as ferramentas de teste do Business Agent são um começo decente, e cobri o agente ao lado de Zendesk, Freshdesk e Gorgias. Para QA especificamente, estes são os limites que eu pesaria:
| O que a QA precisa | O que a Meta oferece | Lacuna |
|---|---|---|
| Testes pré-lançamento | Test chat, Agent Test (grátis), Agent Eval | Os cenários são os que você escreve |
| Avaliar conversas ao vivo | Aba Conversations, um chat por vez | Sem avaliação em massa |
| Acesso a transcrições | Webhooks standby (desligados por padrão) | Sem API de histórico |
| Rastreio de fontes | View sources em cada resposta | Só na interface self-service |
| Controle de escalonamento | Texto de instruções; gatilhos da Platform fixos | Taxa de repasse não informada |
| QA de agentes humanos | Taxa e tempo de resposta no Insights | Sem scorecards |
| Feedback do cliente | Feedback por toque longo em respostas de IA | Sem exportação documentada |
| Rodar uma segunda IA para vigiar | Um agente de IA por número | Standby é acesso somente leitura |
Mais duas notas. "An active authorized-agent integration blocks Meta Business Agent" (overview), então você não pode apontar uma segunda IA para o mesmo número para conferir a primeira. E, a partir de 1º de outubro de 2026, mensagens de serviço do WhatsApp de pessoas ou de IA de terceiros são cobradas depois de 1.000 gratuitas por mês por número, o que meu detalhamento dos preços da API do WhatsApp cobre.
Meus posts irmãos sobre análise de feedback de clientes e monitoramento da saúde do cliente tratam das mesmas fontes de dados por outros ângulos, e o Grok Bot para QA de suporte faz o mesmo trabalho em outro stack.
Uma configuração de QA que funciona
Se o WhatsApp é um canal grande e o agente da Meta está na linha de frente, eu faria assim:
- Ligue o standby antes do lançamento e armazene cada evento de entrada, resposta e status, indexado pelo ID de usuário com escopo de negócio do cliente.
- Monte a suíte de Agent Eval a partir dos seus motivos de contato reais, com mais peso nos quatro perigosos: exigências de reembolso, pedidos por uma pessoa, perguntas sem resposta documentada e contatos repetidos e irritados.
- Avalie todas as conversas e depois faça amostragem. Dê nota a todas com um modelo e envie às pessoas as que tiveram repasse, contato repetido em 48 horas, pergunta reformulada ou nota baixa na rubrica.
- Transforme falhas em casos de eval e rode a suíte de novo após cada mudança de instruções ou de conhecimento.
- Faça a QA dos seus humanos separadamente com um scorecard no seu helpdesk, já que a Meta não tem nenhum.
Para uma visão mais ampla das métricas a acompanhar, meu guia de métricas de atendimento ao cliente com IA e a explicação de CSAT com IA são boas próximas leituras.
Experimente a eesel para garantia de qualidade do suporte
A pilha da Meta testa seu agente antes do lançamento e depois devolve a QA para você. A eesel é um colega de helpdesk com IA que embute a QA em seu funcionamento e se conecta ao WhatsApp em poucos minutos.
Ela também funciona dentro do Zendesk e do Freshdesk, além de Gorgias e HubSpot, então chats do WhatsApp e tickets do helpdesk passam pelas mesmas verificações.
A maior diferença em relação ao Agent Eval é o que é testado. A habilidade Simulation da eesel "Runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes" (eesel docs). Assim, você avalia o agente nas perguntas que seus clientes realmente fizeram, inclusive as esquisitas para as quais ninguém pensaria em escrever um cenário.
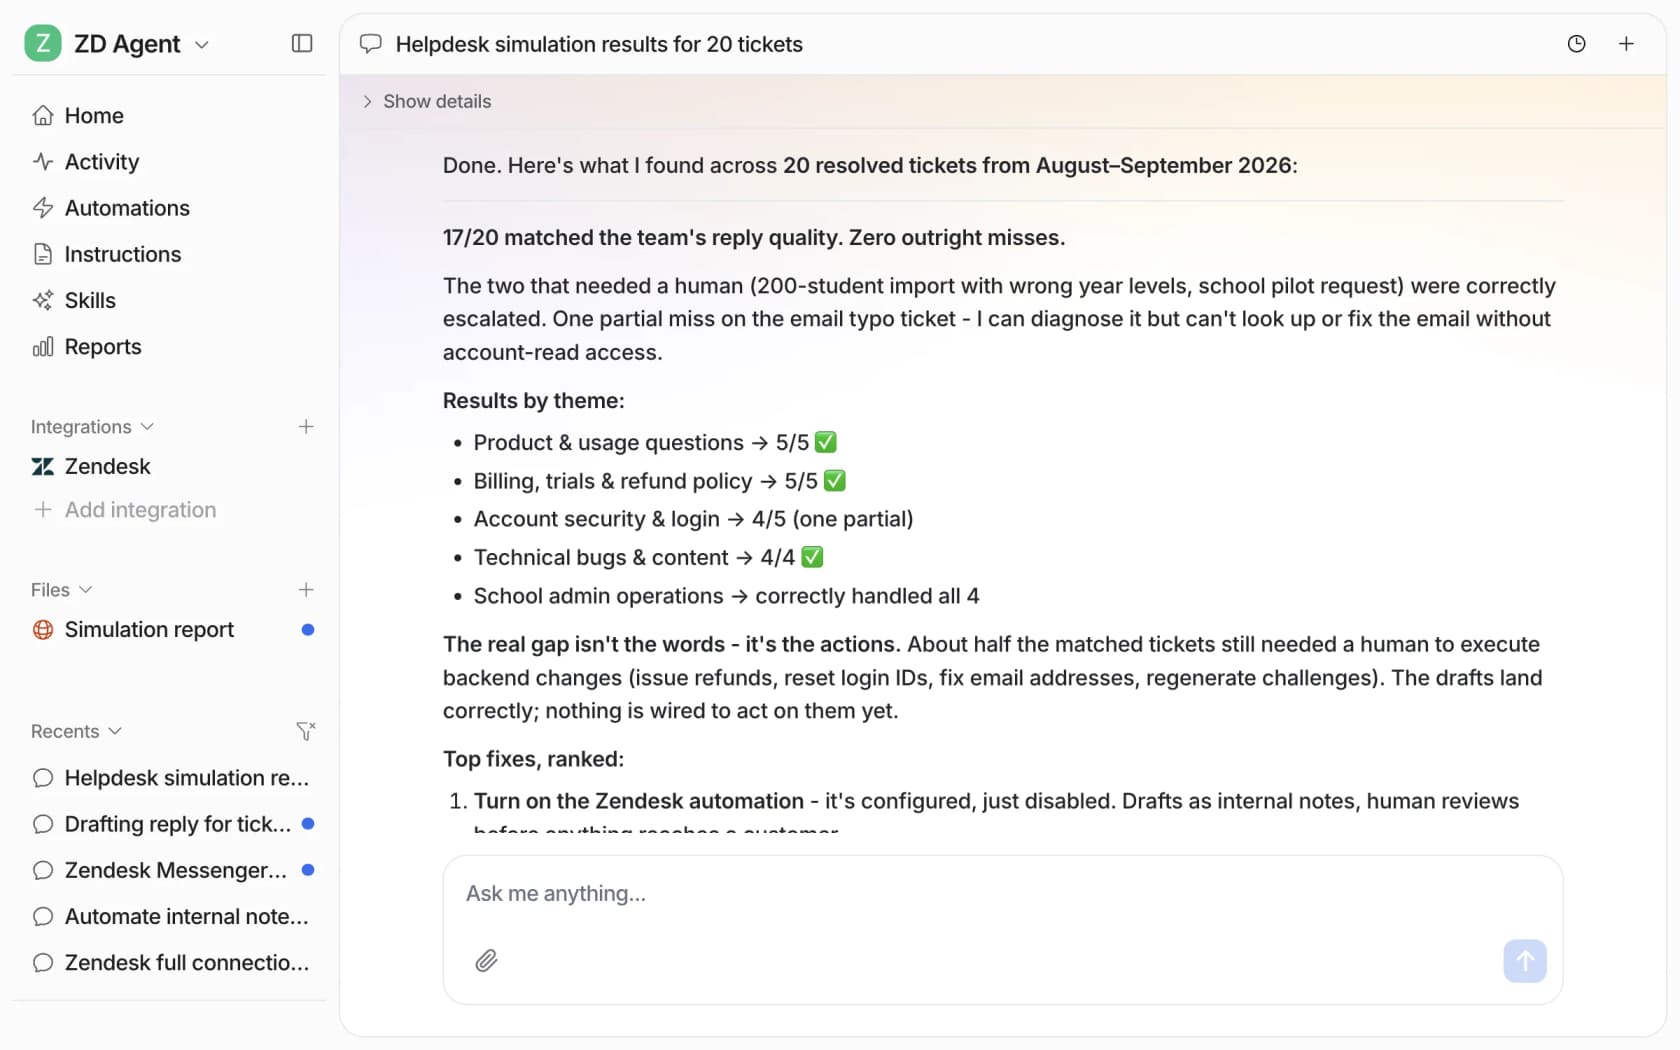
Depois do lançamento, cada execução aparece em Activity com onde aconteceu, "What it read", cada ação e onde uma pessoa aprovou, e "Why, its reasoning step by step" (Reports docs). Quando uma resposta está errada, você abre a execução e a corrige no chat ao lado, e a correção vira uma regra para toda resposta parecida. A habilidade "Analyze and improve replies" faz o mesmo em escala: olha o que sua equipe rejeitou ou editou e sugere a correção, que é o sinal de saída rejeitada que o comentarista do Reddit descreveu.
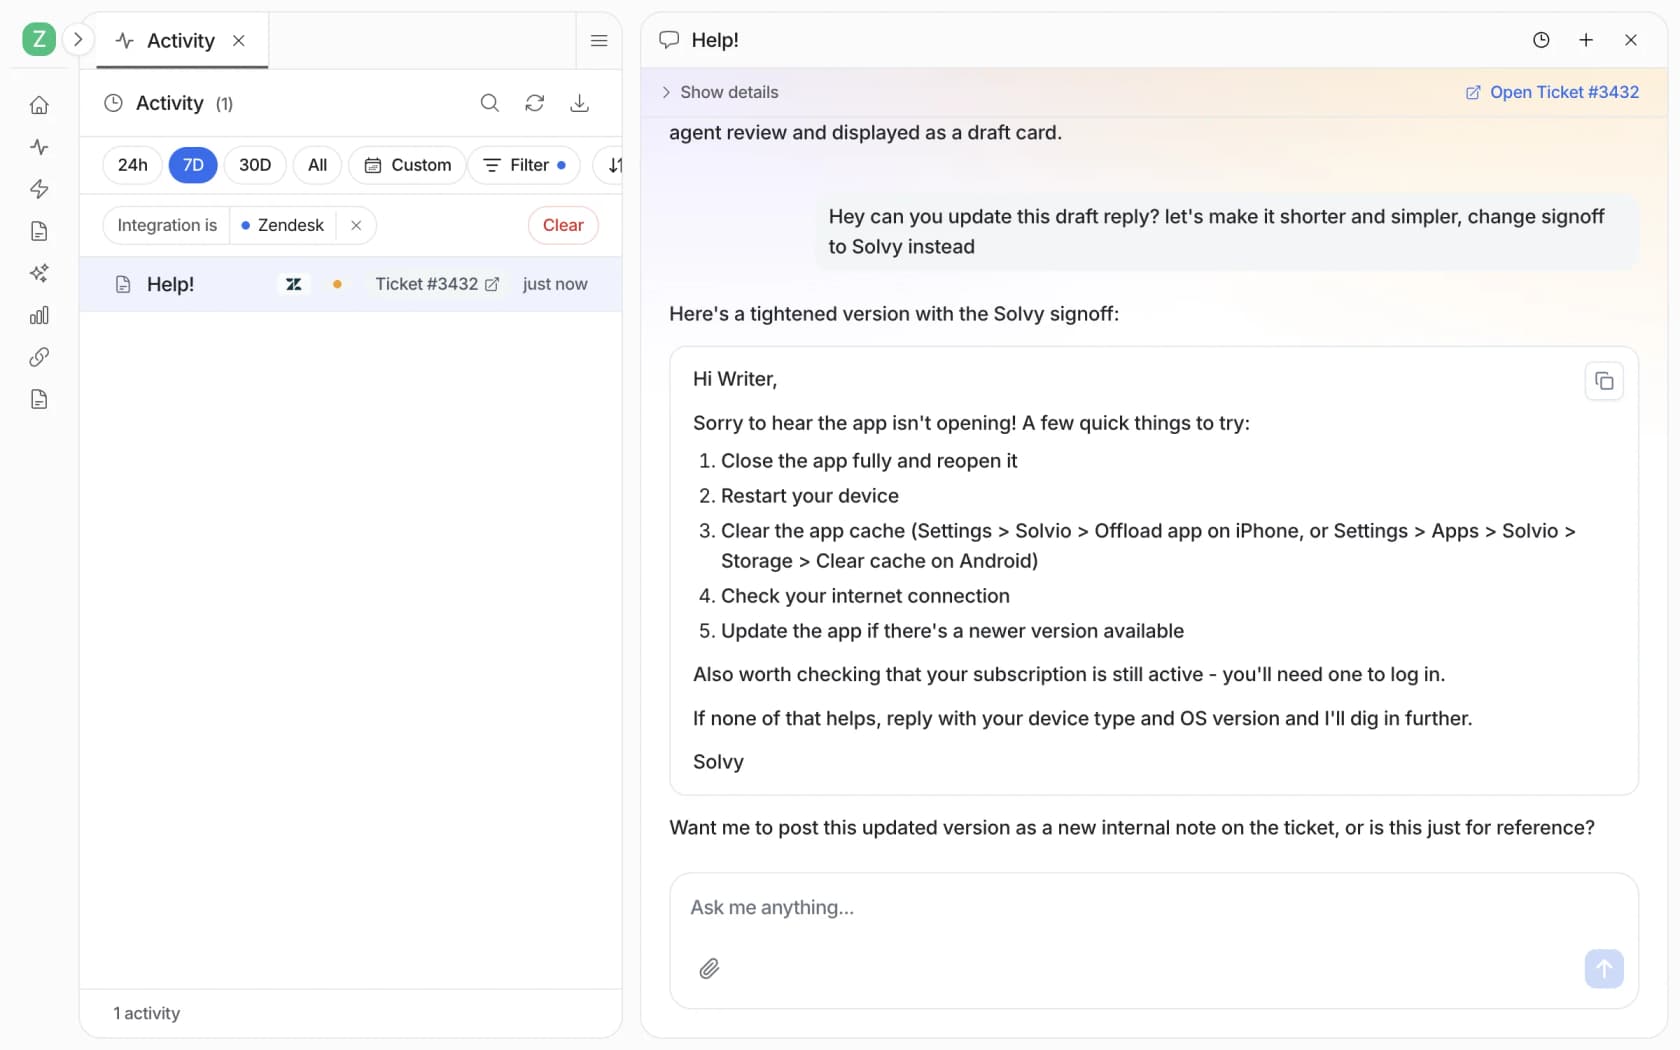
A página Reports acompanha uma nota de CSAT de IA, lacunas de conhecimento e taxas de aprovação, e repito a ressalva dos próprios docs: "AI CSAT is not customer feedback." É um sinal interno de qualidade. Você também pode agendar uma autorrevisão semanal e, se sua QA vive em scripts, a CLI da eesel imprime JSON em todo comando, de modo que um agente de código como o Claude Code pode puxar atividade e aprovações para o seu próprio painel de QA.
Uma nota honesta: por causa da regra da Meta de uma IA por número, em um número de WhatsApp você rodaria a eesel ou o Meta Business Agent, não os dois. Se o WhatsApp é seu único canal e você tem engenheiros para o ciclo de QA acima, o agente da Meta é uma escolha razoável. Se você quer a QA embutida e as conversas de todos os canais em um só lugar, os preços da eesel são um plano mensal fixo de créditos com faixa gratuita de 100 créditos e planos a partir de $299 por 500, e você pode rodar a simulação nos seus próprios tickets passados antes de ela responder a um único cliente.
Perguntas frequentes
Posso usar o Meta Muse para garantia de qualidade do suporte?
O que o Meta Agent Eval realmente avalia?
Como faço QA das conversas ao vivo do Meta Business Agent no WhatsApp?
O Meta Business Suite tem scorecards de QA para agentes humanos?
Quanto custa a garantia de qualidade do suporte com o Meta Muse?
Por que meu agente de IA do WhatsApp dá respostas erradas com tanta confiança?
Posso rodar uma segunda IA no meu número de WhatsApp para fazer QA do Meta Business Agent?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.