Resumo
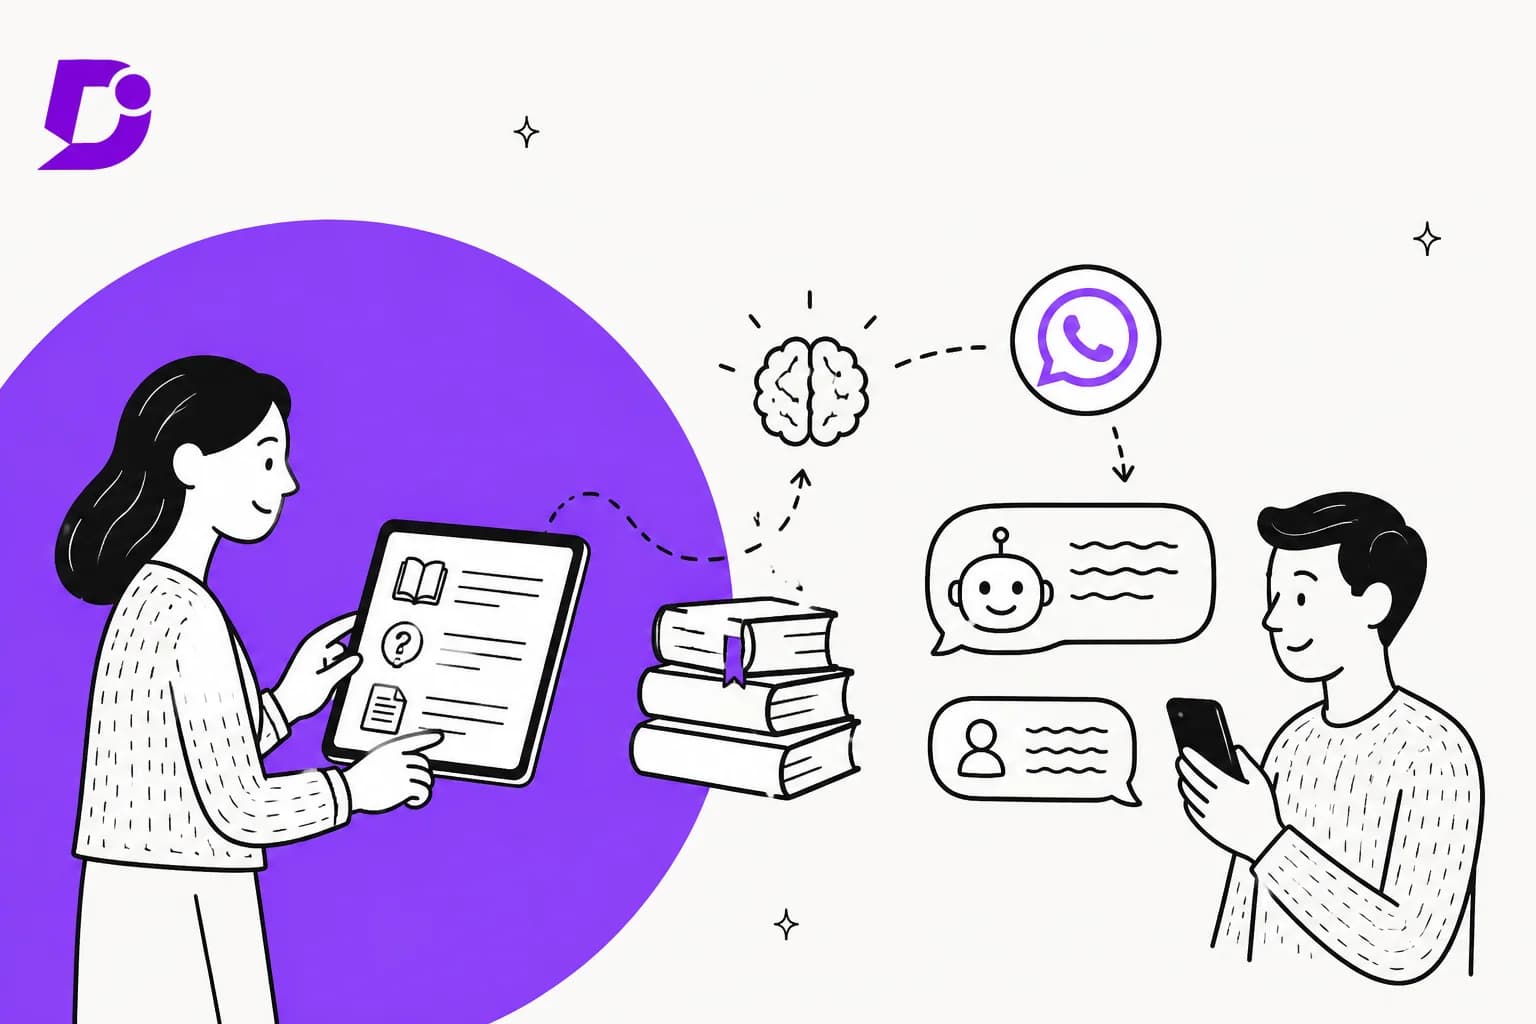
«Meta Muse para Document360» na verdade significa alimentar o Meta Business Agent com sua base de conhecimento do Document360, a IA que responde a clientes no WhatsApp e no Messenger. O Muse em si é um agente para consumidores. O Business Agent não tem importador do Document360 e aprende apenas de quatro entradas: informações da empresa, entradas de FAQ, arquivos enviados e sites públicos rastreados.
O Document360 facilita isso mais que a maioria das ferramentas, porque um site público do Document360 é feito para ser rastreado. Os casos difíceis são projetos privados e atualização. A Meta não consegue rastrear atrás de um login de leitor, arquivos enviados nunca se atualizam sozinhos, e o próprio servidor MCP do Document360 faz login com um fluxo OAuth de usuário que os conectores da Meta não suportam. Uma chave de API v3 somente leitura é a autenticação que se encaixa.
A eesel roda IA em filas de suporte reais há anos, e a falha que mais vejo é um bot que responde com confiança quando a base de conhecimento não tem nada sobre o assunto. Se seus artigos do Document360 mudam toda semana, a eesel rastreia seu site do Document360, linka o artigo de origem em cada resposta e é testada com seus tickets anteriores antes de responder a qualquer pessoa.
O que «Meta Muse para Document360» realmente significa
Passo muito tempo observando o que as pessoas digitam no Google antes de comprar, e «Meta Muse para Document360» é um bom exemplo de busca que aponta para o produto errado. Três produtos da Meta carregam o nome Muse ou ficam perto dele, e só um fala com seus clientes (meu hub Meta Muse para atendimento ao cliente aprofunda os três):
- Muse, o agente de IA pessoal que a Meta lançou para tarefas de consumidores. Não foi feito para atender os clientes de uma empresa.
- Muse Spark 1.3, o modelo, vendido pela Meta Model API. Você poderia construir um bot do Document360 por conta própria com ele, e minha visão geral do Muse Spark 1.3 traz os detalhes do modelo.
- Meta Business Agent, que a Meta lançou em junho como a IA que responde a clientes no WhatsApp, Messenger e Instagram. A Meta diz que mais de um milhão de empresas já o usam.
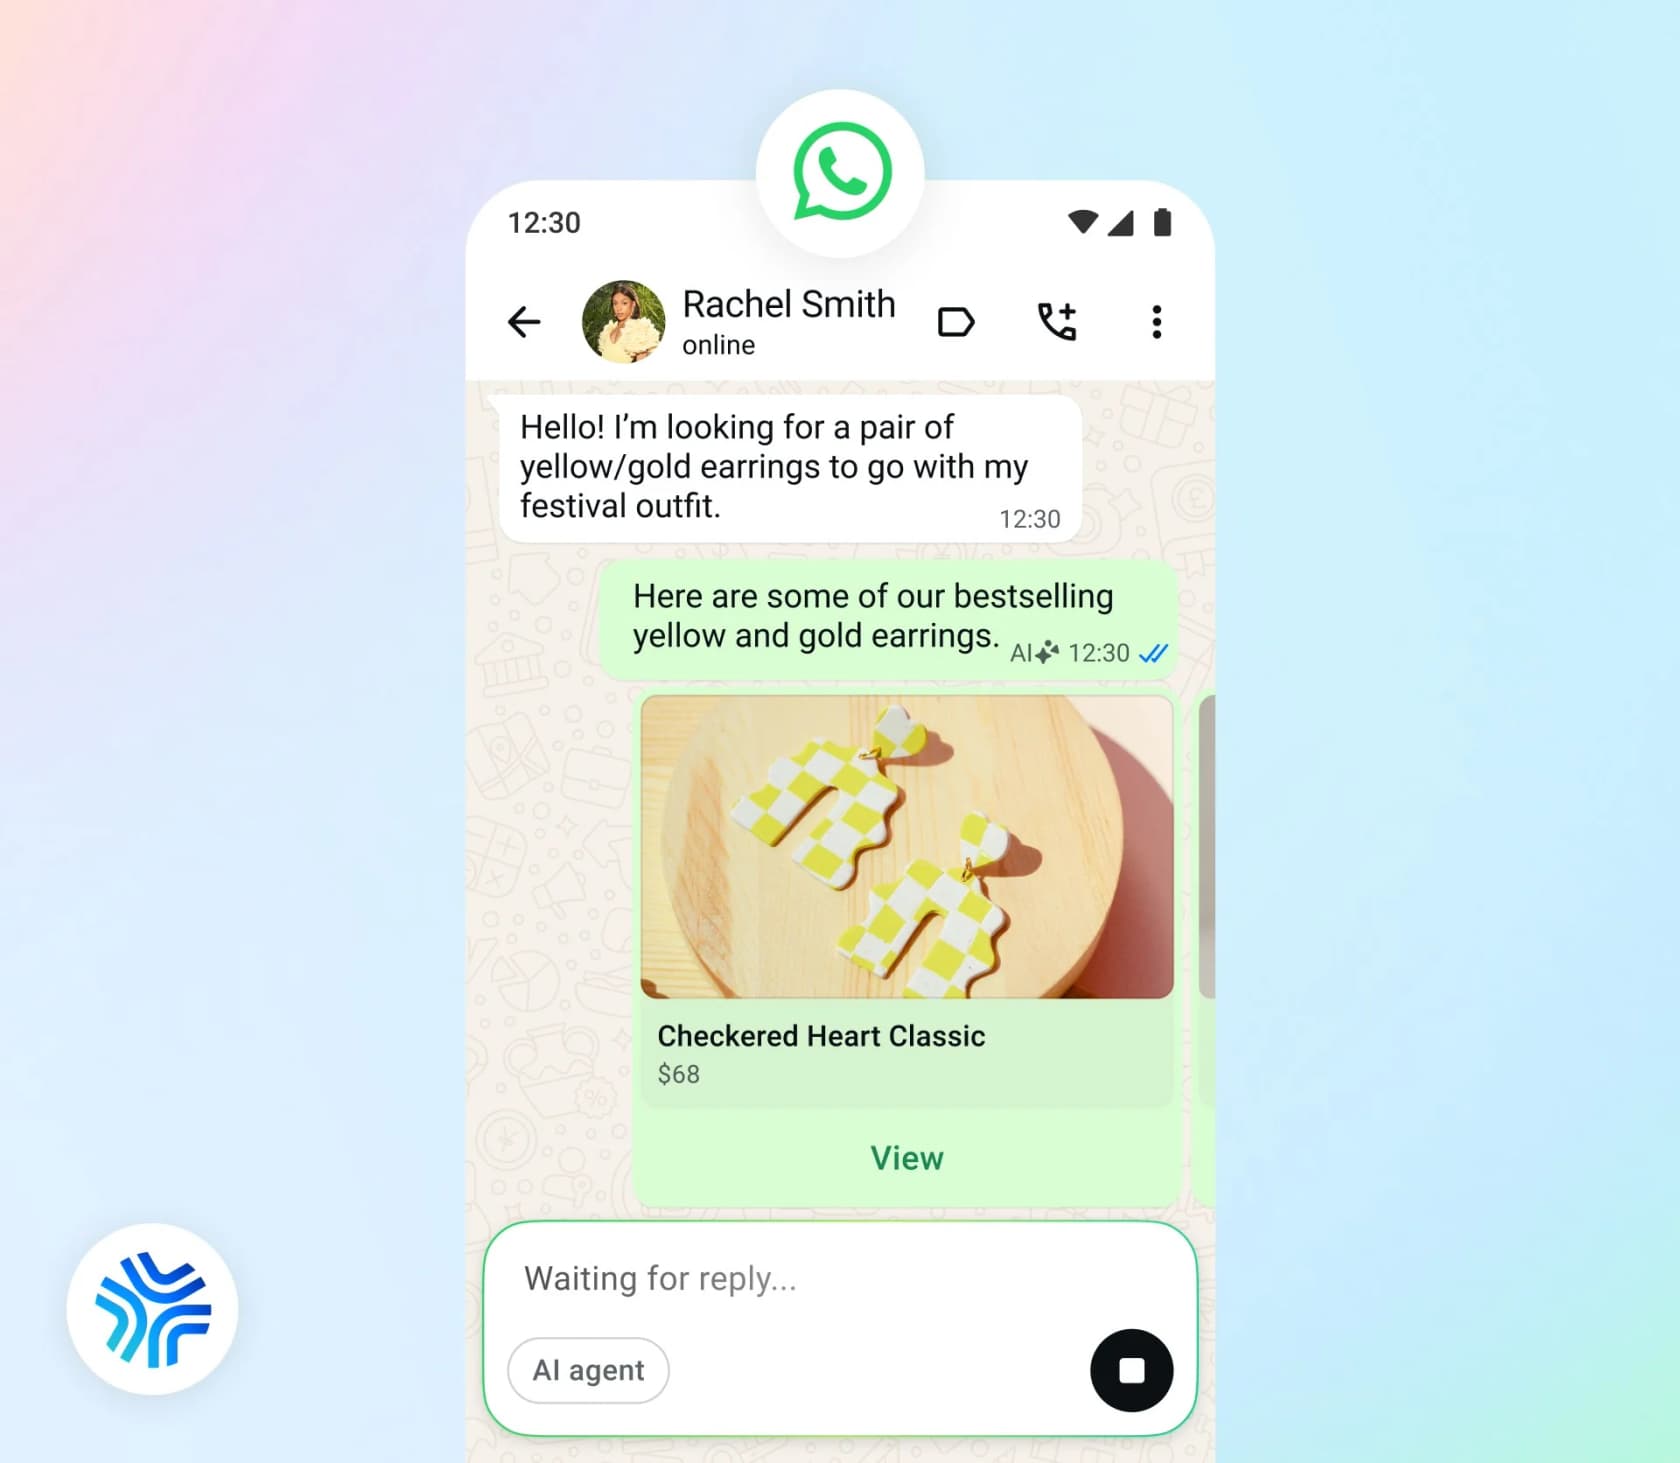
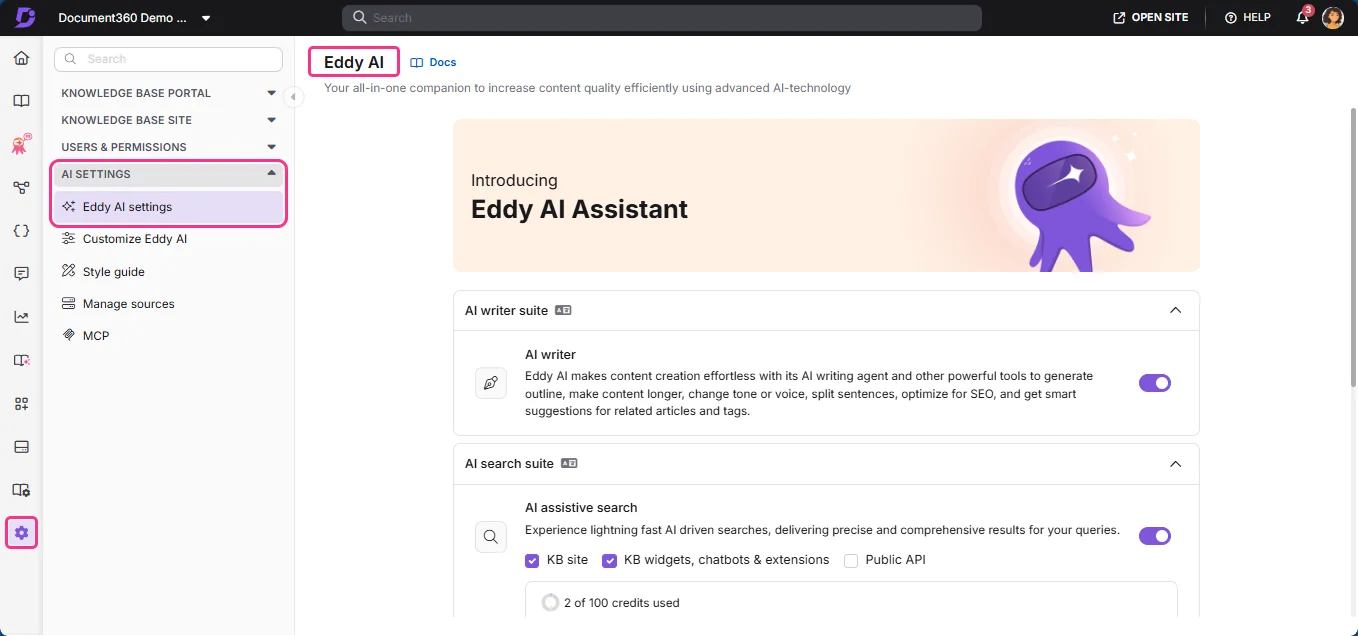
Então a verdadeira pergunta de compra por trás da busca é: como meu conteúdo do Document360 chega a um bot de WhatsApp? É um trabalho diferente dos posts sobre helpdesks desta série, como Zendesk ou Freshdesk, onde as conversas chegam. O Document360 é onde as respostas vivem, e já tem sua própria IA, o Eddy, sobre o qual volto adiante.
O Document360 também é mais parecido com a versão do Confluence deste post do que com qualquer helpdesk. A diferença é que a maioria dos sites do Document360 é voltada ao cliente por design, o que muda qual caminho é o mais fácil.
Quatro formas de o conteúdo do Document360 chegar ao agente da Meta
A página de capacidades da Meta lista quatro fontes de conhecimento na Platform API: Business Info, FAQs, Files e Websites. Ações e consultas passam por conectores, que são integrações HTTP ou MCP que você define. O Document360 não é citado em nenhum lugar da documentação da Meta.
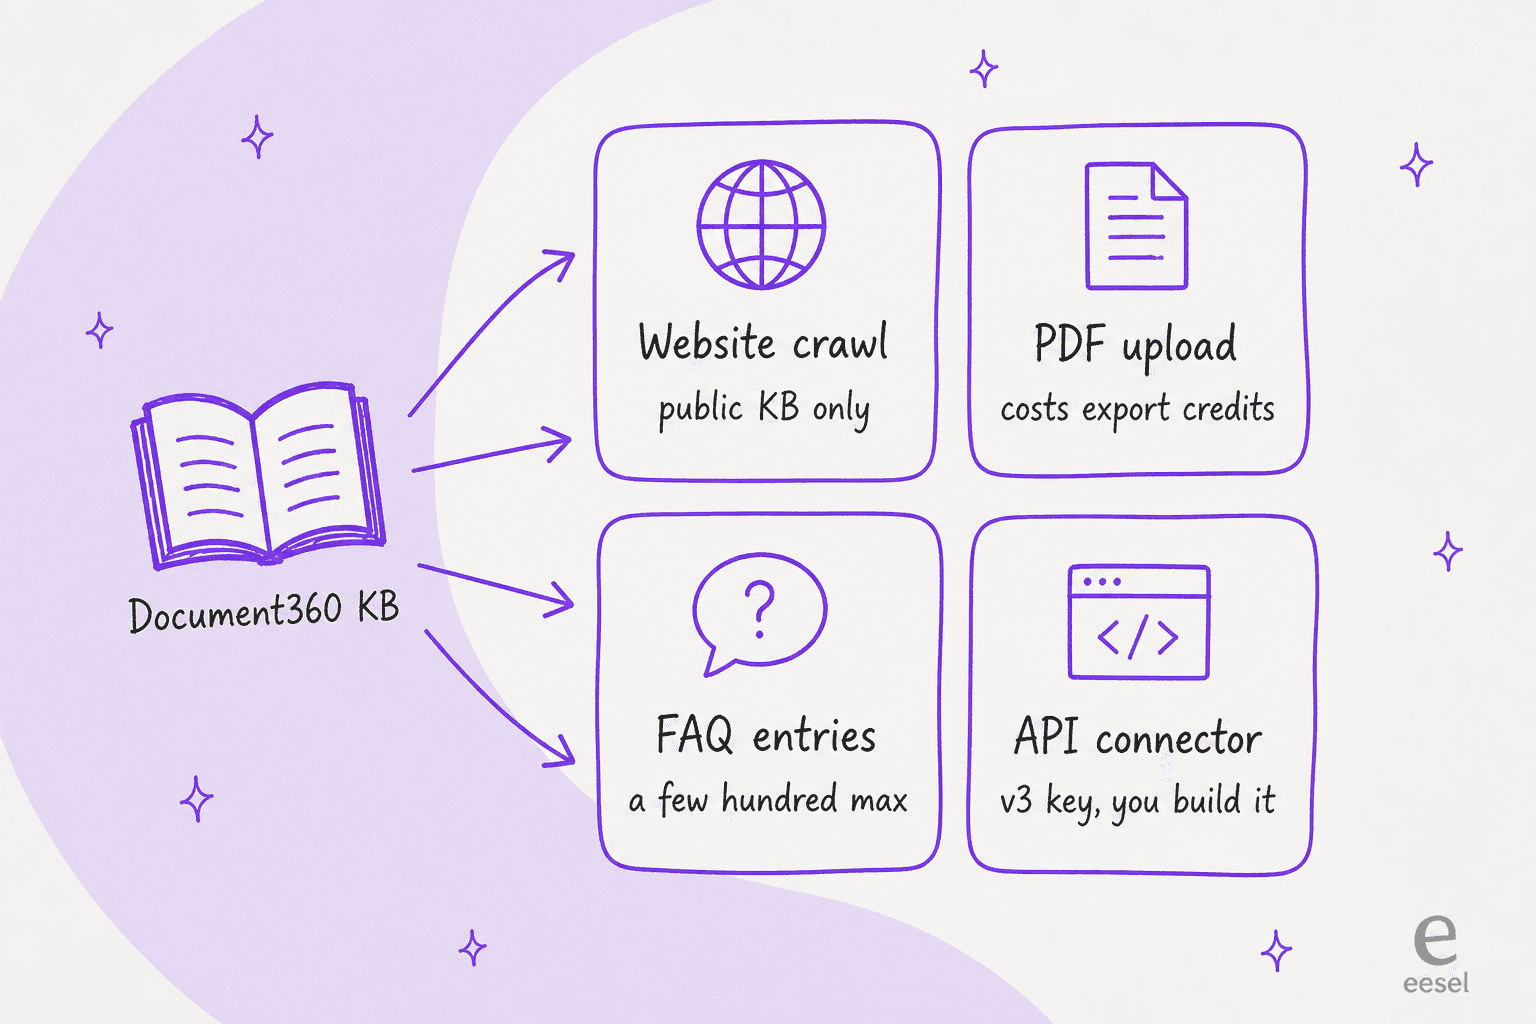
Veja como as quatro se comparam antes de passar por cada uma:
| Caminho | Entrada da Meta | Configuração no Document360 | Projetos privados? | Atualização | Principal pegadinha |
|---|---|---|---|---|---|
| Rastreamento público | API Websites | Um projeto público ou misto, sitemap ativado | Não | Próximo rastreamento, intervalo não publicado | Só funciona para artigos públicos |
| Envio de PDF | API Files | Exportar artigos como PDF | Sim, se você exportá-los | Nunca, até você reenviar | Gasta créditos de exportação de PDF, arquivos antigos continuam ativos |
| Reescrita em FAQ | API FAQs | Nenhuma, reescrever à mão ou com o gerador de FAQ de IA | Sim | Quando você atualiza a entrada | A qualidade cai além de algumas centenas de entradas |
| Conector de API | Conector HTTP | Chave de API v3, somente leitura e restrita | Sim, conforme o escopo de conteúdo da chave | Ao vivo | Você constrói e mantém |
Caminho 1: deixar a Meta rastrear seu site público do Document360
Este é o caminho que a maioria das equipes do Document360 pode usar hoje, porque um projeto público do Document360 já é um site.
A API Websites da Meta rastreia uma URL e traz seu conteúdo. Por padrão ela pega «o domínio inteiro», e você pode restringir com campos de subdomínio, padrão de URL e URL única. A requisição não tem campo para login ou cookie, e o guia do agente de suporte da Meta descreve isso como rastrear «seu site público». Então só o conteúdo que qualquer pessoa abre sem fazer login está no escopo.
O Document360 dá alguns controles que deixam o rastreamento mais limpo:
- Sitemap. O Document360 gera um para seu site, que é o mapa que um rastreador segue. A documentação do sitemap explica o que entra nele.
- Robots.txt. Você pode editá-lo nas configurações do site da base de conhecimento para bloquear caminhos para todos os rastreadores ou um user agent, conforme a página de robots.txt do Document360. A Meta não publica o user agent do seu rastreador na documentação do Business Agent, então eu restringiria com os campos de padrão de URL da Meta e não dependeria de regras de robots.
- Visibilidade na busca. Chaves por artigo excluem uma página do Google, da busca da base de conhecimento ou do Eddy AI. A pegadinha está na documentação de visibilidade na busca do Document360: essas configurações «não restringem o acesso». Um artigo excluído continua legível em sua URL, então um rastreador que encontre o link ainda pode lê-lo.
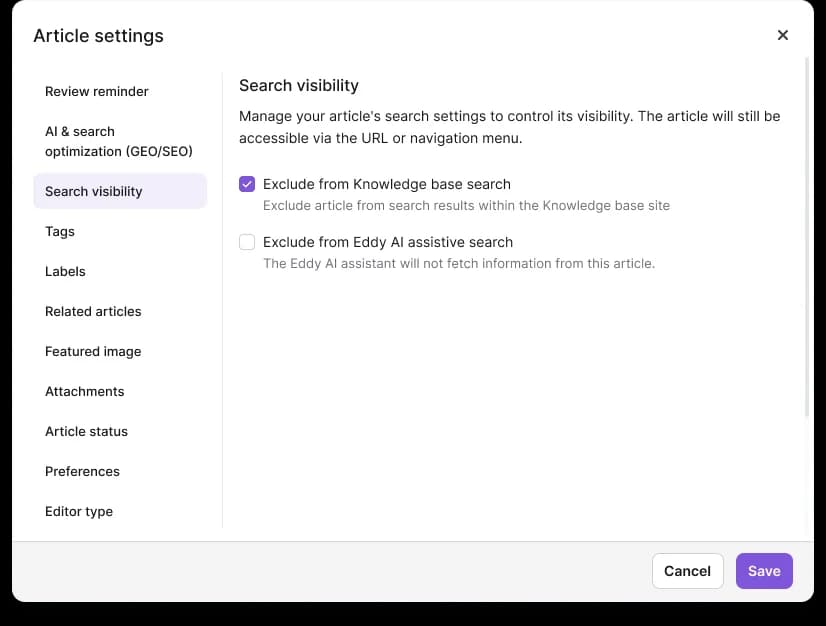
Esse último ponto importa se você tem um projeto misto, em que algumas categorias são públicas e outras são para leitores logados. O FAQ de preços do Document360 descreve os projetos como públicos, privados ou mistos, e diz que contas de leitor «se aplicam apenas a bases de conhecimento privadas» (preços do Document360). A Meta verá a parte pública e nada mais, então confira se as respostas mais perguntadas pelos clientes não estão na metade só para leitores.
Restrinja o rastreamento mesmo assim. O guia da Meta alerta que rastrear um site inteiro «dilui o conteúdo de ajuda de que o agente deveria responder». Se seu site do Document360 também traz referência de API ou notas de versão, aponte a Meta apenas para as categorias de ajuda.
Caminho 2: exportar artigos como PDF e enviá-los
Para um projeto privado, você pode exportar o conteúdo e entregar os arquivos à Meta. A exportação em PDF do Document360 permite escolher categorias e artigos, aplicar um modelo e baixar um PDF.
A API Files da Meta aceita .pdf, .doc, .docx e imagens, com CSV e XLSX quando a extração está ativada, até 100.000.000 de bytes por arquivo. Markdown e HTML não estão na lista, então o PDF é o formato sensato aqui. Vale conhecer antes dois detalhes do Document360:
- Exportações custam créditos. «Cada página do PDF gerado consome um crédito» de uma franquia mensal, e essa franquia é compartilhada com os PDFs que seus leitores baixam do site. Uma exportação de 200 páginas toda semana pesa.
- Só conteúdo publicado entra. Artigos e categorias ocultos não são selecionáveis, o que é útil, pois mantém rascunhos fora do bot.
Depois há a parte que a Meta sinaliza no próprio guia de suporte:
«Não existe chamada de atualização. Para substituir um documento, apague a entrada antiga e envie a nova; caso contrário, o agente usa as duas versões e pode citar um termo que você já retirou.»
Digamos que seu prazo de devolução mude de 30 para 14 dias e alguém envie o novo PDF sem apagar o antigo. O agente pode citar qualquer um dos números no WhatsApp. A própria documentação de exportação do Document360 diz o mesmo pelo outro lado: um PDF exportado «é estático», e edições posteriores «não aparecerão no PDF». Então este caminho significa um script que apaga o arquivo anterior pelo ID e envia o novo toda vez que o conteúdo muda.
A Meta também alerta contra enviar tudo: «um conjunto grande de documentos deixa o agente mais lento para achar a passagem certa». PDFs menores por categoria vencem uma exportação gigante.
Caminho 3: reescrever seus principais artigos como entradas de FAQ
A API FAQs da Meta guarda pares de pergunta e resposta que você pode atualizar no lugar. O agente trata uma entrada correspondente como a resposta e «responde a partir dela, em vez de inferir uma resposta de suas outras fontes de conhecimento». Isso torna as FAQs a entrada mais previsível para respostas que precisam ser exatas, como condições de reembolso ou preços.
O teto é baixo: a Meta diz que a qualidade pode degradar «geralmente além de algumas centenas» de entradas. Para uma equipe do Document360 este caminho é mais barato do que parece, porque o gerador de FAQ de IA do Eddy já rascunha pares de P&R a partir de um artigo. Eu pegaria os principais geradores de tickets do último trimestre (a mesma lista que você usaria para a deflexão de tickets no WhatsApp), geraria FAQs para esses artigos, editaria à mão e enviaria à Meta. A cauda longa vai para o rastreamento ou um conector.
Caminho 4: construir um conector de API com uma chave v3 restrita
Este é o único caminho que mantém o conteúdo privado privado e atualizado ao mesmo tempo, e é o que você precisa construir.
A referência de conectores da Meta permite apontar o agente para uma API HTTP ou um servidor MCP remoto. A autenticação é limitada: «Atualmente, apenas OAUTH2_CLIENT_CREDENTIALS, API_KEY e NONE são suportados.» Essa linha decide qual interface do Document360 você pode usar.
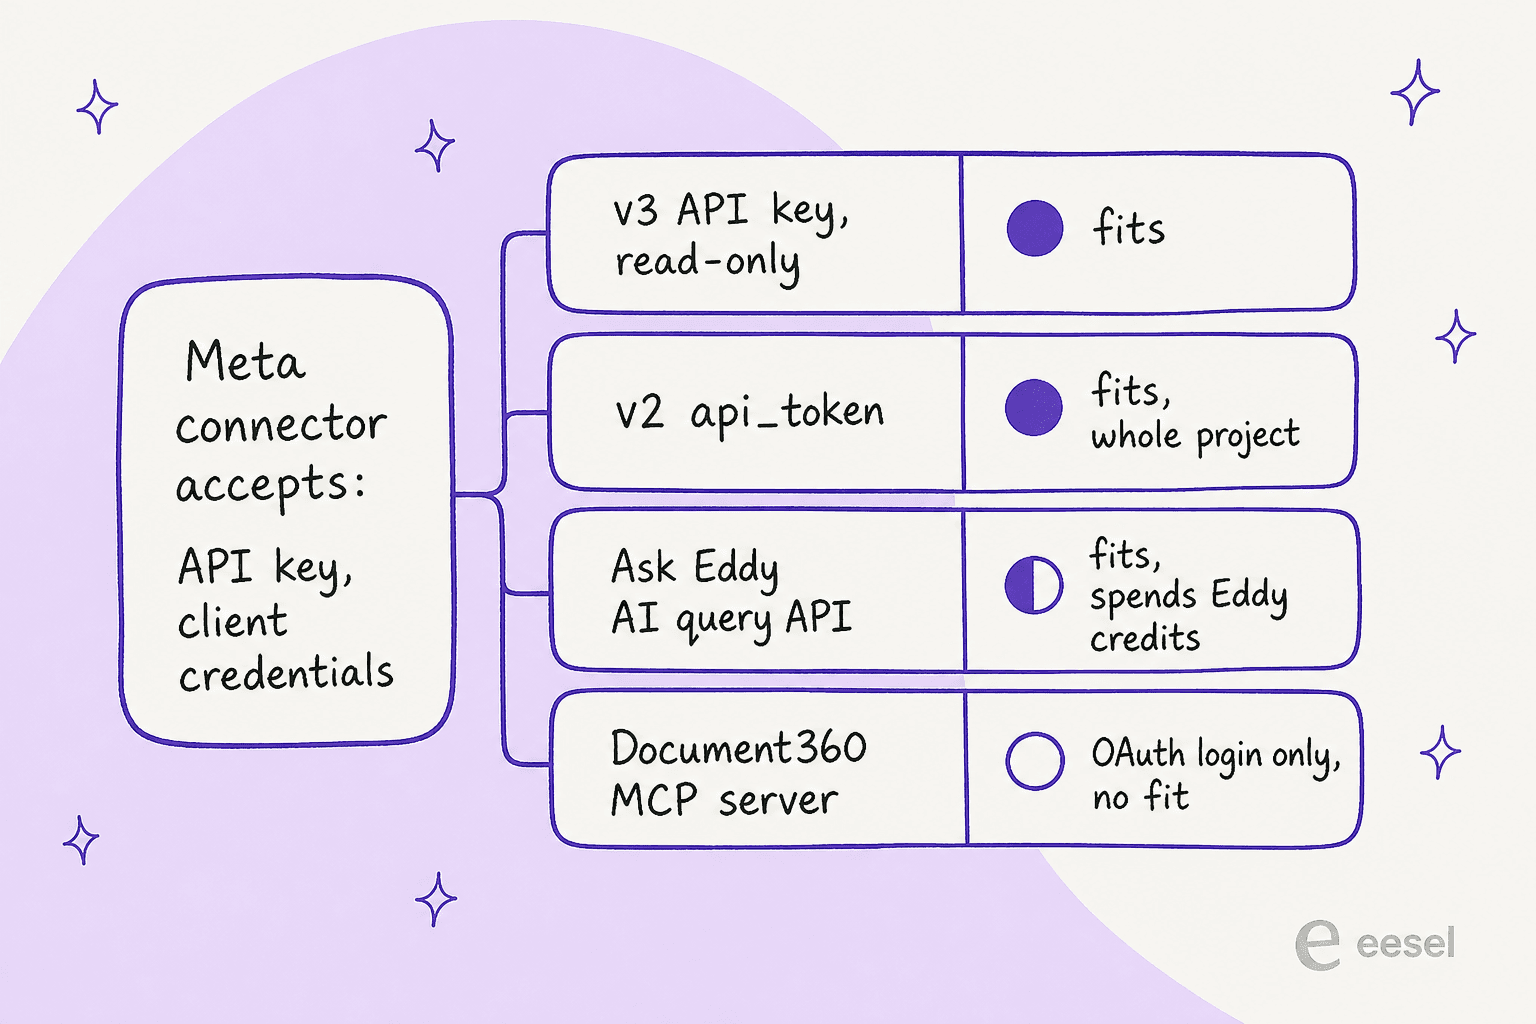
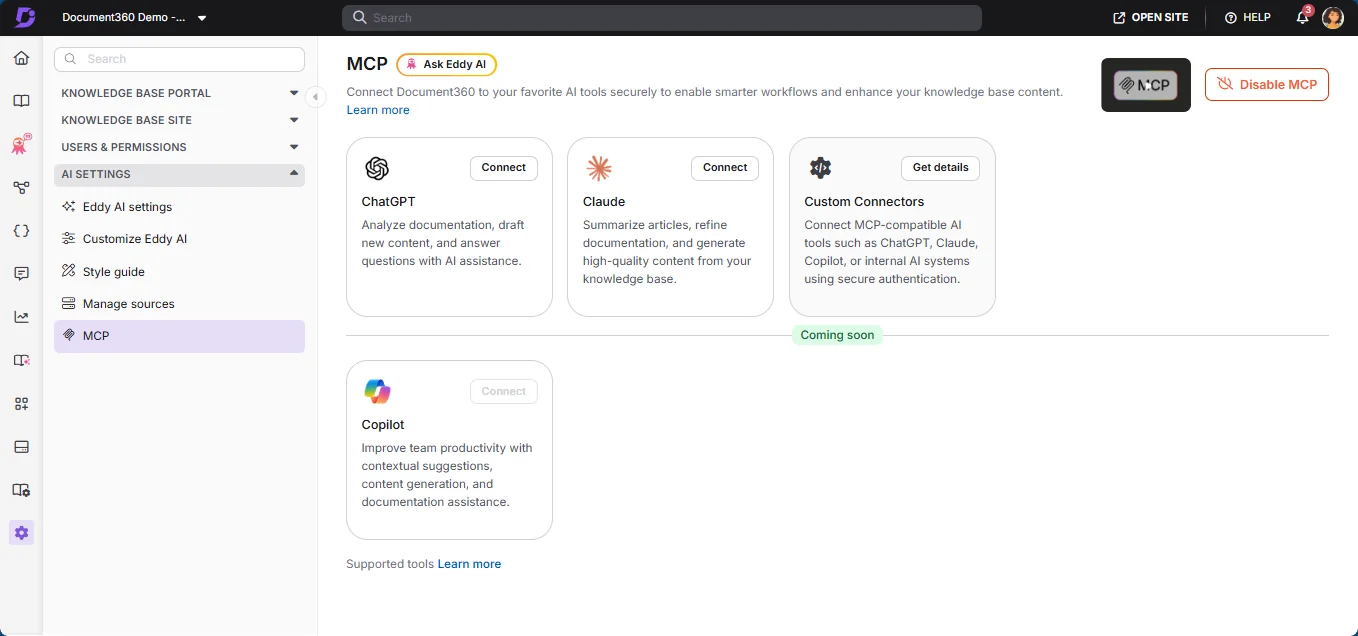
O servidor MCP do Document360 não se encaixa, como documentado. É o primeiro pensamento óbvio, já que ele tem uma ferramenta document360-mcp-search. Mas a visão geral do MCP diz que ele «usa OAuth para autenticação» e vincula cada conexão à «conta de usuário que conclui o fluxo OAuth». Isso é uma tela de consentimento em um navegador, e os conectores da Meta não conseguem clicar nela.
A API REST v3 se encaixa. Se você é novo em MCP, minha explicação de MCP para atendimento ao cliente mostra por que o modelo de autenticação importa tanto. A página de chaves de API do Document360 diz que uma chave vai em um cabeçalho X-API-Key e é «também aceita como Authorization: Bearer», o que corresponde ao tipo de autenticação API_KEY da Meta. A parte útil é o escopo: uma chave v3 carrega um papel de portal, um papel de conteúdo e um escopo de acesso ao conteúdo, então você pode emitir uma chave só GET que lê um workspace ou algumas categorias e nada mais. Projetos criados antes da v3 ainda podem ter o antigo api_token v2, que também funciona, mas não tem escopo de conteúdo.
Um conector básico precisa de duas ferramentas:
- Busca, com o endpoint v3 search workspace articles. É uma busca por palavra-chave em artigos publicados e visíveis, e
page_sizetem limite de 100. - Obter artigo, para trazer o corpo completo da melhor correspondência.
Há uma terceira opção mais interessante: o endpoint v3 AI search query envia uma pergunta em linguagem natural ao Eddy e devolve uma resposta gerada a partir de seus documentos. Ligue isso como ferramenta e o agente da Meta pede a resposta ao Eddy. Funciona com a mesma chave de API, mas cada chamada é uma consulta ao Eddy, e consultas ao Eddy são medidas em créditos.
Planeje três pegadinhas desde o início:
- Limites de taxa. A v3 permite 120 ou 200 leituras por minuto conforme o plano, por chave, segundo a página de limites de taxa. Está bom para uma equipe pequena e vale conferir antes de uma alta temporada.
- Tamanho da resposta. A referência de ferramentas de conector da Meta alerta que respostas grandes demais «degradam a qualidade da resposta do agente». Use sua
transformation_specpara reduzir os corpos dos artigos ao texto. - É uma consulta, não uma fonte de conhecimento. A Meta documenta conectores para ações e consultas de clientes como status de pedido. Nunca descreve um como base de conhecimento, então uma ferramenta «buscar no Document360» deve ser testada a fundo, não é algo que a Meta prometa.
Reserve orçamento para os limites nos dois caminhos que tocam o encanamento do Document360. Um administrador do Document360 no G2 apontou exatamente os dois em que este post se apoia:
«Por fim, há restrições em coisas como uso de tokens de API, limites diários de tamanho de exportação e outros tetos de uso. Esses limites podem criar custos adicionais ou atrito operacional para equipes que gerenciam documentação em grande escala.»

O problema de atualização que ninguém põe na demo
A maioria dos guias de configuração para quando o bot responde à primeira pergunta de teste. Para uma equipe do Document360, o teste real é o que acontece na terça-feira seguinte, quando alguém publica uma edição.
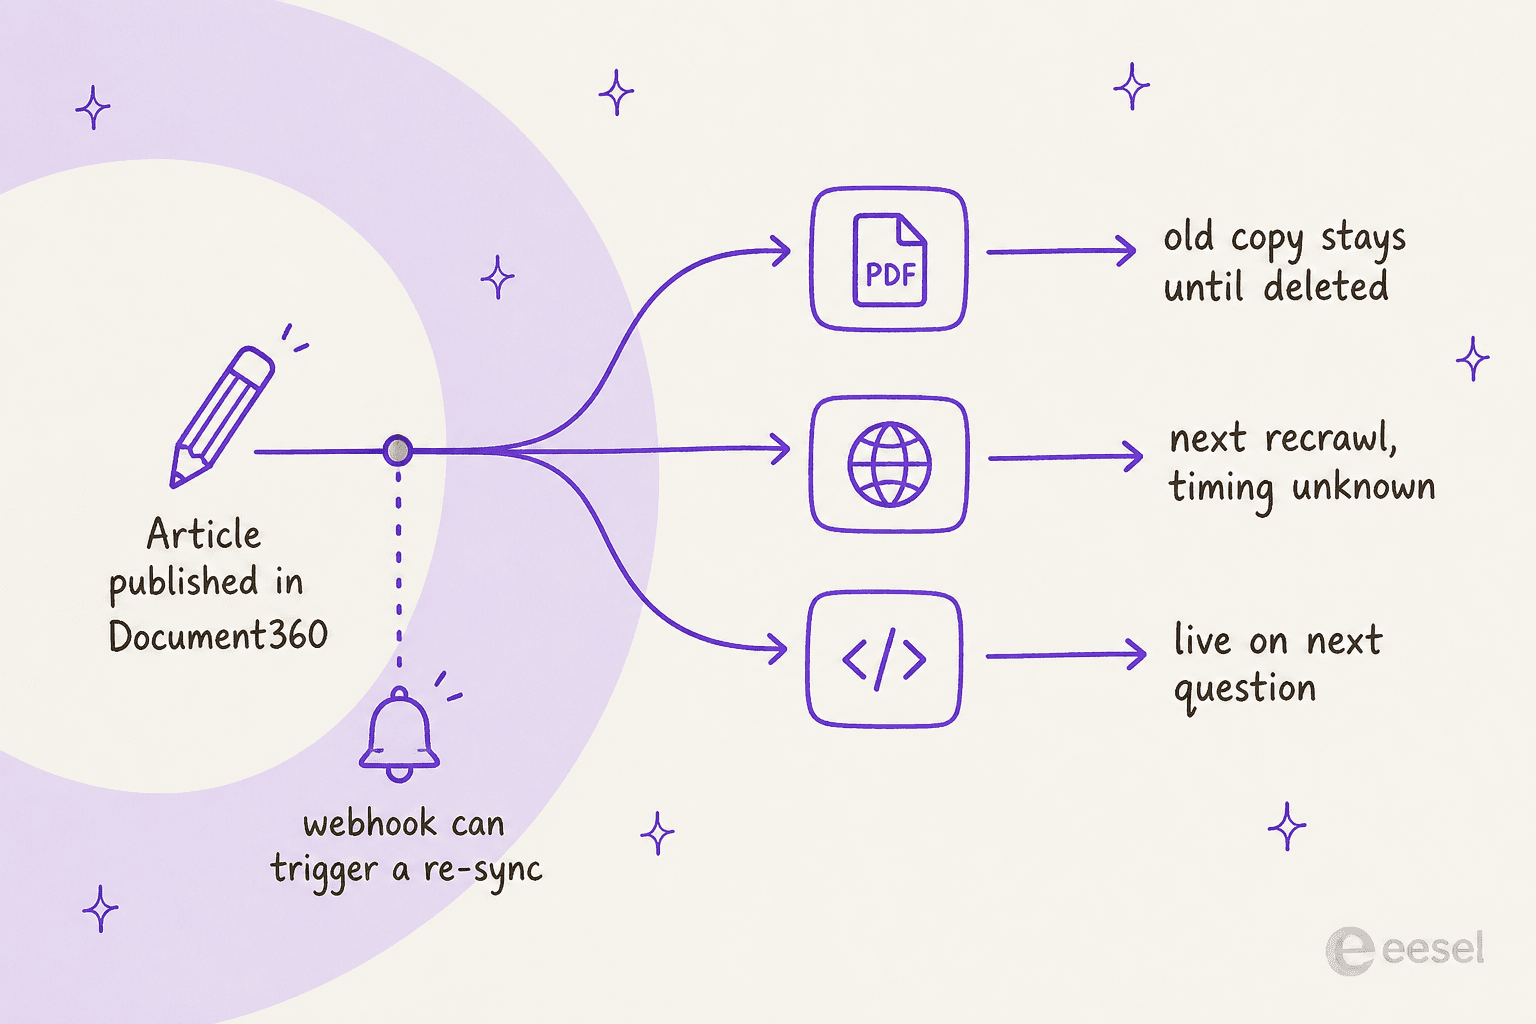
A Meta diz que sites rastreados são «periodicamente rastreados de novo», mas não dá intervalo, e seu guia acrescenta que o conhecimento do site «é um instantâneo tirado no momento do rastreamento». Arquivos nunca se atualizam. FAQs mudam quando você chama a API. Só um conector ao vivo vê uma edição de imediato.
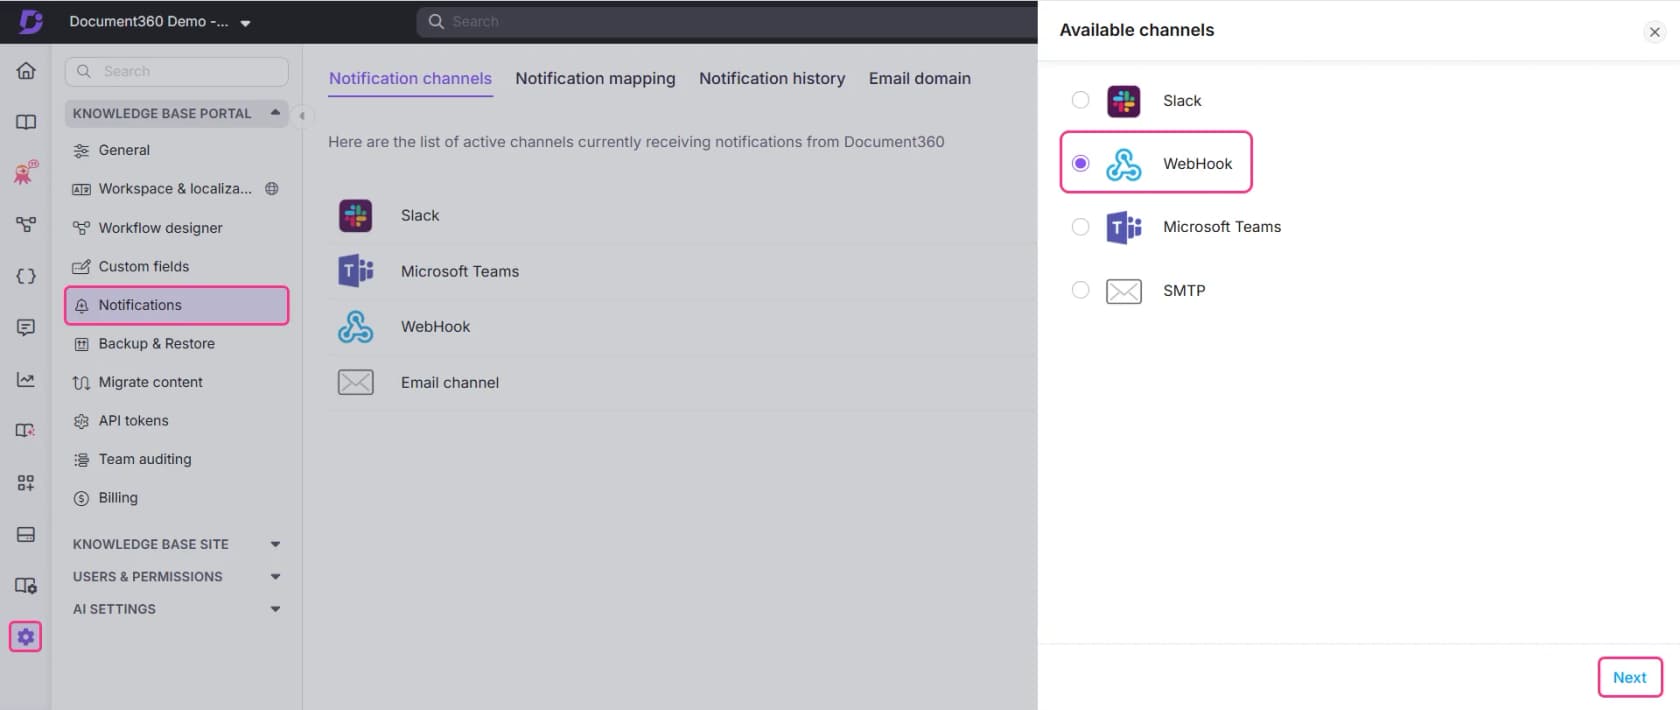
O Document360 tem um recurso que ajuda aqui: as notificações por webhook. Você pode mapear eventos como publicar, atualizar e apagar artigo para uma URL de webhook, conforme a documentação do canal de webhook, e o Document360 cita a invalidação de cache como caso de uso. Esse é o gatilho de que um script de reenvio precisa, e é o mesmo padrão de qualquer automação de suporte no WhatsApp: ao publicar, exportar o artigo, apagar o arquivo antigo na Meta e enviar o novo. Continua sendo um script seu, mas ao menos roda por um evento real e não porque alguém lembrou.
A outra metade da atualização é o que o bot faz quando sua base de conhecimento não tem nada sobre a pergunta. A Meta não tem uma chave «responder só a partir do conhecimento». O ancoramento é uma linha nas suas instruções, e o exemplo da Meta diz: «Responda perguntas de política apenas a partir das políticas documentadas, e diga que vai confirmar com um colega em vez de adivinhar quando a resposta não estiver lá.» Um dos primeiros testadores do Business Agent no Reddit descreveu o que acontece sem isso:
«Consistência é um problema. Vi o mesmo produto voltar com dois preços diferentes em duas respostas. Se você não ancorar direito, ele simplesmente inventa coisas.»

Vi o mesmo em implantações reais da eesel. Tivemos clientes pagantes cujo bot inventava respostas a clientes reais quando a recuperação voltava vazia, por isso uma resposta de contingência para conhecimento ausente e um teste com tickets históricos hoje são padrão antes de qualquer bot entrar no ar. O guia de prevenção de alucinações percorre essa configuração.
Também ajuda escrever artigos que o bot consiga usar. Páginas curtas de um único tema com a resposta no primeiro parágrafo são recuperadas melhor que as longas, e o passo a passo de treinamento com a base de conhecimento mostra como estruturá-las.
Onde o Eddy AI se encaixa
Antes de construir qualquer coisa disso, é justo perguntar se a própria IA do Document360 já faz o trabalho. O Eddy responde no site da sua base de conhecimento, no widget da KB e por um chatbot independente que você incorpora com uma Chatbot Key. Ele também pode treinar com tickets do Freshdesk ou Zendesk, como o guia Freshdesk e Document360 percorre. Cita os artigos que usou e respeita as permissões de artigo para leitores logados.
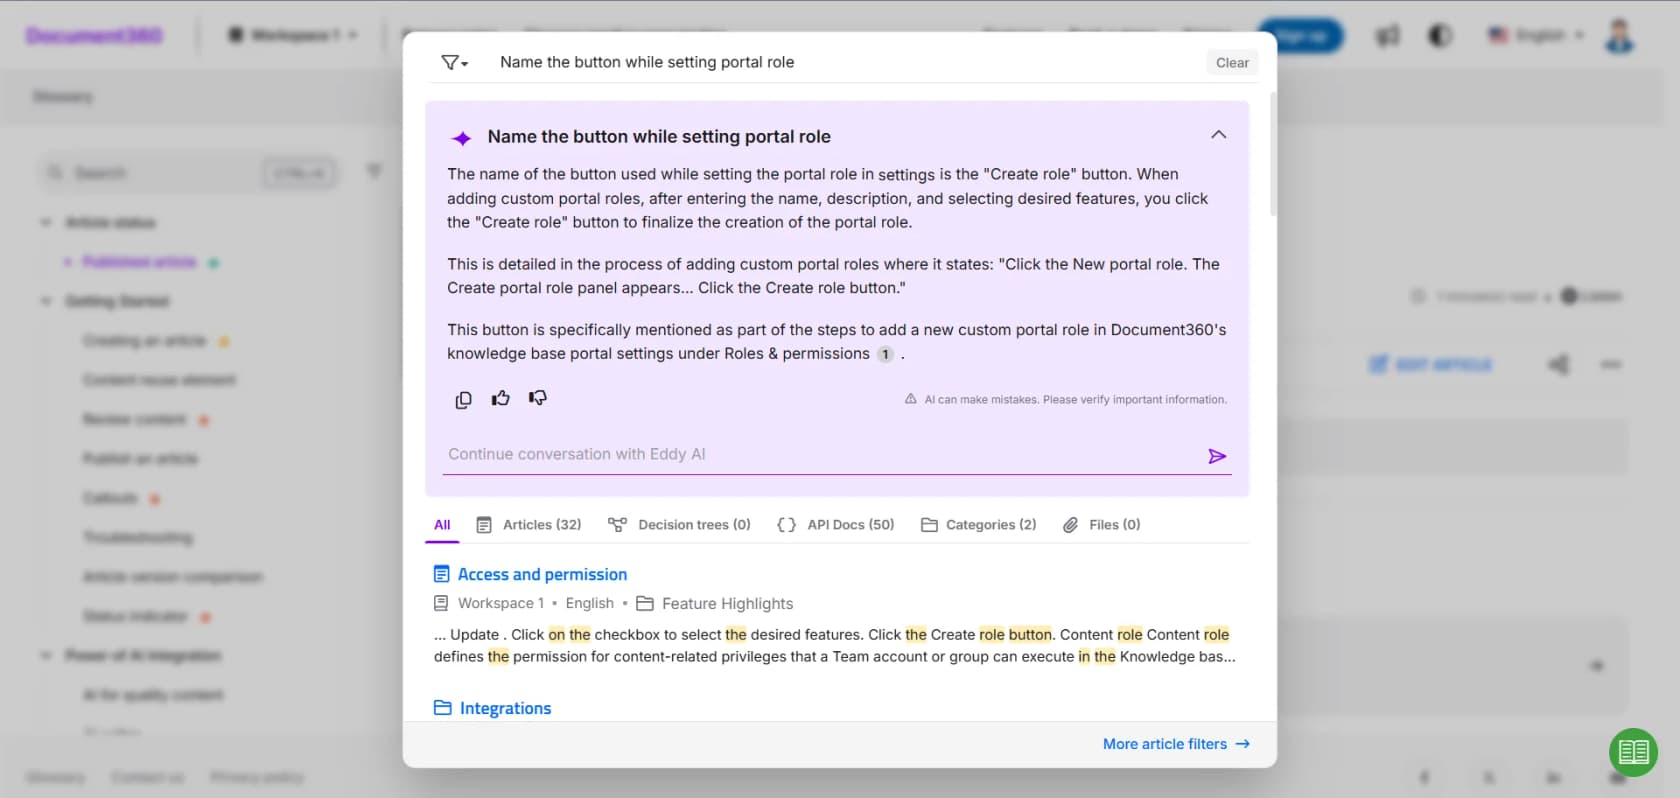
O que o Document360 não documenta é um canal de WhatsApp para o Eddy. O chatbot é implantado em um site, um por domínio, e sua única ação de helpdesk é criar um ticket no Zendesk ou Freshdesk. Então a divisão é simples:
- Clientes perguntam no seu site ou central de ajuda: o Eddy já está lá. Minha análise do Document360 AI cobre a fundo, e a lista de alternativas ao Eddy AI cobre o que mais responde a partir de uma KB do Document360.
- Clientes perguntam no WhatsApp: o agente da Meta é dono desse número, e o Eddy só ajuda se você ligar sua API de busca de IA a um conector.
Se você quer um assistente de uso geral sobre o Document360, os guias de ChatGPT para Document360 e Grok Bot para Document360 cobrem esses caminhos, e IA para Document360 compara escrever documentos com responder a partir deles.
Quanto custa
São duas contas: a da Meta e a do Document360.
| Item de custo | Preço | Fonte |
|---|---|---|
| Meta Business Agent, plataforma WhatsApp | US$ 2,00 por 1 milhão de tokens, cerca de 16 a 20 centavos por conversa simples e 40 a 50 centavos por uma complexa | Preços da Meta |
| Respostas de WhatsApp da sua equipe, a partir de 1º de out. de 2026 | Por mensagem em tarifas de utilidade, após 1.000 gratuitas por número por mês | Preços da Meta |
| Plano do Document360 | Só sob cotação, precificado por contas de equipe, workspaces, idiomas, SSO, modelo de privacidade e uso da AI Premium Suite | Preços do Document360 |
| Contas de leitor do Document360 | Cobradas, apenas projetos privados | Preços do Document360 |
| Exportações em PDF (Caminho 2) | Um crédito de exportação por página de PDF, franquia mensal | Documentação do Document360 |
| Busca do Eddy AI por API (opção do Caminho 4) | Um crédito do Eddy por consulta, franquia definida na sua cotação | Documentação do Document360 |
O lado do Document360 é difícil de quantificar, já que todo plano é uma cotação sob medida. Meu detalhamento de preços do Document360 explica o que o move. Dos seis fatores, o modelo de privacidade é o que se liga a este post: um projeto privado precisa de contas de leitor pagas, e é também a configuração que a Meta não consegue rastrear.
Do lado da Meta, atenção à mudança de 1º de outubro. A página de preços da Meta diz que cada mensagem é cobrada «ou como mensagem do Meta Business Agent ou como mensagem de serviço, nunca as duas», então as respostas da IA são cobradas como tokens e tudo o que sua equipe envia após um repasse é cobrado como mensagens de serviço. Minha explicação de preços da API do WhatsApp traz o histórico completo.
Onde o agente da Meta para para uma equipe do Document360
O agente da Meta é uma escolha razoável para algumas equipes. Aqui está onde ele termina:
- Uma IA por número. A visão geral da plataforma da Meta diz que «uma integração ativa de agente autorizado bloqueia o Meta Business Agent». Você escolhe um bot por número de WhatsApp.
- Só superfícies da Meta. Ele responde no WhatsApp, Messenger, Instagram e num plugin de site que por enquanto está atrelado à Shopify. Minha lista de chatbots de WhatsApp compara ferramentas que respondem além dos apps da Meta. E-mail e filas de helpdesk ficam fora do escopo, e é ali que a maioria dos leitores do Document360 vai parar quando o autoatendimento falha.
- Sem configuração de citações. Nada na documentação da Meta faz o agente linkar o artigo que usou. O Eddy faz, e a maioria dos chatbots de base de conhecimento também.
- O repasse muda a caixa de entrada. Quando o Business Agent assume o número, sua caixa de entrada atual do WhatsApp fica em espera. A versão do Zendesk deste post cobre o Conversation Routing da Meta, e o guia de repasse do agente de IA mostra como é um bom repasse.
- Documentação de API não são respostas de suporte. Muitos sites do Document360 misturam artigos de ajuda com referência de API. Deixe a referência fora do rastreamento, ou o bot responderá uma pergunta de cobrança com a descrição de um endpoint.
Qual configuração combina com sua equipe do Document360
Assim eu escolheria:
| Sua situação | Caminho que eu usaria |
|---|---|
| Central de ajuda pública do Document360, só WhatsApp | Rastreamento de site restrito às categorias de ajuda |
| Menos de 100 respostas-chave que precisam ser exatas | Entradas de FAQ do gerador de FAQ de IA, mais um rastreamento para o resto |
| Projeto privado, conteúdo muda mensalmente | Envio de PDF por categoria, com um script disparado por webhook que apaga antes o arquivo antigo |
| Projeto privado, mudanças semanais, um engenheiro sobrando | Conector HTTP com uma chave de API v3 somente leitura e restrita por categoria |
| Você já paga créditos do Eddy | Conector que chama a API de busca de IA do Eddy, de olho no consumo de créditos |
| Você também responde em um helpdesk ou chat do site | Uma IA em todos os canais, e decidir qual bot é dono do WhatsApp |
Ainda comparando ferramentas e não caminhos? Meu comparativo da melhor IA para suporte no WhatsApp e a lista das melhores ferramentas de IA para base de conhecimento abordam por cada ponta, e as alternativas ao Document360 cobrem a troca da própria KB.
Se você está tentado a construir o conector por conta própria, o post construir ou comprar vale dez minutos antes.
Experimente a eesel com o Document360
Todo caminho acima termina com alguém da sua equipe mantendo a cópia da Meta da sua base de conhecimento sincronizada. A eesel pula essa etapa. É uma colega de helpdesk com IA que lê seu site do Document360 como uma fonte de conhecimento web: você dá a URL da central de ajuda, ela rastreia até 2.000 páginas pelo seu sitemap e links, e cada resposta linka o artigo de onde veio. Caminhos de inclusão e exclusão mantêm sua referência de API de fora, e cabeçalhos personalizados (Cookie, Basic ou Bearer) existem para sites atrás de login, algo que vale testar em um projeto privado.
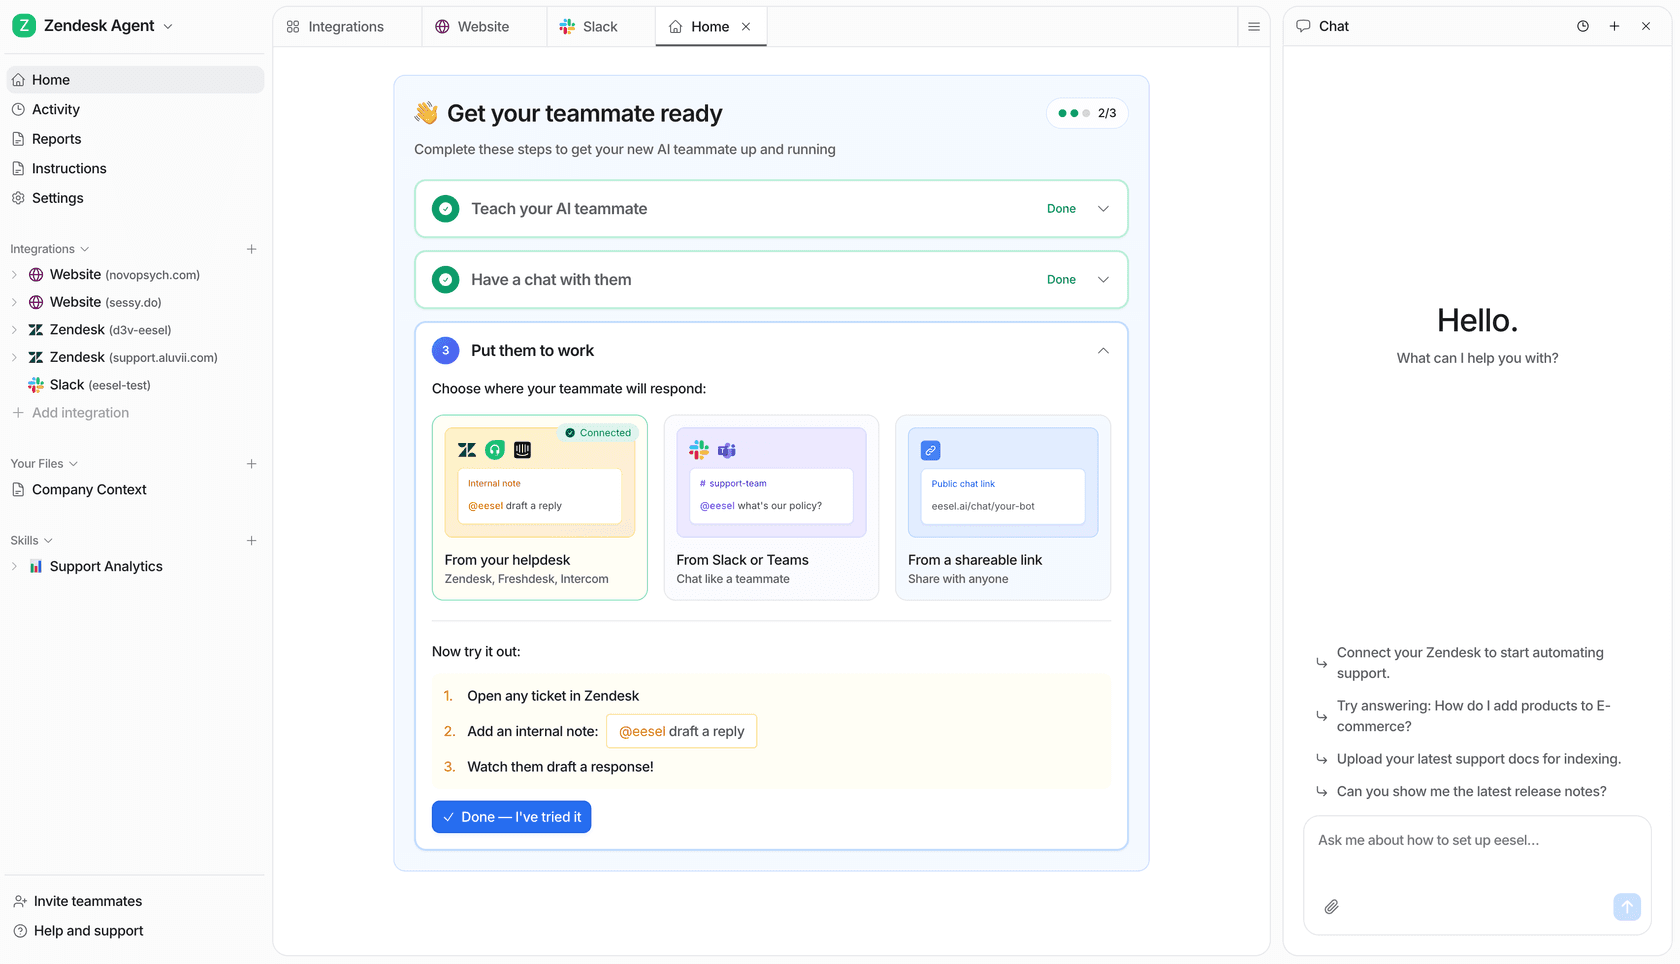
Não há conector nativo do Document360, então não vou fingir o contrário. O que a eesel acrescenta ao rastreamento é tudo o mais de que uma resposta de suporte precisa: seus tickets anteriores, macros e helpdesk, reunidos com os artigos do Document360, e uma simulação com seus tickets históricos antes de o bot responder a um cliente real. Se você trabalha no terminal, a CLI da eesel executa a mesma configuração como comandos: eesel integrations connect website adiciona o site do Document360 e eesel status mostra a contagem de páginas, então o Claude Code ou o Cursor podem fazer isso por você.
Se o WhatsApp é o canal de que você precisa, veja a integração de WhatsApp da eesel e lembre da regra de uma IA por número da Meta ao escolher. O plano gratuito vem com 100 créditos e sem cartão, e os planos pagos começam em US$ 299 por 500 tickets ou chats por mês. Experimente a eesel na sua central de ajuda do Document360 e veja como ela responde.
Perguntas frequentes
O que é Meta Muse para Document360?
O Meta Business Agent consegue ler uma base de conhecimento privada do Document360?
O servidor MCP do Document360 funciona com o agente de WhatsApp da Meta?
O que acontece quando atualizo um artigo do Document360 que o agente da Meta já usa?
Quanto custa o Meta Muse para Document360?
Devo usar o Eddy AI ou o Meta Business Agent para suporte no WhatsApp?
Existe uma IA melhor para atender clientes no WhatsApp a partir do Document360?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.