Garantia de qualidade com IA no Help Scout: o que ela mede e como avaliar o resto

Rama Adi

Katelin Teen
Última edição 21 de novembro de 2026
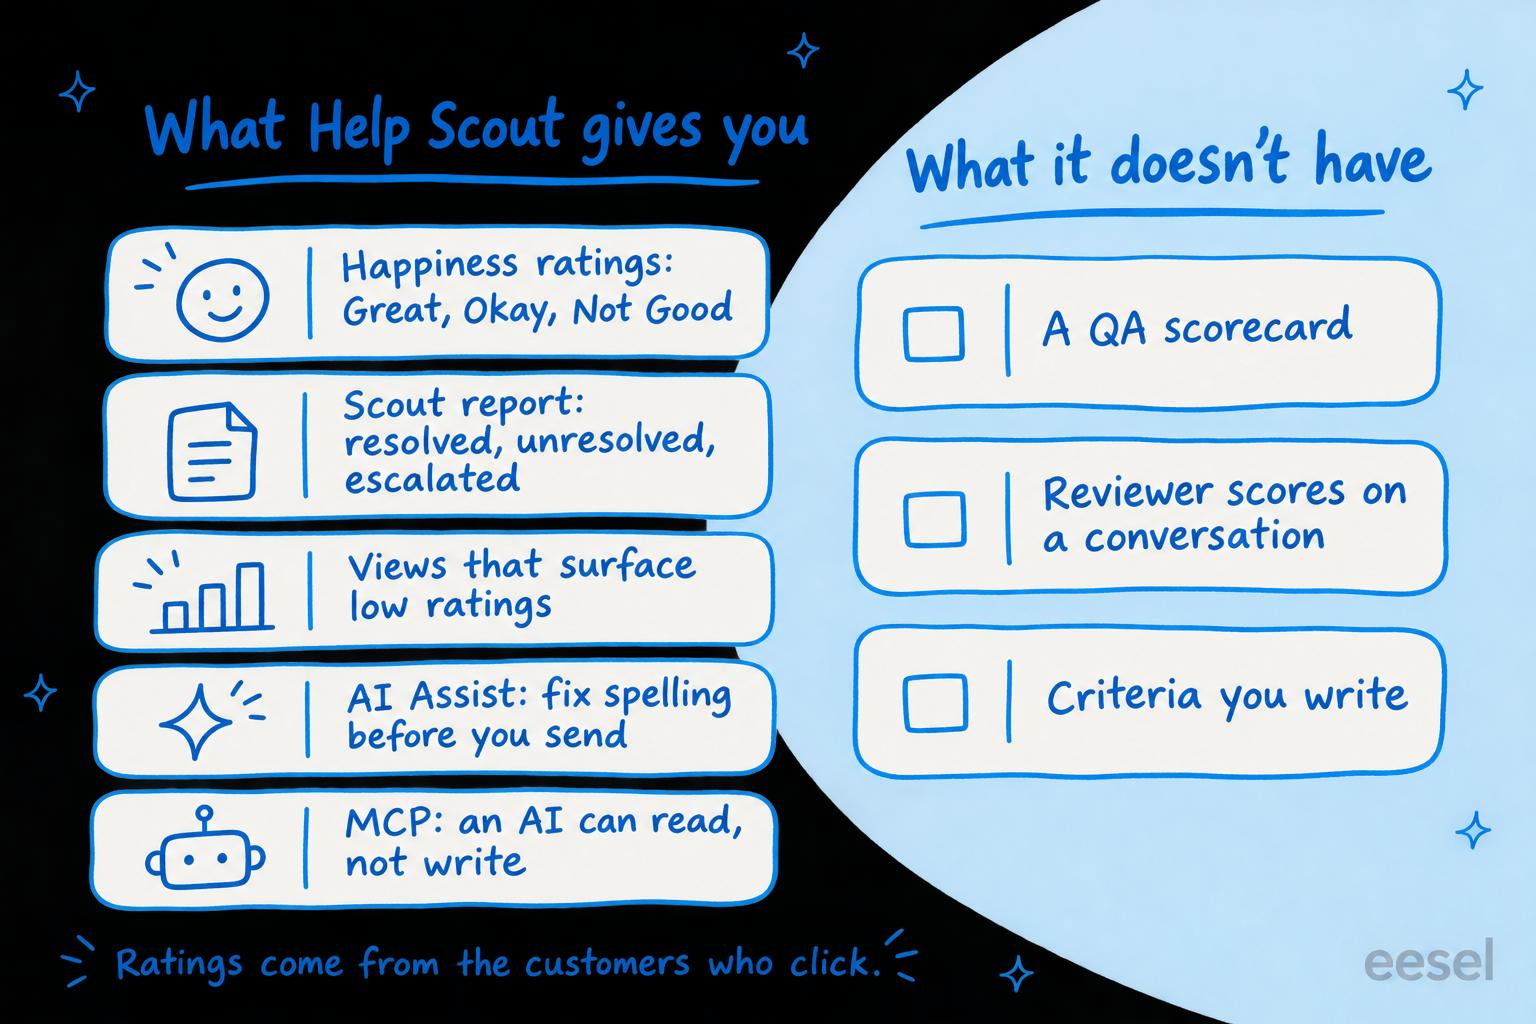
O Help Scout não tem scorecard de QA com IA: nada nele avalia as conversas da sua equipe por precisão, tom ou processo; os sinais de qualidade que ele tem são avaliações de clientes e um relatório sobre se o agente de IA resolveu cada chat. Uma líder de QA tem a própria avaliação do cliente em cada resposta (Great, Okay ou Not Good, somadas em um Happiness Score), um relatório do Scout que marca cada conversa de IA como Resolved, Unresolved ou escalada, e acesso só leitura para Claude ou ChatGPT pelo servidor MCP do Help Scout. Então o Help Scout te diz como os clientes que clicaram em uma avaliação se sentiram, e deixa para você a pergunta "a resposta estava certa segundo nossa política?". Você pode cobrir isso com uma amostra avaliada à mão toda semana, um assistente de IA lendo conversas via MCP, ou um colega de IA como o eesel que avalia toda conversa encerrada segundo uma rubrica que você escreve e deixa os motivos como nota interna. Um agente de código como o Claude Code pode escrever essa rubrica no eesel e configurar o horário pela CLI do eesel, ainda que uma admin do Help Scout precise aprovar a conexão.
O Help Scout tem garantia de qualidade com IA?
Não, não como um scorecard. Eu construo as integrações do eesel, então leio a documentação de helpdesks para ver o que um recurso realmente faz por trás do texto de marketing. A página de recursos de IA do Help Scout lista o Scout (seu agente de IA), AI Drafts, AI Summarize, AI Assist, Topics e um servidor MCP. Nenhum deles avalia uma conversa que sua equipe atendeu segundo um conjunto de critérios de garantia de qualidade.
Isso combina com a forma como o Help Scout descreve sua IA: construída em torno de "can be used to improve support", não em torno de desviar chamados. Também significa que uma líder de suporte que quer saber se as respostas foram precisas precisa juntar as peças sozinha. Veja o que cada peça mede:
| Recurso do Help Scout | Plano | O que diz a uma líder de QA | O que não diz |
|---|---|---|---|
| Avaliações Happiness | Standard mantém 2 anos de relatórios; Plus e Pro, a vida da conta | Como se sentiram os clientes que clicaram em uma avaliação | Nada sobre respostas que ninguém avaliou |
| Relatório do Scout | Scout está no Standard, Plus e Pro, cobrado por resolução | Quais conversas de IA foram resolvidas, ficaram sem resolução ou foram passadas a uma pessoa | Se uma resposta resolvida estava correta |
| AI Assist | Standard, Plus e Pro | Corrige ortografia e gramática, e ajusta o tom, antes de enviar uma resposta | Não avalia nada depois do envio |
| Topics | Plus e Pro | Sobre o que os clientes escrevem, por tema | O quão bem a equipe respondeu |
| Servidor MCP | Standard, Plus e Pro (ferramentas de relatório exigem Plus ou Pro) | Deixa seu próprio assistente de IA ler conversas e relatórios | Não pode escrever notas ou tags de volta |
O que as avaliações Happiness do Help Scout dizem?
Elas dizem como o cliente se sentiu em relação a uma resposta, nas próprias palavras dele. Ative as avaliações de satisfação por caixa de entrada em Settings, Inboxes, depois Satisfaction Ratings, e toda resposta por email passa a levar links de avaliação. O cliente escolhe Great, Okay ou Not Good e pode adicionar um comentário.
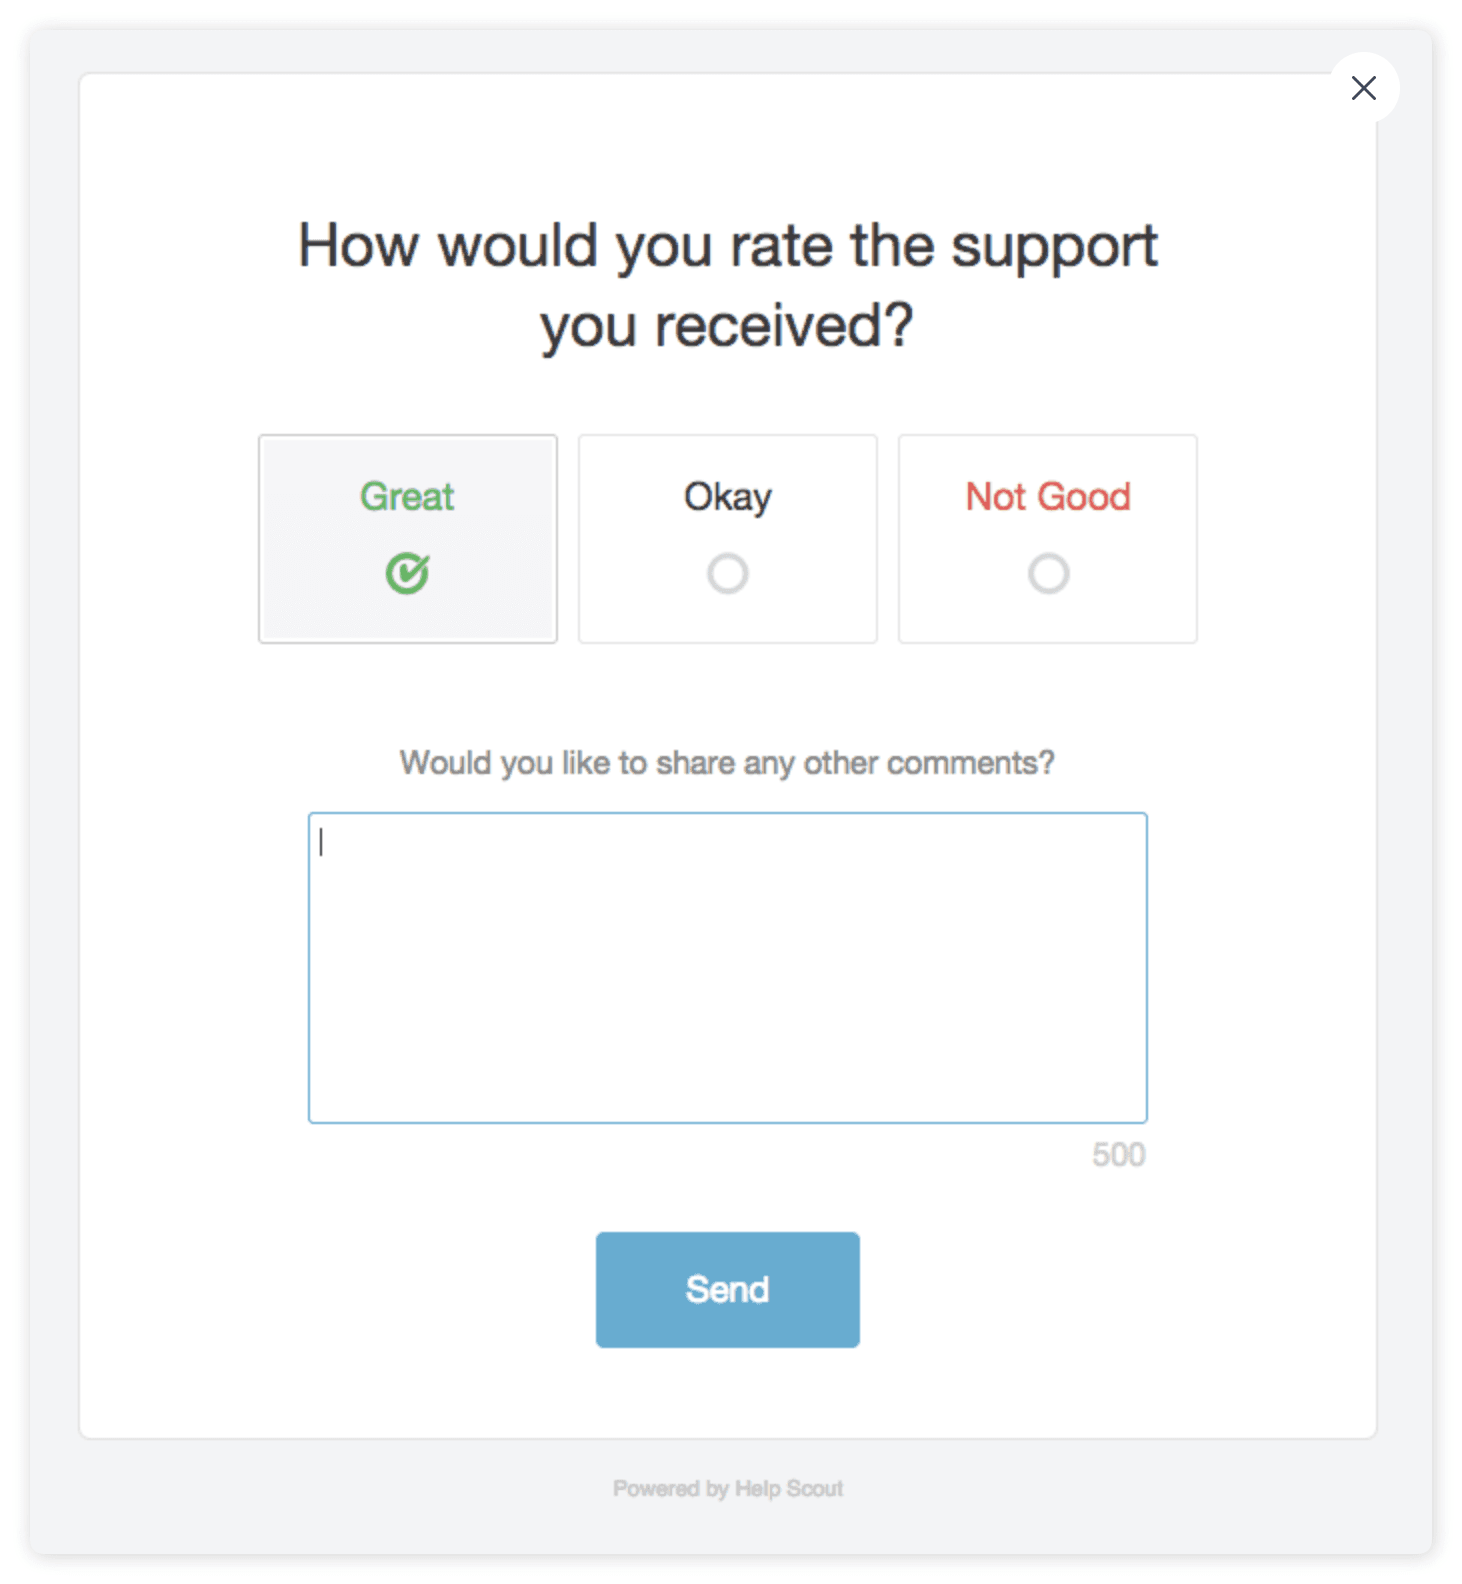
As regras importam se você for ler isso como um sinal de qualidade:
- Toda resposta pode ser avaliada. Se um agente manda cinco respostas, o cliente pode avaliar as cinco, uma avaliação cada.
- A janela é de 10 dias. Os clientes podem avaliar, ou mudar uma avaliação, por 10 dias após a resposta. Avaliações não podem ser excluídas.
- A pontuação é um número líquido. O relatório Happiness mostra o percentual de Great, Okay e Not Good, e um Happiness Score que é o percentual de Great menos o percentual de Not Good, calculado de forma parecida ao NPS.
- As avaliações contam na data da resposta, não na data em que o cliente clicou, então o número da semana passada ainda pode mudar. Minhas notas sobre as datas do relatório Happiness explicam o que isso faz com uma revisão semanal.
- Cada agente tem sua própria aba. Abra o relatório Company, depois um relatório User, para ver as avaliações de uma pessoa.
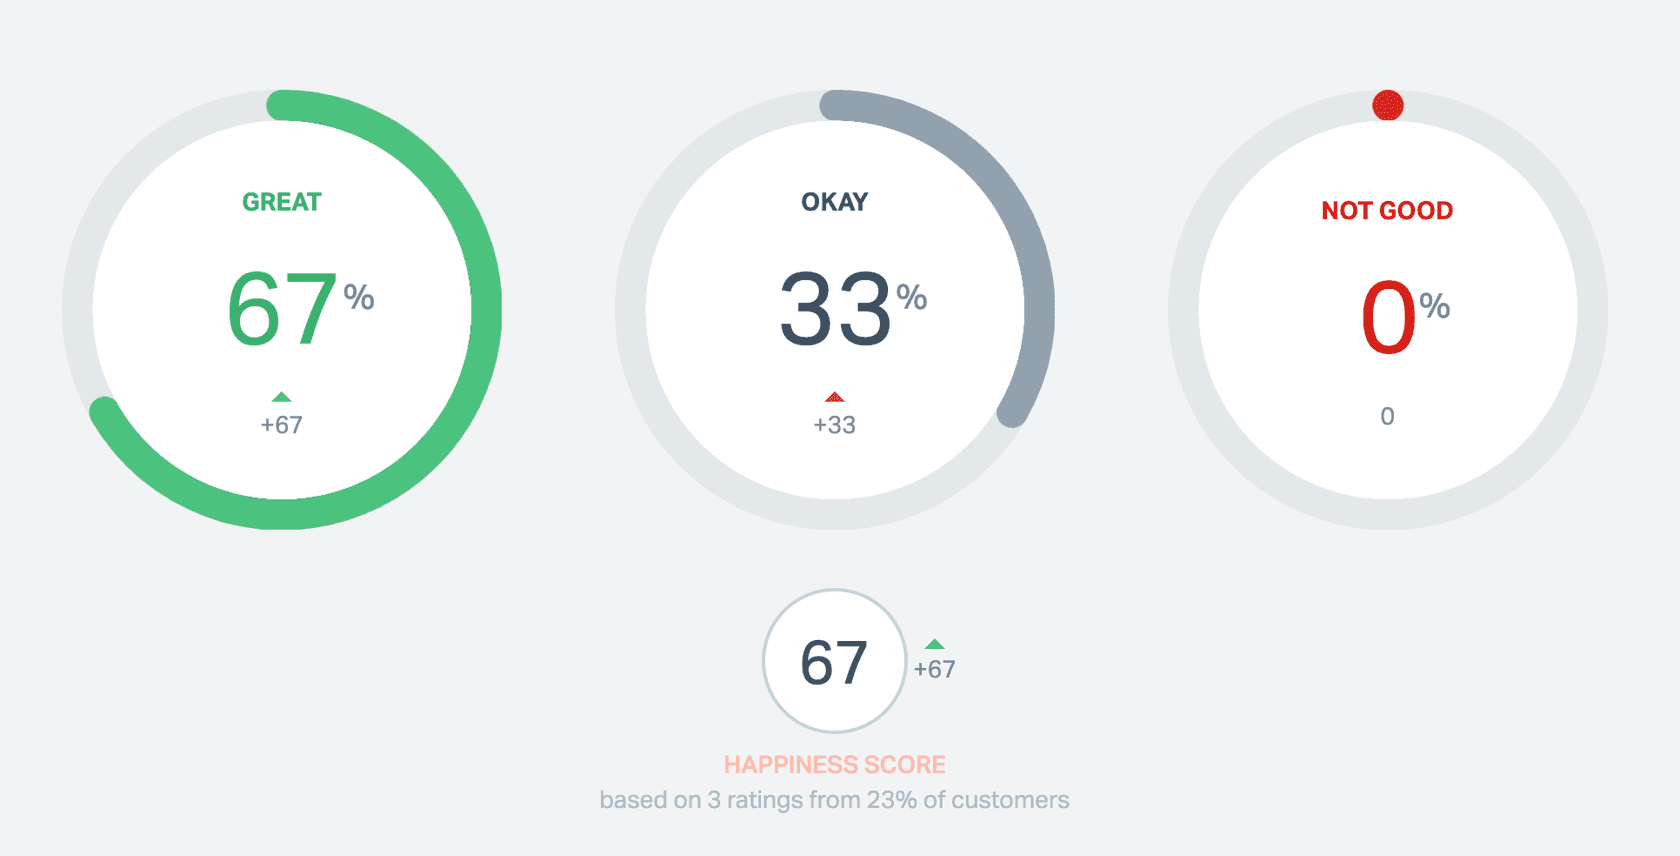
Olhe a letra pequena nessa captura: três avaliações de 23% dos clientes. Esse é o limite das avaliações como QA. Como qualquer pesquisa CSAT, elas só ouvem os clientes que se dão ao trabalho de clicar, e um cliente que recebeu uma resposta de reembolso errada mas confiante pode avaliar como Great até o reembolso não chegar. Uma avaliação diz como a resposta foi sentida. Não diz se a resposta seguiu sua política, que é a lacuna que ferramentas de CSAT com IA tentam fechar.
As avaliações ainda são um bom ponto de partida para uma revisão. Desde maio de 2026, as views do Help Scout podem filtrar pelo que acontece dentro de uma conversa, então você consegue "spot low-rated interactions that need follow-up", e um workflow pode avisar uma líder por email quando chega uma avaliação. Se quiser saber mais sobre como os clientes se sentem, meu artigo sobre análise de sentimento Help Scout vai mais a fundo.
Como revisar as respostas de IA do Scout no Help Scout?
Use o relatório do Scout, em Reports, depois Scout. O Scout é o agente de IA do Help Scout (o produto que você paga se chama Envoy, a 0,75 $ por resolução), e o relatório classifica cada conversa em que ele participou em três grupos:
- Resolved: o Scout deu uma resposta e o cliente não disse que precisava de mais ajuda.
- Unresolved: o cliente disse que precisava de mais ajuda, ou o Scout escalou por uma exclusão, mas o cliente não voltou a contatar.
- Human Escalation: a conversa foi para sua equipe.
Cada Beacon (o widget de chat do Help Scout) tem seu próprio relatório, com uma tabela de sessões mostrando a primeira pergunta do cliente, a resolução, como a sessão terminou, a avaliação e o Topic. As boas práticas do Scout do Help Scout dizem para ordenar por resolução, ler as conversas em que os clientes não foram ajudados, e adicionar uma Improvement onde o Scout deveria ter respondido melhor. Account Owners e Administrators também podem ver as fontes que o Scout checou quando falhou.
Esse é um ciclo de revisão razoável para os erros da IA. Mas note o que "Resolved" significa: o cliente não pediu mais ajuda depois da última resposta. Esse é também o momento em que o Help Scout cobra uma resolução. Uma resposta errada que o cliente acreditou conta como resolvida, então vale a pena ler também uma amostra de sessões resolvidas, não só as falhas. Containment e escalonamento de IA explica essa armadilha com mais detalhe.
Quanto custa rodar QA no Help Scout?
Nada além do seu plano: avaliações, o relatório Happiness e o relatório do Scout não custam extra. O que muda por plano é até onde os relatórios vão e quais ferramentas de IA você tem. Segundo os preços do Help Scout, verificados em 21 de novembro de 2026:
| Plano | Por usuário, cobrança anual | Cobrança mensal | O que importa para QA |
|---|---|---|---|
| Free | 0 $ | 0 $ | Até 5 usuários, "No AI tools included" |
| Standard | 25 $ | 30 $ | Relatórios Happiness dos últimos 2 anos, AI Assist, acesso MCP sem ferramentas de relatório |
| Plus | 45 $ | 54 $ | Relatórios vitalícios, Topics, AI Drafts, ferramentas de relatório MCP |
| Pro | 75 $ | 90 $ | Tudo do Plus, mínimo de 10 usuários |
| Envoy (complemento) | 0,75 $ por resolução | Cobrado mensalmente, de forma retroativa | Scout e seu relatório |
Para uma equipe de oito no Plus, são 360 $ por mês na cobrança anual, com o relatório do Scout incluso se você também pagar pelas resoluções do Envoy. Minhas notas sobre os preços do Help Scout cobrem o resto de cada plano.
O que um scorecard de QA precisa, e o Help Scout deixa para você?
A maioria dos scorecards de QA (aqui alguns critérios de scorecard de referência) verifica três coisas que o Help Scout nunca avalia: se a resposta estava certa segundo sua política, se o agente seguiu seu processo (tags, respostas salvas, escalonamento), e se parecia você falando. Isso precisa de alguém, ou algo, que tenha lido suas regras.
Escolha o que você quer verificar e veja o que cobre isso:
Escolha uma verificação para ver o que cobre isso no Help Scout, e o que cobre se nada cobrir.
Há três formas de cobrir essa lacuna.
Avaliar uma amostra à mão
O caminho mais barato não precisa de nada novo, e é de onde partem a maioria dos guias de QA de suporte com IA. Toda semana, uma líder abre uma view das conversas encerradas na última semana (as com avaliação mais baixa primeiro), lê dez ou vinte, e avalia cada uma segundo uma rubrica curta em uma planilha. Combinem antes o que cada nota significa, para que dois revisores deem o mesmo número para a mesma conversa: a calibração de QA de suporte ajuda com isso, assim como estes exemplos de feedback de QA.
O limite é o óbvio: uma pessoa lê uma amostra, não todas as conversas, e as notas vivem fora do Help Scout.
Pedir a um assistente de IA via MCP
O servidor MCP do Help Scout permite que Claude, ChatGPT e Cursor listem, pesquisem e resumam conversas, incluindo seus tópicos, tags e campos personalizados, e extraiam relatórios Happiness e outros no Plus e Pro. Cada pessoa se conecta com seu próprio login do Help Scout, então o assistente só vê o que essa pessoa pode ver.
Isso dá uma sessão semanal de QA decente: cole sua rubrica, peça ao assistente para ler as conversas encerradas na última semana na caixa de Support, e avaliar cada uma com um motivo. Dois limites a conhecer. Conexões novas são só leitura, então o assistente não pode adicionar notas ou mudar tags no que avaliou, e os resultados ficam só no seu chat. E ele roda quando alguém lembra de pedir, não toda manhã. Nos planos Claude Team e Enterprise, só uma Claude Owner pode adicionar o conector. Minhas notas sobre Claude para Help Scout cobrem a configuração.
Deixar um colega de IA avaliar segundo sua rubrica
A terceira forma é um agente de IA que faz a revisão por conta própria, com suas regras, e escreve o resultado de volta no Help Scout. É isso que eu faria com o eesel. A integração do Help Scout do eesel pode listar conversas por status, tag ou o dia da última atualização, ler cada uma com cada resposta, nota e tag, deixar uma nota interna e adicionar tags.
Coloque isso em um horário programado e toda manhã ele:
- Lista as conversas encerradas desde ontem.
- Lê cada uma segundo os critérios que você escreveu em palavras simples ("uma oferta de reembolso precisa seguir a política de 30 dias do documento de devoluções", "perguntas de envio levam a tag
shipping", "a gente assina com o primeiro nome do agente"). - Deixa a nota e os motivos como nota interna, e marca os erros com a tag
qa-reviewpara que uma líder possa montar uma view do Help Scout com eles. - Envia à líder um resumo do dia, por Slack ou email, se você conectar.
Você escreve a rubrica, então a precisão de política e a voz são só mais linhas nela, e você muda quando suas políticas mudarem. Ele pode avaliar as conversas do Scout com a mesma rubrica das da sua equipe, e o mesmo agente eesel também pode redigir respostas ou marcar e rotear conversas novas se você quiser. Duas coisas para saber antes de começar: as notas do eesel mostram o nome do usuário do Help Scout com o qual ele se conecta, então dê a ele seu próprio usuário, e ele não pode definir campos personalizados, então as notas vivem em notas, tags e nos relatórios que o eesel escreve, não no relatório Happiness do Help Scout.
Verificações programadas como essa já rodam para clientes do eesel. A Cactus Club Cafe roda um segundo agente eesel no seu helpdesk Zendesk que auditoria o extrato financeiro diário toda manhã: ele verifica cada loja e resolve o chamado como balanceado, ou deixa aberto com a diferença indicada. Entre 8 de agosto e 8 de setembro de 2026 ele rodou cerca de 60 vezes. Uma revisão de QA tem a mesma forma: um job toda manhã, segundo regras escritas, com o resultado deixado no chamado.
A abordagem do Help Scout para qualidade é suficiente?
É preciso reconhecer: o Help Scout não finge. (O Gorgias, em comparação, oferece o Auto QA, que avalia três critérios por IA e deixa o resto para uma pessoa.) As avaliações são feedback honesto de clientes, o Happiness Score é fácil de ler, o relatório do Scout mostra com clareza onde a IA falhou, e o AI Assist pega erros de digitação antes que cheguem a alguém. Para um time pequeno, avaliações mais uma leitura semanal das conversas pior avaliadas formam um programa de QA razoável.
Minha opinião: trate as avaliações Happiness e o relatório do Scout como sua lista de triagem, não como sua nota de QA. Elas mostram onde olhar, mas só ouvem os clientes que clicam, e "resolvido" só significa que o cliente parou de perguntar. Quando você precisar saber se as respostas seguiram suas políticas em toda conversa, vai precisar de uma revisora que tenha lido essas políticas: o tempo de uma pessoa, um assistente via MCP uma vez por semana, ou um colega de IA que faz isso toda manhã e escreve de volta no Help Scout.
Experimente o eesel ao lado do Help Scout
Mantenha suas avaliações Happiness e o relatório do Scout para o que eles fazem bem. O que o eesel pode fazer depende de quem está pedindo: você escolhe quais ações dele rodam por conta própria, quais pedem confirmação antes e quais ficam desligadas. Deixe-o ler suas conversas encerradas do Help Scout contra o resto da sua rubrica: suas regras de reembolso, suas tags e sua voz, escritas em palavras simples e mudadas sempre que suas políticas mudarem. Ele deixa os motivos em uma nota interna em cada conversa, marca as que uma líder deveria ler, e te responde em linguagem simples quando você quiser mudar o que ele verifica.

Experimente o eesel na sua caixa de entrada do Help Scout, começando pelas conversas encerradas ontem.