

Resumo
O Claude Opus 5.5 é o modelo mais inteligente. O GPT-6 Sol é o mais barato. Ambos foram lançados em 22 de setembro de 2026. Na comparação da Artificial Analysis, o Opus 5.5 marca 58 no Intelligence Index contra 48 do Sol, e lidera no GDPval-AA, no Terminal-Bench 4.0 e no AutomationBench. O Sol custa metade por token: US$ 2/US$ 10 por milhão contra US$ 4/US$ 20.
No preço de tabela, o Opus custa o dobro. Em esforço máximo, ele custou 5,6 vezes mais por tarefa concluída (US$ 5,98 contra US$ 1,06), porque escreveu quase quatro vezes mais tokens de saída. Se você compara por custo equivalente em vez de por rótulos de esforço equivalentes, o quadro muda de novo: o Opus 5.5 em esforço medium supera o Sol em max, 51 a 48, por US$ 1,34 a tarefa contra US$ 1,06.
Minha escolha: Sol para trabalho de alto volume no dia a dia, em que a resposta é bem definida. Opus 5.5 em medium para trabalhos difíceis, longos e agênticos, em que uma resposta errada custa mais que os tokens. Se o trabalho é atender clientes, o modelo importa menos que o sistema ao redor, que é o que um colega de helpdesk com IA como a eesel cuida, cobrado por ticket resolvido em vez de por token.
Dois lançamentos, uma tarde
Eu construo agentes de IA na eesel, e todo lançamento de modelo de fronteira significa o mesmo ritual para mim: rodar de novo minhas avaliações, olhar o custo por trabalho concluído e decidir quais tarefas migram para o novo modelo. Esta semana o ritual veio duas vezes seguidas. A Anthropic lançou o Claude Opus 5.5 em 22 de setembro, e a OpenAI respondeu em poucas horas com o GPT-6 Sol e o Luna.
Esse timing importa para ler os anúncios. A tabela de benchmarks da Anthropic compara o Opus 5.5 com o GPT-5.6 Sol e o GPT-6 Astra, porque o GPT-6 Sol ainda não existia. A tabela da OpenAI compara o Sol com o Claude Opus 5 e o Claude Fable 5.1, não com o Opus 5.5. Nenhum dos fornecedores mediu o modelo novo do outro. Por isso, para um confronto justo, eu me apoio nos testes independentes da Artificial Analysis, que rodou os dois no mesmo ambiente de testes.
Eles são mesmo da mesma classe? Alguns leitores acham que não, já que o Sol custa metade. Um comentarista do HN expôs a visão oposta com clareza:
"Sol is OpenAI's Opus, and Astra is OpenAI's Fable. Both pricing-wise, and performance-wise."

Concordo com essa correspondência. Cada um é o modelo "use este por padrão" do seu fornecedor, um degrau abaixo do carro-chefe. É exatamente por isso que desenvolvedores estão escolhendo entre eles esta semana.
O que cada modelo é
GPT-6 Sol
O GPT-6 Sol é o meio da família GPT-6 da OpenAI, entre o barato GPT-6 Luna e o carro-chefe Astra. O lema da própria OpenAI é "Build with Sol. Scale with Luna." A manchete é o preço: US$ 2 de entrada e US$ 10 de saída por milhão de tokens, um corte direto de 50% em relação ao GPT-5.6 Sol. A Artificial Analysis coloca a inteligência dele aproximadamente no nível do GPT-5.6 Sol, com o ganho real de qualidade em veracidade factual.
A página do modelo lista seis configurações de raciocínio, de none a max, com medium como padrão, e o conjunto completo de ferramentas da Responses API: busca na web e em arquivos, interpretador de código, shell hospedado, uso do computador e MCP.
Claude Opus 5.5
O Claude Opus 5.5 é a passada de eficiência da Anthropic sobre o Opus 5. É o primeiro Opus a ficar mais barato, 20% a menos, a US$ 4/US$ 20, e a Anthropic agora recomenda começar por ele para a maior parte do trabalho, em vez de tratar o Opus como o último recurso premium. O esforço padrão caiu de high para medium, o raciocínio está sempre ativo e a documentação do Opus 5.5 indica data de corte em junho de 2026.
A Anthropic o posiciona com a qualidade do Fable 5.1 na maior parte das tarefas. A Artificial Analysis atualmente o classifica em 1º lugar entre 212 modelos no seu Intelligence Index.
Especificações e preço lado a lado
A maior parte da ficha técnica é empate. A diferença está quase toda na coluna de preço.
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| ID do modelo na API | gpt-6-sol | claude-opus-5-5 |
| Entrada / saída por 1M de tokens | US$ 2 / US$ 10 | US$ 4 / US$ 20 |
| Leituras de cache por 1M | US$ 0,20 | US$ 0,20 |
| Batch API | 50% de desconto (US$ 1 / US$ 5) | 50% de desconto (US$ 2 / US$ 10) |
| Acréscimo para contexto longo | 2x na entrada, 1,5x na saída acima de 272K | Nenhum |
| Janela de contexto | 1.050.000 tokens | 1M de tokens |
| Saída máxima | 128.000 tokens | 128K (300K no beta do Batch) |
| Data de corte de conhecimento | 20 de abril de 2026 | Junho de 2026 |
| Esforço padrão | Medium | Medium |
| Dá para desligar o raciocínio | Sim (none) | Não, raciocínio sempre ativo |
| Entrada / saída | Texto + imagem de entrada, texto de saída | Texto + imagem de entrada, texto de saída |
Duas linhas merecem atenção. Primeiro, as leituras de cache custam o mesmo nos dois. Se sua carga é um prompt de sistema grande e estável mais perguntas curtas, boa parte da sua conta de entrada é idêntica. Segundo, a linha de contexto longo. Acima de 272K tokens de entrada, o preço de entrada do Sol dobra, então em trabalhos de contexto enorme a diferença de 2x se fecha rápido. Como observou um usuário do HN:
"Once you exceed 272K input tokens, Codex Sol is roughly the same price as Opus; and Astra similar to Fable."
Para as tabelas de preços completas, incluindo o modo Fast e preços regionais, veja minha análise dos preços do GPT-6 Sol e a sua contrapartida do Opus 5.5. A comparação mais ampla API da OpenAI vs API da Anthropic cobre as duas plataformas.
Os benchmarks: o Opus 5.5 vence quase todas as linhas
A Artificial Analysis rodou os dois em esforço máximo no mesmo ambiente de testes. Este é o confronto direto mais limpo disponível no momento.
| Benchmark (Artificial Analysis, esforço máximo) | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index | 48 | 58 |
| GDPval-AA v2.1 (Elo, tarefas de trabalho reais) | 1487 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1483 | 1822 |
| AutomationBench-AA | 62% | 70% |
| Terminal-Bench 4.0 | 44% | 60% |
| SciCode | 58% | 67% |
| Humanity's Last Exam | 48% | 61% |
| AA-LCR (raciocínio de contexto longo) | 84% | 85% |
| CritPt | 31% | 32% |
| AA-Omniscience Index | 27 | 46 |
| Taxa de alucinação (menor é melhor) | 60% | 58,6% |
As grandes diferenças estão no trabalho que mais se parece com um emprego real: GDPval-AA por 359 pontos Elo, Terminal-Bench por 16 pontos e o Intelligence Index por 10. As diferenças pequenas também revelam muito. Raciocínio de contexto longo e CritPt estão a um ponto, e as taxas de alucinação são quase idênticas. A grande melhoria de veracidade do Sol em relação ao GPT-5.6 o deixou no mesmo nível do Opus em taxa de alucinação, embora o Opus ainda saiba mais, com 46 contra 27 no Omniscience Index.
Algumas ressalvas honestas sobre os números. A Anthropic informa o Opus 5.5 com 66,4% no Terminal-Bench 4.0 com a configuração própria em xhigh, mais que os 60% medidos pela Artificial Analysis; para comparar com o Sol, o par independente é mais justo. Os números de OSWorld 2.0 dos dois fornecedores (60,5% para o Sol, 81,8% para o Opus) usam conjuntos de teste diferentes, então eu não leria uma diferença neles. E ainda não há pontuação do Opus 5.5 no DeepSWE, onde o Sol marca 68,8% e 69,0% dentro do Codex no Coding Agent Index.
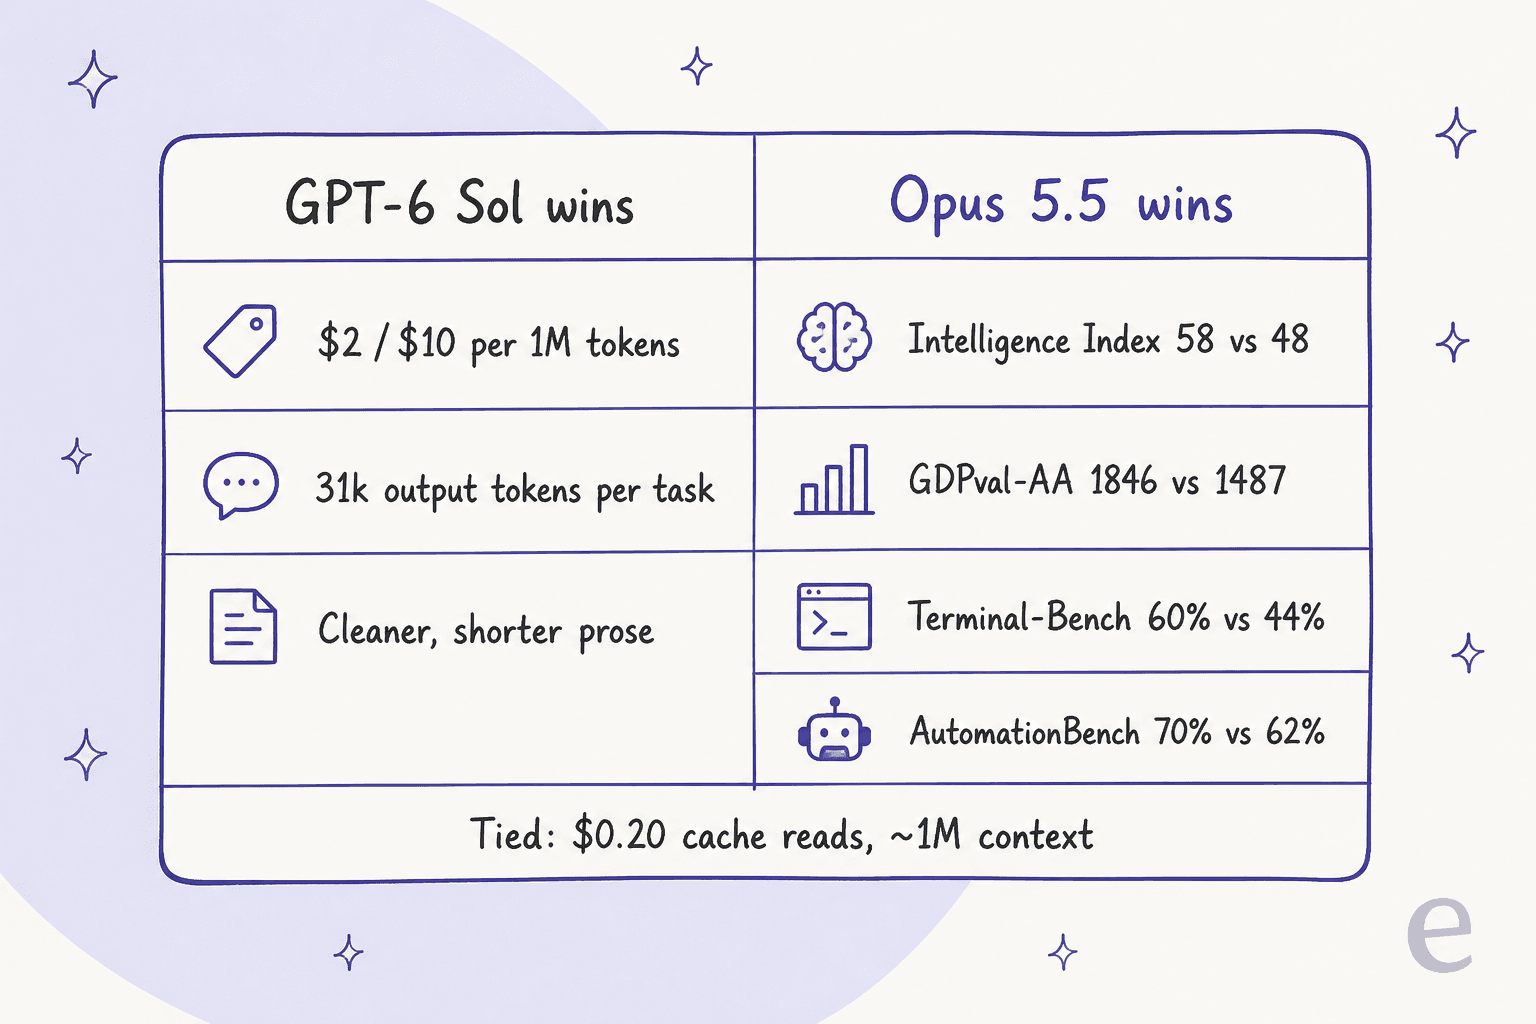
O padrão desse placar é a história toda em uma imagem: o Opus 5.5 vence as linhas de capacidade, o Sol vence as de custo. Qual pesa mais depende do quanto um erro custa a você.
O que a maioria das comparações deixa passar: custo por tarefa, não por token
O preço por token é o número da página de preços. O custo por tarefa concluída é o número da sua fatura. Eles podem ser muito diferentes, porque os modelos gastam quantidades muito diferentes de tokens para chegar a uma resposta.
No índice da Artificial Analysis, em esforço máximo:
| Por tarefa, esforço máximo | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tokens de saída por tarefa | ~31k | ~119k |
| Custo por tarefa | US$ 1,06 | US$ 5,98 |
| Custo total para rodar o índice completo | US$ 1.550 | US$ 8.708 |
Então a diferença de 2x no preço de tabela vira uma diferença de 5,6x por tarefa em max. É uma surpresa, já que o argumento do Opus 5.5 é a eficiência. A alegação de eficiência é real em relação ao Opus 5 no mesmo esforço, mas em esforço máximo o Opus 5.5 pensa muito. A Artificial Analysis mediu que ele usa mais tokens de saída por tarefa que o Opus 5, o Fable 5.1 ou o GPT-6 Astra:
"Opus 5.5 (max) uses ~119k output tokens per Intelligence Index task, against ~73k for Opus 5 (max), ~78k for Fable 5.1 (max) and ~27k for GPT-6 Astra (max)"
É aqui que a história vira de novo. Os rótulos de esforço não significam a mesma coisa entre fornecedores, então comparar "max contra max" não é realmente justo. Alinhe-os por custo, usando os números por nível de esforço nas páginas de lançamento da Artificial Analysis para cada modelo:
| Esforço | GPT-6 Sol pontuação / custo por tarefa | Opus 5.5 pontuação / custo por tarefa |
|---|---|---|
| low | 34 / US$ 0,13 | 42 / US$ 0,55 |
| medium | 40 / US$ 0,25 | 51 / US$ 1,34 |
| high | 43 / US$ 0,37 | 54 / US$ 1,82 |
| xhigh | 44 / US$ 0,53 | 56 / US$ 3,46 |
| max | 48 / US$ 1,06 | 58 / US$ 5,98 |
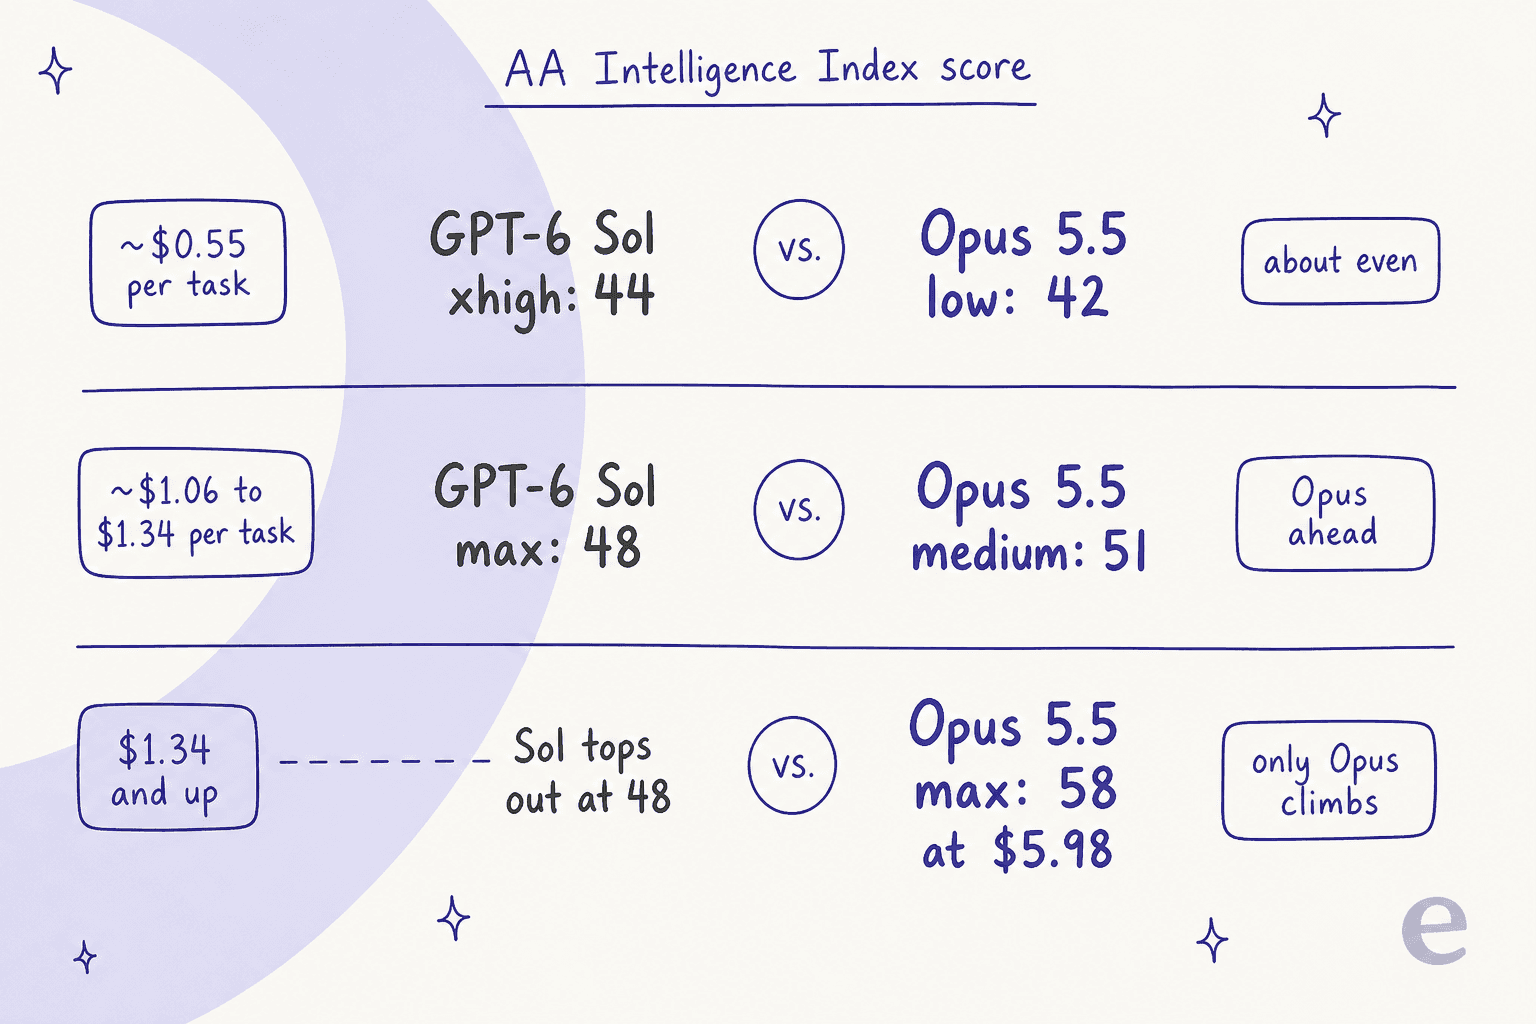
Leia a tabela assim:
- Abaixo de cerca de US$ 0,55 por tarefa, estão empatados. O Sol em xhigh (44) e o Opus em low (42) custam quase o mesmo. Abaixo disso, só o Sol fica mais barato: 40 pontos por um quarto de dólar.
- Por volta de um dólar por tarefa, o Opus passa na frente. O Opus 5.5 em medium marca 51 por US$ 1,34, três pontos acima do melhor esforço do Sol por cerca de 26% a mais de dinheiro.
- Acima disso, só o Opus continua subindo. O teto do Sol é 48. Se você precisa de mais, o Opus é o único dos dois que tem, até 58.
Isso bate com o que os primeiros usuários disseram. Um comentarista do HN:
"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."
Uma resposta contestou que o par mais justo é Opus medium contra Sol high. Nesse par, o Sol custa US$ 0,37 por tarefa contra US$ 1,34 do Opus, então a questão passa a ser se 8 pontos a mais valem uma conta 3,6 vezes maior. Para trabalho em massa, geralmente não. Para uma execução agêntica difícil em que uma tentativa falha significa refazer, muitas vezes sim.
Quer ver o que isso significa para o seu próprio volume? Coloque seus números. Os custos vêm dos resultados por tarefa da Artificial Analysis, então trate-os como um guia relativo: suas tarefas serão mais curtas ou mais longas que as deles.
Como eles são no dia a dia
Os benchmarks mostram o teto. O uso diário mostra como é a experiência padrão, e aqui os primeiros relatos se dividem por uma linha clara.
A leitura prática mais útil até agora é a de Dan Shipper, da Every, que testou os dois em trabalho real. Em programação, ele deu vantagem ao Opus:
"Sol improves on GPT-5.6—including better Ruby code in @kieranklaassen tests—but Opus 5.5 has the higher ceiling for long, autonomous builds."
No mesmo post, ele achou a escrita do Sol mais limpa, colocando a ideia importante primeiro, enquanto os rascunhos do Opus 5.5 ainda tendem a enterrar o ponto principal. O veredito dele se dividiu por tipo de trabalho: Sol para um dia gasto "reading, writing, and getting things done" no Codex, Opus 5.5 quando você "hand an agent a hard coding or visual project and see how far it can take it."
O comportamento também difere. O Sol tende a fazer mais do que você pediu; o Claude tende a fazer o que você pediu e parar. Um desenvolvedor do HN descreveu o lado da OpenAI de forma vívida:
"OpenAI models are also much more eager than Anthropic, which are on the lazier side. Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app."
A verbosidade é a questão em aberto no Opus 5.5. Alguns usuários dizem que ele finalmente se lê com clareza, outros dizem que é tão prolixo quanto o Opus 5. As contagens de tokens acima sugerem que as duas coisas podem ser verdade: respostas visíveis curtas, pensamento oculto longo em esforço alto. Se esse pensamento é o que você paga, ajuste o controle de esforço de propósito em vez de deixá-lo em max.
Os limites de assinatura também são contestados. No HN, um usuário disse que uma semana de Codex durou de um a dois dias de uso semipesado, com um único agente, no Sol High, enquanto outro disse que o Codex vence em uso "by a mile". Se você vive dentro do Claude Code ou do Codex em vez da API, teste a sua própria semana antes de trocar de plano.
Qual você deve usar?
Assim eu dividiria o trabalho, com base nos números acima.
| Se o seu trabalho é... | Use | Por quê |
|---|---|---|
| Classificação, extração e roteamento em alto volume | GPT-6 Sol em low ou medium | 40 pontos por US$ 0,25 a tarefa, e dá para desligar o raciocínio por completo |
| Redação do dia a dia, resumos, respostas curtas | GPT-6 Sol | Mais barato por tarefa, texto mais limpo segundo os primeiros relatos |
| Execuções longas de programação autônoma, agentes de vários passos | Claude Opus 5.5 em medium | Supera a melhor pontuação do Sol por cerca de 26% a mais por tarefa |
| O raciocínio mais difícil, em que errar sai caro | Claude Opus 5.5 em high ou max | Única opção que passa de 48 |
| Contexto enorme (mais de 272K tokens) | Claude Opus 5.5 | Sem acréscimo para contexto longo, então a diferença de preço praticamente some |
| Prompts grandes e estáveis, muitos acertos de cache | Qualquer um | Leituras de cache custam US$ 0,20 nos dois |
O erro que eu evitaria é escolher um para tudo. Os dois fornecedores agora facilitam o roteamento, e as curvas de custo dizem que a resposta boa mais barata vem do Sol na ponta baixa e do Opus na ponta alta. Se você já está no ecossistema da OpenAI, vale olhar o GPT-6 Luna para a faixa bem barata. Do lado da Anthropic, o Claude Sonnet 5 cumpre o mesmo papel, como mostra minha análise Opus 5 vs Sonnet 5.
Para uma visão mais ampla, a lista de modelos da OpenAI cobre o resto da linha da OpenAI, e meu guia de preços da API da Anthropic faz o mesmo para o Claude.
Se o modelo vai responder aos seus clientes
Muita gente que compara esses dois na verdade faz outra pergunta: qual deles deve alimentar nosso bot de suporte? Aqui, a diferença nos benchmarks importa menos do que se imagina.
Um modelo de fronteira é infraestrutura. Para resolver um ticket, ele também precisa da sua central de ajuda e de tickets anteriores para embasar as respostas, de ações no seu helpdesk (etiquetar, rotear, reembolsar, consultar um pedido), de regras de segurança sobre quando passar para um humano e de uma forma de testar tudo isso antes que clientes reais vejam. Essa última parte é onde a maioria dos bots feitos em casa falha. Na eesel, vi respostas de tom confiante se mostrarem erradas nos testes, e é por isso que a eesel simula cada implantação com tickets históricos antes de ir ao ar.
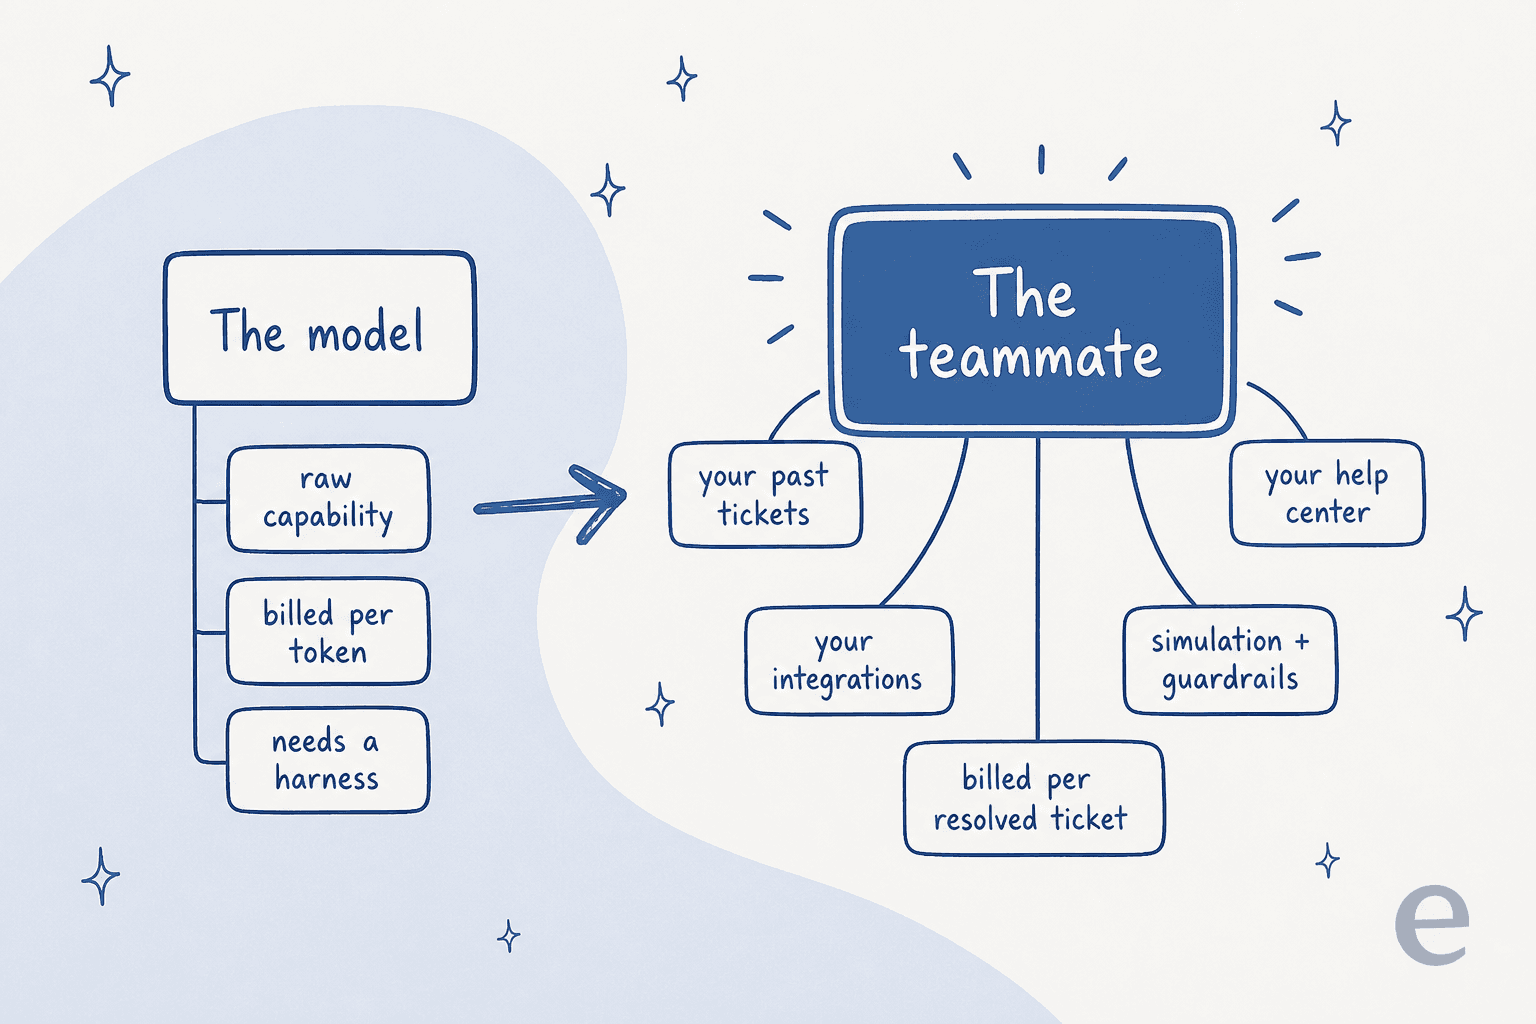
É por isso que penso na eesel como o funcionário e no modelo como o motor. O colega de helpdesk com IA se conecta a ferramentas como Zendesk, Freshdesk e Gorgias, aprende com seus tickets anteriores e cobra por ticket resolvido em vez de por token, então a conta de tokens de Sol contra Opus não é problema seu.
Se você quer comparar opções primeiro, meu levantamento do melhor software de helpdesk com IA é um bom ponto de partida, e esta análise de custo de IA vs humano mostra a conta por ticket.
Para o leitor técnico que chegou a este post por uma comparação de modelos: o mesmo colega também pode ser automatizado por script. A CLI da eesel (npm i -g @eesel/cli) permite conectar integrações, editar as instruções permanentes do agente, ler cada execução com eesel activity e aprovar ou negar ações pendentes pelo terminal. Todo comando imprime JSON e aceita --dry-run, então o Claude Code ou o Codex podem operá-la. Cada workspace também é um servidor MCP, então você pode gerenciar agentes de IA pelo seu terminal com o que você escolher entre esses dois modelos.
Experimente a eesel
Se você está comparando o GPT-6 Sol com o Opus 5.5 porque quer uma IA respondendo tickets de suporte, pode pular o duelo de modelos. O colega de helpdesk com IA da eesel entra no seu helpdesk atual, aprende com seus tickets anteriores e sua central de ajuda e é testado no seu histórico real de tickets antes de responder a um único cliente. Você paga por ticket resolvido, não por token.

Experimente a eesel grátis e veja-a rodar nos seus próprios tickets.