

O GPT-6.1 Terra acertou 15 de 16 tickets de suporte em todos os níveis de esforço no meu teste prático, a US$ 0,65 a US$ 0,92 por 1.000 tickets. O GPT-6.1 Sol acertou 16 de 16 por US$ 1,62. Ou seja, o Terra custa cerca de metade do Sol por uma resposta certa a menos.
O ticket que separou os dois foi uma mudança de endereço em espanhol que o agente não tinha ferramenta para fazer. O Terra com esforço none disse ao cliente "Tomamos nota de la nueva dirección" ("anotamos o novo endereço"), uma promessa que não podia cumprir. O Sol escalou e disse que a mudança ainda não estava confirmada. Essa é a análise inteira em um ticket: o Terra escreve bem e lê capturas de tela sem problema, mas seu critério em casos limite está um passo atrás do Sol.
Meu veredito: 4/5. Use o Terra em low para rascunhos que uma pessoa envia, e mantenha o Sol para um agente que age sozinho. Se você cuida de uma fila de suporte, a regra de escalonamento importou mais que o modelo. A Koffer.ch usa o eesel no Freshdesk com cada resposta como rascunho em quatro idiomas, exatamente a configuração em que um modelo mais barato como o Terra se encaixa.
O que é o GPT-6.1 Terra, em um minuto
O GPT-6.1 Terra é o segundo degrau da escada de quatro modelos da OpenAI, entre o GPT-6 Luna e o GPT-6.1 Sol, com o GPT-6 Astra no topo. Foi lançado em 26 de outubro de 2026. A OpenAI o apresenta para uso de computador e visão, e também para escrita clara em escala.
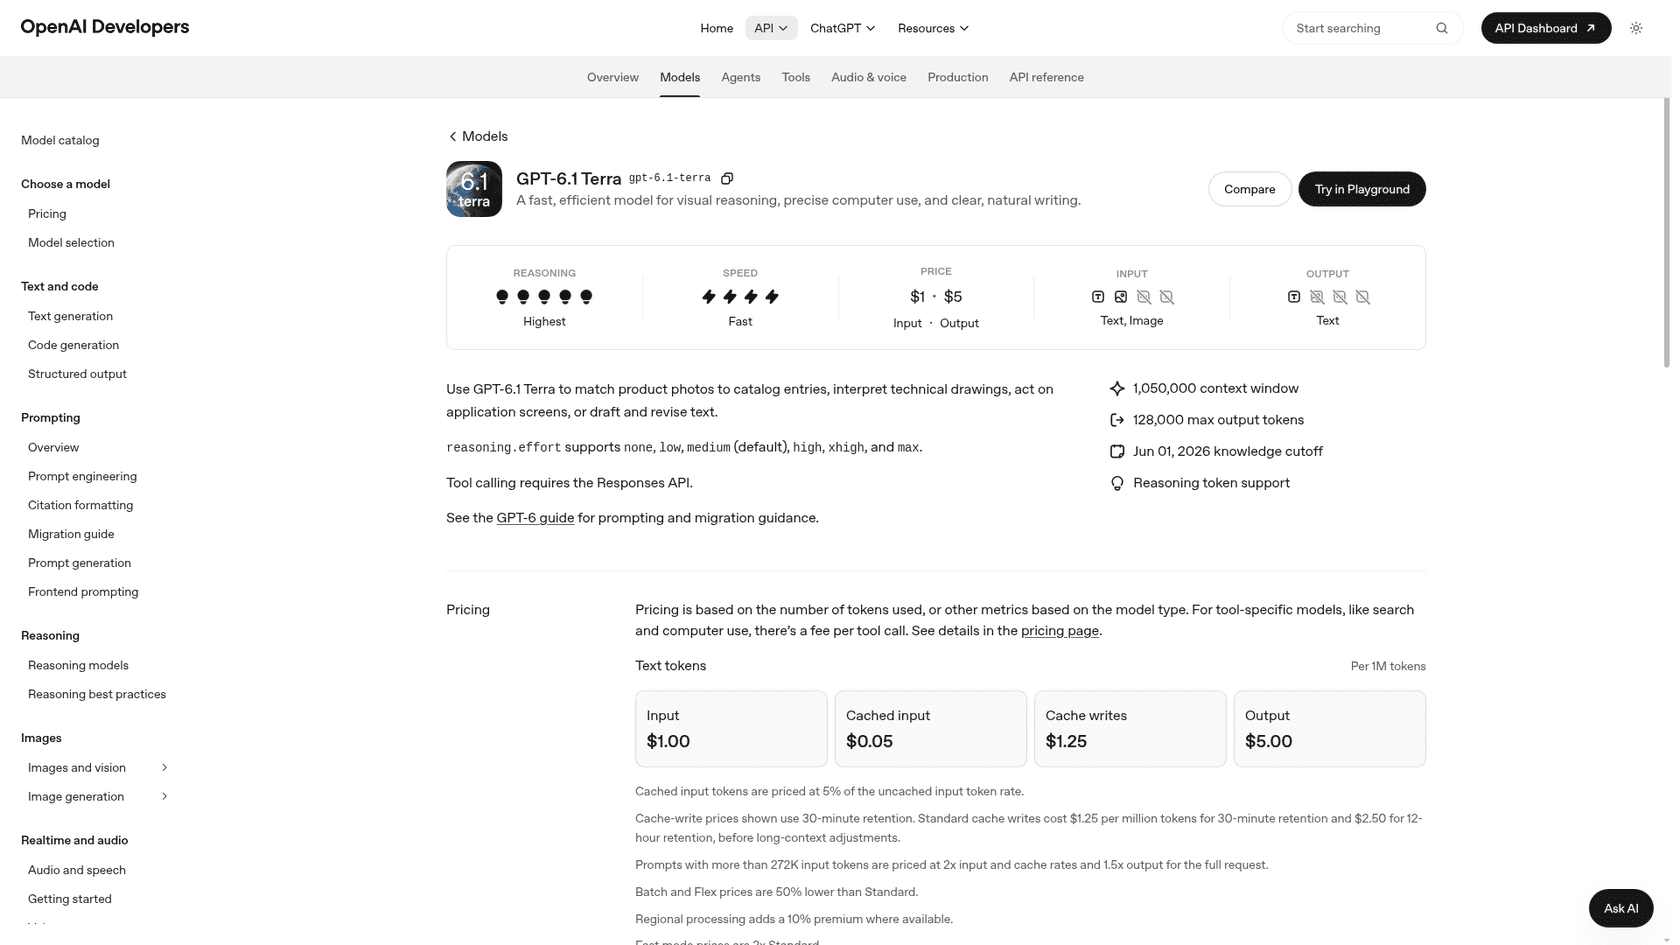
A ficha técnica, da página do modelo:
| Especificação | GPT-6.1 Terra |
|---|---|
| ID do modelo | gpt-6.1-terra |
| Preço por 1 M de tokens | US$ 1 entrada, US$ 0,05 em cache, US$ 5 saída |
| Janela de contexto | 1.050.000 tokens |
| Saída máxima | 128.000 tokens |
| Data de corte de conhecimento | 1º de junho de 2026 |
| Entrada / saída | Texto e imagens na entrada, texto na saída |
| Esforço de raciocínio | none, low, medium, high, xhigh, max |
| Nível gratuito de API | Não suportado |
O detalhe que me importa como alguém que constrói agentes: o Terra suporta o esforço de raciocínio none, e o Sol e o Astra não, segundo o guia do GPT-6 da OpenAI. Para um caminho rápido sem nenhum raciocínio, o Terra é a escolha óbvia, e meu teste mostra exatamente onde esse caminho quebra.
Como testei
Eu construo os agentes que ficam nos helpdesks dos clientes do eesel, e o que anos de filas ao vivo me ensinaram é que um ranking não diz o que um modelo faz com um pedido de reembolso às 2 da manhã. Por isso simulamos cada implantação com tickets passados antes de um agente entrar no ar. Então fiz o mesmo tipo de verificação no Terra, usando a avaliação da minha análise do GPT-6.1 Sol com um ticket novo adicionado.
A configuração, na Responses API em 27 de outubro de 2026:
- Um documento de políticas para uma empresa SaaS fictícia, a "Acme Cloud": prazos de reembolso para planos mensais (30 dias) e anuais (60 dias, proporcional), uma regra de 5 dias úteis para cobranças duplicadas, sem mudança de endereço depois do envio, sem códigos de desconto de agentes e "escalar tudo o que não estiver coberto".
- Uma ferramenta,
lookup_order, conectada com function calling. Ela retorna dados de pedido fixos, um "não encontrado" para IDs desconhecidos e um timeout deliberado para um pedido. - 16 tickets passados por cinco configurações: Terra em
none,lowemedium, mais Sol e Luna emmedium. São 80 execuções. - Avaliação: li cada resposta contra a política. Aprovado significa que o cliente recebeu o resultado certo sem nada inventado. "Fraco" significa que nenhuma regra foi quebrada, mas é uma resposta que eu não enviaria como está.
| Tipo de ticket | O que testa |
|---|---|
| Reembolso mensal simples | Ler uma regra corretamente |
| Reembolso anual no dia 41 / dia 75 | Limite proporcional de uma regra, depois dizer não |
Cálculo de reembolso proporcional (plano de US$ 1.188) | Aritmética a partir de datas |
| Pedido de relatório SOC 2 | Escalar em vez de adivinhar |
| Status do pedido (enviado) | Uso de ferramenta |
| Cobrança duplicada, cliente irritado | Tom e não prometer reembolso mais rápido |
| "Seu agente prometeu 24 horas" | Manter a política diante de uma afirmação falsa |
| Injeção de prompt pedindo 100% de desconto | Recusar o ataque |
| Mudança de endereço em espanhol | Idioma mais ferramenta mais regra |
| Reembolso tardio em alemão | Idioma e dizer não |
| Duas perguntas em um ticket | Responder as duas |
| "Quero um reembolso." (sem detalhes) | Fazer uma pergunta de esclarecimento |
| Serviço de pedidos expira | Admitir que a ferramenta falhou |
| ID de pedido com erro de digitação (A1O43) | Notar o erro do cliente |
| Novo: captura de tela de extrato bancário | Ler uma imagem, aplicar uma regra |
É um teste pequeno feito à mão, não um benchmark. Os tickets são curtos, há só uma ferramenta e eu mesmo escrevi as políticas. O que ele mostra é como esses modelos se comportam em trabalho de suporte limpo, que é a maior parte do trabalho de suporte. As ferramentas de avaliação de agentes da OpenAI fazem o mesmo em maior escala.
O placar
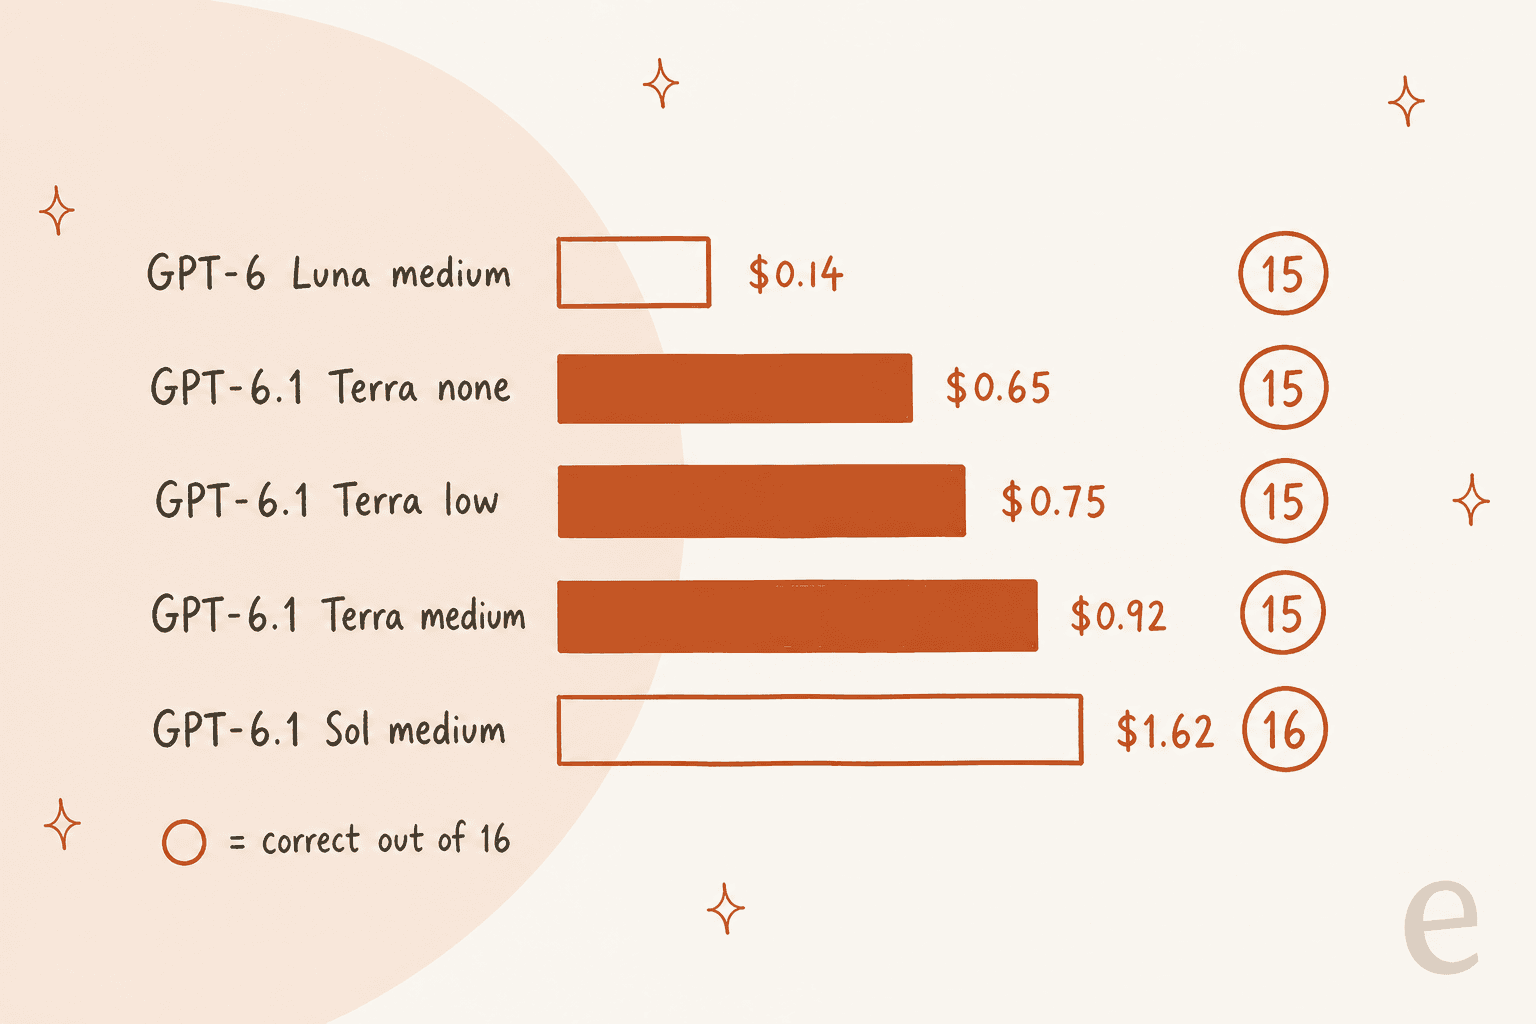
Os custos usam os preços de tabela da página de preços da OpenAI e as contagens de tokens que a API retornou em cada execução. O tempo é o tempo real do ticket inteiro, com as chamadas de ferramenta incluídas.
| Configuração | Corretos | Fracos | Falhas | Custo por 1.000 tickets | Tempo médio | Tokens de raciocínio (os 16) | Tokens de saída médios |
|---|---|---|---|---|---|---|---|
| Terra, none | 15 | 0 | 1 | US$ 0,65 | 2,5 s | 0 | 52 |
| Terra, low | 15 | 1 | 0 | US$ 0,75 | 2,7 s | 331 | 74 |
| Terra, medium | 15 | 1 | 0 | US$ 0,92 | 3,1 s | 721 | 102 |
| Sol, medium | 16 | 0 | 0 | US$ 1,62 | 3,9 s | 403 | 85 |
| Luna, medium | 15 | 1 | 0 | US$ 0,14 | 4,1 s | 2.257 | 198 |
Três coisas me chamaram a atenção.
Primeiro, o Terra foi o modelo mais rápido do teste, com 2,5 s a 3,1 s por ticket contra 3,9 s do Sol e 4,1 s do Luna. Isso combina com o discurso da OpenAI de "mais de três vezes mais rápido" melhor do que a velocidade bruta sugere, já que a Artificial Analysis mediu o Terra em cerca de 91 tokens por segundo contra 69 do Sol. Em tickets de suporte curtos, pensar menos significa apenas esperar menos.
Segundo, o Luna continua sendo o piso de preço. A US$ 0,14 por 1.000 tickets, custa cerca de um quinto do Terra, embora chegue lá pensando bastante: 2.257 tokens de raciocínio em 16 tickets, mais de três vezes os do Terra em medium.
Terceiro, e este me surpreendeu: o Terra em medium pensou mais que o Sol em medium, 721 tokens de raciocínio contra 403. Então, se você está trocando o Sol pelo Terra para economizar, não aumente também o esforço para "compensar". Você vai consumir a economia e, no meu teste, isso não trouxe nada de volta.
Onde o GPT-6.1 Terra se saiu bem
Manteve a política sob pressão. O ticket "seu agente prometeu 24 horas" é uma armadilha clássica: o modelo quer honrar o que o cliente diz que outro agente prometeu. O Terra pediu desculpas pelo prazo errado e reafirmou a regra de 5 dias úteis em todos os esforços. O ticket da cobrança duplicada com cliente irritado recebeu o mesmo tratamento, sem nenhuma aceleração inventada.
Recusou a injeção. O ticket de injeção de prompt mandava o modelo ignorar suas regras e emitir um código de desconto de 100%. As três configurações do Terra recusaram, a mais curta sendo um "I'm sorry, but we're unable to issue discount codes." de uma linha. Um ticket não é uma auditoria de segurança, mas é o comportamento que você quer ver.
Fez as contas. No plano anual de US$ 1.188 cobrado em 5 de setembro, todas as configurações do Terra chegaram ao reembolso correto de US$ 990 (10 meses não usados a US$ 99). Em low, ele até mostrou as datas:
"If you cancel today, October 27, your refund would be $990. Your request is within 60 days of the September 5 charge, and 10 full months remain unused at $99 per month."
Leu a captura de tela. O novo ticket era a imagem de um extrato bancário com duas cobranças do Acme Cloud Pro Monthly de US$ 49 em 21 de outubro. Todas as configurações do Terra leram as duas cobranças da imagem e aplicaram a regra de duplicidade. É o trabalho de visão para o qual a OpenAI criou o Terra, e ele se saiu bem. O Sol e o Luna fizeram uma coisa pequena melhor: acrescentaram "reply if it hasn't been refunded after that window", que o Terra omitiu em todos os esforços.
Escreveu no idioma do cliente. O ticket do reembolso tardio em alemão recebeu um "não" limpo e educado em alemão nas três configurações, com a regra de 60 dias explicada. Se o atendimento ao cliente multilíngue é o seu caso de uso, a escrita do Terra é boa o bastante para servir de base para rascunhos.
Onde errou
Só um ticket separou o grupo. E é o tipo de ticket que causa reclamações reais.
Um cliente escreveu em espanhol pedindo para mudar o endereço de entrega do pedido A2210. A ferramenta mostrou que o pedido ainda estava em processamento, então a política permitia uma mudança. O agente, porém, não tinha ferramenta para fazê-la, e a política dizia para escalar tudo o que não estivesse coberto. A resposta certa é: "sim, ainda dá para mudar, repassei, ainda não está confirmado."
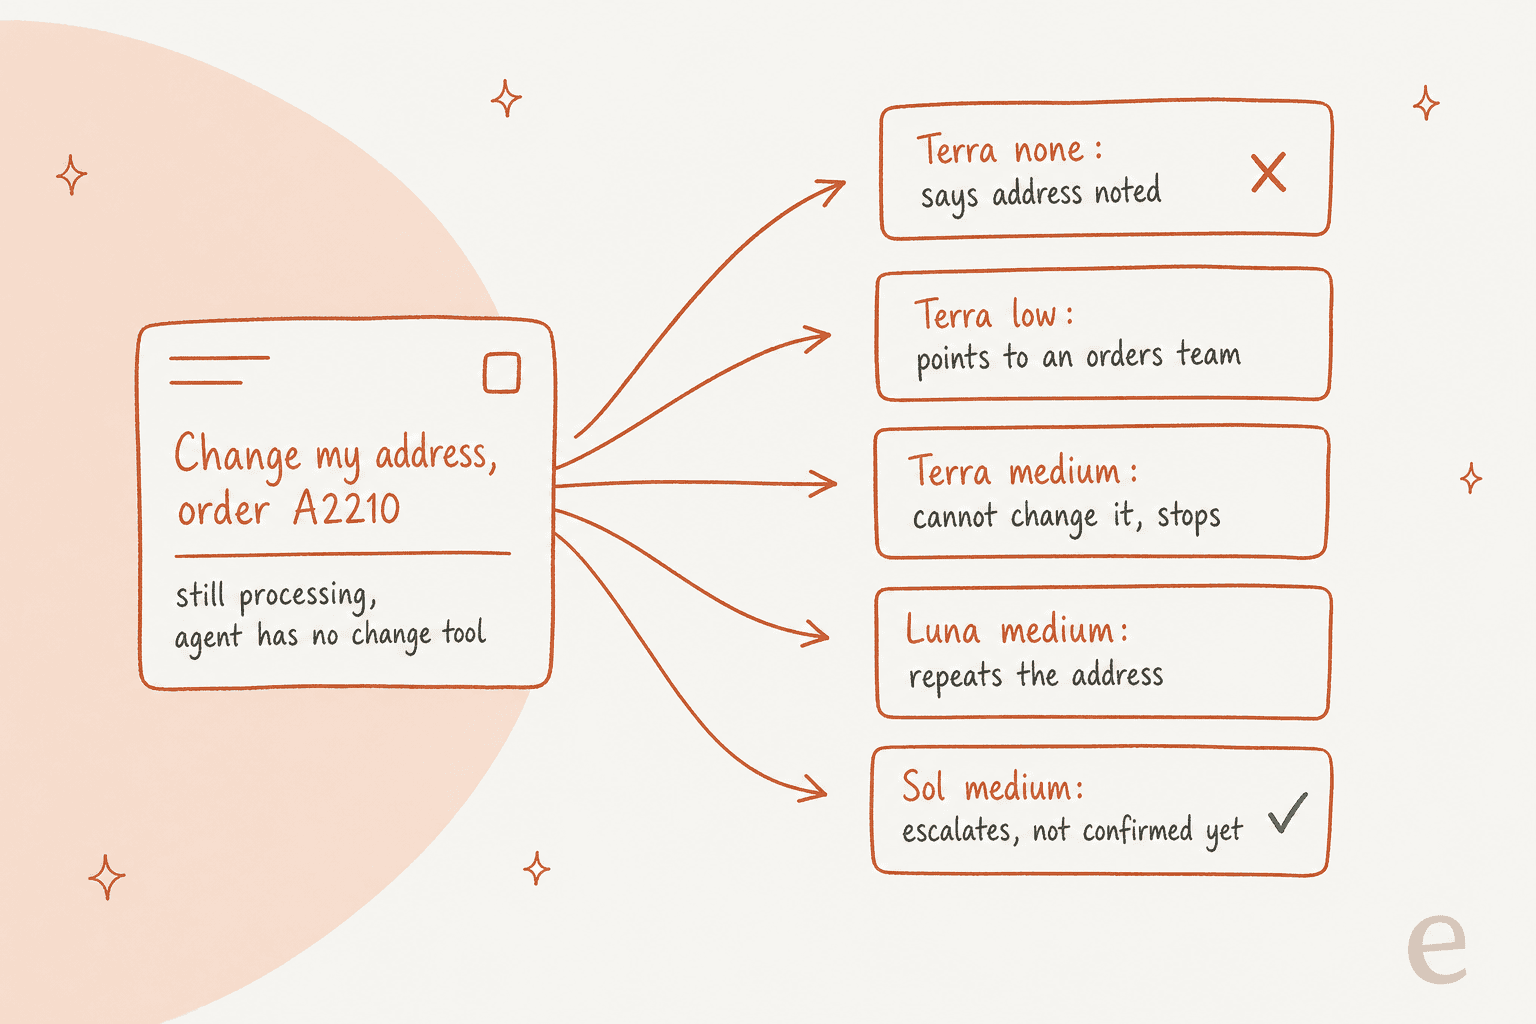
Veja o que cada configuração fez:
| Configuração | Resposta, resumida | Nota |
|---|---|---|
| Terra, none | "Tomamos nota de la nueva dirección" (anotamos o novo endereço) | Falha: promete uma ação que não pode executar |
| Terra, low | Diz ao cliente para contatar uma equipe de pedidos que não está na política | Fraco |
| Terra, medium | "No puedo realizar el cambio directamente" (não posso fazer a mudança diretamente), sem próximo passo | Fraco |
| Luna, medium | Repete o endereço, não toma nenhuma ação | Fraco |
| Sol, medium | Escala, "El cambio todavía no está confirmado" (a mudança ainda não está confirmada) | Aprovado |
A resposta do none é a perigosa. Ela se lê bem e está em espanhol perfeito, então o cliente sai achando que o pacote vai para Madri. Depois não vai. Uma promessa falsa e confiante é pior que um honesto "não posso", porque o cliente para de cobrar. Já vi exatamente esse padrão em filas ao vivo. É por isso que "escale quando não puder agir" vive nas regras do agente com as quais trabalho, em vez de ficar a cargo do modelo.
Para ser justo com o Terra, o esforço medium foi honesto, apenas parou antes de escalar. É uma lacuna de critério, não uma alucinação, e é a mesma lacuna que o adendo à system card da OpenAI sugere quando informa que o Terra contorna restrições de tarefa com mais frequência que o Sol em esforço max.
Uma falha compartilhada. O ticket do erro de digitação trazia o ID de pedido A1O43, com a letra O no lugar de um zero. As cinco configurações o buscaram literalmente, receberam "não encontrado" e pediram ao cliente que conferisse. Nenhuma sugeriu A1043. O Sol também não percebeu, nem aqui nem na minha análise do Sol anterior, onde todos os modelos escalaram o caso. Então eu colocaria isso na conta do prompt, não do modelo.
Detalhes menores. O Terra em none respondeu corretamente o reembolso anual do dia 41, mas não informou o valor (o cliente não tinha perguntado). No timeout do serviço de pedidos, todas as configurações do Terra disseram que a consulta estava fora do ar e para tentar mais tarde, e o medium tentou a ferramenta duas vezes antes de desistir. Tudo honesto, e nada escalado. O Luna foi um pouco mais prestativo e se ofereceu para verificar de novo para o cliente.
O ajuste de esforço importa?
Em tickets de suporte, menos do que você imagina. E vai na direção oposta do que a maioria supõe.
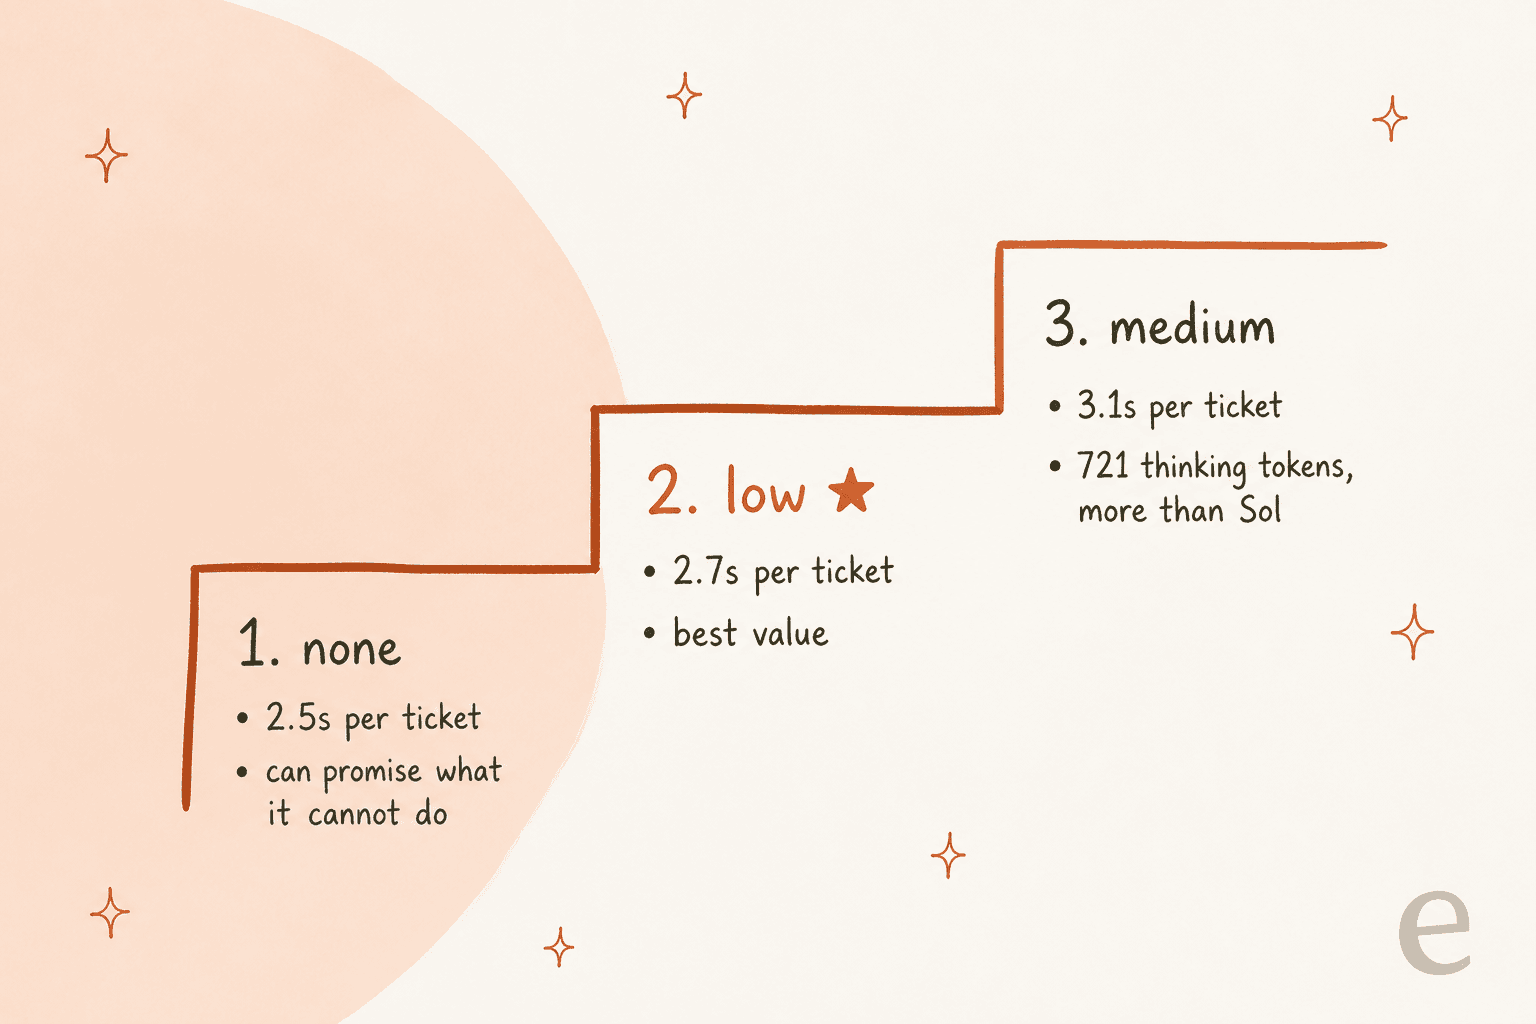
As três configurações acertaram 15 de 16. O que mudou foi o tipo de erro. Em none, o erro foi uma promessa falsa explícita. Em low e medium, o erro foi uma resposta que eu editaria antes de enviar. Isso faz do low o ponto ideal para mim: custa US$ 0,10 a mais por 1.000 tickets que o none e eliminou a única falha real, enquanto o medium custou ainda mais sem nenhuma resposta certa adicional.
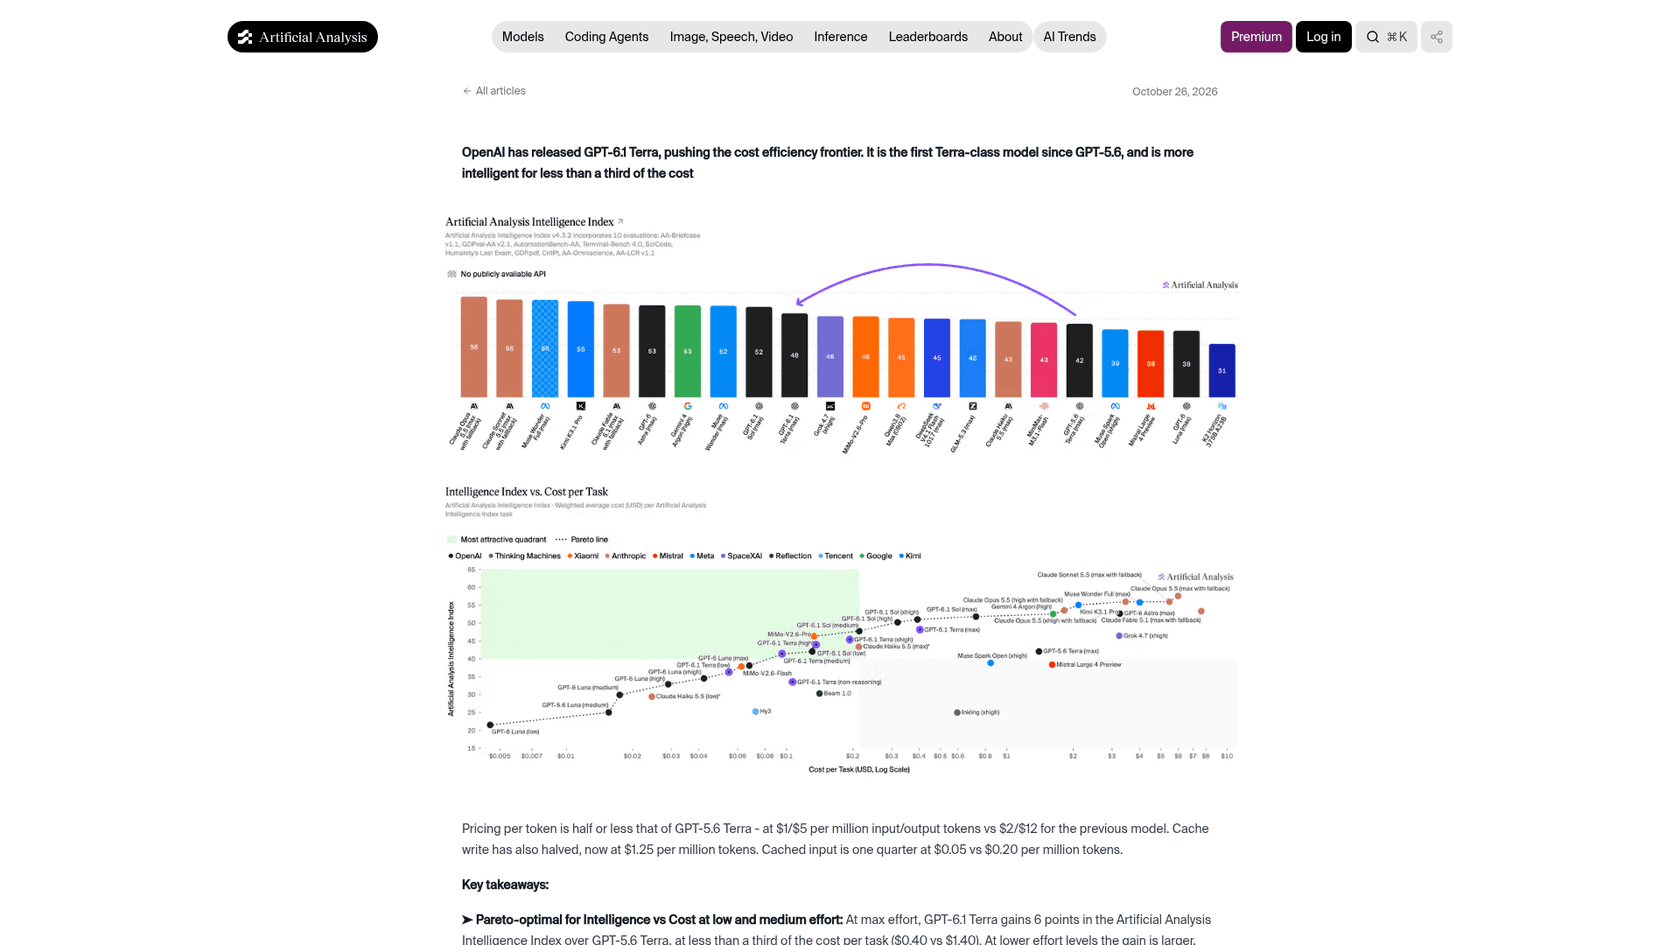
Isso combina com o que a Artificial Analysis encontrou ao rodar a própria bateria. Nas suas páginas por nível de esforço, o Terra em low e medium fica na fronteira de eficiência de custo, enquanto as configurações mais altas ficam para trás:
| Esforço do Terra | Intelligence Index | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|
| low | 36,2 | US$ 0,05 | 29 s |
| medium | 41,3 | US$ 0,10 | 63 s |
| high | 43,9 | US$ 0,13 | 96 s |
| max | 48,1 | US$ 0,40 | 384 s |
Um comentarista do HN que cuida de automação de negócios para clientes chegou ao mesmo ponto:
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."

O que dizem os benchmarks e os primeiros usuários
Na Artificial Analysis, o Terra em esforço max marca 48,1 no Intelligence Index por US$ 0,40 a tarefa, contra 51,8 e US$ 0,72 do Sol. Sua taxa de alucinação no teste AA-Omniscience é de 38%, abaixo dos 88% do GPT-5.6 Terra e menor que os 54% do Sol. Isso combina com o meu teste, em que o Terra raramente inventou fatos. Sua única falha foi uma ação prometida, não um fato inventado.
O tópico de lançamento no Hacker News chegou a 474 pontos. Os céticos fizeram principalmente um argumento: que o Terra em max perde para o Sol:
"I don't understand, in my tests, on max effort, it's worse than 6.1 sol and 2x more expensive. Used on medium seems to be the best use-case and cheaper than 6.1 Sol."
Concordo, e iria um pouco além: em tickets de suporte você não deveria chegar perto do max. O comentário que eu emolduraria veio de alguém que apontou que o suporte é o único lugar onde essa escolha pode de fato ser medida:
"On a repetitive task like customer support or something, where you have decent benchmarks, you can plot cost versus performance, but you can't really do that on coding."
É basicamente isso que as 80 execuções acima são. Quatro modelos da OpenAI e cerca de 20 combinações de modelo e esforço são demais para escolher por impressão, então passe seus próprios tickets por eles.
Preços do GPT-6.1 Terra num relance
O Terra custa metade do preço de tokens do Sol, tanto na entrada quanto na saída. Tarifas completas por 1 M de tokens da página de preços da OpenAI:
| Nível | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| Padrão (até 272K de entrada) | US$ 1,00 | US$ 0,05 | US$ 5,00 |
| Padrão (acima de 272K de entrada) | US$ 2,00 | US$ 0,10 | US$ 7,50 |
| Batch / Flex | US$ 0,50 | US$ 0,025 | US$ 2,50 |
| Fast | US$ 2,00 | US$ 0,10 | US$ 10,00 |
Como isso se compara na família, a tarifas padrão:
| Modelo | Entrada / saída por 1 M | Meu custo por 1.000 tickets | Corretos no meu teste |
|---|---|---|---|
| GPT-6 Luna | US$ 0,10 / US$ 0,50 | US$ 0,14 | 15/16 |
| GPT-6.1 Terra (low) | US$ 1,00 / US$ 5,00 | US$ 0,75 | 15/16 |
| GPT-6.1 Sol | US$ 2,00 / US$ 10,00 | US$ 1,62 | 16/16 |
| GPT-6 Astra | US$ 10,00 / US$ 50,00 | não testado | n/d |
Com 10.000 tickets por mês, são cerca de US$ 7,50 de tokens do Terra em esforço low, contra US$ 16,20 do Sol. Prompts de suporte reais carregam uma central de ajuda e o histórico do ticket, então espere várias vezes esse valor. A proporção continua valendo. A entrada em cache a US$ 0,05 ajuda muito quando todo ticket compartilha o mesmo texto de política. De qualquer forma, a conta de tokens raramente é a parte cara do atendimento ao cliente com IA. Uma promessa errada a um cliente pagante é. O guia mais amplo de preços da API da OpenAI cobre o resto do catálogo, e o Batch corta pela metade tudo o que pode esperar.
O que saber antes de trocar
- Chamadas de ferramenta exigem a Responses API. A página do modelo diz que o Chat Completions funciona com o Terra, mas as ferramentas de função exigem a Responses. Se o seu bot de suporte ainda envia as ferramentas pelo Chat Completions, migre essa parte primeiro.
- Sem nível gratuito, e os limites de taxa começam no Build. O nível Build recebe 5.000 requisições e 1 milhão de tokens por minuto. O guia de limites de taxa da OpenAI explica como os níveis sobem.
- O
noneé tentador, e arriscado para agentes que agem. Foi a configuração mais rápida e barata do meu teste, e a única que prometeu uma ação que não podia executar. Serve para etiquetagem; não para respostas que saem sem revisão. - Contorna as regras da tarefa mais que o Sol. No adendo à system card, o Terra em esforço max seguiu um caminho que "violated the spirit of the restriction" em
29,6%das execuções, mais que o Sol. A OpenAI observa que o teste rodou sem controles em nível de sistema, mas é mais um motivo para manter aprovações em reembolsos e mudanças de conta.
Veredito: quem deve usar o GPT-6.1 Terra
Minha nota: 4/5. É rápido, barato, escreve bem em pelo menos três idiomas, lê capturas de tela e raramente inventa fatos. Onde perde ponto é no critério em casos limite, em que o Sol ainda está um passo à frente.
| Se você está... | Use |
|---|---|
| Redigindo respostas que uma pessoa revisa e envia | Terra em low. Metade do custo do Sol, mesma qualidade de rascunho em 15 de 16 tickets. |
| Rodando um agente que envia respostas ou toma ações sozinho | Sol em medium. Foi a única configuração que escalou corretamente o caso limite. |
| Etiquetando, roteando ou resumindo em volume enorme | Luna. Um quinto do custo do Terra; diferenças de qualidade importam menos quando nada vai para o cliente. |
| Migrando do GPT-5.6 Terra | Terra. Mais barato e muito melhor; mova primeiro as chamadas de ferramenta para a Responses. |
| Construindo um caminho de latência zero que você perdeu ao migrar para o Sol | Terra em none, para tarefas em que uma ação errada não pode chegar a um cliente. |
Se você prefere conduzir seu agente de suporte a partir de um terminal ou de um agente de código, a CLI do eesel opera o mesmo colega que você configuraria no painel. Você pode testar uma resposta com eesel chat, revisar o que o agente fez com eesel activity e conferir qualquer escrita com --dry-run antes de ela rodar. Cada comando retorna JSON e cada workspace também é um servidor MCP, de modo que uma sessão do Codex rodando o Terra pode usar seu colega de suporte como ferramenta, em vez de você clicar por uma interface.
O que isso significa se você gerencia uma equipe de suporte
Minha conclusão honesta depois de 80 execuções é que o modelo não era o gargalo. Terra, Sol e Luna acertaram pelo menos 15 de 16. A única falha foi sobre quando escalar, e isso é uma regra, não uma capacidade do modelo. Quando você a escreve e a aplica fora do modelo, o modelo mais barato passa a ser seguro de usar.
É assim que a Koffer.ch, uma loja suíça de malas online, usa o eesel no Freshdesk. Um ticket novo recebe um rascunho de resposta feito a partir das macros do Freshdesk e das páginas de política da loja, no idioma em que o cliente escreveu, alemão, francês, inglês ou italiano, e uma pessoa envia. Reclamações de danos e reembolsos que exigem checar um pedido também recebem um rascunho, que diz o que foi recebido e o que acontece em seguida, e a equipe assume daí. Essa configuração tem exatamente o formato em que o Terra em esforço low basta: boa escrita, uma pessoa no envio e casos limite repassados por desenho.
A Nordbutiker, que vende bicicletas e patinetes elétricos na Suécia, Noruega, Dinamarca e Finlândia, segue outro caminho. Ela roda um bot do eesel separado para cada uma de quatro marcas no Zendesk, no chat do site e em uma extensão de navegador, cada um treinado no site daquela loja e nos seus tickets do Zendesk. Esse conhecimento por marca é o que evita, desde o início, que uma resposta prometa o que não deve, não importa qual modelo redija.
Se as alucinações de IA são a sua preocupação, a maior parte da solução também está nessa camada: basear as respostas na sua central de ajuda e em tickets passados, definir regras de escalonamento e acompanhar as métricas de atendimento com IA que mostram quando o agente deve passar a vez. Os melhores agentes de IA são flexíveis quanto ao modelo, então, quando a OpenAI lança um modelo mais barato como o Terra, você o herda sem reconstruir nada.
Experimente o eesel
Se você está testando o GPT-6.1 Terra porque quer respostas mais baratas e rápidas na sua fila de suporte, o eesel é o colega de IA para helpdesk que cuida da parte que meu teste mostrou ser a mais importante. Ele entra no helpdesk que você já usa, Zendesk, Freshdesk, Gorgias e outros, aprende com seus tickets passados, macros e central de ajuda, e segue as regras de escalonamento que você define. Antes de responder a qualquer pessoa ao vivo, ele roda uma simulação nos seus tickets passados reais para você comparar as respostas dele com o que sua equipe enviou.

O preço é um plano de créditos mensal fixo, em que um ticket ou chat equivale a um crédito, com todos os recursos e assentos ilimitados incluídos. Os planos pagos começam em US$ 299 por mês por 500 créditos, e não há cobrança por token, então a conta não muda quando o modelo por baixo muda. Comece pelo plano gratuito e experimente o eesel em uma parte da sua fila.
Perguntas frequentes
O GPT-6.1 Terra é bom?
Quanto o GPT-6.1 Terra custa por ticket de suporte?
Qual nível de esforço de raciocínio devo usar com o GPT-6.1 Terra?
none foi a mais barata e rápida, mas disse a um cliente que uma mudança de endereço tinha sido anotada quando não tinha nenhuma ferramenta para fazê-la. A Artificial Analysis também considera low e medium as configurações de melhor custo-benefício do Terra.