

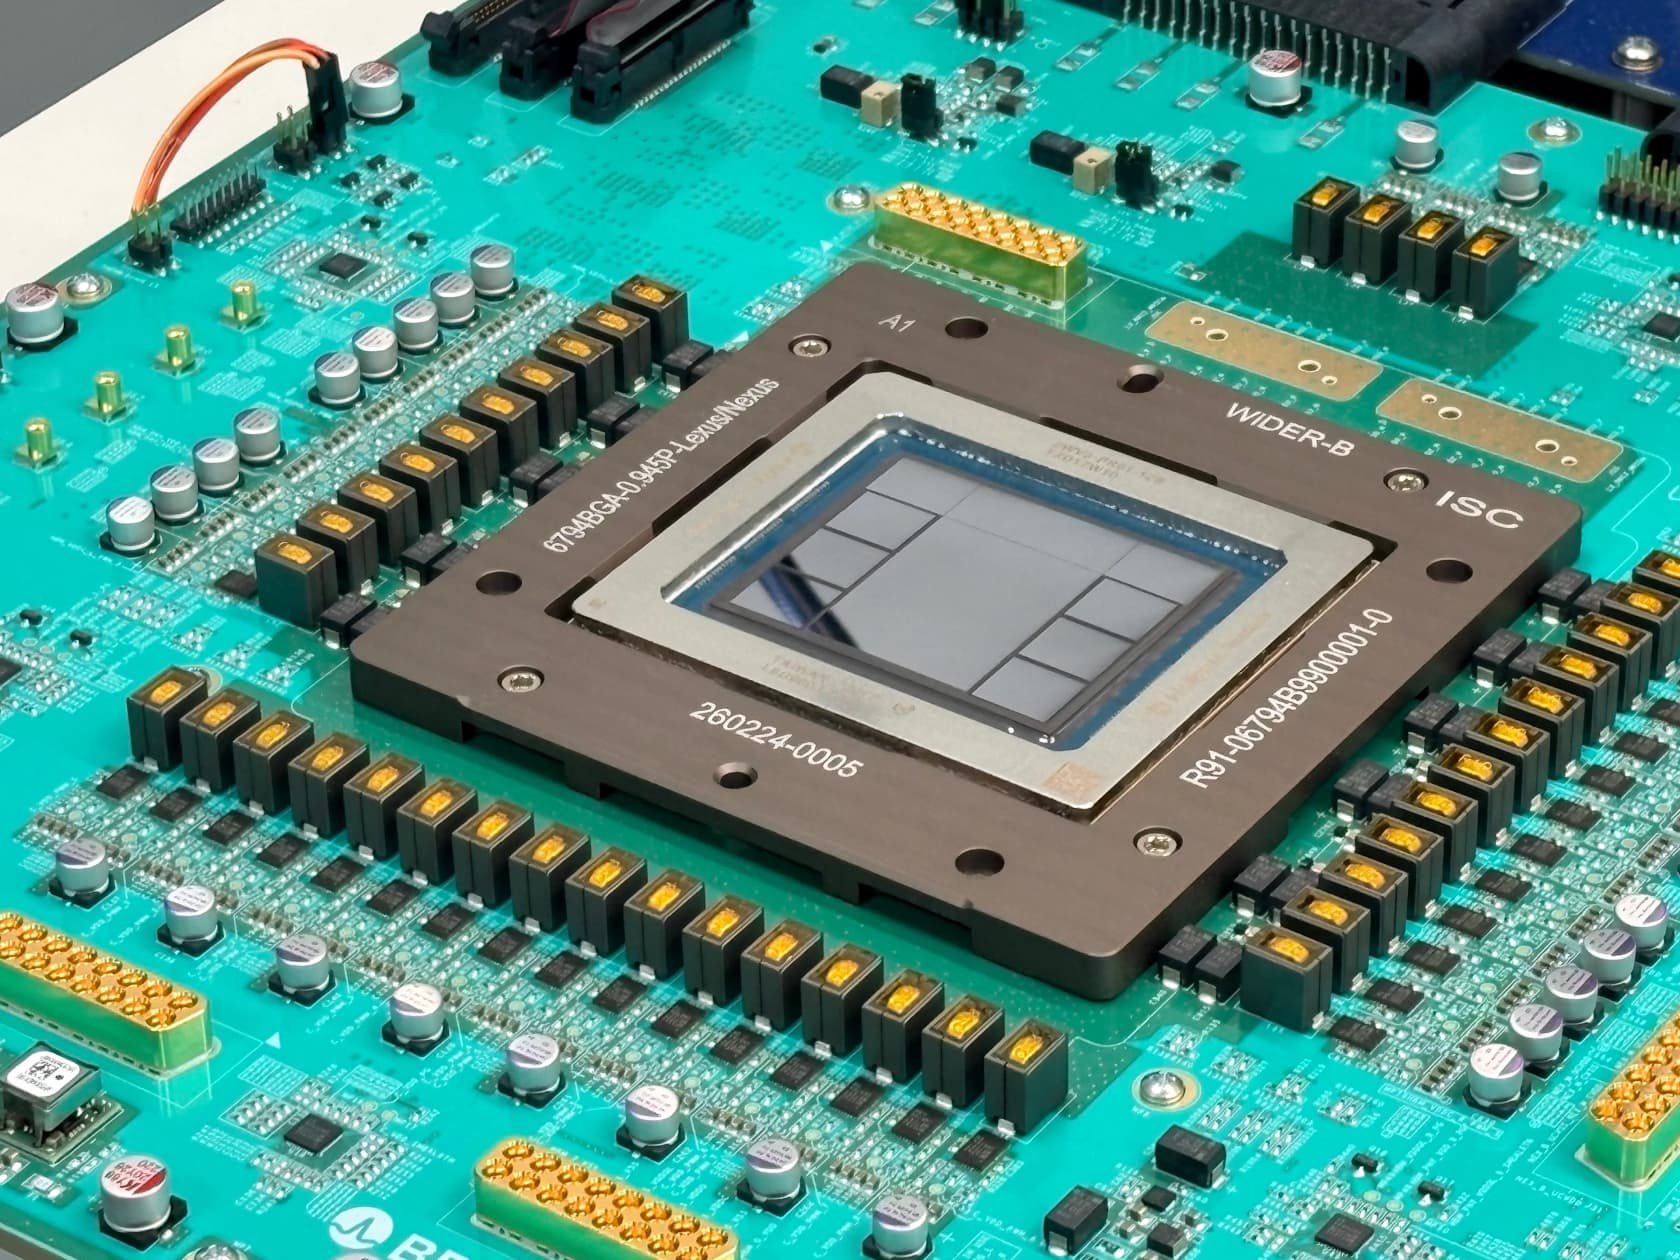
O Jalapeño é o primeiro chip de IA próprio da OpenAI, um ASIC de inferência projetado em conjunto com a Broadcom e anunciado em 24 de junho de 2026. Ele foi feito para um único trabalho: executar grandes modelos de linguagem como o ChatGPT e o Codex da forma mais rápida e barata possível. Ele não treina modelos, e você não pode comprá-lo.
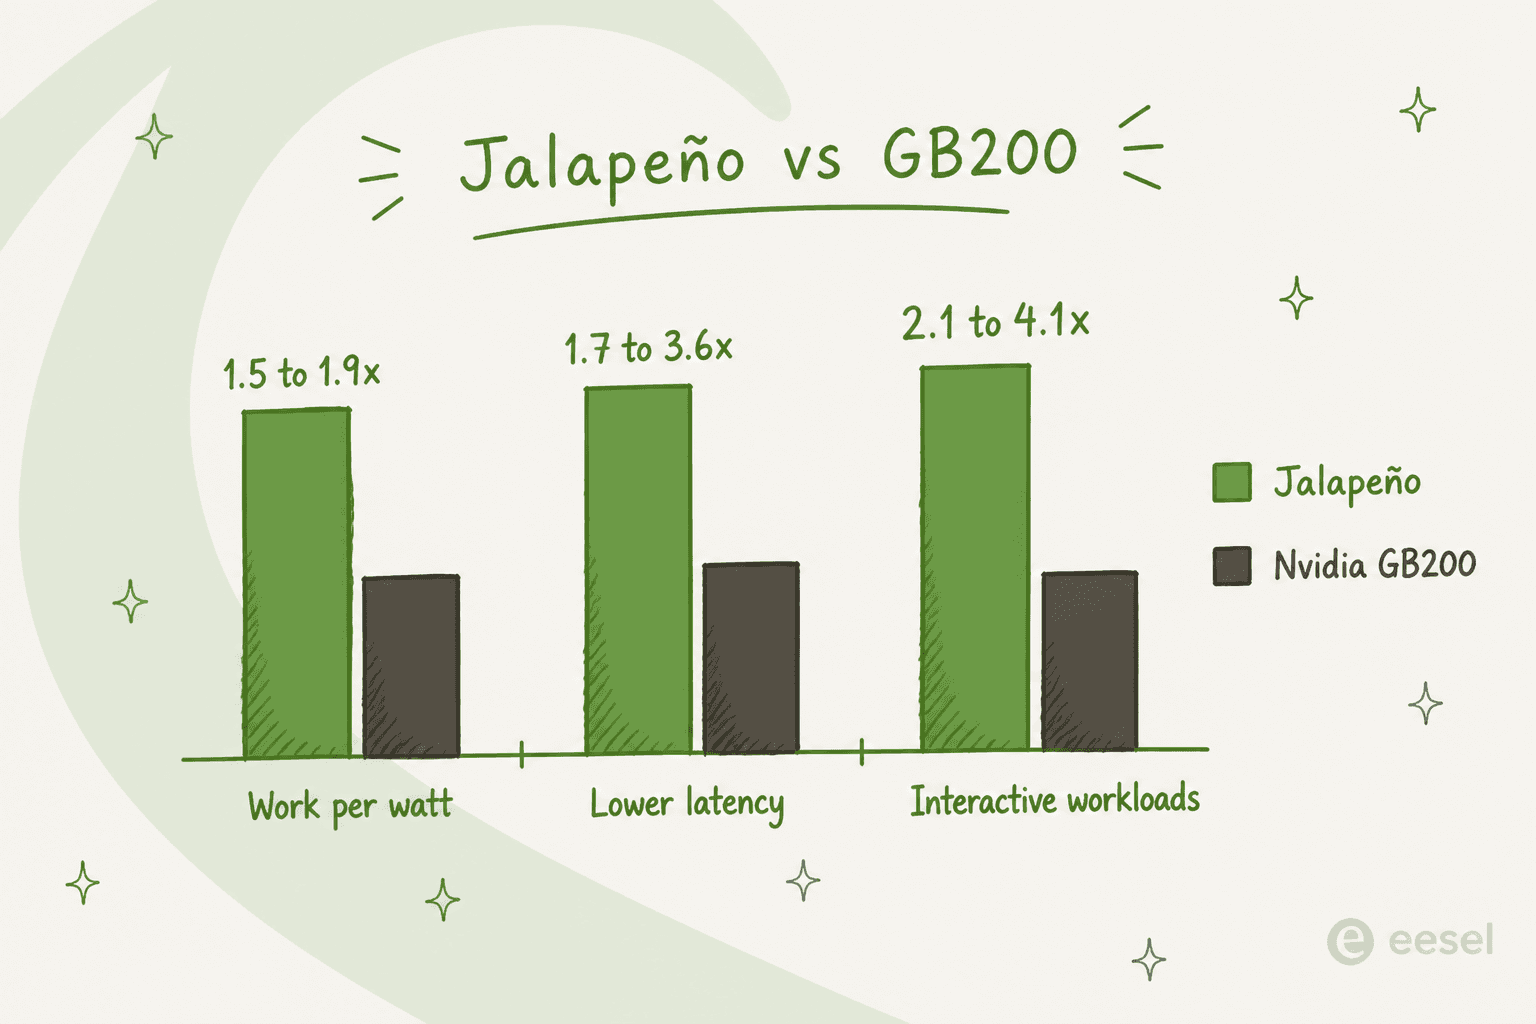
Nos primeiros benchmarks publicados pela OpenAI (25 de agosto de 2026), o Jalapeño entregou de 1,5 a 1,9 vez mais trabalho de IA por watt e latência de 1,7 a 3,6 vezes menor que o sistema Nvidia GB200 de comparação, em três modelos públicos. A OpenAI planeja colocá-lo em operação nos próprios data centers até o fim de 2026, como o primeiro de um roteiro de várias gerações ligado a uma expansão de 10 GW com a Broadcom.
Se você não é a OpenAI, a ideia é simples: isso é a tubulação por baixo dos modelos, e tubulação mais barata significa IA mais barata. É a mesma força que faz um agente de IA custar menos que um agente humano em escala. Ferramentas como a eesel rodam sobre esses modelos para fazer trabalho de verdade, então, quando o silício por baixo fica mais eficiente, a economia do suporte e da automação com IA melhora sem você precisar mexer em nada.
O que a OpenAI realmente anunciou
Eu construo agentes de IA para viver, então leio lançamentos de chips por uma única lente: isso muda o que os modelos por cima podem fazer ou quanto custam para rodar? O Jalapeño é claramente do segundo tipo, e dos grandes.
Em 24 de junho de 2026, a OpenAI e a Broadcom apresentaram o Jalapeño, o primeiro chip próprio da OpenAI. O nome é uma piada sobre calor e velocidade; o que importa é que a OpenAI não aluga mais toda a sua capacidade de computação de terceiros. Ela projetou o próprio silício, informou o TechCrunch, e a Bloomberg observou que ela já havia recebido as primeiras amostras físicas e as estava testando.
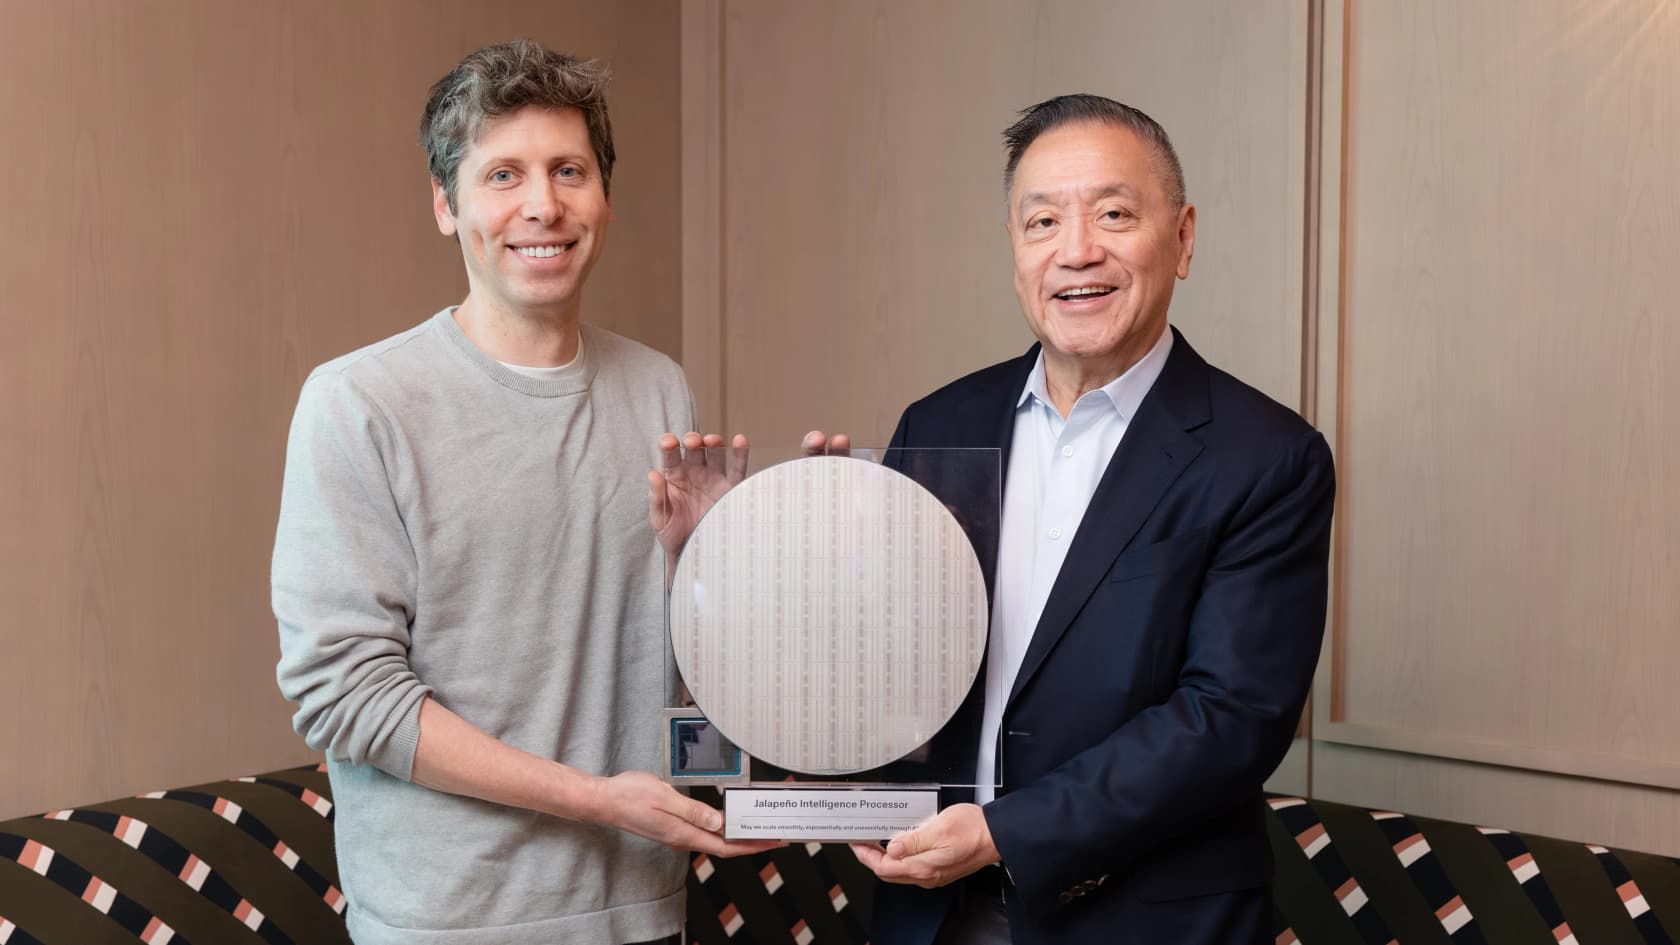
A escala é a manchete que a maioria deixou passar. Esse chip é uma peça de uma parceria para implantar 10 GW de aceleradores projetados pela OpenAI nos próximos anos, uma expansão que a OpenAI apresenta como parte de seu "plano full stack" mais amplo para controlar tudo: modelos, produtos, software de serviço, chips, memória e rede. O Jalapeño é onde esse plano deixa de ser um slide e vira silício funcionando.
O que o Jalapeño é e o que não é
Algumas distinções importam, porque "a OpenAI fez um chip" vira rápido "a OpenAI está brigando com a Nvidia", e isso perde o ponto.
O Jalapeño é um ASIC, um chip de aplicação específica. Enquanto uma GPU da Nvidia é um processador flexível de uso geral que pode treinar modelos, rodar gráficos e servir inferência, um ASIC faz uma única tarefa estreita extremamente bem e nada mais. O único trabalho do Jalapeño é a inferência, o lado do serviço em que um modelo treinado lê o seu prompt e gera uma resposta. Ele não treina modelos. Para isso, a OpenAI continua usando a Nvidia e outros parceiros.
E você não pode comprá-lo. O Jalapeño não é um produto; ele roda dentro da infraestrutura da própria OpenAI para servir o ChatGPT, o Codex, a API e produtos com agentes. Para todos os outros, o chip aparece de forma indireta, como modelos da OpenAI mais rápidos e baratos, e não como hardware no seu rack. Se você quer a versão dessa história com hardware de inferência especializado que dá para alugar de verdade, esse mercado já existe em plataformas como a Baseten.
Mais uma coisa para ser justo: isso foi rápido. A OpenAI diz que foi do design ao tapeout em nove meses, o que é rápido para silício personalizado e mostra quanto talento e dinheiro do setor está apontado agora para o custo de inferência.
Os números dos benchmarks
Em 25 de agosto de 2026, a OpenAI publicou os primeiros resultados do Jalapeño, e esses números são o motivo pelo qual o lançamento rendeu tanta conversa.
Testado em três modelos públicos, GPT-OSS 120B, DeepSeek R1 670B e Kimi K2.5 1T, a OpenAI informou que o Jalapeño entregou:
- De 1,5 a 1,9 vez mais trabalho de IA por watt no pico de throughput
- Latência de ponta a ponta de 1,7 a 3,6 vezes menor
- De 2,1 a 4,1 vezes mais desempenho em cargas de trabalho altamente interativas
O chip de comparação nos gráficos da própria OpenAI é a Nvidia GB200, com potência de 1.200 watts contra 700 do Jalapeño. O que a OpenAI repete o tempo todo é que alcançou maior throughput e menor latência com um único design, enquanto o hardware existente costuma forçar uma escolha entre os dois.
A leitura independente vem da SemiAnalysis, cujo benchmark InferenceX a OpenAI usou. O veredito foi direto já no título, "Better Than Nvidia Blackwell", citando que o Jalapeño chega a quase 700 tokens por segundo por usuário e a mais de 9 vezes o segundo melhor chip em uma meta de interatividade equivalente. Vale ter uma coisa em mente, que abordo abaixo: a SemiAnalysis é dona do benchmark que a OpenAI escolheu rodar.
A parte mais interessante: o chip se projetou sozinho
Este é o detalhe que eu colocaria na primeira página, e que a OpenAI quase enterrou. A razão pela qual silício em nove meses foi possível é que a OpenAI usou seus próprios modelos para projetar o chip.
Modelos anteriores ajudaram a colocar o chip em funcionamento; os mais novos o estão otimizando e programando. Usando o Codex com o GPT-Astra, a equipe levou a alto desempenho, em dois meses, três modelos de pesos abertos que não estavam no plano original. Em blocos selecionados de atenção e de mixture-of-experts, as implementações geradas por IA rodaram de 1,5 a 1,8 vez mais rápido que as versões de especialistas humanos.
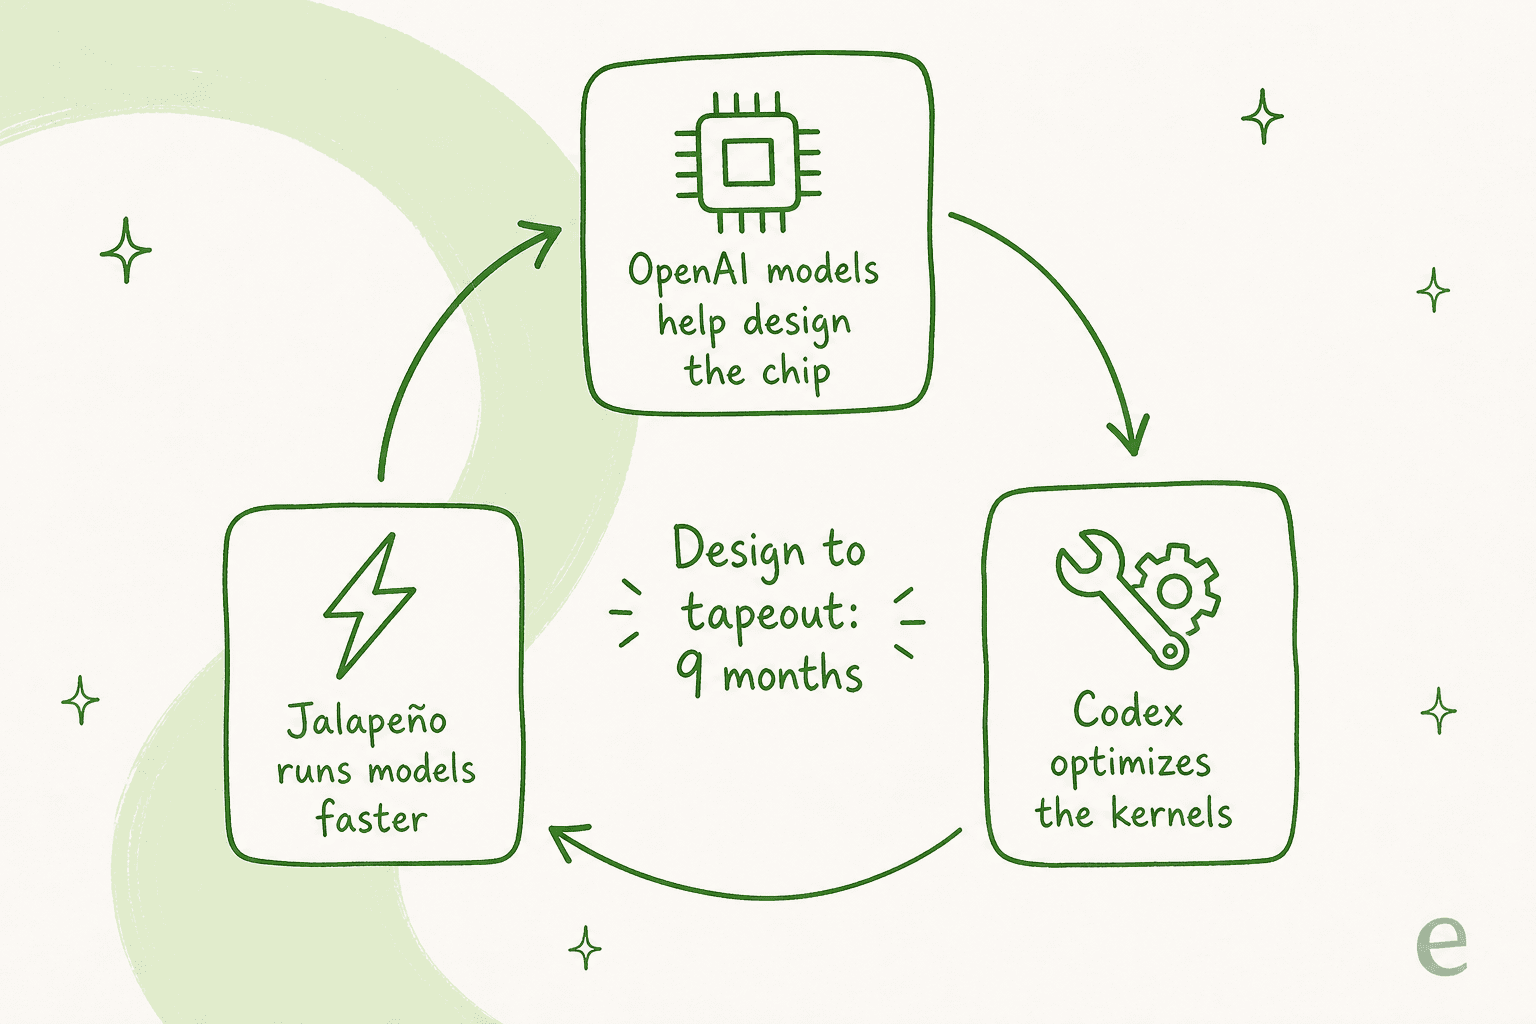
Isso é um ciclo: os modelos ajudam a projetar o silício, o silício roda os modelos mais rápido, e os modelos mais rápidos ajudam a projetar o próximo silício. A Gen 2 está "deep in development" e a Gen 3 está "taking shape". Seja qual for a sua opinião sobre os benchmarks, esse ciclo de retroalimentação é a parte que se acumula, e é a mesma razão pela qual os assistentes de programação com IA ganham cada vez mais voz na forma como produtos reais são construídos.
O que a comunidade achou
A reação não foi uma volta olímpica tranquila, e o ceticismo é razoável o bastante para ser incluído.
A crítica mais afiada no Hacker News foi que essa não é uma comparação em pé de igualdade:
"OpenAI's chip is targeting inference (FP8, FP4), while most of the chips it is being compared to are general purpose."

Um ASIC de inferência feito sob medida deveria superar uma GPU de uso geral em inferência por watt. É isso que a especialização compra, então a vitória é real, mas também um tanto esperada. Outros apontaram quem escreveu o placar:
"This semi-analysis article reads a lot more like an OpenAI press release than a real analysis."
Do lado dos investidores no Reddit, o enfoque tinha menos a ver com tokens e mais com margens: o r/NVDA_Stock tratou o silício próprio como uma ameaça de queima lenta ao poder de preço da Nvidia, e não como uma ameaça da noite para o dia. Minha leitura fica no meio: os números provavelmente estão certos na direção e são reais para as cargas de trabalho da OpenAI, e também são exatamente os números que você esperaria de um chip especializado medido no teste do próprio autor.
Por que um anúncio de chip importa se você não é a OpenAI
Você não vai instalar o Jalapeño. Então por que se importar? Porque o custo de inferência é o número silencioso por baixo de todo produto de IA que você usa ou constrói.
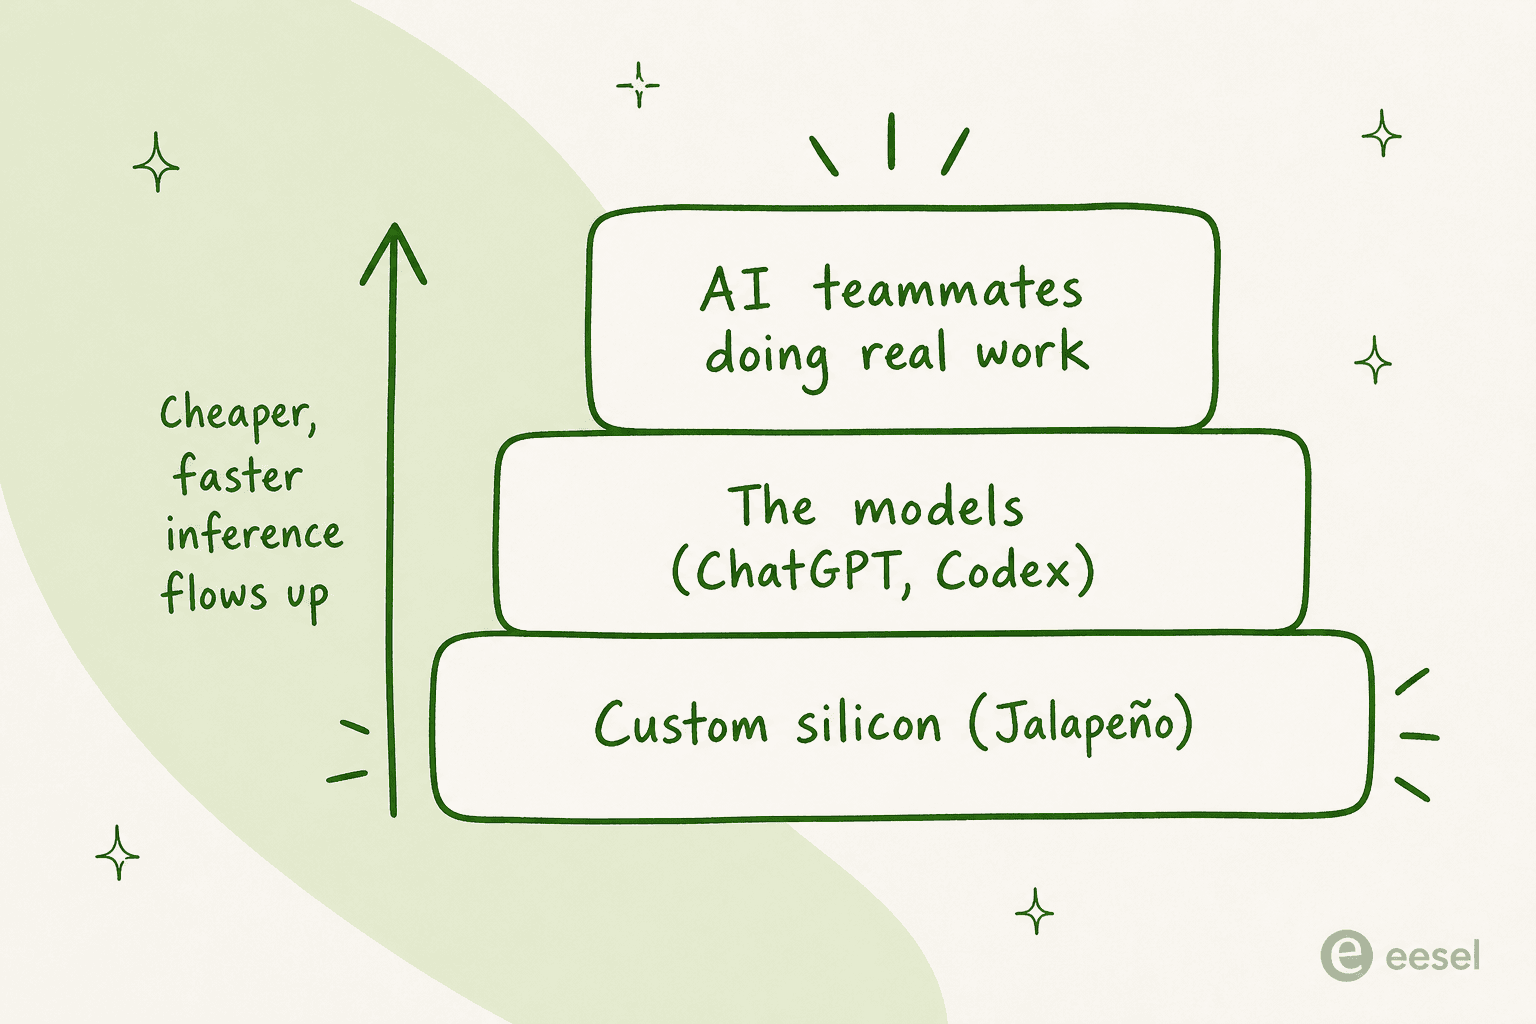
Cada resposta de suporte com IA, cada e-mail redigido, cada agente de IA que lê um pedido e responde a um cliente é uma chamada de inferência que custa dinheiro de verdade para servir. Quando a OpenAI reduz esse custo, ela melhora primeiro as próprias margens, mas o efeito sobe pela pilha com o tempo, em preços de API mais baixos e modelos que fazem mais por dólar. Esse é o vento a favor que continua transformando o suporte com IA de uma demo em um item de custo que claramente se paga, a mesma conta por trás de quanto a IA pode realmente economizar no atendimento ao cliente.
Também é um lembrete de onde está a verdadeira alavanca para a maioria das equipes. Você não compete sendo dono de silício; você compete colocando os modelos para trabalhar nos seus problemas reais. O chip é o chão de fábrica. O agente de IA que cuida dos seus tickets é o funcionário, e o funcionário é a parte que você pode contratar.
Experimente a eesel
O Jalapeño é infraestrutura, a camada por baixo dos modelos. A eesel é a camada por cima, a parte que você realmente coloca para trabalhar. É uma plataforma de colegas de equipe de IA: você contrata colegas prontos para trabalhar em tarefas específicas, e o colega de helpdesk com IA entra na sua fila atual do Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda e começa a redigir ou enviar respostas.
O diferencial que eu destacaria é que você pode simular um colega com seus tickets históricos antes que ele responda a um cliente real, vendo como ele vai se sair em vez de ligar uma chave e torcer. O preço é a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat), sem cobrança por usuário, e você pode começar de graça com 100 créditos. Silício mais barato por baixo é bom; um colega que você pode testar hoje é a parte que muda a sua semana.