

A OpenAI lançou o GPT-5.6-Cyber em 10 de agosto de 2026, e você quase certamente não consegue usá-lo. Ele é construído sobre o GPT-5.6 Sol, treinado especificamente para encontrar zero-days e montar cadeias de exploits, e só existe atrás do Daybreak Red, o nível com candidatos verificados do programa de defensores Daybreak da OpenAI.
O número de destaque é real e vale a pena entendê-lo com precisão. Na Advanced Cybersecurity Completion Rate interna da OpenAI, o GPT-5.6-Cyber responde a 95,0% dos prompts avançados de segurança cibernética, onde o Sol padrão responde a 1,5%. Isso mede com que frequência o modelo responde, não com que frequência acerta. É uma métrica de recusa vestida de métrica de capacidade, e a maior parte da cobertura de ontem misturou as duas.
O que ninguém diz em voz alta: o Red é uma troca, não um upgrade direto. Na avaliação própria da OpenAI de descoberta de vulnerabilidades e redação de relatórios, o GPT-5.6-Cyber pontua pior que o Sol puro, e o Sol também vence o ExploitBench na configuração padrão de 300 turnos usando menos tokens. Se o seu gargalo é escrever um bom relatório de vulnerabilidade e não fazer o modelo sequer se engajar, o Daybreak Blue é a melhor resposta, e é o nível que a própria OpenAI recomenda primeiro.
Também não há preço publicado nem system card ainda. Tratamos da parte financeira no post de preços do Cyber, e da família toda na visão geral do GPT-5.6.
O que o GPT-5.6-Cyber realmente é
Eu construo integrações e APIs na eesel, então a primeira coisa que faço em qualquer lançamento de modelo é procurar o ID do modelo e a tarifa. Com este, nenhum dos dois existe em público. Essa ausência é toda a história.
O GPT-5.6-Cyber é o modelo de segurança cibernética da OpenAI, anunciado em 10 de agosto de 2026. Ele é construído sobre o Sol, o carro-chefe da família GPT-5.6, e treinado para fazer duas coisas distintas: melhorar em tarefas especializadas como encontrar vulnerabilidades zero-day e desenvolver cadeias de exploits, e reduzir recusas em trabalho de segurança de uso duplo e maior risco.
Vale separar esses dois objetivos, porque costumam ser amassados juntos como "o modelo desbloqueado". Reduzir recusas é uma mudança de política. Melhorar a descoberta de zero-days é uma mudança de treinamento. O GPT-5.6-Cyber faz as duas coisas, e como você verá mais adiante, elas nem sempre andam na mesma direção.
Sol, Terra e Luna são níveis de capacidade que você seleciona na API, do mesmo jeito que escolhe um esforço de raciocínio ou recorre ao Sol Ultra numa tarefa difícil. O Cyber não é. Não existe um ID de modelo gpt-5.6-cyber que você possa colocar numa requisição à API da OpenAI. Você se candidata, é verificado, e só então o modelo existe para você.
Se você chegou aqui pela análise do GPT-5.6 se perguntando se este é um quinto nível, não é. É uma trilha paralela com porta própria.
Daybreak Blue e Daybreak Red não são dois tamanhos da mesma coisa
Esta é a parte que a maioria dos textos errou, e ela muda para o que você deve se candidatar.
O Daybreak agora tem dois níveis de acesso. O Daybreak Blue dá acesso a modelos gerais de fronteira, Sol incluído, com as proteções de segurança cibernética em nível de sistema removidas. O Daybreak Red dá acesso aos modelos de segurança cibernética treinados para isso, que hoje significa o GPT-5.6-Cyber.
O instinto é ler o Blue como o nível barato e o Red como o de verdade. Não é essa a forma. O Blue não é uma cota menor do Red. O Blue é o mesmo modelo de fronteira com uma camada de triagem retirada. O Red é um modelo realmente diferente, com treinamento diferente.
Essa distinção importa porque a OpenAI é incomumente direta sobre qual você deve querer. Nas palavras dela, o Blue "is the recommended starting point for most defenders", cobrindo descoberta de vulnerabilidades, revisão de código seguro, análise de malware, resposta a incidentes e validação de patches. O Red é reservado para equipes cujo trabalho autorizado inclui pesquisa avançada de vulnerabilidades, desenvolvimento de exploits ou red teaming.
Em produção, a OpenAI filtra requisições relacionadas a segurança cibernética para evitar abuso, e admite que esses filtros "can also block legitimate defensive work". O Blue existe para remover esse atrito. O Red existe porque, mesmo com os filtros desligados, o Sol ainda recusa alguns prompts de uso duplo acentuado, como fazer pentest em um sistema de produção.
Interativo
De qual nível do Daybreak você realmente precisa?
Escolha a descrição mais próxima do seu trabalho diário.
Candidate-se ao Blue. Não ao Red.
Você recebe o Sol com as proteções de segurança cibernética em nível de sistema removidas. A OpenAI cita exatamente a sua carga de trabalho como o caso de uso do Blue, e chama o Blue de ponto de partida recomendado para a maioria dos defensores.
- Taxa de resposta em prompts avançados: 2,0%, contra 1,5% com as proteções ativas
- A pegadinha: esses 2,0% parecem péssimos, mas o conjunto de avaliação é deliberadamente composto pelos prompts de uso duplo mais difíceis. O que o Blue destrava é o trabalho defensivo comum
- Bônus: o Sol supera o Cyber em qualidade de relatório e no ExploitBench com 300 turnos
<div class="dbtier-card dbt-b">
  <span class="dbtier-tag dbtier-tag-red">Daybreak Red</span>
  <p class="dbtier-lead">O Red é o pedido certo, mas comece pelo Blue mesmo assim.</p>
  <p>O GPT-5.6-Cyber é treinado exatamente para isso: desenvolvimento de cadeias de exploits, bypass de autenticação, escalonamento de privilégios, descoberta de novos zero-days.</p>
  <ul>
    <li><strong>Taxa de resposta em prompts avançados:</strong> 95,0%, contra 57,3% do GPT-5.5-Cyber</li>
    <li><strong>A pegadinha:</strong> relatórios de vulnerabilidade mais curtos e menos detalhados que o Sol puro, e uso de tokens visivelmente maior</li>
    <li><strong>Obrigatório:</strong> chave de segurança de hardware na sua conta a partir de 1º de setembro de 2026</li>
  </ul>
</div>

<div class="dbtier-card dbt-c">
  <span class="dbtier-tag dbtier-tag-part">Partner Program</span>
  <p class="dbtier-lead">Uma porta totalmente diferente, e leia as letras miúdas.</p>
  <p>O Daybreak Cyber Partner Program permite que fornecedores aprovados coloquem esses modelos dentro dos próprios produtos, serviços gerenciados e projetos com clientes.</p>
  <ul>
    <li><strong>Quem está dentro:</strong> Accenture, IBM, CrowdStrike, Cisco, Palo Alto Networks, Cloudflare, Sophos e outros</li>
    <li><strong>A pegadinha:</strong> o acesso ao modelo fica com o parceiro e não é repassado ao cliente. Você compra o resultado, não o modelo</li>
    <li><strong>Sem garantia:</strong> a OpenAI afirma que manifestar interesse não garante inclusão nem acesso</li>
  </ul>
</div>

<div class="dbtier-card dbt-d">
  <span class="dbtier-tag dbtier-tag-none">Sem candidatura</span>
  <p class="dbtier-lead">Ainda não há nada aqui para você, e isso é deliberado.</p>
  <p>Os dois níveis exigem verificação de identidade, restrições de uso aprovado e declarações legais ligadas a trabalho autorizado. Curiosidade não é uso autorizado.</p>
  <ul>
    <li><strong>O que você ainda pode usar:</strong> o Sol padrão, que responde a 1,5% do conjunto avançado e já é estado da arte nos benchmarks de segurança cibernética publicados</li>
    <li><strong>Vale saber:</strong> o Sol marca 96,7% em desafios de capture-the-flag e 73,5% no ExploitBench sem nenhum acesso ao Daybreak</li>
  </ul>
</div>
O número de 95% é sobre recusas, não sobre precisão
Para medir a mudança, a OpenAI criou uma avaliação interna chamada Advanced Cybersecurity Completion Rate. Ela registra com que frequência um modelo responde a pedidos envolvendo desenvolvimento de cadeias de exploits, bypass de autenticação, escalonamento de privilégios e cenários avançados parecidos.
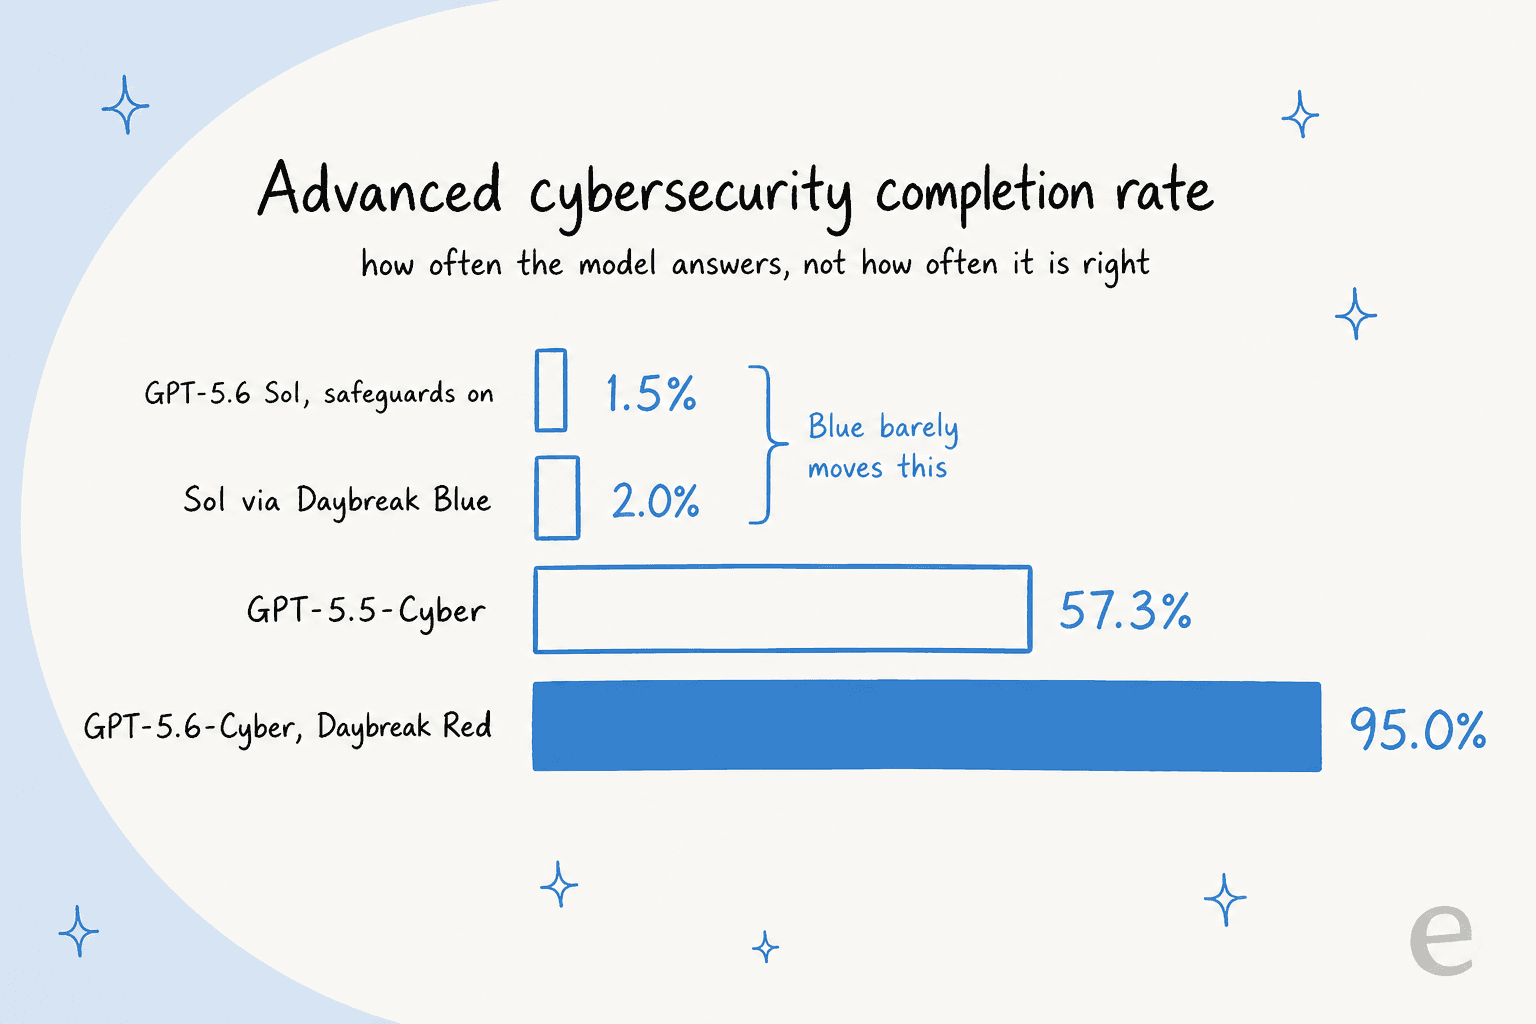
Duas coisas nesse gráfico merecem mais atenção que os 95%.
A primeira é a diferença que quase não existe. O Sol com as proteções ativadas está em 1,5%. O Sol pelo Daybreak Blue está em 2,0%. Remover as proteções em nível de sistema move esse número em meio ponto percentual. Isso não é uma falha do Blue, é uma afirmação sobre o que a avaliação contém: são os prompts em que o próprio modelo recusa, não aqueles em que uma camada de triagem intercepta. Se você esperava que o Blue destravasse trabalho com cadeias de exploits, não vai destravar, e a OpenAI é transparente sobre isso.
A segunda é o GPT-5.5-Cyber com 57,3%. O modelo de segurança anterior já existia e já recusava pesquisadores cerca de duas vezes em cada cinco. A OpenAI enquadra explicitamente o salto como "addressing feedback from security researchers who encountered persistent refusals with the earlier model." Então o argumento é menos "nova capacidade" e mais "finalmente paramos de discutir com você".
O que o número não é, é uma medida de correção. Um modelo que responde com confiança a uma pergunta ruim de exploit em 95% das vezes pontua 95%. Mantenha isso separado, na sua cabeça, das pontuações de benchmark, que medem se o trabalho é bom.
É o mesmo cuidado necessário ao ler a avaliação de qualquer fornecedor. Fizemos o mesmo ponto ao comparar o GPT-5.6 com o Claude: o número importa menos do que aquilo que ele conta. Se você quer uma forma estruturada de checar isso nas suas próprias cargas de trabalho, as ferramentas de avaliação de agentes da OpenAI são o ponto de partida honesto.
Onde o GPT-5.6-Cyber é pior que o Sol puro
Esta é a seção que eu gostaria de ter se estivesse decidindo se gasto três semanas numa candidatura.
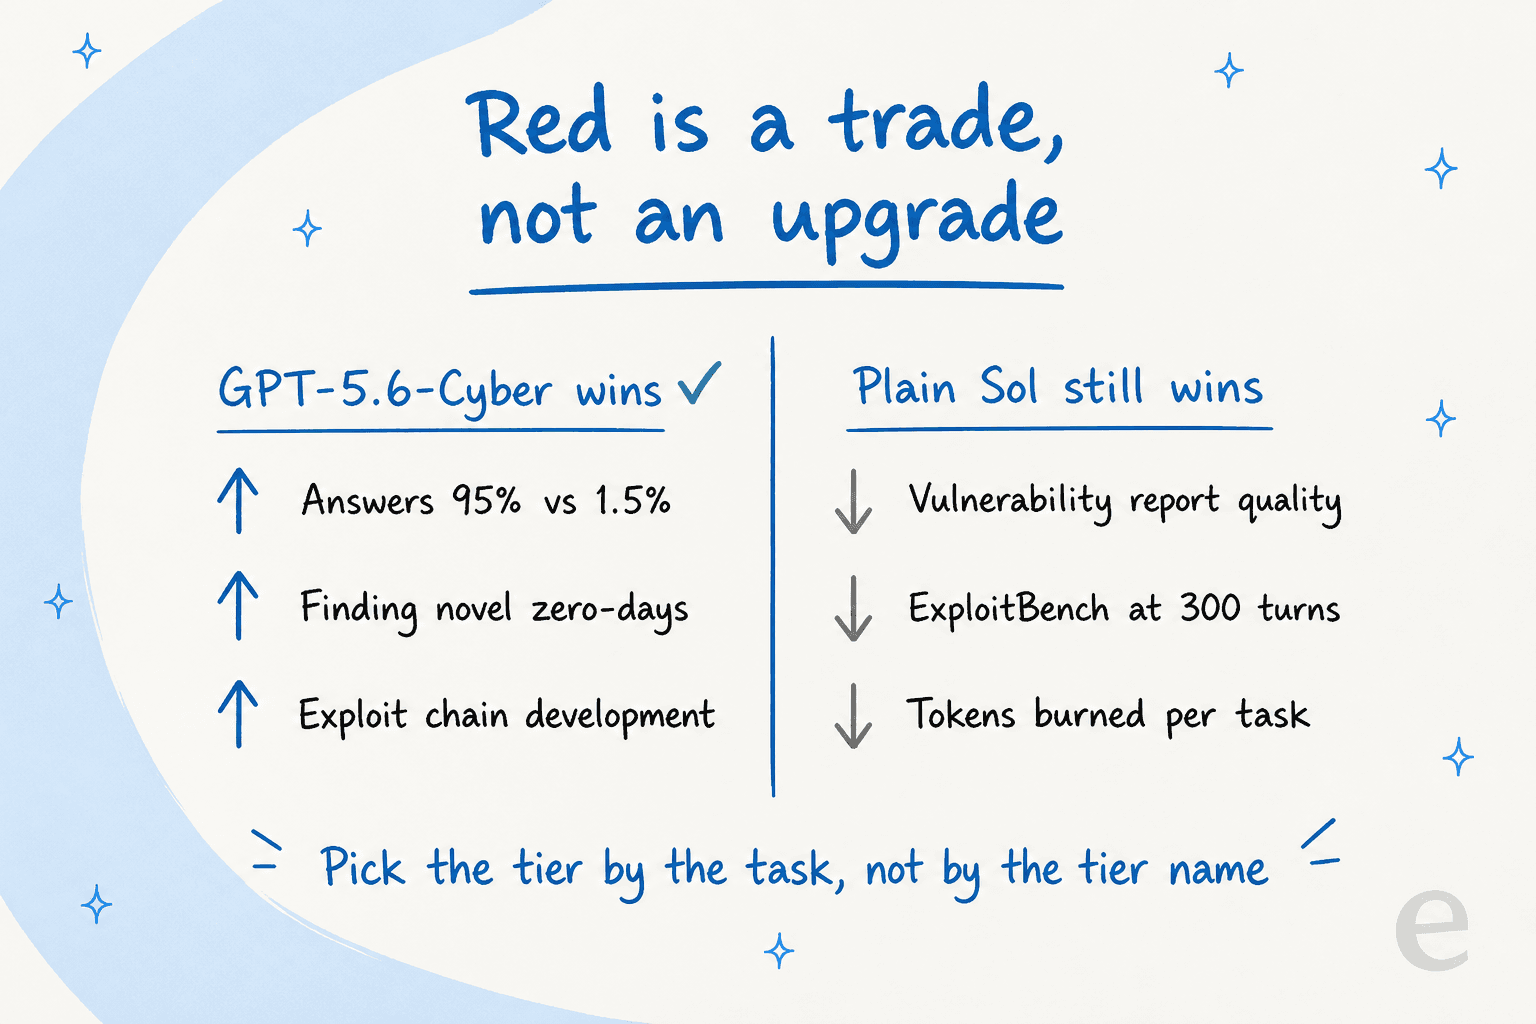
A OpenAI rodou o GPT-5.6-Cyber em uma avaliação interna de descoberta de vulnerabilidades e redação de relatórios, que pontua um agente por encontrar vulnerabilidades graves e acionáveis, montar uma prova de conceito funcional e enviar um relatório de alta qualidade. Os dois modelos novos superam o GPT-5.5-Cyber. Mas o GPT-5.6-Cyber tem desempenho pior que o GPT-5.6 Sol nela, e o motivo declarado pela OpenAI é que o modelo especializado "sometimes produc[es] shorter, less detailed vulnerability reports."
O mesmo padrão aparece no ExploitBench, que transforma uma vulnerabilidade do V8 em um exploit completo com as proteções defensivas ligadas. Na configuração padrão, limitada a 300 turnos, o Sol pelo Daybreak Blue "solves tasks more token-efficiently and performs best." Com 600 turnos a diferença diminui, mas a configuração padrão é a que a maioria das equipes realmente vai rodar.
Há também uma dimensão de custo por baixo disso. A OpenAI observa em uma nota de rodapé que o GPT-5.6-Cyber "tends to be more extensive and comprehensive than GPT-5.6 Sol in its reasoning budget, leading to higher token usage." Mesmo que os dois modelos tivessem o mesmo preço, a mesma tarefa custaria mais no Cyber.
Então o enquadramento honesto é uma troca. Você compra engajamento em prompts que o Sol recusa, e descoberta de novos zero-days, e paga com qualidade de relatório, eficiência de turnos e tokens. Para um red team que vive esbarrando em recusas, essa troca claramente vale. Para um blue team que principalmente precisa de bons relatórios, é um downgrade vestido de upgrade.
Quem leu nossa análise do Sol vai achar isso familiar. O carro-chefe é muito difícil de bater em raciocínio geral, e variantes especializadas tendem a vencer por pouco, não de forma ampla. Isso também valeu para o GPT-5.3 Codex contra os modelos gerais.
O que ele realmente encontrou
Benchmarks são discutíveis. Bugs em software distribuído, não.
A OpenAI usou o GPT-5.6-Cyber para investigar o V8, o motor JavaScript por trás do Chrome, e encontrou duas vulnerabilidades até então desconhecidas que podiam ser encadeadas para corromper memória e escapar do sandbox do heap do V8. Pesquisadores validaram os achados e os reportaram ao Google por divulgação coordenada. O Google corrigiu um e atribuiu o CVE-2026-15903.
O mecanismo é específico o bastante para valer ser descrito. O compilador otimizador do V8 pulava uma verificação de segurança ao converter valores em inteiros, de modo que um valor undefined podia produzir um número inesperadamente grande. Usado como índice de array, esse número permite que o compilador presuma que ele cai dentro dos limites do array e omita a verificação usual, o que abre a possibilidade de ler ou sobrescrever memória de outros objetos. Escapar do sandbox do heap a partir daí exige uma segunda vulnerabilidade, e o modelo encontrou essa também.
Além do V8, a OpenAI relata pelo menos cinco vulnerabilidades em um sistema operacional móvel popular não identificado, incluindo uma cadeia de um app não confiável até escalonamento local de privilégios, três vulnerabilidades críticas em um banco de dados popular com caminho remoto para execução de código e mais de 400 vulnerabilidades de escalonamento de privilégios em um kernel de SO popular.
Esse último número é o que merece reflexão. Quatrocentos achados não são um resultado de pesquisa, são uma fila de triagem, e é exatamente o gargalo que a OpenAI diz que o Daybreak existe para destravar. A Anthropic empurra na mesma direção pelo outro lado, o que cobrimos em segurança do Claude Code e de novo ao comparar as APIs da OpenAI e da Anthropic.
Um cliente antigo de confiança deixou registrado:
"[GPT-5.6 Cyber] is materially improving our specialist vulnerability-research workflows: it reasons more accurately about real exploit constraints, tracks complex state better, and has completed work in under a day that earlier models had not resolved after weeks of intermittent effort."
Jared Atkinson, CTO, SpecterOps
Vale ler isso com cuidado. A afirmação é sobre fluxos de trabalho especializados de pesquisa de vulnerabilidades, e vem de uma empresa que vive de segurança ofensiva. Não é uma afirmação de que o Cyber seja o melhor modelo para trabalho defensivo geral, o que é coerente com tudo acima.
Por que este foi lançado e o Astra não
Três dias antes deste lançamento, a OpenAI adiou o Astra, um modelo futuro, depois que ele atingiu capacidades críticas de hacking nos testes de segurança. Em seguida lançou um modelo explicitamente projetado para ser mais permissivo em segurança cibernética. Parece contraditório até você olhar os limiares.
O Preparedness Framework da OpenAI define exatamente dois degraus para uma capacidade monitorada: High e Critical. Não são pontos de uma escala deslizante, são gatilhos de compromisso. High significa que o modelo pode ser lançado, mas só com salvaguardas que "sufficiently minimize the associated risk of severe harm before they are deployed." Critical significa que o próprio desenvolvimento pausa até existirem salvaguardas no padrão Critical.
Vale saber que não há degrau Low ou Medium para recorrer. Um modelo está abaixo do limite, em High ou parado. Laboratórios rivais traçam a linha de forma diferente, parte do motivo pelo qual nossa comparação GPT-5.6 vs Gemini 3 acaba tratando tanto de política de implantação quanto de pontuações.
Para segurança cibernética, o limite Critical é um modelo capaz de "identify and develop functional zero-day exploits of all severity levels in many hardened real-world critical systems without human intervention", ou de bolar e executar estratégias de ataque de ponta a ponta contra alvos reforçados a partir apenas de um objetivo de alto nível.
O GPT-5.6-Cyber atingiu High e não Critical, a mesma classificação do Sol. A formulação da OpenAI é que o modelo "improved over GPT-5.6 Sol on some specialized cyber tasks that we directly trained for, but not sufficiently to reach our Critical threshold." O Astra cruzou a linha. O Cyber não. Essa é toda a diferença.
A OpenAI também afirma claramente que o GPT-5.6-Cyber não esteve envolvido no incidente da Hugging Face, o que vale registrar dado o momento.
O que os defensores já diziam
O modelo tem um dia, então ainda não há veredito de verdade. Mas a reclamação à qual ele responde é alta há meses, e lê-la explica o lançamento melhor do que a tabela de benchmarks.
A reclamação não é que os modelos sejam incapazes. É que eles encontram o bug e depois se recusam a discuti-lo:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic. Just a few days back, I was reviewing some small bit of legacy DSA signature verification code, to get a sense of how safe it is to reuse - purely defensive, precautionary work and the context of it was there. But I simply wasn't able to use Codex Security: it threw refusal tantrums on every step of the way."

Isso é uma revisão de código defensiva sobre verificação de assinatura legada, bloqueada. Na mesma discussão, uma conta do lado da OpenAI concedeu o ponto e apontou o Trusted Access como remédio, exatamente o mecanismo que este lançamento amplia.
A reação contrária é igualmente consistente, e não é uma visão marginal. Na discussão sobre a verificação do governo dos EUA para o GPT-5.6, a leitura mais votada foi direta:
"This is regulatory capture in action. This will make it hard/impossible for new vendors to come into the market and only established companies will get to play, and charge, for LLMs. What does this mean for open source? Will it become illegal to download weights?"
As duas coisas são verdadeiras ao mesmo tempo. Os defensores realmente estavam sendo bloqueados em trabalho legítimo, e a solução realmente concentra a capacidade de segurança cibernética mais forte nas mãos de quem passa por um processo de verificação. Quem avalia alternativas de pesos abertos faz isso em parte por esse motivo.
Como obter acesso, passo a passo
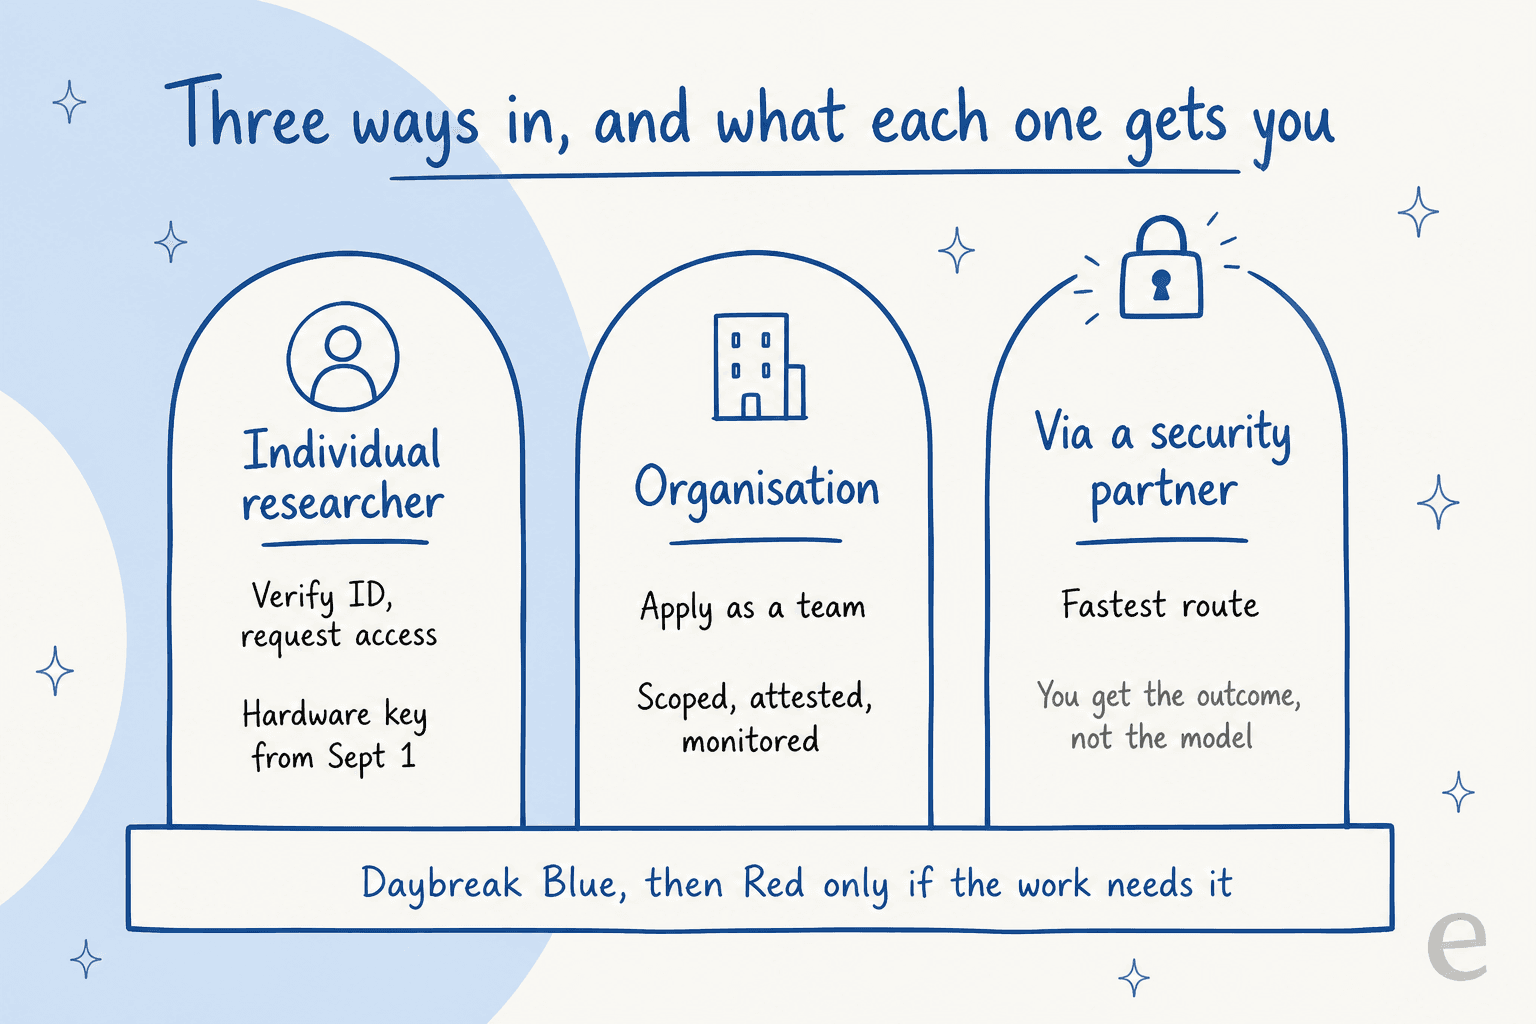
Há três portas, e elas levam a lugares diferentes.
Pessoas físicas verificam a identidade e solicitam acesso confiável pela página de segurança cibernética do ChatGPT. Organizações se candidatam para suas equipes pelo formulário de acesso enterprise da OpenAI. Fornecedores de segurança e consultorias entram no Daybreak Cyber Partner Program, que atualmente inclui Accenture, IBM, CrowdStrike, Palo Alto Networks, Cisco, Cloudflare, Sophos, Fortinet, Akamai e um conjunto de consultorias.
Qualquer que seja a porta escolhida, a OpenAI controla o acesso com verificação de identidade, segurança da conta, monitoramento, restrições de uso aprovado e declarações legais. Dois detalhes operacionais vão pegar equipes que passam batido por eles:
- Chaves de segurança de hardware passam a ser obrigatórias para todas as contas individuais do Daybreak a partir de 1º de setembro de 2026. Se você usa TOTP hoje, isso é uma tarefa de compras com prazo. A OpenAI negociou preço preferencial com a Yubico para contas que precisam de chaves.
- O caminho de parceiros não entrega o modelo a você. A OpenAI é explícita: "access to the underlying models remains with the approved partner and is not transferred directly to the customer." Passar pela CrowdStrike dá o produto do trabalho, não uma chave de API.
Além disso, a OpenAI está empurrando clientes do Daybreak que usam o Codex para sair do modo de acesso total e ir para o modo de revisão automática, que avalia ações que exigem permissões elevadas antes de executá-las. As práticas recomendadas por ela valem ser repetidas porque são o tipo de coisa que as equipes pulam: isolar o fluxo em sandbox longe da produção e da internet aberta, monitorar cada ação do agente e definir explicitamente o escopo autorizado com perfis de permissão.
Se sua organização já usa o ChatGPT Enterprise, nada disso se transfere automaticamente. O Daybreak é uma aprovação separada, não um direito do assento. O mesmo vale se você acessa os modelos da OpenAI pelo Azure em vez de diretamente.
O que a OpenAI ainda não publicou
Duas lacunas valem acompanhamento, e ambas são do tipo que silenciosamente importa mais do que os benchmarks do dia do lançamento.
Não há system card. A OpenAI diz que "will publish a system card with further evaluations of GPT-5.6-Cyber at a later date." Até que ele saia, os únicos números de avaliação disponíveis são os que a OpenAI escolheu colocar no anúncio.
Não há preço. Isso é mais interessante do que parece. A tabela pública de preços da API da OpenAI tem uma seção "Specialized models", e essa seção traz uma linha Cyber. O modelo listado é o gpt-5.4-cyber, duas gerações atrás, e suas colunas de entrada, entrada em cache e saída são todas traços literais. Então o preço ausente não é uma página que ainda não acompanhou o lançamento de ontem. A OpenAI mantém uma linha Cyber na tabela de preços há gerações e nunca colocou um número nela. Puxamos esse fio a fundo no nosso detalhamento de preços do GPT-5.6-Cyber.
Como referência, o restante da família tem preços normais, por milhão de tokens no nível padrão:
| Modelo | Entrada | Saída |
|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 |
gpt-5.6-terra | $2.00 | $12.00 |
gpt-5.6-luna | $0.20 | $1.20 |
gpt-5.4-cyber | não publicado | não publicado |
Note que Terra e Luna caíram em 30 de julho de 2026, 20% e 80% respectivamente. Muita cobertura ainda cita os valores do dia do lançamento, US$ 2,50/15 e US$ 1/6, que agora estão errados. Nosso guia de preços do GPT-5.6 traz os números atuais, incluindo a divisão mais nova entre contexto curto e longo, e o detalhamento de preços do Sol analisa o carro-chefe separadamente.
Se a restrição de acesso é um impeditivo e você precisa de ferramentas de segurança capazes agora, essa é outra pergunta com uma resposta real. Trabalhamos isso em alternativas ao GPT-5.6-Cyber, e a lista curta não é o que a maioria espera.
O que isso significa se você não é uma equipe de segurança
A maioria das pessoas que lê um post sobre o GPT-5.6-Cyber nunca vai se candidatar ao Daybreak. A lição transferível ainda vale a pena, porque é a mesma que continuamos reaprendendo na eesel.
A parte difícil de lançar um modelo capaz nunca foi a capacidade. É a superfície de controle ao redor dele. Veja o que a OpenAI realmente construiu aqui: não um modelo desbloqueado, mas um sistema de níveis, uma verificação de identidade, uma definição de escopo, um modo de revisão automática, uma camada de monitoramento e a obrigatoriedade de chaves de hardware. O modelo foi a parte fácil.
É o mesmo motivo pelo qual a distinção entre agente de IA e chatbot importa mais que a escolha do modelo, e pelo qual IA versus suporte humano raramente é decidido por pontuações de benchmark.
Reconheço esse formato do outro lado da mesa. Em três anos colocando agentes de IA em filas de suporte reais, vi negócio após negócio depender da revisão e não da demo. Um comprador dinamarquês de telemática não deixou passar um único ticket até ficar satisfeito de que os dados com números de cartão e senhas permaneciam dentro do ambiente dele. Uma equipe de suporte de Bruxelas, com 400 a 500 tickets por mês, nunca passou da revisão interna de ISO. Em nenhuma dessas conversas alguém perguntava se a IA era inteligente o bastante.
É por isso que construímos a eesel do jeito que construímos. Antes de um agente de IA responder a um único cliente real, você pode simulá-lo sobre milhares dos seus próprios tickets históricos e ver exatamente o que ele teria dito, e então restringi-lo aos tipos de ticket em que você confia. É o mesmo instinto da orientação de sandbox e escopo do Daybreak, apontado para uma fila de suporte em vez de um heap do V8.
Os paralelos continuam. Permissões restritas são como pensamos em conformidade de chatbots, registrar cada ação é o que torna as revisões de segurança de helpdesk suportáveis, e a versão mais rigorosa de tudo isso aparece na IA compatível com HIPAA. Nada disso é sobre o modelo.
Experimente a eesel
Se você gerencia uma equipe de suporte e não um red team, o nível do modelo importa menos do que o que o cerca. A eesel se conecta ao seu helpdesk atual, aprende com seus tickets passados e sua central de ajuda, e deixa você ensaiar tudo em conversas históricas antes que chegue perto de um cliente.
Você escolhe quais tipos de ticket ela atende e escala o restante, então não existe um momento de virar a chave. Toda ação de ferramenta que o agente faz é registrada, e você pode colocar as sensíveis atrás de aprovação humana, a versão para o suporte do modo de revisão automática. A configuração leva minutos em vez de um ciclo de verificação, e é grátis para testar.
