

プラットフォームに切り替えスイッチがあるなら、ヘルプセンターにllms.txtを追加してもかまいませんが、検索トラフィックは期待しないでください。それは誰かがあなたのサイトに送り込むAIエージェント向けの地図であり、ランキング信号ではありません。GoogleはAI機能がそれを使わないと述べており、トラフィックを記録している運営者たちはAIクローラーがそれを素通りすることを見ています。GitBook、Mintlify、Document360、ReadMe、HelpDocsは生成します。Zendesk、Help Scout、Freshdeskは生成しないので、自分で厳選したファイルを作って自分でホストします。eeselのようにヘルプデスクに接続するサポートAIは記事を直接読むため、このファイルはまったく必要ありません。
ヘルプセンターにおけるllms.txtとは何か
llms.txtは、最も役立つページを1行のメモ付きで列挙する、単純なマークダウンファイルです。これにより、AIエージェントはナビゲーションメニューやクッキーバナーをかき分けずに正しい記事を見つけられます。Jeremy Howardが2024年9月にこの提案を公開し、バージョン2が2026年8月に登場しました。仕様自体の主張は、詳細はリンクの先に置いたまま「ファイル自体はコンテキストに収まる十分な小ささを保つ」というものです。
私はeeselでAIエージェントを作っていますが、その仕組みはほとんどのガイドが聞こえさせるより単純です。エージェント(Claude Code、Cursor、誰かがあなたのURLを貼り付けたChatGPTのセッション)が/llms.txtを取得し、リストを読み、質問に合うリンクを選び、そのページを開きます。各リンクが記事のきれいなマークダウン版を指していれば、エージェントはあなたのテーマを解析せずに答えを得ます。それ以外のことは何も起きていません。
llms.txtフォーマット仕様によれば、この形式には必須部分が1つと、いくつかの任意部分があります。
- サイト名を含むH1。「これが唯一の必須セクションです」
- ブロッククオートの要約。エージェントにヘルプセンターが何を扱っているかを伝えます。
- 自由記述のテキスト。ファイルの読み方に関する注意事項を記します。
- リンクのH2セクション。各行は
[名前](url): 説明の形式です。 - 慣例としての
## Optionalセクション。スペースが足りないときにエージェントが飛ばせるリンク用です。変更履歴ページによれば、バージョン2ではこれに対する特別な解析上の意味は廃止されました。
ヘルプセンターに特に関係する詳細が2つあります。第一に、ファイルはそのパス配下のURLをカバーします。そのためyourcompany.com/helpに置かれたヘルプセンターは、独自の/help/llms.txtを持てます。第二に、仕様は各ページについて、同じURLに.mdを加えたマークダウン版を求めています。ヘルプデスクにホストされたヘルプセンターの大半はこれを配信しておらず、それが以下でどの設定方法を選ぶかに影響します。
今、ヘルプセンターを誰が読んでいるか(検索エンジン、AI回答エンジン、コーディングエージェント、あなた自身のサポートボット)という大きな図を知りたいなら、私のAI可読性チェックリストが、この話より前にやるべき記事の修正を扱っています。
llms.txtはヘルプセンターに実際に役立つのか
ある種の読者には役立ち、別の種類には何も効果がありません。目的ごとに、一次資料が何と言っているかを見てみましょう。
| 求めるもの | llms.txtは役立つか | 根拠 |
|---|---|---|
| Googleの順位向上 | いいえ | Googleは「不要なAIテキストファイル(llms.txtなど)」を無視してよいとしている(AI最適化ガイド) |
| AI OverviewsやAI Modeへの表示 | いいえ | スニペット付きでインデックスされていること以外に「追加の技術要件はない」(GoogleのAI機能) |
| ChatGPTやClaudeの回答での引用 | 未確認 | サーバーログを持つ運営者たちはAIクローラーがそれを取得しないと報告している(引用は下記) |
| コーディングエージェントによるプロダクト設定 | はい | 仕様はエージェントが「関連リンクをたどる」としており、これが最も重い用途 |
| 大きなヘルプセンターで1つの答えを見つけるエージェント | はい、ファイルが厳選されていれば | 短い索引はコンテキストに収まるが、4,000件のリンクは収まらない |
| サイトマップの置き換え | いいえ | 仕様はサイトマップを完全なリスト、llms.txtを「厳選された概要」と呼んでいる |
Googleはこの点について珍しくはっきりしています。その生成AIガイドは、「Google検索に表示されるために新しいマシン可読ファイル、AIテキストファイル、マークアップ、Markdownは必要ない」と述べています。なぜなら「Google検索自体がそれらを使わない」からです。ChromeのLighthouse llms.txt監査は、ファイルがないことを対象外として扱います。「現時点ではファイルを提供することは任意」だからで、リクエストがサーバーエラーを返したときだけ指摘します。
導入はまだ小さいです。HTTP Archive Web Almanac 2025は、2025年7月のクロールでllms.txtがデスクトップサイトの2.13%、モバイルサイトの2.10%にあったと発見し、そのうち39.6%は単一のWordPress SEOプラグインから来ていたため、その一部は意図的な選択ではまったくありませんでした。
サーバーログの報告はそれと一致します。
"I can definitively say llms.txt is not used by any AI players. I run a blogging platform with around 80k blogs and /llms.txt is not requested by anything (other than humans checking to see if there's an llms.txt path)."

賛成の立場は、わざとエージェントにファイルを手渡す人たちから来ています。
"It's a single link you can give your AI agent and ask to "read this, understand it does, implement it"."
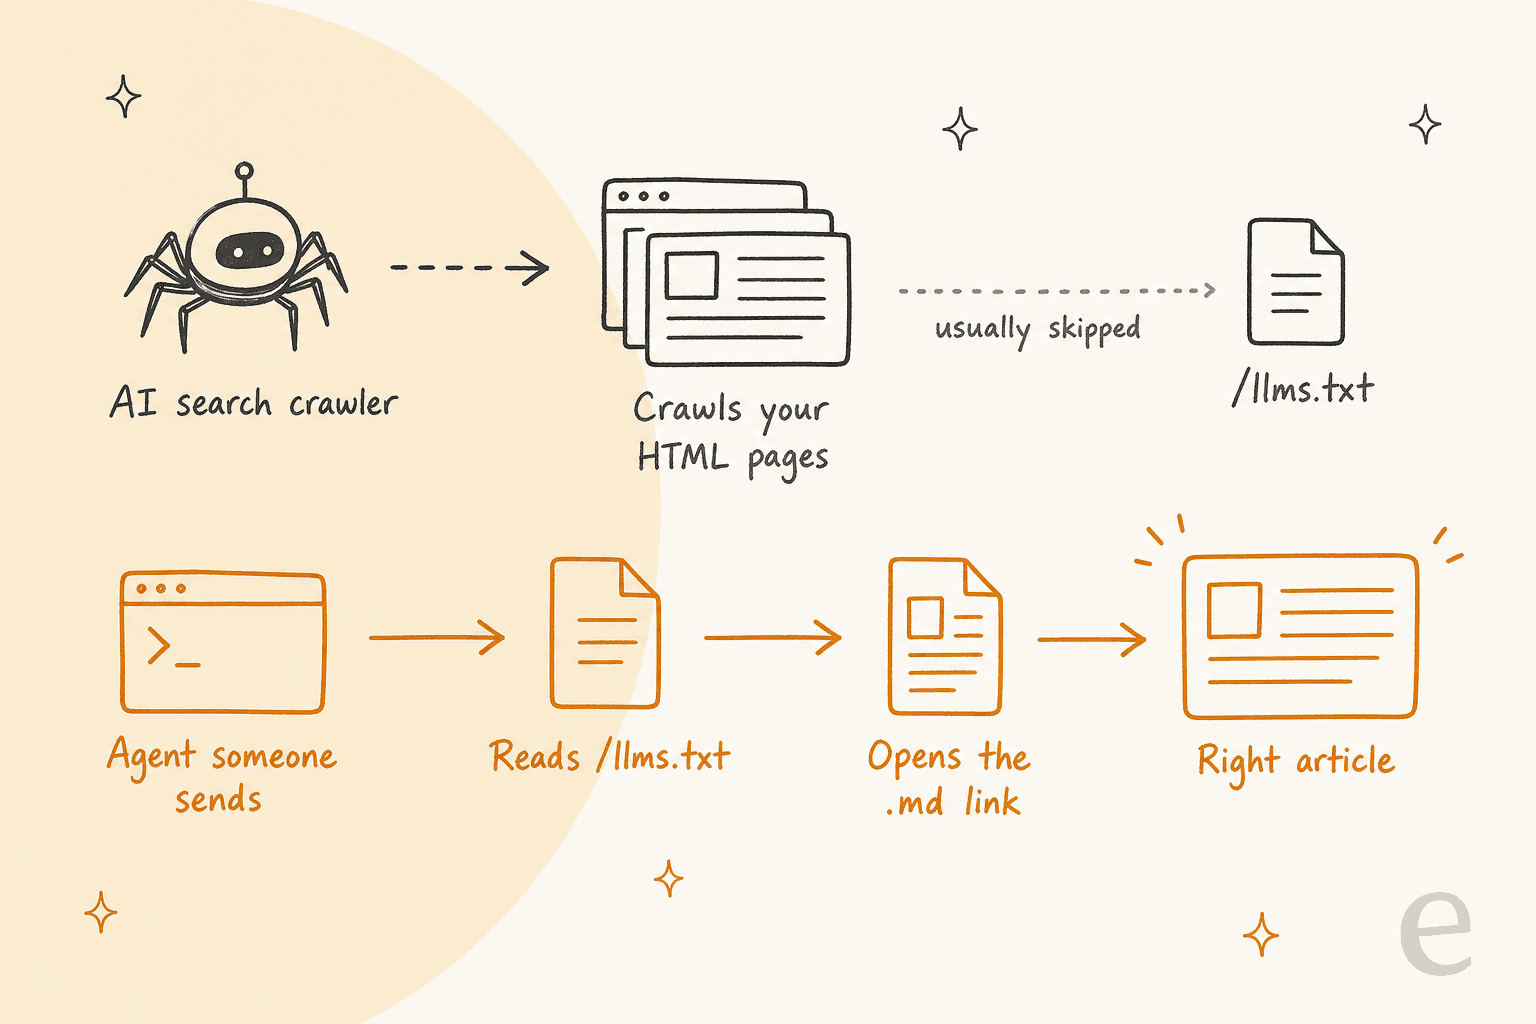
つまり、正直な結論はこうです。llms.txtは、わざわざ探しに来るエージェントに引き出されるものであり、検索インデックスに押し込まれるものではありません。ヘルプセンターにとって、その読者とはAPIを接続する開発者、ヘルプURLをAIアシスタントに貼り付けた顧客、あるいは返金ポリシーを確認するパートナーのエージェントです。どれもあなたに関係しないなら、その1時間は記事に投資したほうがいいでしょう。AI回答エンジンがどのように出典を選ぶのか気になるなら、私のAI検索エンジンの解説でその側面を扱っています。
どのヘルプセンタープラットフォームが/llms.txtを公開できるか
これはほとんどのllms.txtガイドが飛ばす質問であり、どれだけの作業量になるかを決めます。あなたのヘルプセンタープラットフォームは3つのグループのいずれかに当てはまります。
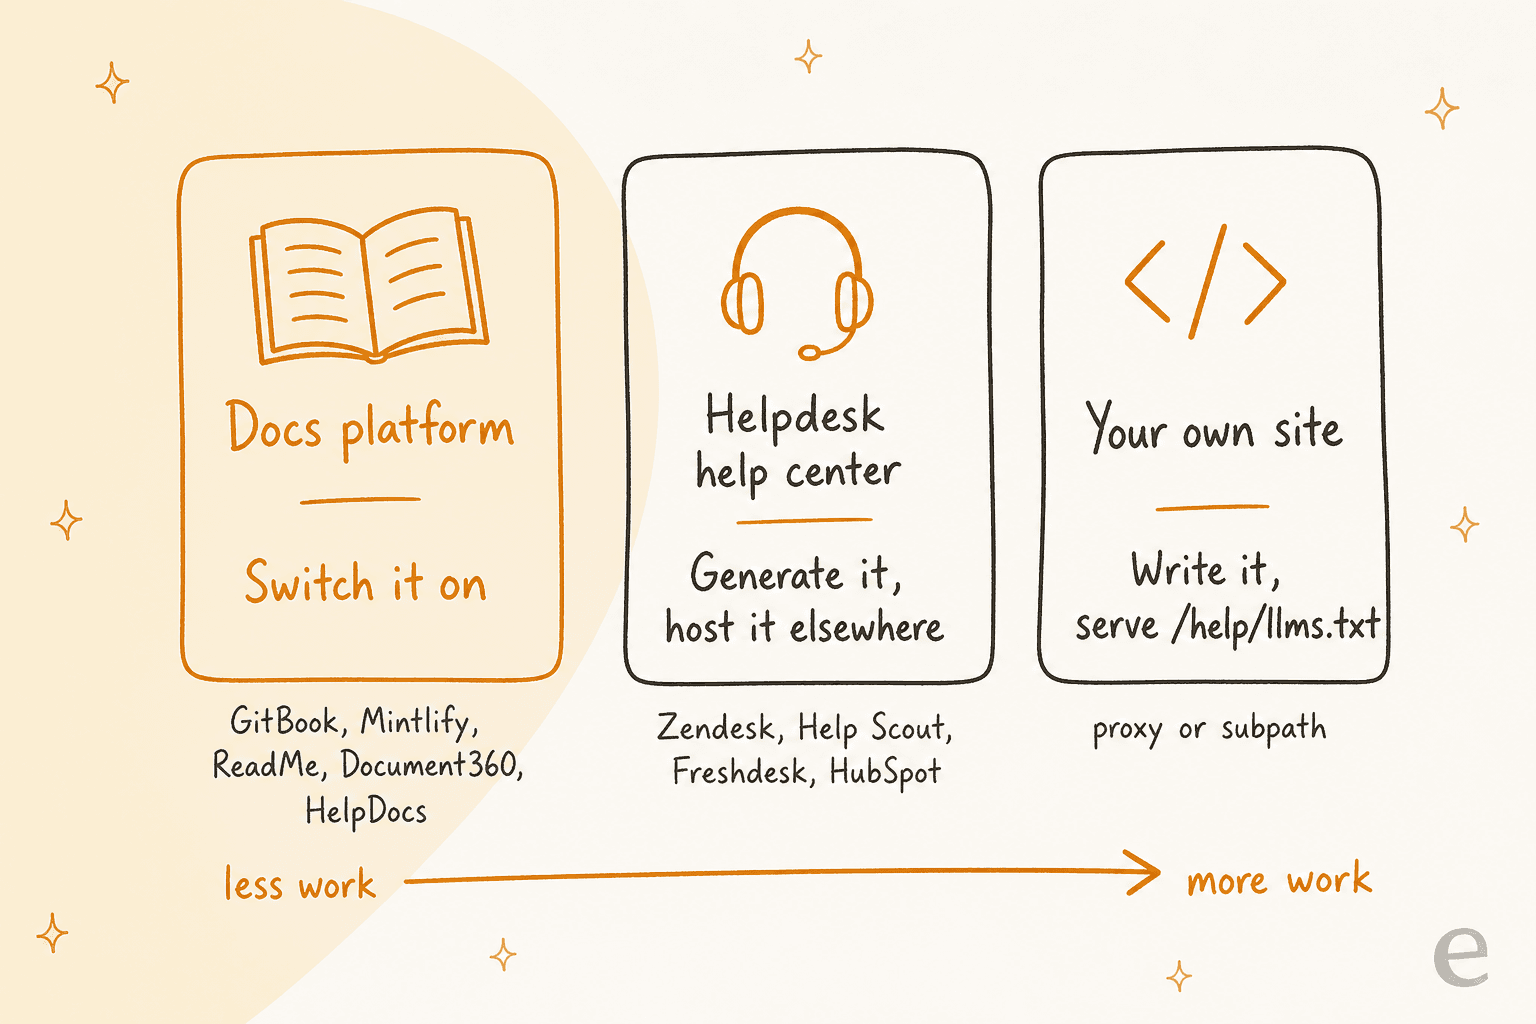
2026年11月17日に各ベンダー自身のドキュメントを確認しました。現状は以下の通りです。
| プラットフォーム | llms.txt | llms-full.txt | 厳選のコントロール | 注意点 |
|---|---|---|---|---|
| GitBook | Freeを含む全プランで自動 | あり | 文書化なし | 非公開ページもllms-full.txtには残る |
| Mintlify | 自動、/.well-known/llms.txtにも | あり | 非公開・noindexページは除外、カスタムファイルで上書き可能 | 生成ファイルは10万文字で上限、超えると分割 |
| ReadMe | 全プランでデフォルト有効 | 文書化なし | 非公開ページは除外、カスタムファイル可 | カスタムファイルにすると自動更新が止まる |
| Document360 | 自動、公開時に再構築 | 文書化なし | 検索エンジンから記事を除外すると、llms.txtからも外れる | 説明のない記事はタイトルのみで表示 |
| HelpDocs | Settings、AIの切り替えスイッチ、全プランで | 文書化なし | 文書化なし | 非公開ヘルプセンターはファイルを生成しない |
| Zendesk Guide | 標準機能なし | Marketplaceアプリ経由 | アプリでカテゴリ、セクション、ラベルを除外可能 | ファイルは自分でホストする |
| Help Scout Docs | ドキュメントに言及なし | なし | n/a | 自分で生成してホストする |
| Freshdesk | ドキュメントに言及なし | なし | n/a | 自分で生成してホストする |
| HubSpotナレッジベース | ドキュメントに言及なし | なし | n/a | 自分で生成してホストする |
各行の出典は以下のセクションにリンクしています。
自動で作ってくれるドキュメントプラットフォーム
ヘルプセンターがドキュメントプラットフォーム上で動いているなら、作業はほぼ完了しています。GitBookのドキュメントは、llms.txt、llms-full.txt、各ページの.md版を含め、「AIフレンドリーな形式を自動的に公開する」と述べています。見落としやすい落とし穴が1つあります。「Hiding a page only removes it from the published table of contents」とあり、非公開にしたページもllms-full.txtには残ります。エージェントに読ませたくないものは公開を取り消してください。カスタムドメインにどのプランが必要かは、私のGitBookの料金の解説で扱っています。
Mintlifyは最も細かいコントロールを提供します。非公開・noindexページを除外し、独自のllms.txtを入れて生成版を上書きでき、部分的に認証されたサイトでは匿名の訪問者には公開ページのみを一覧表示します。
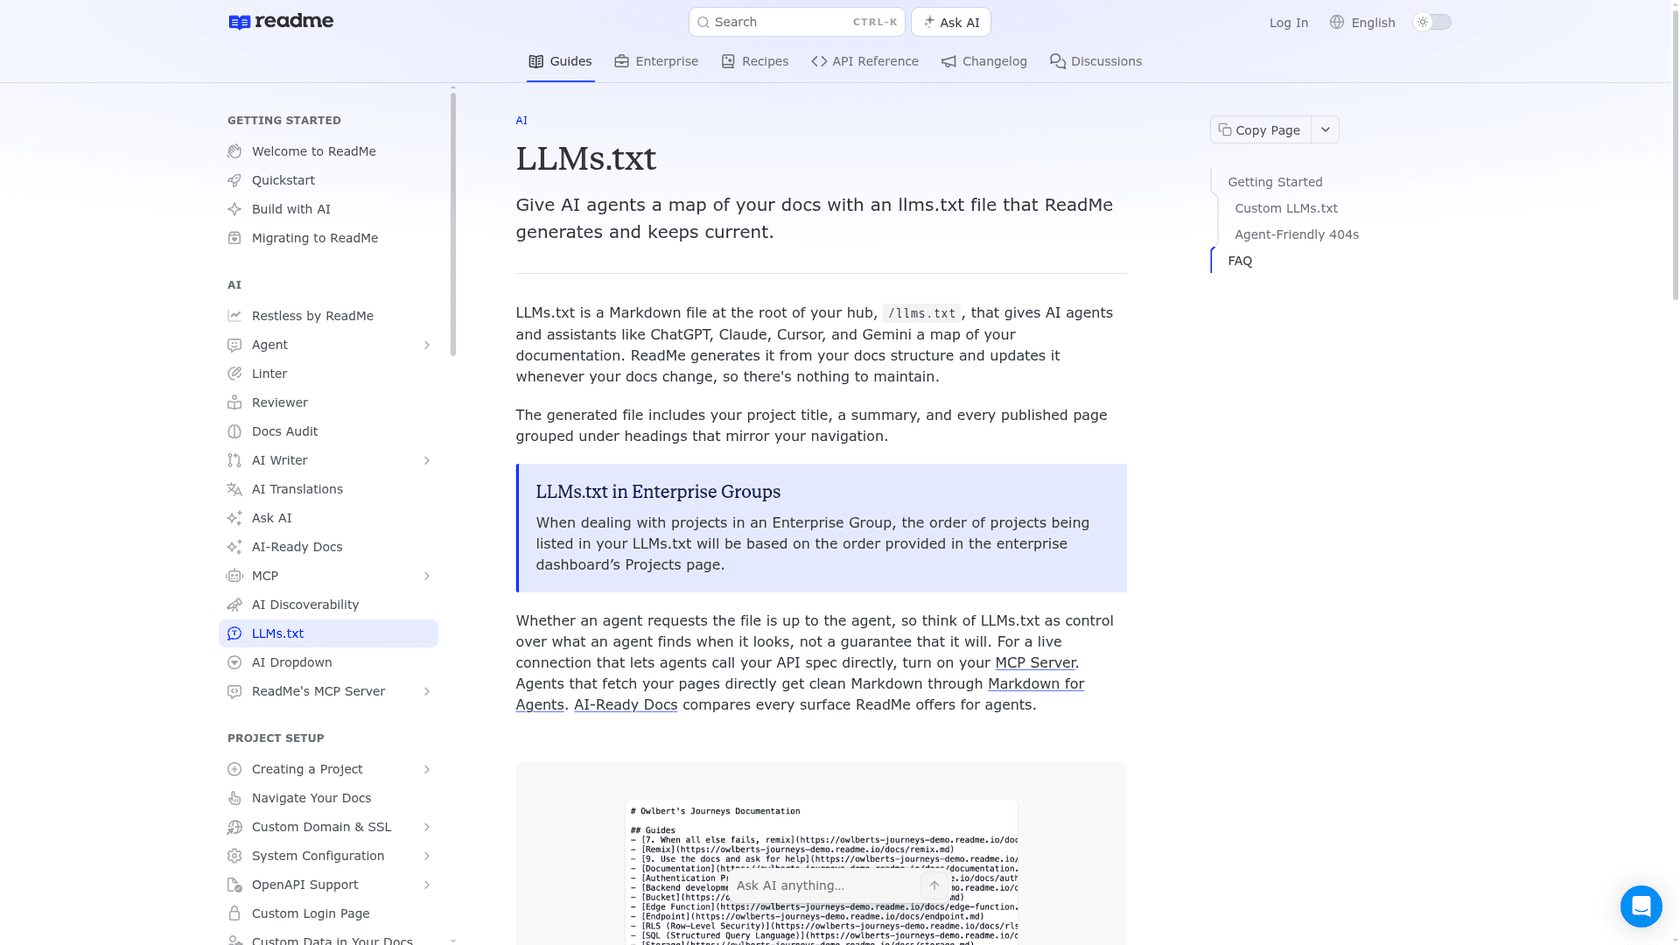
ReadMeのllms.txtページは、そのファイルが何をできて何をできないかについて率直です。「think of LLMs.txt as control over what an agent finds when it looks, not a guarantee that it will.」
Document360は公開済みのコンテンツからファイルを構築し、「whenever you publish, update, or remove content」更新します。説明は各記事の検索説明から来るため、説明がない記事はタイトルだけで現れ、エージェントにはほとんど選びようがありません。この点でナレッジベースのベンダーを比較しているなら、私のDocument360の代替のリストが良い出発点です。
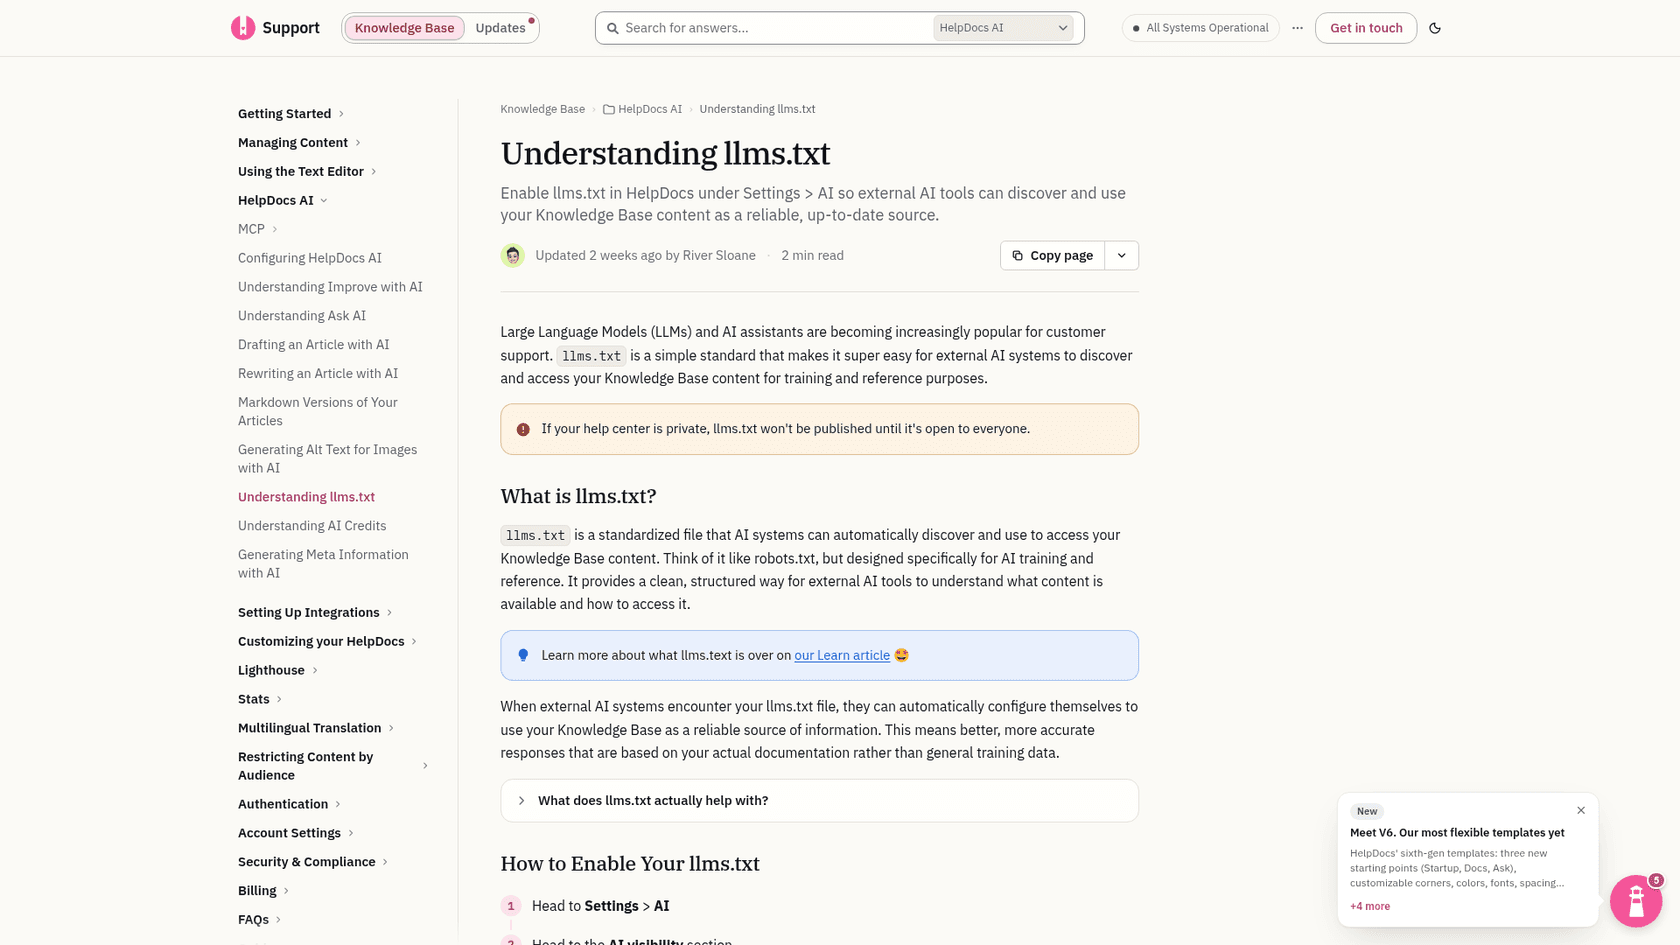
HelpDocsは最も新しい追加です。2026年10月14日の更新により、マークダウン記事とllms.txtが「available now, on every plan」になり、Settings、AI、AI visibilityの下で有効にします。
まだ対応していないヘルプデスクのヘルプセンター
ヘルプデスクに付属するヘルプセンターは話が違います。Zendesk Guide、Help Scout Docs、Freshdesk、HubSpotのナレッジベース、Helpjuice、Zoho Deskのドキュメントでllms.txt機能を探しましたが、見つかりませんでした。2026年11月17日には、各ベンダー自身のヘルプセンターに対して/llms.txtを実際に要求してみました。
| ヘルプセンター | 2026年11月17日の/llms.txt |
|---|---|
| support.zendesk.com | 404 |
| docs.helpscout.com | 404 |
| support.freshdesk.com | 404 |
| knowledge.hubspot.com | 404 |
| docs.gorgias.com | 200、.md記事リンクあり |
| help.shopify.com | エージェント向けガイドへの308リダイレクト |
Gorgiasは興味深い例外です。自社のヘルプセンターは.mdリンク付きのファイルを配信していますが、それを顧客機能として提供すると述べるヘルプ記事は見つけられなかったので、頼りにする前に自分のGorgiasヘルプセンターを確認してください。
Zendeskについては、制限が文書化されています。Guideでは.txtファイルをテーマアセットとしてアップロードできますが、それらはCDNパス上にあり、/llms.txtではありません。ホストマッピングはsupport.yourcompany.comをCNAMEでZendeskに向けるだけで、それ以外は何も変わりません。その設定の詳細は私のサブドメインとカスタムドメインのガイドで扱っています。
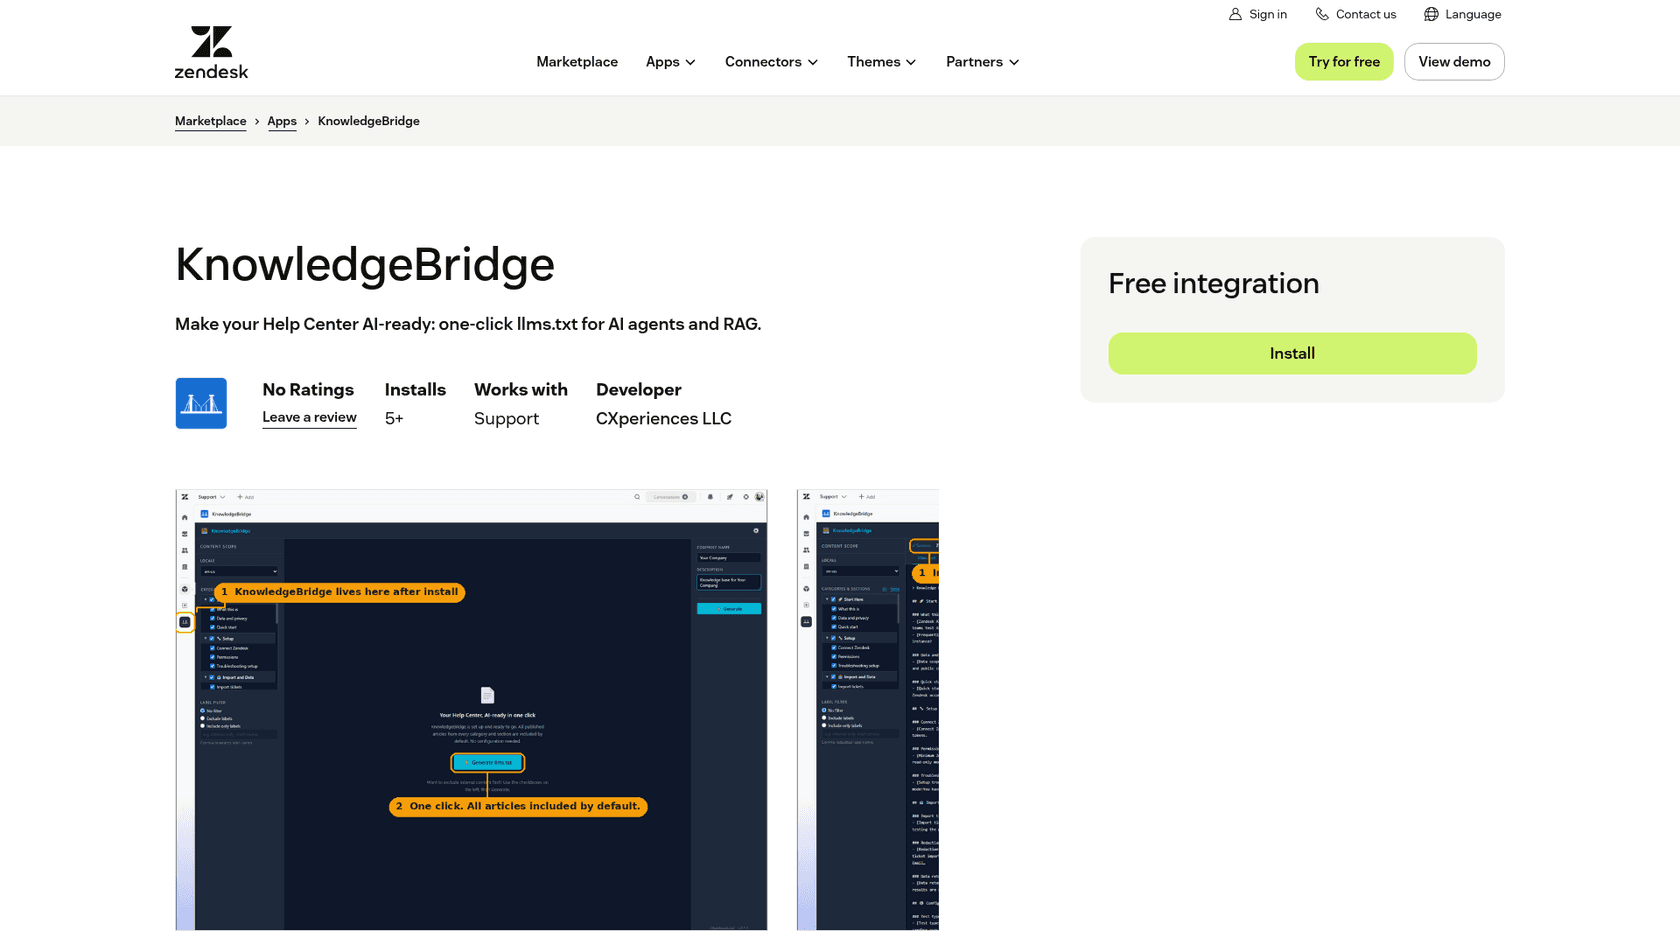
最も標準機能に近いのはKnowledgeBridgeです。CXperiences LLCによる、5件以上のインストールがある無料のMarketplaceアプリで、ヘルプセンターからllms.txtとllms-full.txtを構築し、カテゴリ、セクション、ラベル付き記事を除外できますが、出力はダウンロードです。その設定手順自体が、ファイルを自分のドメインでホストするよう案内しています。
Zendesk、Help Scout、Freshdeskにllms.txtを追加するにはどうすればいいか
別の場所でファイルを生成し、ルートを管理できる場所でホストします。数百件の記事があるヘルプセンターで、最初から最後まで約1時間でできる設定を紹介します。
- ファイルの置き場所を決める。 簡単な選択肢はメインサイトです。
yourcompany.com/llms.txtに、ヘルプセンターの記事にリンクする## Help centerセクションを置きます。マーケティングサイトにすでにllms.txtがある場合(WordPress SEOプラグインがよく生成します)は、2つ目を作る代わりにそのファイルにセクションを追加してください。より強い選択肢は、ヘルプセンターがリバースプロキシ経由でyourcompany.com/helpのようなサブパス下にある場合の/help/llms.txtです。仕様はより具体的なファイルが優先されると述べています。 - 公開記事のリストを取得する。 ZendeskのList Articlesエンドポイントはログインなしで動作し、「the response lists only the articles that the requesting agent, end user, or anonymous user can view」とあるため、匿名呼び出しが制限付き記事を漏らすことはありません。ページングについては私の記事APIの解説で扱っています。FreshdeskではナレッジベースAPIが同じ仕事をし、Help Scoutには独自のDocs APIがあります。
- 絞り込んで説明を書く。 スプレッドシートで作業したい場合は、ヘルプセンターのエクスポートから始めましょう。チケットの大半に答える30から100件の記事を取り出し、実際のカテゴリ名でグループ化し、各記事がどの質問に答えるかを示す1行を書きます。
- アップロードしてリンクする。 ファイルをメインサイトに置き、ヘルプセンターのフッターからリンクして、人間(とヘルプセンターから始めるエージェント)が見つけられるようにします。
- 仕様通りにテストする。 llmstxt.orgによれば、「Test your file by asking an agent questions about your content, giving it only your llms.txt as a starting point」です。チームが最も多く答える5つの質問をして、エージェントがどの記事を開くかを確認してください。
Zendeskでのステップ2として、これは公開されている英語記事を新しい順に、すぐ編集できるリスト行として取得します。
curl -s "https://support.yourcompany.com/api/v2/help_center/en-us/articles.json?per_page=100&sort_by=updated_at&sort_order=desc" \
  | jq -r '.articles[] | select(.draft == false) | "- [\(.title)](\(.html_url)): "'
出力をテンプレートに貼り付け、説明は手作業で入力してください。Zendeskで厳選がなぜ重要かを見るために、同じ呼び出しをZendesk自身のヘルプセンターに対して行ったところ、2026年11月17日時点で英語記事4,687件と報告されました。そのリストをエージェントに読ませたい人はいません。
Zendesk特有の注意点が2つあります。ユーザーセグメントで記事を制限している場合、匿名呼び出しはそれらを静かに除外します。これは望ましい動作ですが、記事を手作業で追加する前に再確認してください。また、複数のブランド別ヘルプセンターを運用している場合は、各ブランドに専用のセクション、またはブランドドメインごとの専用ファイルを用意し、エージェントが2つの返品ポリシーを混同しないようにしましょう。
ヘルプセンターのllms.txtはどのようにすべきか
短く、顧客が尋ねる質問でグループ化し、文脈を持たない読者向けに書きます。コピーできるテンプレートを紹介します。
# Acme Help Center

> Official help for Acme customers: setting up an account, billing and invoices,
> shipping and returns, and connecting Acme to other tools. Answers here are
> current; if an article and an old blog post disagree, the article wins.

Articles are written for customers, not admins. For API reference, see
https://developers.acme.com/llms.txt. To reach a person, see "Contact support" below.

## Getting started

- [Create your Acme account](https://help.acme.com/en-us/articles/101): Sign-up steps, email verification, and what the free trial includes.
- [Invite your team](https://help.acme.com/en-us/articles/102): Adding users, roles and seat limits.

## Billing

- [Change or cancel your plan](https://help.acme.com/en-us/articles/201): Upgrades, downgrades, cancellation and when changes take effect.
- [Refund policy](https://help.acme.com/en-us/articles/202): Who qualifies for a refund, the 30-day window, and how to request one.

## Shipping and returns

- [Start a return](https://help.acme.com/en-us/articles/301): The returns portal, return labels and what items can't be returned.

## Contact support

- [Contact support](https://help.acme.com/en-us/articles/401): Hours, channels and what to include so we can help faster.

## Optional

- [Release notes](https://help.acme.com/en-us/articles/501): Product changes by month.
- [Full sitemap](https://help.acme.com/sitemap.xml): Every public article.
ここにはいくつか意図的な選択があります。
- ブロッククオートはどの出典が優先されるかをエージェントに伝えます。 サポートコンテンツはブログ記事、古いマクロ、アーカイブされた記事の間で矛盾することがあります。ヘルプセンターが最新の出典だと伝える1行があれば、エージェントが2023年のブログ記事を引用することを防げます。
- 説明はトピックではなく質問を名指しします。 「Who qualifies for a refund, the 30-day window, and how to request one」は、エージェントが顧客の質問に一致させるのに役立ちます。「Refund information」ではそれができません。これは良いメタディスクリプションを書くのと同じ作業で、そのまま再利用できることも多いです。
- サポートへの問い合わせは独自のセクションを持ちます。 Shopifyのヘルプセンターも同様のことをしています。そのファイルは、エージェントにまず現在の記事から答えるよう、そして加盟店に代わってサポートに連絡する前にサポートガイドを読むよう求めています。
- 開発者向けドキュメントは統合ではなく誘導を受けます。 APIがあるなら、エンドポイントをヘルプセンターのファイルに詰め込むのではなく、その独自のllms.txtをリンクしましょう。
すべての記事を載せるべきか、厳選すべきか
厳選すべきです。仕様全体の目的は、エージェントのコンテキストに収まるファイルであり、成熟したヘルプセンターの全記事リストはそれに収まりません。2026年11月17日に取得した3つの実際のヘルプセンターのllms.txtファイルがどれだけの重さだったかを紹介します。
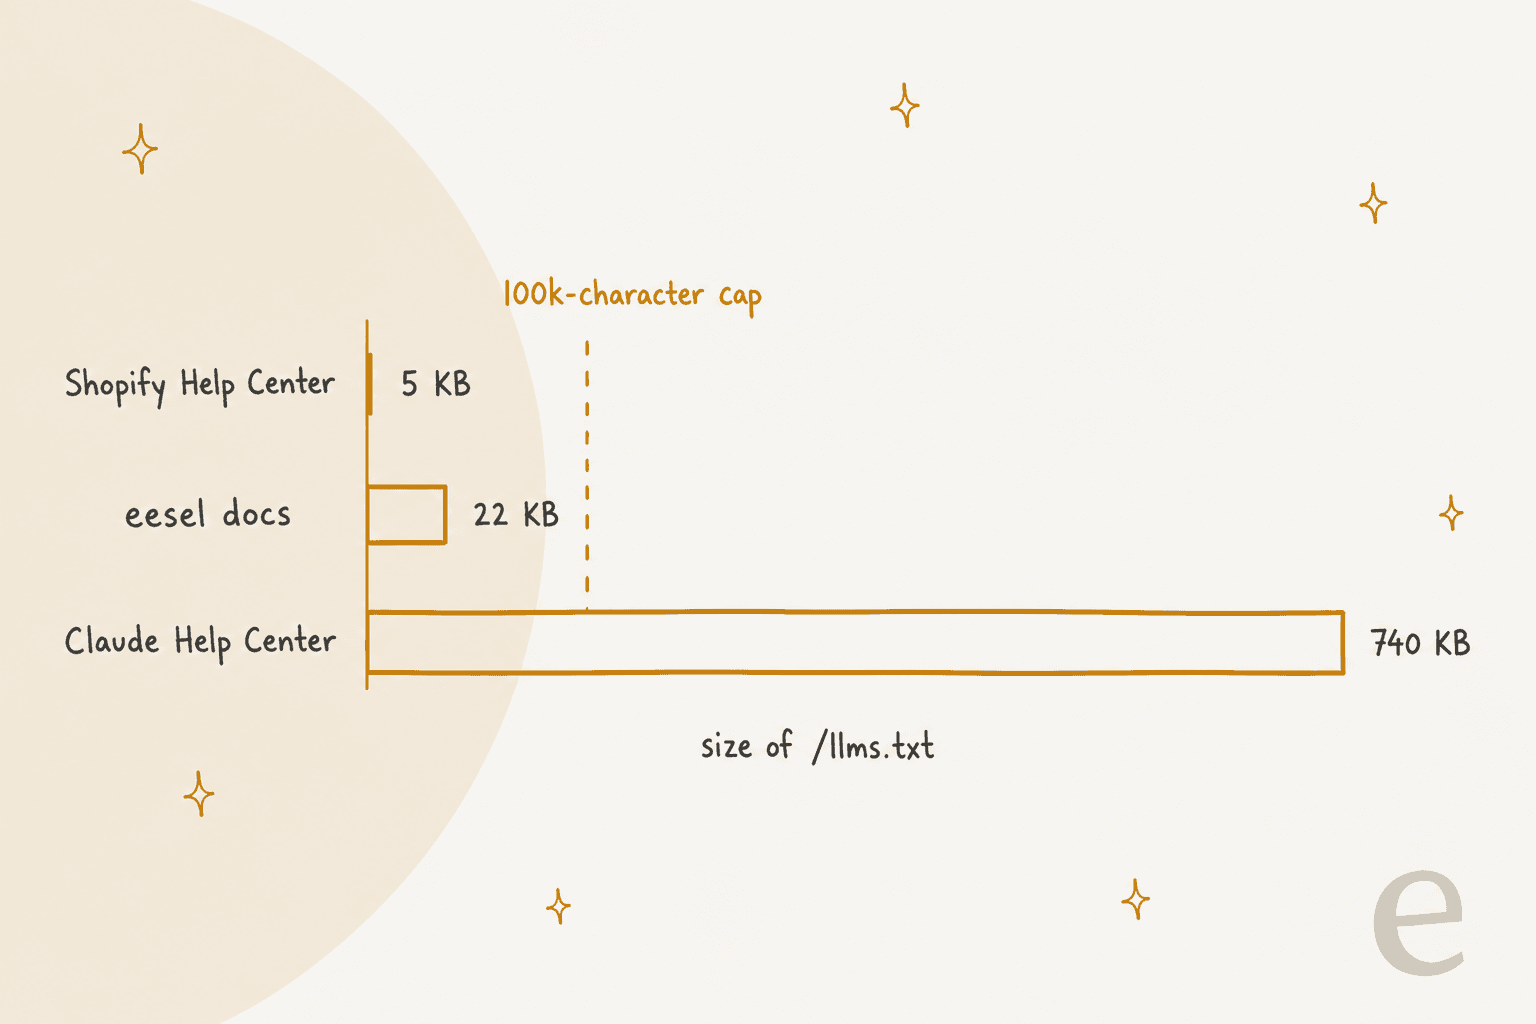
- Claudeヘルプセンター:740KB、4,528リンク。 すべての記事が、10以上の言語セクションにわたって繰り返されています。
- eesel自身のドキュメント:22KB、86リンク。それぞれに1行の説明があります。GitBookによって生成され、eeselのヘルプセンター全体をカバーしますが、プロダクトのドキュメントが小さいため小規模です。
- Shopifyヘルプセンター:5KBで記事リストはまったくなし。 これはエージェント向けガイドです。どのページもマークダウンとして取得する方法、URLの仕組み、マークダウンのサイトマップの場所を示しています。
比較として、Mintlifyはllms.txtのドキュメントによれば、生成するllms.txtを10万文字で制限し、それを超えると小さな索引に分割します。ReadMeはAI Discoverabilityページによれば、同じ理由で「Summarize Index」というオプションを提供しています。
次にllms-full.txt、各ページの全文を含む単一ファイルがあります。これは現行の仕様にはまったく含まれていません。変更履歴ページは、コンテキスト拡張のためのツール群は「is no longer part of the proposal」としています。それでもGitBookとMintlifyは生成を続けており、eeselのものは1.3MBに達します。これはあなたのドキュメントをリポジトリにダウンロードしたい開発者には有用ですが、1つの返金に関する質問に答えようとするエージェントには大きすぎます。
私の経験則はこうです。約100記事未満なら、すべてを説明付きで載せます。それを超えるなら、チケット量で上位30から100件を載せ、残りはShopifyがエージェントをマークダウンのサイトマップに誘導するように、## Optionalでサイトマップへ誘導します。どの記事が負荷を担っているかを見つけるには、検索クエリを記事に対応付け、あなたのエージェントが最もリンクしている記事を確認する方が、当てずっぽうより速いです。
llms.txtを最新に保つにはどうすればいいか
古くなったllms.txtは、ないよりも悪いです。移動または削除された記事へ、自信を持ってエージェントを送り込んでしまうからです。どれだけ手間がかかるかは設定方法によります。
- 生成ファイルは自分で更新されます。 Document360とReadMeは公開時に再構築し、Mintlifyはそのバージョンを「always up to date」と呼んでいます。
- カスタムファイルは固定されます。 ReadMeは、カスタムファイルにすると「your llms.txt will no longer be updated automatically」とはっきり述べています。Mintlifyは、自分のカスタムファイルを削除すれば生成版を復元するので、いつでも戻せます。
- 自前でホストするファイルにはスケジュールが必要です。 他の自己更新型ナレッジベースプロセスと同様に、記事の取得を毎月、またはカテゴリを再編成するたびに再実行しましょう。新しいリストと古いリストを比較し、削除されたURLを検出する小さな定期ジョブが、ほとんどの破損を捉えます。
再生成するたびに、リンクを確認してください。この1行は、ファイル中で200を返さないURLをすべて出力します。
grep -oE 'https://[^)]+' llms.txt | while read u; do
  code=$(curl -s -o /dev/null -w '%{http_code}' -L "$u"); [ "$code" != "200" ] && echo "$code $u"
done
移動した記事が、たいてい原因です。Zendeskの移動した記事のリダイレクトは人間向けには古いリンクを機能させ続けますが、厳選されたファイルはエージェントが無駄なホップをしないよう、現在のURLを指すべきです。古い記事が繰り返し問題になるなら、古いコンテンツの検出に関する私のガイドが、人間であれAIであれ、どの読者にも届く前にそれらを捕える方法を扱っています。
ローカライズされたヘルプセンターについては、言語ごとに決めましょう。多言語ヘルプセンターは、言語ごとに1つのファイルを持つこともできますし、デフォルト言語のファイル1つに言語URLの仕組みに関する注記を加えることもできます。これはShopifyがやっている方法です。
何かがそれを読んでいるかをどう知るか
ダッシュボードは教えてくれないので、ログを確認してください。Webサーバーまたはcdnのログを/llms.txtへのリクエストでフィルタし、ユーザーエージェントを見てください。ドキュメントプラットフォームの2つはこれを代わりにやってくれます。HelpDocsはAI統計タブで認識済みのAIツールからのリクエストを表示し、GitBookにはAgents & MCPレポートがあります。
すでに調べた人たちから、期待値を設定しましょう。
"What I've seen from ASNs is that visits are coming from GOOGLE-CLOUD-PLATFORM (not from Google itself), and OVH. Based on UA, users are: WebPageTest, BuiltWith, and zero LLMs based on both ASN and UA."
数える価値のある訪問は、ユーザーが始めたものです。OpenAIのChatGPT-Userのように、そのクローラードキュメントが自動クロールではなく人間が引き起こす訪問だと説明しているもの、それに加えてコーディングツールからのリクエストです。それがllms.txtの想定読者です。四半期後も数字がゼロに近いままなら、それがそのヘルプセンターについての答えであり、その1時間は記事そのものに投資するか、静的なリストを渡す代わりにライブで質問に答えるMCPサーバーに投資したほうがいいでしょう。
サポートAIにllms.txtは必要か
ヘルプデスクに接続しているなら不要です。llms.txtは、あなたのURLしか持たない外部のエージェントのために存在します。あなた自身のサポートAIはそのどちらでもあるべきではありません。公開されているすべての記事を直接読むべきであり、さらにヘルプセンターには決して載らないマクロや過去のチケットも読むべきです。
これがeeselのAIヘルプデスクのチームメイトの動き方です。Zendesk、Freshdesk、Help Scout、HubSpot、Gorgiasに接続し、ヘルプセンターをナレッジソースとして同期し、使用した記事のリンク付きで返信を作成または送信します。Zendeskを使うデンマークの法律文書サービスDokument 24は、自社サイトの約1,900ページとZendeskの640件のチケット・記事に対してこれを運用し、2026年8月8日から9月8日の間に、チームが送信するためのデンマーク語の返信案を約680件のチケット分用意しました。
llms.txtが直せないのは、記事が何を言っているかという部分です。私が学んだあるeeselの商談で、Zendeskを使うデンマークの車両テレマティクスチームは、ある記事が「すべてのモデル」を対応していると書いていたために、対応していない車種をボットが対応していると確認してしまっていたと話していました。完全に厳選されたllms.txtがあったとしても、まさにその記事を指すだけだったでしょう。修正すべきはその一文であり、索引ではありませんでした。だからこそ、ナレッジベースの監査は通常、新しいファイルより優れています。ヘルプセンターについてRAGとファインチューニングを比較検討しているなら、同じ点が当てはまります。検索は記事が言っていることしか返しません。
eesel:ヘルプセンターにチケットを答えさせる
一番気にかけているAIが顧客に答えるものであるなら、そこから始めましょう。eeselのヘルプデスクのチームメイトは、接続した日からヘルプセンターを学び、llms.txtは不要で、どの記事が弱い返信案を生むかを教えてくれます。ある産業オートメーション企業は、技術文書だけから答えるeeselのチャットの裏に技術ライブラリを置き、その回答の中にあるギャップは今やドキュメントチームのバックログに直接入っています。それが、ヘルプセンターをAIであれ人間であれすべての読者にとって良くしていく循環です。
開発者はダッシュボードなしで設定できます。eesel CLIを使えば、コーディングエージェントがeesel files uploadで承認済みのポリシーファイルをアップロードし、ヘルプセンターの同期が何を保持しているかを確認し、何かが顧客に届く前にeesel chatでテストの質問をすることができます。ヘルプデスク自体の接続には、依然として管理者権限を持つ誰かの承認が必要です。eeselを試すなら7日間無料で、直近の10件のチケットを通してみてください。
よくある質問
ヘルプセンターにllms.txtは必要ですか?
Zendeskのヘルプセンターにllms.txtを追加するにはどうすればいいですか?
/llms.txtでファイルを配信する設定がなく、ホストマッピングはホスト名しか変えません。ヘルプセンターAPI(匿名呼び出しは公開記事のみを返します)か、無料のKnowledgeBridge Marketplaceアプリでリストを生成し、ヘルプセンターからのリンク付きでメインサイトにホストしてください。リスト呼び出しについては私の記事APIガイドで解説しています。