

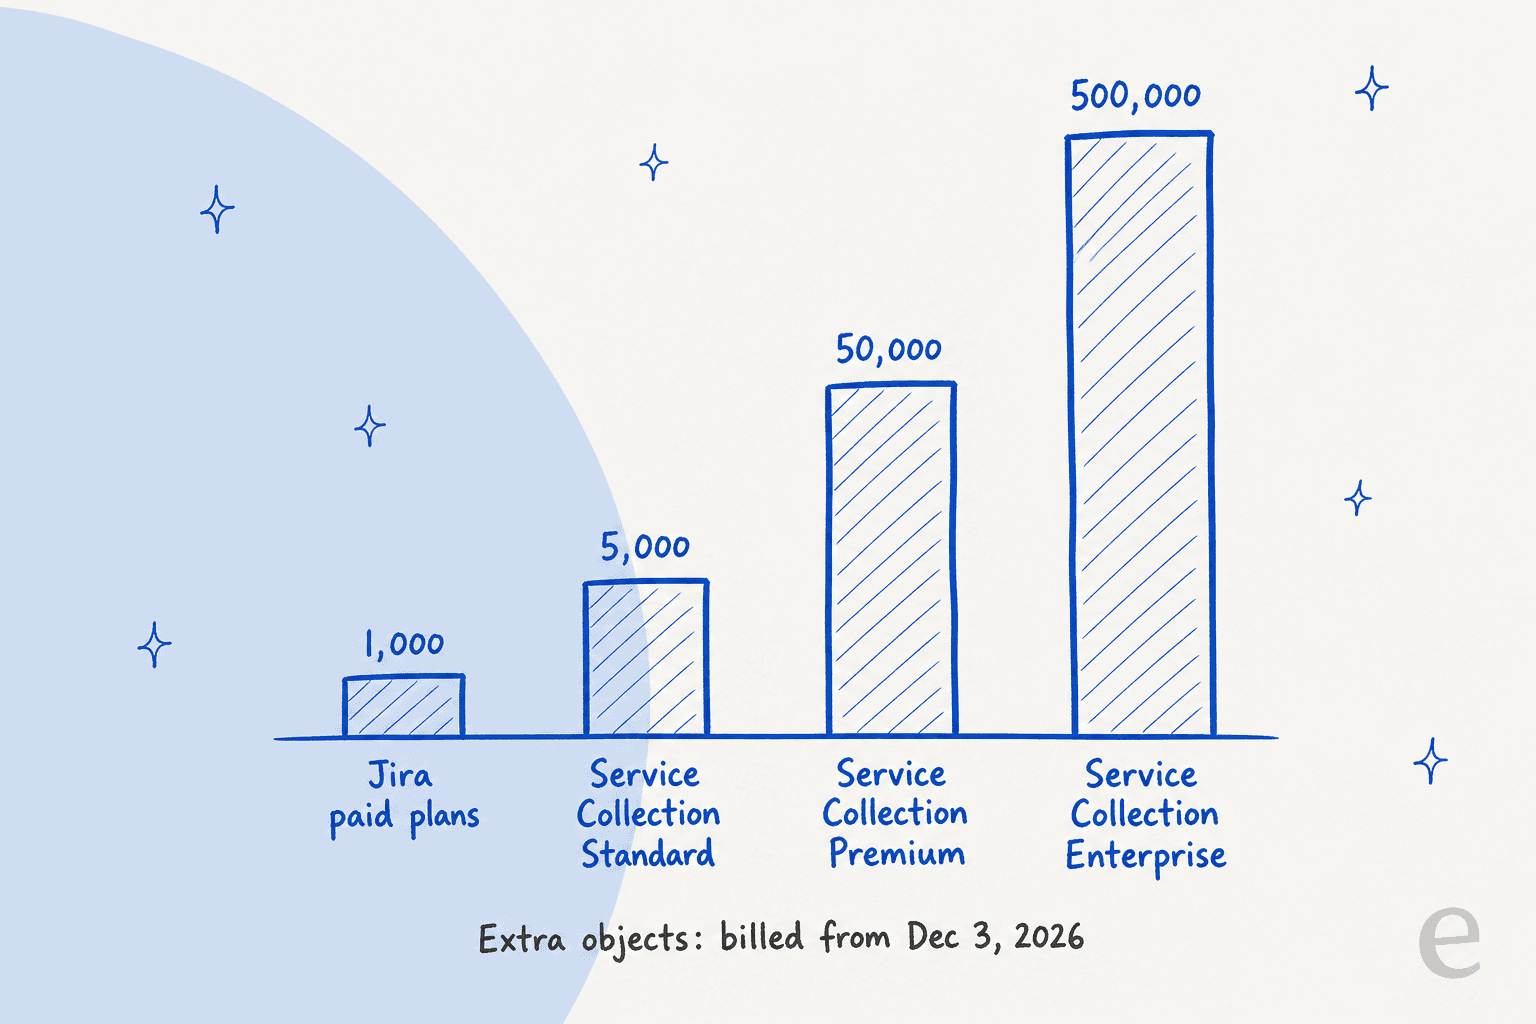
Jira Service Management AssetsはAtlassianのCMDBだ。追跡するものを属性つきのオブジェクトとして記述し、参照でつなぎ、リクエストやインシデント、変更に紐づける。プランにはオブジェクトの上限があり、Standardで5,000、Premiumで50,000、Enterpriseで500,000で、Atlassianはそれを超えるオブジェクトの課金が2026年12月3日に始まるとしているので、構築する前にスキーマの規模を見積もるべきだ。最も重要なスキルはモデリングで、独自の所有者・ライフサイクル・参照が必要なものにはオブジェクトを1つ、それ以外には属性を使う。eeselはキュー側に座り、承認済みのアセットのメモから「自分のノートパソコンはどれ?」に答えつつ、レコードの変更はすべてITに残せる。
私はeeselのインテグレーションとAPIを担当しているので、この機能もインテグレーターの視点で読む。データモデルはどうなっているのか、接続されたツールは何を見るのか、そしてハードな上限はどこにあるのか。このガイドのためにAtlassianのAssetsドキュメントと価格ページを読み込んだところ、いくつかは互いに矛盾していたので、以下で指摘する。eesel CLIを使えば、AIコーディングエージェントがエクスポートされたデバイス一覧やノートパソコンの買い替えポリシーなど承認済みの参照資料をアップロードし、テストの質問を投げて、何かが本番に出る前に回答を確認できる。Jiraのサイト自体の接続には、依然としてJira管理者の承認が必要だ。
Jira Service Management Assetsとは何ですか?
チームが気にかけるものすべてを追跡し、すでに行っている作業に結びつける場所だ。Atlassianの概要ページはサービス、従業員、ベンダー、契約、拠点、機器を追跡する典型的な対象として挙げており、追跡するものはすべて、それを説明する属性と他オブジェクトへの参照を持つオブジェクトとして保存されるとしている。
すでにAssetsを使っていた人にも読む価値がある2つの変化がある。
- Assetsはプラットフォームアプリになった。 Atlassianは、アプリスイッチャーからどのJiraアプリからもアクセスできるとしている。ロールのページは、Assets UserまたはApp Adminのロールを持つ人は、アプリを開くのにJiraやJSMのライセンスを必要としないと付け加えている。
- オブジェクトは今や計測対象になった。 同じバナーが2026年12月3日からの使用量ベース課金を告知しており、下のプランのセクションで扱う。
フル機能のCMDBは1つの問いに答える必要がある。何かが壊れたり変わったりしたとき、それは何に触れるのか。Jira Service Managementでは、その答えは以下で扱うリクエストと、変更管理を通じてエージェントに届く。ITSM側が初めてなら、私のITSM向けAIガイドとITILフレームワークガイドが語彙を与えてくれる。
スキーマ、オブジェクトタイプ、属性、参照はどう関係しますか?
オブジェクトスキーマはオブジェクトタイプを持ち、オブジェクトタイプはオブジェクトを持つ。Atlassianのスキーマのページは、各スキーマが独自のオブジェクトタイプ、オブジェクト、属性、アイコン、参照、ステータスを持ち、独自の権限を持つとしており、ハードウェアだけが必要な人から契約スキーマを隠すこともできる。
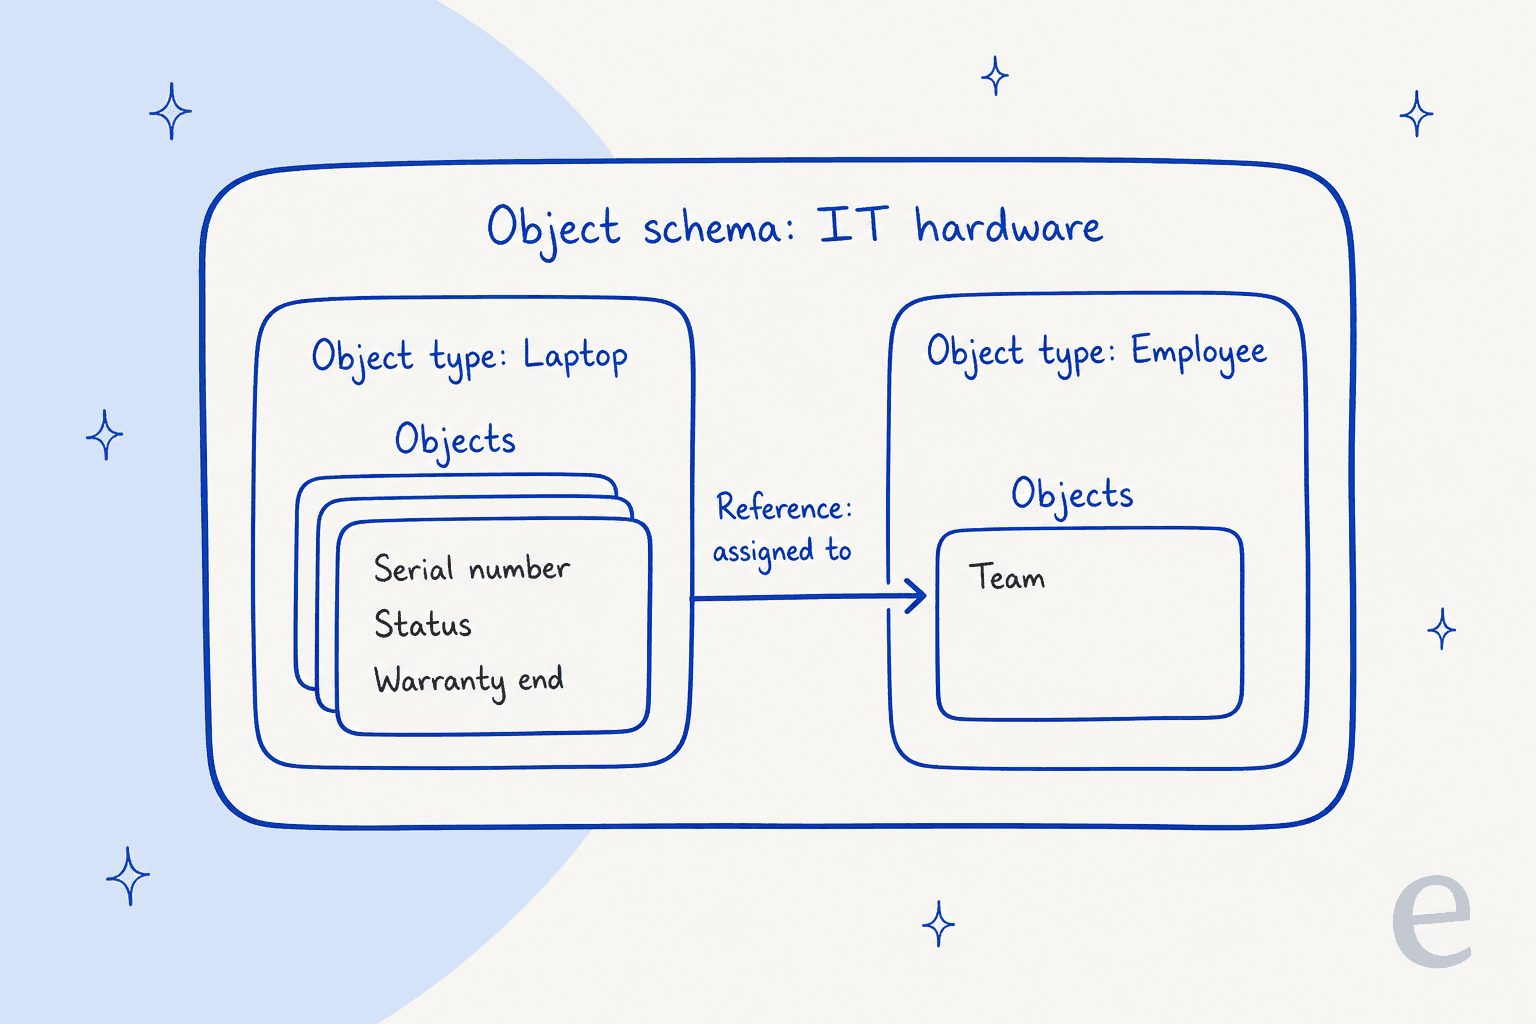
用語集はオブジェクトタイプを、同じ属性を共有する似たオブジェクトのグループと定義し、参照を、別のオブジェクトにリンクする特別な属性と定義している。オブジェクトタイプは親タイプから属性を継承することもでき、抽象オブジェクトタイプ自体はオブジェクトを持てないが親として機能する。
実践的になるのは属性タイプの話だ。Atlassianの属性タイプのページによれば、7つのグループは次のとおり。
| グループ | 保持するもの | 知っておくべき詳細 |
|---|---|---|
| デフォルト | Text、Boolean、Integer、Float、Date、DateTime、URL、Email、Textarea、Select、IPアドレス | Textは255文字、Textareaは10,000文字が上限 |
| オブジェクト | 他オブジェクトへの参照 | 最小・最大カーディナリティを設定できる |
| User | Jiraユーザーへのリンク | Userでリストを並べ替えると名前ではなくユーザーIDで並ぶ |
| Group | Jiraグループへのリンク | 見えるJiraグループは自動的に検出される |
| Project | Jiraプロジェクト | 権限から検出される |
| Status | グローバルまたはスキーマのオプションからのステータス | オブジェクトの状態を表す |
| Bitbucketリポジトリ | リポジトリへのリンク | 権限から検出される |
私が当てるとしたら、Atlassian自身の最適化ガイダンスにある設計原則を使う。項目が独自の所有者・ライフサイクル・参照・レポート・保持履歴を必要とするなら別オブジェクトを作り、それ以外は既存オブジェクトの属性にする。各契約から参照されるベンダーの方が、契約ごとに打ち直されるベンダーより良い。このアドバイスは整理整頓だけでなくコストの問題でもある。すべてのオブジェクトが上限に対してカウントされるからだ。
"The knowledge base and asset information also contribute to faster resolution of recurring tickets and better storage of critical information for future reference."

どのプランにAssetsが含まれ、オブジェクトはいくつもらえますか?
Atlassianの価格ページはAssetsをFreeには含まれず、Standard、Premium、Enterpriseにはそれぞれオブジェクトの上限付きで含まれるとしている。
| プラン | 含まれるAssetsオブジェクト | 同じページの他のAssets機能 |
|---|---|---|
| Free | 含まれない | なし |
| Standard | 5,000 | 共通データモデル、アセットディスカバリー、依存関係マッピング |
| Premium | 50,000 | Data ManagerとHardware Asset Managementを追加 |
| Enterprise | 500,000 | Premiumと同じ |
Atlassian自身のドキュメントの中で3つの点が食い違っており、予算を立てる前にAtlassianの担当者に確認したい。
- バンドルとプロダクト。 価格ページの列はAssetsを含むService Collectionバンドルだ。Assets for CloudのページはJiraのStandard、Premium、Enterpriseに1,000オブジェクト、Service CollectionのStandard、Premium、Enterpriseに5,000、50,000、500,000を挙げている。追加オブジェクトのページの課金例は、Jira Service Management Premiumと50,000オブジェクトを組み合わせており、複数のサブスクリプションの上限は合算されるので、50,000プラス1,000は51,000になる。
- サイトの上限。 使用量のページは各サイトが最大300万オブジェクトまで保持できるとしているが、技術的な上限の表では1サイトあたり1,000万のスキーマオブジェクトとしている。低い方の数字で計画するのが安全だ。
- 共通データモデル。 価格ページはStandard以上でチェックが入っているが、Atlassianの共通モデルのページは、この共通データモデルが現在はBetaプログラムの顧客にのみ提供されているとしている。4つのシステムスキーマはPeople、Geography、External organizations、Hardwareだ。
2026年12月3日に何が変わりますか?
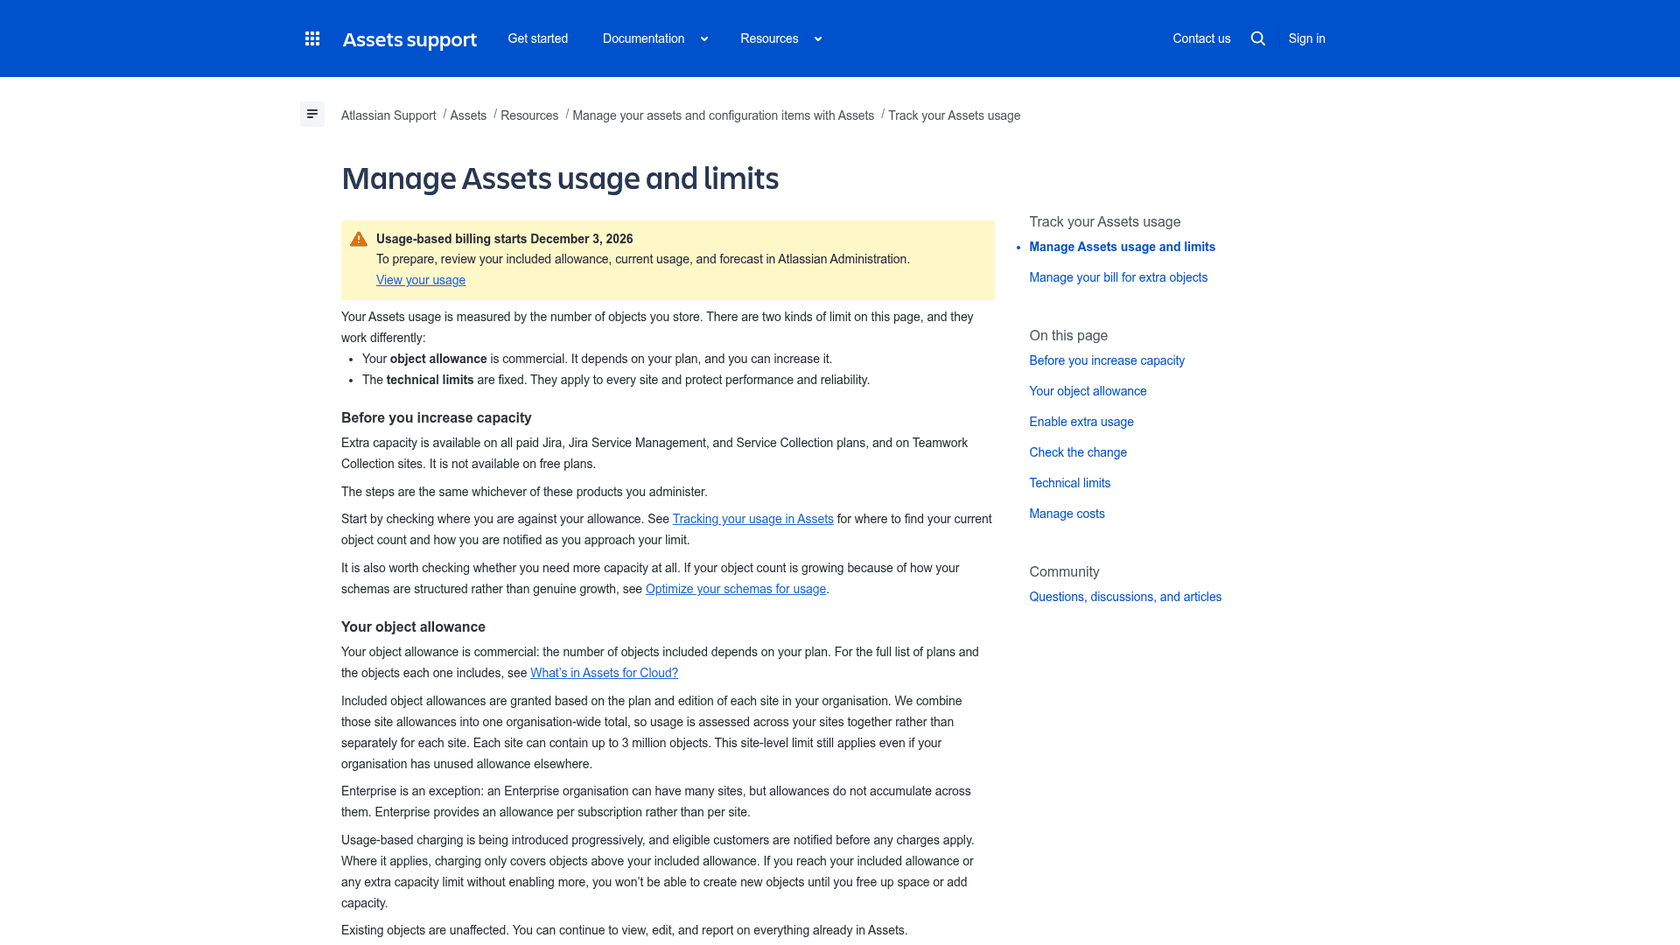
Atlassianのサポートページには、その日から使用量ベース課金が始まると告げるバナーがある。課金されるのは含まれる上限を超えたオブジェクトだけで、ボリューム割引付きの前払いオブジェクトパックか、超過分の実使用量に基づく後払いのどちらかになる。Atlassianはこれらのページでオブジェクトあたりの単価を公開しておらず、Atlassian Administrationで自分の単価を確認するよう案内しているため、ここで価格は示せない。使用量のページは上限の80%と、再び100%で通知されるとしている。
すべてがカウントされるわけではない。Software RegistryとBusiness Portfolioのスキーマ、段階的に廃止されるServicesスキーマ、サンドボックス、Data Manager内のオブジェクトは使用量にカウントされないが、Hardware assetsスキーマなど他のシステムスキーマ内のオブジェクトはカウントされる。Atlassianの使用量の説明ページによる。もう一つの注意点として、上限のページは課金が段階的に導入されるとしており、対象となる顧客には課金の前に通知があるとしているため、実際にその日が来るタイミングはバナーが示すものとずれることがある。
オブジェクト数がこれらの上限に対してどの位置にあるかを確認する、小さなウィジェットを用意した。
見積もりのオブジェクト数を選んで、どのJira Service Managementプランがそれをカバーするか確認する。
Assetsオブジェクトをリクエストに結びつけるにはどうすればいいですか?
リクエストタイプにAssetsオブジェクトのカスタムフィールドを追加する。Atlassianの設定ページは手順を説明している。Jira管理者でフィールドを作成し、Assetsオブジェクトのフィールドタイプを選び、フィールドが届くオブジェクトスキーマを選び、オプションでAQLを追加して表示されるオブジェクトをフィルタする。
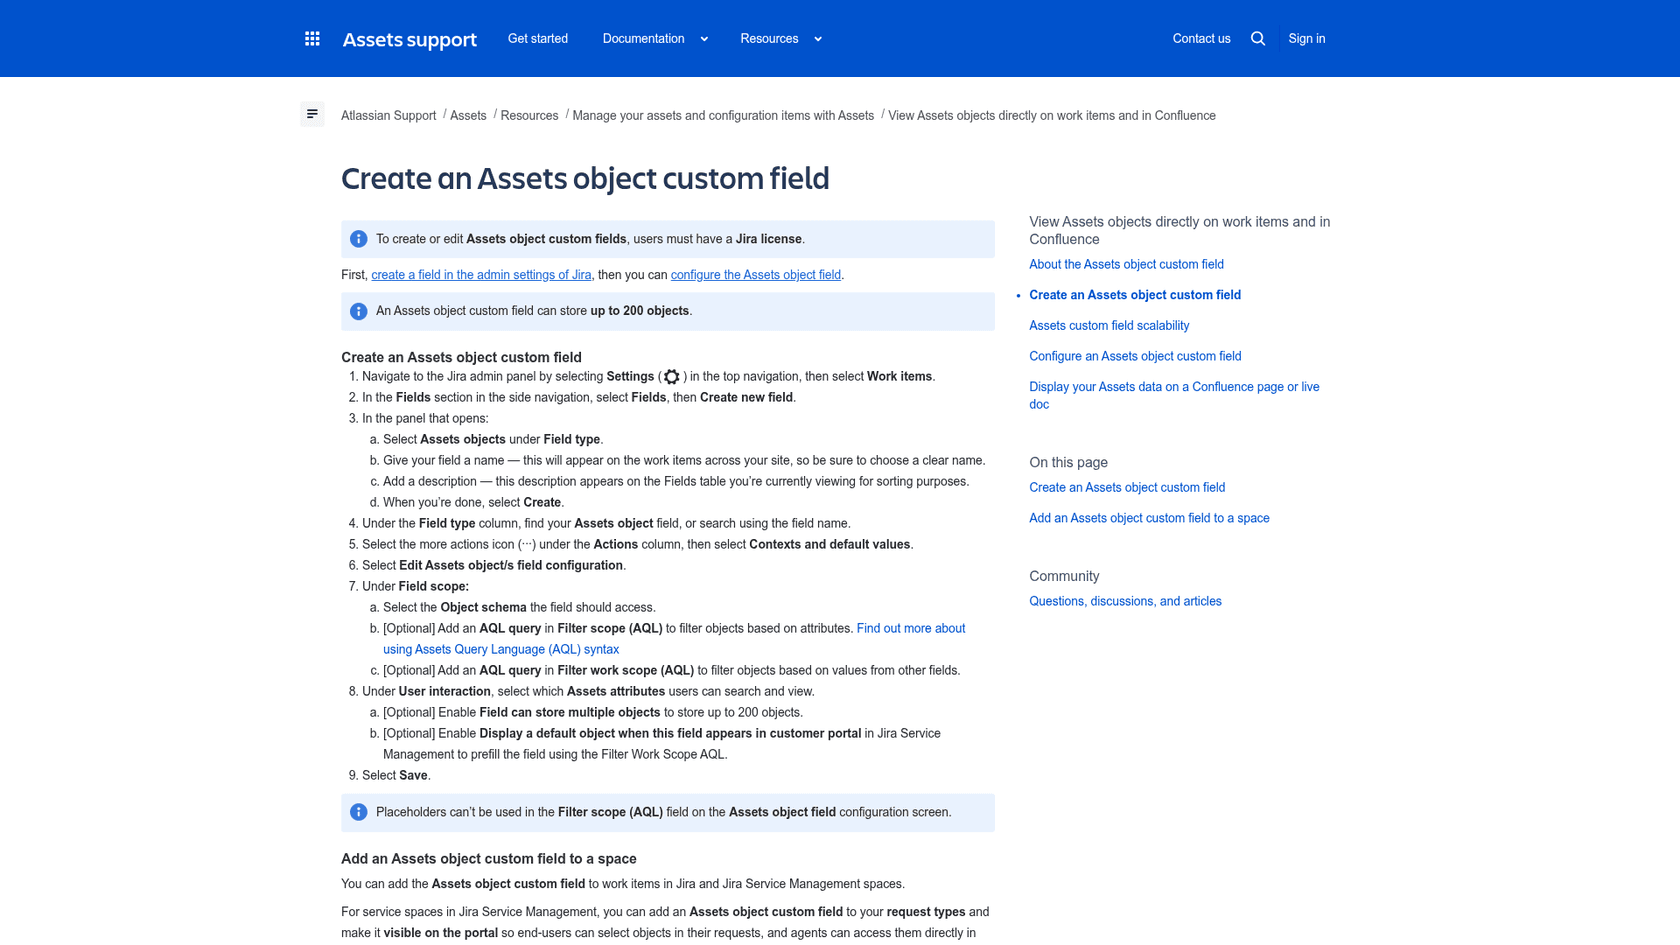
フィールドが有用かどうかを決める設定は次のとおり。
- Filter scope(AQL) は人が選べるオブジェクトを限定し、プレースホルダーはここでは使えない。
- Filter work scope(AQL) は他フィールドの値でフィルタし、カスタマーポータルでデフォルトのオブジェクトを事前入力できる。
- Multiple objects はオプションで、1フィールドに最大200オブジェクトを保存できる。
- Portal visibility は顧客が自分のリクエストでオブジェクトを選べるようにする。Atlassianは、リクエストタイプにフィールドを追加すると、ポータルの顧客全員にAssetsの読み取り専用Userロールが付与されると注記しており、センシティブな属性を持つスキーマを公開する前に知っておく価値がある。
Atlassianは、ボードやバックログなど一部のビューは50オブジェクトの短縮リストを表示し、ワークアイテムとポータルのビューは最大200表示するとも述べている。オブジェクトが選択されると、そのオブジェクト上でリクエストがConnected Jira work itemsの下に表示される。この双方向のリンクこそが、エージェントにとってこのデータベースを価値あるものにしている。チケット上でノートパソコンのステータスと保証を見られ、ノートパソコンの履歴ではそれについて起票されたすべてのチケットを見られる。
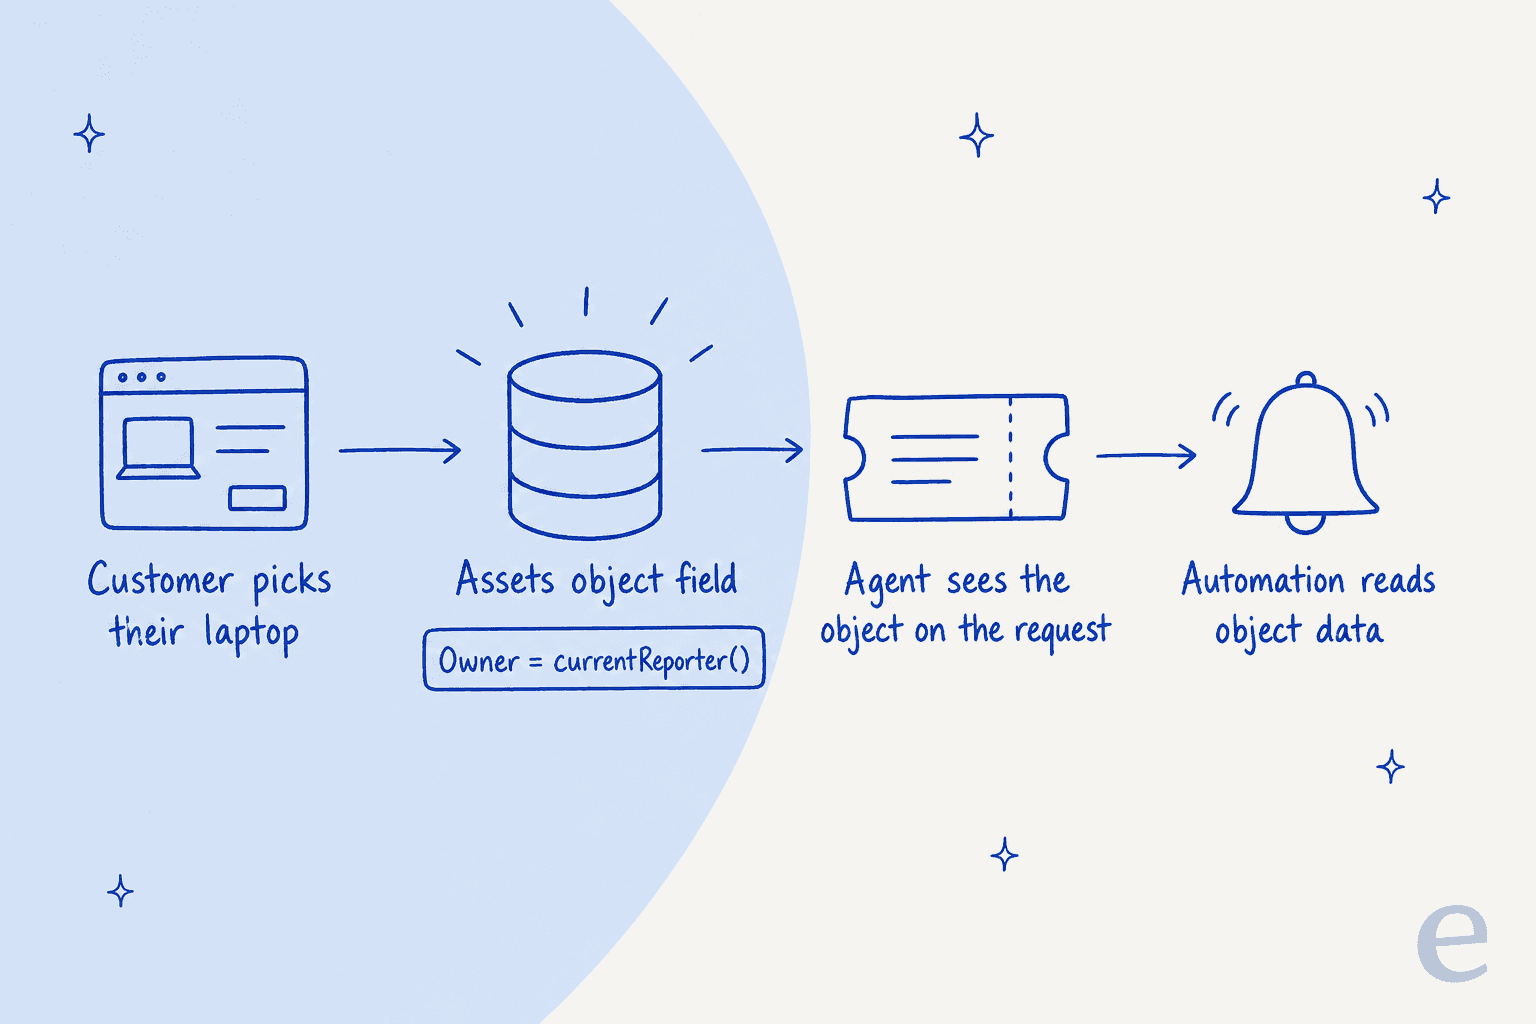
Atlassianのページは自動化も指し示している。Assets向けのsmart valuesはルールがオブジェクトデータに対して動作することを可能にし、Atlassian AutomationはCloud限定の機能として挙げられている。デスクで他に何を自動化すべきか検討しているなら、私のサービスデスク自動化ガイドとJira自動化ガイドで扱っている。
AQLはどう動きますか?
AQLは小さなクエリ言語で、<属性> <演算子> <値>という形を取る。AtlassianのAQLページは、高度なAQL検索やオブジェクトのカスタムフィールドで使えるとしており、大文字小文字は区別しないが、==は大文字小文字を区別する等価演算子だとしている。
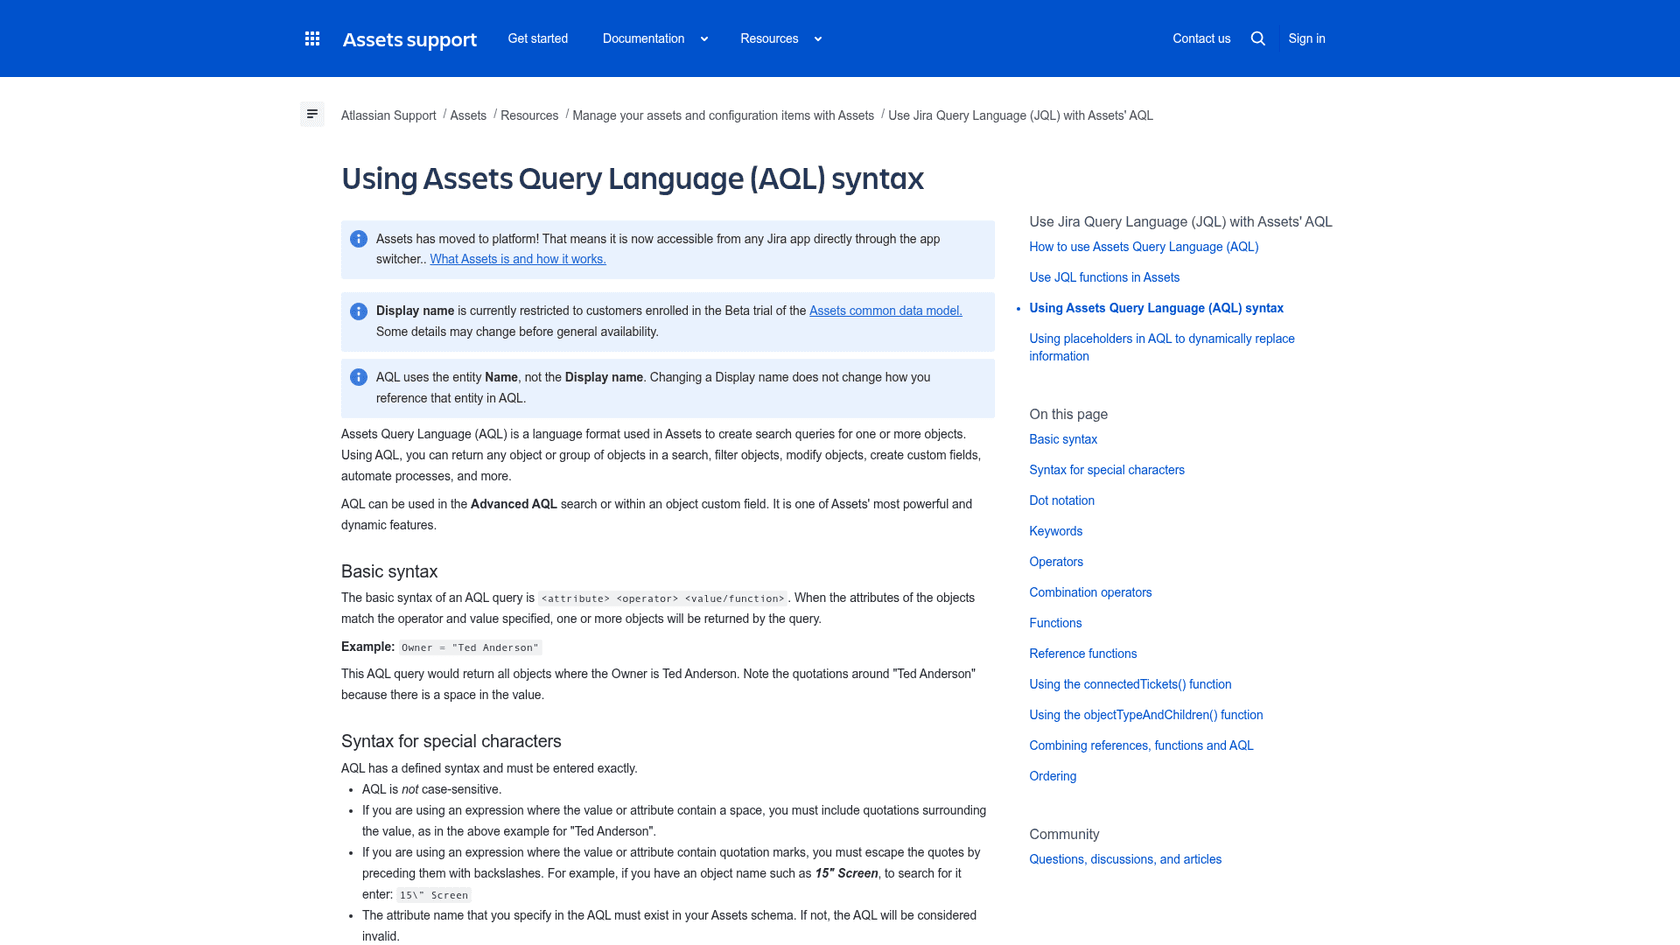
このページから、私が最もよく使う部分は次のとおり。
| 必要なこと | AQL | 動作 |
|---|---|---|
| あるタイプのすべてのオブジェクト | objectType = "Host" | オブジェクトタイプによるキーワード検索 |
| 参照をたどる | "Belongs to Department".Name = HR | ドット記法が参照の連鎖をたどる |
| 所有者のいないオブジェクト | Owner is EMPTY | is演算子が空の値をテストする |
| 自分のデバイスだけ | objecttype = Computer and User = currentUser() | User型の属性が必要 |
| レポーターのデバイス | User = currentReporter() | ワークアイテムが選択されているときだけ動く |
| 未完了の作業があるオブジェクト | object HAVING connectedTickets(Project = VK) | 先にJQLを実行し、次にAQLを実行する |
| あるタイプとその子タイプ | objectType in objectTypeAndChildren("Asset Details") | 子オブジェクトタイプを含む |
2つの注意点がある。AQLはエンティティのNameを使い、Display nameは使わないので、表示名を変更してもクエリは壊れない。また属性がスキーマに存在しなければクエリは無効になる。anyAttributeクエリとconnectedTickets()は、ページ上にオブジェクトのテーブルを埋め込むConfluenceマクロでは動かないので、そのように作られたConfluenceレポートには別のフィルタが必要になる。チームがConfluenceで文書化しているなら、eeselのConfluence連携がそのページをAIチームメイトが回答する同じ知識の中に取り込める。
インポート、Data Manager、ディスカバリーはどう動きますか?
Cloudには取り込みのための複数のルートがある。Assets for Cloudのページは、CSV、JSON、Assets Discoveryによるインポートに加えて、WebアドレスからのインポートとExternal Imports APIを挙げている。上限のページはスキーマごとの最大インポートファイルサイズを250MBとしている。
PremiumとEnterpriseはData Managerを追加する。Atlassianによれば、複数のソースからのデータを接続し、クレンジングし、統合するもので、SQLデータベース向けのCSVやODBCを含む30以上のアダプターを持つ。
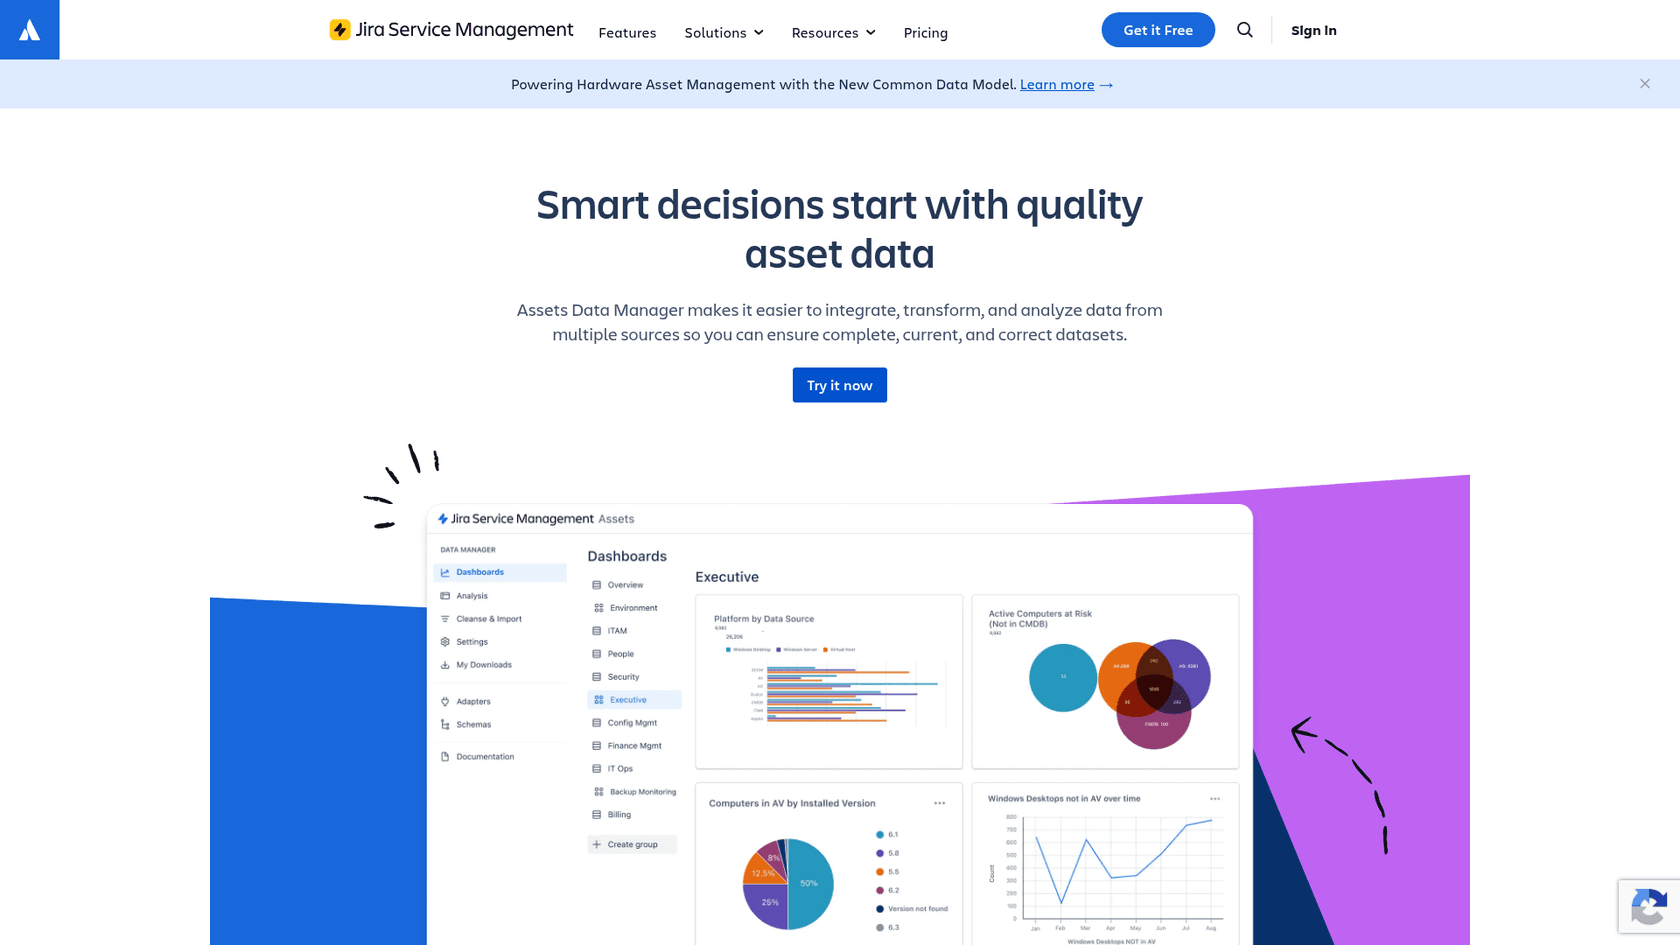
Atlassian自身のページは、Data Managerがどうスキーマに届くかについて一致していない。価格ページはスキーマへのデータのネイティブインポートが「近日公開」としているが、Data ManagerのFAQはCSVか新しいインポートアダプターを通じてデータをスキーマにインポートできるとしている。CSVのルートは今日から使えるものとして扱い、アダプターの方は確認するのがよいだろう。コストにとって有用な事実は、Data Manager内に保持されるオブジェクトはオブジェクト使用量にカウントされないことだ。つまり生の元データをData Managerに置きながら、統合済みのレコードだけをスキーマに置くことができる。
Atlassianの重複防止のアドバイスはどのインポートにも当てはまる。従業員IDや拠点コードのような安定した識別子を使い、入ってくるレコードを既存のオブジェクトに一致させることで、インポートが重複を作るのではなく正しいオブジェクトを更新するようにする。ネットワークスキャナーのAssets Discoveryは統合されたドキュメントページに移動しており、価格ページはStandard以上でそれを挙げている。
Assetsは変更管理とインシデント管理にどう接続しますか?
同じカスタムフィールドを通じて接続する。Atlassianの変更管理のページは、Assetsオブジェクトのフィールドを作成し、スキーマにマッピングし、変更とインシデントの画面に追加するとしている。接続されたオブジェクトは、特定のオブジェクトでの潜在的な競合を確認できる変更リスクインサイトと、今後の変更がどのオブジェクトに影響するかを確認できる変更カレンダーに表示されるようになる。
これがCMDBの実用的な見返りだ。データベースサーバーへの変更を承認する前に、承認者は同じオブジェクトに対して既に予定されている他の変更を見ることができる。私の変更管理ガイドは承認、リスク、カレンダーの部分を扱い、変更管理向けAIはAIがどこで役立つかを扱っている。インシデント側については、自動化されたITインシデント管理と私のSLAベストプラクティスを参照してほしい。
ハードな上限とつまずきやすい点は何ですか?
上限を超えると、Atlassianは課金が変えないハードな技術的上限を公開している。上限のページより。
| 上限 | 値 |
|---|---|
| サイトごとのスキーマオブジェクト | 1,000万 |
| スキーマの総数 | 100 |
| オブジェクトタイプごとのオブジェクト | 200万 |
| オブジェクトタイプごとの属性 | 120 |
| オブジェクトタイプごとの一意制約 | 2 |
| Text属性の文字数 | 255 |
| Textarea属性の文字数 | 10,000 |
| スキーマごとのインポートファイルサイズ | 250MB |
人を驚かせるのは、Assetsにはアーカイブ状態がないことだ。Atlassianの最適化ガイダンスは、アーカイブ状態が存在しないためアーカイブでは使用量を減らせないとしている。削除されたオブジェクトはカウントされなくなるが、削除は取り消せないので、オブジェクトを作る前にその寿命を決めておくべきだ。従業員がチームを変わったときは、2つ目を作るのではなく既存のオブジェクトを更新する。
構築前に行う短いチェックリストはこうなる。
- 必要なオブジェクトタイプを挙げ、独自の所有者やライフサイクルを持つものに印をつける。
- 残りは既存タイプの属性にする。
- 最初のインポートの前に、各タイプの安定した識別子を決める。
- フィールドがポータル顧客にUserロールを与えるので、どのスキーマを顧客に見せるか決める。
- プランの上限に対してオブジェクトを数え、毎月アプリの使用量を確認する。
Assetsの上にAIチームメイトはどこで役立ちますか?
AIが座るのはこのデータのチケット側で、レコードの中ではない。誰かが「自分のノートパソコンはどれ?」や「保証はいつ切れる?」と尋ねたとき、答えはオブジェクトの中にあり、尋ねている人はたいていキューの中にいる。私のIT資産管理向けAIガイドは、そうした仕事のどれをAIがこなせ、どれをITに残すべきかを見ていく。資産管理向けAIと資産管理AIツールのベストが全体像を補う。
確認できることについての注意点を一つ。Assetsオブジェクト用のeeselネイティブなリーダーは確認していない。eeselが今日行っているのは、Jira Service Managementのデスクに接続し、過去のリクエストとナレッジベースから学び、キューの中で回答やドラフトを作ることだ。これはそのインテグレーションページが説明している。資産に関する質問については、デバイス一覧のような承認済みのデータのエクスポートを定期的に更新するのが実用的なルートで、AIが引用できるものを人が管理し続けられ、古くなったエクスポートこそ気をつけるべきものになる。
このパターンは技術的なデスクでも成り立つ。ある産業オートメーション企業はeeselを運用し、技術ライブラリの上でサポートエージェントがエンジニアがチケットを開く前に、信頼度レベルと使用したソースつきで各チケットに回答をドラフトしている。週間のボリュームは最初の数カ月でおよそ2倍になり、サポートデスクに届く数の2倍を大きく超える質問がチャットに届いている。エンジニアが編集して送信し、eeselが自分の判断で顧客に書き込むことはない。
JSMのデスクでは、私はこの形をそのまま真似る。まずAIサポートシミュレーションで過去のリクエストに対してテストし、私の承認ワークフローガイドのように承認は人に残し、ソースとしてきれいなナレッジベースを使う。ルートを選んでいるなら、JSM向けAIのベスト、Atlassian自身のAI、Rovoが出発点になり、エージェンティックAIガイドはAtlassianが向かう先を扱っている。
Jira Service Managementのデスクでeeselを試す
Assetsはエージェントにデバイスが何かを伝えるが、キューには質問に素早く答える誰かがそれでも必要だ。eeselは既存のJira Service Managementのキューに参加し、過去のリクエストとナレッジベースから学び、返信をドラフトしてリクエストフィールドを更新し、承認はチームに残すAIヘルプデスクチームメイトだ。関連記事:サービスデスク向けAIとオンボーディングの質問向けAI。
よくある質問
Jira Service Management Assetsとは何ですか?
AssetsはどのJira Service Managementプランに含まれますか?
Jira Service Management Assetsには何オブジェクトまで含まれますか?
Jira Service ManagementのAQLとは何ですか?
objectType = "Laptop" AND Status = "In stock"のようにオブジェクトを検索・フィルタするための構文だ。AtlassianのAQL構文ページによれば、高度な検索やオブジェクトのカスタムフィールドで使える。大文字小文字は区別せず、表示名ではなく属性名を使う。