

Hermes を「ナレッジベース」ではなく「保守役」と捉える理由
私は毎日 eesel のサポートキューを担当していますが、AI の回答がおかしいとき、原因がモデルであることはまれです。原因はヘルプ記事です。バス追跡サービスのサポートマネージャー(月 200〜250 件の Zendesk チケットを処理)は、私たちとの通話で、ナレッジベース全体が管理者向けに書かれている一方で、チケットは乗客から来ていると気づきました。どの回答も技術的には正しく、実際にはほとんど役に立っていませんでした。別のチーム、デンマークの太陽光エネルギー企業では、ナレッジベースに該当がないとき、ボットが回答をでっち上げて実際の顧客に送っていました。
つまり「AI エージェントにナレッジベースを管理させられるか?」は、実は 2 つの問いです。知識を保持できるか、そして最新に保てるか。Nous Research のオープンソースエージェント Hermes Agent の場合、正直な答えは「いいえ」と「はい、ただし慎重に」です。
Hermes は、自分のマシンやサーバーで動かすセルフホスト型の MIT ライセンスのエージェントで、数あるオープンソース AI エージェントの中でも優れたものの一つです。初めての方は、基本を押さえた私の Hermes Agent レビューをご覧ください。
カスタマーサポートと社内 IT サポートのガイドでは、Hermes によく任される他の 2 つの仕事を扱っています。このガイドでは、地味な仕事であるナレッジベース管理、つまり記事を正確に、見つけやすく、漏れなく保つ作業を取り上げます。
Hermes が実際に知っていること(と、その置き場所)
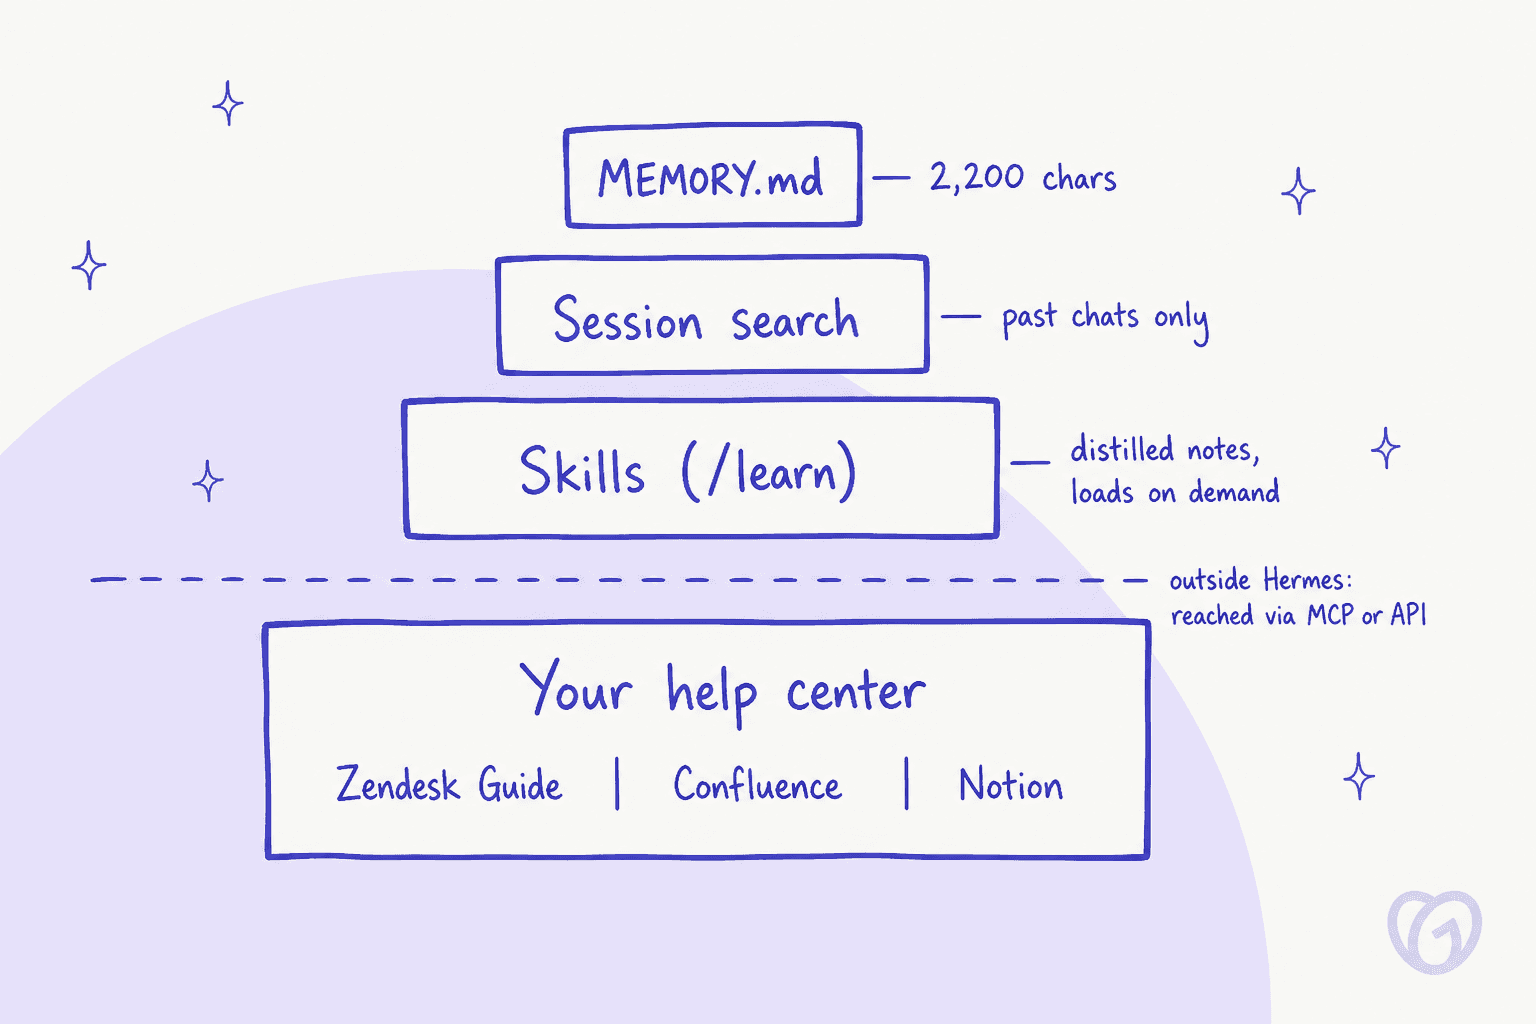
Hermes には知識を置ける場所が 4 つあり、サイズは大きく異なります。「ナレッジベースとしての Hermes」をめぐる混乱の多くは、これらを混同することから生じます。
メモリ:意図的に小さい
Hermes の永続メモリは 2 つのファイルです。MEMORY.md はエージェント自身のメモで 2,200 文字(約 800 トークン)、USER.md はあなたのプロフィールで 1,375 文字です。おおよそ 8〜15 件のエントリに相当します。どちらもセッション開始時に固定されたスナップショットとしてシステムプロンプトに読み込まれ、メモリは自動圧縮されません。上限を超える書き込みはエラーになり、エージェントが空きを作る必要があります。
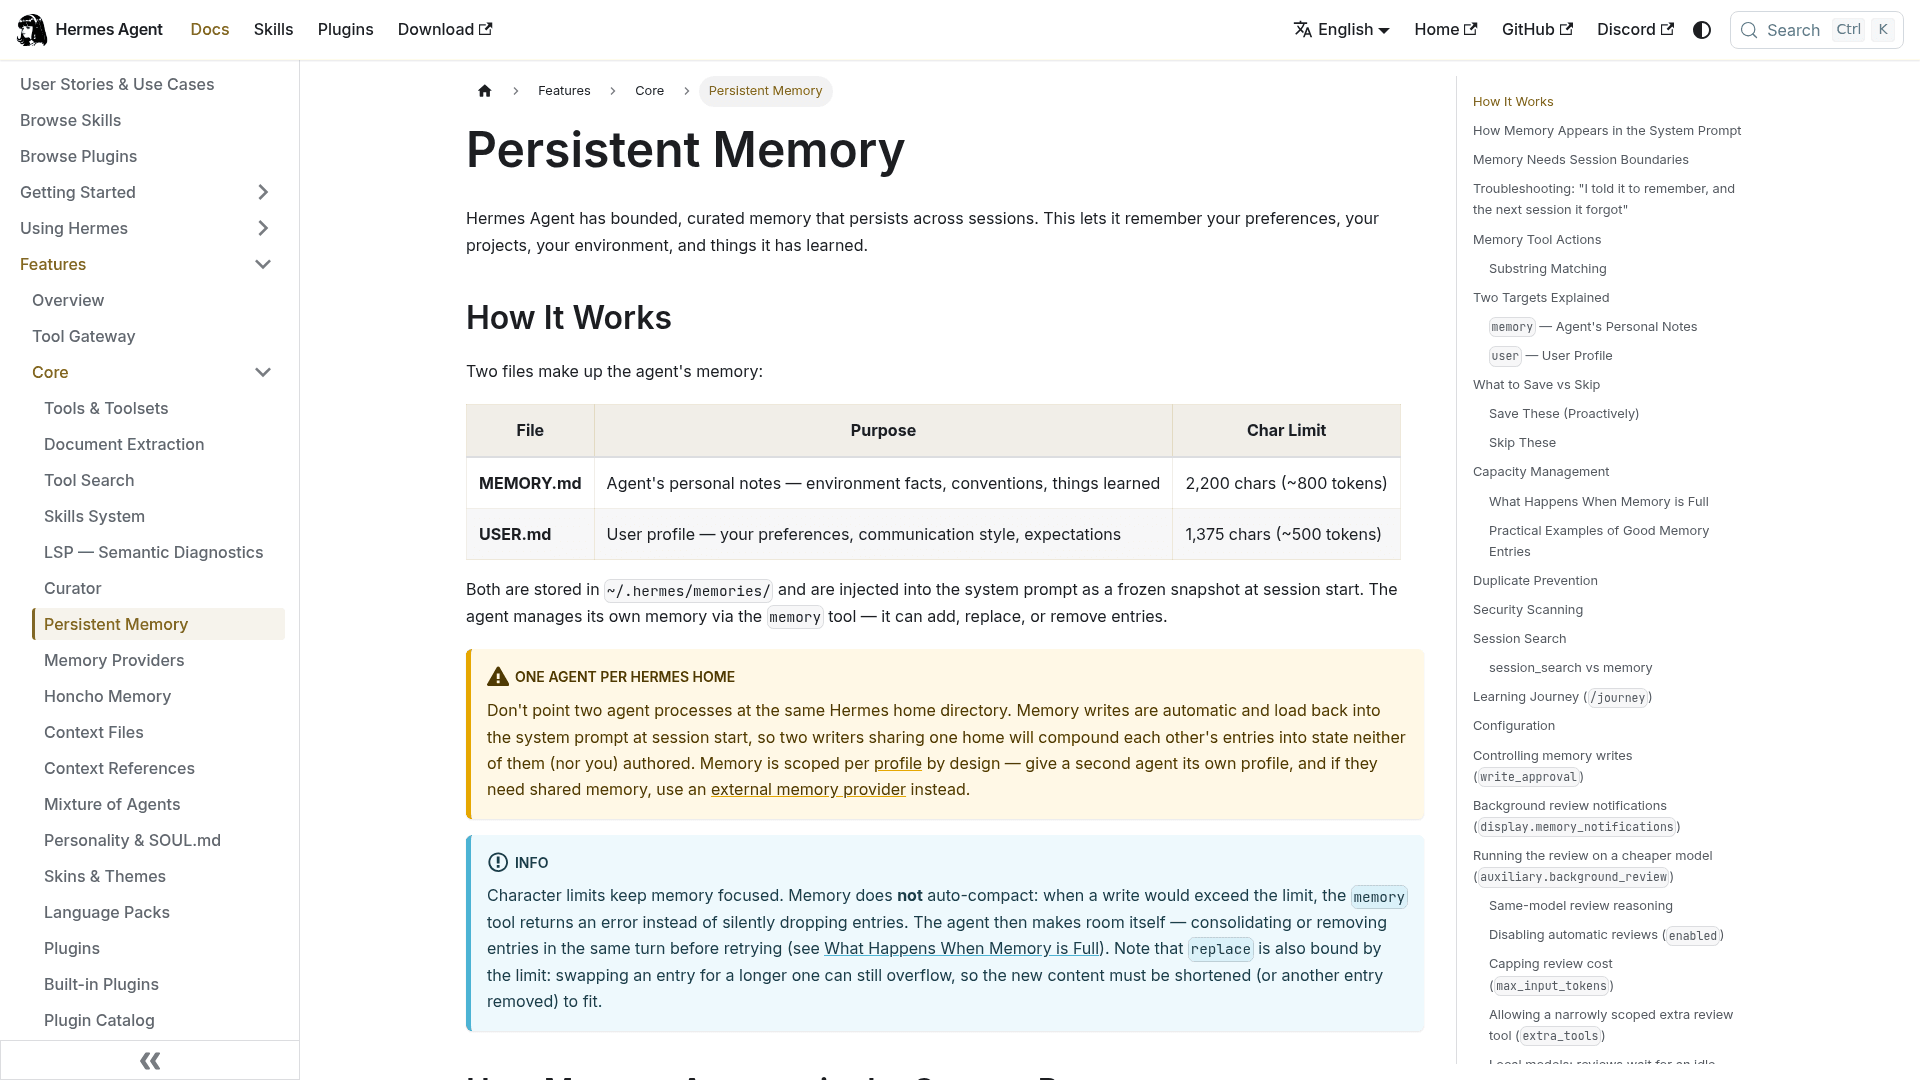
ドキュメントは、何を入れるべきでないかについて率直です。"Raw data dumps" は対象外リストに入っており、エージェントが毎回必要とするものについては、スキルのほうが "often the better home than a memory entry" だと書かれています。返金ポリシーのヘルプ記事 1 本だけでも、この予算の大きな部分を食ってしまいます。ヘルプセンターは収まりませんし、もともと収めるものでもありません。
セッション検索:会話であって、ドキュメントではない
session_search は過去のすべてのチャットに対して SQLite の全文検索を実行し、1 クエリあたり約 20ms、モデル呼び出しはありません。「先週これ話したっけ?」には最適です。しかしファイルやドキュメント、ヘルプセンターはインデックスしません。ここで検索できるようになるのは、過去の会話にそのテキストが登場した場合だけです。
スキル:内蔵ナレッジベースに最も近いもの
スキルは、関連するときだけ読み込まれるオンデマンドの知識ドキュメントです。/learn コマンドは、ドキュメントフォルダや URL を「ナレッジベーススキル」に変換します。軽量な SKILL.md と、references/ 以下のトピックごとの要約ファイルで構成されます。同じトピックに対して /learn を再実行すると、新しい内容が既存のスキルに統合されます。
ナレッジベース運用で重要な注意点が 2 つあります。
- 要約であって、ミラーではありません。 ドキュメントによれば、要約は "never reproduces passages of the source text" です。製品をエージェントに教えるには有用ですが、顧客に引用できる記事のコピーではありません。
- 使われないスキルはアーカイブされます。 curator は、エージェントが作ったスキルを
14日間未使用で古いとマークし、30日後にアーカイブフォルダへ移します。四半期ごとの監査のときしか触らないナレッジスキルは、hermes curator pin <skill>でピン留めしない限り、いつの間にか消えます。
本当のナレッジベース:外部にあり、MCP か API で到達する
Hermes には RAG もベクトル検索も内蔵されていません。ドキュメントに対するセマンティック検索には、何かを選んで導入する必要があります。外部メモリプロバイダー(ドキュメント取り込みが文書化されているのは OpenViking と RetainDB で、RetainDB は $20/month)、オプションの qmd 検索スキル、または自分で運用するベクトルデータベース用スキルです。それ以外はすべて本物のナレッジベースにあり、Hermes は外部ツール用のプラグインプロトコルである MCP か、単純な API 呼び出しでそこへアクセスします。
この分担が、考え方のすべてです。ヘルプセンターが信頼できる唯一の情報源で、Hermes はそこを訪れる作業者です。これは、AI を社内ナレッジにつなぐ方法で述べたのと同じパターンです。
Hermes が得意なナレッジベースの 3 つの仕事
Hermes にナレッジベースそのものであることを求めるのをやめれば、すぐに役に立ちます。私が任せたいのは次の 3 つです。
1. Markdown ウィキやドキュメント用リポジトリの毎週の監査
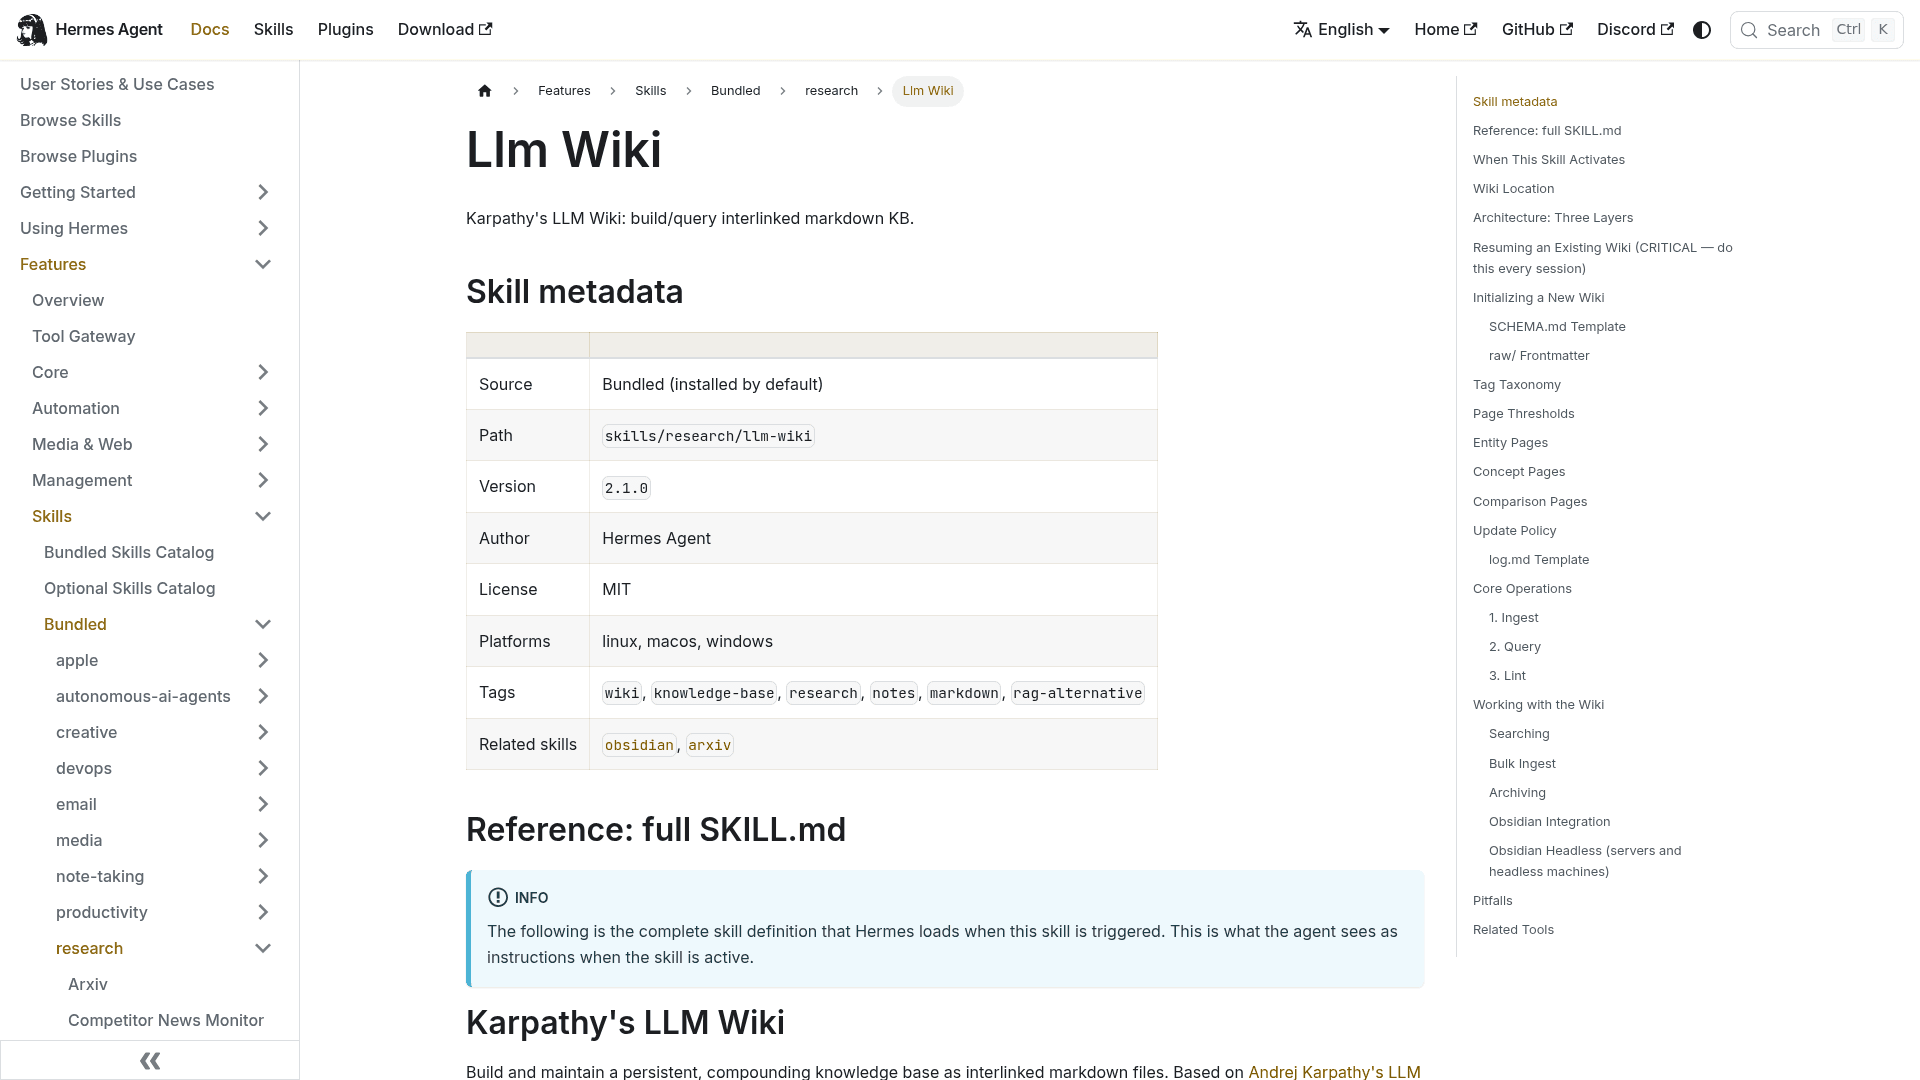
同梱の llm-wiki スキル(Andrej Karpathy の LLM Wiki のアイデアに基づく)は、相互リンクされた Markdown のナレッジベースを構築し、リント処理も備えています。このリントは、孤立ページ、リンク切れ、索引の抜け、矛盾、情報源とのずれ、200 行を超えるページ、古い内容を調べます。古い内容とは、updated の日付が、同じトピックに触れている最新の情報源より 90 日以上古いページのことです。
ドキュメントが Markdown なら、サポートナレッジベース監査のほとんどが無料でできる計算です。docs-as-code のチームなら、残りは Hermes のファイルツールが担います。read_file は大きなファイルをページ送りで読み(約 100K 文字を超えると切り詰め)、patch は的を絞った編集を行って diff を返し、search_files の中身は ripgrep です。
2. 不足している記事や古くなった記事のドラフト作成
Hermes は、各プラットフォームの MCP サーバーや API を通じて、Notion、Confluence、Freshdesk、Help Scout、GitHub に記事を書けます。うまくいくパターンは「ドラフトを書く、公開はしない」です。エージェントは、人がレビューできる場所に記事案を書きます。Reddit のある Zendesk 管理者は、エージェントが流行るずっと前に Make.com で作った同じループについて、こう述べています。
"If it can't it drafts me an article that would cover it, as well as tells me why."

この "tells me why" が大事です。理由が付いたドラフトは数分でレビューできます。理由のないドラフトはキューに放置されます。執筆面については、AI でナレッジベース記事を書くガイドでさらに触れています。
3. 何かに答える前に、自分で製品を学習する
公開しているヘルプセンターに対して /learn を実行すると、Hermes は他のことに手を付ける前に製品の作業モデルを持てます。ほかの場所で返信案の作成にも Hermes を使っているなら便利で、ナレッジベースで AI をトレーニングするのと同じ考え方です。Hacker News のあるコメント投稿者は、まさにこの構成を運用しています。
"Hermes uses an llm-wiki [...] as a source of information when drafting suggested replies - I have a cronjob that feeds it all emails, slack messages, meeting minutes every single day."

Hermes はヘルプセンターに書き込めるか?プラットフォームによります
ここで多くの構成がつまずきます。Hermes のドキュメントのどのページも顧客向けヘルプセンターに触れていないため、この部分は一切カバーされていません。Hermes が変更を安全に提案できるかどうかは、Hermes そのものよりもナレッジベースのプラットフォームに大きく左右されます。
Hermes が厳選した MCP カタログには 62 件のエントリがあります。Notion と Atlassian(Jira と Confluence)は入っています。Google Drive、GitHub、Zendesk は入っていません。GitHub は同梱の gh スキルを優先してあえて外されており、Google Drive は自前の OAuth クライアントが必要で、Zendesk はドキュメントのどこにも登場しません。
ナレッジベースはどこにありますか?
プラットフォームを選ぶと、Hermes がどう接続できるか、そして勝手に公開させないための設定を確認できます。
経路:Hermes のスキルまたはターミナル呼び出しから Help Center REST API を使います。Hermes の MCP カタログには入っておらず、Zendesk 自身の MCP サーバーにもまだ公開ドキュメントがありません。
安全な設定:エージェントのアカウントには公開権限のない権限グループを与え、draft を true にした記事しか作れないようにします。
注意:ドラフトフラグは翻訳ごとに働きます。公開中の記事に設定すると、その記事がヘルプセンターから外れます。編集案は、新しいドラフト記事として提案してください。
経路:Hermes のカタログにある Atlassian の MCP サーバー。v2 には createConfluenceContent や updateConfluenceContent を含む 65 個の Confluence ツールがあります。
安全な設定:Hermes でサーバーを trust: untrusted にして、書き込みのたびに事前確認が入るようにします。無人実行には、組織の管理者が有効にした API トークンが必要です。
注意:MCP ツールにはドラフトのオプションがなく、コンテンツステータスのツールが設定するのはレビュー用ラベルで、公開状態ではありません。制限付きの保管用スペースに書くか、コメントを残してください。
経路:Hermes のカタログにある Notion のホスト型 MCP サーバー。Notion 自身のドキュメントに Hermes 用の設定と hermes mcp login notion の手順があります。
安全な設定:信頼できるまでは notion-search、notion-fetch、notion-create-comment だけを含め、その後レビューの関門として Status プロパティを追加します。
注意:サインインは OAuth のみでヘッドレス用トークンはまだなく、ドラフトモードでは親ページのない非公開ページが作られます。
経路:Freshdesk 公式の MCP サーバー(2026 年 9 月 10 日に一般提供開始)には createSolutionFolderArticle と updateSolutionArticle があります。
安全な設定:記事は status 1(ドラフト)で作成します。status 2 は公開になります。
注意:接続した API キーにはすべてのツールが与えられ、MCP は従量制です。Growth には年 1,200 アクションが含まれ、その後は 1,000 あたり $15 です。
経路:Docs API。Help Scout の MCP サーバーは新規接続では読み取り専用で、Docs の記事は編集できません。
安全な設定:ドラフト保存エンドポイントは、公開中の記事の上にドラフトを書き込み、"so that the published version will not be affected."
注意:Docs API キーには「Docs: Create new, edit settings & Collections」の権限が必要です。
経路:gh コマンドラインを操作する Hermes 同梱の github スキル、または GitHub 自身の MCP サーバー。
安全な設定:ブランチに書き込み、ドラフトのプルリクエストを開きます。main のブランチ保護が公開ボタンの役割を果たします。
注意:ほぼありません。Notion のサインインと違い、個人アクセストークンで無人実行ができます。
同じ内容をまとめた早見表がこちらです。
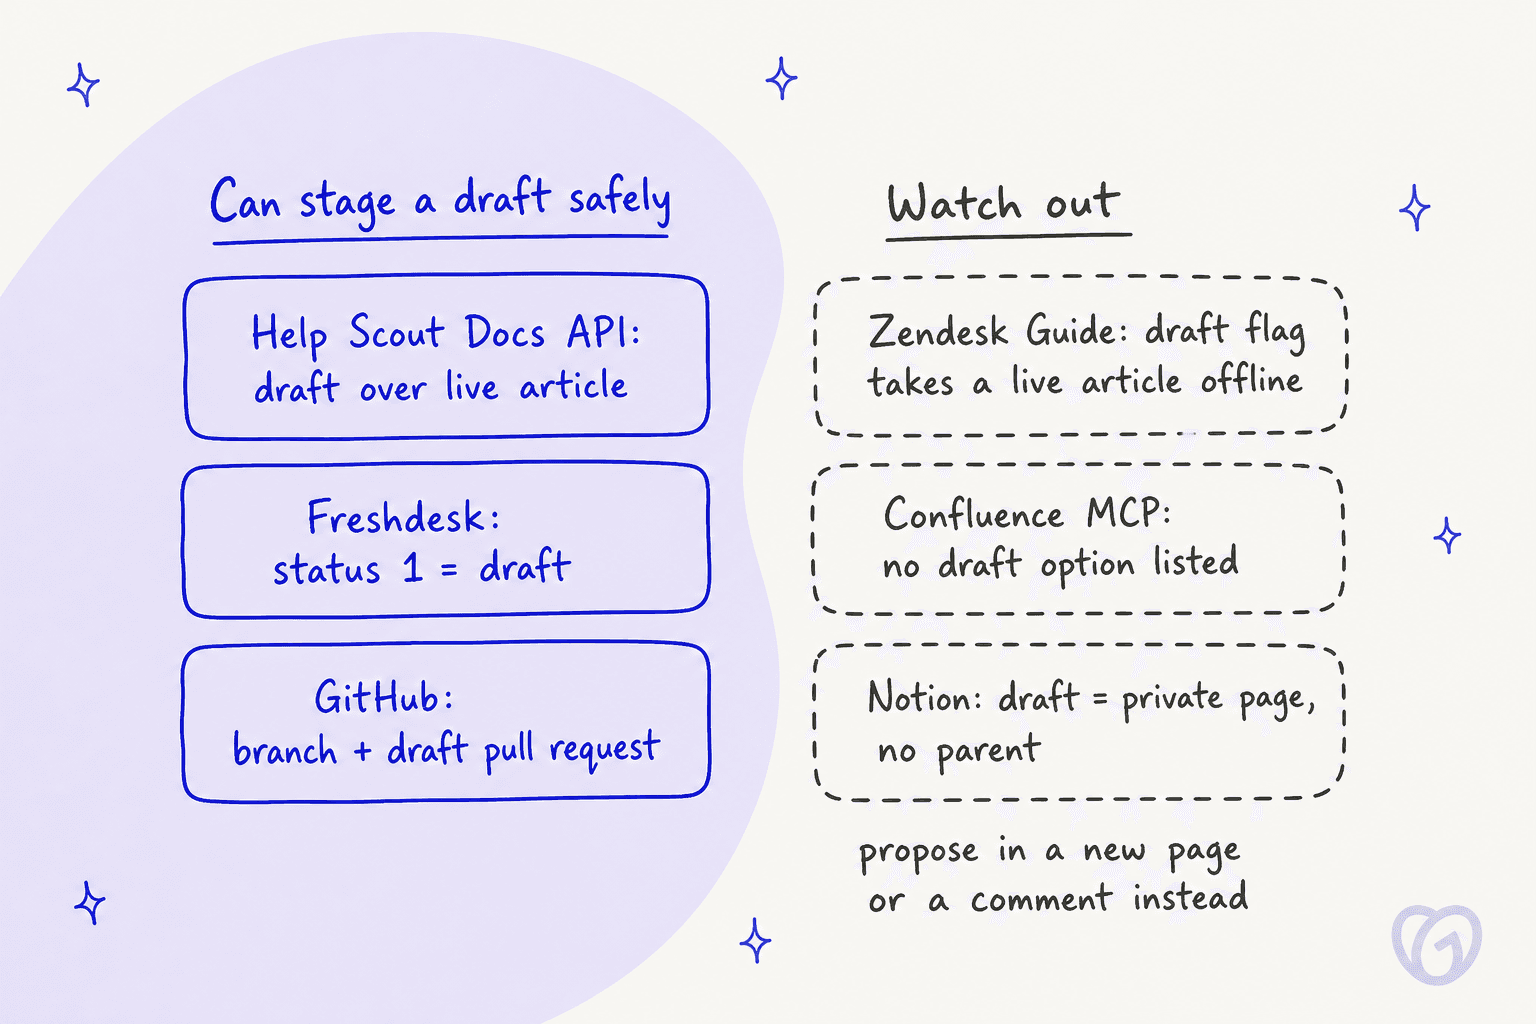
Zendesk の件は、最も驚かれる点です。Help Center API によれば、draft フィールドは "can be set when creating but not when updating" で、更新は翻訳エンドポイント経由で行われ、そこでは draft がその翻訳全体に適用されます。「保留中の編集」という別オブジェクトは存在しないため、エージェントが公開中の記事をドラフトに切り替えると、その記事は非公開になります。良い面もあります。API には、公開権限がない場合 "the article must be created using draft=true" とも書かれています。これはきれいな安全柵です。エンドポイントは私の Zendesk Guide API の記事で解説しており、Freshdesk ユーザーは Freshdesk ナレッジベース API ガイドで同等の内容を確認できます。
| プラットフォーム | Hermes の接続方法 | ドラフトの仮置き | サインイン | 知っておくべき制限 |
|---|---|---|---|---|
| Zendesk Guide | REST API(カタログ外) | 新規記事のみ、draft: true | OAuth トークンまたは API トークン | プランにより 200〜2,500 リクエスト/分 |
| Confluence | Atlassian MCP(カタログ内) | MCP ツールに記載なし | OAuth 2.1、または管理者が有効にした API トークン | 書き込みは無料、拡張呼び出しは Rovo クレジット 1-10 |
| Notion | Notion MCP(カタログ内) | 非公開ページ、親なし | OAuth のみ | Business 以上は 600/分、その他は 180/分 |
| Freshdesk | Freshdesk MCP | 可、status: 1 | API キーのみ | Growth は年 1,200 アクション、以降 1,000 あたり $15 |
| Help Scout Docs | Docs API(MCP は読み取り専用) | 可、公開記事の上にドラフト | Docs API キー | 10 分あたり 2,000 以上のリクエスト |
| GitHub のドキュメントリポジトリ | github スキルまたは GitHub MCP | 可、ブランチとドラフト PR | OAuth または個人トークン | コンテンツ作成リクエストは 80/分 |
ナレッジベース管理のための Hermes セットアップ:ステップごとの手順
サポートチーム向けに、私ならこの順序で進めるというセットアップです。Hermes がすでにインストールされているなら、ステップ 1〜4 は午後ひとつ分を見込んでください。
ステップ 1:信頼できる唯一の情報源の置き場所を決める
正しい答えが存在する場所として、システムを 1 つ選びます。ヘルプセンターが Zendesk Guide でも、実際の答えの半分が Confluence にあると、Hermes は両方を喜んで監査し、先に到達したほうにドラフトを書きます。こうして 2 つの記事が食い違います。担当者が別の社内ナレッジベースも持っているなら、衝突したときにどちらを優先するか、今のうちに決めてください。r/CustomerSuccess のある Reddit コメント投稿者が、その行き着く先を語っています。
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it"
ステップ 2:まず読み取り専用で接続する
MCP サーバーを追加すると、Hermes はそれを調べてチェックリストを表示し、チェックを入れたツールだけが tools.include に入ります。最初は検索と読み取りのツールだけにしてください。Notion の場合、Notion 自身の Hermes 向け手順にあるホスト型サーバーを使います。
mcp_servers:
  notion:
    url: "https://mcp.notion.com/mcp"
    auth: oauth
    trust: untrusted
    tools:
      include: [notion-search, notion-fetch, notion-create-comment]
その後、hermes mcp login notion を 1 回実行して OAuth サインインを完了します。
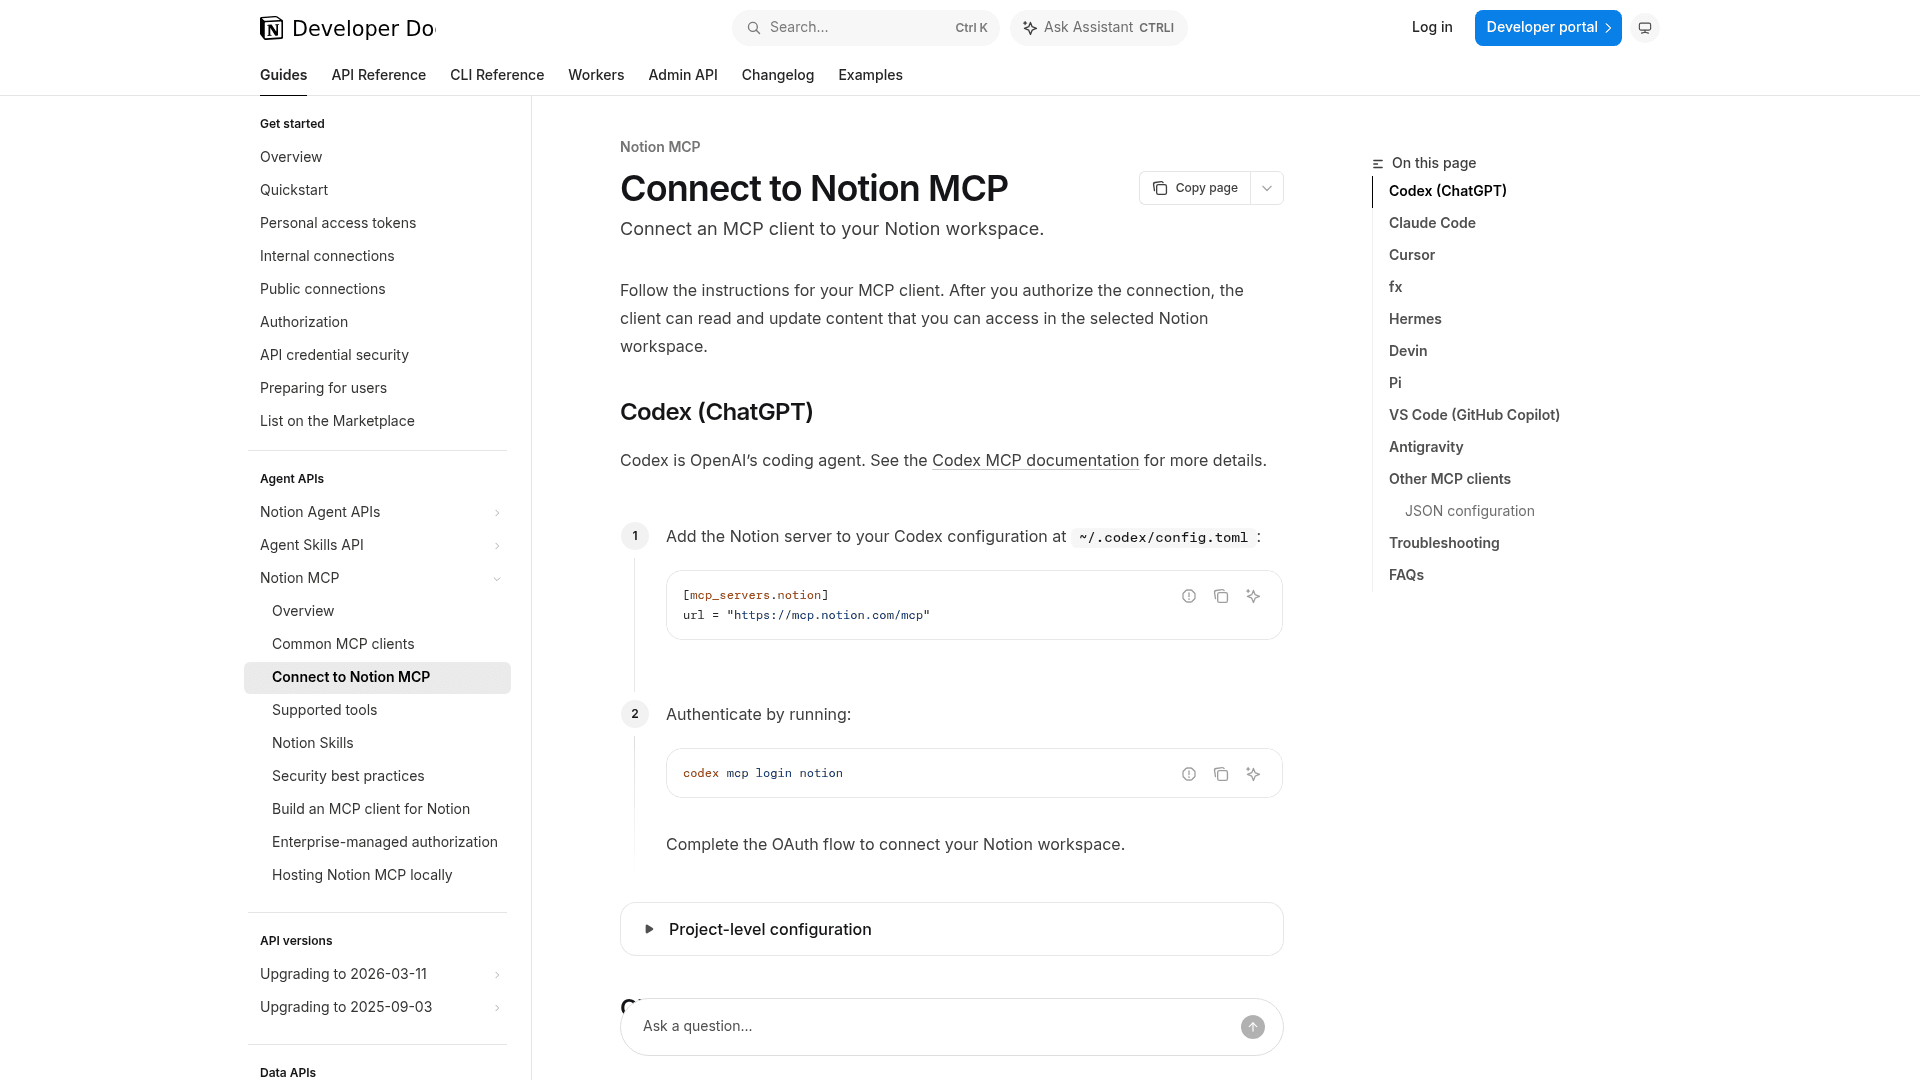
この trust: untrusted の一行が最も大きな役割を果たします。MCP 設定リファレンスによれば、信頼しないサーバーでは "every write-capable tool call [...] requires user approval." となります。デフォルトは full で、確認は一切入りません。
ステップ 3:Hermes がオフにしている書き込みの関門を有効にする
Hermes の承認の仕組みは一様ではないので、次の設定を意識的にオンにしてください。
memory.write_approval: trueはメモリへの書き込みを保留にし、/memory pendingと/memory approve <id>でレビューできるようにします。skills.write_approval: trueはスキルの変更に対して同じことを行い、/skills diff <id>で差分全体を確認できます。checkpoints.enabled: trueはファイル書き込みの前にスナップショットを取り、/rollbackで Markdown ページを復元できるようにします。チェックポイントは任意でオンにする機能です。
これらがカバーしないことが 2 つあります。通常のファイル書き込み(write_file、patch)は確認を一切求めません。セキュリティドキュメントにも "there is no approval prompt" とあり、あるのはブロックするパスの一覧と任意の書き込みサンドボックスだけです。また、チェックポイントはローカルファイルのスナップショットしか取らないため、MCP 経由で変更した Notion や Confluence のページを元に戻すには、そのプラットフォーム自身のページ履歴に頼ることになります。
ステップ 4:毎週の監査をスケジュールする
Hermes cron は平易な英語のスケジュールを受け付け、スキルを添付でき、Slack に配信します。最初のジョブは次のようになります。
hermes cron create "every monday 9am" "Lint the support wiki. List stale pages, orphan pages and contradictions with file paths. If nothing changed since last week, reply [SILENT]." --skill llm-wiki
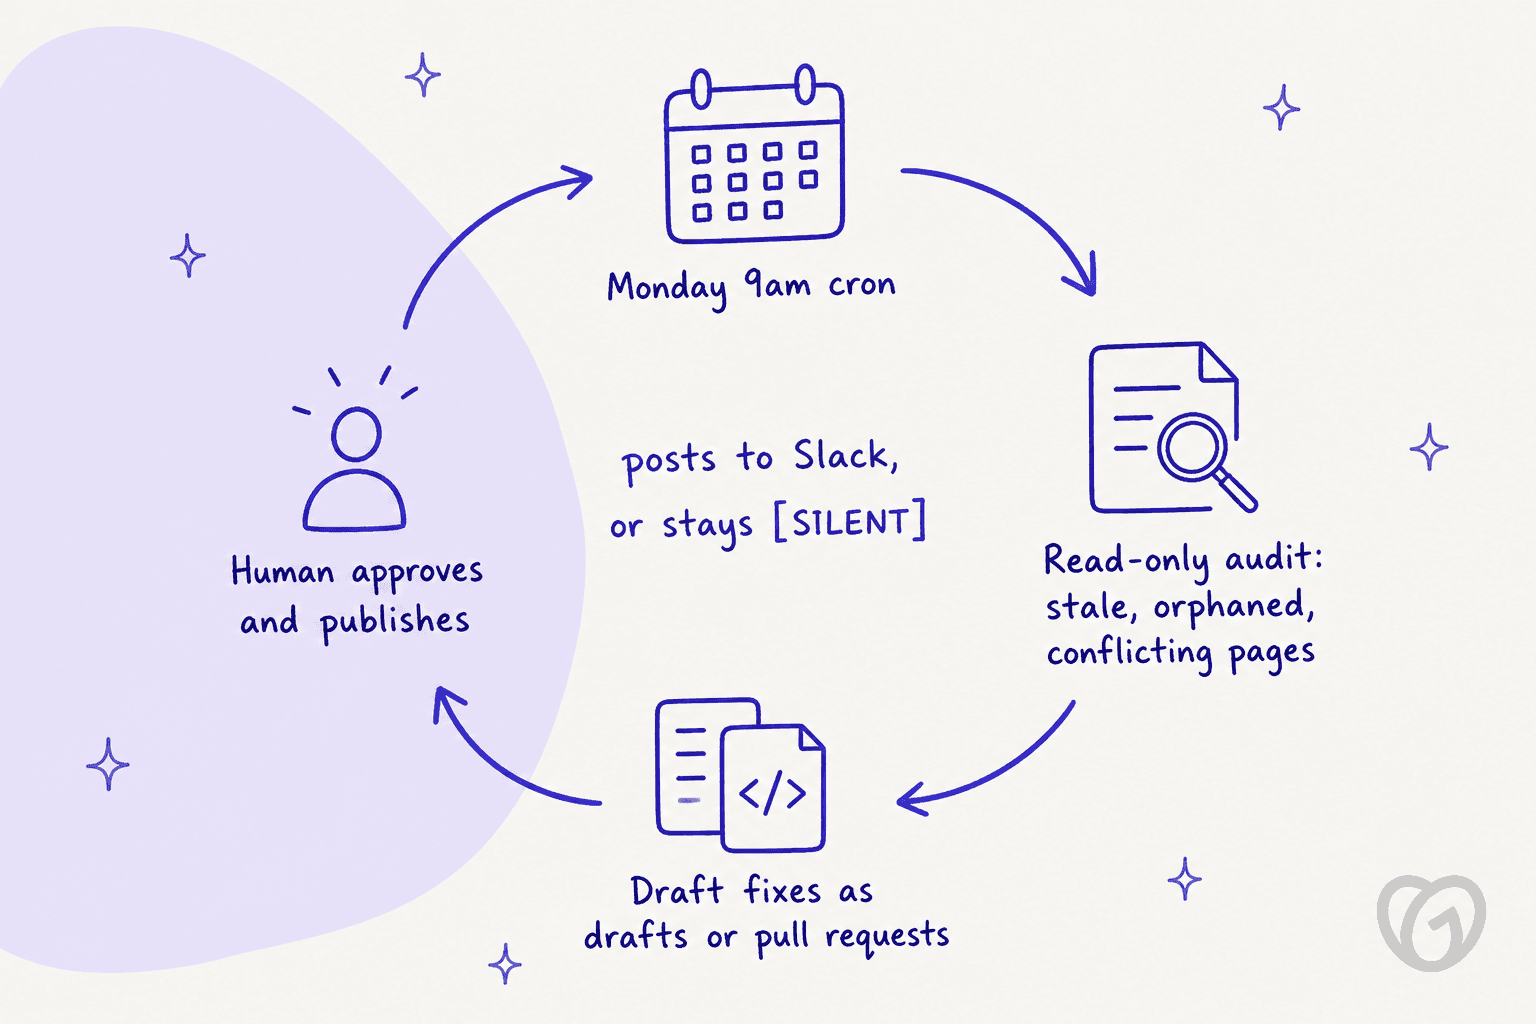
cron はこの用途でよく動作します。返信に [SILENT] を含めると配信が抑制されるため、チャンネルには変更があったときだけ通知が届き、失敗したジョブは常に配信されます。キー、スキル、MCP サーバーのいずれかが解決できない場合、ジョブは blocked_config としてマークされ、アラートを 1 回送り、モデル呼び出しは行いません。cron では、危険なシェルコマンドはデフォルトで拒否されます。ひとつ癖があり、cron の実行のたびに完全に新しいセッションが始まるため、プロンプトにはエージェントが必要とするすべてを含める必要があります。
ステップ 5:監査が退屈になってからドラフト作成を追加する
自分が指摘したであろうものと一致する監査が数週間続いてから、はじめて Hermes に書かせます。お使いのプラットフォーム用の書き込みツールを追加し、サーバーは untrusted のままにして、ドラフトはレビュー用の場所に向けます。ドラフトのプルリクエスト、Freshdesk のドラフト、Help Scout のドラフト、または Confluence ページへのコメントです。ジョブが依存するナレッジスキルはピン留めして、四半期の途中で curator にアーカイブされないようにしてください。
エージェント運用のナレッジベースが失敗する場面
Hermes のコミュニティで、顧客向けヘルプセンターに対して運用していると報告する人は、まだいません。どの事例も個人やチームのウィキ、たいていは Obsidian の vault の話です。それでも、失敗のパターンはサポートのナレッジベースにそのまま当てはまり、エージェントに書き込み権限を与える前に読んでおく価値があります。
監督なしの書き込みはウィキ全体を腐らせる
私が読んだ r/hermesagent のスレッドで、最も支持を集めた教訓がこれです。
"Don't let the agent write the vault unsupervised. That's the one I wish I'd heard on day one. They will dump session recaps, fake "I remember" facts, and half finished incident notes into Obsidian like it's a trash can. Looks busy. A month later you don't trust a single file."
Hermes 自身のドキュメントも関連するリスクを指摘しています。小さなローカルモデルでは、"a sentence like 'I've added that to my memory' is just text" です。エージェントは、実際には保存していないものを保存したと言うことがあり、だからドキュメントはファイル変更の検証機能を加え、"trust the verifier over the model's summary" と勧めています。
エージェントは書き足すが、削除はめったにしない
Hacker News の「Agents don't need memory, they need documentation」というスレッドで、あるエンジニアは、エージェントに整合作業をさせていても、社内のナレッジベースが "completely useless giant mess of stale, outdated, duplicated, or superfluous info" に膨れ上がったと述べています(kaydub, Hacker News)。エージェントは段落を削るのではなく、足します。ヘルプセンターでは、監査プロンプトで更新すべきページだけでなく、アーカイブや統合すべきページも明示的に尋ねる必要があるということです。見つけ方については、古くなったヘルプセンターコンテンツのガイドでさらに詳しく説明しています。
書き込みは静かに失敗する
"But the main problem is really that it can sometimes just not insert it."
これは Hermes がリサーチの要約をノートに送り込む話でした。ヘルプセンターでも対処は同じです。書き込みの後、プラットフォーム上に記事が実在することを確認し、週次レポートには、エージェントが作ろうとしたものではなく、実際に作成されたものを載せてください。
個人規模ならうまくいくが、会社規模は難しい
"There are a few successes on an individual level (I really like Hermes[0]) but nothing scales to a company level easily."
Hermes のメモリはプロフィールごとに分かれており、共有したいものについては、ドキュメントが外部メモリプロバイダーを案内しています。ドキュメント担当者が 1 人なら問題ありませんし、だからこそ、サポートナレッジの継承を 1 人のエージェントに任せることはできません。全員が同じ答えを期待する 15 人のサポートチームでは、共有の情報源はヘルプセンターでなければならず、上のプラットフォーム表に戻ることになります。
書かれているものを監査するが、顧客が尋ねることは監査しない
サポート担当者として、私が最も重く見る欠点がこれです。llm-wiki のリントは、古いページや矛盾するページを見つけます。しかし、先月、記事のない機能について質問するチケットが続いたことは教えてくれません。自分で作り込まない限り、Hermes にはヘルプデスクのチケットを読んでそれを見つける仕組みがないからです。r/startups のある創業者が言うように、仕事の大きな部分は "which legacy articles are broken by a new feature" を知ることです(u/19Vicus90, Reddit r/startups)。それが最初に現れる場所がチケットです。どのヘルプデスクがそうしたシグナルを標準で提供するかは、ナレッジギャップ分析の記事で扱っています。
ナレッジベース保守における Hermes とサポート向けに作られた選択肢の比較
Hermes のために公平に言えば、ドキュメントがリポジトリ内の Markdown で、サーバーを自分で持つことに抵抗がないなら、柔軟で無料の保守役であり、llm-wiki のリントは Markdown ウィキ向けとしてよく考えられた古いページのチェックです。コストがかかるのは、サポートチーム向けの AI ナレッジマネジメントが必要とする、サポート固有の連携部分です。
| Hermes Agent | eesel ヘルプデスクチームメイト | |
|---|---|---|
| ナレッジの置き場所 | 自分で組み込む MCP や API で接続するナレッジベース | ソースとして接続するナレッジベース(Zendesk、Confluence、Notion、Google Drive、ウェブサイトなど) |
| チケットから不足を見つける | 標準では非対応 | レポートに、実際の会話から作られる Knowledge gaps カードが表示される |
| 不足している記事のドラフト | 可、プラットフォームのドラフト経路を使う | Update knowledge base スキルが不足記事をドラフトする |
| Markdown の古いページのリント | 可、llm-wiki | 主眼ではない |
| 公開前のレビュー | 任意(trust: untrusted、書き込み承認) | アクションは承認を経由する |
| 実行場所 | 自分のマシンまたはサーバー | ホスト型 |
| コスト | 無料のソフトウェア、加えてモデルトークンとホスティング | 500 クレジットで月額 $299 から、100 クレジットの無料枠 |
eesel がすべての人にとって最良とは限りません。ヘルプセンターが GitHub のドキュメントサイトで、それについてチケットを出す人がいないなら、Hermes とドラフトのプルリクエストのほうが心地よいループです。ナレッジベースが顧客への回答のために存在するなら、チケットは手元にある最良のシグナルであり、私ならそこから始めます。より広い視点は、Hermes の代替と AI ナレッジベースツールの比較記事で網羅しています。
ナレッジベースの保守に eesel を試す
ヘルプセンターを正直に保つためにサーバーを運用したくないなら、eesel の AI ヘルプデスクチームメイトは、すでにお持ちのナレッジにつながります。Zendesk、Confluence、Notion をソースとして接続し(Notion は 1 接続あたり最大 15,000 ページ)、すべての返信に出典を付けて回答し、ドキュメントでは答えられなかった質問に当たるたびに記録します。
それらは Reports にナレッジギャップとして表示され、Update knowledge base スキルが不足している記事をドラフトして、チームの承認を待ちます。お使いのワークスペースでそのスキルのタイルが "Contact us" と表示されている場合は、eesel に有効化を依頼してください。

コマンドラインツールもあるので、Hermes のワークフローが気に入ったなら、あなたや Claude Code のようなコーディングエージェントが、ターミナルからソースの接続、手順の確認、保留中のアクションの承認を行えます。料金ページから、カード不要で 100 クレジットの無料で始められます。ご自身のヘルプセンターで eesel を試して、最初の 1 週間でどんな不足が見つかるか確かめてください。