

Qu'est-ce qui compte comme feedback à un agent du support ?
Le feedback à un agent du support est tout signal qui lui dit comment une réponse a été reçue et quoi faire autrement la prochaine fois. La plupart des équipes pensent à la grille de notation QA, mais c'est une source sur cinq, et en général la plus lente.
| Source | Qui le donne | Vitesse d'arrivée | À quoi il sert |
|---|---|---|---|
| Notes sur les tickets en cours | Agent senior ou responsable d'équipe | De quelques minutes à quelques heures | Corriger une réponse avant ou juste après son envoi |
| Évaluations QA | Analyste ou responsable QA, avec une grille de notation | De quelques jours à quelques semaines | Cohérence dans l'équipe, repérage de tendances |
| Commentaires CSAT des clients | Le client | De quelques heures à quelques jours | Ton et résultat, avec les mots du client |
| Indicateurs | Le rapport du helpdesk | Hebdomadaire | Tendances : durée de traitement, taux de réouverture, résolution |
| Auto-évaluation et évaluation par les pairs | L'agent lui-même ou un autre agent | Selon le planning | Construire le jugement, partager ce qui marche |
Je travaille la file de support d'eesel tous les jours, et le feedback qui a changé ma façon d'écrire des réponses ne venait presque jamais d'un score. Il venait de quelqu'un qui laissait une note sur un ticket que je venais de traiter, pendant que je me rappelais encore pourquoi je l'avais écrit ainsi.
C'est le cadre du reste de ce guide : chaque source a son rôle, et les problèmes commencent quand une équipe attend de la plus lente qu'elle les remplisse tous.
Pourquoi la plupart des feedbacks aux agents du support ne changent-ils rien ?
Demandez aux agents ce qu'ils pensent du feedback et vous entendrez toujours les mêmes quatre plaintes. Aucune n'est "mon manager a été trop direct".
Il arrive trop tard. Une évaluation QA rédigée deux ou trois semaines après le ticket demande à l'agent de se souvenir d'une conversation dont il a eu cent autres depuis. À ce moment-là, l'habitude s'est répétée des dizaines de fois.
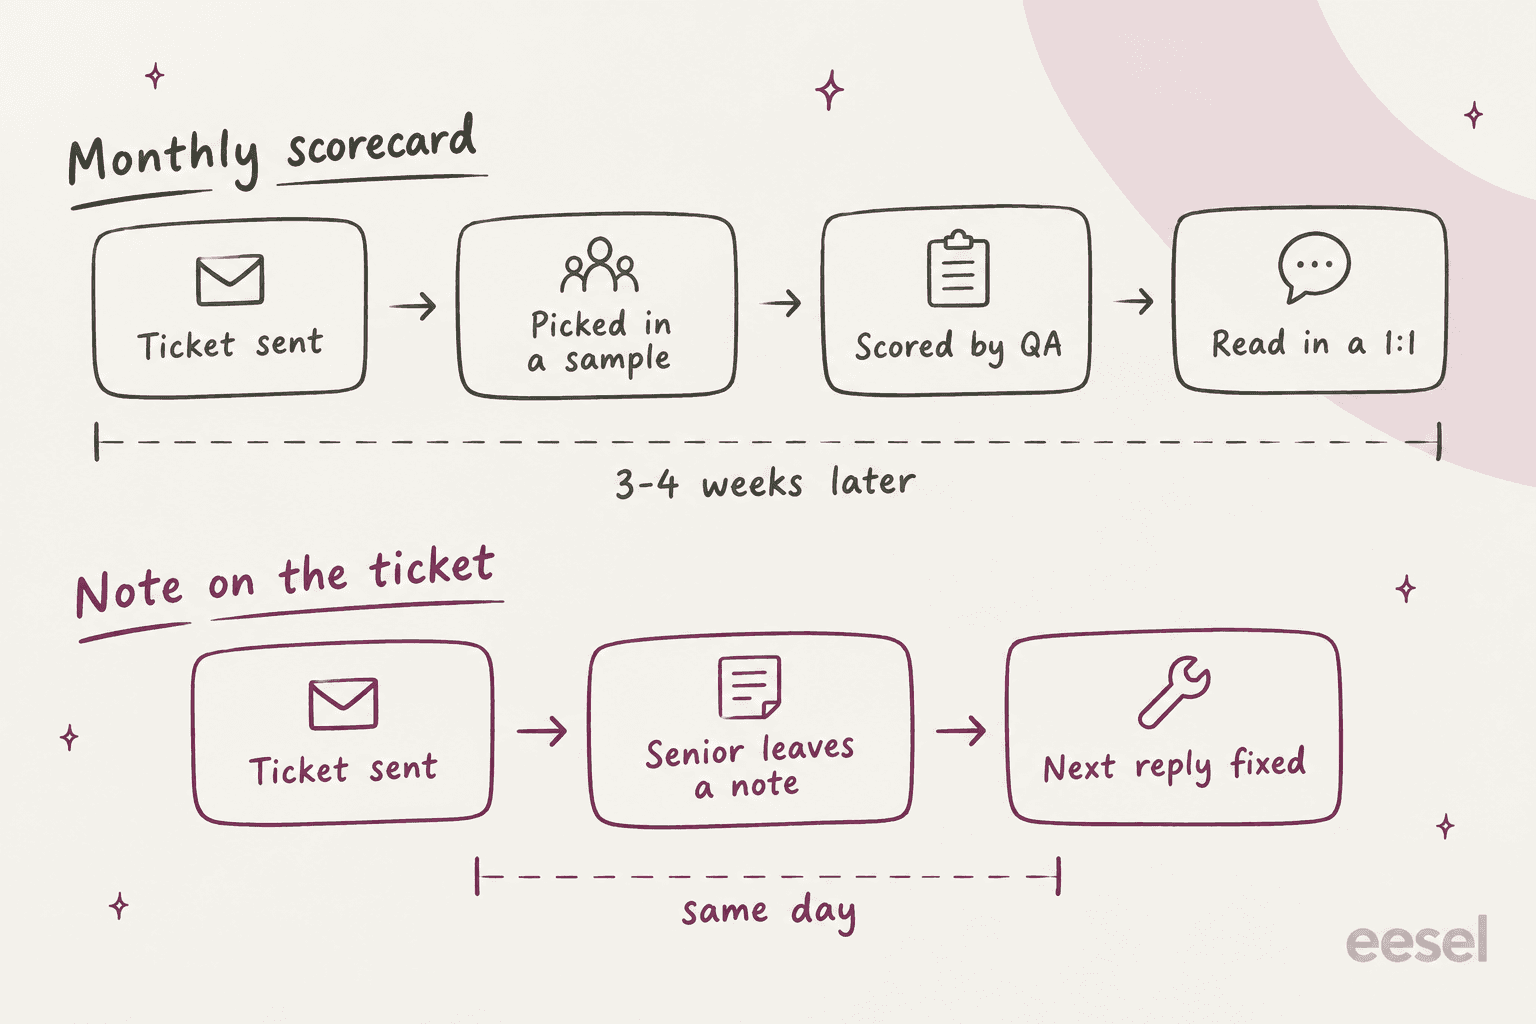
C'est un score sans conversation. C'est le principal. Un pourcentage dit à l'agent que quelque chose a mal tourné, jamais quoi faire sur le prochain ticket.
"I've gotten the same QA scores for weeks now. I haven't reviewed a single call with my boss yet and I've been graded on 8 or 9 calls. She's sent out a copy of the QA agent rubric sheet for two or three of them - the rest, no detail at all. But with no info on account and no call review or coaching on it, I really can't process the percentage score."

L'échantillon est trop petit pour être équitable. Quand un évaluateur lit deux tickets par mois et par agent, un mauvais ticket devient toute l'histoire. Un agent a eu un zéro sur un appel par ailleurs parfait parce que son chien avait aboyé : "Out of hundreds of calls, they got the one where he barked!" Un autre a fait remarquer que les évaluateurs évitent les tickets difficiles et notent les courts que n'importe qui réussit, ce qui récompense exactement les mauvais agents.
La grille de notation mesure la mauvaise chose. Les agents apprennent ce qui compte vraiment pour vous à la pondération, pas à l'affiche des valeurs sur le mur.
"I did tech support, only 30% of our score was actually fixing the user's problem. 70% was getting the opening/closing right, bullshit empathy statements, positive responses about being able to fix the problem (even when I couldn't because it was a misroute that I'd have to transfer), offering to send the knowledge article you were using, etc.."
Les indicateurs utilisés comme feedback ont le même défaut, en plus bruyant. Sur Hacker News, un ancien agent de centre d'appels a décrit une équipe tellement focalisée sur la durée moyenne des appels qu'il était "common practice" de contrarier les clients exprès pour qu'ils demandent un superviseur et que l'appel puisse être transféré. Un autre a décrit un appel de traducteur qui a duré près d'une heure et le seul feedback du lendemain, selon son récit, était "your handle time is too high." Il est parti en moins d'une semaine.
La bonne nouvelle, c'est que les agents savent clairement ce qu'ils veulent à la place. Un habitué de r/callcentres passe chaque feedback au crible de trois questions : est-il objectif, est-il équitable et est-il constructif ? Si l'évaluateur "can't give practical advise", il est ignoré. C'est une meilleure grille pour les managers que la plupart des supports de formation.
Le rythme du feedback : quotidien, hebdomadaire, mensuel, trimestriel
La solution à un feedback tardif et maigre n'est pas plus de QA. C'est de placer chaque type de feedback sur la cadence pour laquelle il est vraiment bon. Voici le rythme que je mettrais en place pour une équipe de cinq à 50 agents.
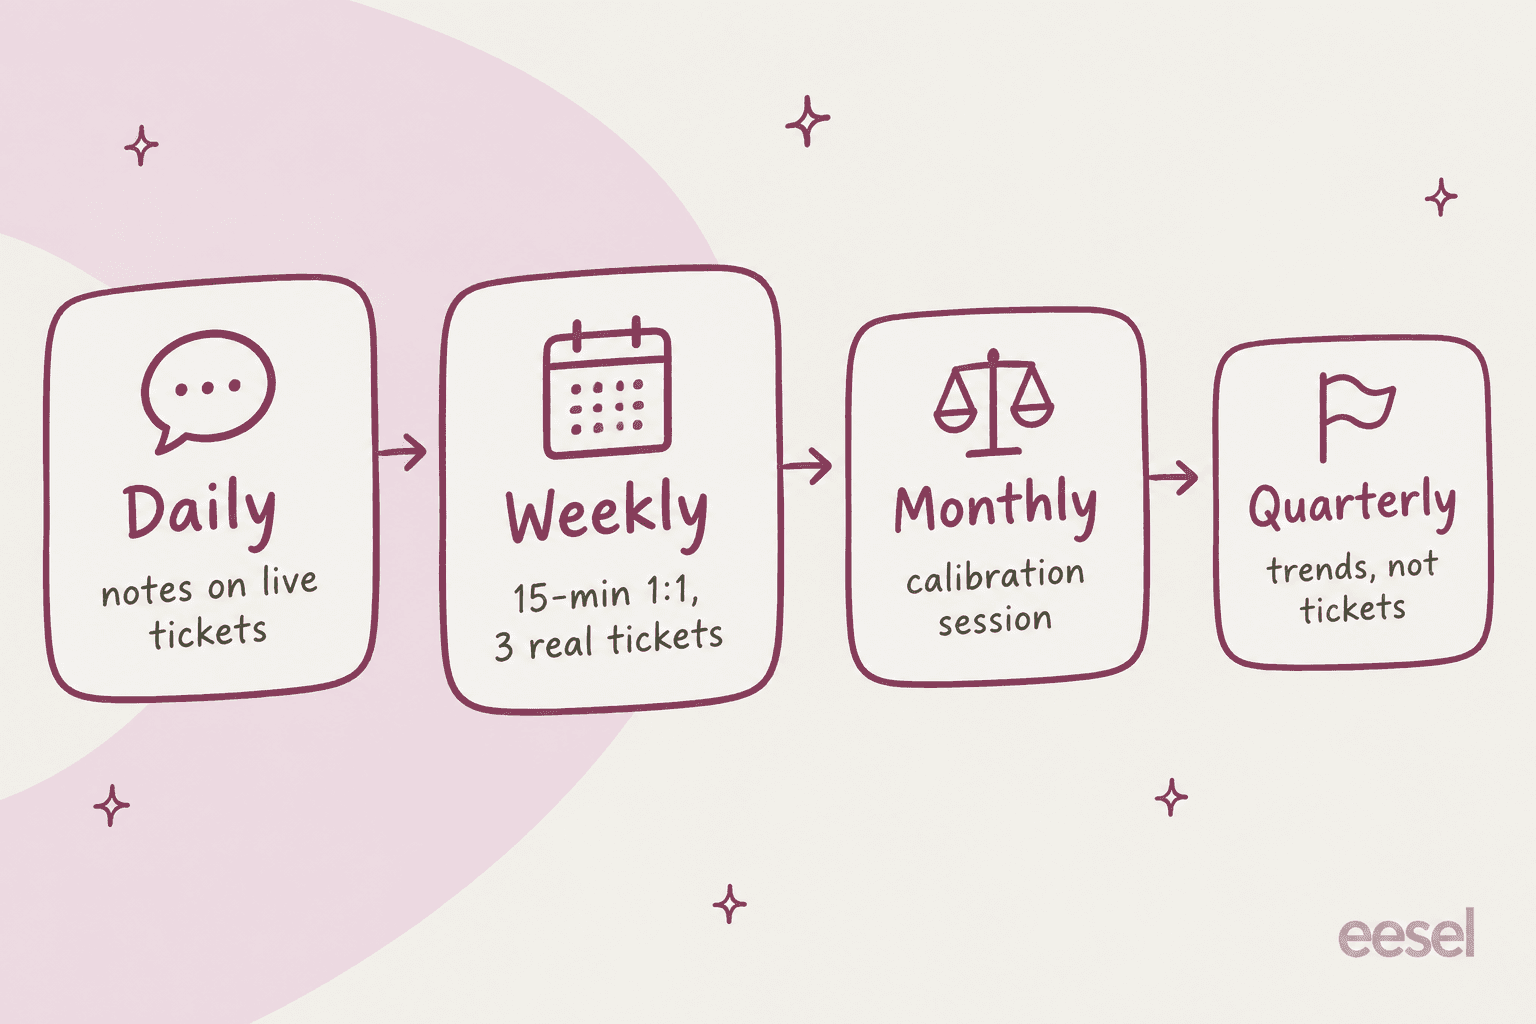
Quotidien : notes sur les tickets en cours
C'est la couche qui enseigne le plus, et celle que la plupart des équipes ne formalisent pas. Un senior ou un responsable lit une poignée de réponses par jour et laisse une courte note interne sur le ticket : ce qui a marché, ou l'unique chose à changer. Pour les nouveaux agents, allez un cran plus tôt et relisez les réponses avant l'envoi.
Un responsable support sur Hacker News décrivait exactement cela : les nouveaux agents suivent les experts, et quand leur responsable les juge prêts, ils traitent des tickets "reviewed by a senior before sending," d'après ce fil. C'est le feedback le moins cher que vous donnerez, car il arrive pendant que l'agent a encore le problème du client en tête. Mon guide d'onboarding explique comment configurer ces accès réservés aux notes selon le helpdesk.
Tous les helpdesks peuvent le faire avec des outils que vous payez déjà. Les fils privés de Freshdesk, les notes de Help Scout, les notes internes de Gorgias et les commentaires de Front notifient la personne que vous @mentionnez (détails par outil dans le tableau plus bas).
Hebdomadaire : un 1:1 de 15 minutes sur trois vrais tickets
Choisissez trois tickets de la semaine de l'agent : un bien traité, un qui a dérapé et un qu'il choisit lui-même. Lisez-les ensemble. Demandez ce qu'il ferait autrement avant de dire quoi que ce soit.
Trois tickets, c'est le bon nombre. Un seul donne l'impression d'un verdict sur une mauvaise journée ; dix en font un sermon. Apportez aussi ses commentaires CSAT, car les mots d'un client ne pèsent pas comme ceux d'un évaluateur.
"It sounds like your boss is really letting you down. A big part of their job is to help you perform better. When I worked the floor I'd have a weekly meeting with my boss and we'd go over my surveys then."
Gardez un équilibre honnête. Un responsable QA de régulation 911 a dit sur Reddit qu'il donne "a lot of positive and supportive feedback as well as coaching feedback." Si chaque 1:1 est une liste d'erreurs, les agents cessent de vous apporter les tickets dont ils doutent. Pour la formulation, mon article sur les exemples de feedback QA propose des formulations avant et après par critère de la grille.
Mensuel : calibrez les évaluateurs, pas les agents
Quand trois évaluateurs donnent trois scores différents au même ticket, les agents le remarquent, et chaque score suivant devient suspect. Un agent a raconté avoir lu le script mot pour mot et reçu quand même "3 different scores" de trois évaluateurs.
Le calibrage est la solution. Tout le monde note séparément le même petit lot, puis on se réunit et on s'accorde sur la bonne réponse. La version la plus concrète que j'aie trouvée vient d'un ancien responsable d'équipe qualité :
"Every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
Zendesk QA intègre des séances de calibrage, avec une évaluation de référence pour comparer. Deux réserves à connaître : le calibrage n'envoie aucune notification, donc le responsable doit prévenir les évaluateurs qu'une séance existe, et les agents n'en voient rien. Ce sont deux choix de conception raisonnables, mais mettez vous-même la séance au calendrier.
Trimestriel : des tendances, pas des tickets
La conversation trimestrielle est l'endroit où les indicateurs ont leur place, et seulement comme tendances. "Votre taux de réouverture est passé de 9 % à 5 % depuis mars" est utile. "Vous avez eu une durée de traitement élevée le 14" ne l'est pas. Mes exemples d'évaluation de performance et le guide des KPI expliquent quels chiffres tiennent la route.
Si vous voulez un guide à choix pour savoir où va un feedback précis, voici la version que je garde épinglée :
Où ce feedback doit-il aller ?
Choisissez la situation. Vous obtenez le canal, le moment et une phrase à adapter.
- "Petite chose : ce client a le forfait annuel, donc le délai de remboursement est de 30 jours, pas 14. Peux-tu envoyer un message pour corriger ?"
- Si la règle n'est pas claire non plus dans le centre d'aide, corrigez l'article dans la même séance.
- Demandez d'abord : "Comment penses-tu que ce client s'est senti en lisant ta réponse ?"
- Montrez ensuite une phrase réécrite, pas un e-mail réécrit.
- Mettez à jour la macro, l'article d'aide ou les instructions de l'IA qui produisent sans cesse l'erreur.
- "J'ai mis à jour la macro d'expédition, tu n'auras plus besoin de te souvenir de l'exception."
- "Ton taux de réouverture est passé de 5 % à 9 % en six semaines. Sortons trois tickets rouverts et voyons ce qu'ils ont en commun."
- N'évoquez jamais une seule mauvaise journée comme un indicateur.
- "Cette réponse au ticket de double facturation est maintenant le modèle. Claire, courte, et elle a répondu à la question suivante avant qu'on la pose."
- Les félicitations en public servent de formation pour tous les autres.
Comment donner un feedback que les agents peuvent vraiment utiliser
Le rythme décide du quand. Ces cinq habitudes décident si l'agent repart en sachant quoi faire autrement.
- Ancrez chaque point à un vrai ticket. "Sois plus empathique" ne veut rien dire. "Sur le ticket 4182, le client disait avoir été débité deux fois ; ta première ligne est allée directement aux étapes de remboursement" est quelque chose qu'un agent peut visualiser et corriger.
- Une chose par séance. S'il y a cinq problèmes, choisissez celui qui coûte le plus au client. Les quatre autres peuvent attendre une semaine, et l'agent retiendra vraiment le premier.
- Demandez avant de dire. "Que changerais-tu ici ?" Une fois sur deux, l'agent le repère lui-même, et un feedback auquel on arrive soi-même s'ancre mieux que celui qu'on reçoit.
- Dites pourquoi cela compte pour le client. "Confirme le numéro de commande" est une règle. "Confirme le numéro de commande, parce que deux des réouvertures de la semaine dernière étaient des remboursements envoyés sur la mauvaise commande" est une raison.
- Séparez le coaching de la notation. Un 1:1 qui se termine par "et c'est pour ça que tu es à 72 %" rend toutes les conversations futures défensives. Gardez le score pour l'évaluation ; le 1:1 porte sur le prochain ticket.
J'ajouterais une règle pour qui gère une équipe mixte de nouveaux et d'agents expérimentés : ne jugez pas les nouvelles recrues sur la même grille dès la deuxième semaine. Une responsable d'équipe sur Reddit, réagissant au renvoi d'une promotion de nouvelles recrues après 10 jours sur un objectif de 80 %, l'a dit simplement : "10 days is nothing." Mon guide du temps de montée en compétence donne les délais que les équipes constatent réellement.
Laissez les agents répondre : contestations et auto-évaluations
Un système de feedback sans moyen de ne pas être d'accord est un système de notation. Les agents connaissent la différence, et les histoires de contestation sur r/callcentres sont une leçon sur ce qui tourne mal.
Un agent a contesté un score de 95,5 %, son responsable était d'accord, et l'évaluation est revenue à 90,25 % avec environ huit "new errors found," a écrit l'agent. Un autre disait que les contestations sur de mauvaises enquêtes étaient "almost always ignored for months," puis refusées, selon son commentaire. Et quelqu'un a remarqué qu'un score avait changé discrètement après un appel réussi, sans aucun message : "an acknowledgment of it would be nice."
Comparez avec ce à quoi ressemble un processus qui fonctionne :
"If there's a problem with one of my scores and I feel I have a reason to dispute we have a process, but I've never even had to use it because the scorer just looks at it and either clarifies in a way that makes sense to me or changes it because they agree with me. They are reasonable, and not retaliatory, even the semi cranky ones. That's how adults behave at work."
Les règles qui font la différence sont simples : une raison écrite de l'agent, un délai de traitement fixé, une décision expliquée dans tous les cas et une notification quand c'est réglé. Un évaluateur de l'autre côté en a ajouté une que j'aime : quand la QA se trompe, "we own up to it and award the points back and issue an apology," comme l'a dit un évaluateur QA.
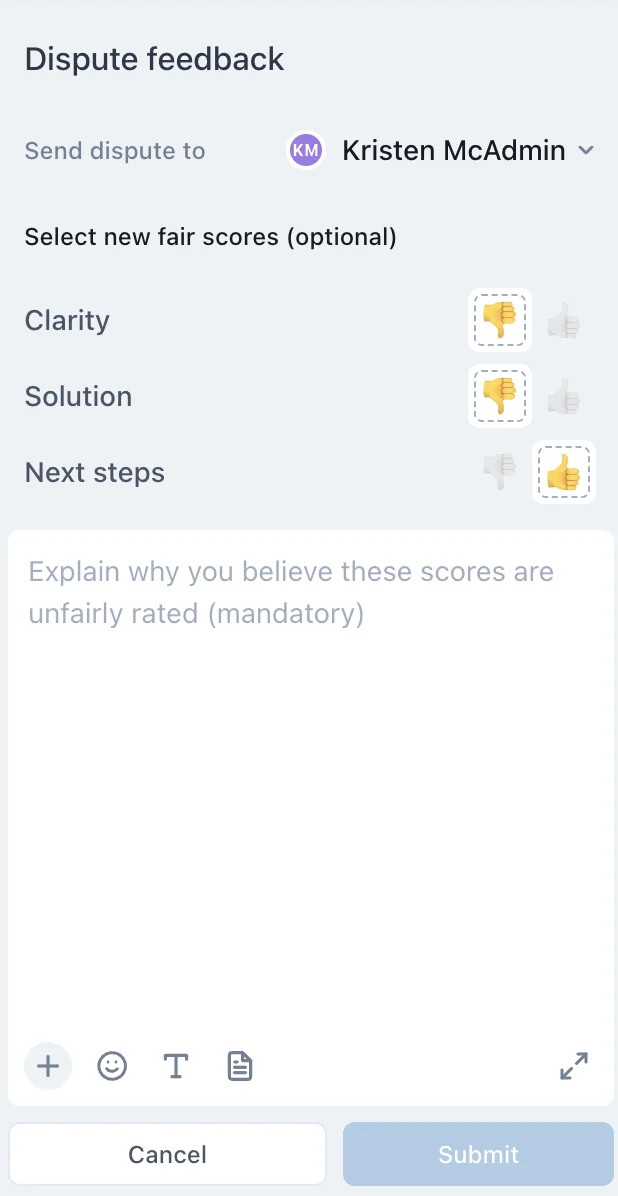
Zendesk QA intègre l'essentiel au produit. Un agent ouvre l'évaluation, choisit qui reçoit la contestation, peut proposer de nouveaux scores par catégorie et doit écrire un commentaire expliquant pourquoi. Le destinataire accepte, accepte en partie ou rejette, les deux côtés sont notifiés, et il n'y a pas de limite de contestations par évaluation, d'après la documentation de contestation de Zendesk QA.
Il y a aussi un tableau de bord des contestations avec le temps moyen de résolution en jours et un tableau des évaluateurs les plus contestés, un moyen discret de repérer un évaluateur à calibrer. MaestroQA (désormais Rippit) appelle sa version les appels, avec une option pour qu'un responsable d'équipe examine d'abord l'appel, et Scorebuddy offre aux agents un parcours "request a review" depuis leur tableau de bord.
Les auto-évaluations sont la moitié sous-estimée. Zendesk QA permet d'activer les auto-évaluations par espace de travail, pour que les agents notent leurs propres conversations avec la même grille. Faites-en une par mois à côté du score de l'évaluateur, et l'écart entre les deux chiffres est souvent un meilleur sujet de 1:1 que l'un ou l'autre seul.
Où vit le feedback dans votre helpdesk
C'est ici que cela devient pratique, et c'est là que j'ai trouvé les plus grandes surprises dans la documentation des éditeurs. Tous les helpdesks ne laissent pas les agents voir leurs propres scores de qualité, et les modules de notation IA sont volontairement prudents sur l'usage de leurs scores.
| Outil | Où le feedback est écrit | Agent notifié ? | Voie de contestation | Auto / évaluation par les pairs | Notation IA | Prix |
|---|---|---|---|---|---|---|
| Zendesk QA | Commentaires d'évaluation (hashtags, @mentions), séances de coaching, épingles | Oui, par e-mail ou Slack, d'instantané à mensuel | Oui : nouveaux scores, commentaire obligatoire, accepter / en partie / rejeter | Les deux, plus calibrage | AutoQA, 8 catégories système | Module à $35/agent/mois, annuel |
| Front Smart QA | Grille IA dans la barre latérale, remplacement par l'admin avec commentaire, commentaires internes | @mentions oui ; aucune alerte spécifique QA documentée | Aucune documentée | Non documentée | 15 critères par défaut, jusqu'à 10 personnalisés | $20/siège/mois, inclus dans Enterprise |
| Gorgias Auto QA | Scores IA dans le ticket ; les responsables modifient ; notes internes | Notes oui ; les agents ne peuvent pas voir les scores QA | Aucune | Non documentée | 3 critères automatiques, 4 manuels | Nécessite un abonnement AI Agent |
| Freshdesk | Notes privées et fils privés avec @mentions | Oui, e-mail à la personne assignée et aux participants | Aucun module QA trouvé | Aucune trouvée | Aucune trouvée | Fils sur tous les forfaits |
| Help Scout | Notes avec @mentions | Oui, Notification Station plus e-mail facultatif | Aucun module QA trouvé | Aucune trouvée | Aucune trouvée | Notes sur tous les forfaits |
| MaestroQA / Rippit | Notes par grille, séances de coaching avec tâches | Non confirmé publiquement | Oui, appels avec approbation facultative du responsable | Programme d'évaluation par les pairs | AutoQA | Rippit Free, $185, $495/mois |
| Scorebuddy | Grilles de notation avec feedback de l'évaluateur, séances de coaching | Tableaux de bord des agents en temps réel | "Request a review" | Notation par les pairs et calibrage | 500 ou 1 000 scores IA/mois | Sur devis uniquement |
Quelques détails de ce tableau méritent d'être précisés, car ils changent la façon de mener le feedback sur chaque outil.
Zendesk QA suit si les agents lisent leur feedback. Son tableau de bord Reviews indique les Unseen reviews, la part des évaluations manuelles que l'agent n'a pas encore ouvertes, et le tableau de bord Coaching suit si les agents ont relu le feedback reçu. Si votre taux de non-vus est élevé, votre problème de feedback n'est pas la formulation, c'est la remise. La page Activity de l'agent réunit évaluations, commentaires, réactions, feedback CSAT et contestations au même endroit.
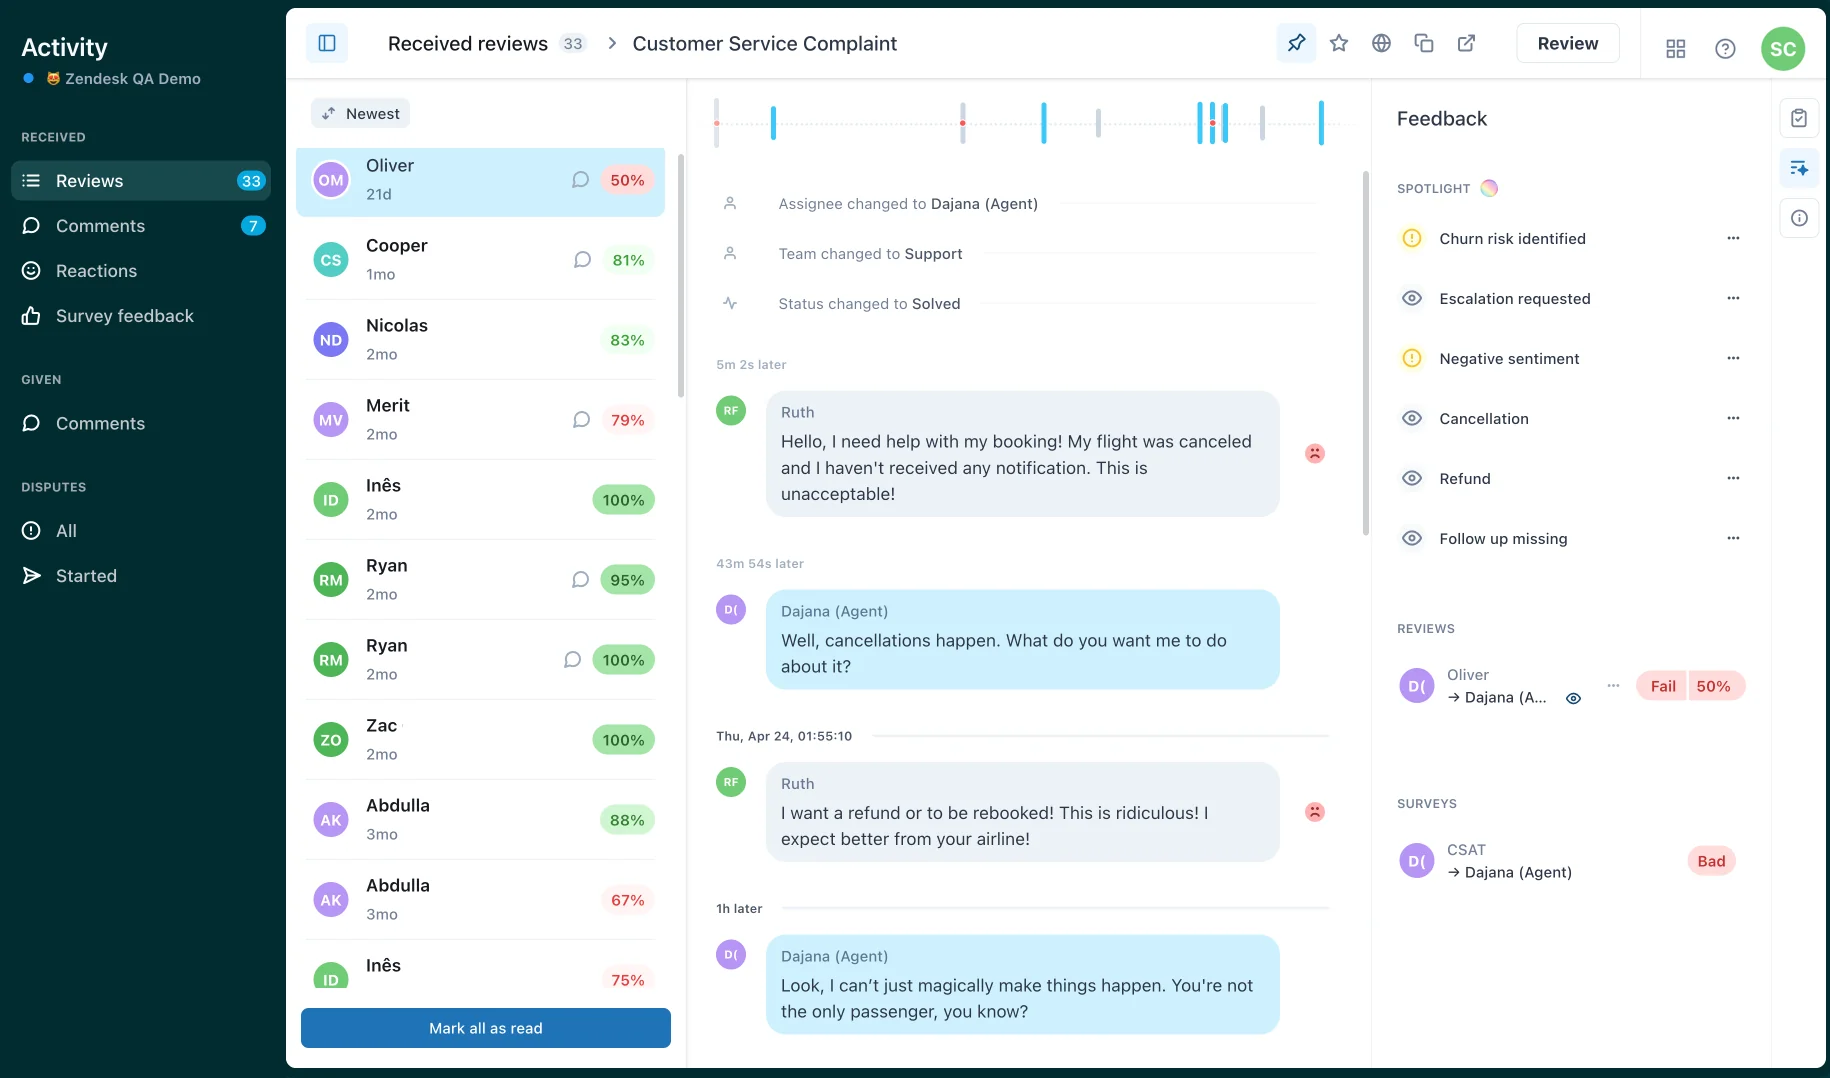
Zendesk garde séparés les scores IA et les scores humains. Les résultats d'AutoQA alimentent un score de qualité automatique, tandis que le score de qualité interne reste basé uniquement sur les évaluations manuelles, et la propre documentation des paramètres du compte de Zendesk dit que les évaluations d'AutoQA "are for guidance only and shouldn't be used for performance decisions." C'est une ligne sensée à reprendre même avec un autre outil. Le module QA coûte $35 par agent et par mois en plus de tout forfait Support ou Suite, d'après les tarifs de Zendesk.
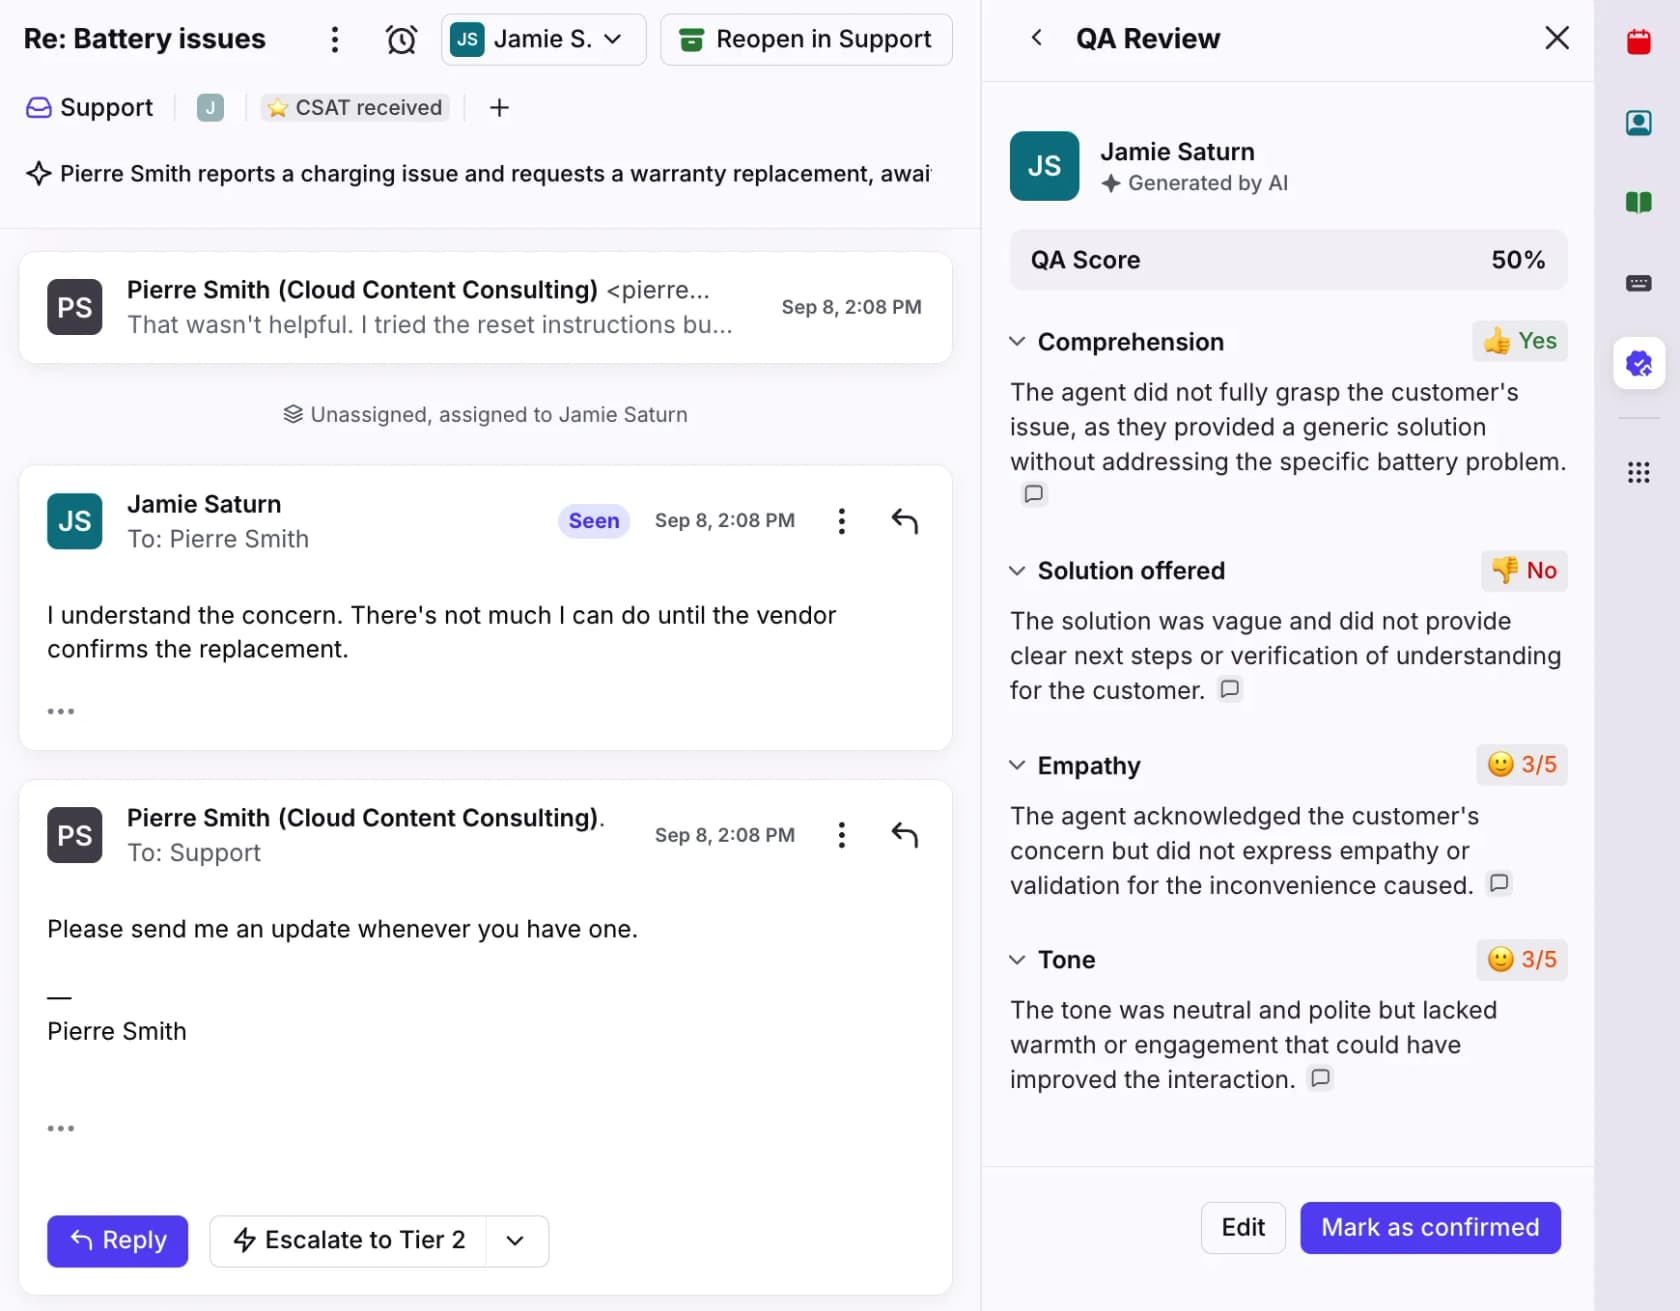
Front montre aux agents leurs propres scores IA, avec le raisonnement. Smart QA place une grille dans la barre latérale de la conversation avec une explication écrite par critère, et les agents ne voient que leurs propres résultats. Les admins peuvent remplacer un score, ajouter un commentaire et le marquer comme confirmé, auquel cas leur nom remplace "Generated by AI." Front demande aussi de prévenir les clients quand Smart QA note leurs conversations, ce que je ferais quel que soit l'outil. Il coûte $20 par siège et par mois sur Starter et Professional, et est inclus dans Enterprise à $105, d'après l'article d'aide Smart QA et les tarifs de Front.
Gorgias Auto QA est un outil de manager, pas du feedback pour les agents. Il note automatiquement l'exhaustivité de la résolution, la communication et la maîtrise de la langue, mais "only the account owner, admins, and leads can view and change QA scores," d'après la documentation d'Auto QA. Donc sur Gorgias, tout feedback qui atteint un agent passe par une note, un 1:1 ou un rapport que vous partagez. C'est très bien, tant que quelqu'un a réellement la conversation.
Freshdesk et Help Scout n'ont pas de grille de notation QA native dans leur documentation ou leurs pages de tarifs. Le feedback y passe par des notes et des @mentions, qui notifient bien l'agent, plus le CSAT. Les fils privés de Freshdesk permettent de commenter une réponse précise et d'associer la personne assignée, ce qui fonctionne bien pour la couche quotidienne. Si vous voulez des grilles de notation sur l'un ou l'autre, il vous faut un outil QA dédié.
Les commentaires CSAT sont la seule source que tous les grands helpdesks exposent aux agents. Dans Zendesk, la note s'affiche en haut du ticket avec les commentaires sous Events ; Freshdesk les montre dans les Activities du ticket ; Gorgias laisse tous les rôles ouvrir le rapport de Satisfaction avec ses commentaires mis en avant. Servez-vous-en dans le 1:1 hebdomadaire, pas comme classement.
Corrigez une fois : quand le feedback est en fait une réponse manquante
Voici la partie qui a changé ma façon de penser le feedback. Si vous vous surprenez à donner la même correction pour la troisième fois, à des agents différents, le problème n'est probablement pas les agents.
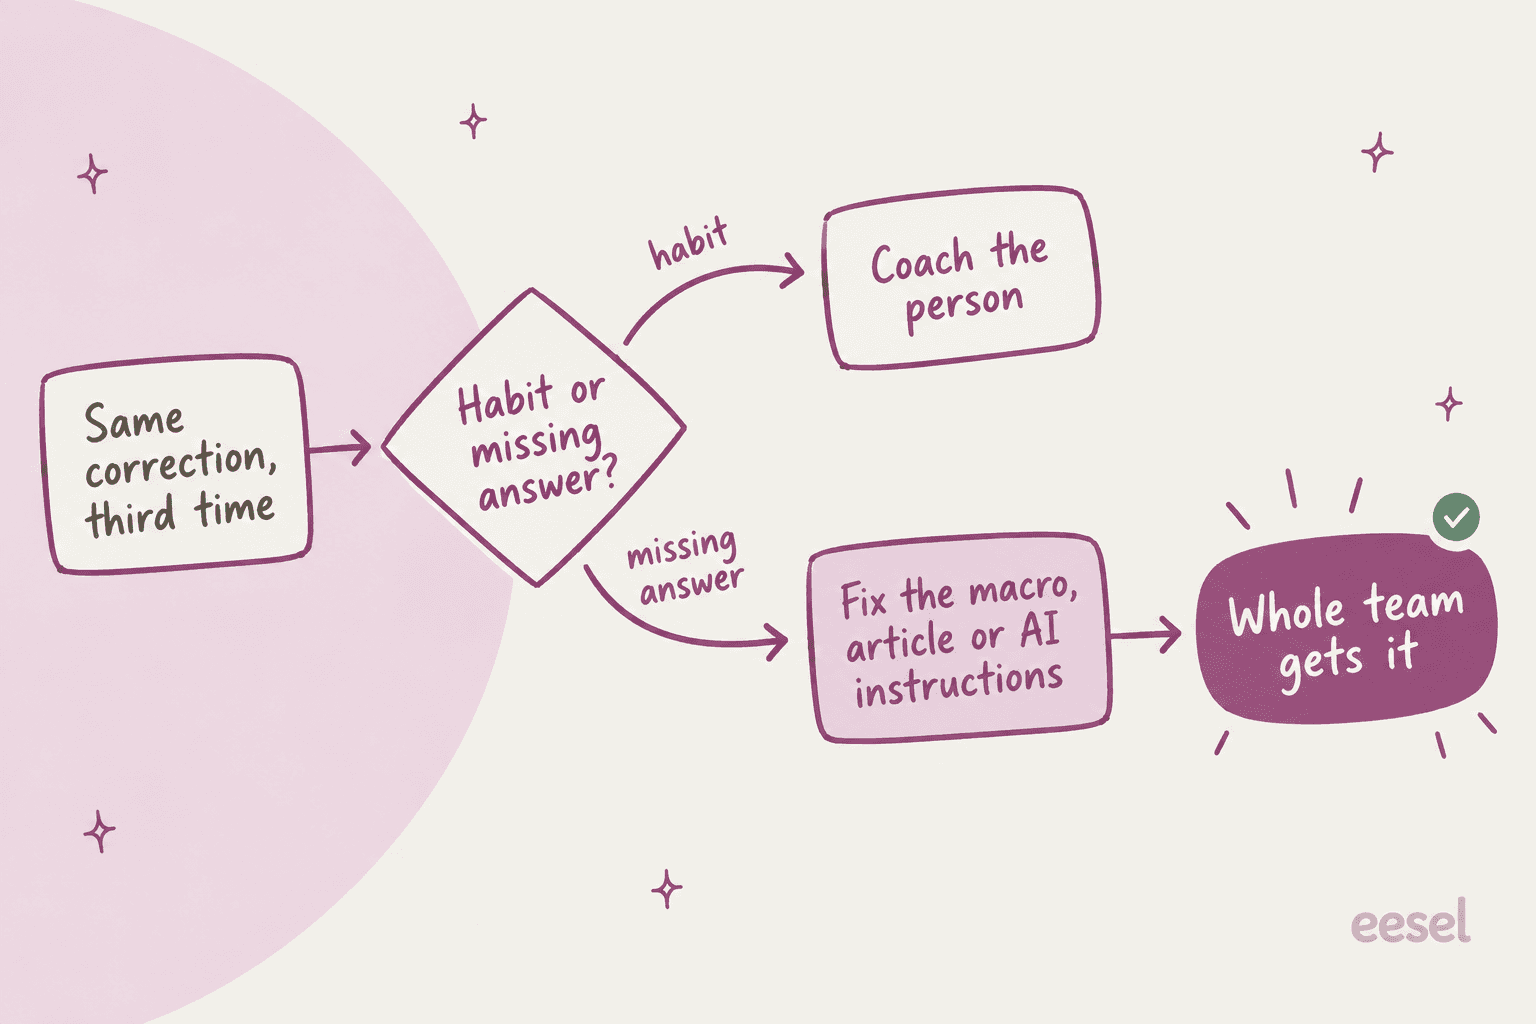
Les corrections répétées sont généralement un trou dans la base de connaissances, une macro périmée ou une règle qui vit dans la tête d'un senior. Coacher chaque agent séparément est lent, et la prochaine recrue tombe droit dans le même trou. Corriger la source une fois la corrige pour tous, et c'est souvent une modification de cinq minutes.
Je l'ai vu clairement dans un essai eesel que j'ai examiné. Les agents n'envoyaient les brouillons de l'IA sans changement qu'environ 12 % du temps ; le schéma habituel était "glance and rewrite", transformant de longs brouillons en réponses d'une à trois phrases. En détail, environ 65 % concernaient la longueur et le ton, environ 20 % nécessitaient des données auxquelles l'IA n'était pas connectée, et seulement environ 5 % étaient l'IA qui se trompait sur les faits. Chaque agent donnait le même feedback, à la main, sur chaque ticket. La solution n'a pas été de coacher les agents ou l'IA ticket par ticket. Elle a été d'entraîner sur les réponses envoyées par l'équipe elle-même, pour que les brouillons sortent dès le départ dans sa voix.
La même logique s'applique à votre équipe humaine. Tenez une liste continue des corrections issues des notes quotidiennes. Tout ce qui apparaît trois fois est corrigé à la source : l'article d'aide, la macro ou les instructions de l'IA. Mentionnez-le ensuite en 1:1 pour que l'agent sache que le problème venait du système, pas de lui. Ce seul geste fait plus pour le moral que n'importe quel sandwich de feedback.

Si un copilote IA rédige des réponses pour votre équipe, il a aussi sa place dans cette boucle. Il a besoin du même feedback qu'une nouvelle recrue, et l'avantage est qu'une correction faite une fois s'applique à tous les brouillons futurs. J'en ai écrit davantage dans mon guide sur le coaching d'un agent IA.
Erreurs qui font échouer le feedback aux agents du support
- Tout garder pour l'évaluation mensuelle. Quand elle arrive, l'agent répète l'habitude depuis des semaines. Les notes quotidiennes l'attrapent au deuxième ticket, pas au quarantième.
- Noter des tickets dont personne ne parle. Une évaluation que l'agent ne discute jamais est une note, pas du feedback. Vérifiez votre taux de non-vus si votre outil le remonte.
- Pondérer la grille vers les scripts. Si 70 % du score tient aux salutations et aux formules de clôture, les agents optimiseront salutations et clôtures. Pondérez davantage la résolution au premier contact et l'exactitude que la formulation.
- Utiliser les scores IA pour des décisions de performance. Même les éditeurs disent de ne pas le faire. Utilisez l'IA pour repérer les tickets qui méritent une relecture humaine, puis relisez-les.
- Évoquer une seule mauvaise journée comme un indicateur. Un appel de traducteur peut ruiner la durée de traitement d'une journée. Regardez les tendances sur trois semaines ou plus.
- Ne pas avoir de voie de contestation, ou en avoir une lente. Les agents qui ne peuvent pas répondre cessent de croire à tous les scores, y compris les équitables.
- Coacher les personnes sur un processus défaillant. Si trois agents font la même erreur, corrigez d'abord la macro ou l'article.
eesel pour le feedback aux agents du support
Si votre équipe reçoit sans cesse le même feedback sur les mêmes types de tickets, la correction la plus rapide est de mettre la bonne réponse sous les yeux des agents avant l'envoi. Le coéquipier helpdesk IA d'eesel se connecte à Zendesk, Freshdesk, Gorgias et au reste de votre stack, apprend de votre centre d'aide, de vos macros et de vos tickets passés, et rédige chaque réponse sous forme de note interne qu'un agent vérifie et envoie. Les nouveaux agents voient comment votre équipe répond à un remboursement ou à une panne avant d'écrire un mot, ce qui transforme beaucoup de feedback a posteriori en une retouche rapide en amont.

Ce que j'aime le plus pour le feedback : quand un responsable corrige une réponse dans le chat, eesel écrit cette correction dans ses propres instructions, si bien que le correctif apparaît dans tous les brouillons futurs au lieu d'être répété dans cinq 1:1 distincts. Un fondateur sur Freshdesk l'a formulé ainsi dans un avis G2 :
"When we re-test, it correctly incorporates the coaching... specifically on enabling newer team members to have a 24/7 supervisor that coaches them on how to handle inquiries."
Pour être clair sur le périmètre : eesel n'est ni une grille de notation QA ni un outil de contestation pour agents humains, gardez donc Zendesk QA, Front Smart QA ou une plateforme QA dédiée pour cela. Ce qu'il fait, c'est réduire la quantité de feedback correctif que vous devez donner au départ. Vous pouvez essayer eesel gratuitement avec 100 crédits et voir les brouillons sur vos propres tickets.
Comment donner un feedback à un agent du service client ?