
Qué significa realmente "Meta Muse para el control de calidad del soporte"
Trabajo la cola de soporte de eesel todos los días, y lo que me quita el sueño de la IA en soporte no es el bot que dice "no lo sé". Es el bot que responde con total seguridad y se equivoca. Así que cuando un equipo me pregunta cómo hacer QA del agente de WhatsApp de Meta, lo primero es aclarar de qué producto de Meta hablan.
"Meta Muse" son tres productos, y solo uno habla con tus clientes:
| Producto | Qué es | Papel en la QA de soporte |
|---|---|---|
| Muse | El agente personal de consumo de Meta | Ninguno |
| Muse Spark API | El modelo de Meta, invocable desde tu propio código | Un evaluador que podrías construir tú |
| Meta Business Agent | La IA de negocio de cara al cliente de Meta, lanzada el 3 de junio de 2026 | Lo que estás revisando, más sus herramientas de prueba |
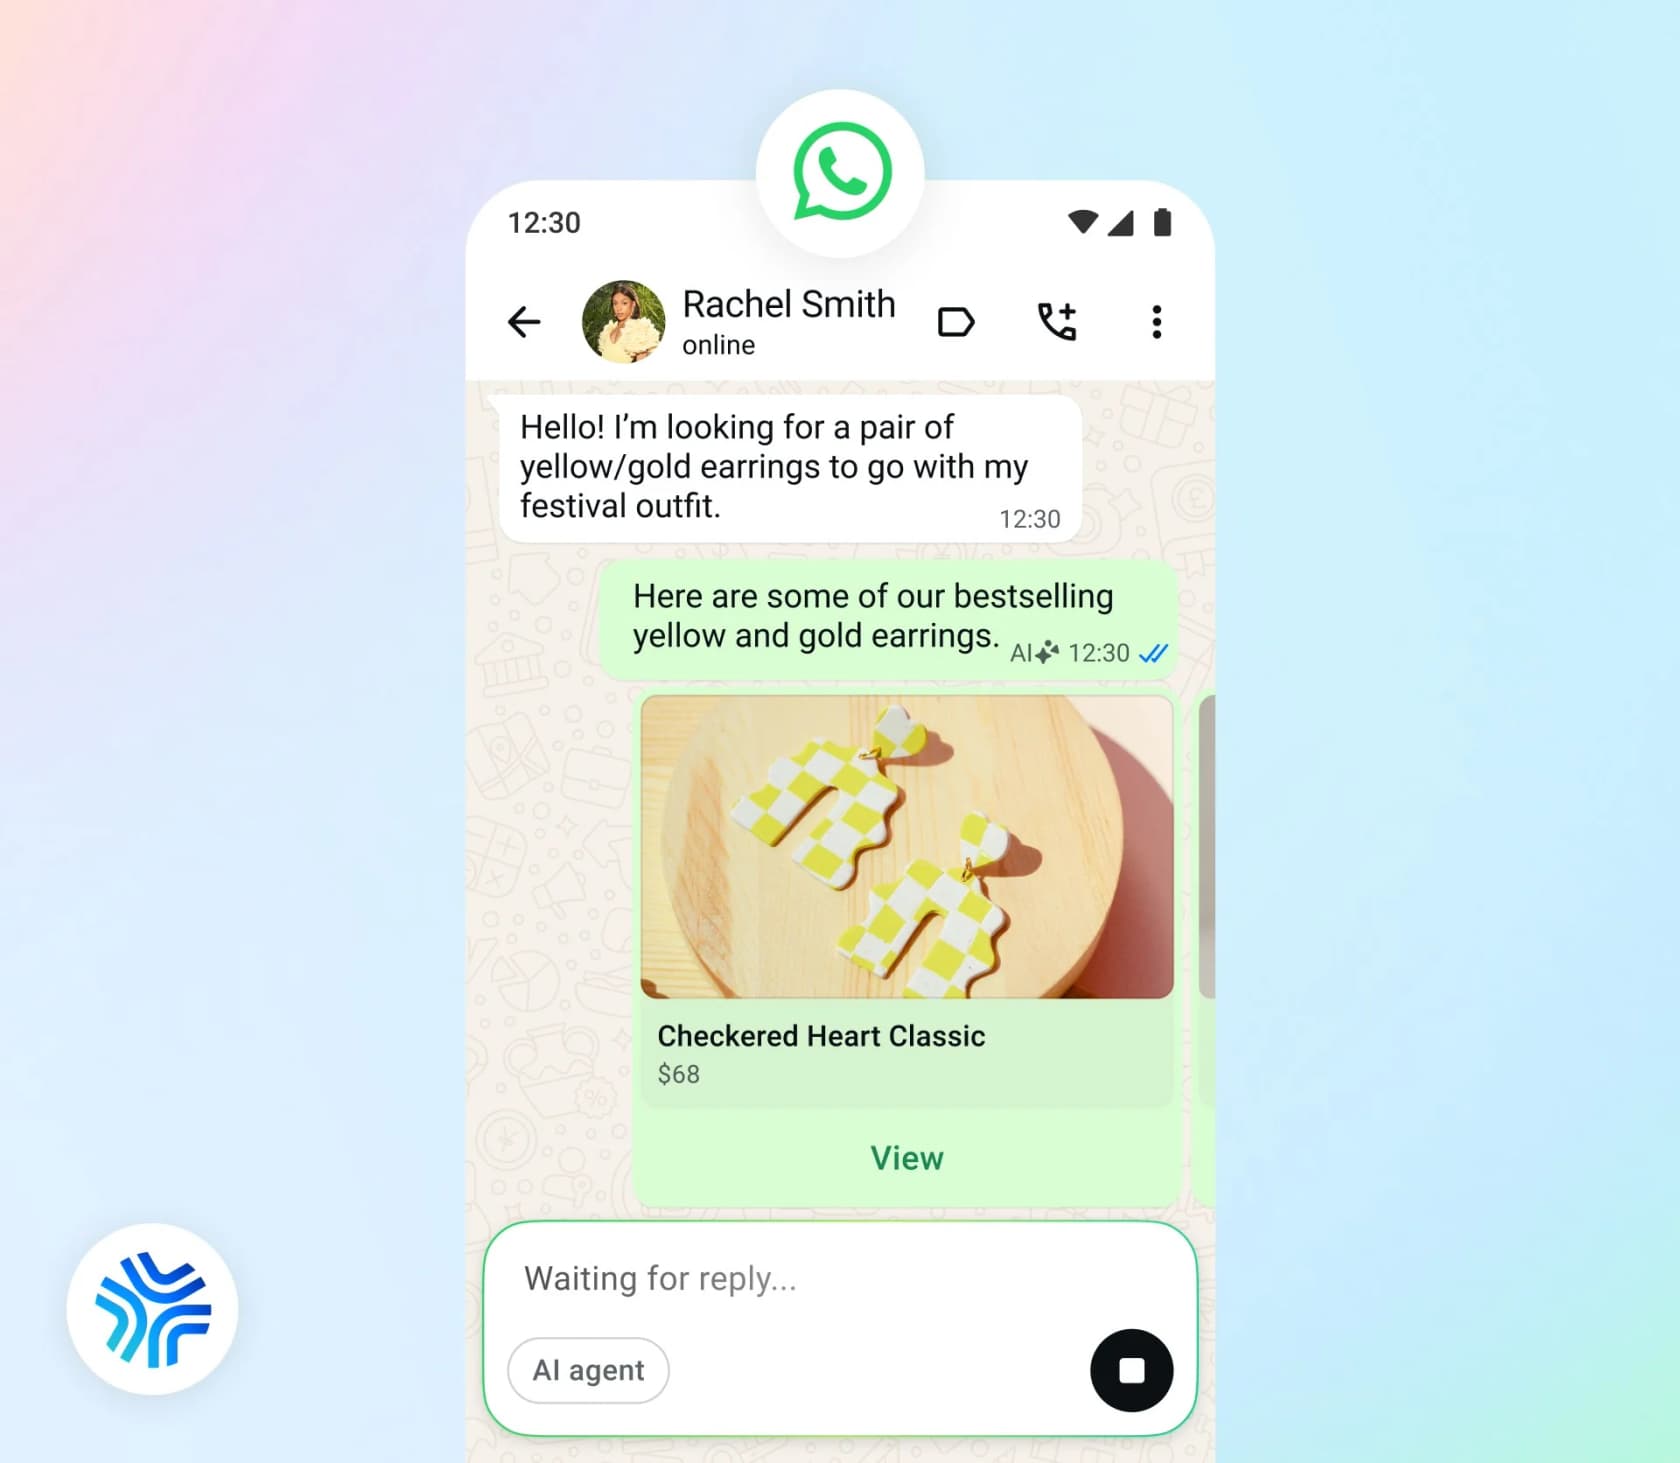
Business Agent viene en una versión de autoservicio dentro de Meta Business Suite y la app WhatsApp Business, y como Business Agent Platform para empresas en la API de WhatsApp Business Platform. El desglose completo del producto está en mi hub Meta Muse for customer support, y la app de consumo tiene su propio artículo sobre Meta Muse Agent.
Por control de calidad del soporte entiendo el trabajo habitual: comprobar que las respuestas son correctas, cumplen la política y respetan la marca, que el agente escala cuando debe y que el mismo error no se repite. Si eres nuevo en esto, mi introducción a la QA de soporte con IA cubre lo básico. La pregunta aquí es más concreta: ¿qué te da Meta para hacer ese trabajo?
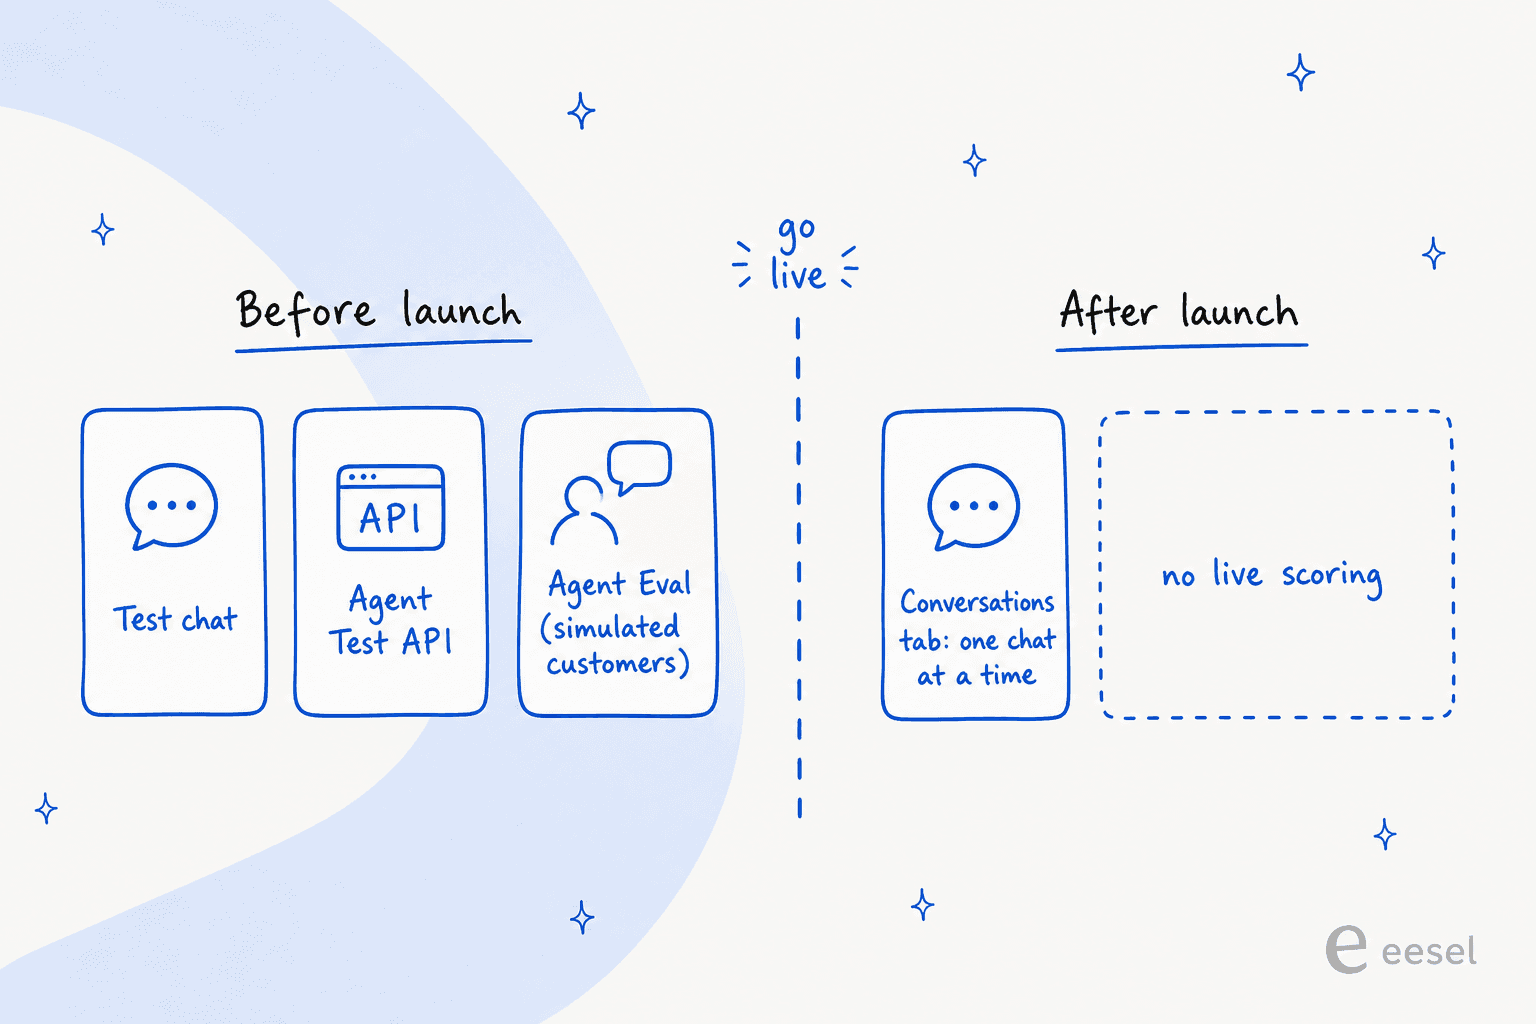
Las herramientas de QA de Meta están pensadas para antes del lanzamiento
Tras leer la documentación y las páginas de ayuda de Business Agent de Meta, lo resumiría así. Hay tres herramientas de prueba, y las tres revisan al agente con conversaciones que te inventas tú.
Test chat y "Improve AI response" (autoservicio)
En Meta Business Suite, "Under Test chat, you can chat with your Meta Business Agent as if you were a customer and give feedback on the responses you see" (Meta Business Help). Si una respuesta es incorrecta, haces clic en Improve AI response y das la respuesta correcta o una instrucción. El mismo botón funciona con mensajes reales pasados de la IA en la bandeja.
Dos detalles importan para la QA. Meta dice que el agente "will not respond using your exact words", así que una corrección es una orientación, no una respuesta fija. Y "Existing responses will not be updated", lo que significa que un arreglo solo cambia respuestas futuras. También puedes pasar el cursor sobre cualquier respuesta y hacer clic en View sources para ver qué conocimiento la produjo (Meta Business Help), que es la función de QA más útil del nivel de autoservicio.
La API Agent Test
En la Platform, Agent Test te permite "send free test messages to the agent without affecting live customer conversations" (Capabilities). Haces POST de un user_msg y devuelves conversation_id para continuar un intercambio de varios turnos. Es la versión API de Test chat, así que puedes automatizarla con scripts.
Agent Eval: un LLM juez puntúa clientes simulados
Agent Eval es la pieza más interesante. Un caso de eval tiene un scenario, descrito como "Free-form text defining the task and constraints for the user simulator", más success_criteria y max_turns. POST /run "runs simulation, evaluation, and optionally insights across multiple cases."
Lo que devuelve es rico. Cada conversación recibe un score global "from the judge LLM", etiquetas por turno y reasons con categoría, puntuación, descripción y acciones recomendadas. El informe resumen da avg_conversation_score y avg_turn_score en escala de 1 a 5, un resumen en lenguaje natural, aspectos destacados y top_failure_categories.
Es un arnés de regresión de verdad, y yo lo usaría. Pero fíjate en qué se evalúa: una conversación entre tu agente y un cliente simulado que tú describiste. Te dice que el agente maneja los casos en los que pensaste. No puede decirte nada de los casos en los que no pensaste.
El plan de pruebas que recomienda Meta (y la frase que vale la pena enmarcar)
La guía de agentes de atención al cliente de Meta incluye un plan de pruebas de diez filas para un agente de retail: preguntas de política, "¿Dónde está mi pedido?" sin número de referencia, devoluciones dentro y fuera del plazo, un espejo roto, "Quiero un reembolso y lo quiero hoy", "Pásame con alguien", una pregunta sin respuesta documentada y "Es la tercera vez que escribo."
Dice que las últimas cuatro "are the ones worth automating as a regression suite. They are where an agent that is trying to be helpful does the most damage." Y luego la frase que yo pondría sobre todos los escritorios de QA de soporte:
"A support agent is judged on its worst answers rather than its average one, and the failures that matter are confident answers to questions it had no basis to answer."
Estoy de acuerdo con cada palabra, y también es el mejor argumento de por qué las pruebas previas al lanzamiento no bastan. Tus peores respuestas vienen de preguntas que nadie anticipó, y un conjunto de eval solo contiene preguntas que alguien anticipó.
El resto de consejos de la guía relevantes para QA también son sólidos: escribe los disparadores de escalado como una lista con nombre ("damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person"), da al agente solo acciones reversibles y calcula la elegibilidad de devolución en tu propio sistema en lugar de dejar que el agente compare fechas, porque "it tends to err generously." Si escribes tu propia suite, mis notas sobre pruebas adversarias ayudan con los casos difíciles.
Después del lanzamiento: una conversación a la vez
Cuando el agente está en vivo, esto es con lo que puedes hacer QA.
Nivel de autoservicio. La pestaña Conversations "is where you can click into each chat to review your Meta Business Agent's responses", con View sources en cada respuesta (Meta Business Help). Meta también señala que "does not start storing conversation logs until a customer has opened the chat." Los clientes pueden "long press on any Meta Business Agent message to provide feedback" (Meta Business Help), pero no encontré ningún informe ni exportación documentada de ese feedback para la empresa.
Nivel Platform. No hay ningún endpoint que devuelva conversaciones pasadas del agente. Revisé cada página de referencia que enlazan los docs. La única forma de llevar transcripciones a tu sistema son los webhooks standby, que te envían los mensajes del cliente, copias de las respuestas del agente y confirmaciones de lectura. "Standby is off by default", la empresa tiene que dar visibilidad a tu app, y las copias del agente llevan "the send-time parameters exactly as passed to the Send Message API - not the rendered content."
Así que si no activas standby desde el primer día, las conversaciones que más quieres auditar se pierden, al menos para cualquier revisión masiva. Es el único paso de configuración que nunca me saltaría.
También existe Business Agent Usage Insights, pero informa de mensajes facturables, tokens y costo, no de calidad (Usage Insights). Para métricas de volumen en general, mi guía de analítica de chatbots cubre qué vale la pena medir.
QA de escalado: tú lo evalúas, pero no lo configuras
Las escalaciones perdidas son el fallo de QA más difícil de detectar, y en la Platform de Meta los disparadores no son tuyos. El agente "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" (Capabilities). La pestaña Personality de autoservicio sí te deja describir con palabras las condiciones de traspaso.
Lo que sí puedes medir es el traspaso en sí. El evento control_passed se dispara cuando el control pasa de la IA a una persona, con una cadena metadata opcional de hasta 2.000 caracteres (Thread control). El propio consejo de Meta es "Track the share of conversations handed off and the time to first human reply alongside it", y ningún endpoint de Meta devuelve ninguna de las dos cifras. Mis guías sobre calidad de escalado y gestión de escalados con IA profundizan más.
Hay un fallo de escalado que Meta señala por sí misma. Si el agente crea tickets a través de un conector y esa llamada falla, "A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." Los logs del conector muestran tasa de éxito y latencia solo de los últimos siete días, así que yo configuraría alertas ante fallos en lugar de revisarlo a mano.
Lo que Meta no revisa: tus agentes humanos
La mayoría de los programas de QA evalúan tanto a personas como a bots. Meta no tiene nada para eso. La bandeja de Business Suite tiene etiquetas, notas privadas, asignación y una carpeta Done (Meta Business Help), e Insights muestra "response rate and response time" (Meta Business Help). Ni scorecard, ni cola de revisión, ni calibración.
También hay un ángulo de privacidad que los responsables de QA deberían conocer. Tras un traspaso, los términos de Business Agent dicen que el agente queda silenciado "but may continue to observe the content being shared in the chat", y ese contenido cuenta como Content licenciado a Meta. Así que las respuestas de tus agentes en hilos escalados, justo los hilos que más le importan a la QA, también quedan bajo los términos de Meta.
Para evaluar a las personas necesitarás una herramienta de QA de soporte aparte y una scorecard. Mi artículo sobre criterios de scorecard de QA de Zendesk y los ejemplos de feedback de QA sirven para cualquier helpdesk.
Los fallos que una simulación no detecta
Aquí viene la parte incómoda. Las respuestas que más te dañan se ven bien en una transcripción.
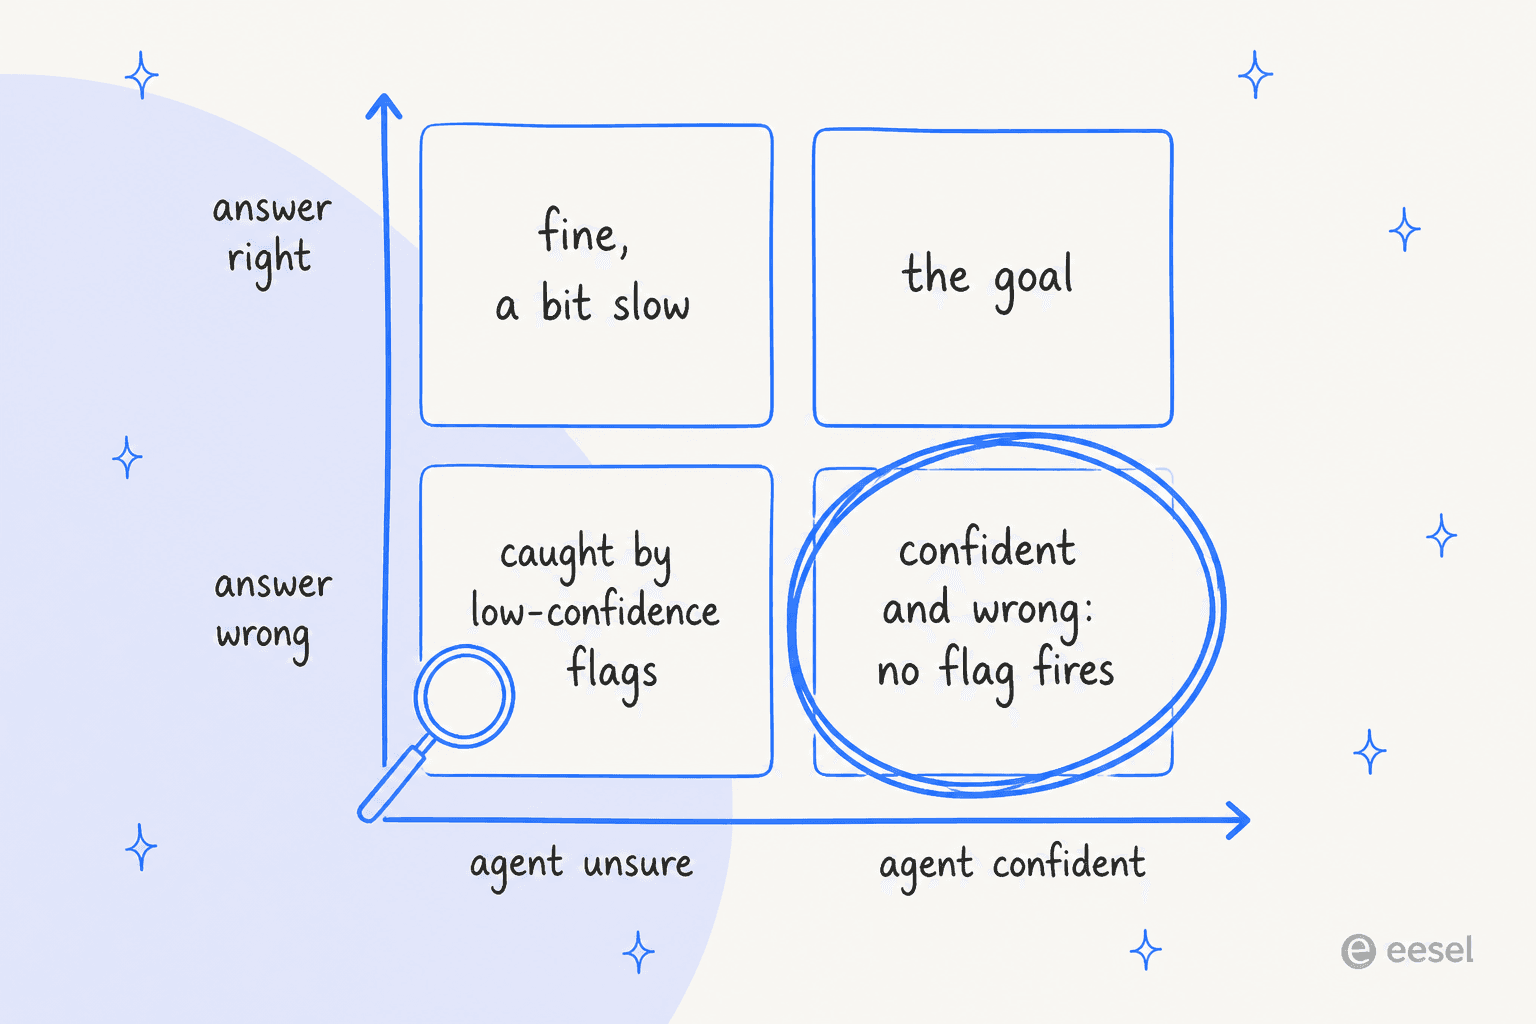
Lo he visto en eesel, y no es un recuerdo agradable. A principios de este año, varios clientes de pago tenían bots que se inventaban respuestas para clientes reales cuando la base de conocimiento no tenía nada relevante. Uno inventó condiciones de suscripción para los clientes de una empresa de energía. Otro respondió a un cliente con "Oxygen", sacado de la tabla periódica. Un equipo B2B de telemática, en una de las llamadas de ventas de eesel, temía lo contrario: su centro de ayuda decía "we support all models", así que el bot confirmaba encantado marcas de coche que no soportaban. Nada en esas respuestas parecía dudoso. Por eso eesel ahora prueba cada despliegue con los tickets históricos reales de un equipo antes de que el bot hable con nadie.
Quienes ejecutan agentes en producción describen el mismo patrón:
"The thing that moved us off confidence sampling is that the worst answers are confident. What actually surfaced them was downstream signals: user rephrased the same question, contacted again within 48 hours, a human took over, or an action got reversed."

Y sobre escalaciones perdidas en concreto:
"A conversation where the agent should have escalated and didn't looks completely normal in the transcript, so no confidence threshold and no reviewer reading outputs will flag it."
Sobre el agente de Meta en particular, un consultor de WhatsApp con acceso anticipado señaló la consistencia:
"Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up."
Para ser justos, en el mismo hilo también escribió que aún le gusta y que Meta mejorará las herramientas. Y el propio historial de soporte de Meta muestra por qué importan las herramientas de prueba: cuando su bot de soporte con IA fue engañado para enviar enlaces de restablecimiento de contraseña en junio de 2026, un comentarista de Hacker News lo resumió así: "they didn't really evaluate whether tools intended for conscientious human use should be provided directly to the LLM that replaced the former support agents" (semiquaver, Hacker News). Para más sobre prevención, consulta mi guía de prevención de alucinaciones.
Construir tú mismo un bucle de QA en vivo
Si estás en el nivel Platform con ingenieros, puedes cerrar la brecha. La forma que yo construiría es un bucle, no una auditoría puntual.
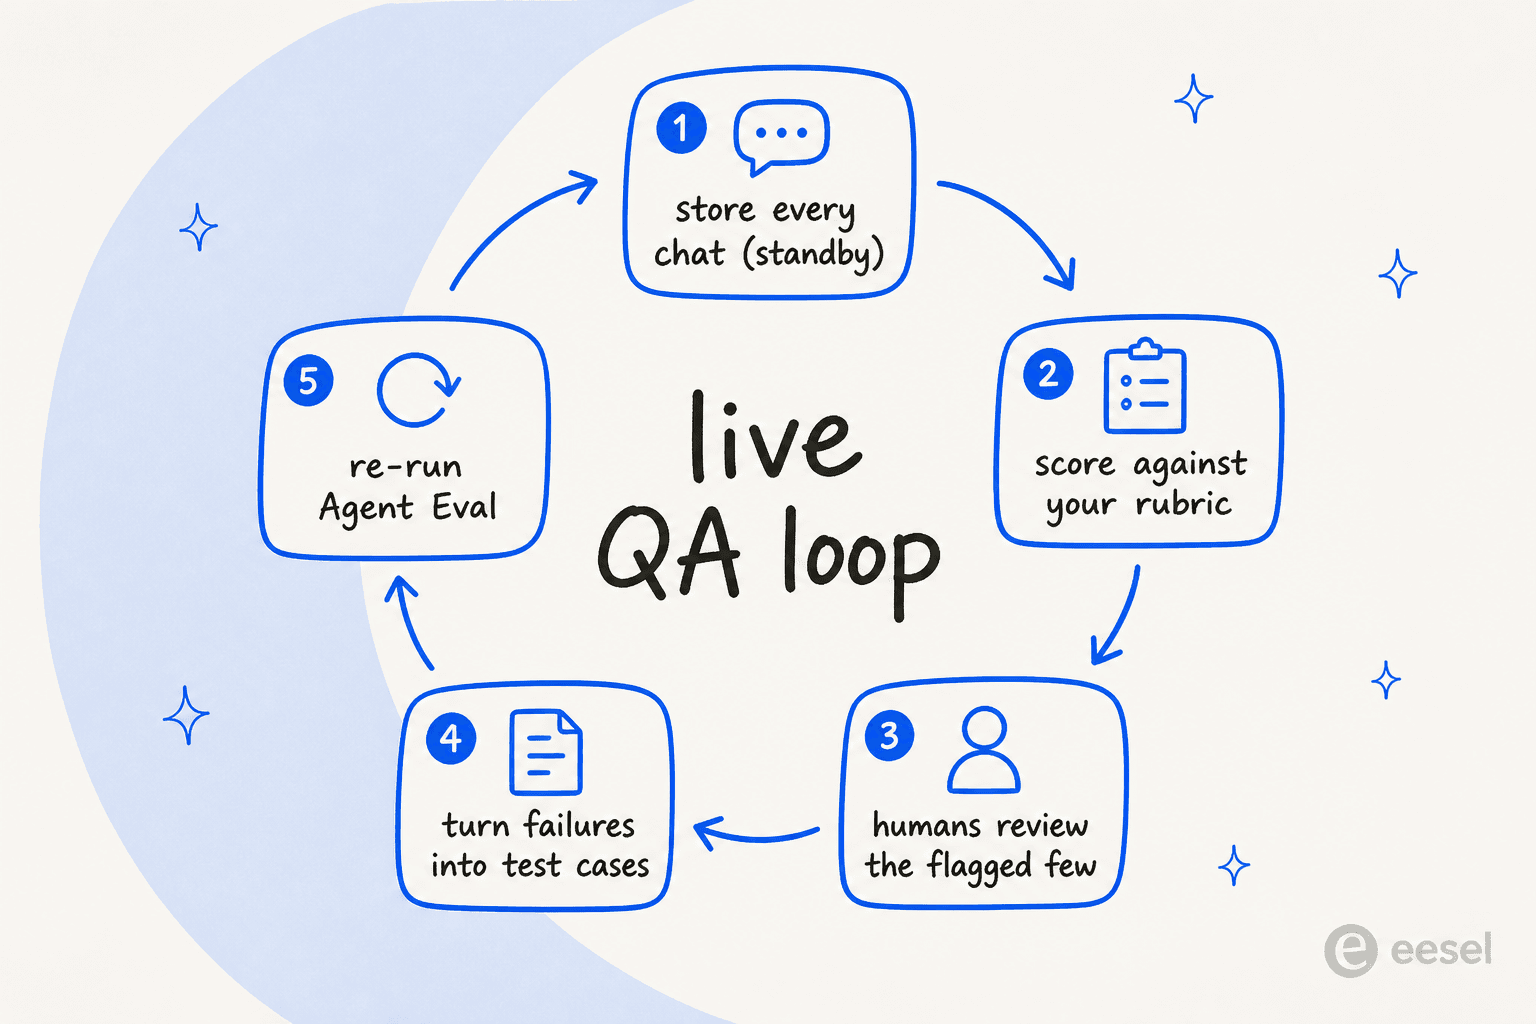
El paso de evaluación puede usar el propio modelo de Meta. El nivel estándar de Muse Spark cuesta $1.25 por 1M de tokens de entrada y $4.25 por 1M de tokens de salida, y admite salida con JSON Schema para que cada veredicto vuelva con la misma forma (lo cubro en mi reseña de Muse Spark 1.3). Un ejemplo aproximado, con tamaños que supongo yo y no Meta: 10.000 transcripciones de 2.000 tokens cada una son 20M de tokens de entrada ($25.00), y un veredicto de 200 tokens cada uno son 2M de tokens de salida ($8.50). Son unos $34 al mes para evaluarlo todo, mucho más barato que una persona leyendo el 1 % de ello.
Dos reglas antes de empezar:
- No uses el nivel contributor, más barato, con transcripciones. La página de ayuda de Meta dice "You must not submit sensitive, confidential, or personal information to the Discounted Services" (Meta Model API). Los chats de soporte están llenos de nombres, teléfonos e IDs de pedido.
- No hay un endpoint de QA prediseñado. La rúbrica, el esquema, los umbrales y la cola de revisión los escribes tú.
Una rúbrica con la que yo empezaría tiene cinco campos: correcta según las fuentes, conforme a la política vigente, debía haber escalado, tono y resuelta. Puntúa la recuperación por separado de la respuesta, porque una fuente equivocada suele elegirse varios turnos antes de que algo suene mal. La guía de QA de soporte con IA tiene más ideas de rúbrica, y mi comparativa de la mejor IA para QA de soporte cubre herramientas que lo hacen por ti.
El último paso es el que los equipos se saltan. Cada fallo confirmado debería convertirse en un nuevo caso de Agent Eval, para que el siguiente cambio de instrucciones se pruebe contra lo que falló el mes pasado. Un profesional lo dijo sin rodeos: "Every time someone rejected an agent output, that was information" (u/Spdload, Reddit).
Los límites de Meta para el control de calidad del soporte
Para un pequeño negocio que vive en WhatsApp, las herramientas de prueba de Business Agent son un buen comienzo, y he cubierto el agente junto a Zendesk, Freshdesk y Gorgias. Para QA en concreto, estos son los límites que yo sopesaría:
| Lo que necesita la QA | Lo que ofrece Meta | Brecha |
|---|---|---|
| Pruebas previas al lanzamiento | Test chat, Agent Test (gratis), Agent Eval | Los escenarios los escribes tú |
| Puntuar conversaciones en vivo | Pestaña Conversations, un chat a la vez | Sin puntuación masiva |
| Acceso a transcripciones | Webhooks standby (desactivados por defecto) | Sin API de historial |
| Trazabilidad de fuentes | View sources en cada respuesta | Solo en la interfaz de autoservicio |
| Control del escalado | Texto de instrucciones; disparadores de Platform fijos | No se informa la tasa de traspaso |
| QA de agentes humanos | Tasa y tiempo de respuesta en Insights | Sin scorecards |
| Feedback del cliente | Feedback con pulsación larga en respuestas de IA | Sin exportación documentada |
| Ejecutar una segunda IA para vigilar | Un agente de IA por número | Standby es solo lectura |
Dos notas más. "An active authorized-agent integration blocks Meta Business Agent" (overview), así que no puedes apuntar una segunda IA al mismo número para verificar a la primera. Y desde el 1 de octubre de 2026, los mensajes de servicio de WhatsApp de personas o de IA de terceros se cobran después de 1.000 gratis al mes por número, lo que cubre mi desglose de precios de la API de WhatsApp.
Mis artículos hermanos sobre análisis de feedback de clientes y monitoreo de la salud del cliente cubren las mismas fuentes de datos desde otros ángulos, y Grok Bot para QA de soporte hace el mismo trabajo en otro stack.
Una configuración de QA que funciona
Si WhatsApp es un canal importante y el agente de Meta está en primera línea, esto es lo que haría:
- Activa standby antes del lanzamiento y guarda cada evento entrante, respuesta y estado, con clave en el ID de usuario con alcance de negocio del cliente.
- Construye la suite de Agent Eval a partir de tus motivos de contacto reales, con más peso en los cuatro peligrosos: exigencias de reembolso, peticiones de hablar con una persona, preguntas sin respuesta documentada y contactos repetidos con enfado.
- Puntúa cada conversación y luego muestrea. Puntúalas todas con un modelo y envía a las personas las que tengan traspaso, contacto repetido en 48 horas, pregunta reformulada o una puntuación baja en la rúbrica.
- Convierte los fallos en casos de eval y vuelve a ejecutar la suite tras cada cambio de instrucciones o conocimiento.
- Haz QA de tus humanos por separado con una scorecard en tu helpdesk, ya que Meta no tiene ninguna.
Para una visión más amplia de las métricas a seguir, mi guía de métricas de servicio al cliente con IA y la explicación de CSAT con IA son buenas lecturas siguientes.
Prueba eesel para el control de calidad del soporte
La pila de Meta prueba a tu agente antes del lanzamiento y luego te devuelve la QA a ti. eesel es un compañero de helpdesk con IA que integra la QA en su forma de trabajar y se conecta a WhatsApp en pocos minutos.
También funciona dentro de Zendesk y Freshdesk, además de Gorgias y HubSpot, así que los chats de WhatsApp y los tickets del helpdesk pasan por las mismas comprobaciones.
La mayor diferencia con Agent Eval es qué se prueba. La habilidad Simulation de eesel "Runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes" (eesel docs). Así que lo evalúas con las preguntas que tus clientes realmente hicieron, incluidas las raras para las que nadie pensaría en escribir un escenario.
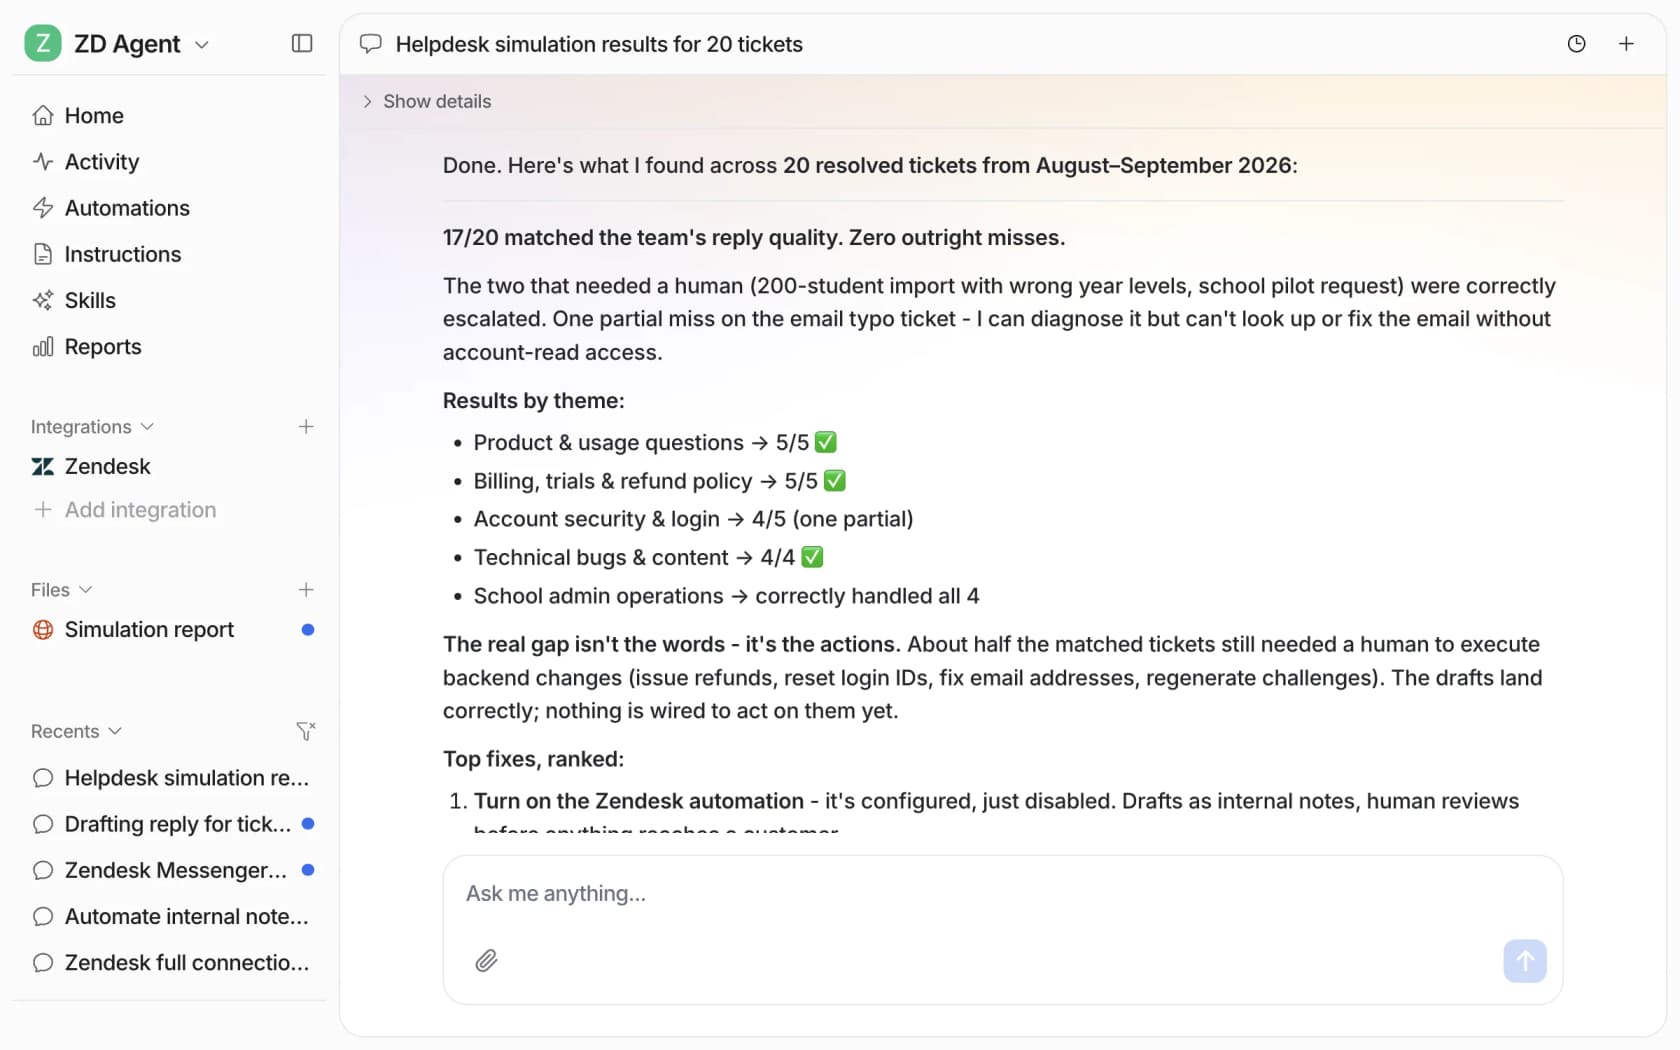
Tras el lanzamiento, cada ejecución aparece en Activity con dónde ocurrió, "What it read", cada acción y dónde la aprobó una persona, y "Why, its reasoning step by step" (Reports docs). Cuando una respuesta falla, abres la ejecución y la corriges en el chat de al lado, y la corrección se convierte en una regla para toda respuesta similar. La habilidad "Analyze and improve replies" hace lo mismo a gran escala: mira lo que tu equipo rechazó o editó y sugiere el arreglo, que es la señal de salida rechazada que describía el comentarista de Reddit.
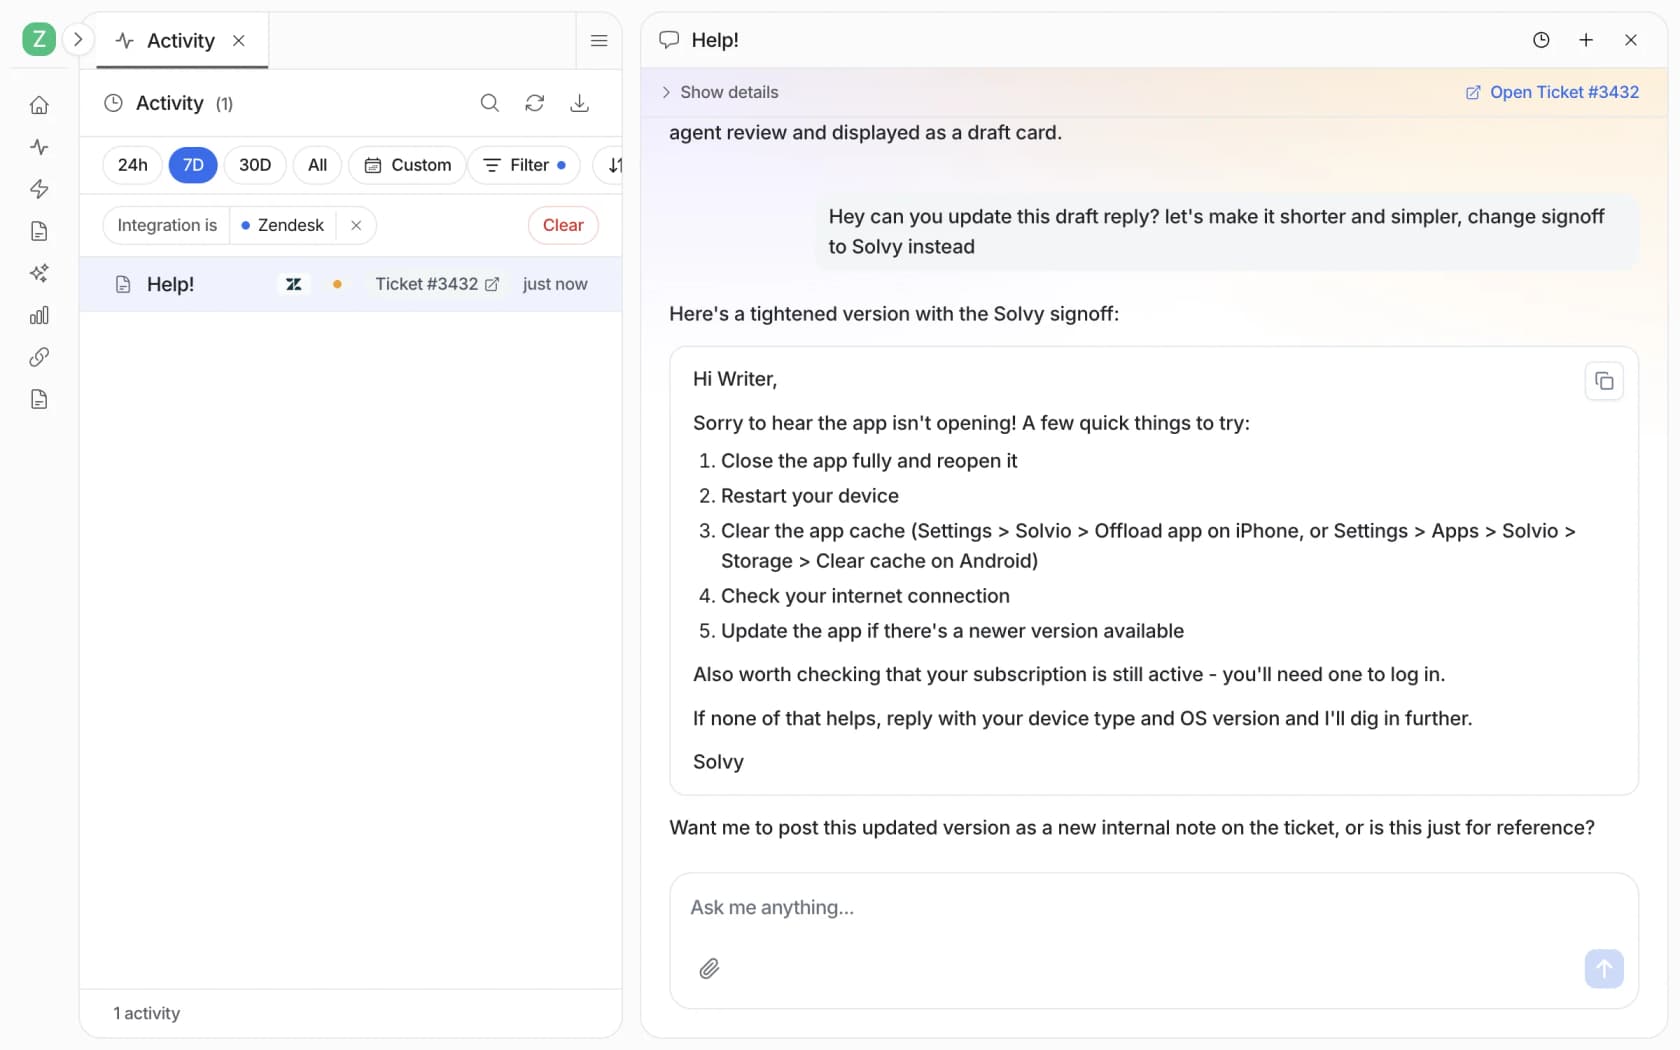
La página Reports registra una puntuación de CSAT de IA, lagunas de conocimiento y tasas de aprobación, y repito la advertencia de los propios docs: "AI CSAT is not customer feedback." Es una señal interna de calidad. También puedes programar una autorrevisión semanal, y si tu QA vive en scripts, la CLI de eesel imprime JSON en cada comando, de modo que un agente de código como Claude Code puede llevar actividad y aprobaciones a tu propio panel de QA.
Una nota honesta: por la regla de Meta de una IA por número, en un número de WhatsApp ejecutarías eesel o Meta Business Agent, no ambos. Si WhatsApp es tu único canal y tienes ingenieros para el bucle de QA de arriba, el agente de Meta es una opción razonable. Si quieres la QA integrada y las conversaciones de todos los canales en un solo lugar, los precios de eesel son un plan mensual fijo de créditos con un nivel gratuito de 100 créditos y planes desde $299 por 500, y puedes ejecutar la simulación con tus propios tickets pasados antes de que responda a un solo cliente.
Preguntas frecuentes
¿Puedo usar Meta Muse para el control de calidad del soporte?
¿Qué puntúa realmente Meta Agent Eval?
¿Cómo reviso las conversaciones en vivo de Meta Business Agent en WhatsApp?
¿Meta Business Suite tiene scorecards de QA para agentes humanos?
¿Cuánto cuesta el control de calidad del soporte con Meta Muse?
¿Por qué mi agente de IA de WhatsApp da respuestas erróneas con mucha seguridad?
¿Puedo ejecutar una segunda IA en mi número de WhatsApp para revisar a Meta Business Agent?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.