

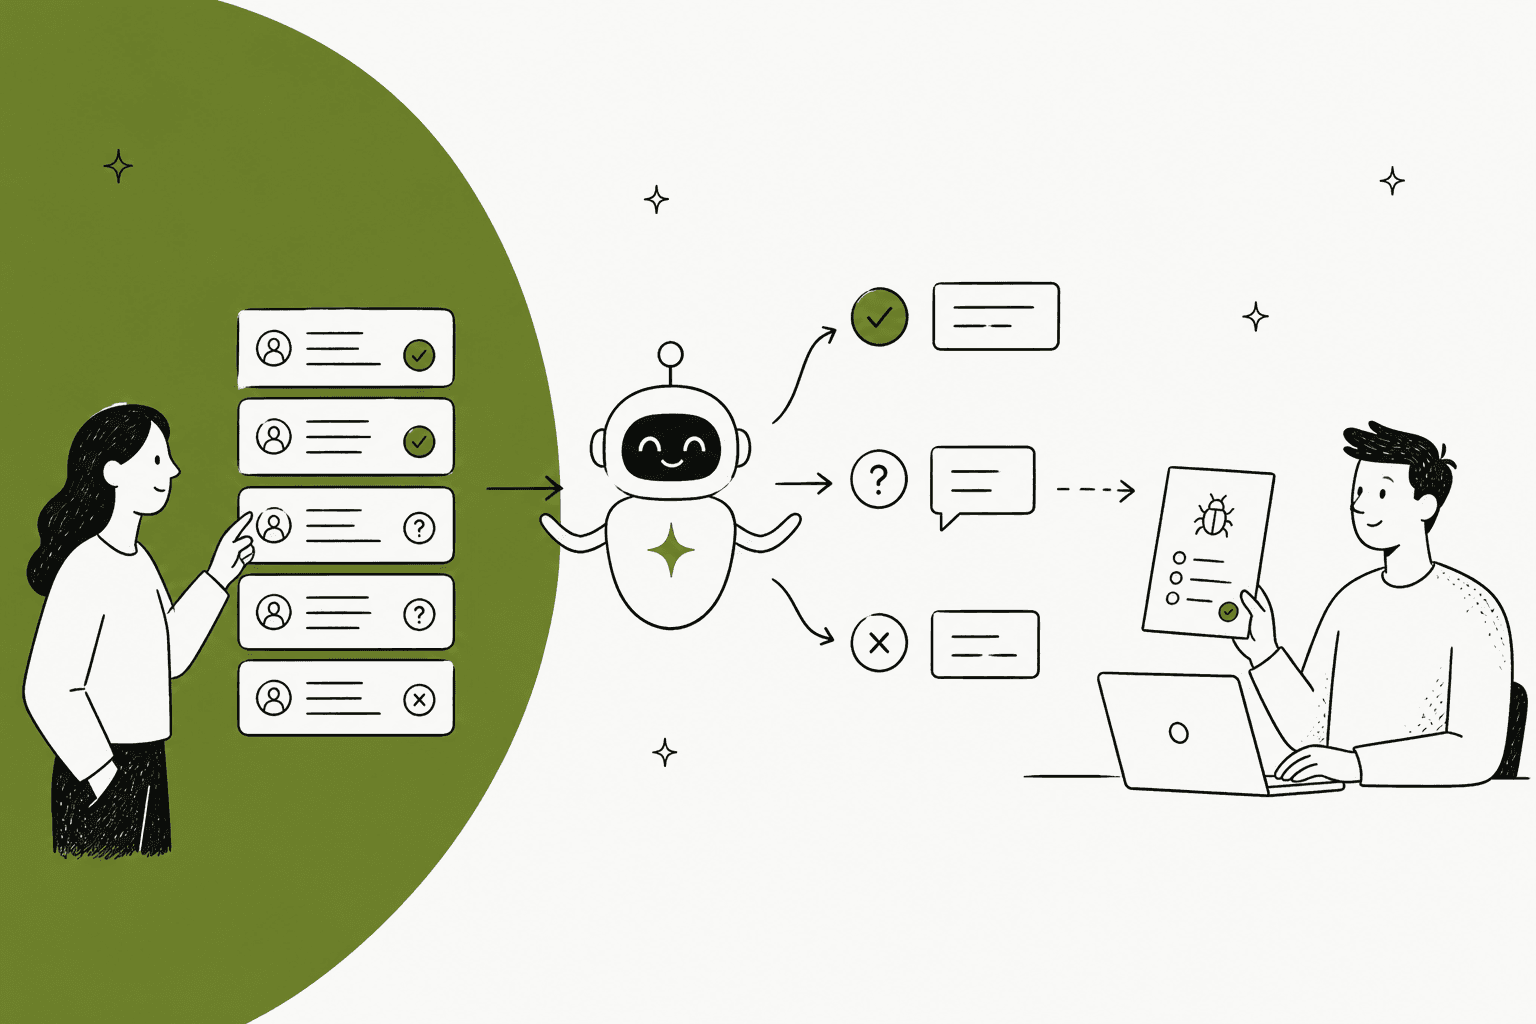
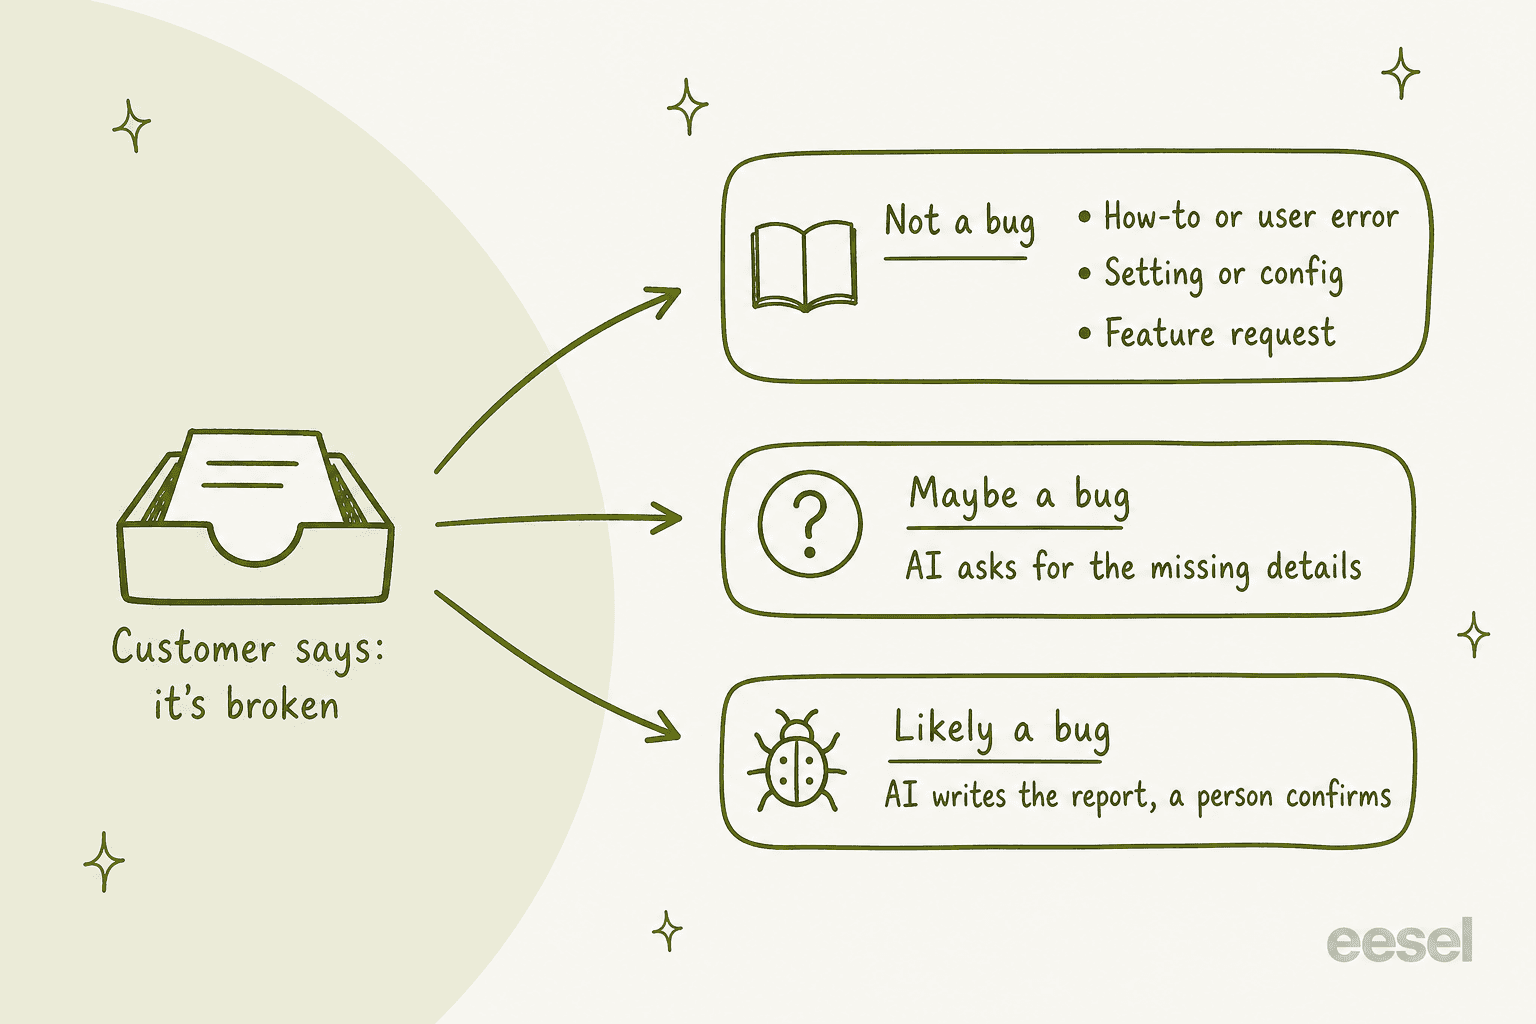
La IA para el triaje de errores funciona mejor en la cola de soporte, no en el backlog de ingeniería. Clasifica cada ticket de "algo está roto" en tres carriles: no es un error (una duda de uso, un ajuste, una petición de función), quizá es un error (la IA pide los detalles que faltan) y probablemente es un error (la IA redacta el informe y una persona lo confirma). La mayor parte del tiempo que ahorra viene de los dos primeros carriles, porque la mayoría de los "errores" que reportan los clientes nunca llegan a ingeniería.
La regla que mantiene la confianza de los ingenieros: la IA nunca le dice a un cliente que algo es un error confirmado, y nunca registra un informe sin pasos para reproducirlo, la cuenta y una comprobación de duplicados. Cuando sale la corrección, avisa a cada cliente que lo reportó.
eesel hace esto dentro del helpdesk que ya usas. SE Ranking lo usa para convertir las preguntas sobre datos incorrectos y sobre la API en tickets de nivel 2, con el dominio, el enlace de la auditoría o la captura reunidos de antemano, sobre unas 4.650 conversaciones al mes.
¿Por qué los reportes de errores atascan una cola de soporte?
Trabajo en la cola de soporte de eesel, y buena parte de lo que llega empieza con alguna versión de "creo que algo está roto". Algunos son errores. La mayoría no. Son un ajuste que alguien cambió, un botón que se movió, una extensión del navegador que estorba o una función que nunca existió. El problema es que en la bandeja de entrada todos se ven igual, y los reales quedan mezclados con el resto.
Esa mezcla genera dos tipos de desperdicio: soporte gasta tiempo en tickets que necesitan a ingeniería e ingeniería gasta tiempo en tickets que nunca fueron errores. Alguien en Hacker News, hablando de proveedores de redes, llevó el segundo problema al extremo:
"Especially with network vendors where 99%+ of their support workload is dealing with client or reseller misconfiguration."

Tu proporción no será tan desequilibrada, pero la forma es conocida. Y cuando un error real sí llega a ingeniería, a menudo llega con muy pocos detalles. Un ingeniero que trabaja con personal de soporte describió la brecha en Hacker News:
"they're not developers and every now and then they cut the corner and need to be reminded that "I cannot press this button" is not good enough"
Ese es el trabajo en el que la IA es buena aquí. No decidir qué es un error, sino hacer la clasificación y las preguntas de seguimiento que un equipo de soporte ocupado se salta. Si quieres la visión desde ingeniería (Sentry, Linear y GitHub clasificando incidencias una vez que existen), la expliqué en IA para el triaje de reportes de errores. Este artículo trata el paso anterior: pasar del ticket de un cliente a una incidencia que valga la pena registrar.
¿Cómo debería clasificar la IA el reporte de un cliente?
Cuando le pregunté a ChatGPT cómo debería hacer el triaje de reportes de errores un equipo de soporte, describió el mismo flujo al que llegan la mayoría de los equipos: clasificar, luego investigar, luego traspasar. Yo haría más concreto el paso de clasificar, y lo que hay que notar aquí son tres carriles, con un trabajo distinto para la IA en cada uno.
| Carril | Reporte típico | Qué hace la IA | Quién decide |
|---|---|---|---|
| No es un error: duda de uso o error del usuario | "I can't find the export button anymore" | Responde desde el centro de ayuda y el registro de cambios, enlaza el artículo | La IA, una vez probada |
| No es un error: ajuste o configuración | "The report totals are wrong" | Revisa primero los ajustes habituales (rango de fechas, filtros, zona horaria) | La IA, con una persona en los borradores al principio |
| No es un error: petición de función | "Can you add dark mode?" | Da las gracias, registra la petición, nunca promete nada | La IA |
| Quizá es un error | "Nothing works since this morning" | Pide pasos, cuenta, versión del navegador o de la app, una captura | La IA pregunta y luego reclasifica |
| Probablemente es un error | "Export freezes at 99% since Tuesday's update, worked last week" | Revisa problemas conocidos y estado, redacta el informe, dice al cliente que está con el equipo | Una persona confirma |
| Caída del servicio | "Login shows a 500 for everyone in our org" | Revisa la página de estado, avisa a una persona de inmediato | Una persona, ya |
El detalle de "worked last week" importa más de lo que parece. La respuesta de ChatGPT lo llamó un indicador de regresión y estoy de acuerdo: un reporte que menciona algo que antes funcionaba, más un cambio reciente, es la señal más fuerte que un cliente puede darte. La IA debería tratar esos casos como probables errores aunque la descripción del cliente sea vaga.
Prueba a clasificar tú mismo algunos reportes:
¿En qué carril está este reporte de error?
Elige un reporte de cliente para ver adónde va y qué debería hacer la IA a continuación.
Aún no has elegido nada. Empieza con cualquier reporte de arriba.
La IA revisa primero el registro de cambios. Si el botón cambió de sitio en una versión reciente, responde dónde está ahora y enlaza la nota de la versión. Si no cambió nada, pide una captura antes de clasificarlo de otra forma.
Necesita: centro de ayuda, registro de cambios, tickets pasados.
La mayoría de los tickets de "los números están mal" son un rango de fechas, un filtro, una zona horaria o un documento en borrador. La IA repasa esas comprobaciones en una sola respuesta. Si todas parecen correctas, el ticket pasa a quizá es un error y la IA pide un registro de ejemplo.
Necesita: una regla escrita para los reportes de números incorrectos, tickets pasados.
La IA da las gracias, dice claramente que hoy no está disponible, etiqueta el ticket como petición de función para que producto pueda contarla y nunca insinúa una fecha de lanzamiento.
Necesita: una etiqueta de petición de función, una regla contra prometer elementos de la hoja de ruta.
Demasiado vago para clasificar. La IA revisa la página de estado y luego pide lo que no puede consultar: qué intentaba hacer el cliente, qué vio, versión del navegador o de la app y una captura. Después vuelve a clasificar con la respuesta.
Necesita: página de estado, una lista corta de preguntas por área de producto.
"Worked last week" más una actualización reciente es una señal de regresión. La IA busca un ticket o incidencia existente con el mismo síntoma, lo vincula si lo encuentra y, si no, redacta el informe para ingeniería. Dice al cliente que el equipo lo está revisando y nunca lo da por confirmado.
Necesita: problemas conocidos, búsqueda de tickets, una forma de registrar en tu gestor.
Muchos usuarios, un síntoma, todos a la vez. La IA revisa la página de estado, vincula el ticket al incidente si hay uno abierto y, si no, avisa a la persona de guardia. Sin pasos de solución de problemas ante una caída.
Necesita: página de estado, una vía urgente a una persona.
Una nota sobre cómo debería clasificar la IA: déjala leer tus tickets pasados, no una lista de palabras clave. "It's broken" significa cosas muy distintas en productos distintos, y por eso las palabras que tus clientes usan para un error real ya están en tus tickets resueltos. Si estás montando el enrutamiento más amplio alrededor de esto, enrutamiento de tickets con IA para SaaS y cómo automatizar el triaje de tickets cubren el resto de la cola.
¿Qué debería preguntar la IA al cliente antes de llamarlo error?
El carril de "quizá" es donde la IA se gana el sueldo, porque es el paso que los equipos de soporte se saltan bajo presión. Una persona con cuarenta tickets abiertos reenvía "nothing works" a ingeniería y sigue adelante. Una IA puede hacer las preguntas de seguimiento todas las veces, mientras el cliente sigue en la conversación y aún recuerda dónde hizo clic.
Lo que le haría preguntar, más o menos en este orden:
- ¿Qué intentabas hacer? El objetivo, no el error. La mitad de las veces esto revela una duda de uso.
- ¿Qué ocurrió en cambio y qué esperabas? El texto exacto del error, si lo hay.
- ¿Cuándo empezó y funcionaba antes? Esta es la pregunta de la regresión.
- ¿Qué cuenta, espacio de trabajo o proyecto? Para que nadie tenga que volver a preguntar.
- ¿Qué navegador, app o versión? Omítelo si tus sistemas ya lo registran.
- ¿Puedes enviar una captura o una grabación corta? Una imagen ahorra tres respuestas.
Dos reglas hacen que esto resulte útil y no un formulario. Primero, la IA debería buscar antes de preguntar. El agente de SE Ranking está configurado para no hacer nunca una pregunta aclaratoria antes de haber revisado los centros de ayuda, las macros y los tickets pasados. Segundo, pide una o dos cosas a la vez y no pidas nada que la IA pueda consultar por sí misma.
La configuración de SE Ranking muestra cómo se ve esto cuando está bien hecho. Los datos incorrectos en sus herramientas de investigación, la configuración de marca blanca, las preguntas de auditoría, la API y Looker Studio se convierten todos en un ticket para su grupo de nivel 2, con el dominio, el enlace de la auditoría o la captura del conector reunidos de antemano. Si un cliente dice que su pantalla no coincide con lo que describió la IA, esta deja de resolver problemas y traspasa con una nota de lo que ya le dijo. En un mes fueron unos 400 tickets creados para nivel 2 y casos de fin de semana, de unas 4.650 conversaciones en tres productos.
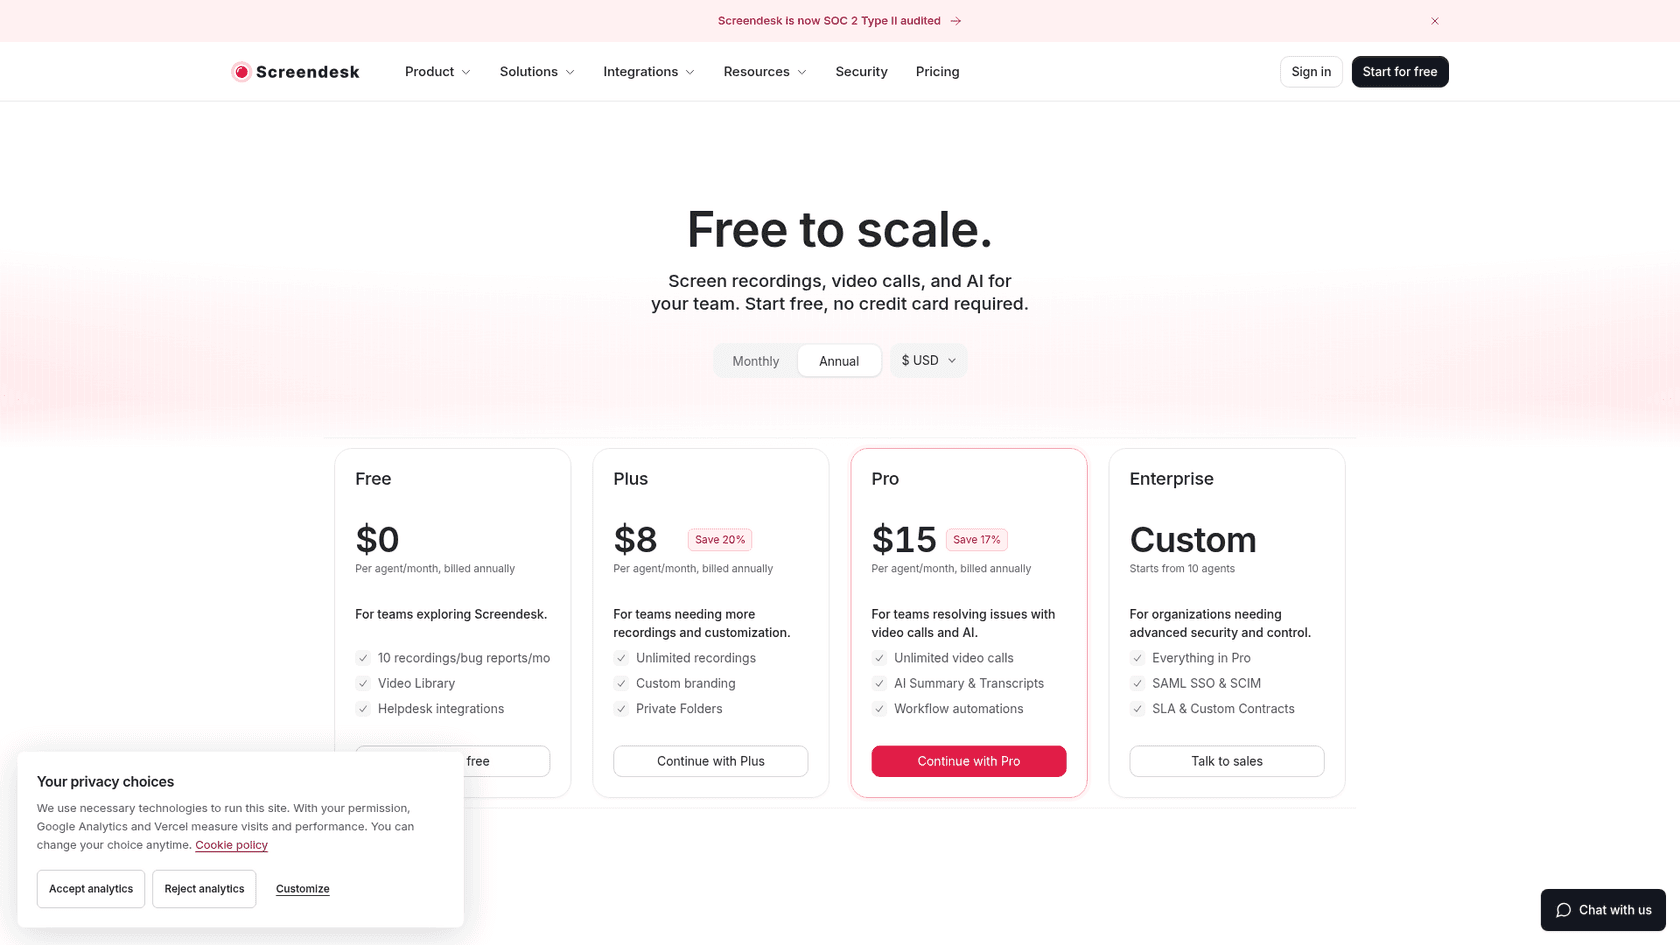
Las grabaciones de pantalla también ayudan aquí. Screendesk añade enlaces de grabación y de reporte de error a helpdesks como Zendesk, Freshdesk, Help Scout y Jira Service Management, y su plan Pro rellena con IA el título y los pasos para reproducir. Combina bien con un agente de IA: el agente pide la grabación y la grabación rellena los pasos.
¿Cómo comprueba la IA si ingeniería ya lo sabe?
Antes de que nada llegue a ingeniería, la IA debería responder una pregunta: ¿esto ya se conoce? Hay tres sitios donde mirar:
- Tickets abiertos en tu helpdesk. Si seis clientes reportaron esta mañana el mismo bloqueo de la exportación, el séptimo es un enlace, no un informe nuevo.
- Problemas conocidos y la página de estado. Para que la IA diga "lo sabemos y estamos trabajando en ello" en lugar de guiar a un cliente por una solución para una caída.
- El propio gestor de incidencias. Una incidencia abierta con el mismo síntoma significa que el ticket se vincula a ella y que el cliente recibe aviso cuando se cierre.
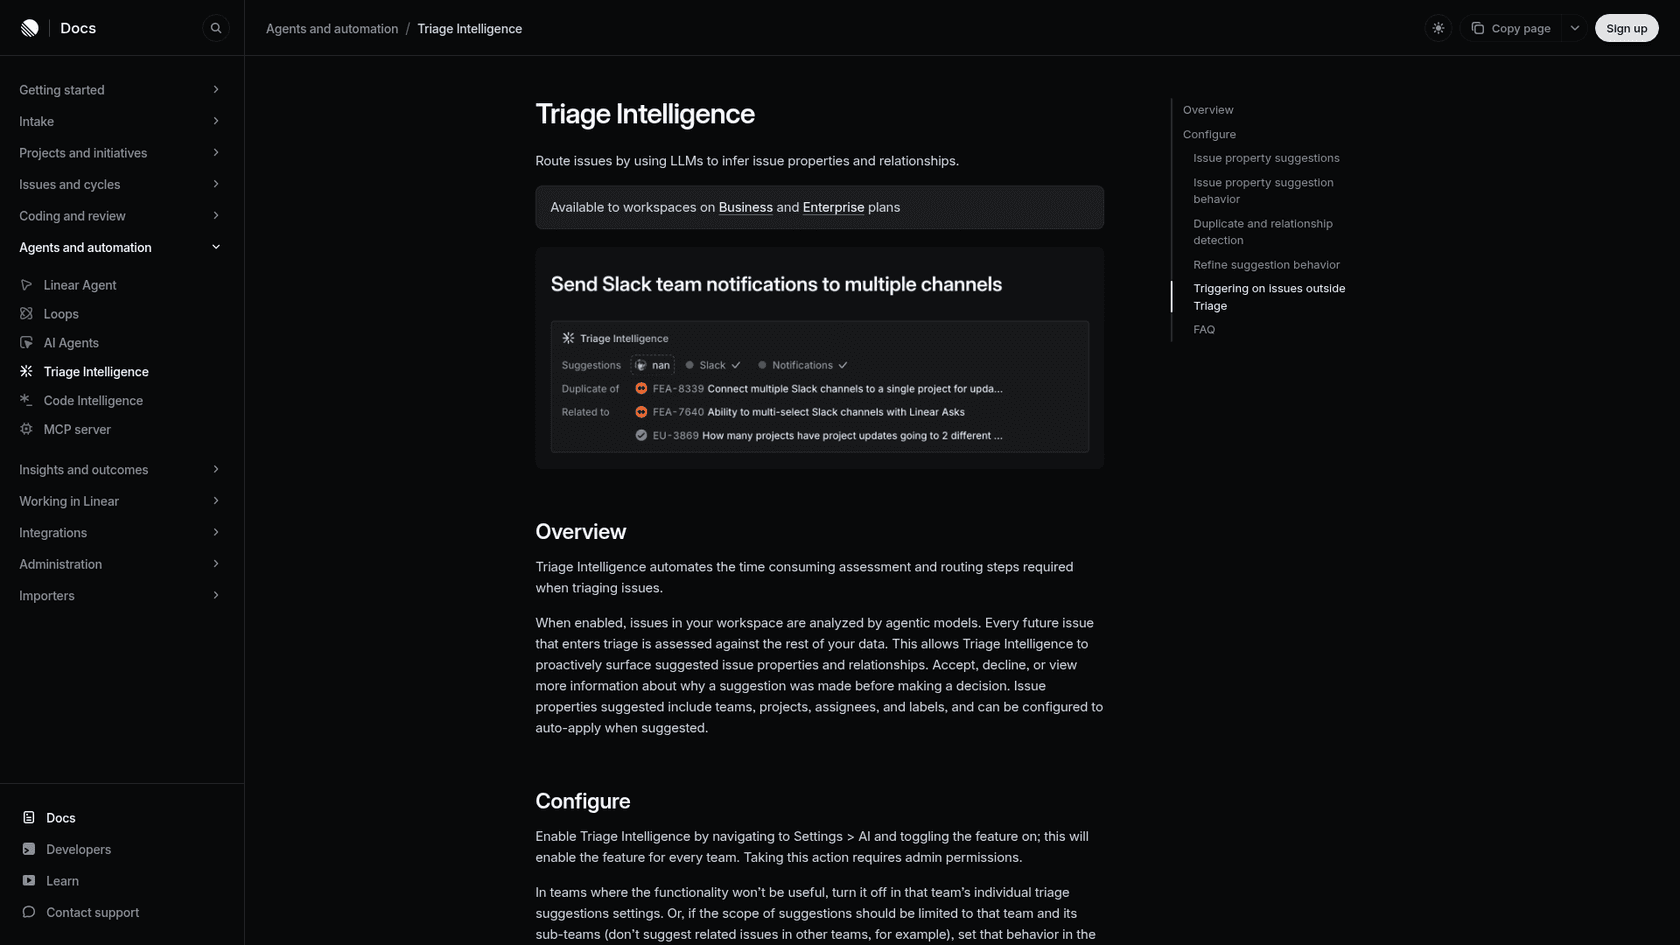
Tanto los helpdesks como los gestores han añadido IA para esto. Zendesk lista sugerencias de fusión y tickets similares entre sus funciones de Copilot. Del lado de ingeniería, Triage Intelligence de Linear marca un probable duplicado cuando una incidencia en triaje tiene "a strong semantic similarity" con una existente, y muestra su razonamiento antes de que lo aceptes.
Hacer la comprobación del lado de soporte sigue valiendo la pena, porque cambia lo que le dices al cliente. Un ticket vinculado significa que el cliente oye "lo sabemos, se está trabajando" hoy en lugar de dentro de tres días, y además da a ingeniería un recuento real. "Catorce clientes del plan Pro, desde el martes" es un argumento de prioridad; "un cliente dice que la exportación no funciona" no lo es. Mi artículo sobre la deduplicación de tickets cubre cuándo fusionar y cuándo vincular.
¿Cómo es un informe de error listo para ingeniería?
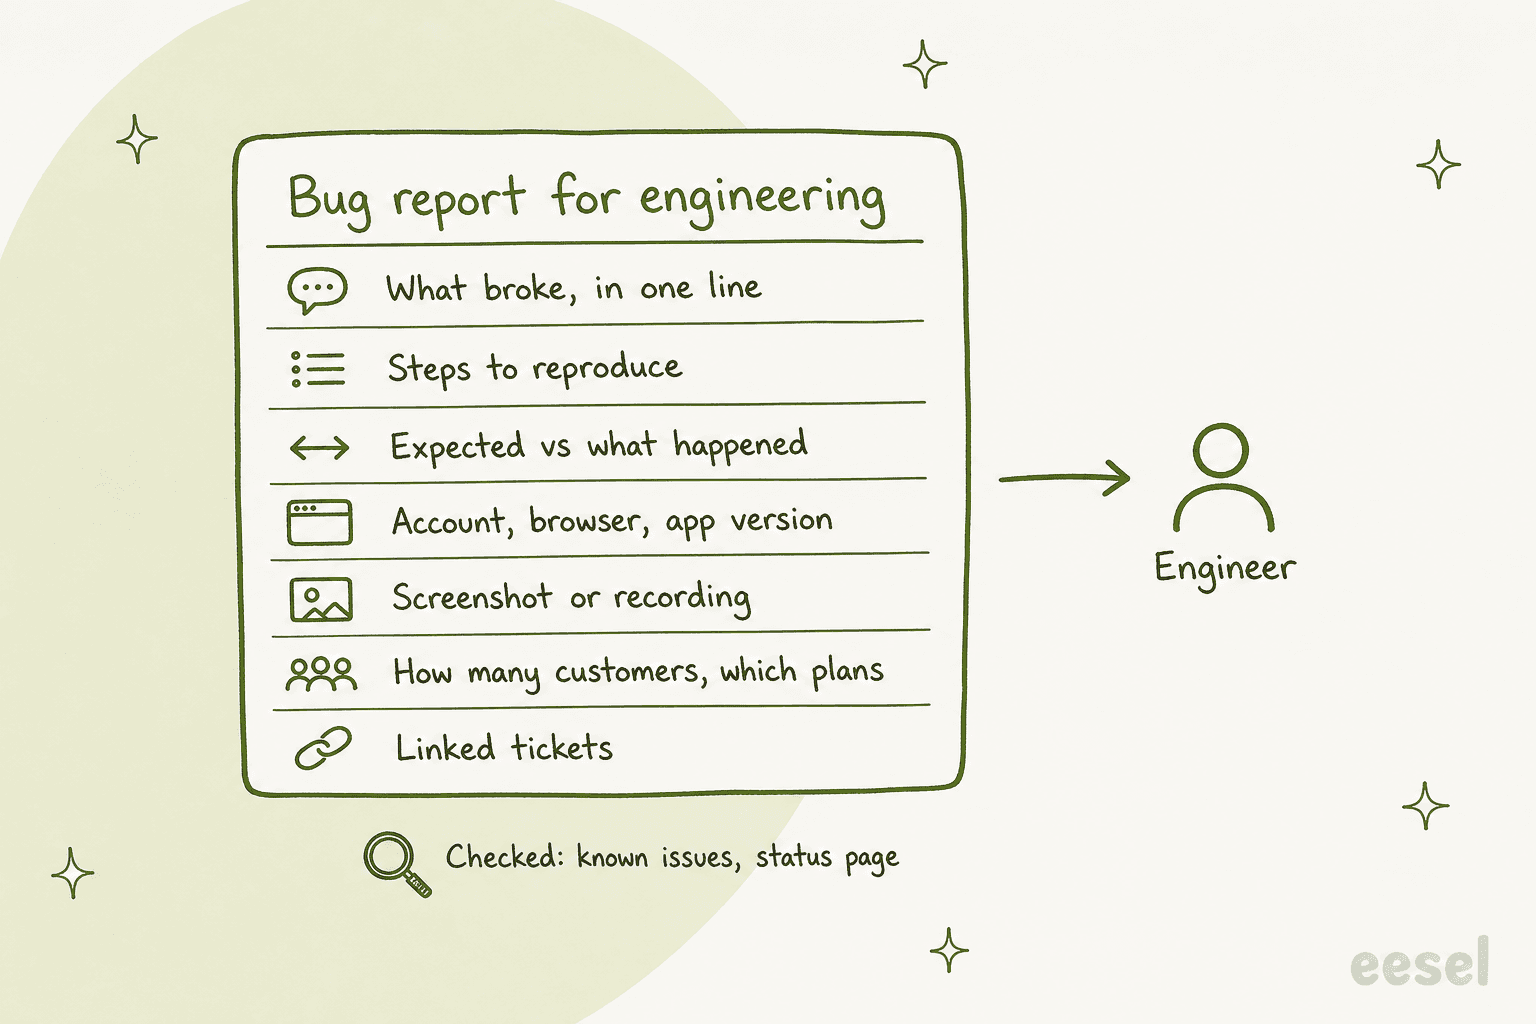
El peor traspaso que puede recibir un ingeniero es un ticket reenviado con "customer says export is broken" encima. El mejor es un informe con el que pueda actuar en cinco minutos. Aquí es donde compensa una IA que ya ha hecho las preguntas y buscado duplicados: puede escribir el segundo tipo cada vez.
Un buen informe incluye:
- Qué se rompió, en una línea. "Monthly CSV export stops at 99% for large workspaces."
- Pasos para reproducirlo, hasta donde el cliente pudo darlos.
- Esperado frente a lo ocurrido, con el texto exacto del error.
- Cuenta, navegador y versión de la app, y cuándo empezó.
- Una captura o grabación.
- Impacto: cuántos clientes, qué planes, tickets vinculados.
- Qué se comprobó ya: problemas conocidos, página de estado, los ajustes habituales.
- Un enlace de vuelta a cada ticket, para que ingeniería vea quién está esperando.
Y una regla por encima de todas las demás: la IA puede decir "esto parece un error y lo he pasado al equipo", pero nunca debe decirle a un cliente que algo es un error confirmado ni prometer una fecha de corrección. Confirmar un defecto es una decisión para alguien que pueda reproducirlo o leer el código. La propia respuesta de ChatGPT dijo lo mismo con otras palabras: no dejes que la confianza de la IA por sí sola decida si algo es un error real.
Aquí va una historia con moraleja de una llamada de ventas. Una empresa de medios digitales que gestiona unos 4.000 tickets de Zendesk al mes describió el flujo que quería como "User contacts → AI troubleshooting → escalate to Jira if unresolved." Durante su piloto, una escalada salió como un correo electrónico que después se cerró automáticamente, de modo que nadie del equipo lo vio nunca. Un traspaso que nadie lee es peor que no tener traspaso, porque al cliente se le dijo que alguien lo estaba mirando. Sea cual sea la vía que elijas, comprueba que el informe llega al lugar desde el que trabaja de verdad una persona o un equipo concretos.
¿Cómo llega el informe a Jira, Linear o GitHub?
Depende de dónde trabajen tus ingenieros, y es donde más difieren las herramientas. El mapa honesto está abajo:
| Vía | Cómo funciona | A qué prestar atención |
|---|---|---|
| Jira Service Management, con eesel | La integración de eesel con JSM responde, deja notas internas y mueve, asigna, etiqueta y crea incidencias | Caducidad del token: Atlassian fija una y hay que reconectar cuando vence |
| Plain con Linear, GitHub, Jira o Shortcut | Crear o vincular una incidencia desde el hilo de soporte; el estado de Linear se sincroniza de vuelta | Plain es un helpdesk, así que implica abandonar el tuyo |
| Linear Asks | Cada correo o mensaje de Slack entrante se convierte en una incidencia en el Triage del equipo | Plan Business o Enterprise; pensado para peticiones internas |
| Automatizaciones de Screendesk | Una nueva grabación o reporte de error puede crear una incidencia de Jira o GitHub y publicar en Slack | Plan Pro; el disparador es la grabación, no el texto del ticket |
| eesel a Linear o GitHub | Sin integración propia; eesel llama a su API mediante Network Access | Tú configuras el dominio, la cabecera de autenticación y las instrucciones |
La propia guía de Plain plantea algo con lo que estoy de acuerdo: un envío en un solo sentido al gestor no basta. En Plain, cuando una incidencia de Linear vinculada se completa o se cancela, el hilo pasa a un estado "Close the Loop" como aviso para informar al cliente, según su guía de Linear y GitHub. También señala un problema de configuración: si la integración con Linear está limitada a algunos equipos, las actualizaciones de estado no se sincronizan.
Linear Asks es la opción más ligera si ya estás en el plan Business de Linear. Su documentación lista "engineering teams receiving bug reports from non-technical teammates" como uso principal, y un Ask por correo usa el asunto como título de la incidencia y el cuerpo como descripción. Eso significa que un informe limpio desde tu lado de soporte se convierte en una incidencia limpia de Linear, sin cableado extra.
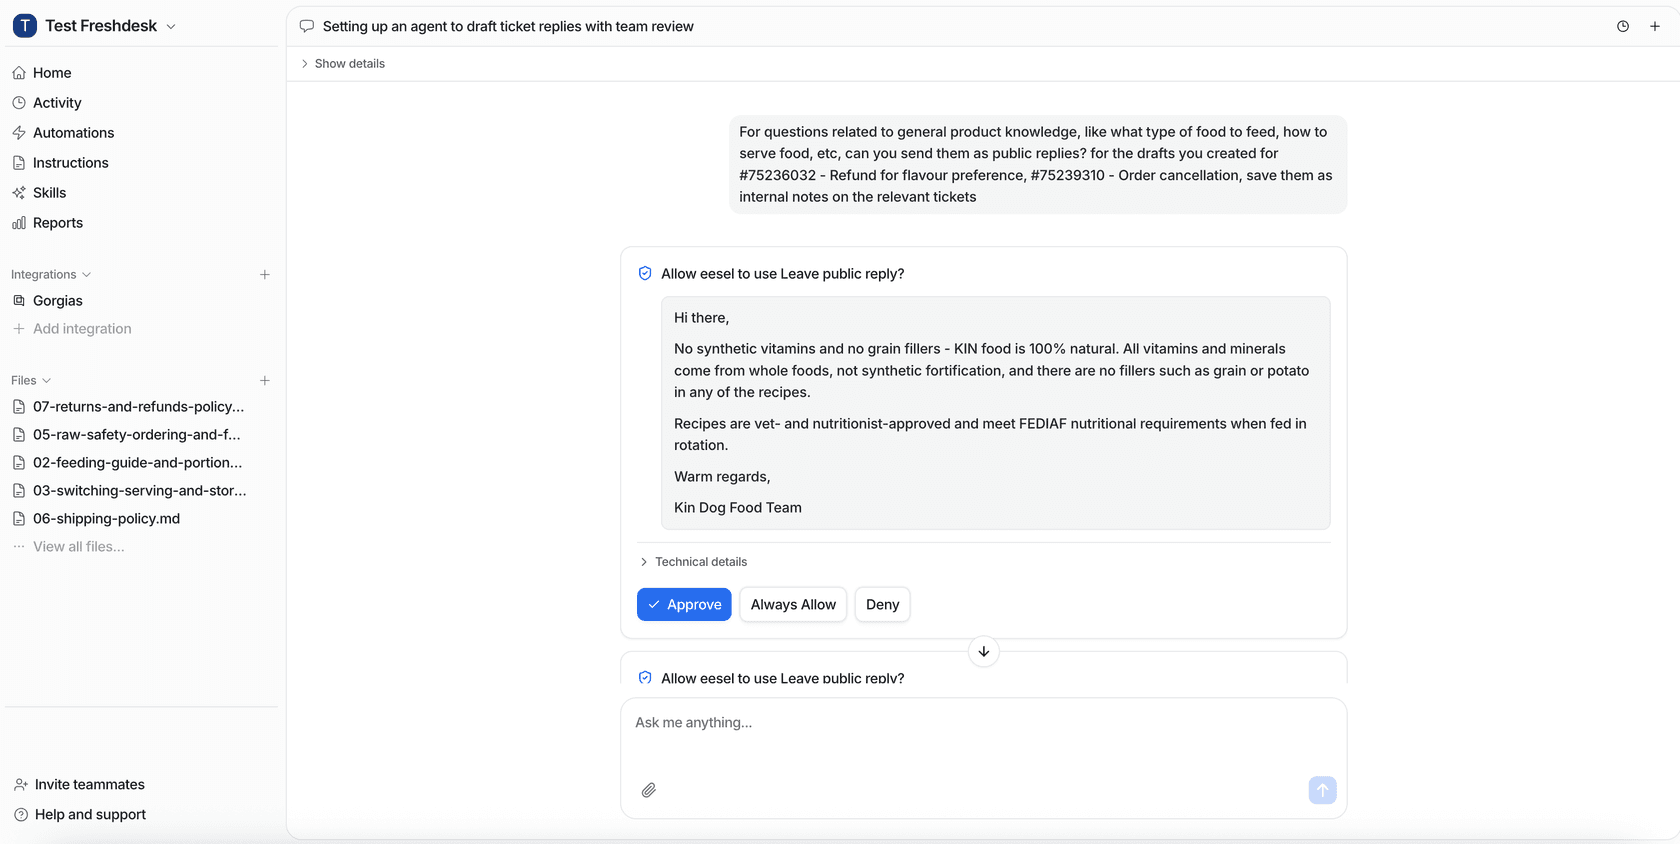
Para eesel con un gestor con el que no se integra, la vía es Network Access. Permites el dominio del gestor, añades la cabecera de autenticación y le dices al agente con palabras sencillas para qué sirve la conexión. Las credenciales se quedan en tus ajustes y eesel las adjunta a cada solicitud, así que la IA nunca ve la clave. Admite GET, POST, PATCH y DELETE, lo que cubre crear una incidencia y añadir un comentario. Yo pondría esa acción tras una aprobación al principio, de modo que una persona dé el visto bueno a cada incidencia nueva hasta que confíes en los informes. Las acciones y aprobaciones de eesel te permiten fijar cada acción en Auto, Requiere aprobación o Desactivada.
Si tus ingenieros ya viven en Jira, mis guías sobre la escalada de Zendesk a Jira y la integración de Zendesk con Jira profundizan más.
Para Linear, consulta Linear AI y Linear vs Jira.
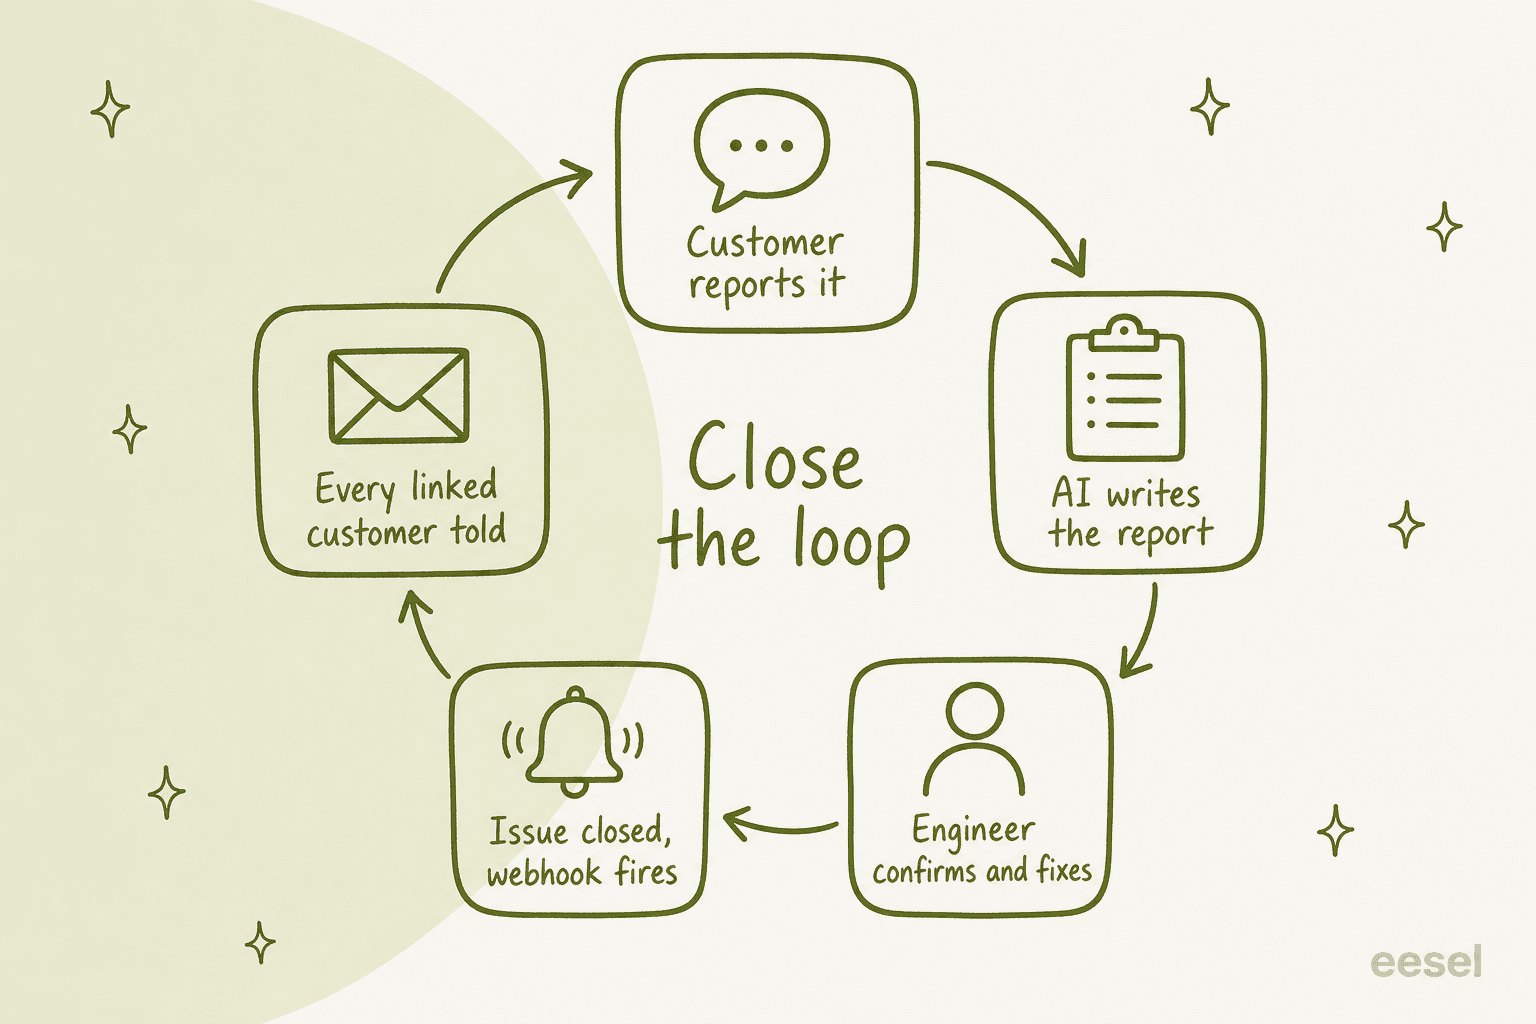
¿Cómo se enteran los clientes de que un error está corregido?
Este es el paso que casi todos olvidan. La corrección sale, la incidencia de ingeniería se cierra y el cliente que la reportó nunca se entera. La página de inicio de Modem describe exactamente esto: "The fix ships. Whoever heard the complaint never finds out." Un comentarista de Hacker News expuso el ciclo completo de soporte a ingeniería y lo terminó igual, con soporte contactando al cliente para que lo vuelva a probar:
"as soon as you have multiple people involved in a communication chain, details get lost, and feedback loops become really extensive because of all the latency involved"
La IA abarata el último paso, siempre que se cumplan dos cosas: cada ticket de cliente está vinculado a la incidencia y algo avisa a la IA cuando la incidencia se cierra. En Plain lo hace la sincronización de estado. Con eesel lo hace una automatización por webhook: eesel te da una URL y cualquier servicio que pueda enviar una solicitud web (Zapier, Make, tu propio backend, el webhook de un gestor de incidencias) puede despertar al agente con la incidencia cerrada e instrucciones. El agente busca entonces los tickets etiquetados con esa incidencia, escribe a cada cliente una nota breve diciendo que la corrección ya salió y le pide que lo compruebe por su parte.
Decirle a catorce clientes "el error que reportaste está corregido" es una de las victorias de buena voluntad más baratas en soporte, y casi nunca ocurre a mano. También detecta los casos en que la corrección no arregló nada, algo que conviene saber antes del próximo sprint.
¿Qué herramientas hacen triaje de errores con IA y cuánto cuestan?
La lista corta de ChatGPT para esta pregunta fue Modem, Plain y un helpdesk existente más IA y Zapier. Así se comparan las opciones que revisé, con los precios de la página de precios de cada proveedor, consultados el 30 de octubre de 2026. No todas hacen el mismo trabajo, así que al elegir la columna "dónde se ubica" importa tanto como el precio.
| Herramienta | Dónde se ubica | Qué hace para el triaje de errores | Precio |
|---|---|---|---|
| Zendesk intelligent triage | Dentro de Zendesk | Clasifica los tickets por tema, sentimiento e idioma, cada uno con un campo de confianza | Suite Professional 115 $/agente/mes más Copilot 50 $/agente/mes, facturado anualmente |
| Linear Triage Intelligence | Gestor de ingeniería | Sugiere equipo, responsable, etiquetas y duplicados para incidencias en triaje | Business 16 $/usuario/mes facturado anualmente, incluye Asks |
| Jira Service Management | Service desk | Recepción de solicitudes con agentes Rovo e IA en planes de pago | Gratis para 3 agentes, Standard 21,50 $/agente/mes |
| Plain | Helpdesk para equipos técnicos B2B | Enlaces nativos con Linear, GitHub y Jira con sincronización de estado | Foundation 45 $/usuario/mes facturado anualmente, 100 créditos por resolución de IA |
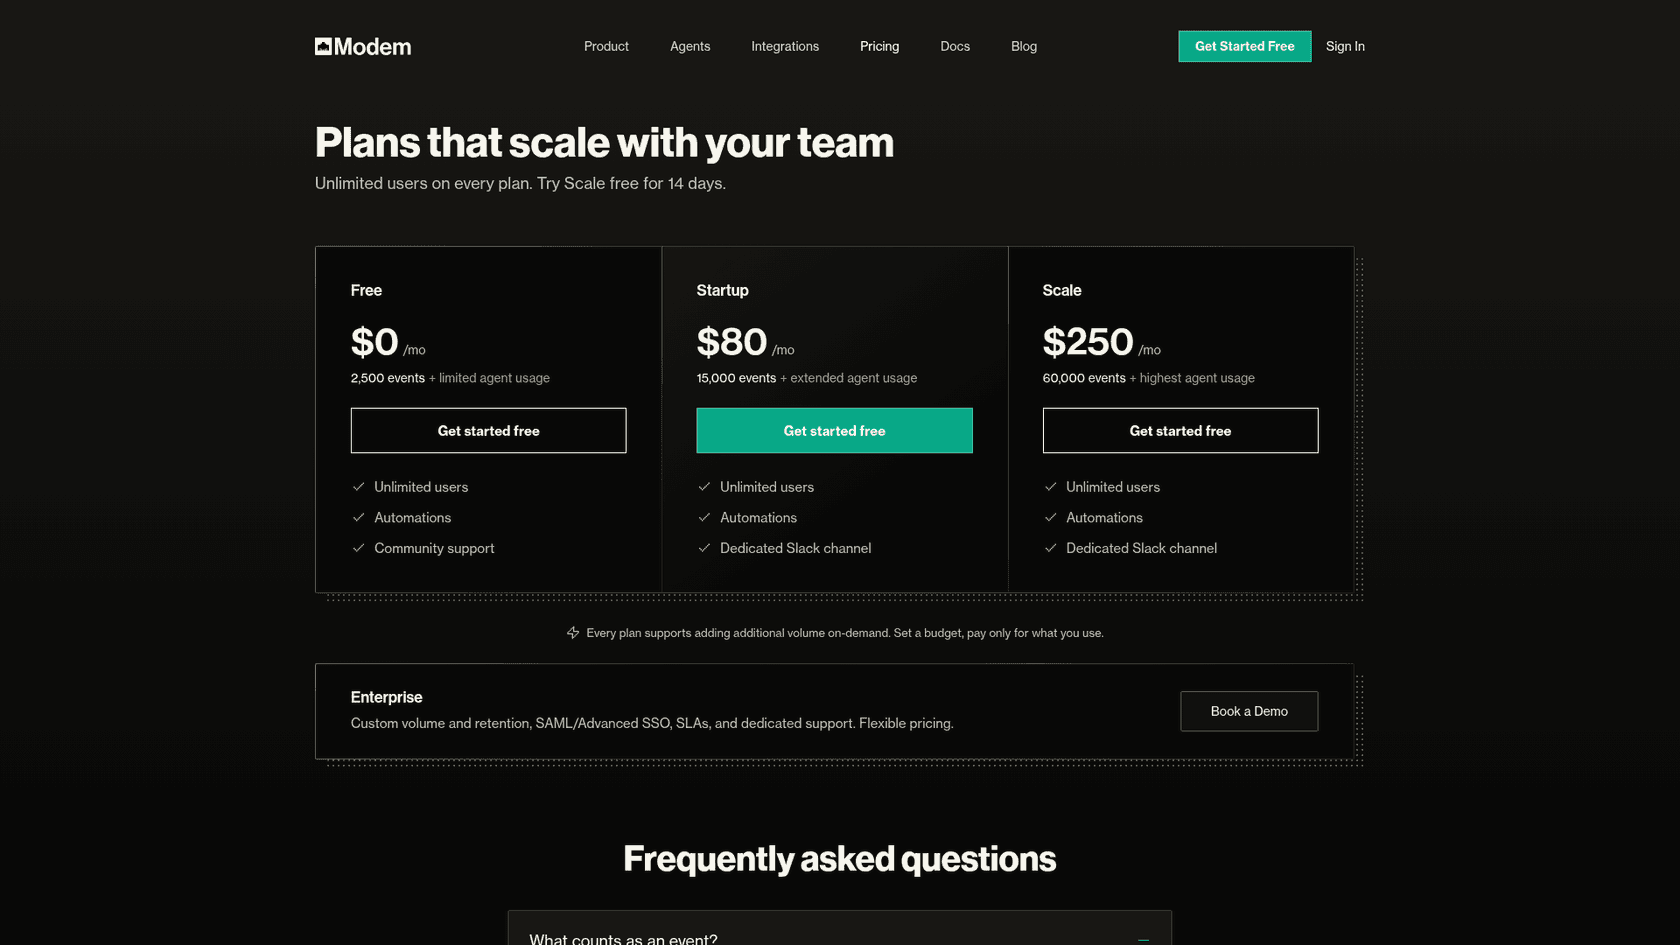
| Modem | A través de Slack, Discord, GitHub y soporte | Encuentra preocupaciones repetidas de clientes y las sigue hasta la corrección | Gratis, Startup 80 $/mes (15.000 eventos), Scale 250 $/mes |
| Screendesk | Complemento de tu helpdesk | Grabaciones de pantalla, pasos de reproducción con IA, automatizaciones de Jira y GitHub | Gratis, Plus 8 $, Pro 15 $ por agente/mes facturado anualmente |
| eesel | Compañero de IA dentro de tu helpdesk | Clasifica, pide detalles, redacta y registra el informe, avisa a los clientes cuando se corrige | 299 $/mes por 500 tickets, puestos ilimitados |
Unas notas sobre esa tabla. El triaje inteligente de Zendesk clasifica según el asunto y el primer comentario público, y puedes ver las clasificaciones en Suite Professional, pero usarlas en disparadores y enrutamiento requiere Copilot. Linear dice que Triage Intelligence tarda de 1 a 4 minutos por incidencia, lo cual está bien porque se ejecuta sobre incidencias, cuando un ticket ya se ha convertido en una. Modem cuenta como "evento" cualquier entrada sobre la que ejecuta IA, como un mensaje de Slack o una incidencia de GitHub.
¿Cuánto cuesta para un equipo de soporte?
Los precios por agente, por usuario, por evento y por ticket no se pueden comparar hasta que se calculan para un mismo equipo. Así que toma la empresa SaaS con seis agentes de soporte, 3.000 tickets al mes y diez ingenieros, que ya tiene un helpdesk.
| Configuración | La cuenta | Coste mensual |
|---|---|---|
| Zendesk con Copilot (Suite Professional, anual) | 6 x (115 $ + 50 $) | 990 $, helpdesk incluido |
| eesel leyendo cada ticket nuevo | 3.000 créditos, puestos ilimitados | 1.149 $, y los mismos créditos redactan respuestas en los tickets que no son errores |
| eesel solo en tickets que parecen errores | Se activa con un formulario de "problema" o una etiqueta, unos 500 al mes | 299 $ |
| Screendesk Pro añadido a tu helpdesk | 6 x 15 $ | 90 $ |
| Linear Business para ingeniería | 10 x 16 $ | 160 $ |
| Plain Foundation (cambio de helpdesk) | 6 x 45 $, más 100 créditos por resolución de IA tras 1.000 incluidas | 270 $ más créditos |
| Modem Startup | Tarifa plana, hasta 15.000 eventos | 80 $ |
Mi opinión: estas opciones se suman más de lo que compiten. Si tus ingenieros están en Linear Business, activa Triage Intelligence, ya está pagado. Si tu soporte vive en Zendesk y sobre todo quieres tickets clasificados y enrutados, Copilot lo hace dentro de Zendesk. Si quieres las preguntas de seguimiento, el informe redactado y el cliente avisado cuando sale la corrección, ese es el trabajo del lado de soporte que hace un compañero de IA, y es donde yo gastaría primero. Para el panorama más amplio, también escribí recopilaciones sobre las mejores herramientas de IA para el triaje de tickets y sobre la mejor IA para soporte de SaaS.
¿Cómo implantar el triaje de errores con IA sin molestar a ingeniería?
Los ingenieros perdonan un "esto podría ser un error, esto es lo que reuní". No perdonan un flujo de informes seguros de sí mismos que resultan ser ajustes, así que impleméntalo en este orden:
- Solo borradores y notas. La IA clasifica cada ticket y deja su carril, sus preguntas y cualquier borrador de informe como nota interna, y luego una persona envía. Así es como Timengo gestiona el soporte técnico de su producto de correo seguro en Freshdesk: cada ticket nuevo recibe un borrador en danés y una nota interna para el ingeniero, y eesel nunca envía por su cuenta.
- Escribe las reglas de lo que no es un error. Las falsas alarmas habituales de tu producto, con palabras sencillas, en una lista corta. Qontro, un ERP en la nube sobre Freshdesk, escribió una regla sobre cómo tratar un reporte de que los números parecen incorrectos, y envía los errores del sistema y la pérdida de datos directamente a una persona.
- Compara sus carriles con lo que decidió tu equipo. Donde la IA llamó error a algo que no lo era, afina la regla o corrige el artículo de ayuda. Qontro usa sus borradores así: un borrador equivocado suele señalar un artículo que falta o una regla que hay que afinar.
- Deja que el carril de lo que no es un error pase a automático. Respuestas de uso y de ajustes sobre temas acotados, una vez que aguantan con tickets pasados.
- Activa el registro de incidencias, tras aprobación. La IA registra el informe en Jira, Linear o GitHub, y una persona aprueba cada uno hasta que los informes sean buenos de forma constante.
- Cierra el bucle. Conecta de vuelta a la IA el evento de "incidencia cerrada" del gestor para que los clientes vinculados se enteren de la corrección.
Antes del paso cuatro, pruébalo. Las pruebas de simulación de soporte con IA explican cómo ejecutar el agente sobre los tickets del mes pasado, y mi cronograma de implementación tiene las cifras realistas de cada etapa.
Algunos más que ayudan por el camino. Las buenas prácticas de traspaso a humanos cubren lo que debe oír el cliente cuando la IA pasa un ticket, y IA para soporte de nivel 2 cubre el trabajo de investigación una vez que hay un informe. Y si las respuestas erróneas siguen apuntando a documentación escasa, el análisis de lagunas de conocimiento en soporte las convierte en un backlog.
¿Pueden los ingenieros configurarlo desde la terminal?
Para un equipo de software esto es práctico. La CLI de eesel ejecuta desde una terminal el mismo agente que ves en el panel, y cada comando imprime JSON, así que un agente de programación como Claude Code, Cursor o Codex también puede manejarla. Un ingeniero puede añadir el documento de problemas conocidos con eesel files upload, probar cómo clasifica el agente un reporte de ejemplo con eesel chat "export freezes at 99% since the update" y liberar una acción retenida de registro de incidencias con eesel approvals approve <id>, todo sin abrir el panel. eesel automations lista la automatización por webhook que cierra el bucle. El contexto de la idea está en mi artículo sobre los servidores MCP de agentes de IA.
Prueba eesel para el triaje de errores
Si tus reportes de errores llegan a Zendesk, Freshdesk o Jira Service Management, eesel se une a esa cola como un compañero de soporte que ha leído tu centro de ayuda, tu registro de cambios y cada ticket que has resuelto. Responde los tickets de uso y de ajustes, pide a los clientes los pasos y las capturas que ingeniería necesitará, etiqueta los duplicados con el informe que ya está abierto y luego redacta el informe que una persona confirma antes de registrarlo. Cuando sale la corrección, avisa a todos los que lo reportaron.
SE Ranking lo usa así en tres productos en Zendesk, enviando a nivel 2 las preguntas sobre datos incorrectos y sobre la API con la evidencia ya adjunta.
Los planes empiezan en 299 $ al mes por 500 tickets o chats, con puestos ilimitados, y hay una prueba gratuita con 100 créditos. Prueba eesel con los reportes de errores del mes pasado y mira cuáles habría clasificado como lo hizo tu equipo.