

Kurzfassung
Claude Opus 5.5 ist das klügere Modell. GPT-6 Sol ist das günstigere. Beide erschienen am 22. September 2026. Im Vergleich von Artificial Analysis erreicht Opus 5.5 im Intelligence Index 58 Punkte gegenüber 48 für Sol und liegt bei GDPval-AA, Terminal-Bench 4.0 und AutomationBench vorn. Sol kostet pro Token die Hälfte: 2 $/10 $ pro Million gegenüber 4 $/20 $.
Auf dem Preisschild kostet Opus das Doppelte. Bei maximalem Aufwand kostete es 5,6-mal mehr pro erledigter Aufgabe (5,98 $ vs. 1,06 $), weil es fast viermal so viele Output-Tokens schrieb. Vergleicht man stattdessen bei gleichen Kosten statt bei gleichen Aufwands-Labels, kippt das Bild erneut: Opus 5.5 mit mittlerem Aufwand schlägt Sol auf max, 51 zu 48, bei 1,34 $ pro Aufgabe gegenüber 1,06 $.
Meine Wahl: Sol für Aufgaben mit hohem Volumen im Alltag, bei denen die Antwort klar definiert ist. Opus 5.5 auf medium für schwierige, lange, agentische Aufgaben, bei denen eine falsche Antwort mehr kostet als die Tokens. Wenn es darum geht, Kunden zu antworten, spielt das Modell eine kleinere Rolle als das System drumherum. Genau das übernimmt ein KI-Helpdesk-Teammitglied wie eesel, abgerechnet pro gelöstem Ticket statt pro Token.
Zwei Launches an einem Nachmittag
Ich baue bei eesel KI-Agenten, und jedes Frontier-Release bedeutet für mich dasselbe Ritual: Evals neu laufen lassen, die Kosten pro erledigter Aufgabe prüfen und entscheiden, welche Arbeit auf das neue Modell wechselt. Diese Woche kam das Ritual gleich zweimal hintereinander. Anthropic hat am 22. September Claude Opus 5.5 veröffentlicht, und OpenAI zog innerhalb weniger Stunden mit GPT-6 Sol und Luna nach.
Dieses Timing ist wichtig, um die Launch-Beiträge richtig zu lesen. Anthropics Benchmark-Tabelle vergleicht Opus 5.5 mit GPT-5.6 Sol und GPT-6 Astra, weil GPT-6 Sol noch gar nicht existierte. OpenAIs Tabelle vergleicht Sol mit Claude Opus 5 und Claude Fable 5.1, nicht mit Opus 5.5. Keiner der Anbieter hat das neue Modell des anderen gemessen. Für einen fairen Direktvergleich stütze ich mich deshalb auf die unabhängigen Tests von Artificial Analysis, die beide durch denselben Testaufbau geschickt haben.
Gehören die beiden überhaupt in dieselbe Klasse? Manche Leser meinen nein, da Sol nur halb so viel kostet. Ein HN-Kommentator hat die gegenteilige Sicht klar formuliert:
"Sol is OpenAI's Opus, and Astra is OpenAI's Fable. Both pricing-wise, and performance-wise."

Dieser Zuordnung stimme ich zu. Jedes ist das "Nimm das als Standard"-Modell seines Anbieters, eine Stufe unter dem Flaggschiff. Genau deshalb entscheiden sich Entwickler diese Woche zwischen den beiden.
Was jedes Modell ist
GPT-6 Sol
GPT-6 Sol ist die Mitte der GPT-6-Familie von OpenAI, zwischen dem günstigen GPT-6 Luna und dem Flaggschiff Astra. OpenAIs eigener Leitsatz lautet "Build with Sol. Scale with Luna." Die Schlagzeile ist der Preis: 2 $ für Input und 10 $ für Output pro Million Tokens, pauschal 50 % weniger als bei GPT-5.6 Sol. Artificial Analysis sieht die Intelligenz etwa auf dem Niveau von GPT-5.6 Sol, mit dem eigentlichen Qualitätsgewinn bei der Faktentreue.
Die Modellseite listet sechs Reasoning-Einstellungen von none bis max, mit medium als Standard, sowie das komplette Tool-Set der Responses API: Web- und Dateisuche, Code Interpreter, gehostete Shell, Computer Use und MCP.
Claude Opus 5.5
Claude Opus 5.5 ist Anthropics Effizienz-Update von Opus 5. Es ist das erste Opus, das günstiger wird, 20 % weniger auf 4 $/20 $, und Anthropic empfiehlt jetzt, für die meiste Arbeit damit zu beginnen, statt Opus als teure letzte Instanz zu behandeln. Der Standardaufwand sank von high auf medium, das Denken ist immer aktiv, und die Opus-5.5-Dokumentation nennt einen Wissensstand von Juni 2026.
Anthropic positioniert es bei der Qualität von Fable 5.1 für die meiste Arbeit. Artificial Analysis führt es derzeit auf Platz 1 von 212 Modellen im Intelligence Index.
Spezifikationen und Preis im Vergleich
Der größte Teil des Datenblatts ist ein Unentschieden. Der Unterschied liegt fast nur in der Preisspalte.
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| API-Modell-ID | gpt-6-sol | claude-opus-5-5 |
| Input / Output pro 1 Mio. Tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Cache-Lesezugriffe pro 1 Mio. | 0,20 $ | 0,20 $ |
| Batch API | 50 % Rabatt (1 $ / 5 $) | 50 % Rabatt (2 $ / 10 $) |
| Long-Context-Aufschlag | 2x Input, 1,5x Output ab 272K | Keiner |
| Kontextfenster | 1.050.000 Tokens | 1 Mio. Tokens |
| Maximaler Output | 128.000 Tokens | 128K (300K in der Batch-Beta) |
| Wissensstand | 20. April 2026 | Juni 2026 |
| Standardaufwand | Medium | Medium |
| Reasoning abschaltbar | Ja (none) | Nein, Denken immer aktiv |
| Input / Output | Text + Bild rein, Text raus | Text + Bild rein, Text raus |
Zwei Zeilen verdienen Aufmerksamkeit. Erstens kosten Cache-Lesezugriffe bei beiden gleich viel. Besteht Ihre Last aus einem großen, stabilen System-Prompt plus kurzen Fragen, ist ein großer Teil Ihrer Input-Rechnung identisch. Zweitens die Long-Context-Zeile. Ab 272K Input-Tokens verdoppelt sich Sols Input-Preis, sodass der 2x-Abstand bei Jobs mit riesigem Kontext schnell schrumpft. Wie ein HN-Nutzer anmerkte:
"Once you exceed 272K input tokens, Codex Sol is roughly the same price as Opus; and Astra similar to Fable."
Die vollständigen Preislisten samt Fast-Modus und regionaler Preise finden Sie in meiner Aufschlüsselung zu den GPT-6-Sol-Preisen und ihrem Opus-5.5-Pendant. Der breitere Vergleich OpenAI-API vs. Anthropic-API deckt beide Plattformen ab.
Die Benchmarks: Opus 5.5 gewinnt fast jede Zeile
Artificial Analysis hat beide bei maximalem Aufwand durch denselben Testaufbau laufen lassen. Das ist derzeit der sauberste Direktvergleich.
| Benchmark (Artificial Analysis, max. Aufwand) | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index | 48 | 58 |
| GDPval-AA v2.1 (Elo, reale Arbeitsaufgaben) | 1487 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1483 | 1822 |
| AutomationBench-AA | 62 % | 70 % |
| Terminal-Bench 4.0 | 44 % | 60 % |
| SciCode | 58 % | 67 % |
| Humanity's Last Exam | 48 % | 61 % |
| AA-LCR (Reasoning über lange Kontexte) | 84 % | 85 % |
| CritPt | 31 % | 32 % |
| AA-Omniscience Index | 27 | 46 |
| Halluzinationsrate (niedriger ist besser) | 60 % | 58,6 % |
Die großen Abstände liegen bei den Aufgaben, die echter Arbeit am ähnlichsten sind: GDPval-AA mit 359 Elo-Punkten, Terminal-Bench mit 16 Punkten und der Intelligence Index mit 10. Die kleinen Abstände sind ebenfalls aufschlussreich. Reasoning über lange Kontexte und CritPt liegen innerhalb eines Punktes, und die Halluzinationsraten sind nahezu identisch. Sols große Verbesserung bei der Faktentreue gegenüber GPT-5.6 bringt es bei der Halluzinationsrate auf Augenhöhe mit Opus, wobei Opus mit 46 zu 27 im Omniscience Index trotzdem mehr weiß.
Ein paar ehrliche Einschränkungen zu den Zahlen. Anthropic gibt für Opus 5.5 bei Terminal-Bench 4.0 mit dem eigenen Setup auf xhigh 66,4 % an, mehr als die 60 %, die Artificial Analysis gemessen hat; für den Vergleich mit Sol ist das unabhängige Paar fairer. Die OSWorld-2.0-Werte der beiden Anbieter (60,5 % für Sol, 81,8 % für Opus) nutzen unterschiedliche Testsätze, deshalb würde ich aus ihnen keinen Abstand ablesen. Und es gibt noch keinen Opus-5.5-Wert für DeepSWE, wo Sol 68,8 % und 69,0 % innerhalb von Codex im Coding Agent Index erreicht.
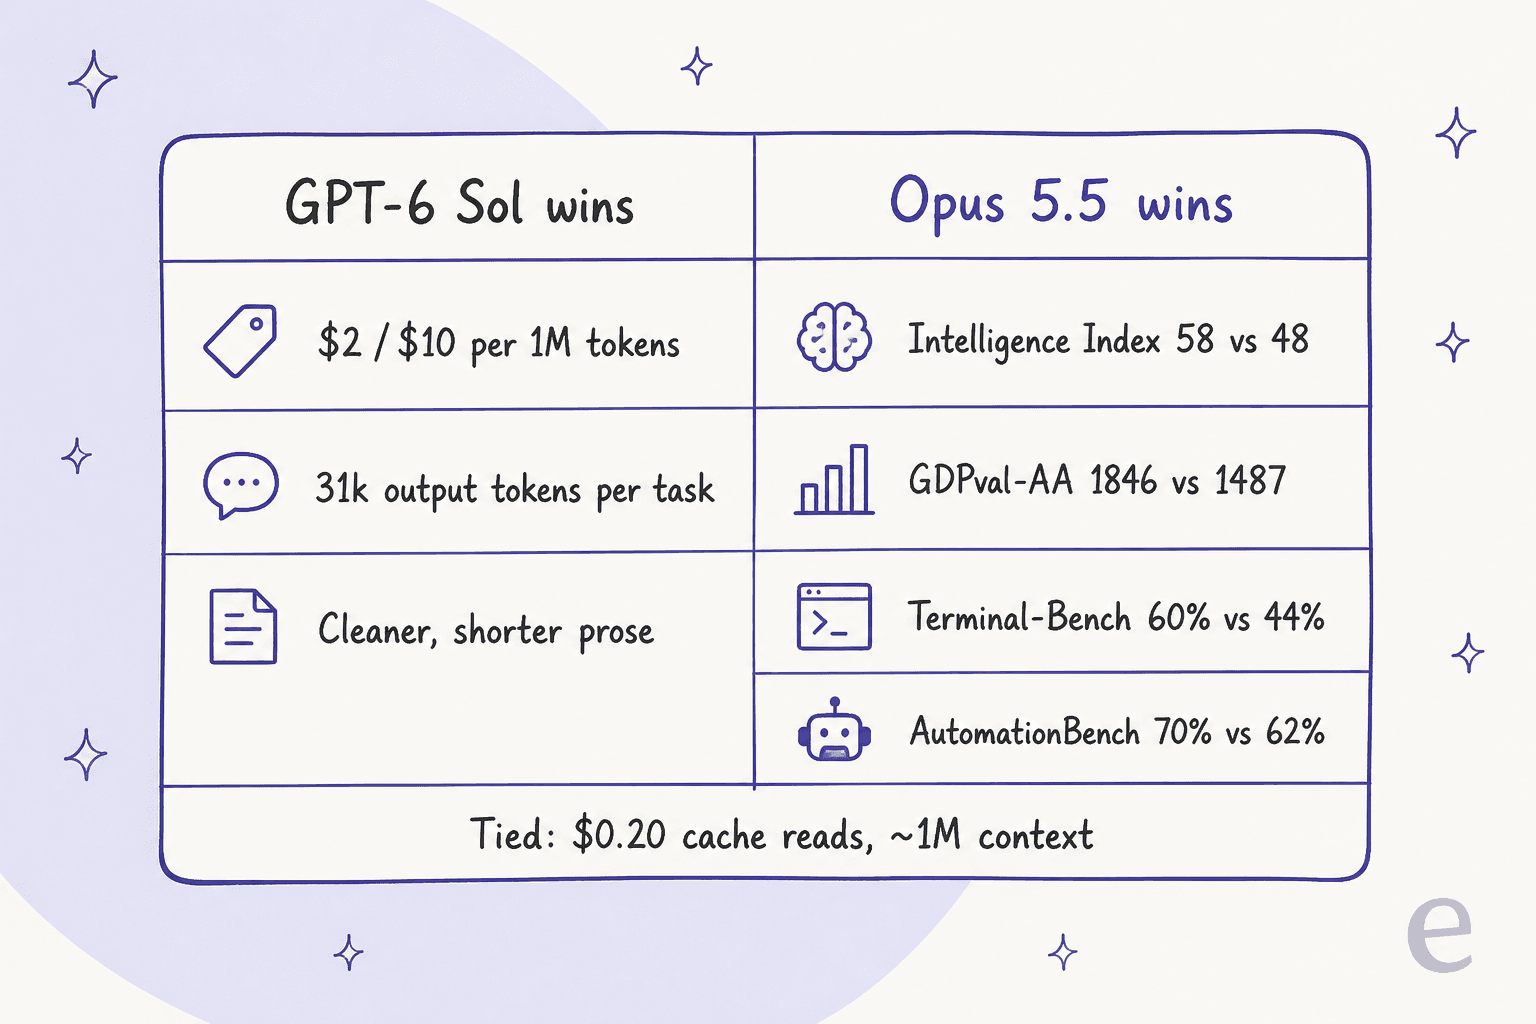
Das Muster dieser Scorecard ist die ganze Geschichte in einem Bild: Opus 5.5 gewinnt die Leistungszeilen, Sol gewinnt die Kostenzeilen. Was davon mehr zählt, hängt davon ab, was ein Fehler Sie kostet.
Was die meisten Vergleiche übersehen: Kosten pro Aufgabe statt pro Token
Der Preis pro Token ist die Zahl auf der Preisseite. Die Kosten pro erledigter Aufgabe sind die Zahl auf Ihrer Rechnung. Beide können sehr verschieden sein, weil Modelle sehr unterschiedlich viele Tokens bis zur Antwort verbrauchen.
Im Artificial-Analysis-Index, bei maximalem Aufwand:
| Pro Aufgabe, max. Aufwand | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Output-Tokens pro Aufgabe | ~31k | ~119k |
| Kosten pro Aufgabe | 1,06 $ | 5,98 $ |
| Gesamtkosten für den kompletten Index | 1.550 $ | 8.708 $ |
Aus dem 2x-Abstand auf dem Preisschild wird bei max also ein 5,6x-Abstand pro Aufgabe. Das überrascht, denn Opus 5.5 wird mit Effizienz beworben. Das Effizienzversprechen stimmt gegenüber Opus 5 bei gleichem Aufwand, aber bei maximalem Aufwand denkt Opus 5.5 sehr viel. Artificial Analysis hat gemessen, dass es mehr Output-Tokens pro Aufgabe verbraucht als Opus 5, Fable 5.1 oder GPT-6 Astra:
"Opus 5.5 (max) uses ~119k output tokens per Intelligence Index task, against ~73k for Opus 5 (max), ~78k for Fable 5.1 (max) and ~27k for GPT-6 Astra (max)"
Und hier kippt es wieder zurück. Aufwandsstufen bedeuten bei den Anbietern nicht dasselbe, deshalb ist ein Vergleich "max gegen max" nicht wirklich fair. Stellen Sie sie stattdessen nach Kosten nebeneinander, anhand der Werte pro Aufwandsstufe auf den Release-Seiten von Artificial Analysis für jedes Modell:
| Aufwand | GPT-6 Sol Punktzahl / Kosten pro Aufgabe | Opus 5.5 Punktzahl / Kosten pro Aufgabe |
|---|---|---|
| low | 34 / 0,13 $ | 42 / 0,55 $ |
| medium | 40 / 0,25 $ | 51 / 1,34 $ |
| high | 43 / 0,37 $ | 54 / 1,82 $ |
| xhigh | 44 / 0,53 $ | 56 / 3,46 $ |
| max | 48 / 1,06 $ | 58 / 5,98 $ |
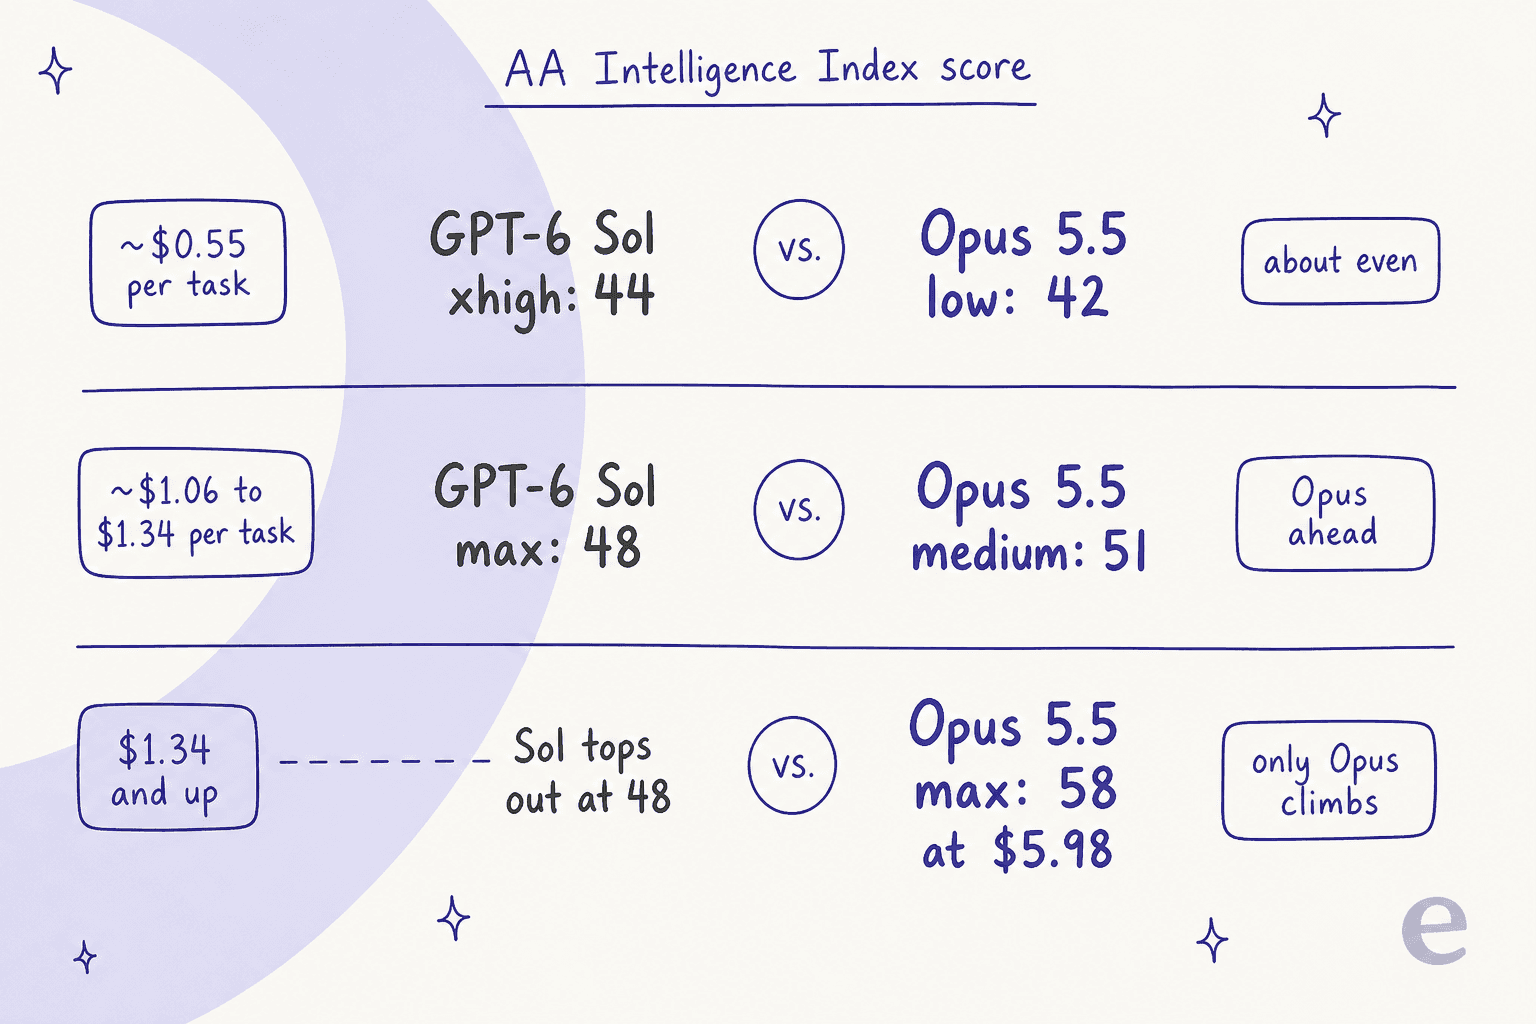
So lesen Sie die Tabelle:
- Unter etwa 0,55 $ pro Aufgabe sind sie gleichauf. Sol auf xhigh (44) und Opus auf low (42) kosten fast dasselbe. Darunter wird nur Sol noch günstiger: 40 Punkte für einen Viertel-Dollar.
- Bei etwa einem Dollar pro Aufgabe zieht Opus davon. Opus 5.5 auf medium erreicht 51 für 1,34 $, drei Punkte über Sols bestem Aufwand für rund 26 % mehr Geld.
- Darüber steigt nur noch Opus weiter. Sols Obergrenze liegt bei 48. Wenn Sie mehr brauchen, ist Opus das einzige der beiden Modelle, das es bis hinauf zu 58 liefert.
Das deckt sich mit dem, was frühe Nutzer sagten. Ein HN-Kommentator:
"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."
Eine Antwort wandte ein, dass die fairere Paarung Opus medium gegen Sol high sei. Bei dieser Paarung kostet Sol 0,37 $ pro Aufgabe gegenüber 1,34 $ bei Opus, es wird also zur Frage, ob 8 Punkte mehr die 3,6-fache Rechnung wert sind. Für Massenarbeit meist nicht. Für einen schwierigen agentischen Lauf, bei dem ein gescheiterter Versuch einen erneuten Durchlauf bedeutet, oft schon.
Möchten Sie sehen, was das für Ihr eigenes Volumen bedeutet? Geben Sie Ihre Zahlen ein. Die Kosten stammen aus den Ergebnissen pro Aufgabe von Artificial Analysis, betrachten Sie sie also als relative Orientierung: Ihre Aufgaben werden kürzer oder länger sein als deren.
Wie sie sich in der Arbeit anfühlen
Benchmarks zeigen die Obergrenze. Der tägliche Einsatz zeigt, wie sich das Standarderlebnis anfühlt, und hier teilen sich die frühen Berichte entlang einer klaren Linie.
Die nützlichste Praxiseinschätzung bisher stammt von Dan Shipper bei Every, der beide an echter Arbeit getestet hat. Beim Programmieren sah er Opus vorn:
"Sol improves on GPT-5.6—including better Ruby code in @kieranklaassen tests—but Opus 5.5 has the higher ceiling for long, autonomous builds."
Im selben Beitrag fand er Sols Schreibstil sauberer, mit der wichtigen Idee zuerst, während Entwürfe von Opus 5.5 den Kern tendenziell vergraben. Sein Fazit teilte sich nach Aufgabe: Sol für einen Tag mit "reading, writing, and getting things done" in Codex, Opus 5.5, wenn Sie "hand an agent a hard coding or visual project and see how far it can take it."
Auch das Verhalten unterscheidet sich. Sol tut tendenziell mehr, als Sie verlangt haben; Claude tut, worum Sie gebeten haben, und hört auf. Ein HN-Entwickler beschrieb die OpenAI-Seite anschaulich:
"OpenAI models are also much more eager than Anthropic, which are on the lazier side. Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app."
Die Wortfülle ist bei Opus 5.5 die offene Frage. Manche Nutzer sagen, es lese sich endlich klar, andere finden es so ausschweifend wie Opus 5. Die Token-Zahlen oben legen nahe, dass beides stimmen kann: kurze sichtbare Antworten, langes verborgenes Denken bei hohem Aufwand. Wenn Sie für dieses Denken zahlen, stellen Sie den Aufwandsregler bewusst ein, statt ihn auf max zu lassen.
Auch die Abo-Limits sind umstritten. Auf HN sagte ein Nutzer, eine Codex-Woche habe bei halbintensiver Nutzung mit einem einzelnen Agenten auf Sol High ein bis zwei Tage gehalten, während ein anderer sagte, Codex gewinne bei der Nutzung "by a mile". Wenn Sie in Claude Code oder Codex statt in der API arbeiten, testen Sie Ihre eigene Woche, bevor Sie den Tarif wechseln.
Welches sollten Sie nutzen?
So würde ich die Arbeit aufteilen, auf Grundlage der obigen Zahlen.
| Wenn Ihre Aufgabe ... | Nehmen Sie | Warum |
|---|---|---|
| Klassifikation, Extraktion, Routing in hohem Volumen | GPT-6 Sol auf low oder medium | 40 Punkte für 0,25 $ pro Aufgabe, und das Reasoning lässt sich ganz abschalten |
| Alltägliches Entwerfen, Zusammenfassungen, kurze Antworten | GPT-6 Sol | Günstiger pro Aufgabe, nach frühen Berichten saubererer Text |
| Lange autonome Coding-Läufe, mehrstufige Agenten | Claude Opus 5.5 auf medium | Schlägt Sols beste Punktzahl für etwa 26 % mehr pro Aufgabe |
| Das schwierigste Reasoning, bei dem ein Fehlschlag teuer ist | Claude Opus 5.5 auf high oder max | Einzige Option, die über 48 hinausgeht |
| Riesiger Kontext (über 272K Tokens) | Claude Opus 5.5 | Kein Long-Context-Aufschlag, der Preisabstand verschwindet größtenteils |
| Große stabile Prompts, viele Cache-Treffer | Beide | Cache-Lesezugriffe kosten bei beiden 0,20 $ |
Den Fehler, für alles dasselbe Modell zu wählen, würde ich vermeiden. Beide Anbieter machen Routing inzwischen leicht, und die Kostenkurven sagen, dass die günstigste gute Antwort am unteren Ende von Sol und am oberen Ende von Opus kommt. Wenn Sie ohnehin im OpenAI-Stack sind, lohnt sich ein Blick auf GPT-6 Luna für die sehr günstige Stufe. Auf Anthropic-Seite übernimmt Claude Sonnet 5 dieselbe Rolle, wie meine Aufschlüsselung Opus 5 vs. Sonnet 5 zeigt.
Für einen breiteren Überblick deckt die OpenAI-Modellliste den Rest von OpenAIs Angebot ab, und mein Leitfaden zu den Anthropic-API-Preisen leistet dasselbe für Claude.
Wenn das Modell Ihren Kunden antworten soll
Viele, die diese beiden vergleichen, stellen eigentlich eine andere Frage: Welches soll unseren Support-Bot antreiben? Hier spielt der Benchmark-Abstand weniger eine Rolle, als man denkt.
Ein Frontier-Modell ist Infrastruktur. Um ein Ticket zu lösen, braucht es außerdem Ihr Help Center und frühere Tickets als Grundlage für seine Antworten, Aktionen in Ihrem Helpdesk (taggen, routen, erstatten, eine Bestellung nachschlagen), Leitplanken dafür, wann es übergibt, und eine Möglichkeit, all das zu testen, bevor echte Kunden es sehen. Dieser letzte Punkt ist der, an dem die meisten selbstgebauten Bots scheitern. Bei eesel habe ich erlebt, dass überzeugend klingende Antworten sich im Test als falsch erwiesen, weshalb eesel jeden Rollout an historischen Tickets simuliert, bevor er live geht.
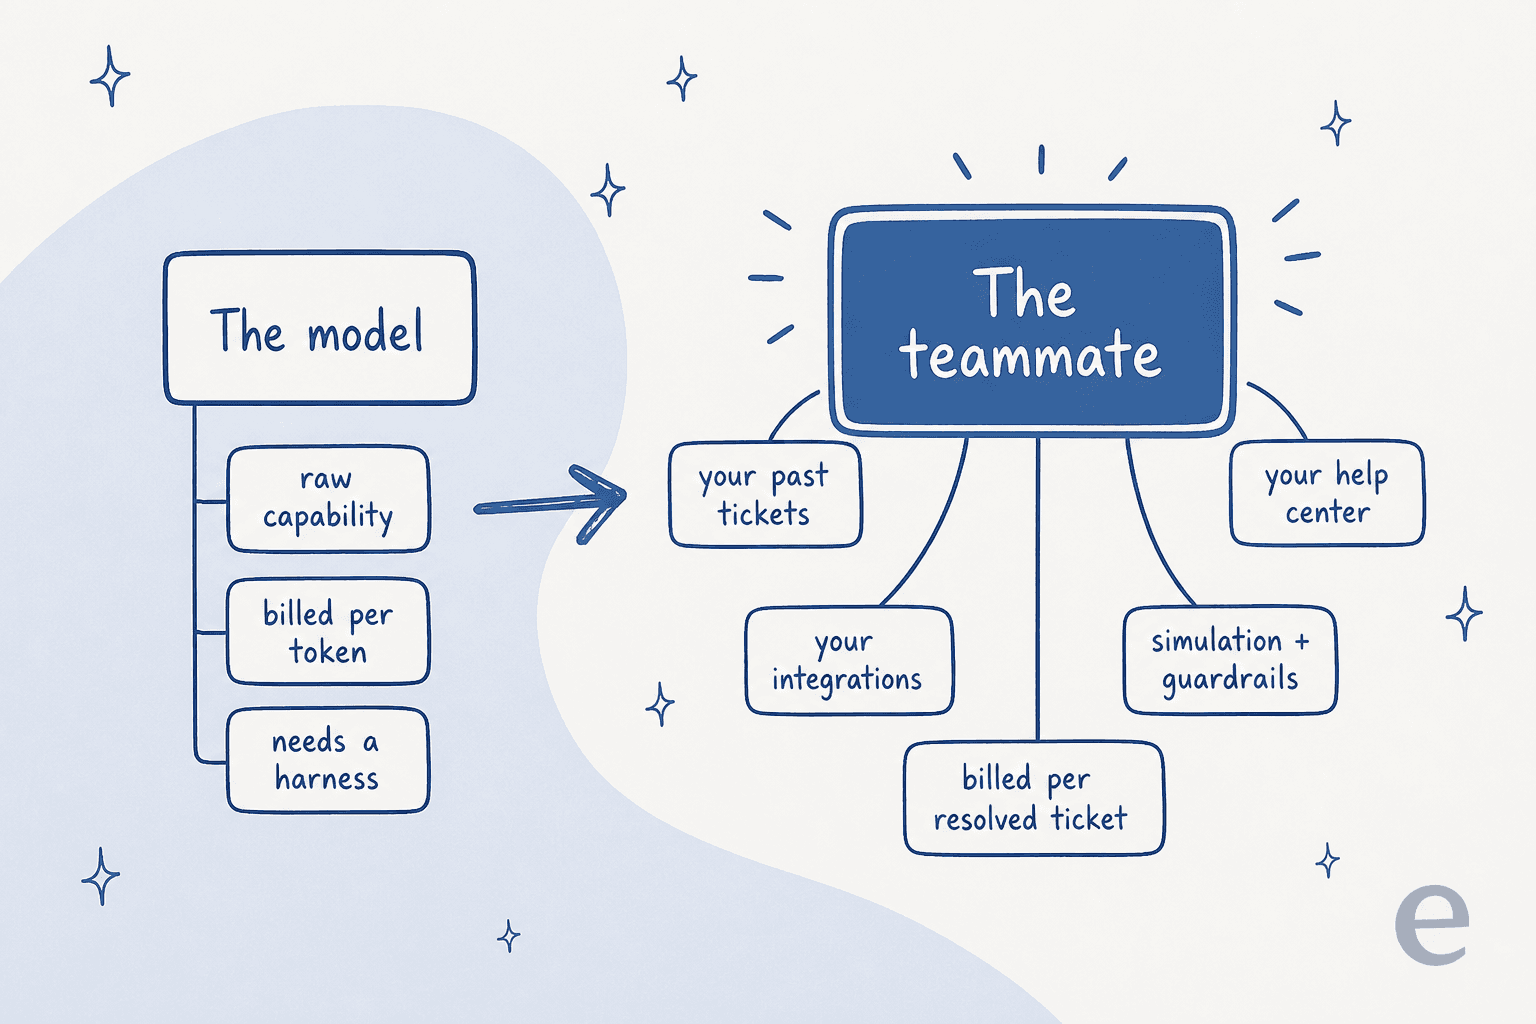
Deshalb sehe ich eesel als den Mitarbeiter und das Modell als den Motor. Das KI-Helpdesk-Teammitglied steckt in Tools wie Zendesk, Freshdesk und Gorgias, lernt aus Ihren früheren Tickets und rechnet pro gelöstem Ticket statt pro Token ab, sodass die Sol-vs-Opus-Token-Rechnung nicht Ihr Problem ist.
Wenn Sie zuerst Optionen vergleichen möchten, ist meine Übersicht der besten KI-Helpdesk-Software ein guter Startpunkt, und diese Aufschlüsselung zu KI vs. menschlichen Kosten zeigt die Rechnung pro Ticket.
Für die technisch Interessierten, die diesen Beitrag über einen Modellvergleich gefunden haben: Dasselbe Teammitglied lässt sich auch skripten. Mit dem eesel CLI (npm i -g @eesel/cli) verbinden Sie Integrationen, bearbeiten die dauerhaften Anweisungen des Agenten, lesen jeden Lauf mit eesel activity und genehmigen oder lehnen ausstehende Aktionen im Terminal ab. Jeder Befehl gibt JSON aus und unterstützt --dry-run, sodass Claude Code oder Codex ihn steuern können. Jeder Workspace ist außerdem ein MCP-Server, sodass Sie KI-Agenten verwalten können, direkt aus Ihrem Terminal, mit welchem der beiden Modelle Sie auch arbeiten.
eesel testen
Wenn Sie GPT-6 Sol und Opus 5.5 vergleichen, weil Sie KI wollen, die Support-Tickets beantwortet, können Sie sich das Modell-Duell sparen. Das KI-Helpdesk-Teammitglied von eesel schließt sich Ihrem bestehenden Helpdesk an, lernt aus Ihren früheren Tickets und Ihrem Help Center und wird an Ihrem echten Ticket-Verlauf getestet, bevor es einem einzigen Kunden antwortet. Sie zahlen pro gelöstem Ticket, nicht pro Token.

eesel testen Sie kostenlos und sehen Sie es an Ihren eigenen Tickets in Aktion.