

OpenAI hat GPT-5.6-Cyber am 10. August 2026 veröffentlicht, und Sie können es mit hoher Wahrscheinlichkeit nicht nutzen. Es basiert auf GPT-5.6 Sol, ist gezielt auf das Finden von Zero-Days und den Bau von Exploit-Ketten trainiert und existiert nur hinter Daybreak Red, der von Bewerbern zu prüfenden Stufe von OpenAIs Daybreak-Verteidigerprogramm.
Die Schlagzeilenzahl ist real und verdient eine genaue Einordnung. In OpenAIs interner Advanced Cybersecurity Completion Rate beantwortet GPT-5.6-Cyber 95,0 % der fortgeschrittenen Cyber-Prompts, bei denen das normale Sol 1,5 % beantwortet. Das misst, wie oft das Modell antwortet, nicht wie oft es richtig liegt. Es ist eine Ablehnungsmetrik im Gewand einer Leistungsmetrik, und die meiste Berichterstattung gestern hat beides verwischt.
Was niemand laut sagt: Red ist ein Kompromiss, kein reines Upgrade. In OpenAIs eigener Evaluierung zu Schwachstellenentdeckung und Berichtsschreiben schneidet GPT-5.6-Cyber schlechter ab als das normale Sol, und Sol gewinnt auch ExploitBench bei der Standardeinstellung von 300 Durchgängen und verbraucht dabei weniger Tokens. Wenn Ihr Engpass ein guter Schwachstellenbericht ist und nicht, das Modell überhaupt zum Antworten zu bringen, ist Daybreak Blue die bessere Antwort, und es ist die Stufe, die OpenAI selbst zuerst empfiehlt.
Es gibt außerdem weder einen veröffentlichten Preis noch eine System Card. Die Kostenseite behandeln wir im Cyber-Preisbeitrag, die ganze Familie in der GPT-5.6-Übersicht.
Was GPT-5.6-Cyber eigentlich ist
Ich baue bei eesel Integrationen und APIs, also suche ich bei jedem Modellstart zuerst nach der Modell-ID und dem Preis. Hier existiert beides öffentlich nicht. Diese Abwesenheit ist die ganze Geschichte.
GPT-5.6-Cyber ist OpenAIs auf Cybersicherheit spezialisiertes Modell, angekündigt am 10. August 2026. Es baut auf Sol auf, dem Flaggschiff der GPT-5.6-Familie, und ist auf zwei verschiedene Dinge trainiert: spezialisierte Aufgaben wie das Finden von Zero-Day-Schwachstellen und die Entwicklung von Exploit-Ketten zu verbessern und Ablehnungen bei riskanter Dual-Use-Cyberarbeit zu reduzieren.
Diese beiden Ziele sollte man trennen, weil sie meist zu „dem freigeschalteten Modell“ zusammengeworfen werden. Weniger Ablehnungen sind eine Richtlinienänderung. Bessere Zero-Day-Entdeckung ist eine Trainingsänderung. GPT-5.6-Cyber tut beides, und wie weiter unten zu sehen ist, bewegen sich beide nicht immer in dieselbe Richtung.
Sol, Terra und Luna sind Leistungsstufen, die Sie in der API auswählen, so wie Sie einen Reasoning-Aufwand wählen oder bei einer schweren Aufgabe zu Sol Ultra greifen. Cyber ist das nicht. Es gibt keine Modell-ID gpt-5.6-cyber, die Sie in eine Anfrage an die OpenAI API einsetzen können. Sie bewerben sich, werden geprüft, und erst dann existiert das Modell für Sie.
Wenn Sie nach dem GPT-5.6-Test hierhergekommen sind und sich fragen, ob dies eine fünfte Stufe ist: nein. Es ist ein paralleler Strang mit eigener Tür.
Daybreak Blue und Daybreak Red sind nicht zwei Größen desselben Produkts
Das ist der Teil, den die meisten Beiträge falsch verstanden haben, und er ändert, wofür Sie sich bewerben sollten.
Daybreak hat jetzt zwei Zugangsstufen. Daybreak Blue gibt Ihnen allgemeine Frontier-Modelle, Sol eingeschlossen, ohne die Cyber-Schutzmechanismen auf Systemebene. Daybreak Red gibt Ihnen die eigens trainierten Cybersecurity-Modelle, was derzeit GPT-5.6-Cyber bedeutet.
Der Instinkt ist, Blue als die günstige Stufe und Red als die echte zu lesen. So ist es nicht aufgebaut. Blue ist kein kleineres Kontingent von Red. Blue ist dasselbe Frontier-Modell, von dem eine Prüfschicht abgenommen wurde. Red ist ein wirklich anderes Modell mit anderem Training.
Diese Unterscheidung ist wichtig, weil OpenAI ungewöhnlich direkt sagt, welche Stufe Sie wollen sollten. In den eigenen Worten ist Blue „the recommended starting point for most defenders“, und deckt Schwachstellenentdeckung, sicheres Code-Review, Malware-Analyse, Incident Response und Patch-Validierung ab. Red ist Teams vorbehalten, deren autorisierte Arbeit fortgeschrittene Schwachstellenforschung, Exploit-Entwicklung oder Red Teaming umfasst.
In der Produktion prüft OpenAI cyberbezogene Anfragen, um Missbrauch zu verhindern, und räumt ein, dass diese Prüfungen „can also block legitimate defensive work“. Blue soll diese Reibung beseitigen. Red existiert, weil Sol auch bei ausgeschalteten Prüfungen manche stark Dual-Use-lastigen Prompts weiterhin ablehnt, etwa Pentests an einem Produktivsystem.
Interaktiv
Welche Daybreak-Stufe brauchen Sie wirklich?
Wählen Sie die Beschreibung, die Ihrem Berufsalltag am nächsten kommt.
Bewerben Sie sich für Blue. Nicht für Red.
Sie bekommen Sol ohne die Cyber-Schutzmechanismen auf Systemebene. OpenAI nennt genau Ihre Arbeitslast als Blue-Anwendungsfall und bezeichnet Blue als empfohlenen Einstieg für die meisten Verteidiger.
- Completion Rate bei fortgeschrittenen Prompts: 2,0 %, gegenüber 1,5 % mit aktiven Schutzmechanismen
- Der Haken: Die 2,0 % wirken vernichtend, aber das Evaluierungsset besteht bewusst aus den härtesten Dual-Use-Prompts. Blue entsperrt die gewöhnliche Verteidigungsarbeit
- Bonus: Sol schlägt Cyber bei der Berichtsqualität und bei ExploitBench mit 300 Durchgängen
<div class="dbtier-card dbt-b">
  <span class="dbtier-tag dbtier-tag-red">Daybreak Red</span>
  <p class="dbtier-lead">Red ist die richtige Anfrage, aber fangen Sie trotzdem mit Blue an.</p>
  <p>GPT-5.6-Cyber ist genau dafür trainiert: Entwicklung von Exploit-Ketten, Umgehung der Authentifizierung, Rechteausweitung, Entdeckung neuer Zero-Days.</p>
  <ul>
    <li><strong>Completion Rate bei fortgeschrittenen Prompts:</strong> 95,0 %, gegenüber 57,3 % bei GPT-5.5-Cyber</li>
    <li><strong>Der Haken:</strong> kürzere, weniger detaillierte Schwachstellenberichte als beim normalen Sol und deutlich höherer Token-Verbrauch</li>
    <li><strong>Pflicht:</strong> Hardware-Sicherheitsschlüssel für Ihr Konto ab dem 1. September 2026</li>
  </ul>
</div>

<div class="dbtier-card dbt-c">
  <span class="dbtier-tag dbtier-tag-part">Partner Program</span>
  <p class="dbtier-lead">Eine ganz andere Tür, und lesen Sie das Kleingedruckte.</p>
  <p>Das Daybreak Cyber Partner Program erlaubt freigegebenen Anbietern, diese Modelle in ihre eigenen Produkte, Managed Services und Kundenprojekte einzubauen.</p>
  <ul>
    <li><strong>Wer dabei ist:</strong> Accenture, IBM, CrowdStrike, Cisco, Palo Alto Networks, Cloudflare, Sophos und andere</li>
    <li><strong>Der Haken:</strong> Der Modellzugang bleibt beim Partner und wird nicht an den Kunden weitergegeben. Sie kaufen das Ergebnis, nicht das Modell</li>
    <li><strong>Keine Garantie:</strong> OpenAI stellt klar, dass die Interessensbekundung keine Aufnahme und keinen Zugang garantiert</li>
  </ul>
</div>

<div class="dbtier-card dbt-d">
  <span class="dbtier-tag dbtier-tag-none">Keine Bewerbung</span>
  <p class="dbtier-lead">Für Sie gibt es hier noch nichts, und das ist Absicht.</p>
  <p>Beide Stufen setzen auf Identitätsprüfung, Einschränkungen auf genehmigte Nutzung und rechtliche Erklärungen, die an autorisierte Arbeit gebunden sind. Neugier ist keine autorisierte Nutzung.</p>
  <ul>
    <li><strong>Was Sie weiterhin nutzen können:</strong> das normale Sol, das 1,5 % des fortgeschrittenen Sets beantwortet und bei veröffentlichten Cyber-Benchmarks ohnehin Stand der Technik ist</li>
    <li><strong>Gut zu wissen:</strong> Sol erreicht 96,7 % bei Capture-the-Flag-Aufgaben und 73,5 % bei ExploitBench, ganz ohne Daybreak-Zugang</li>
  </ul>
</div>
Die 95 % betreffen Ablehnungen, nicht Genauigkeit
Um die Veränderung zu messen, hat OpenAI eine interne Evaluierung gebaut, die Advanced Cybersecurity Completion Rate heißt. Sie erfasst, wie oft ein Modell auf Anfragen zu Exploit-Ketten-Entwicklung, Umgehung der Authentifizierung, Rechteausweitung und ähnlichen fortgeschrittenen Szenarien antwortet.
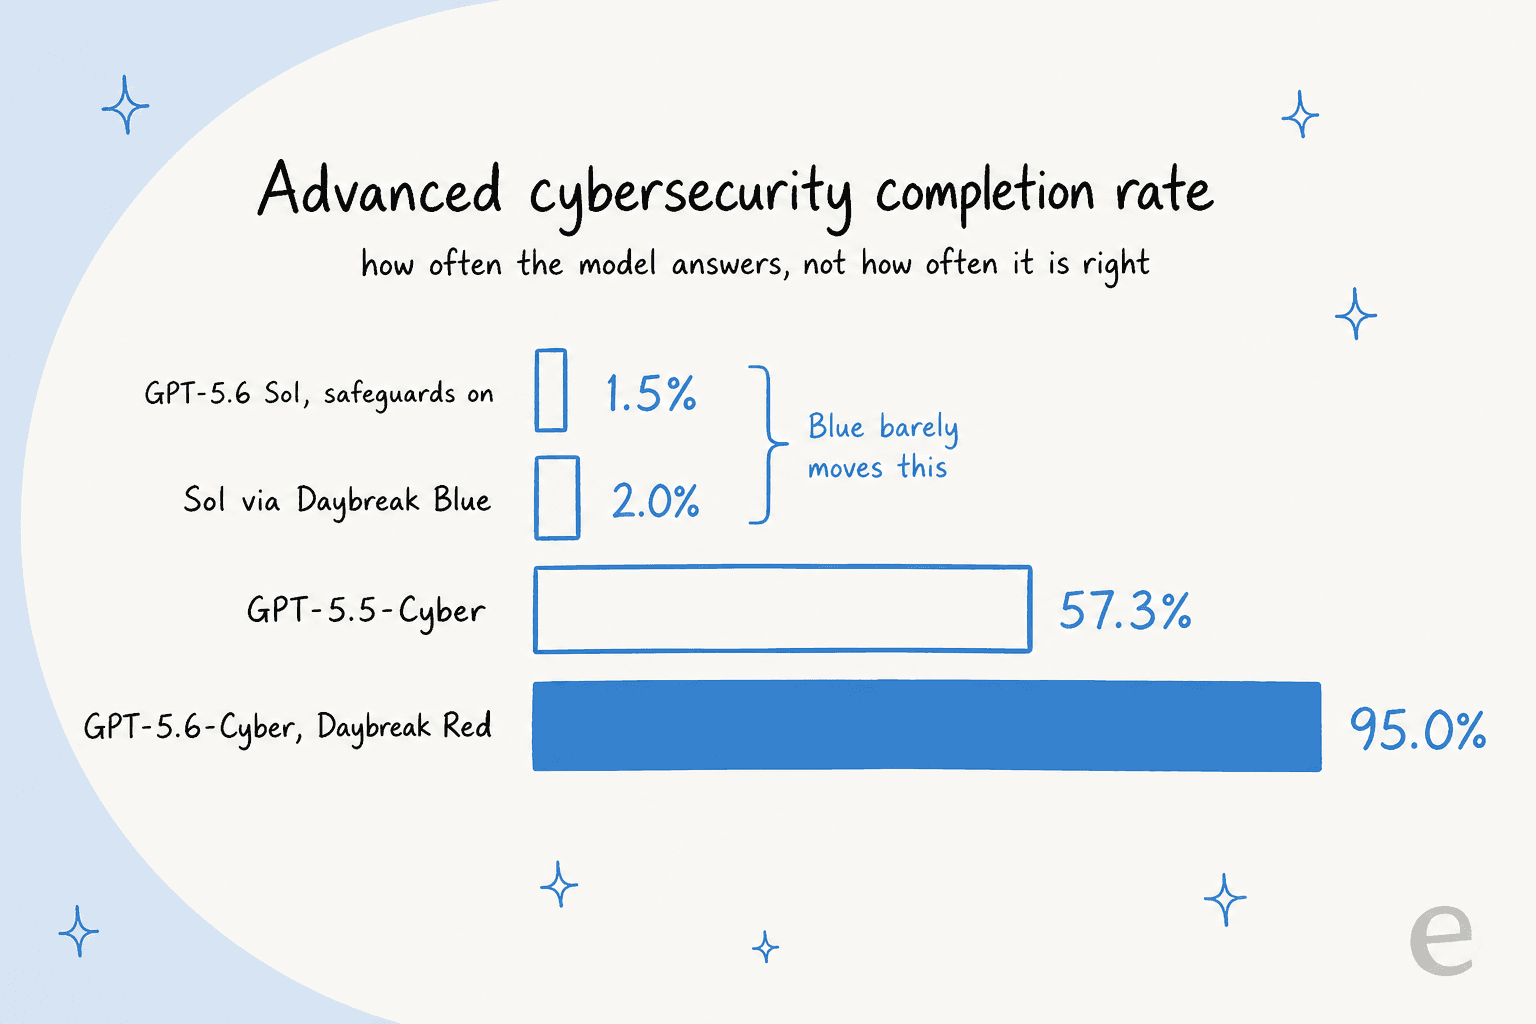
Zwei Dinge in diesem Diagramm verdienen mehr Aufmerksamkeit als die 95 %.
Das erste ist die Lücke, die kaum existiert. Sol mit aktiven Schutzmechanismen liegt bei 1,5 %. Sol über Daybreak Blue liegt bei 2,0 %. Das Aufheben der Schutzmechanismen auf Systemebene verschiebt diese Zahl um einen halben Prozentpunkt. Das ist kein Versagen von Blue, sondern eine Aussage darüber, was die Evaluierung enthält: Es sind die Prompts, bei denen das Modell selbst ablehnt, nicht bei denen eine Prüfschicht eingreift. Wenn Sie gehofft haben, Blue würde Exploit-Ketten-Arbeit freischalten, tut es das nicht, und OpenAI sagt das offen.
Das zweite ist GPT-5.5-Cyber mit 57,3 %. Das Vorgängermodell für Cyber existierte bereits und lehnte Forschende schon in etwa zwei von fünf Fällen ab. OpenAI beschreibt den Sprung ausdrücklich als „addressing feedback from security researchers who encountered persistent refusals with the earlier model.“ Der Pitch lautet also weniger „neue Fähigkeit“ als „wir streiten endlich nicht mehr mit Ihnen“.
Was die Zahl nicht misst, ist Korrektheit. Ein Modell, das eine schlechte Exploit-Frage in 95 % der Fälle selbstbewusst beantwortet, erreicht 95 %. Halten Sie das im Kopf getrennt von den Benchmark-Werten, die tatsächlich messen, ob die Arbeit etwas taugt.
Es ist dieselbe Sorgfalt, die man bei jeder Evaluierung eines Anbieters braucht. Denselben Punkt haben wir im Vergleich von GPT-5.6 mit Claude gemacht: Die Zahl ist weniger wichtig als das, was sie zählt. Wenn Sie das an Ihren eigenen Workloads strukturiert prüfen wollen, sind OpenAIs Agent-Evals der ehrliche Ausgangspunkt.
Wo GPT-5.6-Cyber schlechter ist als das normale Sol
Das ist der Abschnitt, den ich mir wünschen würde, wenn ich entscheiden müsste, ob ich drei Wochen in eine Bewerbung stecke.
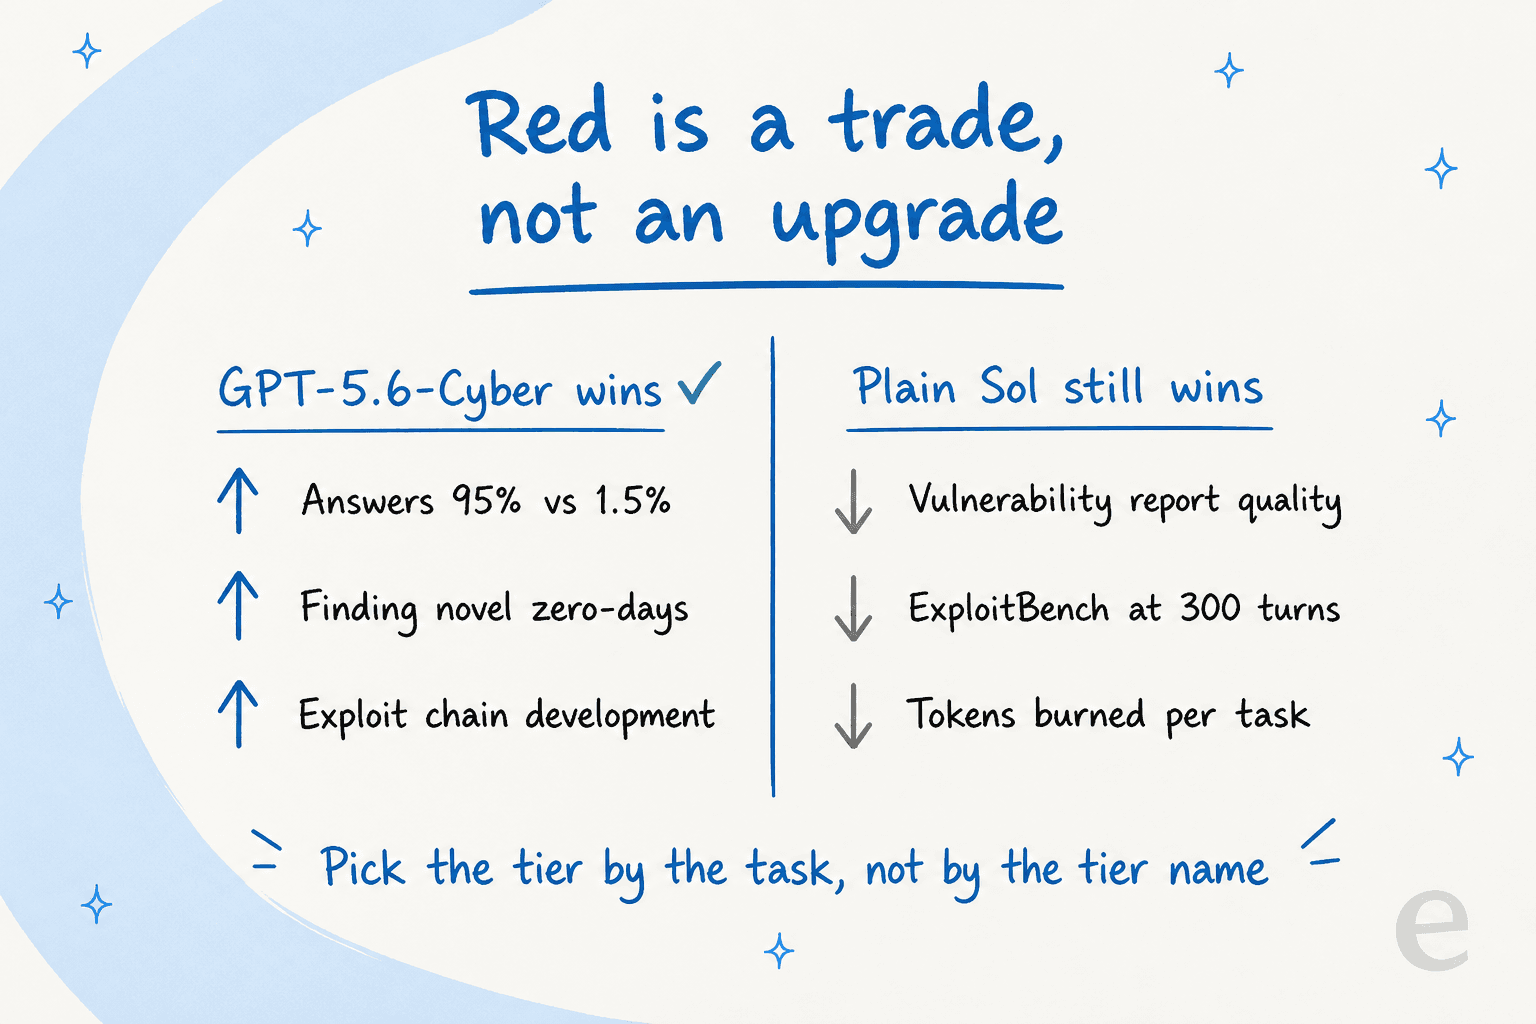
OpenAI hat GPT-5.6-Cyber gegen eine interne Evaluierung zu Schwachstellenentdeckung und Berichtsschreiben laufen lassen, die einen Agenten daran misst, schwere und umsetzbare Schwachstellen zu finden, einen funktionierenden Proof of Concept zu bauen und einen hochwertigen Bericht einzureichen. Beide neuen Modelle schlagen GPT-5.5-Cyber. Aber GPT-5.6-Cyber schneidet dabei schlechter ab als GPT-5.6 Sol, und OpenAIs erklärter Grund ist, dass das spezialisierte Modell „sometimes produc[es] shorter, less detailed vulnerability reports.“
Dasselbe Muster zeigt sich bei ExploitBench, das eine V8-Schwachstelle mit aktiven Schutzmaßnahmen zu einem vollständigen Exploit ausbaut. In der Standardeinstellung mit maximal 300 Durchgängen „solves tasks more token-efficiently and performs best“, nämlich Sol über Daybreak Blue. Bei 600 Durchgängen verkleinert sich der Abstand, aber die Standardeinstellung ist die, die die meisten Teams tatsächlich nutzen werden.
Darunter liegt auch eine Kostendimension. OpenAI vermerkt in einer Fußnote, dass GPT-5.6-Cyber „tends to be more extensive and comprehensive than GPT-5.6 Sol in its reasoning budget, leading to higher token usage.“ Selbst bei identischem Preis würde dieselbe Aufgabe mit Cyber mehr kosten.
Die ehrliche Einordnung ist also ein Kompromiss. Sie kaufen Engagement bei Prompts, die Sol ablehnt, und die Entdeckung neuer Zero-Days, und bezahlen dafür mit Berichtsqualität, Durchgangs-Effizienz und Tokens. Für ein Red Team, das ständig auf Ablehnungen stößt, lohnt sich das offensichtlich. Für ein Blue Team, das vor allem gute Berichte braucht, ist es ein Downgrade im Upgrade-Kostüm.
Wer unseren Sol-Test gelesen hat, kennt das. Das Flaggschiff ist beim allgemeinen Reasoning sehr schwer zu schlagen, und spezialisierte Varianten gewinnen eher knapp als breit. Das galt auch für GPT-5.3 Codex gegenüber den allgemeinen Modellen.
Was es tatsächlich gefunden hat
Über Benchmarks lässt sich streiten. Über Bugs in ausgelieferter Software nicht.
OpenAI hat GPT-5.6-Cyber eingesetzt, um V8 zu untersuchen, die JavaScript-Engine hinter Chrome, und zwei bisher unbekannte Schwachstellen gefunden, die sich verketten lassen, um Speicher zu korrumpieren und die V8-Heap-Sandbox zu verlassen. Forschende haben die Funde validiert und per koordinierter Offenlegung an Google gemeldet. Google hat eine davon behoben und ihr die Kennung CVE-2026-15903 zugewiesen.
Der Mechanismus ist konkret genug, um ihn zu benennen. Der optimierende Compiler von V8 übersprang beim Umwandeln von Werten in Ganzzahlen eine Sicherheitsprüfung, sodass ein undefined-Wert eine unerwartet große Zahl erzeugen konnte. Als Array-Index verwendet, lässt diese Zahl den Compiler annehmen, sie liege innerhalb der Array-Grenzen, und die übliche Prüfung weglassen, was das Lesen oder Überschreiben von Speicher anderer Objekte ermöglicht. Für das Verlassen der Heap-Sandbox braucht es von dort aus eine zweite Schwachstelle, und auch die hat das Modell gefunden.
Über V8 hinaus berichtet OpenAI von mindestens fünf Schwachstellen in einem nicht genannten, verbreiteten mobilen Betriebssystem, darunter eine Kette von einer nicht vertrauenswürdigen App bis zur lokalen Rechteausweitung, drei kritische Schwachstellen in einer verbreiteten Datenbank mit einem Remote-Pfad zur Codeausführung und über 400 Schwachstellen zur Rechteausweitung in einem verbreiteten Betriebssystemkernel.
Die letzte Zahl ist die, bei der man innehalten sollte. Vierhundert Funde sind kein Forschungsergebnis, sondern ein Triage-Rückstau, und genau der Engpass, den Daybreak laut OpenAI lösen soll. Anthropic drängt von der anderen Seite in dieselbe Richtung, was wir in Claude Code Security und beim Vergleich der OpenAI- und Anthropic-APIs behandelt haben.
Ein früher, vertrauenswürdiger Kunde hat sich öffentlich geäußert:
"[GPT-5.6 Cyber] is materially improving our specialist vulnerability-research workflows: it reasons more accurately about real exploit constraints, tracks complex state better, and has completed work in under a day that earlier models had not resolved after weeks of intermittent effort."
Jared Atkinson, CTO, SpecterOps
Das sollte man genau lesen. Die Aussage bezieht sich auf spezialisierte Workflows der Schwachstellenforschung, und sie stammt von einer Firma, die hauptberuflich offensive Sicherheit betreibt. Es ist keine Aussage, dass Cyber das bessere Modell für allgemeine Verteidigungsarbeit ist, was zu allem oben Gesagten passt.
Warum dieses Modell erschien und Astra nicht
Drei Tage vor diesem Start hat OpenAI Astra verschoben, ein kommendes Modell, nachdem es in Sicherheitstests kritische Hacking-Fähigkeiten erreicht hatte. Dann hat es ein Modell veröffentlicht, das ausdrücklich bei Cyber-Themen permissiver sein soll. Das wirkt widersprüchlich, bis man sich die Schwellen ansieht.
OpenAIs Preparedness Framework definiert für eine beobachtete Fähigkeit genau zwei Stufen: High und Critical. Sie sind keine Punkte auf einer gleitenden Skala, sondern Auslöser für Verpflichtungen. High heißt, das Modell darf erscheinen, aber nur mit Schutzmaßnahmen, die „sufficiently minimize the associated risk of severe harm before they are deployed.“ Critical heißt, die Entwicklung selbst pausiert, bis Schutzmaßnahmen nach Critical-Standard existieren.
Wichtig zu wissen: Es gibt keine Stufe Low oder Medium, auf die man ausweichen könnte. Ein Modell liegt entweder unter der Schwelle, bei High oder wird angehalten. Konkurrierende Labore ziehen die Linie anders, weshalb unser Vergleich GPT-5.6 gegen Gemini 3 am Ende ebenso von Einsatzrichtlinien wie von Werten handelt.
Für Cybersicherheit ist die Critical-Schwelle ein Modell, das „identify and develop functional zero-day exploits of all severity levels in many hardened real-world critical systems without human intervention“ kann, oder das aus einem übergeordneten Ziel allein durchgängige Angriffsstrategien gegen gehärtete Ziele entwirft und ausführt.
GPT-5.6-Cyber erreichte High und nicht Critical, dieselbe Einstufung wie Sol. OpenAIs Formulierung lautet, das Modell „improved over GPT-5.6 Sol on some specialized cyber tasks that we directly trained for, but not sufficiently to reach our Critical threshold.“ Astra hat die Linie überschritten. Cyber nicht. Das ist der ganze Unterschied.
OpenAI stellt außerdem klar, dass GPT-5.6-Cyber nicht in den Hugging-Face-Vorfall verwickelt war, was angesichts des Zeitpunkts erwähnenswert ist.
Was Verteidiger schon vorher gesagt haben
Das Modell ist einen Tag alt, es gibt also noch kein echtes Urteil. Aber die Beschwerde, auf die es antwortet, ist seit Monaten laut, und sie zu lesen erklärt den Start besser als die Benchmark-Tabelle.
Die Klage lautet nicht, dass die Modelle unfähig seien. Sondern dass sie den Bug finden und dann nicht darüber sprechen wollen:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic. Just a few days back, I was reviewing some small bit of legacy DSA signature verification code, to get a sense of how safe it is to reuse - purely defensive, precautionary work and the context of it was there. But I simply wasn't able to use Codex Security: it threw refusal tantrums on every step of the way."

Das ist ein defensives Code-Review von Legacy-Signaturprüfung, blockiert. Im selben Thread räumte ein OpenAI-nahes Konto den Punkt ein und verwies auf Trusted Access als Abhilfe, genau den Mechanismus, den dieser Start ausbaut.
Der Widerspruch ist ebenso beständig und keine Randmeinung. Im Thread über die Prüfung von GPT-5.6 durch die US-Regierung war die am höchsten bewertete Lesart deutlich:
"This is regulatory capture in action. This will make it hard/impossible for new vendors to come into the market and only established companies will get to play, and charge, for LLMs. What does this mean for open source? Will it become illegal to download weights?"
Beides stimmt gleichzeitig. Verteidiger wurden bei legitimer Arbeit tatsächlich blockiert, und die Lösung konzentriert die stärksten Cyber-Fähigkeiten tatsächlich in den Händen derer, die ein Prüfverfahren bestehen. Wer Open-Weight-Alternativen erwägt, tut das teils aus diesem Grund.
Zugang erhalten, Schritt für Schritt
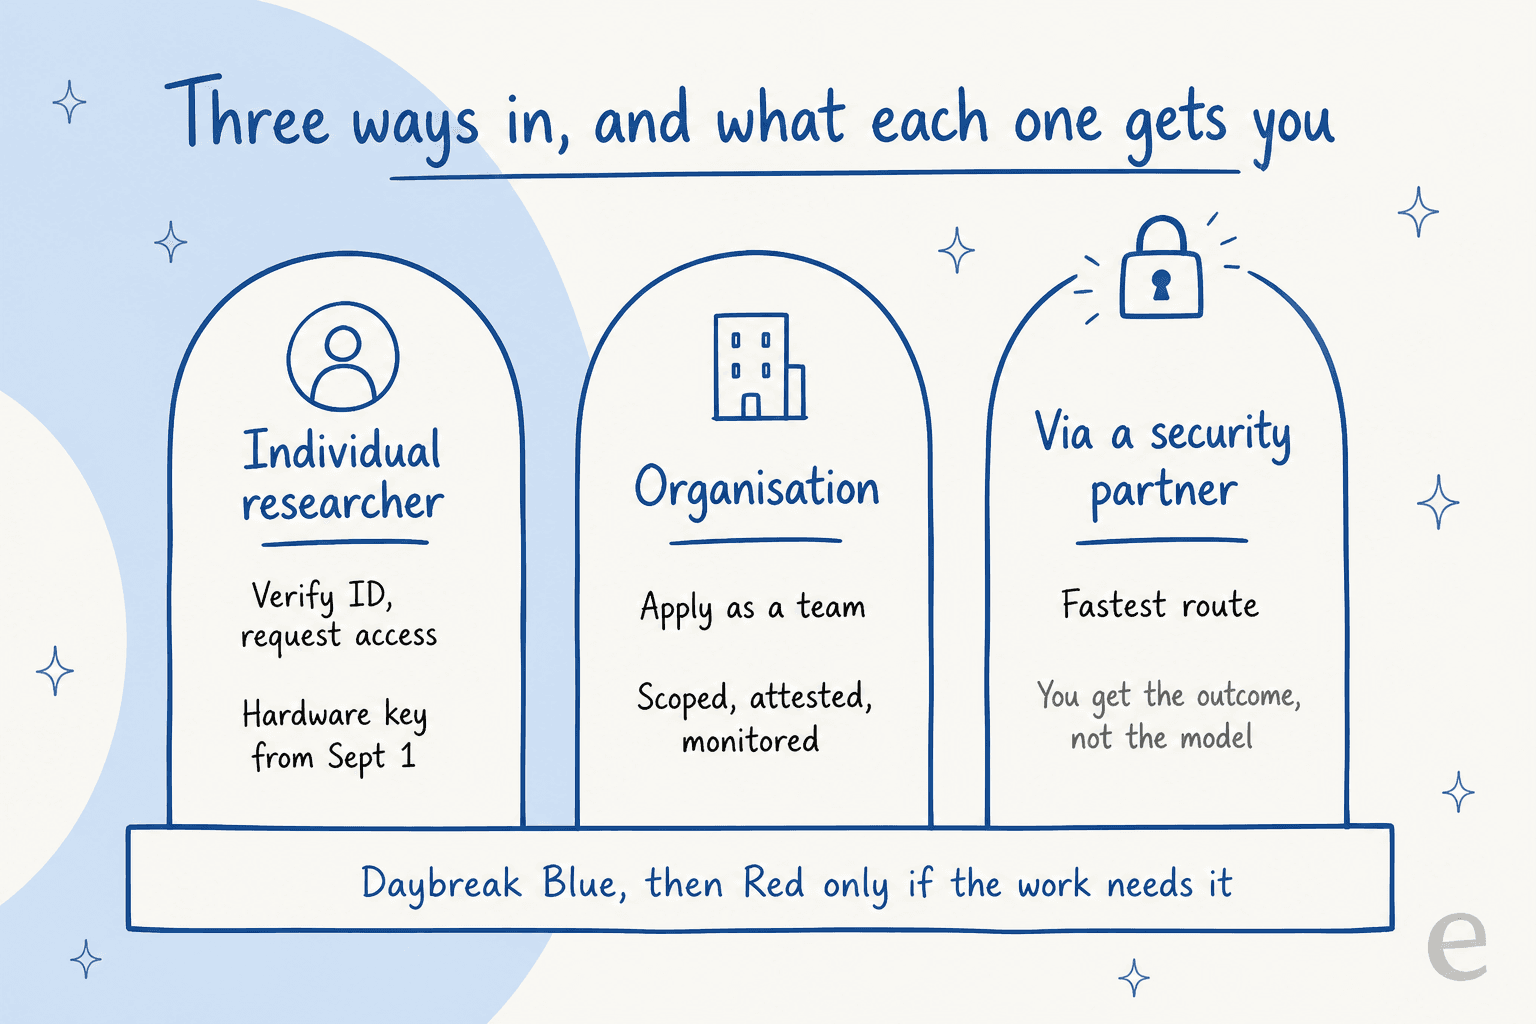
Es gibt drei Türen, und sie führen an unterschiedliche Orte.
Einzelpersonen verifizieren ihre Identität und beantragen vertrauenswürdigen Zugang über die Cyber-Seite von ChatGPT. Organisationen bewerben sich für ihre Teams über OpenAIs Enterprise-Zugangsformular. Sicherheitsanbieter und Beratungen treten dem Daybreak Cyber Partner Program bei, zu dem derzeit Accenture, IBM, CrowdStrike, Palo Alto Networks, Cisco, Cloudflare, Sophos, Fortinet, Akamai und einige Beratungen gehören.
Welche Tür Sie auch wählen, OpenAI steuert den Zugang über Identitätsprüfung, Kontosicherheit, Überwachung, Einschränkungen auf genehmigte Nutzung und rechtliche Erklärungen. Zwei operative Details erwischen Teams, die darüber hinweglesen:
- Hardware-Sicherheitsschlüssel werden Pflicht für alle individuellen Daybreak-Konten ab dem 1. September 2026. Wenn Sie heute TOTP nutzen, ist das eine Beschaffungsaufgabe mit Frist. OpenAI hat mit Yubico bevorzugte Preise für Konten vereinbart, die Schlüssel brauchen.
- Der Partnerweg gibt Ihnen das Modell nicht in die Hand. OpenAI sagt ausdrücklich: „access to the underlying models remains with the approved partner and is not transferred directly to the customer.“ Über CrowdStrike erhalten Sie das Arbeitsergebnis, keinen API-Schlüssel.
Darüber hinaus drängt OpenAI Daybreak-Kunden, die Codex nutzen, vom Vollzugriffsmodus weg zum Auto-Review-Modus, der Aktionen mit erhöhten Rechten vor der Ausführung prüft. Die eigenen empfohlenen Vorgehensweisen sind wiederholenswert, weil Teams sie gern überspringen: den Workflow per Sandbox von Produktivsystemen und dem offenen Internet isolieren, jede Agentenaktion überwachen und den autorisierten Umfang mit Berechtigungsprofilen explizit definieren.
Wenn Ihre Organisation bereits ChatGPT Enterprise betreibt, überträgt sich davon nichts automatisch. Daybreak ist eine separate Freigabe on top, kein Bestandteil der Lizenz. Dasselbe gilt, wenn Sie OpenAI-Modelle über Azure statt direkt nutzen.
Was OpenAI noch nicht veröffentlicht hat
Zwei Lücken sind beobachtenswert, und beide sind von der Art, die leise mehr zählt als die Benchmarks am Starttag.
Es gibt keine System Card. OpenAI sagt, es „will publish a system card with further evaluations of GPT-5.6-Cyber at a later date.“ Bis die erscheint, sind die einzigen verfügbaren Evaluierungszahlen die, die OpenAI in die Ankündigung gestellt hat.
Es gibt keinen Preis. Das ist interessanter, als es aussieht. OpenAIs öffentliche API-Preisliste hat einen Abschnitt „Specialized models“, und dieser enthält eine Cyber-Zeile. Das aufgeführte Modell ist gpt-5.4-cyber, zwei Generationen alt, und seine Spalten für Eingabe, zwischengespeicherte Eingabe und Ausgabe sind alle buchstäblich Striche. Der fehlende Preis ist also keine Seite, die dem gestrigen Start noch nicht gefolgt ist. OpenAI führt seit Generationen eine Cyber-Zeile in der Preisliste und hat nie eine Zahl eingetragen. Dem sind wir in unserer GPT-5.6-Cyber-Preisanalyse ordentlich nachgegangen.
Zum Vergleich: Der Rest der Familie hat normale Preise, pro Million Tokens in der Standardstufe:
| Modell | Eingabe | Ausgabe |
|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 |
gpt-5.6-terra | $2.00 | $12.00 |
gpt-5.6-luna | $0.20 | $1.20 |
gpt-5.4-cyber | nicht veröffentlicht | nicht veröffentlicht |
Beachten Sie, dass Terra und Luna am 30. Juli 2026 um 20 % beziehungsweise 80 % gesunken sind. Viele Berichte nennen noch die Startpreise von 2,50 $/15 $ und 1 $/6 $, die inzwischen falsch sind. Unser GPT-5.6-Preisleitfaden enthält die aktuellen Zahlen, einschließlich der neueren Aufteilung in kurzen und langen Kontext, und die Sol-Preisanalyse nimmt das Flaggschiff gesondert unter die Lupe.
Wenn die Zugangsschranke ein Ausschlusskriterium ist und Sie jetzt leistungsfähige Sicherheitswerkzeuge brauchen, ist das eine andere Frage mit einer echten Antwort. Wir haben sie in GPT-5.6-Cyber-Alternativen durchgearbeitet, und die Auswahl ist nicht das, was die meisten erwarten.
Was das bedeutet, wenn Sie kein Sicherheitsteam sind
Die meisten, die einen Beitrag über GPT-5.6-Cyber lesen, werden sich nie für Daybreak bewerben. Die übertragbare Lehre ist trotzdem wertvoll, denn es ist dieselbe, die wir bei eesel immer wieder neu lernen.
Das Schwierige beim Ausliefern eines leistungsfähigen Modells war nie die Fähigkeit. Es ist die Kontrollfläche darum herum. Sehen Sie sich an, was OpenAI hier tatsächlich gebaut hat: nicht ein freigeschaltetes Modell, sondern ein Stufensystem, eine Identitätsprüfung, eine Umfangsdefinition, einen Auto-Review-Modus, eine Überwachungsschicht und eine Pflicht für Hardware-Schlüssel. Das Modell war der einfache Teil.
Das ist derselbe Grund, warum der Unterschied zwischen KI-Agent und Chatbot wichtiger ist als die Modellwahl, und warum KI gegen menschlichen Support selten durch Benchmark-Werte entschieden wird.
Ich kenne diese Konstellation von der anderen Seite des Tisches. In drei Jahren, in denen ich KI-Agenten auf produktive Support-Warteschlangen gebracht habe, habe ich gesehen, wie Deal um Deal an der Prüfung hing statt an der Demo. Ein dänischer Telematik-Käufer ließ kein einziges Ticket durch, bis er überzeugt war, dass Daten mit Kartennummern und Passwörtern in seiner Umgebung blieben. Ein Brüsseler Support-Team mit 400 bis 500 Tickets im Monat kam nie über seine interne ISO-Prüfung hinaus. In keinem dieser Gespräche hat jemand gefragt, ob die KI klug genug ist.
Deshalb haben wir eesel so gebaut, wie wir es gebaut haben. Bevor ein KI-Agent auch nur einen echten Kunden beantwortet, können Sie ihn über Tausende Ihrer eigenen historischen Tickets simulieren und genau sehen, was er gesagt hätte, und ihn dann auf die Tickettypen eingrenzen, denen Sie vertrauen. Es ist derselbe Instinkt wie Daybreaks Sandbox-und-Umfang-Empfehlung, nur auf eine Support-Warteschlange gerichtet statt auf einen V8-Heap.
Die Parallelen gehen weiter. Eingegrenzte Berechtigungen sind unsere Sicht auf Chatbot-Compliance, das Protokollieren jeder Aktion macht Sicherheitsprüfungen von Helpdesks überstehbar, und die strengste Version von alldem zeigt sich bei HIPAA-konformer KI. Bei nichts davon geht es um das Modell.
eesel ausprobieren
Wenn Sie ein Support-Team leiten und kein Red Team, zählt die Modellstufe weniger als das, was darum herum sitzt. eesel fügt sich in Ihren bestehenden Helpdesk ein, lernt aus Ihren früheren Tickets und Ihrem Help Center und lässt Sie das Ganze an historischen Gesprächen durchspielen, bevor es in die Nähe eines Kunden kommt.
Sie wählen, welche Tickettypen es bearbeitet, und eskalieren den Rest, also gibt es keinen Moment, in dem man einen Schalter umlegt. Jede Tool-Aktion des Agenten wird protokolliert, und sensible lassen sich hinter eine menschliche Freigabe stellen, die Support-Desk-Version des Auto-Review-Modus. Die Einrichtung dauert Minuten statt eines Prüfzyklus, und das Ausprobieren ist kostenlos.
