Was ist der Unterschied zwischen Deflection Rate und Lösungsrate?
Ich bin Riell und arbeite jeden Tag in der Support-Queue von eesel. Die Frage hinter diesem Beitrag klingt meist so: "Unser KI-Bot meldet eine hohe Deflection Rate, warum ist mein Team trotzdem überlastet?" Die kurze Antwort: Das Dashboard berichtet Deflection, und das Team lebt mit der Lösung.
Hier sind die beiden Kennzahlen nebeneinander, in der einfachen Variante, wie die meisten Helpdesks sie berechnen.
| Deflection Rate | Lösungsrate | |
|---|---|---|
| Welche Frage sie beantwortet | Endete das Gespräch ohne Mensch? | Wurde das Problem des Kunden gelöst? |
| Übliche Formel | Gespräche ohne Übergabe ÷ alle KI-Gespräche | Bestätigt gelöst ÷ alle KI-Gespräche |
| Was entscheidet | Fehlende Eskalation oder menschliche Antwort | Ein "Ja" des Kunden, eine Modellprüfung oder kein erneuter Kontakt |
| Was sie verbirgt | Kunden, die aufgaben, später zurückkamen oder ein "Ich weiß es nicht" bekamen | Wenig, wenn der Bestätigungsschritt echt ist |
| Auch genannt | Containment, Self-Service-Rate, Automatisierungsrate | Automatisierte Lösung (AR), verifizierte Lösung |
| Wer danach abrechnet | Selten | Zendesk, Help Scout, Front, Gorgias, HubSpot, Agentforce |
Eine Deflection Rate ist eine gute operative Zahl. Sie zeigt, wie viel der Queue die KI auffängt, bevor ein Mensch hinschauen muss. Was sie nicht sagen kann: ob der Kunde mit einer Hilfe gegangen ist. Eine Lösungsrate beantwortet das, solange jemand oder etwas nachprüft.
Der Begriff "Containment" sorgt für die meiste Verwirrung. Die Dokumentation von Ada bringt es gut auf den Punkt: Die Containment Rate zeigt, welche Gespräche ohne Übergabe endeten, fragt aber, ob man einen Kunden, der ging "because they were satisfied, as opposed to one who got frustrated and gave up", davon unterscheiden kann (Ada docs). In einem Deflection-Dashboard sehen diese beiden Kunden identisch aus.
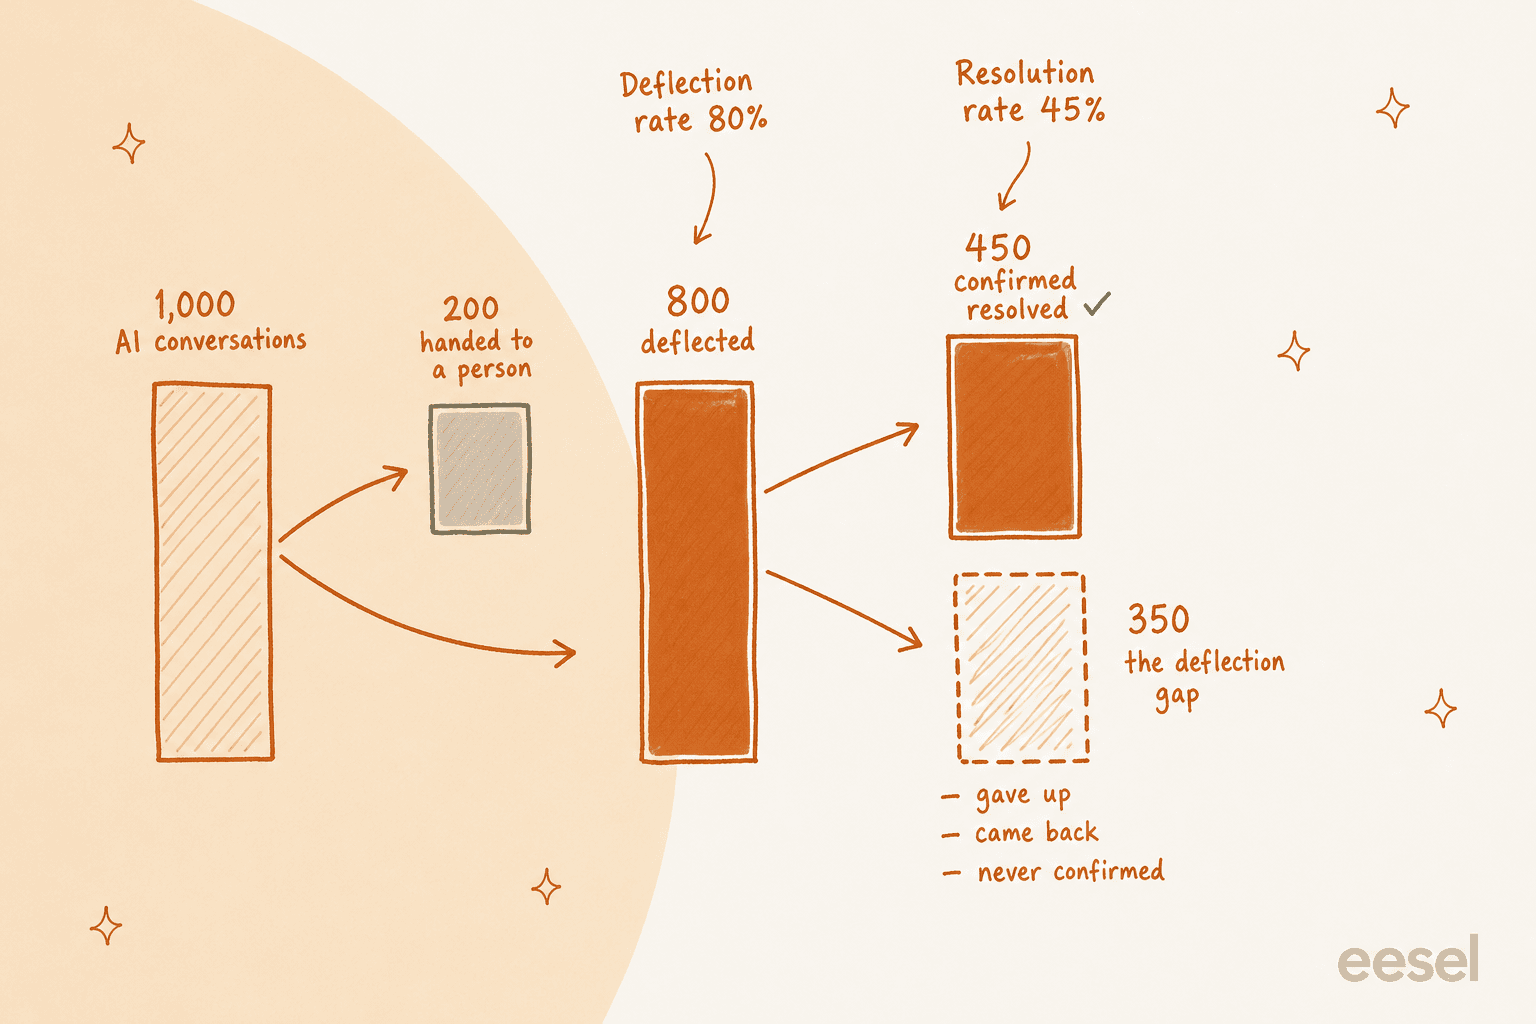
Diese Lücke von 35 Punkten ist die Zahl, die niemand auf die QBR-Folie schreibt. Im Beispiel oben sind es 350 Kunden, und manche davon stecken schon unter neuer Ticketnummer in Ihrer menschlichen Queue.
Berechnen Sie Ihre eigene Deflection-Lücke
Der Rechner unten nimmt fünf Zahlen aus einem Monat Helpdesk-Daten und teilt Ihre KI-Gespräche in vier Gruppen: bestätigt gelöst, still und unbestätigt, zurückgekommen und an einen Menschen übergeben. Dann zeigt er die Deflection-Lücke in Punkten und in Gesprächen und rechnet beide Raten in Personalstunden um.
Tragen Sie die Zahlen des letzten Monats ein. Die Vorgabewerte entsprechen dem Beispiel von oben mit 80 % vs. 45 %. Nichts, was Sie eingeben, verlässt Ihren Browser.
Wo Sie jede Zahl finden:
- KI-Gespräche: jedes Gespräch, auf das der KI-Agent geantwortet hat. In Zendesk ist das "Total conversations" im Overview-Bericht des KI-Agenten; in Freshdesk "Total" im Performance-Tab von AI Agent Studio.
- Ohne Übergabe beendet: die Deflection- oder Containment-Zahl Ihres Anbieters. Haben Sie nur eine Eskalationsrate, nehmen Sie die Gesamtzahl minus Eskalationen.
- Bestätigt gelöst: Gespräche, in denen der Kunde "Ja, das hat geholfen" geklickt hat oder in denen Sie geprüft haben, dass kein erneuter Kontakt kam. Die Lösungszahl eines Anbieters ist ein Ausgangspunkt, nicht diese Zahl, aus Gründen, die der nächste Abschnitt behandelt.
- Innerhalb von 72 Stunden zurückgekommen: derselbe Kunde eröffnet auf einem beliebigen Kanal ein neues Ticket. Die meisten Teams müssen das selbst abgleichen, per E-Mail-Adresse oder Kunden-ID.
- Menschliche Minuten pro Ticket: Ihre durchschnittliche Bearbeitungszeit für dieselbe Art Ticket, wenn ein Mensch es bearbeitet.
Liegt die Lücke über 10 Punkten, würde ich aufhören, Deflection nach oben zu berichten, bis Sie eine Stichprobe geprüft haben. Das ist das Problem von KI- vs. menschlicher Deflection in anderem Mantel: Die Zahl sieht nach Fortschritt aus, und die Arbeit, die sie angeblich beseitigt, liegt noch auf jemandes Schreibtisch.
Warum deflected Gespräche nicht immer gelöst sind
Es gibt drei Wege, wie ein Gespräch als deflected zählt, ohne gelöst zu sein. Jeder zeigt sich in echten Queues, und jeder braucht eine andere Lösung.
Der Kunde hat aufgegeben. Die KI antwortete, die Antwort half nicht, und der Kunde schloss den Tab. Es gab keine Eskalation, also zählt das Gespräch als deflected. Ist das Fenster des Anbieters kurz (das Messaging-Fenster von Zendesk beträgt standardmäßig 2 hours, laut Artikel zu den Lösungsstufen), blieb dem Kunden ohnehin wenig Zeit zu widersprechen.
"Silence alone is a dangerous proxy for resolution. It's useful operationally, but it's not an experience signal. A bot answer + 72 hours of no follow-up mostly tells you the customer gave up or moved on, not that the problem was fixed."

Der Kunde kam woanders zurück. Ein Chat endet leise, und 20 Minuten später schreibt dieselbe Person eine E-Mail. In den Zendesk-Dokumenten steht, automatisierte Lösungen "are counted per conversation rather than per user", und Besuche über "multiple channels, browsers, or devices will be considered separate interactions" (Zendesk help center). Der Chat kann also gelöst bleiben, während die E-Mail ein neues menschliches Ticket wird. Deshalb sind wiederholte Tickets die nützlichste Leitplanke, die Sie einbauen können.
Die Antwort wurde nie bestätigt. Eine KI, die antwortet "Ich bin nicht sicher, hier ist unser Hilfecenter", hat in keinem nützlichen Sinn etwas deflected, aber die meisten Regeln zählen es trotzdem. Ein CX-Leiter mit rund 7.000 Tickets im Monat sagte es uns in einem Verkaufsgespräch unverblümt:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
CX lead at a company handling about 7,000 tickets a month, on a sales call with eesel
Das Anreizproblem unter allen dreien ist alt. Lange vor KI-Agenten haben Support-Organisationen Deflection über Self-Service-Seiten und Telefonmenüs berichtet, und die Logik war dieselbe.
"Within the customer service industry, they'd claim a great "deflection rate". That's a metric that all of these large companies hold around any kind of help/support channel that may involve humans because people are a cost. It's often covered by some kind of satisfaction metric based off post-issue surveys, but fundamentally, if you just go away that's success."

Wie definiert jeder Helpdesk Deflection und Lösung?
Ich habe die Hilfecenter, Abrechnungsdokumente und Preisseiten von neun Helpdesks und KI-Support-Anbietern durchgesehen. Das Muster ist klar, sobald man es nebeneinanderlegt: Die meisten zählen eine Lösung danach, was innerhalb eines Zeitfensters nicht passiert ist, einige ergänzen ein Modell, das das Transkript liest, und keiner prüft, was der Kunde nach Ablauf des Fensters tut.
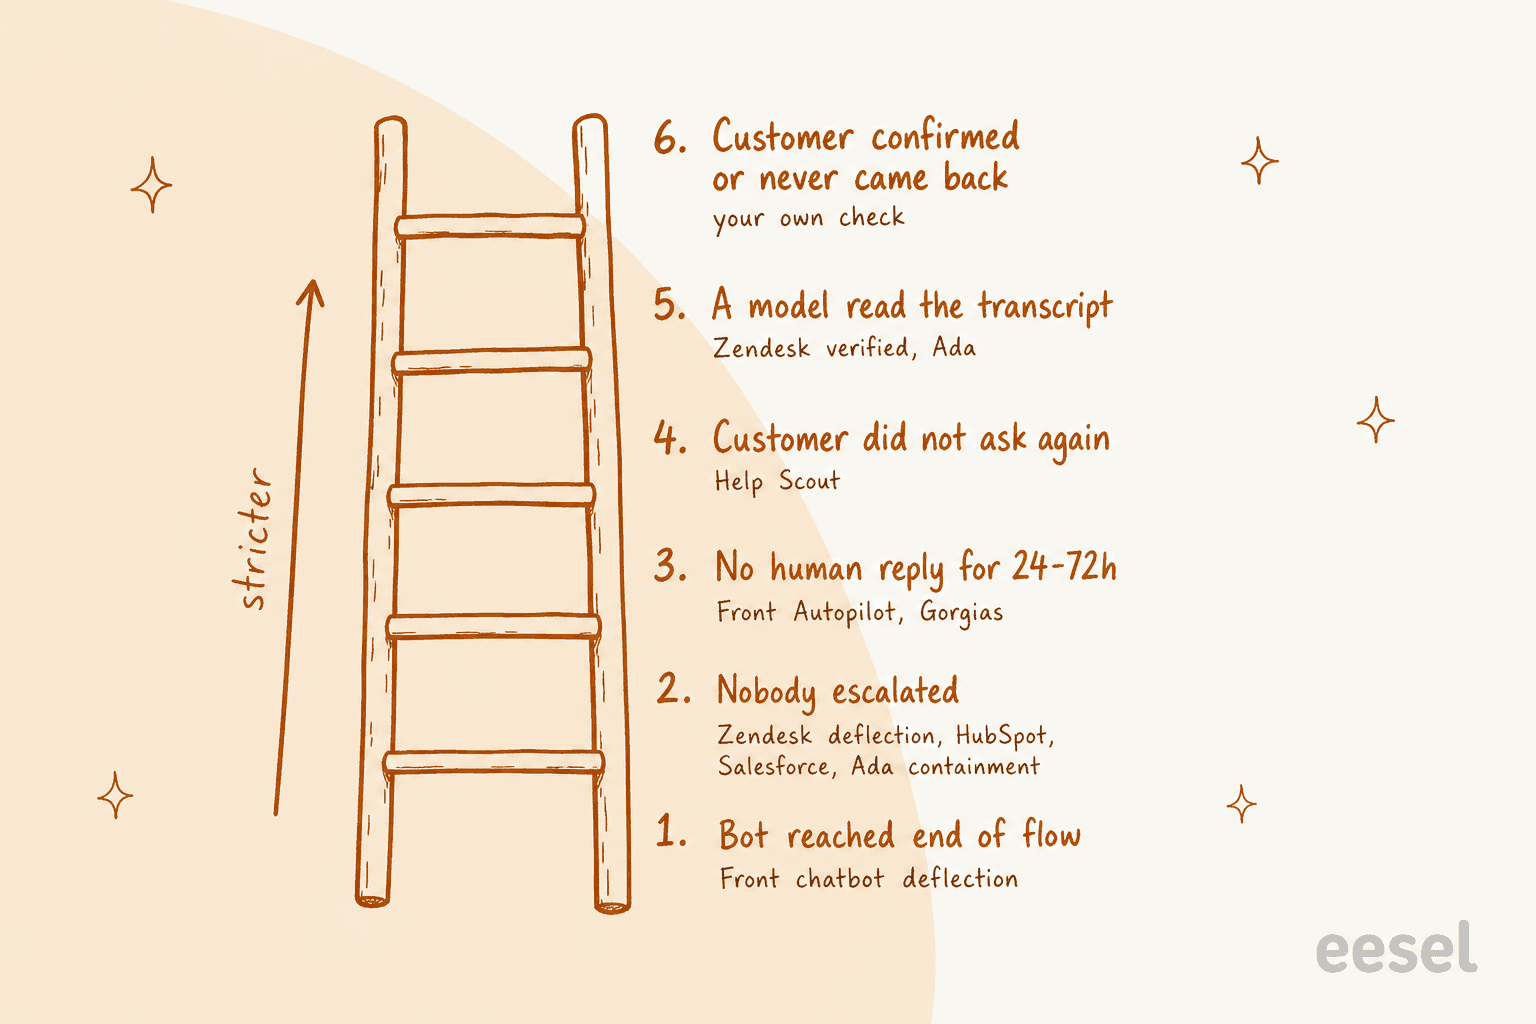
Hier die vollständige Matrix. Die Preise stammen von der jeweiligen Preisseite oder den Abrechnungsdokumenten des Anbieters, geprüft am 20. Oktober 2026.
| Anbieter | Deflection-Begriff | Was als Lösung zählt | Fenster | Wer entscheidet | Abrechnungseinheit und Preis |
|---|---|---|---|---|---|
| Zendesk | Deflected: keine Eskalation | Verifizierte Lösung: keine Rückfrage, dann bestätigt ein LLM | 2 Std. Messaging (bis 72 Std.), 72 Std. E-Mail | LLM | Pro automatisierter Lösung: 1,50 $ bei Mindestabnahme, 2,00 $ pay-as-you-go |
| Freshdesk | Deflection Rate: ohne Mensch gelöst | Ohne menschliches Eingreifen geschlossen; abgebrochen wird separat gezählt | ca. 24 Std. bis abgebrochen | Regeln | Pro Session: 49 $ pro 100, die ersten 500 inklusive |
| Gorgias | Automatisierungsrate | Automatisierte Interaktion: kein Mensch innerhalb von 72 Std. beteiligt | 72 Std. | Regeln | Pro automatisierter Interaktion: 0,85 $ bis 1,00 $ |
| HubSpot | Deflection Rate | Quelle geteilt oder Aktion ausgeführt, keine vom Besucher ausgelöste Übergabe | Gesetzt 72 Std. nach der letzten Besucherantwort | Regeln | 50 Credits pro textbasierter Lösung |
| Help Scout | Keiner | KI antwortete, Kunde bat nicht um weitere Hilfe | Pro Session | Regeln | 0,75 $ pro Lösung |
| Salesforce | Deflected Sessions: vom Nutzer beendet | Abrechenbar: 2+ Runden, kein negatives Schlussfeedback, keine Eskalation | Bis zu 2 Std. pro Chat-Lösung | Regeln, plus Modellbewertung in der Analyse | 2 $ pro Gespräch oder Flex Credits |
| Ada | Containment Rate | Relevant, korrekt, sicher und eingedämmt | Nach Ende des Gesprächs | KI-Modell | Nicht veröffentlicht |
| Kustomer | Keiner | Nur von der KI bearbeitet und jetzt geschlossen | Keines, statusbasiert | Regeln | KI-Agenten sind ein Add-on nur auf Anfrage |
| Front | Deflection Rate (ältere Chatbot-Abläufe) | Keine Nachfrage eines Teammitglieds nach der KI | 24 Std. Chat, 72 Std. E-Mail | Regeln | Pro Gespräch: Triage 0,05 $, Übergabe 0,39 $, Lösung 0,89 $ |
Die Kurzfassung pro Anbieter, mit dem jeweils entscheidenden Detail.
Zendesk: deflected und verifiziert sind absichtlich verschiedene Wörter
Zendesk ist der klarste Fall eines Anbieters, der die Grenze selbst zieht. Der Optimierungsleitfaden sagt "Any conversation that doesn't end in escalation is considered deflected" (Zendesk). Seit dem 18. Mai 2026 teilen sich die automatisierten Lösungen jedoch in drei Stufen: Assisted escalation, Contained resolution und Verified resolution. Eine Contained resolution liegt vor, wenn der Kunde nicht um Klärung bat, kein Feedback gab und keinen Menschen verlangte, ein LLM, das das Transkript liest, aber nicht bestätigen konnte, dass die Anfrage "was satisfactorily resolved". Die beiden anderen Stufen "do not count against your resolution allowance", sodass Verified die Stufe ist, die Sie bezahlen.
Das ist ein faires Design, und ich würde es das ehrlichste der Liste nennen. Die Grenzen sind die Fenster (2 Stunden bei Messaging standardmäßig, 72 Stunden bei E-Mail, jeweils ab der ersten Nachricht) und die oben beschriebene Zählung pro Gespräch. Im Explore-Datensatz ist "% Resolution rate" automatisierte Lösungen ÷ alle Gespräche, mit Abbrüchen als eigener Gruppe (Zendesk AI metrics). Wenn Sie eesel für Zendesk daneben einsetzen, führt Sie unser Leitfaden zur Zendesk-AR% Zeile für Zeile durch diese Berichte.
Freshdesk: "Deflection Rate" heißt gelöst, und bezahlt wird trotzdem pro Session
Freshdesk verwendet "Deflection Rate" für die Zahl, die die meisten Anbieter Lösung nennen: "Percentage of conversations in this topic resolved by the AI without human intervention." Abgebrochene Gespräche meldet es separat, "if there is no response for a defined period (for example, ~24 hours)" (Freshdesk). Das ist besser als bei den meisten.
Der E-Mail-Agent ist lockerer. Sein älterer Ticket Deflection Trend "typically includes" ein Ticket, das "being closed by a human agent after the customer read an answer without further interaction" (Freshdesk email AI agent). Ein Mensch hat es geschlossen, und es zählt trotzdem als deflected.
Die Abrechnung kümmert das nicht. Freddy AI Agent wird pro Session verkauft, "$49 per 100 sessions", die ersten 500 inklusive (Freshdesk pricing), egal ob die Session gelöst, eskaliert oder abgebrochen wurde. Die Aufschlüsselung der Freddy-AI-Preise und der Vergleich Breeze vs. Freddy gehen tiefer auf die Rechnung pro Session vs. pro Lösung ein.
Gorgias: Die Dashboard-Zahl ist die Rechnungszahl
Gorgias rechnet eine "automated interaction" ab, die vorliegt, "if the customer does not require the involvement of a human agent within 72 hours of the interaction" (Gorgias billing). Die Preisseite nennt 1,00 $ bei Starter, 0,90 $ bei Basic und Pro und 0,85 $ bei Advanced pro automatisierter Interaktion (Gorgias pricing). Nach aktueller Preisgestaltung kann ein Ticket, das AI Agent vollständig löst, sowohl eine Automatisierungsgebühr als auch eine Helpdesk-Ticketgebühr tragen.
Das nützliche Detail steckt im Kennzahlen-Glossar. "Coverage rate" ist der Anteil der Tickets, die AI Agent versucht hat, während "Success rate" abrechenbare KI-Interaktionen ÷ alles, was AI Agent bearbeitet hat, einschließlich Übergaben, ist (Gorgias metrics). Liest man beide zusammen, ergibt sich ein klareres Bild als aus der Automatisierungsrate in der Überschrift. Die Plan-Rechnung finden Sie unter Gorgias-AI-Agent-Preise.
HubSpot: die offenste Zeile in allen Anbieterdokumenten
Der Bericht des Customer Agent von HubSpot zeigt gelöste und deflected Gespräche nebeneinander und sagt dann klar: "Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent" (HubSpot).
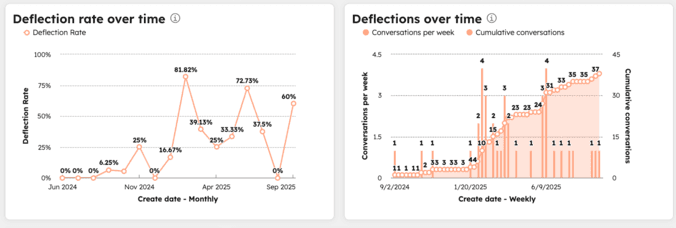
Eine Lösung setzt voraus, dass der Agent eine Inhaltsquelle geteilt oder eine Aktion ausgeführt hat, ohne "qualifying handoff", und "only visitor-initiated handoffs count." Der Status wird gesetzt "72 hours after the last visitor response", und spätere Nachrichten eines menschlichen Agenten "will not change the resolution status." Die Abrechnung folgt der Lösung: Die Credit-Preisliste von HubSpot nennt 50 Credits für "Resolve one conversation (text-based channels)" zu "$0.010 per credit" (HubSpot catalog), und eine E-Mail-Antwort nach 72 Stunden öffnet das Gespräch erneut, sodass "additional credits are consumed", wenn es erneut gelöst wird (HubSpot). Mehr unter Customer-Agent-Preise.
Help Scout: Schweigen nach einer Antwort zählt
Der KI-Agent von Help Scout heißt jetzt Scout und kostet "$0.75 per resolution each month." Eine Lösung ist "a single AI chat session that is resolved without help from a human", berechnet, wenn Scout eine Antwort gibt und "the customer doesn't ask for additional help after the last AI response" (Help Scout docs). Eine Begrüßung oder eine Folgefrage ohne vollständige Antwort wird nicht berechnet, was eine faire Regel ist.
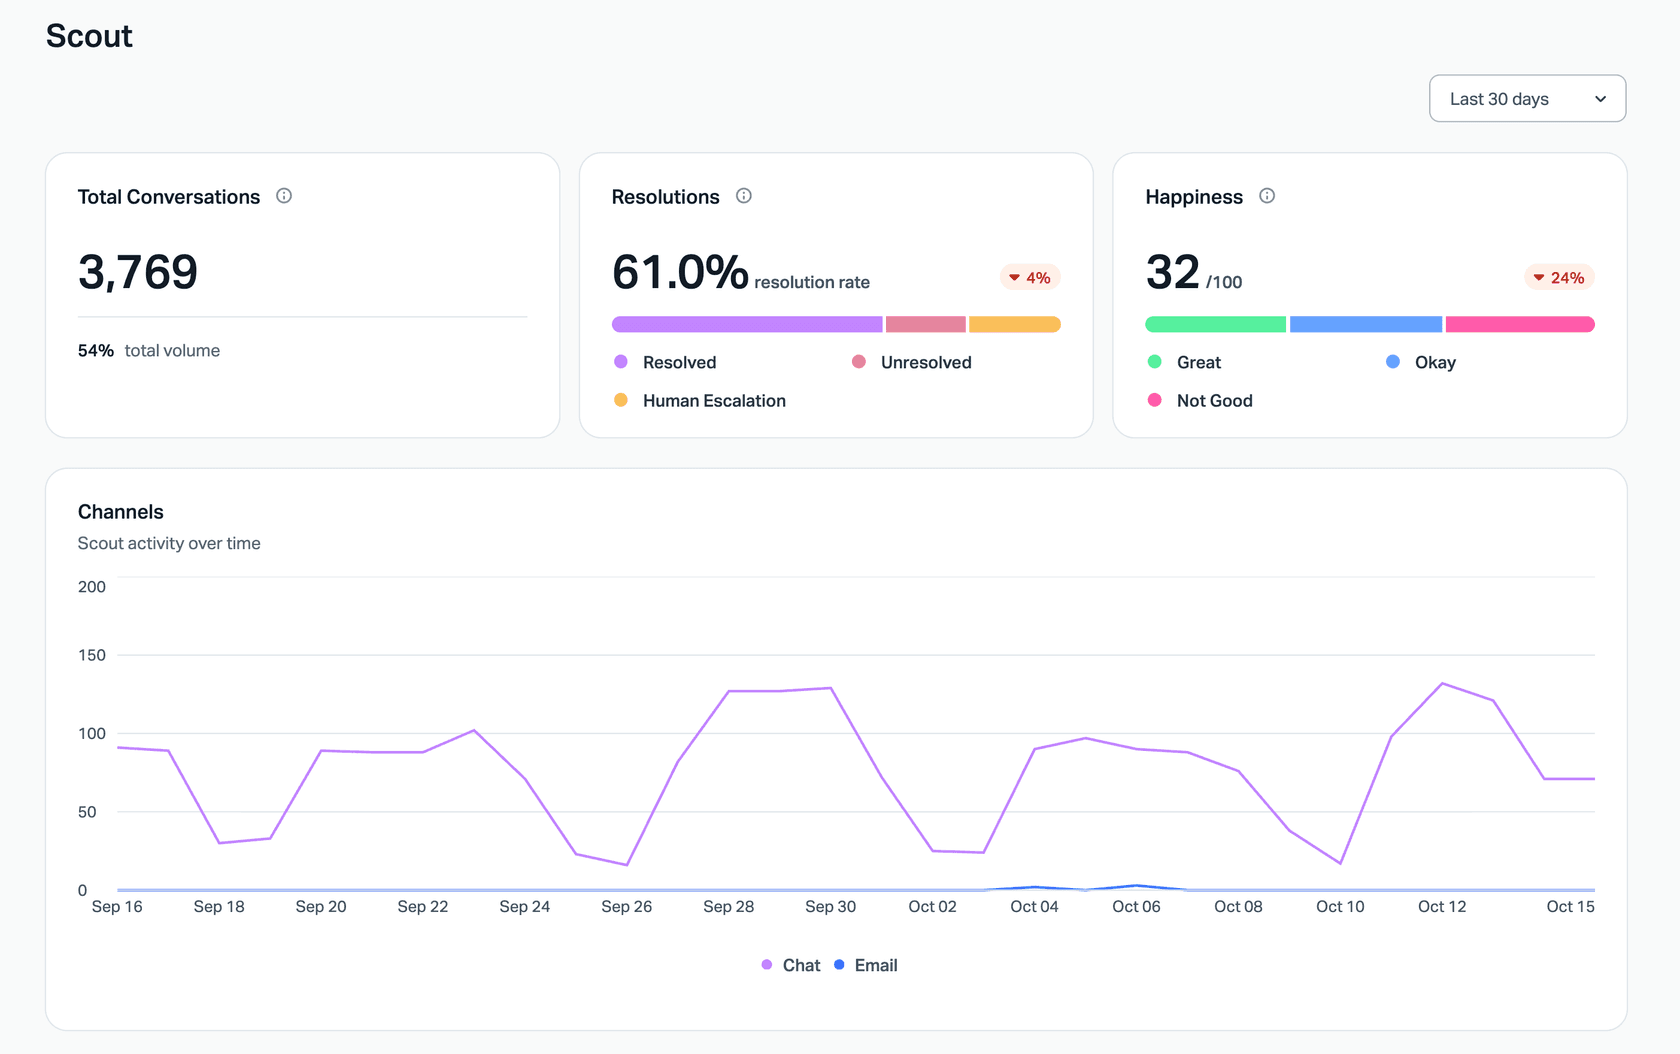
Der Haken liegt darin, wie eine Session endet. Help Scout nennt "Timeout means the customer didn't reply to the last answer given" als einen der Endgründe (Help Scout), sodass ein Kunde, der still ging, als gelöst abgerechnet werden kann. Die Beispieldaten oben zeigen, warum ich die Lösung immer neben einem Zufriedenheitssignal lesen würde. Help-Scout-Preise behandelt die Seat-Tarife.
Salesforce Agentforce: deflected Sessions, abrechenbare Lösungen und ein Modell-Score
Agentforce trennt drei Ideen. "Deflected Sessions" sind "Sessions ended by user (not by escalation or abandonment)." Eine "Task Resolution Rate" ist der Anteil der Sessions, die "evaluated as fully resolved by the Task Resolution detector" wurden (Agent Analytics data model). Und für den Help Agent braucht eine abrechenbare Lösung "at least two turns", ein Schlussfeedback, das "not explicitly negative" ist, und keine Eskalation an einen Menschen, oder ein ausdrücklich positives Schlussfeedback (Flex Credits).
Die Preisseite nennt 2 $ pro Gespräch oder Flex Credits zu 500 $ pro 100.000 (Agentforce pricing). Zwei Runden sind eine sinnvolle Untergrenze, weil sie die Ein-Nachricht-Sessions mit "Hallo" ausschließt, die anderswo die Deflection aufblähen. Unser Beitrag zu Agentforce-Preisen enthält die Credit-Rechnung.
Ada: Ein Modell beurteilt jedes Gespräch
Die automatisierte Lösung von Ada verlangt vier Dinge: Das Gespräch war relevant, korrekt ("correct, up-to-date information"), sicher und eingedämmt. Der KI-Agent "uses AI language understanding to assess both customers' inquiries and its own responses", und jede Übergabe markiert das Gespräch sofort als Not Resolved (Ada docs). Kundenfeedback zu einer Klassifizierung wird zur Verbesserung des Modells genutzt, "does not override the automatic classification."
Auf dem Papier ist das eine strenge Definition. Ada veröffentlicht keine Preise auf seiner Preisseite, ich kann Ihnen also nicht sagen, was eine Lösung kostet; Ada-Preise sammelt, was öffentlich ist.
Kustomer: geschlossen ohne menschliche Nachricht
Die AI Resolution Rate von Kustomer ist "The percentage of inbound conversations that were solely handled by AI and are currently done" (Kustomer). Der Concierge-Bericht nutzt dieselbe Idee: geschlossen, mit ausgehenden Nachrichten von Concierge und keiner von einem Menschen. Sie ist statusbasiert, ohne Fenster und ohne Modellprüfung. Der Concierge-Bericht von Kustomer enthält selbst eine gute Warnung: Lesen Sie ihn "alongside customer satisfaction, escalation, and error rates." KI-Agenten sind in der Preistabelle ein Add-on nur auf Anfrage; siehe Kustomer-Preise.
Front: drei Preisstufen, eine Teammitglied-Regel
Front rechnet Autopilot nach dem höchsten erreichten Ergebnis ab: 0,05 $ für Triage, 0,39 $ für eine Übergabe und 0,89 $ für eine Lösung. Ein Gespräch gilt als gelöst, "if there is no follow-up message from a teammate within 24 hours" bei Chat, SMS und WhatsApp, "or within 72 hours for email and portal" (Front help center). Ausschlusskriterium ist die Antwort eines Teammitglieds, sodass ein Kunde, der innerhalb des Fensters wütend zurückschreibt, die Lösung nicht allein dadurch aufhebt.
Front hat für seine älteren Chatbot-Abläufe noch eine "Deflection rate", definiert als Chats, die "successfully ended & archived by your chatbot" wurden, im Verhältnis zu Chats, die "reach the end of a path" (Front). Das ist Pfadabschluss, kein gelöstes Problem. Front-Preise behandelt die Seat-Tarife.
Warum Preise pro Lösung das zur Geldfrage machen
Rechnet ein Anbieter pro Lösung ab, wird seine Definition von "gelöst" von einer Berichtsentscheidung zu einer Zeile auf Ihrer Rechnung. Sechs der neun genannten Anbieter rechnen nach einer Form von Ergebnis ab. Freshdesk rechnet pro Session und Kustomer pro abrechenbarem Gespräch ab, was das Ergebnis völlig ignoriert, und Ada veröffentlicht seine Abrechnungseinheit nicht.
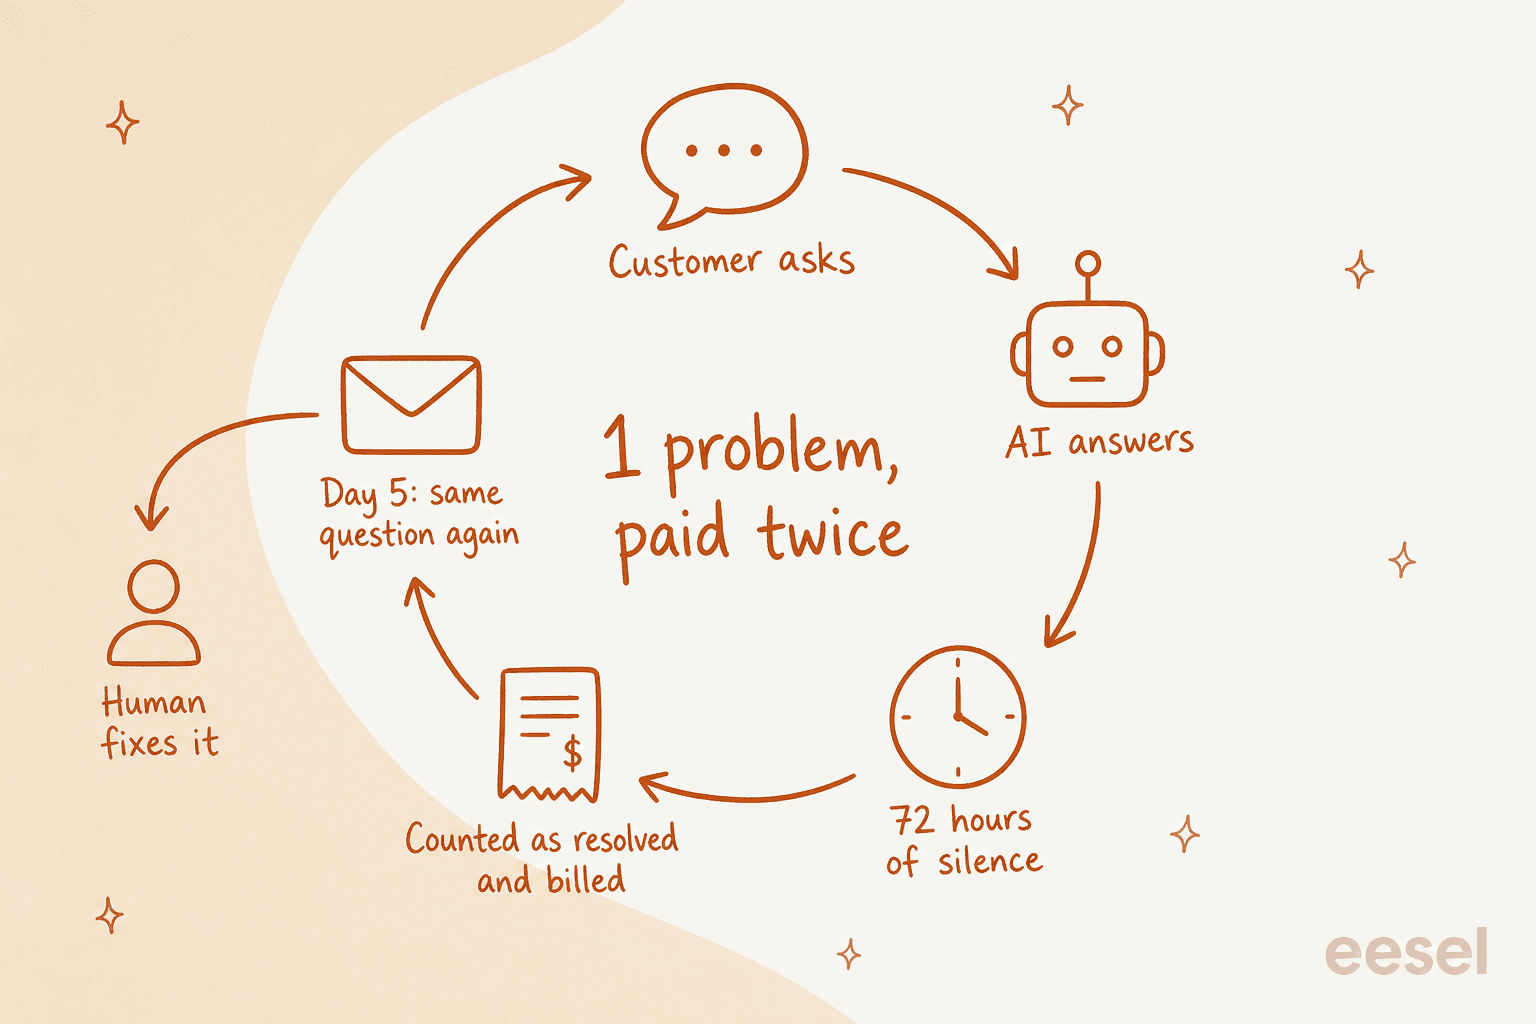
Hier die Rechnung mit dem Mindestabnahme-Tarif von Zendesk. Angenommen, Ihnen werden in einem Monat 2.000 verifizierte Lösungen zu 1,50 $ berechnet, das sind 3.000 $. Kamen 10 % dieser Kunden nach dem 72-Stunden-E-Mail-Fenster mit demselben Problem zurück (eine Zahl zur Veranschaulichung, keine Zendesk-Zahl), haben Sie 300 $ für 200 Lösungen gezahlt, die zusätzlich in der Queue eines Menschen landeten. Bei 8 Minuten pro Ticket sind das rund 27 Stunden menschliche Arbeit, die laut Dashboard gar nicht anfiel.
Zugunsten der Anbieter gilt: Preise pro Lösung sind für Sie deutlich besser ausgerichtet als Preise pro Session, und die LLM-Prüfung von Zendesk, der Genauigkeitstest von Ada und die Zwei-Runden-Regel von Agentforce verschärfen die Definition. Die verbleibende Lücke liegt nach dem Fenster, und diesen Teil müssen Sie messen. Die sauberste Käufer-Checkliste, die ich gesehen habe, stammt von einem Zendesk-Admin in einem Thread zu automatisierten Lösungen:
"The gaps show up in counting rules, whether surfacing a help article counts, how agent handoffs are treated, what happens if a customer reopens within a defined window, and whether abandonment is being mistaken for satisfaction."
Und ein weiterer Fall, den Sie vor der Unterschrift kennen sollten: Tickets, bei denen der Kunde noch blockiert ist, wenn die KI-Antwort rausgeht.
"lock, suspend, ban, "can't log in", payment hold, and appeal follow-ups burn resolution credits and often auto-close while the user is still blocked. route those to a human queue with a recoverable tag so they do not count as done until login works again."
Ein Kommentator in einem Thread zu Preisen pro Lösung hatte den praktischsten Ansatz dafür: die Kennzahl an etwas koppeln, das Sie selbst prüfen können.
"Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked."
Stellen Sie dem Anbieter vor jedem ergebnisbasierten Vertrag fünf Fragen: Was beendet das Fenster, was disqualifiziert eine Lösung, zählt ein "hilfreich"-Klick, wird ein erneuter Kontakt auf einem anderen Kanal zugeordnet, und können Sie eine abgerechnete Lösung anfechten? Der Leitfaden zu den Kosten pro Lösung und der Vergleich von integrierter Helpdesk-KI mit einer KI-Schicht decken die Gesamtkostenseite ab.
Wie Sie die Lösungsrate richtig messen
Sie brauchen dafür kein Data-Team. Sie brauchen einen Nenner, den Sie nicht schönrechnen, einen Bestätigungsschritt und ein monatliches Audit. So würde ich es aufsetzen, der Reihe nach.
- Legen Sie den Nenner fest. Nehmen Sie jedes Gespräch, auf das die KI geantwortet hat, auch die abgebrochenen. Abgebrochene Gespräche wegzulassen, ist der schnellste Weg, eine Rate versehentlich aufzublähen.
- Fragen, dann warten. Beenden Sie KI-Antworten mit einem "Hat das geholfen?"-Button. Zählen Sie ein "Ja" als bestätigt. Zählen Sie Schweigen als unbestätigt, nicht als gelöst.
- Prüfen Sie 72 Stunden lang auf erneuten Kontakt. Gleichen Sie dieselbe Kunden-E-Mail oder -ID über alle Kanäle ab, nicht nur im ursprünglichen Thread. Ein erneuter Kontakt im Fenster stuft die Lösung herab. Die Kennzahl für wiedereröffnete Tickets in Zendesk erfasst nur Wiedereröffnungen desselben Tickets, daher brauchen Sie meist einen einfachen Export.
- Prüfen Sie monatlich 100 deflected Gespräche. Lesen Sie sie und ordnen Sie jedes ein: gelöst, abgebrochen, unbeantwortet oder falsch. Diese eine Stunde sagt Ihnen mehr als jedes Dashboard.
- Nach Thema aufteilen. Eine Rate von 60 %, die bei Sendungsverfolgung 95 % und bei Abrechnung 10 % beträgt, zeigt genau, wo Sie ansetzen müssen. Unser Leitfaden zur Verbesserung der Lösungsrate behandelt, was pro Thema zu beheben ist.
- Berichten Sie Stunden, nicht Prozente. Bestätigte Lösungen × menschliche Bearbeitungszeit ist die Zahl, die Finanzen und Ihr Team gleichermaßen verstehen. Ergänzen Sie die End-to-End-Automatisierungsrate (bestätigte KI-Lösungen ÷ alle eingehenden Tickets, auch menschliche), damit ein kleiner KI-Kanal nicht wie ein großer Erfolg aussieht.
"Three things that actually catch what deflection hides: re-open rate within 24-72h on deflected tickets specifically (not overall), channel-switch rate (same customer/issue resurfacing in a different channel), and CSAT for tickets closed by "bot" only, not blended into your overall average."
Der dritte Punkt wiegt schwerer, als es scheint. Ein gemischter KI-CSAT-Wert mittelt Bot-Gespräche mit menschlichen und verbirgt beide. Für das größere Kennzahlenset zerlegt CX-KI-Kennzahlen eine komplette Scorecard, und der Leitfaden zur Containment Rate behandelt die Qualität der Übergabe.
Der beste Zeitpunkt, das alles aufzusetzen, ist vor dem Start. Eine Pilot-Scorecard mit einem Lösungsziel statt eines Deflection-Ziels bewahrt Sie vor einem Vertrag, der auf der falschen Zahl beruht. Stecken Sie mitten in der Evaluierung, zeigt der Plan für einen KI-Support-Piloten, wie Sie den Vergleich in vier Wochen durchführen.
Wie das in einer echten Queue aussieht
Das sauberste Beispiel, das ich für eine in das Gespräch eingebaute Bestätigung habe, ist SE Ranking, das eesel im Zendesk-Live-Chat für drei Produkte betreibt. Jede Antwort geht mit "Was this response helpful?" und Ja- und Nein-Buttons raus. Bei Planable löst ein Ja das Ticket, und Schweigen lässt es für einen Menschen offen. Das Team bat außerdem um einen ai_handled-Tag auf jedem Ticket, das eesel anfasst, plus Tags für hilfreich und nicht hilfreich, "so containment is counted in Zendesk, not guessed." Zwischen dem 8. August und dem 8. September 2026 beantwortete eesel rund 2.100 Live-Chats zuerst und übergab etwa 1.260 davon an das Team. Diese Übergabezahl ist kein Scheitern; so sieht ein ehrlicher Nenner aus.
Question Beauty, eine Kosmetikmarke mit Gorgias und Shopify, zeigt, warum Antwortzahlen allen schmeicheln. Im selben Monat bearbeitete eesel rund 990 Tickets und sendete rund 960 Antworten direkt, fast jedes Ticket bekam also eine KI-Antwort. Aber rund 280 Tickets schloss eesel, und rund 250 wurden einer Person zugewiesen, wobei Erstattungen, Beschwerden und Großhandel immer an einen Menschen gehen. Berichten Sie "Tickets mit KI-Antwort", erhalten Sie eine Zahl nahe 97 %. Berichten Sie "ohne Person geschlossen", erhalten Sie etwa 28 %. Beides stimmt, und nur das zweite sagt, wie viel Arbeit den Schreibtisch des Teams verlassen hat.
Rúngne, eine norwegische Kletterbekleidungsmarke, bringt eine Wendung: In dem Monat gingen rund 440 öffentliche Antworten raus, aber viele davon waren kurze Bestätigungen eines Triage-Agenten, unterzeichnet mit MagBot, die dem Kunden sagen, dass sich jemand kümmert. Zählt man sie, hat die KI viel "angefasst". Der Helpdesk-Agent, der selbstständig antwortet, lief auf rund 280 von etwa 2.100 Tickets, "around one ticket in seven." Eine Bestätigung verhindert, dass ein Kunde zweimal schreibt, was nützlich ist, aber es ist keine Lösung und gehört nicht in diese Spalte.
Unsere eigenen Verkaufsgespräche zeigen dieselbe Trennung in Testdaten. Ein deutscher Online-Juwelier mit rund 1.000 Zendesk-Tickets im Monat testete eesel mit echtem Traffic: Die Entwürfe gingen in 88 % der Fälle in die richtige Richtung, aber nur 12 % wurden unverändert gesendet. "Richtige Richtung" und "gelöst, ohne Änderungen" liegen so weit auseinander wie Deflection und Lösung.
Wie eesel Deflection und Lösung auseinanderhält
eesel ist eine Plattform für KI-Teammitglieder, und sein Helpdesk-Teammitglied arbeitet im Helpdesk, den Sie schon haben. SE Ranking nutzt es mit Zendesk, Question Beauty und Rúngne mit eesel für Gorgias, und die Freshdesk-Integration funktioniert genauso. Drei Dinge daran sind für diesen Beitrag wichtig.
Erstens sehen Sie die Lösungsfrage schon vor dem Livegang. Die Simulation von eesel entwirft eine eigene Antwort auf 20 Tickets, die Ihr Team kürzlich gelöst hat, vergleicht jede mit dem, was Ihr Team gesendet hat, gruppiert die Ergebnisse nach Thema und "sends nothing to customers" (eesel docs). Sie meldet auch die Lücke, die die Worte nicht abdecken.
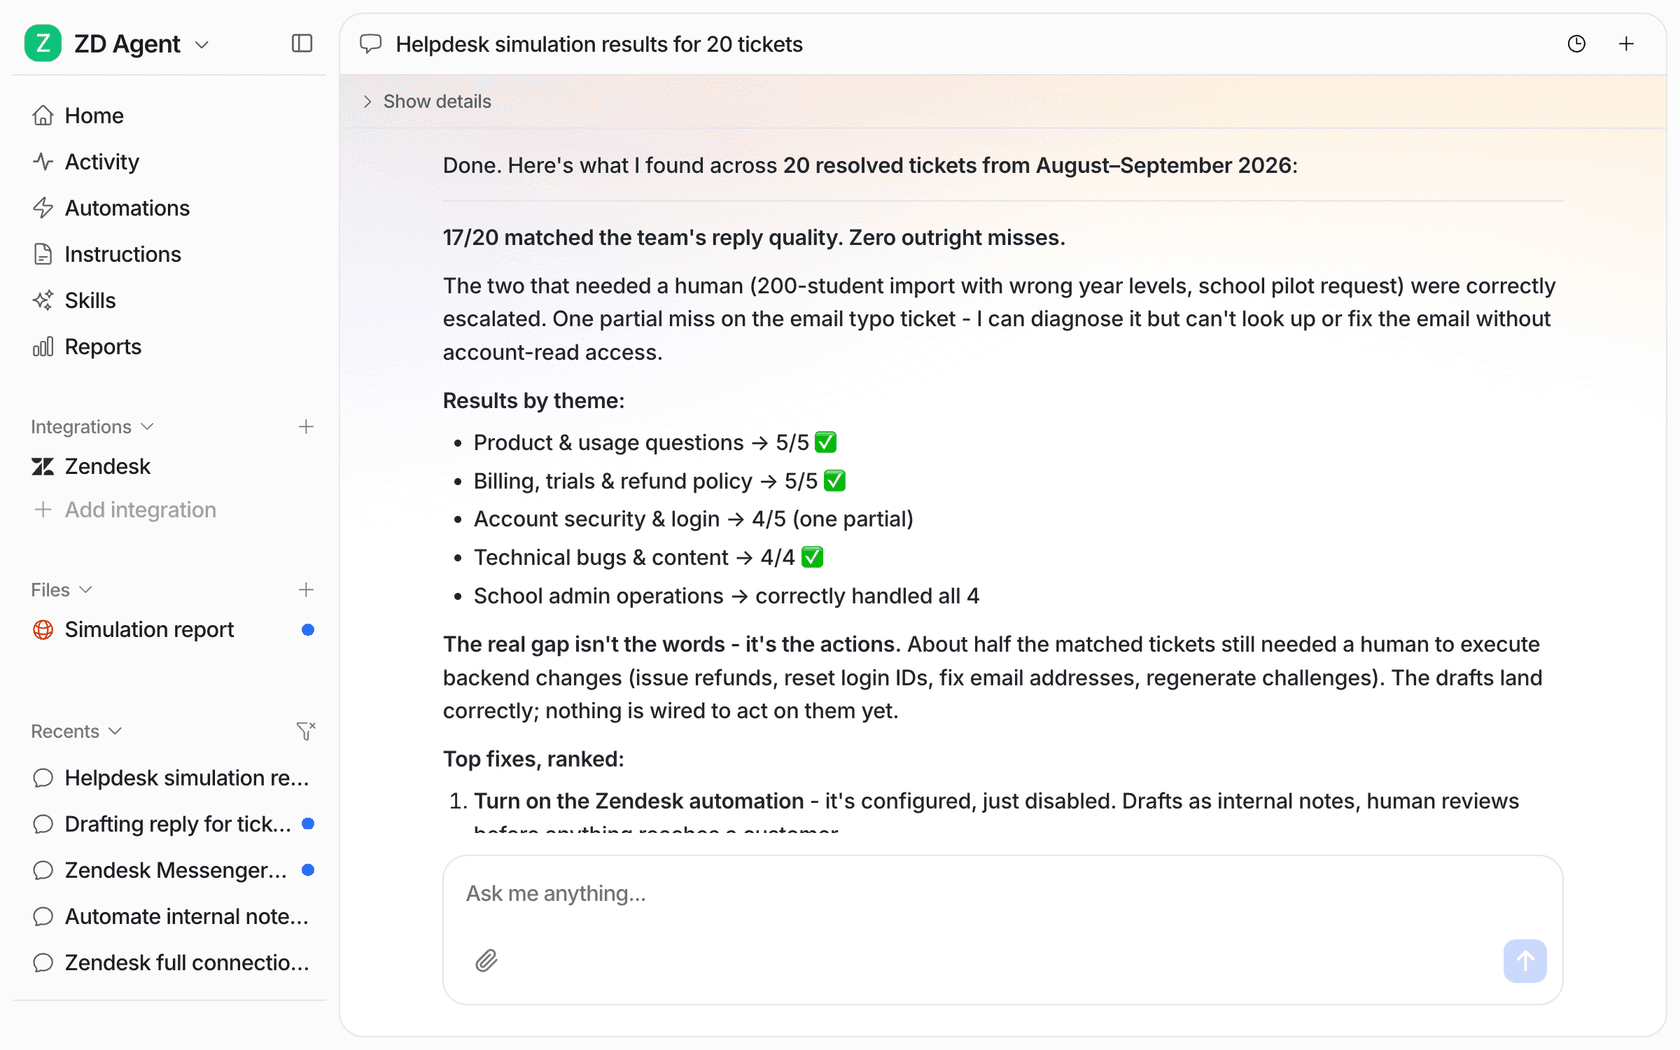
Dieser Screenshot ist der ganze Beitrag auf einem Bildschirm: 17 von 20 Antworten stimmten überein, und etwa die Hälfte der übereinstimmenden Tickets brauchte trotzdem jemanden, der eine Erstattung auslöst oder ein Login zurücksetzt. Gemessen daran, ob die Antwort richtig aussah, bestehen alle 17. Gemessen daran, ob das Problem ohne Menschen gelöst wurde, ungefähr die Hälfte.
Zweitens rechnet eesel nicht pro Lösung oder pro Deflection ab. Auf den eesel-Preisen gilt: "A ticket or a chat is 1 credit", egal wie viele Antworten hin- und hergehen, mit Tarifen ab 299 $ im Monat für 500 Credits. Ein Ticket, das der Agent an einen Menschen übergibt, kostet denselben Credit wie eines, das er schließt, es gibt also keinen finanziellen Grund, die Definition von gelöst zu dehnen. Das heißt auch, dass Sie für bearbeitete Tickets zahlen und die Lösungsprüfung von oben trotzdem brauchen, um zu beurteilen, ob es sich lohnt.
Drittens die Grenzen, denn sie zählen hier. Die Reports-Seite von eesel zeigt Volumen, Wissenslücken und Freigaben, und die Dokumentation sagt klar, dass "AI CSAT is not customer feedback. It is an AI's rating of your agent's answers." Es gibt keine Deflection-Karte, und erneuter Kontakt über Kanäle hinweg stammt weiterhin aus Ihren Helpdesk-Daten. Kombinieren Sie das dafür mit der 72-Stunden-Prüfung von oben.
eesel ausprobieren
Sieht Ihre Deflection-Zahl großartig aus und Ihr Team fühlt sich trotzdem begraben, liegt die Lösung meist in einer strengeren Definition, nicht in einem besseren Bot. Das KI-Helpdesk-Teammitglied von eesel steigt in Ihre bestehende Queue ein, spielt zuerst Ihre alten Tickets durch, damit Sie sehen, was es lösen würde und was es nur beantwortet, und übergibt den Rest mit Notizen an Ihr Team. SE Ranking hat in jeden Chat einen "War das hilfreich?"-Schritt eingebaut; Sie können genauso beginnen, mit 100 kostenlosen Credits.