Was "Meta Muse für das Monitoring der Kundengesundheit" eigentlich bedeutet
Ich baue bei eesel Agenten, und die Frage, die ich von Customer-Success-Leitern am häufigsten höre, lautet nicht mehr "Kann die KI Tickets beantworten?". Sie lautet: "Kann die KI mir sagen, wer gleich abspringt?" Und wenn deine Kunden vor allem über WhatsApp mit dir sprechen, liegt die Frage nahe, ob Metas KI das für dich im Blick behalten könnte.
Metas Namensgebung hilft dabei ehrlich gesagt nicht. "Meta Muse" umfasst drei Produkte, und nur eines davon spricht mit deinen Kunden:
| Produkt | Was es ist | Nützlich für Health-Monitoring? |
|---|---|---|
| Muse | Metas persönlicher Consumer-Agent für Privatpersonen | Nein |
| Muse Spark API | Metas Modell, das du aus deinem eigenen Code aufrufen kannst | Nur als Klassifikator, den du selbst baust |
| Meta Business Agent | Metas kundenorientierte Business-KI, gestartet am 3. Juni 2026 | Teilweise. Er erzeugt die Konversationen und einige Signale |
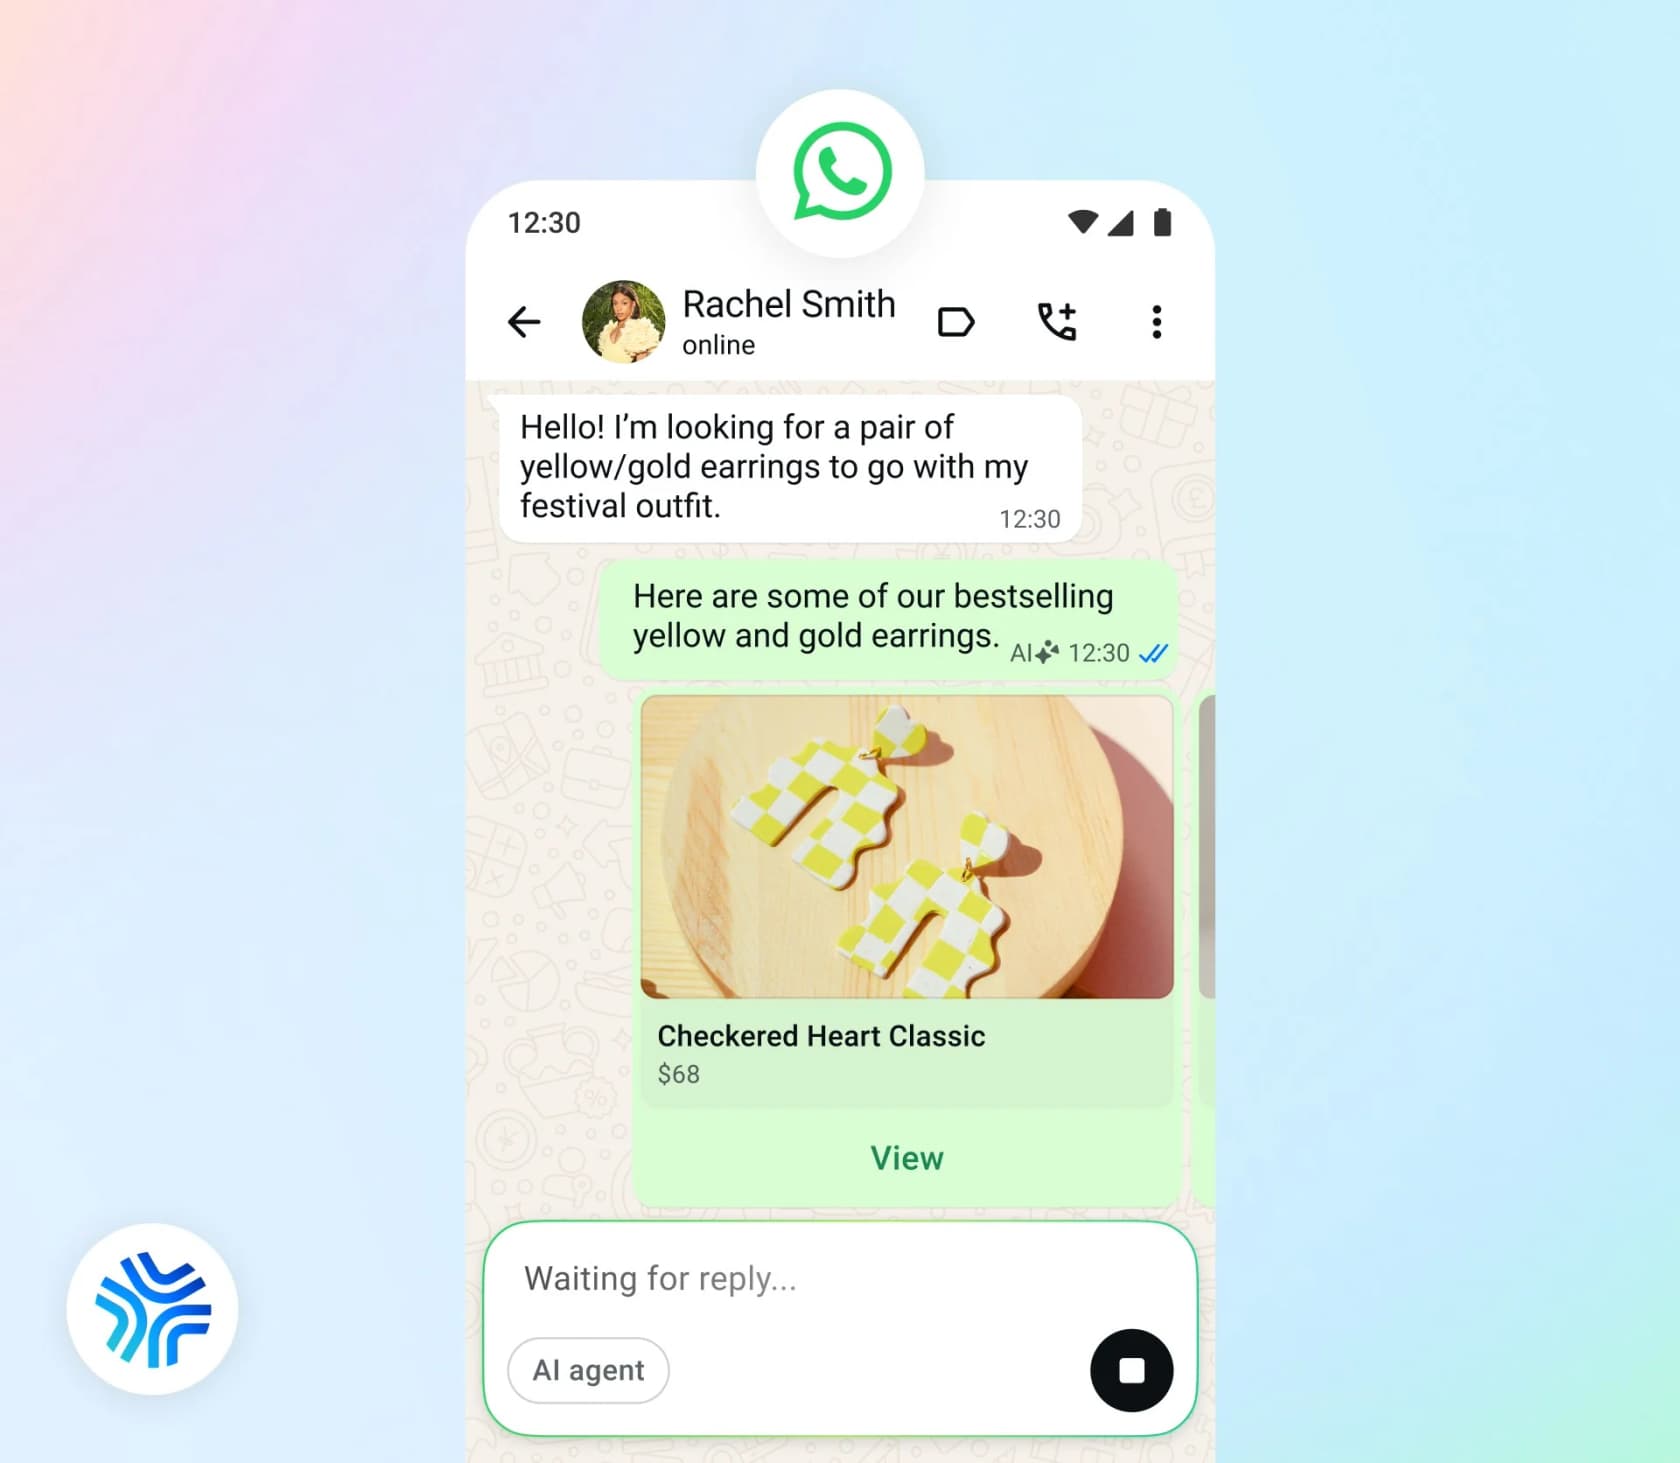
Business Agent selbst gibt es in zwei Varianten: eine Self-Serve-Version in Meta Business Suite und der WhatsApp Business App sowie den Meta Business Agent Platform für Unternehmen auf der WhatsApp Business Platform API. Die vollständige Aufschlüsselung steht in meinem Hub Meta Muse für den Kundensupport, und die Consumer-App behandelt der Beitrag Meta Muse Agent.
Wenn ich in diesem Beitrag von Monitoring der Kundengesundheit spreche, meine ich, unzufriedene oder festgefahrene Kunden zu erkennen, oder solche, die still abdriften, solange noch Zeit zum Handeln bleibt. Im Support-Kontext sind die Konversationen selbst der reichhaltigste Input, weshalb Abwanderungsrisiko in Support-Konversationen eine eigene Disziplin ist. Das führt zu einer engeren Frage. Was lässt Meta dich über diese Konversationen tatsächlich sehen?
Meta liefert Signale, keinen Health Score
Nach dem Durcharbeiten von Metas Doku zu Business Agent, WhatsApp und Business Suite lautet die Kurzfassung: Meta liefert die Rohrleitungen, das Scoring bleibt dir überlassen. Ich habe in der Doku nirgends einen Stimmungsscore gefunden, auch keinen Abwanderungsscore oder irgendein Kundengesundheitsfeld. Das "Morning Briefing" auf der Warteliste, das "provide[s] insights on your threads", nennt Produkt-Insights und Wettbewerbsanalyse als Roadmap, nicht Abwanderung (Meta for Business).
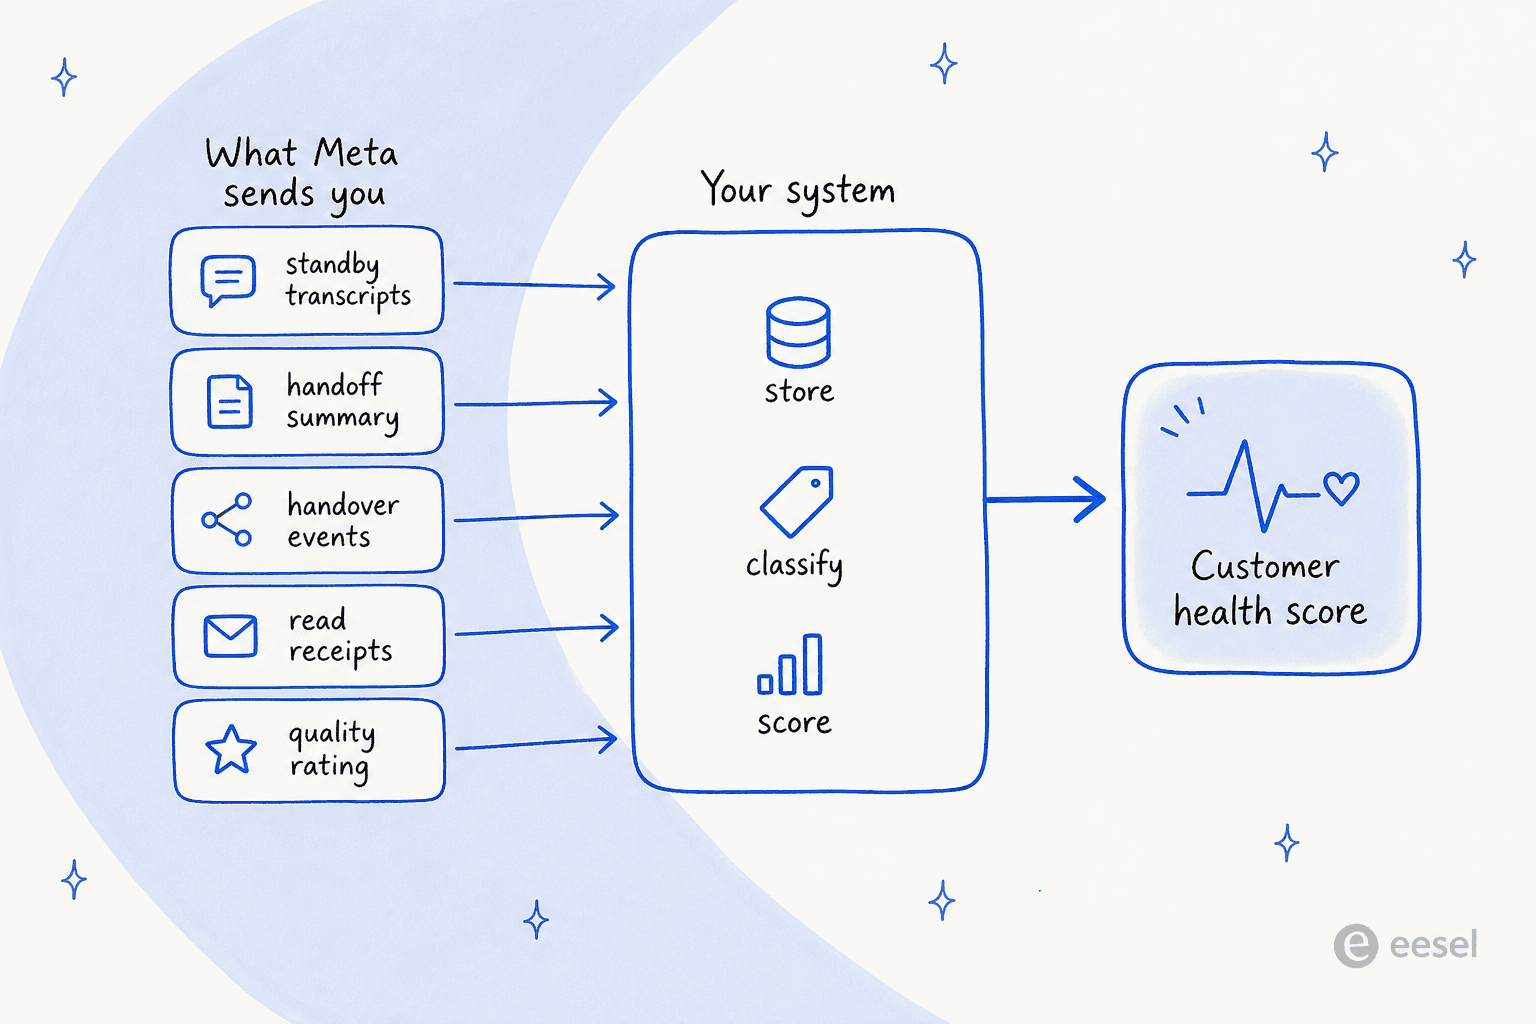
Meta räumt das mehr oder weniger selbst ein. Der Leitfaden für Kundensupport-Agenten rät: "Track the share of conversations handed off and the time to first human reply alongside it." Keine Meta-Schnittstelle liefert aber eine dieser beiden Zahlen. Das hast du tatsächlich zur Verfügung.
Der Live-Transkript-Feed (Standby-Webhooks)
Von allem hier ist das das nützlichste Signal, und zugleich das, das man am leichtesten übersieht. Standby-Webhooks benachrichtigen deine App über eine Konversation, "when another responder owns the thread", wozu auch Meta Business Agent zählt. Du bekommst drei Streams: die eingehenden Nachrichten des Kunden (Reaktionen eingeschlossen), Kopien dessen, was der Agent gesendet hat, sowie Gesendet-, Zugestellt- und Gelesen-Bestätigungen. Meta nennt sogar "Monitor messaging activity" als einen der Zwecke, was mich ein wenig überrascht hat.
Es gibt aber zwei Haken. "Standby is off by default", und das Unternehmen muss deiner App in Meta Business Suite Standby-Sichtbarkeit gewähren. Außerdem enthalten die Agent-Echos "the send-time parameters exactly as passed to the Send Message API - not the rendered content". Wenn du also nachbauen willst, was der Kunde tatsächlich gesehen hat, ist etwas Arbeit einzuplanen.
Das größere Problem für das Health-Monitoring: Es gibt keine API, um vergangene Agent-Konversationen abzurufen. Ich habe zur Sicherheit jeden Referenz-Endpoint durchgesehen, auf den Metas Doku verlinkt. Wenn du die Standby-Ereignisse also nicht beim Eintreffen speicherst, ist diese Historie praktisch weg, zumindest für alles, was du damit anfangen wolltest. Metas eigener Rat lautet: "Store context from standby events so your app can provide continuity." In der Self-Serve-Stufe sind Konversationen nur im Tab Konversationen der Business Suite einsehbar, und Meta "does not start storing conversation logs until a customer has opened the chat" (Meta Business Help).
Die KI-geschriebene Übergabe-Zusammenfassung
Wenn der Agent eine Konversation übergibt, kann Meta conversation_context anhängen, "an AI-generated summary of the conversation so far" (Meta for Developers). Das Gute daran ist die Sorgfalt: "Identifiers and amounts are preserved verbatim" und "Open items are framed as unresolved." Metas eigenes Beispiel liest sich schon wie ein Health-Alert: ein Kunde meldet eine Bestellung, bei der "missing three items ($18.40)" fehlen, dazu einen verdorbenen Artikel.
Jetzt das weniger Gute. Meta sagt: "Treat summary.text as human-readable prose, not structured data - do not parse it for fields or rely on a fixed format." Ein Stimmungsfeld findest du darin nicht, und auch kein Dringlichkeits- oder Grundfeld. Ebenfalls wissenswert: Für eine gegebene Konversation bekommst du diese Zusammenfassung oder Standby-Webhooks, "exactly one", nie beides.
Übergabe-Ereignisse
Das Ereignis control_passed wird ausgelöst, wenn die Kontrolle von der KI an einen Menschen übergeht, mit einem optionalen frei formulierten metadata-String von bis zu 2.000 Zeichen (Thread control). Metas Beispiel-Payload zeigt "previous_owner_role": "ai_agent" mit "metadata": "WhatsApp user requested human agent". Ich habe nirgends eine Zusage gefunden, dass der Agent immer einen Grund einträgt. Mein Rat: Zähle die Übergaben und betrachte den Grund als Bonus, wenn er auftaucht.
Nimmst du diese drei zusammen, kannst du eine Übergaberate pro Kunde ermitteln, wiederkehrende Kontakte erkennen und Threads markieren, die ungelöst endeten. Das ist ein echtes Fundament. Das Haus darauf musst du selbst bauen.
Das eine Gefühl, das Meta misst: deine Qualitätsbewertung
Es gibt genau eine stimmungsähnliche Zahl, die Meta für dich berechnet. Deine WhatsApp-Telefonnummer hat eine Qualitätsbewertung von Grün, Gelb oder Rot, "based on the recent messages that your customers have received over the past 7 days". Sie stammt aus "blocks, reports, mutes, archives, and reasons users provide when they block you" (Meta for Developers). Als Blockierungsgründe können Kunden wählen: "No longer needed", "Didn't sign up", "Spam", "Offensive messages" und "No reason".
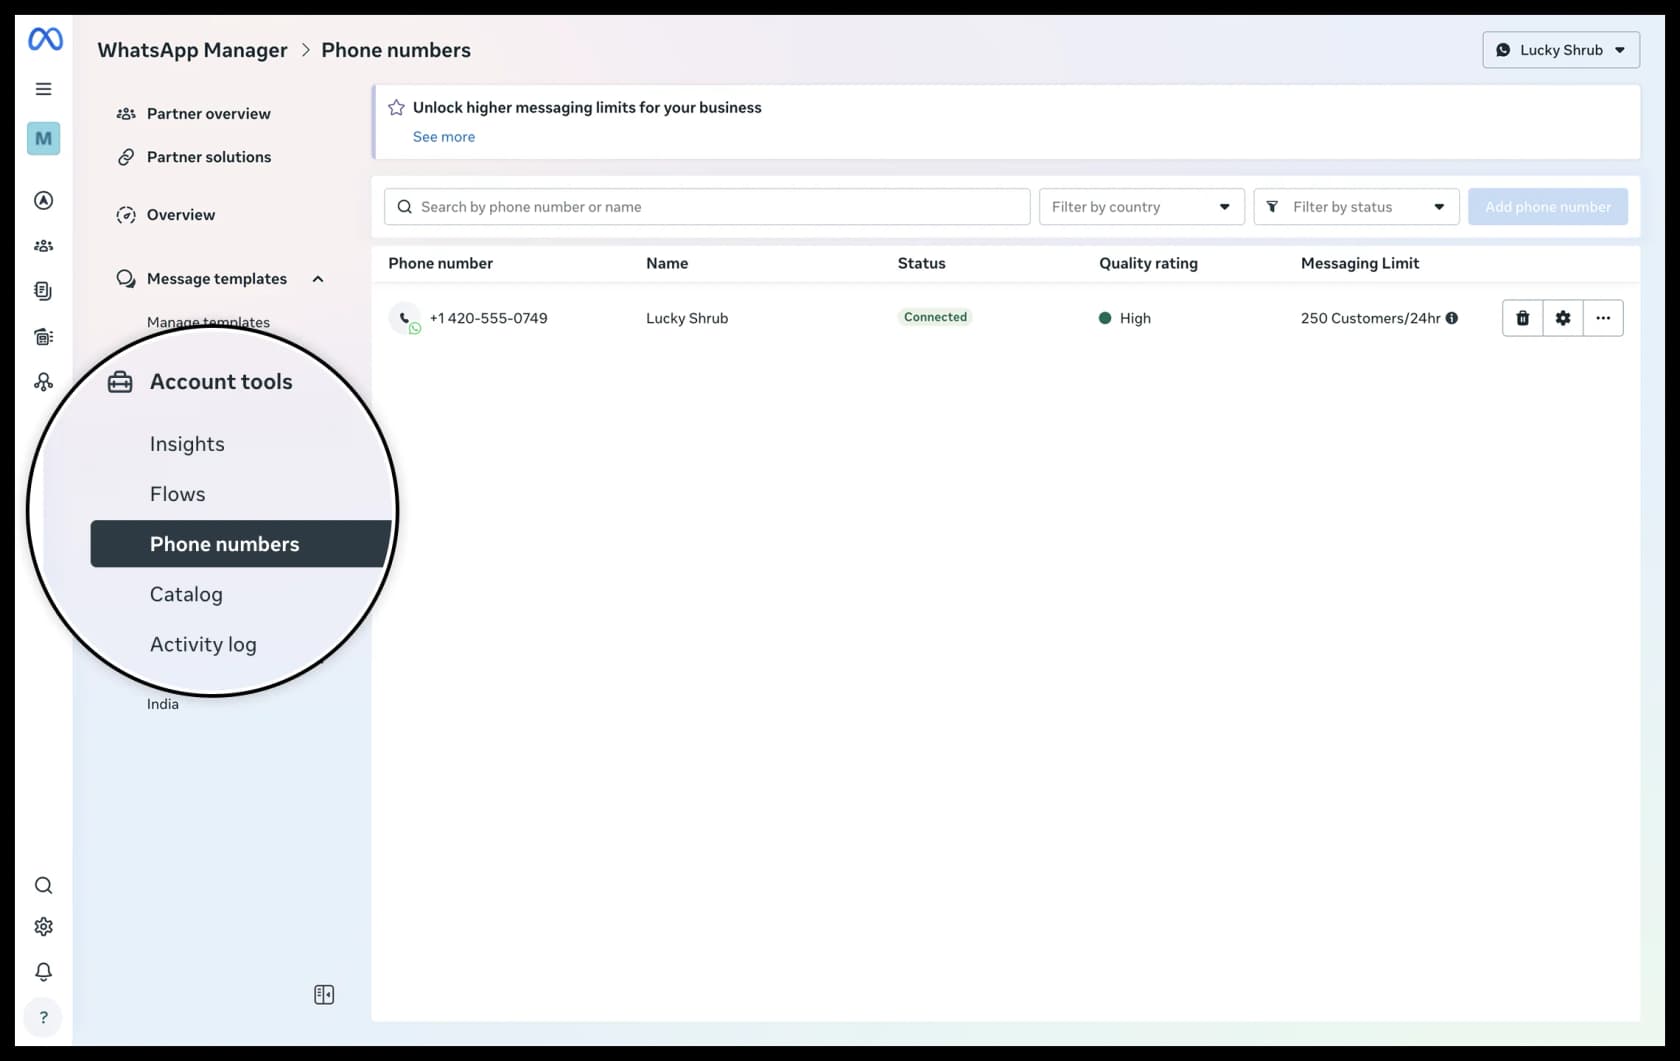
Auch Templates werden separat bewertet, jedes mit eigenem quality_score. Gelb bedeutet "negative feedback from multiple WhatsApp users, or low read-rates, and may soon become paused or disabled" (Template quality rating).
Die Bewertung ist auch nicht nur Kosmetik. Sie hat Konsequenzen. Nachrichtenlimits begrenzen, wie viele einzelne Kunden du innerhalb von 24 Stunden außerhalb einer offenen Konversation anschreiben darfst. Neue Portfolios starten bei 250, steigen dann auf 2.000, 10.000, 100.000 und Unlimited, und für den Aufstieg braucht es "high-quality messages across all of your business phone numbers and templates".
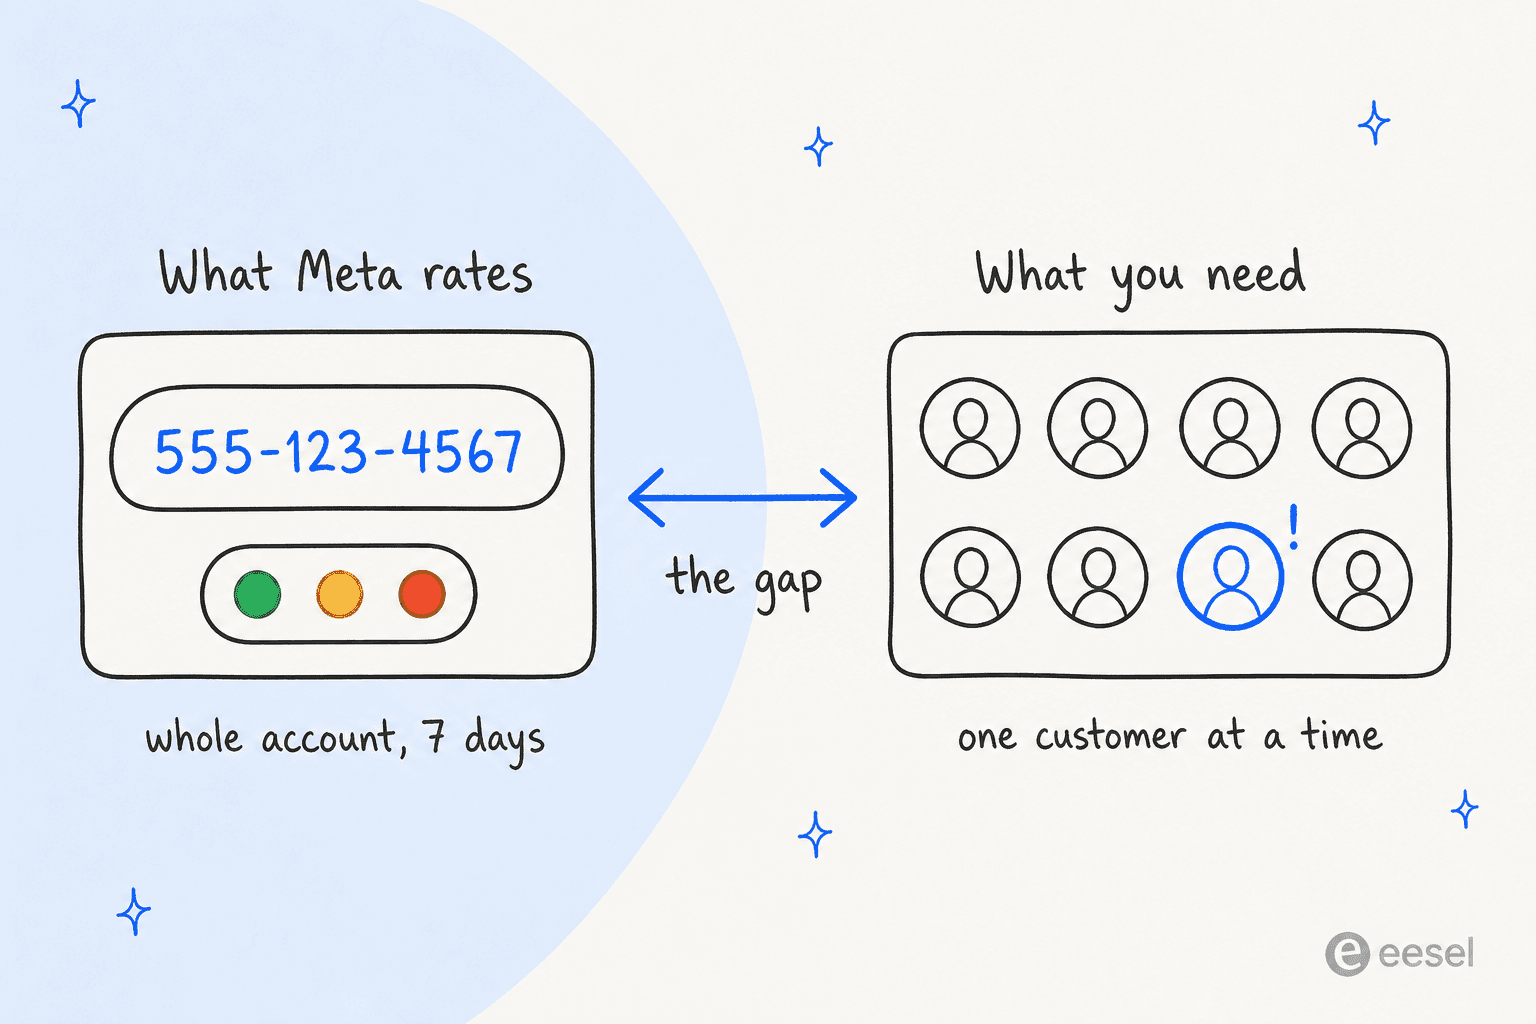
Das, was ich dir aus diesem Abschnitt mitgeben möchte, ist einfach. Die Qualitätsbewertung misst, wie Kunden über deine Nachrichten denken, nicht wie es jedem einzelnen Kunden geht. Sie existiert nur auf Konto- und Template-Ebene, und Meta sagt dir nicht, wer dich blockiert hat. Als Frühwarnung, dass deine Nachrichten Leute nerven, ist sie großartig, und genervte Leute sind selbst ein Gesundheitsrisiko. Was sie nicht kann: dir sagen, dass dein größter Kunde gleich kündigt.
Signale pro Kunde gibt es auch. Sie sind dünner, aber echt, und du berechnest sie selbst. Status-Webhooks zeigen dir, wann ein Kunde aufhört, deine Nachrichten zu lesen. Der user_preferences-Webhook feuert, wenn ein Kunde Marketing-Nachrichten abbestellt. Emoji-Reaktionen kommen als eigener Nachrichtentyp. Meta interpretiert keines davon. Das ist deine Aufgabe.
Für aggregierte Trends gibt es die WhatsApp-Analytics-API mit 1 Jahr Rückblick bei Nachrichten- und Konversationsdaten und 90 Tagen bei Templates. Lese- und Klickdaten zählen nur 7 Tage nach dem Versand, und Template-Analytics "are not supported" für Konten mit Bezug zur Europäischen Union oder Japan. Was du dort bekommst, sind Volumen und Ausgaben, im Grunde das, was du auch in ein Chatbot-Analytics-Dashboard packen würdest, keine Zufriedenheit.
Eskalation: das größte Health-Signal, und du legst es nicht fest
Ein Kunde, der nach einem Menschen fragt, ist meist das lauteste Signal in jedem Support-Health-Modell. Auf Metas Platform-Stufe entscheidest du aber nicht, wann das passiert. Die Doku sagt, der Agent "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" (Capabilities).
Agent Settings bietet nur, ob die Übergabe aktiv ist, die Übergabenachricht und ein Follow-up für inaktive Nutzer in Abständen von 5 Minuten bis 24 Stunden. Nichts davon funktioniert wie ein Frustrationsschwellenwert. Metas Workaround ist, die Auslöser in die Anweisungen des Agenten zu schreiben: "Enumerate the escalation triggers rather than describing them. ... A named list - damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person - behaves predictably" (Support-Agent-Leitfaden). Der Testplan enthält sogar einen Fall "Angry repeat contact": "This is the third time I've messaged".
Fairerweise: Der anweisungsbasierte Ansatz funktioniert gut. So würde ich Eskalationsregeln in den meisten Tools ohnehin einrichten. Hier ist die Self-Serve-Stufe etwas freundlicher: Im Tab Personality kannst du "manage specific conditions where you'd want your Business Agent to hand off the conversation to a human representative" (Meta Business Help).
Ein weiteres Gesundheitsrisiko versteckt sich im Eskalationspfad, und man übersieht es leicht. Wenn dein Agent über einen Connector Tickets öffnet, warnt Meta: "A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." Connector-Logs zeigen zwar Erfolgsquote und Latenz, aber nur für die letzten sieben Tage. Ich würde Alerts auf Fehler einrichten, statt manuell nachzusehen.
CSAT erheben: Messenger hat es, WhatsApp nicht
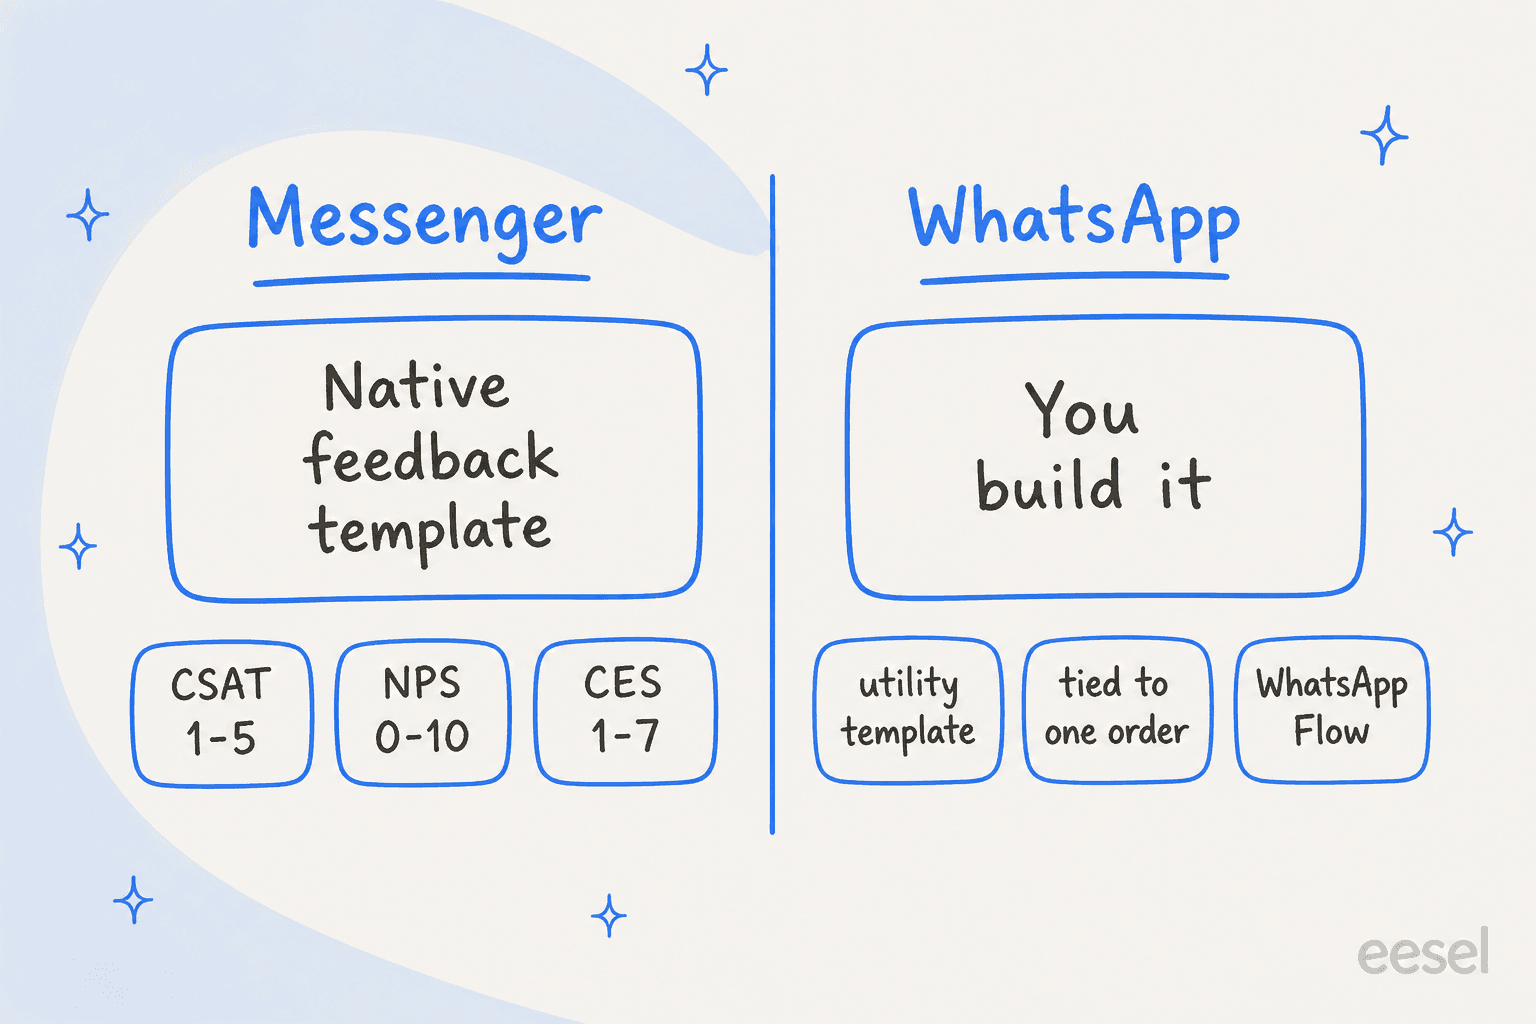
Wenn dein Health-Modell auf Zufriedenheitswerten beruht, ist der Kanal entscheidend. Messenger hat ein natives Customer Feedback Template mit CSAT von 1 bis 5, NPS von 0 bis 10 und CES von 1 bis 7, plus bis zu 400 Zeichen Freitext. Du kannst es bis zu 7 Tage nach der letzten Nachricht des Kunden mit dem Tag CUSTOMER_FEEDBACK senden. Meta kennzeichnet es als "in development", daher würde ich darauf noch nichts allzu Dauerhaftes bauen.
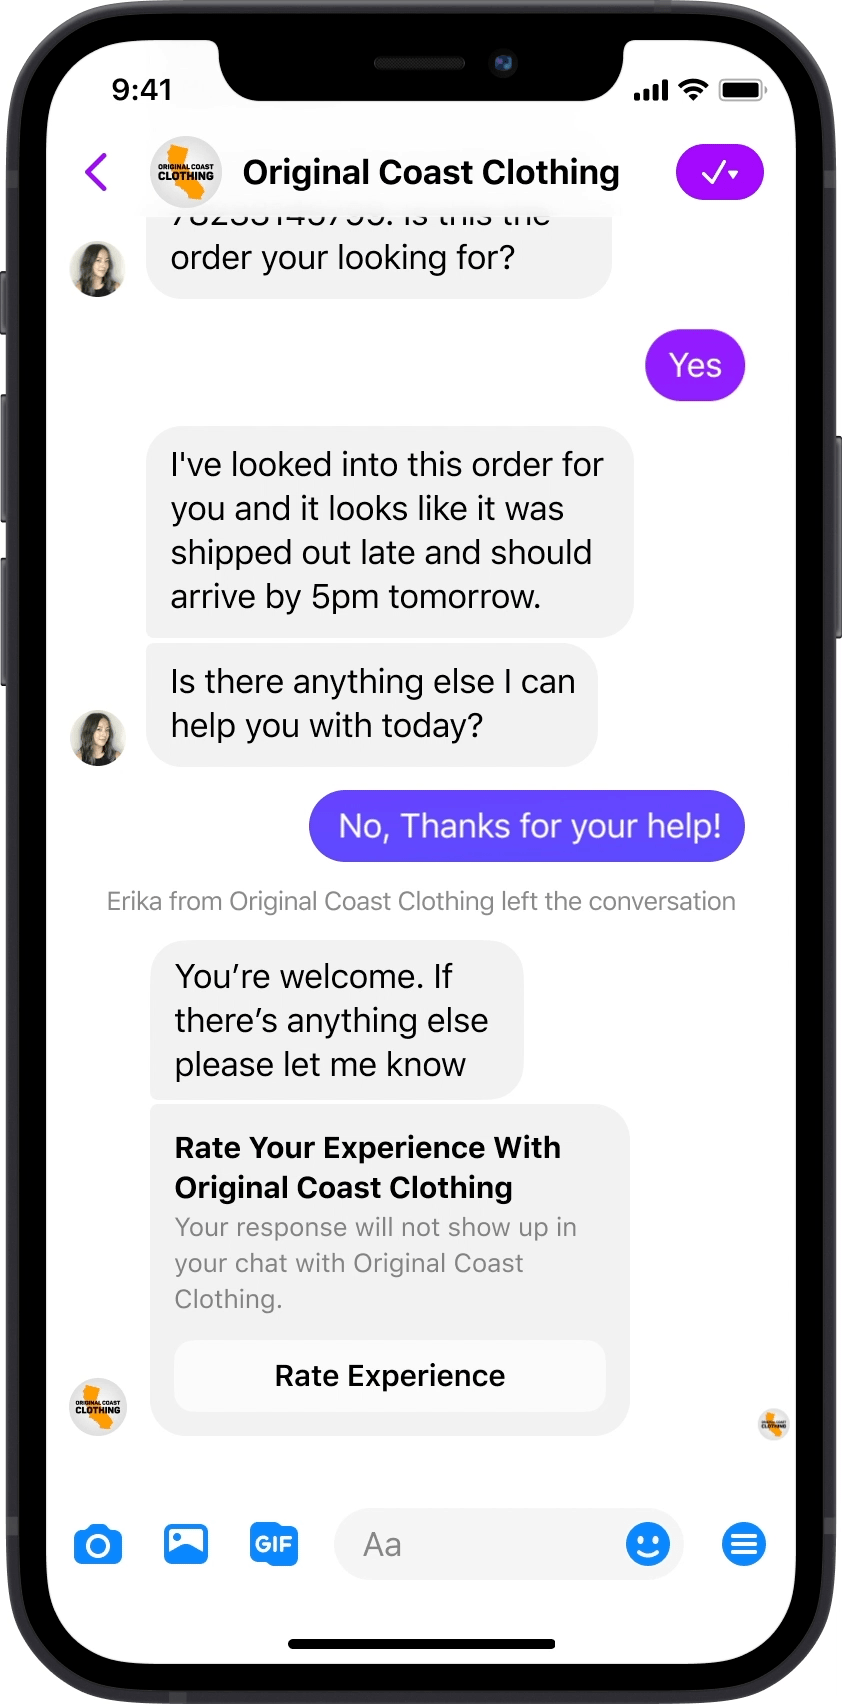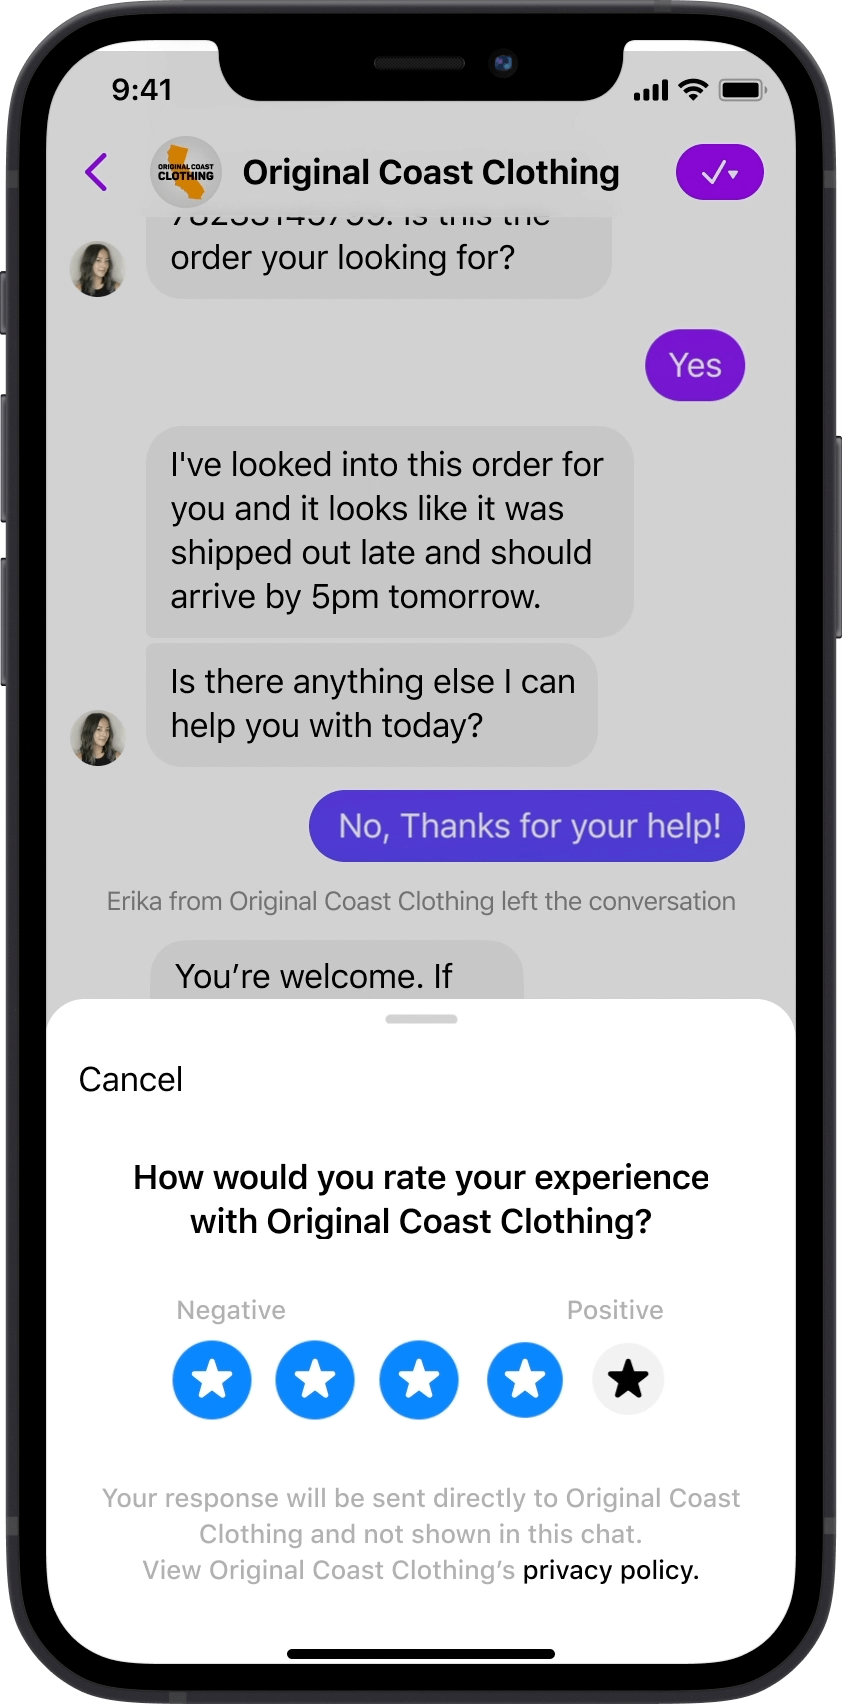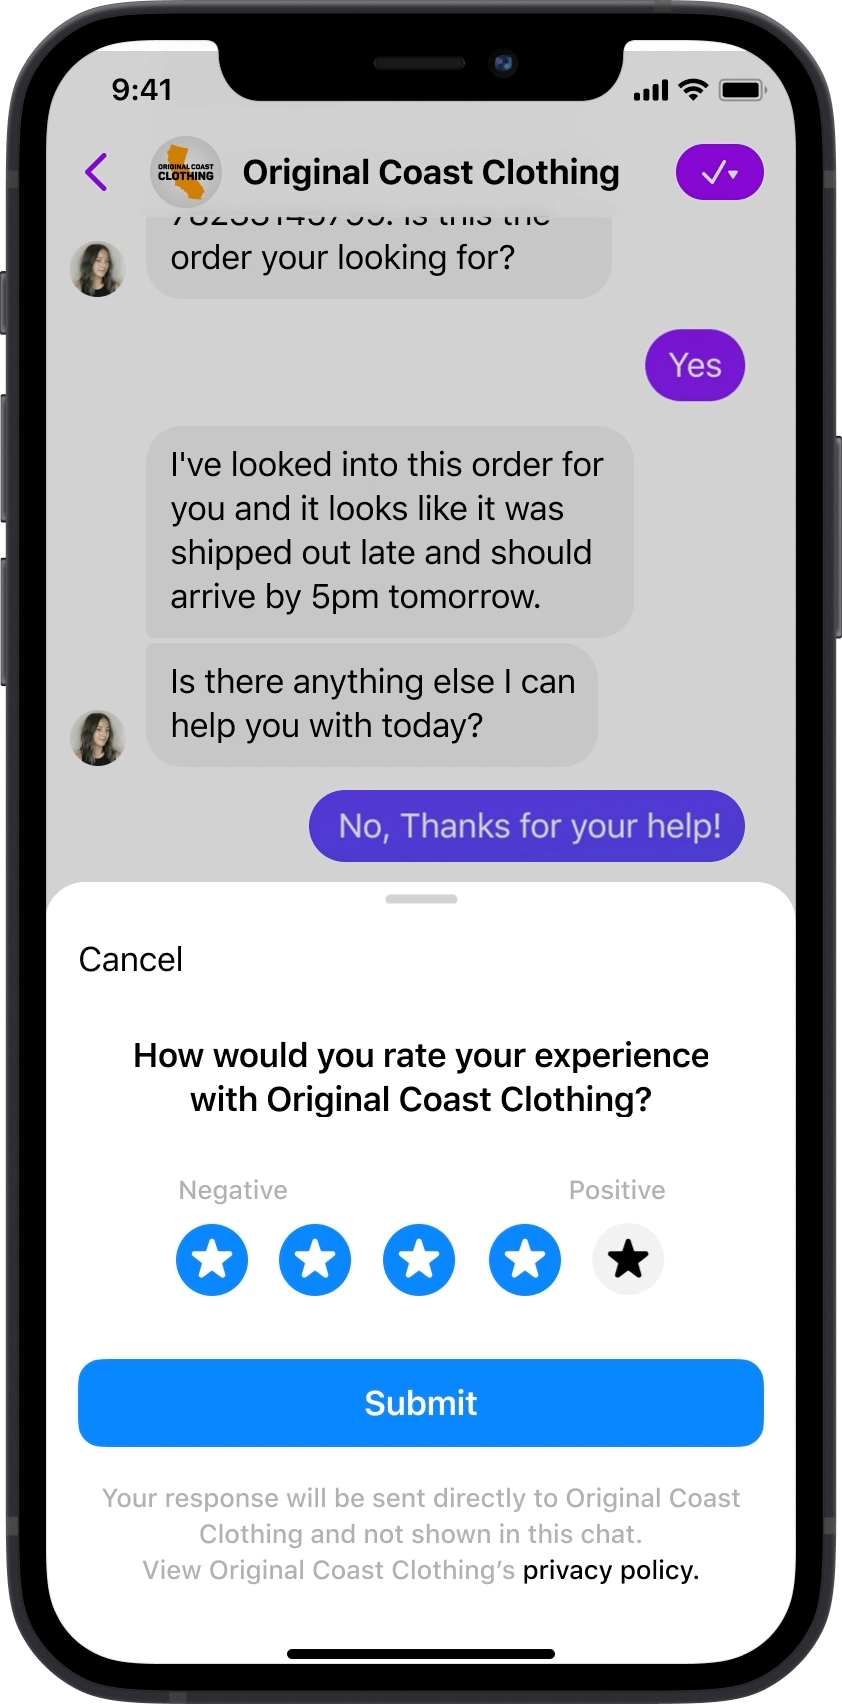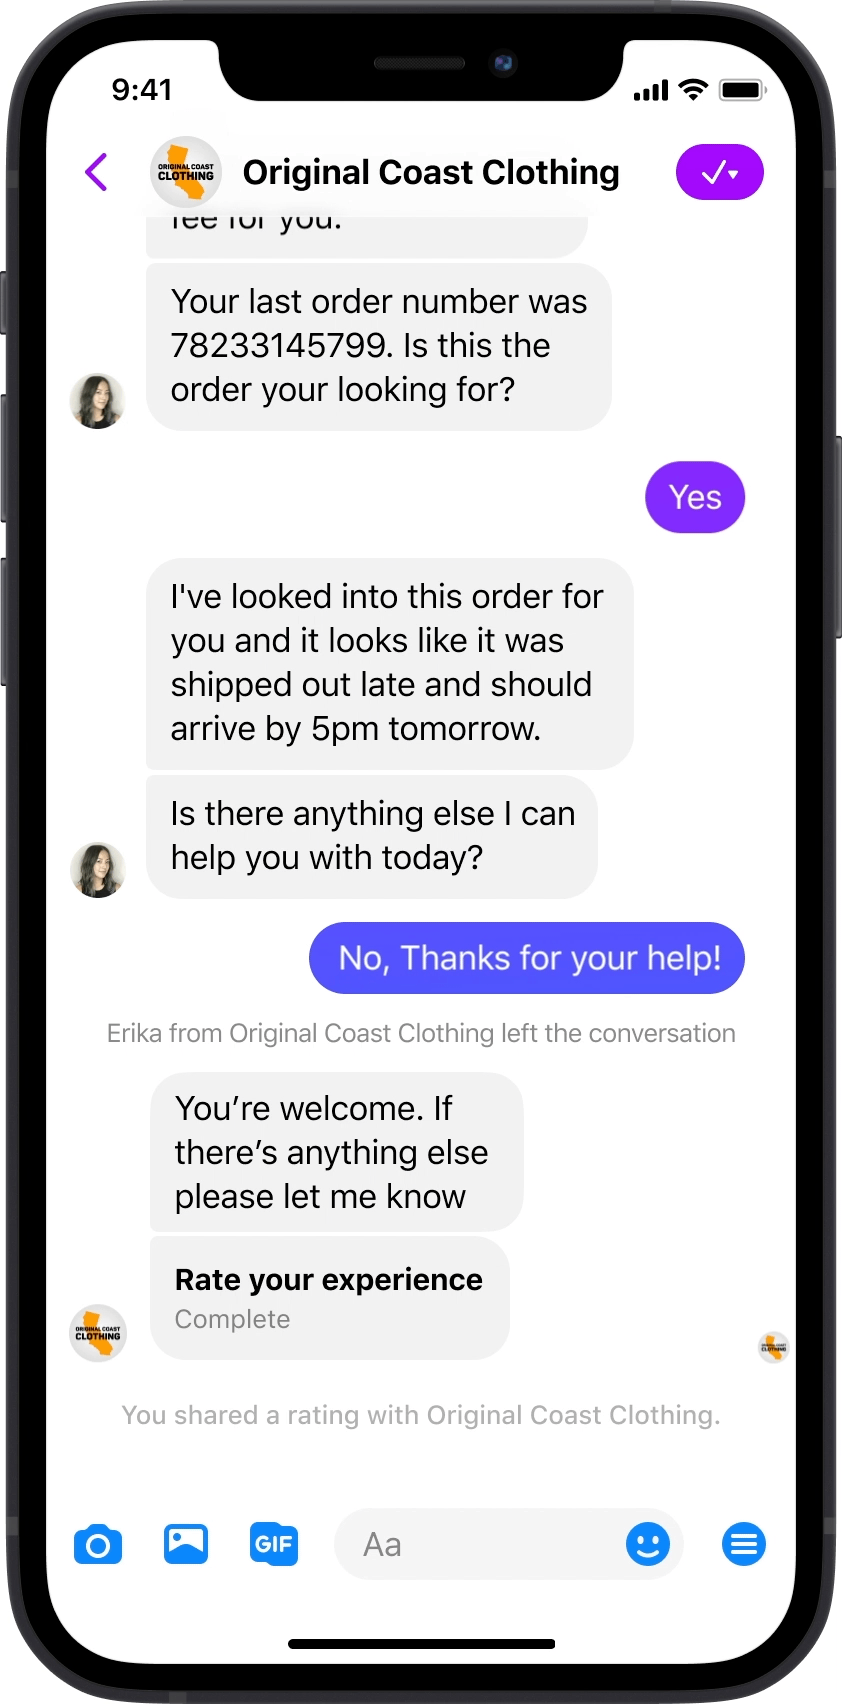
Auf WhatsApp gibt es nichts Vergleichbares. Du sendest ein Utility-Template, und Metas Kategorisierungsregeln sind streng: "Specificity of the order or interaction to which these relate is necessary. A general/generic survey or request for feedback will not be approved as utility." Metas Beispiel lautet "You chatted with us {{online}} recently about order {{order_number}}. How was your experience?" Für eine Umfrage mit mehreren Fragen liefert ein WhatsApp Flow die Antworten als JSON an deinen Webhook zurück.
Ab dem 1. Oktober 2026 wird es außerdem teurer. Utility-Templates, die innerhalb des 24-Stunden-Fensters gesendet werden, kosten wieder Geld, und Service-Nachrichten von Menschen oder KI von Drittanbietern werden nach 1.000 kostenlosen pro Monat und Nummer berechnet (Meta for Developers). Meine Aufschlüsselung der WhatsApp-API-Preise enthält die vollständige Tabelle.
Zur Formulierung der Fragen siehe meine Anleitung CSAT-Umfragefragen, zum Messen des Aufwands den Customer Effort Score.
Eine kleine Warnung, und die stammt aus eesels eigenen Dashboards: Die Reports-Seite zeigt einen KI-CSAT-Wert, und die Doku stellt klar: "AI CSAT is not customer feedback." Egal welches Tool du am Ende nutzt, ich würde vorhergesagte und erfragte Zufriedenheit in getrennten Spalten führen.
Den Score selbst bauen mit Muse Spark
Wenn du Transkripte über Standby erfasst hast, kannst du sie durch Metas eigenes Modell laufen lassen, um Stimmung und Abwanderungsrisiko zu taggen. Muse Sparks Standard-Tier kostet 1,25 $ pro 1 Mio. Input-Tokens und 4,25 $ pro 1 Mio. Output-Tokens, mit 0,15 $ für gecachten Input, und unterstützt JSON-Schema-Ausgabe, sodass jedes Transkript in derselben Form zurückkommt.
Zur Einordnung: Bei durchschnittlich 2.000 Tokens Input pro Transkript und einem JSON-Urteil von 150 Tokens kostet das Bewerten von 10.000 Konversationen 20 Mio. Input-Tokens (25,00 $) plus 1,5 Mio. Output-Tokens (6,38 $), etwa 31 $. Diese Token-Größen sind meine Annahmen, nicht Metas Zahlen, aber die Größenordnung stimmt. Die Modellkosten sind hier der günstige Teil. Das meiste Geld fließt in die Entwicklung.
Vorab solltest du zwei Regeln kennen:
- Das günstigere Contributor-Tier ist für Kundendaten tabu. Metas Hilfeseite sagt "You must not submit sensitive, confidential, or personal information to the Discounted Services" und "If your use case involves processing personal information, please use Standard Services" (Meta Model API). Transkripte enthalten Namen, Telefonnummern und Bestell-IDs.
- Es gibt keinen fertigen Stimmungs- oder Abwanderungs-Endpoint. Du schreibst Prompt, Schema, Schwellenwerte und Alerting. Metas eigener Vorbehalt zu strukturierter Ausgabe: Sie garantiert die Form der Antwort, nicht dass das Modell die Eingabe richtig gelesen hat.
Wenn das nach einem Wochenendprojekt klingt, dann ist es das auch, zumindest für die erste Version. Es danach genau zu halten, hört nie wirklich auf. Meine Anleitungen zu KI-Stimmungsanalyse und Ticket-Klassifizierung zeigen, was typischerweise kaputtgeht.
Was Konversationssignale übersehen
Ein gut gebauter Stimmungsscore ist trotzdem nicht dasselbe wie Gesundheit. Die Customer-Success-Community ist da ziemlich direkt:
"Had a big account leave last year and the dashboard was green the whole time. Usage was up, support tickets were low, NPS score was high."

Das habe ich auch bei eesel erlebt. Als Amogh, einer der eesel-Mitgründer, Anfang des Jahres 24 abgewanderte Konten durchging (rund 90.000 $ Lifetime-Umsatz), lautete sein Fazit: "Common thread across all 24: zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Ein britisches Fintech auf dieser Liste hatte positive Stimmung und echte Nutzung und kündigte trotzdem wegen des Preises. Seine Einschätzung dazu: "We didn't lose them on product - we lost them because nobody from our side ever framed the ROI for a finance team doing budget cuts."
Umgekehrt tragen Support-Konversationen durchaus Signal, wenn du sie gut bewertest:
"i built a scoring model in our crm that weights support ticket sentiment way heavier than usage. not perfect but it flags accounts before they go quiet."
Ein anderer Kommentator im selben Thread schlug vor, den Ticket-Typ statt des Tons zu bewerten: ""how do i" tickets are healthy. "why does it" tickets at day 90 mean onboarding never landed" (Reddit). Das gefällt mir sehr. Genau so eine Regel würde ich am ersten Tag in einen Klassifikator packen.
Dann gibt es den schwersten Fall für einen Agenten, der nur antwortet: den Kunden, der sich nie meldet.
"if you have two high ARR clients, and one files support tickets and complaints regularly but is very engaged such that it's actually happy because of the responsiveness, and one that never files tickets and stews in silence, your strategy has to adapt accordingly."
Meta Business Agent reagiert nur. Er kann nicht von sich aus Kontakt aufnehmen (das habe ich in meinem Beitrag zum Kunden-Onboarding behandelt). Das heißt: Schweigen erzeugt gar keine WhatsApp-Daten. Dein Health-Modell braucht neben den Konversationssignalen auch Produktnutzungs- und Abrechnungsdaten sowie Kontosignale, und hier kommen Customer-Success-Tools ins Spiel.
Metas Grenzen beim Health-Monitoring
Für ein kleines Unternehmen, das in WhatsApp lebt, ist Meta Business Agent eine vernünftige erste Linie, und ich habe ihn auch neben Zendesk, Freshdesk und HubSpot behandelt. Speziell für Health-Monitoring würde ich diese Grenzen abwägen:
- Kein Stimmungs- oder Abwanderungsscore pro Kunde. Alles oberhalb der Rohsignal-Ebene baust du selbst.
- Kein Transkript-Export. Standby-Webhooks sind der einzige programmatische Weg, und nur wenn das Unternehmen sie einschaltet.
- Tests bewerten Simulationen, keine echten Chats. Agent Eval liefert Scores von 1 bis 5 und Top-Fehlerkategorien, aber für Konversationen mit einem "user simulator", nicht mit deinen echten Kunden.
- Eine KI pro Nummer. "An active authorized-agent integration blocks Meta Business Agent" (Überblick). Du kannst keine zweite KI auf derselben Leitung laufen lassen, die die erste beobachtet.
- Meta behält sich eine weitreichende Lizenz an den Inhalten vor. Die Business-Agent-Bedingungen gewähren eine "perpetual, worldwide" Lizenz an Eingaben, und nach einer Übergabe kann der Agent "may continue to observe the content being shared in the chat". Die Antworten deines Teams in eskalierten Threads zählen ebenfalls.
- WhatsApp deckt nur WhatsApp ab. Ein Kunde, der sich auf WhatsApp beschwert, dann eine E-Mail schreibt und ein Ticket öffnet, erscheint als drei Fremde, solange du sie nicht selbst zusammenführst.
Ein Setup, das funktioniert
Wenn WhatsApp ein wichtiger Kanal ist und du Metas Agent an die Front stellen willst, würde ich ungefähr so aufbauen:
- Aktiviere Standby von Anfang an und speichere jedes eingehende, Echo- und Status-Ereignis, geschlüsselt nach der Business-Scoped-User-ID des Kunden. Behandle das als deine maßgebliche Transkriptquelle.
- Schreibe Eskalationsauslöser als Liste in die Anweisungen des Agenten, einschließlich "asked twice for a person" und "third contact about the same order". Zähle jedes
control_passedvon der KI als Health-Ereignis. - Klassifiziere jede abgeschlossene Konversation in ein kleines, festes Schema: Thema, Ticket-Typ ("how do I" vs. "why does it"), Stimmung, gelöst oder nicht. Nutze dafür deine Helpdesk-KI oder Muse Sparks Standard-Tier.
- Alarmiere bei Gelb, für die Telefonnummer und jedes Template, sowie bei Connector-Fehlern. Das sind zwei Signale, die Meta berechnet und die du auf deiner Seite nicht nachrechnen kannst.
- Frage CSAT pro Interaktion ab, mit Messengers Feedback-Template oder einem WhatsApp-Utility-Template, das an eine bestimmte Bestellung gebunden ist, und verknüpfe es in deinem CRM mit Produktnutzungs- und Abrechnungsdaten.
Und behalte bei den Markierungen einen Menschen im Loop. Ein Skeptiker in r/CustomerSuccess fragte, ob KI-Health-Analyse "reliable enough to trust blindly or you have to crosscheck ?" (Reddit). Meine Antwort: gegenprüfen.
Mehr dazu findest du in meinen Anleitungen zum Messen der Kundenstimmung, zum Tagging von Support-Tickets und zu einem Voice-of-Customer-Programm.
Mein Schwesterbeitrag zu Grok Bot behandelt dieselbe Aufgabe auf einem anderen Stack.
eesel für das Monitoring der Kundengesundheit ausprobieren
Metas Stack hinterlässt dir drei Aufgaben. Du erfasst die Konversationen und bewertest sie, und dann handelst du auf Basis des Scores. eesel ist ein KI-Helpdesk-Teammitglied, das alle drei Aufgaben in den Tools erledigt, die du bereits nutzt. Es verbindet sich mit WhatsApp in unter fünf Minuten.
Es funktioniert auch in Zendesk, Freshdesk und Gorgias, plus HubSpot, sodass Konversationen aus allen Kanälen an einem Ort landen.
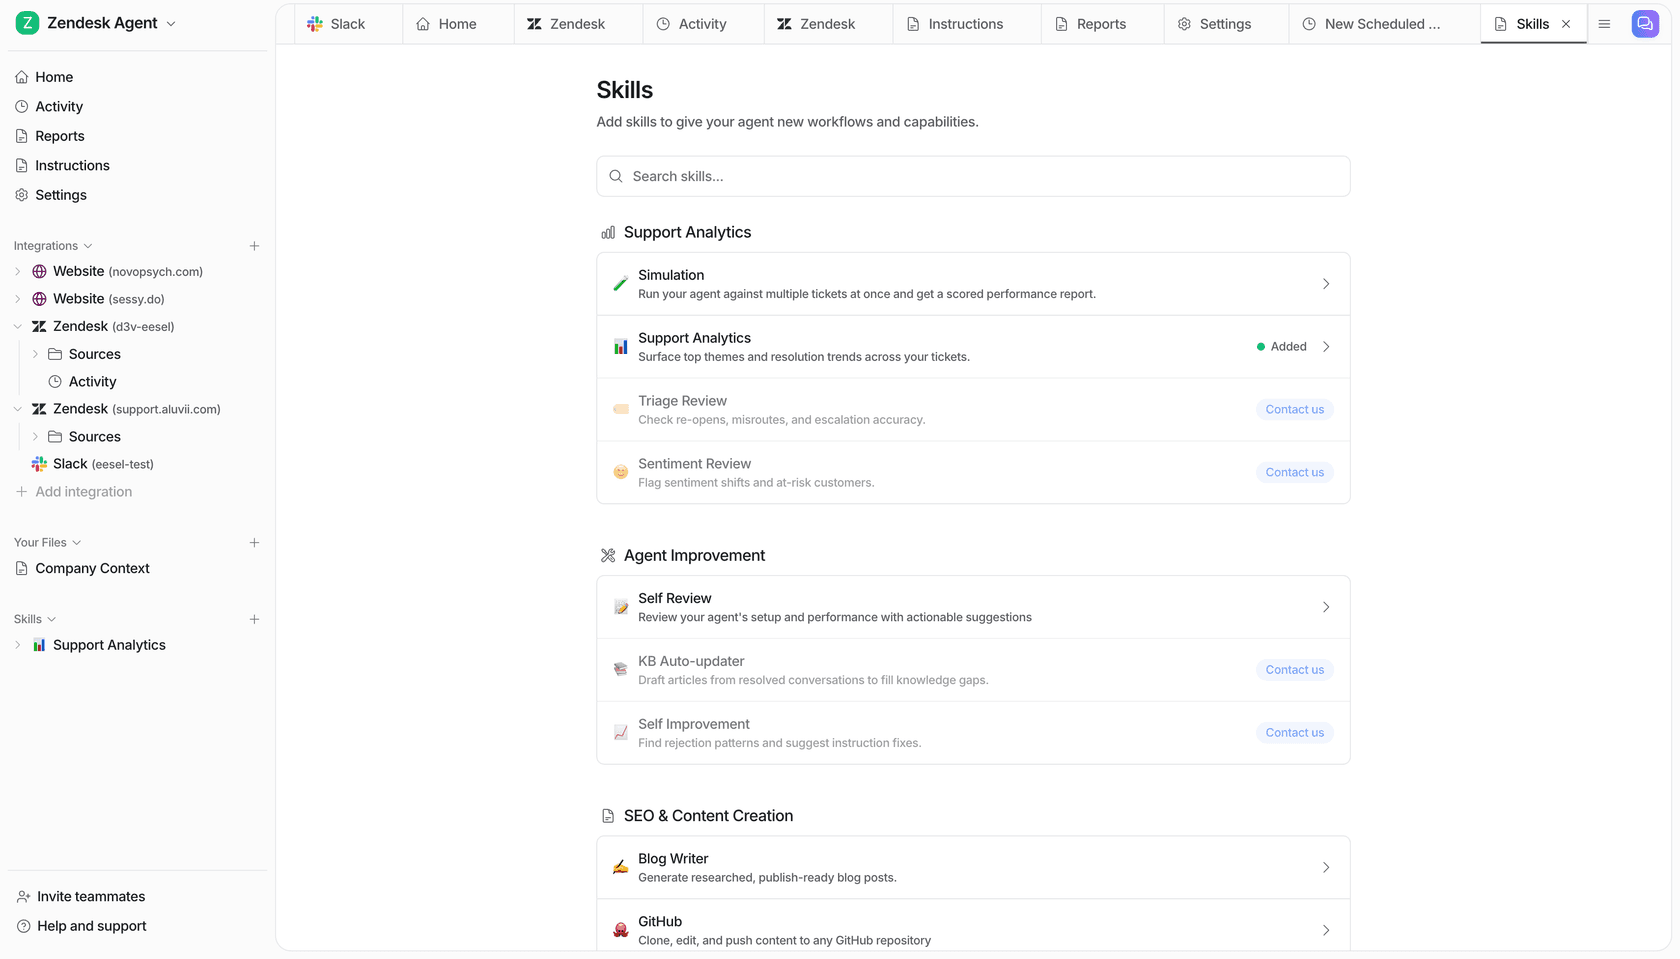
Bei jedem Ticket kann es die Konversation taggen, Felder wie die Priorität setzen, eine interne Notiz hinterlassen und nach deinen eigenen Anweisungen an einen Menschen weiterleiten, "for example low confidence or an angry customer" (eesel-Doku). Die Triage beginnt mit der ersten Nachricht des Kunden, bevor jemand geantwortet hat. Über Tickets hinweg berichtet der Ticket-Trends-Skill über "Recurring topics, sentiment, volume and resolution patterns", in einem Rhythmus deiner Wahl, etwa jeden Montagmorgen (Skills). Ein eigener Sentiment-Review-Skill für gefährdete Kunden ist auf Anfrage verfügbar.

Jede Aktion lässt sich auf automatisch oder freigabepflichtig setzen, und das Aktivitätsprotokoll zeigt, was der Agent gelesen hat und warum er etwas markiert hat. Das beantwortet die Frage "Kann ich dem blind vertrauen?" mit "Musst du nicht." Wenn du Markierungen lieber in dein eigenes Health-Modell leiten willst: Die eesel CLI gibt bei jedem Befehl JSON aus, sodass ein Skript oder ein Coding-Agent wie Claude Code Aktivitäten und Freigaben direkt in dein CRM ziehen kann.
Ein ehrlicher Hinweis, bevor du loslegst: Wegen Metas Regel "eine KI pro Nummer" würdest du auf einer WhatsApp-Nummer entweder eesel oder Meta Business Agent betreiben, nicht beides. Wenn WhatsApp dein einziger Kanal ist und du Entwickler hast, die die Scoring-Schicht bauen, sind Metas Agent plus Standby-Webhooks eine faire Wahl. Wenn Konversationen von überall kommen, sind eesels Preise ein fester monatlicher Credit-Plan mit einem kostenlosen Tarif mit 100 Credits und Plänen ab 299 $ für 500, und du kannst es an deinen vergangenen Tickets testen, bevor es mit irgendjemandem spricht.
Häufig gestellte Fragen
Kann ich Meta Muse für das Monitoring der Kundengesundheit nutzen?
Macht Meta Business Agent eine Stimmungsanalyse?
Wie bekomme ich Meta-Business-Agent-Transkripte in mein CRM?
Kann ich auf WhatsApp eine CSAT-Umfrage versenden?
Was sagt die WhatsApp-Qualitätsbewertung über die Kundengesundheit aus?
Kann ich Meta Business Agent dazu bringen, verärgerte Kunden zu eskalieren?
Was kostet Meta Muse für das Monitoring der Kundengesundheit?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.