

ステータスページ更新のAI活用は、逆向きにするのが最もうまくいきます。AIがステータスページに書くのではなく、ステータスページがAIに情報を渡すのです。ステータスページは、何が事実かについてエンジニアリングが合意した唯一の場所です。これを読むAIエージェントは、「止まっていますか?」のチケットをすべて宣言済みのインシデントに突き合わせ、掲載済みのテキストをそのまま返信し、ページがResolvedになったらチケットごとにフォローアップできます。
ステータス更新文そのものを書くのは、引き続き人の判断です。AIはインシデントチャンネルから下書きできますが、そのメッセージは全顧客に一斉に届くため、公開前にエンジニアが承認します。
仕組みはすでにあります。StatuspageはStartupプランの$99からインシデント更新のたびにWebhookを送り、ZendeskとFreshdeskはどちらも障害チケットをグループ化しますが、障害の最中に返信を書いてくれるものはありません。その隙間が、eeselのようなAIチームメイトの仕事です。SE Rankingは、チームが守れない約束を決してしないよう設定したエージェントを、月4,650件の会話で運用しています。
なぜステータスページはサポートの受信箱より遅れるのか?
私はeeselで連携機能を作っているため、マーケティングページの説明ではなく、APIやWebhookが実際に何を送るのかを読む時間が長くなります。ステータスページはその好例です。主要なステータスページツールはどれも、インシデントが更新されるたびに、購読するあらゆる相手へ通知します。ほとんどのヘルプデスクは購読していません。
そのため障害中には、2つの時計が同時に進みます。エンジニアリングは問題を直し、手が空いたときに更新を投稿します。サポートは同じ質問が50通りの言い回しで届くのを見ながら、各担当者がSlack、ステータスページ、同僚を確認して、何を言ってよいかを探っています。Hacker Newsのコメント投稿者は、顧客側の事情をこう端的に述べました。
"If I'm having issues but you show all green, I'm submitting a case."

しかも遅れは現実のものです。ホスティング事業者の障害について、別の投稿者はこう述べています。
"they only updated the status page to indicate that there's an issue ~20 minutes into the outage."
サポートのキューにとって20分は長く、初回応答時間に響きます。多くのチームが選ぶ対策は「AIでステータス更新をもっと速く書く」ことです。私はそれは小さい方の問題を解くだけだと考えます。大きい問題は、ステータスページとヘルプデスクが互いに連携していないことで、そのせいで担当者全員が両者をつなぐ人間の中継役になっていることです。私の障害時サポートガイドを読んだ方へ。この記事はその土台となる配線の話、つまりステータスページをAIの情報源にする方法です。
AIとステータスページはどう連携させるべきか?
私が組むパターンは5つのステップで、AIが新しく何かを書くのはそのうち1つだけです。
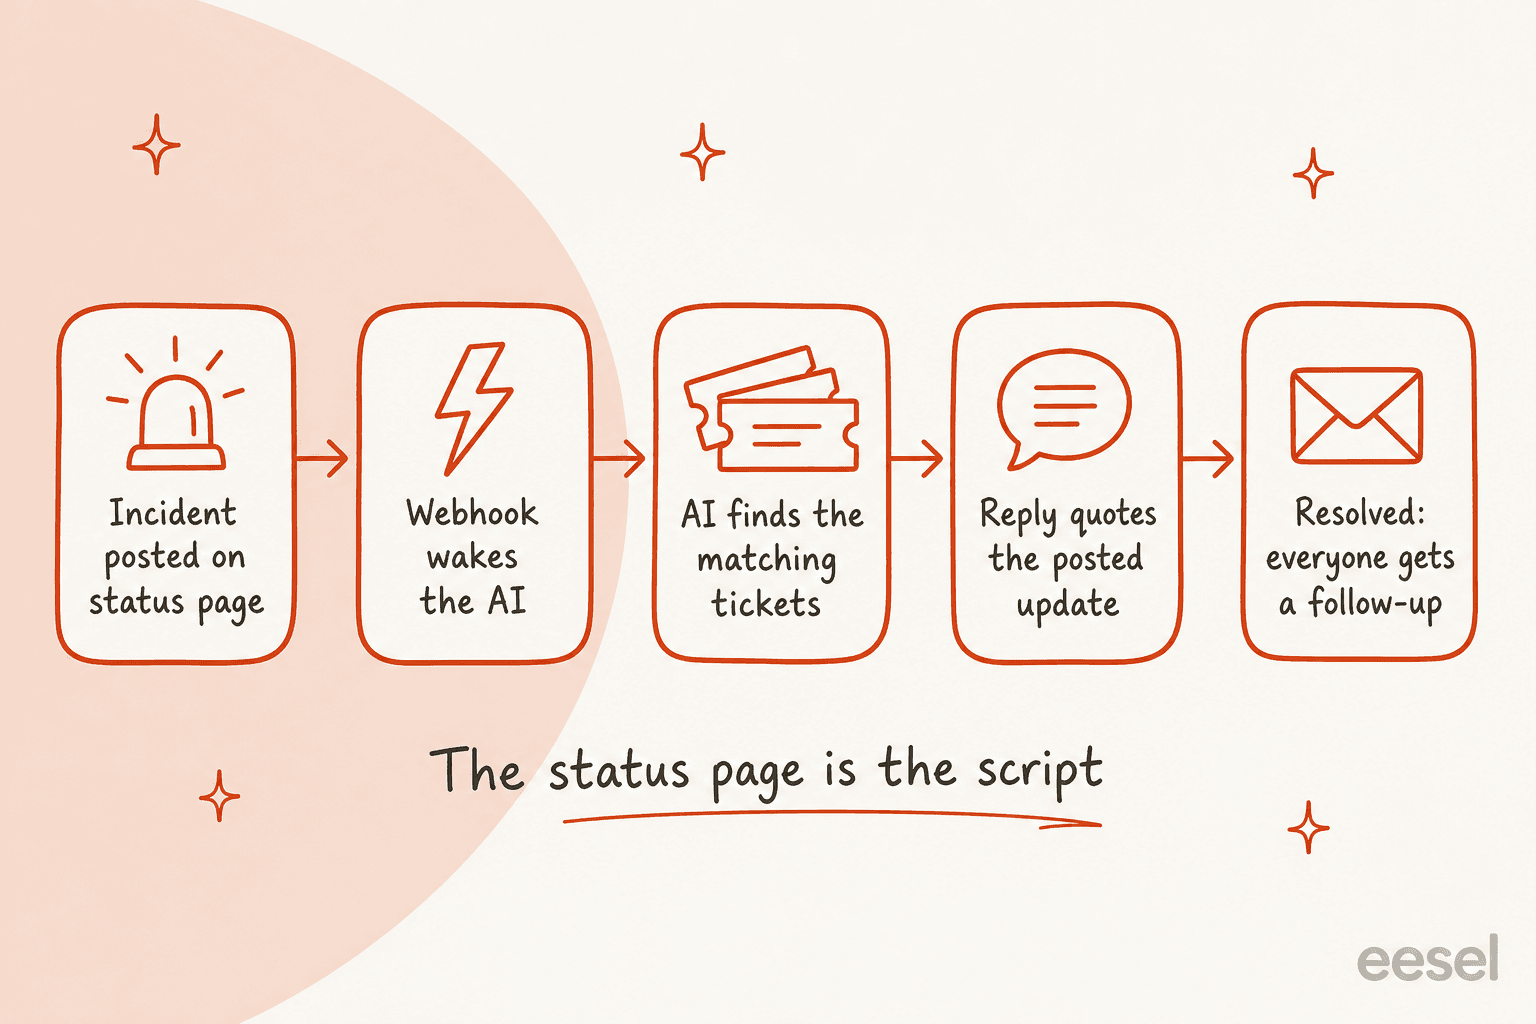
- エンジニアがインシデントを投稿する。 Atlassian Statuspageでは、名前、4つのステータス(Investigating、Identified、Monitoring、Resolved)のいずれか、メッセージ、影響を受けるコンポーネントです。
- ステータスページがAIに知らせる。 作成や更新のたびにWebhookが発火し、AIがインシデント名、ステータス、メッセージ、コンポーネントを読み取ります。
- AIが該当チケットを探す。 影響を受けるコンポーネントについて書かれた新規・未解決のチケットにインシデントのタグを付けます。チケットの重複排除が繰り返しの質問をまとめるのと似ています。
- 返信はステータスページを引用する。 顧客には、掲載済みのメッセージとリンクだけが届き、エンジニアが書いていないことは含まれません。
- Resolvedでループが閉じる。 ステータスがResolvedになると、タグ付きのすべてのチケットにフォローアップが送られます。やり取りが途絶えたものも含みます。
この順序が重要なのは、障害について何が事実かをAIが決めることがないからです。AIが決めるのは、どのチケットが障害についてのものかという仕分けで、AIが得意とする作業です。事実はページから来ます。
ステータスページのWebhookとAPIは実際に何を送るのか?
ここが私が最も重視する部分です。カスタムコードなしで何を作れるかが決まるからです。
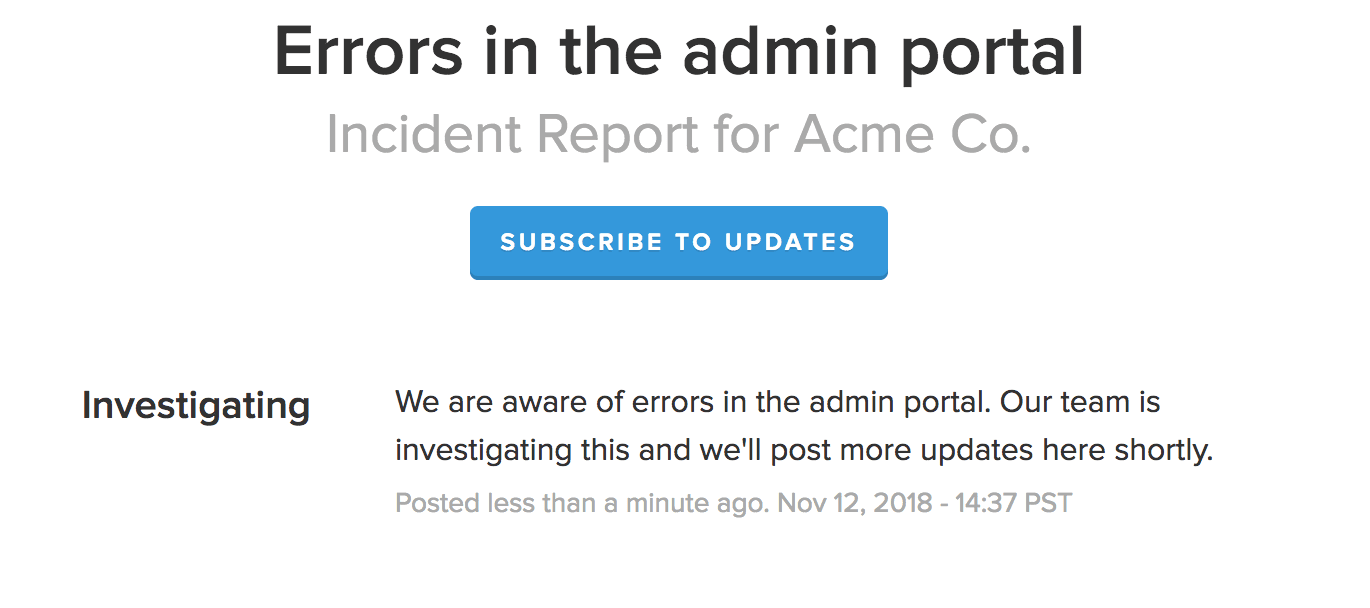
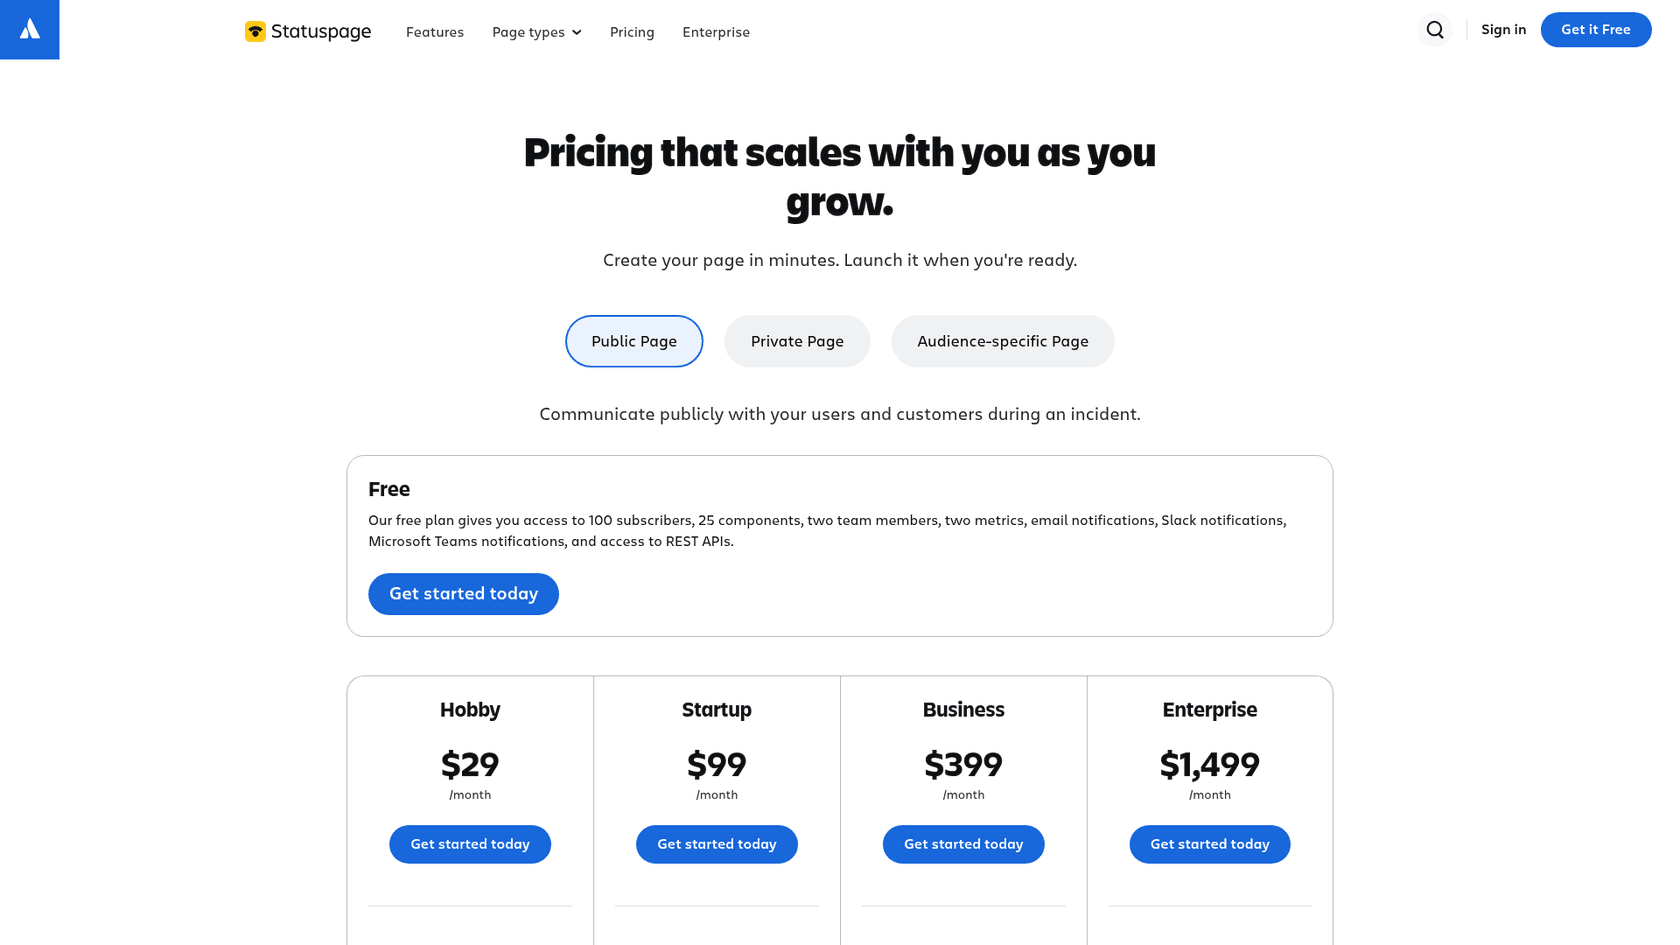
Atlassian Statuspageは、Webhook通知のガイドによれば、"when you create or update an incident, or update a component status"にWebhookを送れます。ペイロードには、ページ全体のステータス、変化したコンポーネントとその新旧ステータス、またはインシデントとその最新の更新が含まれます。エンドポイントは30秒以内に2xxコードで応答する必要があります。Webhook通知はStartupプランの月額$99から使え、FreeとHobbyで挙げられているのはメール、Slack、Teamsだけです。
読み取り側もあります。Statuspageの公開ページはどれも、ステータスのインジケーター、コンポーネントのステータス、未解決のインシデントを含むサマリーエンドポイントを、キー不要で公開しています。認証付きのStatuspage REST APIではインシデントの作成と更新ができ、上限はトークンあたり毎秒1リクエストです。この上限は更新の投稿には十分ですが、忙しいヘルプデスクからのポーリングには向きません。
incident.ioはステータスページをインシデントのワークフローに組み込んでおり、ステータスページの紹介ページによれば、"you're prompted to post when it matters most"で、"automate updates entirely or use templates with pre-approved messaging"もできます。顧客はメール、Slack、RSSで購読します。
PagerDutyは、外部ステータスページでは訪問者が"via email, Slack or webhook"で購読できるとしており、Statuspageと同じプッシュのトリガーが得られます。
eeselでの構成では、プッシュはWebhookオートメーションになります。エージェントにURLを頼み、それをステータスページにWebhook購読者として貼り付けると、インシデントが更新されるたびに、完全なペイロードとともにエージェントが起動します。インシデントIDを設定したX-Eesel-Referenceのような配信ヘッダーを使うと、1つのインシデントの全更新がActivityページでまとまります。プッシュできないページには、Network AccessでエージェントがステータスページのAPIを直接呼び出せます。キーは設定に保管され、AIには見えません。
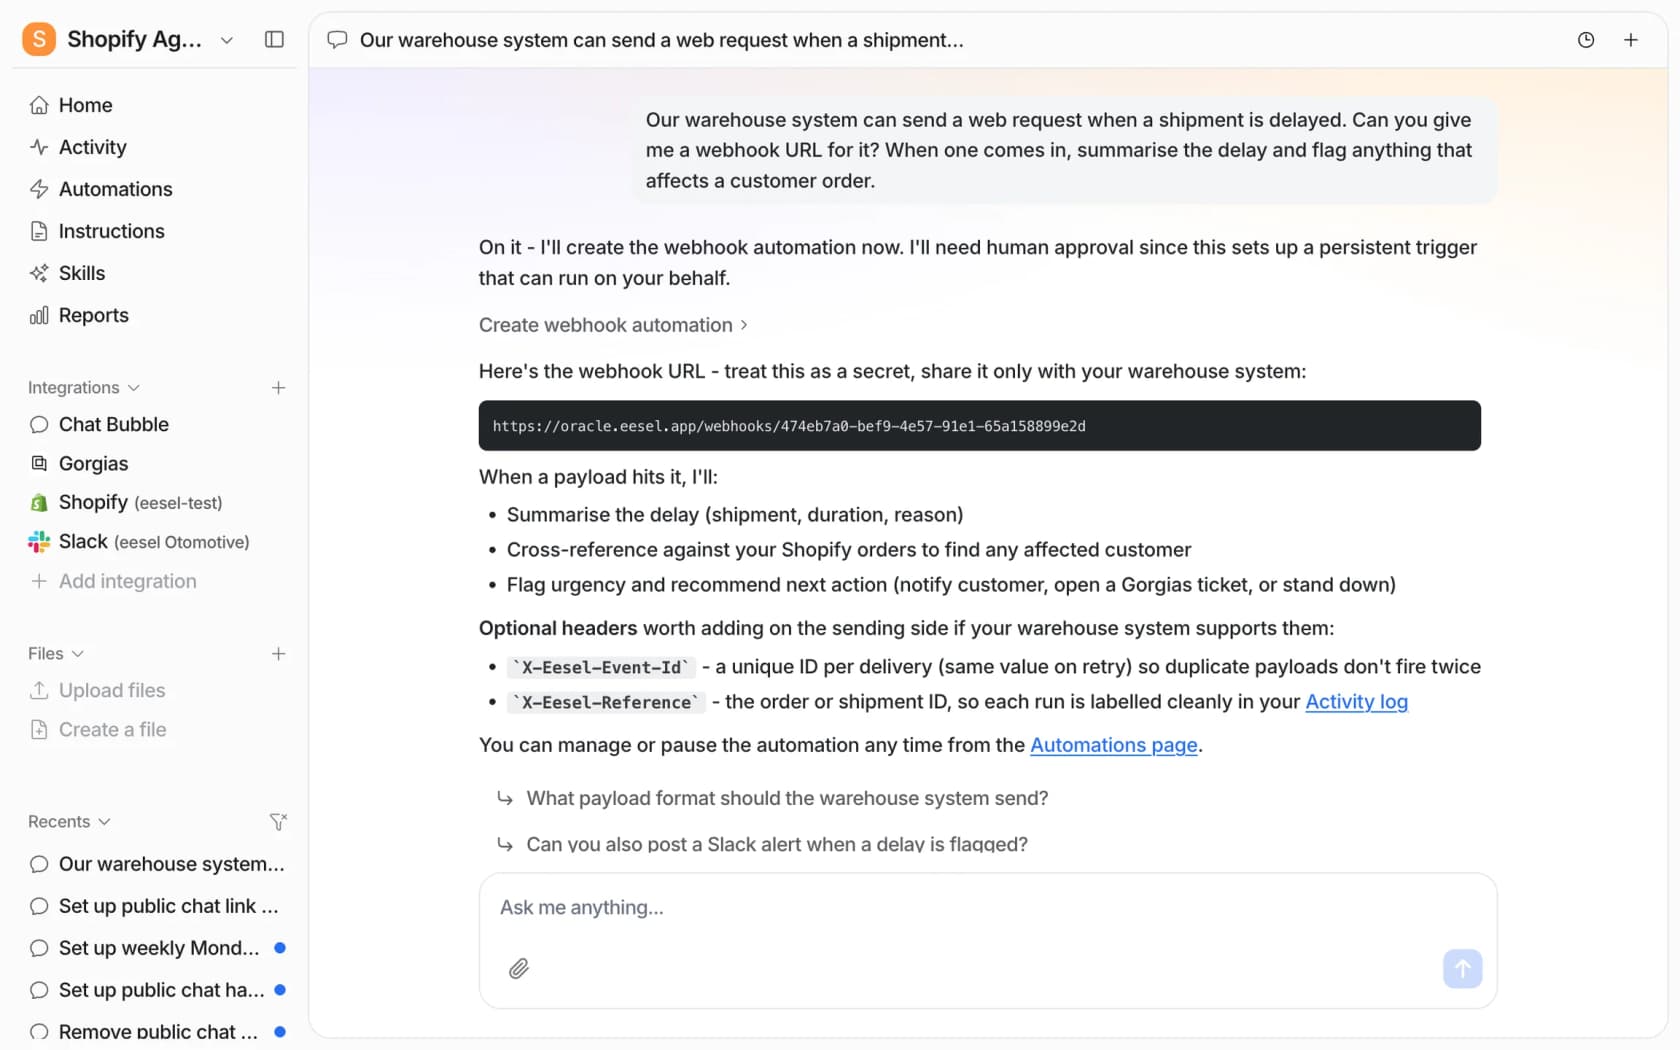
インシデントの最中ではなく、その前に知っておきたい制限が2つあります。eeselのWebhook URLは、ワークスペースあたり毎分60件の配信を受け付け、同時に8件を処理します。ステータスページが1回のインシデントで送る更新は数件なので十分ですが、監視ツールの生のアラートの流れを直接つなぐべきでない理由でもあります。供給するのは、人が確認したインシデントであって、一瞬の揺らぎすべてではありません。
AIは障害チケットをどう仕分けるべきか?
どのインシデントが進行中かをAIが把握すれば、届くチケットはすべて4つのレーンのどれかに振り分けられます。価値の大半はここにあり、多くの構成が大雑把すぎるのもここです。
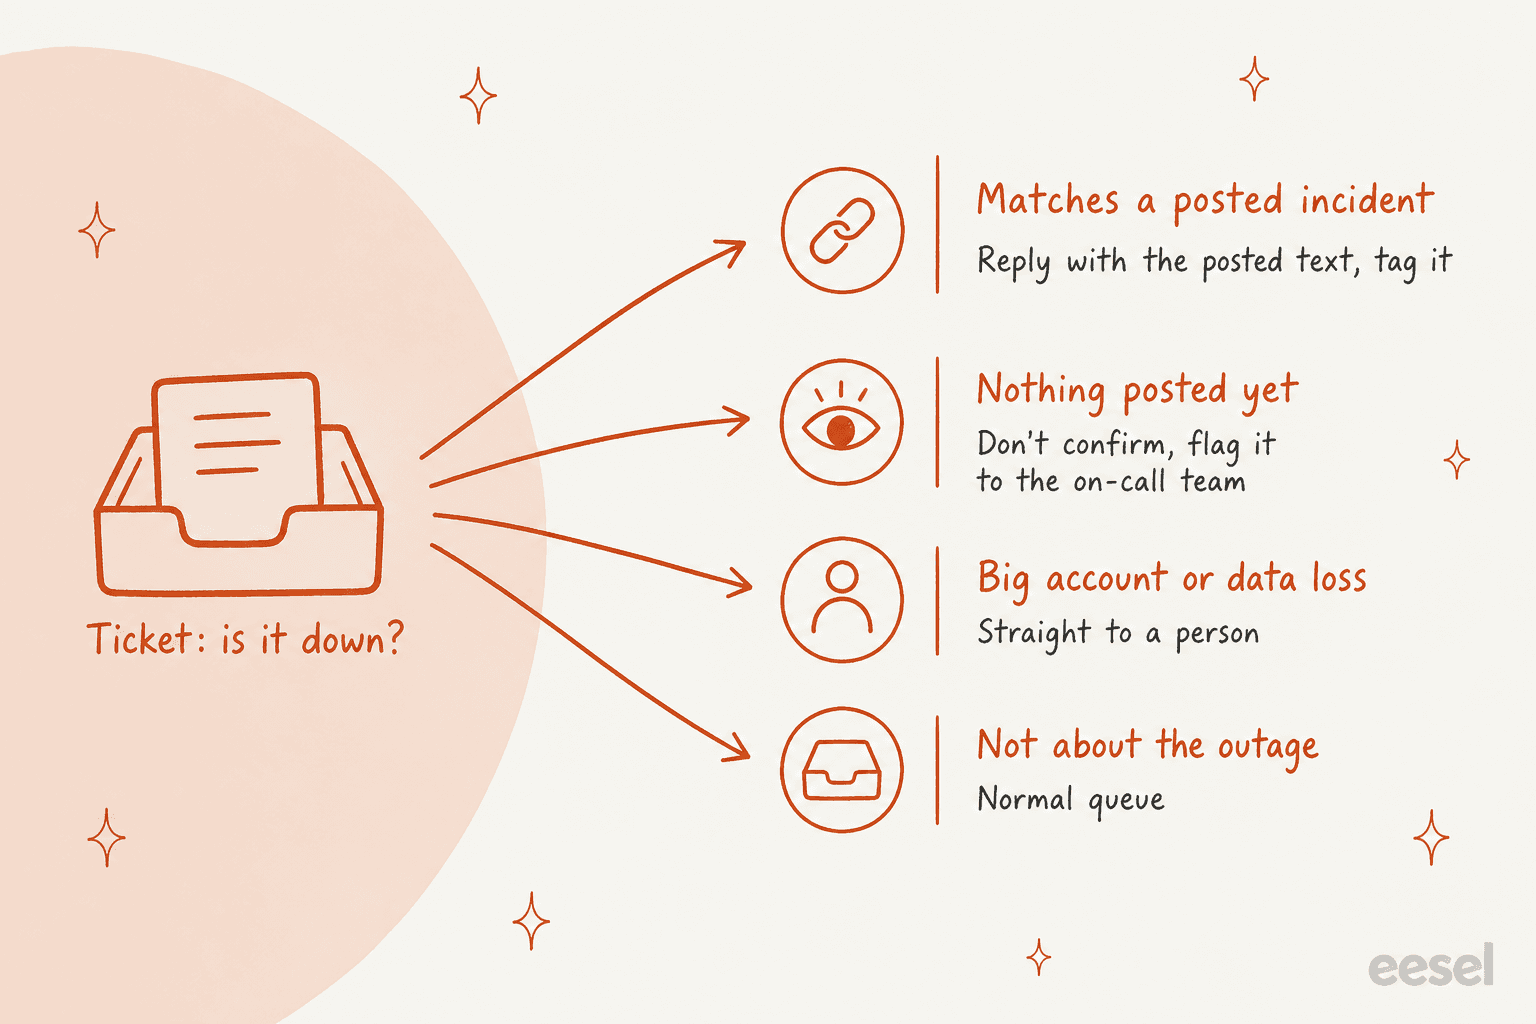
掲載済みのインシデントに一致する。 チケットが、影響を受けるコンポーネントやインシデントが説明する症状に触れています。AIは最新の掲載メッセージで返信し、ステータスページへのリンクを添え、解決したらチケットを更新すると伝え、インシデントのタグを付けます。これが最も件数の多いレーンで、最初に自動化すべきものです。初回応答の自動化と同じ考え方です。
まだ何も掲載されていない。 顧客はページより先に気づくことがよくあります。この場合、AIは障害を確認してはいけません。確認する根拠がないからです。チームが調査中だと伝え、チケットにタグを付け、当番チャンネルにアラートを投稿できます。インシデント未掲載のまま10分間にチェックアウトの件が5件届けば、それは早期警戒です。たいていサポートが最初に気づきます。インシデントが掲載されたら、AIはこれらのチケットに戻って、そちらにも回答します。
大口アカウントやデータ損失。 返信がどれほど正確でも、テンプレートの返信を送るべきでないチケットがあります。指名されたエンタープライズアカウント、データ損失を報告する人、SLAに言及する人、クレジットを求める人です。これらは通常のAIエスカレーションルールで担当者に回します。Freshdesk上でeeselを使うERPソフトウェア会社のQontroは、障害、データ損失、請求の質問を、AIにトラブルシューティングさせず担当者に直接回しています。
障害とは無関係。 インシデントの最中に届いた請求の質問は、やはり請求の質問です。通常のキューに入り、タイミングが重なっただけでAIがインシデントの文面を貼り付けてはいけません。テストではここに注意してください。最もよくある誤一致で、誤検知を減らす方法で扱った失敗と同じです。
障害中にAIは何を言ってよく、何を言ってはいけないのか?
ルールは短く、顧客を落ち着かせるAIと、2つ目のインシデントを生むAIとの分かれ目になります。
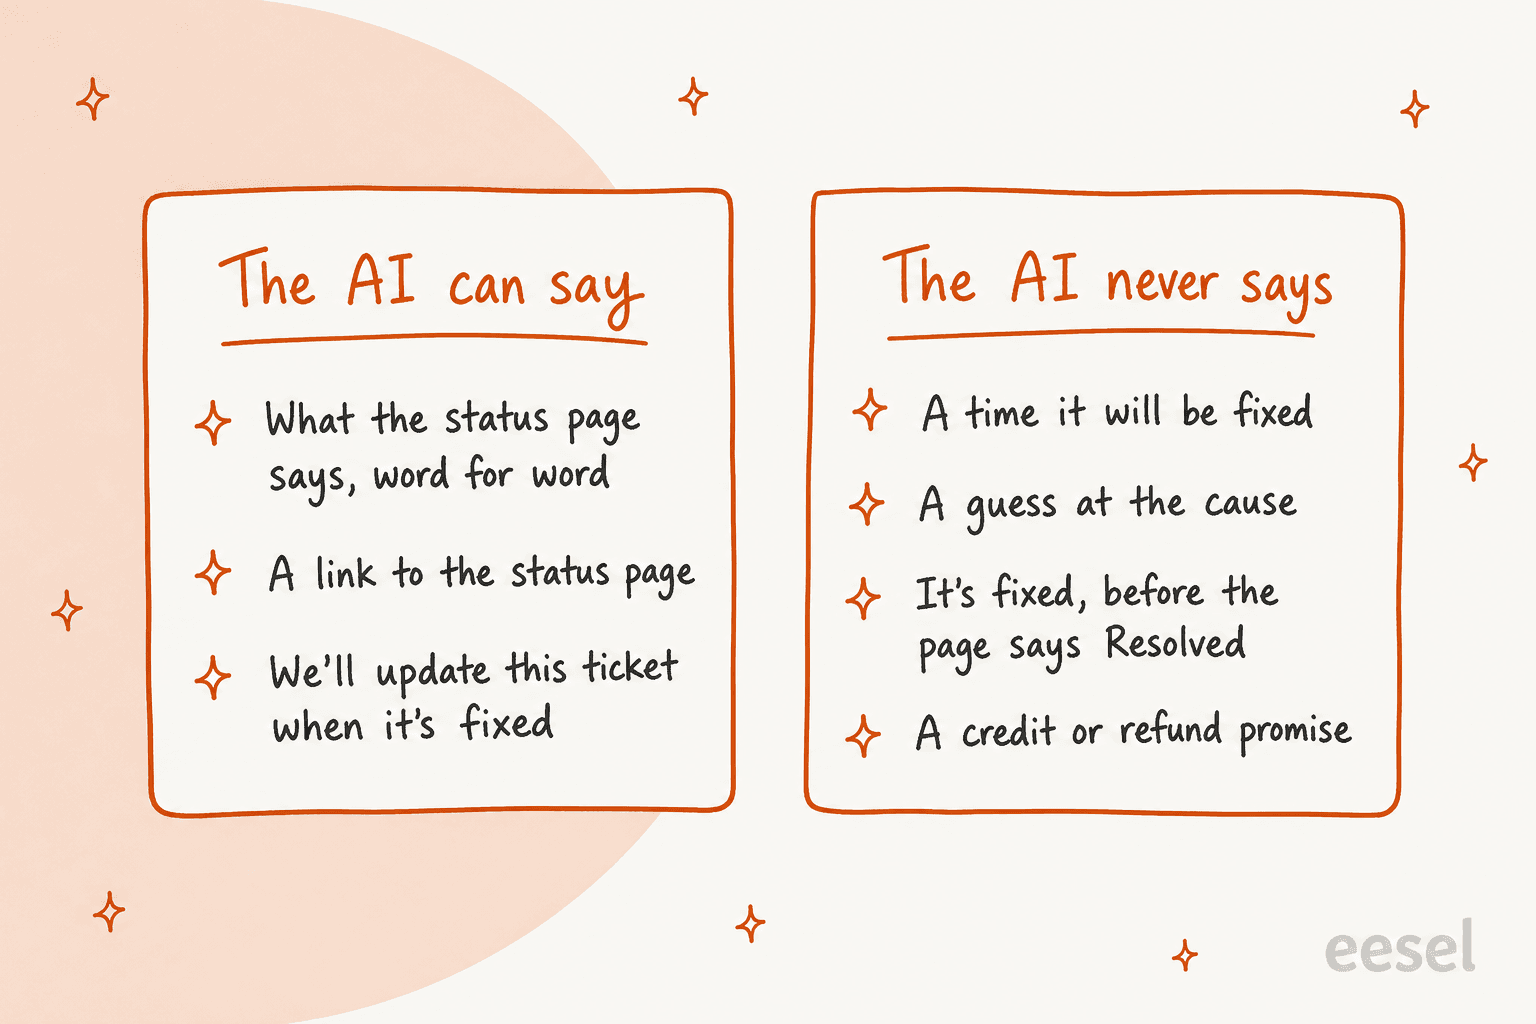
「言わない」リストが守るのは1点だけです。AIはエンジニアリングが行った約束しか繰り返せません。「いつ復旧しますか?」と聞かれたモデルは、それらしい時刻を平気で作り出します。それはタイムスタンプ付きのAIハルシネーションです。根本原因も同じです。Statuspageの「Identified」でさえ、チームが原因を突き止めたという意味であって、共有したという意味ではありません。
ここで参考にしたいのが、SE Rankingのエージェントの設定です。チームはライブチャットに即座に答えてほしい一方で、"without the bot promising things the team could not deliver."を望みました。そこでeeselのエージェントは、顧客に1〜2営業日での返信を案内し、担当者が今すぐ加わるとは決して言いません。障害でもこれが正しい発想です。遅くても本当の答えは、速くても作り話の答えに勝ります。
AIに自由に書かせるのではなく、AIが埋める固定テンプレートとして返信を用意するのも有効です。
| ページ上のステータス | AIの返信に含める内容 |
|---|---|
| Investigating | 掲載済みのメッセージ、ステータスページへのリンク、「解決したらこのチケットを更新します」 |
| Identified | 新しい掲載済みのメッセージ、リンク、同じフォローアップの約束 |
| Monitoring | 掲載済みのメッセージ、修正を適用し経過を見ているという注記。「直りました」はまだ書かない |
| Resolved | 解決のメッセージ、問題が続く場合は返信してほしいという依頼、その後チケットを解決済みにする |
ZendeskとFreshdeskは現在、障害チケットをどう扱っているのか?
ヘルプデスクには何年も前から障害向けの機能があります。チケットのグループ化はうまくできます。できないのは顧客向けの返信を書くことで、AIが入り込む余地はその細部にあります。
Zendeskには問題チケットとインシデントチケットがあります。すべての報告を1つの問題チケットにリンクし、問題を解決するとインシデントが解決され、未解決の各チケットに最後のコメントがコピーされます。Suite Team以上で利用できます。Zendesk自身の記事にある2つの制限がここで重要です。"AI agent tickets can't be linked to problem and incident tickets"、そして問題が解決されたとき、"Customers are not notified using the messaging channel."です。つまり、ZendeskのAIエージェント自身が処理したチケットや、メッセージングで連絡した顧客は、締めくくりの更新を受け取れない可能性があります。設定はZendeskのチケットタイプのガイドで扱っており、オートメーションでタイプを自動設定することもできます。
Freshdeskにはリンクされたチケットがあり、報告を「トラッカー」チケットの下にまとめます。Freshdesk自身の例は"your product is facing some unexpected downtime."です。トラッカーへのコメントはリンクされたすべてのチケットに配信されますが、"the internal broadcast message will be visible only to agents"のため、顧客への返信は担当者が1件ずつ書くことになります。またトラッカーを解決しても、Freshdeskのよくある質問によれば"would not resolve the linked tickets by default"です。
まとめると、ヘルプデスクが提供するのはグループ化です。AIの仕事はその間の部分、つまりどのチケットがどのインシデントに属するかを判断し、ステータスページの文面から顧客向けの返信を書くことです。Zendeskでは、インシデントチケット自体にAIが書き込むようにすれば、チケットは通常のチケットのままなので、"AI agent tickets can't be linked"という制限も回避できます。
ステータスページ用ツールの費用はいくらか?
各ツールの料金を、2026-10-30時点のそれぞれの料金ページに基づいて示します。ステータスページは通常、安い部分です。チームを驚かせるのはヘルプデスク側の費用で、それは次に扱います。
| ツールとプラン | 価格 | 購読者 | Webhook送信 | AI機能 |
|---|---|---|---|---|
| Statuspage Free | $0 | 100 | なし(メール、Slack、Teams) | 記載なし |
| Statuspage Hobby | $29/月 | 250 | なし | 記載なし |
| Statuspage Startup | $99/月 | 1,000 | あり | 記載なし |
| Statuspage Business | $399/月 | 5,000 | あり、コンポーネント購読も | 記載なし |
| Statuspage Enterprise | $1,499/月 | 25,000 | あり | 記載なし |
| incident.io Basic | 無料 | 無制限、公開ページ1つ | メール、Slack、RSS | 基本的なポストモーテムエディター |
| incident.io Team | ユーザーあたり$15/月(年払い)、月払いは$19 | 無制限 | メール、Slack、RSS | 基本的なポストモーテムエディター、ワークフロー |
| incident.io Pro | ユーザーあたり$25/月 | 無制限、内部ページ1つ追加 | メール、Slack、RSS | AIネイティブのポストモーテム |
| PagerDuty Free | $0 | ステータスページなし | n/a | n/a |
| PagerDuty Professional | ユーザーあたり$21/月(年払い)、月払いは$25 | 外部ページに250、Status Pagesアドオンでさらに追加 | あり(メール、Slack、Webhook) | PagerDuty AdvanceによるAIインシデント事後レビュー |
| PagerDuty Reliability Platform Starter | $2,800/年 | 含まれる | あり | 含まれる |
私の見立てはこうです。オンコール用にすでにincident.ioやPagerDutyを使っているなら、手元のステータスページをそのまま使えばよいでしょう。公開ページだけが必要でWebhookも欲しいなら、越えるべき線は$99のStatuspage Startupです。ただし、これらのツールはどれもチケットには答えてくれません。それは引き続きサポート側の仕事です。
1回の障害はサポート側にいくらかかるのか?
ここで料金モデルの違いが効いてきます。障害は、ほぼ同じ質問で構成されたサポートの急増であり、AIの料金体系によっては、その急増がそのまま請求になります。
ZendeskはAIエージェントを自動解決ごとに課金します。コミット契約なら1件$1.50、従量課金なら$2.00で、エージェントあたり月5〜10件の含まれる分を超えた場合です。FreshdeskはFreddy AI Agentのセッションを、初回限りの500件無料のあと100件あたり$49で販売しています。eeselの料金は毎月固定のクレジットのまとまりで、チケットまたはチャット1件が1クレジットです。500で$299から、5,000で$1,749までです。下のツールにご自身の障害の数字を入れてみてください。
重要なのは、どちらかのモデルが常に安いということではありません。解決ごとの料金だと、チームがすでに最も負荷のかかっている日である障害が、コストの変動するイベントにもなる点です。製品にときどき悪い日があるなら、毎月固定のまとまりの方が予算を立てやすいでしょう。
ステータスページの更新文をAIに書かせるべきか?
下書きはできます。ただし公開までは任せません。ステータスページのメッセージは、全顧客に一斉に届く障害コミュニケーションの唯一のもので、その後のサポート返信はすべてこれを引用します。これが間違っていれば、その上に築いたものはすべて間違いになります。
ステータスページは自動更新されるのかという問いに答えたHacker Newsのコメント投稿者が、このトレードオフをうまく言い表していました。
"Typically no because there's an art to crafting the actual message around impact… but sometimes yes it is automated"
よい落としどころは、承認ステップ付きの下書きです。Statuspage REST APIは新しいインシデントや更新を単純なPOSTとして受け付けるため、api.statuspage.ioへのNetwork Accessを持つAIエージェントがインシデントチャンネルから更新を準備し、投稿前にエンジニアが承認できます。eeselでは、アクションをNeeds approvalに設定します。エージェントは止まり、正確な文面を表示して、ApproveかDenyを待ちます。インシデント側では、incident.ioのProプランにAIネイティブのポストモーテムエディターがあり、PagerDutyはAdvanceアドオンでAI生成のインシデント事後レビューを提供するため、事後の書き起こしはそこでカバーされます。
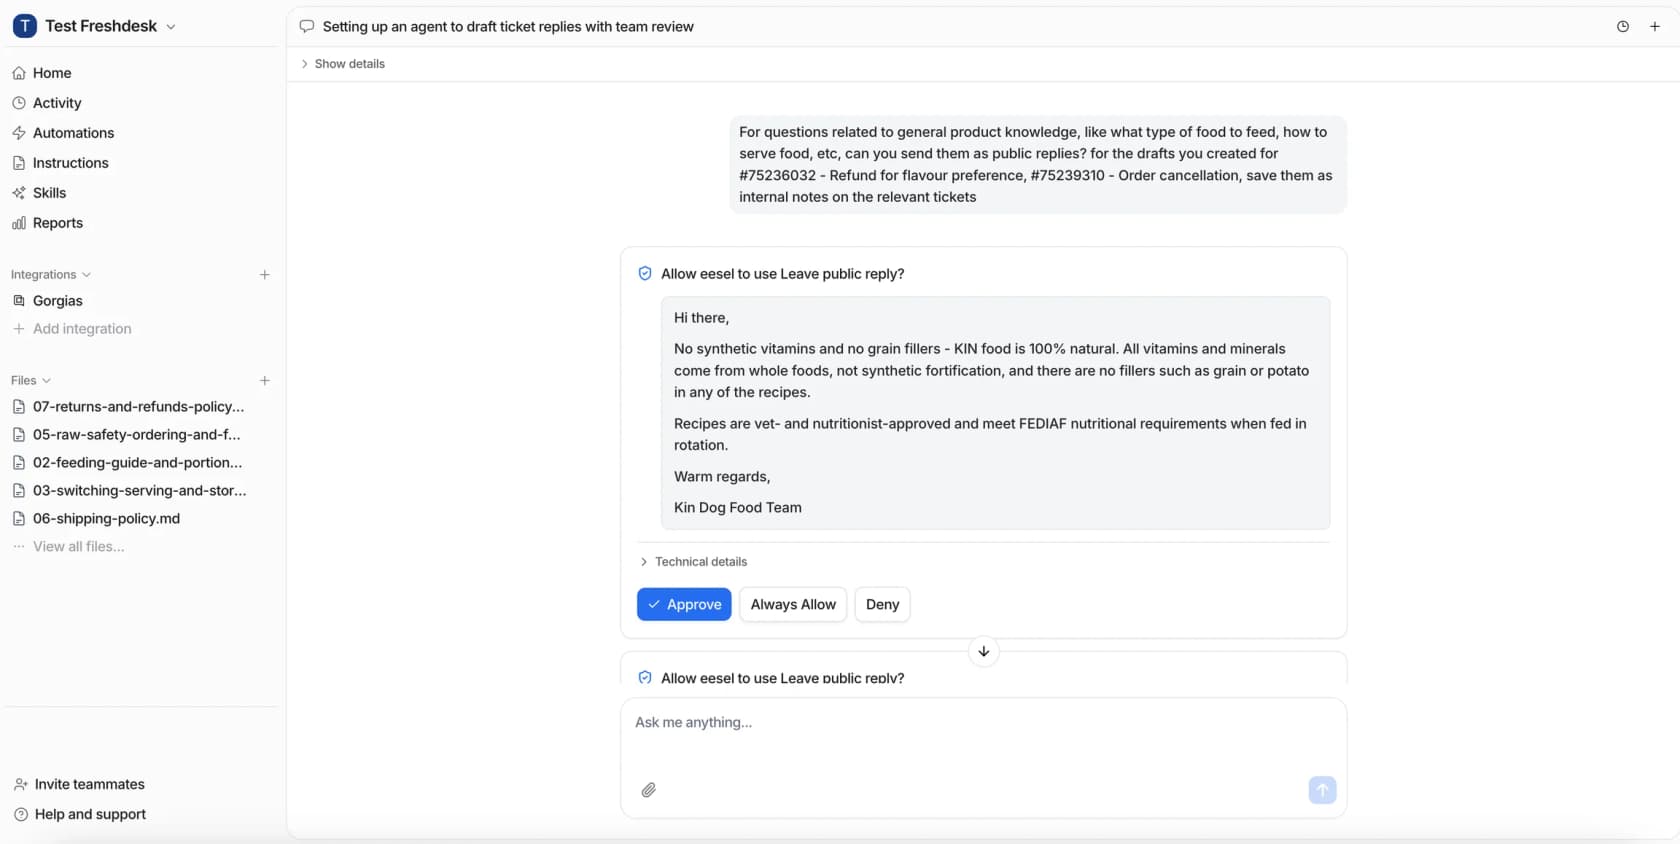
サポート側の返信も、私ならこの方法で始めます。Lesson Proは2つのZendeskアカウントでeeselを使い、1か月で1,700件の社内メモを残し、560件の返信を下書きしました。顧客に届く前にはチームが承認しています。障害時の返信を監督付きで始めても、最初のインシデントで数分かかるだけで、AIが送ったはずの内容が正確にわかります。
次の障害の前に、どう設定すればよいか?
設定には午後半日ほどかかります。インシデントの最中にやるとはるかに長くかかるので、私ならこの順序で進めます。
- 情報源を決める。 ステータスページは1つ、コンポーネント名も1セットにします。エンジニアリングとサポートでチェックアウトのサービスの呼び名が違うなら、先にそれを直します。AIはコンポーネントでチケットを突き合わせるからです。
- AIをページに購読させる。 Statuspage Startup以上、またはPagerDutyなら、エージェントのWebhook URLを購読者として追加します。そうでなければ、公開サマリーエンドポイントか、Network Access経由のベンダーAPIを使います。
- レーンを指示に書き込む。 上の4つのレーン、ステータスごとの返信テンプレート、「言わない」リスト。自動返信から外すエンタープライズアカウントとキーワードも明記します。
- タグとフォローアップのルールを決める。 障害ごとに1つのインシデントタグを付け、Resolvedで、タグ付きの全チケットへのフォローアップが走るルールにします。Zendeskなら、チケットを問題チケットにリンクすることもでき、手作業で閉じたい場合はステータスの一括更新もできます。
- 過去の障害でテストする。 直近の実際のインシデントのチケットを再生して、すべてのレーンを確認します。方法はシミュレーションテストのガイドにあります。「障害とは無関係」のレーンは特に注意して見てください。
- 下書きから始め、本番へ。 最初のインシデントでは公開返信をNeeds approvalにし、下書きが正しくなったら該当レーンをAutoに切り替えます。クレジットと返金は、常に承認の対象にします。
- 数える。 AIが処理した障害チケットすべてにタグを付けて、報告できるようにします。SE Rankingがeeselの触れたすべてのチケットに
ai_handledタグを求めたのは、"so containment is counted in Zendesk, not guessed."のためでした。残りはサポートレポートのガイドで扱っています。
ターミナルから設定したい場合や、コーディングエージェントにやらせたい場合は、eesel CLIがダッシュボードと同じエージェントを動かします。eesel automationsはWebhookオートメーションを一覧表示してオン・オフを切り替え、eesel activityは各インシデント更新に対してエージェントが何をしたかを表示し、eesel approvalsは担当者待ちの返信を一覧表示します。すべてのコマンドがJSONを出力し、書き込みには--dry-runオプションがあります。そのため、Claude Code、Cursor、Codexが設定全体を実行し、自分の結果を読み戻すこともできます。
障害チケットでeeselを試す
eeselはヘルプデスク向けのAIチームメイトで、障害チケットは最初の仕事として扱いやすいものです。ステータスページの各更新を読み取り、Zendesk、Freshdesk、Gorgiasにある「止まっていますか?」のチケットをインシデントに突き合わせ、掲載済みのテキストで返信し、ページがResolvedになったらすべてにフォローアップします。大口アカウントとデータ損失は、Qontroが障害チケットを回すのと同様に、チームに直接届きます。
まず承認をオンにした下書きから始め、直近の障害を再生して、信頼できると感じたら該当レーンをAutoに切り替えてください。プランは500チケットで月額$299からで、先に試せる100クレジットが無料で付きます。eeselを試す。