Codex Security Cloudとは?
Codex Securityは、OpenAI Codex内にあるOpenAIのアプリケーションセキュリティエージェントです。コードを読んで脅威モデルを作り、脆弱性を探し、1件ずつ検証し、修正案も提案します。Cloud版は2026年9月29日のDevDayで、接続したGitHubリポジトリに対してCodexクラウド上で動くプラグインとして登場しました。OpenAIのDevDayまとめによると、リポジトリ全体を「オンデマンドまたはスケジュールでスキャンし、新しいコミットも継続的にチェック」できます。ノートPCを閉じていても動くのは便利です。
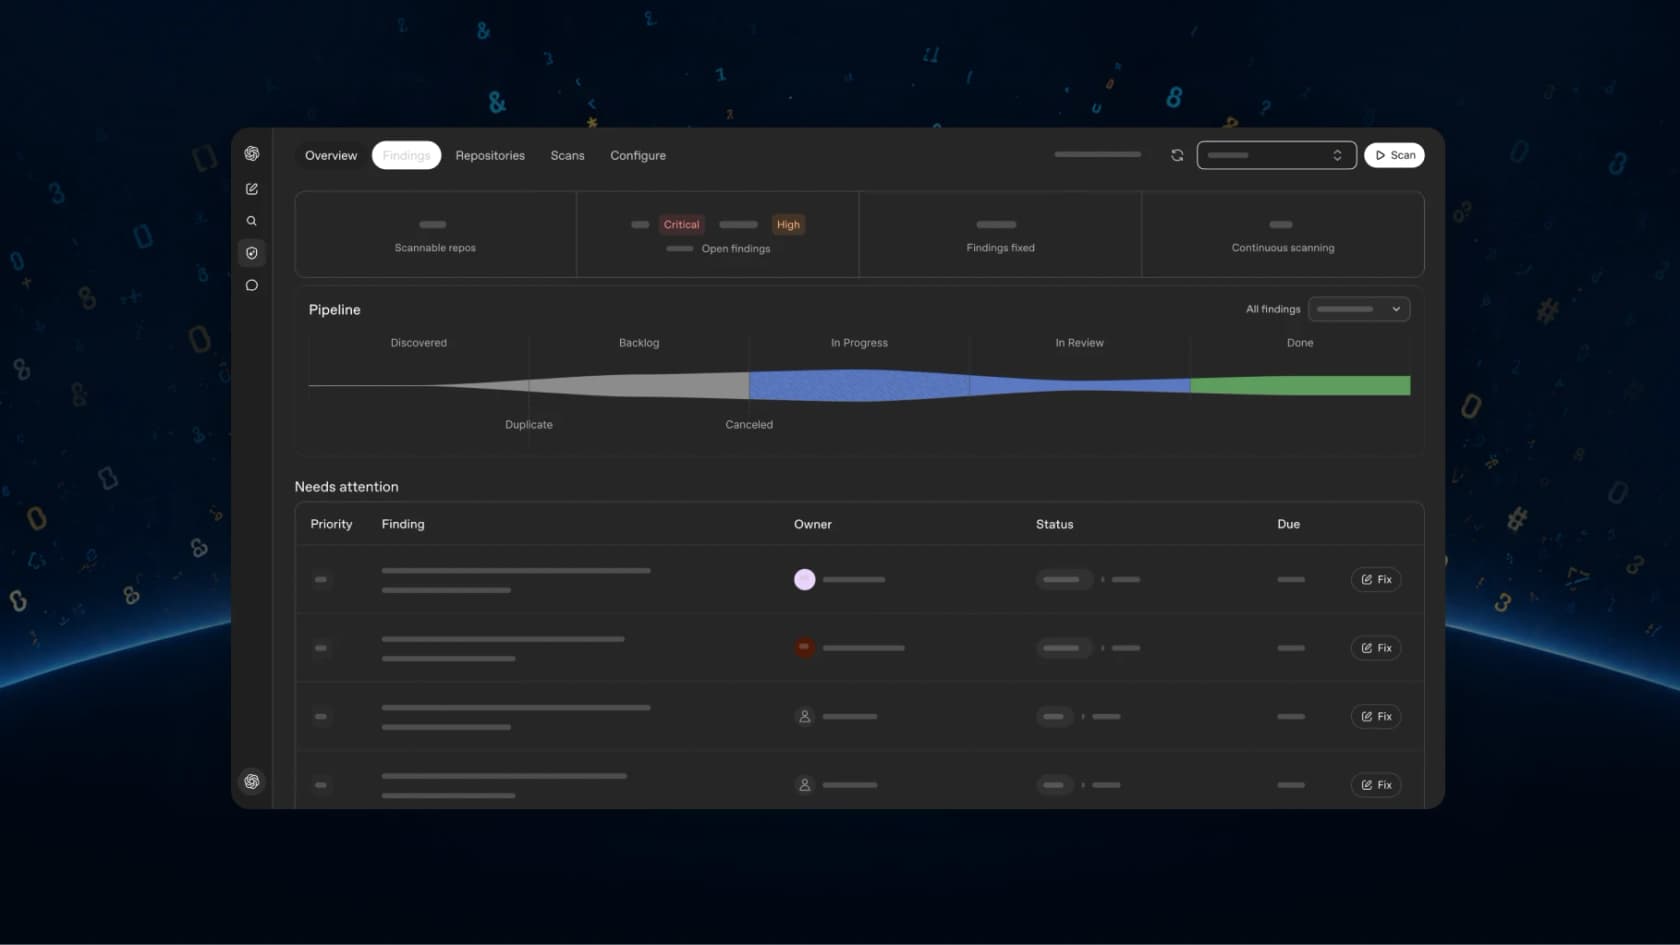
最大のアップグレードは、「別途Daybreakの申請なしで」使えるDaybreak Blueです。これはOpenAIが防御目的のセキュリティ作業向けに提供する、拒否を減らしたモデルです。これが重要なのは、Cloud登場前に最も多かった不満が検出の質ではなかったからです。30分かけて走ったスキャンが、最後に拒否されるという不満でした。BlueとRedの各ティアの仕組みは、GPT-5.6-Cyberの記事で解説しています。
機能を一通り知りたい方は、Codex Security Cloud解説記事をご覧ください。セットアップ、4つのインターフェース、Aardvarkまでさかのぼる経緯を紹介しています。この記事は評価編です。
テスト方法
Cloudプラグインを有効にしたチームワークスペースは持っていないので、最も近い代替手段を使いました。オープンソースのCodex Security CLIです。同じCodex Securityプラグインを同梱しており、ターミナルから同じパイプラインを実行できます。バージョン0.1.31をデフォルト設定で使いました。モデルはgpt-5.6-sol、推論強度はxhigh、標準スキャンモードで、OpenAI APIキーで認証しています。
テスト対象は、このために自作した小さな社内チケットAPIです。Flaskの1ファイルで約60行、加えて「社内ネットワークで動作する」と書いた1行のREADMEがあります。定番のバグを5つ仕込みました。
- SQLインジェクション:顧客のメールアドレスをクエリに連結しているチケット検索。
- パストラバーサル:ユーザーが指定したファイル名をフォルダーに結合している添付ファイルのダウンロード。
- コマンドインジェクション:
formatの値をシェルに渡す管理者用エクスポートルート。 - 認可の欠如:
# TODO: only admins should do thisというコメントが付いた削除ルート。 - 全インターフェースでのデバッグモード:
app.run(host="0.0.0.0", debug=True)。
どれも簡単なバグです。それがこのテストの狙いです。セキュリティエージェントが60行の中の教科書的なバグを見逃すなら、他のことはどうでもよくなります。検出できるなら、次に気になるのは、どれだけうまく説明できるか、そのためにいくらかかるかです。
テストには2つの制約があるので、結果の前に触れておきます。1つ目に、APIキーではDaybreak Blueが使えません。そのため標準のガードレールで実行しており、拒否に関してはCloudより厳しい設定です。2つ目に、CLIの標準スキャンはソースを追跡して指摘を検証しており、レポートには「no runtime query was executed」と書かれています。Cloudのドキュメントにはサンドボックスのコンテナーで再現を行うと説明されていますが、今回それは試せませんでした。
Codex Securityが見つけたもの
2回目の実行は8m 56sで、完全なカバレッジで終了しました。出力されたサマリーは次のとおりです。
FINDINGS  5 (5 confirmed this scan; 0 previously found; 2 high, 2 medium, 1 low)
COVERAGE  complete
ELAPSED   8m 56s
TOKENS    18,684 uncached input, 3,357,854 cache reads, 173,804 cache writes, 73,204 output, 3,623,546 total
COST      $3.7509776–$6.7699152 (standard, context unknown)
仕込んだバグと検出結果の対応は次のとおりです。
| 仕込んだバグ | 検出したか | 付けた深刻度 | 根拠 |
|---|---|---|---|
/admin/exportでのコマンドインジェクション | はい | High | 認証なしの1回のリクエストでコマンドを実行できる。社内アプリのためcriticalには引き上げず |
| 削除の認可欠如 | はい(全ルートに拡大) | High | どのルートもIDを確認しないため、ネットワーク上のどのクライアントもチケットを読み取り、変更、削除できる |
| 添付ファイルのパストラバーサル | はい | Medium | パスの脱出は直接的だが、影響はサービスアカウントが読めるファイル次第 |
| 検索でのSQLインジェクション | はい | Medium | PythonのSQLiteは一度に1文しか実行しないため、複文による書き込みはできず、データの読み取りのみ |
0.0.0.0でのdebug=True | はい | Low | デバッグ用エラーページが露出するが、コンソールのロック解除にはPINが必要 |
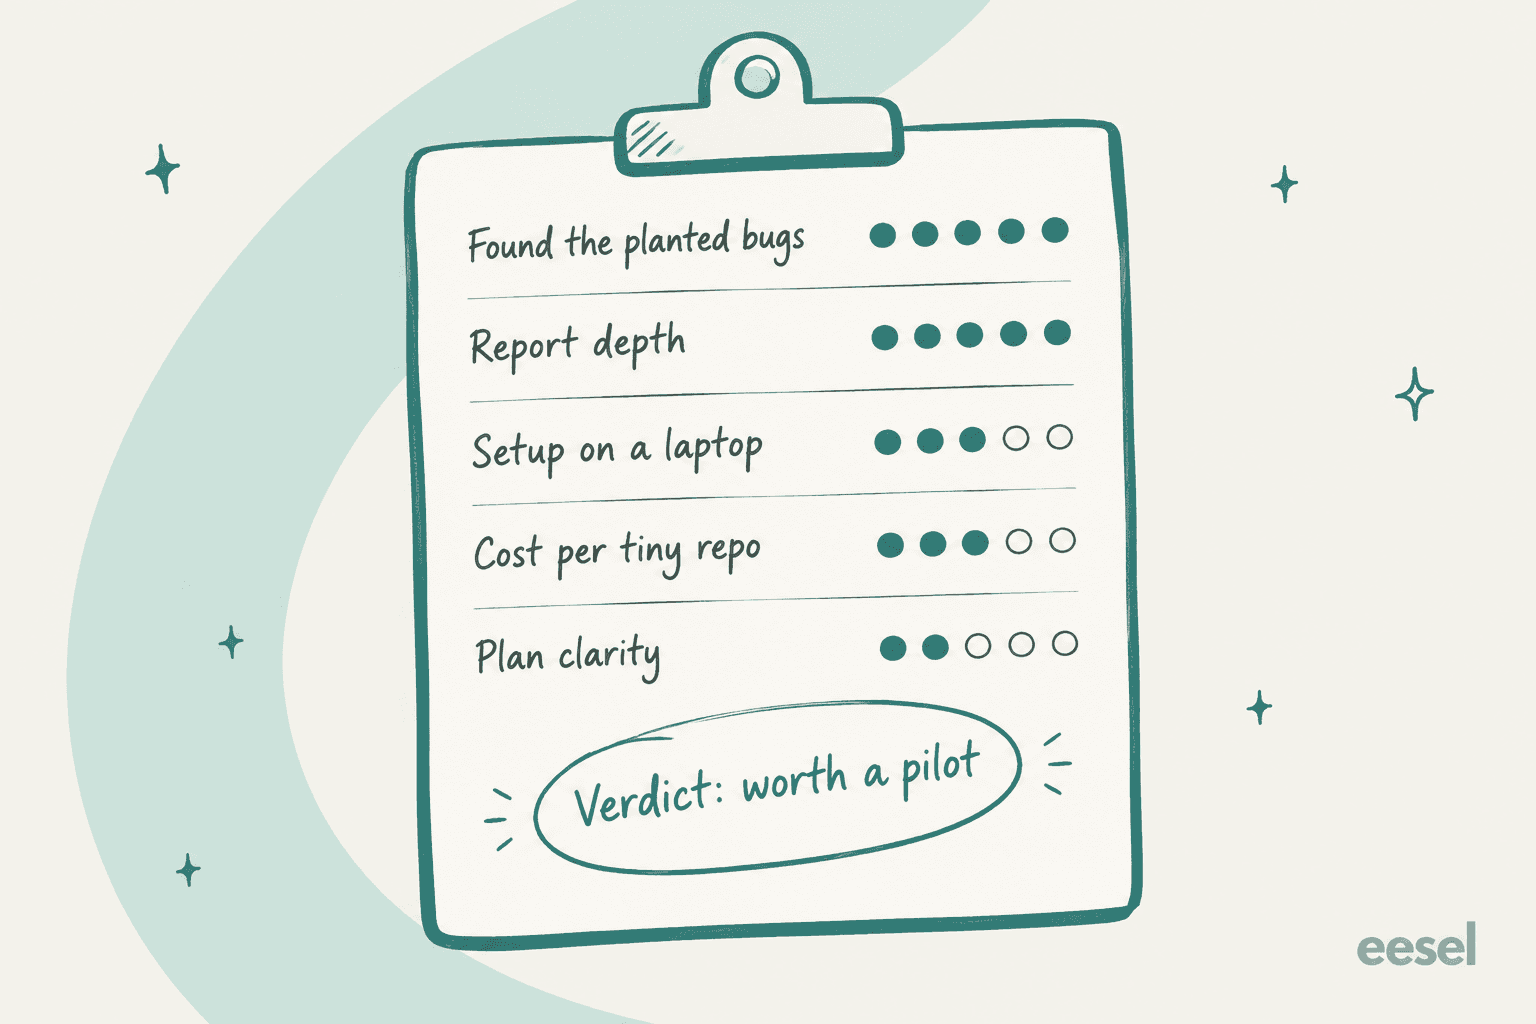
5つ中5つ、すべて高い確信度で、でっち上げはゼロ。おもちゃのアプリでは、これは最低ラインであってトロフィーではありません。それより感心したのは、深刻度の判断理由です。多くのスキャナーは、条件反射でSQLインジェクションをcriticalにします。これは、よくある癖です。しかしこのツールは、Pythonのsqlite3が複文を実行しないので、被害はデータの読み取りまでだと気づきました。そしてmediumと評価し、深刻度を上げる条件も添えていました。腕のいい人間のレビュアーなら、同じ判断をするでしょう。
TODOコメントで止まらなかった点も良かったです。ステータス更新ルートにも同じ認可チェックがないことを見つけ、両方を「アプリに認証が一切ない」というより広い指摘にまとめました。1つのルートを直しても他が開いたままなので、こちらのほうが有用な捉え方です。
レポートの中身
出力フォルダーには、report.md、findings.json、coverage.json、そしてGitHubのコードスキャン画面にアップロードできるSARIFエクスポートが入っていました。60行のアプリに対してレポートは55KBあり、細部を省くツールではありません。
指摘の前に、まずアプリの脅威モデルが書かれます。資産(チケットデータベース、添付ファイルのフォルダー、プロセスのシェルアクセス)、信頼境界、そして現実的な攻撃者にできることが並びます。見えなかった部分にも言及していました。私のエクスポートルートはリポジトリに存在しないexport.pyを呼び出しており、レポートは推測せずにその旨を書いていました。
各指摘には、深刻度の根拠、行単位でたどった証拠、リスクを下げうる「反証」、そして書くべきテスト付きの修復セクションがあります。コマンドインジェクションの修正案は次のとおりです。
"Require administrator authorization, remove
shell=True, invoke a fixed interpreter and script with an argument vector, and allowlist the supported export formats."
正確で、具体的でもあります。さらに2つのテストも提案されました。format内のシェルメタ文字が2つ目のプロセスを起動しないことの確認と、管理者以外がそのルートに到達できないことの確認です。--patchは渡していないので、コードは書かれませんでした。Cloudでは、これに相当するのがFix with Codexボタンです。Cloudセットアップガイドによると、パッチの下書きを作成し、確認してからCreate draft pull requestを選びます。
Claude Codeの/security-reviewを使ったことがあれば、こちらのほうがずっと構造化されています。レポートはコードコメントというより、監査文書のように読めます。
つまずいた点
最初の実行は失敗しました。スキャンはプリフライト段階で2分半を費やし、「Scan agent did not create required draft artifacts」というメッセージで終了、出力フォルダーは空でした。ログを見ると、エージェントがPythonのパスを含む必要なランタイム設定を認識できていませんでした。その時点で52万7千入力トークン、約$0.74〜$1.40を使っており、成果はゼロです。2回目はPythonのパスを明示的に渡し、シェル環境を継承させたところ成功しました。
この問題に遭遇したのは私だけではありません。リポジトリの未解決issue #73には、WindowsとLinuxで同じパターンが報告されています。スキャンは走り、トークンは課金され、そのあと保存に失敗して「the 'partial output' directory is completely empty」となる、というものです。CLIの--max-costフラグも防げません。OpenAIのCLI FAQには、この上限は「an estimate, not a hard spending cap」とあります。私は$4に設定しましたが、最終的な見積もりの上限は$6.77でした。
これは、CLIよりCloudを選ぶ最も強い理由です。CloudではOpenAIがコンテナー、環境、Pythonのセットアップを管理するので、この種のローカル環境の失敗は起きにくいはずです。
費用は妥当か?
評価を下げた最大の理由は費用です。60行のコードのスキャンで360万トークンを使いました。内訳を見ると理由が分かります。
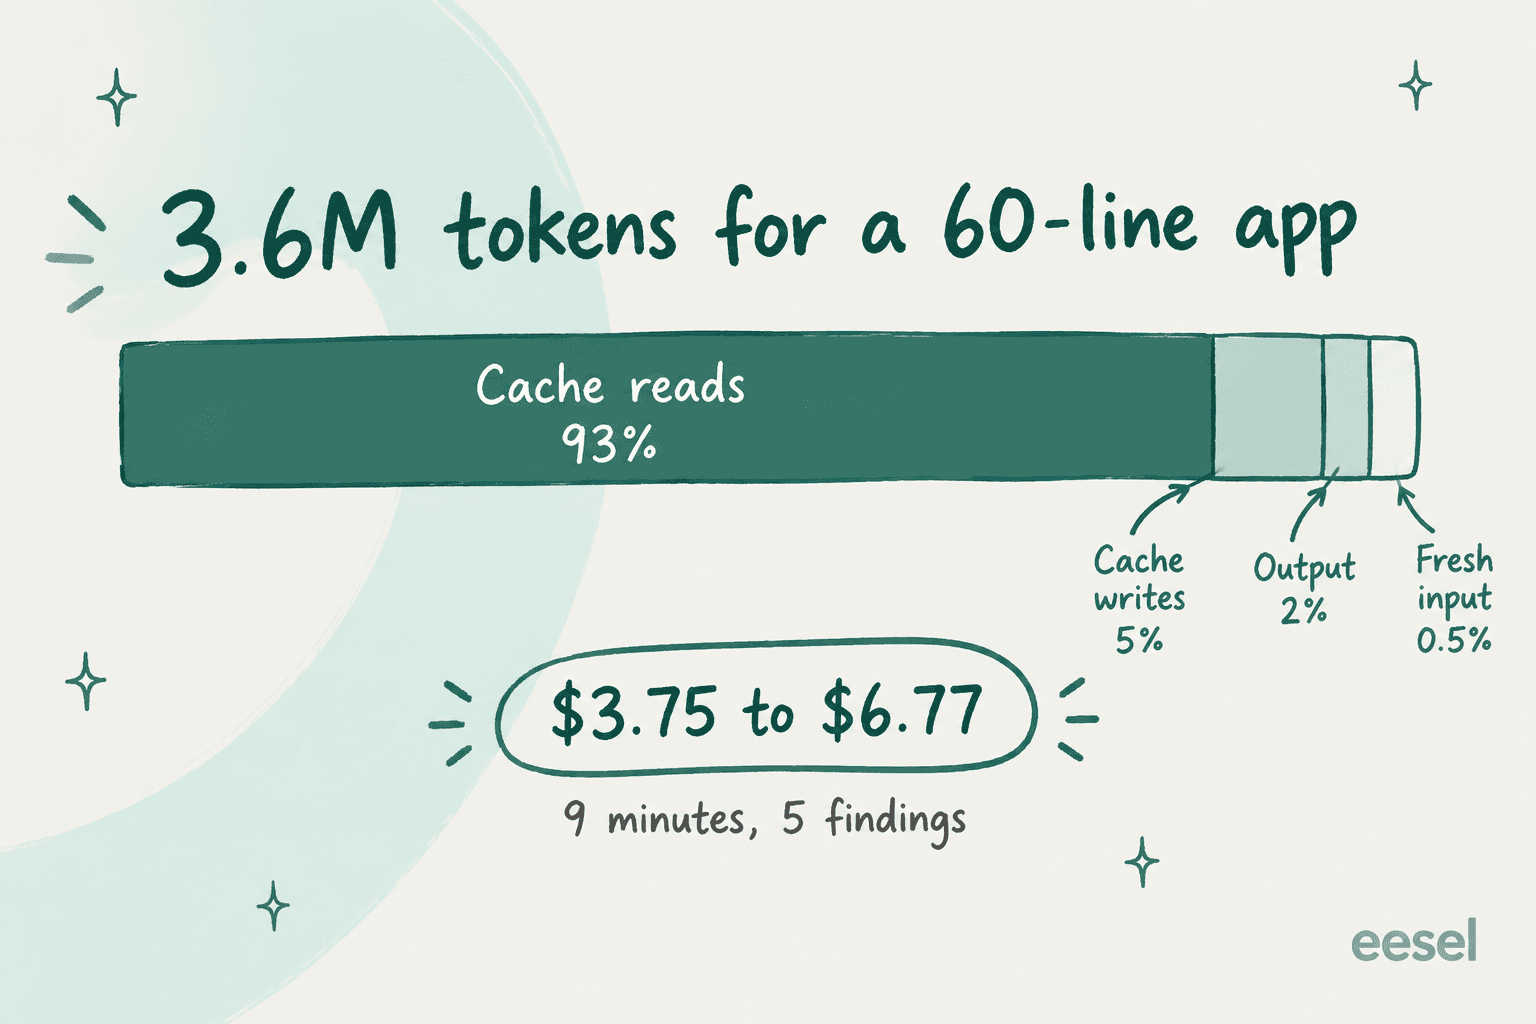
トークンの93%はキャッシュ読み取りでした。エージェントは、脅威モデリング、探索、検証、攻撃経路の分析、レポート作成と進むたびに、自分の指示、脅威モデル、コードを何度も読み直します。その大半は固定のオーバーヘッドなので、大きなリポジトリでも1行あたりの費用が比例して増えることはないはずです。それでも、ごく小さなスキャンですら数ドルかかります。しかもコミット監視では、プッシュのたびにその作業の一部が繰り返されます。
CLIのgpt-5.6-solの価格表では、キャッシュ読み取りが100万トークンあたり$0.40、出力が100万トークンあたり$20です。出力はトークンのわずか2%でしたが、低い方の見積もりのうち$1.46を占めました。
Cloudではドル建ての表示はありません。スキャンはプランに含まれるCodex利用枠から引かれ、その後はクレジットが使われます。OpenAIの料金ページには「Daybreak Blue uses GPT-5.6 Sol credit rates」とあり、入力100万トークンあたり100クレジット、キャッシュ入力は10、出力は500です。これはGPT-6 Solの2倍のレートです。
DevDayのまとめと同じ料金ページに基づく、Cloudを使えるプランは次のとおりです。
| プラン | 価格 | Cloudの利用 | 超過分 |
|---|---|---|---|
| Plus | $20/月 | 含まれない | 該当なし |
| Pro | $100、$200、または$500/月 | 可(DevDayによる) | ChatGPTクレジット |
| Business | 年払い$20/ユーザー/月、月払い$25 | 可(DevDayによる) | ワークスペースのクレジット |
| EnterpriseとEdu | 営業に問い合わせ | 可 | ワークスペースのクレジットまたは従量課金 |
| APIキーのみ | APIレート | クラウド機能なし | トークン単位で課金 |
プランには1つ引っかかる点があります。同じ料金ページの機能表では、「Codex Security for connected GitHub repositories」が今もEnterpriseとEduのみとされています。新しいDevDayの記事を信じたいところですが、アップグレードする前に、ご自身のワークスペースにプラグインが表示されるか確認することをおすすめします。クレジットの消費の仕組みは、Codex料金ガイドでさらに詳しく解説しています。
私のスキャンを位置づけるなら、リポジトリ1回のスキャンで数ドルというのは、セキュリティエンジニアの1時間と比べれば安いものです。ただし、すべてのプルリクエストで無料で動くルールベースのスキャナーと比べれば高価です。だから正解は、どちらか一方ではなく両方を使うことです。
ほとんどの人が見落とすDaybreak Blueの落とし穴
Daybreak BlueはCloudを選ぶ最大の理由ですが、ローンチ記事には書かれていない条件があります。ChatGPTでサインインしたときにしか適用されないのです。
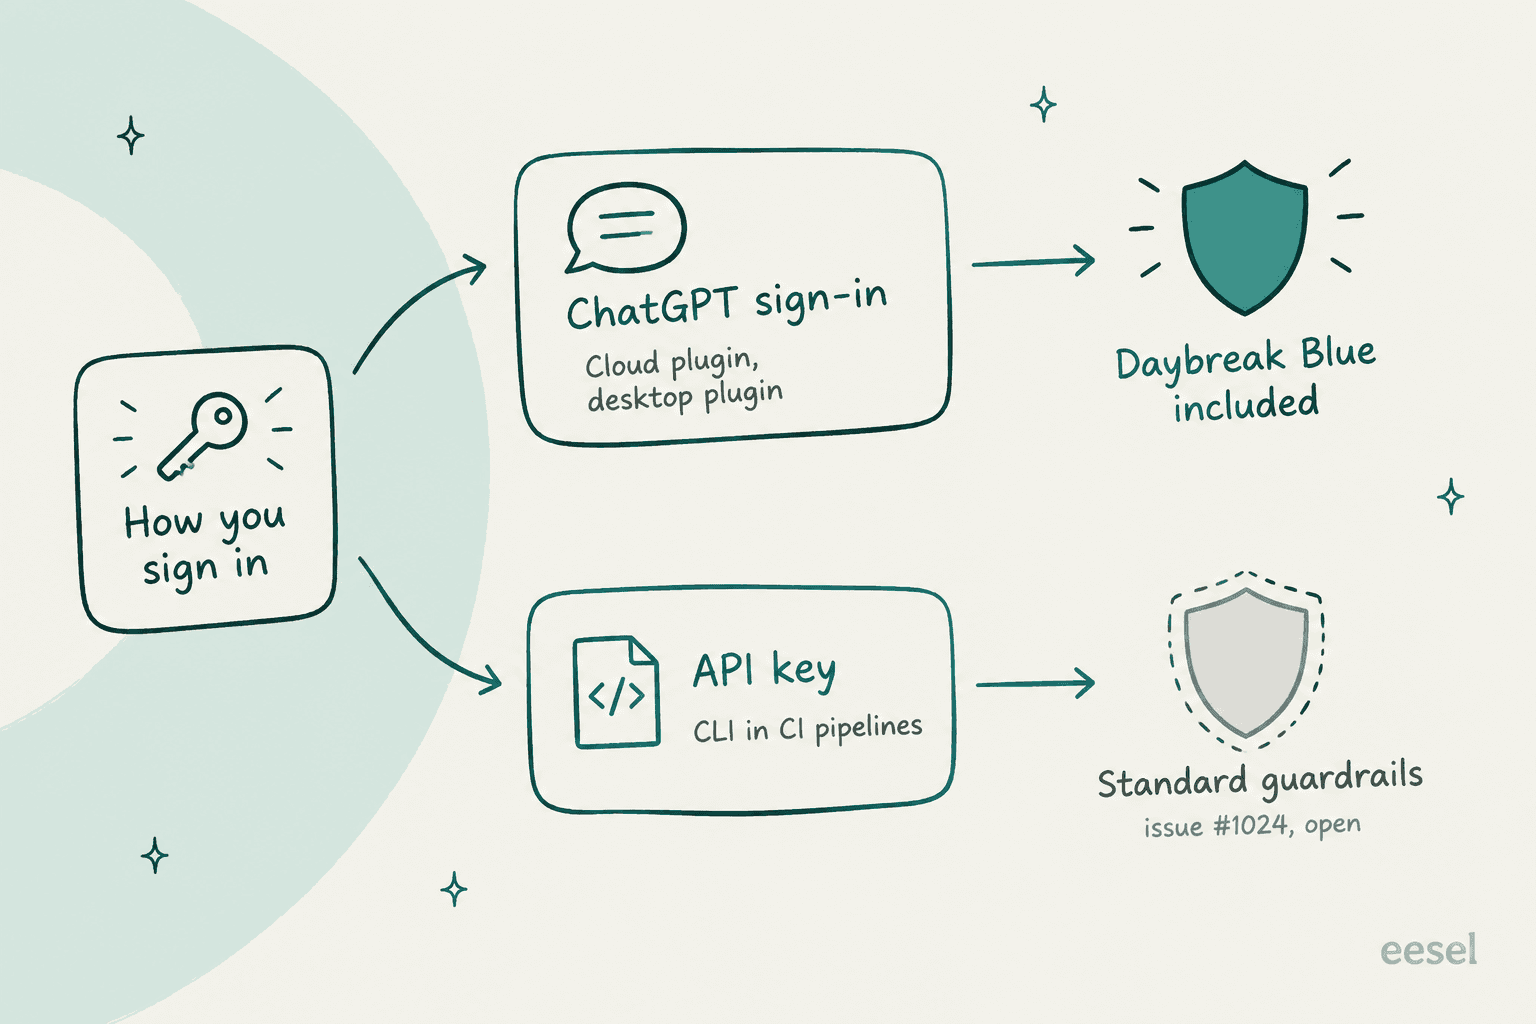
すでにDaybreak Blueの承認を受けているチームが立てた未解決のissue #1024では、CLIが固定しているCodexのバージョンが「filters out the cyber access program unless authentication is through ChatGPT」と報告されています。つまりAPIキーを使うと、Blueの選択が外れてしまいます。これは、ほとんどのCIパイプラインがまさに使っている方法です。プラグインの変更履歴も別の角度からこれを裏付けており、「Sessions that use only an API key can't verify account access」と書かれています。
なぜ重要なのか。拒否の問題は現実だからです。OpenAIが7月にCLIをオープンソース化したとき、Hacker Newsのスレッドは、それに遭遇した人たちで埋まりました。
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic."

別のユーザーは、小さなオープンソースライブラリのスキャンが40分以上走ったあと、「This content was flagged for possible cybersecurity risk」で終わるのを見ています。
"it ran for over 40 minutes and during that time I had no idea what was happening, thought it was frozen or in a bad state. Also, it ate through 25% of my weekly credits :("
公平を期すと、私のテストアプリでは、標準のガードレールでも拒否は一度もありませんでした。バグが教科書的で、アプリも小さいからかもしれません。このエラーのissue #56は、まだ未解決です。実用上の私の見方としては、本番のものにはCloudかChatGPTでサインインしたプラグインを使い、#1024が修正されるまではAPIキーでのCIスキャンを軽めのゲートとして扱うのがよいと思います。
他のユーザーの評価
Cloudそのものに関する実機レポートは、公開から2日しか経っていないため、まだ少ないです。Hacker Newsのローンチスレッドは、確認した時点でコメントがありませんでした。今のところの声は、主に同じスキャナーを動かすCLIと、以前のプラグインプレビューに関するものです。
肯定的な意見は、4月に先行して試したSimon Willisonからです。
"I've been previewing this in Codex for a few weeks - it's very good! Had some great results from it having it run security reviews against code written using other models"
懐疑的な意見は2つに分かれます。1つは、OpenAIのモデルを包んだハーネスにすぎないという見方です。あるエンジニアのXでの分解レポートは、CLIを「just JS calling Codex in a loop」とまとめていました。これには少し反論したいです。55KBのレポートを読んだ限り、素のプロンプトにはない構造をハーネスが加えているのは明らかです。ただし、品質の源がモデルにあるのは確かです。
もう1つは、カバレッジへの懸念です。Hacker Newsのコメント投稿者が、curlのメンテナーであるDaniel Stenbergの投稿を引いて、別のツールのスキャンが6件のCVEにつながる前は、Codex SecurityもClaude Mythosもcurlで指摘ゼロだったと述べています。伝聞ではありますが、妥当な警告です。OpenAIが公表している最良の数値はAardvark時代のもので、自社の「golden」テストリポジトリで既知の脆弱性の92%を見つけたというものです。ルールベースのツールとの公開比較はまだありません。私の5つ中5つという結果は、存在を知っていたバグでのものです。成熟したコードベースには、もっと見つけにくいバグが隠れているでしょう。
代替ツールとの比較
OpenAI自身のCloud FAQは、置き換えられるのかという疑問に一行で答えています。「Codex Security complements SAST.」各ベンダーが公表している内容で、近いツールを比べると次のとおりです。
| ツール | 公表価格 | 指摘を検証するか | 修正を提案するか | 向いている用途 |
|---|---|---|---|---|
| Codex Security Cloud | Codex利用枠に含まれ、その後クレジット | はい、サンドボックスで再現 | はい、ドラフトPRはご自身で作成 | ChatGPTプランのチームでの、推論が必要なバグ |
| Claude Code Security | 公開価格なし、限定プレビュー | 各指摘を再検討 | はい、人間の承認付き | Claude Codeに統一しているチーム |
| GitHub Code Security | アクティブコミッター1人あたり月$30 | ルールベースのCodeQL解析 | はい、Copilot Autofix | すべてのPRでの決定的な最低ライン |
| Snyk | 無料枠あり、Teamは月$25から | 修正候補を再スキャン | はい、Snyk Agent Fix | 依存関係とオープンソースのリスク |
| Semgrep | 10コントリビューターまで無料、Teamsはコントリビューター1人あたり月$30から | 記載なし | 修復ガイダンス | 自分で書くカスタムルール |
私がおすすめする構成は、すべてのプルリクエストで最低ラインとなるルールベースのスキャナーを、GitHubの有料プラン、SnykまたはSemgrepで動かすことです。そのうえで、ルールでは表現できないバグ向けに、Codex Security Cloudをスケジュール実行で追加します。アプリ全体を理解して初めて意味を持つ、認可チェックの欠如のようなバグです。
チームがClaude Codeを使っているなら、そのGitHub連携が、PR側で最も近い代替になります。より広い選択肢は、OpenAI Codexの代替リストをご覧ください。専門のサイバーモデルを検討するセキュリティチームは、まずGPT-5.6-Cyberの代替のまとめから始めてください。
メリットとデメリット
| メリット | デメリット |
|---|---|
| 仕込んだ5つのバグをすべて検出し、誤検知はゼロ | 60行のアプリで$3.75〜$6.77、9分かかった |
| 条件反射ではなく、根拠のある深刻度判断 | 最初の実行はセットアップで失敗し、それでも約$1が課金された |
| すべての指摘に脅威モデル、証拠、テストが付く | プランの対象がOpenAI自身のページ間で矛盾している |
| GitHubのコードスキャン向けのSARIFエクスポート | Daybreak BlueはAPIキーのCIスキャンにまだ適用されない |
| 人間の確認なしにパッチを適用しない | SASTツールとの公開ベンチマークがなく、OpenAI自身の数値のみ |
もう1点注意したいのは、このリポジトリの更新が速いことです。GitHubリポジトリで確認できる2日前にマージされたコミットで、CLIのデフォルトモデルがxhighのGPT-6 Solに切り替わります。私がインストールしたnpmのバージョンは、まだgpt-5.6-solがデフォルトでした。これが反映されれば、GPT-6 SolのクレジットレートはGPT-5.6 Solの半分なので、スキャンは安くなるはずです。
Codex Security Cloudは誰に向いている?
向いている人:ChatGPT Pro、Business、Enterprise、Eduを使っていて、コードがGitHubにあり、すべての変更をレビューするセキュリティエンジニアがいないチームです。ルールベースのツールが見逃すロジックのバグに対して、頼れるセカンドオピニオンになります。レポートも、そのまま開発者に渡せる品質です。まずは最も機密性の高いサービスで1リポジトリのスキャンを行い、前後で利用状況ダッシュボードを確認してから、コミット監視をオンにしてください。
見送るべき人:ソースコードを環境の外に出せないというポリシーがある場合です。オフラインのスキャナーではなく、OpenAIのチームメンバーがHacker Newsで説明しているとおり、コードとコンテキストはOpenAIのホスト型モデルに送られます。Plusプランの場合や、すべてのプルリクエストで安価で決定的なゲートが必要な場合も見送りです。それはCodeQLやSemgrepの仕事です。
待つべき人:APIキーでCIからヘッドレス実行するつもりの場合です。Daybreak Blueの問題が修正され、保存失敗が落ち着くまで、CIでのCLIは最も弱い使い方です。
OpenAIの最近の他のローンチ、たとえば常時稼働のOpenAI DotsやGPT-6.1 Solと比べると、これが最も本番運用に近いと感じます。ただし、まだリサーチプレビューと表示されているので、期待値は手元のバージョンに合わせてください。
止まらないキューにはeeselを
Codex Securityは、セキュリティバグを見つけて説明するという1つの仕事をこなし、人間が動く前に証拠を示すことで信頼を得ています。これは私がeeselで作っているチームメイトと同じ形です。eeselはAIチームメイトのプラットフォームで、現在すぐに働ける2つの人材がいます。Zendesk、Freshdesk、Gorgias、Frontに参加するAIヘルプデスクチームメイトと、コンテンツとSEO向けのAIブログライターです。
サポートの面でも、私のスキャンの教訓はそのまま当てはまります。自信があることと、正しいことは別です。Zendeskを使っているあるB2B車両テレマティクスのチームでは、ナレッジベースに「全モデルに対応」とあるだけで、データベースにないブランドについてもボットが「はい、お客様の車種に対応しています」と答えていました。だからeeselは、まず過去の何百件ものチケットでヘルプデスクチームメイトをシミュレーション実行し、実際のお客様に触れる前に、送信したはずのすべての回答を確認できるようにしています。ルール外のアクションは人間の承認を待ちます。ドラフトPRがレビューを待つのと同じです。

Codex SecurityのCLI側に惹かれた方には、eeselにもCLIがあります。eesel CLIは、ダッシュボードで見るのと同じチームメイトとワークスペースを、ターミナルやスクリプトから操作します。eesel approvals listで人間の承認待ちの項目を確認でき、eesel activityですべての実行を一覧して、チームメイトが何をしたか監査できます。各ワークスペースはMCPサーバーとしても動くので、CodexやClaude Codeのようなコーディングエージェントからも操作できます。なぜそれが重要なのかは、AIエージェントCLIガイドで解説しています。
料金は公開されています。100クレジットの無料プランがあり、その後は500クレジットで月$299からのプランです。チケット1件またはチャット1件が1クレジットで、詳細は料金ページをご覧ください。eeselを試して、その日のうちにご自身の過去チケットでヘルプデスクチームメイトを動かしてみてください。このモデルのさらに詳しい説明は、AIチームメイトの解説記事にあります。
よくある質問
Codex Security Cloudは導入する価値がありますか?
Codex Security Cloudの精度はどの程度ですか?
Codex Security Cloudのスキャン費用はいくらですか?
Codex Security Cloudが使えるChatGPTのプランはどれですか?
Codex Security CloudはAPIキーで使えますか?
Codex Security Cloudは見つけたバグを修正してくれますか?
Codex Security Cloudの代替ツールには何がありますか?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.