


機能リクエスト追跡のためのAIは4つの仕事をします。サポートチケットの中の要望を見つけること、それをバグや使い方の質問と区別すること、共有のリクエストに紐付けて需要を数えられるようにすること、そして機能がリリースされたら要望した全員に返信することです。最初の3つは、Canny、Linear、Productboardのようなツールがよくカバーしています。4つ目の返信は、チケットの中でほとんどのツールが行っていない部分であり、顧客が気づくのもそこです。
だから、プロダクト側ではなくサポート側から設定してください。AIに固定リストから各チケットへタグを付けさせ、対応するリクエストを作成または検索させ、チケットを紐付けたままにします。リクエストがリリースされたら、その紐付いたチケットが通知リストになります。CannyのAutopilotは全プランに含まれ、閉じられたチケットを自動で読みます。LinearのZendesk連携はissueが完了するとチケットを再オープンしますが、返信を書くのは人です。
キューがZendesk、Freshdesk、Gorgiasで動いていて、プロダクトチームがJiraで動いているなら、eeselがサポート側の半分を一度に担います。要望にタグを付け、新規作成の前にJiraで既存のissueを検索し、issueが閉じられたら「リリースされました」の返信を下書きします。smavaはすでに、月に14,600件のZendeskチケットをフィールドに分類するために使っており、これは機能リクエストのタグ付けと同じスキルです。
機能リクエスト追跡のためのAIは実際に何をするのですか?
機能リクエスト追跡のためのAIは、各サポート会話を読み、顧客が製品にまだない機能を求めているかを判断し、プロダクトチームが動ける、数えられて紐付いた記録に変えます。何を作るかを決めるわけではありません。
私はeeselのサポートキューを担当していて、これの生の姿を毎日見ています。誰かが請求の質問について4段落を書き、最後の1行に「あと、Sheetsにエクスポートできたらうれしいです」とある。その1行がリクエストです。プロダクトマネージャーにとって残りはノイズで、LLMが助けになる何年も前に、Hacker Newsのコメント投稿者がそう言っていました。
"The Customer Support teams of your customers are going to be one of the main channels for capturing feature requests. We use Zendesk and have custom fields for categorizing and sub-categorizing requests along with a brief description. We do this so that the PMs don't have to read the entire Support ticket if one sentence is about the feature request out of 10 pages of text."

仕事はほぼこれに尽きます。その1文を抜き出し、数えられる場所に記録しつつ、チケットへのリンクを保ちます。AIにとっては4つのステップに分かれます。
- 見つける。 別の件のチケットに埋もれていても、要望を見つけます。
- 分類する。 本当のリクエストか、バグか、使い方の質問か、製品がすでにできることか。
- 紐付けて数える。 そのたびに新規を作るのではなく、チケットを共有のリクエストに付けます。
- リリース時に返信する。 紐付いたチケットを使い、要望した顧客全員に伝えます。
ステップ1〜3が「追跡」の部分で、AIによるチケットのタグ付けやチケットの重複排除と大きく重なります。ほとんどの構成はステップ4の手前で止まります。すでに顧客の声プログラムを運用しているなら、これはそのサポートチケット部分だと考えてください。
なぜ機能リクエストはサポートで失われるのですか?
機能リクエストが失われるのは、サポートが手近なものに書き留める一方で、プロダクトは別の場所を探すからです。チケットには「チームに伝えました」と書かれます。その後、要望はSlackのスレッドやスプレッドシートに行き着くか、誰も集計しないチケットタグの中に残ります。
これはRedditのHead of Productによるスプレッドシート版です。
"So, what ends up happening is each of these customers has a google sheet of their asks/needs/requests. As the Head of Product, I am always checking these spreadsheets and trying to prioritize burning asks into our dev cycles. Its a nightmare to see it all in one place, and understand "what is the biggest need from our clients right now". I find myself prioritizing one feature only impacting a $400K client vs. a feature that would benefit 10 $20K clients."

そして、同じ混乱の顧客側です。チケットが1か月放置された人の声です。
"I'm not asking for instantaneous results. I'm asking for communication. My ticket sat untouched for something like a month before I sent a support ticket in and it was then tagged as a feature request."
この顧客が本当に腹を立てた点を見てください。機能がリリースされなかったことではありません。チケットが機能リクエストとしてタグ付けされ、その後何も返ってこなかったことです。タグは整理であって、返答ではありません。
eesel自身のプロダクトで、これがうまくいった例を見ました。eeselの営業メモで最も多く出てきたリクエストは、不足しているヘルプデスク連携でした。Front、HubSpot Service Hub、Jira Service Management、Zoho Deskが繰り返し挙がり、そのせいで失注もありました。それらの要望は散らばらずに数えられたので仕事になり、4つとも今は連携一覧にあります。顧客の要望がリリースされると、eeselのチームチャンネルの更新は、同僚のAmoghが5月に投稿したこんな形になります。「CUS-605 prompt compressor shipped, unblocked.」issue IDがひとつ、顧客がひとり、そして伝えに行くべきだと今わかった人がひとり。
AIは機能リクエストとバグや使い方の質問をどう区別しますか?
AIは意図で分類しますが、カテゴリを例付きで書き出して初めてうまく機能します。よくある分け方は3つのレーンです。「エクスポートボタンが壊れている」はバグ、「週次エクスポートを追加できますか」は機能リクエスト、「エクスポートボタンが見つかりません」は使い方の質問です。私は4つ目を足します。最も時間を節約できるレーンだからです。
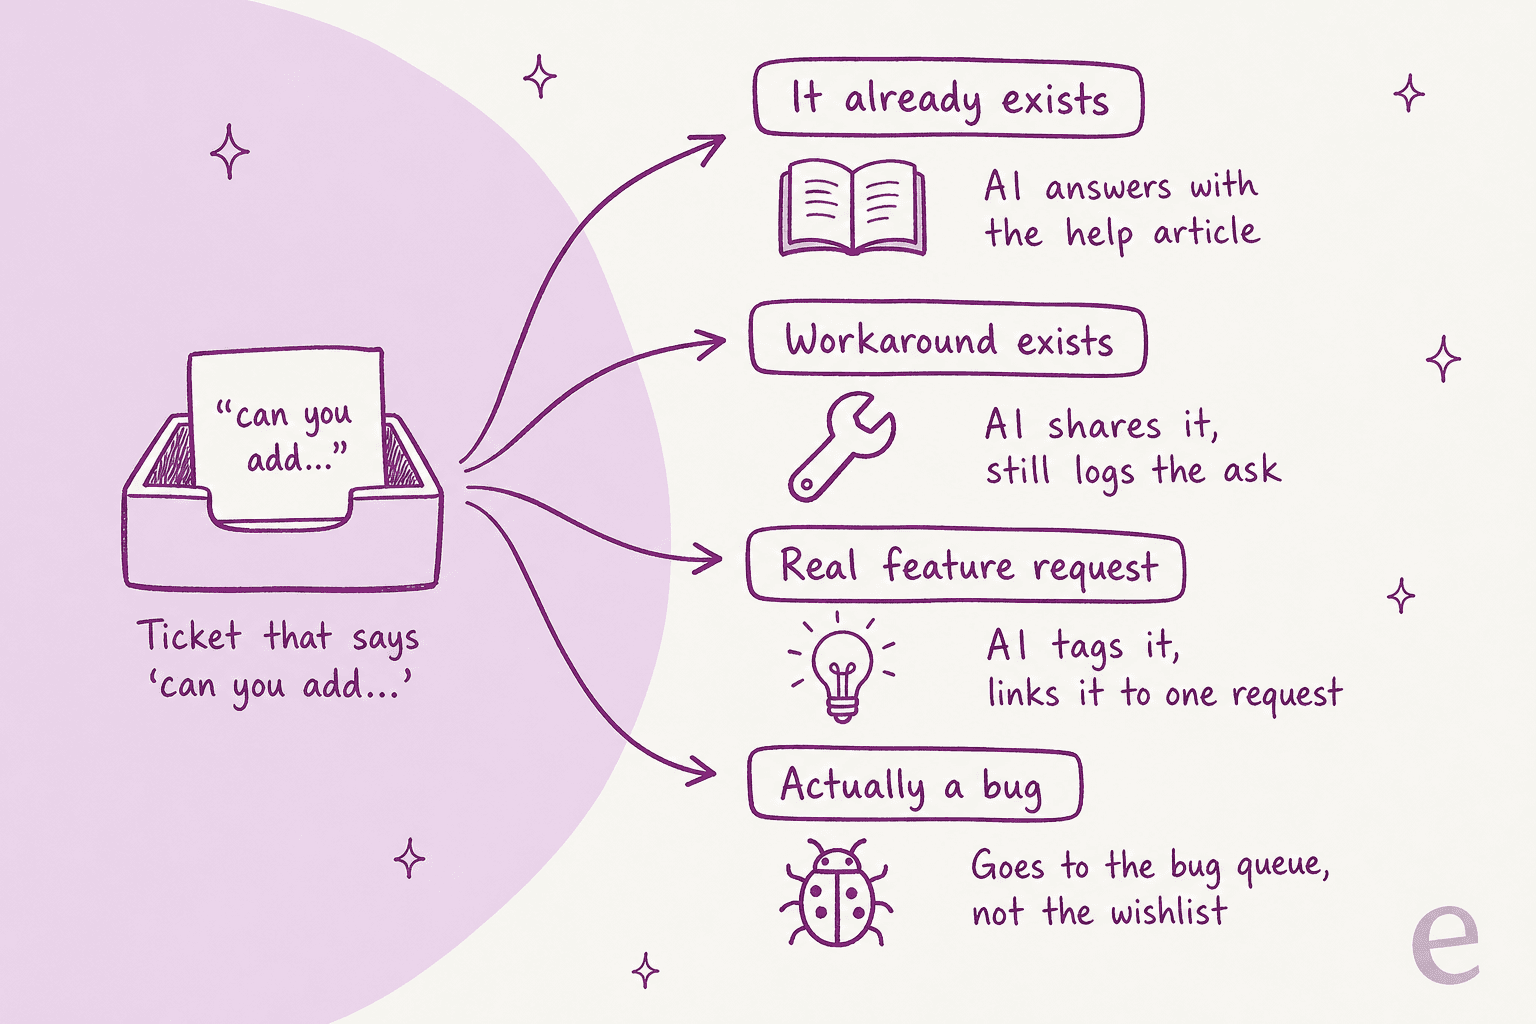
すでにある。 「Xを追加できますか」というチケットのかなりの数が、実は製品がすでにできることについてのものです。優れたサポートAIは、それらを記録するのではなく、ヘルプセンターから回答すべきです。既存機能へのリクエストは、実際には見つけやすさの問題だからです。Redditのカスタマーサクセスマネージャーは、まさにこの理由であいまいな引き継ぎに反論しました。
"So you don't have any detail on the request? No validation? What if its actually something they could already do or approximately do 80% of with existing features? You don't have conversations around why they want it or how it will benefit them? "Hey PM. Mr customer said they want to send emails! Figure it out!""
回避策がある。 共有しつつも、要望は記録してください。回避策で凌いでいる人も、1票として数えられます。
本物のリクエスト。 タグを付け、顧客自身の言葉で要望を書き、対応するリクエストに紐付けます。
実はバグ。 バグトリアージの流れに回します。願望として登録されたバグは、ロードマップボードに何か月も残り、その間、顧客は壊れたものを無視されていると感じます。
これを確実にするのは固定リストです。Gorgiasを使うクライミングウェアブランドのRúngneは、eeselのトリアージエージェントを決まったタグリストで動かしています。事例の数字は、1か月で880件のチケットにタグ付けされ、すべてそのリストから、「nothing invented」でした。機能リクエストのタグも同じように動きます。AIは、毎週火曜に新しいカテゴリを作るのではなく、あなたのリストから選びます。ゼロから始めるなら、チケットのタグ付けを自動化する方法のガイドでそのリストの作り方を説明しています。
追跡するリクエストには何を記録すべきですか?
追跡するリクエストには、顧客自身の言葉での要望、各チケットへのリンク、誰が要望したか、提供した回避策、ステータスを持たせるべきです。5つのフィールドで、後からすべて必要になります。
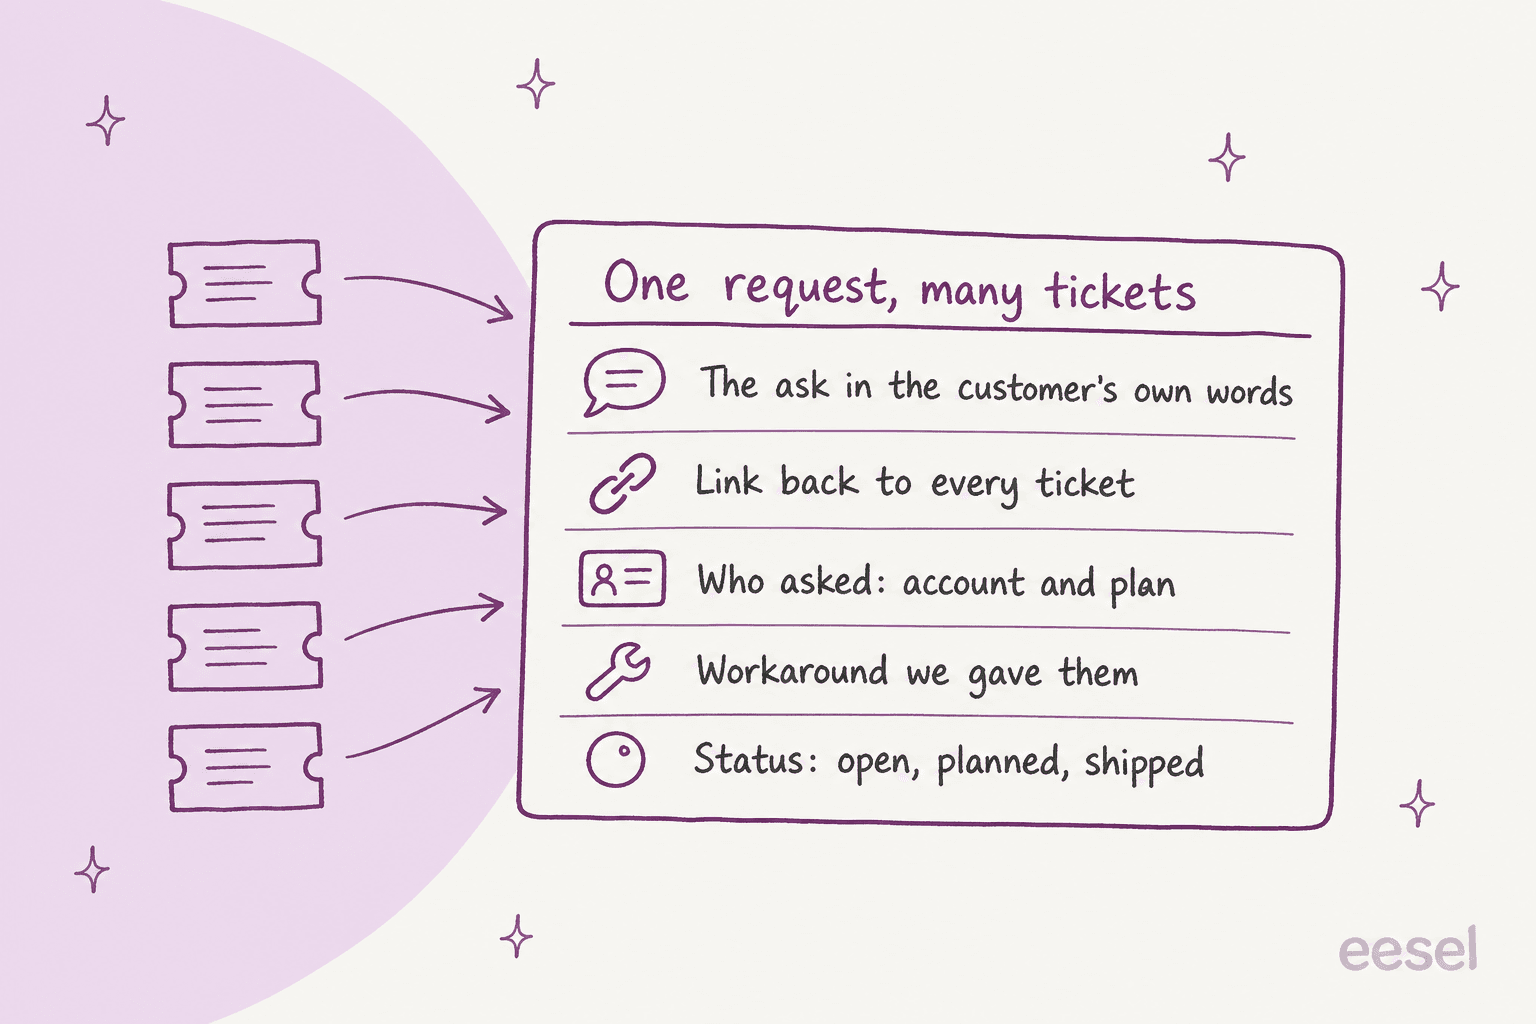
ほとんどの構成は、各チケットへのリンクを失います。要約をスプレッドシートに貼ると、チケットのリンクが消えてしまい、6か月後に機能がリリースされても、誰が要望したのか誰にもわかりません。Linearはこれをうまく扱います。ZendeskからissueをCreateまたはLinkすると、「will automatically add a request pointing back to the source」となり、リクエストには名前とタイムスタンプ付きで顧客の元のメッセージが引用されます。
「誰が要望したか」が重要なのは、生の件数だけでは誤解を招くからです。先ほどのRedditのHead of Productは、$400Kの顧客1社と$20Kの顧客10社を天秤にかけていました。Linearでは顧客ごとにリクエストを重要とマークでき、Cannyの投票者リストには、リンクされたZendeskチケットの横に各顧客のMRRが表示されます。ヘルプデスクがすでにプランやアカウント規模を把握しているなら、AIにそれをリクエストへ書き込ませ、件数を足し上げるだけでなく重み付けできるようにしましょう。
Paul Grahamは2009年に、Hacker News自身の機能リクエストページについて書き、もう半分の論点を示しました。
"One of the main points of the feature request page is to separate feature requests from submmissions. You want to do this because most are either duplicates or bad ideas, and yet (like all meta discussion, including this post) tend to get a lot of upvotes. The feature request page serves that purpose even if no one reads it."
重複は例外ではなく普通のことです。だから「既存のリクエストに紐付ける」がAIの最初の一手で、「新規作成」はフォールバックでなければなりません。
サポートチケットから機能リクエストを追跡するツールにはどんなものがありますか?
サポートチケットから機能リクエストを追跡するツールは、プロダクト側のボード(Canny、Productboard、Featurebase、Jira Product Discovery)、リクエストを受け付けるissueトラッカー(Linear)、ヘルプデスク内のAI(Zendeskのインテリジェントトリアージ、またはeeselのようなエージェント)に分かれます。4つの仕事での比較は次のとおりです。価格は各ベンダー自身の料金ページのもので、2026-10-30に確認しました。
| ツール | チケットの取り込み方 | AIが行うこと | 要望者が結果を知る方法 | 開始価格 |
|---|---|---|---|---|
| Canny | AutopilotがZendesk、Freshdesk、Help Scoutの閉じたチケットを読む。Zendeskサイドバーアプリ | リクエストを見つけ、重複をマージ。手動または自動モード | ステータスメール(「users tracked internally」にも) | 追跡ユーザー25人まで無料。Proは100人で月額$99(年払い$79) |
| Linear | ZendeskまたはFrontのサイドバーからissueを作成またはリンク | 「Create with Linear Agent」が会話全体からissueを書く。Triage Intelligenceが重複を指摘 | 社内メモ+チケット再オープン。返信は人が書く | Businessはユーザーあたり月額$16、年払い(Zendeskに必要) |
| Productboard | Zendeskチケットをタグまたはトリガーで取り込み。Freshdeskは1件ずつ | Sparkがフィードバックを機会にランク付け。機能への自動リンクはSparkでは「Not yet」 | プロダクトマネージャーがポータル更新を書く | 非公開。最低5メーカー |
| Featurebase | 独自の受信箱(AI)、ZendeskとHubSpotのアプリ(手動) | フィードバックをリクエストにリンクし、明らかな重複をマージし、複数の要望を含むメッセージを分割 | ステータスメール。カスタム更新ならリンクされた会話に返信可能 | Growthは1席あたり月額$29(年払い、月払いは$37) |
| Jira Product Discovery | ZendeskまたはJSMのリンクをアイデアにインサイトとして貼り付け | Rovoが要約とブレインストーミング、Premiumのみ | 現時点で組み込みなし | 作成者3人まで無料。Standardは作成者あたり月額$10.50 |
| Zendeskインテリジェントトリアージ | 公開コメントのあるすべてのチケットを分類 | 意図にタグを付ける。カスタムの「機能リクエスト」トピックが必要 | 組み込みなし | Suite Professional。ワークフローで使うにはCopilotがエージェントあたり月額$50 |
| eesel | Zendesk、Freshdesk、Gorgiasなどのヘルプデスクにエージェントとして参加 | あなたのリストからタグ付け、フィールドを書き込み、作成前にJiraで重複を検索 | リンクされた各チケットに返信を下書き。webhookで起動 | 100クレジット無料。500クレジットで月額$299 |
この表のいくつかの行は、もう少し詳しく見る価値があります。
Cannyは取り込みが最も手間いらずです。 Autopilotは「Included in all plans」で、ヘルプデスクで「after they are closed out」のチケットだけを読み、最初の接続時には過去30日分から始めます。個人情報のフィールドも読み飛ばします。注意すべきは件数です。Autopilotがフィードバックを見つけた人は追跡ユーザーとして数えられ、Proの料金は追跡ユーザー数で上がります(月払いで、100人が$99、500人が$349、1,000人が$661)。
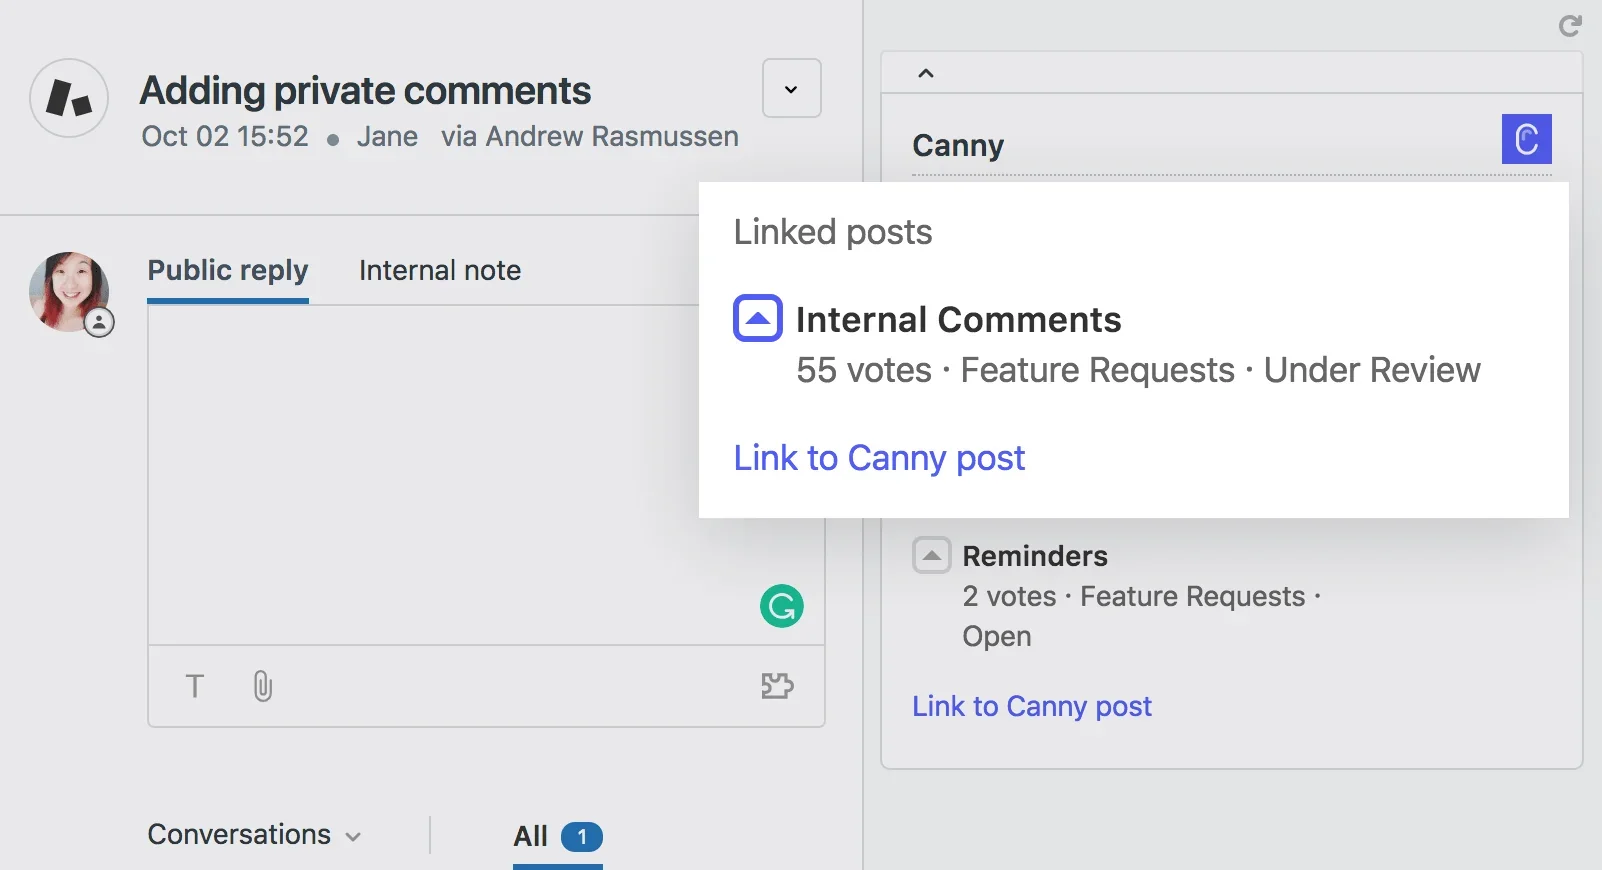
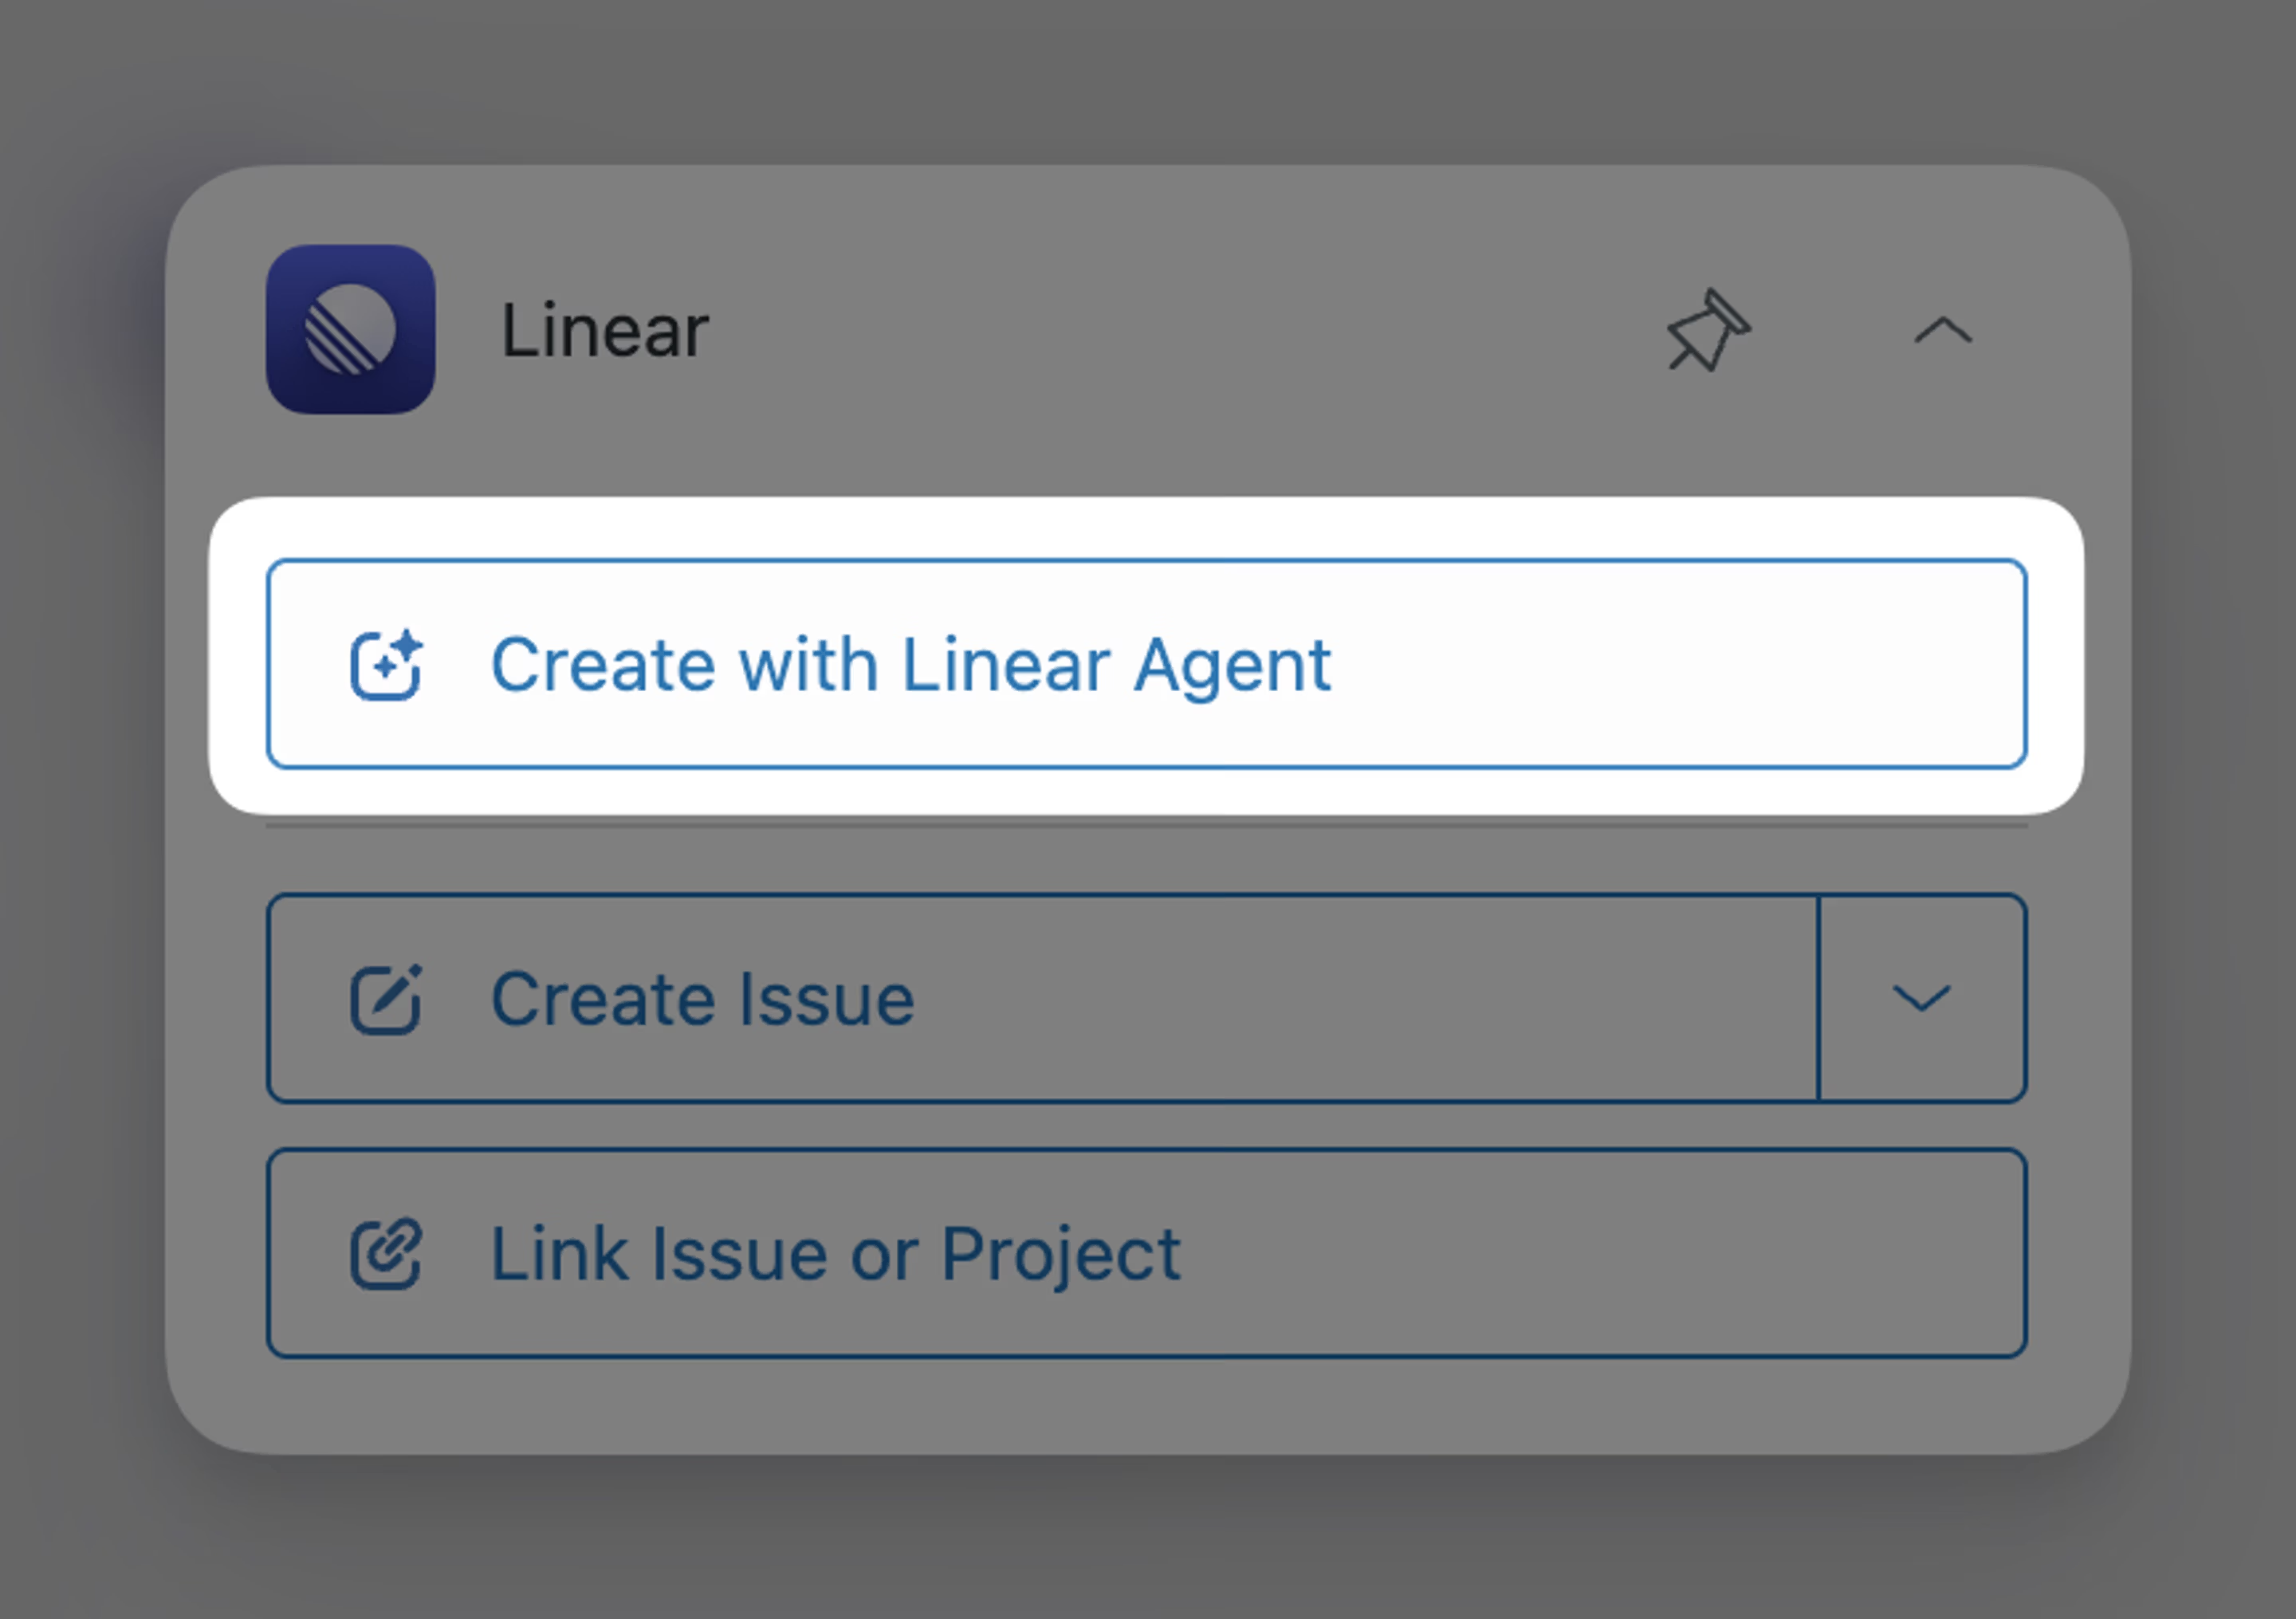
Linearはリンクを保つ力が最も強いです。 「as many Zendesk tickets to a Linear issue as you like」をリンクでき、重複したissueがマージされると、Zendeskのリンクは残るissueへ移るので、自動化は動き続けます。そのAIはエージェントによって起動されます。チケットを担当している人が「Create with Linear Agent」をクリックすると、Linearは添付ファイルを含む会話全体を読んでissueを書きます。すべてのチケットを自動でスキャンすることはありません。
Zendesk自身のAIはタグ付けはできても追跡はできません。 インテリジェントトリアージはチケットを意図で分類しますが、ドキュメントに組み込みの「機能リクエスト」トピックは見当たりませんでした。自分でカスタムトピックを作成する必要があります。機能ごとの需要も数えないため、反対側にはボードやトラッカーがやはり必要です。私のインテリジェントトリアージの解説でプランをさらに詳しく説明しています。
ProductboardのAIは読めますが、まだリンクはしません。 Sparkは全ワークスペースに含まれ、Zendeskのフィードバックを引用付きの機会のランク付きリストに読み込みます。しかしProductboard自身の比較表では、Sparkのインサイト自動リンクは「Not yet」とされ、それを行っていた以前のProductboard AIはもう販売されていません。
プロダクト側のツールを単独で比較検討するなら、Featurebaseの代替、Jira Product Discovery AI、LinearとJiraの比較の記事が、ここで書ける以上に踏み込んでいます。
要望された機能がリリースされたらどうなりますか?
機能がリリースされると、ほとんどのツールは、プロダクトツールからステータスメールを送るか、チケットに社内メモを残します。実際の返信は、サポートの誰かがやはり書かなければなりません。「追跡」はほぼどこでも自動化されています。「顧客に伝える」は、たいてい自動化されていません。
最後のステップで各ツールが行うことを、各社自身のドキュメントに基づいて示します。
- Linearは社内メモを投稿し、ZendeskまたはFrontのチケットを再オープンします。「so that your agents will be able to notify the customers」とのことです。返信は人が書きます。
- Featurebaseはステータス変更時に、リンクされた会話へ社内メモを追加します。ステータス更新のドキュメントによれば「Sending a customer reply is a separate action」ですが、カスタム更新ならリンクされた会話に返信できます。
- Cannyは、「Notify users tracked internally」にチェックを入れると、チケット経由でリクエストした人にメールを送ります。メールはCannyから送られ、ステータス変更メールのドキュメントによれば「if a user replies directly to the email, the reply is not recorded」です。
- Productboardでは、プロダクトマネージャーがポータル更新を書き、投票者およびリンクされたインサイトを持つ全員に送れます。フィードバックループを閉じるガイドによれば「It is not yet possible to reply to email updates」です。
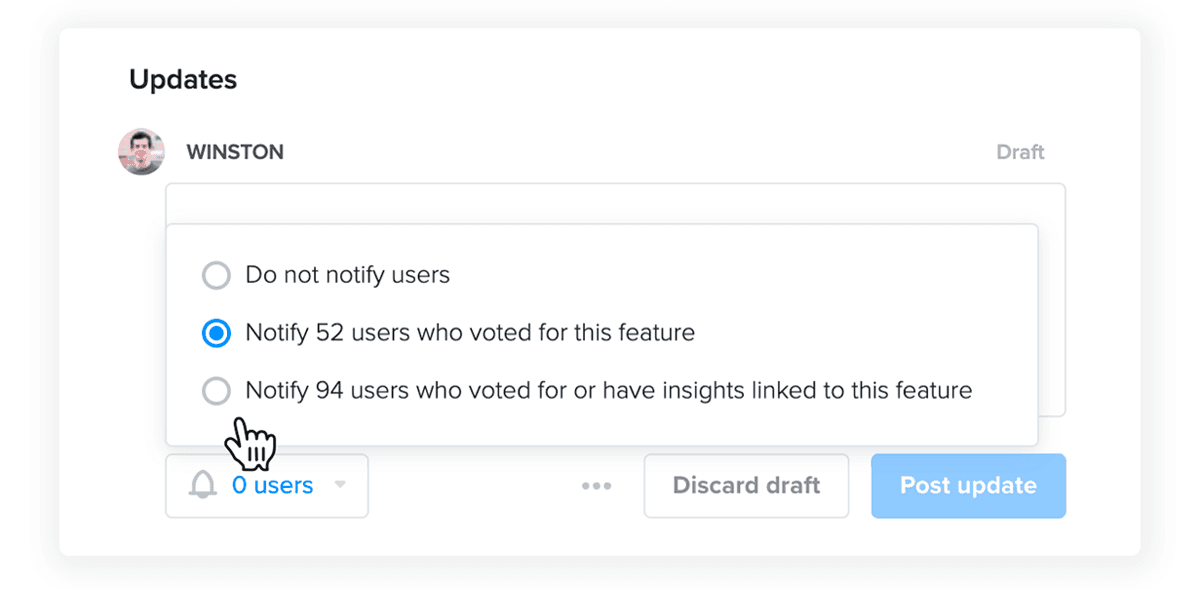
このProductboardの例では、52人が投票しましたが、投票またはフィードバックがリンクされていた人は94人でした。つまり、サポート経由で要望した人は聴衆のかなり大きな部分を占めていて、ボードには一度も触れていません。チケットで頼んだのです。CannyのG2レビュワーは、このギャップをはっきり指摘しました。
"It is very basic. Unless the PM makes comments, it is difficult to understand if there has been any progress. There is no way to close the loop when a feature has been released."

このレビューは、Cannyが「was a way for our support team to submit feature ideas to the Product team」だったチーム、つまりこの記事が扱う構成そのものから来ています。
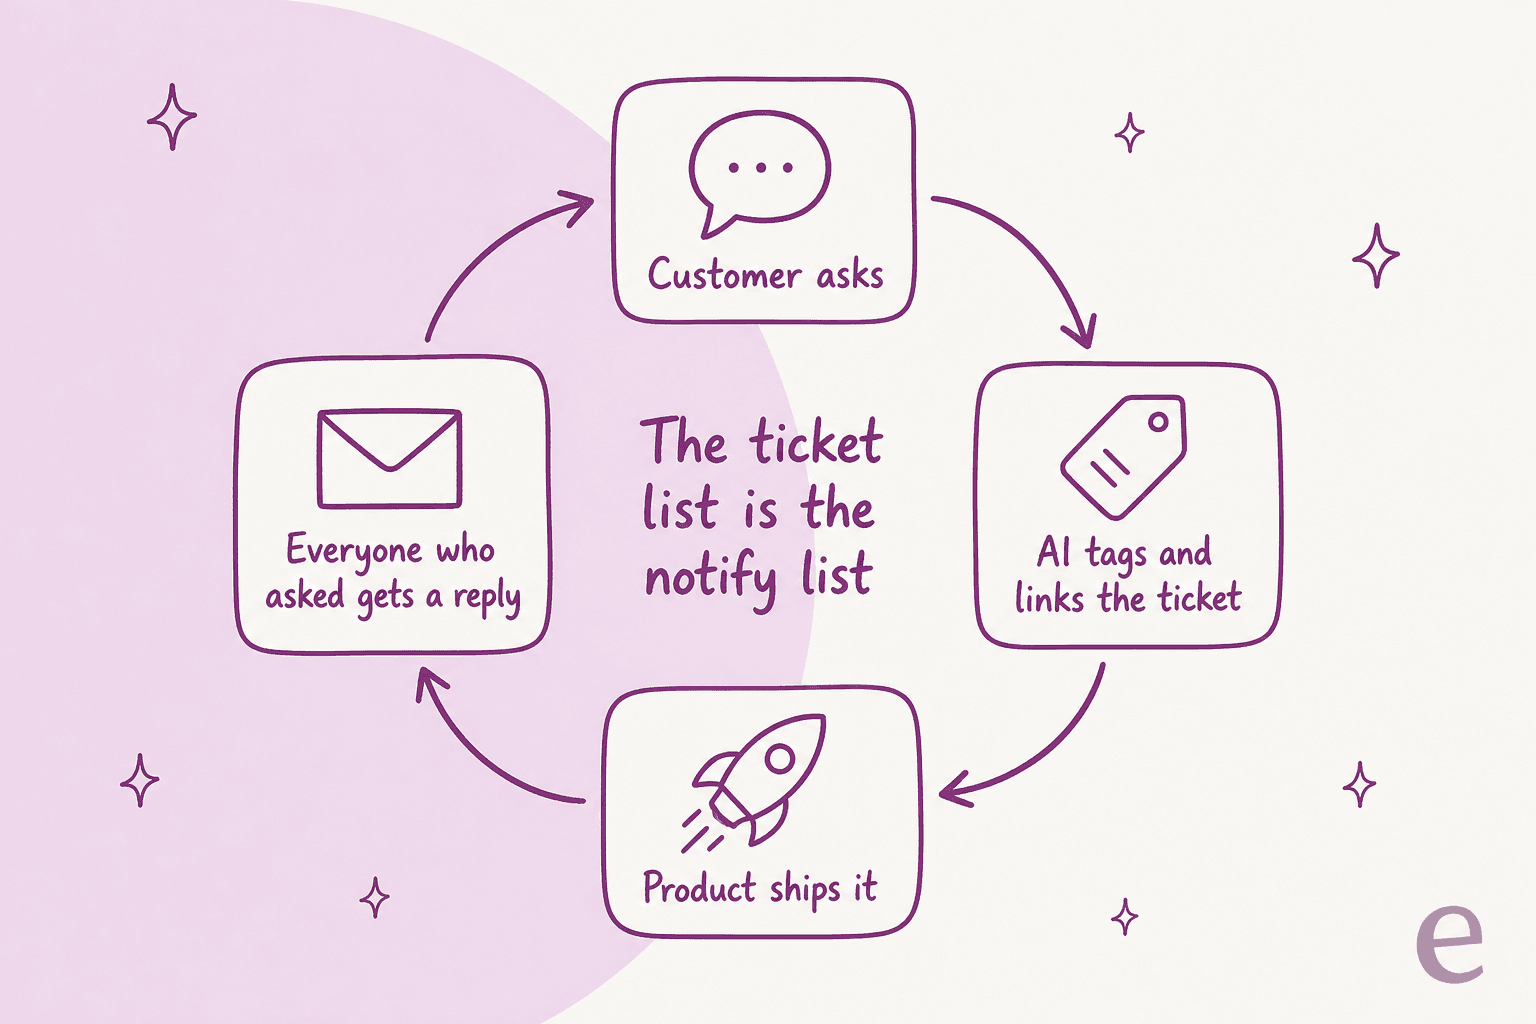
もし今これを設定するなら、私がするのはこの転換です。チケットリストを通知リストとして扱うこと。各リクエストが、それを要望したすべてのチケットへのリンクを保っていれば、「リリースされた」は、それぞれ文脈を持つ会話の既知のリストになります。AIは各会話に、その顧客が何を望み、その間に何を使っていたかに触れた返信を下書きでき、人がそれを承認します。顧客は、頼んだのと同じスレッドで、同じチームから返事を受け取ります。これはZendeskチケットをJiraへエスカレーションするのと同じ考え方を、逆向きに実行するものです。
ヘルプデスクでAIによる機能リクエスト追跡をどう設定しますか?
設定は6つのステップです。何がリクエストに当たるかを定義し、AIに固定のタグリストを与え、リクエストの置き場所を選び、作成前に検索させ、承認から始め、「リリースされました」の返信をつなぎます。以下に、それぞれの進め方を示します。eeselを例にしているのは私が知っているからですが、手順はどのエージェントにも当てはまります。
1. 機能リクエストとは何かを書き出す
先ほどの4つのレーンを、自社のチケットから取った実例を2〜3件ずつ添えて、エージェントの指示に入れます。「すでにある」レーンも含め、回答の元にすべきヘルプ記事を示してください。eeselの指示はプレーンテキストなので、何をリクエストとみなすかの変更はプロジェクトではなく、ちょっとした編集で済みます。smavaの設定も同じ仕組みです。そのカテゴリ分けエージェントは「picks one category from smava's mapping document, judging by intent」で、すべてのルールが指示の中にあります。
2. 固定のタグリストとフィールドを与える
機能リクエスト用のタグをひとつ選び、ヘルプデスクにカスタムフィールドがあれば、プロダクト領域のフィールドも用意します。eeselのZendeskアクションには、Add tags、Update ticket、Get ticket field optionsがあり、最後のものは推測せずに実際のフィールド値を読むためのものです。SE Rankingはこれを計測に使っています。eeselが触れたすべてのチケットにai_handledタグを付けるよう求め、数字が誰かの頭の中ではなくZendeskにあるようにしました。Zendesk Exploreでレポートするなら、チケットタグのレポートのガイドで件数をグラフにする方法がわかります。
3. リクエストの置き場所を決める
プロダクトチームがJiraを使っているなら、エージェントはそこに直接作成できます(ZendeskとJiraのガイドではネイティブの方法も扱っています)。eeselのJira Service Management連携には、Create Issue(プロジェクト、要約、説明、担当者、ラベル)とLabel Issueがあります。チームがAsanaを使っているなら、タスクを作成するネイティブのAsana連携があります。Linear、Canny、Productboardについては、ドキュメント上ネイティブのeesel連携はないため、Network AccessでそのAPIを接続します。これにより、エージェントは許可した任意のREST APIにGET、POST、PATCH、DELETEの呼び出しができます。もうひとつの方法は、トラッカー自身のZendeskアプリをリンクに使い続け、エージェントはタグ付けと返信だけに使うことです。
4. 作成前に検索させる
このステップが重複を防ぎます。eeselのJira連携にはSearch Issuesアクションがあり、「finds issues with a JQL query, so your agent can find related or duplicate issues」です。Asanaのドキュメントは率直に述べています。「Tell it to search before it creates. Otherwise you get a second copy of a task that already exists.」これを指示に書いてください。まず検索して、一致があればリンクし、なければ作成し、どちらの場合もチケットのリンクと顧客をissueに追加します。
5. マージと新規issueは承認制で始める
eeselのすべてのアクションは、エージェントごとにAuto、Needs approval、Disabledで動かせます。アクションと承認のドキュメントに説明があります。私のおすすめは、タグ付けは初日からAuto、Create Issueは最初の数週間Needs approvalです。チェックされないAIのマージは顧客の要望を埋もれさせることがあり、このCannyユーザーに起きたのがそれです。
"Their AI assistant that auto-creates features for you merges tickets in a way that's not helpful. What the AI tool was doing was: 1. Creating a feature request based on feedback 2. Merging an old ticket into the newly created feature request That was driving me mad! The trouble was being able to find my old ticket that I KNEW I created."
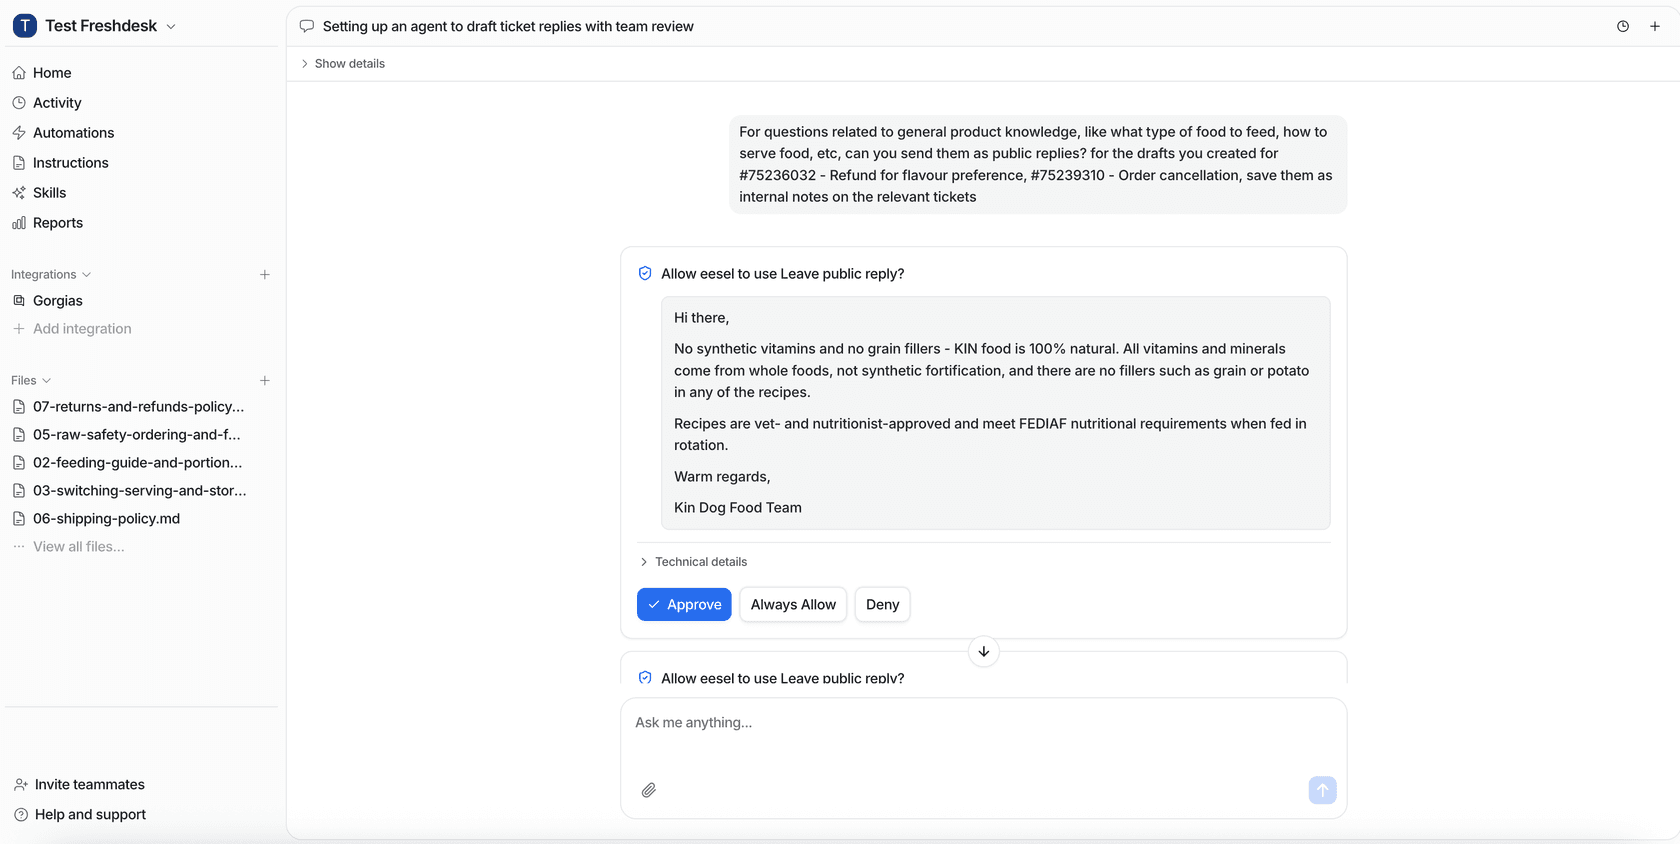
数週間後、承認が適切に見えるなら、信頼できるものに「Always allow」をクリックします。そのアクションはそれ以降Autoに切り替わります。
6. 「リリースされました」の返信をつなぐ
ここには現実的な制限があります。eeselのJiraトリガーはissueが作成またはコメントされたときに発火し、ステータスが変わったときには発火しないため、「Done」を自力では検知できません。回避策は、issueがDoneに移ったときにeeselのwebhookへWebリクエストを送るJira Automationルールです。「Send any JSON you like, and your agent reads all of it.」エージェントはissueキーとともに起動し、ヘルプデスクでそれにタグ付けされ紐付いたチケットを検索し、それぞれに返信を下書きします。返信は、少なくとも1バッチ読み通すまではNeeds approvalのままにしておきます。
週次ビューには、スケジュールを毎週月曜に実行し、eeselのSlack連携で上位のリクエストをSlackチャンネルに投稿できます。ただし、そのチャンネルに招待されている必要があります。Reportsスキルの「Analyze ticket trends」は、反対側から同じ範囲をカバーします。何度も出てくるテーマを、件数とセンチメント付きで示します。ターミナルから操作したいなら、eesel CLIでeesel automationsによりオートメーションを一覧し、eesel integrations connect jiraでJiraを接続し、承認もターミナルから扱えるので、Claude Codeのようなコーディングエージェントが、ダッシュボードで設定したのと同じエージェントを操作できます。
機能リクエストは数えるべきですか、重み付けすべきですか?
重み付けしますが、生の件数も見える状態に保ってください。件数だけでは、最も多く書き込む人が得をします。Cannyを使っているRedditのプロダクトマネージャーが、まさにこの偏りを述べていました。
"I just feel like they just make it easier for users to throw feature requests at my team and in my experience often the vast majority of feature request don't help a ton unless a common request and they could be biased by power users."
より賢いAIのスコアでは解決しません。より良い入力が解決します。リンクされた各チケットがアカウントとプランを持っていれば、プロダクトマネージャーは「最上位プランの顧客からのリクエスト」や「解約に言及したアカウントからのリクエスト」で並べ替えられます。Linearのドキュメントには、Enterpriseティアのissueのうち「where each issue has at least 20 requests」のものを顧客数順に並べたビューの例があります。サポートの役割は、そのデータがリクエストに載るようにすることで、何を作るかの判断はプロダクトの仕事のままです。
丁寧に記録するサポート側の理由もあり、Redditのカスタマーサクセスマネージャーがうまく言っています。
"It's pretty big, especially in a CYA way. For example, if an Enterprise customer threatens to cancel for years due to a missing feature, you need to make that well known in case they churn so people know that you sounded the alarms."
アカウント付きのタグは、その警鐘を書面に残したものです。そしてリクエストが一貫してタグ付けされれば、キューが教えてくれる他のすべてと並んで、そのまま問い合わせ理由のレポートに収まります。
eeselで機能リクエストを追跡する
eeselは、Zendesk、Freshdesk、Gorgiasにある既存のキューに参加するAIヘルプデスクのチームメイトです。そのため機能リクエストの追跡は、サポートが開くのを覚えておかなければならない別のツールではなく、要望が届く場所で行われます。「すでにある」チケットはヘルプセンターから回答し、本物のリクエストはあなた自身のリストからタグ付けし、作成前にJiraを検索して重複が増えずにリンクされるようにし、作業がリリースされたら、リンクされたすべてのチケットに「リリースされました」の返信を下書きします。
タグ付けの部分は、すでに大規模に動いています。smavaは月に14,600件のZendeskチケットをフィールドに分類し、Dokument 24は月に430件のチケットを製品別にタグ付けし、SE Rankingのエージェントは1か月に約400件のチケットを、証拠を添えてセカンドラインのチームのために作成しました。
料金はシート単位ではなくチケット単位です。500クレジットで月額$299、1チケットはエージェントが中で何をしても1クレジットなので、ひとつのチケットでタグ付け、Jira検索、issue作成を行っても1クレジットで済みます。自分のキューで試せる、100クレジットの無料プランがあります。eeselを試す。