

Tencent Hunyuan Hy4 (la « Hy4 preview ») est un gros modèle à poids ouverts conçu pour faire avancer le travail, pas pour discuter. C'est un modèle Mixture-of-Experts de 770B paramètres avec 49B actifs par token, un contexte de 1M de tokens et une licence Apache 2.0, publié le 28 août 2026 pour le code, la productivité bureautique, le développement de jeux et la recherche scientifique.
Côté chiffres : le test à l'aveugle de Tencent le place un cheveu devant Kimi K3 et GLM-5.3, mais sur les benchmarks publics il partage les victoires avec eux et se classe généralement derrière Claude Opus 5 et GPT-5.6. La lecture honnête est « à peu près au niveau des autres modèles phares chinois », avec deux vrais atouts : c'est le moins cher des modèles ouverts haut de gamme, à 0,834 $ en entrée / 2,501 $ en sortie par million de tokens, et les poids sont réellement ouverts.
Le hic qui domine toutes les discussions : il est trop gros pour tourner en local. Les poids seuls demandent environ 924 Go même quantifiés, c'est donc un modèle de datacenter ou d'API, pas un modèle pour portable. Et comme c'est un modèle brut, la plupart des équipes rencontreront Hy4 via l'API ou un produit bâti dessus, pas en le téléchargeant. Si ce que vous voulez vraiment, c'est une IA qui accomplit un travail précis du début à la fin, un coéquipier prêt à travailler comme eesel convient mieux que n'importe quel modèle de base, Hy4 compris.
Ce qu'est réellement Tencent Hy4
Tencent a publié et mis en open source Hy4 preview le 28 août 2026, en le décrivant comme un modèle « built for real-world productivity tasks, delivering outstanding performance across coding, office work, and scientific research. » C'est le dernier modèle de l'équipe Hunyuan de Tencent, après la lignée Hy3, et il est sorti avec des poids ouverts dès le premier jour.
Le positionnement compte. Il n'est pas présenté comme un assistant sympathique pour rivaliser avec un chatbot IA généraliste. Tencent l'a co-conçu avec ses propres produits CodeBuddy et WorkBuddy et l'a entraîné sur des données de travail d'ingénieurs logiciels, de développeurs de jeux, d'analystes financiers et d'experts en sécurité. Les capacités phares sont par exemple le débogage sur de longues tâches, la transformation d'un contexte multi-fichiers désordonné en documents et feuilles de calcul, la génération d'un prototype de jeu jouable à partir d'un seul prompt, et le raisonnement sur des problèmes de recherche en dynamique moléculaire ou en mathématiques pures.
Voici les spécifications qui comptent, d'après la fiche du modèle sur Hugging Face :
| Propriété | Valeur |
|---|---|
| Architecture | Mixture-of-Experts (MoE) |
| Paramètres totaux | 770B |
| Paramètres actifs par token | 49B |
| Couches | 78 (1 dense + 77 MoE) |
| Experts routés / partagés | 256 routés + 1 partagé, top-8 activés |
| Longueur de contexte | 1M de tokens |
| Attention | Gated DeepSeek Sparse Attention (Gated DSA) |
| Licence | Apache 2.0 |
| Variantes | BF16 instruct + build FP8 officiel |
Un bon signe d'honnêteté : Tencent qualifie le modèle de « preview » et énumère ouvertement ses défauts. La fiche admet que Hy4 passe plus de temps que nécessaire à raisonner sur les tâches complexes et a « a tendency to over-verify its own work. » Cette approche, publier tôt puis itérer, est celle qui a rendu Hy3 bien plus solide entre sa preview et sa version finale.
Comment fonctionne le design Mixture-of-Experts
Les deux chiffres sur lesquels tout le monde se focalise, 770B et 49B, décrivent l'astuce centrale d'un modèle Mixture-of-Experts, et elle mérite d'être comprise parce qu'elle explique à la fois pourquoi Hy4 est rapide et pourquoi il est un cauchemar à faire tourner.
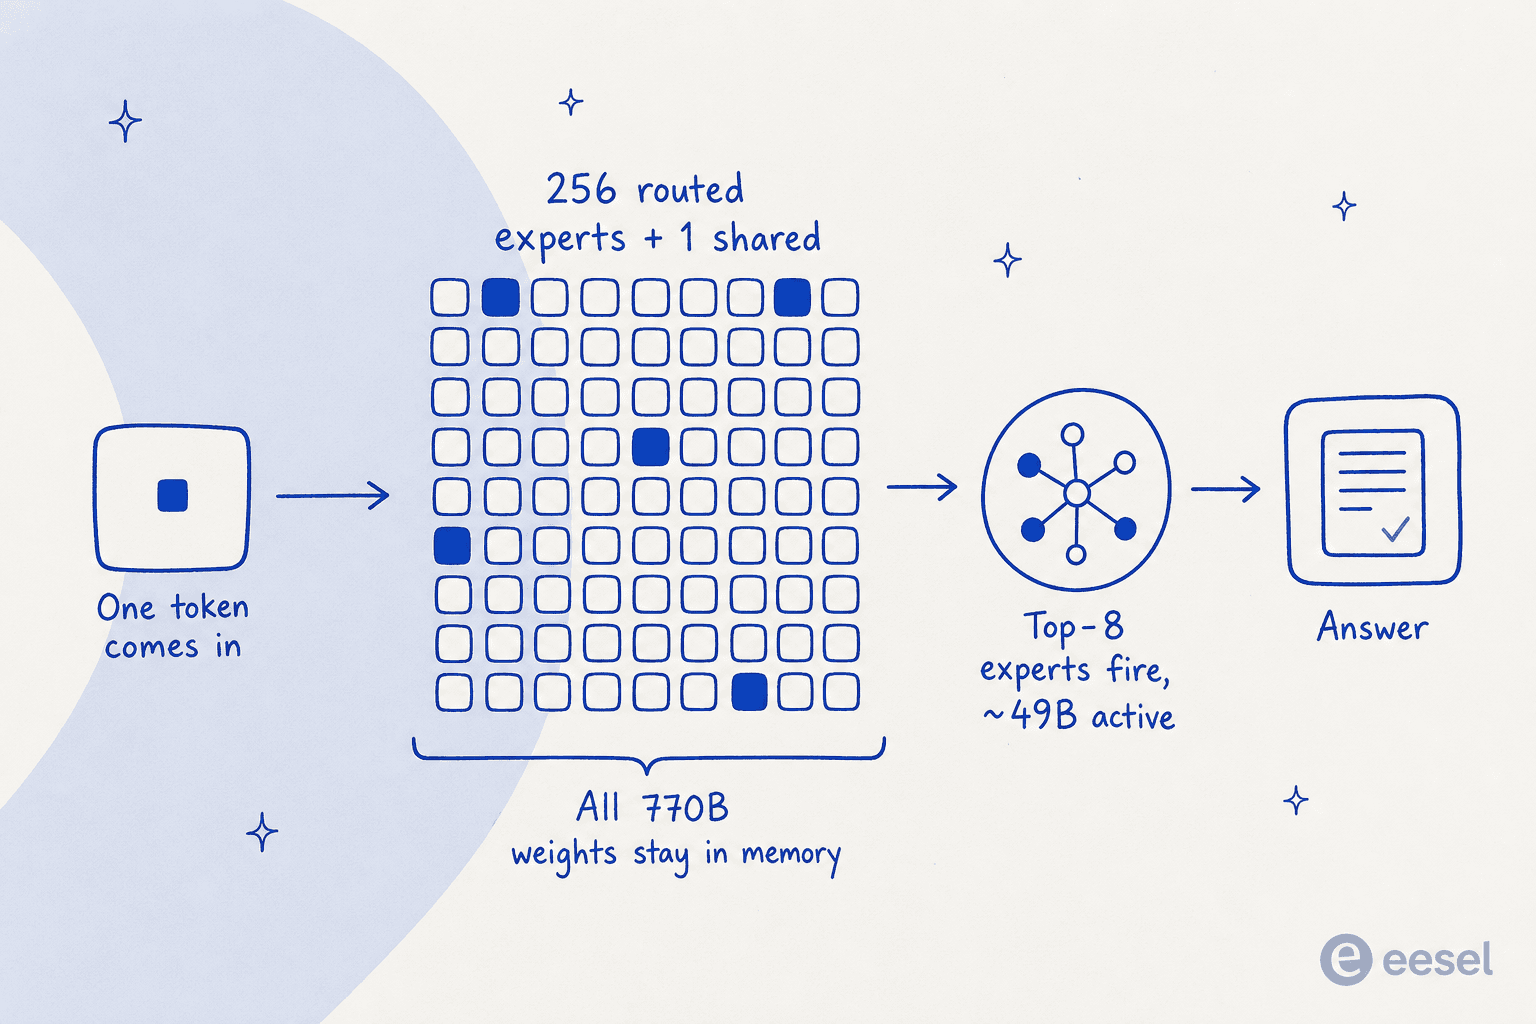
L'ossature compte 78 couches. La première est une couche dense standard ; les 77 autres contiennent chacune 256 experts routés plus 1 expert partagé. Quand un token arrive, un routeur choisit les 8 experts les plus pertinents pour lui, et seuls ceux-ci (plus le partagé) calculent réellement. Ainsi, même si le modèle fait 770B paramètres, environ 49B s'activent par token. C'est ce qui garde le débit d'inférence viable : vous ne payez pas à chaque token le coût de calcul d'un modèle dense de 770B.
Sous le capot, Tencent s'est appuyé sur des idées de DeepSeek et de GLM : l'attention utilise une Gated Sparse Attention avec un cache d'index réutilisable, et une couche native de prédiction multi-tokens est ajoutée pour le décodage spéculatif, qui accélère la génération à petite taille de lot. L'important est de retenir le hic de la section suivante : MoE économise du calcul, pas de la mémoire. Les 770B poids doivent tous tenir en mémoire GPU en même temps.
Les benchmarks, lus honnêtement
Le matériel de lancement de Tencent affirme « bat GLM-5.3 et Kimi K3 », ce qui est techniquement vrai mais bien plus mou qu'il n'y paraît. L'affirmation vient d'une évaluation interne à l'aveugle : 163 experts maison ont noté les sorties de modèles sur 203 tâches d'ingénierie, chacune sur 4,00.
| Modèle | Moyenne à l'aveugle (/4,00) | Résultat en duel de Hy4 |
|---|---|---|
| Hy4 preview | 2,99 | - |
| Kimi K3 (Moonshot) | 2,94 | Hy4 gagne 51,2 % / égalité 7,9 % / perd 40,9 % |
| GLM-5.3 (Z.AI) | 2,92 | Hy4 gagne 46,8 % / égalité 12,8 % / perd 40,4 % |
Un écart de 0,05 point sur l'échelle de quatre points d'un éditeur, c'est statistiquement un haussement d'épaules. Tencent le signale elle-même : "bounded by its tasks, model versions, raters, and procedure... not an independent public benchmark". Face à GLM-5.3, les victoires de Hy4 ne dépassent ses défaites que de 47 à 40. C'est un quasi-match nul déguisé en avance.
Le graphique des benchmarks publics raconte l'histoire complète, et c'est celui qu'il faut regarder honnêtement :
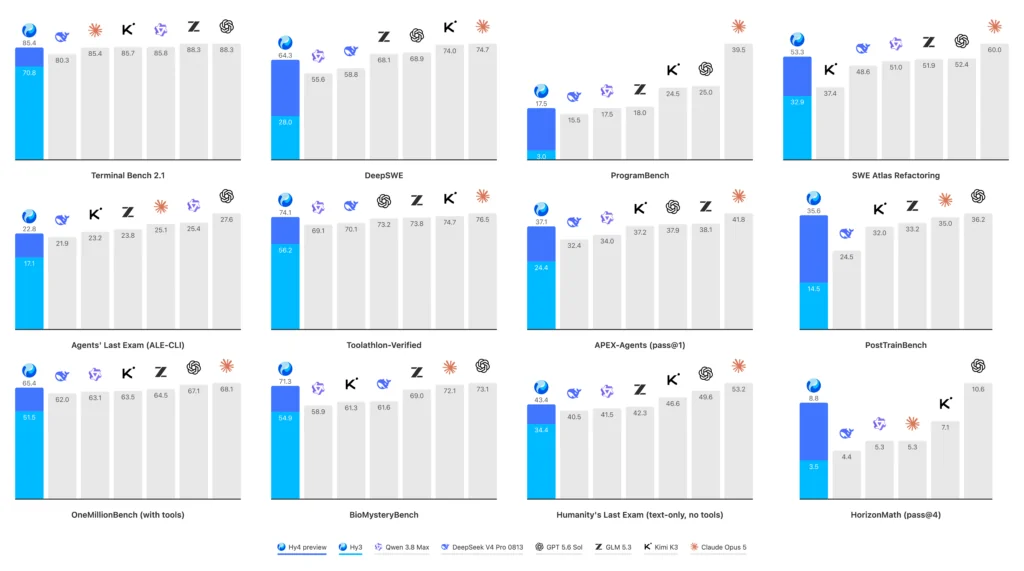
Hy4 affiche quelques scores solides : 92,3 sur GPQA Diamond, 85,4 sur Terminal Bench, 82,9 sur SWE-bench Multilingual, et il mène le champ ouvert sur HorizonMath et BioMysteryBench. Mais en parcourant les douze panneaux, Claude Opus 5 ou GPT-5.6 est généralement en tête, Hy4 se situant au milieu du peloton aux côtés de Kimi K3, GLM-5.3 et Qwen 3.8 Max. La communauté a vite repéré le cadrage :
Why do they always highlight benchmarks where it scored less than other models the same as the ones where it scored better? It's so misleading. I can't even tell which benchmarks it actually beat other models.

Pour un positionnement indépendant, Hy4 n'est pas encore listé dans l'index d'intelligence d'Artificial Analysis, donc il n'existe pas de score agrégé neutre à citer (pour l'échelle, le leader actuel de ce classement, Claude Opus 5, est à 63). Le seul signal tiers à ce jour vient du classement code de LMArena :
Hy4 preview by @TencentHunyuan just landed ~#5 in the Code Arena: WebDev with 1633 pts (AutoEval)... Among open models, Hy4 preview is ~#3, compared to Hy3 at #7.
C'est un vrai bond par rapport à Hy3, mais notez la mention « AutoEval » : Arena indique qu'un modèle de récompense a émis des votes automatiques au lieu de votes humains en direct, donc à considérer comme provisoire. Ma lecture : Hy4 est un modèle ouvert réellement solide, à peu près au niveau des autres modèles phares chinois, et le « bat » relève du marketing sur un quasi-match nul. Si vous voulez un face-à-face plus poussé, la comparaison Qwen 3.8 Max vs Kimi K3 couvre le même segment.
Peut-on vraiment le faire tourner ?
C'est la question qui a dominé tous les fils de lancement, et la réponse est sobre. MoE économise du calcul, mais les 770B poids doivent tous résider en mémoire GPU.
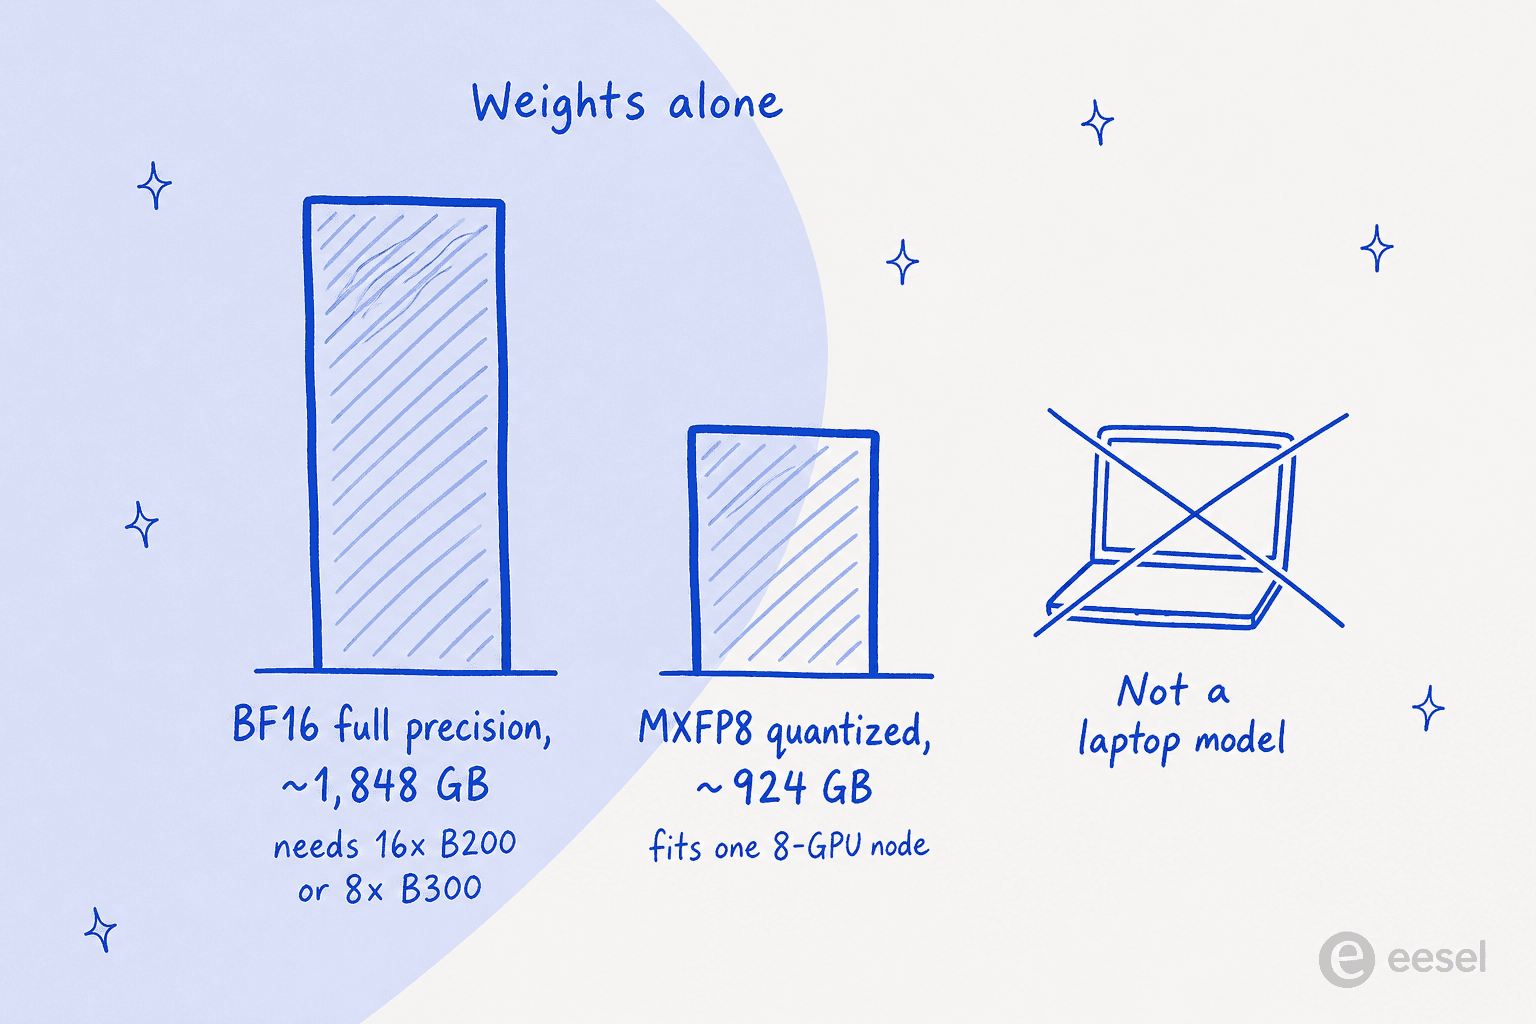
Selon la recette officielle vLLM, les poids BF16 complets représentent environ 1 848 Go. Sa conclusion est brutale : il faut « 16x B200 or 8x B300 minimum for weights + KV cache. » La version quantifiée MXFP8 réduit cela de moitié environ, à 924 Go, ce qui tient sur un nœud de 8 GPU des accélérateurs récents à forte VRAM, et c'est pourquoi l'exemple de déploiement par défaut utilise une taille de tensor-parallel de 8. Il existe un checkpoint FP8 officiel et une boîte à outils de quantification appelée AngelSlim pour le comprimer davantage, mais rien de tout cela ne le met à portée d'une machine personnelle. La communauté r/LocalLLaMA, qui fait tourner de gros modèles par passion, a surtout abandonné :
I don't know who around here runs 780b models, but I am happy for them :)
Même les calculs de quantification de la communauté sont sombres : une version Q4 tourne autour de 450-512 Go, et une machine de 256 Go ne supporte que des quantifications 1-2 bits. Comme l'a dit un commentateur, si vous avez 256 Go, "you'll probably be much better off with GLM-5.3-Flash Q4". Pour la plupart des gens, « poids ouverts » est donc un fait de licence, pas un fait pratique. Vous utiliserez Hy4 via une API.
Tarifs et comparaison
Les tarifs d'API de Hy4 sont de 0,834 $ par million de tokens en entrée, 2,501 $ par million en sortie et 0,042 $ pour les accès au cache. Parmi les modèles ouverts haut de gamme, c'est le moins cher du lot.
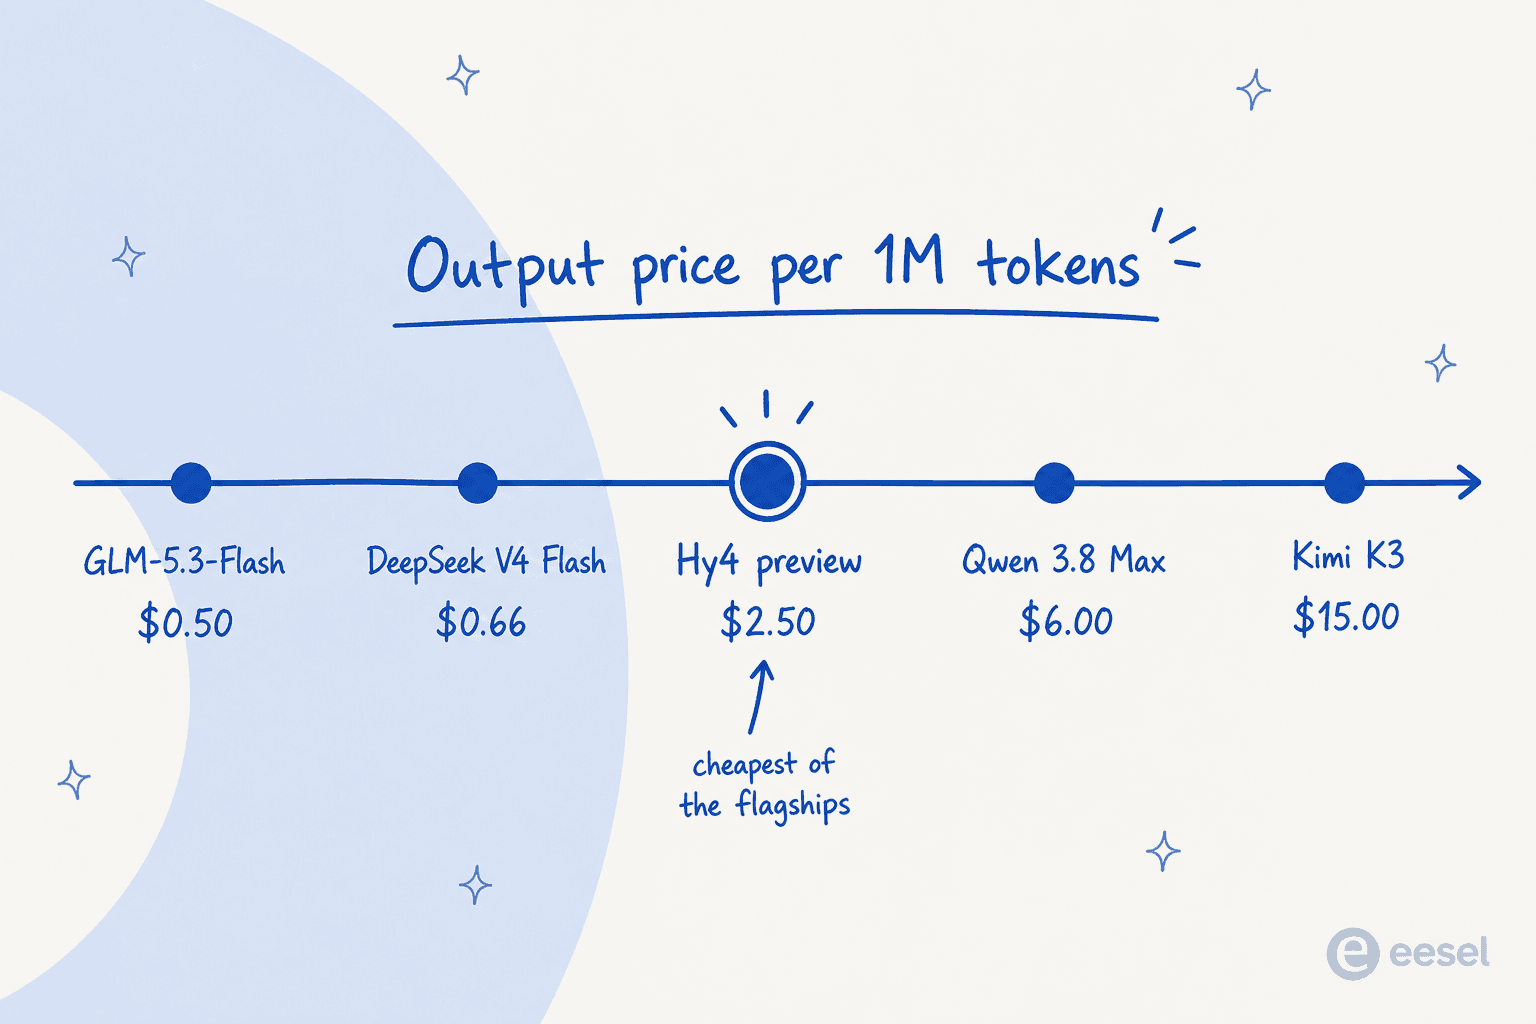
Voici le tableau complet face au champ actuel des poids ouverts (tout par million de tokens, vérifié le 30 août 2026) :
| Modèle | Entrée | Sortie | Entrée en cache | Poids |
|---|---|---|---|---|
| Hy4 preview (Tencent) | 0,834 $ | 2,501 $ | 0,042 $ | Apache 2.0 |
| GLM-5.3-Flash (Z.AI) | 0,15 $ | 0,50 $ | 0,03 $ | Ouverts |
| DeepSeek V4 Flash | 0,22 $ / 0,44 $ | 0,66 $ / 1,32 $ | 0,007 $ | MIT |
| GLM-5.3 (Z.AI) | 1,40 $ | 4,40 $ | 0,26 $ | Ouverts |
| Qwen 3.8 Max | 2,00 $ | 6,00 $ | 0,25 $ | Personnalisée |
| Kimi K3 (Moonshot) | 3,00 $ | 15,00 $ | 0,30 $ | Ouverts |
Hy4 passe donc confortablement sous GLM-5.3, Qwen 3.8 Max et Kimi K3 (dont le tarif de sortie est près de 6 fois celui de Hy4). Mais ce n'est pas le plancher des prix. DeepSeek V4 Flash et GLM-5.3-Flash sont tous deux bien moins chers, et le tarif heures creuses de DeepSeek le ramène à une fraction du coût de Hy4. Il y a aussi un hic pour ceux qui utilisent déjà Hunyuan :
But the new HY4 pricing is roughly 5-6x higher than HY3, so you're looking at about a 400-500% increase in input/output cost.
La seule vraie bonne affaire de la grille est le cache de contexte à 0,042 $ par million, qu'un utilisateur a jugé bien plus bas que celui de GLM-5.3. Si votre charge relit un gros contexte fixe (une base de code, un long document) sur de nombreux appels, c'est ce tarif de cache qui rend Hy4 intéressant. Pour une ventilation plus complète des coûts des modèles voisins, le guide des tarifs de DeepSeek V4 Flash et le guide des tarifs de Kimi K3 sont de bons compléments.
Comment accéder à Hy4 aujourd'hui
Si vous ne montez pas un nœud de 8 GPU, voici où y accéder réellement :
- API : l'identifiant du modèle est
hy4-preview, servi via Tencent Cloud TokenHub et OpenRouter. Les API aux formats OpenAI et Anthropic sont prises en charge, et OpenRouter le propose avec une politique de données sans rétention, un bel avantage face à certaines API chinoises propriétaires dont les conditions sont floues sur l'usage pour l'entraînement. - Gratuit pendant deux semaines : Hy4 est gratuit sur WorkBuddy et CodeBuddy dès le lancement, et l'accès gratuit à Hy3 sur les deux a été prolongé jusqu'au 30 septembre. Il est aussi utilisable dans les applications Yuanbao et ima de Tencent.
- Poids ouverts : disponibles sur Hugging Face, GitHub, ModelScope et GitCode, avec une version BF16 et une version FP8.
Une précision, car elle a circulé au lancement : des CLI de code tierces ont adopté Hy4 rapidement via OpenRouter, mais ce ne sont pas des canaux gratuits officiels de Tencent. Les seules offres gratuites officielles sont WorkBuddy et CodeBuddy.
L'angle de l'auto-amélioration
L'affirmation la plus futuriste du lancement passe facilement inaperçue. Tencent dit que Hy4 a contribué à son propre développement, en participant à l'« automated optimization of training methods, data strategies, evaluation frameworks, and low-level operators », ce qu'elle appelle une « early-stage recursive self-improvement loop. » La version concrète et vérifiable : Hy4 a analysé les goulots d'étranglement de sa propre pile d'inférence, et les optimisations qui en ont découlé ont augmenté le débit de bout en bout de 31,8 %.
Je prendrais le grand cadrage « auto-amélioration » avec des pincettes (un modèle qui propose des fusions d'opérateurs est très loin d'un modèle qui se redessine lui-même), mais le chiffre de 31,8 % de débit est précis et réel, et c'est le genre de prouesse d'ingénierie qui vieillit bien. Il alimente aussi l'espoir récurrent de la communauté que la version finale soit bien plus solide que cette preview :
And this is a PREVIEW? The actual release must actually be fable level or higher then?
Alors, qui devrait vraiment utiliser Hy4 ?
Après avoir tout passé en revue, voici mon verdict honnête. Hy4 est un modèle phare à poids ouverts sérieux, avec un vrai avantage de prix sur Kimi K3 et Qwen 3.8 Max, de solides benchmarks en code et en sciences, et une licence permissive Apache 2.0. Si vous construisez un agent IA sur une infrastructure que vous contrôlez, voulez une licence réellement ouverte et disposez du budget d'API ou du matériel, c'est un choix légitime, surtout pour du code à long contexte et à forte utilisation du cache.
Mais soyez lucide sur deux points. Ce n'est pas l'option la moins chère (DeepSeek et les modèles Flash gagnent là-dessus), et ce n'est pas un leader écrasant (il est au niveau de ses pairs chinois et derrière la frontière fermée). Et surtout, Hy4 est de l'infrastructure. C'est un modèle brut qui répond à des prompts. Il ne connaît pas votre entreprise, ne vit pas dans vos outils et ne fait pas un travail tout seul. Cet écart, entre un modèle puissant et quelque chose qui fait réellement le travail, est tout l'enjeu de la section suivante.
Essayer eesel
Voici la distinction qui compte : Hy4 est un modèle ; eesel est le coéquipier que vous recrutez. Un modèle de base comme Hy4 vous donne de l'intelligence brute qu'il vous faut ensuite câbler, paramétrer par prompts, connecter à vos données et surveiller. eesel est une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler pour des missions précises, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise de son rôle.
L'équipe actuelle comprend un coéquipier IA pour le helpdesk qui rejoint votre file de support existante, consulte les commandes, étiquette les tickets et rédige ou envoie des réponses dans le helpdesk que vous utilisez déjà, et un rédacteur de blog IA qui gère recherche, rédaction et SEO en une seule passe. Tous deux s'entraînent sur vos anciens tickets, votre centre d'aide et vos documents, et sont opérationnels en quelques minutes plutôt que de nécessiter une équipe de ML. Là où un modèle vous laisse avec une zone de prompt, un coéquipier arrive en connaissant déjà le métier.
Autre chose que les modèles bruts ne peuvent pas faire : avant qu'un coéquipier eesel ne passe en production, vous pouvez le simuler sur vos tickets historiques, pour savoir comment il se comportera réellement au lieu d'appuyer sur l'interrupteur en espérant. C'est gratuit à essayer, sans carte bancaire et sans appel commercial. Si votre but est de faire du vrai travail plutôt que de gérer un cluster d'inférence, commencez avec eesel.