

MiniCPM5-2B est un nouveau modèle texte uniquement de 2,5 milliards de paramètres signé OpenBMB, conçu pour tourner sur votre propre matériel. Le titre est réel : il obtient en moyenne 53,9 sur 34 benchmarks, ce qu'OpenBMB présente comme l'état de l'art open source de la classe 2B, et dans leur ensemble de comparaison il devance de peu le meilleur modèle 4B, Qwen3.5-4B à 51,1. Il est sous licence Apache-2.0, offre nativement 128K de contexte, et tourne sur téléphones, ordinateurs portables et mini-PC via Ollama, llama.cpp, MLX et consorts.
Les réserves honnêtes : il est texte uniquement, sans vision, limité à l'anglais et au chinois, et une partie de la communauté doute que ses victoires en benchmark résistent à de vrais environnements de code. Il existe aussi un écart public sur son score à l'Artificial Analysis Index (les trackers indépendants disent 15, le tweet d'OpenBMB dit 23).
Qui devrait s'y intéresser : si vous construisez des assistants locaux, des outils embarqués ou un agent artisanal et que vous voulez quelque chose de petit et sous licence permissive, MiniCPM5-2B est l'un des modèles de moins de 4B les plus intéressants du moment. Si vous avez réellement besoin d'une IA qui résout des tickets de support en production, un modèle brut n'est pas le bon niveau, et j'explique pourquoi vers la fin.
Ce qu'est vraiment MiniCPM5-2B
MiniCPM5-2B est sorti vers le 6 et 7 septembre 2026 comme deuxième modèle de la gamme MiniCPM5 d'OpenBMB, après le plus petit MiniCPM5-1B. OpenBMB (aussi connu sous le nom de ModelBest) publie depuis quelques années des modèles petits et efficaces, et cette gamme tient en une idée : amener de vraies capacités sur du matériel en périphérie plutôt que sur un GPU de centre de données.
Voici les caractéristiques qui comptent, toutes issues de la fiche du modèle :
| Champ | Valeur |
|---|---|
| Paramètres | 2 516 756 480 (environ 2,52B) |
| Architecture | LlamaForCausalLM standard, 42 couches |
| Attention | Grouped-query, 16 têtes de requête, 2 têtes KV |
| Longueur de contexte | 131 072 tokens (128K) |
| Licence | Apache-2.0 (poids et dépôt) |
| Modalité | Texte uniquement, anglais et chinois |
| Formats | BF16, plus GGUF, MLX 4 bits, GPTQ 4 bits |
Un choix de conception fait beaucoup de travail en silence ici. MiniCPM5-2B utilise l'architecture simple LlamaForCausalLM, de sorte que, selon les mots d'OpenBMB, les moteurs courants peuvent le charger directement avec "no custom kernels, no model-code fork." C'est pourquoi il est sorti avec une prise en charge dès le jour 0 dans vLLM, SGLang, llama.cpp, Ollama, LM Studio et MLX, au lieu de la traditionnelle attente de deux semaines pour que l'écosystème suive. Si vous avez déjà essayé de faire tourner un nouveau modèle ouvert le jour de sa sortie, vous savez que cette largeur dès le jour 0 n'a rien d'acquis.
L'autre chiffre phare, ce sont ces 128K de contexte, vraiment énormes pour un modèle aussi petit, et les benchmarks de contexte long (plus bas) suggèrent que ce n'est pas qu'un chiffre de fiche technique qui s'effondre en pratique.
Les benchmarks : un 2B peut-il vraiment battre un 4B ?
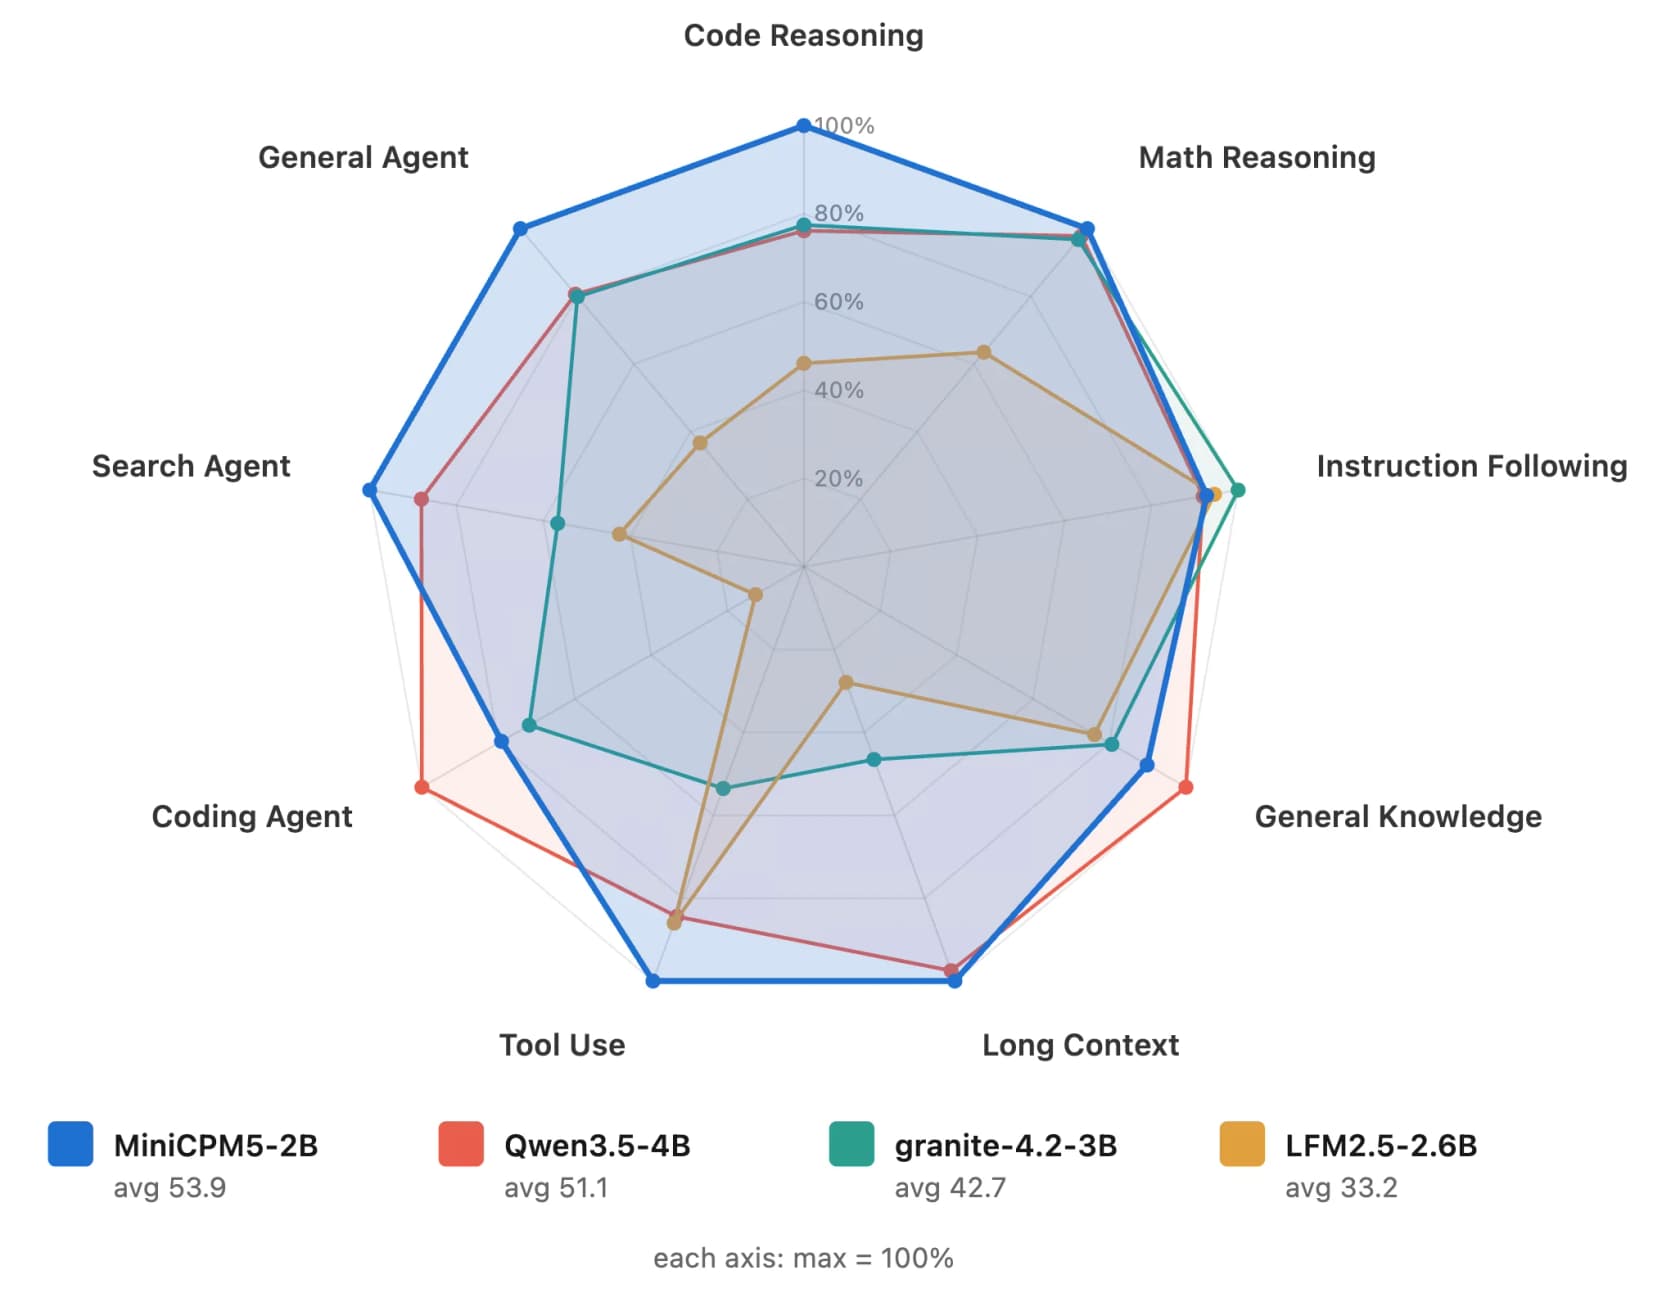
C'est l'affirmation sur laquelle tout le monde s'est jeté, alors voici le vrai tableau. Sur la suite de 34 benchmarks d'OpenBMB, MiniCPM5-2B obtient en moyenne 53,9, devant Qwen3.5-4B à 51,1 et bien au-dessus des autres modèles de la classe 2B avec lesquels il a été testé.
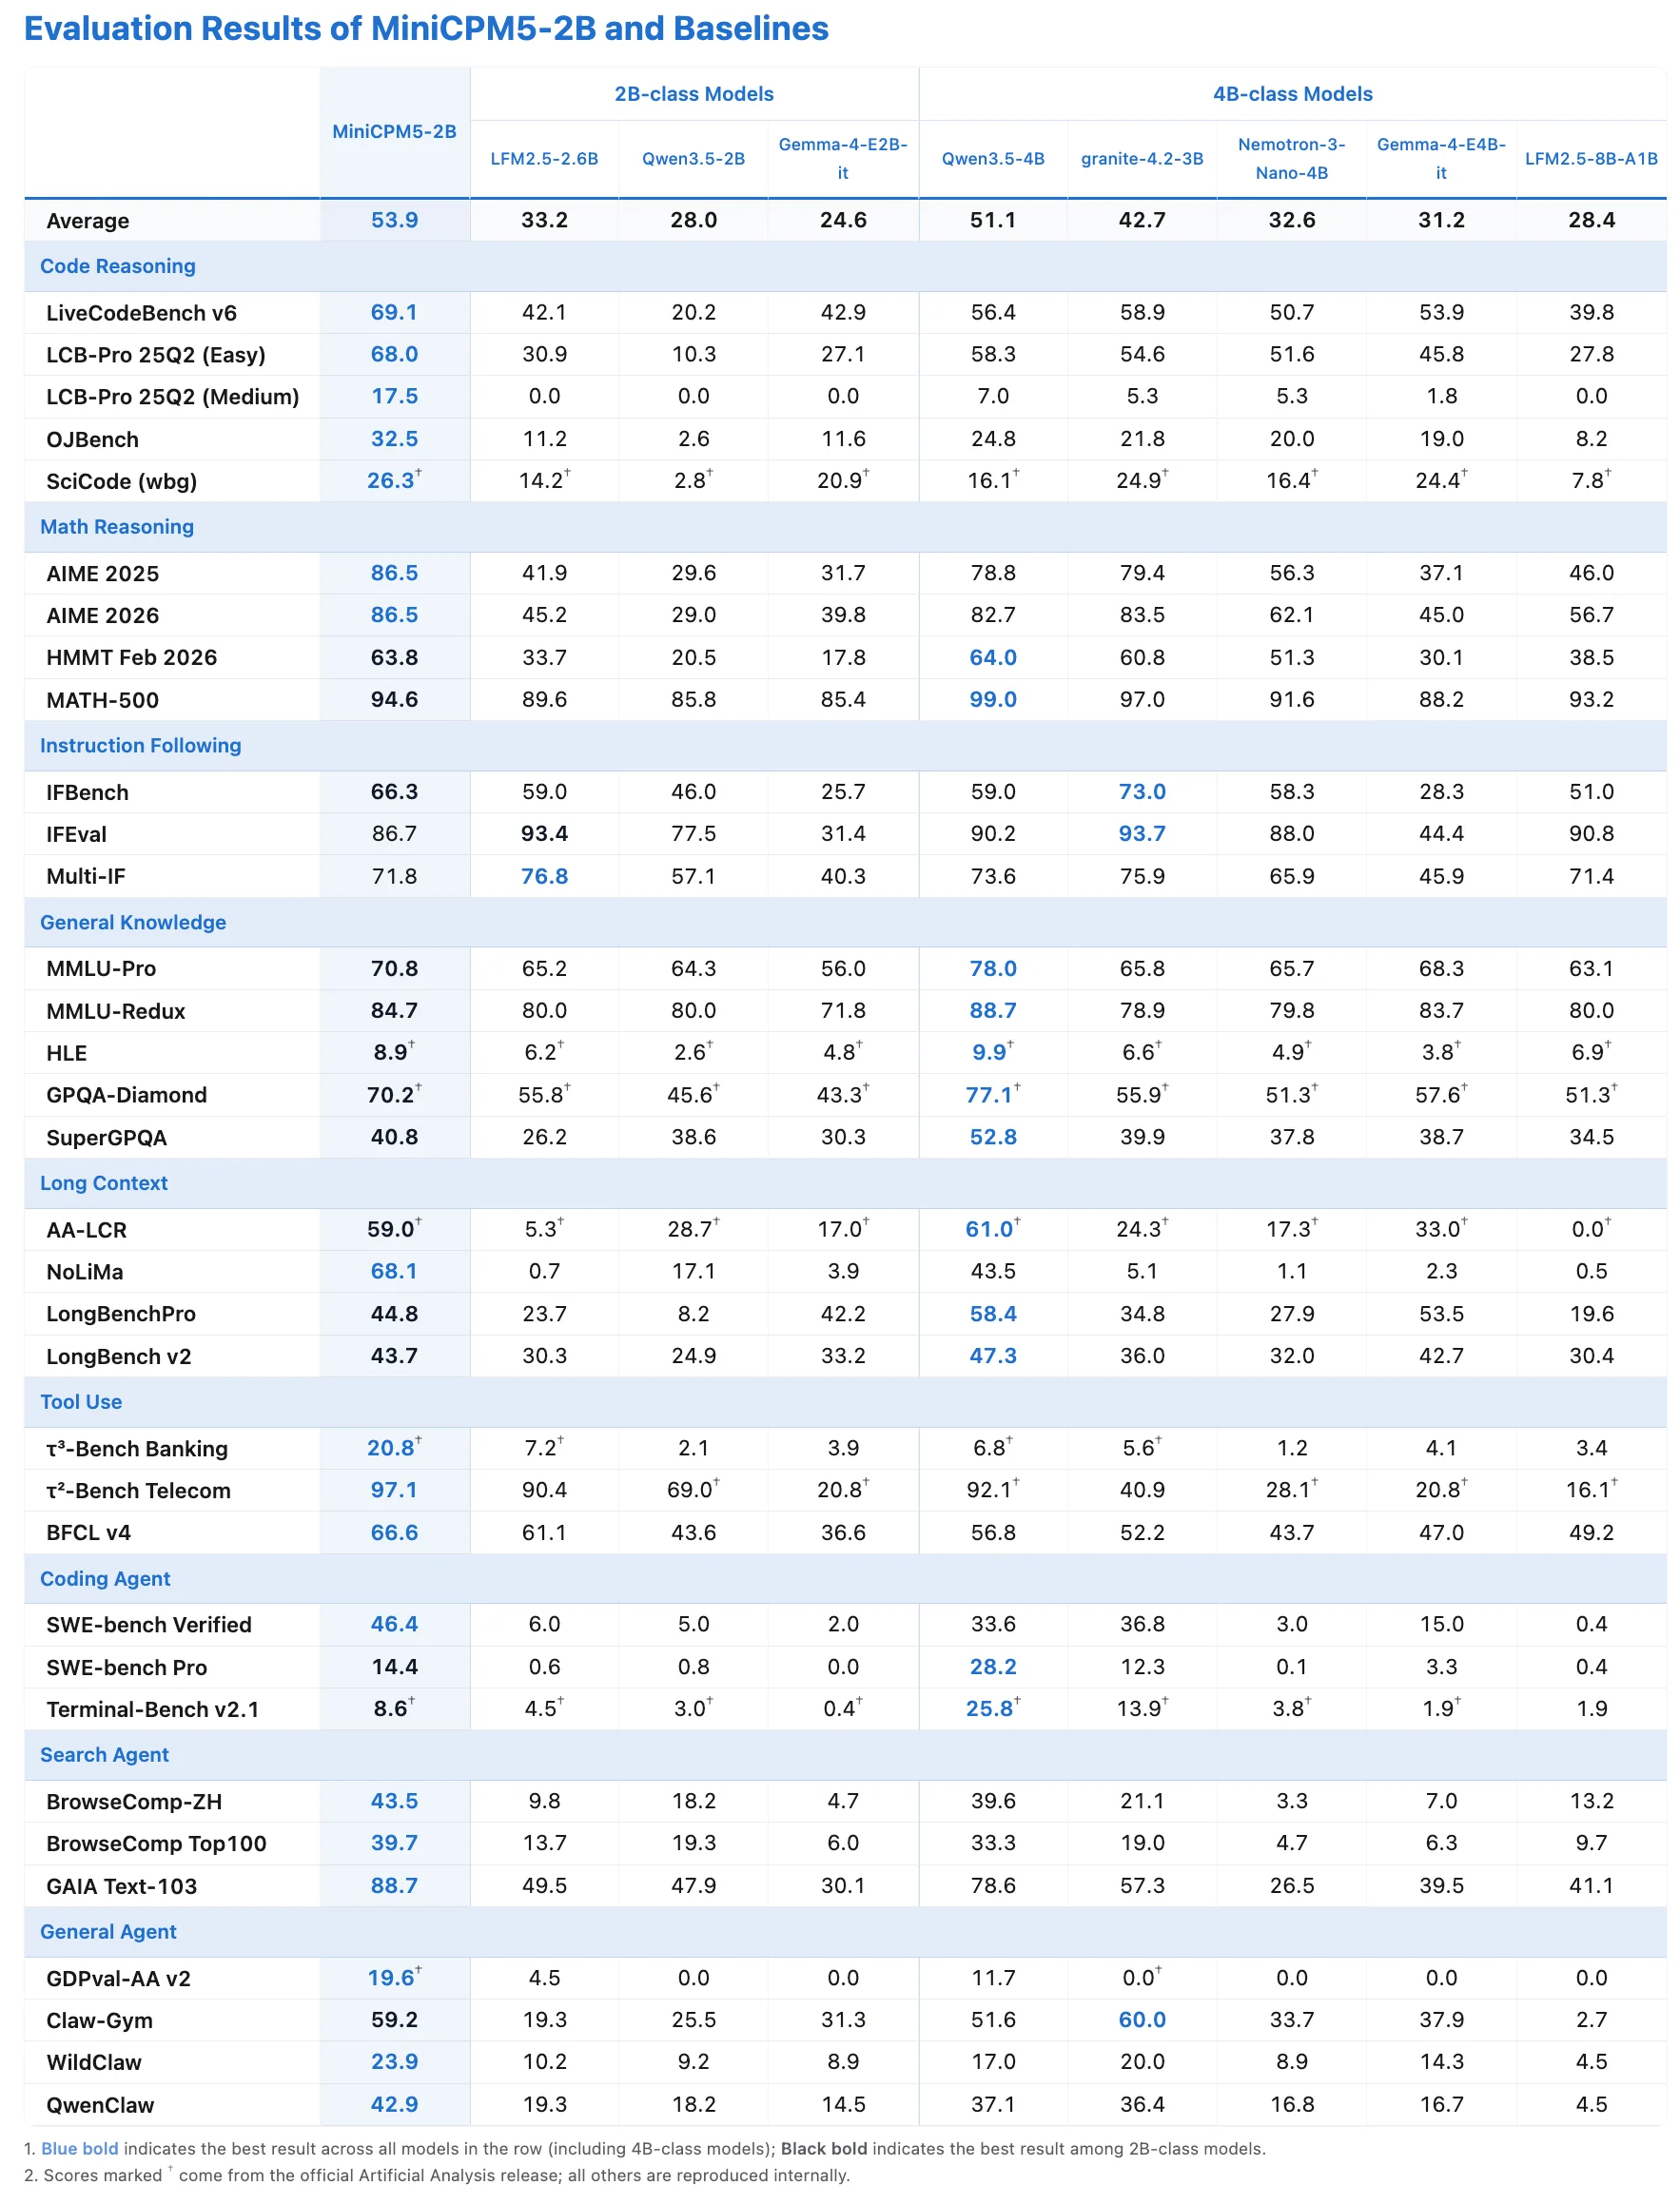
Les lignes marquantes sont celles où ça devient intéressant. En maths, il atteint MATH-500 94,6 et AIME 2026 86,5. En raisonnement sur le code, il domine le tableau avec LiveCodeBench v6 69,1 et SWE-bench Verified 46,4, tous deux au-dessus du Qwen 4B. En utilisation d'outils, il affiche τ²-Bench Telecom 97,1 et BFCL v4 66,6, et côté agents de recherche, GAIA Text-103 atteint 88,7. Pour un modèle qu'on peut faire tourner sur un portable, ces chiffres d'agents et d'utilisation d'outils sont la surprise.
Deux choses à garder honnêtement en tête. D'abord, c'est l'ensemble de comparaison d'OpenBMB lui-même, donc le « bat un 4B » est vrai au sein des modèles et benchmarks qu'ils ont choisis, pas une affirmation universelle. Le Qwen 4B gagne encore plusieurs lignes de connaissances et de contexte long (MMLU-Pro 78,0, GPQA-Diamond 77,1). Ensuite, il y a un vrai écart sur le chiffre tiers. Le fil de lancement sur r/LocalLLaMA et la soumission sur Hacker News rapportent tous deux un Artificial Analysis Intelligence Index de 15, "the highest of any open weights model at 4B parameters or below." Le tweet de lancement d'OpenBMB, lui, revendique un score de 23 et un 20 à l'Agentic Index. Cela ne concorde pas dans les sources que j'ai pu vérifier, probablement une différence de version ou d'arrondi, donc je retiendrais le 15 indépendant comme chiffre prudent et traiterais le 23 comme celui du fournisseur.
Une nuance de plus : OpenBMB ne publie pas les scores classiques MMLU, GSM8K ou HumanEval que l'on cherche d'instinct. La fiche utilise une suite plus récente (MMLU-Pro, LiveCodeBench, SWE-bench, etc.), donc si vous comparez avec la fiche technique d'un modèle plus ancien, vous ne trouverez pas de ligne directement comparable.
Comment un modèle 2B en est arrivé là
Ce que je trouve le plus intéressant n'est pas le score, mais la recette d'entraînement qui l'a produit, car elle explique pourquoi un modèle 2B dépasse sa catégorie au lieu de ressembler à du marketing.
La version finale n'est pas le fruit d'un seul entraînement. Après le pré-entraînement de base et intermédiaire sur les jeux de données UltraData d'OpenBMB, l'étape de post-entraînement enchaîne un fine-tuning supervisé, puis de l'apprentissage par renforcement avec des enseignants spécialisés en maths, code, tâches agentiques et rédaction, avec leur algorithme JustRL II. L'astuce est la dernière étape : la distillation on-policy fusionne 16 modèles experts distincts (dont 5 experts agentiques) dans l'unique version 2B via une KL inverse sur tout le vocabulaire entre élève et enseignant. En clair, ils ont entraîné une équipe de spécialistes, puis recompressé leurs compétences dans un seul petit modèle.
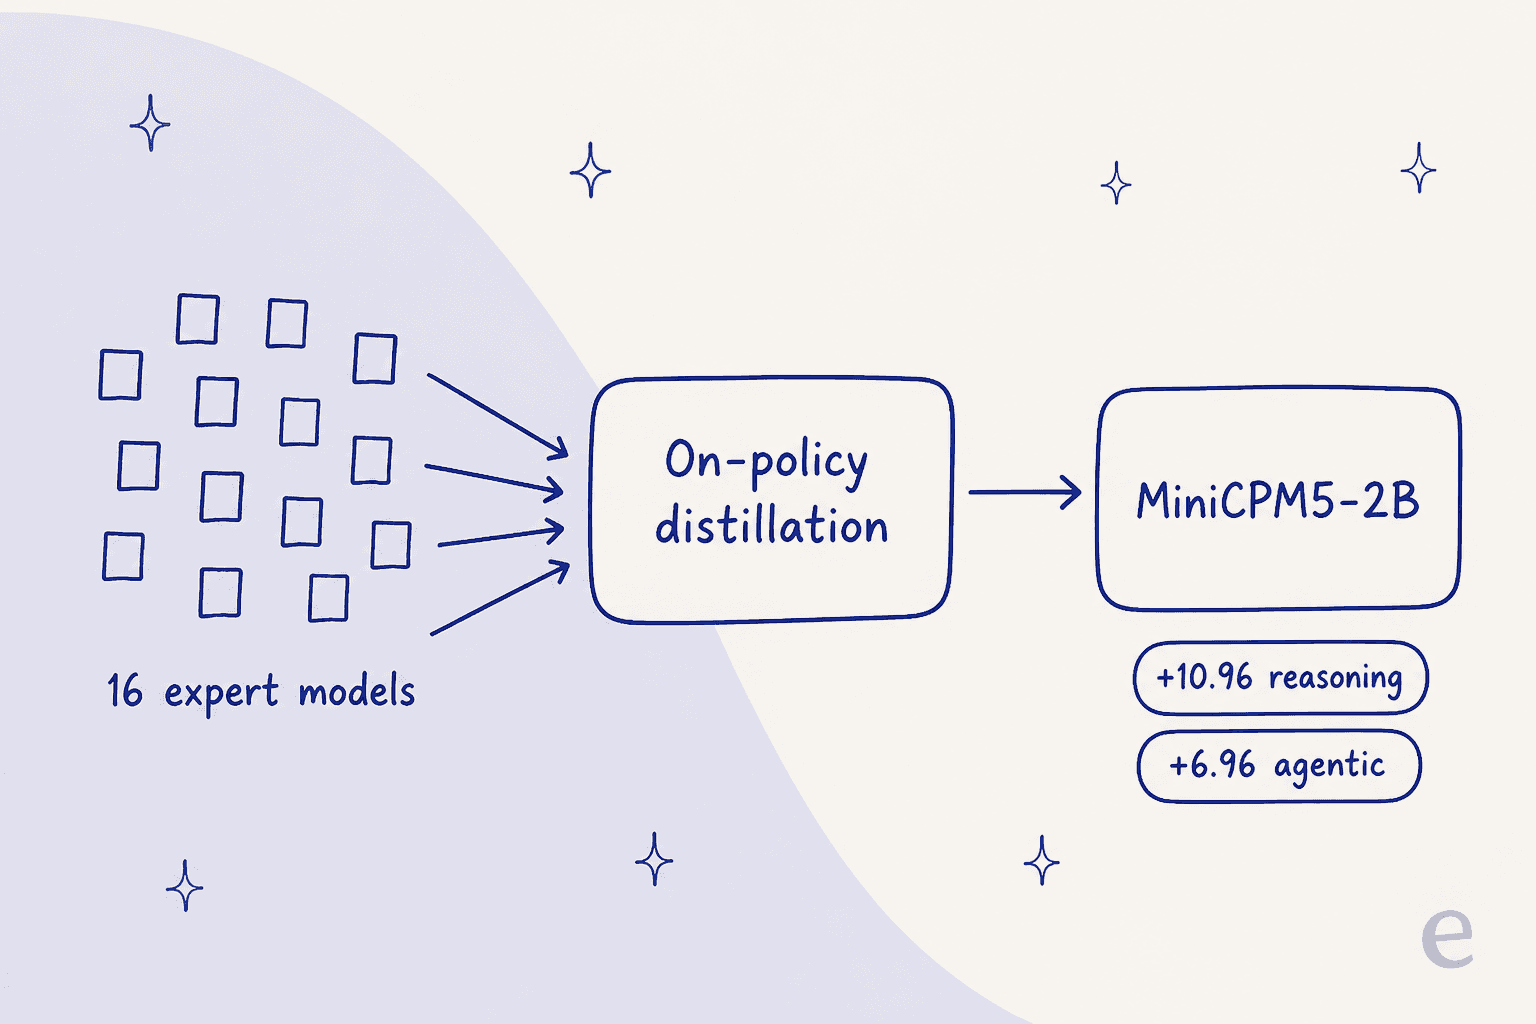
D'après la fiche du modèle, cette étape de RL plus distillation a fait progresser les benchmarks de raisonnement et généraux de 10,96 points en moyenne et les tâches agentiques de 6,96 points par rapport au checkpoint SFT seul. C'est un bond considérable pour une passe de post-entraînement, et c'est le mécanisme derrière l'histoire « petit modèle, gros score ». Si vous voulez comprendre comment on construit aujourd'hui les petits modèles, cette recette mérite une lecture attentive.
L'exécuter : où se place MiniCPM5-2B
Comme il utilise une architecture standard, faire tourner MiniCPM5-2B est agréablement ennuyeux, ce qui est un compliment. La fiche du modèle donne une commande vLLM en une ligne :
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
Si l'appel d'outils vous importe, SGLang est le backend recommandé : le modèle émet des appels d'outils de style XML et le parseur intégré minicpm5 de SGLang les convertit en tool_calls compatibles OpenAI. Il existe aussi un modèle brouillon DSpark pour le décodage spéculatif si vous voulez une sortie plus rapide sans changer les résultats. Pour ordinateur portable et téléphone, les versions GGUF et MLX 4 bits fonctionnent avec Ollama, LM Studio, llama.cpp et MLX, et OpenBMB revendique aussi une adaptation dès le jour 0 aux puces Intel, Arm et Rockchip, avec environ 1,7x de gain en prefill et 1,2x en decode sur du matériel mobile Arm SME2.
Les démos de débit embarqué sont là où l'on quitte la fiche technique. Un testeur a fait tourner 32 sous-agents concurrents sur un seul DGX Spark à 931 tokens par seconde en moyenne et 1 364 en pointe, le tout sur le modèle 2B. OpenBMB a repartagé une autre exécution sur un MacBook 16 Go, appelant la recherche web et résumant les résultats entièrement sur l'appareil. Ce sont les types de charges qu'un modèle compact et rapide rend possibles et qu'un gros modèle cloud ne peut pas égaler en latence ou en coût.
Ce que les gens disent vraiment
L'accueil sur r/LocalLLaMA, le public naturel de ce genre de modèles, a été en grande partie ravi :
"Hot damn. Very promising."

Mais deux fils de critique revenaient sans cesse, et les deux sont fondés. Le premier est l'absence de vision, qui a clairement agacé la communauté locale :
"Sad that there is no vision though. Having to switch to Lfm2.5-vl-3b for it is a bummer"
Le second est un scepticisme sain quant au fait que les scores des classements se traduisent en travail utile. À propos de la démo de débit, une réponse a été sans détour :
"you get some likes here, but useful code? I don't think so"
Et un testeur pratique a signalé qu'il échoue quand on le pilote via un vrai environnement de code, ce qu'il attribuait à la version 2B quantifiée plus le drafter. C'est la leçon récurrente avec les petits modèles : une victoire en benchmark n'est pas un agent fiable, et l'écart apparaît précisément quand on le branche sur une vraie boucle d'outils.
Les limites, en toute honnêteté
Pour rassembler les réserves au même endroit, car un avis honnête les nomme clairement :
- Ni vision ni audio. Ce checkpoint est texte uniquement. Le multimodal vit dans la gamme séparée MiniCPM-V, donc les tâches d'image impliquent de faire tourner un second modèle.
- Anglais et chinois uniquement. Des testeurs de la communauté ont confirmé la couverture linguistique, ce n'est donc pas un modèle largement multilingue.
- Les benchmarks devancent les retours du monde réel. Les échecs en environnement de code évoqués plus haut sont ce qu'il faut tester soi-même avant de construire dessus.
- Un écart de score public. La différence de 15 contre 23 à l'Intelligence Index n'est pas résolue, et les chiffres produits par le fournisseur méritent toujours un sourcil levé.
- L'adoption de la première semaine reste faible. La fiche du modèle affichait 2 879 téléchargements la première semaine, donc les tests de résistance de la communauté ne font que commencer.
Rien de tout cela ne le coule. Cela le situe : MiniCPM5-2B est un excellent modèle de périphérie pour la recherche et les passionnés, et une base prometteuse pour des outils embarqués, plutôt qu'un cerveau prêt pour la production.
Modèle contre coéquipier : ce qu'un modèle 2B peut et ne peut pas faire pour le support
Voici le recadrage qui m'importe, car beaucoup de ceux qui lisent un avis sur un modèle se demandent discrètement s'ils pourraient pointer quelque chose de ce genre vers leur file de support.
Un modèle brut est un ingrédient, pas un repas. MiniCPM5-2B vous donne des poids et une solide fiche de benchmarks. Pour en faire quelque chose qu'un client touche, il faut encore l'héberger, le promouvoir, le connecter à votre helpdesk, lui fournir vos connaissances, lui donner des outils, ajouter des garde-fous et le tester pour qu'il ne donne pas avec aplomb une mauvaise réponse. C'est un vrai projet d'ingénierie, plus proche de la création d'un agent IA que du choix d'un bon modèle. C'est le même écart que je soulignerais que vous regardiez MiniCPM5-2B, un modèle Qwen ou un endpoint OpenAI : le modèle est de l'infrastructure, et le véritable travailleur, c'est tout ce que vous construisez par-dessus.
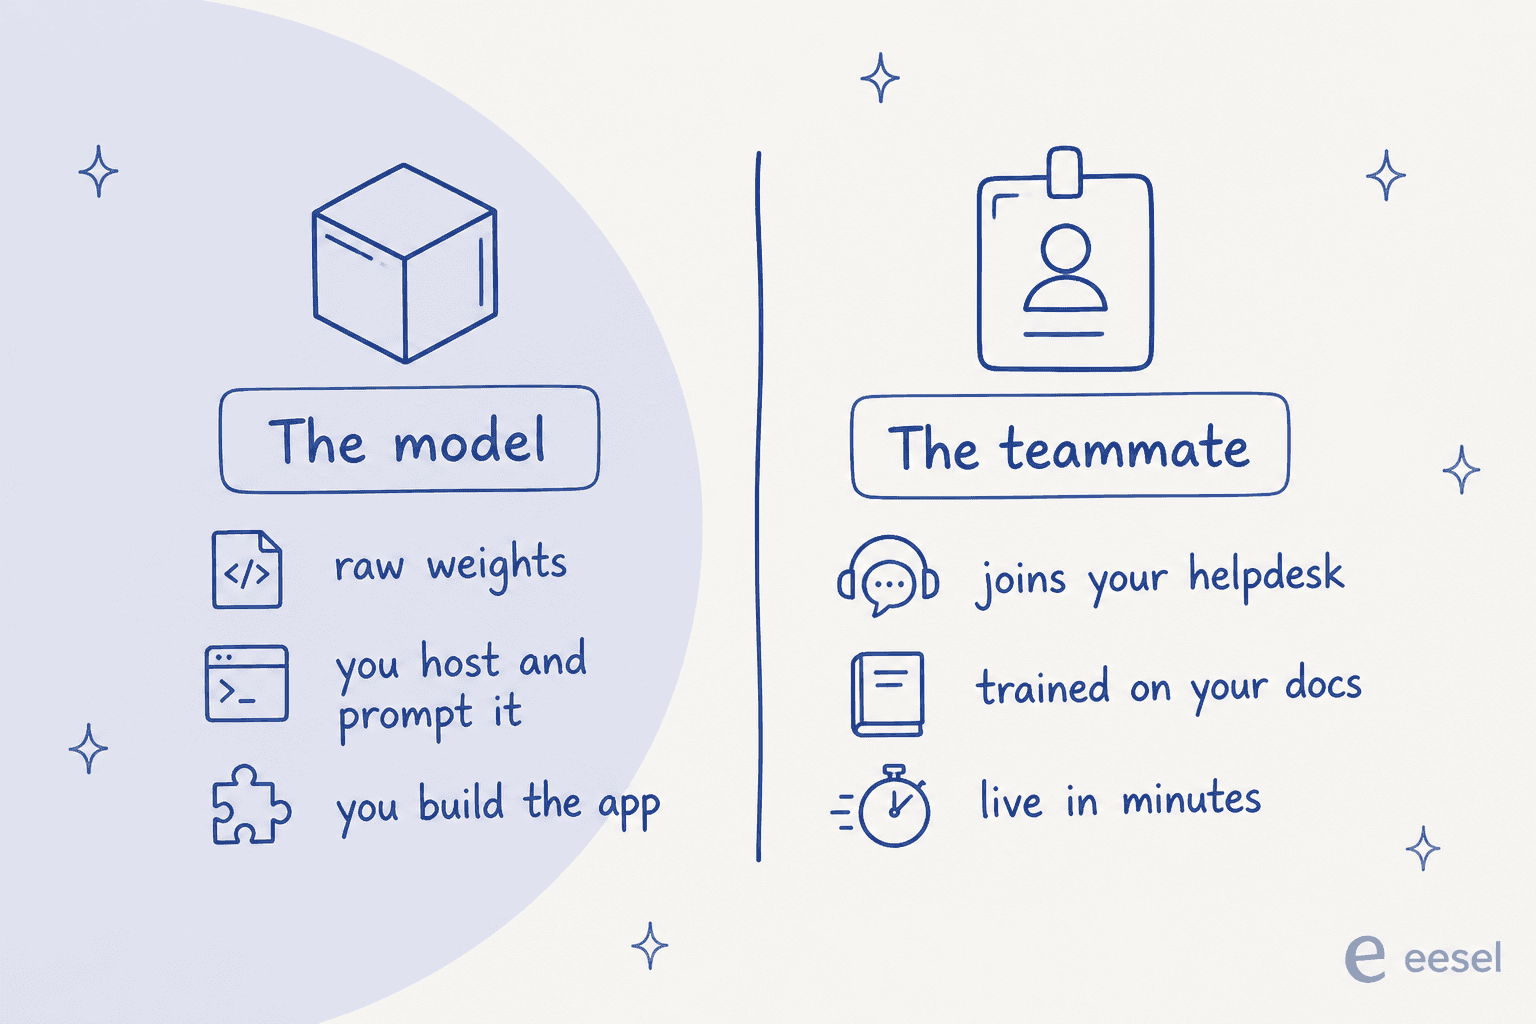
Cette distinction est la raison d'être d'eesel. Au lieu de vous remettre un modèle à brancher, il vous remet un coéquipier IA prêt à travailler sur une tâche précise, et son coéquipier IA pour helpdesk intègre déjà les intégrations, le contexte de l'entreprise et l'outillage pour le support. Le compromis est réel et mérite d'être clair : vous ne pouvez pas faire tourner vos propres poids sur votre propre portable comme avec MiniCPM5-2B. En échange, vous obtenez quelque chose qui répond à de vrais tickets en quelques minutes plutôt qu'en quelques mois.
Essayer eesel pour le support par IA
Si votre raison de lire un avis sur un modèle 2B était « est-ce que ça pourrait aider mon équipe support », la réponse honnête est qu'un modèle seul ne le fera pas, mais que le coéquipier IA construit par-dessus le peut.
eesel se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias, Help Scout et plus), s'entraîne sur vos anciens tickets et documents, et peut être opérationnel en quelques minutes. La partie que je ne sauterais pas : il peut être simulé sur vos tickets historiques avant de toucher la moindre conversation en direct, pour voir exactement comment il aurait répondu à de vrais clients. C'est la discipline « tester avant de faire confiance » que réclament les sceptiques du modèle cités plus haut, intégrée au produit. Et pour le public terminal et scripts qui a aimé l'approche embarquée de MiniCPM5-2B, eesel propose aussi un CLI et la prise en charge de MCP, de sorte qu'une personne, un script ou un agent de code comme Claude Code ou Cursor peut piloter le même coéquipier sans ouvrir le tableau de bord.
Vous pouvez essayer eesel gratuitement, sans carte bancaire ni appel commercial, et avoir un coéquipier qui répond aux tickets avant même d'avoir fini de monter votre propre infrastructure d'inférence.