Les 8 meilleures alternatives à Tencent Hy4 en 2026

Rama Adi

Katelin Teen
Dernière modification August 30, 2026
L'essentiel
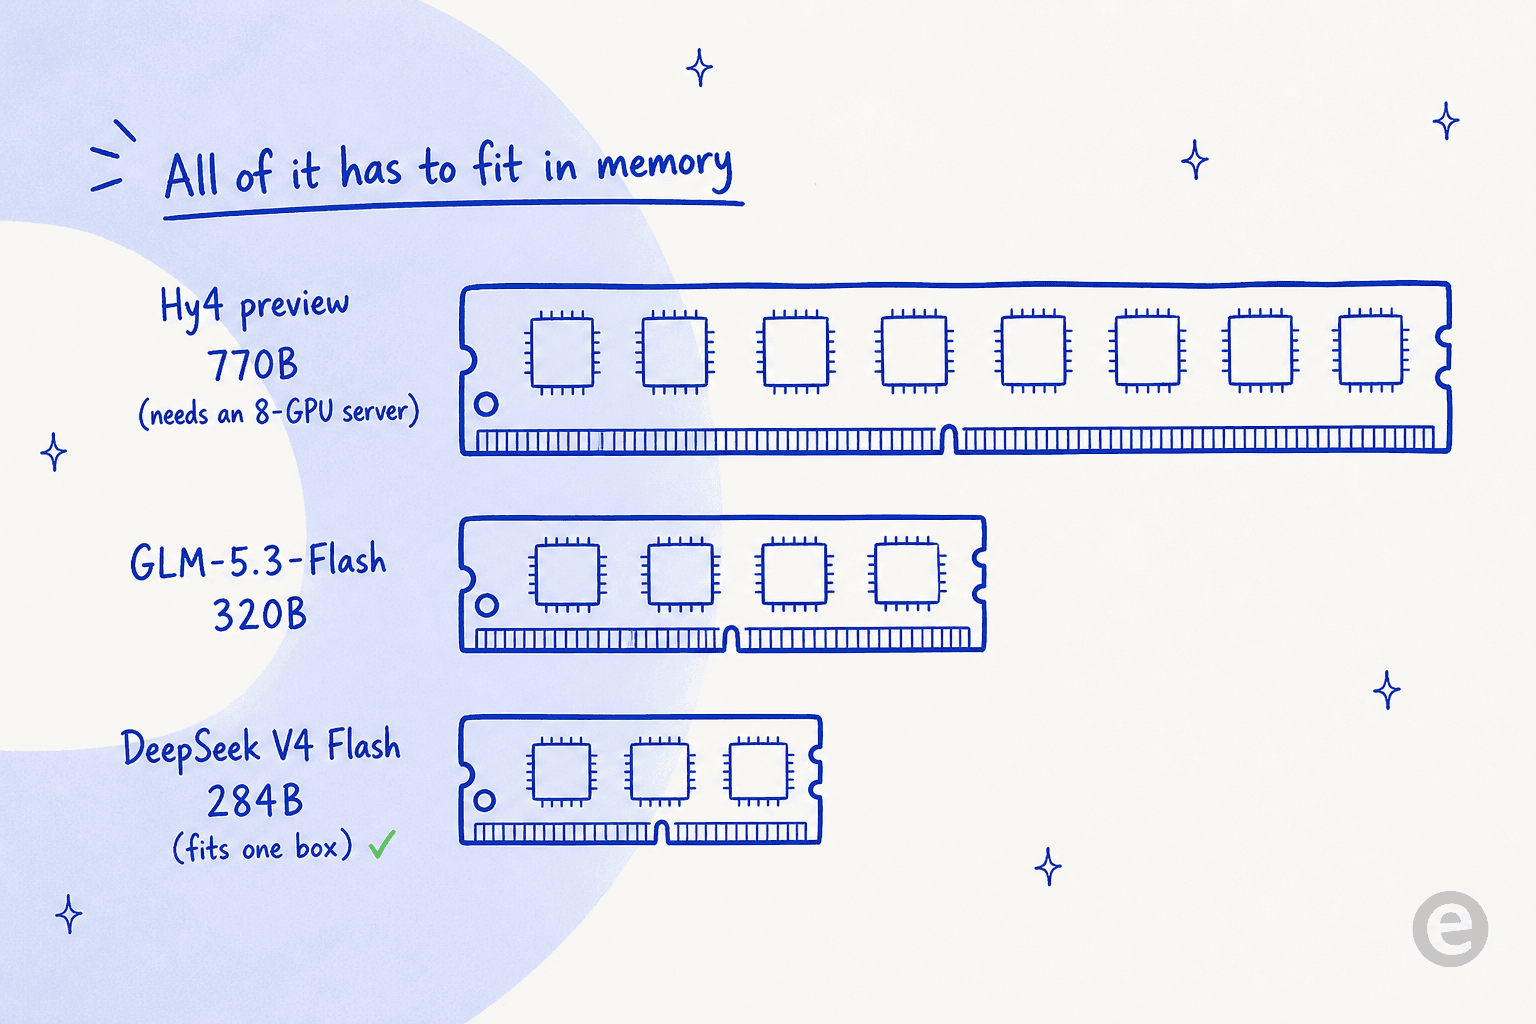
Tencent Hy4 preview est un modèle à poids ouverts vraiment solide : une version à mélange d'experts de 770B qui casse les prix des autres modèles phares chinois et se classe près du sommet des modèles ouverts dans l'arène de code WebDev. Le hic : vous ne pouvez probablement pas le faire tourner. C'est un modèle à mélange d'experts, donc seuls 49B paramètres s'activent par token, mais les 770B doivent quand même tenir en même temps dans la mémoire GPU, ce qui signifie un serveur à huit GPU. Il coûte aussi environ cinq à six fois plus cher que Hy3 et reste une préversion.
La vraie question n'est donc pas « Hy4 est-il bon ? » (oui), mais « quel modèle me donne des résultats de niveau Hy4 sur un matériel et un budget que j'ai réellement ? ». Mes choix :
- GLM-5.3-Flash - la meilleure alternative polyvalente : 320B, nativement multimodal et peu cher.
- DeepSeek V4 Flash - le plancher de prix, sous licence MIT et assez petit pour être hébergé soi-même.
- GLM-5.3 - le plus proche de la qualité de Hy4 (c'est le modèle auquel Tencent se compare).
- Kimi K3 - le plus solide pour les longues sessions de code avec agents.
- Qwen 3.8 Max, DeepSeek V4 Pro, Claude Opus 5 et GPT-5.6 complètent la liste pour les besoins multimodaux, de long contexte et zéro infrastructure.
Une dernière chose : si vous voulez un modèle pour répondre à des tickets clients, vous n'avez pas à en assembler un vous-même. eesel est un coéquipier IA pour le helpdesk qui tourne déjà sur des modèles de pointe, se branche sur vos outils existants et vous laisse tester sur d'anciens tickets avant la mise en production.
Pourquoi on regarde au-delà de Hy4
Soyons d'abord justes avec Hy4, car il le mérite. L'équipe Hunyuan de Tencent a sorti un vrai modèle ouvert de classe frontière : 770B paramètres au total, 49B actifs, une fenêtre de contexte de 1M de tokens, des poids ouverts sur Hugging Face et un prix inférieur à celui de GLM-5.3, Qwen 3.8 Max et Kimi K3. Sur le classement Code Arena WebDev, il s'est placé autour de la 5e place, environ 3e parmi les modèles ouverts, un bond de +115 points par rapport à Hy3. Si vous avez le matériel, c'est un choix solide.
C'est là que ça se complique, et c'est ce que je rencontre chaque semaine en construisant sur ces modèles. Un modèle à mélange d'experts vous économise du calcul par token, pas de la mémoire. Le routeur n'allume que 49B des 770B paramètres pour chaque token, donc il est rapide, mais les 770B doivent tout de même être chargés et résidents. En pratique, cela représente environ 924GB de poids dans la version MXFP8, soit un nœud de huit GPU de classe B300. Une machine avec huit H100 (640GB) ne le contient pas. L'avis de la communauté sur r/LocalLLaMA aboutit au même constat : modèle formidable, impossible à faire tourner chez soi.
Le deuxième problème est le coût. Hy4 casse les prix de ses rivaux phares, mais c'est un grand pas par rapport au modèle qu'il remplace, donc les utilisateurs actuels de Hy3 voient une vraie hausse de facture même s'il paraît bon marché à côté de Kimi. Et le troisième est la maturité : c'est une préversion, et Tencent note elle-même que le modèle tend à trop raisonner et trop vérifier.
Rien de tout cela ne fait de Hy4 un mauvais modèle. Cela en fait un modèle avec un petit cercle de personnes capables de le déployer réellement. Pour tous les autres, les alternatives ci-dessous vous amènent presque au même niveau sur un matériel que vous pouvez vous offrir.
Comment Hy4 se compare réellement à ces alternatives
Avant d'en venir aux choix, il vaut la peine de voir le face-à-face. C'est la grille de benchmarks de Tencent elle-même au lancement, et l'intérêt est que les rivaux qui y figurent sont exactement les modèles de ce comparatif : Qwen 3.8 Max, DeepSeek V4 Pro, GPT-5.6 Sol, GLM-5.3, Kimi K3 et Claude Opus 5.
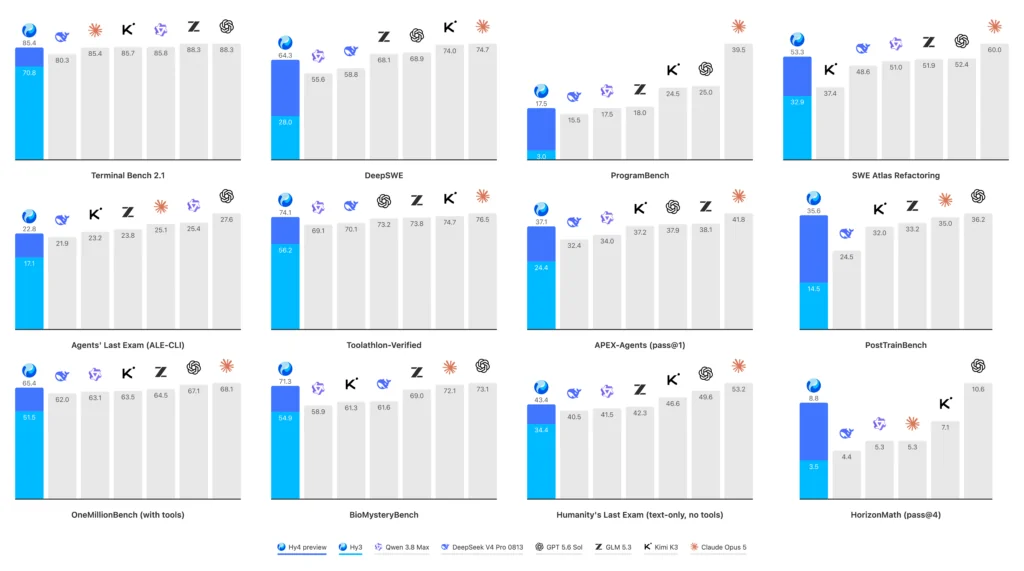
Deux réserves honnêtes. D'abord, c'est le graphique d'un éditeur sur son propre produit, à lire comme un point de départ, pas comme un verdict. Ensuite, Hy4 ne figure pas encore dans l'indice indépendant d'Artificial Analysis, donc il n'y a pas de score d'intelligence neutre à citer. L'évaluation à l'aveugle interne de Tencent a placé Hy4 à 2,99/4,00 contre Kimi K3 (2,94) et GLM-5.3 (2,92), assez proche pour que la communauté des CLI de code y voie un à peu près triple match nul, avec le prix comme véritable avantage de Hy4.
Comment j'ai choisi
Je construis les intégrations et la plomberie des modèles chez eesel, donc choisir quel modèle faire réellement tourner en production occupe une grande partie de ma semaine. Un chiffre de classement est la partie facile. Les questions qui tranchent en pratique sont : puis-je faire tenir les poids, que coûte un vrai mois de tokens, la licence me permet-elle de livrer un produit, et le modèle tient-il une longue session d'agent plutôt qu'une seule réponse brillante ? J'ai donc pondéré ainsi :
- Facilité de déploiement - une équipe normale peut-elle réalistement le faire tourner ou le payer, pas seulement un hyperscaler.
- Prix par 1M de tokens - d'après la grille tarifaire de l'éditeur, en signalant les promotions et les particularités heures pleines/creuses.
- Licence et poids ouverts - si vous pouvez l'héberger vous-même et ce que vous avez le droit d'en faire.
- Capacité réelle - force en code et en agents, pas seulement un score d'affichage.
Chaque prix et chaque spécification ci-dessous provient des pages de l'éditeur lui-même, vérifiées le 30 août 2026. Quand un chiffre est un benchmark interne de l'éditeur plutôt qu'un benchmark indépendant, je le précise.
Les alternatives en un coup d'œil
| Modèle | Idéal pour | Paramètres totaux / actifs | Contexte | Entrée $/1M | Sortie $/1M | Poids ouverts | Licence |
|---|---|---|---|---|---|---|---|
| GLM-5.3-Flash | Meilleur choix polyvalent | 320B / 18B | 1M | $0.075* | $0.25* | Oui | Ouverte (HF) |
| DeepSeek V4 Flash | Prix le plus bas | 284B / 13B | 1M | $0.22-0.44 | $0.66-1.32 | Oui | MIT |
| GLM-5.3 | Le plus proche de Hy4 | Non communiqué | 1M | $1.40 | $4.40 | Oui | Ouverte (HF) |
| Kimi K3 | Code avec agents | 2.8T / 104B | 1M | $3.00 | $15.00 | Oui | "other" |
| Qwen 3.8 Max | Multimodal + écosystème | 2.4T / 95B | 1M | $2.00 | $6.00 | Oui (base) | qwen3.8-max |
| DeepSeek V4 Pro | Rappel en long contexte | 49B de classe actifs | 1M | $0.66-1.32 | $1.98-3.96 | Oui | Ouverte |
| Claude Opus 5 | Zéro infrastructure | Non communiqué | 1M | $5.00 | $25.00 | Non | Propriétaire |
| GPT-5.6 | Niveaux d'API gérée | Non communiqué | Niveaux de long contexte | $0.20-5.00 | $1.20-30.00 | Non | Propriétaire |
*GLM-5.3-Flash bénéficie d'une promotion de lancement de 50 % ($0.15 / $0.50 au tarif public) qui se termine le 9 septembre 2026. DeepSeek affiche de l'heure creuse à l'heure pleine ; un horaire US/UE est surtout facturé au tarif creux, plus bas. Tous les tarifs d'après la page de prix de chaque éditeur, vérifiés le 30 août 2026.
Le schéma saute aux yeux une fois tout mis côte à côte : les deux modèles « Flash » sont un ordre de grandeur moins chers que le niveau frontière, et les API fermées (Opus 5, GPT-5.6) sont en haut côté prix mais ne vous demandent rien en retour. Voici la même image en prix de sortie, qui est généralement la facture qui fait vraiment mal avec un agent bavard :
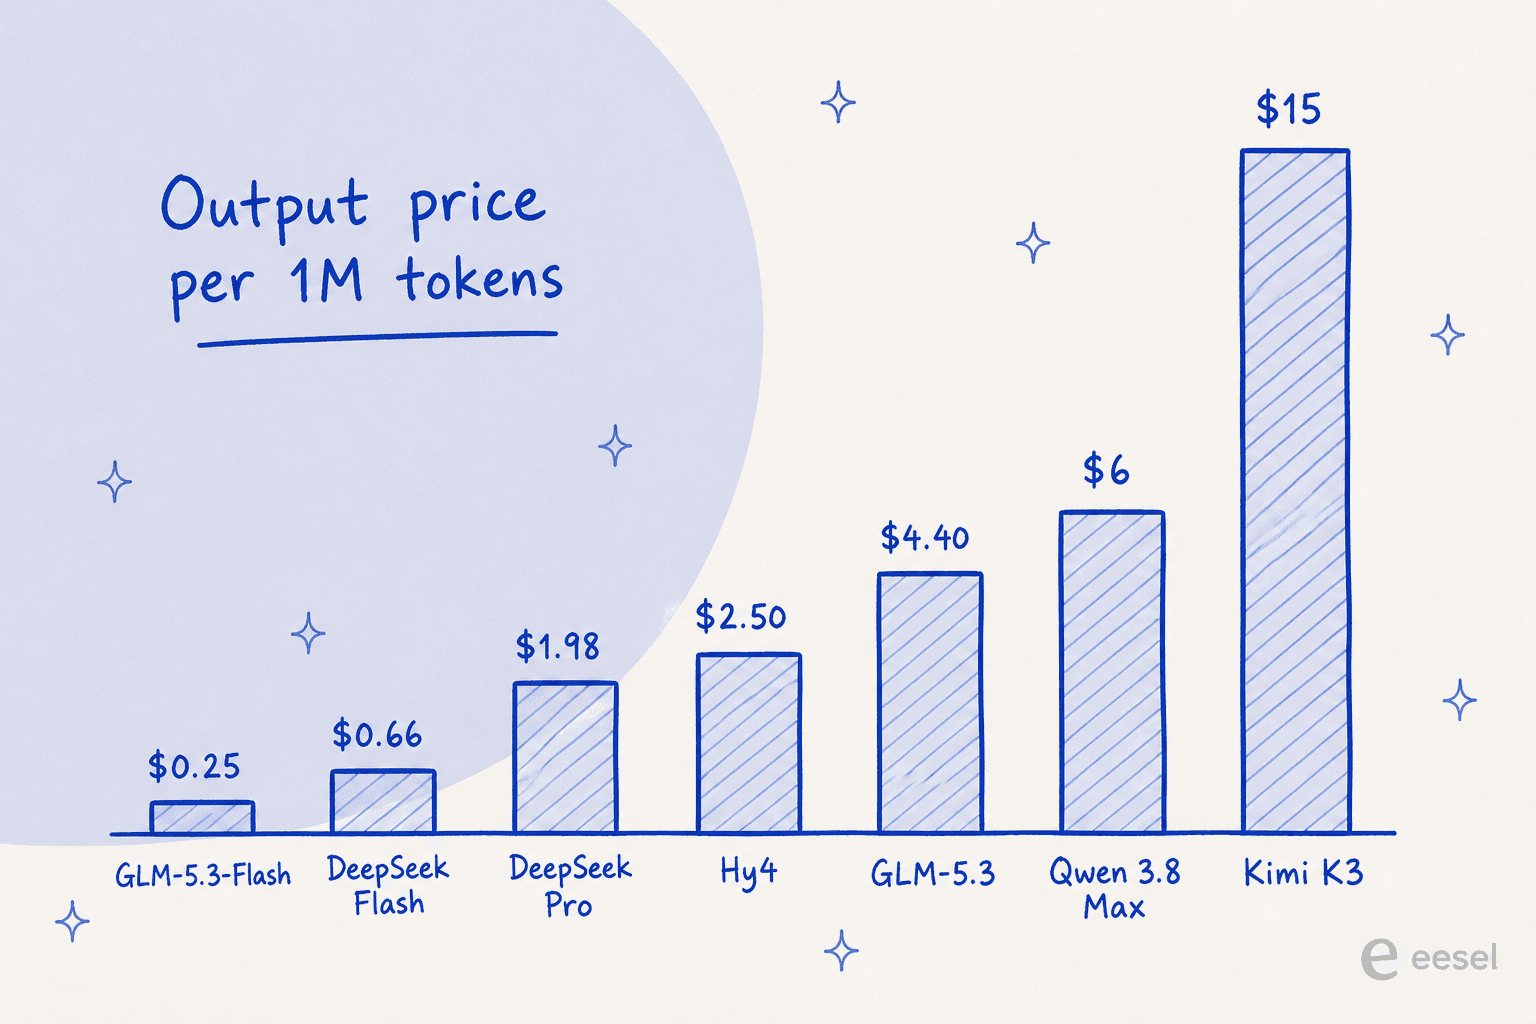
Si vous ne savez pas dans quel coin de la carte vous vous situez, cet outil rapide vous mène à un choix.
1. GLM-5.3-Flash
Idéal pour : les équipes qui veulent une qualité de niveau Hy4 sur un matériel qu'elles peuvent réellement faire tourner, au prix réaliste le plus bas.
C'est celui vers lequel je me tournerais en premier. GLM-5.3-Flash, de Z.ai (anciennement Zhipu AI), est un modèle à mélange d'experts de 320B avec seulement 18B actifs, et c'est le premier modèle nativement multimodal de la gamme GLM-5, qui gère le texte, l'image et la vidéo. L'argument de Z.ai est « intelligence de pointe, coût flash », et les chiffres confirment la seconde moitié : il obtient 57 sur l'indice d'intelligence d'Artificial Analysis pour environ $0.045 par tâche avec la remise, un niveau qui coûtait auparavant environ 10x plus.
La raison pour laquelle il bat Hy4 pour la plupart des gens est simple : à 320B au total, il fait moins de la moitié de l'empreinte de Hy4, donc il est nettement plus facile à servir, et il a été testé discrètement sous le nom « ox-alpha » sur OpenRouter, où il est devenu le modèle le plus utilisé de la semaine, le tout servi sur des puces chinoises. Sur le Code Bench de Z.ai lui-même, il atteint 29,0 contre 29,5 pour Claude Opus 4.8, presque à égalité.
Avantages : nativement multimodal (texte, image, vidéo), poids ouverts sur Hugging Face, et de loin le meilleur rapport prix-capacité de cette liste.
Inconvénients : les comparaisons de benchmarks viennent de Z.ai elle-même, et le prix d'affichage est une promotion de lancement. Z.ai n'a pas publié de fiche complète de paramètres et de contexte aussi nette que certains rivaux.
Tarif : $0.075 en entrée / $0.25 en sortie par 1M pendant la promotion de lancement de 50 % (tarif public $0.15 / $0.50), qui se termine le 9 septembre 2026. L'entrée en cache coûte $0.015. Également inclus dans le GLM Coding Plan à partir de $18/mois.
Verdict : si vous ne pouvez essayer qu'une seule alternative à Hy4, prenez celle-ci. C'est le rare modèle à la fois moins cher et plus petit et multimodal, et c'est celui que je donnerais à une équipe qui a aimé Hy4 mais ne pouvait pas justifier le serveur à huit GPU.
2. DeepSeek V4 Flash
Idéal pour : le coût par token le plus bas possible et la licence la plus favorable à l'auto-hébergement du groupe.
DeepSeek V4 Flash est le plancher de prix, et l'écart n'est pas mince. C'est un modèle à mélange d'experts de 284B avec 13B actifs, publié sous une vraie licence MIT, et avec environ 167GB de poids, c'est le seul modèle de classe frontière de cette liste qu'une équipe bien équipée peut réellement faire tourner chez elle pour moins de 10 000 $. En heures creuses, il est facturé environ $0.22 en entrée / $0.66 en sortie par 1M, soit environ un quart du tarif de sortie de Hy4.
Une particularité à connaître : la grille tarifaire de DeepSeek est découpée par heure de la journée, avec des heures pleines calées sur les heures de bureau chinoises (01:00-04:00 et 06:00-10:00 UTC). Une file de support américaine ou européenne tourne surtout pendant la fenêtre creuse de DeepSeek, donc vous payez en général la moitié la moins chère de la grille par défaut. Le seul vrai reproche est la verbosité : les tests indépendants montrent qu'il consomme nettement plus de tokens de sortie que ses rivaux pour arriver à une réponse, donc l'économie par token fond un peu à l'échelle d'une tâche.
Avantages : le moins cher par une large marge, sous licence MIT et assez petit pour être hébergé soi-même.
Inconvénients : bavard (plus de tokens de sortie que ses pairs), et les conditions de l'API payante de DeepSeek sont muettes sur l'usage pour l'entraînement au lieu de le déclarer explicitement exclu, avec une résidence des données en Chine. Cela compte si vous faites passer des données clients par l'API officielle.
Tarif : entrée sans cache $0.22 en heures creuses / $0.44 en heures pleines ; sortie $0.66 / $1.32 ; entrée avec succès de cache à partir de $0.007, d'après la page de tarifs de DeepSeek.
Verdict : si le critère décisif est la facture, c'est votre modèle. Prévoyez simplement du budget pour sa verbosité, et gardez les données personnelles de vos clients hors du point d'accès officiel tant que vous n'avez pas lu les conditions attentivement.
3. GLM-5.3
Idéal pour : ce qui se rapproche le plus de la qualité réelle de Hy4, du modèle auquel Tencent a choisi de se comparer.
Quand Tencent a voulu montrer que Hy4 était de classe frontière, GLM-5.3 était l'un des deux modèles auxquels elle l'a opposé, et Hy4 ne l'a devancé que de 2,99 contre 2,92 dans l'évaluation à l'aveugle de Tencent elle-même. Autrement dit, si vous voulez le modèle le plus proche de la qualité réelle de Hy4, c'est le candidat évident, et il vient d'une lignée au solide bilan en code de longue haleine (son prédécesseur GLM-5.2 a été le premier modèle à poids ouverts à dépasser 80 % sur Terminal-Bench).
Il est aussi moins cher que Hy4 côté entrée et dans la même fourchette côté sortie, donc vous ne payez pas de supplément pour un modèle presque équivalent. Z.ai ne publie pas le nombre exact de paramètres de GLM-5.3 aussi nettement que certains rivaux, donc je laisse ce chiffre de côté plutôt que de citer un agrégateur.
Avantages : le rival benchmarké le plus proche de Hy4, poids ouverts, solide héritage en code de longue haleine, 1M de contexte, et points d'accès compatibles OpenAI et Anthropic, donc il s'intègre aux outils existants.
Inconvénients : la fiche publique de Z.ai pour la 5.3 est maigre sur les paramètres totaux/actifs et, comme Hy4, c'est un gros modèle à héberger soi-même.
Tarif : $1.40 en entrée / $4.40 en sortie par 1M, entrée en cache $0.26, d'après la documentation tarifaire de Z.ai. Également disponible via le GLM Coding Plan.
Verdict : si votre objectif est « donnez-moi Hy4, mais que je puisse déployer sans les réserves de la préversion », GLM-5.3 est le remplacement le plus sûr. C'est l'alternative équivalente.
4. Kimi K3
Idéal pour : les longues sessions de code avec agents et beaucoup d'outils, où la profondeur compte plus que le prix.
Kimi K3, de Moonshot AI, est le plus gros modèle ici : 2.8T au total, 104B actifs, avec 1M de tokens de contexte et des poids ouverts sortis dans les temps. Sur l'indice d'intelligence d'Artificial Analysis, il est à 57, vers la 4e place au lancement, et c'est le modèle que Hy4 bat le moins nettement dans les chiffres par paires de Tencent (Hy4 ne gagne que 51,2 % du temps contre lui). Il est vraiment bon sur les longues sessions d'agent.
Ce qu'il faut savoir, c'est que Kimi K3 est cher et vous engage : le raisonnement ne peut pas être désactivé à aucun niveau, et baisser l'effort ne le rend pas moins cher (les niveaux sont facturés au même tarif). À $3 en entrée / $15 en sortie par 1M, il est dans le territoire de Claude Sonnet, soit environ 23x le tarif de sortie de Hy4 sans cache. Il le mérite sur un travail difficile et en plusieurs étapes ; pour de simples appels, c'est excessif.
Avantages : capacités d'agent et de code de niveau frontière, vision native, énorme contexte de 1M et poids ouverts sur Hugging Face.
Inconvénients : le modèle le plus cher de ce comparatif, aucun moyen de désactiver le raisonnement, et les URL d'images publiques ne sont pas acceptées (base64 ou identifiants de fichier uniquement).
Tarif : $3.00 en entrée / $0.30 avec succès de cache / $15.00 en sortie par 1M, d'après Moonshot. Les offres de l'application grand public vont d'une formule gratuite à $199/mois.
Verdict : tournez-vous vers Kimi K3 quand la tâche est une session d'agent longue et vraiment difficile et que la qualité prime sur tout. Pour tout ce qui est routinier, l'un des modèles moins chers ci-dessus fera le même travail pour un dixième de la facture.
5. Qwen 3.8 Max
Idéal pour : le multimodal et l'écosystème le plus riche parmi les laboratoires chinois.
Qwen 3.8 Max, d'Alibaba, est un modèle à mélange d'experts de 2.4T / 95B passé en disponibilité générale début août, avec 1M de contexte et une entrée native image et vidéo. Il figure sur le classement d'Artificial Analysis au rang 6 (indice ~58) et se montre aussi solide sur les classements WebDev et vision de LMArena. Ce qui le distingue du lot, c'est l'écosystème : Qwen possède l'une des plus grandes familles de modèles ouverts qui soient, donc il existe un petit frère pour presque tous les budgets, et le Max hébergé ajoute la vision, un mode sans réflexion et des outils intégrés par-dessus la base ouverte.
Une note d'équité que j'inclus toujours : les poids de base entièrement ouverts (Qwen3.8-2.4T-A95B) sont sortis, mais ils ne sont pas équivalents en fonctionnalités au Max hébergé, qui ajoute l'entrée vision et le contexte de 1M par défaut. Et le membre permissif sous licence Apache de la famille est le plus petit Qwen3.8-27B, pas le Max lui-même.
Avantages : nativement multimodal, famille de modèles immense et bien soutenue, un vrai écosystème d'outils et des poids de base ouverts.
Inconvénients : la licence du Max n'est pas Apache, les versions hébergée et ouverte diffèrent en capacités, et à $6 en sortie, il est plus cher que les options GLM et DeepSeek.
Tarif : $2.00 en entrée / $6.00 en sortie par 1M, cache implicite $0.25, d'après QwenCloud.
Verdict : choisissez Qwen 3.8 Max si l'entrée multimodale et une large famille de modèles comptent pour vous, ou si vous voulez standardiser sur un seul laboratoire pour de nombreuses tailles de modèle. Sur le pur rapport prix-capacité, GLM-5.3-Flash garde l'avantage.
6. DeepSeek V4 Pro
Idéal pour : le rappel en long contexte et la recherche d'une aiguille dans une botte de foin, là où le Flash plus petit peine.
Si DeepSeek V4 Flash est le choix économique, DeepSeek V4 Pro est le choix du rappel. Il exécute plus de paramètres actifs (classe 49B) que Flash, et cela se voit là où ça compte : dans le tableau inter-modes de DeepSeek, Pro devance Flash sur SimpleQA-Verified (57,9 contre 34,1) et sur la recherche d'aiguilles en contexte de 1M. Le classement de préférence humaine de LMArena place aussi toujours Pro au-dessus de Flash. C'est le modèle à utiliser quand le travail consiste à lire un très long document et à en ressortir un fait précis.
Il y a un piège que je signale à quiconque route des niveaux d'effort : la correspondance publiée par DeepSeek sert une requête low sur Pro en high, donc il n'existe pas d'exécution Pro bon marché, vous payez le tarif plein et ne pouvez pas réduire le raisonnement. Si la maîtrise des coûts compte, c'est une raison de rester sur Flash, sauf si vous avez précisément besoin du rappel de Pro.
Avantages : rappel et recherche en long contexte plus solides que Flash, toujours à poids ouverts, toujours avec la même tarification horaire qui favorise les horaires non chinois.
Inconvénients : impossible de faire une requête Pro bon marché à faible effort, et il coûte environ 3x le tarif de Flash sans cache.
Tarif : entrée sans cache $0.66 en heures creuses / $1.32 en heures pleines ; sortie $1.98 / $3.96, d'après la page de tarifs de DeepSeek.
Verdict : la plupart des équipes devraient commencer sur Flash et ne passer à Pro que pour les charges précises (questions sur de longs documents, rappel précis) où Flash est visiblement insuffisant. Ne payez pas Pro partout.
7. Claude Opus 5
Idéal pour : les équipes qui veulent une qualité de premier plan et zéro infrastructure à faire tourner.
Voici le recadrage honnête : pour beaucoup d'équipes, la vraie alternative à un modèle à poids ouverts de 770B n'est pas un autre modèle à poids ouverts, c'est de ne pas en faire tourner du tout. Claude Opus 5 est le modèle phare d'Anthropic, il est n°1 de l'indice d'intelligence (de justesse, à 61-63 selon l'instantané), et il n'y a rien à faire tenir en mémoire. Vous appelez une API et obtenez une réponse de pointe.
La contrepartie, ce sont le prix et l'ouverture. À $5 en entrée / $25 en sortie par 1M, il est un ordre de grandeur plus cher que les options à poids ouverts, et il n'y a pas de poids à héberger. La communauté signale aussi qu'Opus 5 a tendance à dépenser plus de tokens de sortie que son prédécesseur à effort égal, donc le coût par tâche a augmenté même au même tarif affiché, même si le contre-argument est le coût par tâche réussie. Ce n'est pas le choix économique ; c'est le choix sans souci, en haut du classement.
Avantages : qualité de pointe de premier rang, 1M de contexte sans surcoût de long contexte, et zéro infrastructure à faire tourner.
Inconvénients : bien plus cher par token que les modèles ouverts, poids fermés, et il peut être verbeux à effort élevé.
Tarif : $5 en entrée / $25 en sortie par 1M (inchangé par rapport à Opus 4.8), avec le traitement par lots à moitié prix et les lectures de cache à 0,1x, d'après Anthropic.
Verdict : si votre goulot d'étranglement est le temps d'ingénierie plutôt que le budget de tokens, Opus 5 est la réponse nette. Vous échangez de l'argent contre le fait de ne plus jamais penser aux GPU.
8. GPT-5.6
Idéal pour : une API gérée avec une gamme étagée, pour arbitrer entre coût et capacité à chaque appel.
L'autre réponse en API gérée est GPT-5.6, et sa force est l'étendue de la gamme. Au lieu d'un prix unique, OpenAI propose une échelle : gpt-5.6-luna à $0.20 en entrée / $1.20 en sortie par 1M pour le travail bon marché à gros volume, gpt-5.6-terra à $2 / $12 au milieu et gpt-5.6-sol à $5 / $30 en haut. Cela permet d'adapter le modèle à la tâche au lieu de payer le tarif du modèle phare à chaque appel, un levier vraiment utile si votre trafic mélange demandes faciles et difficiles.
Le piège structurel à intégrer dans vos calculs : OpenAI facture un palier de long contexte en 2x dès que vous dépassez le seuil de contexte, le même schéma qu'utilise xAI (et que ni Anthropic ni Google n'utilisent). Donc si votre charge est riche en long contexte, le tarif effectif est supérieur au tarif affiché. GPT-5.6 Sol se place aussi juste derrière Opus 5 sur l'indice d'intelligence, donc c'est une vraie option de pointe, pas un substitut économique.
Avantages : une gamme étagée qui permet d'ajuster le coût par appel, un écosystème d'API et d'outils mature, et aucune infrastructure à faire tourner.
Inconvénients : poids fermés, et le palier de long contexte double à peu près le tarif sur les appels à gros contexte.
Tarif : de $0.20 / $1.20 (luna) à $5 / $30 (sol) par 1M, avec un multiplicateur de long contexte, d'après OpenAI.
Verdict : si l'idée d'une API gérée vous plaît mais que le tarif unique d'Opus 5 paraît lourd pour votre trafic facile, les paliers de GPT-5.6 sont le choix le plus souple. Modélisez simplement le surcoût de long contexte avant de vous engager.
Les deux familles, en une image
Prenez du recul : chaque option ici tombe dans l'un de deux camps, les poids ouverts que vous pouvez faire tourner ou louer pas cher, et les API gérées où vous ne faites rien tourner. Cette carte est la façon dont j'expliquerais le choix à un collègue en dix secondes.
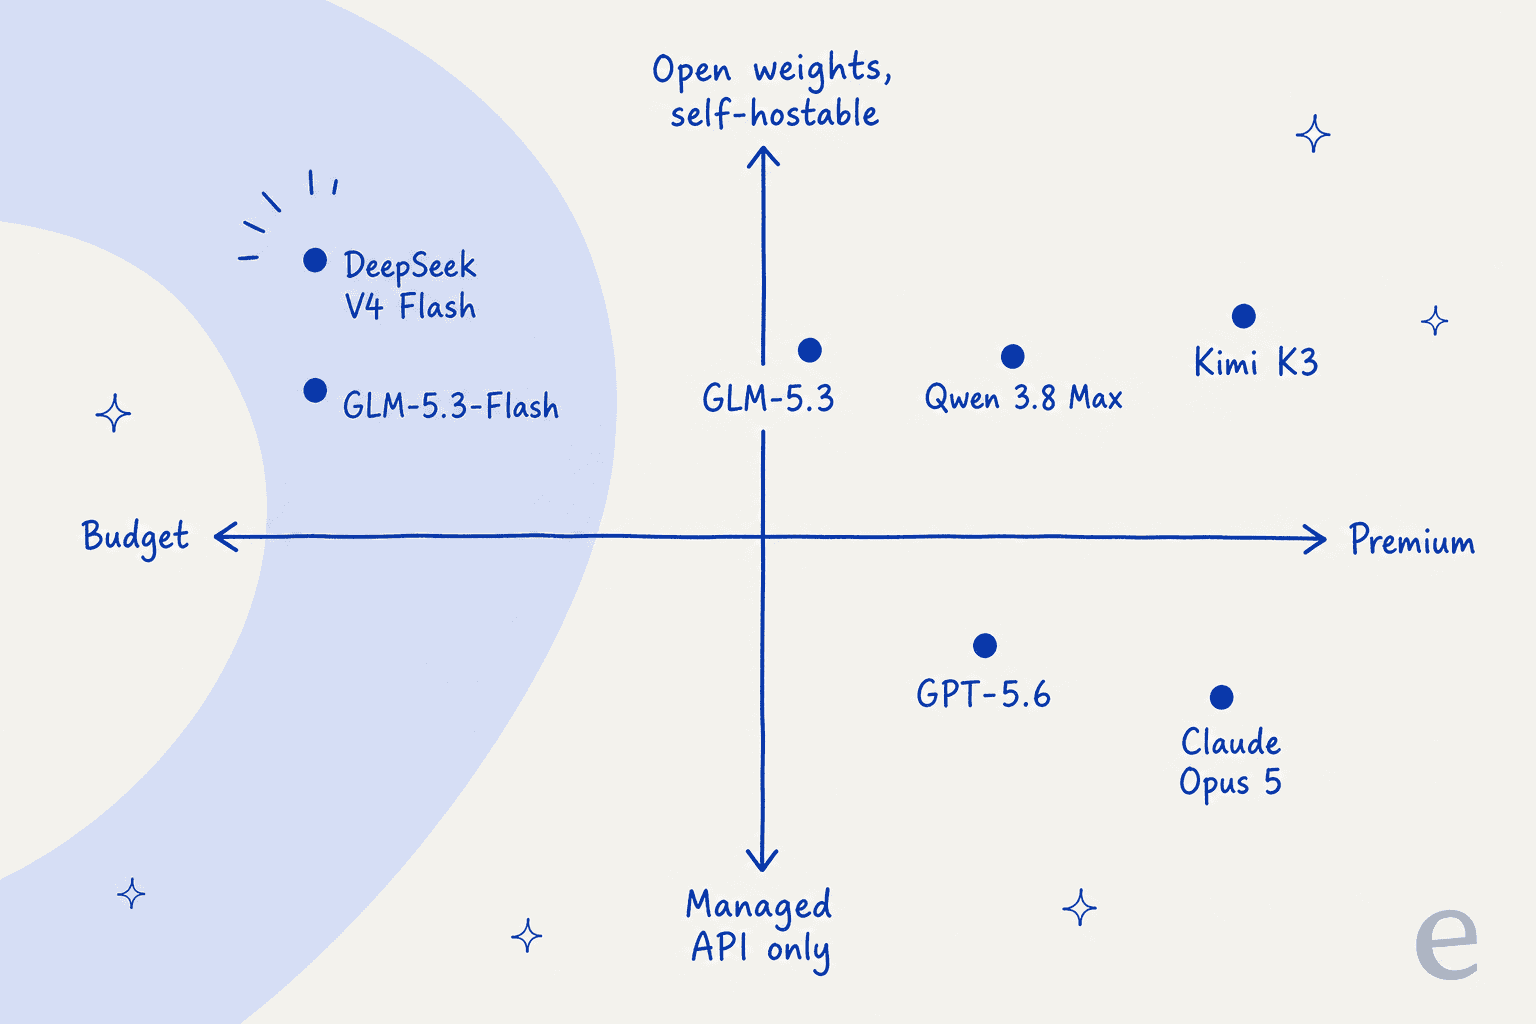
Si c'est le contrôle et le coût qui vous ont éloigné de Hy4, restez sur la rangée du haut, celle des poids ouverts, et commencez par GLM-5.3-Flash ou DeepSeek V4 Flash. Si c'était la pure difficulté de faire tourner un modèle de 770B, descendez sur la rangée gérée et laissez Anthropic ou OpenAI porter l'infrastructure.
Essayer eesel
Tous les modèles de cette liste ont un point commun : ce sont des infrastructures brutes. Choisir Hy4 ou une alternative, c'est choisir un moteur. Il vous reste à construire la voiture autour : la connexion à votre centre d'aide, les garde-fous, les intégrations et un moyen de tester avant qu'elle réponde à un vrai client.
Si la raison pour laquelle vous comparez des modèles est le support client, eesel vous épargne toute cette construction. C'est un coéquipier IA pour le helpdesk qui tourne déjà sur des modèles de pointe, donc vous héritez de la qualité du modèle sans jamais en choisir un, l'héberger ou le faire tenir en VRAM. Il se connecte à des outils comme Zendesk, Freshdesk et Slack, apprend de vos anciens tickets et de votre centre d'aide et, ce qui m'importe le plus en tant que témoin de bots sûrs d'eux qui donnent des réponses sûrement fausses, il vous permet de simuler sur des milliers de vos vrais tickets historiques avant de répondre à qui que ce soit en direct.

Donc, si vous êtes arrivé ici en comparant des modèles pour construire un agent de support, il vaut la peine de se demander si vous avez besoin du modèle ou du coéquipier déjà prêt. Vous pouvez essayer eesel gratuitement, et il se branche sur votre helpdesk existant en quelques minutes.
Comment ces alternatives à Tencent Hy4 se comparent-elles pour construire un agent de support ?