

Tencent Hy4 preview est un modèle open-weight impressionnant et, pour la plupart des gens, un modèle que vous louerez plutôt que de l'exécuter. C'est un modèle Mixture-of-Experts avec 770B de paramètres au total, 49B actifs par token et une fenêtre de contexte de 1M de tokens, publié en open-weight sous Apache 2.0 sur Hugging Face le 28 août 2026.
Sur les benchmarks, il se place dans le haut du panier des modèles ouverts : 92,3 sur GPQA Diamond, 82,9 % sur SWE-bench Multilingual, et légèrement devant Kimi K3 et GLM-5.3 dans l'évaluation à l'aveugle de Tencent. Mais son propre graphique publié montre qu'il alterne victoires et défaites avec ces rivaux, donc « au niveau des meilleurs modèles ouverts » est la lecture honnête, pas « les bat tous ».
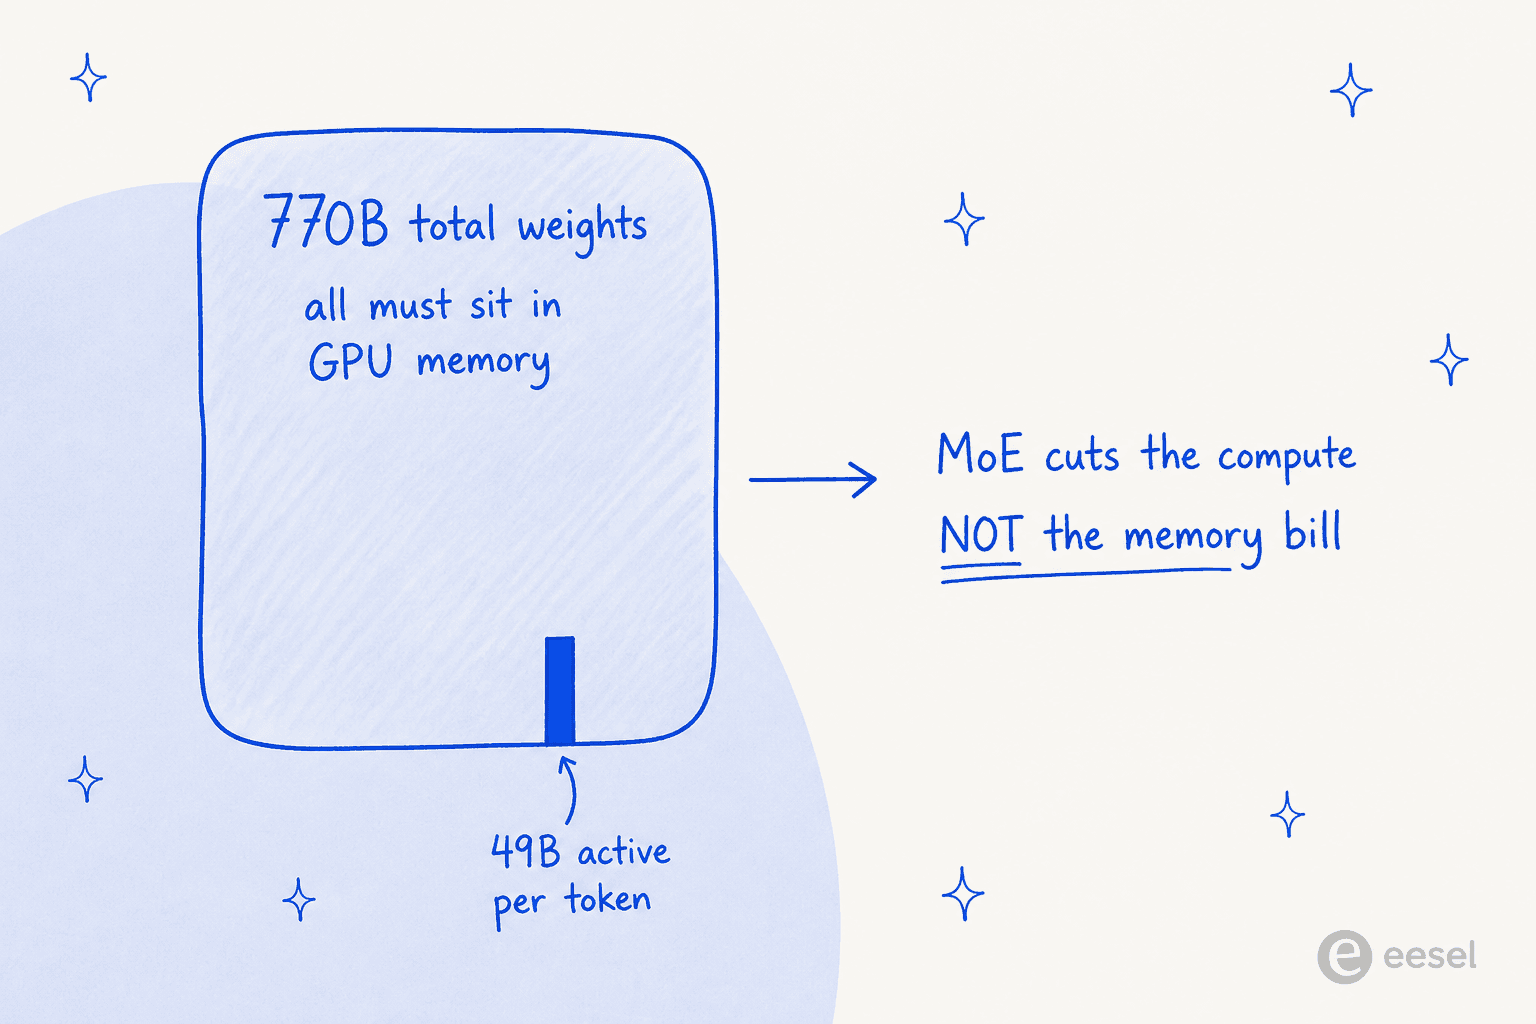
Le hic, c'est de l'exécuter. Le MoE réduit le calcul par token, pas la facture mémoire : les 770B poids doivent tous tenir en mémoire GPU, il faut donc compter 16x B200 ou 8x B300 pour le modèle complet. Via l'API, c'est 0,834 $ en entrée / 2,501 $ en sortie par million de tokens, ce qui est moins cher que Qwen 3.8 Max et Kimi K3, mais 5 à 6 fois plus cher que le Hy3 qu'il remplace, et DeepSeek V4 Flash reste bien moins cher.
À qui s'adresse-t-il ? Aux équipes qui construisent des outils agentiques de code ou de recherche, veulent des poids ouverts et une licence permissive, et ont (ou louent) le matériel. Si vous voulez juste le résultat, un ticket de support traité ou un article de blog rédigé, un coéquipier IA prêt à l'emploi est un chemin plus court que de monter vous-même un modèle de 770B.
Ce que Tencent a réellement publié
Je construis pour vivre les agents IA qui se placent au-dessus de modèles comme celui-ci, donc un nouveau modèle phare open-weight est la partie de ma semaine que j'attends vraiment avec impatience. J'ai passé les dernières années à observer ce qui sépare un modèle qui brille en démo d'un modèle qui survit à une vraie file de production, et Hy4 est un bon test de cet écart.
Voici la version courte de ce qui est sorti. L'équipe Hunyuan de Tencent a publié et mis en open source Hy4 preview le 28 août 2026, en le positionnant comme « built for real-world productivity tasks... across coding, office work, and scientific research. » C'est le successeur de la gamme Hy3 de juillet, et Tencent le livre en « préversion d'abord, version officielle ensuite », le même rythme qu'avant.
Les caractéristiques principales, directement tirées de la fiche du modèle :
- 770B de paramètres au total, 49B actifs par token (une architecture Mixture-of-Experts).
- 78 couches, avec 256 experts routés plus 1 expert partagé ; chaque token active les 8 meilleurs experts routés.
- Fenêtre de contexte de 1M de tokens.
- Licence Apache 2.0, avec un modèle BF16 et une version quantifiée FP8 officielle livrés côte à côte.
Un détail m'a intéressé : Tencent affirme que Hy4 a participé à son propre développement, en proposant et en exécutant des expériences sur les méthodes d'entraînement et les opérateurs bas niveau, et qu'il a optimisé de façon autonome sa propre pile d'inférence pour un gain de débit de 31,8 %. Ils appellent cela « an early-stage recursive self-improvement loop. » C'est du cadrage marketing sur un résultat réel, mais c'est le genre d'affirmation à garder en mémoire.
Comment fonctionne vraiment le calcul 770B / 49B
Si le Mixture-of-Experts est nouveau pour vous, les deux grands nombres semblent contradictoires : comment un modèle de 770B peut-il n'être que « 49B » de quelque chose ? La réponse : le MoE découpe le réseau en de nombreux sous-réseaux experts et, pour chaque token, un routeur en choisit une petite poignée à exécuter. Le calcul par token se comporte donc comme celui d'un modèle de ~49B, ce qui garde Hy4 assez rapide pour être servi.
Le piège est de croire qu'un nombre actif plus petit signifie un matériel plus petit. Ce n'est pas le cas. Chacun de ces 770B poids doit résider en mémoire GPU, parce que le routeur peut choisir n'importe quel expert pour le token suivant. Le MoE vous offre des calculs moins chers, pas une machine moins chère.
Sous le capot, il y a plus d'ingénierie que la fiche technique ne le laisse entendre : l'attention utilise Gated DeepSeek Sparse Attention avec un IndexCache pour réutiliser des indices épars entre les couches, et une couche native de prédiction multi-tokens est ajoutée pour le décodage spéculatif. Si vous avez suivi les articles d'architecture de DeepSeek et GLM, beaucoup de choses vous paraîtront familières, ce qui est en soi un signe de la vitesse à laquelle la frontière open-weight converge vers les mêmes astuces.
Les benchmarks, lus honnêtement
Hy4 se comporte bien sur les benchmarks. Sur les scores vérifiés qu'affiche Hugging Face, il atteint 92,3 sur GPQA Diamond, 82,9 % résolus sur SWE-bench Multilingual, 65,7 sur SWE-bench Pro et 64,3 sur Deep SWE. Pour un modèle open-weight, ce sont de solides chiffres en code et en raisonnement, et la communauté l'a remarqué. Un commentateur du fil sur les benchmarks complets a résumé l'ambiance :
For a 770B parameters model, it's impressive.

La comparaison que Tencent met en avant est une évaluation interne à l'aveugle : 163 experts ont noté des résultats sur 203 tâches d'ingénierie, sur 4,00. Hy4 a obtenu 2,99, devant Kimi K3 (2,94) et GLM-5.3 (2,92). C'est un vrai résultat, mais c'est le test de Tencent lui-même, et un écart de 0,05 point sur une échelle de 4 est une quasi-égalité, pas un K.O.
Son propre graphique public raconte toute l'histoire, et il vaut mieux le regarder que de croire le résumé sur parole. Face à Claude Opus 5 et GPT-5.6 Sol, Hy4 (bleu foncé) est généralement derrière ; face à Kimi K3 et GLM-5.3, il échange les coups benchmark par benchmark.
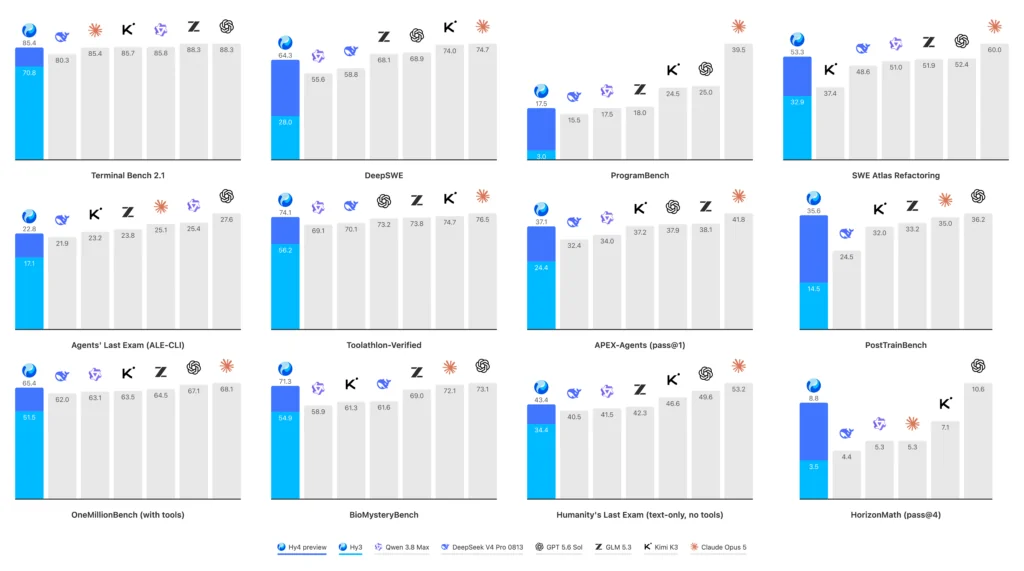
Le lecteur le plus affûté du fil r/LocalLLaMA a fait le décompte que le marketing n'a pas fait :
I don't think their own chart backs the beats glm and kimi line. Against kimi k3 it's behind on 7 of the 12 benchmarks... The beats claim comes from the internal blind test where wins only beat losses 47 to 40 against glm.
De façon indépendante, le compte officiel d'Arena a signalé Hy4 autour de la 5e place du classement WebDev de Code Arena avec 1 633 points, soit environ 3e parmi les modèles ouverts, tout en précisant qu'il s'agit d'un classement AutoEval précoce (un modèle de récompense vote à la place des votes humains en direct), pas d'un rang définitif. Et il n'est pas encore dans l'indice Artificial Analysis, donc il n'y a pas de score d'intelligence indépendant à citer. Ma lecture : un modèle ouvert solide, de premier rang, pas le nouveau n° 1, et le cadrage « bat tout le monde » est la partie que j'écarterais.
Autre point que Tencent admet franchement, et que je respecte : cette préversion raisonne plus longtemps que nécessaire et vérifie trop son propre travail. Ils livrent tôt volontairement, comme l'a fait la préversion de Hy3 avant que sa version finale ne progresse, selon les rapports, de 50 à 100 %.
Peut-on vraiment l'exécuter ?
C'est ici que l'étiquette « open-weight » se complique, et c'est la chose la plus importante à comprendre avant de s'enthousiasmer. Des poids ouverts et une licence Apache 2.0 signifient que vous avez le droit d'exécuter Hy4 n'importe où. Le matériel décide si vous le pouvez.
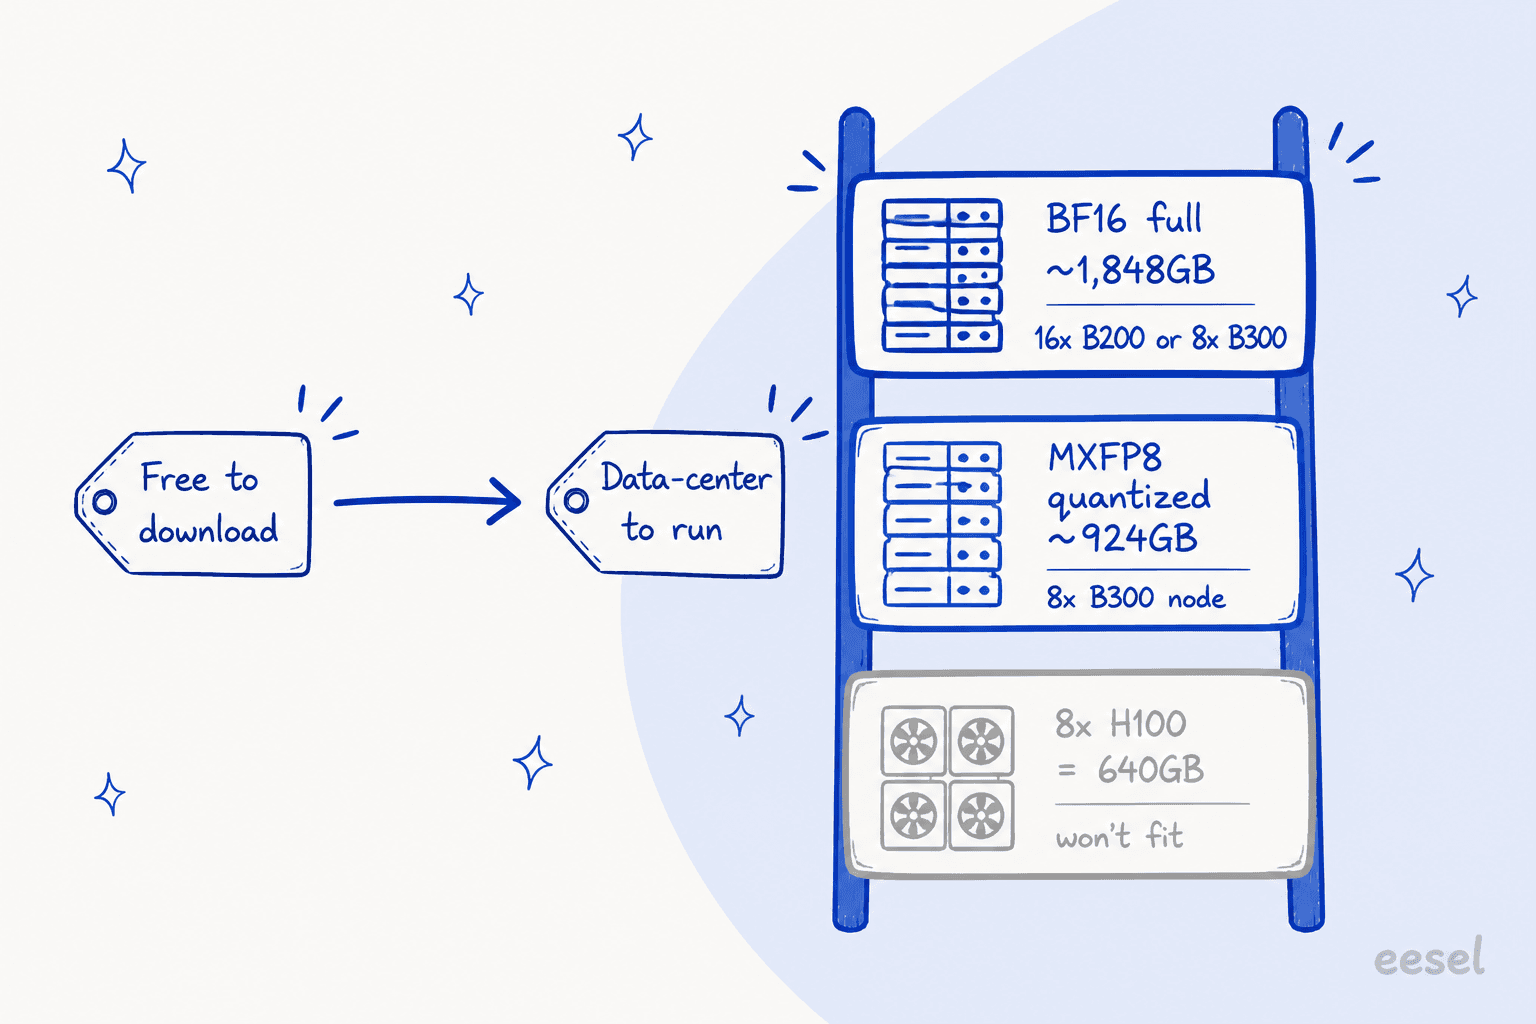
La recette vLLM est directe. Les poids complets en BF16 font environ 1 848 Go. Même les poids quantifiés MXFP8 font ~924 Go. Le plancher de la recette elle-même : « 16xB200 or 8xB300 minimum for weights + KV cache. » Un seul nœud 8x H100 (640 Go) ne peut pas le contenir. C'est un modèle de centre de données, point.
La communauté r/LocalLLaMA, qui fait tourner de gros modèles chez elle par passion, l'a accueilli avec autant d'admiration que de résignation :
The amount of people who can drop $5-10k to run these locally is vanishingly small.
Le calcul pratique de quantification qu'ils ont fait est utile si vous êtes tenté : un GGUF Q4 tourne autour de 450 Go, donc 512 Go est le minimum réaliste, et une machine de 256 Go ne supporte que les quantifications 1-2 bits. Comme le résumait une analyse détaillée : « if you have 256GB, you'll probably be much better off with GLM-5.3-Flash Q4. » C'est le verdict récurrent : en local, un modèle plus petit et bien post-entraîné est le choix le plus judicieux, et les modèles Flash de Z.AI reviennent sans cesse comme ceux à privilégier.
Donc, concrètement, « utiliser » Hy4 signifie l'API ou l'une des applications de Tencent, pas votre propre machine.
Ce que coûte Tencent Hy4
Sur l'API, Hy4 preview est facturé 0,834 $ par million de tokens en entrée et 2,501 $ par million en sortie, avec l'entrée en cache à 0,042 $ (annonce officielle). Parmi les modèles ouverts phares auxquels il se compare, c'est l'option économique.
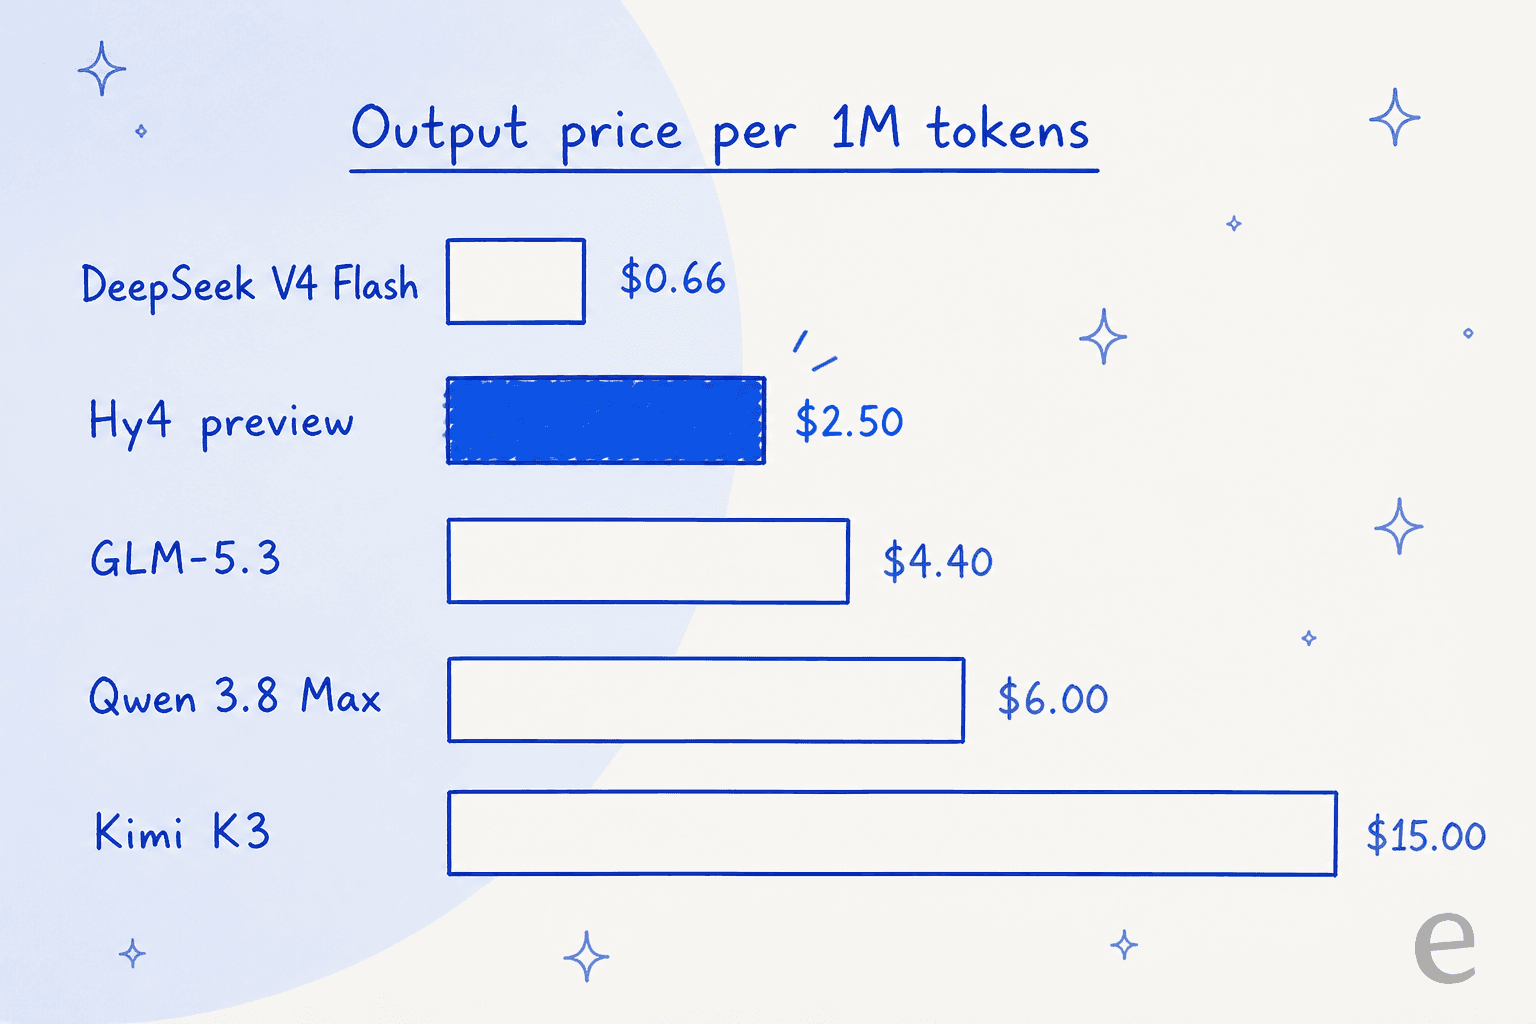
Voici le tableau complet face à ses rivaux, tout par million de tokens :
| Modèle | Paramètres totaux / actifs | Contexte | Entrée | Sortie | Entrée avec succès de cache |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | non communiqué | n/d | $1.40 | $4.40 | $0.26 |
Deux réserves honnêtes s'ajoutent. D'abord, Hy4 est environ 5 à 6 fois plus cher que Hy3, donc si vous utilisez déjà Hy3, c'est un vrai bond de coût, pas une remise. Ensuite, DeepSeek V4 Flash reste nettement moins cher sur les deux compteurs, et pour beaucoup de travail agentique, « pas cher et suffisamment bon » l'emporte. Un développeur a fait un vrai test et l'a dit sans détour :
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Si vous voulez l'essayer sans payer, Hy4 est gratuit pendant deux semaines dans WorkBuddy et CodeBuddy, et il est listé sur OpenRouter (avec une politique de rétention zéro des données, un petit plus par rapport à certaines API chinoises en direct).
Alors, à qui s'adresse vraiment Tencent Hy4 ?
Après quelques jours avec lui et les tests de la communauté, voici où j'atterris.
Choisissez Hy4 si vous construisez des outils agentiques de code, d'automatisation de bureau ou de recherche, que vous voulez précisément des poids ouverts et une licence permissive Apache 2.0, et que vous avez le matériel (ou le budget API) pour faire tourner un modèle à l'échelle de la frontière. Les scores en code et en maths sont réels, la fenêtre de contexte est énorme et le prix est inférieur à celui des autres modèles ouverts phares.
Passez votre chemin si vous exécutez des modèles en local sur un poste de travail (un modèle de classe Flash bien post-entraîné vous servira mieux pour une fraction de la mémoire), si le coût brut par token est votre principal levier (DeepSeek V4 Flash est bien moins cher) ou si vous voulez simplement que le travail soit fait sans vous soucier du modèle qui le fait.
Ce dernier cas est celui que je vois le plus souvent, et il faut être honnête : la plupart des gens qui demandent « dois-je utiliser Hy4 ? » ne veulent pas vraiment un modèle. Ils veulent une file de support vidée, un article de blog rédigé ou une tâche de recherche terminée. Un modèle brut de 770B est un moteur brillant sans voiture autour : il faut encore construire la recherche d'information, les garde-fous, les intégrations, les évaluations et la logique de repli avant qu'il ne fasse quoi que ce soit d'utile en production. C'est l'écart entre un benchmark impressionnant et quelque chose qui survit au trafic réel, et c'est la partie sur laquelle je passe mes journées.
Essayez eesel : engagez le coéquipier, évitez la plomberie du modèle
Voici comment je vois les choses : les modèles comme Hy4 sont de l'infrastructure. eesel AI est l'employé. Au lieu de choisir un modèle et de tout câbler autour, vous engagez un coéquipier IA prêt à travailler pour une tâche précise, et il arrive en sachant déjà la faire.
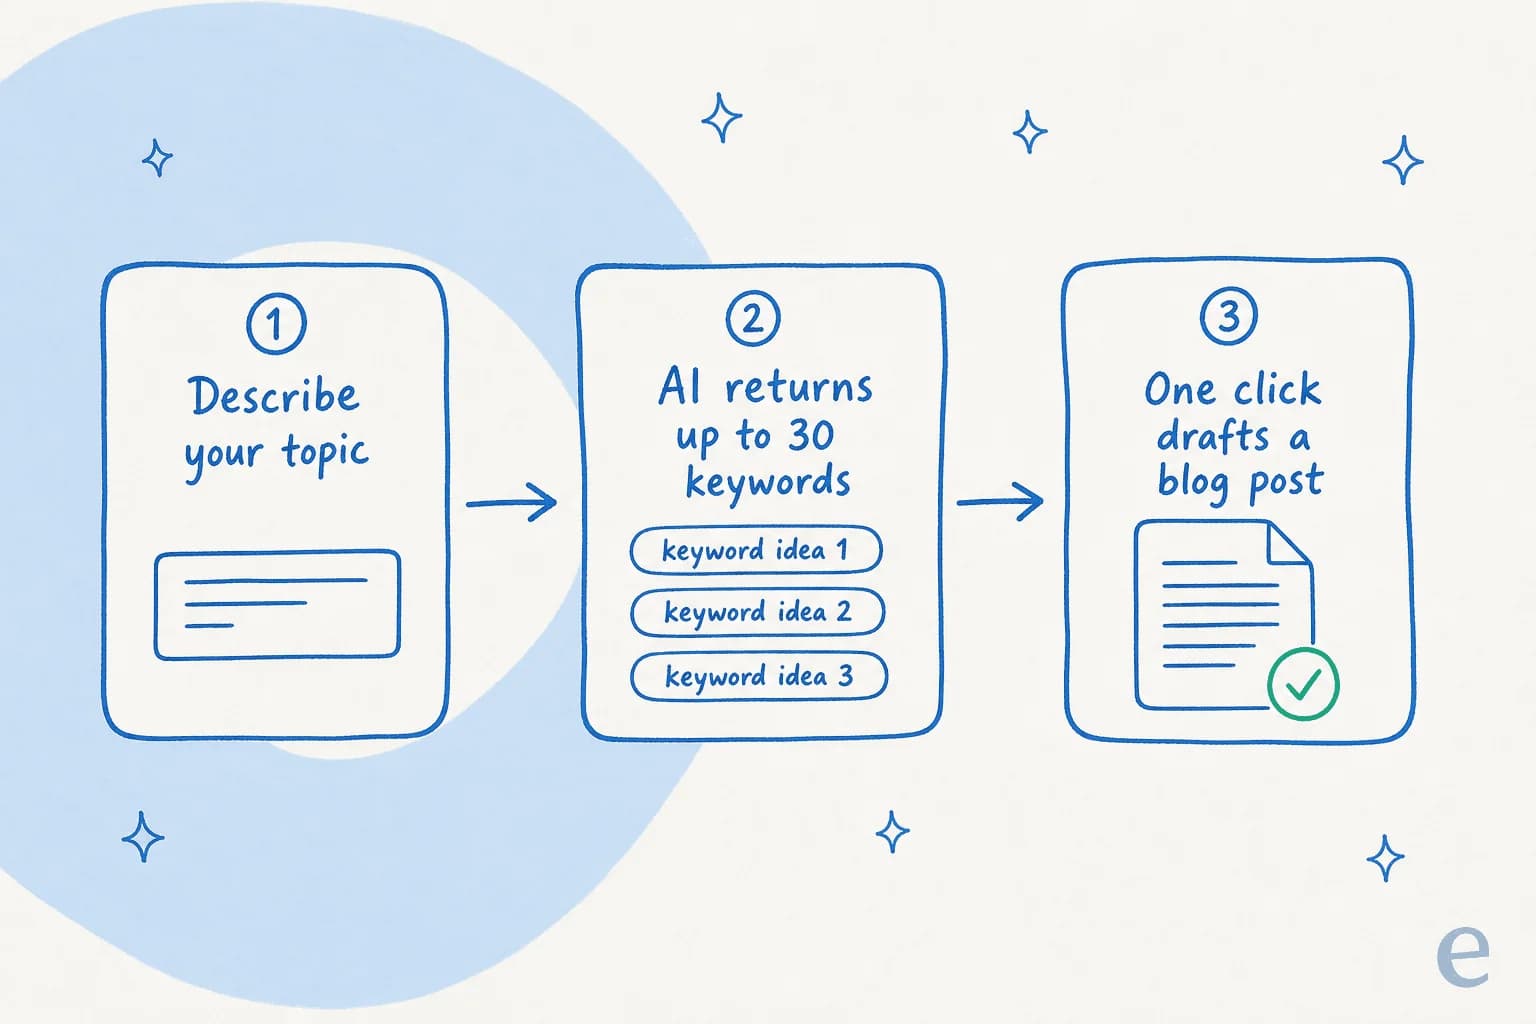
Pour l'instant, l'équipe compte deux coéquipiers. Le coéquipier IA de helpdesk rejoint votre file existante dans Zendesk, Freshdesk, Gorgias ou une boîte partagée, s'entraîne sur vos anciens tickets et votre centre d'aide, et rédige ou envoie des réponses, et surtout, vous pouvez le simuler sur vos tickets historiques avant qu'il ne réponde à un seul client, pour savoir comment il se comportera au lieu d'appuyer sur un interrupteur en espérant. Le rédacteur de blog IA fait la recherche, la rédaction et le SEO d'un article long en une seule exécution. Les deux tournent sur des modèles de pointe sous le capot, vous obtenez donc la capacité d'un modèle comme Hy4 sans provisionner un seul GPU. Vous pouvez démarrer gratuitement, sans carte bancaire et sans appel commercial.