

Tencent Hy4 preview a deux prix, et celui que tout le monde cite est le plus petit. Sur l'API, il coûte $0.834 par million de tokens en entrée et $2.501 par million en sortie, avec l'entrée en cache à $0.042 (annonce officielle). Parmi les modèles phares à poids ouverts auxquels il se compare, c'est la place bon marché.
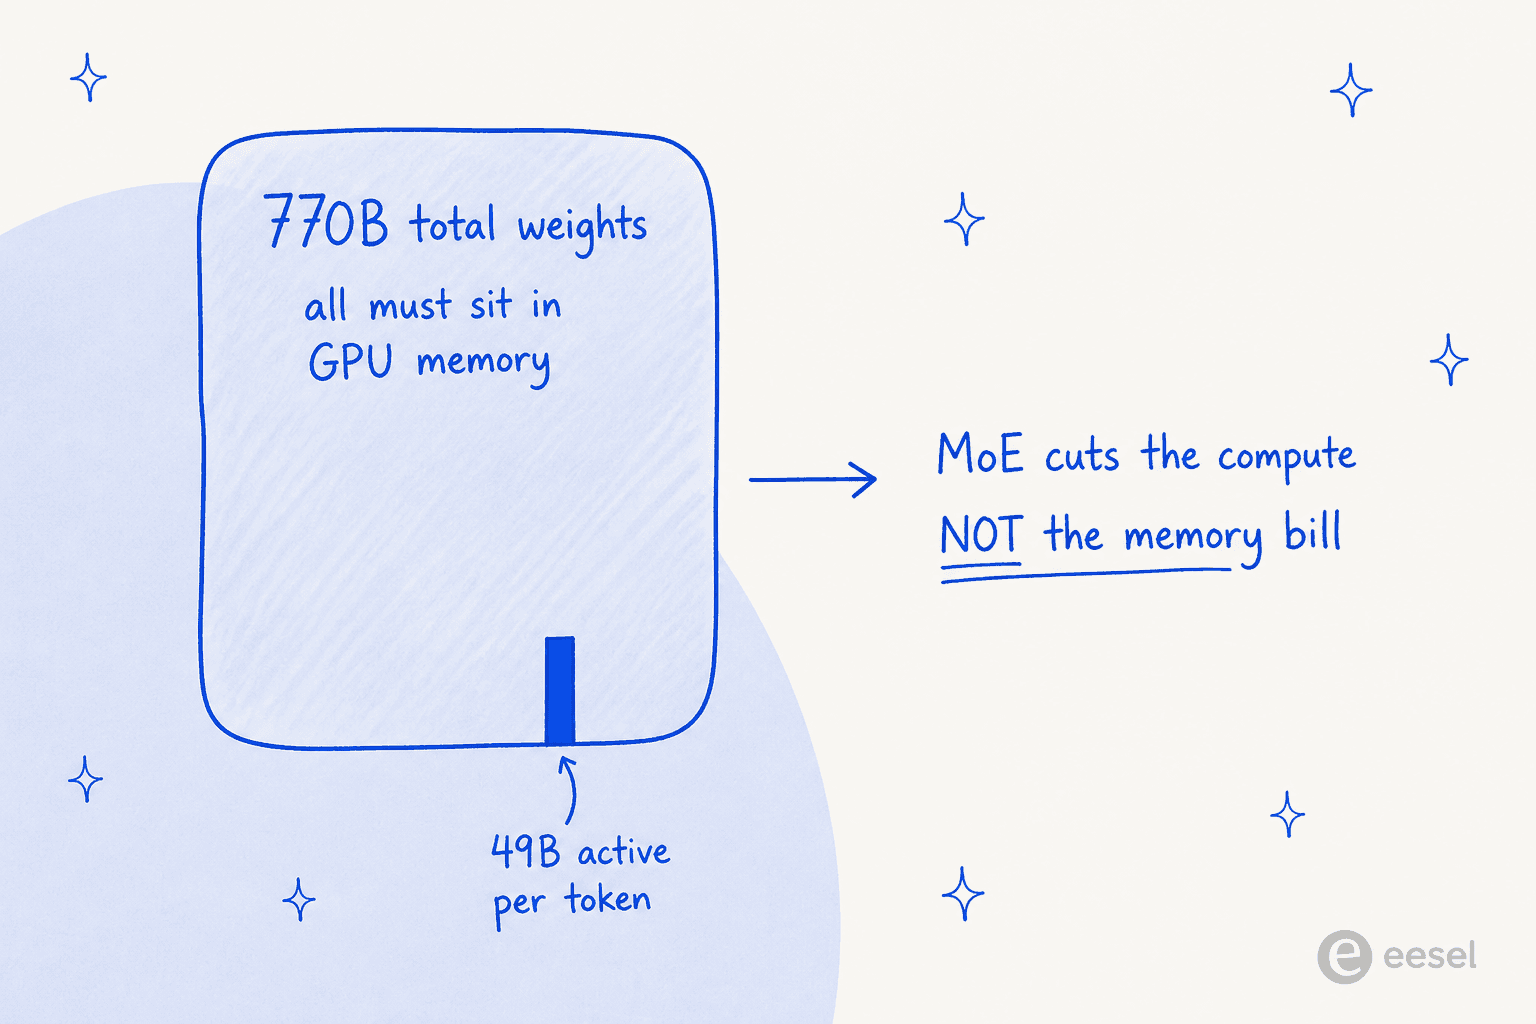
Le chiffre le plus gros, c'est le matériel. Hy4 est un modèle Mixture-of-Experts de 770B paramètres, et le MoE réduit le calcul par token, pas la facture mémoire : les 770B poids doivent donc tenir en même temps dans la mémoire GPU. L'exécuter vous-même implique 16x B200 ou 8x B300, un nœud de centre de données, pas une station de travail.
Voici donc la lecture honnête des tarifs Tencent Hy4 : loué via l'API, il est à un prix compétitif, moins cher que Kimi K3 ou Qwen 3.8 Max, même si DeepSeek V4 Flash reste bien moins cher. Si vous essayez de le posséder, le prix est un poste d'investissement sérieux. Et il est 5-6x plus cher que le Hy3 qu'il remplace, donc les utilisateurs actuels ne doivent pas s'attendre à une mise à niveau gratuite.
Si ce que vous voulez vraiment, c'est un travail terminé plutôt qu'un modèle à provisionner, un collègue IA prêt à l'emploi est un chemin plus court et souvent moins cher que tout cela.
Tarifs de l'API Tencent Hy4 en un coup d'œil
Je passe l'essentiel de ma semaine à réfléchir à la façon dont les acheteurs cherchent réellement des outils comme celui-ci, et « tarifs Tencent Hy4 » recouvre presque toujours deux questions : combien coûte un token, et combien coûte l'ensemble à faire tourner. Prenons d'abord la question du token, parce que c'est la simple.
Voici les tarifs publiés de l'API, tirés directement de l'annonce de lancement de Tencent, tous par million de tokens :
| Compteur | Prix par 1M de tokens | Ce qu'il couvre |
|---|---|---|
| Entrée | $0.834 | Chaque token que vous envoyez (prompt, contexte, documents récupérés) |
| Sortie | $2.501 | Chaque token que le modèle génère en retour |
| Entrée en cache | $0.042 | Tokens d'entrée servis depuis le cache sur un prompt répété |
Trois choses méritent d'être relevées dans ce tableau.
D'abord, le ratio sortie/entrée est d'environ 3:1, ce qui est normal pour un modèle à fort raisonnement. Comme Hy4 est un gros raisonneur (plus de détails plus bas), vos factures pencheront vers le compteur de sortie, donc ce chiffre de $2.501 est celui sur lequel planifier, pas le $0.834 des gros titres.
Ensuite, le tarif du cache est très bas, $0.042. Si votre charge répète un grand prompt système ou une base de connaissances fixe sur de nombreux appels, et c'est le cas de la plupart des charges agentiques, les succès de cache réduisent le prix d'entrée effectif d'environ 20 fois. C'est un vrai levier, et c'est ce qui sépare un agent IA bien construit d'un chatbot à règles ou d'une enveloppe naïve qui paie plein tarif pour chaque token.
Enfin, il n'existe pas d'offre gratuite permanente. L'essai est limité dans le temps (deux semaines dans les applications de Tencent), et ensuite chaque token est facturé.
Estimez votre facture mensuelle Tencent Hy4
Des tarifs par million de tokens sont difficiles à se représenter. Saisissez un volume mensuel approximatif et voyez ce que coûte Hy4 face aux autres modèles ouverts phares. Le calculateur suppose les tarifs standard sans cache pour chaque modèle.
Le prix que personne ne cite : l'exécuter soi-même
C'est ici que les « poids ouverts » deviennent chers, et c'est le point le plus important à comprendre avant de vous enthousiasmer pour le côté open source de Hy4. La licence Apache 2.0 signifie que vous avez le droit de l'exécuter n'importe où. C'est le matériel qui décide si vous le pouvez, et à quel coût.
La recette vLLM est directe sur le plancher. Les poids BF16 complets pèsent environ 1 848 Go. Même les poids quantifiés MXFP8 font ~924 Go. Le minimum de la recette elle-même : "16xB200 or 8xB300 minimum for weights + KV cache." Un seul nœud de 8x H100 (640 Go) ne peut pas le contenir.
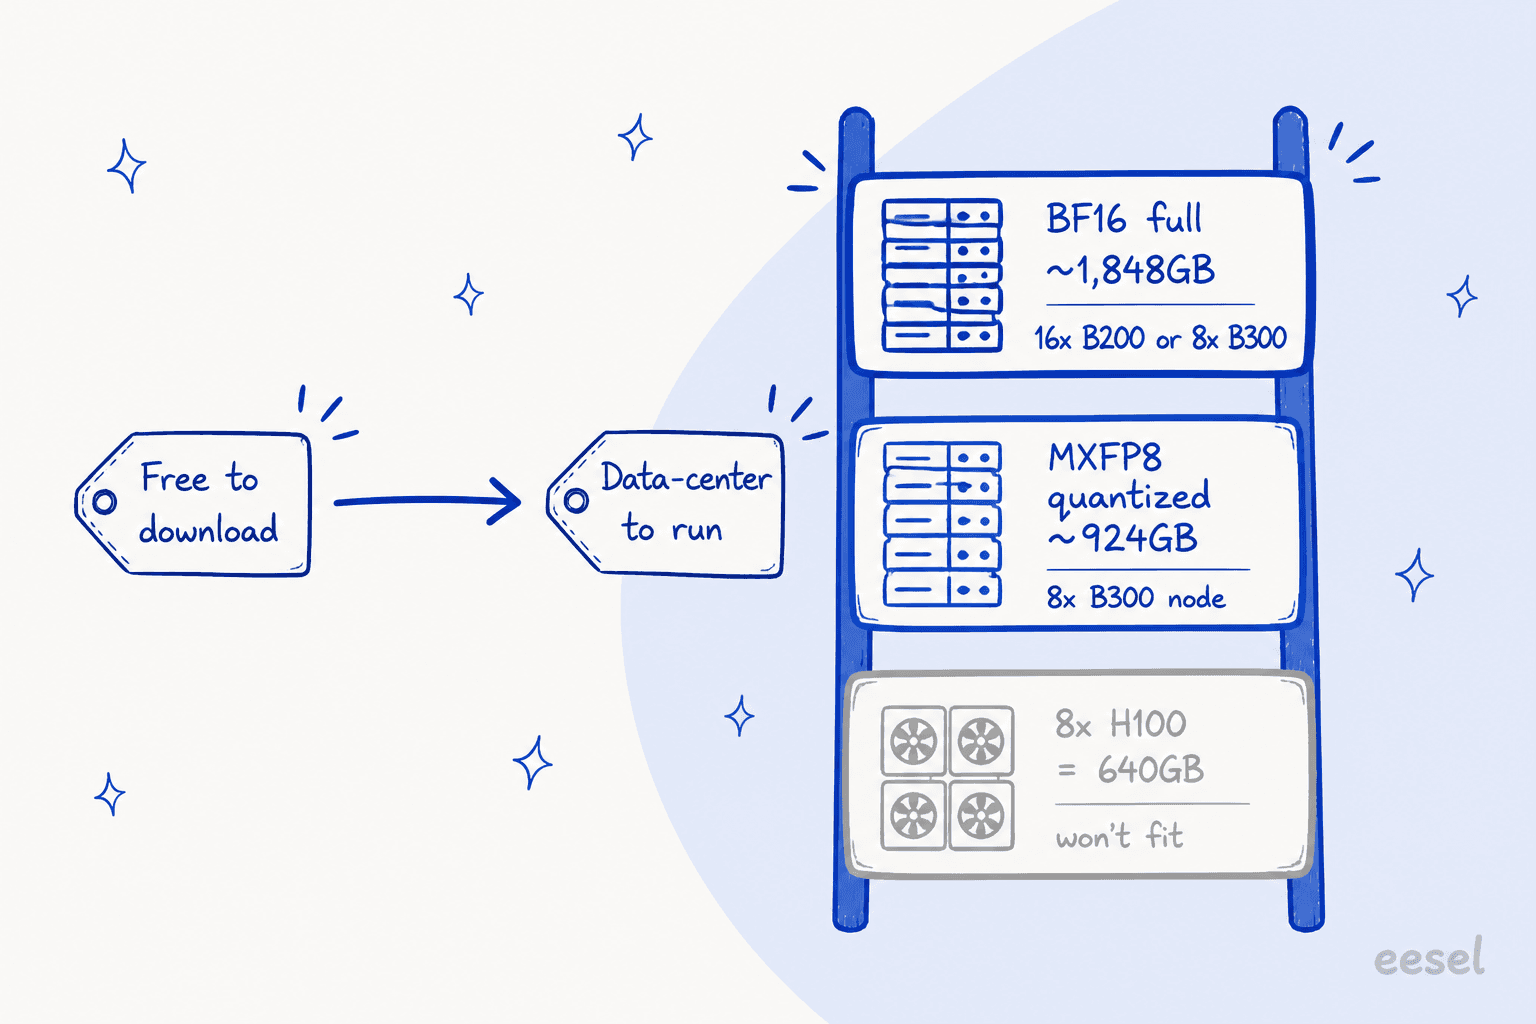
Mettons des ordres de grandeur dessus. Louer un nœud de 8x B200 chez un fournisseur de GPU cloud coûte de l'ordre de dizaines de milliers de dollars par mois, et la recette BF16 complète en demande deux. Acheter le silicium directement est un achat d'investissement à six chiffres avant même de l'allumer. C'est le vrai prix de Tencent Hy4 pour qui veut posséder son inférence, et il écrase le tarif par token, sauf si vous faites tourner la machine à très forte utilisation.
La communauté de r/LocalLLaMA, qui exécute de gros modèles chez elle par passion, l'a accueilli avec autant d'admiration que de résignation :
The amount of people who can drop $5-10k to run these locally is vanishingly small.

Le calcul de quantification qu'ils ont fait est utile si vous êtes tenté. Un GGUF Q4 pèse environ 450 Go, donc 512 Go de mémoire est le minimum réaliste, et une machine de 256 Go ne convient qu'aux quantifications de 1-2 bits. Une analyse détaillée le dit clairement : avec 256 Go, vous êtes bien mieux servi par GLM-5.3-Flash. En usage local, un modèle plus petit et bien post-entraîné continue de gagner l'argument du coût.
Ce qu'il faut retenir côté tarifs : pour presque tout le monde, « utiliser » Hy4 veut dire passer par l'API. L'auto-hébergement est un projet de centre de données, pas une ligne de budget.
Tarifs Tencent Hy4 face aux autres modèles phares à poids ouverts
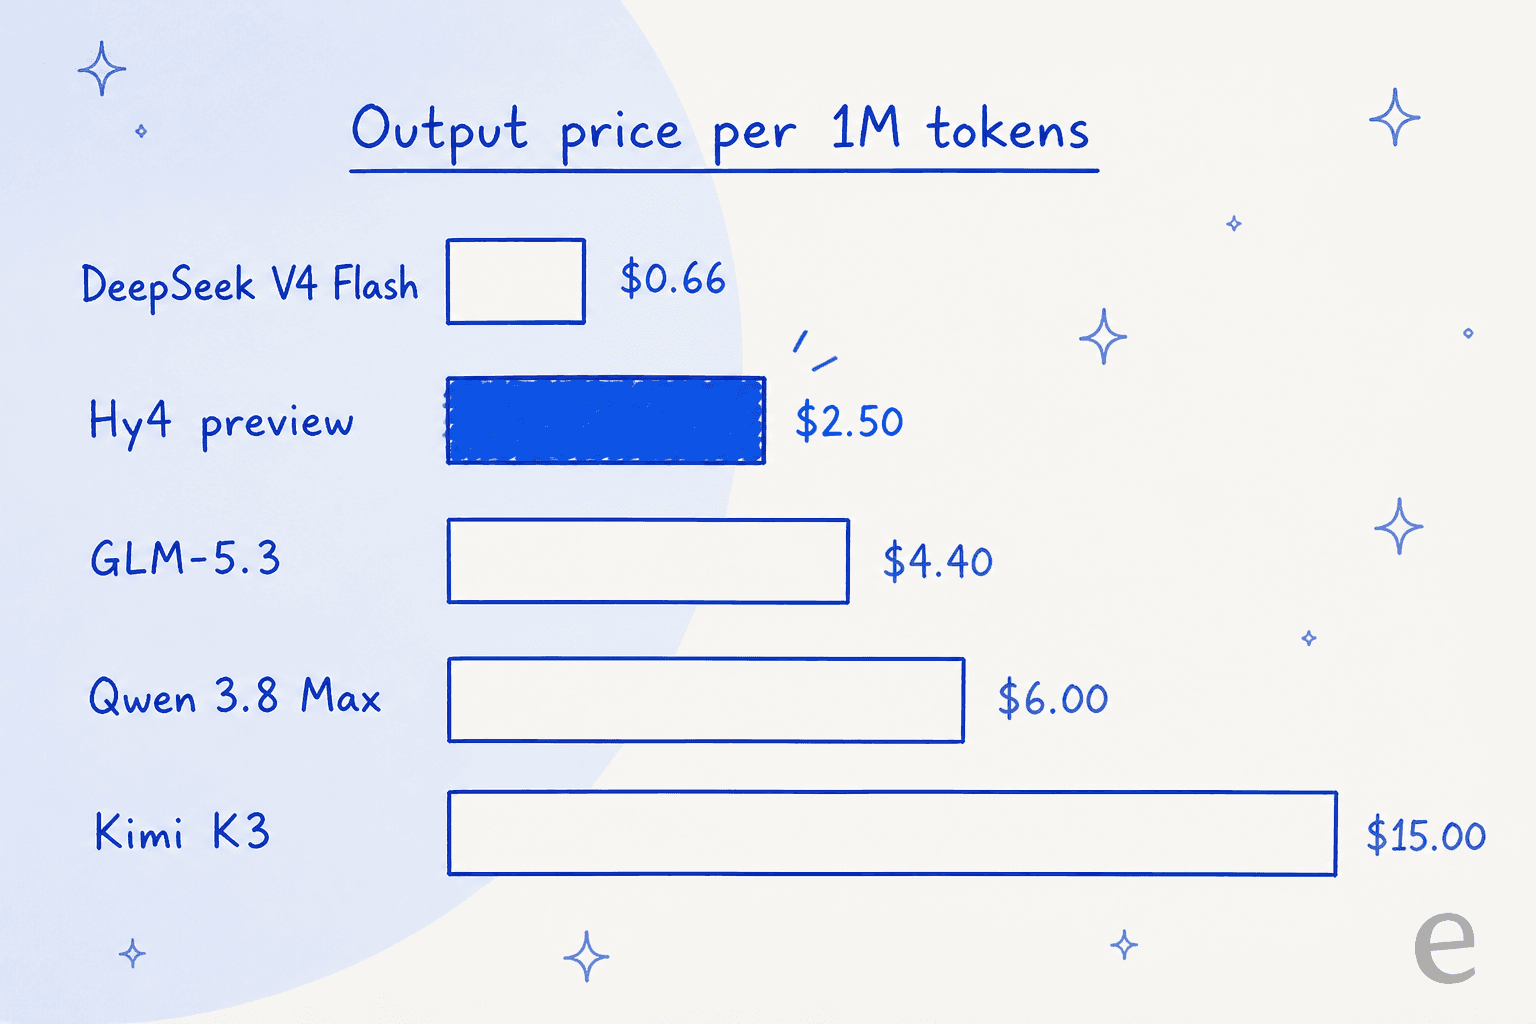
Voici où se situe Hy4 face à ses rivaux, le tout par million de tokens, vérifié le 30 août 2026.
| Modèle | Paramètres totaux / actifs | Contexte | Entrée | Sortie | Entrée avec succès de cache |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | non communiqué | n/d | $1.40 | $4.40 | $0.26 |
Le graphique raconte la même histoire plus vite. Sur le compteur qui domine la plupart des factures, la sortie, Hy4 est le deuxième moins cher de ce groupe, derrière DeepSeek V4 Flash seulement.
Deux réserves honnêtes s'ajoutent à ce tarif.
D'abord, Hy4 est environ 5-6x plus cher que Hy3, comme signalé dans le fil de discussion sur les prix de la communauté. Si vous utilisez déjà Hy3, c'est un vrai bond de coût, pas une remise, et vous devez décider si la capacité supplémentaire change votre résultat.
Ensuite, DeepSeek V4 Flash est nettement moins cher sur les deux compteurs, et pour beaucoup de travaux agentiques, « pas cher et assez bon » l'emporte. Un développeur l'a dit sans détour après un vrai test :
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
C'est le cœur de la position tarifaire de Hy4 : ce n'est pas le moins cher, et il n'essaie pas de l'être. C'est l'option à prix intermédiaire qui vous apporte des scores en code de niveau frontière et un contexte de 1M, et savoir si cela vaut la prime par rapport à DeepSeek ou à un modèle de gamme Flash dépend entièrement de combien la qualité supplémentaire fait bouger vos chiffres.
Comment essayer Hy4 à moindre coût (ou gratuitement)
Si vous voulez tester avant d'engager un budget, il existe quelques voies peu coûteuses :
- Gratuit pendant deux semaines dans les applications WorkBuddy et CodeBuddy de Tencent dès le lancement. Aucun coût de tokens pendant la fenêtre.
- OpenRouter, qui référence Hy4 preview avec une politique de données à rétention zéro. Pratique si vous voulez une seule clé d'API pour de nombreux modèles et que le traitement des données vous importe.
- Tencent Cloud TokenHub, la voie directe si vous êtes déjà dans le cloud de Tencent.
Pour la plupart des acheteurs, le plus malin est de lancer un petit pilote pendant la fenêtre gratuite, de mesurer votre vraie répartition entrée/sortie (utilisez le calculateur ci-dessus avec ces chiffres), puis seulement de décider si le tarif de Hy4 bat un modèle moins cher pour votre charge de travail précise.
Ce que le prix de Hy4 achète vraiment, et où il fuit
Une dernière nuance de prix qui n'apparaît pas sur la grille tarifaire. Tencent reconnaît franchement que cette preview raisonne plus longtemps que nécessaire et vérifie trop son propre travail. Sur un modèle facturé au token, un sur-raisonneur gonfle discrètement votre facture, parce que vous payez chacun de ces tokens de sortie supplémentaires. Le coût effectif de Hy4 pour une tâche bavarde et riche en vérifications peut donc dépasser le tarif affiché, ce qui n'apparaît justement qu'une fois en production.
C'est l'écart auquel je reviens sans cesse. Un tarif brut de modèle vous dit ce que coûte un token. Il ne dit pas combien de tokens la tâche va demander, si vos prompts atteignent le cache, combien vous dépenserez en nouvelles tentatives, ni ce que vaut le temps d'ingénierie pour tout brancher. Ce sont ces chiffres qui décident de la vraie facture, et un benchmark ou un tableau de prix ne les montre jamais.
Si vous voulez le contexte plus détaillé des spécifications et des benchmarks derrière ces prix, le test complet de Tencent Hy4 et la présentation de Hy4 détaillent ce que vous payez.
Et si vous comparez uniquement sur le coût, ces analyses sont les lectures suivantes naturelles :
- Tarifs Qwen 3.8 Max
- Tarifs Kimi K3 et le test de Kimi K3
- Tarifs Gemini
- Tarifs Mistral
- DeepSeek V4, l'actuel plancher des prix
Essayez eesel : embauchez le collègue, oubliez le calcul des tokens
Voici comment je formule les choses après des années à regarder des équipes choisir des modèles. Un modèle comme Hy4 est une infrastructure, un moteur sans voiture autour. eesel AI est l'employé. Au lieu de choisir un modèle, de provisionner des GPU ou de mesurer des tokens, et de construire vous-même la recherche, les garde-fous, les intégrations et les évaluations, vous embauchez un collègue IA prêt à travailler pour une tâche précise, et il arrive en sachant déjà la faire.

Pour l'instant, l'équipe compte deux collègues. Le collègue IA pour helpdesk rejoint votre file existante dans Zendesk, Freshdesk ou une boîte partagée, s'entraîne sur vos anciens tickets et votre centre d'aide, et rédige ou envoie des réponses. Vous pouvez le simuler sur des tickets historiques avant qu'il ne réponde à un seul client, pour connaître le coût et le comportement à l'avance au lieu d'actionner un interrupteur en espérant. Le rédacteur de blog IA prend en charge la recherche, la rédaction et le SEO d'un long article en une seule exécution.
Les deux tournent sur des modèles de pointe en coulisses, vous obtenez donc la capacité sans provisionner un seul GPU ni lire une grille tarifaire, et les prix mensuels fixes d'eesel (à partir de $299/mois pour 500 crédits) sont un chiffre prévisible plutôt qu'un compteur de tokens brut à anticiper. Vous pouvez démarrer gratuitement, sans carte bancaire et sans appel commercial.
Vous voulez le calcul de bout en bout plutôt qu'un tarif par token ? Ces articles le rendent concret :