

Gemini Omni 1.2 Flash est la mise à jour du 5 novembre 2026 de Google DeepMind pour son modèle vidéo Omni. Les changements principaux sont des clips de 15 secondes (contre 10 avant), environ 0,07 $ par seconde de vidéo 720p (contre environ 0,10 $ avant), et une cohérence plus serrée des personnages et des produits sur les images de référence. Ça reste un modèle sur lequel on construit, pas un travailleur qui fait un métier. Je l'utiliserais pour des pipelines de vidéo publicitaire et produit. Pour les tickets de support ou les articles de blog, un coéquipier prêt à l'emploi comme eesel convient mieux, et la eesel CLI permet à un agent de code de téléverser des connaissances approuvées et de tester les réponses d'un coéquipier avant sa mise en ligne.
Qu'est-ce que Gemini Omni 1.2 Flash ?
C'est la troisième sortie de la gamme vidéo Omni de Google, après le Gemini Omni Flash original et la mise à jour d'août, Gemini Omni 1.1 Flash. La fiche modèle de Google liste le texte, les images, l'audio et la vidéo comme entrées, et « une vidéo de haute qualité et haute résolution avec audio » comme sortie. L'identifiant du modèle dans l'API Gemini est gemini-omni-1.2-flash, et le journal des modifications de l'API Gemini le marque comme disponible de façon générale depuis le 5 novembre 2026.
L'idée reste la même que dans les versions précédentes : vous décrivez un plan, puis vous l'affinez en discutant plutôt qu'en re-rendant de zéro. Si vous voulez l'histoire du modèle original, mon avis sur Gemini Omni Flash la couvre.
Qu'est-ce qui a changé depuis 1.1 ?
En résumé : des clips plus longs, un prix plus bas et des références plus solides. Un détail va dans l'autre sens, que je signale plus bas.
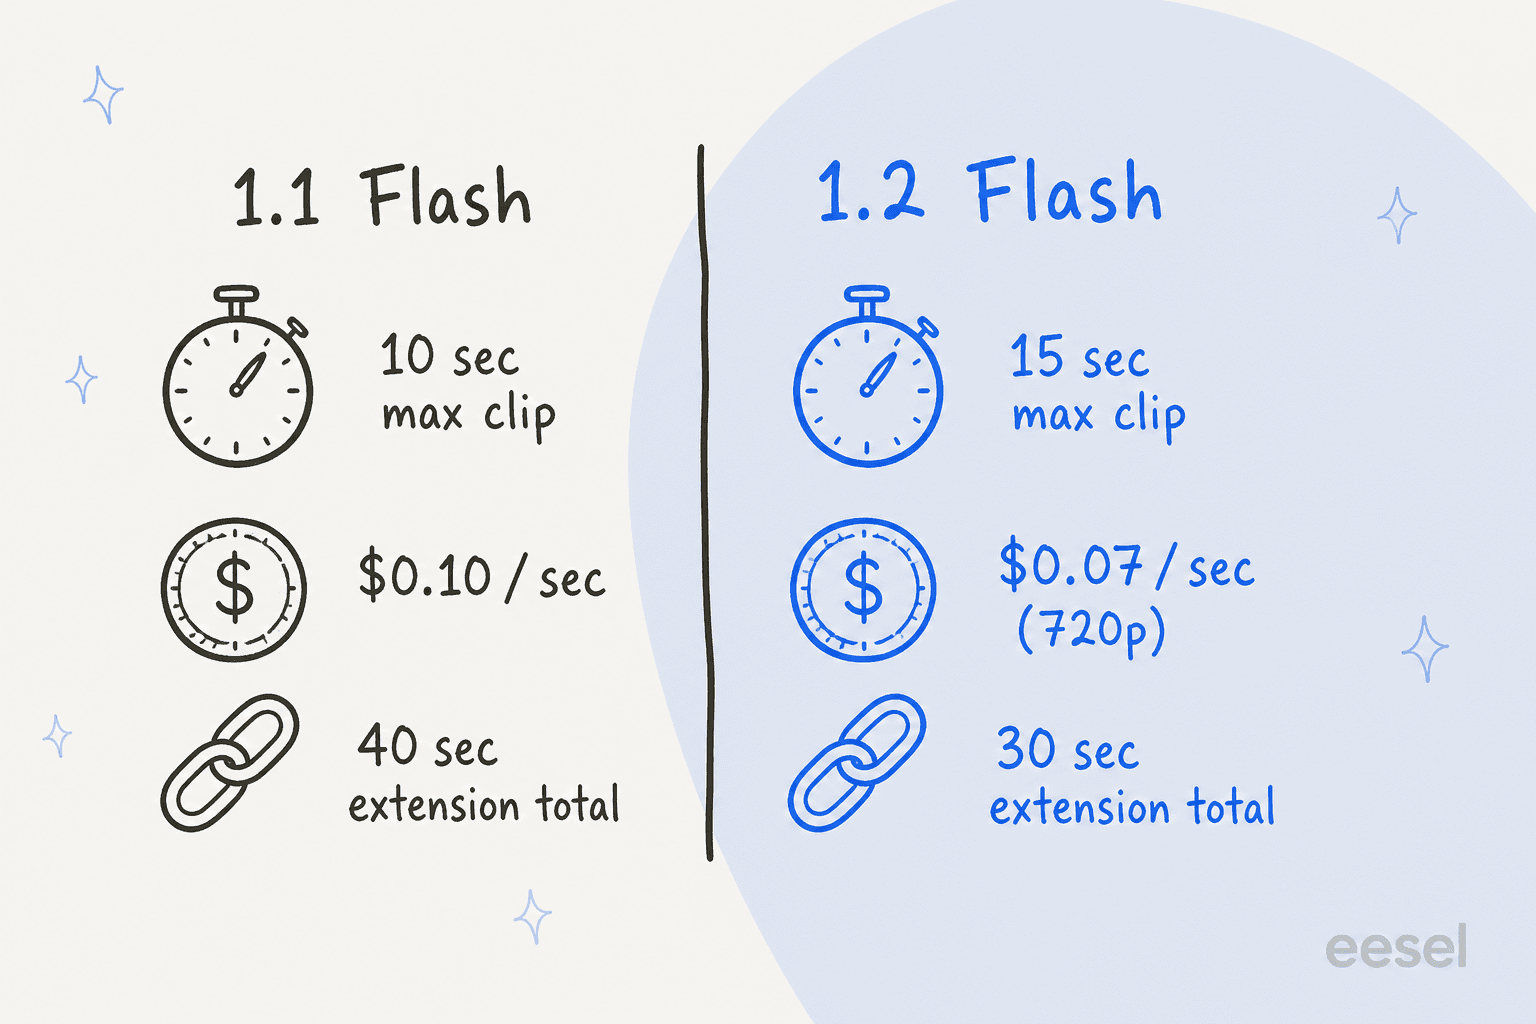
- Durée du clip : de 3 à 15 secondes par génération, par paliers d'une seconde, selon la documentation de Google AI Studio. La version 1.1 limitait une génération à 10 secondes.
- Prix : la sortie vidéo baisse à
12,00 $par million de tokens contre17,50 $, ce que la page tarifaire situe à environ0,07 $par seconde de vidéo 720p. - Références : le journal des modifications indique que le modèle garde les personnages et les sujets plus cohérents sur jusqu'à six images de référence. Les références audio sont derrière une liste d'autorisation sur Google Cloud.
- Voix : le billet de lancement de Google Cloud cite une synchronisation labiale plus nette et un conditionnement multi-locuteurs.
- Limites : les limites de débit du palier payant ont doublé, selon la même entrée du journal des modifications.
Un point va à rebours de la tendance. Au lancement, 1.1 annonçait une extension de scène allant jusqu'à 40 secondes au total. La documentation de 1.2 liste l'extension à 3-10 secondes par tour, jusqu'à 30 secondes au total. Les pages de Google n'expliquent pas la différence, donc si vous aviez prévu des chaînes de 40 secondes, testez avant de vous engager.
Quelle est sa qualité, selon les propres chiffres de Google ?
La page Gemini Omni de Google publie des taux de préférence côte à côte pour 1.2 contre 1.1. Ce sont les propres évaluations de Google, pas un benchmark indépendant, et vos invites et images de référence n'étaient pas dans cet échantillon.
| Test | Taux de préférence 1.2 | Taux de préférence 1.1 |
|---|---|---|
| Texte vers vidéo, cohérence visuelle | 62 % | 38 % |
| Référence vers vidéo, préférence globale | 63 % | 37 % |
| Référence vers vidéo, cohérence d'identité | 63 % | 37 % |
| Image vers vidéo, préférence globale | 59 % | n/a |
| Édition par instructions | 57 % | n/a |
Lisez cela comme « une avancée claire mais modeste ». Un taux de préférence de 62 % signifie qu'environ une comparaison sur trois préférait encore l'ancien modèle. Pour le travail publicitaire, les lignes de cohérence des références comptent le plus, car des couleurs de produit qui dérivent sont souvent la raison du rejet d'une génération.
Combien ça coûte ?
La page tarifaire de l'API Gemini ne liste le modèle que sur le palier standard. Il n'y a ni palier gratuit ni palier batch. L'entrée coûte 1,50 $ par million de tokens, la sortie texte 9,00 $, et la sortie vidéo 12,00 $.
| Résolution | Par seconde | Tokens par seconde |
|---|---|---|
| 360p | 0,023 $ | 1 931 |
| 720p | environ 0,07 $ | 5 792 |
| 1080p (avec sur-échantillonnage) | 0,104 $ | 8 688 |
| 4K (avec sur-échantillonnage) | 0,209 $ | 17 376 |
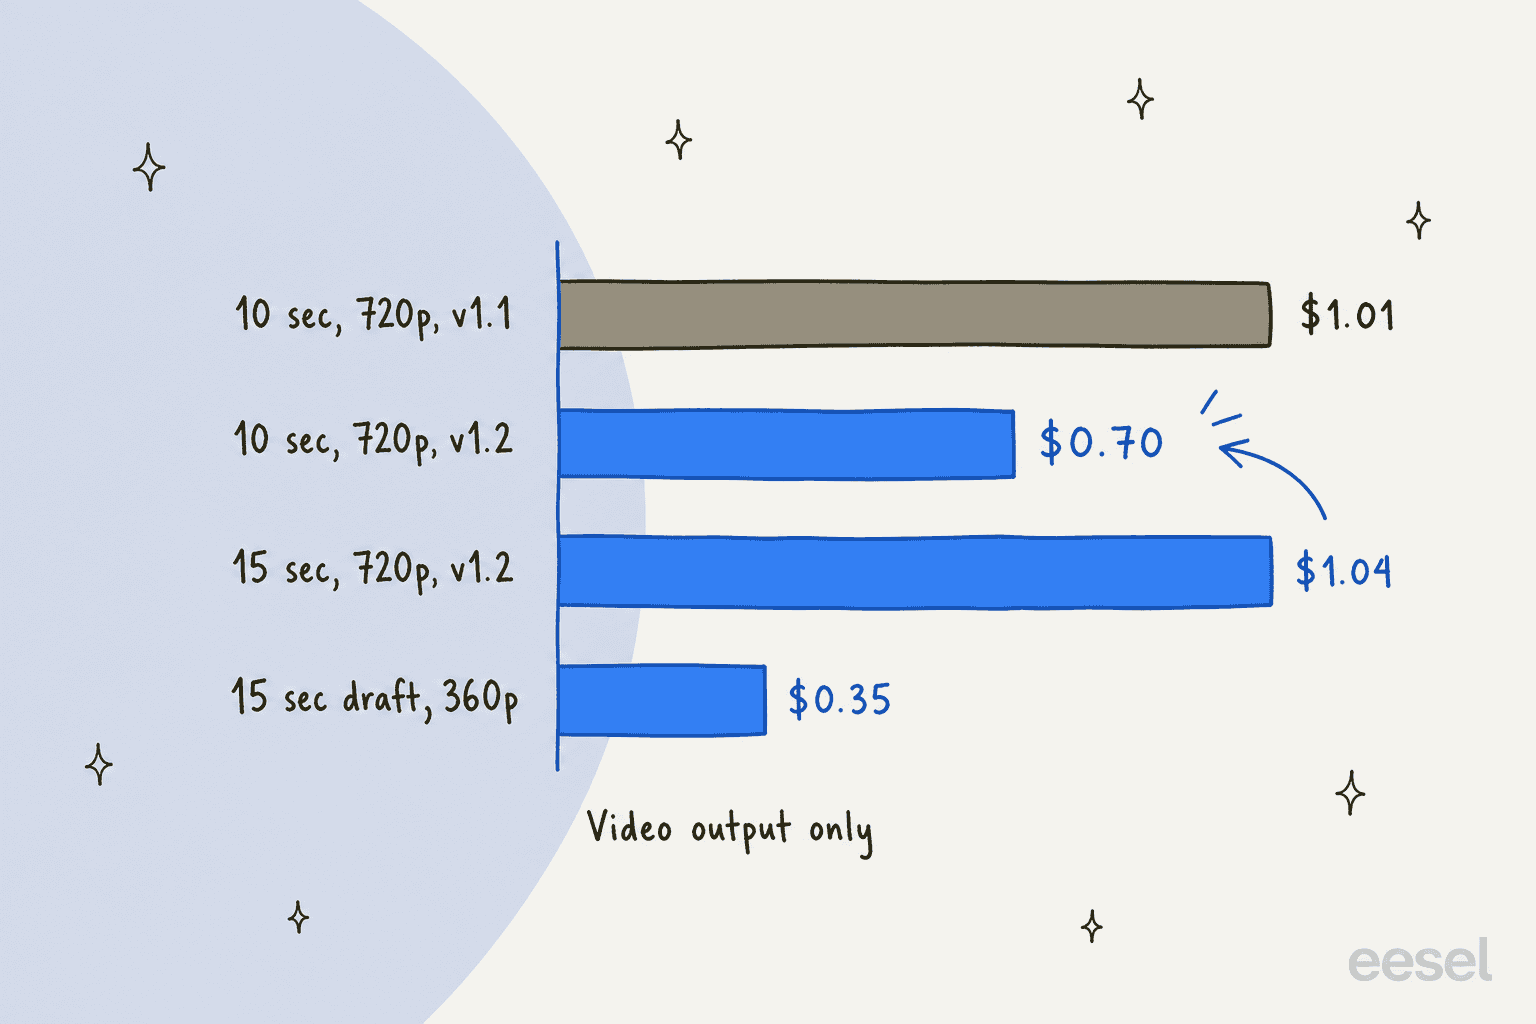
Les 5 792 tokens par seconde en 720p viennent du même taux utilisé dans mon guide tarifaire Omni 1.1. En multipliant, un clip complet de 15 secondes en 720p coûte environ 1,04 $ et un clip de 10 secondes environ 0,70 $, contre environ 1,01 $ pour 10 secondes sur 1.1. Pour un contexte plus large, voir ma ventilation des tarifs de Gemini Omni Flash et le guide général des tarifs de Gemini.
La page tarifaire de Google indique qu'à partir du 3 décembre 2026, les requêtes vers l'identifiant du modèle 1.1 sont automatiquement redirigées vers 1.2 et facturées aux tarifs de 1.2. Si vous avez des appels 1.1 en production, vos coûts baissent sans changement de code, et votre sortie change aussi sans en changer.
Comment fonctionne le flux brouillon puis mise à l'échelle ?
Le billet de lancement de Google décrit le fait de faire des brouillons en 360p ou 720p, puis de passer la meilleure prise à l'échelle en 1080p ou 4K. En pratique, vous itérez à bas coût, vous corrigez les problèmes avec un message de chat de suivi, et vous ne payez qu'une fois pour le rendu haute résolution.
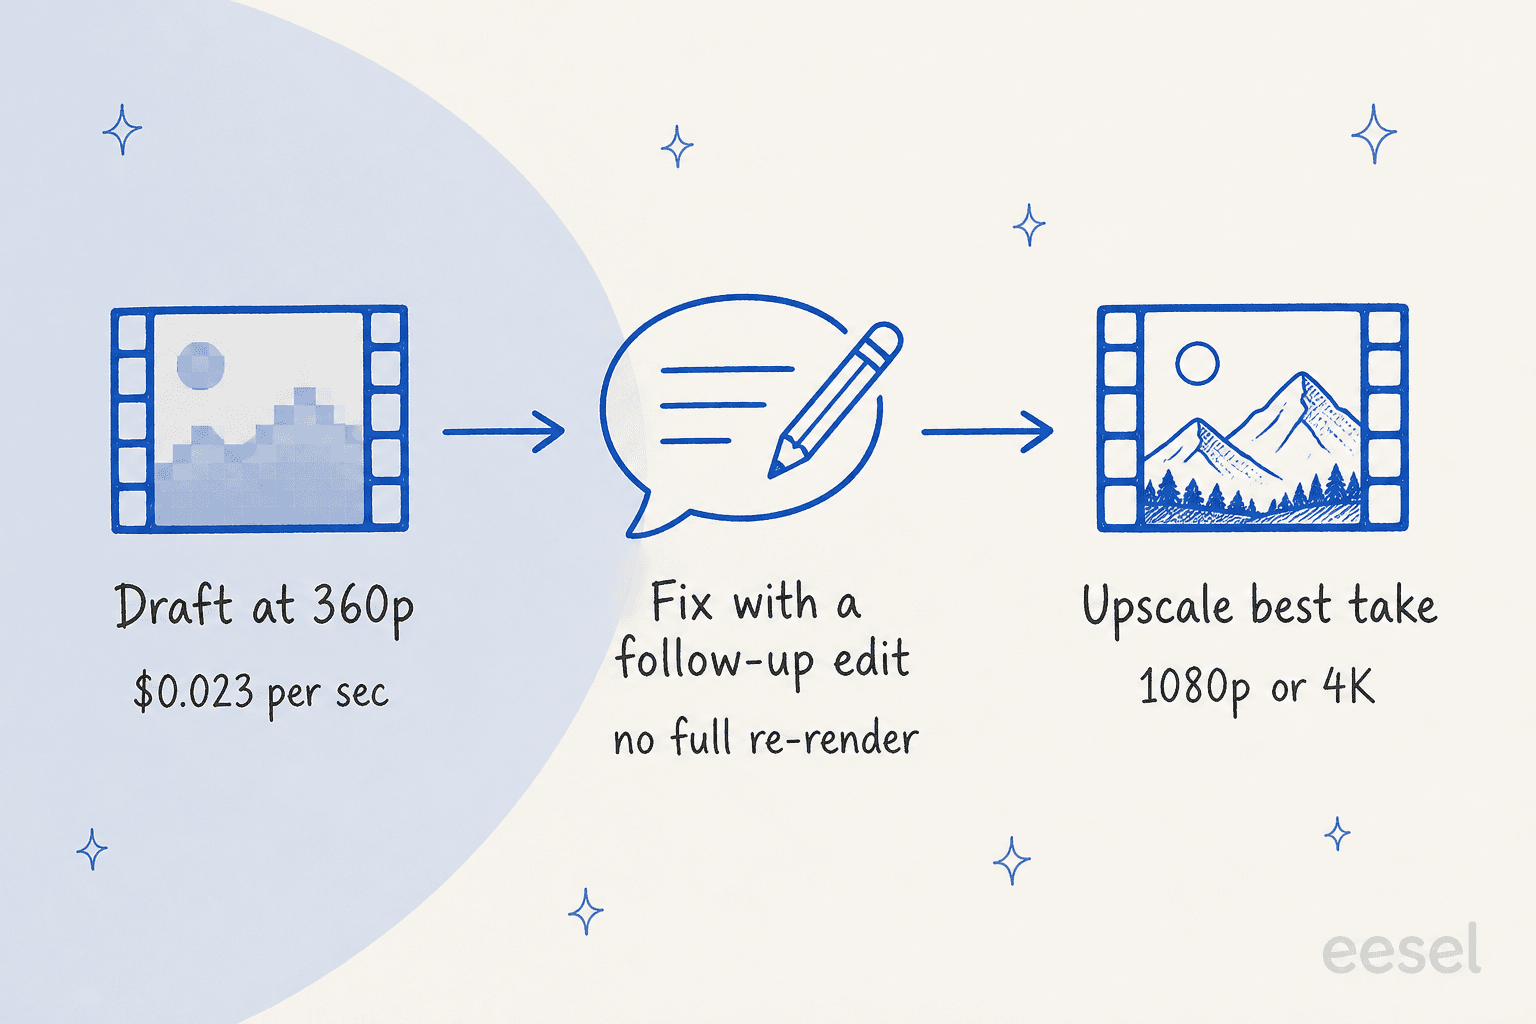
Deux détails sur lesquels la documentation reste muette. Elle ne dit pas si un brouillon est facturé en plus de sa mise à l'échelle ultérieure, donc un flux de travail riche en brouillons devrait être chiffré d'abord avec un petit test. Et comme l'a noté un commentateur de Hacker News à propos de 1.1, les brouillons et les rendus finaux ne sont pas déterministes, donc un brouillon est un aperçu de la direction plutôt qu'une garantie de l'image finale.
Où pouvez-vous l'utiliser ?
Google liste un large éventail de surfaces dans la fiche modèle : l'application Gemini, l'application Gemini Enterprise, Google AI Studio, YouTube, Flow, Google Cloud, l'API Gemini et Workspace. Des détails à connaître :
- Google Vids : le billet Workspace Updates indique que le déploiement a commencé le 5 novembre, avec un curseur de 3 à 15 secondes et sans contrôle administrateur. Cela couvre les plans Business, Enterprise et Education, plus les comptes personnels avec Google AI Pro ou Ultra.
- Google Cloud : disponible de façon générale via l'API et la console, avec Provisioned Throughput pour les charges de travail en production. La création vidéo dans Gemini pour les entreprises est listée comme à venir.
- Limites de contexte : 131 072 tokens en entrée et 65 536 tokens en sortie, une sortie à 24 FPS, et du 360p jusqu'au 4K.
L'accès n'est pas uniforme selon les plans. Dans le fil de lancement sur Hacker News, un commentateur a décrit la friction :
"There have been months where we've paid 1500€ for my AI models, but I can't bother with Google's models because I literally don't know how to get them."

Et la sécurité et la provenance ?
Chaque sortie porte un filigrane SynthID imperceptible, et la page produit de Google ajoute des C2PA Content Credentials. La fiche modèle indique que le modèle peut modifier la voix des personnes pendant l'édition vidéo, une capacité actuellement restreinte. Elle rapporte aussi que, d'après des évaluations de Gemini 3.1 Pro et Gemini 3.7 Flash, le modèle est peu susceptible d'atteindre un niveau de capacité suivi ou critique.
Qui construit déjà avec ?
Le billet de lancement de Google Cloud cite une série d'équipes produit vidéo : invideo dit que 15 secondes permettent de faire tenir une scène complète dans une seule génération, QuickFrame AI dit qu'une sortie de 15 secondes en 1080p permet aux utilisateurs de construire une publicité connected-TV complète en une seule passe, et Picsart met en avant le mode brouillon pour une itération rapide des concepts. Ce sont des partenaires de lancement que Google a choisi de mettre en avant, lisez-les donc comme un cadrage, pas comme des avis neutres. Le schéma reste clair malgré tout : publicité, animation produit et outils créatifs.
Si vous comparez des modèles vidéo, mon guide des tarifs de Sora 2 et la liste des alternatives à Sora 2 couvrent le côté OpenAI, et l'article sur les alternatives à Omni 1.1 couvre le champ plus large.
Où se situe Gemini Omni 1.2 Flash ?
Je m'appelle Rama, je mets en production des intégrations et des API chez eesel, donc je lis le lancement d'un modèle comme un ingénieur : quel est le contrat, et que me reste-t-il à construire ? Omni 1.2 vous donne un bon contrat pour la vidéo : un identifiant de modèle, un prix par seconde, des limites documentées. Vous construisez toujours l'application, l'étape de relecture et le branchement sur vos propres outils.
C'est la ligne que je vois entre l'infrastructure et un employé. Un modèle vidéo est de l'infrastructure ; eesel est l'employé. eesel est une plateforme de coéquipiers IA, et les clients embauchent des coéquipiers prêts à l'emploi pour un métier défini. L'équipe actuelle est un rédacteur de blog IA et un agent helpdesk IA, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise pour son rôle.
Une preuve nommée vaut mieux que des adjectifs ici. SE Ranking, l'éditeur de logiciels SEO, fait tourner un agent eesel séparé pour chacun de ses trois produits sur le chat et les tickets Zendesk. Sur un mois, du 8 août au 8 septembre 2026, ces agents ont traité 4 650 conversations, dont 2 100 chats en direct répondus d'abord par eesel. Aucun modèle vidéo ne fait ce métier, et aucun agent helpdesk ne rend une publicité. Choisissez l'outil pour le métier que vous avez réellement.
Une note pratique pour les développeurs : la eesel CLI permet à un agent de code comme Claude Code ou Codex de téléverser des connaissances approuvées, d'ajuster les instructions d'un coéquipier et de poser des questions de test pour vérifier les réponses avant toute mise en ligne. Connecter un helpdesk lui-même a toujours besoin de quelqu'un ayant un accès administrateur pour l'approuver.
Si vous construisez le côté contenu autour de la vidéo, le même raisonnement s'applique. Mes guides sur le rédacteur de blog IA, l'automatisation de blog IA et le pipeline de contenu de blog IA montrent comment déléguer ce métier. Pour des scripts qui alimentent un modèle vidéo, voir les générateurs de scripts vidéo IA et si l'IA peut écrire des scripts vidéo. Pour la gamme Google plus large, lisez alternatives à Gemini, Gemini 3.8 Flash, Nano Banana 2, Nano Banana Pro, Gemini Lyria 3 et Gemini contre ChatGPT. Pour l'idée du coéquipier IA, voir coéquipiers IA et employés IA.
Essayez eesel pour le travail qu'un modèle vidéo ne peut pas faire
Si votre équipe fait de la vidéo avec Omni, quelqu'un doit encore écrire les articles autour et répondre aux questions qu'elle génère. Le rédacteur de blog IA recherche et rédige du contenu à partir de vos propres connaissances, et l'agent helpdesk IA rejoint votre file de support existante et travaille à partir de vos tickets passés et de votre centre d'aide. Vous pouvez essayer eesel gratuitement et simuler un coéquipier sur de vraies données historiques avant sa mise en ligne.
Questions fréquentes
Qu'est-ce que Gemini Omni 1.2 Flash ?
Combien coûte Gemini Omni 1.2 Flash ?
Combien de temps peut durer une vidéo Gemini Omni 1.2 Flash ?
Quel est l'identifiant du modèle Gemini Omni 1.2 Flash ?
gemini-omni-1.2-flash. À partir du 3 décembre 2026, les requêtes vers gemini-omni-1.1-flash sont redirigées vers 1.2 et facturées aux tarifs de 1.2, selon le journal des modifications de l'API Gemini.
Comment Gemini Omni 1.2 Flash se compare-t-il à Sora 2 ?