

Le 21 juillet 2026, Google a lancé Gemini 3.5 Flash-Lite en même temps que 3.6 Flash et un modèle de sécurité. Flash-Lite est le modèle économique : $0.30 par million de tokens en entrée et $2.50 par million de tokens en sortie, soit environ 5 fois moins cher en entrée et 3 fois moins cher en sortie que 3.6 Flash. Il est rapide (proche du sommet du classement vitesse d'Artificial Analysis), conserve une fenêtre de contexte d'environ 1M de tokens, et est conçu pour les tâches à fort volume et faible raisonnement comme la recherche, le traitement de documents et la traduction.
Pour être honnête : Flash-Lite est le bon choix quand chaque tâche est simple et que vous l'exécutez des millions de fois, et le mauvais choix quand la tâche demande un vrai raisonnement en plusieurs étapes. Et si vous êtes ici parce que vous voulez construire de l'automatisation du support client dessus : le prix au token est la partie facile. Cela fait des années que je mets des agents IA sur de vraies files de support, et le modèle est la couche de base de la pile, pas l'ensemble. Plus de détails sur les deux points ci-dessous.
Ce qu'est vraiment Gemini 3.5 Flash-Lite
Google divise sa famille Gemini en deux voies. Les modèles Pro sont le niveau supérieur pour le raisonnement difficile. Les modèles Flash sont les chevaux de trait : moins chers, plus rapides, calibrés pour des applications de production qui font des milliers d'appels par jour. Flash-Lite est le plus léger de tous, positionné par Google pour les tâches agentiques à fort volume, la traduction et le traitement simple de données.
Les spécifications sont étonnamment généreuses pour un modèle économique. Il accepte le texte, l'image, la vidéo, l'audio et le PDF en entrée, dispose d'une fenêtre de contexte de 1 048 576 tokens (~1M de tokens, soit environ 1 500 pages), et prend en charge le raisonnement, l'appel de fonctions, les sorties structurées, l'exécution de code et l'ancrage par recherche. Il ne prend pas en charge l'utilisation d'ordinateur, la génération d'image ou d'audio, ni la Live API : c'est un moteur texte-vers-texte pour le volume, pas un modèle qui fait tout.
Sur Artificial Analysis, il obtient un Intelligence Index de 36 (#12 sur 152 modèles, bien au-dessus de la moyenne de sa catégorie) tout en tournant à environ 490 tokens de sortie par seconde, le deuxième modèle le plus rapide qu'ils aient mesuré. Pour un modèle aussi peu cher, cette combinaison intelligence-prix est tout l'argument de vente.
Tarifs de Gemini 3.5 Flash-Lite
Voici le tableau complet. Les prix sont par million de tokens sur les paliers payants, et la sortie inclut les tokens de raisonnement.
| Mode | Entrée (par million) | Sortie (raisonnement inclus) | Mise en cache du contexte |
|---|---|---|---|
| Standard | $0.30 | $2.50 | $0.03 |
| Batch (50 % de réduction) | $0.15 | $1.25 | $0.02 |
| Flex | $0.15 | $1.25 | $0.02 |
| Priority | $0.54 | $4.50 | $0.05 |
| Palier gratuit | Gratuit | Gratuit | Non disponible |
Quelques points à signaler avant de le mettre dans un tableur :
- Le palier gratuit entraîne le modèle sur vos données. Sur le palier gratuit, Google utilise votre contenu pour améliorer ses produits ; sur les paliers payants, non. Pour tout ce qui touche des données clients, cela suffit à exclure le palier gratuit.
- Le mode batch, c'est 50 % de réduction fixe. Si le travail n'a pas besoin d'être en temps réel (traitement de documents la nuit, traduction en masse), Batch fait tomber le prix à $0.15 / $1.25.
- L'ancrage par recherche est facturé séparément. Vous avez 5 000 prompts ancrés par mois gratuits sur l'ensemble de la famille Gemini 3, puis c'est $14 pour 1 000 requêtes de recherche, et une seule requête API peut déclencher plusieurs requêtes de recherche facturables.
Pour voir comment cela se positionne face aux forfaits Gemini grand public et au reste de l'API, notre guide des tarifs de Gemini offre le décryptage complet, et les tarifs de Gemini Workspace couvrent les forfaits entreprise.
Ce que ça coûte vraiment
Les prix affichés ne veulent pas dire grand-chose tant qu'on n'a pas calculé un chiffre réel. Disons que vous utilisez Flash-Lite pour le tri initial des tickets sur 50 000 tickets par mois, avec environ 1 000 tokens en entrée et 200 tokens en sortie par ticket.
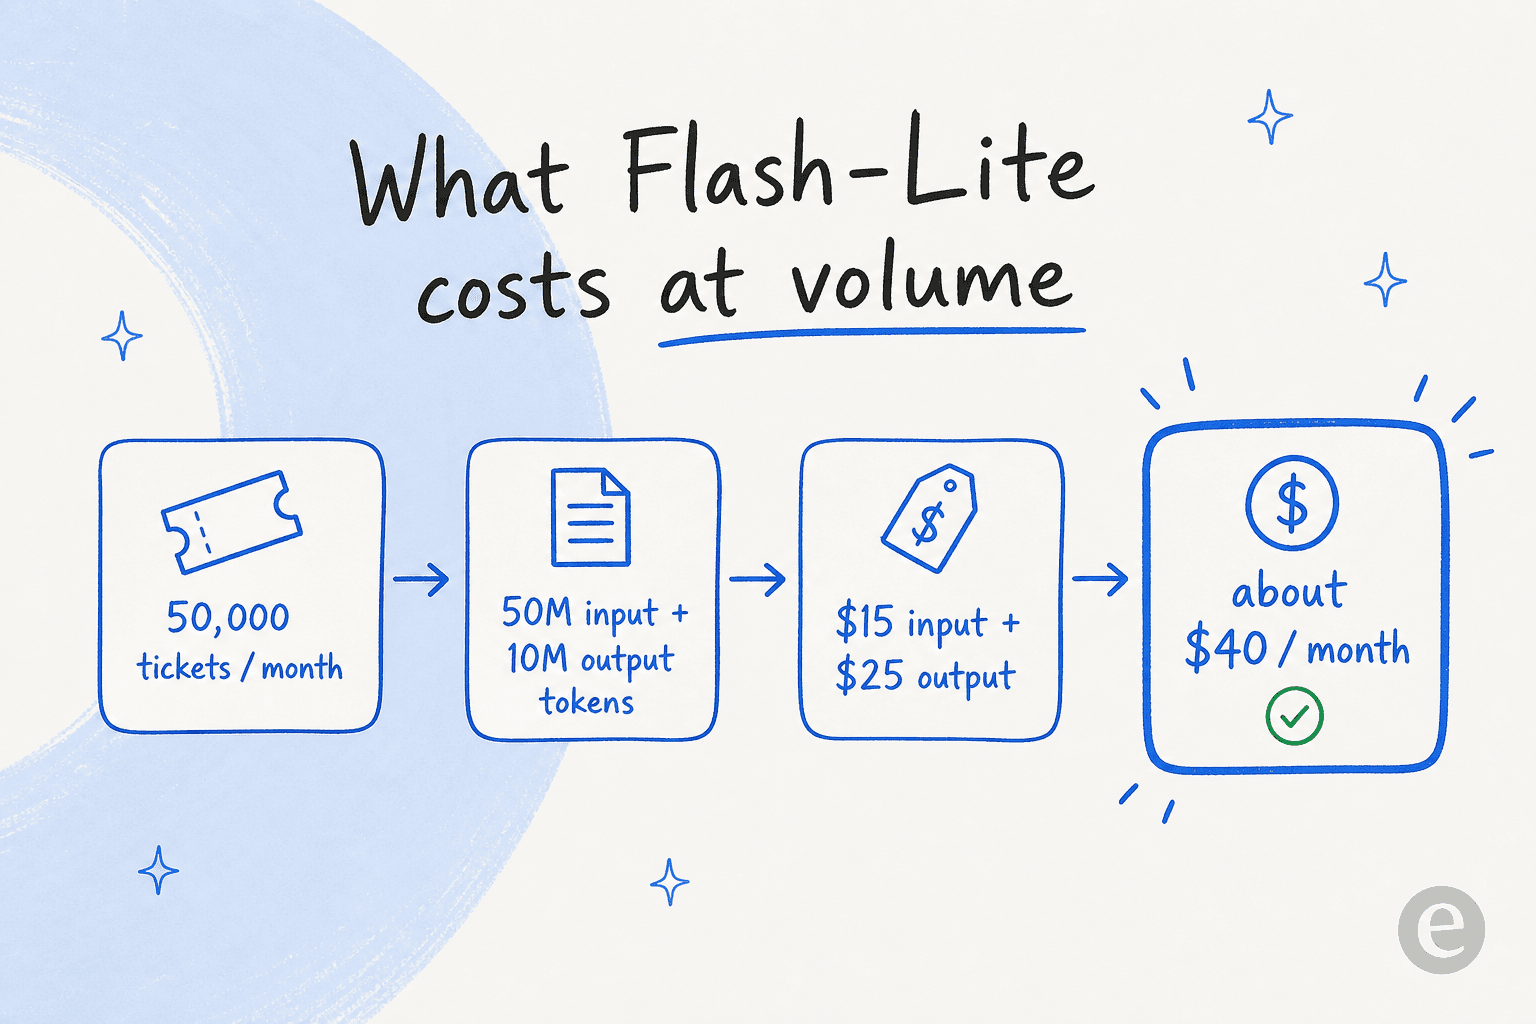
Cela représente 50M de tokens en entrée ($15) et 10M de tokens en sortie ($25), soit environ $40 par mois de coût de modèle brut. Faites tourner le même volume sur 3.6 Flash et vous vous rapprochez de $150. Cet écart, c'est exactement la raison d'être de Flash-Lite, et pourquoi choisir le bon palier de modèle compte plus que ce que la plupart des équipes réalisent quand elles budgètent leur IA de support ou tentent de réduire les coûts de support grâce à l'automatisation.
Comment Flash-Lite se compare
Google a publié un tableau comparatif, et la ligne des prix est ce qui compte le plus. À $0.30 / $2.50, Flash-Lite bat GPT-5.4 mini ($0.75 / $4.50) et Claude Haiku 4.5 ($1.00 / $5.00) tout en restant dans la même tranche de qualité globale sur la plupart des benchmarks agentiques.
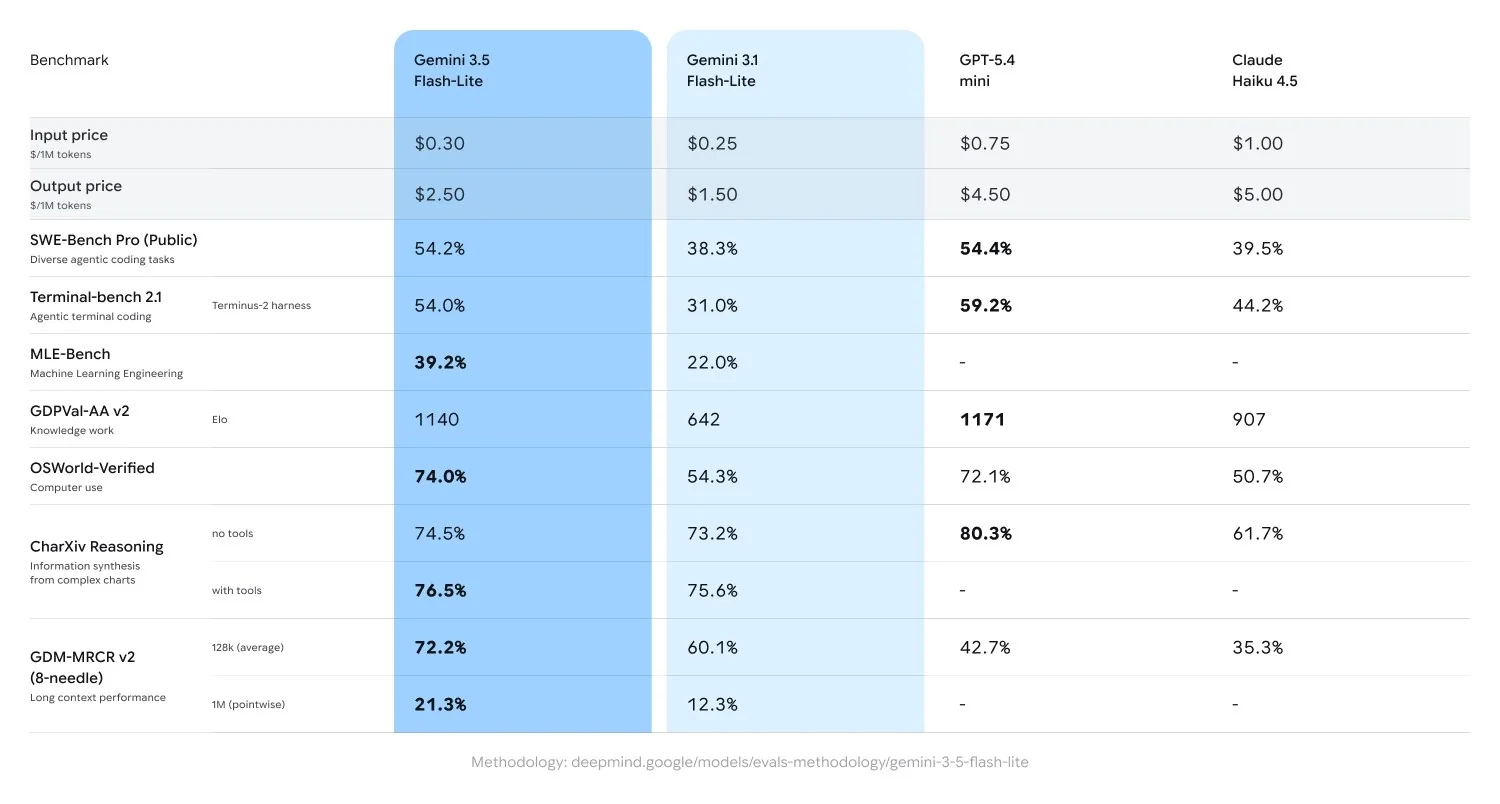
Lisez ce tableau avec une réserve : GPT-5.4 mini devance légèrement sur quelques scores de code et de connaissances. Mais sur le rapport prix-capacité pour le travail à fort volume, Flash-Lite est difficile à battre, et il l'emporte franchement sur le rappel de contexte long. Le seul chiffre qui ne joue pas en sa faveur, c'est la latence : le temps jusqu'au premier token tourne autour de 6 secondes (temps de raisonnement inclus), plutôt élevé pour sa catégorie, donc il convient mieux aux tâches en arrière-plan qu'à un chat en direct réactif.
Face à son propre prédécesseur, le saut générationnel est net :
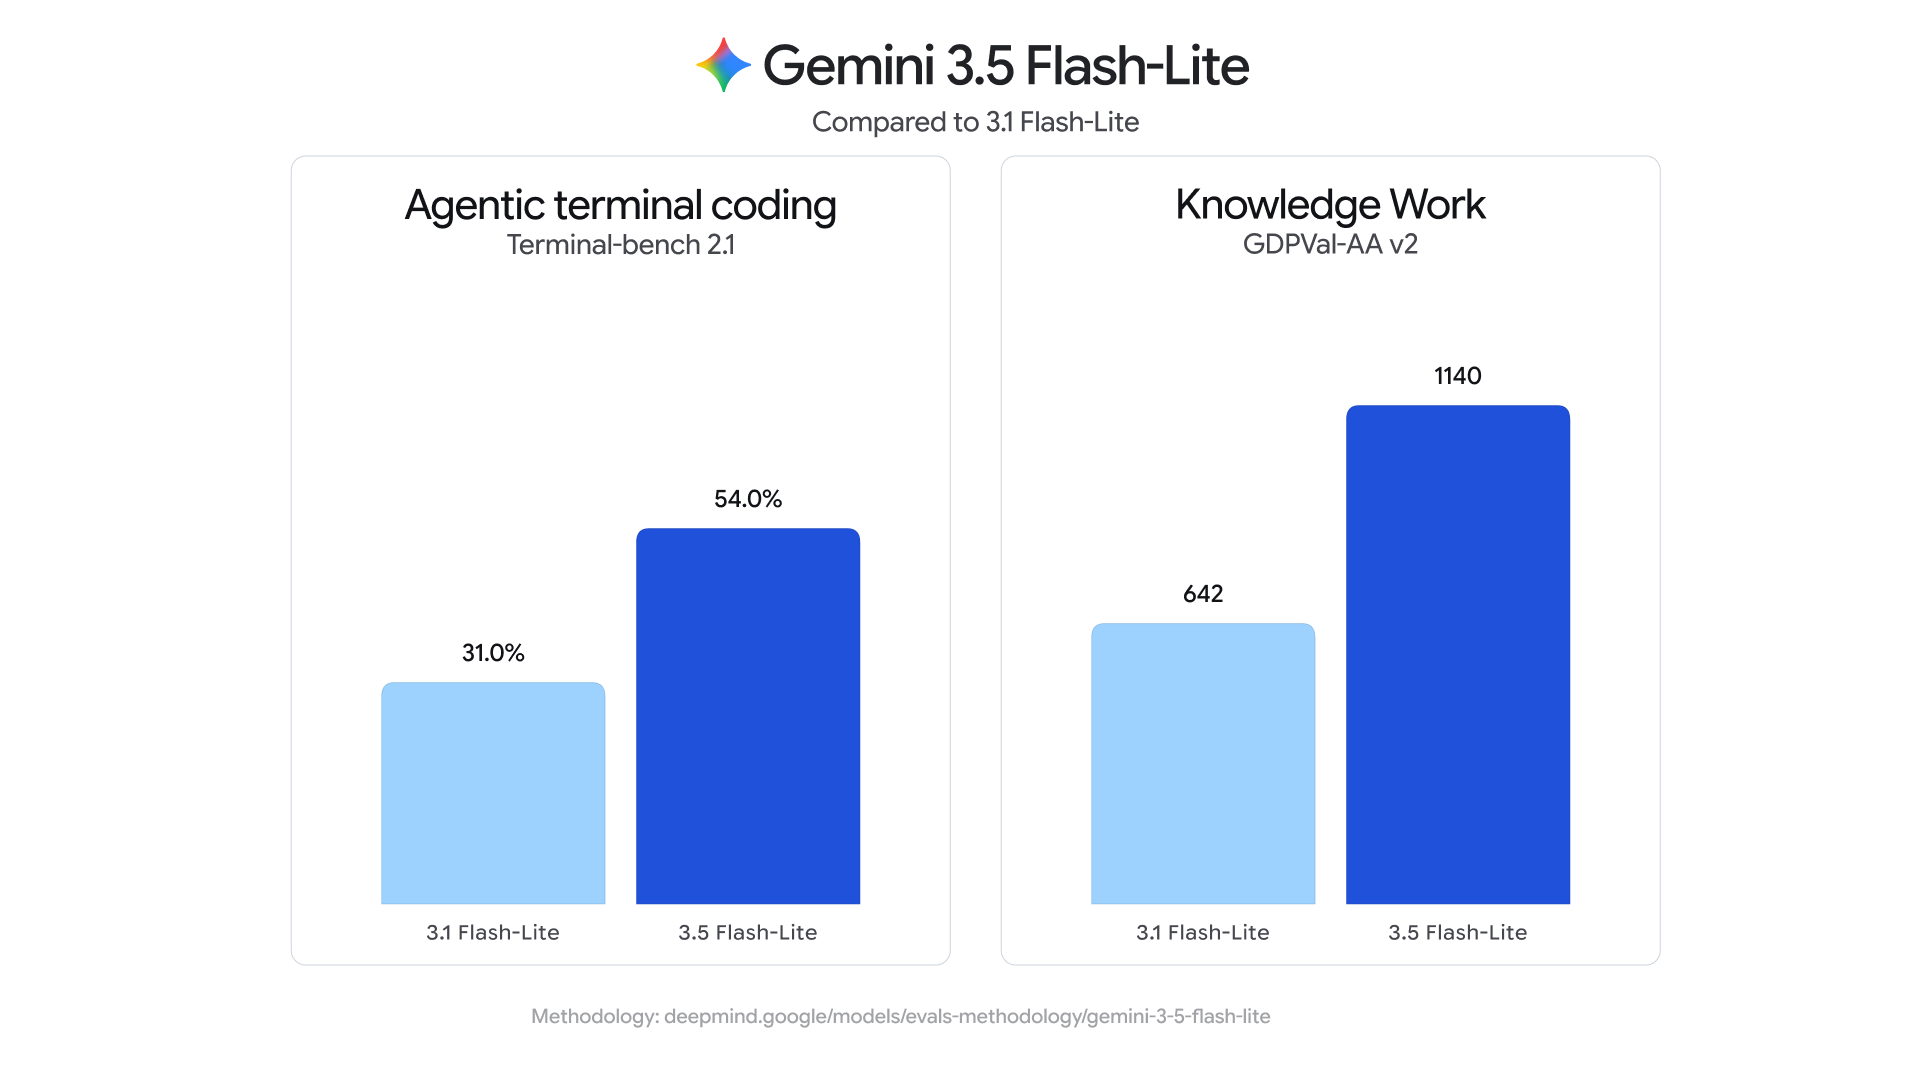
Le codage agentique en terminal passe de 31 % à 54 % sur Terminal-Bench 2.1, et le travail de connaissance fait presque le doublé, de 642 à 1140 sur GDPval-AA v2. Google affirme même qu'il surpasse l'ancien 3 Flash sur SWE-Bench Pro et les tâches d'utilisation d'ordinateur, donc vous ne sacrifiez pas grand-chose en qualité pour ce prix bas. Si vous mettez Gemini en balance avec le reste du marché, nous avons détaillé cela dans Gemini vs Claude, Gemini vs ChatGPT et le tour d'horizon plus large des alternatives à Gemini.
Quel modèle choisir réellement ?
Flash-Lite est sorti en même temps que Gemini 3.6 Flash, et se tromper de modèle soit gaspille de l'argent, soit met en production un bot dépassé. La règle générale est simple.
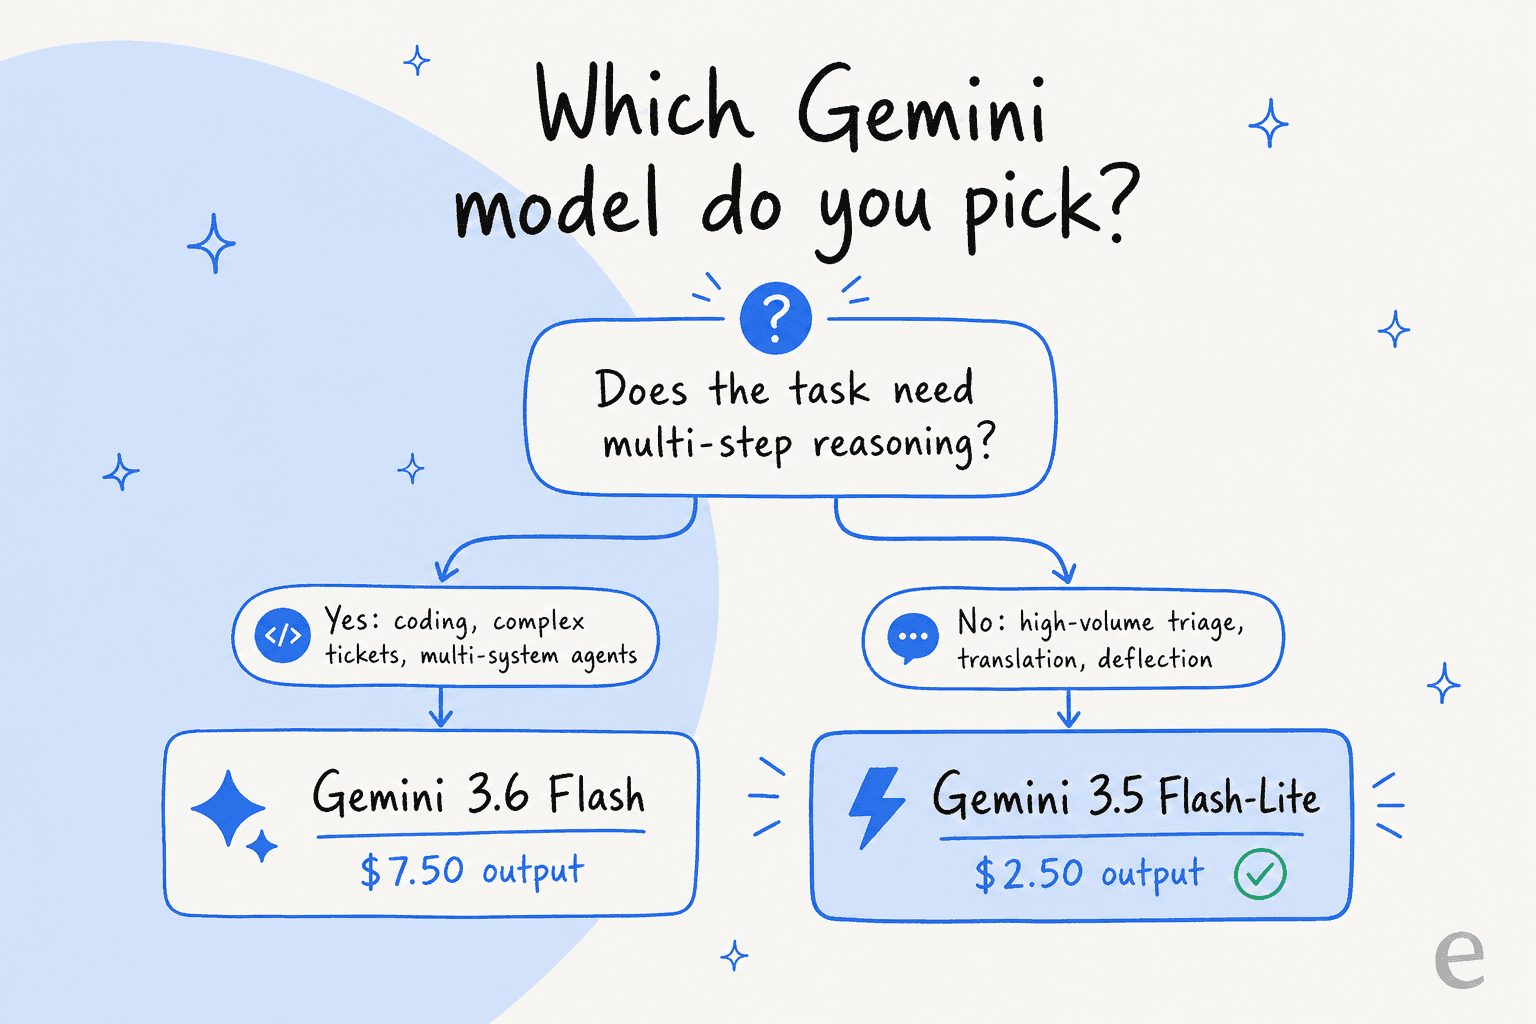
Tournez-vous vers 3.6 Flash quand le travail demande un vrai raisonnement : agents en plusieurs étapes, code, tickets de support complexes qui touchent plusieurs systèmes. Tournez-vous vers Flash-Lite quand vous traitez un volume dont chaque élément est simple, comme le premier tri, la déviation en chat en direct des questions courantes, ou les réponses multilingues en masse. Construire un vrai agent IA ou un bot scripté est une décision distincte de celle du modèle, et elle compte généralement davantage. Si vous gérez un produit SaaS, notre analyse de la meilleure IA pour le support SaaS détaille où chaque modèle trouve sa place.
Ce que cela signifie si vous construisez de l'IA pour le support
Voici le moment d'être direct avec vous, parce que c'est le passage que tous les articles sur les prix des modèles sautent pour les équipes de support.
Un modèle moins cher et plus rapide, c'est une bonne nouvelle. Mais passer à Flash-Lite ne vous donne pas un agent de support qui fonctionne, pas plus qu'un moteur moins cher ne fait une voiture. Cela fait plus de trois ans que je mets de l'IA sur de vraies files de support, et l'échec que j'ai observé encore et encore n'est pas que le modèle soit bête, c'est un bot qui sonne sûr de lui en donnant une mauvaise réponse à un vrai client parce que personne n'a construit les couches autour du modèle. Le modèle est la couche de base de la pile.
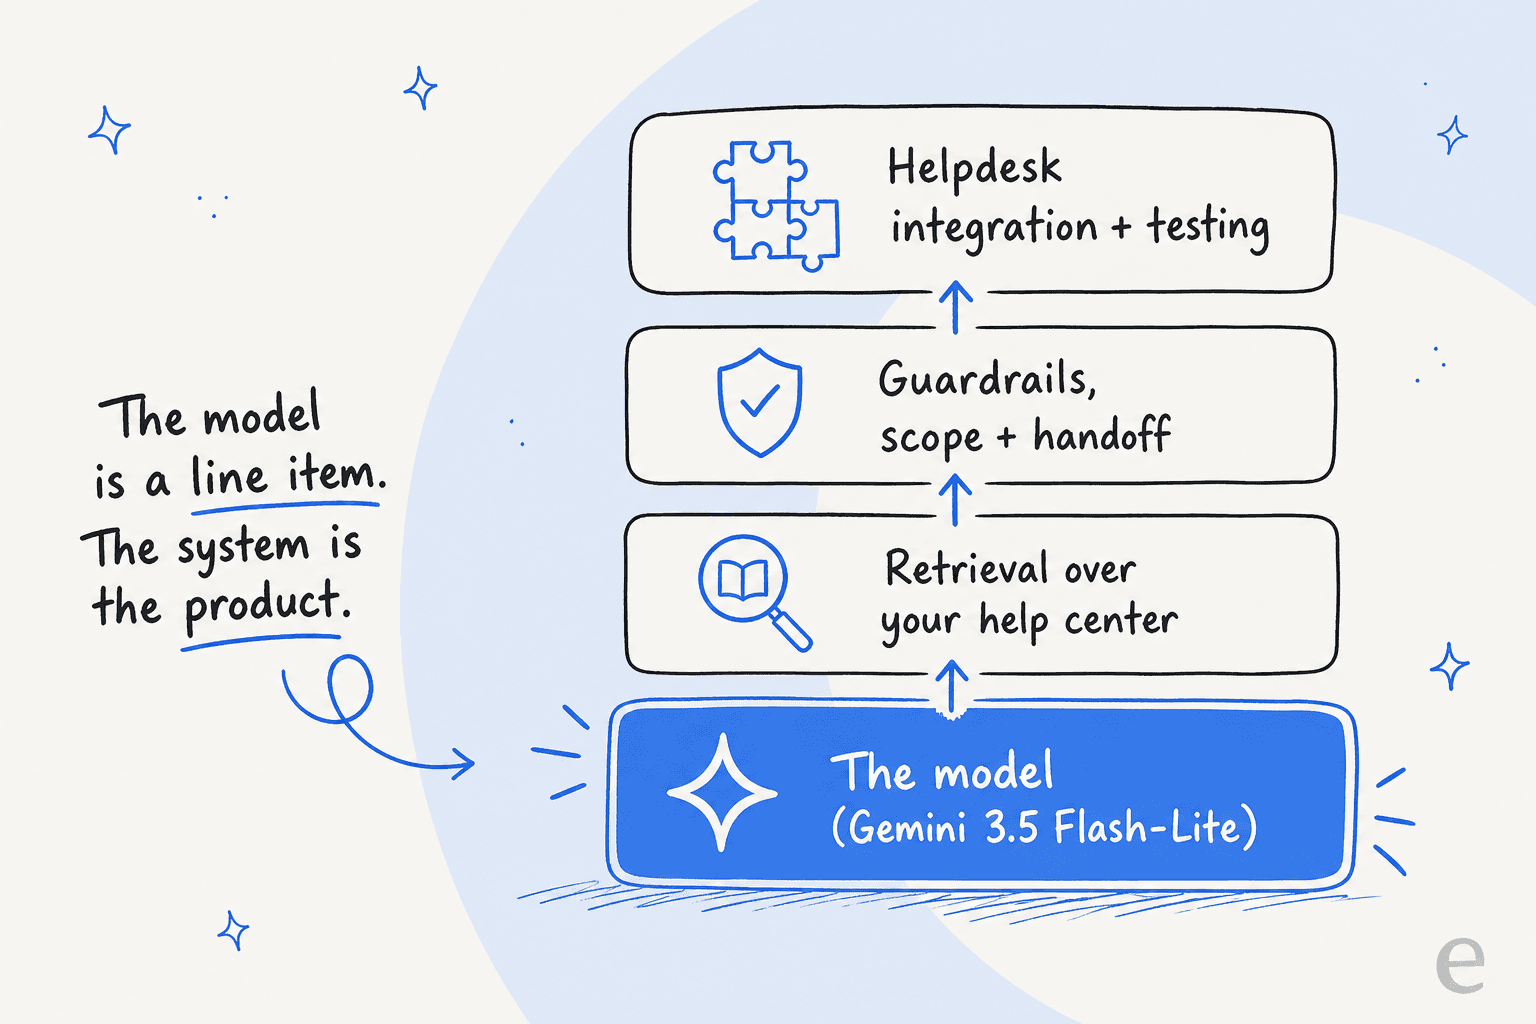
Ces couches, c'est le vrai travail. La recherche documentaire, pour que le modèle réponde à partir de votre centre d'aide et des tickets passés au lieu de deviner. Les garde-fous et le périmètre, pour qu'il transfère proprement au lieu d'inventer une politique de remboursement. L'intégration, pour qu'il puisse agir au sein de votre système de tickets. Et les tests, pour que vous sachiez comment il se comporte avant qu'il touche un client. C'est exactement l'écart entre une API brute et un vrai logiciel de service client IA, et c'est pourquoi les problèmes de chatbot IA remontent presque toujours à la plomberie, pas au modèle.
C'est aussi pourquoi je déconseillerais de connecter vous-même l'API Gemini brute à votre helpdesk. Vous reconstruiriez la recherche documentaire, les garde-fous anti-hallucination, la simulation et chaque intégration helpdesk depuis zéro, puis vous devriez les maintenir à mesure que les modèles changent toutes les quelques semaines. Que Flash-Lite soit bon marché ne change rien à ce calcul. C'est tout l'argument en faveur d'une IA helpdesk conçue pour ça plutôt qu'une pile maison : le palier de modèle est une simple ligne budgétaire, le système qui l'entoure est le produit. Et quand vous entraînez correctement l'agent, le modèle en dessous compte à peine pour le résultat.
Essayer eesel
C'est exactement la couche qu'eesel est conçu pour être. Vous le branchez sur votre helpdesk existant, il apprend de vos tickets passés et de votre base de connaissances dès le départ, et il fonctionne au-dessus de modèles de pointe, donc vous obtenez l'efficacité sans connecter l'API vous-même.

L'élément différenciant qu'un modèle bon marché ne peut pas vous offrir seul : eesel vous permet de simuler l'agent sur vos tickets historiques avant qu'il ne réponde jamais à un client en direct, donc vous voyez le taux de résolution et les réponses exactes qu'il aurait envoyées, et vous pouvez le rattacher à un vrai ROI du support IA. Et comme c'est facturé selon le travail effectué, pas au token, vous évitez le calcul de tokens à chaque ticket. Si vous évaluez Flash-Lite pour construire de l'automatisation du support, partez du résultat que vous voulez et laissez la plateforme gérer la plomberie. C'est gratuit à essayer.