

Gemini 3.6 Flash coûte $1.50 par 1M de tokens en entrée et $7.50 par 1M de tokens en sortie sur le palier payant standard, où la sortie inclut les tokens de réflexion. Le mode Batch divise les deux par deux, à $0.75/$3.75, et il existe un palier gratuit avec un piège : Google utilise votre contenu pour améliorer ses produits.
Le chiffre qui compte par rapport au modèle précédent se trouve du côté de la sortie. L'entrée reste stable, mais la sortie passe de $9.00 à $7.50, et comme 3.6 Flash utilise aussi environ 17% de tokens de sortie en moins par tâche, le même travail agentique coûte moins cher deux fois de suite. C'est tout l'objectif de conception de la gamme Flash : le maximum de capacité par dollar pour le travail que vous exécutez en volume.
Une mise en garde honnête avant de construire là-dessus. Si vous chiffrez ceci pour faire fonctionner du support client, le $1.50/$7.50 est une ligne de la facture, pas la facture elle-même. J'ai passé ces trois dernières années et plus à déployer des agents IA sur des files de support en production, et le prix du token n'est presque jamais l'endroit où l'argent part réellement. Plus de détails ci-dessous, avec une calculatrice pour saisir vos propres chiffres.
Les tarifs de Gemini 3.6 Flash en un coup d'œil
Voici la grille tarifaire complète du palier standard, directement issue de la page de tarifs de Google. Le mode de consommation choisi change le tarif plus que tout autre facteur.
| Mode de consommation | Entrée (par 1M) | Sortie (incl. réflexion) | Mise en cache du contexte |
|---|---|---|---|
| Standard | $1.50 | $7.50 | $0.15 |
| Batch (50% de remise) | $0.75 | $3.75 | $0.075 |
| Flex | $0.75 | $3.75 | $0.075 |
| Priority | $2.70 | $13.50 | $0.27 |
| Palier gratuit | Gratuit | Gratuit | Gratuit |
En résumé : Standard est le mode par défaut, Batch et Flex partagent le même tarif avec 50% de remise pour le travail qui n'a pas besoin d'être en temps réel, et Priority coûte 1.8 fois plus pour une latence garantie basse. La mise en cache du contexte à $0.15 par 1M est le levier que la plupart des équipes sous-utilisent, elle évite de repayer l'entrée pour le même prompt système ou le même fragment de connaissance à chaque appel. C'est le nouveau cheval de bataille de la famille Gemini, et il prend la place où vous auriez auparavant utilisé 3.5 Flash.
Calculez ce que ça va réellement vous coûter
Les tarifs affichés ne prennent tout leur sens qu'une fois multipliés par votre trafic réel. Renseignez votre volume mensuel et le nombre moyen de tokens pour voir le coût mensuel sur les paliers standard et batch, ainsi que le coût par requête.
La leçon que la plupart des équipes retiennent ici : à tout volume réel, les tokens de sortie dominent la facture, ce qui explique pourquoi la baisse de $9.00 à $7.50 sur la sortie est le changement principal, et pourquoi un modèle qui termine avec moins de tokens vaut plus qu'un modèle un peu moins cher de quelques centimes par million.
Ce qui a changé depuis Gemini 3.5 Flash
Le passage d'une génération à l'autre est un pur gain de coût, précisément là où ça fait mal. Voici comment les deux modèles se comparent sur le palier standard, à côté de l'option économique.
| Modèle | Entrée (par 1M) | Sortie (par 1M) | Positionnement |
|---|---|---|---|
| Gemini 3.6 Flash | $1.50 | $7.50 | Le Flash le plus intelligent, conçu pour la vitesse |
| Gemini 3.5 Flash | $1.50 | $9.00 | Ancien Flash phare |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Modèle GA le moins cher, pour le travail à fort volume |
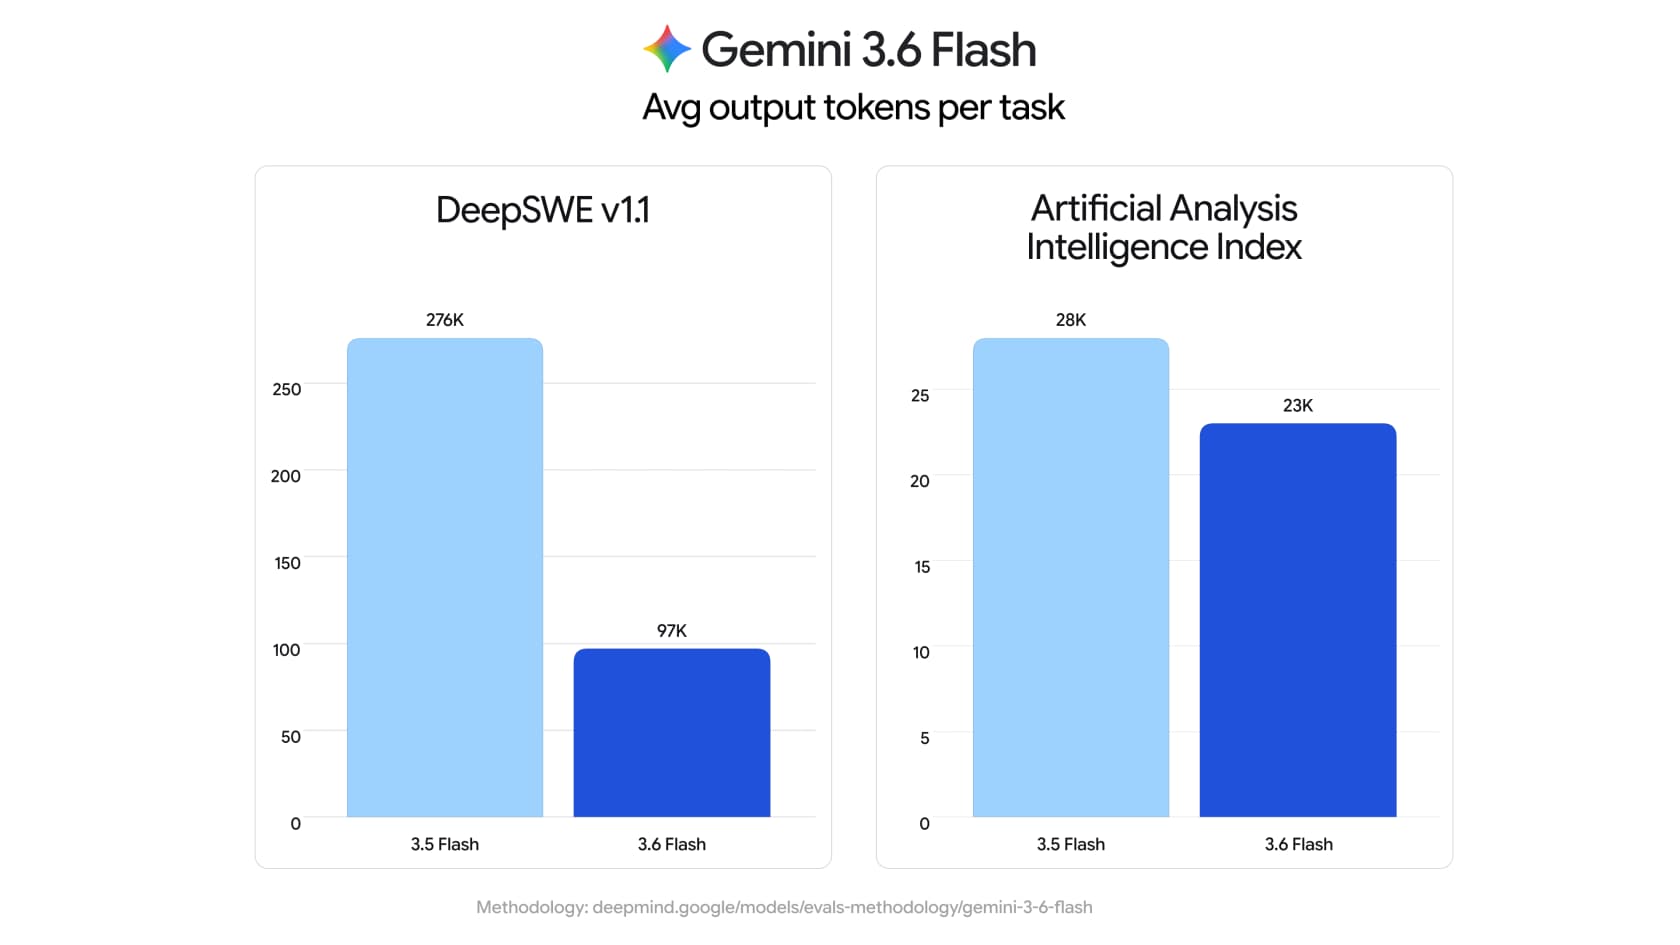
Il y a en réalité deux économies qui s'additionnent. La première est le tarif de sortie ~17% plus bas. La seconde est l'efficacité des tokens : selon l'Artificial Analysis Index, 3.6 Flash utilise 17% moins de tokens de sortie pour effectuer le même travail, et sur des benchmarks agentiques comme DeepSWE l'écart a atteint 65% (la sortie moyenne est passée de 276K à 97K tokens par tâche). Moins de tokens à un tarif plus bas se cumulent, donc l'économie réelle sur une charge de travail concrète est plus importante que ne le suggère la simple baisse de prix. Le palier Batch raconte la même histoire : le batch de 3.6 Flash est à $0.75/$3.75 contre $0.75/$4.50 pour 3.5 Flash.
Entre fournisseurs, ce tarif de sortie de $7.50 se situe largement en dessous de Claude Sonnet 5 (environ $15 en sortie au tarif catalogue), tout en se plaçant dans une gamme de qualité similaire pour la plupart des tâches agentiques. Si c'est le niveau phare que vous recherchez vraiment, les alternatives à Gemini de Google elle-même valent le coup d'œil tant que 3.5 Pro reste en retard.
Les coûts cachés que la grille tarifaire ne montre pas
C'est là qu'une facture réelle s'écarte du $1.50/$7.50 affiché. Quatre postes prennent régulièrement les équipes au dépourvu.
- Les tokens de réflexion sont facturés comme de la sortie. 3.6 Flash prend en charge la réflexion, et ces tokens de raisonnement comptent dans le tarif de sortie de $7.50. Les gains d'efficacité des tokens aident ici, mais un prompt à fort raisonnement facture toujours plus que ne le suggère la longueur visible de la réponse.
- Le grounding de recherche est facturé séparément. Vous disposez de 5 000 prompts avec grounding gratuits par mois sur toute la famille Gemini 3, puis c'est $14 pour 1 000 requêtes de recherche, et une seule demande client peut déclencher plusieurs requêtes facturables.
- Le palier gratuit entraîne les modèles avec vos données. Sur le palier gratuit, Google utilise votre contenu pour améliorer ses produits. Sur n'importe quel palier payant, il ne le fait pas. Pour tout ce qui touche aux données clients, cela suffit à écarter le palier gratuit.
- Le mode Priority applique un supplément de 1.8 fois. Si vous avez besoin d'une latence garantie basse, Priority coûte $2.70/$13.50, presque le double du tarif standard. La plupart des équipes n'en ont pas besoin, mais il est facile de l'activer et de l'oublier.
Gemini 3.6 Flash contre 3.5 Flash-Lite : quand le modèle le moins cher gagne
La façon la plus efficace de réduire une facture Gemini n'est souvent pas d'utiliser 3.6 Flash du tout, mais d'orienter le travail simple vers Gemini 3.5 Flash-Lite. À $0.30/$2.50, Flash-Lite est environ 5 fois moins cher en entrée et 3 fois moins cher en sortie, et il tourne à environ 350 tokens de sortie par seconde.
La règle générale concerne la profondeur du raisonnement, pas la fidélité à une marque. Optez pour 3.6 Flash quand le travail nécessite un vrai raisonnement en plusieurs étapes : programmation, agents qui touchent plusieurs systèmes, tickets de support complexes. Optez pour Flash-Lite quand chaque élément est simple et le volume élevé, comme le triage de tickets en première passe ou la déviation du chat en direct pour les questions courantes. De nombreuses architectures en production font tourner les deux, en orientant selon la difficulté, ce qui est la configuration la moins chère de toutes. Construire un vrai agent ou un bot basé sur des règles est une décision distincte de celle du modèle.
Paliers de compte, plafonds de dépenses et limites de débit
Le tarif de Gemini dépend aussi du palier d'utilisation dans lequel se trouve votre compte de facturation, selon la page des limites de débit.
| Palier d'utilisation | Conditions | Plafond de facturation |
|---|---|---|
| Gratuit | Projet actif ou essai gratuit | N/A |
| Tier 1 | Compte de facturation actif lié | $250 |
| Tier 2 | $100 payés + 3 jours | $2,000 |
| Tier 3 | $1,000 payés + 30 jours | $20,000+ |
Deux remarques pratiques. D'abord, les limites de débit basées sur les dépenses fonctionnent sur une fenêtre glissante de 10 minutes (Tier 1 plafonne à $10, Tier 2 et 3 à $200), et un dépassement renvoie une erreur 429 RESOURCE_EXHAUSTED, donc un pic de trafic peut vous limiter avant même d'atteindre votre budget mensuel. Ensuite, si vous opérez à grande échelle, le palier Enterprise de Google ajoute un débit provisionné et des remises de volume qui n'apparaissent pas dans la grille publique. Pour voir comment cela se situe par rapport aux offres Gemini grand public, notre guide des tarifs de Gemini et les tarifs de Gemini Workspace couvrent le reste.
Ce que coûte réellement l'exploitation d'un agent de support
Voici la partie que tous les articles sur les tarifs de modèles évitent, et la raison pour laquelle je vous dirais de ne pas trop vous fier au tarif du token si votre objectif est le support client.
Un modèle moins cher et plus rapide est une bonne nouvelle. Mais $1.50/$7.50 correspond au coût du moteur brut, pas de la voiture entière. J'ai passé ces trois dernières années et plus à déployer de l'IA sur des files de support en production, et l'échec que j'ai observé encore et encore n'est pas que le modèle soit trop cher, c'est un bot au ton confiant qui donne une mauvaise réponse parce que personne n'a construit ni payé les couches qui entourent le modèle. Ces couches sont le vrai coût.

La récupération d'information sur votre centre d'aide, pour qu'il réponde à partir de vos documents plutôt que de deviner. Les garde-fous contre les hallucinations, pour qu'il transfère proprement plutôt que d'inventer une politique de remboursement. L'intégration, pour qu'il puisse agir dans votre système de tickets. Et les tests, pour que vous sachiez comment il se comporte avant qu'il touche un client. Construisez cela vous-même sur l'API brute et vous ne payez pas $7.50 par 1M de tokens, vous payez une équipe d'ingénierie pour reconstruire la récupération, la simulation et chaque intégration au helpdesk à partir de zéro, puis la maintenir à mesure que les modèles changent toutes les quelques semaines. C'est l'argument en faveur d'une IA de helpdesk conçue pour cela plutôt qu'une pile faite maison, et c'est pourquoi les problèmes des chatbots IA remontent presque toujours à la plomberie, pas au niveau du modèle.
Essayez eesel
C'est exactement la couche qu'eesel est conçu pour être. Vous le branchez sur votre helpdesk existant, il apprend dès le départ de vos tickets passés et de votre base de connaissances, et il fonctionne au-dessus de modèles de pointe comme Gemini, donc vous obtenez l'efficacité sans câbler l'API ni faire de calculs de tokens vous-même.
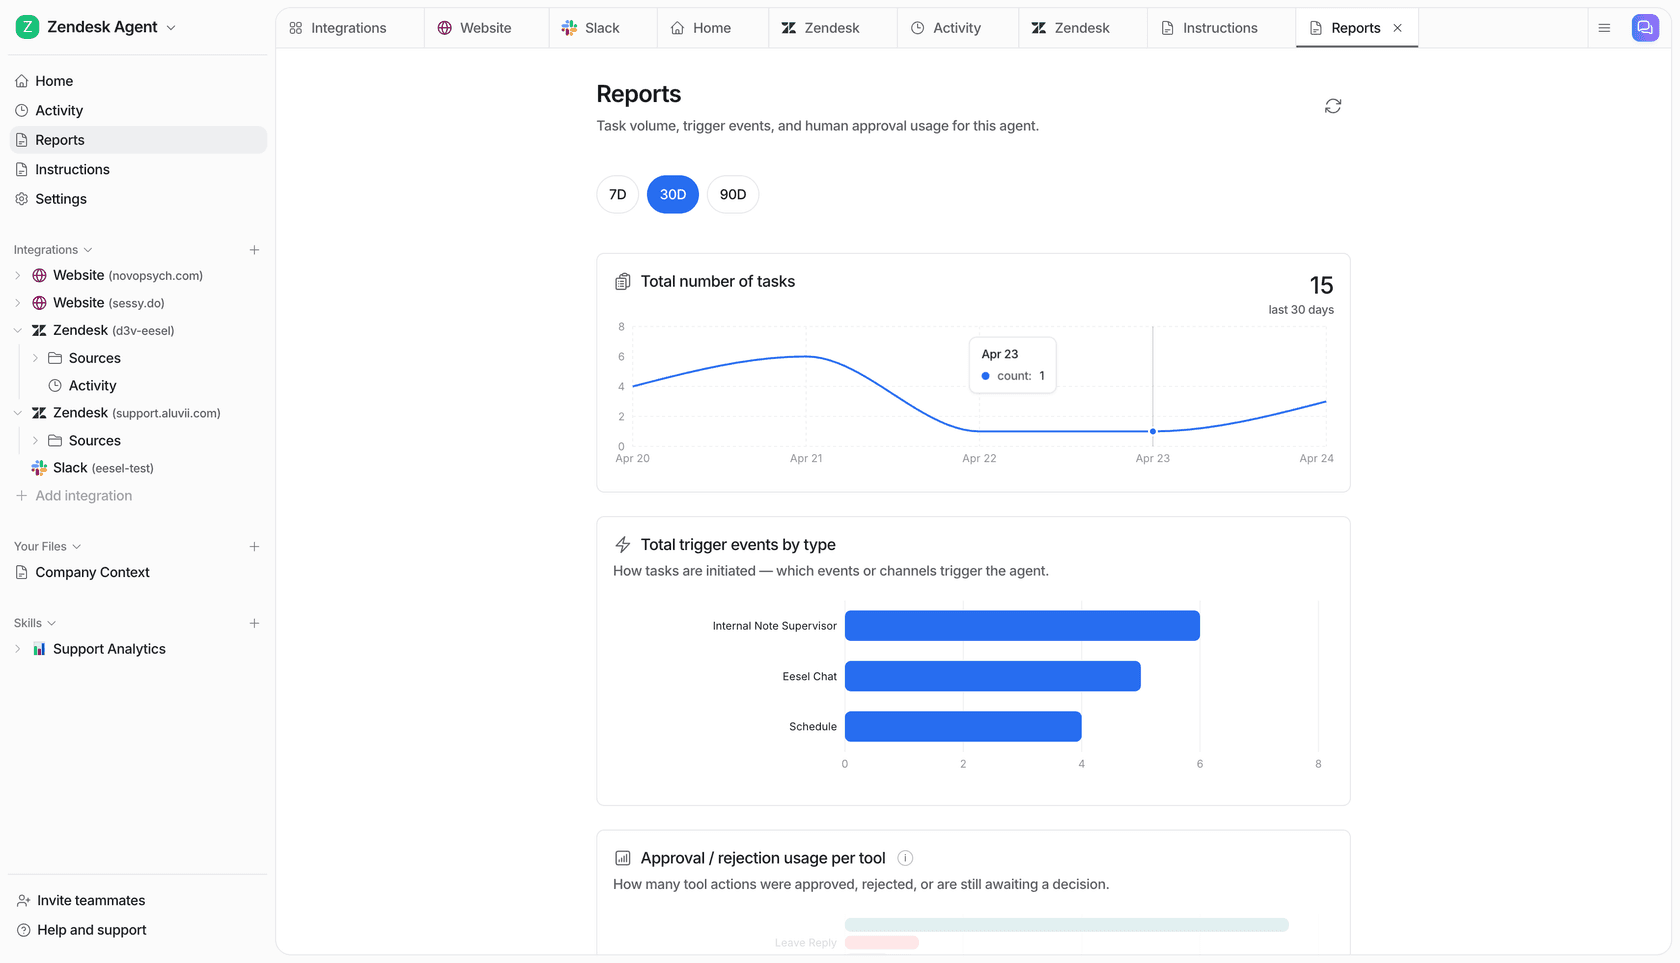
Les deux choses qui comptent le plus pour le tarif sont justement celles que le tarif du token ne peut pas vous donner. D'abord, eesel vous permet de simuler l'agent sur vos tickets historiques avant qu'il ne réponde à un client réel, donc vous voyez le taux de résolution et les réponses exactes qu'il aurait envoyées, sans avoir à deviner ce que la dépense achète. Ensuite, il est tarifé sur le travail effectué, par résolution plutôt que par token, donc un mois chargé ne se transforme pas en facture API surprise. Si vous chiffrez des modèles pour construire de l'automatisation du support, commencez par le résultat que vous voulez et laissez la plateforme gérer la plomberie. C'est gratuit à essayer.
Comment le tarif de Gemini 3.6 Flash se compare-t-il à celui de 3.5 Flash ?