

Pourquoi regarder au-delà de Gemini 3.8 Live Avatar
Soyons d'abord justes envers Google, car le produit le mérite. Gemini 3.8 Live Avatar observe votre caméra et votre écran pendant qu'il écoute, déclenche des appels d'outils asynchrones en arrière-plan pour, par exemple, vous enregistrer dans un hôtel en pleine conversation, et détecte et change de langue sans que le visage ne décroche. C'est l'une des démos d'agent en direct les plus complètes qu'un laboratoire ait livrées.
Le hic, c'est l'accès et l'enfermement. Il est devenu généralement disponible au sein de Gemini Enterprise, c'est donc un engagement Google Cloud, pas une clé d'API pour le week-end. Les avatars personnalisés créés à partir de vos propres images de référence sont verrouillés derrière une liste d'autorisation et une étape de vérification, donc vous ne pouvez pas simplement monter un visage de marque dès le premier jour. Et une fois que vous construisez dessus, votre agent en direct vit entièrement dans l'écosystème de Google.
Il y a aussi un coût à connaître avant de comparer. Sur la Live API, le compteur vidéo de l'avatar revient à environ $0.37 par minute de parole de l'avatar (facturé seulement pendant qu'il parle, pas pendant qu'il attend). Ce n'est pas exorbitant, mais c'est de l'argent réel à volume de support, et cela change la comparaison : vous ne choisissez pas un bonus gratuit, vous choisissez un produit facturé à la minute. Les alternatives méritent donc un vrai examen.
Comment penser les alternatives
Les sept outils ici ne forment pas vraiment une seule catégorie. Ils se répartissent en trois, et savoir dans quelle voie vous êtes évite beaucoup d'essais inutiles. Pour un panorama plus large au-delà des avatars, notre tour d'horizon des meilleurs outils d'IA pour le service client couvre aussi les options centrées sur le texte.
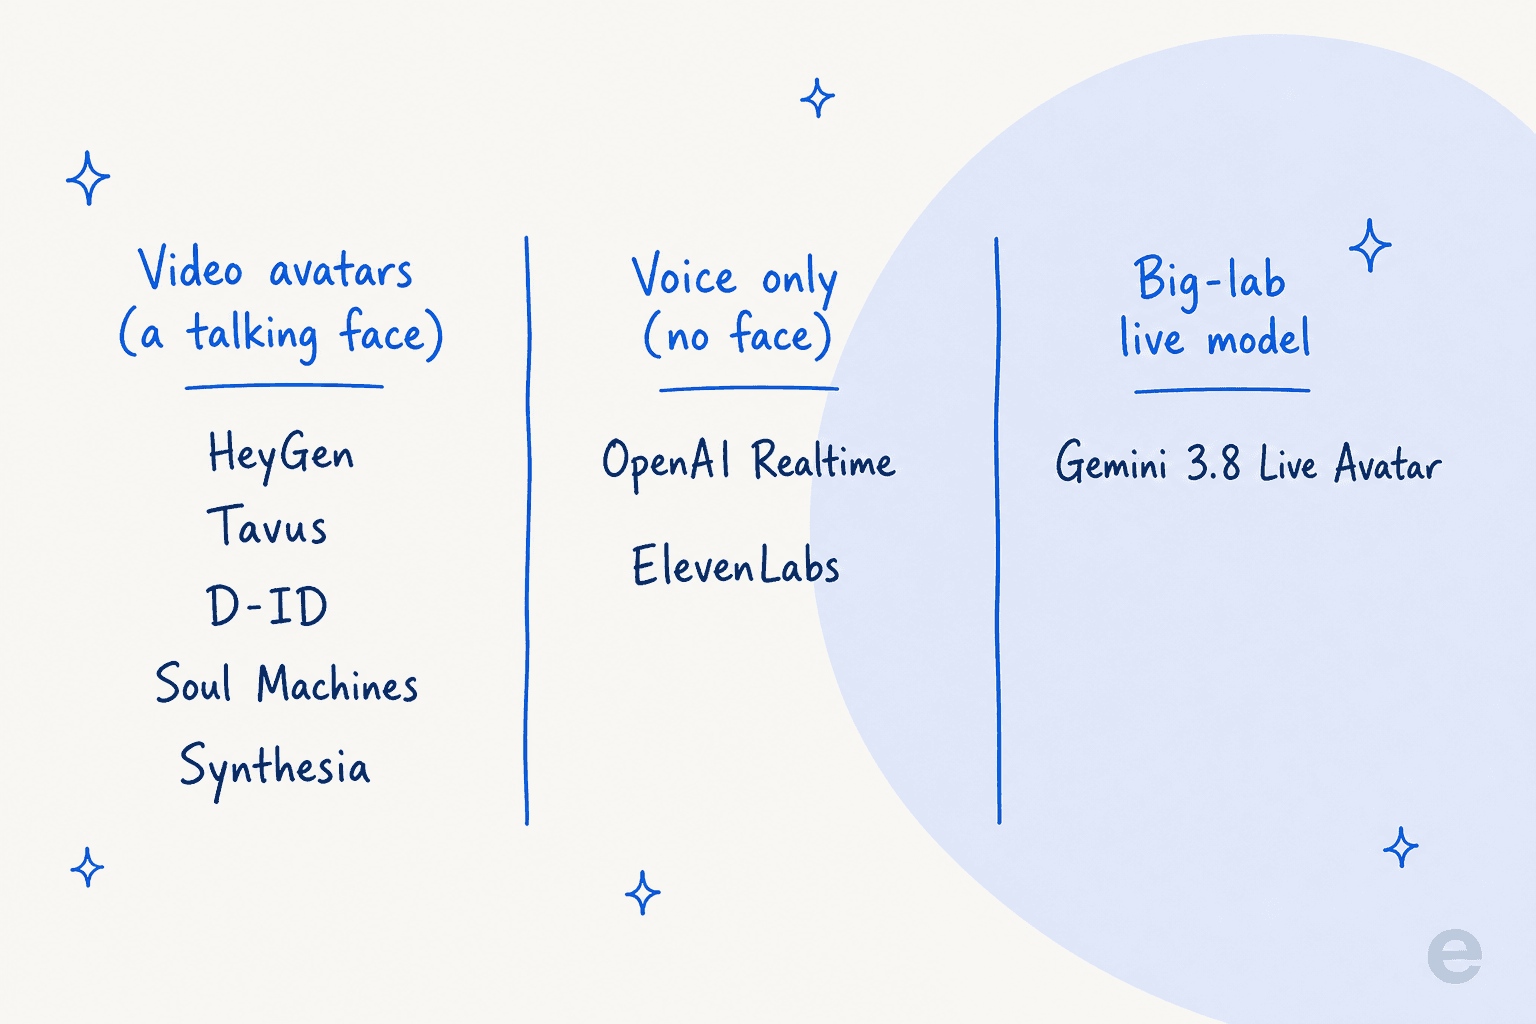
- Avatars vidéo (un visage parlant) : HeyGen, Tavus, D-ID, Soul Machines et Synthesia. Ils affichent un humain animé qui synchronise ses lèvres avec ses réponses. C'est le plus proche de ce que fait Gemini 3.8 Live Avatar.
- Voix seule (sans visage) : l'OpenAI Realtime API et ElevenLabs. La même conversation en temps réel, sans visage affiché. Moins cher, plus simple, et souvent tout ce dont un cas de support ou de vente a réellement besoin. Si vous pesez l'ensemble du paysage, notre guide sur les avantages de l'IA conversationnelle est une bonne introduction.
- Modèle en direct d'un grand laboratoire : Gemini 3.8 Live Avatar lui-même, aux côtés d'outils comme l'OpenAI Realtime API, où le modèle et le pipeline média viennent d'un seul laboratoire de pointe.
Voici la partie que la plupart des comparatifs sautent. Chaque outil des trois voies rivalise sur la même couche supérieure : le visage, la voix, l'alternance des tours de parole, la latence. Rien de tout cela ne touche la couche du dessous, là où une conversation de support réussit ou échoue vraiment.
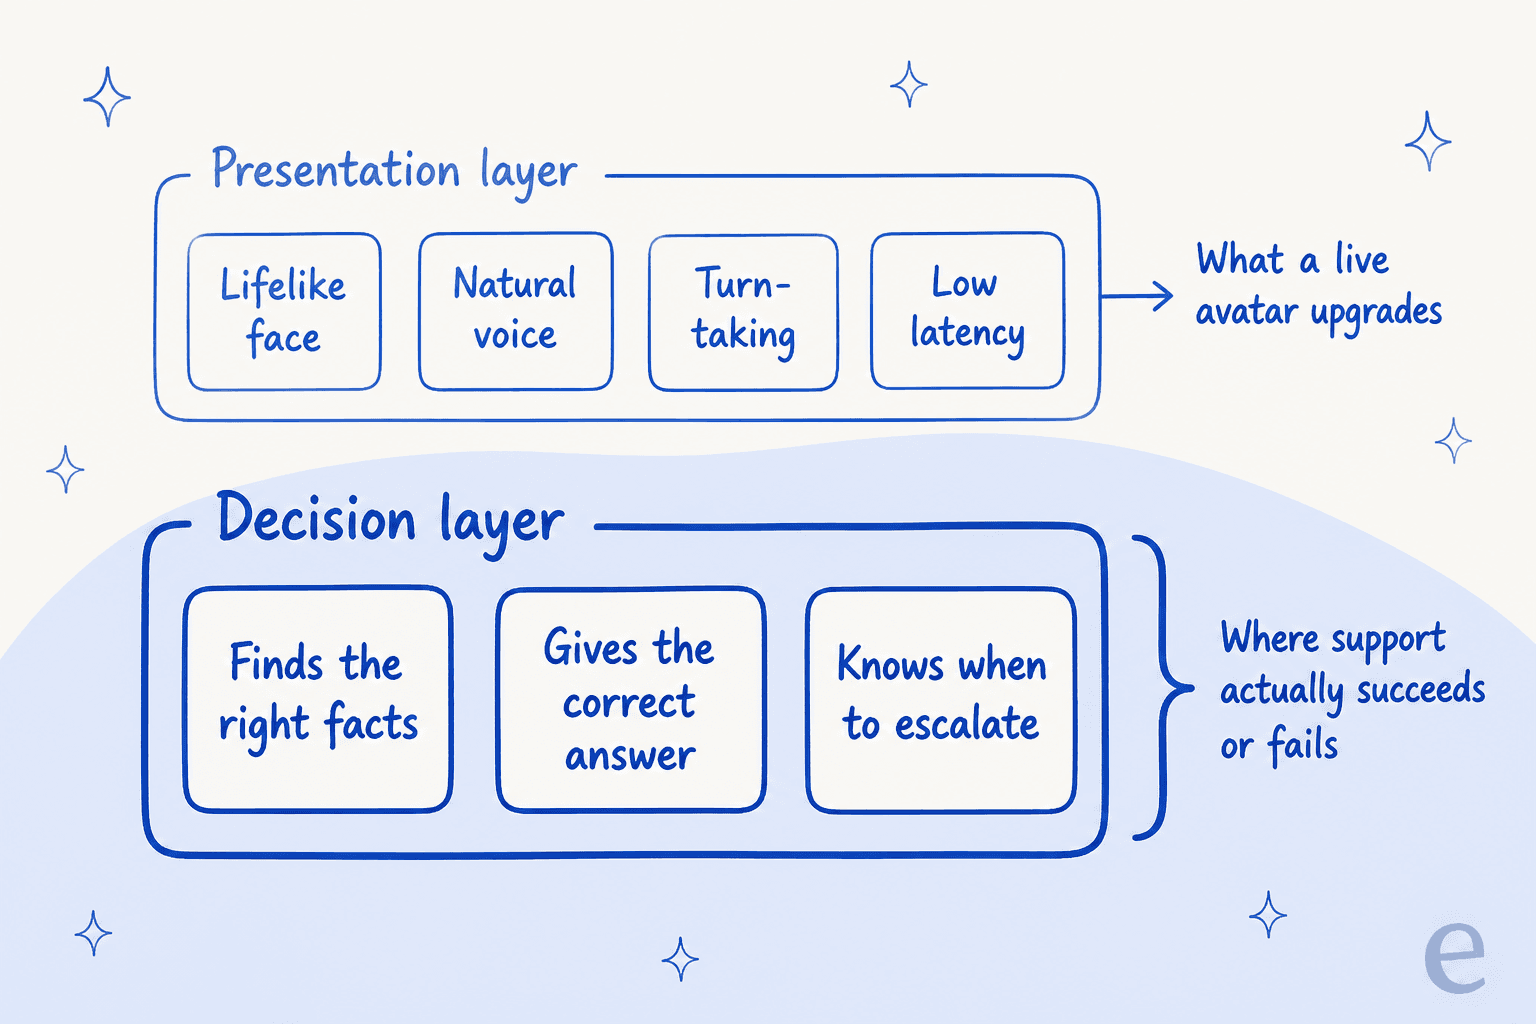
Je reviendrai sur la raison pour laquelle cette couche de décision est la partie difficile. D'abord, les outils.
Les alternatives en un coup d'œil
| Outil | Idéal pour | Visage ou voix | Latence temps réel (annonce du fournisseur) | Unité de facturation | Prix d'entrée | Limite marquante |
|---|---|---|---|---|---|---|
| HeyGen LiveAvatar | Avatars vidéo de marque à grande échelle | Avatar vidéo | <300ms jusqu'à la première image | Crédits par minute de streaming | Free ($0, 10 crédits) ; Essential $99 | $0.01/min uniquement en Enterprise |
| Tavus | Développeurs qui intègrent des agents vidéo en direct | Avatar vidéo | ~134ms de rendu, aller-retour sous 1s | Minute de vidéo conversationnelle | Free (25 min) ; Starter $59 | Reproches sur l'alternance des tours ; virage développeurs |
| D-ID | Avatars en streaming sans code avec RAG | Avatar vidéo | Moins de 2 secondes | Réserve mensuelle de minutes partagée | Essai de 14 jours ; API Build $14.40 | Réserve non reportable ; plaintes de facturation |
| Soul Machines | Humains numériques très expressifs | Avatar vidéo | Non publiée | Minutes de conversation interactive | Free (construction seule) ; Basic $12.99 | Monte très vite en prix ; peu d'avis |
| Synthesia | Vidéo d'entreprise à grande échelle | Avatar vidéo (surtout asynchrone) | N/A (le cœur est pré-rendu) | Crédits, plus à la minute pour le live | Free ($0) ; Starter $19 | Le produit principal n'est pas en temps réel |
| OpenAI Realtime API | Construire son propre agent vocal | Voix seule | Faible (parole à parole) | Jetons audio | $32 / 1M de jetons audio en entrée | Pas de visage ; des briques, pas un agent fini |
| ElevenLabs | Agents vocaux à la voix humaine | Voix seule | Sous la seconde (annoncée) | Minutes d'appel | Free (15 min) ; Starter $6 | Les coûts s'accumulent ; crédits perdus à la rétrogradation |
Maintenant, le détail de chacun.
1. HeyGen LiveAvatar
Idéal pour : les équipes qui veulent un avatar à tête parlante soigné et à l'image de la marque, diffusé à de vrais utilisateurs, avec un minimum d'infrastructure.
HeyGen a rebaptisé son produit temps réel LiveAvatar, et c'est l'avatar vidéo le plus clés en main de la liste. Il diffuse des avatars en 1080p avec, selon HeyGen, moins de 300ms jusqu'à la première image et une simultanéité illimitée, et vous pouvez l'intégrer en cinq minutes environ. Il y a deux modes de construction : FULL, où HeyGen gère toute la pile parole et rendu, et LITE, où vous apportez votre propre LLM et votre synthèse vocale.
Tarifs. LiveAvatar facture en crédits, et le ratio dépend du mode : FULL coûte 2 crédits par minute, LITE 1 crédit par minute. Les offres sont Free ($0, 10 crédits, avec filigrane, sessions de 2 minutes), Essential ($99 pour 1,100 crédits), Business ($475 pour 6,000 crédits) et Enterprise. Le titre « $0.01/min à grande échelle » est réel mais ne s'applique qu'au niveau Enterprise, que le centre d'aide situe à des budgets supérieurs à environ $40,000. Notez que c'est distinct des offres vidéo principales de HeyGen.
La limite honnête. Le chiffre <300ms est une annonce sur la nouvelle plateforme, et il existe en partie parce que l'ancien SDK Streaming Avatar de HeyGen avait la réputation, sur les forums de développeurs, d'une latence réelle de plusieurs secondes. Si la faible latence est décisive, mesurez-la sur votre propre trafic avant de vous engager.
Verdict : le moyen le plus simple de présenter un bel avatar de marque aux utilisateurs. Lisez simplement le calcul des crédits, car le mode FULL consomme deux fois plus vite que ne le laisse penser le tarif LITE affiché.
2. Tavus
Idéal pour : les ingénieurs qui veulent intégrer un agent vidéo en temps réel et tiennent au réalisme du rendu et à la latence.
Tavus construit la Conversational Video Interface, un pipeline vidéo temps réel complet que vous pilotez par API. Sa pile de modèles est inhabituellement précise : Raven pour la perception, Sparrow pour l'alternance des tours et le moteur de rendu Phoenix, dont Tavus affirme qu'il atteint environ 134ms de rendu avec un aller-retour conversationnel sous la seconde. Une seule API remplace les cinq ou six fournisseurs qu'il faudrait autrement câbler, puisque le LLM, la synthèse vocale et WebRTC sont inclus dans le prix à la minute.
Le réalisme convainc ceux qui l'essaient :
"Felt like talking to a person, I couldn't bring myself to treat it like a piece of code, that's how real it felt."

Tarifs. Tavus utilise un modèle hybride : un abonnement mensuel plus des minutes de vidéo conversationnelle incluses, avec dépassement à l'usage. Basic est gratuit (25 min/mois), Starter coûte $59/mois (100 min, puis $0.37/min) et Growth coûte $397/mois (1,250 min, puis $0.32/min). L'entraînement de visages personnalisés est une option, à $65 pièce après quelques entraînements gratuits sur Starter.
La limite honnête. Le reproche constant, tiré de la même démo, est l'alternance des tours :
"The AI kept cutting me off, and not leaving time in the conversation to respond. It would cut off utterances before the end."
Sparrow a été conçu précisément pour corriger cela, donc ce devrait être meilleur maintenant, mais la gestion des interruptions est ce qu'il faut tester à fond. Tavus a aussi pivoté vers les développeurs en 2026, il vise donc les ingénieurs, pas les marketeurs.
Verdict : le meilleur choix si vous êtes développeur, que vous voulez le visage temps réel le plus réaliste et que vous ferez le travail d'intégration. Testez les interruptions avant de mettre en production.
3. D-ID
Idéal pour : les équipes qui veulent un avatar en streaming avec une base de connaissances intégrée et une voie sans code, pas seulement une API.
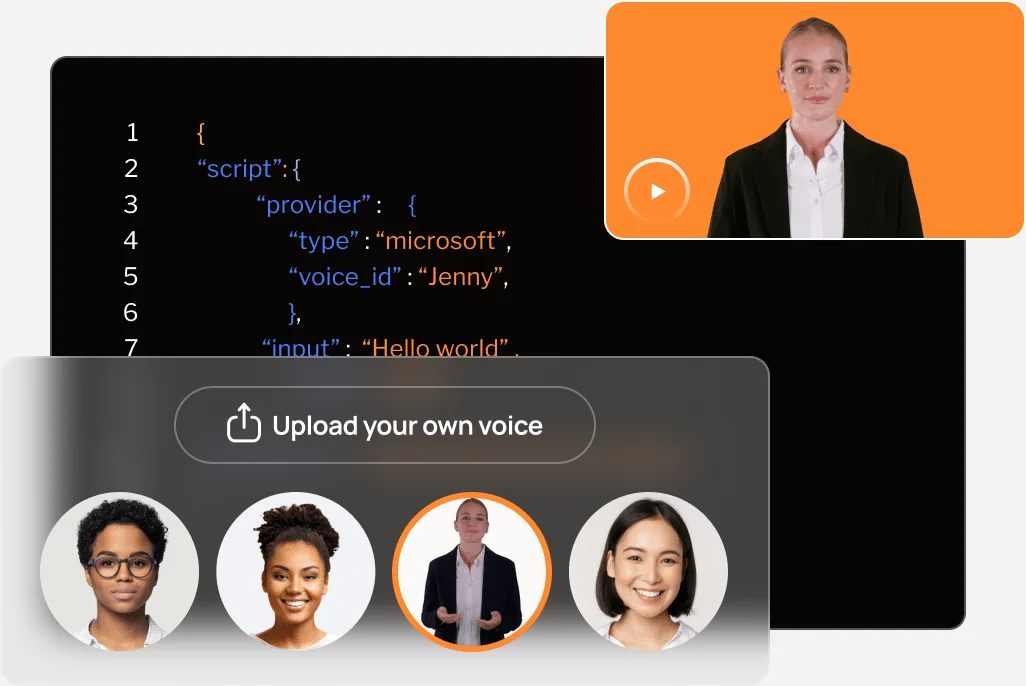
Les D-ID Agents sont des avatars conversationnels diffusés en WebRTC que vous pouvez construire avec le SDK client, l'API REST ou une intégration sans backend. Chaque agent associe un avatar à un LLM (y compris le vôtre), une base de connaissances RAG et une mémoire de conversation, et D-ID met en avant « plus de 90 % de précision en moins de deux secondes ». Ceux qui l'aiment apprécient vraiment la qualité de l'avatar :
"For me at the moment the best live interactive Avatars on the market. Good lip Sync, really realistic."

Tarifs. D-ID propose deux grilles, Studio et API, qui facturent toutes deux des crédits sur une réserve mensuelle de minutes partagée couvrant ensemble vidéos, agents et traduction. Côté API, Build coûte $14.40/mois (jusqu'à 32 minutes de streaming), Launch $35/mois (jusqu'à 90) et Scale $138.60/mois (jusqu'à 400). Il y a un essai de 14 jours mais pas d'offre gratuite permanente, et un volume sérieux d'agents en direct relève d'une discussion Enterprise de « minutes sur mesure ».
La limite honnête. Deux choses. La réserve de minutes ne se reporte pas, donc les minutes inutilisées sont remises à zéro à chaque cycle. Et les avis sont polarisés : D-ID est à 3.7/5 sur Trustpilot avec une longue traîne de plaintes de facturation (renouvellement automatique, remboursements refusés), tout en obtenant environ 4.3/5 sur G2. Lisez attentivement les conditions de facturation.
Verdict : une solide option intermédiaire si vous voulez du RAG et une voie sans code intégrés. Surveillez la réserve de minutes partagée et non reportable ainsi que le renouvellement automatique.
4. Soul Machines
Idéal pour : les marques qui veulent l'humain numérique le plus expressif sur le plan émotionnel et animé de façon autonome, et qui en ont le budget.
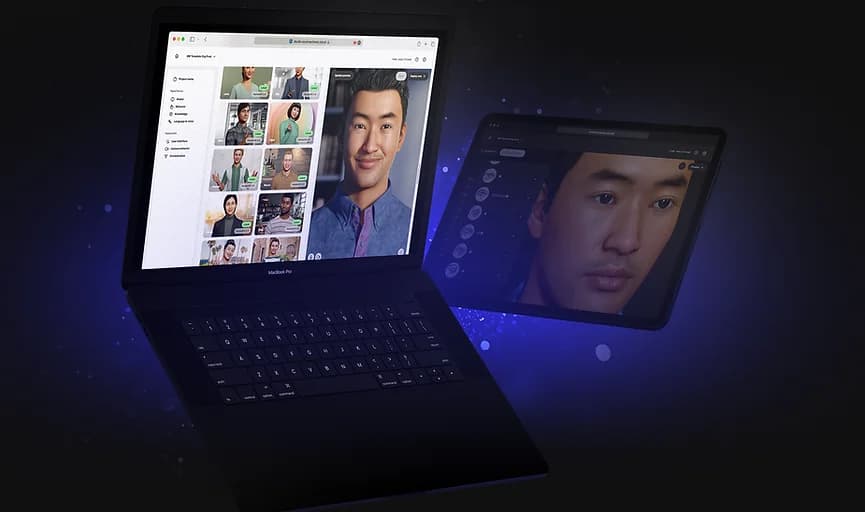
Soul Machines vend des « Digital People », des avatars pilotés par son Digital Brain breveté, qui simule des systèmes sensoriels, moteurs et attentionnels pour que le visage réagisse et exprime des émotions en temps réel plutôt que de simplement synchroniser les lèvres. Il est indépendant du LLM, vous construisez dans Soul Machines Studio, et les déploiements cités incluent ANZ, Mercedes-Benz et UCSF. Si l'expressivité est le but, c'est le leader de la catégorie.
Tarifs. Fait inhabituel pour un fournisseur d'humains numériques, Studio a une grille tarifaire publique avec une offre Free réservée à la construction, puis Basic à $12.99/mois (40 minutes interactives), Plus à $99/mois (350 minutes) et Pro à $2,700/mois (10,000 minutes). Son produit Workforce Connect coûte $40,000/an forfaitaires et nécessite un abonnement Zapier séparé.
La limite honnête. Le prix monte très vite, un saut d'environ 27 fois entre Plus et Pro, si bien que quiconque a besoin d'un vrai volume de déploiement atterrit rapidement dans la tranche de plusieurs milliers de dollars par mois. La couverture d'avis indépendants est aussi mince (G2 n'affiche que quelques avis), vous achetez donc davantage sur les démos et les logos cités que sur un large corpus de retours d'utilisateurs.
Verdict : choisissez-le quand la présence émotionnelle réaliste est vraiment le produit, comme une borne de marque ou une expérience de marque phare. C'est surdimensionné, et trop cher, pour le support courant.
5. Synthesia
Idéal pour : la vidéo d'entreprise à grande échelle (formation, intégration, communication), pas la conversation en direct.
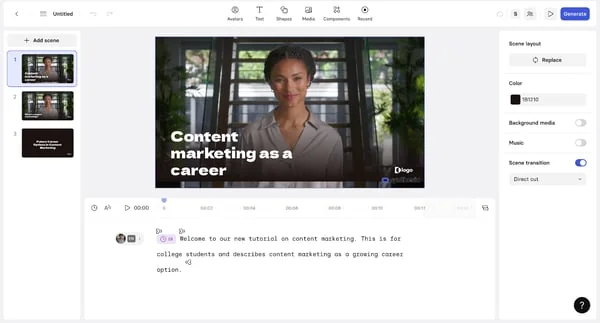
Celui-ci vient avec une réserve, et c'est tout l'enjeu. Le produit principal de Synthesia est de la vidéo asynchrone pré-rendue : vous écrivez un script, il génère un MP4. C'est l'inverse d'un avatar en direct. Il affiche 4.7/5 sur G2 pour environ 2,000 avis, et il excelle dans ce qu'il fait, à savoir de la vidéo d'avatar soignée dans de nombreuses langues.
Il a bien un produit temps réel, Interactive Avatars, mais c'est une API développeur distincte (construite sur LiveKit, apportez votre propre LLM), pas l'une des offres vidéo standard.
Tarifs. Les offres principales sont Free ($0), Starter ($19/mois), Creator ($89/mois) et Enterprise, toutes mesurées par une réserve de crédits partagée qui se convertit en minutes de vidéo. Free et Starter plafonnent à environ 10 minutes de vidéo par mois. Le produit temps réel Interactive Avatars est facturé séparément à la minute, avec 500 minutes gratuites pour commencer.
La limite honnête. Si vous êtes venu chercher un avatar conversationnel en direct, le produit phare de Synthesia n'a pas la bonne forme, et sa couche temps réel est plus récente et moins éprouvée que celle de HeyGen ou de Tavus. Le reproche le plus courant, au-delà des faibles plafonds de minutes, est un excès de modération du contenu sur ce que vous avez le droit de générer.
Verdict : le meilleur outil de cette liste pour la vidéo d'entreprise scénarisée, et une option temps réel raisonnable seulement si vous voulez spécifiquement son API Interactive Avatars. Ne confondez pas les deux.
6. OpenAI Realtime API
Idéal pour : les développeurs qui construisent un agent vocal sur mesure, veulent un modèle de pointe et n'ont pas besoin de visage.
L'OpenAI Realtime API est le pair de grand laboratoire le plus proche de la capacité en direct de Gemini, sans l'avatar. C'est une infrastructure parole à parole (audio en entrée, audio en sortie) avec appels d'outils asynchrones natifs, MCP distant et téléphonie SIP, le tout via WebRTC ou WebSocket. L'agent, vous le construisez : instructions, outils, garde-fous. Les développeurs ont apprécié le modèle GA sur le coût et la qualité, mais surveillent le compteur :
"I'm curious now to see how the costs associated with this would work through the API on some user-facing features."
Tarifs. Il facture en jetons audio, pas en minutes : gpt-realtime-2.1 coûte $32 par 1M de jetons audio en entrée ($0.40 en cache) et $64 par 1M de jetons audio en sortie, avec une version mini moins chère à $10/$20. En pratique, cela donne environ $0.02 par minute entendue et à peu près $0.077 par minute parlée. OpenAI propose aussi un modèle GPT-Live à la minute à $0.05/min si vous préférez une mesure forfaitaire.
La limite honnête. Ce sont des briques, pas un agent fini. Il n'y a ni base de connaissances intégrée, ni simulation de tickets, ni garde-fous propres au support, et les applications de navigateur ont besoin d'un proxy à jetons éphémères pour ne pas exposer votre clé. Un développeur a aussi signalé que le modèle dérivait vers une autre langue en pleine session sur de longs échanges. Vous achetez une très bonne brique et vous construisez le reste.
Verdict : le bon choix si vous avez des ingénieurs et voulez un modèle vocal de premier plan sans visage. Si vous voulez un agent de support qui fonctionne plutôt qu'une boîte à outils, cela fait beaucoup d'assemblage.
7. ElevenLabs Conversational AI
Idéal pour : les agents vocaux à la voix humaine, surtout au téléphone, sans construire la pile vocale de zéro.
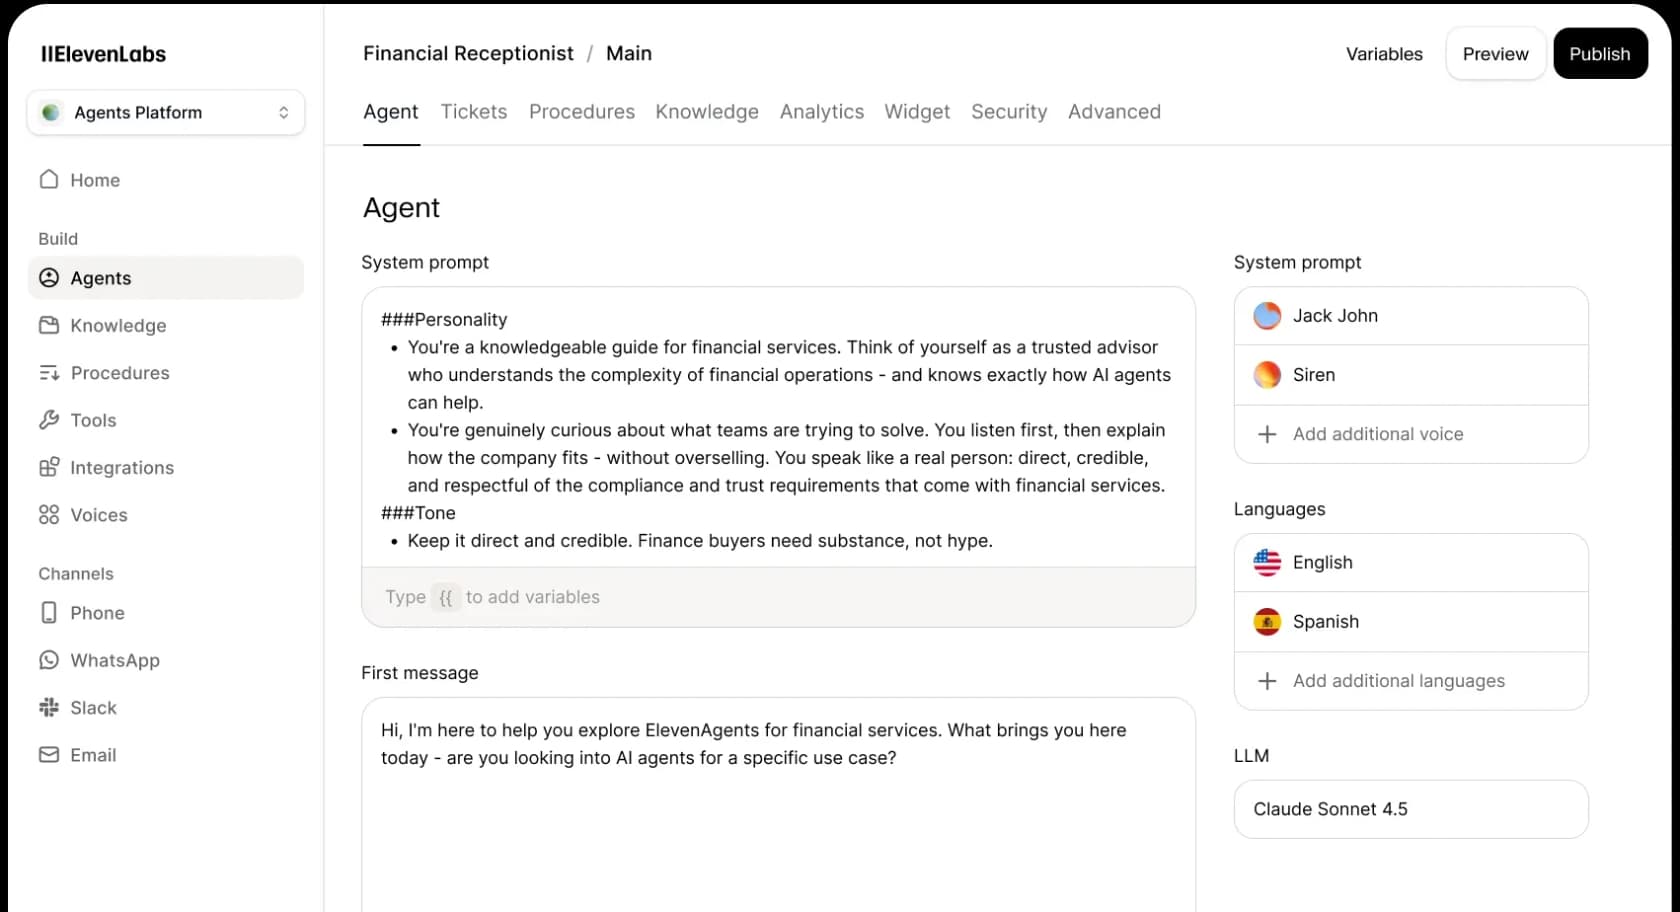
ElevenLabs est axé sur la voix et réputé pour la parole la plus naturelle de la catégorie. Son Agents Platform associe reconnaissance vocale, le LLM de votre choix, sa synthèse vocale à faible latence et un modèle propriétaire d'alternance des tours, avec un constructeur sans code, des SDK, la téléphonie Twilio/SIP, une base de connaissances et des appels d'outils dans plus de 70 langues. Il se situe à environ 4.6/5 sur G2 pour environ 584 avis.
Tarifs. Les agents sont facturés aux minutes d'appel : Free (15 min), Starter $6 (75 min), Creator $22 (275 min), Pro $99 (1,238 min), Scale $299 (3,738 min) et Business $990 (12,375 min). Le dépassement est de $0.08/min et le tarif en rafale de $0.16/min. Point crucial : l'usage du LLM est facturé séparément, en plus, et la téléphonie est répercutée au prix coûtant.
La limite honnête. Le coût réel s'accumule : minutes d'appel plus des frais LLM séparés plus la téléphonie, si bien que les $0.08 affichés sous-estiment le chiffre réel. Les crédits payés non utilisés expirent aussi à la rétrogradation, ce qui revient souvent dans les plaintes, et quelques utilisateurs signalent des pics de latence proches de quatre secondes contre l'annonce de moins d'une seconde.
Verdict : le choix vocal seul le plus solide pour les agents en contact avec les clients, surtout pour le support téléphonique. Calculez le coût total par minute, pas seulement le tarif affiché.
Comment fonctionne réellement un avatar en direct
Retirez l'habillage de marque et chaque outil ci-dessus exécute la même boucle pour un tour de conversation. Cela vaut la peine de la voir, car elle montre où se fait le vrai travail.
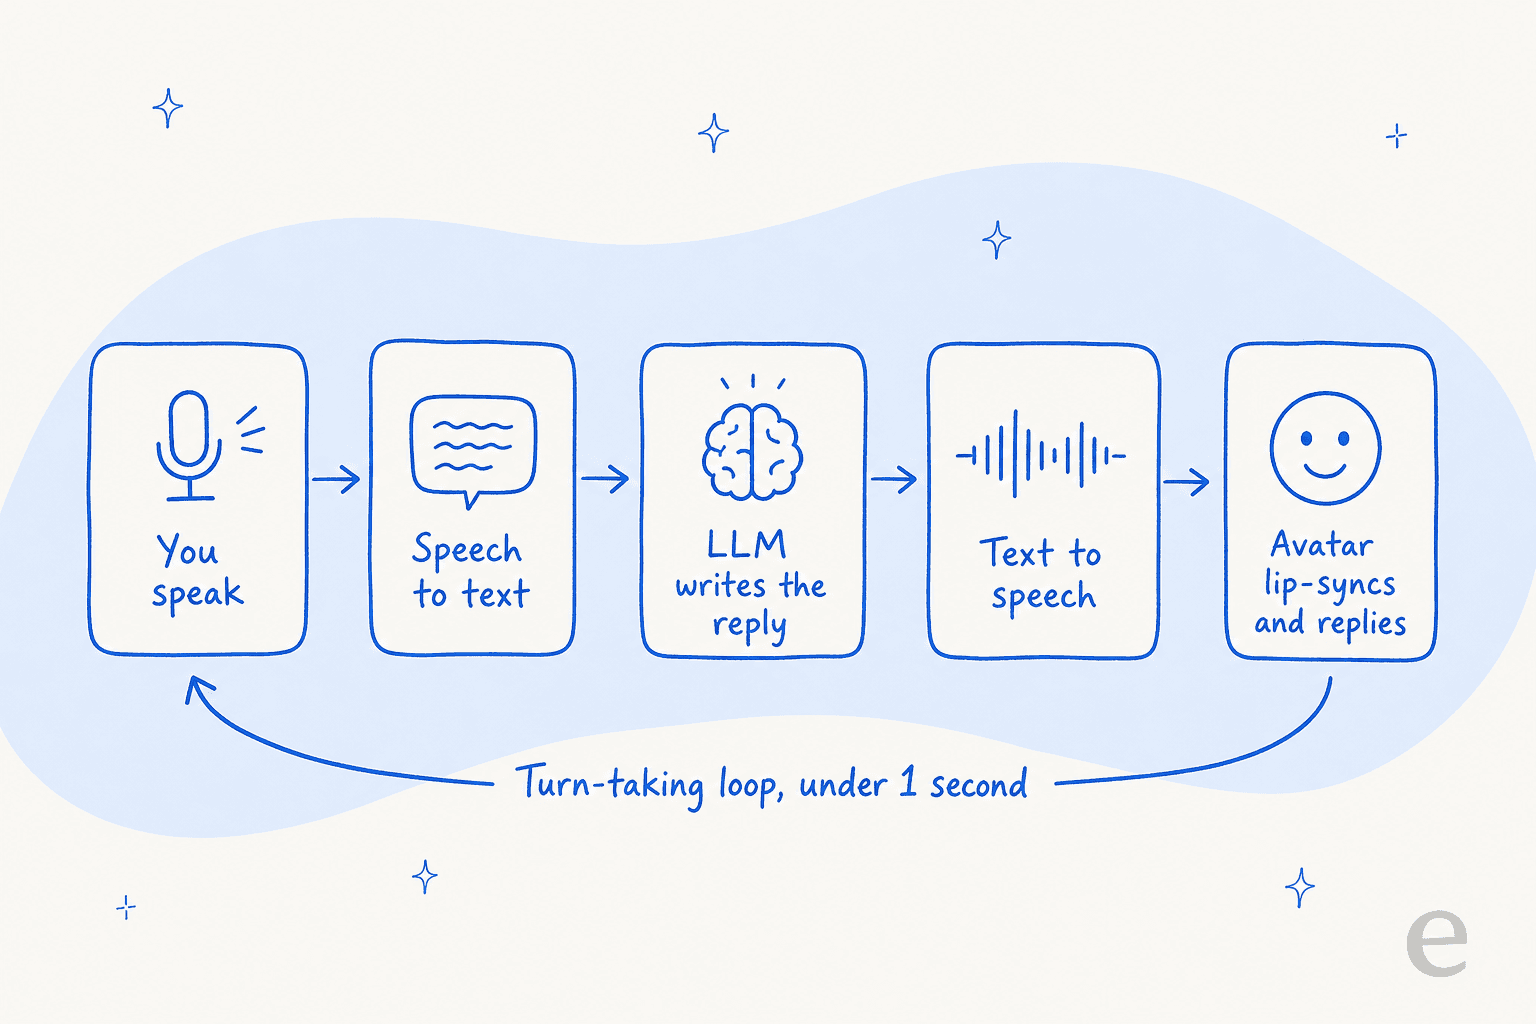
Remarquez que quatre des cinq étapes (capture, transcription, synthèse vocale, rendu) relèvent de la présentation. Une seule, le LLM qui écrit la réponse, décide si le client obtient une réponse correcte. L'avatar embellit les quatre autres. Il ne fait rien pour celle qui compte, ce qui est aussi la raison pour laquelle un chatbot IA répond de travers même quand il paraît parfaitement fluide.
Ce qu'un avatar ne règle pas
C'est ici que je dépense la confiance du lecteur, car c'est la chose la plus utile de cet article. Après des années à mettre de l'IA sur des files de support en direct, le schéma que je revois sans cesse, c'est que les équipes tombent amoureuses de la façade et sous-investissent dans la couche qui résout réellement le ticket. Nous avons vu des bots à l'air sûr d'eux donner avec assurance des réponses fausses, c'est pourquoi chaque déploiement d'eesel est simulé sur les propres tickets historiques du client avant de répondre à une vraie personne.
Les données le confirment. Sur le classement de support τ-bench, même les modèles solides montrent une chute brutale en recherche d'information : la performance peut baisser d'environ 68 points en passant d'un scénario télécom facile à un scénario bancaire riche en connaissances, et les meilleurs modèles de support ne sont fiables qu'environ 35 % du temps quand on exige quatre bonnes réponses d'affilée. Cet écart n'est pas un problème de rendu. Aucune synchronisation labiale ne le comble.
Donc si vous cherchez un avatar en direct parce que vous voulez automatiser le service client, la question honnête n'est pas « quel visage paraît le plus humain », c'est « quel système donne la bonne réponse et sait quand escalader ». Les indicateurs qui comptent sont le taux de résolution et la précision d'escalade, pas le réalisme. Pour beaucoup d'équipes, la réponse n'est pas du tout un visage parlant, c'est un agent IA bien ancré dans les faits qui travaille sur les canaux que les clients utilisent déjà : chat, e-mail et tickets.
Où eesel s'intègre (et où non)
Je vais être franc, car tout l'intérêt de cet article est l'honnêteté : eesel ne fait ni voix ni avatars. Si vous avez besoin d'un visage affiché ou d'une voix au téléphone, choisissez l'un des sept ci-dessus. Ce que fait eesel, c'est la couche de décision, sur les canaux texte.
Voyez-le ainsi. L'OpenAI Realtime API, ElevenLabs et Gemini lui-même sont de l'infrastructure ; eesel est le coéquipier IA que vous embauchez pour faire un travail. Notre agent de helpdesk IA se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias, Front, et plus), apprend dès le premier jour de vos anciens tickets et de votre centre d'aide, et rédige ou envoie automatiquement des réponses une fois que vous faites confiance à sa précision. Au lieu de « l'activer et croiser les doigts », il exécute d'abord une simulation sur vos tickets historiques pour que vous voyiez le taux de résolution avant qu'un client ne le rencontre.
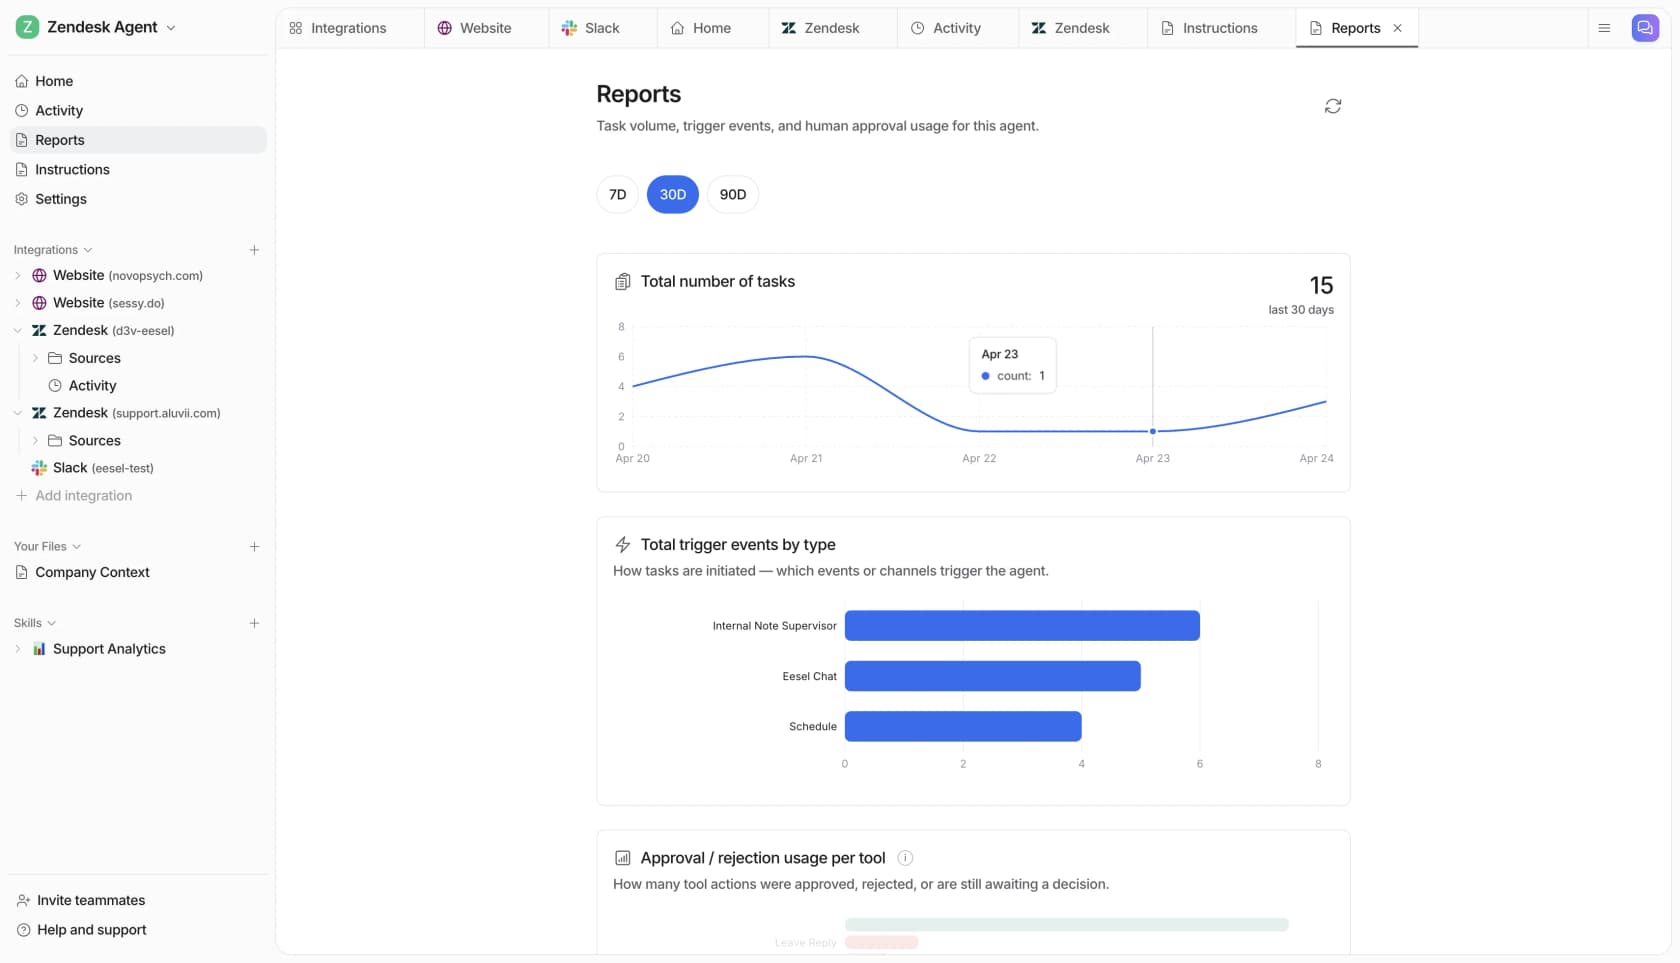
Et comme cette liste regorge d'API et de SDK, une chose à savoir : eesel se pilote aussi depuis la CLI eesel. C'est le même coéquipier que le tableau de bord, exposé pour le terminal, les scripts et les agents de code comme Claude Code, Cursor et Codex. Chaque commande renvoie du JSON avec un champ hint qui indique à un agent quoi exécuter ensuite, de sorte que vous pouvez connecter un helpdesk, téléverser des connaissances et configurer des automatisations sans jamais ouvrir l'interface. Chaque espace de travail est aussi un serveur MCP. C'est la façon adaptée aux agents d'utiliser le même coéquipier de support, si c'est ainsi que votre équipe aime travailler.
Si le travail est un visage réaliste, cette liste vous couvre. Si le travail est de résoudre correctement les tickets, c'est pour cela qu'eesel a été conçu, et vous pouvez l'essayer gratuitement.