

Comment j'ai fait ce test
Une brève note sur la méthode, car elle pose la base de tout ce qui suit. Gemini 3.8 Live Avatar est une fonctionnalité d'entreprise dont la création d'avatars personnalisés est derrière une liste d'autorisation, ce n'est donc pas un test du genre « je l'ai fait tourner en production pendant six mois ». J'ai lu ligne par ligne la fiche du modèle de Google, le guide développeur et la grille tarifaire, recoupé les affirmations du lancement avec les déploiements clients cités, et mis le tout à l'épreuve d'une question qui m'importe plus que l'apparence : un visage améliore-t-il la réponse ?
J'ai passé ces dernières années à construire des agents IA qui tiennent des files de support en direct, et ce qui me tient éveillé n'a jamais été l'apparence du bot. C'est qu'il ait raison. Alors quand Google a sorti une tête parlante photoréaliste pour les agents d'entreprise, ma première question n'a pas été « est-ce beau » (oui), mais « est-ce que ça fait bouger le chiffre qui compte » (non). Voici le détail complet.
Ce que vous obtenez réellement
Google l'a d'abord présenté en avant-première à Google Cloud Next 2026 et l'a livré en disponibilité générale la semaine après le lancement des modèles de base Gemini 3.8 Live et 3.8 Live Extended Thinking. Autant clarifier la dénomination d'emblée, car on trébuche facilement : Gemini 3.8 Live est le modèle de conversation en temps réel, et Live Avatar est la couche vidéo de tête parlante animée qui se pose dessus. C'est une fonctionnalité, pas un modèle distinct, et d'après la fiche du modèle DeepMind, il repose sur Gemini 3 Pro.
Sans le marketing, la fonctionnalité fait cinq choses concrètes :
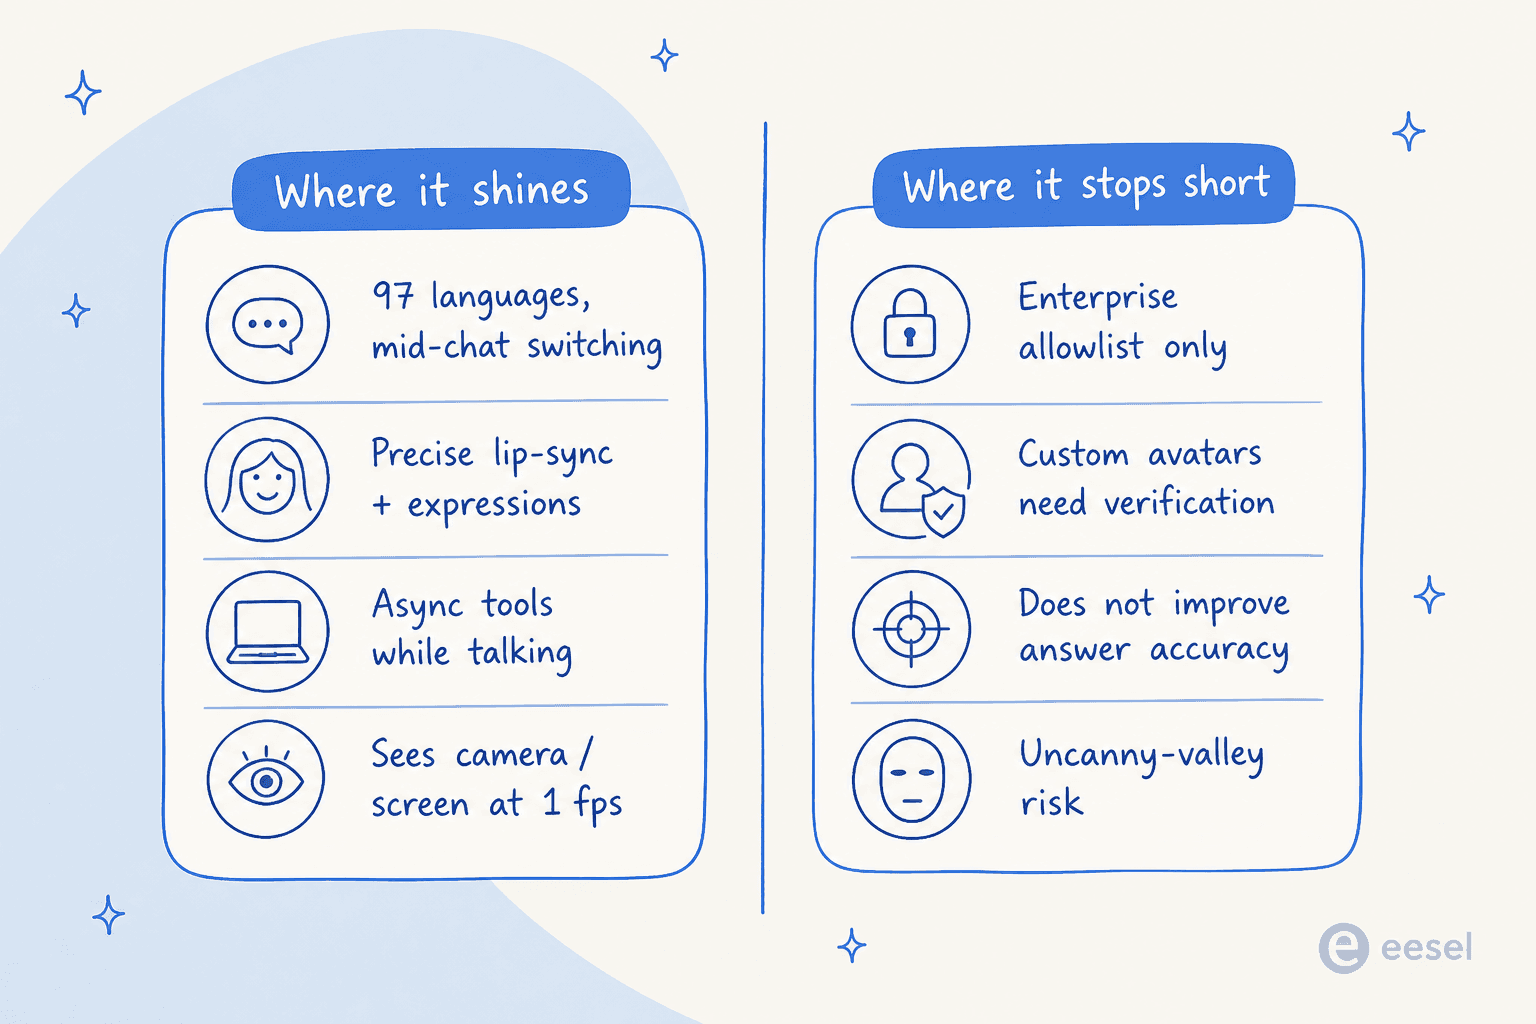
- Un visage en temps réel. Synchronisation labiale précise, expressions faciales naturelles et alternance de parole fluide, rendues sous forme de sortie vidéo synchronisée à 24 FPS. Le modèle de base 2.5 Flash Live n'avait aucune sortie vidéo, c'est donc un vrai pas en avant, pas un ajustement.
- Il voit pendant qu'il parle. Le modèle traite l'audio et le visuel en même temps, lisant un flux de caméra ou un partage d'écran à une image par seconde, et peut donc réagir à ce que vous montrez en pleine conversation.
- 97 langues avec changement en cours de chat. Un voix à voix multilingue natif qui adapte la synchronisation labiale et les expressions d'une langue à l'autre, en changeant en pleine conversation sans dérive visuelle. C'est la capacité phare, et j'y reviendrai.
- Appels d'outils en arrière-plan. Des appels de fonctions asynchrones qui lancent des outils et récupèrent des données en arrière-plan pendant que le dialogue continue, pour que l'avatar ne reste pas figé au milieu d'une phrase en attendant une API.
- Avatars prédéfinis ou personnalisés. Une bibliothèque d'avatars prédéfinis que toute personne sur Gemini Enterprise peut utiliser, plus des avatars personnalisés générés à partir d'une seule image de référence et d'un échantillon audio, qui préservent la ressemblance et le style de marque.
Deux réglages sont activés par défaut et méritent d'être connus : le dialogue affectif (il lit la prosodie, l'émotion et les pauses, puis ajuste son ton) et l'audio proactif (il filtre le bruit ambiant et les bavardages hors sujet). Chaque sortie audio et vidéo porte aussi un filigrane SynthID imperceptible, et la création d'avatars personnalisés est verrouillée par liste d'autorisation et vérification, ce qui relève d'une prudence raisonnable de Google face aux deepfakes.
Le multilingue est le vrai titre
Si je devais pointer une seule chose qui rend cela digne d'intérêt, ce serait l'étendue des langues. Quatre-vingt-dix-sept langues, détectées automatiquement, avec les mouvements des lèvres et les expressions qui se resynchronisent quand la conversation change de langue en pleine phrase. Pour une organisation de support mondiale qui emploie aujourd'hui des équipes vocales distinctes par région, c'est une offre structurellement différente.
Et la qualité de langue sous-jacente de Gemini est vraiment solide, ce qui rend la couche avatar intéressante plutôt que gadget. Un développeur du fil Hacker News consacré au lancement de 3.8 Live l'a dit mieux que n'importe quel benchmark :
"My first language is Afrikaans, which is a somewhat niche language and hard to find teachers/conversation buddies outside South Africa... I've been using Gemini to live chat in Afrikaans... It is phenomenal at speaking the language - like, it really shocks my family members when they hear it."

C'est la capacité à l'œuvre : pas une langue de démonstration, une langue de niche, parlée assez bien pour surprendre des locuteurs natifs. Associez cette qualité à un visage dont la synchronisation labiale reste juste malgré le changement, et on comprend pourquoi Equal AI l'utilise sur 9 langues indiennes avec, selon les chiffres annoncés, plus d'1 million d'appels en direct par jour.
Ce que ça coûte vraiment
C'est ici qu'un test mérite sa place, car la tarification « par token » cache le vrai chiffre. La vidéo de l'avatar est facturée via la grille tarifaire Gemini Enterprise à 1,00 $ par million de tokens, et la note de facturation est l'élément important : la sortie vidéo de l'avatar se convertit à 6 192 tokens par seconde de parole et n'est facturée que lorsque l'avatar parle activement, pas lorsqu'il écoute sans rien dire.
Faites le calcul : environ 0,0062 $ par seconde, soit environ 0,37 $ par minute de parole de l'avatar. Pris seul, le visage est l'une des lignes les moins chères de la facture.
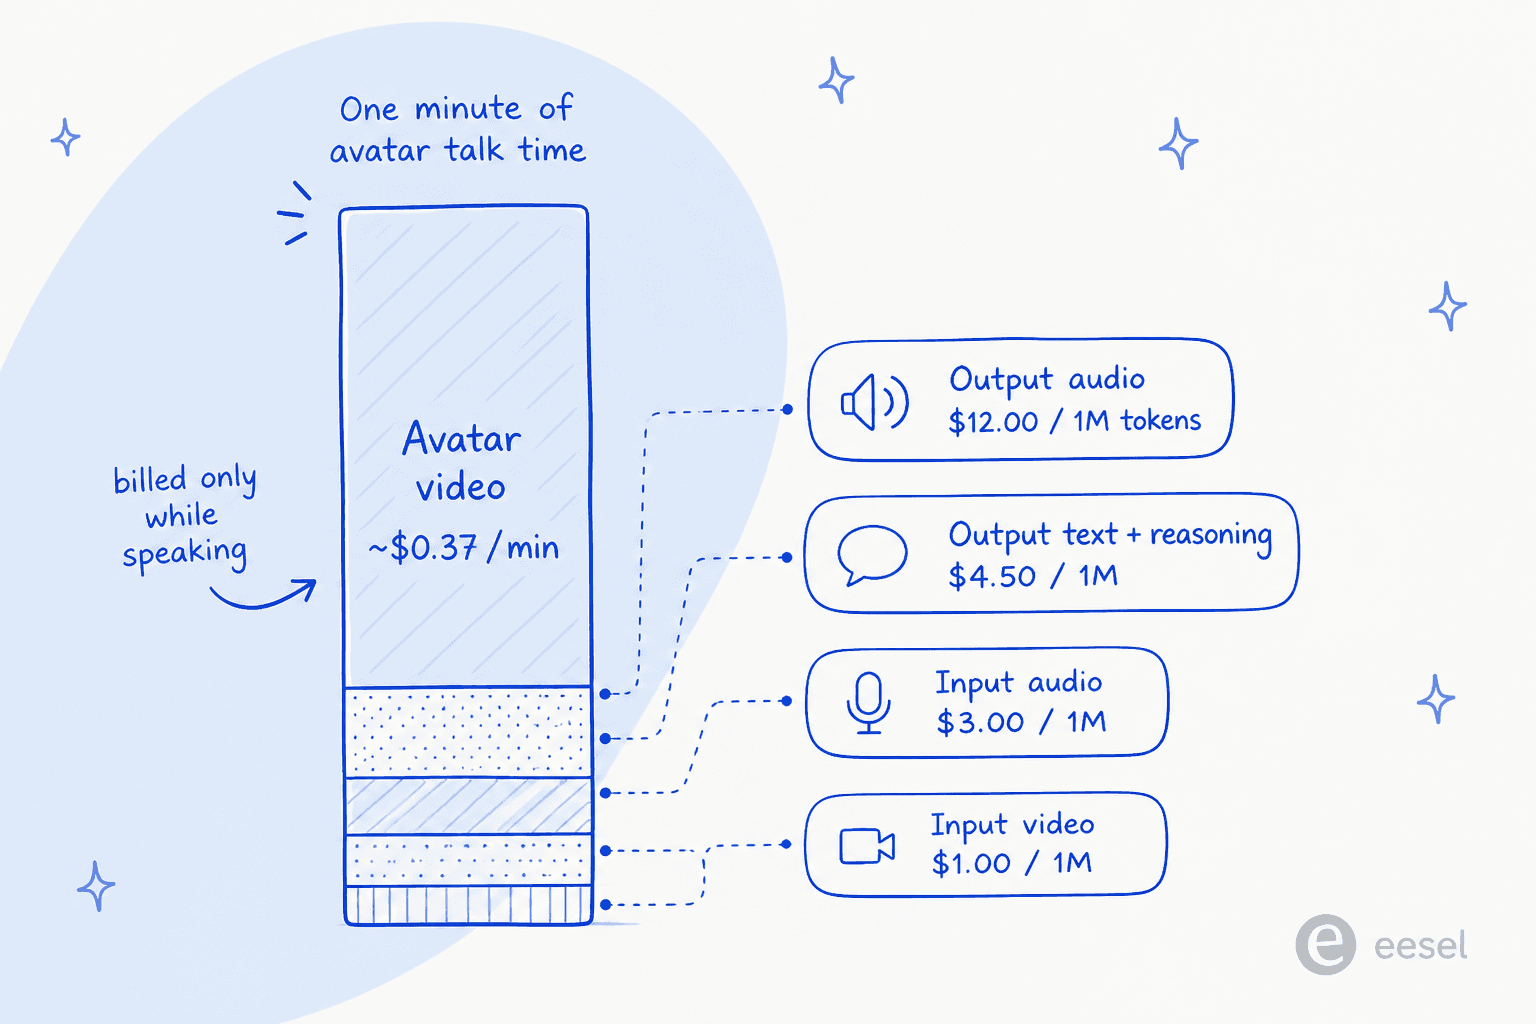
Le piège, c'est que l'avatar ne tourne jamais seul. Il repose sur toute la pile de compteurs de la Live API, et voici tous les tarifs pour les points d'accès non globaux :
| Compteur | Tarif (par million de tokens) | Remarques |
|---|---|---|
| Texte en entrée | 0,75 $ | |
| Vidéo / image en entrée | 1,00 $ | 258 tokens par image |
| Audio en entrée | 3,00 $ | 25 tokens par seconde |
| Texte en sortie (réponse + raisonnement) | 4,50 $ | les tokens de raisonnement sont facturés ici |
| Audio en sortie | 12,00 $ | le plus cher |
| Vidéo en sortie (avatar) | 1,00 $ | 6 192 tokens/s, facturé uniquement pendant la parole |
La ligne qui domine une conversation parlée, c'est l'audio en sortie à 12,00 $ le million, pas la vidéo de l'avatar. La formulation honnête est donc : activer l'avatar ajoute un supplément modeste, limité au temps de parole, à une conversation déjà facturée pour l'audio, le raisonnement et les entrées. Il y a aussi un compromis structurel dans la fiche du modèle qui mérite d'être signalé : avec Live Avatar activé, le plafond de tokens en sortie tombe à 24K, contre 64K sans lui. Et comme dans toute session Live API, les tokens des tours passés sont retraités et refacturés à chaque nouveau tour jusqu'à la limite de contexte, si bien que les longues conversations s'accumulent. Si vous le modélisez face à une file de milliers d'interactions quotidiennes, bâtissez l'estimation d'abord sur l'audio et le raisonnement, puis ajoutez l'avatar par-dessus, pas l'inverse.
Le piège : un visage ne corrige pas la réponse
C'est tout le test en une section. Tout ce qui précède est réel et impressionnant. Rien de cela ne touche ce qui détermine vraiment si un agent de support IA vaut d'être déployé : la réponse est-elle correcte ?
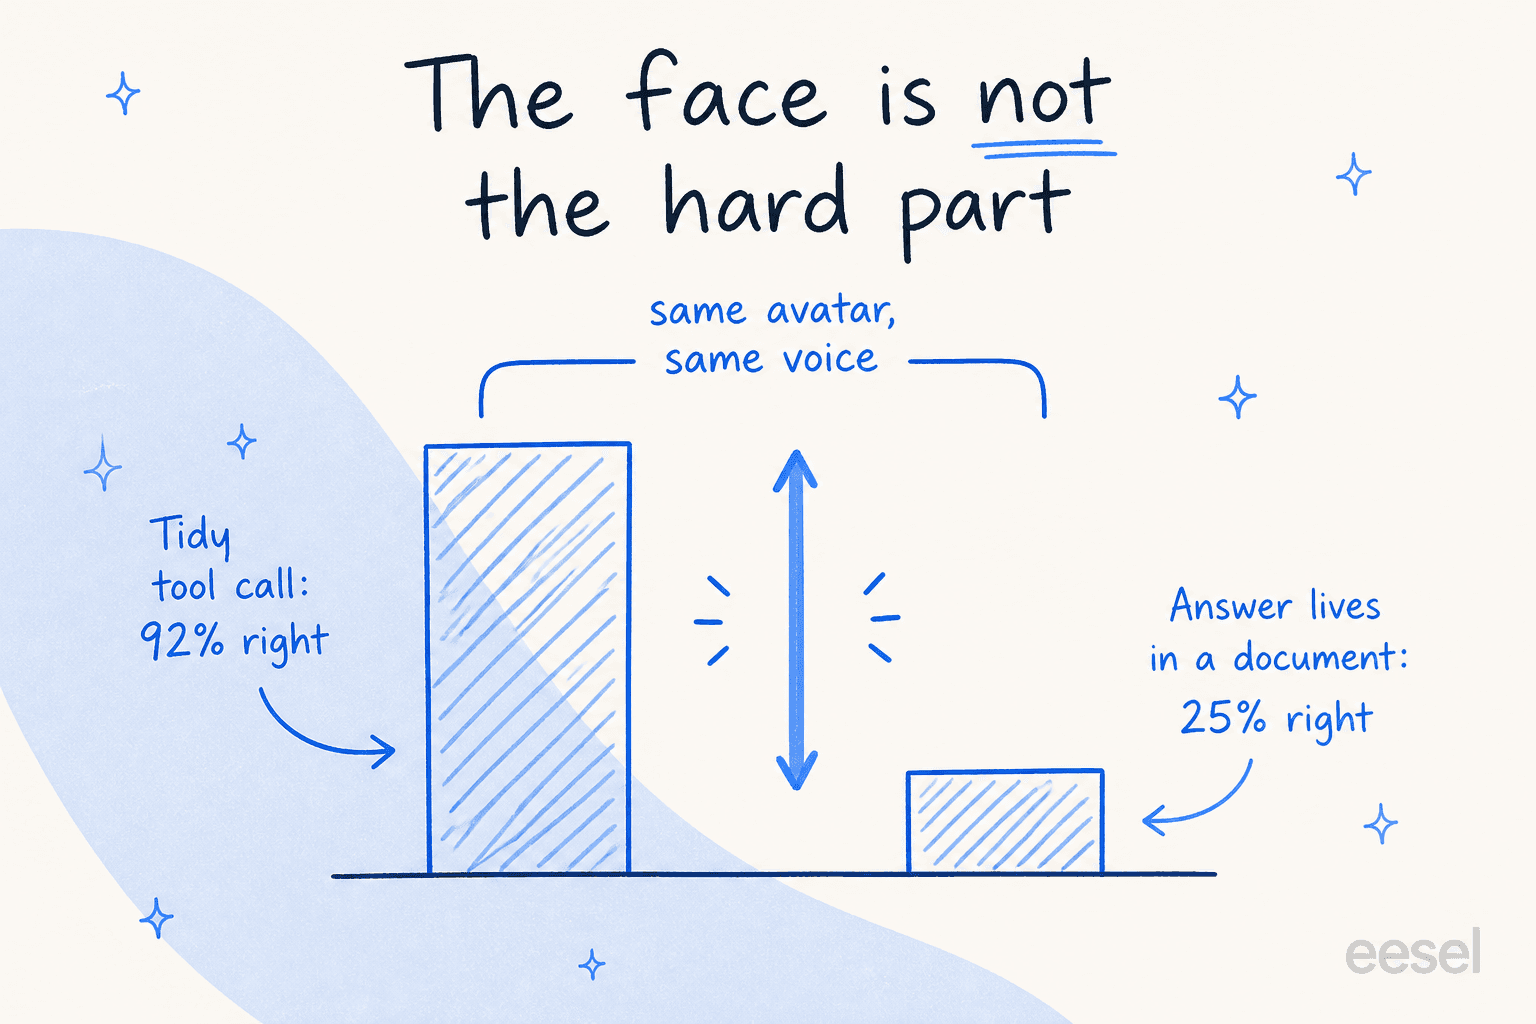
Le schéma que je vois sans cesse dans les évaluations d'agents est une falaise. Sur les tâches qui se ramènent à un appel d'outil propre et structuré, les meilleurs modèles sont excellents. Sur les tâches où la réponse se trouve dans un article de base de connaissances, une politique de cas limite ou une exception à moitié documentée, la précision s'effondre. C'est le même modèle, la même voix, le même visage des deux côtés de cet écart, et le score du côté difficile est celui qui décide si les clients obtiennent une bonne réponse ou une mauvaise réponse assurée.
Un avatar réaliste fait atterrir la mauvaise réponse plus fort, pas plus doucement. Un chatbot brut qui dit « je ne suis pas sûr, je passe la main à un humain » est agaçant mais honnête. Un visage chaleureux, souriant et parfaitement synchronisé qui énonce une politique de remboursement erronée dans un portugais impeccable est un moins bon résultat, car il est plus persuasif. La couche de présentation et la couche d'exactitude sont deux problèmes distincts, et Google a livré une excellente couche de présentation.
Ce n'est pas une critique de Gemini. C'est une critique de ceux qui prennent un visage pour la ligne d'arrivée. Le risque de vallée de l'étrange est réel aussi : un visage convaincant à 95 % peut paraître plus troublant qu'un visage manifestement synthétique, et pour certains moments de support (un client frustré, un litige de facturation) un avatar photoréaliste est tout simplement le mauvais registre. Qu'il aide ou nuise dépend de l'interaction, et c'est un choix de conception, pas une valeur par défaut.
À qui il s'adresse vraiment
Après tout cela, voici à qui je dirais de s'y mettre et à qui d'attendre.
Foncez si vous construisez une expérience vocale ou une borne où le visage est le produit : un assistant en magasin, un parcours d'intégration guidé, un assistant d'achat conversationnel. Cox Automotive et Autotrader l'utilisent exactement pour cela, un assistant d'achat avec surlignage en direct à l'écran, et Marianne Johnson, leur EVP et Chief Product Officer, soutient publiquement l'approche. Si vous avez aussi besoin d'une large couverture multilingue et pouvez entrer dans la liste d'autorisation entreprise pour les avatars personnalisés, l'adéquation est forte.
Attendez, ou regardez ailleurs, si votre but réel est de résoudre correctement plus de tickets de support par e-mail, chat et dans votre helpdesk. L'avatar ne fait pas bouger ce chiffre, et vous paieriez un compteur vidéo et un compromis de plafond de tokens pour une capacité dont votre problème central n'a pas besoin. Les canaux texte et voix résolvent la grande majorité du volume de support, et aucun n'exige un visage généré. C'est aussi à garder en tête si vous le comparez à une plateforme d'IA conversationnelle conçue pour le support plutôt qu'à un modèle que vous assemblez vous-même.
Le point plus profond : Gemini 3.8 Live Avatar est une infrastructure. C'est une brique avec laquelle vous construisez un agent grâce à l'ADK de Google et à la Live API, tout le travail d'intégration, d'ancrage, de test et de garde-fous restant à votre charge. C'est le bon outil si vous êtes une équipe qui construit un produit sur mesure. C'est le mauvais si vous voulez un agent de support qui soit déjà un collaborateur fini.
Essayez eesel pour la réponse, pas pour le visage
Voici le positionnement honnête, car il compte dans un test : eesel ne crée pas d'avatars et n'est pas un produit vocal. C'est un coéquipier IA de helpdesk qui travaille vos canaux de support texte, bâti autour du problème exact que l'avatar laisse intact : donner la bonne réponse.
Là où Gemini 3.8 Live Avatar est une infrastructure que vous assemblez, eesel est le coéquipier que vous embauchez. Il se branche sur votre helpdesk existant (Zendesk, Freshdesk et d'autres), apprend de vos vrais tickets passés et de vos sources de connaissances et, surtout, vous permet de le simuler sur des milliers de vos tickets historiques avant qu'il ne réponde à un client en direct, pour que vous voyiez d'abord sa précision et son taux de résolution sur vos propres données. Il indique aussi exactement ce qu'il a fait, quels tickets il a traités et où un humain est intervenu, si bien que la couche d'exactitude est mesurable, pas un acte de foi.

Si un visage parlant est ce dont votre produit a besoin, celui de Gemini est le meilleur que j'aie testé. Si une réponse correcte est ce dont votre file de support a besoin, c'est un autre outil, et vous pouvez essayer eesel gratuitement sur vos propres tickets.