

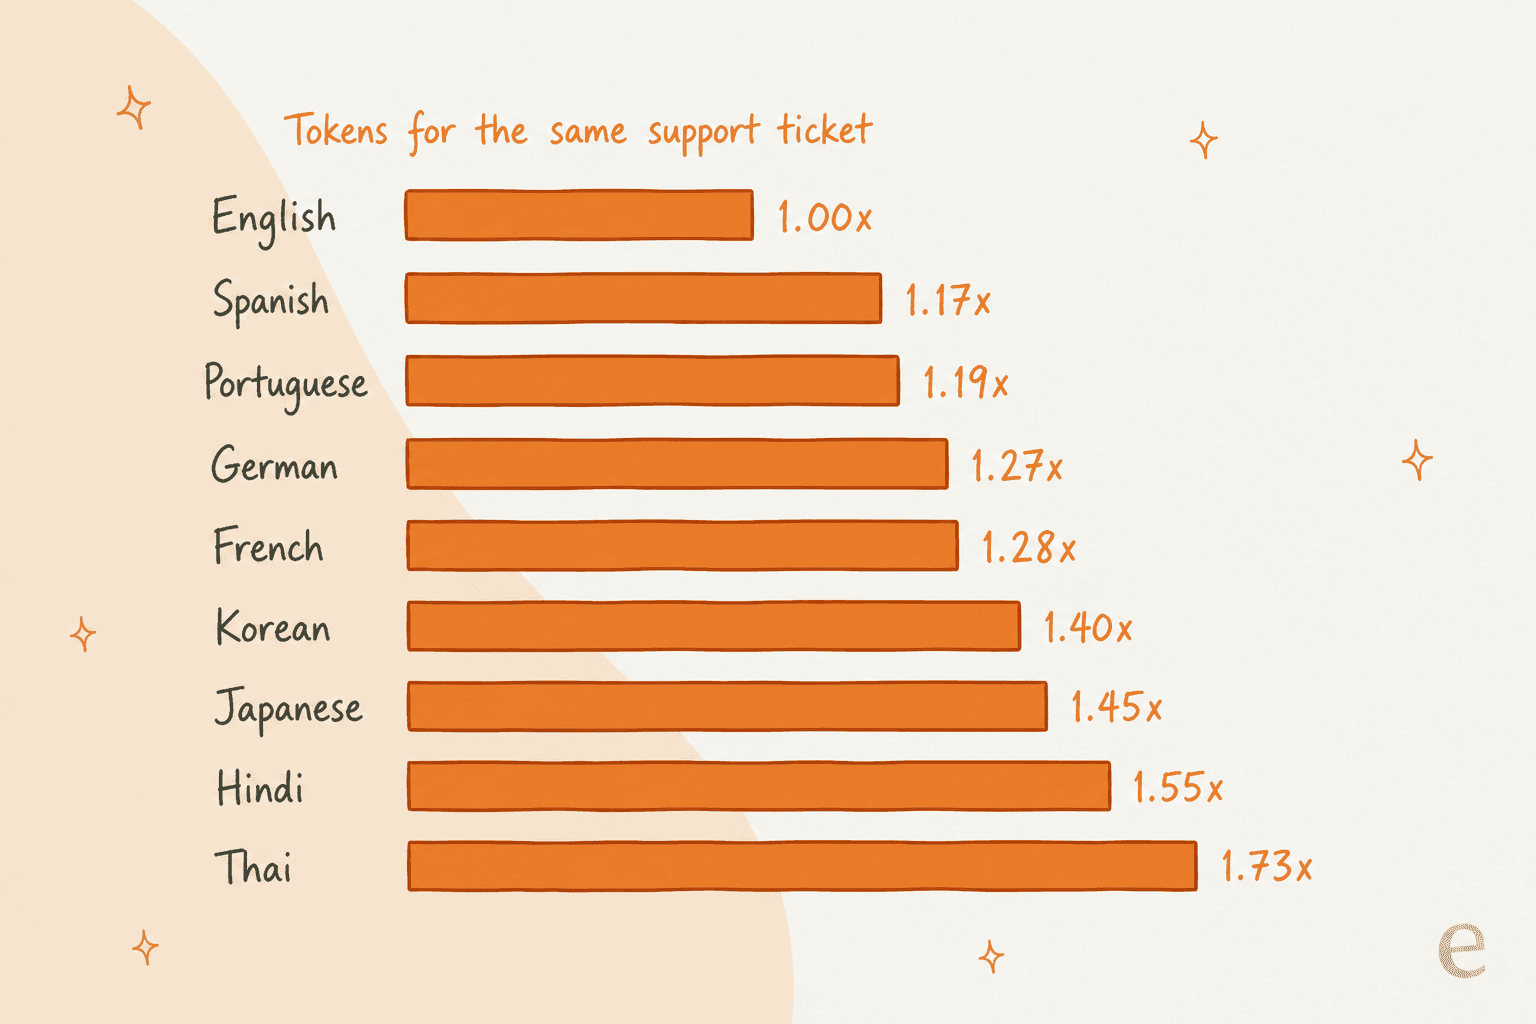
Oui, mais bien moins que ce que la plupart des équipes imaginent. J'ai fait passer le même ticket de support par les modèles actuels d'OpenAI dans 14 langues : l'espagnol a utilisé 1,17x les tokens de l'anglais, l'allemand 1,27x, le japonais 1,45x et le thaï 1,73x. Aux prix actuels des modèles, cela ajoute une fraction de centime par ticket. Le vrai levier, c'est la facturation et la précision. Si votre fournisseur facture par ticket ou par résolution, la différence de tokens n'atteint jamais votre facture, tandis qu'un taux de résolution plus faible dans une langue coûte bien plus en temps humain. eesel facture un crédit par ticket dans n'importe quelle langue, donc ce qu'il faut tester, c'est la qualité des réponses, pas les tokens.
Le support avec l'IA coûte-t-il plus cher dans les langues autres que l'anglais ?
Je construis les agents IA chez eesel, et une grande partie des tickets qu'ils traitent n'est pas en anglais. smava, un comparateur de crédits allemand, fait passer environ 27 000 tickets Zendesk par mois dans eesel, presque tous en allemand, et chacun reçoit une étiquette de langue écrite dans un champ Zendesk avant qu'un conseiller ne le voie. Koffer.ch reçoit des brouillons en allemand, français, anglais et italien, avec l'orthographe suisse. La question « est-ce que ça coûte plus cher en japonais ? » revient donc tout le temps chez les acheteurs que je rencontre.
La réponse honnête comporte deux niveaux. Il y a un coût en tokens faible et bien réel, qui vient de la façon dont les modèles de langage découpent le texte en morceaux. Et il y a un coût opérationnel bien plus important, qui dépend de la qualité de la réponse de l'IA dans cette langue et de la façon dont votre fournisseur facture. La plupart des articles sur ce sujet s'arrêtent au premier niveau. Celui-ci chiffre les deux.
Si vous mettez en place le support client multilingue avec eesel, la CLI eesel permet à un agent IA de développement d'importer les connaissances validées pour chaque marché, comme des articles d'aide exportés en allemand et en japonais, puis de poser des questions test dans chaque langue et de vérifier les réponses avant toute mise en ligne. Connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès admin pour l'approuver.
Combien de tokens en plus chaque langue utilise-t-elle ?
Les modèles de langage ne lisent pas des mots. Ils lisent des tokens, des morceaux de texte qu'un tokenizer découpe dans votre message. L'anglais a reçu le plus d'attention lors de la conception de ces tokenizers, il condense donc le plus de sens dans chaque token. Les autres langues ont besoin de plus de tokens pour dire la même chose, et les API des modèles facturent au token.
Pour obtenir des chiffres réels plutôt que des approximations, j'ai écrit un échange de support réaliste : un client demande où sont ses chaussures de running et s'il peut être remboursé, et un agent répond avec les détails du suivi et la politique de retour. Je l'ai traduit dans 13 langues et compté les tokens de deux façons : avec le tokenizer open source d'OpenAI o200k_base, et avec le point de terminaison de comptage de tokens d'entrée d'OpenAI pour gpt-6.1-terra, gpt-6-luna et gpt-5.4-mini. Les trois modèles actuels ont renvoyé des chiffres identiques (le tokenizer plus six tokens d'enrobage du message), donc une seule colonne couvre toute la gamme actuelle d'OpenAI.
| Langue | Tokens sur les modèles OpenAI actuels | vs anglais | Tokens avec le tokenizer de l'ère GPT-4 (cl100k) | vs anglais |
|---|---|---|---|---|
| Anglais | 166 | 1,00x | 163 | 1,00x |
| Chinois (simplifié) | 182 | 1,10x | 256 | 1,57x |
| Espagnol | 194 | 1,17x | 219 | 1,34x |
| Portugais (Brésil) | 198 | 1,19x | 230 | 1,41x |
| Arabe | 206 | 1,24x | 467 | 2,87x |
| Allemand | 210 | 1,27x | 257 | 1,58x |
| Indonésien | 211 | 1,27x | 257 | 1,58x |
| Français | 213 | 1,28x | 249 | 1,53x |
| Italien | 226 | 1,36x | 253 | 1,55x |
| Vietnamien | 228 | 1,37x | 372 | 2,28x |
| Coréen | 233 | 1,40x | 354 | 2,17x |
| Japonais | 241 | 1,45x | 345 | 2,12x |
| Hindi | 258 | 1,55x | 775 | 4,75x |
| Thaï | 288 | 1,73x | 670 | 4,11x |
Trois choses à retenir :
- La pénalité est réelle, mais modérée sur les modèles actuels. La plupart des langues européennes se situent entre 1,17x et 1,36x. Le japonais et le coréen tournent autour de 1,4x. Seuls le thaï et l'hindi dépassent 1,5x.
- Les anciens tokenizers étaient brutaux. Avec le tokenizer
cl100k_baseutilisé par GPT-4 et GPT-3.5, l'hindi prenait 4,75x et l'arabe 2,87x. Si le bot d'un fournisseur tourne encore sur un modèle ancien, l'écart que vous payez est plusieurs fois plus large que dans la première colonne. - Vos chiffres seront différents. Ceci est un seul ticket. Un ticket en allemand plein de noms de produits composés, ou un ticket japonais très formel, peuvent déplacer les chiffres de quelques points dans un sens ou dans l'autre. Anthropic et Google utilisent leurs propres tokenizers, mesurez donc sur le modèle que vous utilisez réellement. Le point de terminaison de comptage de tokens d'Anthropic est gratuit, et le guide des tokens de Google situe un token Gemini à environ quatre caractères d'anglais.
Qu'est-ce que cela signifie par ticket ?
Un multiplicateur de tokens ne compte qu'une fois rattaché à un prix, et un ticket de support n'est pas seulement le message du client. Il porte aussi vos instructions système et les articles d'aide que l'IA a utilisés pour répondre. Ce contexte est souvent en anglais, et il ne grandit pas quand le client écrit en japonais.
Voici un exemple chiffré avec GPT-6.1 Terra, qu'OpenAI affiche à 1,00 $ le million de tokens d'entrée et 5,00 $ le million de sortie. Mes hypothèses : 3 000 tokens d'instructions et d'articles d'aide en anglais, 1 000 tokens de conversation et une réponse de 400 tokens, sans tokens de raisonnement.
| Configuration | Tokens d'entrée | Tokens de sortie | Coût par ticket | vs anglais |
|---|---|---|---|---|
| Ticket en anglais | 4 000 | 400 | $0,0060 | 1,00x |
| Ticket en japonais, centre d'aide en anglais | 4 450 | 580 | $0,0074 | 1,23x |
| Ticket en japonais, centre d'aide en japonais | 5 800 | 580 | $0,0087 | 1,45x |
| Ticket en japonais, traduit en anglais puis retraduit | 6 250 | 1 980 | $0,0162 | 2,69x |
Deux résultats m'ont surpris la première fois que j'ai fait ce calcul :
- Les connaissances en anglais diluent la pénalité. Quand le centre d'aide reste en anglais, seules la conversation et la réponse coûtent plus cher, donc une langue à 1,45x devient un ticket à 1,23x. Les modèles actuels peuvent répondre en japonais à partir d'articles sources en anglais, et c'est la même idée derrière la façon dont eesel répond aux clients néerlandais, allemands et français d'Innr depuis un seul centre d'aide d'environ
1 500articles et tickets passés. - Le pipeline qui traduit d'abord est le plus coûteux. Traduire le message du client en anglais, répondre en anglais, puis retraduire la réponse ajoute deux appels de modèle, et la traduction est surtout de la sortie, le type de token le plus cher. Dans cet exemple, cela a coûté 2,2x une réponse native en japonais. Les équipes ajoutent souvent une couche de traduction pour économiser et finissent par payer plus.
À 5 000 tickets japonais par mois, la configuration native avec centre d'aide en anglais ajoute 6,75 $ par mois par rapport à l'anglais. C'est toute la « taxe linguistique » sur les tokens. Même avec un modèle premium comme GPT-6 Astra à 10 $ en entrée et 50 $ en sortie par million, cela reste largement sous la centaine de dollars par mois. Si vous construisez sur Anthropic, la même proportion se retrouve sur Claude Haiku 5.5 et Claude Sonnet 5.5.
Qui paie la taxe linguistique, vous ou votre fournisseur ?
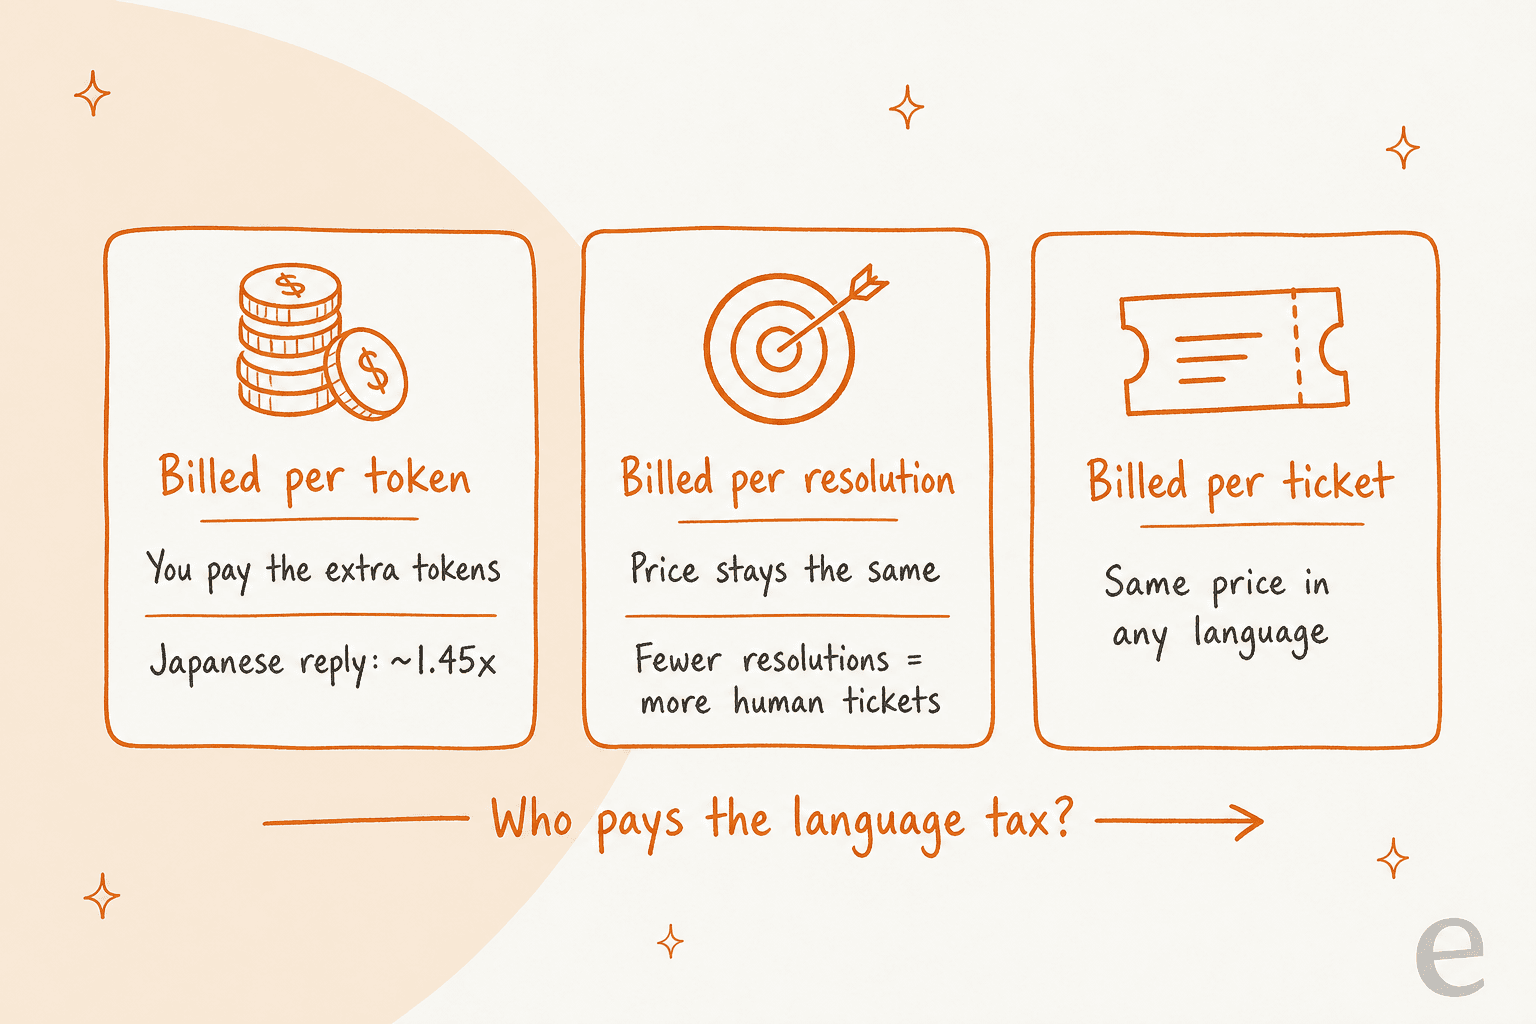
Que ce surcoût en tokens vous atteigne ou non dépend de l'unité sur laquelle votre IA est facturée. Je vois trois modèles de facturation dans le support IA actuellement, et un seul répercute la différence de tokens.
| Modèle de facturation | Qui l'utilise | Prix unitaire | La langue change-t-elle le prix ? |
|---|---|---|---|
| Au token | En direct sur l'API OpenAI, Anthropic ou Google | Varie selon le modèle | Oui, selon le multiplicateur de tokens ci-dessus |
| À la résolution automatisée | Agents IA Zendesk | 1,50 $ avec engagement, 2,00 $ à l'usage | Non |
| À la session IA | Freshdesk Freddy AI Agent | 500 premières sessions incluses, puis 49 $ par 100 | Non |
| À l'interaction automatisée | Gorgias AI Agent | De 0,85 $ à 1,00 $ selon le plan | Non |
| Au ticket traité | eesel | 1 crédit, à partir de 299 $ pour 500 crédits | Non |
Aucune des pages tarifaires que j'ai vérifiées n'affiche de surcharge linguistique. La page tarifaire de Zendesk met en avant la prise en charge de plus de 80 langues sur ses agents IA, au même prix par résolution, et la page tarifaire de Freshworks ainsi que la page tarifaire de Gorgias facturent leurs unités de session et d'interaction de la même manière, quelle que soit la langue.
Cela ne rend pas la langue gratuite sur ces plans. Cela déplace simplement le coût ailleurs :
- À la résolution signifie que vous ne payez que lorsque l'IA résout le ticket. Si elle résout moins de tickets japonais, votre facture IA pour le japonais baisse, et votre facture humaine augmente davantage. Lisez déflexion contre taux de résolution avant de comparer des devis sur cette unité.
- À la session ou à l'interaction facture la tentative, donc une langue plus faible coûte la même chose en IA tout en envoyant quand même plus de tickets à des humains.
- Au ticket est le plus stable. La page tarifaire d'eesel indique qu'un ticket coûte un crédit « quel que soit le nombre d'échanges », donc un long fil en allemand et un court fil en anglais coûtent la même chose.
D'où vient le vrai coût d'un ticket non anglais ?
Une fois qu'on voit que les tokens se chiffrent en centimes, la question de l'argent se déplace vers ce qui coûte des dollars par ticket.
Un taux de résolution plus faible dans certaines langues. C'est le plus gros poste. Si l'IA résout 60 % des tickets anglais mais seulement 50 % des tickets japonais, cet écart de 10 points sur 5 000 tickets représente 500 tickets supplémentaires pour votre équipe chaque mois. À un coût illustratif de 5 $ de temps d'agent par ticket (reprenez votre propre chiffre dans les références de coût par ticket), cela fait 2 500 $ par mois, contre 6,75 $ de tokens supplémentaires. Le simulateur ci-dessous vous permet de tester vos propres chiffres.
Des connaissances dans la langue du client. Traduire un centre d'aide est un coût ponctuel plus un entretien à chaque modification d'article. Souvent, ce n'est pas nécessaire : une IA qui lit des articles en anglais et répond en allemand évite la facture de traduction, et seuls les articles que les clients lisent directement ont besoin d'une version localisée. Ma comparaison des logiciels de base de connaissances multilingues couvre les outils pour ceux qui en ont besoin.
Une terminologie sans traduction propre. Lors d'un appel commercial cette année, une équipe B2B spécialisée dans la télématique de véhicules, en expansion vers de nouveaux marchés de l'UE, s'inquiétait du fait que des termes techniques comme « faisceau de câblage » n'ont pas d'équivalent direct dans certaines langues. C'est un risque de qualité, pas un coût en tokens, et c'est la raison de garder un court glossaire de termes produit par langue dans les instructions de l'IA.
La relecture par des locuteurs natifs. Quelqu'un doit vérifier que la réponse en allemand sonne comme votre marque et non comme un manuel scolaire. Les clients de Koffer.ch attendent l'orthographe suisse en allemand, qu'un modèle générique ratera si on ne le lui précise pas. Prévoyez du temps de relecture par langue les premières semaines, puis passez à l'échantillonnage ; mon guide de QA du support multilingue propose une routine de relecture, et qualité linguistique du support client couvre ce qu'il faut évaluer.
Les salaires locaux changent la comparaison. Un prix fixe par résolution paraît bon marché face à un salaire américain et cher face à un salaire plus bas. Un client Zendesk l'a dit sans détour dans un commentaire sur l'article d'aide de Zendesk lui-même :
"A $1.5 per conversation is viable only for the US/Europe. In our case, we will have to disable the chatbot and look for an alternative solution."
Donc si votre file non anglophone est gérée depuis un marché moins coûteux, comparez le prix unitaire de l'IA avec le coût par résolution réel de cette équipe, pas avec les chiffres de votre siège.
Comment estimer le coût du support avec l'IA par langue ?
Vous pouvez obtenir une estimation fiable par langue en un après-midi. Voici la démarche que je suivrais :
- Prélevez un échantillon de tickets réels par langue. Prenez 100 à 200 tickets récents par langue, avec le même mélange de sujets. Comparer des réinitialisations de mot de passe en anglais à des pannes techniques en japonais fausse le résultat.
- Comptez les tokens sur le modèle que vous utiliserez. OpenAI, Anthropic et Google proposent tous des points de terminaison de comptage de tokens, et celui d'Anthropic est gratuit. Comptez les messages des clients, vos instructions et les articles d'aide que l'IA est susceptible de récupérer, puis comparez chaque langue à l'anglais.
- Vérifiez comment votre fournisseur facture. Si c'est au ticket, à la résolution ou à la session, passez complètement le calcul des tokens ; votre prix unitaire est le même dans toutes les langues. Si vous construisez sur une API brute, multipliez les comptages de tokens par le prix du modèle.
- Testez le taux de résolution par langue. C'est le chiffre qui pèse sur votre budget. Faites tourner l'IA sur des tickets passés dans chaque langue et notez les réponses par rapport à ce que votre équipe a réellement envoyé. Mon guide pour tester un agent IA avant le lancement détaille la démarche, et relire des conversations de support IA couvre les vérifications continues.
- Chiffrez l'écart en temps humain. Multipliez les tickets que l'IA ne résoudra pas dans chaque langue par le coût par ticket de votre équipe. Ajoutez les heures de relecture par des locuteurs natifs pour le premier mois. Ce total, pas le tokenizer, est votre vrai coût du support avec l'IA dans les langues autres que l'anglais.
Si une langue s'avère faible à l'étape 4, la solution tient en général à de meilleures connaissances, pas à un autre modèle : une page de politique manquante, un glossaire produit, ou quelques exemples de réponses dans cette langue. Une fois en ligne, surveillez les taux d'escalade vers un humain par langue, car une hausse à cet endroit est le premier signe que l'IA a du mal sur un marché.
Si vous préférez externaliser toute la file, comparez ces chiffres au coût d'une équipe externalisée dans mon analyse du coût de l'externalisation du service client, et vérifiez d'abord si l'IA peut prendre en charge le support client multilingue pour votre mélange de langues.
eesel pour le support dans toutes les langues
eesel rejoint votre helpdesk comme coéquipier IA pour le support et répond dans la langue utilisée par le client, à partir des connaissances que vous avez déjà, même si elles sont entièrement en anglais. Il fonctionne dans Zendesk, Freshdesk et les autres grands helpdesks, et facture un crédit par ticket dans n'importe quelle langue, donc un fil en allemand et un fil en anglais coûtent la même chose. smava l'utilise pour étiqueter et rédiger des tickets allemands sur deux marques, et Innr reçoit des brouillons en quatre langues depuis un seul centre d'aide.

Vous pouvez connecter votre helpdesk, le faire tourner sur vos tickets passés en allemand ou en japonais, et lire les brouillons avant qu'un client ne les voie. Essayez eesel gratuitement pendant sept jours, sans carte bancaire.
Comment estimer le coût du support avec l'IA par langue ?