Comment j'ai testé ChatGPT Pro 500
Je suis ingénieur logiciel chez eesel et je construis les agents IA du produit eesel. Ce qui m'intéresse dans un forfait, c'est donc ce qui détermine le comportement d'un agent sous charge : la vitesse à laquelle les tokens reviennent, ce que coûte chaque appel et le moment où le compteur se vide. Pro 500 est en grande partie un forfait sur ces points précis. eesel fait tourner depuis des années des teammates IA sur de vraies files de support, et l'habitude que j'y ai prise est simple : avant qu'un agent touche du vrai travail, on le simule sur des tickets passés pour voir ce qu'il aurait fait. J'ai testé Pro 500 dans le même esprit : mesurer avant de faire confiance.
Voici ce que j'ai fait, pour que vous puissiez juger le verdict par vous-même :
- Chronométré Ultrafast moi-même. J'ai passé le même prompt six fois dans GPT-6 Astra via l'API OpenAI, trois sur Standard et trois sur Ultrafast, en mesurant le délai avant le premier token, la vitesse de génération et le temps total. Les résultats sont plus bas.
- Lu chaque page primaire. L'article sur les offres Pro d'OpenAI, ses docs Speed et tarifs Codex, le récapitulatif du DevDay et la page de tarifs de ChatGPT. Chacune est liée à l'endroit où je l'utilise.
- Lu en entier les fils de discussion du lancement. Les
258commentaires du fil Hacker News, plus trois fils Reddit, dont un d'un abonné Pro 500 qui a testé Ultrafast dès le premier jour.
Si vous voulez d'abord comprendre le forfait, l'article explicatif ChatGPT Pro 500 couvre chaque offre, et l'avis sur GPT-6 Astra de mon collègue détaille ce qu'Astra fait bien. Cet article porte plutôt sur le forfait qui l'entoure.
Une réserve honnête à poser d'emblée : j'ai testé Ultrafast via l'API et non via un abonnement Pro 500 dans Codex. La vitesse du modèle est le même produit, mais l'application ChatGPT ajoute son propre surcoût, et OpenAI cite un pic plus élevé pour Codex que pour l'API. Chaque fois qu'une affirmation vient de l'abonnement de quelqu'un d'autre, je le précise.
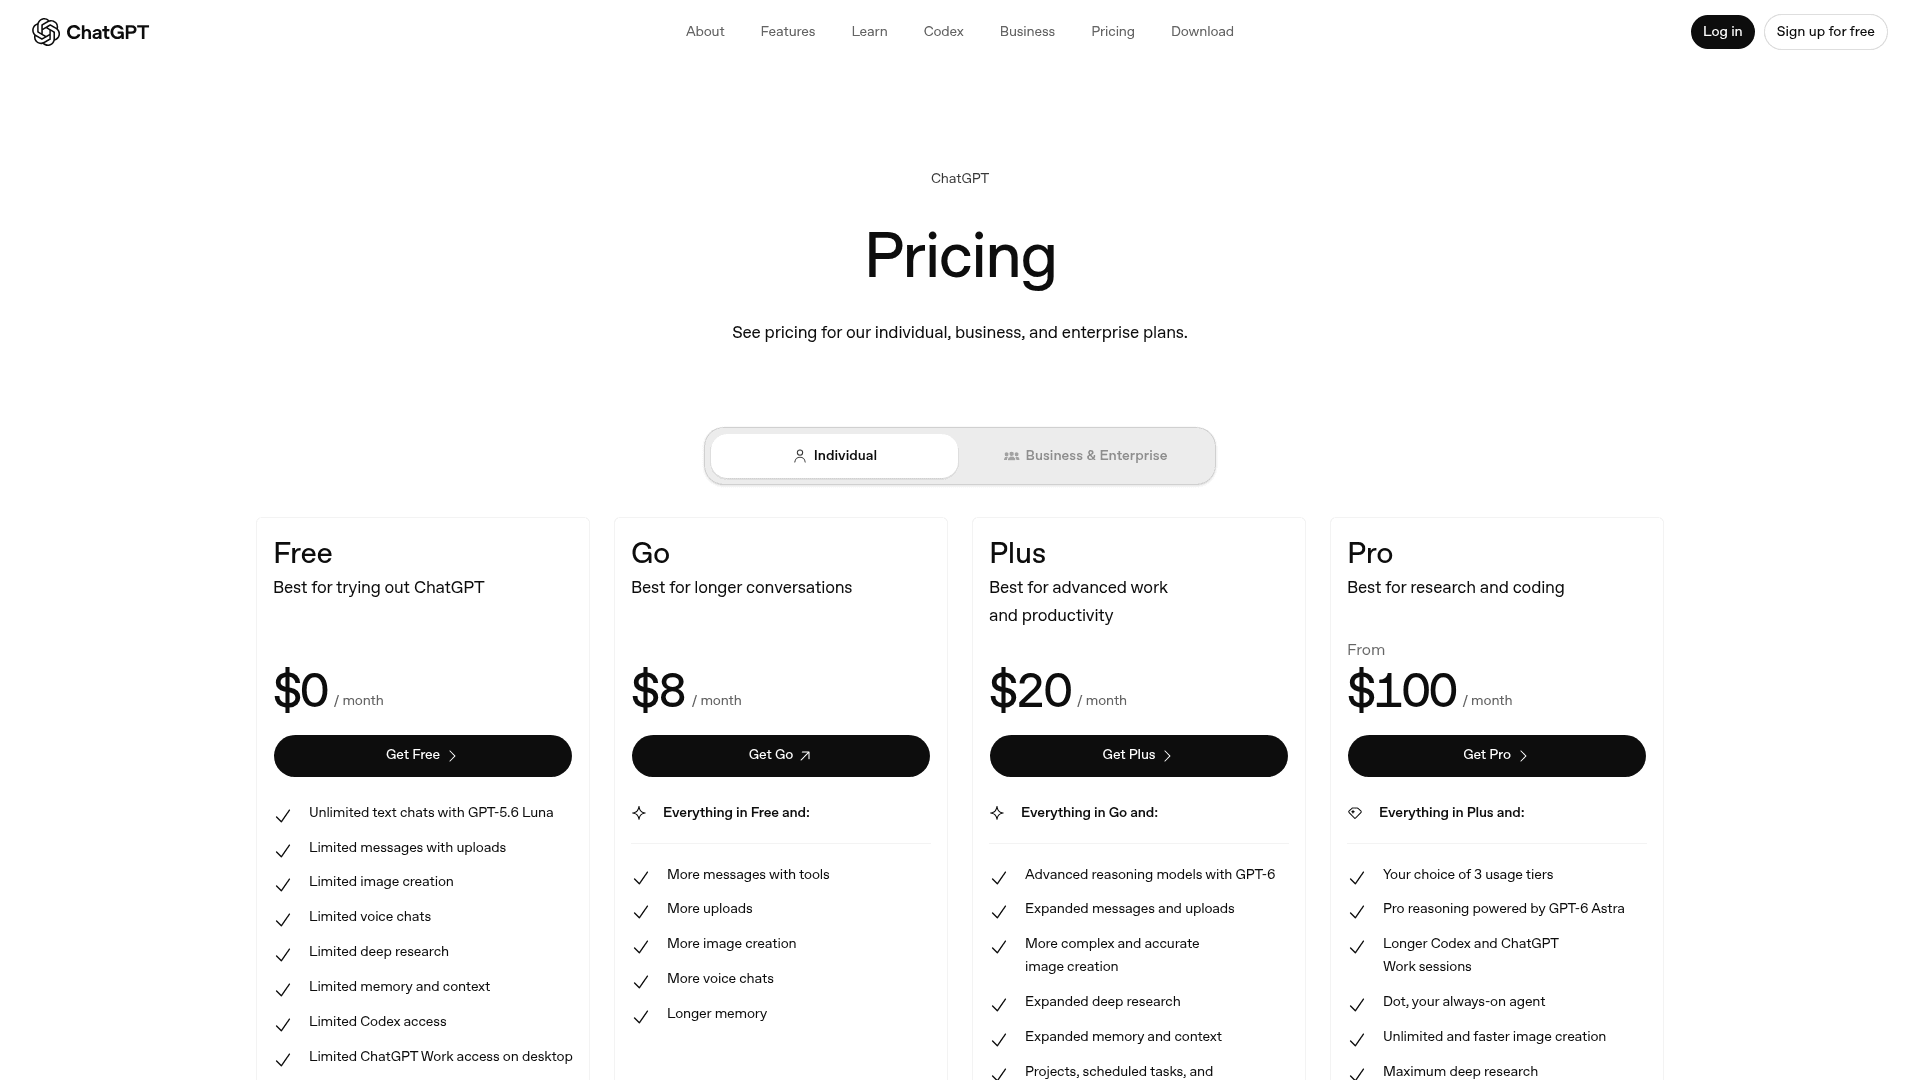
Remarquez ce que la page de tarifs ne montre pas : aucun chiffre d'usage. Elle indique « your choice of 3 usage tiers » et s'arrête là. Les multiples de cet avis viennent de l'article DevDay d'OpenAI et de ses pages d'aide, ainsi que de l'e-mail envoyé aux abonnés Pro 200.
Grille de notation de ChatGPT Pro 500
Voici comment je le noterais, sur les cinq points qui décident si un abonnement IA à 500 $ mérite sa place ou non.
| Domaine | Note | Pourquoi |
|---|---|---|
| Vitesse | 4.5/5 | Ultrafast a atteint en moyenne 153 tokens/s dans mon test, contre 29 sur Standard |
| Marge d'usage | 4/5 | 25x Plus, la plus haute allocation individuelle, et pas de limite de cinq heures sur les forfaits Pro pour l'instant |
| Rapport qualité-prix | 2.5/5 | Mêmes 20 $ par 1x de Plus que toutes les autres offres, et Ultrafast facture à 8x |
| Transparence | 2/5 | Aucun chiffre d'usage sur la page de tarifs ; les multiples se trouvent dans des e-mails, un livestream et un article de blog |
| Adéquation pour la plupart des acheteurs | 2/5 | Conçu pour ceux qui dépassent déjà Pro 200 |
| Global | 3/5 | Un vrai produit pour un acheteur étroit, honnêtement tarifé à l'unité, mal expliqué |
Ce qu'inclut ChatGPT Pro 500
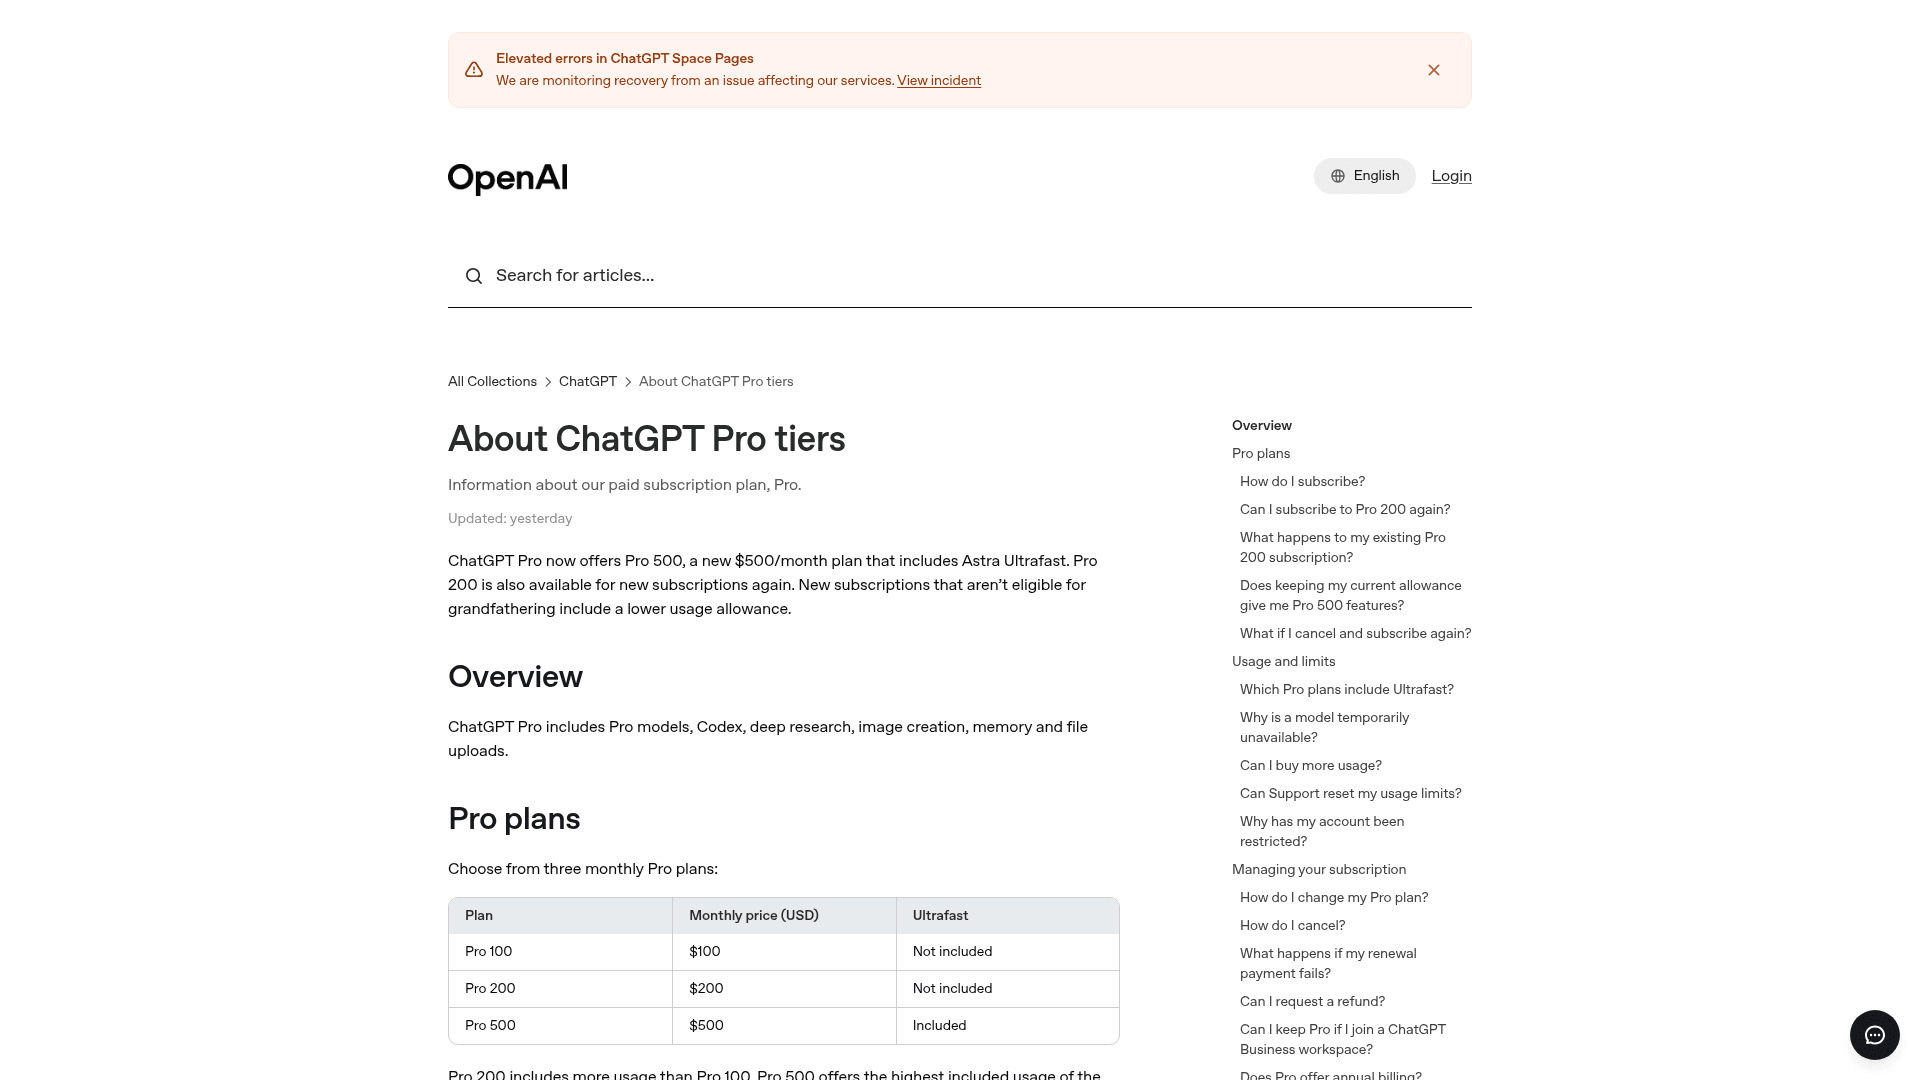
OpenAI vend désormais trois forfaits Pro. Selon l'article sur les offres Pro, tous les trois incluent les modèles Pro, Codex, la recherche approfondie et la création d'images, ainsi que la mémoire et l'import de fichiers. La différence tient à l'usage et à un niveau de vitesse.
| Plus | Pro 100 | Pro 200 | Pro 500 | |
|---|---|---|---|---|
| Prix mensuel | 20 $ | 100 $ | 200 $ | 500 $ |
| Usage Work et Codex vs Plus | 1x | 5x | 10x (20x avant) | 25x |
| Prix par 1x de Plus | 20 $ | 20 $ | 20 $ | 20 $ |
| Astra Ultrafast | Non | Non | Non | Oui |
| Limite de cinq heures | Oui | Aucune pour l'instant | Aucune pour l'instant | Aucune pour l'instant |
| GPT-6 Pro en chat | Non | Allocation hebdomadaire partagée | 100/semaine (200 avant) | Limites Pro les plus élevées |
| Facturation | Mensuelle | Mensuelle uniquement | Mensuelle uniquement | Mensuelle uniquement |
| Votre premier OpenAI dot | Non | Oui, hors EEE/Royaume-Uni/Suisse | Oui, hors EEE/Royaume-Uni/Suisse | Oui, hors EEE/Royaume-Uni/Suisse |
Quelques précisions sur l'origine de ces chiffres, car OpenAI les répartit sur plusieurs pages :
- 25x pour Pro 500 figure dans le récapitulatif du DevDay d'OpenAI : « our highest usage allowance at 25 times the ChatGPT Plus allowance. »
- 5x pour Pro 100 provient du tableau d'usage de l'article d'OpenAI sur l'usage d'Astra, dont les colonnes sont encore intitulées « Pro 5x » et « Pro 20x ».
- 10x pour Pro 200 provient de l'e-mail qu'OpenAI a envoyé aux abonnés Pro 200, cité plus bas. Le centre d'aide lui-même dit seulement que les nouveaux abonnements Pro 200 « include a lower usage allowance ».
- Pas de limite de cinq heures est indiqué sur la page de tarifs de Codex : « Pro plans currently have no five-hour limit. » Les limites hebdomadaires s'appliquent toujours.
- Mensuel uniquement. « Pro is billed monthly. Annual billing and payment for multiple months in advance are not available », selon l'article sur les offres Pro.
Il existe un petit trou dans la documentation qu'il vaut mieux connaître : l'article d'OpenAI sur GPT-6 Pro liste GPT-6 Pro en chat pour « Pro $100, Pro $200, Business and Enterprise plans » et ne nomme pas Pro $500 dans cette phrase. Le même article dit que les forfaits Pro à plus grande allocation obtiennent des limites plus élevées sur les modèles Pro, donc j'y vois plutôt une mise à jour oubliée qu'une fonctionnalité absente. Si GPT-6 Pro en chat est la raison principale de votre achat, vérifiez le sélecteur de modèle avant de vous engager.
Le changement de Pro 200 est la vraie histoire
L'essentiel de la colère dans les fils du lancement ne concerne pas vraiment Pro 500, mais ce qui est arrivé à Pro 200 le même jour. Un commentateur de Hacker News a posté les lignes pertinentes de l'e-mail d'OpenAI :
"Starting October 30, 2026, your included usage in ChatGPT Work and Codex will decrease from 20 times to 10 times the ChatGPT Plus allowance. Your GPT-6 Pro limit in Chat will decrease from 200 to 100 messages per week. Your price remains unchanged and you'll keep your current limits through October 29, 2026."

Dans l'article sur les offres Pro, OpenAI explique que l'allocation réduite reflète « our increasingly efficient models ». Les abonnés existants conservent l'ancienne allocation jusqu'au 29 octobre 2026, tant que leur Pro 200 reste actif. L'allocation en question est partagée entre ChatGPT Work et Codex, ce qui signifie qu'une baisse sur l'un est une baisse sur les deux.
Ce contexte change la lecture de Pro 500. Avant cette semaine, 20x coûtait 200 $, et maintenant 25x coûte 500 $. Pro 500, c'est 25 % d'usage de plus que l'ancien Pro 200 pour 2,5x le prix. Si on le compare au nouveau Pro 200, en revanche, la tarification est parfaitement linéaire :
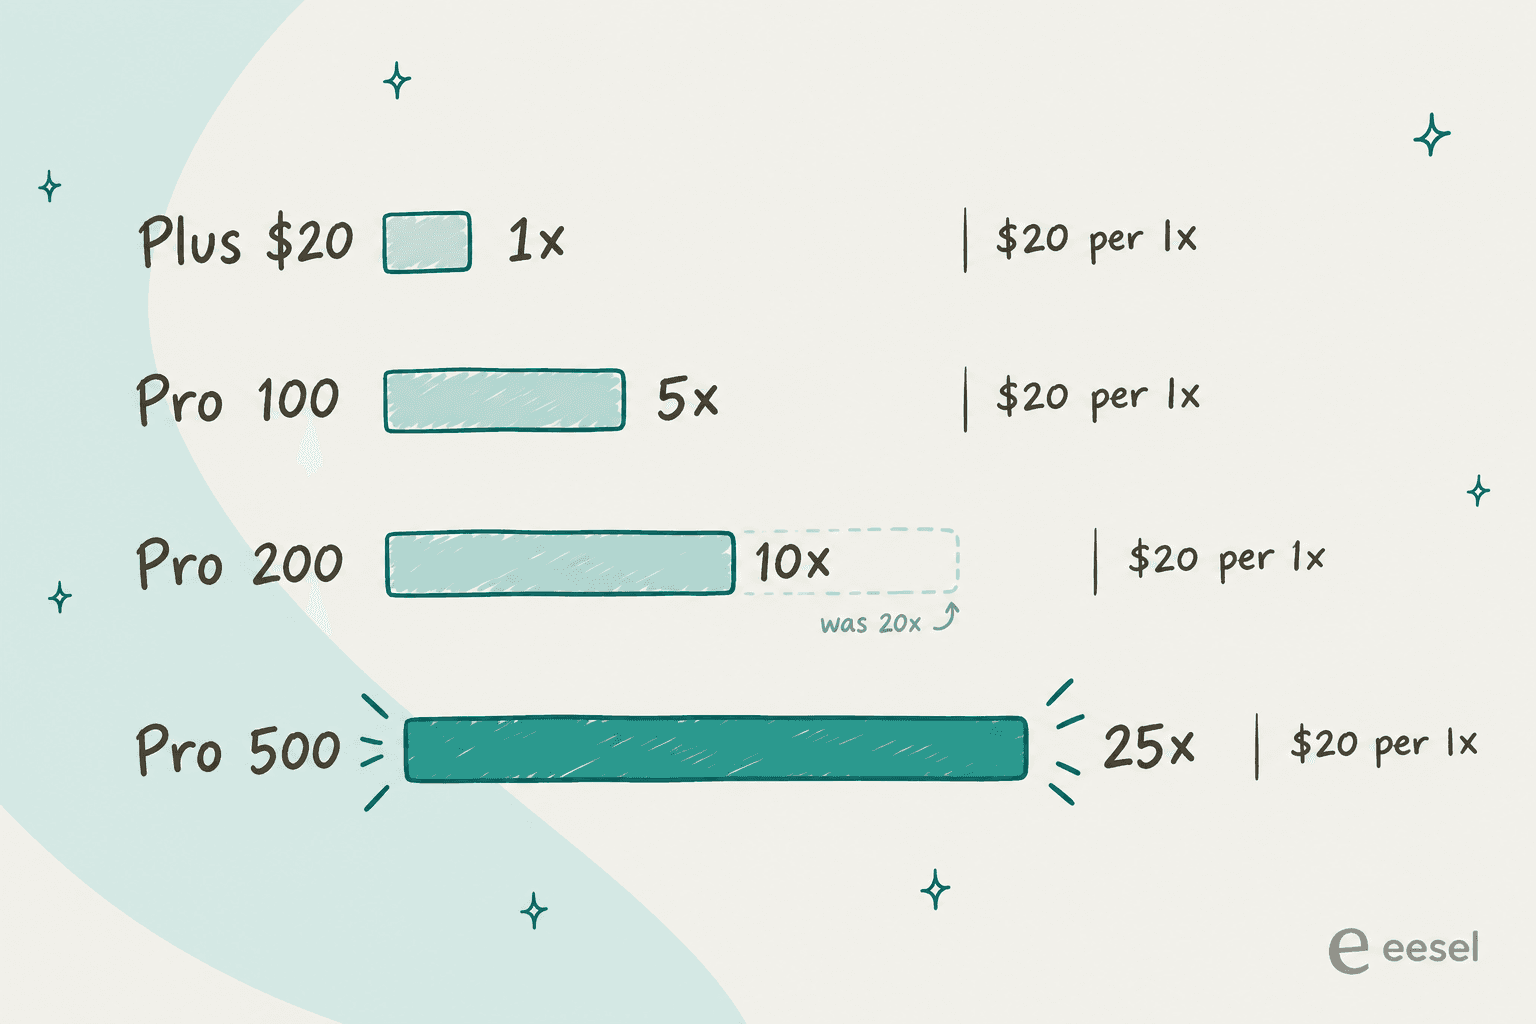
"ChatGPT Plus: 1x usage, $20. Pro 100: 5x usage, $100. Pro 200: 10x usage, $200 (previously was 20x usage, $200). Pro 500: 25x usage, $500. So, essentially scaling is equal."
C'est le résumé en une ligne le plus juste que j'aie lu. Aucune remise sur volume ne vous attend en haut. Avec Pro 500, vous n'achetez pas un usage moins cher, vous en achetez davantage dans un seul compte, plus Ultrafast par-dessus.
Les abonnés existants ont aussi reçu de quoi adoucir le changement. Un autre commentateur a cité un crédit ponctuel de « 62,500 usage credits (a $2,500 USD value) » qui expire le 31 décembre 2026, d'après le même fil d'e-mails sur Hacker News. Ce crédit est utile pour une deuxième raison, car il révèle qu'un crédit vaut 4 cents. Aux tarifs en crédits publiés par OpenAI, GPT-6 Astra coûte 250 crédits par million de tokens en entrée et 1 250 par million en sortie, soit 10 $ en entrée et 50 $ en sortie, comme les tarifs API d'Astra.
J'ai testé Ultrafast : quelle est sa vraie vitesse ?
Ultrafast est la fonctionnalité phare, alors je suis allé la mesurer. Le 1er octobre 2026, j'ai envoyé le même prompt (une explication d'environ 600 mots sur le tri d'un arriéré de 500 tickets, en prose simple) à gpt-6-astra via l'API OpenAI Responses, en streaming, avec un faible effort de raisonnement. Trois exécutions sur Standard, trois avec service_tier: "ultrafast", en alternance pour qu'aucune ne profite d'une minute plus calme sur les serveurs.
| Exécution | Mode | Délai avant le premier token | Vitesse de génération | Temps total | Tokens de sortie |
|---|---|---|---|---|---|
| 1 | Standard | 5.6s | 29.3 tok/s | 30.7s | 820 |
| 1 | Ultrafast | 1.7s | 139.0 tok/s | 6.9s | 799 |
| 2 | Standard | 3.7s | 30.1 tok/s | 28.0s | 771 |
| 2 | Ultrafast | 1.6s | 162.8 tok/s | 6.1s | 727 |
| 3 | Standard | 2.8s | 28.6 tok/s | 28.7s | 769 |
| 3 | Ultrafast | 1.8s | 156.0 tok/s | 6.4s | 745 |
| Moyenne | Standard | 4.0s | 29.3 tok/s | 29.1s | 787 |
| Moyenne | Ultrafast | 1.7s | 152.6 tok/s | 6.5s | 757 |
La vitesse de génération a augmenté d'environ 5,2x, et la requête entière s'est terminée 4,5x plus tôt. Le premier token est aussi arrivé plus de deux fois plus vite, et c'est ce que l'on ressent le plus quand on est assis devant un terminal à regarder.
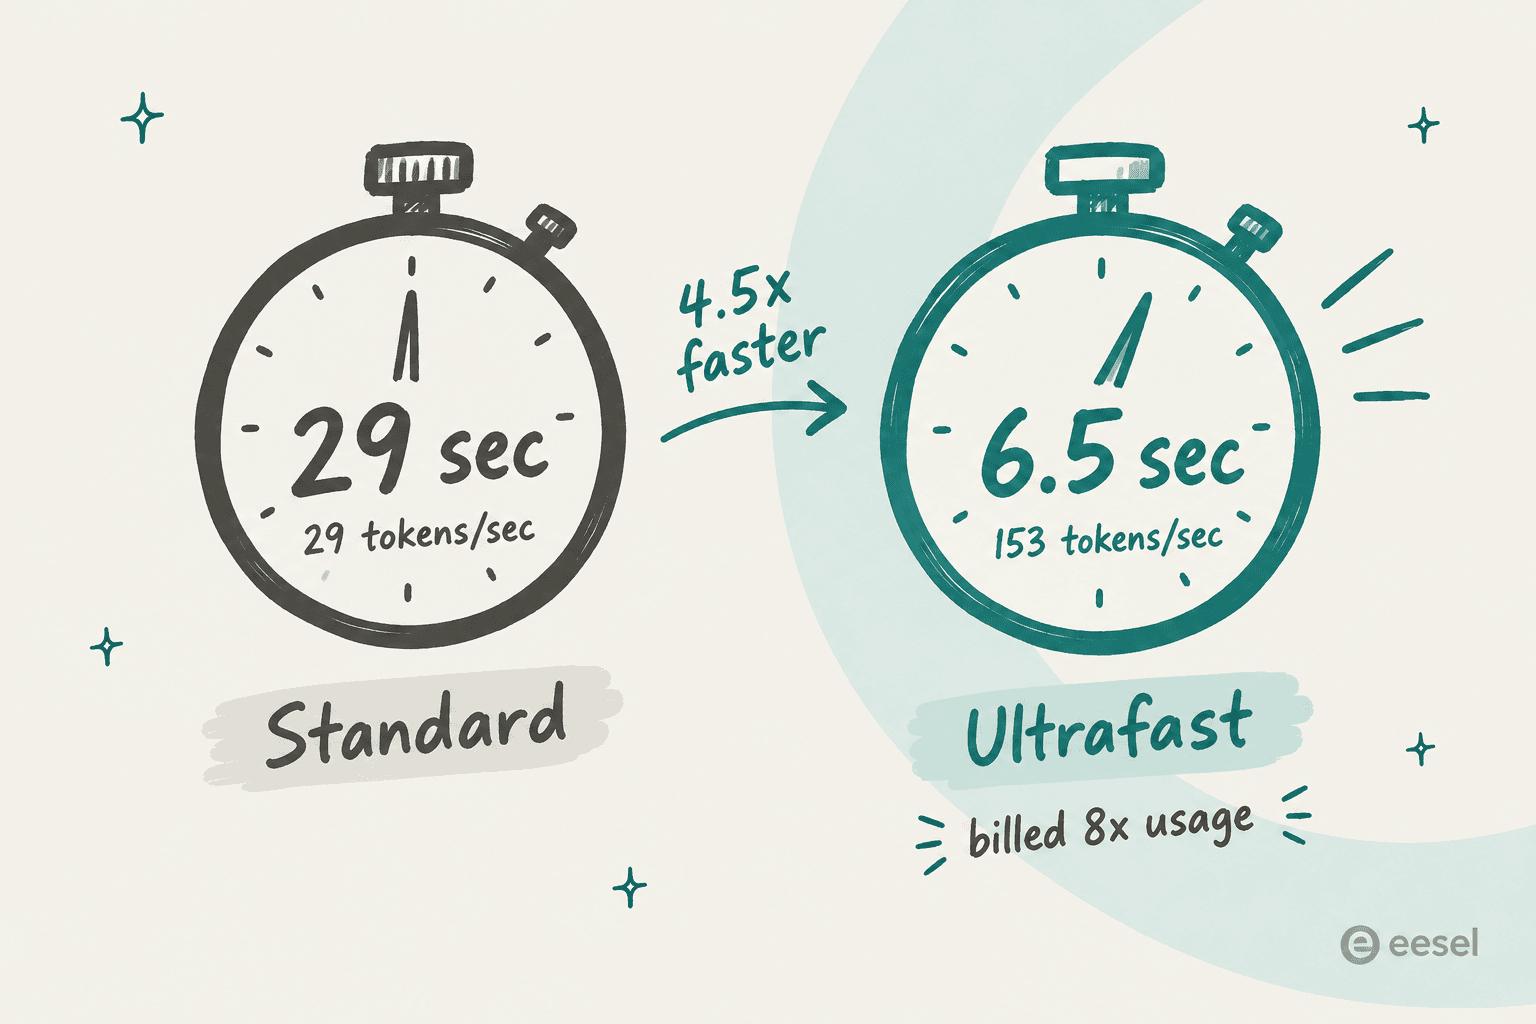
Alors, comment cela se compare-t-il au marketing ? Le récapitulatif du DevDay d'OpenAI dit qu'Ultrafast offre « up to 8× faster token generation (300 tokens per second) in Codex and up to 6x in the API. » Mes exécutions via l'API ont atteint environ 5,2x sur la vitesse de génération et n'ont jamais approché 300 tokens par seconde, ce qui reste dans le « up to » et constitue un résultat honnête pour un prompt court. Les docs Speed d'OpenAI sont elles aussi prudentes sur ce point : le chiffre 8x « measures token generation speed, not billing rates or overall task completion time. »
Cette réserve compte beaucoup pour le travail d'agent. Une longue tâche Codex passe son temps en appels d'outils, lectures de fichiers et exécutions de tests, que rien dans Ultrafast n'accélère. L'écriture pure, comme dans mon test, est proche du meilleur cas.
Où va votre usage : le compteur 8x
Voici la partie de Pro 500 que la couverture du lancement a surtout passée sous silence, et c'est aussi celle que j'aimerais voir expliquée avant de payer 500 $.
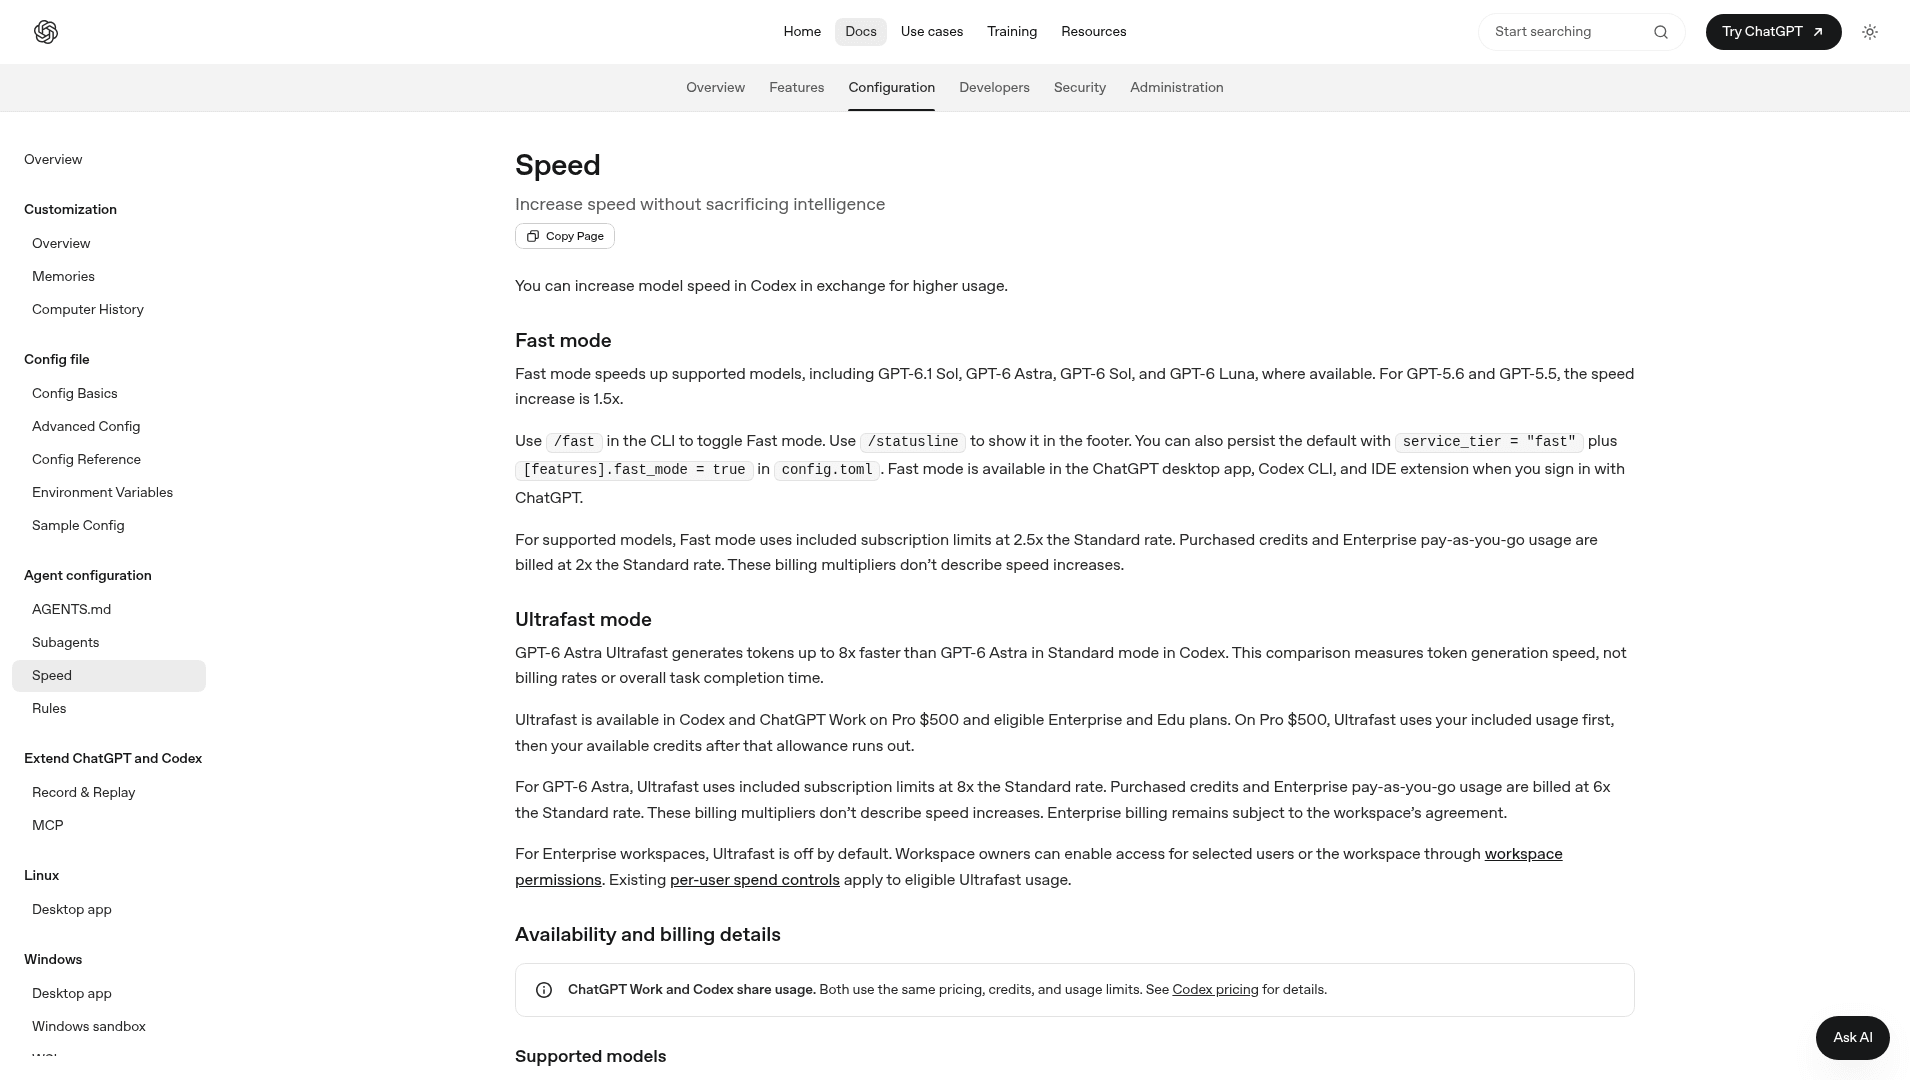
Selon les docs Speed, Ultrafast « uses included subscription limits at 8x the Standard rate. » Les crédits achetés sont facturés à 6x. Le mode Fast, l'option plus modérée, utilise les limites incluses à 2,5x. Sur Pro 500, Ultrafast dépense d'abord votre usage inclus et ne passe à votre solde de crédits qu'ensuite.
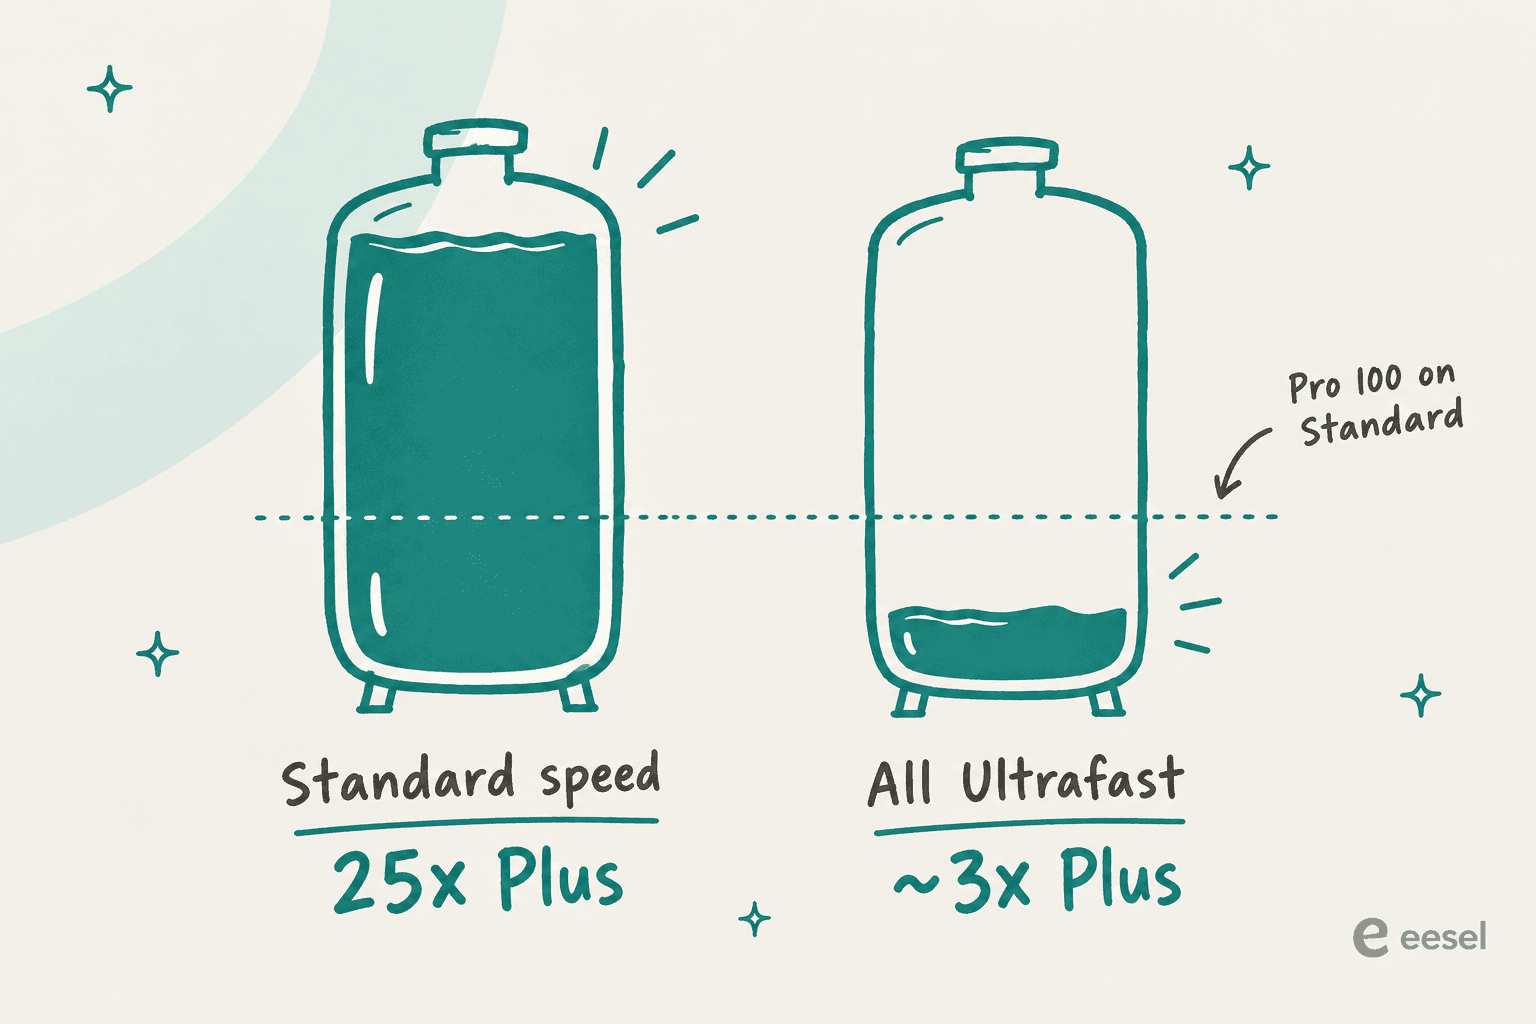
Faites donc la division vous-même. Pro 500 vous donne 25x Plus, et à 8x par tâche, une semaine entièrement sur Ultrafast représente environ 3x Plus de travail avec Astra. C'est moins que ce que Pro 100 vous donne à vitesse Standard, pour cinq fois le prix.
Les retours du premier jour concordent avec le calcul. Un message r/codex d'un nouvel abonné Pro 500, plébiscité 472 fois, montre le compteur hebdomadaire chuter de 17 % en cinq minutes :
"I was running on ultra fast and Astra 6 ultra (just wanted to see). Not sure what I expected but more for $500. I was using it to create a 3d figure with comfyui and blender."

Pour être juste envers OpenAI, cette session cumulait tous les réglages coûteux à la fois : le modèle le plus capable à son niveau « Ultra » et sur Ultrafast. Une réponse dans le même fil a calculé combien de travail à vitesse Standard cette rafale représente. Elle utilise le tarif de 6x en crédits, alors que sur l'usage inclus la doc dit 8x, ce qui aggrave légèrement le résultat :
"If you're going by time it worked, its 8x as fast so 5 minutes = the amount of tokens you would have burned in 45 minutes at normal speed, and you're paying 6x the cost on top of that...so the amount of work done would have lasted you 4.5 hours at normal speeds."
Un second abonné Pro 500, dans un autre fil, a rapporté le même schéma, cette fois sans les réglages extrêmes :
"Pro 500 here, usage went down as fast as pro 20x, 3-4 hours and I'm down to 28% for the week"
Mon interprétation : traitez Ultrafast comme un taxi et non comme une voiture que vous possédez. Ça vaut le coup pour la période où attendre vous coûte de l'argent, et c'est du gaspillage comme réglage par défaut.
Le levier moins cher que la plupart des gens ratent
Si vous achetez Pro 500 pour la marge, le modèle que vous choisissez fait plus bouger le compteur que le forfait. La table de crédits d'OpenAI tarife GPT-6.1 Sol à 50 crédits par million de tokens en entrée et 250 par million en sortie, contre 250 et 1 250 pour Astra. Cela fait un cinquième du coût par token. La page de tarifs de Codex estime 15-160 messages locaux par cinq heures sur Plus pour GPT-6.1 Sol contre 5-45 pour Astra.
L'e-mail d'OpenAI fait aussi cet argument, en présentant 6.1 Sol comme offrant « near-Astra capabilities » pour l'usage courant. L'avis sur GPT-6.1 Sol de mon collègue a testé cette affirmation. La liste complète des modèles OpenAI montre où se situe chacun. La version pratique : utilisez Sol par défaut, passez à Astra pour les problèmes difficiles, et gardez Ultrafast pour les moments où vous attendez vraiment. Ainsi, les 10x de Pro 200 vont bien plus loin que le titre ne le laisse penser.
ChatGPT Pro 500 vaut-il 500 $ ?
Comme chaque offre coûte le même prix par unité, la question n'est pas « Pro 500 est-il un bon rapport qualité-prix ». C'est « avez-vous besoin d'autant dans un seul compte, et la vitesse se rentabilise-t-elle ? » Choisissez votre situation ci-dessous :
Quelle offre ChatGPT Pro vous convient ?
D'après les offres et multiples publiés par OpenAI au 1er octobre 2026.
Trois types d'acheteurs s'en sortent mieux avec Pro 500.
L'utilisateur multi-comptes. Beaucoup de gros utilisateurs de Codex paient deux forfaits Pro ou plus juste pour avoir assez de capacité. Un compte à 25x est plus simple que deux à 10x, et le prix unitaire est le même.
"Among my circle, it's not uncommon for people to have multiple $200 accounts. This seems like it would make things easier for them by letting them use one account instead of juggling two or more."
La personne dont le temps est facturé. Si une attente de 30 secondes se produit des centaines de fois par jour, les 4,5x d'Ultrafast peuvent valoir le compteur 8x. Un commentateur du fil r/ChatGPT a exprimé clairement le point de vue de l'employeur : « 6k is potentially a few weeks of salary for an employee », ajoutant que son entreprise avait « paid 3k this weekend on resets » (matRmet, Reddit).
Le testeur de l'API Agents. Le récapitulatif du DevDay indique que l'utilisation d'ordinateur dans l'API Agents est disponible dans Codex et ChatGPT Work « on Pro 500 and Enterprise ». Si vous développez sur l'API Agents et voulez d'abord essayer l'utilisation d'ordinateur dans Codex, Pro 500 est la voie individuelle.
Pour tous les autres, le forfait ne mérite pas la dépense supplémentaire, y compris la plupart de ceux qui sont arrivés ici en se demandant s'ils « devraient » être sur l'offre la plus haute.
Ce que disent les utilisateurs de Pro 500
La réaction au lancement a été bruyante et surtout négative, même si l'essentiel de la colère visait la baisse de Pro 200 plus que Pro 500 lui-même. Trois thèmes revenaient sans cesse.
Les chiffres sont difficiles à trouver. Plusieurs personnes ont cherché les multiples sur les pages d'OpenAI sans les trouver :
"Does anyone see the usage limits? I don't see anything indicating how much usage is in each tier."
C'est une plainte légitime, et c'est la raison pour laquelle la grille abaisse la note de transparence. Quelqu'un qui dépense 6 000 $ par an devrait pouvoir lire l'allocation directement sur la page de tarifs, sans avoir à la reconstituer à partir d'un e-mail.
Pro 500 est apparu comme une hausse de prix, pas comme une nouvelle offre. Un chef de petite entreprise qui a deux forfaits Pro 200 l'a présenté en mettant l'ancienne offre à côté de la nouvelle :
"before: 400$ == 40x now: 500$ == 25x"
Certains changent ou répartissent. Sur les deux plateformes, un plan revenait souvent : redescendre à Pro 100 et ajouter un second fournisseur. Si vous y réfléchissez, les analyses de mes collègues sur les tarifs de Claude et les tarifs de Claude Code couvrent le côté d'Anthropic, et la comparaison ChatGPT vs Claude couvre les modèles.
Le seul thème que je contesterais est « c'est une arnaque ». Ce n'en est pas une. Le prix à l'unité est le même que sur toutes les autres offres, OpenAI a bien publié les multiples d'Ultrafast dans sa documentation, et l'usage supplémentaire est réel. Ce qui manque, c'est une explication claire sur la page où les gens achètent réellement.
Pro 500 face aux alternatives
Si vous avez lu jusqu'ici et que vous n'êtes toujours pas sûr que Pro 500 soit pour vous, voici les alternatives réalistes, soit pour le même budget, soit pour le même travail.
| Option | Prix | Ultrafast | Usage | Idéal pour |
|---|---|---|---|---|
| Pro 500 | 500 $/mois | Oui | 25x Plus, pas de limite de cinq heures | Gros utilisateurs solo de Codex |
| Pro 200 | 200 $/mois | Non | 10x Plus (20x jusqu'au 29 oct. si maintenu) | Usage quotidien de Codex sans buter sur les limites |
| Pro 100 | 100 $/mois | Non | 5x Plus | Usage régulier plus votre premier dot |
| Clé API OpenAI | Au token | Oui, comme niveau de service | Paiement à l'usage | Scripts, CI, coût par appel prévisible |
| ChatGPT Business Premium | 100 $/place/mois en annuel | Non au lancement | Allocation de la place Premium | Équipes qui ont besoin d'administration et de non-entraînement sur les données |
| ChatGPT Enterprise | Contrat | Désactivé par défaut, l'admin peut l'activer | Crédits ou limites de débit | Entreprises qui ont besoin d'Ultrafast par utilisateur |
Deux points de ce tableau méritent un examen plus attentif.
D'abord, l'API. Avec une clé API, Codex utilise la tarification API au token et les multiples de crédits ChatGPT ne s'appliquent pas, d'après les docs Speed. Pour un travail par à-coups ou automatisé, payer Ultrafast au token peut revenir moins cher qu'un abonnement à 500 $ que vous n'utilisez qu'à moitié. Mon guide des tarifs de l'API OpenAI donne les tarifs par modèle.
Ensuite, les équipes. Pro est un forfait individuel. L'article d'OpenAI sur les offres Pro indique que le partage d'identifiants et la revente d'accès sont interdits par ses conditions. Si une équipe partage un seul identifiant Pro 500, c'est un problème de politique avant d'être un problème de coût. Ultrafast n'est pas non plus disponible pour les espaces de travail qui exigent une résidence d'inférence hors des États-Unis.
Pour une vue plus large des outils de code à ce prix, consultez le comparatif des meilleurs assistants de code IA et l'analyse des tarifs de Cursor.
Mon verdict sur ChatGPT Pro 500
Achetez Pro 500 si vous heurtez le mur hebdomadaire de Pro 200 la plupart des semaines, ou si vous payez déjà deux comptes Pro. Utilisez-le à vitesse Standard par défaut, prenez GPT-6.1 Sol pour le travail courant et n'activez Ultrafast que lorsque l'attente a un prix. Utilisé ainsi, c'est un forfait correct.
Passez votre chemin si vous montez en gamme pour Ultrafast seul. Ultrafast est rapide, environ 4,5x dans mon test, mais à 8x d'usage il transforme 25x Plus en environ 3x. C'est un luxe pour les échéances, pas une façon de travailler au quotidien.
Attendez si vous êtes un abonné Pro 200 maintenu. Vous gardez 20x jusqu'au 29 octobre 2026. Profitez de ce mois pour mesurer votre usage hebdomadaire réel sur le tableau de bord, puis choisissez l'offre qui y correspond.
La leçon plus large de ce lancement ne concerne pas vraiment OpenAI. Quand la valeur d'un forfait s'exprime en « Nx d'un autre forfait », avec un multiple fixé par le fournisseur et modifiable par e-mail, vous achetez une cible mouvante. C'est acceptable pour un outil de code personnel, mais plus difficile à supporter pour un travail dont d'autres dépendent, et c'est là que j'aimerais une unité que je peux compter.
eesel, pour un travail que vous pouvez compter
Si cet avis vous a laissé en train de penser « je veux juste savoir combien coûtera une semaine de travail », c'est exactement le problème autour duquel eesel est construit. eesel est une plateforme de teammates IA : vous embauchez un teammate prêt à l'emploi pour une tâche, comme le teammate IA de helpdesk qui rejoint Zendesk, Freshdesk ou Gorgias, ou le rédacteur de blog IA. Chacun arrive déjà formé à votre contexte, et avant qu'il réponde à un vrai client, vous pouvez le simuler sur vos propres tickets passés.
L'unité de facturation est quelque chose autour de quoi un responsable peut planifier. Un ticket ou un chat vaut un crédit, que la conversation prenne une réponse ou dix. Il existe un forfait gratuit avec 100 crédits, puis des forfaits teammate à partir de 299 $/mois pour 500 crédits, le tout sur la page de tarifs publique. J'ai assisté à des appels commerciaux où cela comptait plus que n'importe quelle fonctionnalité : une entreprise de matériel informatique traitant environ 250 tickets par mois avait vu le prix d'un précédent fournisseur plus que doubler, et voulait un prix garanti par écrit avant toute autre chose.

Et si vous achetez Pro 500, vous vivez probablement déjà dans Codex. Le CLI eesel vous permet de lancer le même teammate depuis un terminal : eesel activity liste chaque exécution, eesel approvals list montre ce qui attend un humain, et chaque commande affiche du JSON avec une option --dry-run, de sorte qu'un agent de code comme Codex ou Claude Code puisse le scripter en toute sécurité. En plus, chaque espace de travail fonctionne comme un serveur MCP.
L'article sur le CLI d'agent IA détaille cette configuration, et le guide des teammates IA explique le modèle. Quand vous serez prêt, essayez eesel et regardez un teammate répondre à vos vrais tickets passés avant qu'il touche un ticket en direct.
Questions fréquentes
ChatGPT Pro 500 vaut-il le coup ?
Quel usage ChatGPT Pro 500 inclut-il ?
Quelle est la vitesse d'Ultrafast sur ChatGPT Pro 500 ?
Pourquoi Ultrafast épuise-t-il si vite ma limite ChatGPT Pro 500 ?
Qu'est-ce qui a changé pour ChatGPT Pro 200 au lancement de Pro 500 ?
ChatGPT Pro 500 propose-t-il une facturation annuelle ou une version équipe ?
ChatGPT Pro 500 est-il moins cher que l'API OpenAI ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.