

Para revisar conversaciones de soporte con IA, lee cada escalamiento, cada conversación con CSAT bajo, cada ticket reabierto y cada conversación de reembolso o política, más una muestra aleatoria de 20 a 30 de las marcadas como resueltas, porque "resuelta" a menudo solo significa que el cliente dejó de responder. Comprueba cada una para ver si la respuesta fue correcta y con fuente, si siguió la política, las acciones, el momento de la transferencia y el tono. Luego etiqueta la causa raíz (falta de conocimiento, falta de instrucciones, acción incorrecta, transferencia tardía), arréglala en esa fuente y repite los mismos tickets pasados antes de que el cambio salga a producción. Revisa a diario la primera semana, luego semanalmente. eesel muestra las fuentes y el razonamiento detrás de cada respuesta y repite tickets resueltos sin enviar nada.
¿Por qué "resuelta" no significa que la IA lo hizo bien?
Trabajo en la cola de soporte de eesel, y lo que más he aprendido a desconfiar es de una insignia verde de "resuelta". Un agente de IA puede cerrar una conversación con una respuesta fluida, educada y equivocada, y nada en el panel se inmuta. El cliente o se rinde, o vuelve enfadado dos días después por otro canal.
Los propios proveedores lo dicen. HubSpot fija el estado de resolución de una conversación del agente de clientes 72 horas después de la última respuesta del visitante, y un comentario negativo posterior "no cambiará el estado de resolución". La misma página es tajante: "Los desvíos no siempre indican una resolución." El nuevo panel de evaluación de calidad de Zendesk, publicado el 10 de noviembre de 2026, puntúa la comprensión y la empatía, y luego advierte que "la comprensión no significa que el problema se haya resuelto". La diferencia entre desvío y resolución tiene su propio artículo.
Así se ve desde el lado del operador, según un equipo que opera un bot de soporte autoalojado:
"just ast week a customer sent a screenshot where the bot told him accidental damage was covered under warranty and we'd repair it for free. It isn't and we don't. The doc it pulled was about the extended plan, which he doesn't have, and the bot blended the two we had to honor it ... haunting part is nothing in our logs looked obviously wrong. The answer was fluent and on topic, it was just built on the wrong chunk"

eesel ha visto el mismo patrón en sus propias implementaciones. En una prueba, un equipo de soporte técnico B2B vio cómo el agente le decía a los clientes que un producto estaba soportado cuando no lo estaba, porque un artículo de ayuda decía, literalmente, "soportamos todos los modelos". El agente no se lo inventó. Leyó una frase demasiado amplia y la repitió con confianza. Ese tipo de fallo solo se detecta cuando una persona lee la conversación junto a la fuente.
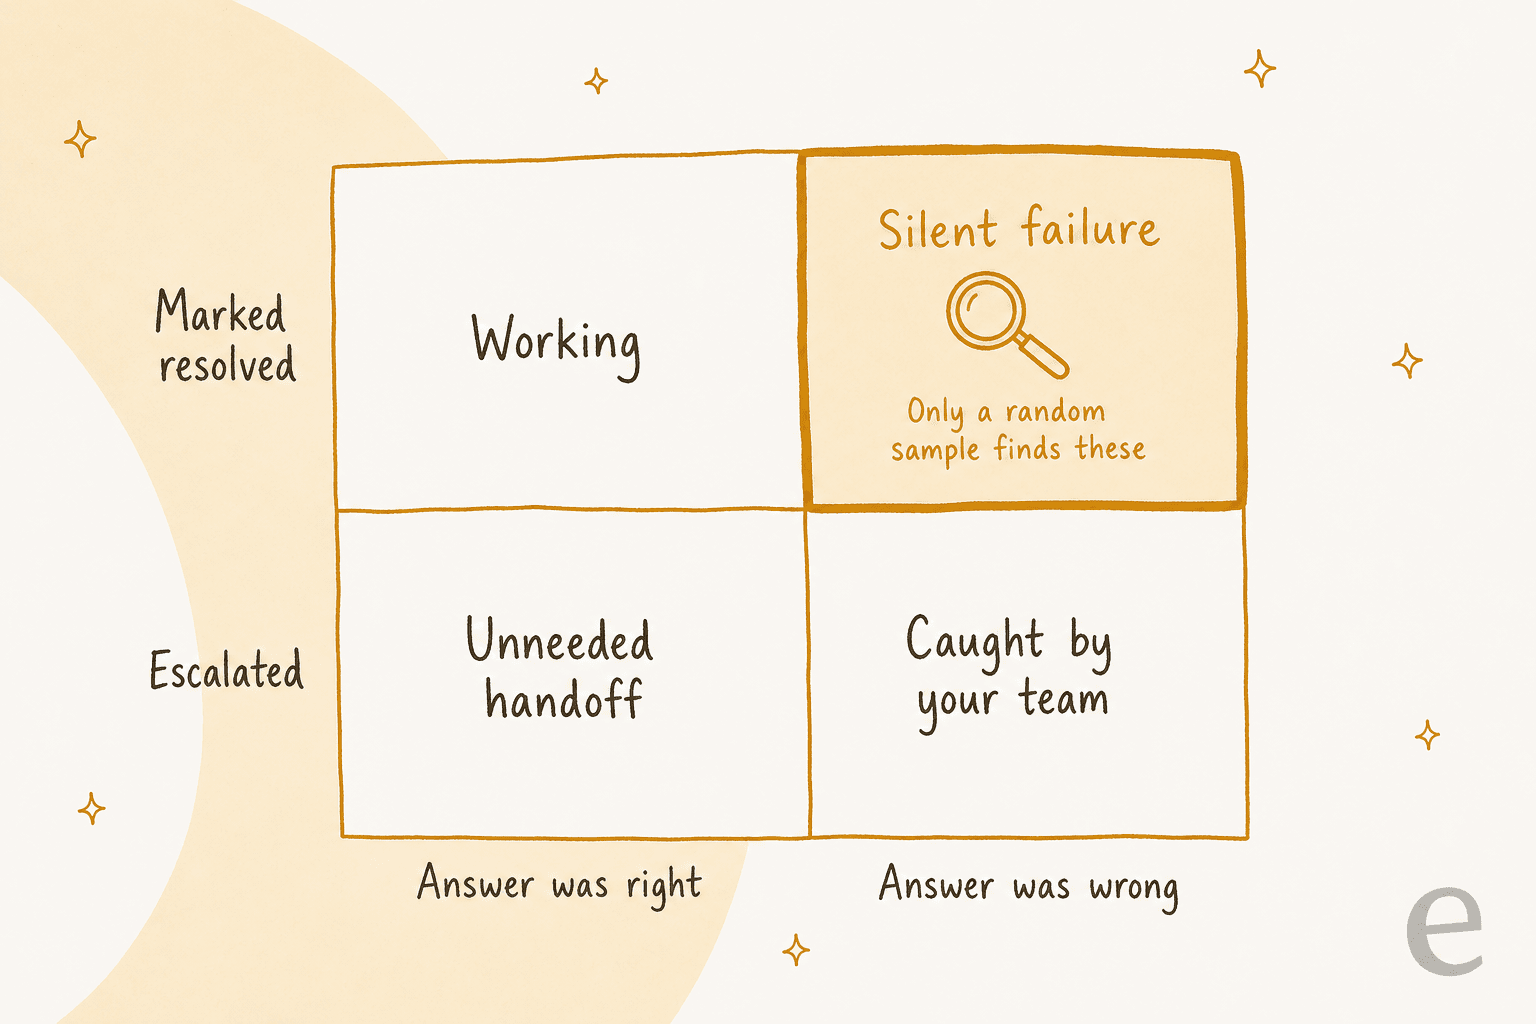
Los escalamientos llegan a tu equipo de todos modos. Los fallos silenciosos del cuadro superior derecho no, por eso la rutina de abajo dedica parte de su tiempo a conversaciones que parecen normales. Es un trabajo distinto del control de calidad de soporte para agentes humanos: no estás guiando a una persona, estás averiguando qué entrada recibió el agente que era incorrecta.
Si tu equipo usa agentes de codificación, la CLI de eesel permite que uno participe en este ciclo. Después de arreglar una regla, el agente puede enviar la corrección con eesel chat, volver a leer la regla guardada con eesel instructions, y luego volver a hacer las preguntas de los tickets que fallaron y revisar las respuestas antes de que nada cambie para los clientes. Conectar la mesa de ayuda en primer lugar sigue necesitando que alguien con acceso de administrador lo apruebe.
¿Qué conversaciones de soporte con IA deberías revisar?
No puedes leerlo todo, y no deberías intentarlo. Una responsable de CX en una marca de suplementos con unos 7.000 tickets al mes lo dijo claramente en una llamada con el equipo de ventas de eesel:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
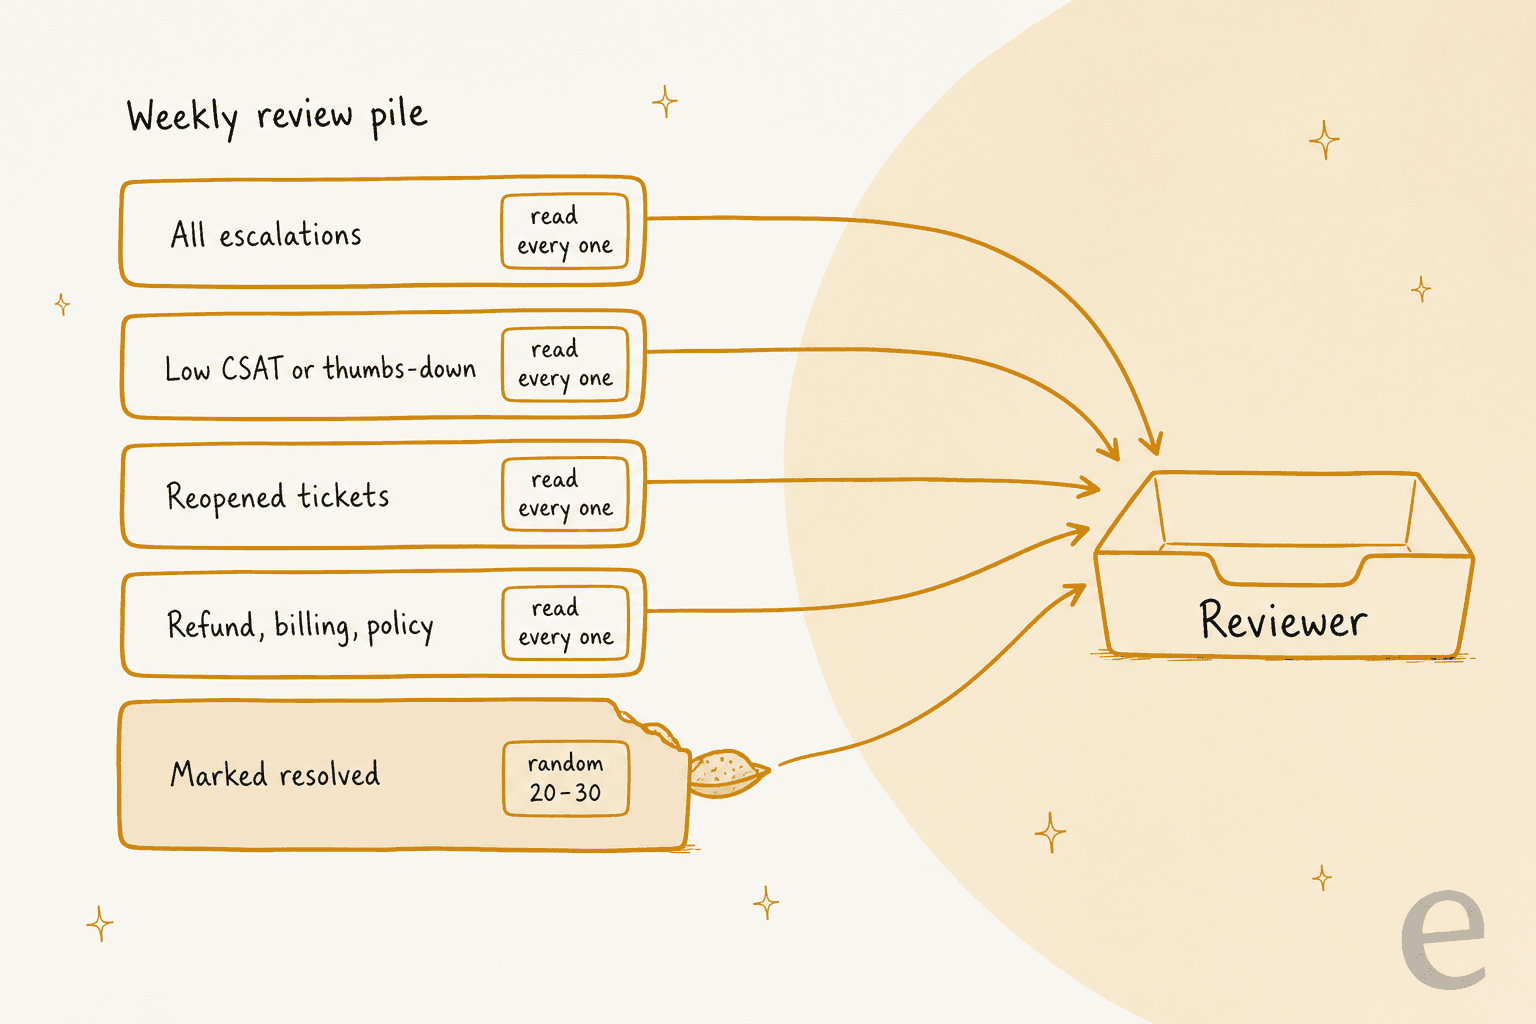
Tiene razón con las matemáticas. La respuesta es un plan de muestreo con dos partes: lee cada conversación en los grupos de riesgo, y toma una pequeña muestra aleatoria del gran grupo de "resueltas".
| Cesta | Cuántas leer | Por qué está en el montón |
|---|---|---|
| Todos los escalamientos y transferencias | Todas | Muestra lo que el agente no pudo hacer, y si se rindió demasiado pronto o demasiado tarde |
| CSAT bajo o pulgar hacia abajo | Todas | Los clientes te están diciendo que algo salió mal, incluso si el ticket se cerró |
| Tickets reabiertos | Todas | La respuesta no se sostuvo. A menudo una respuesta incorrecta o parcial marcada como resuelta |
| Temas de reembolso, facturación y política | Todas al principio | Una respuesta incorrecta aquí cuesta dinero o una promesa que debes cumplir |
| Muestra aleatoria de "resueltas" | 20 a 30 por semana | La única forma de encontrar fallos silenciosos |
Una nota sobre el CSAT: una puntuación de satisfacción generada por IA no es lo mismo que preguntarle al cliente. La propia documentación de eesel dice que "el CSAT de IA no es feedback del cliente" en su página de informes, y lo trata solo como una señal interna. Usa respuestas reales de CSAT para IA cuando las tengas.
De dónde las sacas depende de tu mesa de ayuda, y cada una de las principales ya tiene un lugar para ello:
- Zendesk. Los registros de conversación están en Optimize > Monitoring > Conversation logs y muestran los últimos 7 días por defecto. Los filtros encajan bien con las cestas anteriores: mensajes no entendidos, abandonos, escalamiento fallido, BSAT y si se usó una respuesta de la base de conocimiento. La guía de registros de conversación de Zendesk los recorre.
- Freshdesk. En AI Agent Studio, Analyze > Ticket logs filtra por estado, incluida la transferencia a un agente, y separa las conversaciones reales de las pruebas de vista previa. El propio consejo de Freshdesk es que "leer dos o tres conversaciones reales es la forma más rápida" de confirmar que un tema está fallando (documentación de Freshdesk). Más sobre sus análisis aquí.
- Gorgias. La vista de tickets de AI Agent tiene una sección To review que recoge todos los tickets en los que AI Agent envió una respuesta, y una etiqueta
ai_failed_actionpara acciones fallidas (documentación de Gorgias). Un ticket etiquetado tanto conai_answeredcomo conai_handovermerece leerse primero: respondió y aun así escaló. - HubSpot. El agente de clientes agrupa los fallos en Analyze > Coaching opportunities, con el mensaje exacto que no pudo responder resaltado en rojo.
Un detalle práctico: las últimas 72 horas aún están en movimiento. Gorgias solo cobra una interacción como automatizada una vez que han pasado 72 horas sin transferencia humana, y HubSpot espera esas mismas 72 horas. Toma las conversaciones de la semana pasada, no las de ayer, para lo que planees contar.
¿Qué deberías comprobar en cada conversación?
Seis comprobaciones por conversación. La mayoría toman segundos una vez que te acostumbras. La lenta es la de fuentes, y es la que detecta los fallos tipo garantía.
| Comprobación | Qué mirar | Señal de alarma |
|---|---|---|
| Respuesta correcta | ¿Tu mejor agente habría dicho lo mismo? | Tema correcto, detalle incorrecto (plan, región, fecha, importe) |
| Basada en una fuente | ¿Qué artículo, macro o ticket anterior usó? | Sin fuente, la fuente equivocada o dos fuentes mezcladas |
| Política respetada | Plazos de reembolso, elegibilidad, qué necesita aprobación | Prometió algo que tu política no permite |
| Acciones ejecutadas correctamente | Reembolsos, cancelaciones, etiquetas, búsquedas de pedidos | Una acción se ejecutó en el pedido equivocado, o falló en silencio |
| Momento de la transferencia | Cuándo escaló, y qué decía la nota de transferencia | Dio vueltas después de que el cliente pidiera una persona, o la nota no coincide con la transcripción |
| Tono | ¿Suena como tu equipo? | Exceso de disculpas, robótico, o alegre con un cliente molesto |
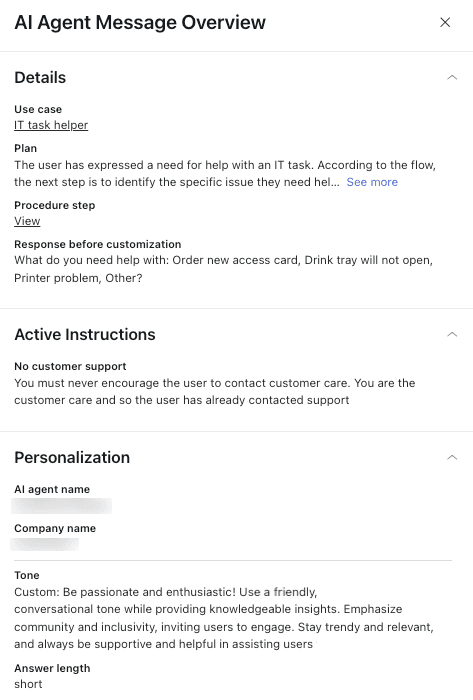
La comprobación de fuentes necesita el trabajo del agente, no solo su respuesta. El View details por mensaje de Zendesk muestra el Plan del agente, la respuesta antes de la personalización y las Active instructions que siguió, que es cómo distingues un problema de conocimiento de uno de instrucciones.
En la comprobación de política, presta especial atención al dinero. Si tu agente puede emitir reembolsos, lee todas las conversaciones de reembolso durante el primer mes, marcadas o no. El artículo sobre límites de reembolso cubre qué límites van en la configuración en lugar de en el prompt.
Trata la nota de transferencia como una comprobación aparte. Es fácil leer la respuesta de la IA, ver que escaló, y seguir adelante. Pero la nota que recibe tu agente humano también puede estar equivocada:
"My place added an AI bot that handles the chat first and gives the summary of what the client said to the agent, but the thing is, its summaries are often just lies that it hallucinated lol. It just makes up stuff that the customer never said, and you still have to check the whole history."
Compara el resumen con la transcripción. Si no coinciden, es un fallo aunque el escalamiento en sí fuera correcto. El artículo sobre buenas prácticas de transferencia cubre qué contiene una buena nota.
El tono es la última comprobación y la más fácil de sobrevalorar. Una respuesta algo rígida pero correcta gana a una cálida pero equivocada. Arregla el tono en bloque cuando tengas varios ejemplos, usando una regla de voz de marca en lugar de ediciones puntuales.
¿Cómo etiquetas lo que salió mal?
Cuando una conversación falla una comprobación, dale una etiqueta de causa raíz. La etiqueta decide a dónde va el arreglo, y el error habitual es arreglarlo todo en el prompt. Yo uso cuatro etiquetas:
- Conocimiento faltante o desactualizado. El dato no estaba en ninguna fuente, o la fuente era incorrecta.
- Falta de instrucciones. Los hechos eran correctos, pero el agente hizo algo mal con ellos.
- Acción o permiso incorrecto. Ejecutó, omitió o estropeó una acción, o se le permitió hacer algo que no debía.
- Debería haber transferido. Siguió adelante cuando debía intervenir una persona, o transfirió algo que podía haber respondido.
Tu mesa de ayuda puede que ya tenga una versión de esto. Las oportunidades de coaching de HubSpot clasifican los fallos por Reason: Knowledge, Handoff, Experience, Action y Other (documentación de HubSpot). Zendesk te deja añadir etiquetas a las conversaciones y advierte contra una etiqueta única por conversación, ya que las etiquetas están "pensadas para agrupar conversaciones para su análisis". Mantén tus etiquetas en una lista corta y fija para que los recuentos signifiquen algo.
Una trampa que debes conocer: en algunas herramientas, calificar una conversación no cambia al agente en absoluto. Gorgias dice que sus calificaciones Bad, Okay y Good "no cambian de inmediato cómo se comporta AI Agent en las conversaciones con tus clientes"; para cambiar el comportamiento, en su lugar califica o añade fuentes (documentación de Gorgias). Las opciones de feedback integradas de Zendesk para respuestas generativas (Incomplete answer, Made-up facts, Missing article, etc.) van a los investigadores de IA de Zendesk. Ambas son útiles, pero ninguna es un arreglo de tu lado.
Elige abajo un tipo de fallo para ver cómo se ve en una transcripción, a dónde va el arreglo en cada mesa de ayuda, y cómo volver a probarlo.
Elige un tipo de fallo para ver a dónde va su arreglo en Zendesk, Freshdesk, Gorgias, HubSpot y eesel.
La mejor prueba de este enfoque que conozco es Qontro, que fabrica software ERP y usa eesel en Freshdesk como copiloto. El equipo compara cada borrador de eesel con la respuesta que realmente envió una persona. Cuando el borrador estaba mal, suele señalar un artículo de ayuda faltante o incompleto, o una regla que hay que ajustar, y arreglan eso en lugar del ticket individual. Alrededor de uno de cada diez borradores sale ahora con poca o ninguna edición, y la proporción va subiendo despacio. Esas son las cuatro etiquetas funcionando en la práctica, con unos 190 tickets de Freshdesk redactados al mes.
Cuando una etiqueta aparece una y otra vez, aléjate de los tickets individuales. Mucho "conocimiento faltante o desactualizado" significa que es hora de una auditoría de la base de conocimiento, y la IA puede ayudar detectando contenido desactualizado antes de que el agente lo repita.
¿Cómo lo arreglas y lo vuelves a probar antes de que salga a producción?
Arréglalo en la fuente que señala la etiqueta, y luego repite los mismos tickets pasados que fallaron. No preguntas nuevas que te inventes, los tickets reales. Un arreglo que pasa tu propia pregunta de prueba igual puede fallar con la redacción del cliente, y los tickets que fallaron son exactamente la redacción que ya sabes que rompe las cosas.
Un comentarista describió el hábito que hace que esto se acumule:
"Keep the transcript reads too, but let them compound instead of evaporate: every escalation like this becomes a case in a small regression set, re-run on every prompt, chunking, or model change, so the failure classes you've already paid for stay fixed."
Cada mesa de ayuda vuelve a probar de forma algo distinta, y la diferencia importa:
| Herramienta | Dónde vuelves a probar | Cuáles son las preguntas de prueba |
|---|---|---|
| Zendesk | Widget de prueba y el simulador de conversación | Escenarios de una biblioteca o escritos por ti |
| Freshdesk | Pestaña Test, hasta 100 consultas por ejecución | Consultas pegadas, o 50 generadas a partir de tu conocimiento |
| Gorgias | Playground, incluidas las Draft Skills y los artículos | Mensajes que escribes, como cliente nuevo o existente |
| HubSpot | Pruebas por lotes, hasta 8 conjuntos de prueba | Generadas a partir de conversaciones reales (5+ similares por tema) o escritas por ti |
| eesel | Simulación de la mesa de ayuda | Tus tickets resueltos y pasados, puntuados contra lo que envió tu equipo |
Gorgias añade una advertencia que vale la pena copiar en tu propio manual: si activas acciones en una prueba, "pueden afectar datos reales de clientes y pedidos" (documentación de Gorgias). Usa un perfil de cliente falso.
La razón por la que eesel trabaja a partir de tickets pasados es que es lo más parecido a un ensayo en tu cola real. Su simulación repite tickets resueltos, redacta una respuesta para cada uno, la pone junto a lo que envió tu equipo, y agrupa los resultados por tema. "No envía nada a los clientes", según la documentación de eesel. La ejecución de ejemplo en la documentación de la mesa de ayuda muestreó 20 tickets resueltos, coincidió con 17 de ellos, y devolvió cinco arreglos clasificados. Esa lista de 3 de 20 fallos es exactamente el montón de revisión que quieres antes de que los clientes vean nada.
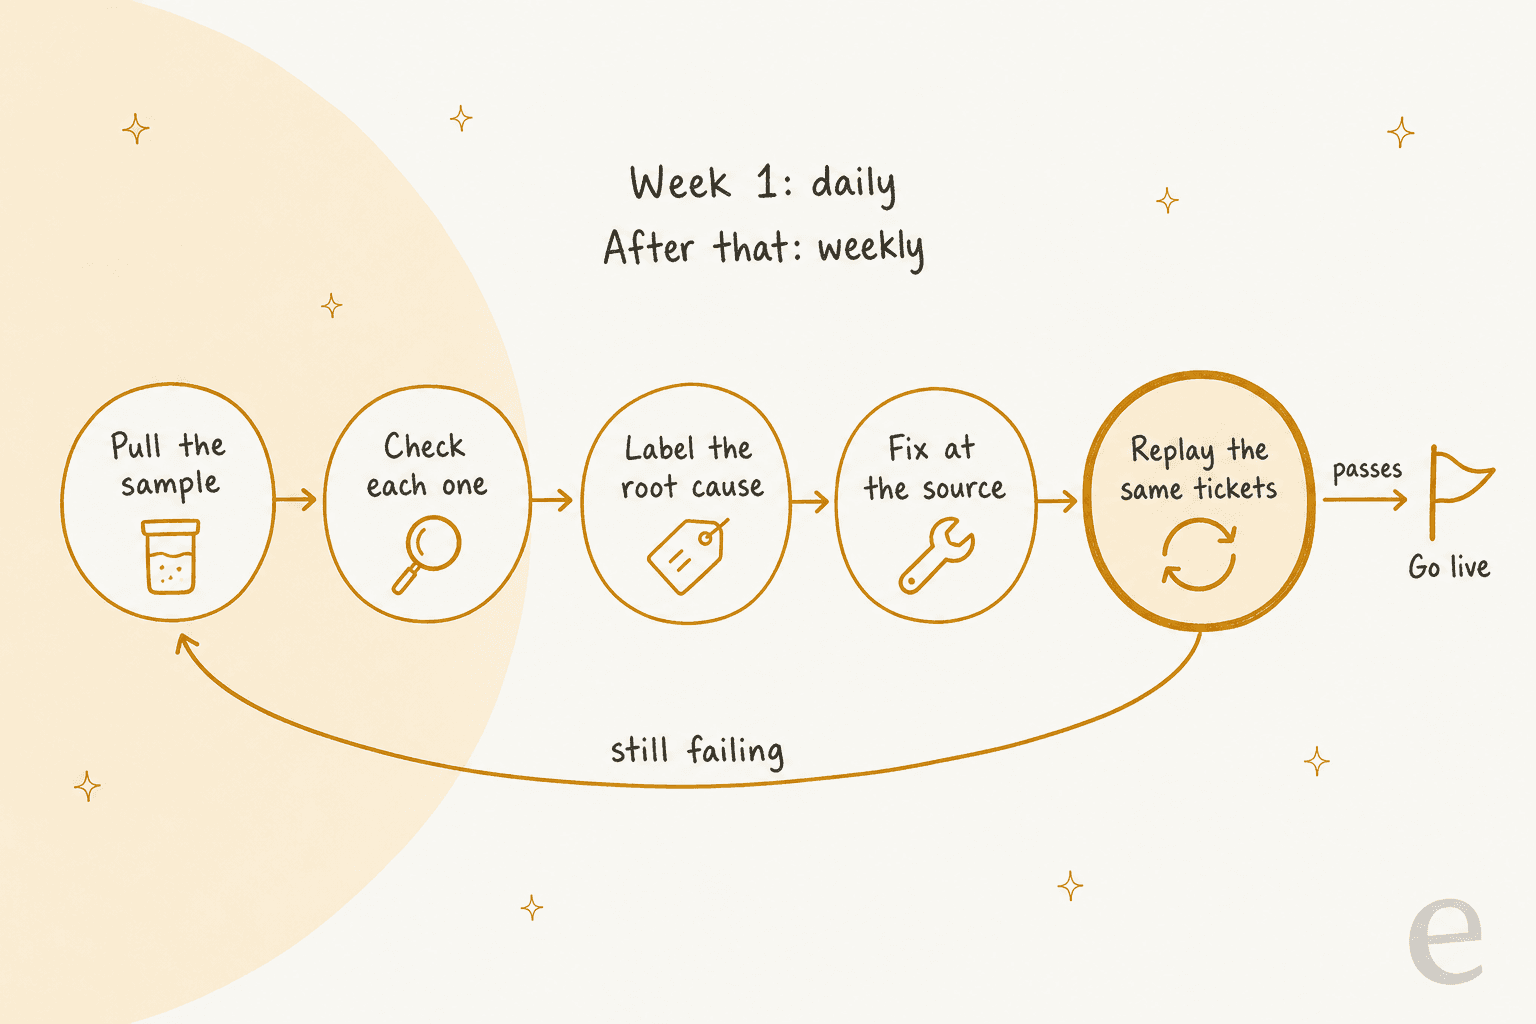
Solo sale a producción cuando la repetición pasa. Si sigue fallando, probablemente la etiqueta estaba mal, algo que pasa. Un fallo de "conocimiento faltante" que persiste después de añadir el artículo puede ser una instrucción que le dice al agente que prefiera otra fuente. Para más sobre el diseño de pruebas, consulta la guía sobre pruebas de agentes de soporte con IA.
¿Con qué frecuencia deberías revisar las conversaciones de soporte con IA?
A diario la primera semana, luego semanalmente. Ese es el ritmo con el que empezaría con cualquier agente nuevo, o cualquier agente al que acabes de dar un canal o acción nuevos.
Semana uno, a diario. Lee cada conversación marcada y unas 10 resueltas al azar cada día. Los fallos se concentran al principio porque los primeros clientes reales encuentran los huecos que tus preguntas de prueba no vieron.
Después, semanalmente. Cada conversación marcada más 20 a 30 resueltas al azar, y un vistazo a los recuentos de etiquetas. Si el recuento de una etiqueta baja después de un arreglo, funcionó. Si la muestra aleatoria deja de encontrar fallos durante tres o cuatro semanas, reduce su tamaño, pero nunca a cero.
Vuelve a diario después de cualquier cambio grande. Un canal nuevo, una acción nueva, un cambio de modelo o una importación grande de conocimiento reinicia el reloj.
Cuánto revisas también depende de cuánto hace el agente sin supervisión. En eesel, cada acción se configura en On, Ask first u Off, y la documentación de acciones sugiere empezar supervisado y pasar las acciones rutinarias a On "una vez que los borradores sean consistentemente correctos". Una excepción: las respuestas de chat en vivo siempre están en On, porque nadie puede pausar un chat en vivo para aprobación. Eso convierte al chat en el canal donde más importa la muestra aleatoria.
La página de informes de eesel tiene un área de Approvals que muestra lo mismo desde el otro lado. Su documentación dice que una acción "aprobada siempre sin ediciones está lista para funcionar sola", mientras que una que "sigue siendo rechazada necesita un arreglo en las instrucciones".

Para que el repaso semanal no se escape, pon un horario fijo. eesel tiene una habilidad Weekly digest que resume las conversaciones gestionadas por tema y canal, las aprobaciones pendientes, y lo que se omitió y por qué, y la tarjeta la configura para enviarse cada lunes (documentación de eesel). Sea cual sea la herramienta que uses, el resumen debería terminar con una lista corta de conversaciones para que las lea una persona, no solo números.
¿Qué errores hacen que una rutina de revisión se desmorone?
Los habituales:
- Leer solo los escalamientos. Aprenderás lo que el agente no puede hacer, y te perderás lo que hace mal con confianza. Mantén la muestra aleatoria de resueltas.
- Arreglarlo todo en el prompt. Un dato faltante escrito en las instrucciones funciona para un ticket y se queda obsoleto el día que cambia la política. Los datos van en tu base de conocimiento o en macros.
- Confiar en la tasa de resolución como puntuación. Úsala para decidir dónde mirar, no como prueba de que las respuestas eran correctas.
- Volver a probar solo con preguntas nuevas. Repite los tickets que fallaron. De lo contrario, nunca demuestras que el arreglo funcionó con la redacción que lo rompió.
- Sin responsable. Las revisiones que se hacen "cuando alguien tiene tiempo" se detienen en silencio. Nombra a una persona por semana, y usa la calibración de control de calidad si varias personas comparten el trabajo, para que las etiquetas sigan siendo consistentes.
- Usar una tarjeta de puntuación de control de calidad humana tal cual. Las tarjetas de puntuación hechas para personas, como las de Zendesk QA, puntúan la empatía y el proceso. Añade las comprobaciones de fuentes y acciones, o puntuarás una respuesta educada pero incorrecta como aprobada.
El costo de saltarse las etiquetas se nota rápido. Cuando un equipo no puede distinguir qué decisiones de la IA están mal, termina revisándolas todas, como describe este comentario de Hacker News:
"The AI would confidently misroute 15-20% of tickets, requiring human review of ALL AI decisions"

Revisa el trabajo de tu agente de soporte con IA con eesel
eesel es un compañero de equipo de soporte con IA que se une a la cola que ya tienes en Zendesk, Freshdesk, Gorgias o HubSpot. Está hecho para ser revisado. Cada ejecución aparece en Activity con un enlace al ticket, qué la disparó, qué fuentes buscó, cada acción que tomó, su razonamiento paso a paso, y si encontró una falta de conocimiento. Si una respuesta está mal, abres la ejecución y le dices en el chat de al lado qué cambiar, y el arreglo pasa a sus instrucciones o a una memoria.

También puedes elegir cuánto hace solo mientras generas confianza. STIL Classics usa eesel en Gorgias como borradores: en un mes dejó unas 430 notas internas, la mayoría borradores de respuesta para que el equipo revise y envíe, y cuando falta un dato, el borrador deja un hueco entre corchetes en lugar de adivinar. Eso hace que la revisión sea rápida, porque los huecos señalan directamente el conocimiento faltante.
SamCart usa agentes separados en los tickets de Freshdesk y en el chat de su web, y cuando un vendedor pide una persona o la pregunta va más allá del centro de ayuda, el ticket se etiqueta para transferencia y el agente deja de responder. Esa etiqueta le da a la revisión semanal un montón limpio para leer.
Antes de que algo salga a producción, la simulación repite tus tickets resueltos y muestra dónde el agente y tu equipo no coinciden, sin enviar nada. Los planes empiezan en 299 $ al mes por 500 créditos tras una prueba gratuita de 7 días, según los precios de eesel.
Prueba eesel con tus propios tickets pasados y mira cómo se ve tu montón de revisión antes de que lo vean tus clientes.