

Muse Code no cuesta nada. Meta te cobra el modelo que hay detrás: 1,25 $ por millón de tokens de entrada, 0,15 $ en caché y 4,25 $ de salida en muse-spark-1.2, o 0,10 $ / 0,002 $ / 0,20 $ en el nivel contributor si dejas que Meta entrene con tu código. No hay precio por puesto, ni suscripción, ni nivel gratuito, ni crédito de prueba en ninguna de las páginas de precios, producto o facturación de Meta. Comprobé las tres.
Eso suena barato, y por token lo es. El problema es que Muse Code decide cuántos tokens gastar, y nada lo detiene. De fábrica corre el modelo caro, en el segundo nivel de razonamiento más alto de siete, con tres agentes observadores en segundo plano que hacen cada uno sus propias llamadas al modelo, y un reparto de subagentes que escala con el número de núcleos de tu CPU. Meta no ofrece ningún límite de gasto. Lo único que la documentación de facturación llama límite es un "umbral de pago", y sube cuanto más pagas.
Si tu razón para mirar los precios de tokens es que quieres una factura de soporte predecible, ese es otro problema con otra respuesta. eesel cobra 1 crédito por ticket o chat, sin importar cuánto dure, a un precio mensual fijo desde 299 $/mes por 500 créditos, en lugar de cobrar por millón de tokens, lo que significa que la factura sigue el trabajo realizado en lugar de cuánto tiempo le apeteció pensar a un modelo. Esa unidad es todo el punto.
Por qué te cobra realmente Muse Code
Muse Code es la herramienta de codificación de IA para terminal de Meta AI, lanzada en beta el 5 de agosto de 2026 junto con el modelo Muse Spark 1.2. Se instala con una línea, curl -fsSL https://dev.meta.ai/install.sh | bash, y se ejecuta escribiendo muse en un directorio de proyecto.
Esto es lo que confunde a la gente en la página de producto de Muse Code: la sección titulada "Models and pricing" no contiene ningún precio para Muse Code. Contiene una tabla de tokens de cinco columnas para Muse Spark. Busqué en todo el texto renderizado de esa página las palabras free, trial, credit, subscription, seat, plan, spend, limit y cap. Cero coincidencias en las nueve. Toda la historia comercial del agente de código de Meta es una tabla de tokens.
Así que la tarifa real es la de la Model API. Cada modelo que vende Meta, según publicado en pricing and rate limits:
| Modelo | Nivel | Ventana de contexto | Entrada / Mtok | Entrada en caché / Mtok | Salida / Mtok | Solicitudes por minuto | Tokens por minuto |
|---|---|---|---|---|---|---|---|
muse-spark-1.2 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
muse-spark-1.2-contributor | Contributor | 1.048.576 | 0,10 $ | 0,002 $ | 0,20 $ | 100 | 3M |
muse-spark-1.1 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
Tres modelos, dos precios, y ninguna puerta trasera barata y antigua: 1.1 cuesta exactamente lo mismo que 1.2. Los límites de tasa se aplican por equipo, no por clave, así que claves adicionales no compran nada. Los envíos en segundo plano llevan además un tercer tope de 600 por minuto. Si quieres la lectura desde el lado del modelo de esas mismas cifras, incluido lo que cambió entre 1.1 y 1.2, eso es lo que cubre el desglose de precios de Muse Spark 1.2.
Luego los extras, o más bien la falta de ellos. Hay un único medidor adicional genuino, el grounding de búsqueda web a 2,50 $ por 1.000 consultas, que se cobra encima de los tokens y es plano sin importar cuánto contexto saque cada búsqueda. Más allá de eso, Meta tiene menos mecánica de precios que la mayoría de los proveedores, y casi siempre a tu favor:
- Sin recargo por contexto largo. Meta lo dice sin rodeos: "There is no long-context premium: you pay the same rate whether your context window is mostly empty or almost full." Varios rivales suben el precio tras un umbral de contexto. Meta no lo hace.
- Sin cargo por escritura en caché. El caché es automático, los tokens en caché son un subconjunto de los tokens de entrada en lugar de una línea separada, y el indicio opcional de retención
"24h"no cuesta nada extra. - El andamiaje propio de Meta es gratis. De la documentación: "Meta injects a small amount of steering context into every prompt (a system prompt and related scaffolding); those injected tokens are not billed."
- Sin API por lotes y sin descuento por lotes. Las respuestas
background: trueexisten pero no tienen descuento. - Sin ajuste fino, a ningún precio. No hay ningún producto de fine-tuning en la documentación.
- Sin descuento por volumen o compromiso. Las palabras de la página de precios son "no minimums or upfront commitment", lo que corta en ambos sentidos.
Esa es una tarifa inusualmente limpia. Todo lo caro de Muse Code pasa en otro lugar.
Los tres valores predeterminados que definen tu factura
Todo agente medido tiene tres o cuatro ajustes que decide el tamaño de la factura. Lo que hace que Muse Code merezca un artículo es que sus tres diales de coste vienen de fábrica en la posición cara, y ninguno está en la página de precios.
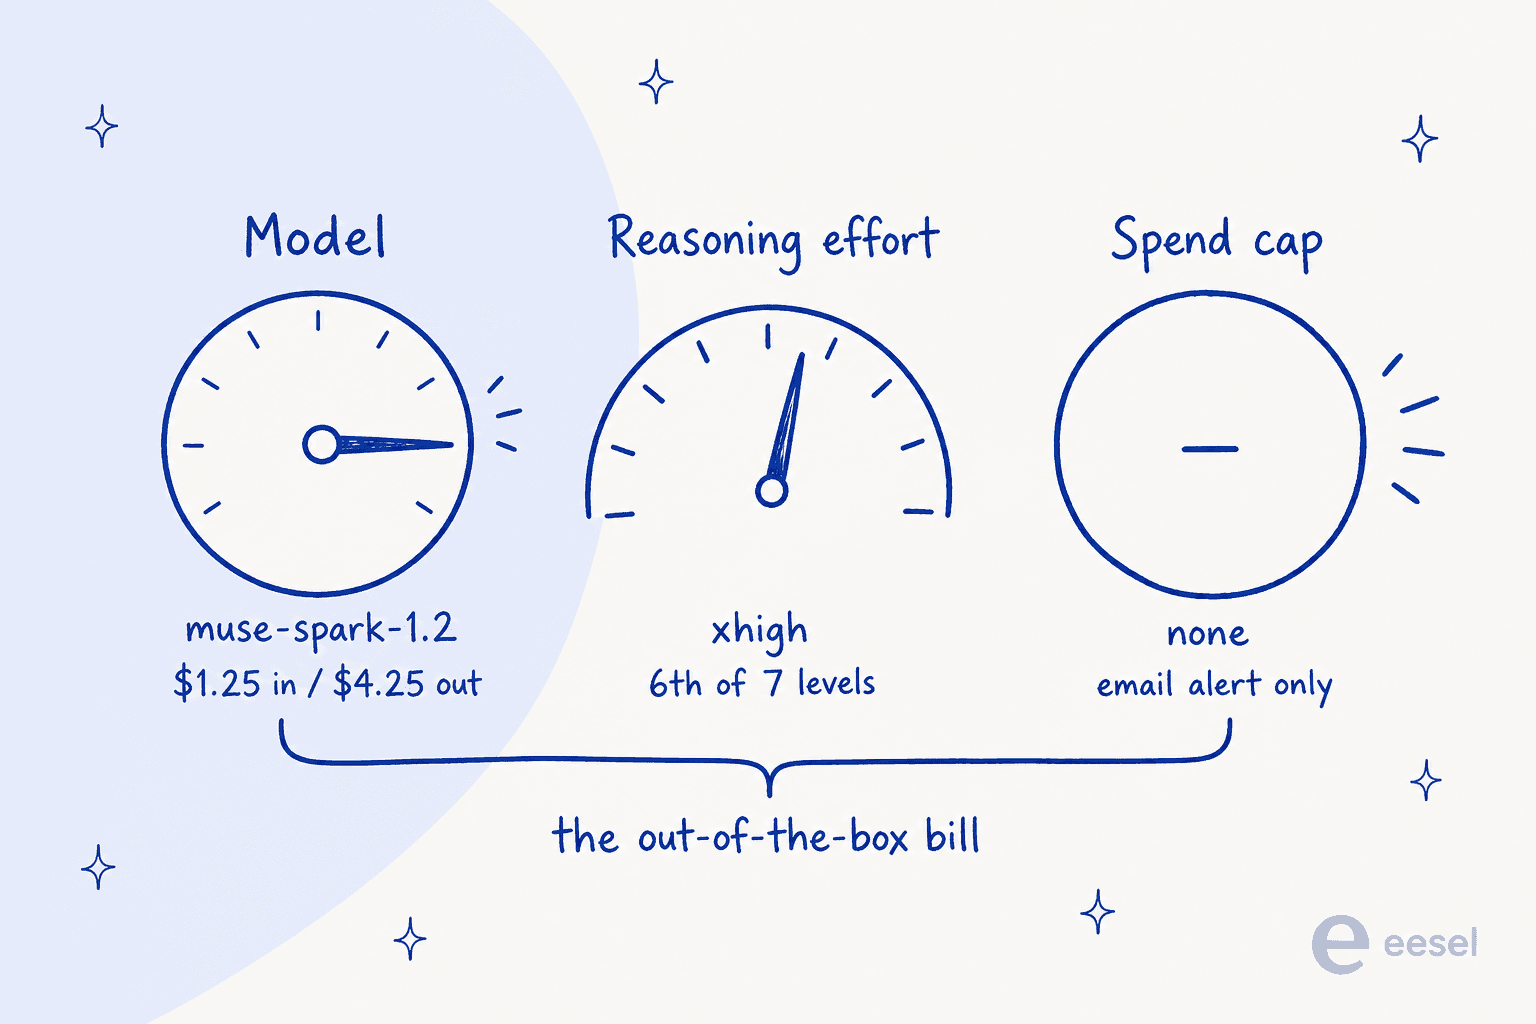
El primer dial es el modelo. La documentación de configuración de Meta lo dice sin ambigüedad: "The default model is muse-spark-1.2." Ese es el nivel de 1,25 $ y 4,25 $, no el de diez centavos.
Aquí es donde se vuelve confuso, y quiero ser preciso porque la brecha entre las dos respuestas es de 12,5x en la entrada. El blog de lanzamiento dice lo contrario: Muse Code "starts on a contributor tier", y da el comando de cambio, /model to muse-spark-1.2-contributor. La página de configuración no menciona el nivel contributor en absoluto. La palabra aparece cero veces en ella, y el único ejemplo de --model que imprime Meta es el redundante muse --model muse-spark-1.2. Las dos páginas de Meta se contradicen sobre qué precio estás pagando. El blog también llama al comando /model donde la documentación lo llama /models. Hasta que Meta lo resuelva, ejecuta /models en tu primera sesión y lee lo que dice, en lugar de confiar en ninguna de las dos páginas.
El segundo dial es el esfuerzo de razonamiento. Muse Spark es un modelo de razonamiento, y Meta es directo sobre lo que eso significa para la factura: "It thinks before it answers; those tokens are billed as output." Salida es el medidor de 4,25 $. Los niveles de esfuerzo documentados son none, minimal, low, medium, high, xhigh y ultra, y el predeterminado es xhigh, el sexto de siete. none no está soportado en Muse Code en absoluto.
ultra merece una etiqueta de advertencia, y en honor a Meta, la tiene. No es un ajuste de pensamiento más profundo; el cliente limita la solicitud al modelo a xhigh de todas formas. Lo que ultra realmente hace, en palabras de Meta, es cambiar "how aggressively Muse Code delegates to multi-agent workflows on the client, which can raise token usage". Quien lo use esperando mejores respuestas obtendrá en cambio una factura más grande.
El tercer dial es el límite de gasto, y no existe. Más sobre esto más adelante, porque es la parte que decide si algo de esto es seguro de poner en una tarjeta de empresa.
Tu conversación es lo que estás comprando
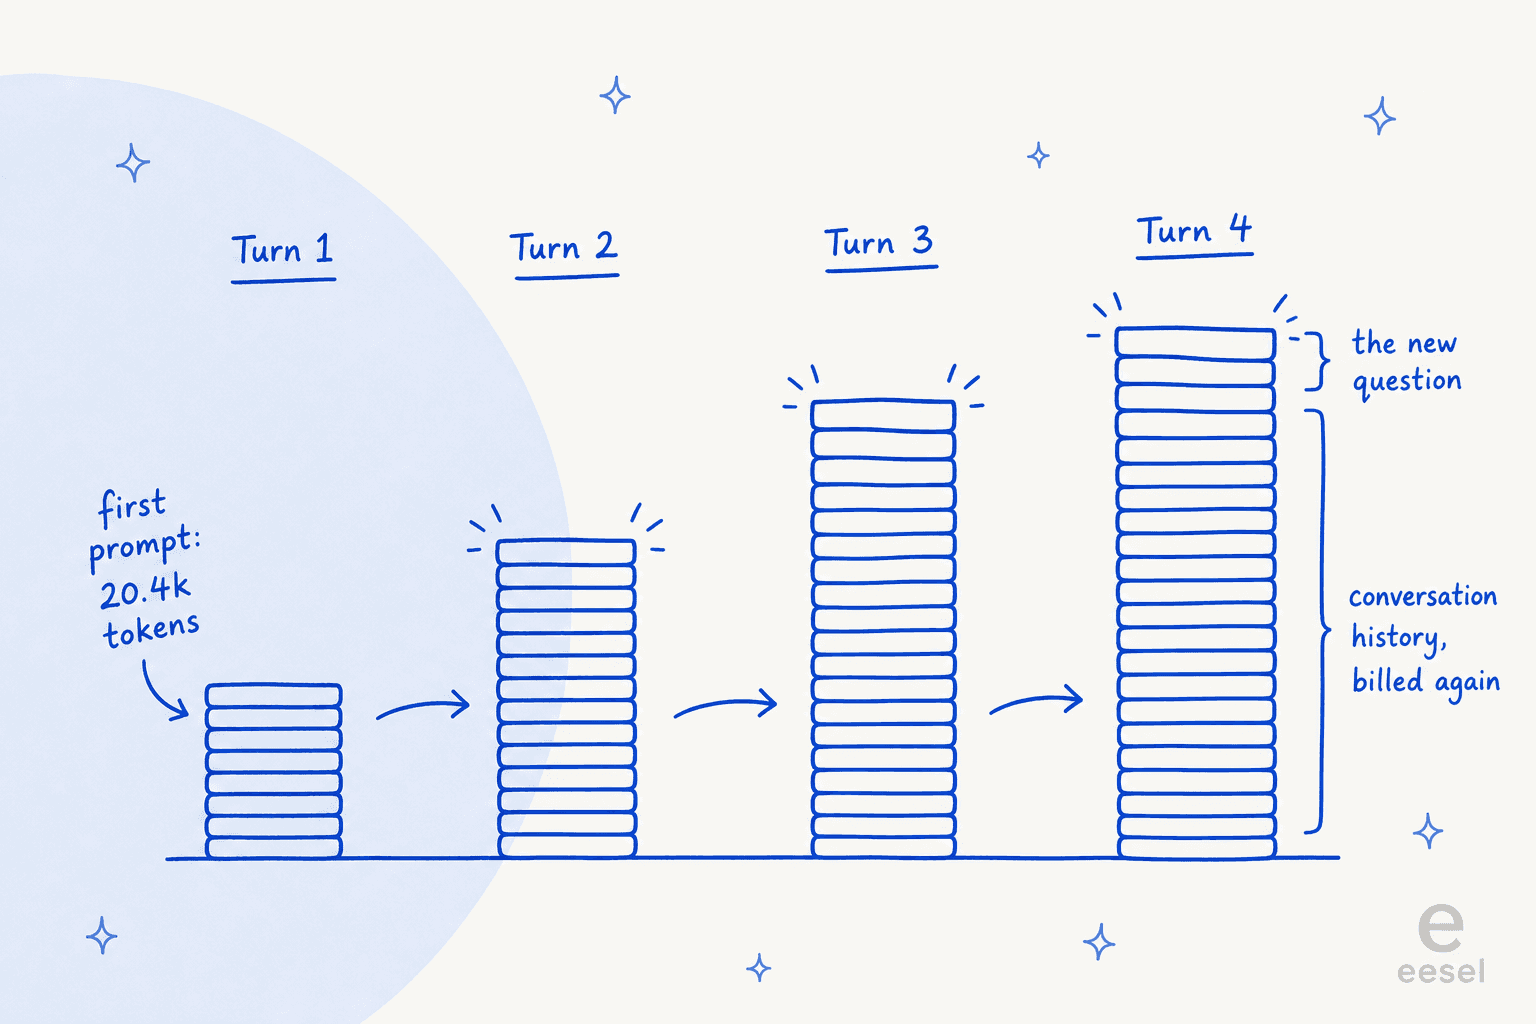
La frase más útil de toda la documentación de facturación de Meta es una definición que la mayoría de la gente se salta. Los cargos se basan en el uso de tokens, y cada solicitud consume "Input tokens: your prompt, system instructions, and conversation history."
Historial de conversación. En una ventana de chat eso es una nota al pie. En un agente que lee archivos, ejecuta pruebas, lee el resultado y lo vuelve a intentar, es todo el modelo de coste. El turno doce se cobra por los turnos uno al once.
Dos cosas lo suavizan y una lo agrava.
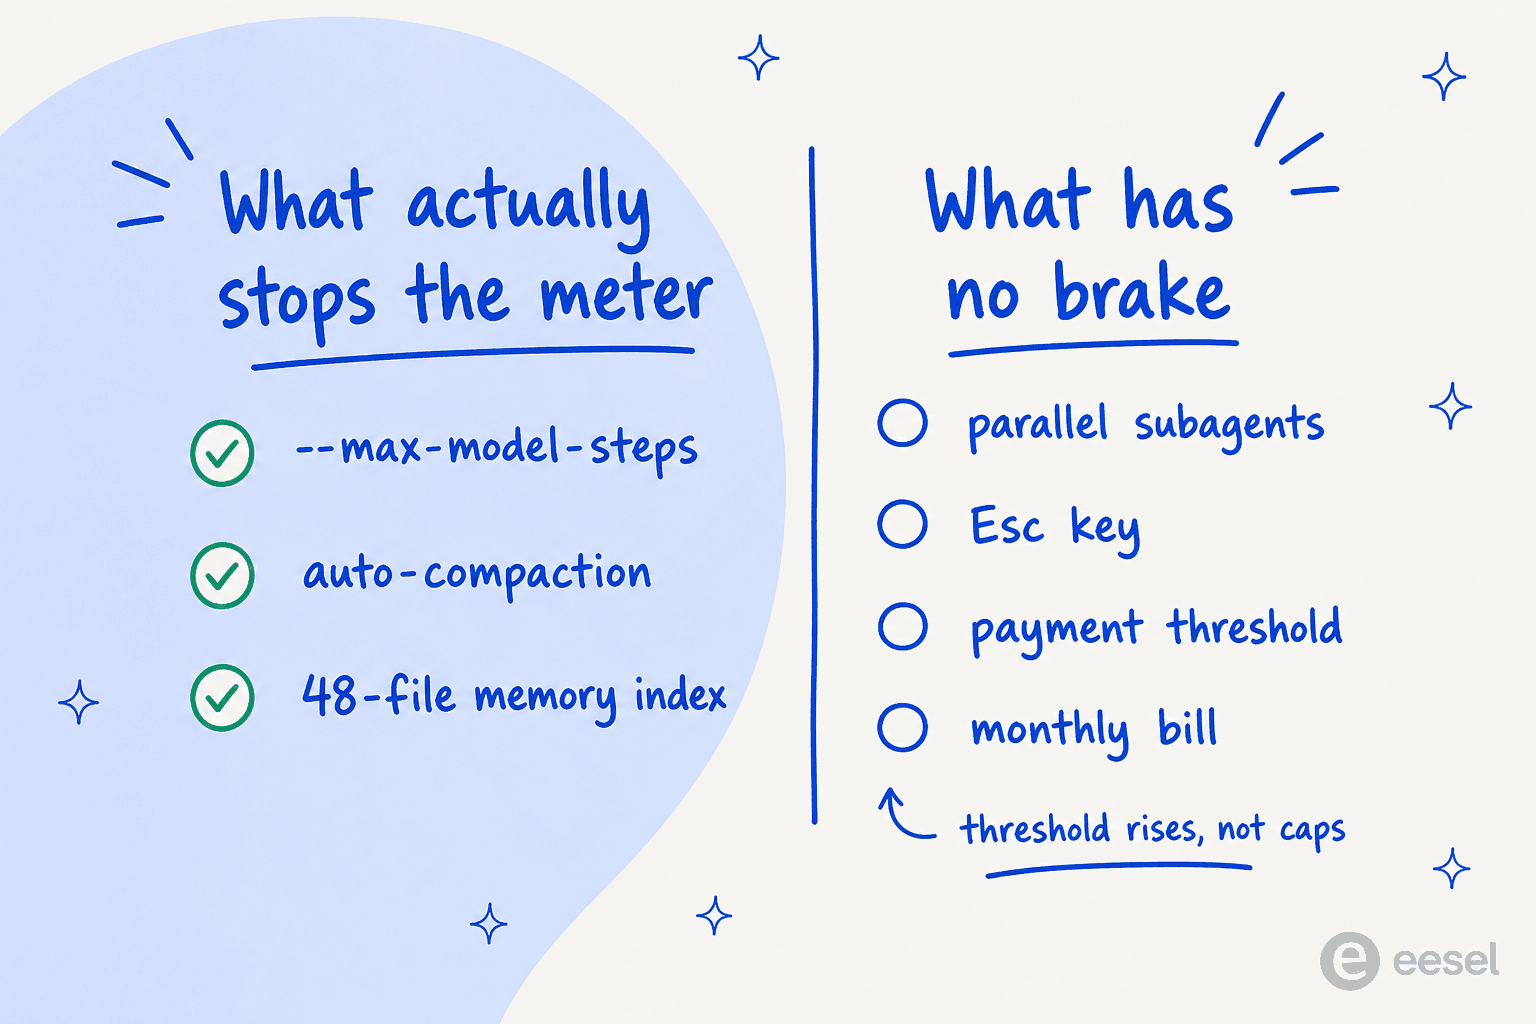
Lo suaviza: el caché de prompts es automático, y el prefijo repetido se cobra a 0,15 $ en lugar de 1,25 $, un descuento del 88 % en la parte de tu contexto que no ha cambiado. Meta también mantiene barato el recuerdo de memoria por diseño. Al iniciar la sesión, el agente inyecta un índice de tus archivos de memoria, "their paths, not their contents, up to 48 files", y solo lee archivos individuales cuando los quiere. Eso es un control de coste real, y es agradable ver uno.
Lo agrava: el código tokeniza peor que la prosa, algo que Meta también dice en voz alta. "A token is roughly 3 to 4 characters of English text. Non-English text and code often use more tokens per word, so equivalent requests can cost more." Un agente de código es el peor caso para un medidor por token, y es exactamente el producto que vende Meta.
Puedes ver el suelo de todo esto en una sola medición. Un desarrollador escribió una sola palabra en Muse Code el día del lanzamiento y observó el medidor:
"Meta AI released muse code today. so i tested out. just said
hias the first prompt, and it consumed 20.4k tokens (and $0.02)."

Dos centavos no es nada. 20.400 tokens por dos caracteres es la cifra que hay que recordar, porque ese es el tamaño de la base desde la que empieza a acumularse tu sesión antes de haber pedido nada.
El multiagente por defecto es una decisión de facturación
Meta promociona la función estrella de Muse Code como "Multi-agent by default". En la página de producto se lee como una capacidad. En el medidor es un multiplicador, y la documentación es lo bastante específica para hacer la cuenta.
Empecemos por el reparto. De la documentación de extensión de Meta: "The runtime runs several children at once. The default cap scales with the machine: roughly core count minus two, clamped between 2 and 16." El número de núcleos de tu portátil es una variable de precio. En una máquina de 16 núcleos eso son hasta 14 procesos hijos con capacidad de escritura corriendo como flujos facturados por separado, cada uno con su propio contexto, cada uno con su propia copia de la tarea. Los hijos corren solo un nivel de profundidad, así que al menos no puede haber recursión.
No te apuntas a esto. El blog de lanzamiento es enfático: las tareas se "fanned out automatically... Your working copy is never touched and you don't set any of this up - Muse Code does it all automatically." Eso es un logro de ingeniería real y el diseño me gusta. También es lo que multiplica tu gasto en tokens mientras miras una sola barra de progreso.
Luego están los observadores, algo que no había visto cubierto en ningún otro sitio y que fue lo que más me sorprendió. Muse Code ejecuta un equipo de agentes en segundo plano que vigilan el recuerdo de memoria, el recuerdo de habilidades, el seguimiento de objetivos y la verificación. La frase de Meta: "Three of the four observers run by default, and each makes its own model calls, so they add token usage in addition to the main session." Tres conversaciones facturadas extra en las que nunca escribiste nada, activadas por defecto, desactivables en settings.json bajo runtime_capabilities.
Y hay una trampa en la interrupción. Pulsar Esc "stops the turn only. It does not stop background terminals or subagents." El reflejo de pánico universal cuando un agente se descontrola no detiene el medidor en los flujos paralelos. Eso vale la pena saberlo antes de necesitarlo, y es una versión más afilada del mismo problema que hace difícil presupuestar la orquestación de subagentes en cualquier harness, este incluido. Si quieres la comparación, los subagentes de Claude Code y los sistemas multiagente atraviesan el mismo compromiso desde el otro lado.
Calcula tu propia cifra
Meta no publica ninguna calculadora de coste, y cualquier ejemplo que yo pudiera escribir estaría mal para tu repositorio. Así que aquí está la cuenta en una caja donde puedes poner tus propios números. Usa la tarifa publicada y modela lo único que realmente mueve la factura: que tu conversación se vuelve a cobrar en cada turno, a la tarifa de caché, una vez por cada flujo paralelo.
El porcentaje de ese aviso es el punto de todo el ejercicio. En cualquier sesión lo bastante larga para ser útil, la mayor parte de lo que le pagas a Meta es por releer una conversación que ya pagaste. Acortar las sesiones es una palanca más grande que cambiar de modelo, que no es donde la mayoría de la gente mira primero. Es la misma razón por la que el tamaño de la ventana de contexto se convierte en una pregunta de presupuesto más que de capacidad en cuanto un agente hace trabajo real.
Cómo se compara con comprar un plan
La razón por la que un agente medido se siente extraño es que casi nada más en esta categoría se vende así. Comparé cada CLI de codificación agéntica serio contra el de Meta, y el patrón es lo bastante consistente para ser la conclusión: cinco de los seis ofrecen un plan fijo y te dan un límite de gasto duro también en la vía medida. Muse Code no tiene ninguno de los dos.
| Herramienta | Plan fijo | Tarifa medida | Límite de gasto duro | Nivel gratuito |
|---|---|---|---|---|
| Muse Code | Ninguno, a ningún precio | 1,25 $ / 0,15 $ / 4,25 $, o 0,10 $ / 0,002 $ / 0,20 $ contributor | No. Solo alerta por correo | No |
| Claude Code | Pro 20 $, Max 5x 100 $, Max 20x 200 $ | Opus 5 5 $ / 25 $; Sonnet 5 2 $ / 10 $ | Sí, límite mensual configurable, más límites de workspace en organizaciones de API | No en el plan gratuito |
| Codex CLI | Go 8 $, Plus 20 $, Pro desde 100 $, Business 25 $/usuario | Sol 5 $ / 30 $, Terra 2 $ / 12 $, Luna 0,20 $ / 1,20 $ | Sí, un límite de uso aprobado por la organización que falla con error duro | Nivel gratuito disponible, CLI desde Plus |
| Gemini CLI | Incluido en los planes AI Pro y Ultra | Niveles de la API de Gemini, Tier 1 con tope de 250 $ | Sí, topes por nivel de facturación y límites de gasto por cada 10 minutos | Sí, 60 solicitudes/min y 1.000 solicitudes/día |
| Cursor | Pro 20 $, Pro Plus 60 $, Ultra 200 $, Teams 40 $/usuario | Cuota de uso incluida, luego pago por uso | Sí, y las funciones de IA se detienen al alcanzarlo | Sí, Hobby |
| Grok Build | SuperGrok 30 $, SuperGrok Plus 100 $ | grok-build-0.1 1,00 $ / 2,00 $, 0,20 $ en caché | Sí, y es el estado por defecto | Sí |
| OpenCode | Software gratuito, plan Go opcional 10 $/mes | Lo que cueste tu propia clave | Heredado de tu proveedor | Sí |
Lee la columna del límite de gasto de arriba abajo. La documentación de Cursor es la más clara sobre lo que significa un límite en la práctica: "When a limit is reached, AI features stop for that user until the next billing cycle." Grok Build viene con un límite de facturación de 0 $ facturados por defecto, así que las solicitudes se rechazan en cuanto se acaba el crédito prepagado. Incluso las vías de API medidas tienen techos, porque los proveedores aprendieron hace años que los desarrolladores no dejan su tarjeta sin uno.
Hay una segunda cosa que esos proveedores hacen y Meta no, y es la más útil. Publican lo que deberías esperar gastar. La propia documentación de Anthropic sitúa a Claude Code en "$13 per developer per active day and $150-250 per developer per month." Cursor también publica rangos, aproximadamente de 60 a 100 $ al mes para usuarios diarios de agentes y más de 200 $ para usuarios intensivos. Meta publica una tarifa y te desea suerte. En ningún lugar de su documentación hay una frase que diga cómo se ve un mes normal.
Así que en precio por token Muse Spark es competitivo, y el nivel contributor es agresivo frente a todo salvo los laboratorios chinos más baratos. En previsibilidad de precio, Muse Code es la única opción aquí que no puede responder "cuánto es lo máximo que esto puede costarme este mes". Si ya has pasado por una conversación de compras sobre los precios de Claude, los precios de Codex, los precios de Windsurf o los precios de GitHub Copilot, sabes lo que vale esa certeza para un equipo de finanzas, y suele ser más que la diferencia de tokens.
Comprar tokens directamente sigue siendo una estrategia real, solo que distinta. Es la misma decisión que recurrir a la API de OpenAI o a la API de Anthropic en lugar de un producto empaquetado: mejor economía unitaria, y heredas el problema de la previsión. La comparación de las tres grandes APIs de modelos cubre dónde cae cada una junto a los precios de Claude Opus 4.6 y los precios de GPT 5.3 Codex. Si compras puramente por tokens baratos, los precios de Qwen, los precios de Kimi K2.5, los precios de Mistral AI y DeepSeek V3.2 van todos en la misma hoja de cálculo. Alojar los pesos en otro lugar es la tercera vía, para lo que existen los precios de Together AI y los precios de Groq.
Un mérito que hay que reconocerle a Meta, ya que he dedicado la mayor parte de este artículo a la brecha: la tarifa en sí es honesta. Dos precios, ambos impresos, con las condiciones de datos en inglés claro debajo de cada uno. Ningún sistema de créditos se interpone entre tú y la cifra, que es más de lo que se puede decir de los esquemas de créditos de IA y Flex Credits que se han extendido por el resto de la industria. El problema no es que Meta escondiera el precio. Es que Meta puso precio a los tokens y dejó el volumen completamente en manos del agente.
Una observación de la comunidad merece repetirse aquí porque fija el nivel con el que Meta realmente se está midiendo, y no es Anthropic:
"This is a nice release and a solid improvement over Spark 1.1. It compares favorably with Grok 4.5. Not SOTA, but solid releases. I think they need to really get this more competitive with Deepseek V4 Flash / Luna pricing to move the needle."

Lo que Muse Code no te vende: un techo
He leído cada página de facturación que Meta publica para este producto y no hay límite de gasto, ni límite de presupuesto, ni parada dura, ni alerta de uso en ninguna de ellas. Lo que hay es un umbral de pago, y es fácil confundirlo con un techo porque es una cifra vinculada a tu cuenta con un signo de dólar.
Las palabras de Meta: "Whenever your current balance reaches your payment threshold amount, your payment method is charged for that amount. As you make successful payments, your payment threshold may be raised until your account reaches a final threshold amount."
Lee eso con cuidado. Es un disparador para cobrar tu tarjeta, y sube a medida que demuestras que puedes pagar. Es un límite de crédito que funciona a favor del proveedor. Lo que quede se cobra el primer día del mes de todas formas. La palabra "plans" aparece en el título de la página de facturación y en la descripción de navegación, y nunca va seguida de un plan real.
Los desarrolladores lo notaron el primer día, y la objeción no es teórica:
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Quiero detenerme en ese comentario, porque lo reconozco de un mercado completamente distinto. Construyo integraciones en eesel y estoy presente en suficientes llamadas de ventas para saber que pedir un techo es lo más normal que un comprador puede pedir. Un equipo con el que estuve, anonimizado aquí como un grupo de soporte de hardware B2B consciente del presupuesto que gestiona unos 250 tickets al mes, había visto cómo el precio de un proveedor anterior se duplicaba con creces y llegó pidiendo específicamente bloqueos de precio contractuales, proponiendo el prepago anual como forma de conseguir uno. Nadie llama a eso paranoia. Es simplemente lo que pasa después de haberse llevado una sorpresa una vez.
Y la sorpresa suele llegar después de que el producto ya se ha demostrado, que es la parte que duele. Otro equipo, una marca de moda estadounidense en Gorgias, hizo doce chats de prueba contra el agente de eesel. El agente lo hizo bien. Luego abrieron la página de facturación y de inmediato presentaron dos solicitudes de cancelación, una de las cuales decía simplemente:
"PLEASE CANCEL MY subscription"
Eso era sobre la propia página de precios de eesel, no la de un competidor, y me enseñó algo con lo que he diseñado desde entonces: lo que decide la compra no es que el producto funcione, es la factura. Un agente medido sin techo guarda esa conversación para el final del mes.
Lo más parecido a un freno que Meta te da es un límite de pasos en lugar de un límite en dólares: --max-model-steps <n> en ejecuciones headless, que Meta describe como algo que está ahí "so a stuck task can't loop indefinitely". Útil en CI. No hace nada por una sesión interactiva, que es donde se gasta la mayor parte del dinero.
Dónde el nivel barato se vuelve caro
El nivel contributor es la decisión de precios más interesante de todo el lanzamiento, y la más discutida. 0,10 $ de entrada y 0,20 $ de salida son 12,5x y 21x más baratos que el estándar, y la etiqueta que Meta pone debajo en la página de producto es una sola frase: "Used to improve our products." La etiqueta del nivel estándar es "Not used to improve our products." Raramente he visto a un proveedor plantear el trato de forma tan directa, y muchos desarrolladores lo respetaron por eso:
"I actually really like that pricing strategy. It's very transparent"
"The fact that Facebook has so much experience taking advantage of people's private data is one of the reasons I believe them when they say they won't be doing it when you pay them for that service."
La crítica se dividió en dos direcciones. Algunos argumentaron que el descuento subvalora los datos, ya que el coste real de elegirlo son los 4,05 $ por millón de tokens de salida que se dejan de ganar. Otros señalaron que se puede conseguir el mismo precio sin ceder los datos:
"FYI: there are providers of deepseek that offer the same or lower pricing and zero retention policies."
Más allá de la ética, hay cuatro razones concretas por las que el nivel barato puede costarte más de lo que sugiere la etiqueta de precio, y son las que yo querría tener en una pizarra antes de comprometer un equipo a usarlo.
Tiene 30 veces más límite de tasa en solicitudes. 100 solicitudes por minuto frente a las 3.000 del nivel estándar, mientras que los tokens por minuto solo caen un 25 %, de 4M a 3M. Meta frenó específicamente la vía de solicitudes. Un agente que dispara muchas llamadas pequeñas a herramientas en paralelo, que es exactamente lo que hace el reparto de Muse Code, choca contra un techo de solicitudes mucho antes que contra un techo de tokens. Un agente en cola es un agente lento, y los agentes lentos se vuelven a ejecutar.
El acceso puede retirarse sin previo aviso. Un desarrollador informó haberlo perdido a mitad de un proyecto:
"Pointing out for others: without warning I was restricted from using the contributor model because of "policy violations". I was working on Kaggle research and some Apple Security work at the time. They really need to make cyber a first priority product feature."
Las condiciones de los créditos gratuitos cambiaron después de otorgarlos. Meta repartió créditos de 20 $ en el lanzamiento de Muse Spark 1.1, y el lenguaje sobre uso de datos asociado cambió más tarde:
"If you got the $20 in free credits from Meta for signing up when muse-spark-1.1 was release, please note that there's now small print stating "While using free credits your content may be used for product improvement" which was not present at muse-spark-1.1 launch when the credits were given out."
La retención cero de datos está restringida a ventas y sin precio. Del blog de lanzamiento: "We're also beginning to accept requests for zero data retention. Contact Meta sales to request this." Empezando, y a petición. Si una revisión de seguridad te va a bloquear, te bloqueará aquí, y no hay ajuste de autoservicio ni precio publicado para arreglarlo.
Ese último punto es donde el coste y la privacidad dejan de ser preguntas separadas. Un agente de terminal lee tu repositorio y lo envía como entrada facturable a la API de un proveedor, así que cada token que sale de tu máquina es a la vez una línea de factura y una divulgación. Oigo la misma pregunta constantemente en el lado del soporte de este negocio. Un evaluador técnico en una empresa de hardware de semiconductores no quiso avanzar hasta estar seguro de que la IA respondía solo desde el conocimiento aprobado de su organización en lugar de consultar un modelo general, y preguntó directamente si ese comportamiento se podía desactivar. No estaba preguntando por precios. Estaba haciendo la misma pregunta. Esa superposición es exactamente por qué la seguridad de Claude Code se lee en partes como un documento de costes.
Sobre lo que vale el modelo en sí a ese precio, la lectura práctica más justa en el hilo de lanzamiento fue también la más útil:
"Muse code is rough around the edges. But combined with almost free model (muse spark contributor) it's actually pretty good. I think it's on the same level as grok build."
Lo que yo haría de verdad
En concreto, en el orden en que lo haría, si pusiera Muse Code en un proyecto real esta semana.
- Ejecuta
/modelsen tu primera sesión y confirma en qué nivel estás. La documentación de Meta y el blog de lanzamiento se contradicen, y la diferencia es de 12,5x. No lo infieras, léelo. - Bájale
--reasoning-effortamediumy mira si lo notas. El razonamiento se cobra como salida a 4,25 $.xhighes el predeterminado, no una recomendación, y la mayoría de las tareas no son difíciles. Es la misma palanca que ofrecen la selección de modelo y bajar a un nivel de modelo barato en otros harnesses. - Desactiva los agentes observadores que no usas. Tres se ejecutan por defecto en
settings.jsonbajoruntime_capabilities, cada uno con sus propias llamadas al modelo. La verificación ya está desactivada; los otros tres son una elección. - Termina las sesiones en lugar de continuarlas. La transcripción es entrada facturable en cada turno, así que un
/newlimpio para una tarea nueva es el hábito más barato disponible, con diferencia. Usa/compactcuando tengas que seguir. - Pon
--max-model-stepsen cada ejecución headless. No es un límite en dólares, pero es la única parada documentada, y CI es donde un bucle corre sin vigilancia a las 3 de la madrugada. - Vigila el panel de uso cada semana, porque nada más te lo va a decir. No hay límite ni alerta más allá del correo. Trata el hábito de los análisis de uso como obligatorio, no opcional, y si esto va a entrar en un equipo, lee antes sobre los controles de administrador.
Y el punto estructural, que prefiero decir claramente en vez de esconderlo. Un agente medido sin techo es el extremo de hazlo-tú-mismo del mercado, y hacerlo uno mismo tiene un coste que nunca aparece en ninguna tarifa. Un cliente de eesel, un líder de ingeniería en una empresa de hardware cripto, lo dijo mejor de lo que yo podría:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Algunos equipos deberían de todas formas comprar tokens en bruto. Si tu carga de trabajo es irregular, tus ingenieros son fuertes y alguien es responsable de la factura, la economía unitaria es mejor y Muse Code es un harness bien construido para gastarlos a través de él. La decisión de construir frente a comprar depende de quién tiene tiempo, no de quién tiene la tarifa más barata. Y si la respuesta es "ninguno de los dos, quiero un plan", el resumen de los mejores asistentes de codificación con IA es el camino más corto hacia uno.
Prueba eesel para el lado de soporte de este problema
Si has llegado hasta aquí porque intentas prever lo que realmente cuesta la IA, y el trabajo que estás prediciendo es soporte al cliente en lugar de código, la unidad es todo el argumento. Muse Code pone precio al esfuerzo de la máquina, así que su factura se mueve según cuánto tiempo corrió un modelo. eesel pone precio a un ticket resuelto, así que la factura se mueve con el trabajo terminado, una cifra que tu equipo de finanzas ya sigue.
Eso importa más justo donde Muse Code no tiene respuesta: puedes ver lo que vas a deber. eesel simula un agente nuevo contra tus propios tickets históricos antes de tocar una cola en vivo, así que obtienes la tasa de resolución y la proyección de coste a partir de tu historial de tickets real en lugar de descubrir ambas cosas en producción. He implementado muchas de estas integraciones, y el paso de simulación es el que los clientes siguen mencionando, porque es la diferencia entre una previsión y una esperanza.

Vale la pena mirar si estás sopesando una factura de modelo medida frente a una por resolución: el desglose de coste por resolución, el argumento a favor de los precios basados en resultados, y cómo construirlo en la práctica con un helpdesk de IA. Gratis para probar, y sabrás tu cifra antes de comprometerte con ella.
Preguntas frecuentes
¿Cuánto cuesta Meta Muse Code?
¿Es gratis usar Muse Code?
¿Puedo fijar un límite de gasto en Muse Code?
--reasoning-effort más bajo, --max-model-steps en ejecuciones headless, desactivar los agentes observadores en segundo plano y cambiar de modelo. Compara eso con los límites publicados de los límites de tasa de OpenAI o los topes de crédito en sistemas como los créditos de IA.¿Cuáles son los precios de Muse Code para un equipo pequeño?
¿Cuál es la diferencia entre los niveles contributor y standard de Muse Spark?
muse-spark-1.2 es el que lleva la etiqueta "Not used to improve our products", y el desglose completo está en nuestra guía de precios de Muse Spark 1.2.¿Por qué mi primer prompt de Muse Code costó dinero?
hi en 20.400 tokens y dos centavos, y a partir de ahí cada turno reenvía la conversación como entrada facturable a la tarifa de caché. Es el mismo efecto acumulativo que convierte el tamaño de la ventana de contexto en una pregunta de coste más que de capacidad, y por eso casi todas las buenas prácticas para estos agentes se reducen a mantener las sesiones cortas.