

Una plantilla de comunicación de interrupciones es un texto aprobado de antemano para cada etapa del incidente (investigación, identificado, monitorizando, resuelto, autopsia) en cada canal, con espacios para qué está roto, quién está afectado y cuándo darás el próximo aviso. Copia el conjunto de abajo, pero dos reglas importan más que el texto: cada aviso nombra la hora del próximo aviso, y cada canal copia de una sola nota de incidente que aprueba el líder de tu incidente. Atlassian dice que nunca dejes pasar más de una hora entre avisos.
Para la avalancha de tickets, el compañero de equipo de IA para helpdesk de eesel responde los tickets de problemas conocidos desde esa misma nota dentro de tu helpdesk y pasa los casos límite a una persona. Con la CLI de eesel, un agente de código puede subir la nota aprobada y probar las respuestas primero; un administrador sigue siendo quien conecta el helpdesk.
Haz clic en una etapa para cambiar el texto de la página de estado, el banner y el helpdesk para ese momento de la interrupción.
¿Qué debe decir todo aviso de interrupción?
Trabajo todos los días en la cola de soporte de eesel, y en un mal día la primera señal de que algo se rompió es la misma pregunta llegando a la cola una y otra vez. La plantilla es lo que detiene eso. Un buen aviso de interrupción responde cuatro preguntas antes de que el cliente tenga que hacerlas: qué está roto, quién está afectado, qué estás haciendo, y cuándo dirás más.
Esa estructura no es invención mía. La guía de incident.io divide un aviso a clientes en las mismas partes: dar contexto para que la gente no asuma lo peor, decir qué estás haciendo, fijar expectativas, decir a la gente qué hacer, y decir cuándo llegará el próximo aviso. La biblioteca de plantillas de Atlassian está construida igual, y la mitad de sus plantillas de investigación terminan con "We will send an additional update in NEXT_UPDATE minutes."
Las cuatro etapas vienen directamente de las herramientas de páginas de estado. La documentación de publicación de incident.io las define en una línea cada una: Investigando significa que todavía no sabes con certeza cuál es el problema, Identificado significa que estás trabajando en una solución, Monitorizando significa que los clientes deberían esperar que todo vuelva a la normalidad pero tu respuesta todavía no ha terminado, y Resuelto significa que todo ha vuelto a la normalidad. Cada etapa pide un detalle distinto, por lo que un mensaje genérico de "somos conscientes de un problema" estirado durante cuatro horas se siente como silencio.
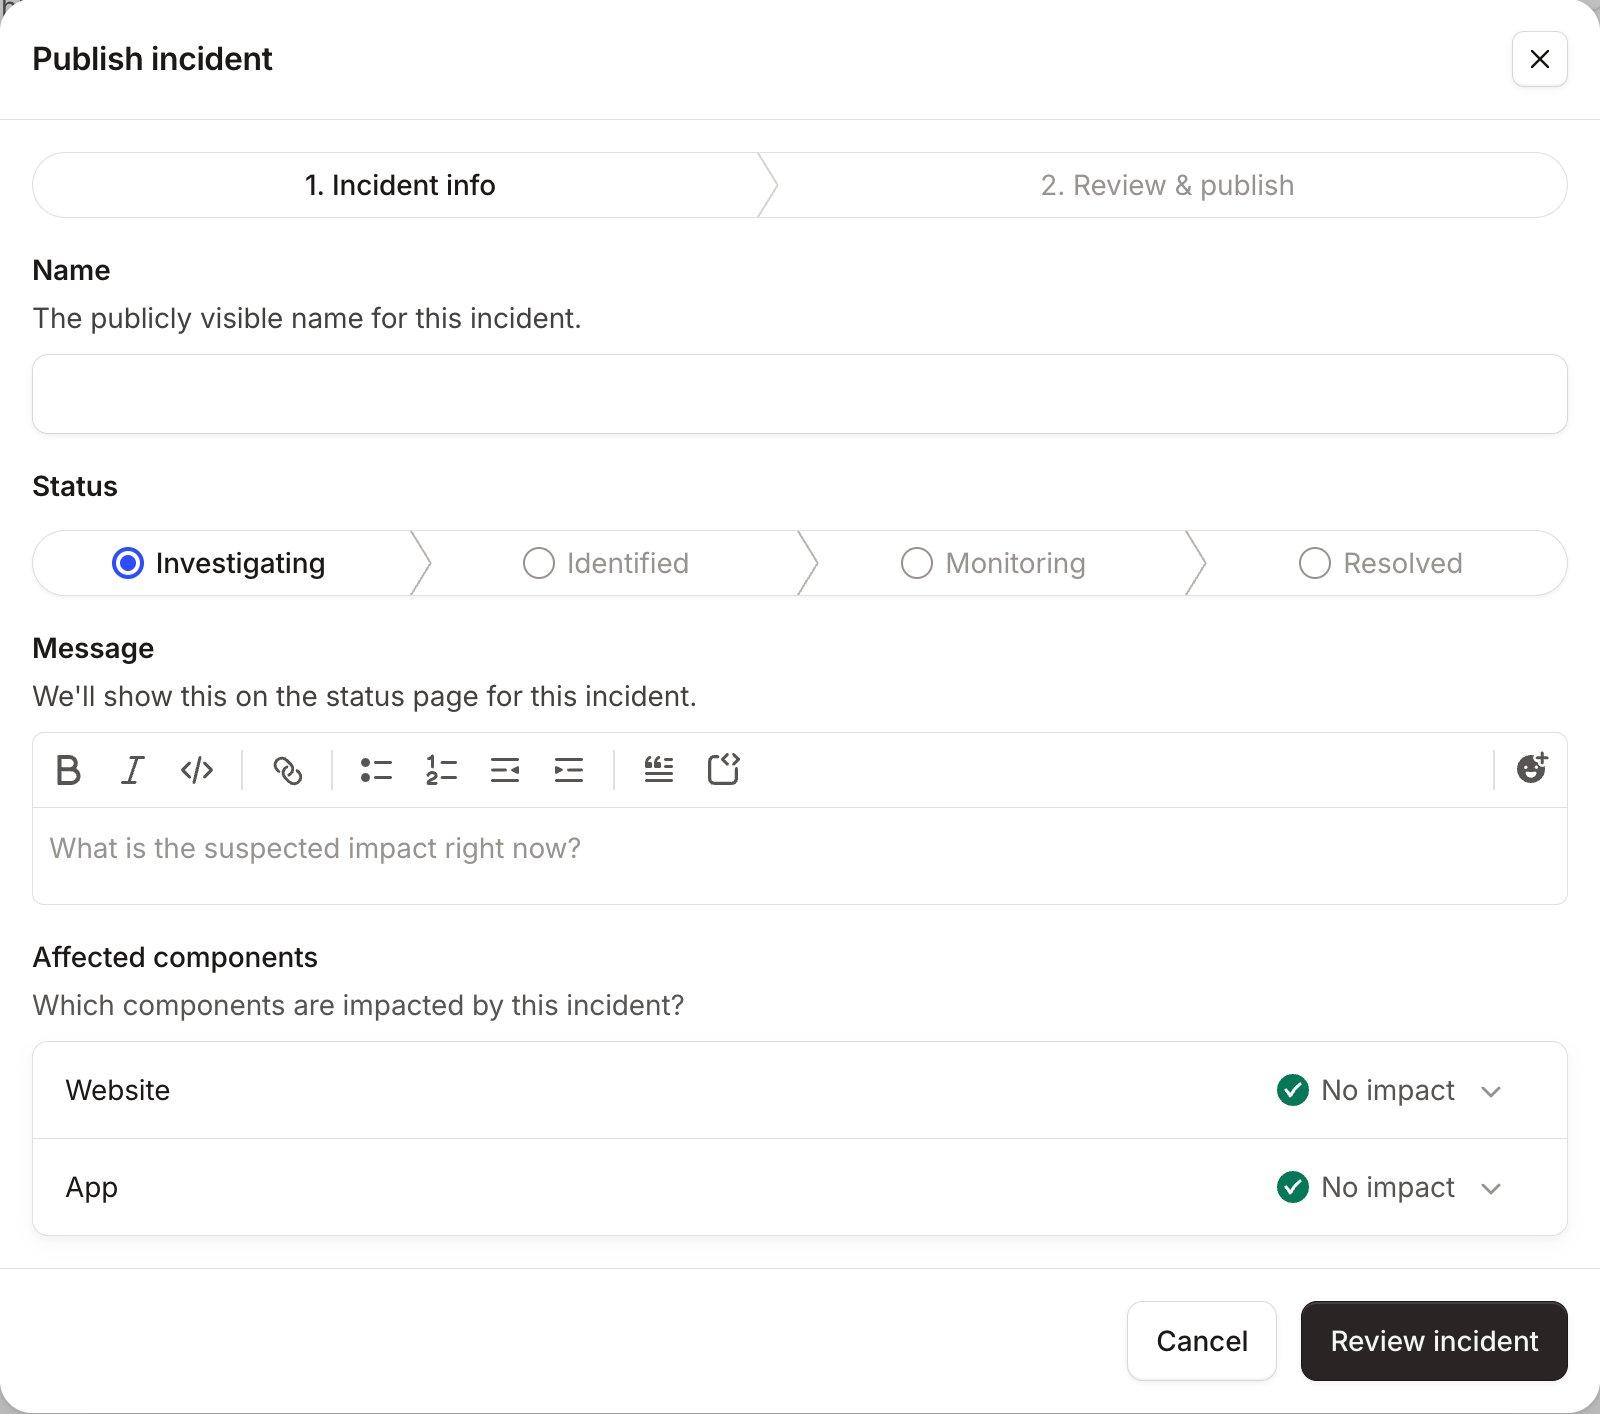
Fíjate en lo que pide el formulario: un nombre, un estado, un mensaje y los componentes afectados. El nombre se convierte en el asunto del correo para los suscriptores, según la misma documentación, así que escribe el título para alguien que solo lea el asunto. "Los paneles no cargan para algunos usuarios de la UE" es mejor que "Interrupción del servicio".
¿Con qué frecuencia deberías publicar avisos de interrupción?
Al menos cada hora mientras los clientes estén afectados, y cada 30 minutos si puedes gestionarlo. La guía de comunicación de incidentes de Atlassian recomienda "never going more than one hour without sending an update" para todo lo que siga afectando a los clientes, y dice que siempre se debe indicar cuándo llegará el próximo aviso.
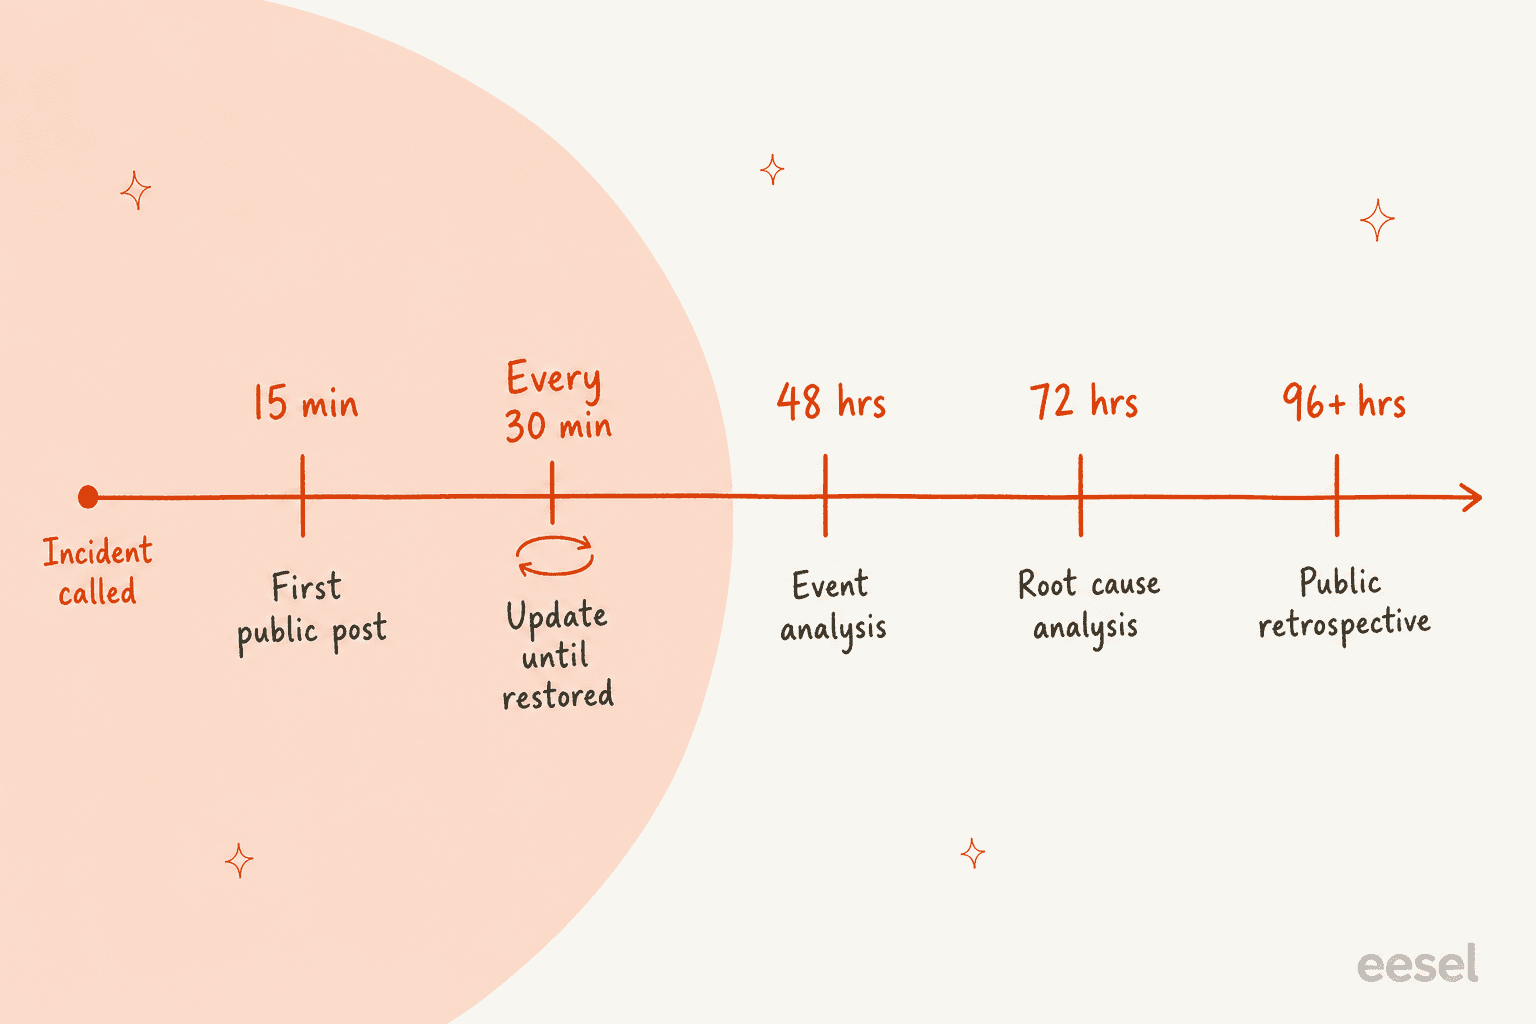
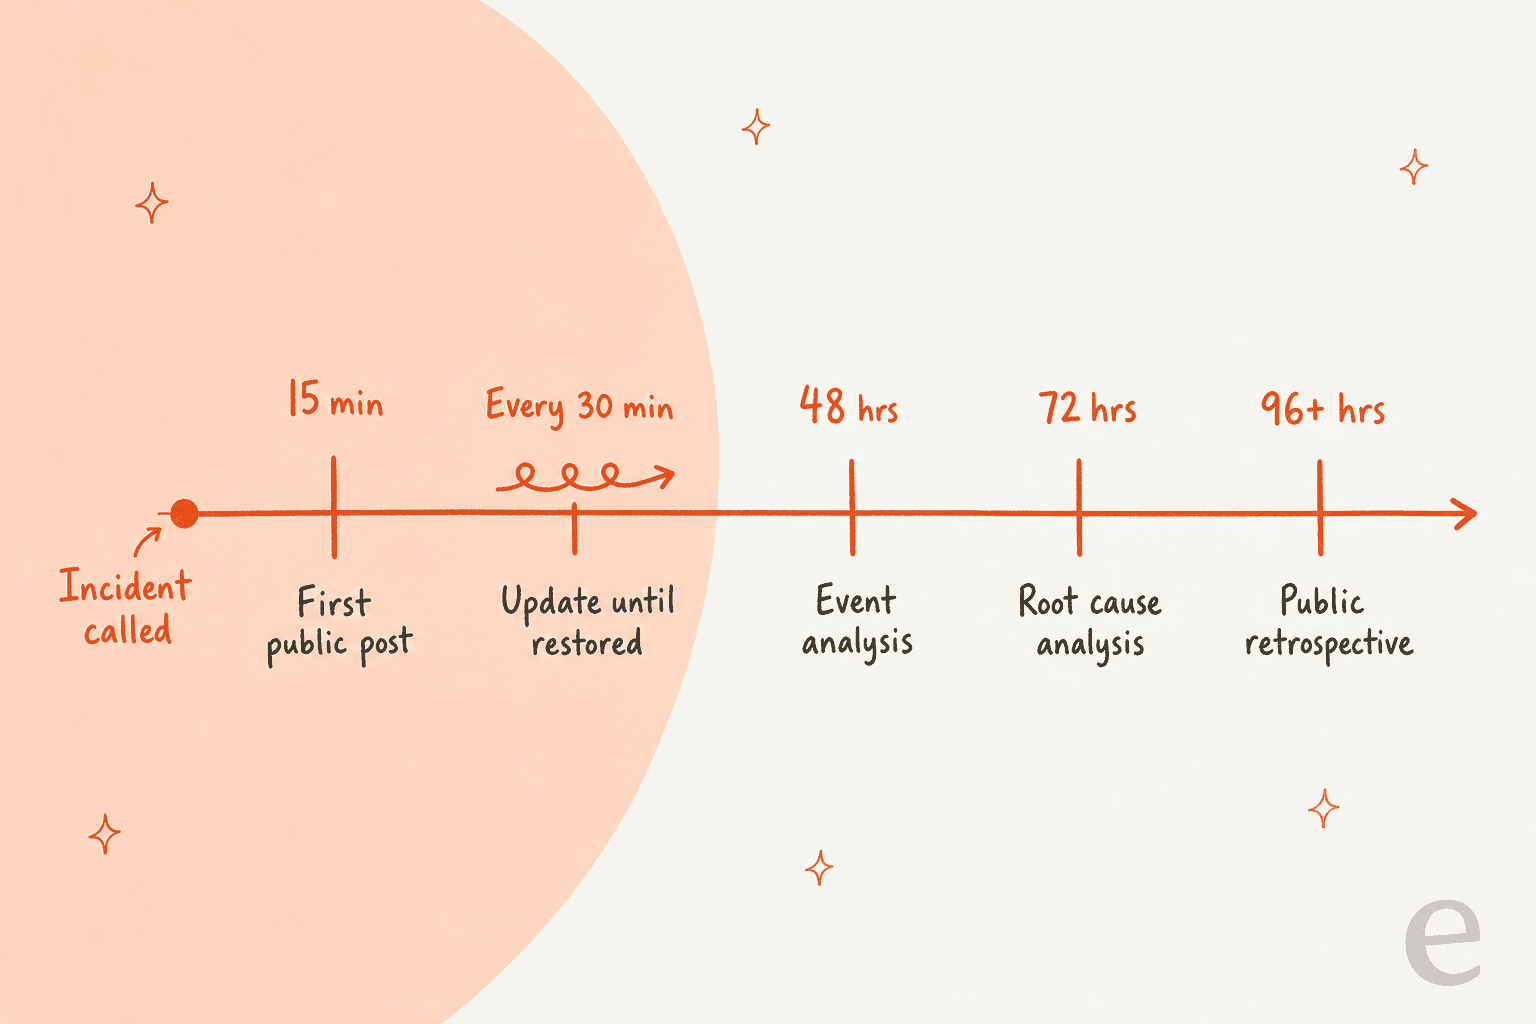
Zendesk publica su propio calendario, el ejemplo público más concreto que he encontrado. Su artículo sobre gestión de incidentes enumera los plazos internos que sigue:
| Etapa | Objetivo de Zendesk |
|---|---|
| Anuncio público | Dentro de los 15 minutos tras declarar el incidente |
| Actualizaciones del incidente | Cada 30 minutos hasta que el servicio se restablezca, o cuando llegue nueva información |
| Análisis del evento (gravedad 0 y 1) | Dentro de las 48 horas tras la resolución |
| Análisis de causa raíz | Dentro de las 72 horas tras la resolución |
| Retrospectiva pública del incidente | Dentro de 96 horas o más tras la resolución |
El número importa menos que cumplir la promesa. Si dices "próximo aviso a las 14:30" y publicas a las 14:50, los siguientes 20 minutos de tickets tratarán sobre el aviso que faltó, no sobre la interrupción. Los clientes también se dan cuenta cuando lo cumples:
"They also updated the status page every hour (or when they had new information), which is what they said they would do in their status updates."

Una trampa más del ritmo: repetirte está bien, quedarte desactualizado no. incident.io señala que hay "a zillion different ways" de decir que todavía estás investigando, y una marca de tiempo reciente con "sin cambios, seguimos trabajando en ello" es mejor que un mensaje intacto de hace tres horas. Si tu equipo de soporte trabaja con temporizadores de SLA, decide de antemano si los tickets de interrupción los pausan; esta guía de gestión de SLA cubre las opciones.
¿Quién es responsable de cada canal durante una interrupción?
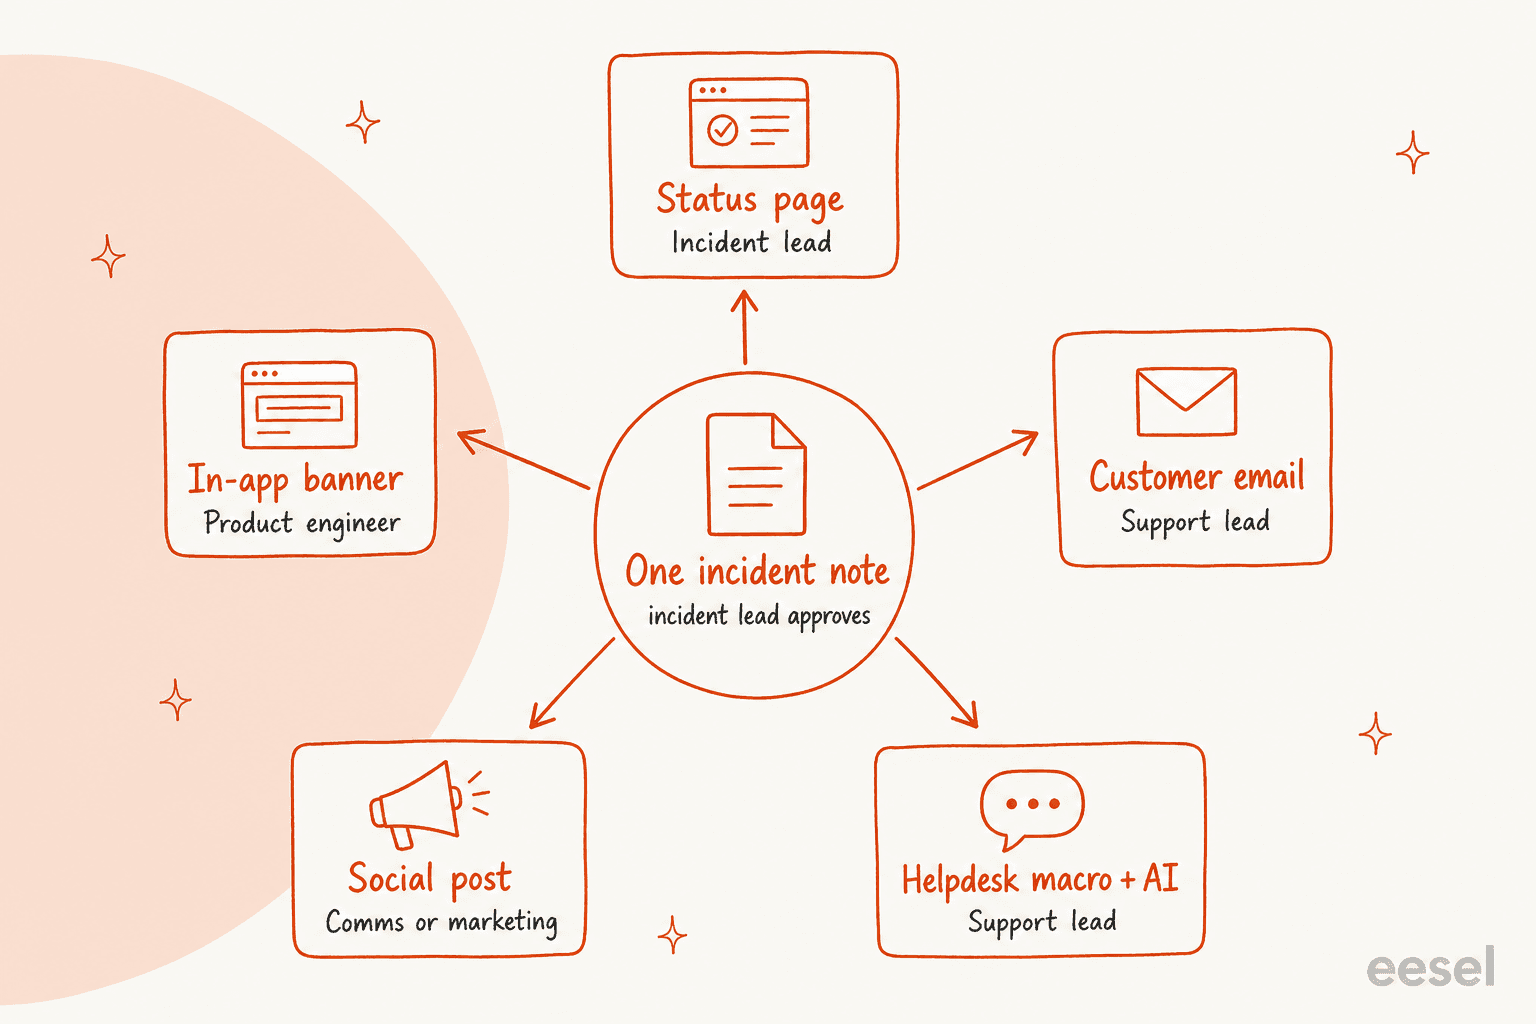
Una persona aprueba la nota de incidente, y cada canal tiene exactamente un responsable con nombre que copia de ella. Sin eso, la página de estado dice "algunos usuarios", el banner dice "todos los usuarios" y la respuesta de un agente dice "debería estar resuelto en 10 minutos", y ahora tienes tres historias distintas.
Así es como empezaría a repartirlo en una empresa SaaS de entre 20 y 200 personas:
| Canal | Responsable | Copia de la nota | Cuándo usarlo |
|---|---|---|---|
| Página de estado | Líder del incidente (o comunicación de guardia) | Aviso completo | Todo incidente que los clientes puedan ver |
| Banner en la app | Ingeniero de producto en el incidente | Una línea + enlace de estado | Cuando los usuarios están dentro del producto afectado |
| Correo a clientes | Líder de soporte | Resumen + qué hacer | Interrupciones largas, impacto en datos o cuentas clave |
| Publicación en redes sociales | Comunicación o marketing | Una línea + enlace de estado | Cuando los clientes ya están publicando sobre ello |
| Respuesta automática, macros e IA del helpdesk | Líder de soporte | Texto de la etapa actual | Siempre, desde el primer ticket duplicado |
Atlassian hace el mismo planteamiento por capas: publica los incidentes en su página de estado, empuja las actualizaciones a redes sociales, y muestra un anuncio en su portal de servicio, con cada mensaje señalando de vuelta a la página de estado. Su guía también enumera al equipo de soporte de primera línea como su propia audiencia, las personas que "directly answering questions and giving customers updates", que es la parte que la mayoría de los manuales de incidentes se saltan. Si tu equipo de soporte solo se entera de la causa por la página de estado pública, ya has perdido 15 minutos. Una solución sencilla es canalizar las actualizaciones del incidente al canal de soporte, de la misma forma en que conectarías Zendesk con Slack para las alertas de tickets.
¿Qué deberían decir la página de estado y el banner en la app?
El widget de arriba contiene el texto de la página de estado y el banner para cada etapa. Hay tres reglas detrás.
Empieza con el síntoma del cliente, no con tu sistema. "Los pagos fallan al finalizar la compra" es algo que un cliente puede relacionar con lo que ve. "Tasa de error elevada en payments-api" no lo es. La biblioteca de Atlassian sí mantiene algunos títulos a nivel de sistema ("Elevated API Errors", "Webhook failures"), que funcionan para una audiencia de desarrolladores. Adapta las palabras a quién lee tu página.
Nombra el alcance con honestidad. "Algunos usuarios" y "todos los usuarios" significan cosas distintas para un cliente que decide si esperar o escalar. Si todavía no lo sabes, di "algunos usuarios" y acótalo en el siguiente aviso, nunca al revés.
Dale al canal de soporte un plan de respaldo. La biblioteca de Atlassian tiene una plantilla para cuando el propio portal de soporte está caído, que remite a los clientes a un correo o cuenta de redes sociales secundaria. Eso no es paranoia. Durante la interrupción de Cloudflare del 18 de noviembre de 2025, su página de estado también cayó, aunque está alojada por completo fuera de la infraestructura de Cloudflare. Resultó ser una coincidencia, pero por un momento convenció a parte del equipo de que estaban bajo ataque.
Para el banner, comprueba si tu herramienta lo retira por ti. La documentación de anuncios de estado de Better Stack dice claramente que el anuncio no se actualiza automáticamente según el estado del servicio; lo eliminas borrando el texto y guardando.
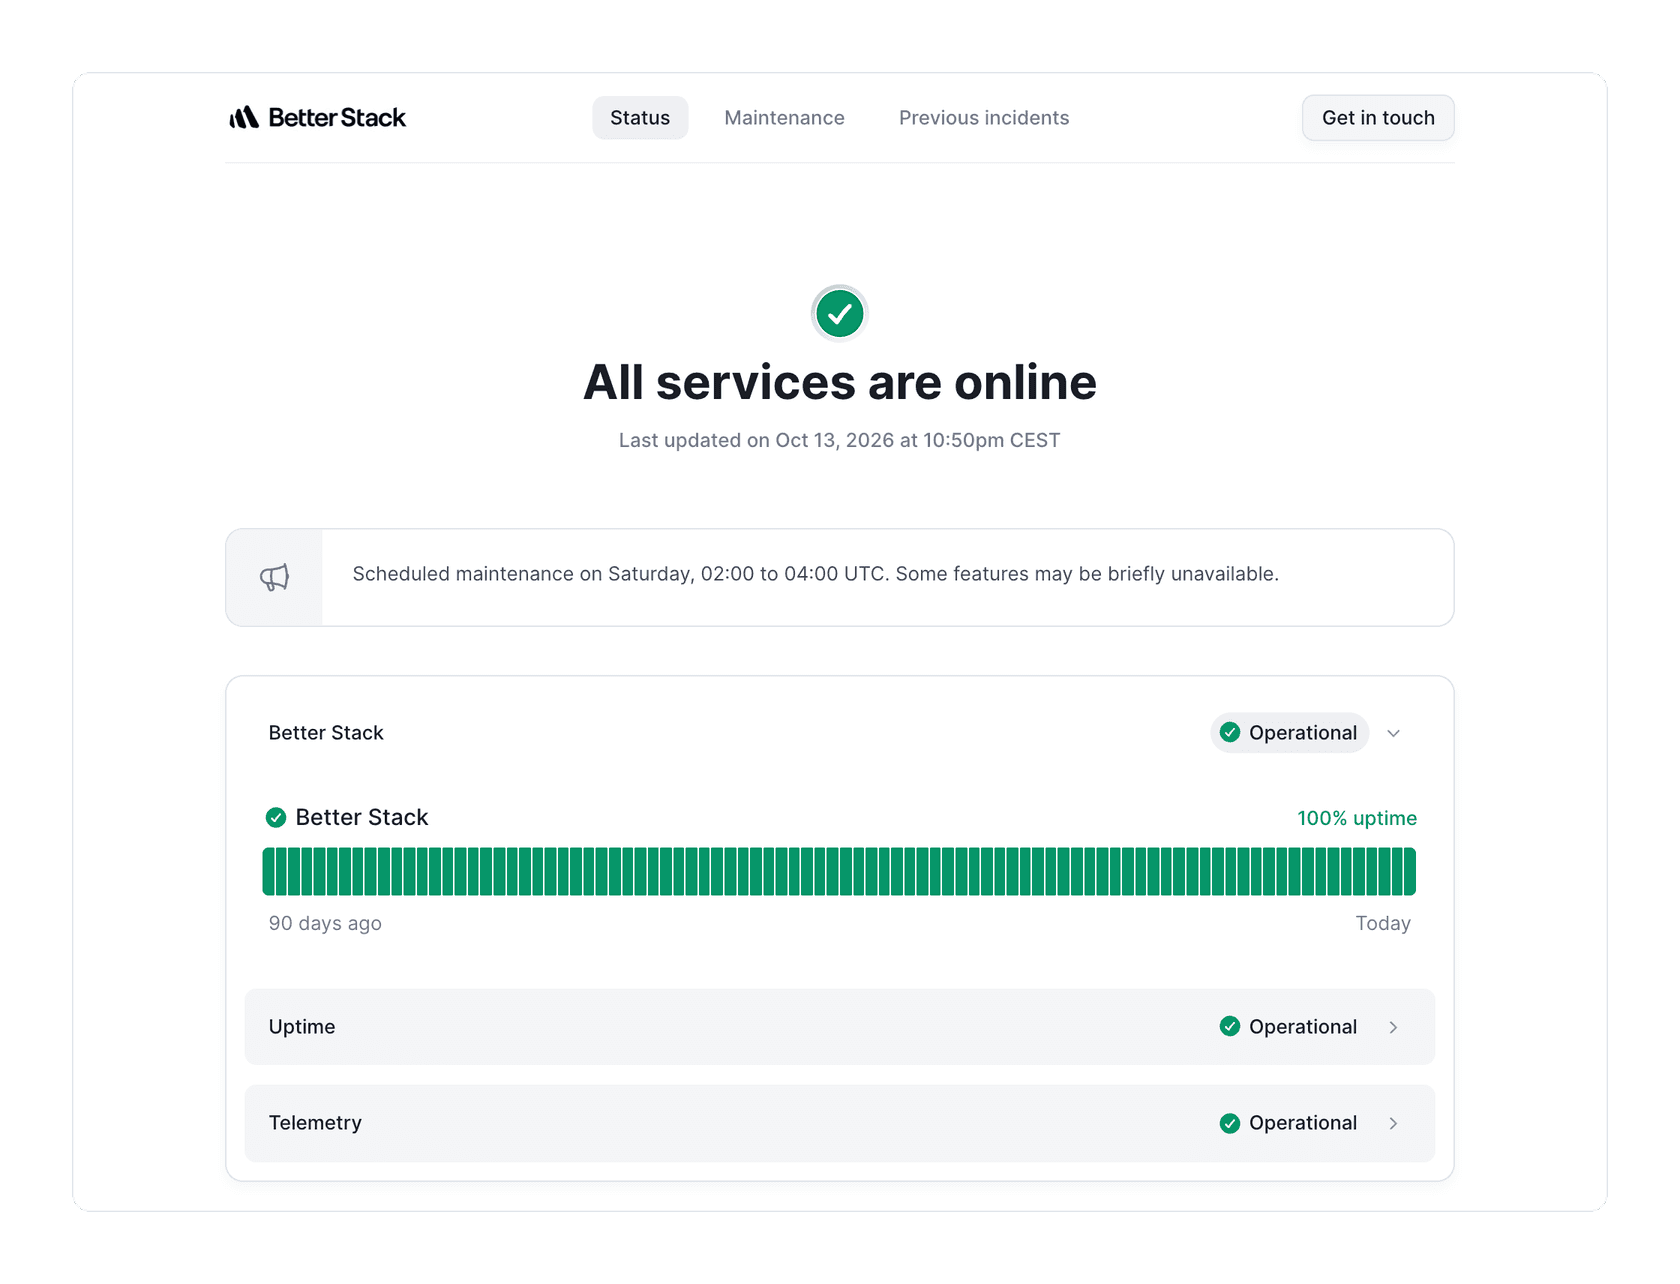
Pon "retirar el banner" en la lista de comprobación de resuelto, o los clientes verán un aviso de interrupción de un problema que arreglaste ayer. Las actualizaciones de estado automáticas tienen su propia trampa: la documentación de actualizaciones de página de estado de Better Stack indica que editar una actualización automática la convierte en manual, y entonces tienes que añadir tú mismo la actualización de Resuelto. Si usas Atlassian, mi guía sobre páginas de estado de Jira Service Management cubre el lado de la configuración.
¿Qué debería decir el correo de interrupción a los clientes?
El correo es para interrupciones que duran lo suficiente, o golpean con suficiente fuerza, como para que los clientes necesiten algo en su bandeja de entrada: retrasos de datos, pagos fallidos, una interrupción de varias horas, o cuentas con SLA. Para un fallo de 15 minutos, la página de estado y las notificaciones a suscriptores son suficientes. Aquí tienes los dos correos que aprobaría de antemano.
Correo 1: aviso de interrupción (enviado una vez, pronto, a las cuentas afectadas)
Asunto: [Función] no está disponible para algunas cuentas ahora mismo

Hola [nombre],

Desde las [hora de inicio, zona horaria], [función] ha estado
[lo que ven, p. ej. sin cargar / enviando notificaciones retrasadas]
para algunas cuentas, incluida la tuya.

Lo que sabemos: [una frase, o "todavía estamos investigando la causa"].
Lo que puedes hacer: [solución temporal, o "nada, tus datos están
seguros y en cola"].
Lo que estamos haciendo: [el equipo de ingeniería está trabajando en
una solución / estamos revirtiendo un cambio].

Las actualizaciones en vivo están en [enlace a la página de estado],
y te escribiremos de nuevo cuando esté resuelto. Si esto bloquea algo
urgente, responde a este correo y llegará directo a nuestro equipo de
soporte.

[Nombre], soporte de [Empresa]
Correo 2: resolución (enviado a todos los que recibieron el correo 1)
Asunto: Resuelto: [función] vuelve a funcionar

Hola [nombre],

[Función] vuelve a funcionar con normalidad. El problema duró de
[inicio] a [fin] [zona horaria].

Qué pasó: [una frase sencilla, sin nombres internos de sistemas].
Tus datos: [no se perdió ningún dato / X se retrasó y ya se ha puesto
al día / qué se vio afectado y qué hicimos al respecto].
Qué sigue: compartiremos un informe completo antes del [fecha] en
[enlace].

Siento que esto se cruzara en tu día. Si algo todavía no está bien,
responde aquí y revisaremos tu cuenta directamente.

[Nombre], soporte de [Empresa]
Dos notas sobre esto. Envía el correo 2 exactamente a la lista que recibió el correo 1, para que nadie quede con la duda. Y mantén la disculpa en una sola línea que nombre el impacto; mis ejemplos de mensajes de disculpa y las plantillas de correo de atención al cliente profundizan más en el tono.
¿Qué deberías publicar en redes sociales durante una interrupción?
Las redes sociales son un señalizador, no una segunda página de estado. La guía de Atlassian dice que las uses como parte del plan, pero no como tu único canal. Publica cuando los clientes ya estén hablando de la interrupción públicamente, manténlo breve, y enlaza siempre la página de estado para que las actualizaciones vivan en un solo lugar.
Investigando: algunos clientes no pueden [acción] en [producto]
ahora mismo. Estamos en ello. Actualizaciones en vivo: [enlace a la
página de estado]

Identificado: hemos encontrado la causa del problema de hoy con
[función] y lo estamos solucionando. Actualizaciones cada 30 minutos
aquí: [enlace a la página de estado]

Resuelto: [función] vuelve a funcionar con normalidad. Disculpa la
interrupción de hoy. Qué pasó y qué estamos cambiando: [enlace]
Responde a las quejas individuales con el enlace de estado y una invitación a abrir un ticket, no con resolución de problemas en público. Si alguien comparte datos de su cuenta en una respuesta, muévelo al helpdesk.
¿Cómo gestionas la avalancha de tickets de interrupción en el helpdesk?
Aquí es donde los líderes de soporte pierden la mayor parte de su día, y es el canal que más planes de interrupción olvidan. Tres plantillas hacen el trabajo pesado: una respuesta automática, una macro con etiquetas, y una nota interna para que los agentes no improvisen.
Respuesta automática mientras el incidente está abierto
Asunto: Re: {%subject%}

Gracias por escribirnos. Sabemos que [función] no está funcionando
para algunos clientes ahora mismo y nuestro equipo de ingeniería lo
está solucionando. Actualizaciones en vivo: [enlace a la página de
estado].

No necesitas hacer nada, y no necesitas enviar otro mensaje.
Actualizaremos esta conversación cuando esté resuelto. Si tu pregunta
no es sobre este problema, responde y una persona la atenderá.
Comprueba cómo envía las respuestas automáticas tu helpdesk antes de contar con una. La respuesta automática de Help Scout va solo al primer correo de una conversación, y a cada dirección una vez cada 24 horas por defecto, así que un cliente que ya recibió tu respuesta automática normal esta mañana no verá la de la interrupción. Si usas Zendesk o Gorgias, mis guías sobre las respuestas automáticas de Zendesk y las respuestas automáticas de Gorgias cubren la configuración de los disparadores, y las buenas prácticas de respuesta automática cubren el texto.
Macro para agentes (añade una etiqueta y la respuesta de la etapa actual)
Nombre de la macro: Interrupción - [ID del incidente] - [etapa]
Acciones:
  Añadir etiqueta: outage_[incident_id]
  Establecer tipo: Incidente (vinculado al ticket de problema)
  Comentario (público): [pega la respuesta de helpdesk para la etapa
    actual]
En Zendesk, solo los administradores pueden crear macros compartidas para todo el equipo, así que crea el conjunto de interrupción antes de necesitarlo, y las macros se aplican a uno o varios tickets a la vez. La palanca más grande es el ticket de problema: cuando lo resuelves, la documentación de problemas e incidentes de Zendesk dice que cada ticket de incidente vinculado se resuelve y recibe el mismo comentario. Eso convierte tu plantilla de resuelto en el único mensaje que cierra todo el montón. Mi recorrido por los tipos de ticket de Zendesk muestra la vinculación, y también puedes automatizar el tipo de ticket. En Freshdesk, las piezas equivalentes son las respuestas predefinidas y los tickets vinculados. Si eres nuevo en construir esto, empieza con cómo crear una macro y mis plantillas de macros.
Nota interna para agentes (fíjala donde trabajan)
INTERRUPCIÓN [ID del incidente] - etapa actual: [Investigando]
Última actualización: [hora] por [líder del incidente]
Decir: [resumen seguro para el cliente en dos líneas]
No decir: una ETA, la causa antes de confirmarla, "todos los usuarios",
  nada sobre créditos.
Escalar a [nombre/canal]: informes de pérdida de datos, preguntas de
  seguridad, cuentas enterprise, cualquiera que pida un reembolso o
  crédito.
Próxima actualización prevista: [hora]
La lista de "no decir" es la línea que te salva. Los agentes bajo presión llenan el silencio con suposiciones, y una ETA inventada en un ticket se convierte en una captura de pantalla en una queja una hora después.
¿Qué nunca deberías prometer en un mensaje de interrupción?
Nunca prometas lo que la nota de incidente no dice. En la práctica son cuatro cosas:
- Una ETA que no te han dado. La guía de incident.io dice "It's absolutely fine to say 'we don't know how long it'll take'", y que después de unas horas los clientes pueden razonablemente esperar una estimación en horas, días o semanas. Antes de eso, la hora del próximo aviso hace el trabajo.
- Una causa raíz antes de confirmarla. El propio informe de Cloudflare dice que el equipo inicialmente "wrongly suspected" un ataque DDoS a gran escala. Imagina esa suposición en un aviso público.
- Un alcance que no has comprobado. Decir "no se perdió ningún dato" antes de que el equipo de ingeniería lo confirme es la promesa que luego te muerde.
- Créditos o reembolsos sin una política. Deriva siempre eso a una persona.
La honestidad sobre el estado de las cosas importa más que el pulido. Este comentario, en un hilo sobre el fallo de la API de Instagram mientras su página de estado seguía en verde, resume cómo leen los clientes una página que no coincide con la realidad:
"There is nothing more frustrating than a status page that lies about the state of an API. Feels like insult + injury. I'd rather they not even have a status page!"
Y el fallo opuesto, el silencio, se percibe igual de mal:
"A status page is not something you update only when things are calm. It is part of the response itself. It is how you keep users informed and maintain trust when everything else is going wrong."
La misma regla se aplica a cualquier IA que responda tickets por ti. SE Ranking, que usa eesel en el chat de Zendesk para tres productos, configuró su agente para que nunca prometa cosas que el equipo no pueda cumplir: nada de "un agente humano se está uniendo ahora", sin descuentos, sin reembolsos. Cuando un cliente necesita a una persona, dice que puede esperar una respuesta en uno o dos días hábiles y entrega el caso con el nombre y el correo del cliente.
¿Qué debería decir la autopsia de cara al cliente?
Hechos simples con horas, una disculpa sin matices, y qué estás cambiando. Los mejores ejemplos públicos siguen una forma similar. El historial de estado de GitHub lo muestra en dos capas: la actualización de resuelto es breve ("This incident has been resolved... A detailed root cause analysis will be shared as soon as it is available."), y el resumen del incidente de seguimiento empieza con horas exactas: "Between 19:05 and 21:27 UTC on November 13, 2026, GitHub Copilot experienced degradation...", y luego nombra la causa y qué se hizo.
El informe de Cloudflare empieza con la hora de inicio en UTC, dice sin rodeos que la interrupción "was not caused, directly or indirectly, by a cyber attack", y se disculpa sin matices: "We know we let you down today." Aquí tienes una plantilla de cara al cliente construida sobre esa forma:
Título: interrupción de [función] el [fecha]: qué pasó y qué estamos cambiando

Resumen
El [fecha], entre las [inicio] y las [fin] [zona horaria], [número o
proporción de] clientes [lo que experimentaron]. [El problema no fue
causado por un incidente de seguridad / qué impacto de seguridad
hubo.]

Lo que experimentaste
- [Síntoma 1, p. ej. los paneles no cargaban]
- [Síntoma 2, p. ej. las notificaciones se retrasaron hasta X minutos]
- [Impacto en los datos, indicado con precisión]

Qué pasó
[Dos a cuatro frases simples: el cambio o el fallo, por qué se
propagó, cómo lo encontramos, cómo lo arreglamos.]

Cronología ([zona horaria])
[HH:MM] [Primer impacto en los clientes]
[HH:MM] [Incidente declarado, primer aviso público]
[HH:MM] [Causa identificada]
[HH:MM] [Solución desplegada, monitorizando]
[HH:MM] [Resuelto]

Qué estamos cambiando
- [Cambio 1, con equipo responsable y fecha objetivo]
- [Cambio 2]

Lo sentimos. [Una frase que nombre el impacto en los clientes.]
Si tienes preguntas sobre tu cuenta, responde a [dirección de soporte].
Escríbela mientras está fresca. La guía de autopsias de Atlassian sugiere documentar dentro de las 24 a 48 horas tras la resolución, y Zendesk apunta a su retrospectiva pública 96 horas o más después. Si quieres ayuda redactando la versión interna, el artículo sobre revisiones posteriores al incidente escritas por IA cubre lo que hace la herramienta de Atlassian.
¿Dónde entra la IA en la comunicación de interrupciones?
Sobre todo en el helpdesk, donde está el volumen. La página de estado es una publicación cada 30 minutos; el helpdesk puede ser cientos de tickets casi idénticos en la misma ventana. Mis compañeros han escrito los artículos más extensos sobre soporte con IA durante interrupciones de SaaS, IA para actualizaciones de páginas de estado e IA para la comunicación de incidentes mayores, así que aquí me centro en cómo se conectan las plantillas de arriba.
La configuración es fácil de describir: la nota de incidente actual se convierte en el conocimiento desde el que responde la IA, y las líneas de "no decir" y "escalar" se convierten en sus reglas. El compañero de equipo de IA para helpdesk de eesel (mira cómo se compara en este resumen de helpdesk con IA) trabaja dentro de tu Zendesk o Freshdesk actual, así que los tickets de interrupción reciben la respuesta de la etapa actual en el mismo hilo que usan tus agentes, y todo lo que se salga del guion, como una solicitud de reembolso o un informe de pérdida de datos, va a una persona con el contexto adjunto. También ayuda con tu tasa de desvío en los días de interrupción, sin tocar los tickets que necesitan criterio humano.

Cambiar las instrucciones del agente es un mensaje de chat, como en la captura de arriba, lo cual importa cuando el incidente pasa de Identificado a Monitorizando y el texto tiene que cambiar con él. SamCart es un buen ejemplo de cómo se ve eso a gran volumen: ejecuta un agente de eesel en los tickets de Freshdesk y otro en el chat de su web, respondiendo desde unos 280 artículos del centro de ayuda, en un plan de 8.000 interacciones al mes, que un mes ajetreado ya ha superado.
Tres cosas que haría antes de la próxima interrupción:
- Carga las plantillas como conocimiento ahora. Sube de antemano las respuestas por etapa, la respuesta automática y la lista de "no decir". Con la CLI de eesel, un agente de código con IA puede ejecutar
eesel files uploadsobre la nota de incidente aprobada en mitad del incidente, luego hacerle preguntas de prueba al agente coneesel chaty revisar las respuestas antes de que responda a los clientes. Conectar el helpdesk en sí sigue necesitando a alguien con acceso de administrador que lo apruebe en esa herramienta. - Prueba la transferencia, no solo las respuestas. He visto lo que pasa cuando esto no se prueba: un cliente nuestro de hosting web holandés en Zendesk tenía un bot que decía a los clientes que los estaba transfiriendo a una persona cuando la transferencia nunca se completaba. En un día de interrupción, eso es el peor fallo posible, así que haz una escalada simulada de principio a fin. Mis guías sobre transferencia humana en el chat y escalada con IA cubren lo que lleva una transferencia limpia.
- Mídelo después. Etiqueta cada ticket de interrupción que la IA haya tocado y revisa la contención y calidad de escalada en la autopsia, junto a la cronología de la página de estado. SE Ranking pidió exactamente esto, una etiqueta
ai_handleden cada ticket que toca eesel, para que la contención se cuente en Zendesk en lugar de suponerse.
Prueba eesel para tu próxima interrupción
Si tu página de estado está cubierta pero tu helpdesk se ahoga cada vez que algo se rompe, eesel es la pieza que yo añadiría. Se une a tu helpdesk actual como una nueva incorporación al equipo de soporte, responde a los tickets de problemas conocidos a partir de la nota de incidente que aprobaste, usa tu texto de la etapa actual mientras avanza el incidente, y pasa a tu equipo los reembolsos, las preguntas sobre datos y todo lo que no esté claro. Puedes ver cómo gestiona tus propios tickets anteriores antes de que hable con un cliente.

Prueba eesel en tu helpdesk, o consulta primero los precios.