

La IA para actualizaciones de la página de estado funciona mejor apuntando en el otro sentido: que la página de estado alimente a la IA, y no la IA a la página de estado. La página de estado es el único lugar donde ingeniería ha acordado qué es cierto. Un agente de IA que la lee puede relacionar cada ticket de «¿está caído?» con el incidente declarado, responder con el texto publicado palabra por palabra y hacer seguimiento de cada ticket cuando la página diga Resolved.
Redactar la actualización de estado sigue siendo una decisión humana. La IA puede redactarla a partir del canal del incidente, pero un ingeniero la aprueba antes de que salga, porque ese mensaje llega a todos los clientes a la vez.
La infraestructura ya existe: Statuspage envía un webhook en cada actualización de incidente desde su plan Startup de $99, y tanto Zendesk como Freshdesk agrupan los tickets de caídas, pero ninguno escribe las respuestas mientras la caída está activa. Ese hueco es el trabajo de un compañero de IA como eesel, que SE Ranking usa en 4,650 conversaciones al mes con agentes configurados para no prometer nunca lo que el equipo no puede cumplir.
¿Por qué la página de estado va por detrás de la bandeja de soporte?
Construyo integraciones en eesel, así que paso mucho tiempo leyendo lo que las API y los webhooks envían de verdad, en contraste con lo que dice la página de marketing. Las páginas de estado son un buen ejemplo. Todas las grandes herramientas de páginas de estado ya anuncian cada actualización de incidente a quien se suscriba. La mayoría de los helpdesks nunca se suscriben.
Así que durante una caída corren dos relojes a la vez. Ingeniería arregla el problema y, cuando alguien tiene un minuto, publica una actualización. Soporte ve llegar tickets con la misma pregunta en cincuenta formulaciones distintas, y cada agente revisa Slack, la página de estado y a sus compañeros para saber qué puede decir. Un comentarista de Hacker News expuso el lado del cliente con claridad:
"If I'm having issues but you show all green, I'm submitting a case."

Y el retraso es real. Otro comentarista, sobre la caída de un proveedor de hosting:
"they only updated the status page to indicate that there's an issue ~20 minutes into the outage."
Veinte minutos son mucho tiempo en una cola de soporte, y tu tiempo de primera respuesta se resiente. La solución a la que recurren la mayoría de los equipos es «que la IA escriba las actualizaciones de estado más rápido». Creo que eso resuelve el problema pequeño. El grande es que la página de estado y el helpdesk no hablan entre sí, así que cada agente se convierte en un relevo humano entre ambos. Si has leído mi guía de soporte durante caídas, este artículo es el cableado que hay debajo: cómo la página de estado se convierte en la fuente de verdad de la IA.
¿Cómo deberían trabajar juntas la IA y la página de estado?
El patrón que yo construiría tiene cinco pasos, y solo en uno la IA escribe algo nuevo.
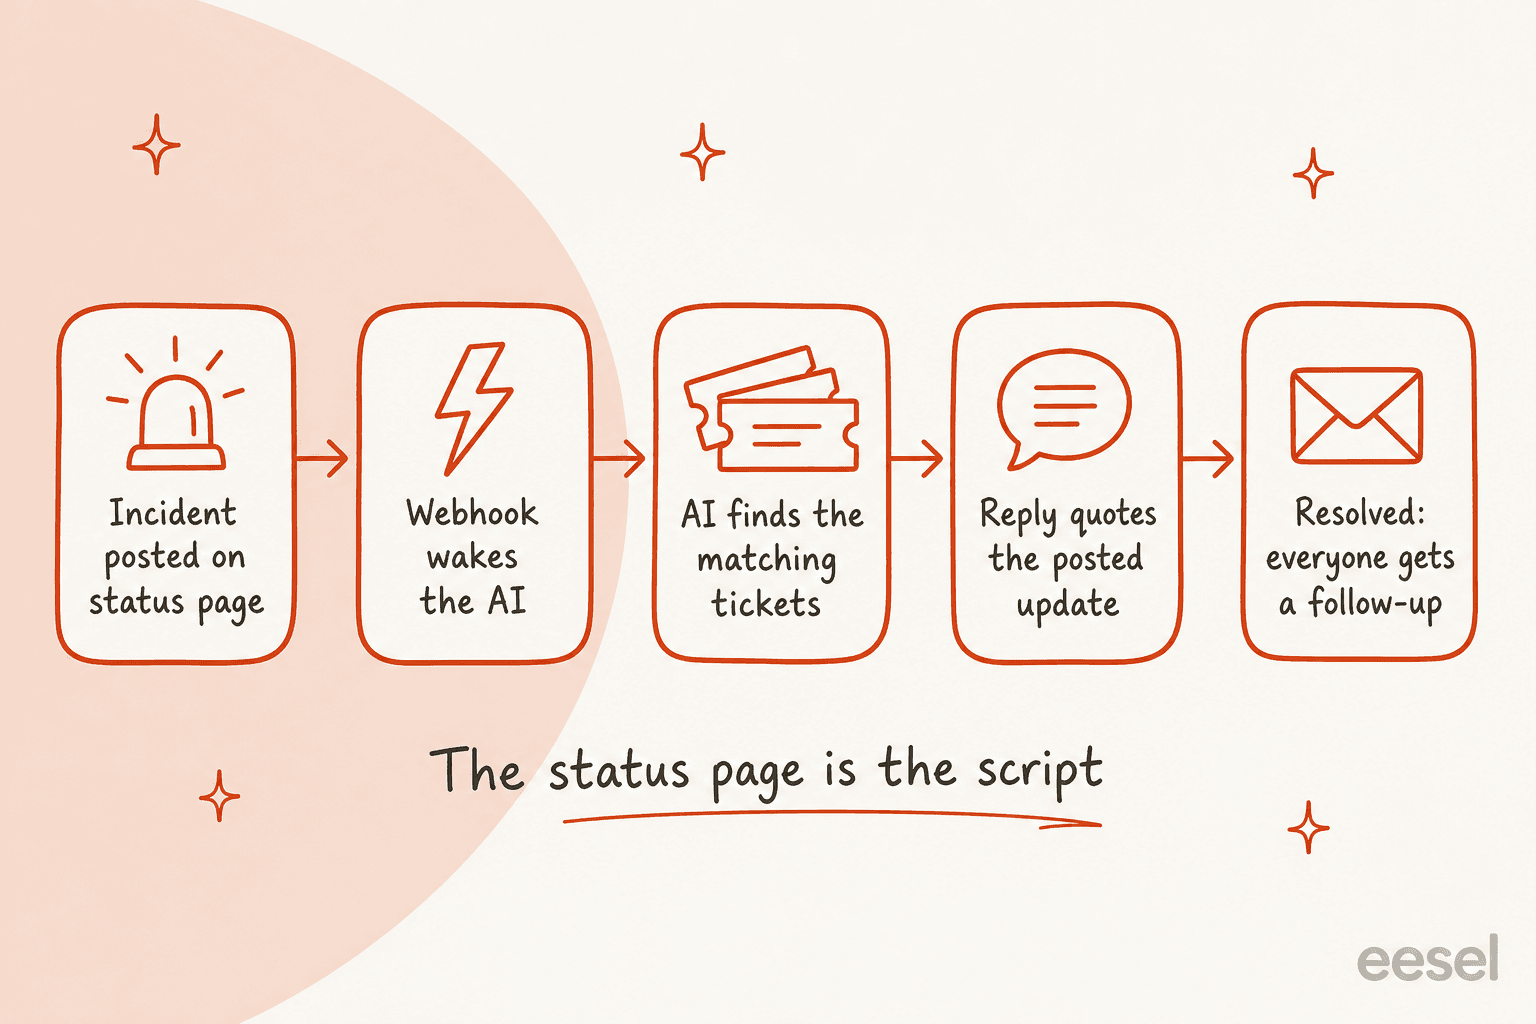
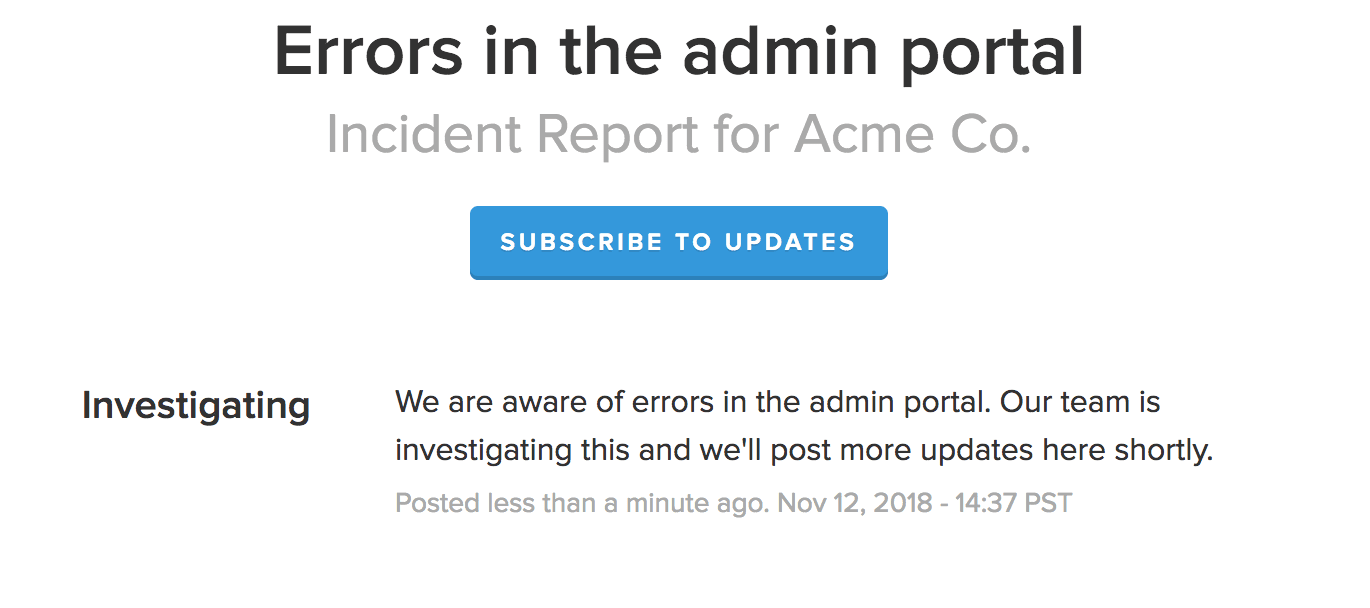
- Un ingeniero publica el incidente. En Atlassian Statuspage son un nombre, uno de cuatro estados (Investigating, Identified, Monitoring, Resolved), un mensaje y los componentes afectados.
- La página de estado avisa a la IA. Un webhook se dispara en cada creación o actualización, y la IA lee el nombre del incidente, el estado, el mensaje y los componentes.
- La IA encuentra los tickets coincidentes. Los tickets nuevos y abiertos que describen el componente afectado se etiquetan con el incidente, de forma parecida a como la deduplicación de tickets agrupa preguntas repetidas.
- La respuesta cita la página de estado. El cliente recibe el mensaje publicado y un enlace, nada que los ingenieros no hayan escrito.
- Resolved cierra el ciclo. Cuando el estado pasa a Resolved, cada ticket etiquetado recibe un seguimiento, incluidos los que se quedaron en silencio.
El motivo de este orden: la IA nunca decide qué es cierto sobre la caída. Decide qué tickets tratan de la caída, una tarea de clasificación en la que la IA es buena. Los hechos vienen de la página.
¿Qué envían realmente los webhooks y las API de las páginas de estado?
Esta es la parte que más me importa, porque decide qué puedes construir sin código a medida.
Atlassian Statuspage puede enviar un webhook "when you create or update an incident, or update a component status", según su guía de notificaciones por webhook. La carga incluye el estado general de la página, el componente que cambió con su estado anterior y nuevo, o el incidente y su última actualización. Tu endpoint tiene que responder con un código 2xx en 30 segundos. Las notificaciones por webhook empiezan en el plan Startup a $99 al mes; Free y Hobby solo listan correo, Slack y Teams.
También hay un lado de lectura. Cada página pública de Statuspage expone un endpoint de resumen con el indicador de estado, los estados de los componentes y los incidentes sin resolver, sin necesidad de clave. La API REST de Statuspage autenticada permite crear y actualizar incidentes, con un límite de 1 solicitud por segundo por token. Ese límite es suficiente para publicar actualizaciones y poco adecuado para consultar de forma periódica desde un helpdesk ocupado.
incident.io integra la página de estado en su flujo de incidentes, de modo que "you're prompted to post when it matters most", y puedes "automate updates entirely or use templates with pre-approved messaging", según su página de status pages. Los clientes se suscriben por correo, Slack y RSS.
PagerDuty dice que sus páginas de estado externas permiten a los visitantes suscribirse "via email, Slack or webhook", lo que te da el mismo disparador push que Statuspage.
En una configuración con eesel, un push se convierte en una automatización por webhook: le pides al agente una URL, la pegas en la página de estado como suscriptor de webhook, y cada actualización de incidente despierta al agente con la carga completa. Un encabezado de entrega como X-Eesel-Reference, con el ID del incidente, agrupa todas las actualizaciones de un incidente en la página Activity. Para una página que no puede enviar push, Network Access permite al agente llamar directamente a la API de la página de estado, con la clave guardada en los ajustes y nunca mostrada a la IA.
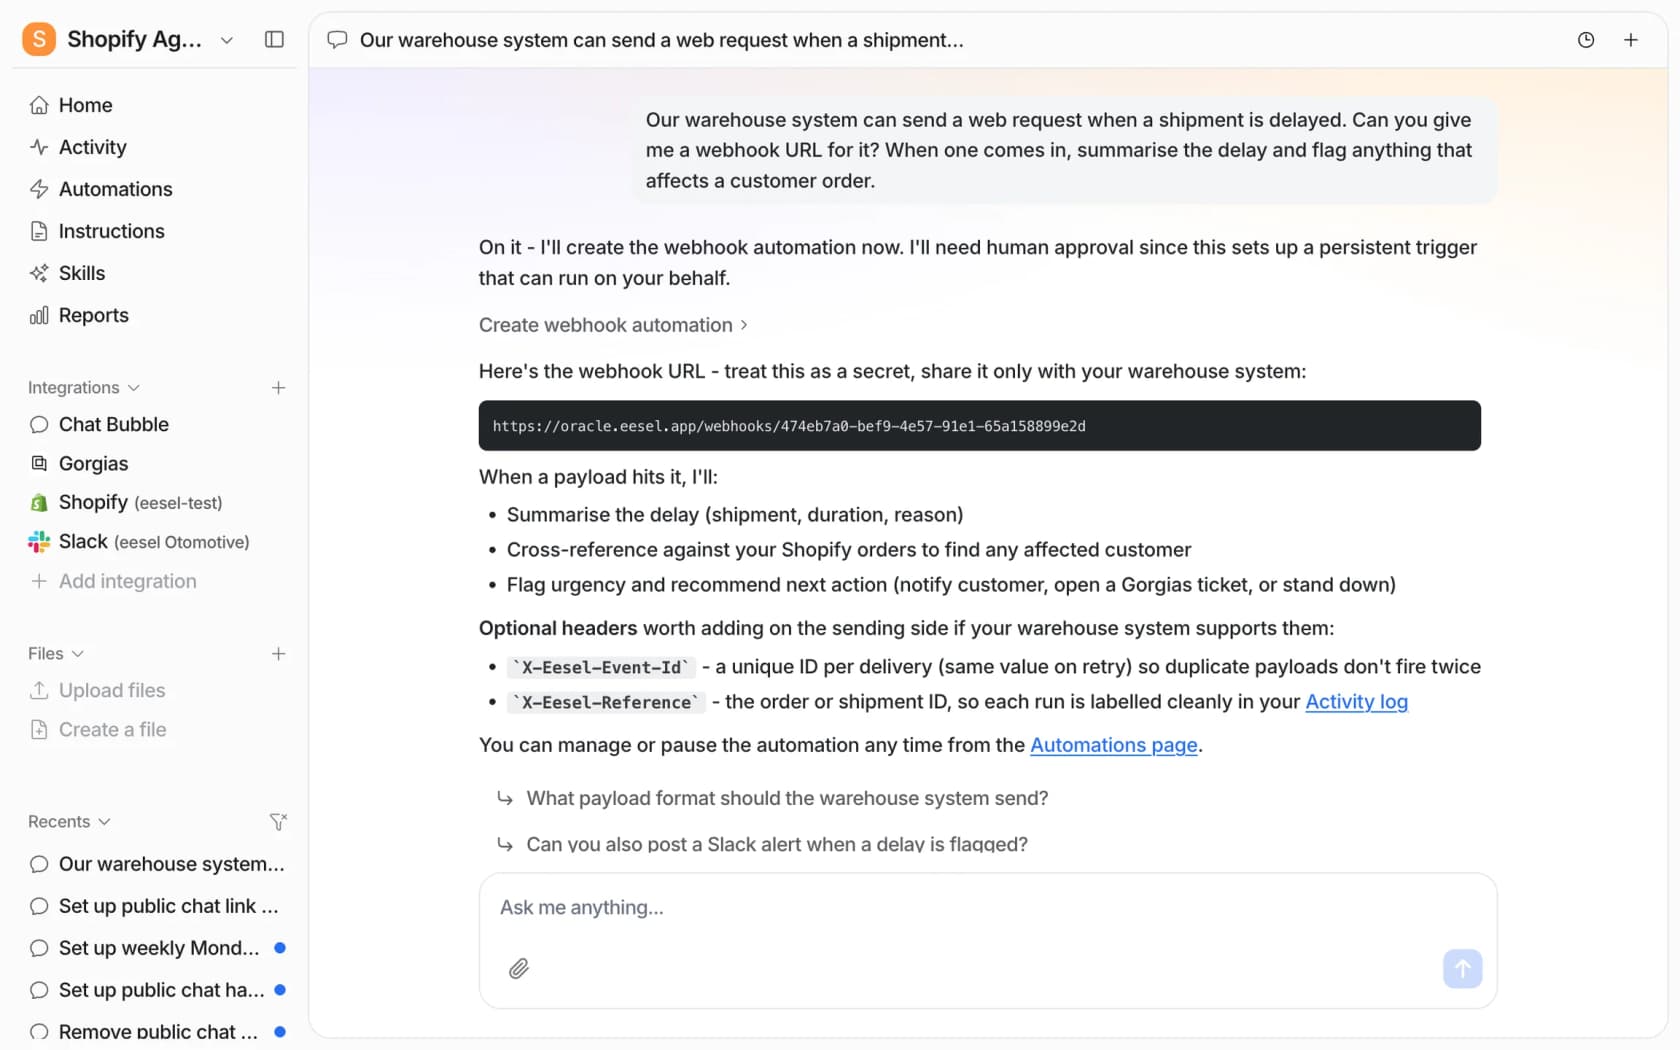
Dos límites que conviene conocer antes de un incidente, no durante. La URL de webhook de eesel acepta 60 entregas por minuto por espacio de trabajo y procesa ocho a la vez. Una página de estado envía un puñado de actualizaciones por incidente, así que sobra, pero es la razón por la que nunca apuntaría el flujo bruto de alertas de una herramienta de monitorización hacia ella. Aliméntala con el incidente confirmado por una persona, no con cada parpadeo.
¿Cómo debería clasificar la IA los tickets de caídas?
Cuando la IA sabe qué incidente está activo, cada ticket entrante va a uno de cuatro carriles. Aquí está la mayor parte del valor, y donde la mayoría de las configuraciones son demasiado toscas.
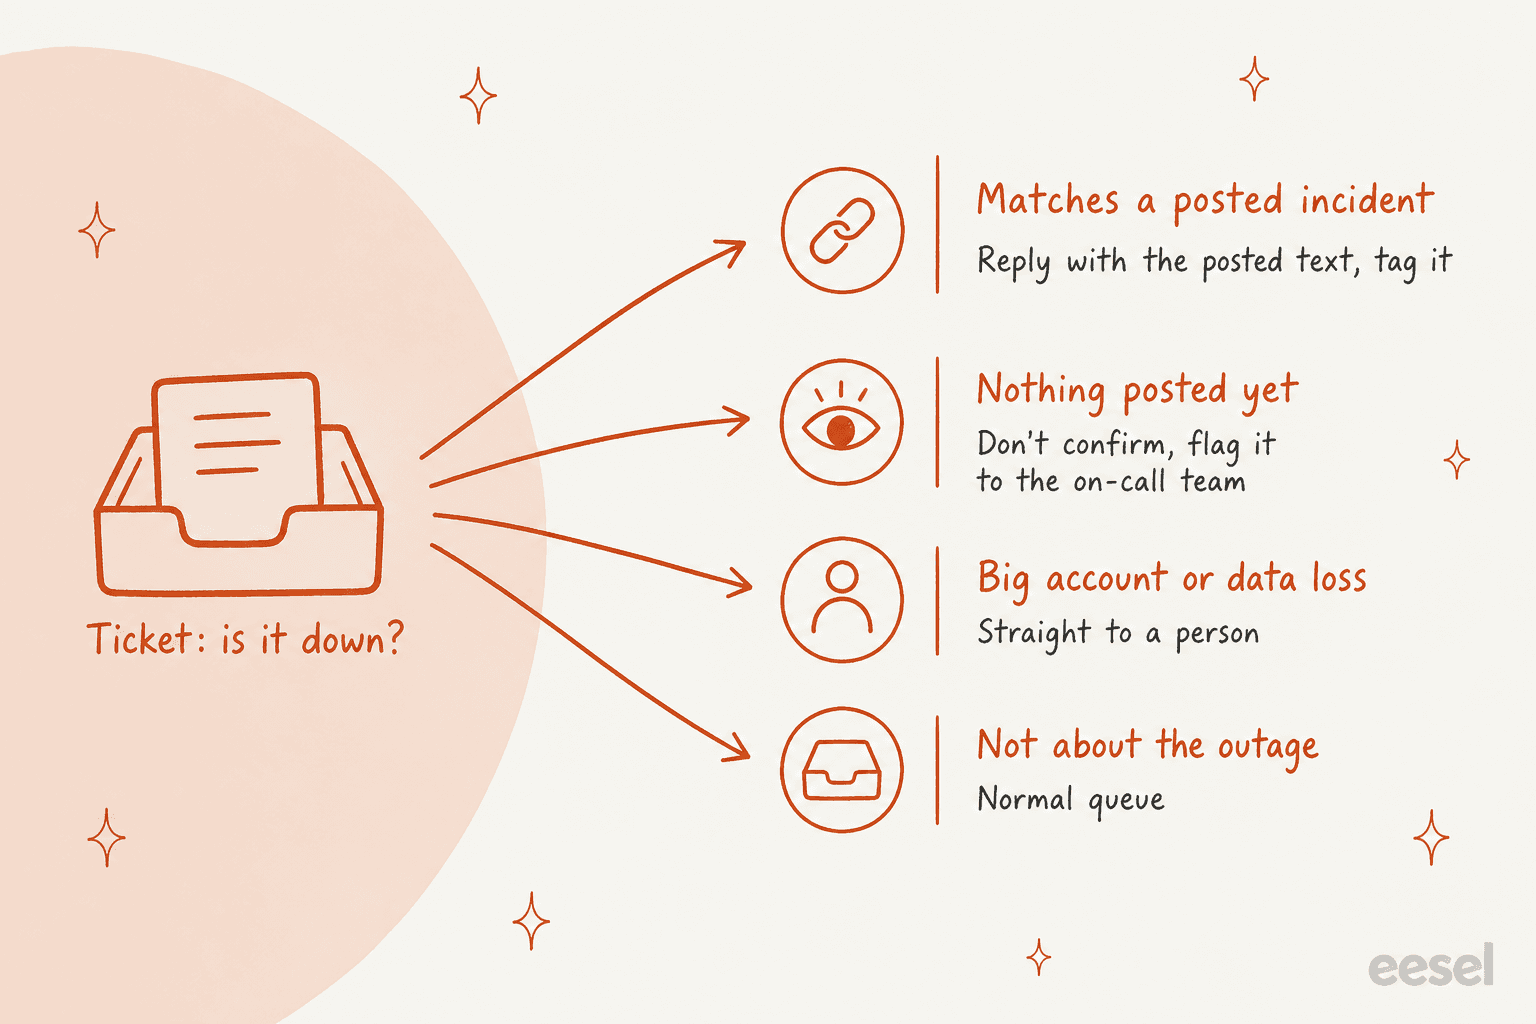
Coincide con un incidente publicado. El ticket menciona el componente afectado, o el síntoma que describe el incidente. La IA responde con el último mensaje publicado, enlaza la página de estado, dice que el ticket se actualizará cuando se resuelva y añade una etiqueta de incidente. Es el carril de más volumen y el primero que conviene automatizar, con la misma lógica que cualquier automatización de la primera respuesta.
Aún no hay nada publicado. Los clientes suelen notarlo antes que la página. Aquí la IA no debe confirmar una caída, porque no tiene nada con qué confirmarla. Puede decir que el equipo lo está revisando, etiquetar el ticket y publicar una alerta en el canal de guardia. Cinco tickets sobre el checkout en diez minutos sin incidente publicado son una alerta temprana, y soporte suele verla primero. Cuando se publica el incidente, la IA vuelve a esos tickets y también los responde.
Cuenta grande o pérdida de datos. Algunos tickets no deberían recibir una respuesta de plantilla, por muy exacta que sea. Cuentas enterprise con nombre, cualquiera que reporte datos perdidos, quien cite un SLA, quien pida créditos. Van a una persona mediante tus reglas normales de escalado de IA. Qontro, una empresa de software ERP que usa eesel en Freshdesk, envía las caídas, la pérdida de datos y las dudas de facturación directamente a una persona en lugar de dejar que la IA las investigue.
No trata de la caída. Una duda de facturación que llega en pleno incidente sigue siendo una duda de facturación. Va a la cola normal, y la IA no debería pegarle el texto del incidente solo porque el momento coincida. Vigila este caso en las pruebas, ya que es la falsa coincidencia más común, el mismo fallo que trato en reducir falsos positivos.
¿Qué debe decir la IA en plena caída, y qué nunca?
Las reglas son cortas, y marcan la diferencia entre una IA que calma a los clientes y una que crea un segundo incidente.
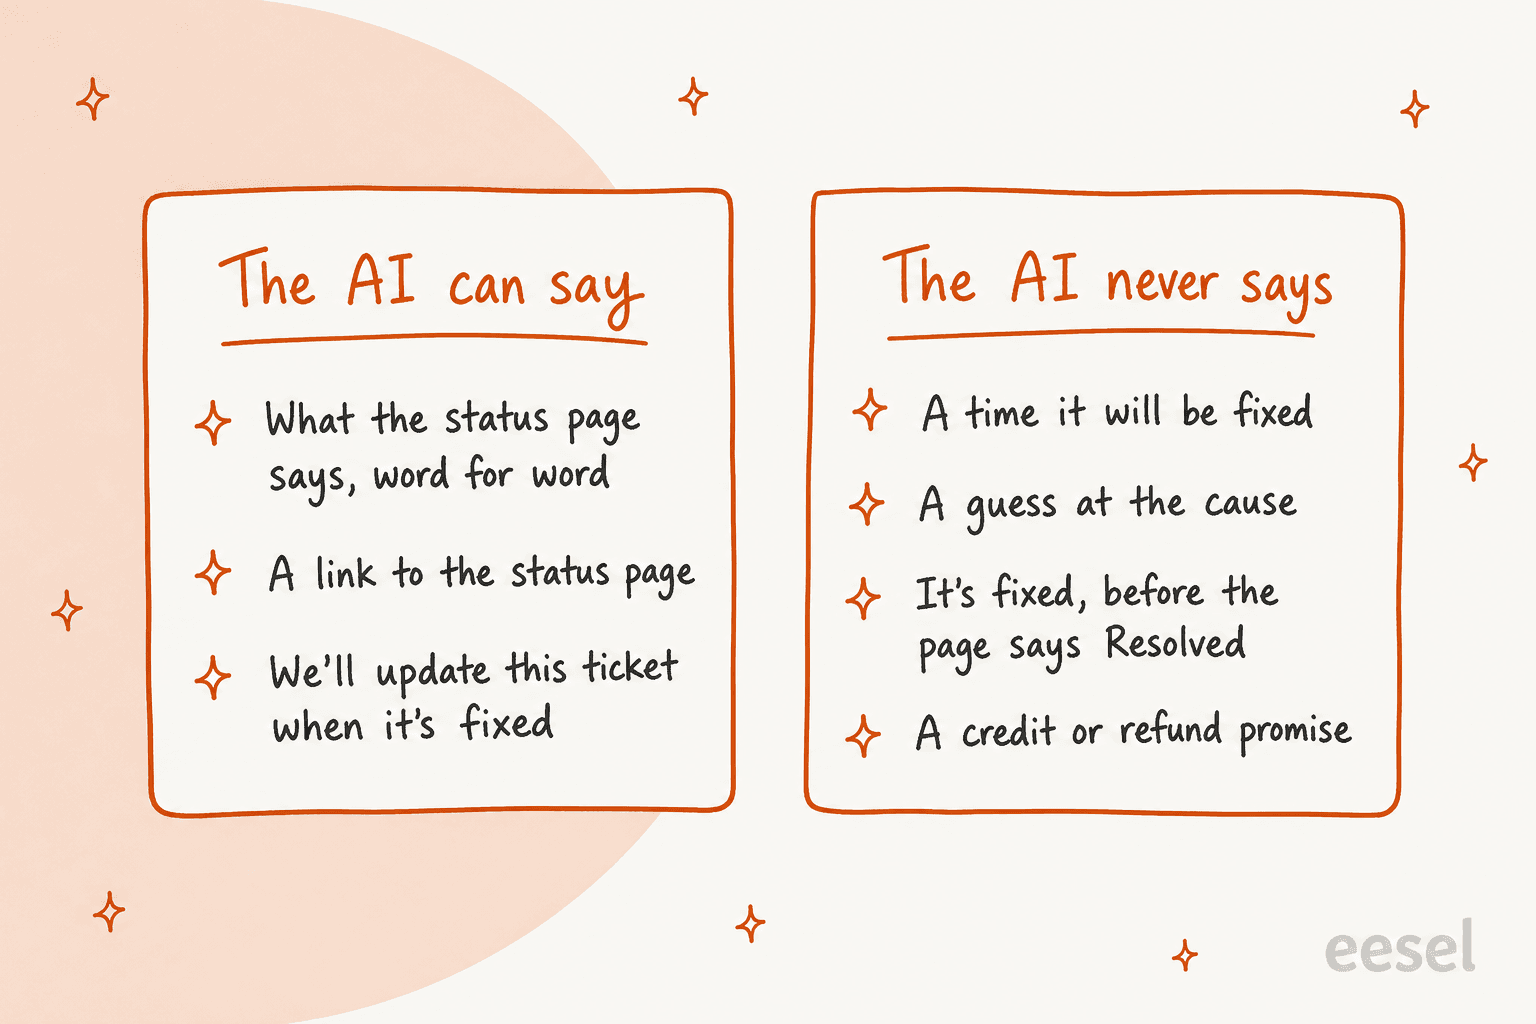
La lista de «nunca» gira en torno a una cosa: la IA solo puede repetir compromisos que ingeniería ha asumido. Un modelo al que se pregunta «¿cuándo volverá?» producirá con gusto una hora razonable, y eso es una alucinación de IA con marca de tiempo. Lo mismo con la causa raíz. Incluso «Identified» en Statuspage significa que el equipo ha encontrado la causa, no que la haya compartido.
Aquí tomaría ejemplo de cómo SE Ranking configuró sus agentes. El equipo quería que el chat en vivo se respondiera al instante "without the bot promising things the team could not deliver." Así que sus agentes de eesel dicen a los clientes que esperen una respuesta en uno o dos días laborables, nunca que alguien se une ahora mismo. Es el instinto correcto también para las caídas: una respuesta más lenta y verdadera vale más que una rápida e inventada.
También ayuda escribir la respuesta como una plantilla fija que la IA rellena, en lugar de dejar que componga libremente:
| Estado en la página | Qué contiene la respuesta de la IA |
|---|---|
| Investigating | El mensaje publicado, el enlace a la página de estado, «actualizaremos este ticket cuando se resuelva» |
| Identified | El nuevo mensaje publicado, el enlace, la misma promesa de seguimiento |
| Monitoring | El mensaje publicado, una nota de que hay una solución aplicada y vigilada, todavía sin «arreglado» |
| Resolved | El mensaje de resolución, una petición de que respondan si el problema continúa, y luego el ticket se resuelve |
¿Cómo gestionan hoy Zendesk y Freshdesk los tickets de caídas?
Los helpdesks llevan años con funciones para caídas. Agrupan bien los tickets. Lo que no hacen es escribir la respuesta al cliente, y en los detalles es donde encaja la IA.
Zendesk tiene tickets de problema e incidente: vinculas cada reporte a un ticket de problema, y al resolver el problema se resuelven los incidentes y se copia el comentario de cierre en cada uno sin resolver. Está en Suite Team y superiores. Dos límites del propio artículo de Zendesk importan aquí. "AI agent tickets can't be linked to problem and incident tickets", y cuando se resuelve el problema, "Customers are not notified using the messaging channel." Así que los tickets que gestionó el propio agente de IA de Zendesk, y los clientes que escribieron por mensajería, pueden perderse la actualización de cierre. Mi guía de tipos de ticket de Zendesk cubre la configuración, y puedes fijar el tipo automáticamente con una automatización.
Freshdesk tiene tickets vinculados, que agrupan reportes bajo un ticket «tracker». El propio ejemplo de Freshdesk es "your product is facing some unexpected downtime." Un comentario en el tracker se difunde a todos los tickets vinculados, pero "the internal broadcast message will be visible only to agents", así que un agente sigue escribiendo cada respuesta al cliente. Y resolver el tracker "would not resolve the linked tickets by default", según una FAQ de Freshdesk.
En conjunto, los helpdesks te dan la agrupación. El trabajo de la IA es lo que hay en medio: decidir qué ticket pertenece a qué incidente y escribir la respuesta al cliente a partir del texto de la página de estado. En Zendesk, una IA que escribe en los propios tickets de incidente también esquiva el límite de «AI agent tickets can't be linked», porque los tickets siguen siendo tickets normales.
¿Cuánto cuestan las herramientas de páginas de estado?
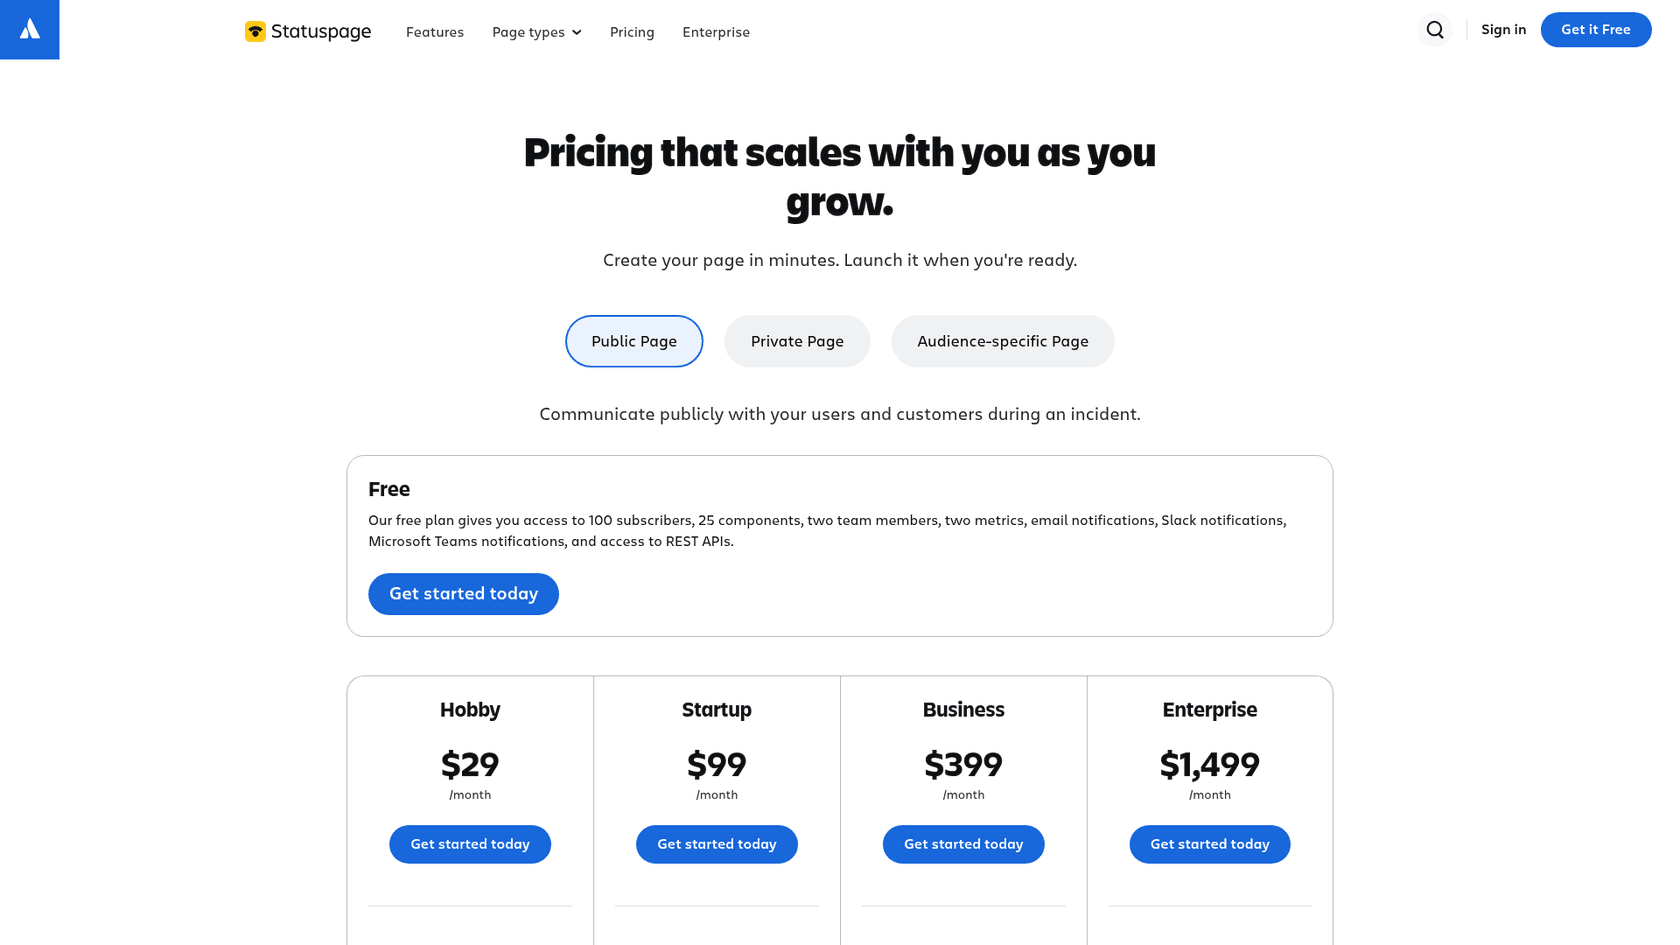
Esto es lo que cobra cada herramienta, según su propia página de precios el 30-10-2026. La página de estado suele ser la parte barata; el coste que sorprende a los equipos está en el lado del helpdesk, que trato a continuación.
| Herramienta y plan | Precio | Suscriptores | Webhook de salida | Funciones de IA |
|---|---|---|---|---|
| Statuspage Free | $0 | 100 | No (correo, Slack, Teams) | Ninguna indicada |
| Statuspage Hobby | $29/mes | 250 | No | Ninguna indicada |
| Statuspage Startup | $99/mes | 1,000 | Sí | Ninguna indicada |
| Statuspage Business | $399/mes | 5,000 | Sí, más suscripciones por componente | Ninguna indicada |
| Statuspage Enterprise | $1,499/mes | 25,000 | Sí | Ninguna indicada |
| incident.io Basic | Gratis | Ilimitados, 1 página pública | Correo, Slack, RSS | Editor básico de post-mortem |
| incident.io Team | $15/usuario/mes anual, $19 mensual | Ilimitados | Correo, Slack, RSS | Editor básico de post-mortem, flujos de trabajo |
| incident.io Pro | $25/usuario/mes | Ilimitados, más 1 página interna | Correo, Slack, RSS | Post-mortems nativos con IA |
| PagerDuty Free | $0 | Sin página de estado | n/a | n/a |
| PagerDuty Professional | $21/usuario/mes anual, $25 mensual | 250 en la página externa, más con el complemento Status Pages | Sí (correo, Slack, webhook) | Revisiones posincidente con IA mediante PagerDuty Advance |
| PagerDuty Reliability Platform Starter | $2,800/año | Incluido | Sí | Incluido |
Mi opinión: si ya usas incident.io o PagerDuty para las guardias, usa la página de estado que ya tienes. Si solo necesitas una página pública y quieres el webhook, Statuspage Startup a $99 es la línea que hay que cruzar. Ninguna de estas herramientas responde a tus tickets, sin embargo; eso sigue siendo trabajo del lado de soporte.
¿Cuánto cuesta una caída en el lado de soporte?
Aquí es donde los modelos de precios empiezan a importar. Una caída es un pico de soporte hecho de preguntas casi idénticas, y algunos precios de IA convierten ese pico en una factura.
Zendesk cobra su agente de IA por resolución automatizada: $1.50 cada una con volumen comprometido o $2.00 de pago por uso, después de las 5 a 10 incluidas por agente al mes. Freshdesk vende sesiones del Freddy AI Agent a $49 por 100 tras 500 gratis una sola vez. Los precios de eesel son un lote mensual fijo de créditos, donde un ticket o chat es un crédito: $299 por 500, hasta $1,749 por 5,000. Introduce abajo tu propia caída.
La cuestión no es que un modelo sea siempre más barato. Es que el precio por resolución convierte una caída, el día en que tu equipo ya está más presionado, en un evento de coste variable. Un lote mensual fijo es más fácil de presupuestar si tu producto tiene algún mal día ocasional.
¿Debería la IA escribir ella misma la actualización de la página de estado?
Puede redactarla. Yo no dejaría que la publique. El mensaje de la página de estado es la pieza de comunicación de la caída que llega a todos los clientes a la vez, y cada respuesta de soporte posterior lo cita. Si está mal, todo lo construido sobre él está mal.
Un comentarista de Hacker News, al responder si las páginas de estado se actualizan automáticamente, expuso bien el equilibrio:
"Typically no because there's an art to crafting the actual message around impact… but sometimes yes it is automated"
El buen término medio es un borrador con un paso de aprobación. La API REST de Statuspage acepta un nuevo incidente o actualización como un simple POST, así que un agente de IA con Network Access a api.statuspage.io puede preparar la actualización desde el canal del incidente, y un ingeniero la aprueba antes de publicarse. En eesel eso es una acción configurada como Needs approval: el agente se detiene, muestra el texto exacto y espera Approve o Deny. Del lado de los incidentes, el plan Pro de incident.io incluye un editor de post-mortem nativo con IA y PagerDuty ofrece revisiones posincidente generadas por IA mediante su complemento Advance, así que el informe posterior queda cubierto ahí.
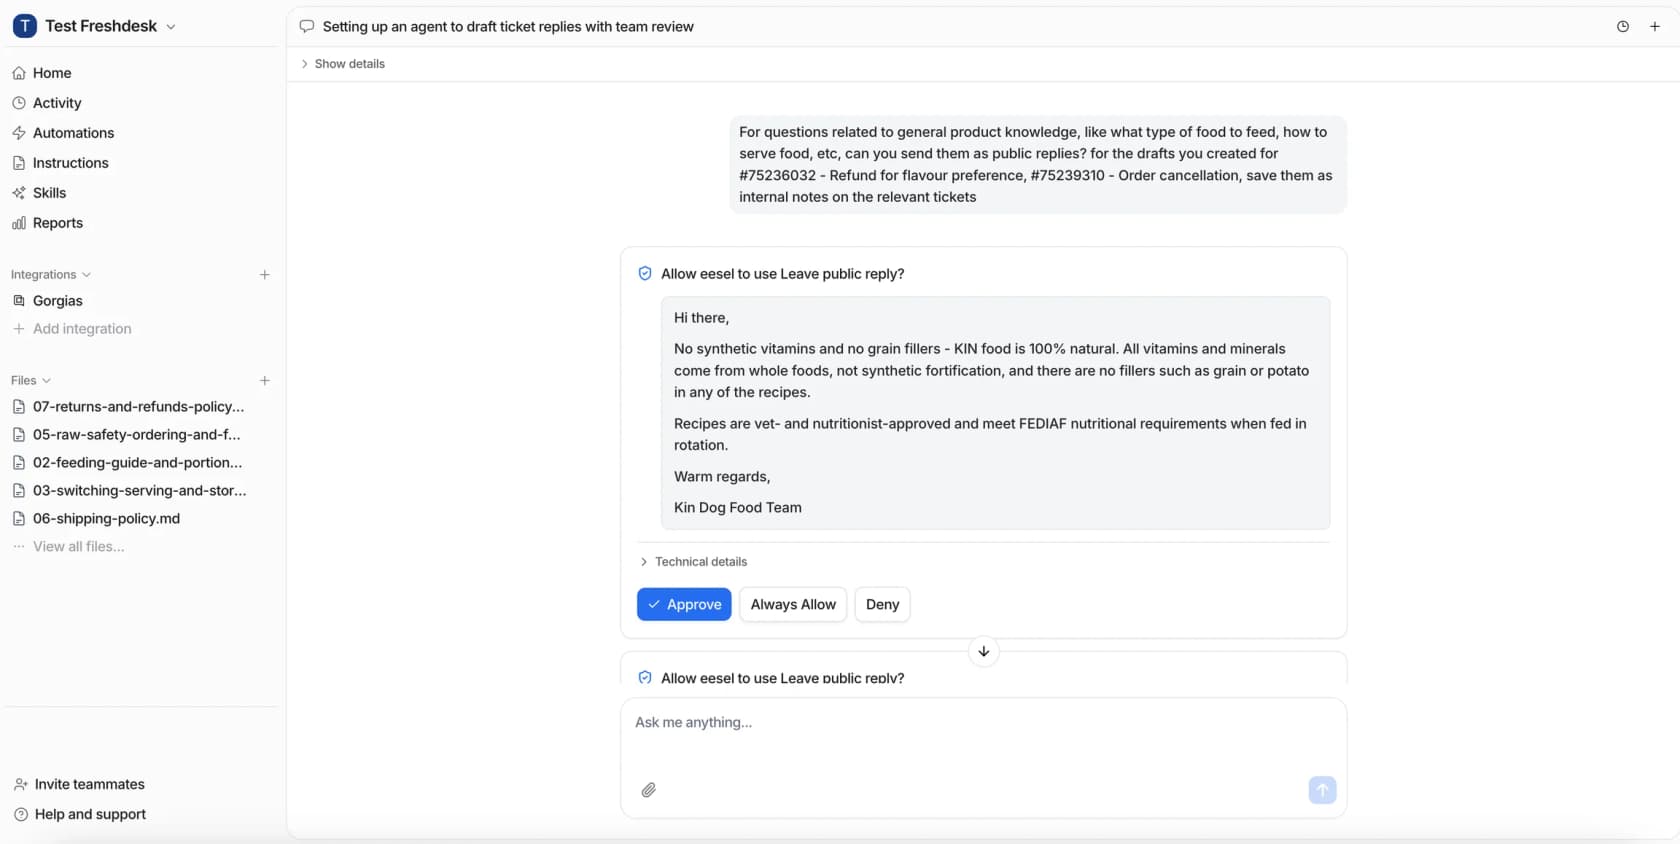
Así es también como empezaría con las respuestas del lado de soporte. Lesson Pro usa eesel en dos cuentas de Zendesk, donde dejó 1,700 notas internas y redactó 560 respuestas en un mes, con el equipo aprobando antes de que nada llegara a un cliente. Empezar supervisado con las respuestas de caídas te cuesta unos minutos en el primer incidente y te dice exactamente qué habría enviado la IA.
¿Cómo lo configuras antes de la próxima caída?
La configuración lleva una tarde. Hacerlo en pleno incidente lleva mucho más, así que este es el orden que seguiría.
- Elige la fuente de verdad. Una página de estado, un conjunto de nombres de componentes. Si ingeniería y soporte llaman de forma distinta al servicio de checkout, arregla eso primero, porque la IA relaciona los tickets por componente.
- Suscribe la IA a la página. En Statuspage Startup o superior, o en PagerDuty, añade la URL de webhook del agente como suscriptor. Si no, usa el endpoint de resumen público o la API del proveedor mediante Network Access.
- Escribe los carriles en las instrucciones. Los cuatro carriles de arriba, la plantilla de respuesta por estado y la lista de «nunca decir». Nombra las cuentas enterprise y las palabras clave que se saltan la respuesta automática.
- Elige tu etiqueta y tu regla de seguimiento. Una etiqueta de incidente por caída, y una regla por la que Resolved dispare un seguimiento en cada ticket etiquetado. En Zendesk también puedes vincular los tickets a un ticket de problema y actualizar el estado en bloque si prefieres cerrarlos a mano.
- Prueba con una caída pasada. Reproduce los tickets de tu último incidente real y comprueba cada carril, el enfoque de mi guía de pruebas de simulación. Vigila de cerca el carril «No trata de la caída».
- Empieza con borradores y luego pasa a producción. Pon las respuestas públicas en Needs approval durante el primer incidente, y cambia el carril correspondiente a Auto cuando los borradores sean correctos. Mantén los créditos y reembolsos tras aprobación de forma permanente.
- Cuéntalo. Etiqueta cada ticket de caída gestionado por la IA para poder informar sobre ello, como SE Ranking pidió una etiqueta
ai_handleden cada ticket que eesel toca, "so containment is counted in Zendesk, not guessed." Mi guía de informes de soporte cubre el resto.
Si prefieres configurarlo desde una terminal, o que lo haga un agente de programación, la CLI de eesel ejecuta el mismo agente que el panel. eesel automations lista la automatización por webhook y la activa o desactiva, eesel activity muestra qué hizo el agente con cada actualización de incidente y eesel approvals lista las respuestas que esperan a una persona. Cada comando imprime JSON con una opción --dry-run para las escrituras, por lo que Claude Code, Cursor o Codex pueden llevar toda la configuración y leer sus propios resultados.
Prueba eesel con tickets de caídas
eesel es un compañero de IA para tu helpdesk, y los tickets de caídas son un primer trabajo limpio para él. Lee cada actualización de tu página de estado, relaciona los tickets de «¿está caído?» en Zendesk, Freshdesk o Gorgias con el incidente, responde con el texto publicado y hace seguimiento de cada uno cuando la página dice Resolved. Las cuentas grandes y la pérdida de datos van directas a tu equipo, como Qontro encamina sus tickets de caídas.
Empieza con borradores y aprobaciones activadas, reproduce tu última caída y cambia el carril correspondiente a Auto cuando confíes en él. Los planes empiezan en $299 al mes por 500 tickets, con 100 créditos gratis para probarlo antes. Prueba eesel.