Meta Muse für Confluence: So kommt dein Wiki 2026 in Metas WhatsApp-KI

Kira

Katelin Teen
Zuletzt bearbeitet September 29, 2026
Kurz gesagt
„Meta Muse für Confluence“ heißt in Wahrheit, deine Confluence-Wissensdatenbank an den Meta Business Agent zu verfüttern, die KI, die Kunden auf WhatsApp und Messenger antwortet. Muse selbst ist ein Consumer-Agent. Der Business Agent hat keinen Confluence-Importer. Er lernt aus vier Quellen: Unternehmensinfos, FAQ-Einträgen, hochgeladenen Dateien und gecrawlten öffentlichen Websites.
Damit bleiben vier Wege. Du kannst einen Space öffentlich machen, damit Meta ihn crawlen kann (ab dem Standard-Plan, und Google indexiert ihn ebenfalls), Seiten als PDF oder Word exportieren und hochladen, Artikel als FAQ-Einträge umschreiben (Meta warnt, dass die Qualität ab ein paar Hundert nachlässt) oder einen Connector bauen, der Confluence per Service-Account live durchsucht. Der Haken ist die Aktualität. Hochgeladene Dateien aktualisieren sich nie, und Metas eigene Doku warnt, dass der Agent alte und neue Version zitiert, wenn du vergisst, eine zu löschen.
Das erste Produkt von eesel war eine KI-App für Confluence, ich habe also viele Teams gesehen, die einen Chatbot auf ein Wiki richten wollten. Wenn sich dein Confluence jede Woche ändert, liest eesel die Spaces, die du auswählst, indexiert Seiten neu, sobald du sie bearbeitest, und verlinkt in jeder Antwort die Quellseite. Niemand muss ein Export-Skript betreiben.
Was „Meta Muse für Confluence“ eigentlich bedeutet
Ich baue beruflich Agent-Funktionen, und trotzdem brauche ich bei Metas Namensgebung 2026 einen Moment, um alles zu entwirren. Drei Meta-Produkte tragen den Namen Muse oder stehen ihm nahe, und nur eines spricht mit deinen Kunden:
- Muse, der persönliche KI-Agent, den Meta für Alltagserledigungen von Privatpersonen gestartet hat. Er ist nicht dafür gebaut, die Kunden eines Unternehmens zu beantworten.
- Muse Spark 1.3, das Modell, das über die Meta Model API verkauft wird. Darauf könntest du selbst einen Confluence-Bot bauen. Meine Übersicht zu Muse Spark 1.3 enthält die Modelldetails.
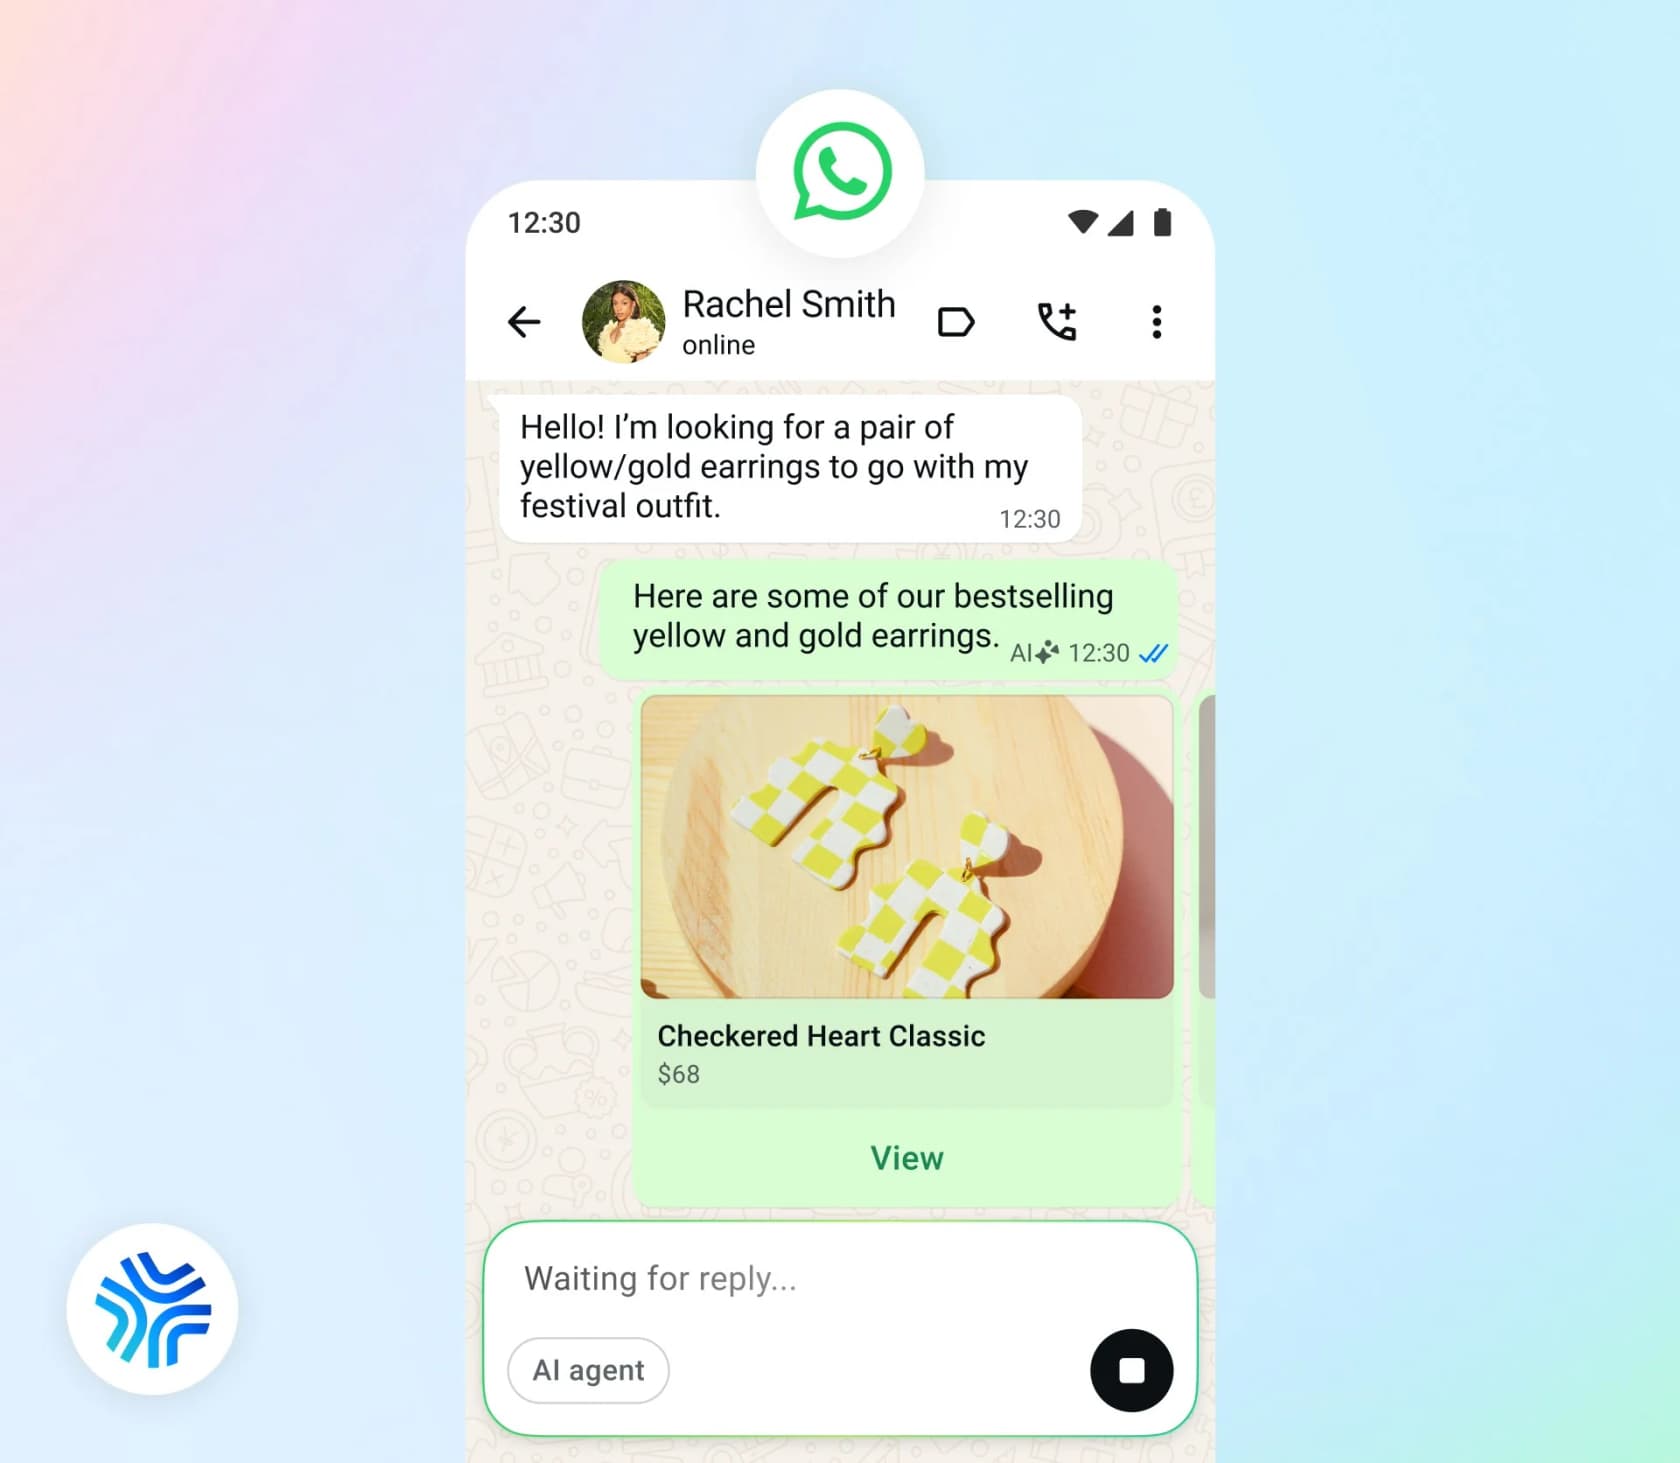
- Meta Business Agent, den Meta im Juni gestartet hat, als die KI, die Kunden auf WhatsApp, Messenger und Instagram antwortet. Laut Meta nutzen ihn schon mehr als eine Million Unternehmen.
Confluence passt anders als die Helpdesk-Beiträge dieser Reihe. Zendesk, Freshdesk und Jira Service Management sind Orte, an denen Unterhaltungen landen. Confluence ist der Ort, an dem die Antworten liegen. Die Frage lautet also nicht, wie ein WhatsApp-Chat zu deinem Team kommt, sondern wie dein Wiki zum Bot kommt.
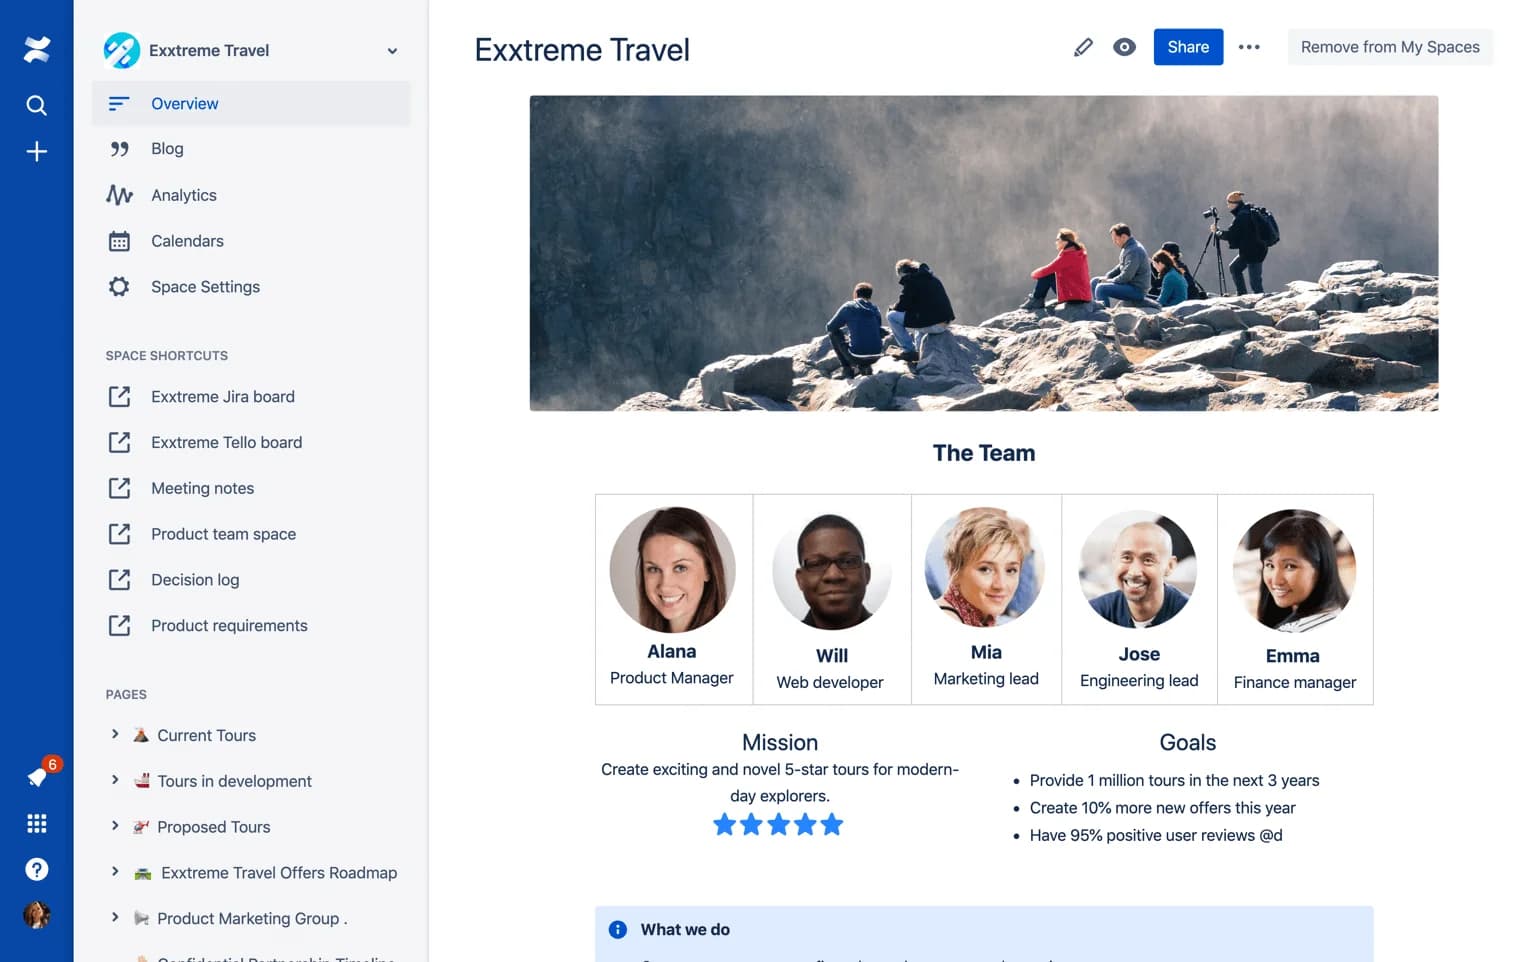
Das ist außerdem ein Problem, das eesel gut kennt, denn vor dem Helpdesk-Teammate war die erste Wachstumsquelle eine KI-App im Atlassian Marketplace, die Fragen aus Confluence beantwortete. Ein Kunde, den ich nennen würde, ist GENERAL BYTES, ein Hersteller von Bitcoin-Geldautomaten mit mehr als 12.000 Automaten in über 60 Ländern. Dort steht eine Confluence-Wissensdatenbank mit 329 Artikeln hinter einem Kundenbot auf Telegram, also derselben Messenger-Form wie WhatsApp. Funktioniert hat das durch den Teil, den Metas Agent dir überlässt: Der Bot liest die neuesten Confluence-Seiten, sobald sie sich ändern.
Vier Wege, wie Confluence-Inhalte zu Metas Agent gelangen
Metas Capabilities-Seite nennt vier Wissensquellen in der Platform-API: Business Info, FAQs, Files und Websites. Aktionen und Abfragen laufen über Connectors, also HTTP- oder MCP-Integrationen, die du selbst definierst. In der Doku wird weder Confluence noch Notion noch ein anderes Wiki namentlich erwähnt.
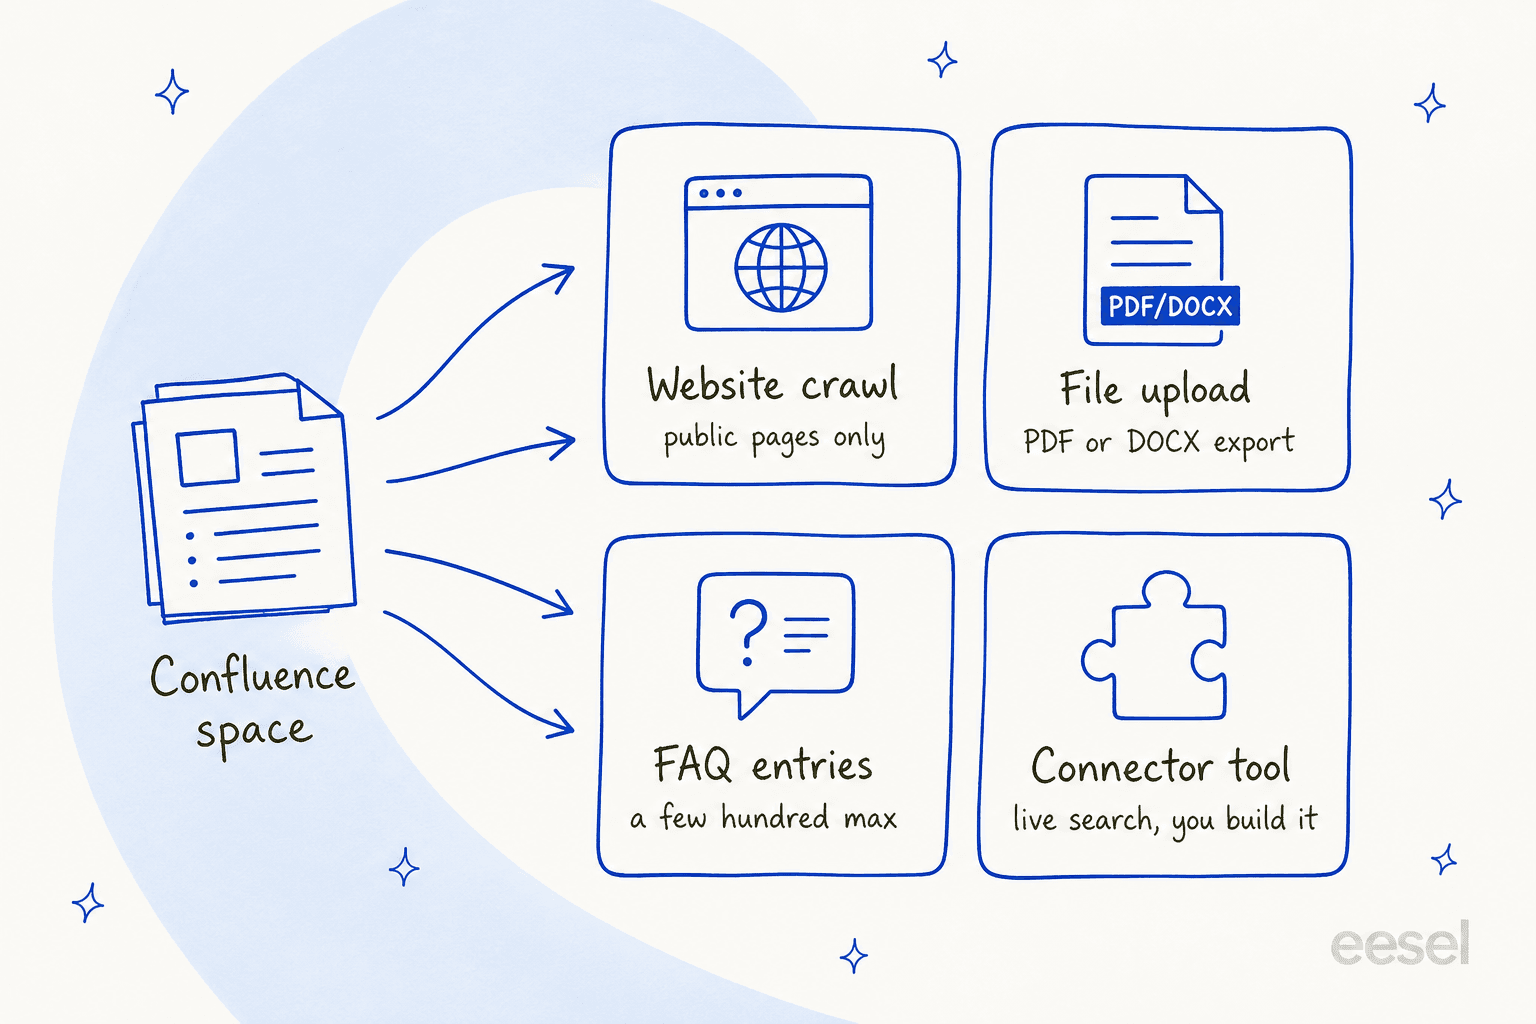
So schneiden die vier ab, bevor ich sie einzeln durchgehe:
| Weg | Meta-Eingabe | Confluence-Einrichtung | Private Seiten? | Aktualität | Hauptproblem |
|---|---|---|---|---|---|
| Öffentlicher Crawl | Websites-API | Anonymer Zugriff auf einem Space, ab Standard-Plan | Nein | Nächster Recrawl, Intervall nicht veröffentlicht | Der ganze Space wird öffentlich und von Google indexiert |
| Export und Upload | Files-API | PDF- oder Word-Export | Ja, wenn du sie exportierst | Nie, bis du erneut hochlädst | Alte Dateien bleiben aktiv, bis du sie löschst |
| FAQ-Umschreiben | FAQs-API | Keine, du schreibst von Hand oder per Skript um | Ja | Wenn du den Eintrag aktualisierst | Qualität sinkt ab ein paar Hundert Einträgen |
| Live-Connector | HTTP- oder MCP-Connector | Service-Account plus API-Scopes | Ja, gemäß den Berechtigungen des Accounts | Live | Du baust und wartest ihn selbst |
Weg 1: Den Space öffentlich machen und Meta crawlen lassen
Das ist der am einfachsten einzurichtende Weg, und zugleich der mit dem größten Kompromiss.
Metas Websites-API crawlt eine URL und übernimmt deren Inhalt. Standardmäßig nimmt sie „die ganze Domain“, und mit Feldern für Subdomain, URL-Muster und einzelne URLs kannst du sie eingrenzen. Metas Leitfaden für den Support-Agenten nennt das Crawlen „deine öffentliche Website“, und die Anfrage hat kein Feld für Login oder Cookie. Ein Confluence-Space hinter einer Atlassian-Anmeldung lässt sich also nicht crawlen.
Um einen Space crawlbar zu machen, würdest du den anonymen Zugriff aktivieren. Das ist eine kostenpflichtige Funktion: Die Confluence-Preisseite führt anonymen Zugriff ab Standard auf, im Free-Plan gibt es ihn nicht. Er arbeitet auf drei Ebenen. Ein Site-Admin erlaubt anonyme Nutzer auf der Site, ein Space-Admin schaltet ihn pro Space ein, und Seiten mit der Einstellung „Eingeschränkt“ bleiben verborgen. Neue Spaces starten laut Atlassians Einrichtungsanleitung geschlossen, „auch wenn die globale Einstellung aktiviert ist“.
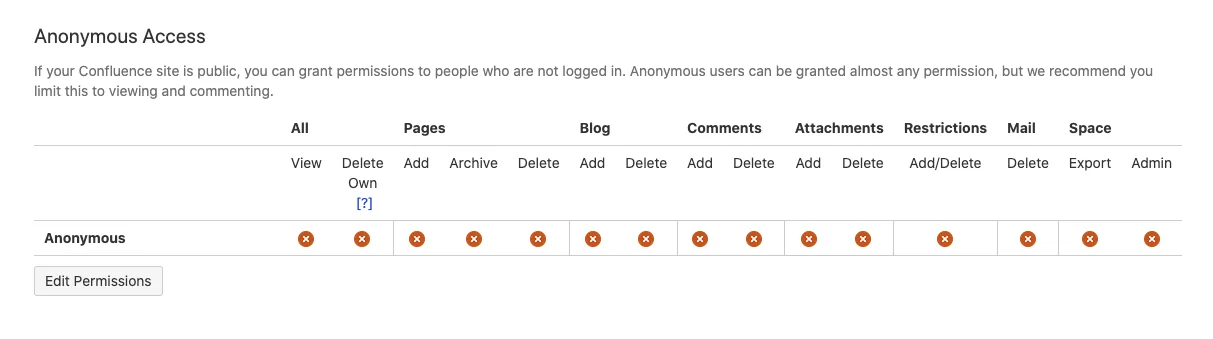
Der Kompromiss steht in Atlassians eigenen Worten: Sobald anonyme Nutzer Zugriff haben, „werden deine Inhalte von Suchmaschinen indexiert“. Für ein öffentliches Help Center ist das in Ordnung, für ein Wiki, das Kundendokumentation mit internen Notizen mischt, ein Problem. Wenn deine Kundenartikel schon in einer JSM-Wissensdatenbank liegen, kannst du diese ebenfalls öffentlich machen, aber nur, wenn sie auf einem kostenpflichtigen Confluence-Plan läuft, und sie funktioniert darunter genauso.
Und die öffentlichen Links von Confluence? Die helfen hier kaum. Atlassian sagt, man habe Schritte unternommen, „damit Suchmaschinen unsere öffentlichen Links nicht indexieren“, laut der Seite zur Sicherheit öffentlicher Links. Ein Crawler findet sie also nur, wenn du jede URL in Metas Feld single_urls einträgst. Und ein öffentlicher Link ignoriert Seitenbeschränkungen, sodass man leicht etwas freigibt, was man nicht wollte.
Grenze den Crawl eng ein, denn Metas Leitfaden warnt, dass das Crawlen einer ganzen Website „die Hilfeinhalte verwässert, aus denen der Agent antworten sollte“. Bei Confluence heißt das: den Crawl auf einen kundenorientierten Space richten und nicht auf die ganze Site.
Weg 2: Seiten exportieren und als Dateien hochladen
Wenn der Inhalt privat bleiben muss, kannst du ihn exportieren und Meta die Dateien geben. Confluence kann einzelne Seiten als PDF oder Word exportieren, und Space-Admins können einen ganzen Space als ein PDF exportieren.
Metas Files-API nimmt .pdf, .doc, .docx und Bilder, dazu CSV und XLSX, wenn die Extraktion aktiviert ist. Das Limit liegt bei 100.000.000 Bytes pro Datei. HTML-, Markdown- und Zip-Dateien stehen nicht auf der Liste, Confluences HTML-Space-Export geht also nicht direkt hinein. Zwei Export-Details solltest du ebenfalls kennen: PDF-Exporte enthalten nie Kommentare, und Blogbeiträge fehlen in einem Space-PDF.
Am wichtigsten ist, was danach passiert. Metas Support-Leitfaden sagt:
„There is no update call. To replace a document, delete the old entry and upload the new one, otherwise the agent draws on both versions and can quote a term you have already withdrawn.“
Stell dir eine Erstattungsrichtlinie vor, die sich von 30 auf 14 Tage ändert. Wenn jemand das neue PDF hochlädt und das alte vergisst, kann der Agent einem Kunden auf WhatsApp beide Zahlen nennen. In der Praxis bedeutet dieser Weg also, ein Skript zu schreiben, das geänderte Seiten exportiert, die vorherige Datei anhand ihrer ID löscht und dann die neue hochlädt. Die Files-API erlaubt 1.000 Anfragen pro Stunde, und das reicht für so eine Aufgabe locker.
Meta rät außerdem davon ab, alles hochzuladen: „Ein großer Dokumentensatz macht den Agenten langsamer dabei, die richtige Passage zu finden.“ Ein 300-seitiges Space-PDF ist genau die Art Upload, auf die dieser Rat zielt. Wenn du die Überlegungen hinter einer gut geformten KI-Wissensdatenbank suchst, zeigt der Leitfaden zur Confluence-KI-Wissensdatenbank, wie man sie strukturiert.
Weg 3: Artikel als FAQ-Einträge umschreiben
Metas FAQs-API speichert Frage-Antwort-Paare, und anders als Dateien lassen sie sich aktualisieren. Der Agent behandelt jeden Eintrag für sich: Er „antwortet daraus, statt eine Antwort aus deinen anderen Wissensquellen abzuleiten“. Das macht FAQs zur berechenbarsten Eingabe für deine heikelsten Antworten.
Die Obergrenze ist niedrig. Meta warnt: „Zu viele FAQs (im Allgemeinen über ein paar Hundert) können die Fähigkeit des Agenten verschlechtern, die richtige Antwort zu finden.“ FAQs eignen sich also für deine Top 50 oder 100 Fragen, nicht für ein ganzes Wiki. Metas eigener Rat lautet, die häufigsten Ticket-Treiber des letzten Quartals zu nehmen und dafür Einträge zu schreiben. Für ein Confluence-Team würde ich dasselbe tun: die wichtigsten Artikel als knappe Q&A-Paare umschreiben, den Long Tail dann auf einen der anderen Wege legen.
Weg 4: Einen Connector bauen, der Confluence live durchsucht
Das ist der einzige Weg, der private Inhalte zugleich privat und aktuell hält, und es ist auch der einzige, den du selbst bauen musst.
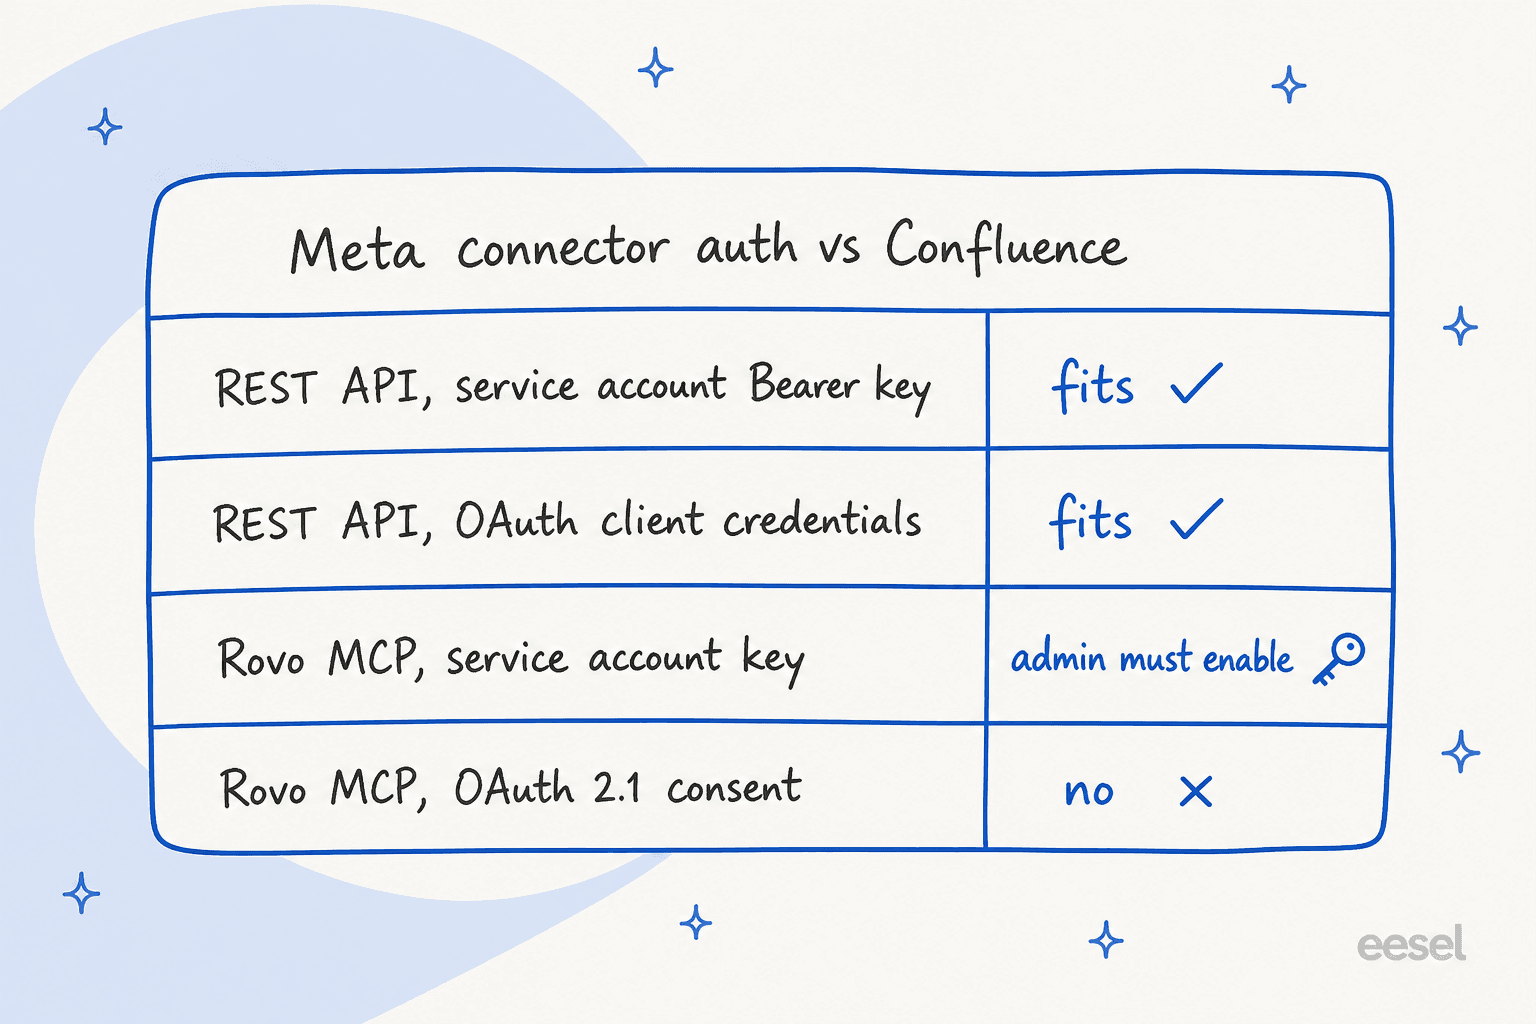
Metas Connectors-Referenz lässt dich den Agenten auf eine HTTP-API oder einen Remote-MCP-Server richten. Die Authentifizierung ist begrenzt: „Derzeit werden nur OAUTH2_CLIENT_CREDENTIALS, API_KEY und NONE unterstützt.“ Basic Auth ist aufgelistet, aber nicht unterstützt. Das schließt den üblichen Weg aus, sich bei Atlassian-Tools anzumelden, nämlich einen Zustimmungsbildschirm im Browser.
Die gute Nachricht: Atlassian-Service-Accounts passen. Ein API-Token eines Service-Accounts funktioniert als Bearer-Header gegen das Atlassian-Gateway, und Atlassians Seite zu Service-Account-Tokens nutzt als Beispiel einen Confluence-Endpunkt: https://api.atlassian.com/ex/confluence/{cloudId}/wiki/rest/api/space. Service-Accounts unterstützen außerdem OAuth-Client-Credentials, was zu Metas anderem Auth-Typ passt. Atlassian gibt jeder Organisation 5 kostenlose Service-Accounts, und laut Understand service accounts zählen sie nicht zu deinem Confluence-Nutzerlimit.
Ein einfacher Confluence-Connector braucht zwei Tools:
- Suche, mit CQL über den v1-Such-Endpunkt (
/wiki/rest/api/search?cql=...) mit dem Scopesearch:confluence. - Seite abrufen, über den v2-Seiten-Endpunkt mit
read:page:confluenceund einembody-format-Parameter.
Auf drei Stolpersteine würde ich mich vorab einstellen. Erstens kommen Seiteninhalte als Confluence-Storage-Format oder ADF-JSON zurück, wenn du nicht die gerenderte Ansicht anforderst, der Agent liest also viel Markup. Metas Referenz zu Connector-Tools warnt, dass übergroße Antworten „die Antwortqualität des Agenten verschlechtern“, und bietet eine transformation_spec zum Kürzen an. Zweitens sieht der Service-Account, was seine Berechtigungen erlauben, gib ihm also einen Space, statt ihn einer breiten Gruppe hinzuzufügen. Drittens beschreibt Metas Doku Connectors für Aktionen und Kundenabfragen wie Bestellstatus und Tickets. Ein Connector als Wissensquelle wird nie beschrieben, ein „Confluence durchsuchen“-Tool musst du also sorgfältig testen, statt dich auf Metas Doku zu verlassen.
Die andere Möglichkeit ist der Atlassian-Rovo-MCP-Server unter https://mcp.atlassian.com/v2/mcp, der bereits ein searchConfluence-Tool hat. Seine Standard-Anmeldung ist OAuth 2.1 mit Zustimmungsbildschirm, was Meta nicht kann. Ein API-Key eines Service-Accounts, als Bearer-Token gesendet, funktioniert, aber nur, „wenn er von deinem Organisations-Admin aktiviert wurde“, laut Atlassians Seite zur API-Token-Authentifizierung. Jeder Aufruf braucht außerdem eine cloudId. Mein Beitrag Claude für Confluence erklärt mehr zu den Rovo-MCP-Tools und ihren Eigenheiten.
Entwickler, die die Confluence-Suche über MCP genutzt haben, bewerten sie tendenziell gut, was für diesen Weg spricht:
„Considering how poor the Confluence search function is, the results from Confluence via an MCP-powered search are remarkably good. I was able to solve one or two obscure, company-specific issues purely by using the MCP search, and I'm convinced that finding these pages would have been almost impossible without it.“

Das Aktualitätsproblem, das keiner in die Demo packt
Die meisten Berichte über den Meta Business Agent hören beim Setup auf, aber für ein Confluence-Team ist die größere Frage, was an einem Dienstag passiert, wenn jemand eine Seite bearbeitet.
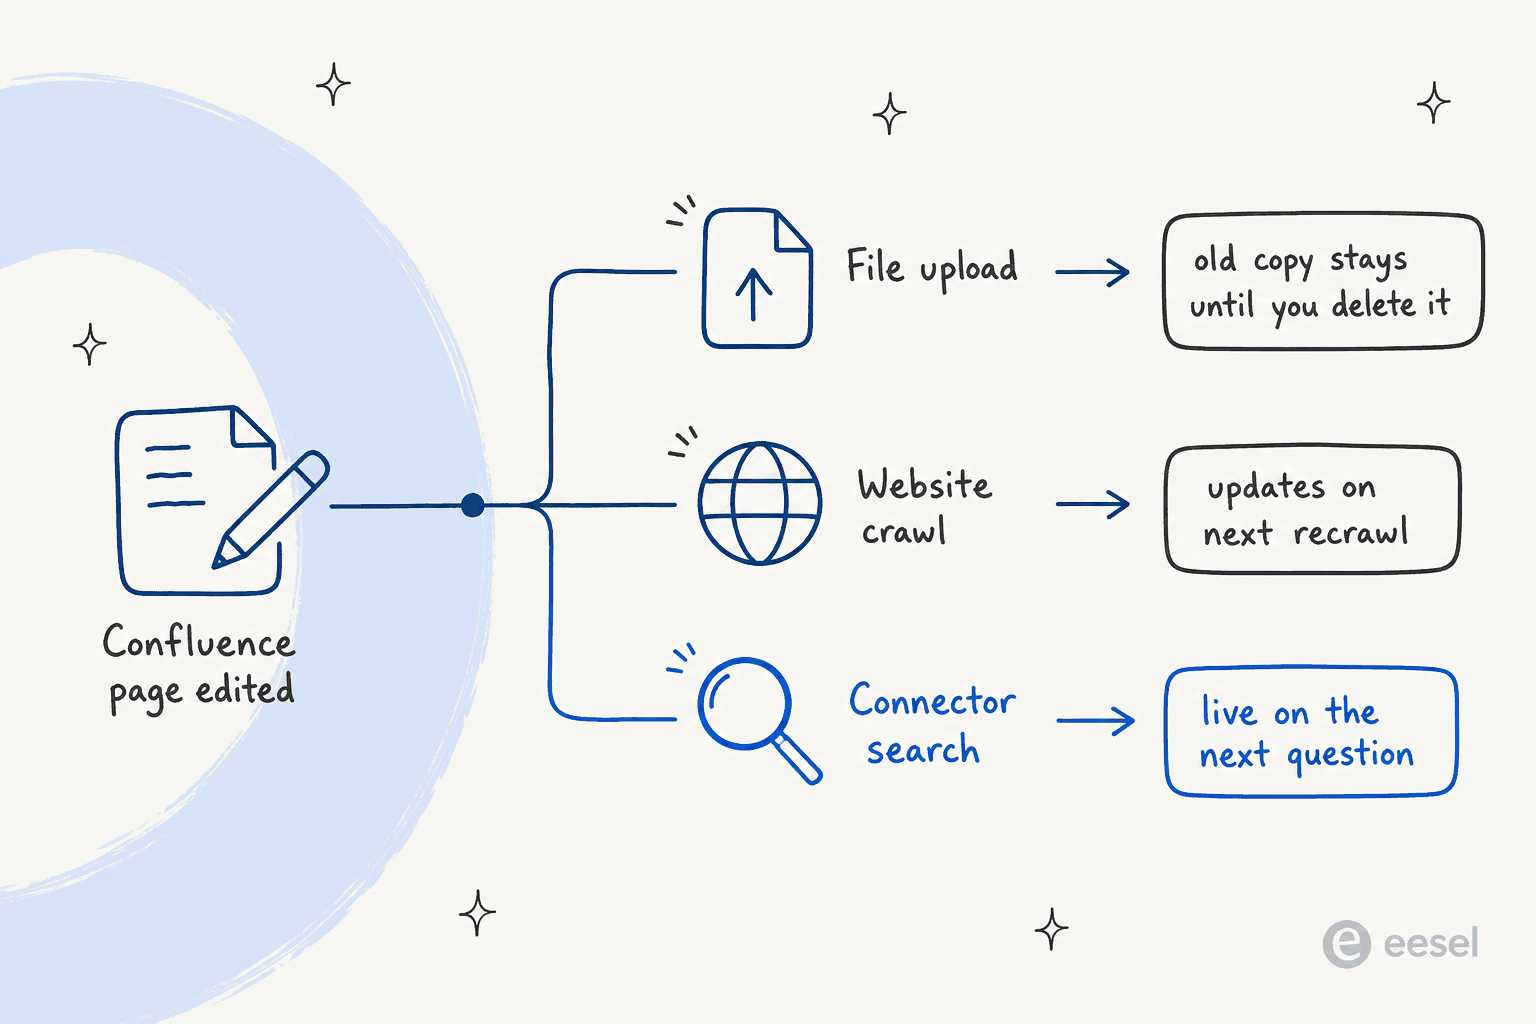
Meta sagt, gecrawlte Websites würden „periodisch neu gecrawlt“, nennt aber kein Intervall, und der Leitfaden ergänzt: „Website knowledge is a snapshot taken at crawl time... re-crawl whenever those pages change materially.“ Dateien aktualisieren sich nie von selbst. FAQs ändern sich nur, wenn du die API aufrufst. Nur ein Live-Connector sieht eine Änderung sofort.
Die andere Hälfte der Aktualität ist, ob das Wiki von Anfang an korrekt war. Eine KI, die aus Confluence antwortet, ist nur so gut wie das, was darin steht, und viele Entwickler sagen das ziemlich unverblümt:
„How can AI search into documentation, if the documentation is a thousands of obsolete and contradicting Jira tickets, few outdated Confluence pages with mail attachments and handful of excel files on SharePoint?“
Auch das Grounding richtest du über einen Prompt ein. Meta hat keinen Schalter „nur aus dem Wissen antworten“. Die Beispielanweisung lautet: „Answer policy questions from the documented policies only, and say you will check with a colleague rather than guessing when the answer is not there.“ Ein früher Tester des Business Agent auf Reddit beschrieb das Risiko deutlich:
„Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up.“

Diese Lektion hat eesel früh mit Confluence-Kunden gelernt, weshalb jeder Rollout gegen echte frühere Fragen getestet wird, bevor der Bot jemandem antwortet. Ein Bot, der selbstsicher aus einer veralteten Seite antwortet, ist schlechter als einer, der sagt, er prüfe das nach. Die Anleitung Confluence mit einem Wissensbot verknüpfen zeigt die Sync-Seite dieses Setups.
Was es kostet
Hier gibt es zwei Rechnungen: die von Meta und die von Atlassian.
| Kostenposten | Preis | Quelle |
|---|---|---|
| Meta Business Agent, WhatsApp Platform | 2,00 $ pro 1 Mio. Tokens, etwa 16 bis 20 Cent pro einfacher Unterhaltung und 40 bis 50 Cent pro komplexer | Meta-Preise |
| WhatsApp-Antworten deines Teams, ab 1. Okt. 2026 | Pro Nachricht zu Utility-Tarifen, nach 1.000 kostenlosen pro Nummer und Monat | Meta-Preise |
| Confluence Free | 0 $, 10 Nutzer, kein anonymer Zugriff und keine öffentlichen Links | Confluence-Preise |
| Confluence Standard | 6,70 $ pro Nutzer und Monat, enthält anonymen Zugriff | Confluence-Preise |
| Confluence Premium | 13,20 $ pro Nutzer und Monat | Confluence-Preise |
| Atlassian-Service-Accounts | 5 kostenlos, bis zu 250 mit Atlassian Guard Standard | Atlassian Support |
Ein Confluence-Team im Free-Plan stößt sofort an eine Wand: kein anonymer Zugriff, also kein öffentlicher Crawl-Weg. Dieses Team würde auf Standard upgraden oder den Export-Weg gehen, die andere Wahl ist, einen Connector zu bauen. Die Aufschlüsselungen zu Confluence-Preisen und Confluence-KI-Preisen gehen tiefer auf die Atlassian-Seite ein, und die Erklärung der Rovo-Preise behandelt Atlassians eigene KI-Credits.
Auf Metas Seite ist die Änderung zum 1. Oktober die, die man im Blick behalten sollte. Metas Preisseite sagt, jede Nachricht werde „entweder als Meta-Business-Agent-Nachricht oder als Service-Nachricht abgerechnet, nie beides“. Die Antworten der KI werden also als Tokens berechnet, und alles, was dein Team nach einer Übergabe sendet, als Service-Nachrichten. Meine Erklärung zu den WhatsApp-API-Preisen enthält die vollständige Tarifhistorie.
Wo Metas Agent für ein Confluence-Team aufhört
Metas Agent ist für manche Teams eine vernünftige Wahl, und es hilft zu wissen, wo er endet:
- Eine KI pro Nummer. Metas Platform-Übersicht sagt, eine Nummer, auf der bereits „ein anderer KI-Agent läuft“, sei gesperrt, denn „eine aktive Integration eines autorisierten Agenten blockiert den Meta Business Agent“. Du wählst pro WhatsApp-Nummer einen Bot.
- Nur Meta-Oberflächen. Er antwortet auf WhatsApp, Messenger, Instagram und in einem Website-Plugin, das vorerst an Shopify gebunden ist. In E-Mail, Helpdesk, Slack oder Teams antwortet er nicht, und dort stellen die meisten Confluence-Leser ihre Fragen.
- Keine Zitier-Einstellung. Nichts in der Doku bringt den Agenten dazu, die Confluence-Seite zu verlinken, aus der er geantwortet hat. Vergleiche das mit Tools, die für Confluence gebaut sind, bei denen der Quellenlink der Kern ist. Der Leitfaden zur Confluence-Such-KI zeigt, wie das aussieht.
- Übergabe ist eine Routing-Änderung, kein Ticket. Sobald der Business Agent die Nummer übernimmt, wird dein bestehender WhatsApp-Posteingang in den Standby versetzt. Meine Zendesk-Version dieses Beitrags erklärt Metas Conversation Routing, und der Leitfaden zur KI-Agent-Übergabe zeigt, wie eine gute Übergabe aussieht.
- Interne Wikis gehören nicht auf WhatsApp. Die meisten Confluence-Spaces sind für Mitarbeitende geschrieben. Bevor du einen Weg wählst, solltest du also einen kundenorientierten Space abtrennen, sonst besteht das Risiko, dass der Bot interne Notizen an Kunden zitiert.
Welches Setup zu deinem Confluence-Team passt
So würde ich wählen:
| Deine Situation | Weg, den ich nehmen würde |
|---|---|
| Kundendokumentation liegt schon in einem öffentlichen Help Center auf Confluence Standard | Eng gefasster Website-Crawl dieses Spaces |
| Unter 100 stabile Artikel, nur WhatsApp | FAQ-Einträge für die Top-Fragen, dazu ein Crawl oder ein paar Dateien |
| Private Dokumente, die sich monatlich ändern | Export und Upload, mit einem Skript, das zuerst die alte Datei löscht |
| Private Dokumente, die sich wöchentlich ändern, und ein Entwickler übrig | HTTP-Connector mit Service-Account, v1-Suche plus v2-Seitenabrufe |
| Confluence im Free-Plan, kein Entwickler | Auf Standard upgraden für den Crawl, oder ein Tool nutzen, das Confluence nativ liest |
| Du antwortest auch in einem Helpdesk, in Slack oder im Website-Chat | Eine Confluence-native KI über alle Kanäle, und entscheiden, welcher Bot WhatsApp besitzt |
Wenn du noch Tools statt Wege vergleichst, nähern sich meine Übersichten zur besten KI für Confluence und zur besten KI für WhatsApp-Support dem Thema von beiden Enden.
Erwägst du stattdessen einen Allzweck-Assistenten? Der Leitfaden ChatGPT für Confluence behandelt OpenAIs Weg. Die Grok-Bot-Version behandelt den von xAI.
Und wenn du versucht bist, den Connector selbst zu bauen, lohnen sich vorher zehn Minuten mit dem Beitrag Build vs. Buy. GENERAL BYTES hat den Eigenbau geprüft und sich dagegen entschieden: „We wanted something that we would not have to maintain and something that somebody else will work on improving.“
eesel mit Confluence ausprobieren
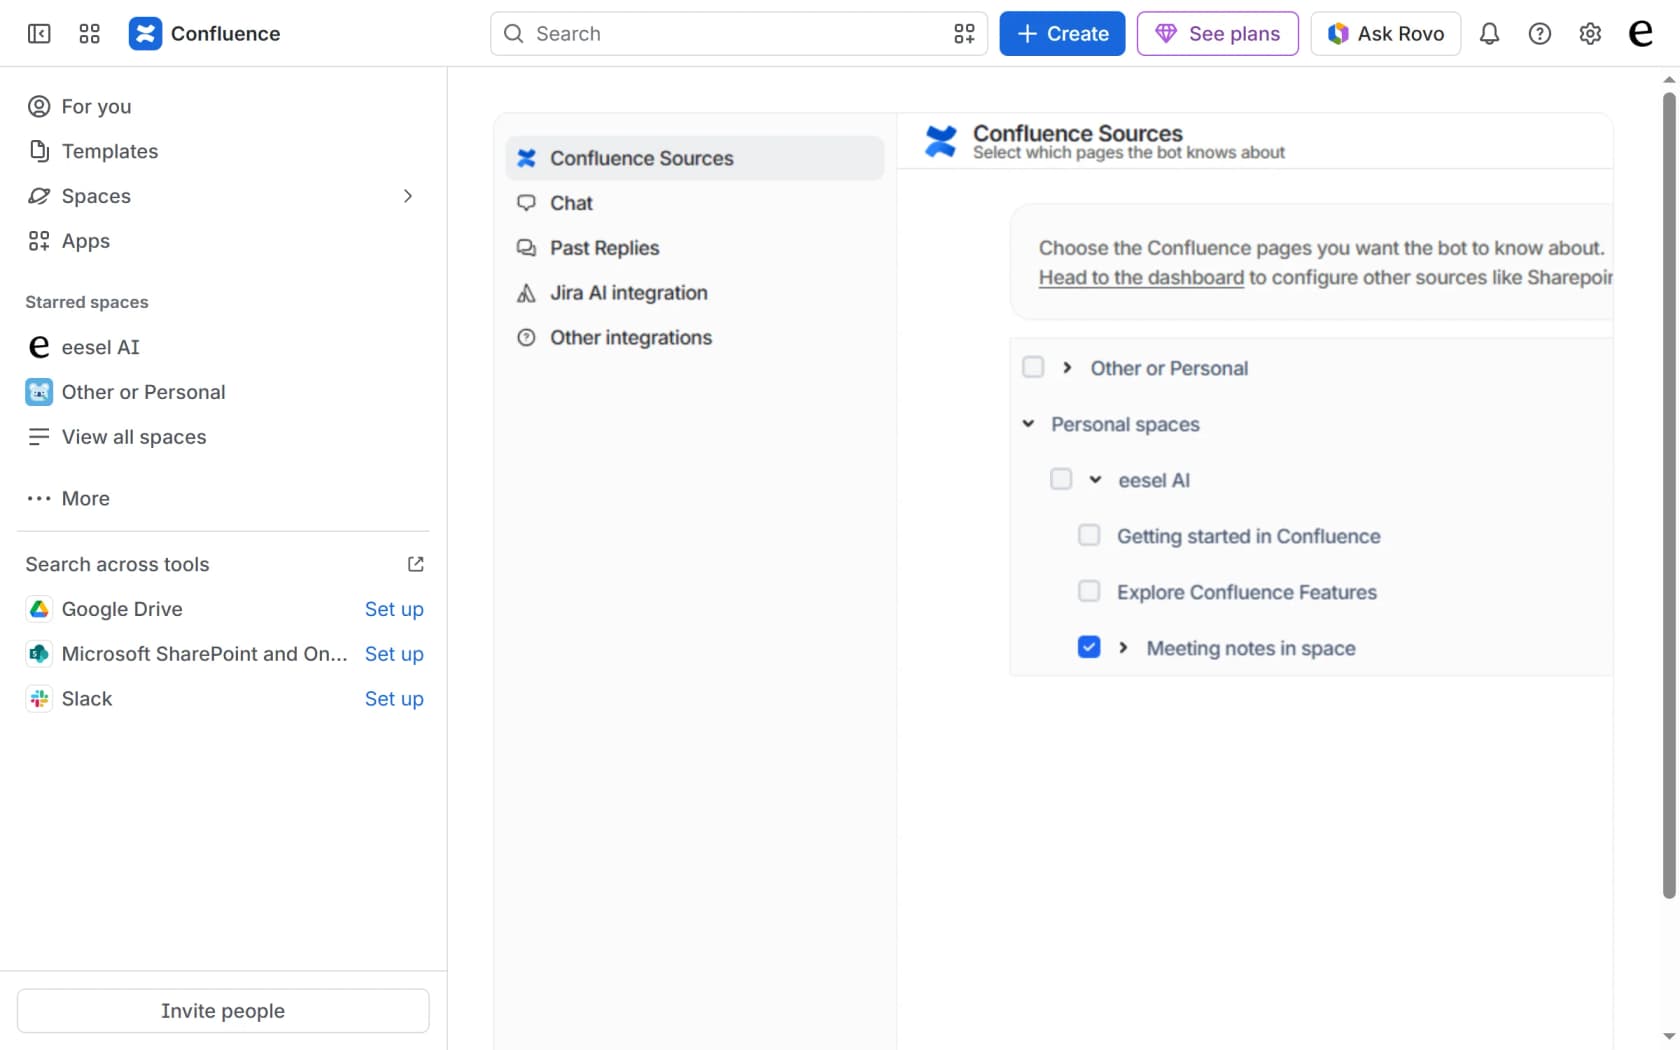
Jeder der obigen Wege endet damit, dass jemand in deinem Team Metas Kopie deines Wikis synchron halten muss. eesel überspringt diesen Schritt. Es ist ein KI-Teammate für dein Helpdesk: Du wählst die Confluence-Spaces und Seiten, die es liest, das Anhaken einer übergeordneten Seite nimmt ihre Unterseiten mit, und die eesel-Confluence-Doku bringt es auf den Punkt: „Edits re-index on their own.“ Jede Antwort verlinkt die Seite, aus der sie stammt.
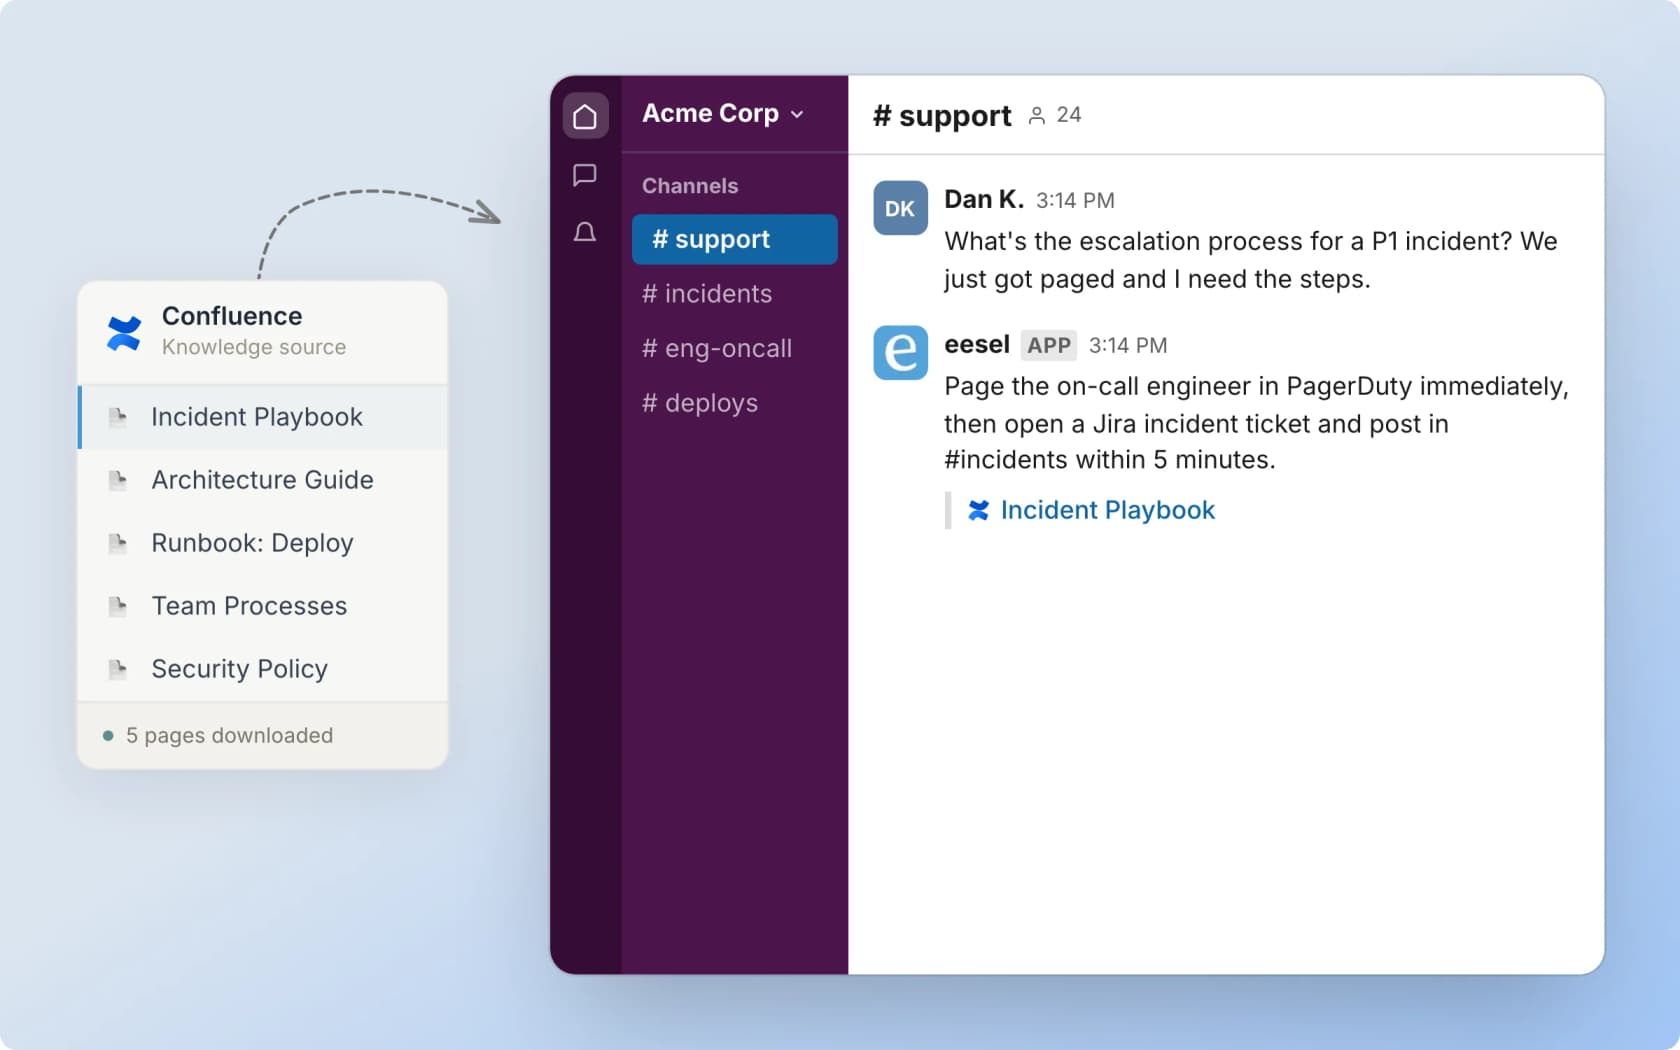
Dasselbe Wissen beantwortet dann überall, wo deine Kunden und dein Team fragen: in deinem Helpdesk, in Slack, Microsoft Teams, einer Chat-Blase auf deiner Website oder einem Chat-Tab direkt in Confluence. Es führt Confluence mit deinem Help Center und früheren Tickets zusammen, sodass eine Antwort aus allen dreien schöpfen kann. Flemming Ottosen, Development Director bei Simployer, beschrieb, was sie brauchten, als „a turnkey solution for Confluence that met our GDPR requirements and could serve different teams through dedicated Slack bots.“
Wenn WhatsApp der Kanal ist, den du brauchst, schau dir auch eesels WhatsApp-Integration an und denke bei der Wahl an Metas Regel „eine KI pro Nummer“. Der Free-Plan enthält 100 Credits und braucht keine Karte, und kostenpflichtige Pläne beginnen bei 299 $ für 500 Tickets oder Chats im Monat. Probiere eesel an einem Confluence-Space aus und sieh, wie es antwortet.
Häufig gestellte Fragen
Kann ich Meta Muse mit Confluence nutzen?
Verbindet sich der Meta Business Agent direkt mit Confluence?
Kann Metas Agent einen privaten Confluence-Space crawlen?
Was passiert, wenn ich eine Confluence-Seite aktualisiere, die Metas Agent schon nutzt?
Was kostet Meta Muse für Confluence?
Kann ich den Atlassian-Rovo-MCP-Server mit dem Meta Business Agent nutzen?
Gibt es eine bessere KI, um Kunden aus Confluence heraus zu antworten?



Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.