

Ja, aber weit weniger, als die meisten Teams erwarten. Ich habe dasselbe Support-Ticket mit OpenAIs aktuellen Modellen durch 14 Sprachen geschickt: Spanisch brauchte 1,17x so viele Tokens wie Englisch, Deutsch 1,27x, Japanisch 1,45x und Thailändisch 1,73x. Bei den heutigen Modellpreisen macht das einen Bruchteil eines Cents pro Ticket aus. Der eigentliche Hebel ist Abrechnung und Genauigkeit. Wenn Ihr Anbieter pro Ticket oder pro Lösung abrechnet, erreicht der Token-Unterschied nie Ihre Rechnung, während eine schwächere Lösungsrate in einer Sprache weit mehr an menschlicher Zeit kostet. eesel verlangt ein Credit pro Ticket in jeder Sprache, daher sollten Sie die Antwortqualität testen, nicht die Tokens.
Kostet KI-Support in Sprachen außer Englisch mehr?
Ich baue die KI-Agenten bei eesel, und ein großer Teil der Tickets, die sie bearbeiten, ist nicht auf Englisch. smava, eine deutsche Kreditvergleichsseite, lässt eesel etwa 27.000 Zendesk-Tickets im Monat bearbeiten, fast alle auf Deutsch, und bei jedem wird ein Sprach-Tag in ein Zendesk-Feld geschrieben, bevor ein Berater es sieht. Koffer.ch erhält Entwürfe auf Deutsch, Französisch, Englisch und Italienisch, in Schweizer Rechtschreibung. Die Frage „Kostet das auf Japanisch mehr?" höre ich von Käufern ständig.
Die ehrliche Antwort hat zwei Ebenen. Es gibt kleine, reale Token-Kosten, die daraus entstehen, wie Sprachmodelle Text in Stücke zerlegen. Und es gibt deutlich größere Betriebskosten, die davon abhängen, wie gut die KI in dieser Sprache antwortet und wie Ihr Anbieter abrechnet. Die meisten Artikel zu diesem Thema bleiben bei der ersten Ebene stehen. Dieser hier bepreist beide.
Wenn Sie mehrsprachigen Kundensupport mit eesel einrichten, lässt die eesel CLI einen KI-Coding-Agenten freigegebenes Wissen für jeden Markt hochladen, etwa exportierte deutsche und japanische Hilfeartikel, dann Testfragen in jeder Sprache stellen und die Antworten prüfen, bevor etwas live geht. Das Helpdesk selbst anzubinden braucht trotzdem jemanden mit Admin-Zugriff, der das freigibt.
Wie viele Tokens mehr braucht jede Sprache?
Sprachmodelle lesen keine Wörter. Sie lesen Tokens, Textstücke, die ein Tokenizer aus Ihrer Nachricht herausschneidet. Englisch bekam die meiste Aufmerksamkeit, als diese Tokenizer gebaut wurden, daher passt es die meiste Bedeutung in jedes Token. Andere Sprachen brauchen mehr Tokens, um dasselbe zu sagen, und Modell-APIs rechnen pro Token ab.
Um echte Zahlen statt Faustregeln zu bekommen, habe ich einen realistischen Support-Wechsel geschrieben: Ein Kunde fragt, wo seine Laufschuhe sind und ob er eine Rückerstattung bekommen kann, und eine Agentenantwort mit Tracking-Details und Rückgaberichtlinie. Ich habe das in 13 Sprachen übersetzt und die Tokens auf zwei Arten gezählt: mit OpenAIs Open-Source-Tokenizer o200k_base, und mit OpenAIs eigenem Input-Token-Zähl-Endpunkt für gpt-6.1-terra, gpt-6-luna und gpt-5.4-mini. Alle drei aktuellen Modelle lieferten identische Zahlen (der Tokenizer plus sechs Tokens für die Nachrichtenverpackung), daher deckt eine Spalte die heutige OpenAI-Produktpalette ab.
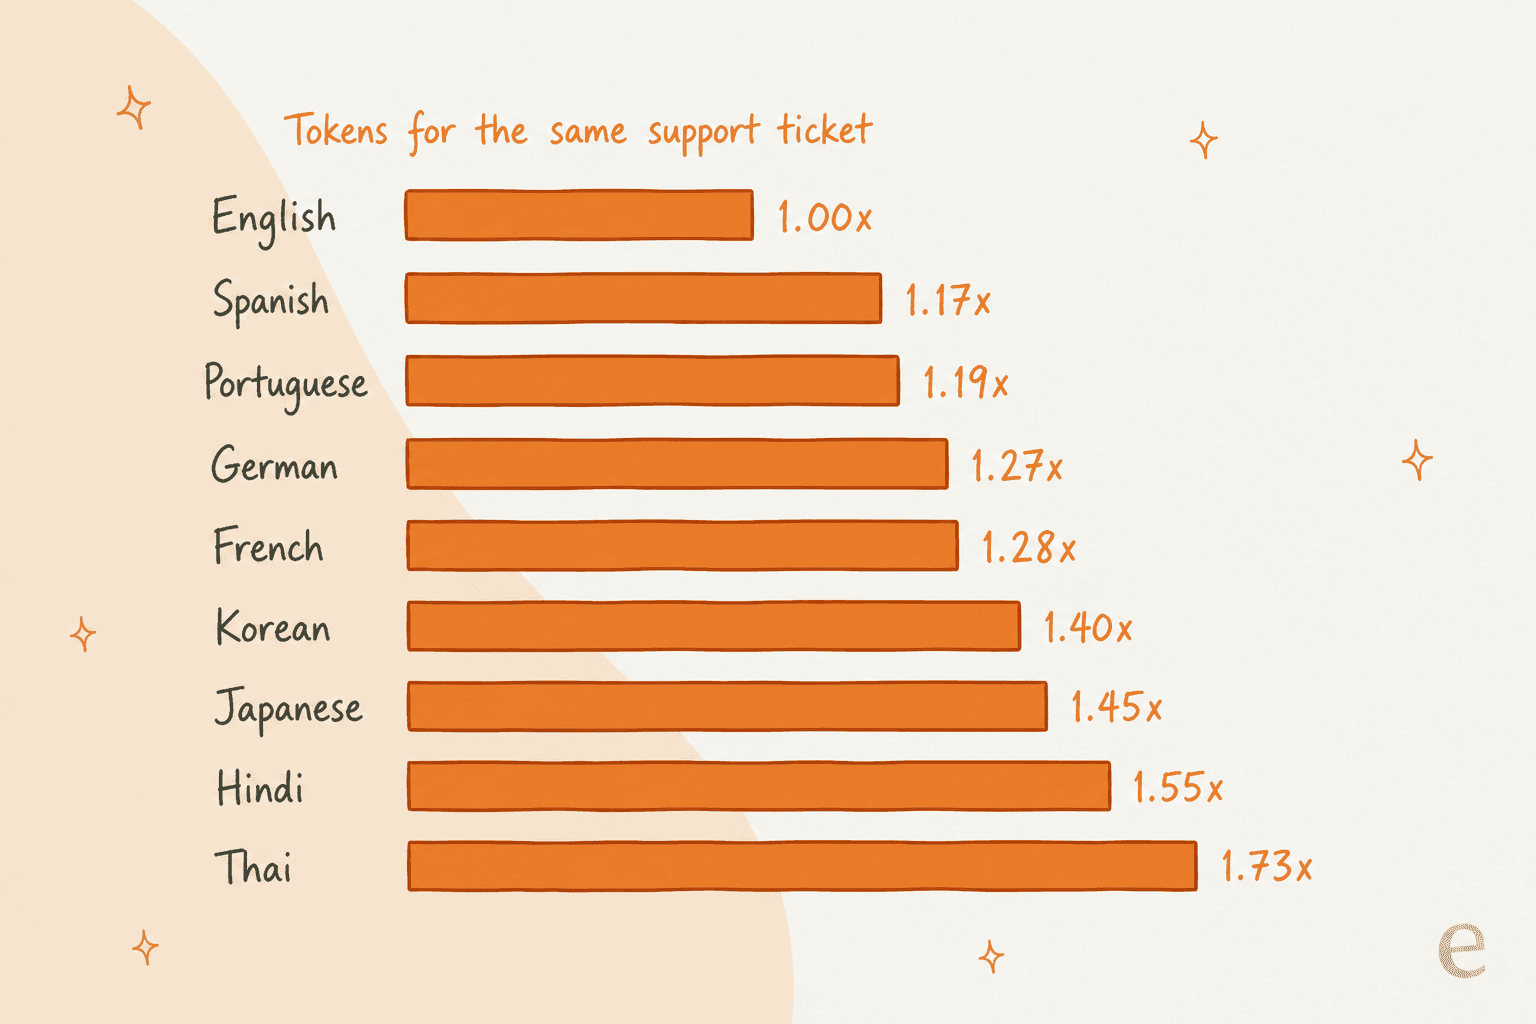
| Sprache | Tokens auf aktuellen OpenAI-Modellen | vs. Englisch | Tokens auf GPT-4-Tokenizer (cl100k) | vs. Englisch |
|---|---|---|---|---|
| Englisch | 166 | 1,00x | 163 | 1,00x |
| Chinesisch (vereinfacht) | 182 | 1,10x | 256 | 1,57x |
| Spanisch | 194 | 1,17x | 219 | 1,34x |
| Portugiesisch (Brasilien) | 198 | 1,19x | 230 | 1,41x |
| Arabisch | 206 | 1,24x | 467 | 2,87x |
| Deutsch | 210 | 1,27x | 257 | 1,58x |
| Indonesisch | 211 | 1,27x | 257 | 1,58x |
| Französisch | 213 | 1,28x | 249 | 1,53x |
| Italienisch | 226 | 1,36x | 253 | 1,55x |
| Vietnamesisch | 228 | 1,37x | 372 | 2,28x |
| Koreanisch | 233 | 1,40x | 354 | 2,17x |
| Japanisch | 241 | 1,45x | 345 | 2,12x |
| Hindi | 258 | 1,55x | 775 | 4,75x |
| Thailändisch | 288 | 1,73x | 670 | 4,11x |
Drei Dinge fallen auf:
- Die Strafe ist real, aber auf aktuellen Modellen moderat. Die meisten europäischen Sprachen liegen zwischen 1,17x und 1,36x. Japanisch und Koreanisch liegen bei etwa 1,4x. Nur Thailändisch und Hindi gehen über 1,5x.
- Alte Tokenizer waren brutal. Beim
cl100k_base-Tokenizer, den GPT-4 und GPT-3.5 nutzten, brauchte Hindi 4,75x und Arabisch 2,87x. Wenn der Bot eines Anbieters noch auf einem älteren Modell läuft, ist die Lücke, die Sie bezahlen, mehrfach so breit wie in der ersten Spalte. - Ihre Zahlen werden abweichen. Das ist ein einzelnes Ticket. Ein deutsches Ticket voller zusammengesetzter Produktnamen oder ein besonders formelles japanisches können die Werte in beide Richtungen um ein paar Punkte verschieben. Anthropic und Google nutzen eigene Tokenizer, messen Sie also am Modell, das Sie tatsächlich betreiben. Anthropics Token-Zähl-Endpunkt ist kostenlos, und Googles Token-Leitfaden setzt ein Gemini-Token mit etwa vier Zeichen Englisch gleich.
Was bedeutet das pro Ticket?
Ein Token-Multiplikator zählt erst, wenn er an einen Preis gekoppelt ist, und ein Support-Ticket ist nicht nur die Nachricht des Kunden. Es trägt auch Ihre Systemanweisungen und die Hilfeartikel, die die KI zur Beantwortung herangezogen hat. Dieser Kontext ist oft auf Englisch und wächst nicht, wenn der Kunde auf Japanisch schreibt.
Hier ein Rechenbeispiel mit GPT-6.1 Terra, das OpenAI mit 1,00 $ pro Million Input-Tokens und 5,00 $ pro Million Output-Tokens listet. Meine Annahmen: 3.000 Tokens englische Anweisungen und Hilfeartikel, 1.000 Tokens Konversation und eine 400-Token-Antwort, ohne Reasoning-Tokens.
| Setup | Input-Tokens | Output-Tokens | Kosten pro Ticket | vs. Englisch |
|---|---|---|---|---|
| Englisches Ticket | 4.000 | 400 | $0,0060 | 1,00x |
| Japanisches Ticket, englisches Helpcenter | 4.450 | 580 | $0,0074 | 1,23x |
| Japanisches Ticket, japanisches Helpcenter | 5.800 | 580 | $0,0087 | 1,45x |
| Japanisches Ticket, ins Englische übersetzt und zurück | 6.250 | 1.980 | $0,0162 | 2,69x |
Zwei Ergebnisse haben mich überrascht, als ich das zum ersten Mal durchgerechnet habe:
- Englisches Wissen verdünnt die Strafe. Wenn das Helpcenter auf Englisch bleibt, werden nur die Konversation und die Antwort teurer, sodass aus einer 1,45x-Sprache ein 1,23x-Ticket wird. Aktuelle Modelle können auf Japanisch antworten, ausgehend von englischen Quellartikeln, und das ist dieselbe Idee, nach der eesel Innrs niederländische, deutsche und französische Kunden aus einem Helpcenter mit etwa
1.500Artikeln und vergangenen Tickets beantwortet. - Die Pipeline mit Vorab-Übersetzung ist die teure. Die Nachricht des Kunden ins Englische zu übersetzen, auf Englisch zu antworten und die Antwort dann zurückzuübersetzen fügt zwei Modellaufrufe hinzu, und Übersetzung ist größtenteils Output, die teuerste Art von Token. In diesem Beispiel kostete das 2,2x einer nativen japanischen Antwort. Teams fügen oft eine Übersetzungsebene hinzu, um zu sparen, und zahlen am Ende mehr.
Bei 5.000 japanischen Tickets im Monat erhöht das native Setup mit englischem Helpcenter die Kosten um 6,75 $ im Monat gegenüber Englisch. Das ist die gesamte „Sprachsteuer" bei den Tokens. Selbst bei einem Premium-Modell wie GPT-6 Astra mit 10 $ Input und 50 $ Output pro Million bleibt es deutlich unter hundert Dollar im Monat. Wenn Sie auf Anthropic bauen, gilt dieselbe Größenordnung für Claude Haiku 5.5 und Claude Sonnet 5.5.
Wer zahlt die Sprachsteuer, Sie oder Ihr Anbieter?
Ob diese zusätzlichen Token-Kosten Sie überhaupt erreichen, hängt von der Einheit ab, in der Ihre KI abgerechnet wird. Ich sehe derzeit drei Abrechnungsmodelle im KI-Support, und nur eines davon gibt den Token-Unterschied weiter.
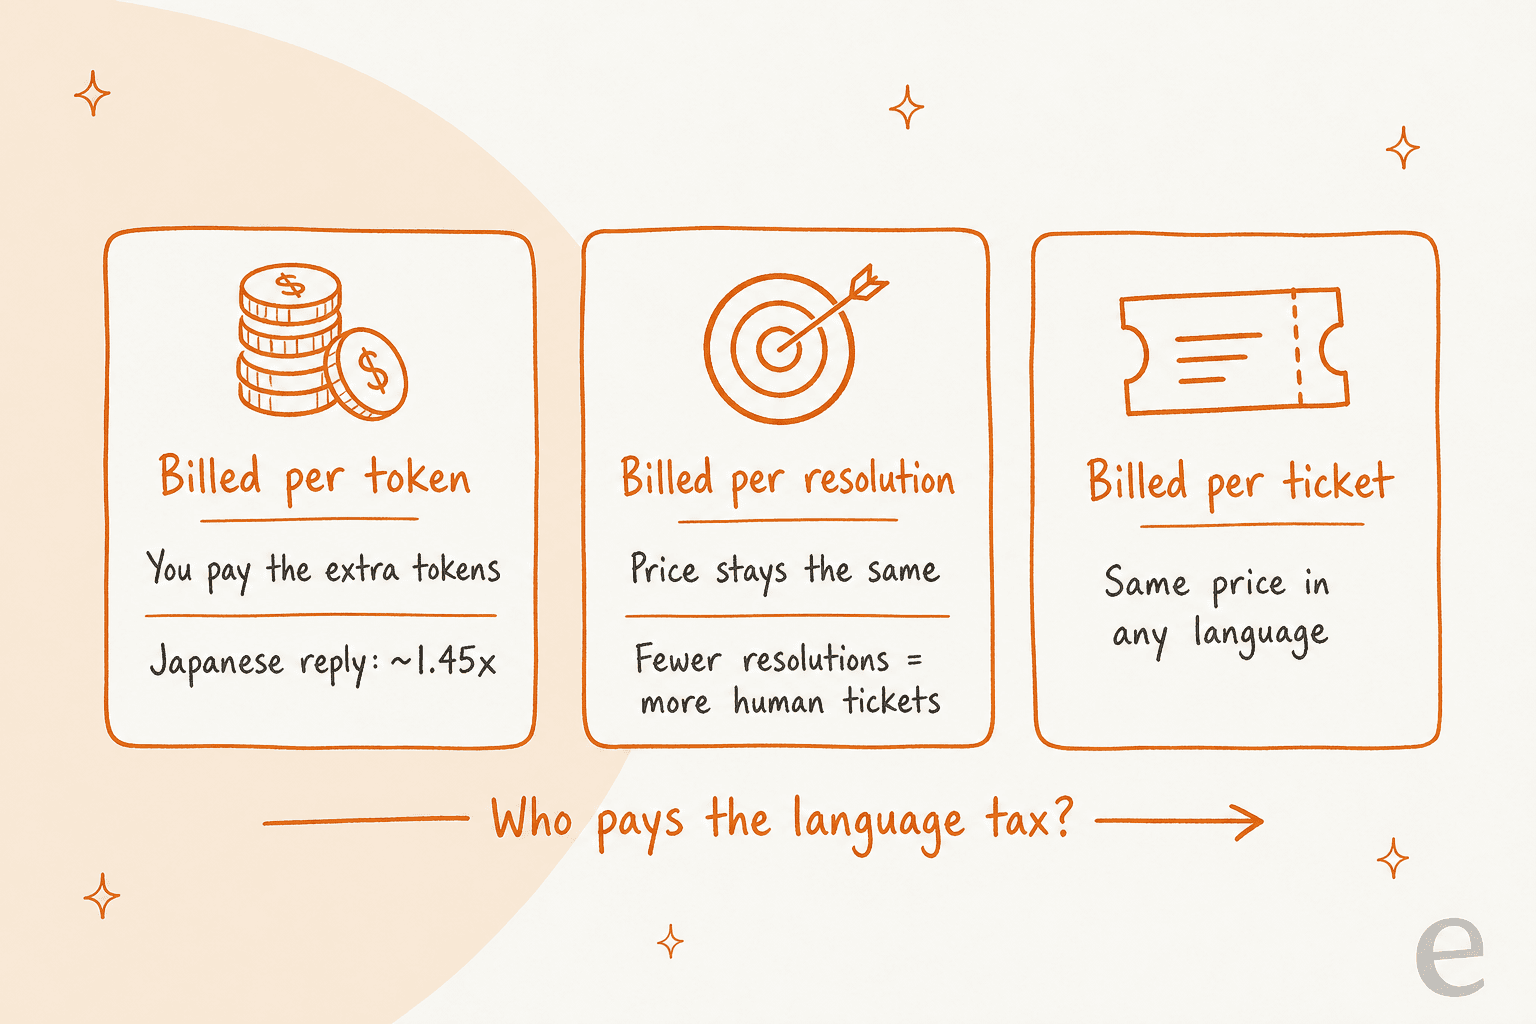
| Abrechnungsmodell | Wer nutzt es | Stückpreis | Ändert die Sprache den Preis? |
|---|---|---|---|
| Pro Token | Direkt über die OpenAI-API, Anthropic oder Google | Variiert je Modell | Ja, je nach obigem Token-Multiplikator |
| Pro automatisierter Lösung | Zendesk-KI-Agenten | 1,50 $ fest gebucht, 2,00 $ Pay-as-you-go | Nein |
| Pro KI-Sitzung | Freshdesk Freddy AI Agent | Erste 500 Sitzungen inklusive, dann 49 $ pro 100 | Nein |
| Pro automatisierter Interaktion | Gorgias AI Agent | 0,85 $ bis 1,00 $ je nach Plan | Nein |
| Pro bearbeitetem Ticket | eesel | 1 Credit, ab 299 $ für 500 Credits | Nein |
Keine der Preis-Seiten, die ich geprüft habe, listet einen Sprachaufschlag. Zendesks Preis-Seite wirbt mit Unterstützung für über 80 Sprachen bei seinen KI-Agenten zum gleichen Preis pro Lösung, und Freshworks' Preis-Seite sowie Gorgias' Preis-Seite rechnen ihre Sitzungs- und Interaktionseinheiten unabhängig von der Sprache gleich ab.
Das macht Sprache auf diesen Plänen nicht kostenlos. Es verschiebt die Kosten nur woanders hin:
- Pro Lösung bedeutet, Sie zahlen nur, wenn die KI das Ticket löst. Löst sie weniger japanische Tickets, sinkt Ihre KI-Rechnung für Japanisch, und Ihre menschliche Rechnung steigt um mehr. Lesen Sie Deflection vs. Lösungsrate, bevor Sie Angebote auf dieser Einheit vergleichen.
- Pro Sitzung oder Interaktion rechnet den Versuch ab, sodass eine schwächere Sprache dieselbe KI-Rechnung kostet und trotzdem mehr Tickets an Menschen schickt.
- Pro Ticket ist am gleichmäßigsten. eesels Preis-Seite sagt, ein Ticket ist ein Credit „egal wie viele Antworten hin- und hergehen", sodass ein langer deutscher Thread und ein kurzer englischer gleich viel kosten.
Woher kommen die echten Kosten eines nicht-englischen Tickets?
Sobald klar ist, dass Tokens nur Cents sind, verschiebt sich die Geldfrage zu den Stellen, die mehrere Dollar pro Ticket kosten.
Eine niedrigere Lösungsrate in manchen Sprachen. Das ist der große Posten. Wenn die KI 60 % der englischen Tickets löst, aber nur 50 % der japanischen, sind diese 10 Punkte Lücke bei 5.000 Tickets 500 zusätzliche Tickets für Ihr Team, jeden Monat. Bei veranschlagten 5 $ Mitarbeiterzeit pro Ticket (setzen Sie Ihre eigene Zahl aus den Kosten-pro-Ticket-Benchmarks ein) sind das 2.500 $ im Monat, gegenüber 6,75 $ zusätzlichen Tokens. Der Rechner unten lässt Sie Ihre eigenen Zahlen durchspielen.
Wissen in der Sprache des Kunden. Ein Helpcenter zu übersetzen ist eine Einmalkosten plus laufende Pflege bei jeder Artikeländerung. Oft brauchen Sie das gar nicht: Eine KI, die englische Artikel liest und auf Deutsch antwortet, vermeidet die Übersetzungsrechnung, und nur die Artikel, die Kunden direkt lesen, brauchen eine lokalisierte Version. Mein Vergleich von mehrsprachiger Wissensdatenbank-Software deckt die Tools für diejenigen ab, die das brauchen.
Terminologie ohne saubere Übersetzung. Bei einem Sales-Call in diesem Jahr sorgte sich ein B2B-Team für Fahrzeug-Telematik, das in neue EU-Märkte expandiert, dass technische Begriffe wie „Kabelbaum" in manchen Sprachen keine direkte Entsprechung haben. Das ist ein Qualitätsrisiko, keine Token-Kosten, und der Grund, ein kurzes Glossar an Produktbegriffen pro Sprache in den Anweisungen der KI zu pflegen.
Prüfung durch Muttersprachler. Jemand muss prüfen, dass die deutsche Antwort nach Ihrer Marke klingt und nicht nach einem Lehrbuch. Koffer.chs Kunden erwarten Schweizer Rechtschreibung auf Deutsch, die ein generisches Modell falsch macht, wenn man es ihm nicht sagt. Planen Sie in den ersten Wochen Prüfzeit pro Sprache ein, dann stichprobenartig; mein Leitfaden zu mehrsprachiger Support-QA hat eine Prüfroutine, und Sprachqualität im Kundensupport behandelt, was zu bewerten ist.
Lokale Löhne verändern den Vergleich. Ein pauschaler Preis pro Lösung sieht günstig aus gegen ein US-Gehalt und teuer gegen ein niedrigeres. Ein Zendesk-Kunde hat es in einem Kommentar zu Zendesks eigenem Hilfeartikel deutlich gesagt:
"A $1.5 per conversation is viable only for the US/Europe. In our case, we will have to disable the chatbot and look for an alternative solution."
Wenn Ihre nicht-englische Warteschlange also in einem günstigeren Markt besetzt ist, vergleichen Sie den Stückpreis der KI mit den echten Kosten pro Lösung dieses Teams, nicht mit den Zahlen Ihrer Zentrale.
Wie schätze ich die KI-Supportkosten pro Sprache?
Eine verlässliche Schätzung pro Sprache bekommen Sie an einem Nachmittag. So würde ich vorgehen:
- Eine Stichprobe echter Tickets pro Sprache ziehen. Nehmen Sie 100 bis 200 aktuelle Tickets pro Sprache, mit derselben Themenmischung. Englische Passwort-Resets mit japanischen technischen Störungen zu vergleichen verzerrt das Ergebnis.
- Die Tokens am Modell zählen, das Sie nutzen werden. OpenAI, Anthropic und Google bieten alle Token-Zähl-Endpunkte an, und Anthropics ist kostenlos. Zählen Sie die Kundennachrichten, Ihre Anweisungen und die Hilfeartikel, die die KI wahrscheinlich abruft, und vergleichen Sie dann jede Sprache mit Englisch.
- Prüfen, wie Ihr Anbieter abrechnet. Wenn es pro Ticket, pro Lösung oder pro Sitzung ist, überspringen Sie die Token-Rechnung komplett; Ihr Stückpreis ist in jeder Sprache gleich. Wenn Sie auf einer rohen API aufbauen, multiplizieren Sie die Token-Zahlen mit dem Preis des Modells.
- Die Lösungsrate pro Sprache testen. Das ist die Zahl, die Ihr Budget bewegt. Lassen Sie die KI an vergangenen Tickets in jeder Sprache laufen und bewerten Sie die Antworten gegen das, was Ihr Team tatsächlich geschickt hat. Mein Leitfaden zum Testen eines KI-Agenten vor dem Start geht das durch, und Prüfung von KI-Support-Gesprächen behandelt die laufenden Checks.
- Die Lücke in menschlicher Zeit bepreisen. Multiplizieren Sie die Tickets, die die KI pro Sprache nicht lösen wird, mit den Kosten pro Ticket Ihres Teams. Fügen Sie Prüfzeit durch Muttersprachler für den ersten Monat hinzu. Diese Summe, nicht der Tokenizer, sind Ihre echten KI-Supportkosten für Sprachen außer Englisch.
Wenn eine Sprache in Schritt 4 schwach abschneidet, liegt die Lösung meist in besserem Wissen, nicht in einem anderen Modell: einer fehlenden Richtlinienseite, einem Produktglossar oder ein paar Beispielantworten in dieser Sprache. Sobald es live ist, behalten Sie die KI-Eskalations-Raten pro Sprache im Blick, denn ein Sprung dort ist das erste Zeichen, dass die KI in einem Markt Schwierigkeiten hat.
Wenn Sie die ganze Warteschlange lieber abgeben möchten, vergleichen Sie diese Zahlen mit den Kosten eines ausgelagerten Teams in meiner Aufschlüsselung der Kundenservice-Outsourcing-Kosten, und prüfen Sie zuerst, ob KI mehrsprachigen Kundensupport für Ihre Mischung übernehmen kann.
eesel für Support in jeder Sprache
eesel tritt als KI-Teammitglied Ihrem Helpdesk für den Support bei und antwortet in der Sprache, in der der Kunde geschrieben hat, aus dem Wissen, das Sie bereits haben, selbst wenn es komplett auf Englisch ist. Es läuft in Zendesk, Freshdesk und den anderen großen Helpdesks, und es rechnet ein Credit pro Ticket in jeder Sprache ab, sodass ein deutscher Thread und ein englischer gleich viel kosten. smava nutzt es, um deutsche Tickets über zwei Marken zu taggen und zu entwerfen, und Innr erhält Entwürfe in vier Sprachen aus einem einzigen Helpcenter.

Sie können Ihr Helpdesk verbinden, es an Ihren vergangenen deutschen oder japanischen Tickets laufen lassen und die Entwürfe lesen, bevor ein Kunde sie sieht. Testen Sie eesel sieben Tage kostenlos, keine Kreditkarte nötig.