As 8 melhores alternativas ao Empromptu em 2026: preços reais, limites reais

Kira

Katelin Teen
Última edição October 14, 2026
O Empromptu vende uma única coisa, e essa coisa é precisão que você consegue provar. Você traz um protótipo de IA que já existe. Por cima, eles acrescentam avaliações e políticas, controles de custo e monitoramento também, e dizem que a implantação padrão é on-premise. Um produto real, e um nicho pouco atendido. Os preços também são mais transparentes do que os da maior parte desta categoria, o que eu não esperava.
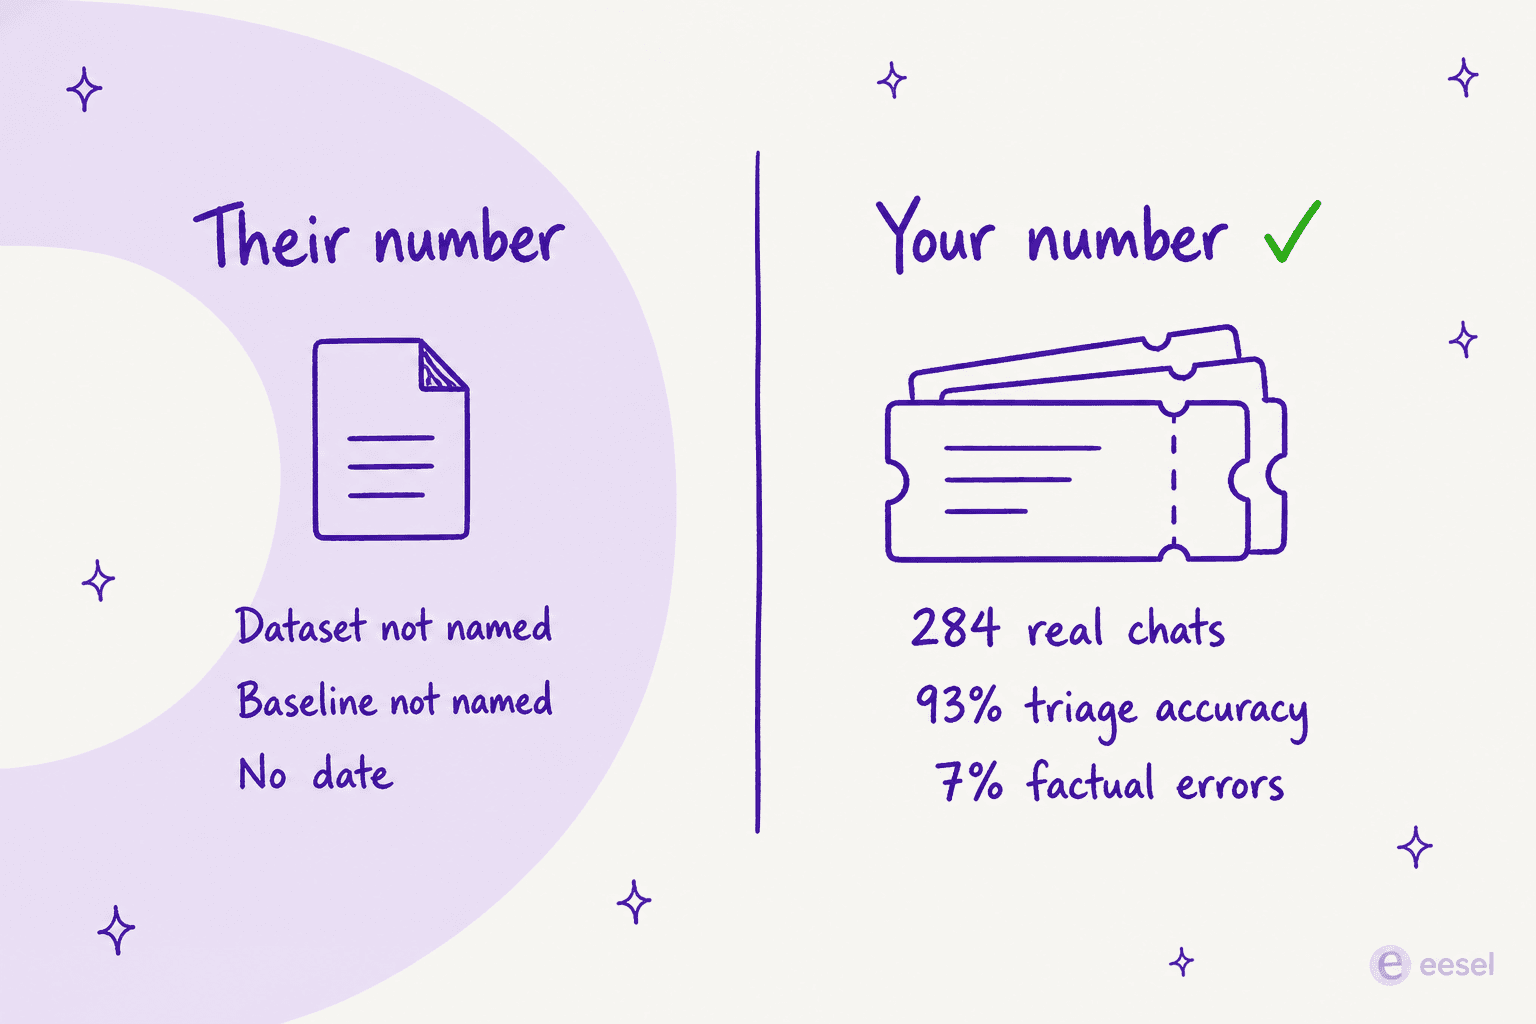
O problema está no número da embalagem. A própria central de ajuda explica esse número melhor do que a página de marketing, o que é estranho para uma página de marketing. A pontuação de precisão é uma nota dada por si mesmo: seu app produz uma saída, cada critério de avaliação que você escreveu a pontua de 0 a 10, e essas pontuações são calculadas pela média. A documentação até mostra a aritmética, (8.0 + 6.5 + 7.5) ÷ 3 = 7.3. Então "90%+ de precisão" é 9,0 ou mais em 10, avaliado contra critérios que você mesmo escreveu. Em nenhum dos 73 artigos da central de ajuda há um conjunto de dados ou uma linha de base, nem um benchmark externo. A jornada típica de otimização na própria documentação termina em 8,4.
O que significa que a pergunta que organiza toda alternativa ao Empromptu não tem nada a ver com quem faz a alegação de precisão mais alta. A pergunta real é de quem você consegue medir a precisão com os seus próprios dados antes que um cliente a veja. Isso divide as oito opções abaixo em três faixas, e as faixas são: construir você mesmo, medir algo que você já construiu, ou contratar um colega que já faz o trabalho. Se o trabalho é suporte ao cliente, o eesel está nessa terceira faixa. Ele roda uma simulação sobre seus tickets históricos antes de entrar no ar, e a cobrança é de US$ 0,40 por ticket atendido, com a tarifa publicada na própria página.
Por que as equipes começam a buscar alternativas ao Empromptu
Primeiro, quero ser justo com o Empromptu. A ideia é boa.
A maioria das ferramentas de IA assume uma de duas coisas sobre você. Ou você não tem nada, então aqui está um construtor, ou você tem uma equipe de plataforma, então aqui está um SDK. O Empromptu mira a lacuna do meio, e o pitch de três passos é honesto no que promete: você traz um app de IA, eles acrescentam as verificações de precisão, as políticas e o monitoramento, e sua equipe fica com o que aprender. A frase da página inicial que me fez concordar foi "Most AI fails in production, not because the model was wrong, but because nothing was in place to catch it." Que é correta. Já vi isso acontecer.
A história de origem do fundador é a mesma observação:
"We started Empromptu after burning through thousands of credits on AI builders and hitting the same problem: cool looking prototypes or demos that break with real users."

E profissionais dizem o mesmo, sem que ninguém pergunte. Esta vem de um tópico sobre por que projetos de agentes travam, e para toda a premissa do Empromptu é o melhor argumento de uma linha que encontrei em qualquer lugar:
"Companies need processes, not tools. Once they deploy an agent, it should be boring and reliable. Measurable quality, failure alerts, "report to human" cases. All those wrappers make the enterprise-ready solution much more complicated than building an agent itself."

É também uma empresa jovem. O Empromptu levantou uma rodada pre-seed de US$ 2 milhões liderada pela Precursor Ventures, anunciada em dezembro de 2025, com uma equipe de cerca de doze pessoas. Os fundadores também são operadores confiáveis: Shanea Leven dirigiu antes a CodeSee, e o CTO Dr. Sean Robinson construiu a tecnologia de otimização na Madrona Venture Studio.
Então aqui está a parte que de fato manda os compradores procurarem em outro lugar.
O número de precisão é autoavaliado, e a documentação diz isso. Há quatro formulações na página inicial: um firme "98% de precisão em produção, medida", um mais cauteloso "até 98% de precisão" na FAQ, um "98% mesmo com mais de 250 documentos enquanto outras ferramentas caem para 60-70%" como comparação sem fonte, e uma cifra de 98,2% dentro de uma maquete de interface de marketing. A central de ajuda usa "90%+" em vez disso, em seis artigos, e depois explica o mecanismo com clareza suficiente: cada avaliação ativa é um critério em linguagem natural, um modelo pontua esse critério de 0 a 10 e depois as pontuações são calculadas pela média. Mude os critérios e o número muda. Há uma chave Ativa/Inativa por avaliação, e as inativas não afetam a pontuação atual.
Em favor do Empromptu, a documentação é franca exatamente nesse ponto. Evaluations Overview traz uma entrada de solução de problemas intitulada "High Scores But Poor Real-World Performance", com as causas apontadas como avaliações que não correspondem a casos de uso reais e critérios ausentes. A orientação publicada também é mais modesta do que o marketing: mirar 6,0 para tarefas novas, 7,5 depois de em produção e 8,5 para as críticas. Em nenhum lugar a documentação afirma que 9,0+ seja típico. A jornada de otimização documentada termina em 8,4.
"RAG incluído" é alegado, mas não especificado. Quatro artigos dizem que a recuperação vem em todo app. Nenhum dos 73 cita uma estratégia de divisão em blocos, um índice, um armazenamento vetorial, uma lista de conectores, uma configuração de top-k ou uma configuração de citações. Há uma única primitiva de recuperação documentada, o text_embedder, e o conhecimento é anexado descrevendo-o dentro do prompt de construção. A coleção Prompting chega a aconselhar os usuários a parar de nomear coisas como bancos de dados vetoriais, o que é um bom conselho de prompt engineering, embora deixe a configuração de recuperação sem documentação. Se a qualidade da recuperação é o que quebra a sua precisão, e com conteúdo de suporte costuma ser, então essa é exatamente a parte que você gostaria de ver especificada. Nosso comparativo entre RAG e fine-tuning explica o motivo.
A superfície de conformidade é mais fina do que os selos sugerem. A faixa principal diz SOC 2, HIPAA, Zero vendor lock-in. A própria FAQ da página Sobre descreve o SOC 2 como em andamento. A página de preços rotula o Enterprise como "Built for regulated industries" e depois não cita nenhuma certificação: nem SOC 2, nem HIPAA, nem ISO 27001, nem BAA, nem residência de dados, nem SLA. Em todo o conjunto de 73 artigos da central de ajuda, HIPAA aparece exatamente uma vez, e é uma caixa desmarcada numa planilha de pré-construção. /security e /trust retornam ambos 404. A história do on-premise também é mais estreita do que "on-premise por padrão" sugere: a documentação a descreve como um movimento de vendas empresariais e como híbrida por design, em que o app roda localmente mas mantém uma conexão de volta com o Empromptu para a otimização. Não há modo isolado documentado, nem declaração do que atravessa essa fronteira. Para um comprador de saúde ou fintech isso não é um impedimento. É uma revisão de segurança que você quer fazer antes do piloto, e não depois.
A documentação é real, mas escondida. Existe uma central de ajuda completa em docs.empromptu.ai, com 73 artigos distribuídos em 15 coleções, e, sinceramente, é mais útil do que o site de marketing. Ela também está configurada como noindex, o que significa que um buscador nunca vai enviar você até lá. E não tem nenhuma captura de tela. Um artigo sobre otimização de modelos termina no meio da lista depois do item sobre o Claude 3 Sonnet, sem entregar nenhuma das cinco seções que a própria introdução promete, e sua lista de modelos ainda cita GPT-4o e Claude 3 Opus em agosto de 2026.
O custo marginal é impossível de saber. O custo agrupado é incomumente claro, e dou crédito por isso mais abaixo. O excedente é a peça que falta: nenhum preço de recarga, nenhuma política de acúmulo e nenhuma declaração sobre o que acontece quando os créditos acabam. Então o plano você consegue dimensionar. A fatura, não.
Quase não há sinal de terceiros. Nove publicações Show HN e Launch HN enviadas por eles mesmos entre junho e dezembro de 2025 somaram 14 pontos e exatamente uma resposta de alguém que não era fundador, que era um pedido para explicar a diferença para as alternativas em duas frases. O G2 diz abertamente que não há avaliações suficientes lá para oferecer informação de compra, e no Capterra ou no Trustpilot não há nenhuma listagem. Para uma empresa pre-seed isso é normal, e não é uma crítica minha. Mas significa que toda alegação que você acabar avaliando vem do próprio fornecedor.
Como comparei essas ferramentas
Sou engenheiro da equipe de produto do eesel, então leio essas ferramentas como leio uma dependência. Qual é a unidade. O que está bloqueado. O que quebra quando você escala.
Para cada uma das oito, levantei a página de preços do fornecedor e a documentação, e registrei cinco coisas:
- A unidade de cobrança, exatamente como o fornecedor a define. Créditos e tokens, spans de rastreamento, checkpoints, tickets: não são coisas intercambiáveis.
- Se a tarifa de excedente é publicada. Um preço publicado ao lado de um excedente não publicado é metade de uma tabela de preços.
- Se a medição de precisão vem embutida, em oposição a testes de software ou varreduras de segurança com a mesma fantasia. A diferença entre as duas é real, e eu a explico em avaliar o desempenho de agentes de IA.
- Se você pode testar com os seus próprios dados antes do lançamento, e não depois.
- A resposta real de conformidade: BAA assinado, tipo de relatório SOC 2, hospedagem própria, residência de dados.
Duas coisas que deliberadamente não fiz. Não avaliei ninguém com um benchmark que eu mesmo executei, porque um benchmark sobre os meus dados não diz nada sobre os seus, e esse é todo o ponto deste artigo. Também não incluí o Empromptu entre as oito, ele é o incumbente aqui.
A pergunta que organiza toda esta lista
Toda ferramenta abaixo está dentro de uma de três faixas, e a faixa é o que decide todo o resto da decisão.
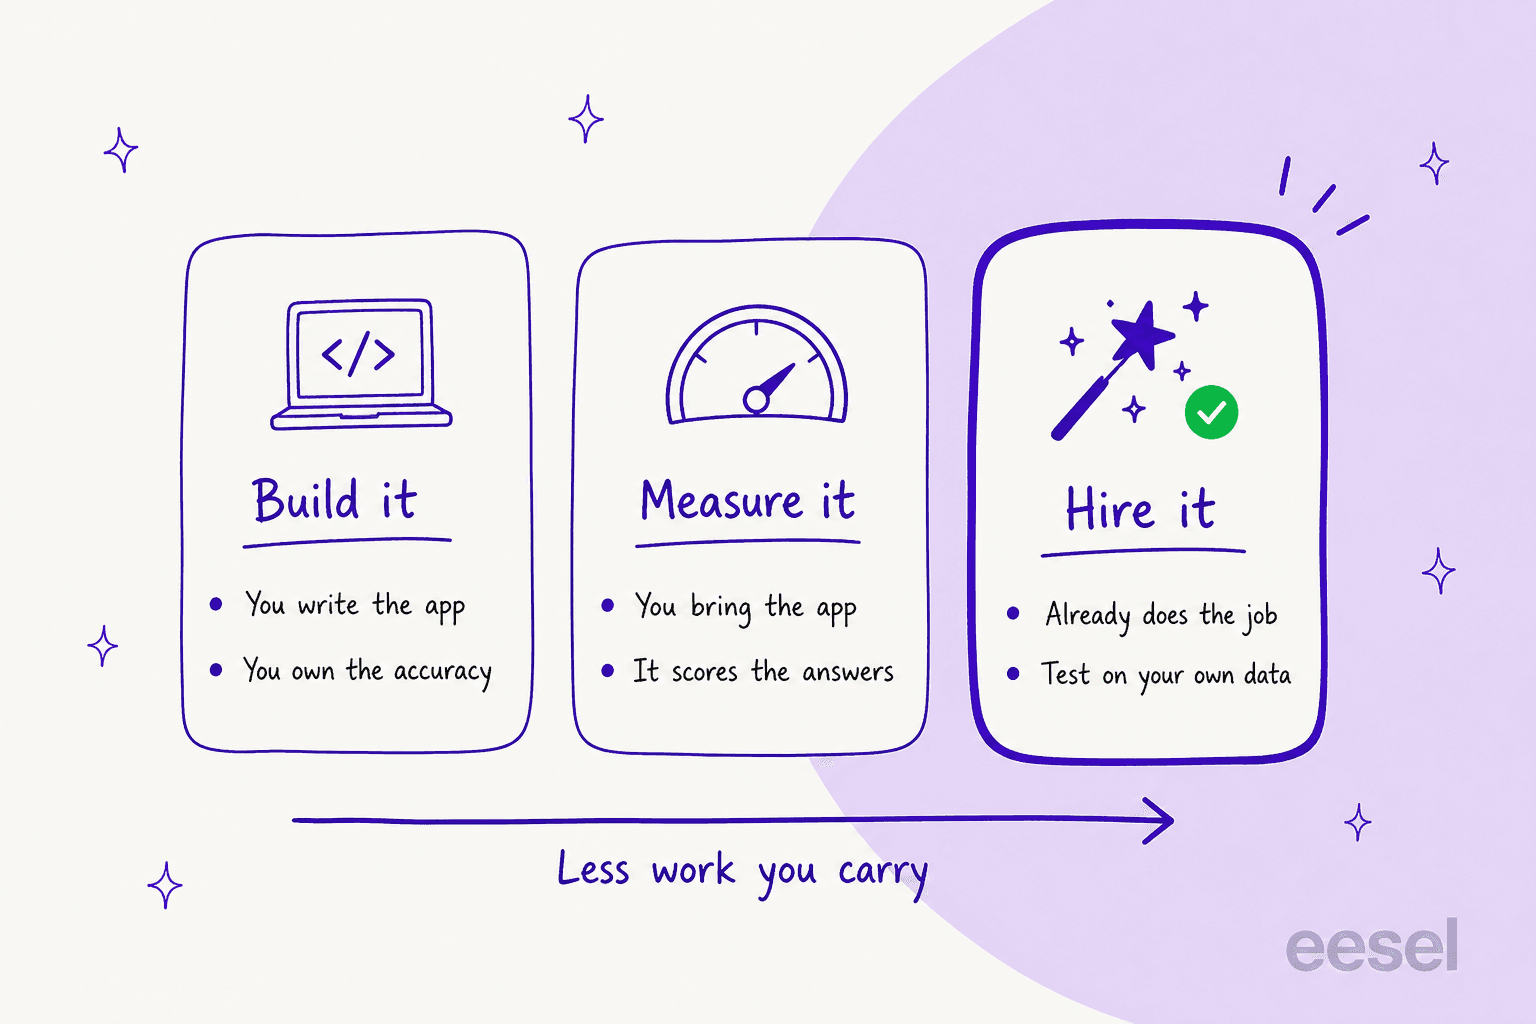
Construir. Lovable, Replit, Bolt e a plataforma do Google dão a você uma forma de produzir uma aplicação. Nenhuma delas vai dizer se as respostas estão certas. Isso não é uma falha, é apenas o escopo da coisa. O que significa é que o problema da precisão é seu, e a precisão é onde esses projetos vão morrer.
Medir. Arize e Langfuse são a camada de medição, sozinha. São boas nisso, e também honestas quanto ao limite: a documentação do Langfuse define uma tarefa como "the application code that you want to test", o que diz claramente que o app é seu. Vale saber: esses dois usam o mesmo método de fundo do Empromptu, LLM como juiz contra critérios que você escreve, então o mecanismo em si não é o diferencial. A diferença está em poder apontá-lo para tráfego histórico real antes do lançamento, ou apenas para o tráfego que chega depois.
Contratar. Glean e eesel são a faixa de compra. Trabalho já feito, integrações já presentes, e as únicas coisas que você configura são o escopo e as barreiras de proteção. A razão pela qual essa faixa vence em suporte em particular é que o modelo nunca foi a parte difícil, foram a recuperação e a lógica de escalonamento, que é exatamente o que encontrei ao comparar RAG com um LLM puro.
Essa faixa tem mais nomes do que cabem aqui. Se o trabalho é suporte voltado ao cliente e não um app de IA interno, a lista curta é diferente, e Decagon ou Sierra também pertencem a ela.
O teste a que sempre volto foi formulado por um engenheiro melhor do que eu faria:
"you shouldn't build anything that doesn't make YOUR beer taste better... your CS team buys a COTS solution for their tickets - why should you build an agent when there are multiple startups doing this? What, are you going to be better at it than those startups?"
Uma ressalva que vai na direção oposta, e digo com clareza porque o eesel perde negócios por causa dela: para uma equipe técnica, construir diretamente sobre a API do Claude ou da OpenAI é uma alternativa real, e nem sempre a decisão errada. Vários clientes do eesel saíram para fazer exatamente isso, entre eles uma empresa de tecnologia de construção com RA e uma marca de beleza DTC que migrou direto para a API do Claude. Caso de uso estreito, volume baixo, engenheiros com tempo livre: construa.
O contrapeso aparece quando alguém de fato calcula o custo da construção:
"When I started deep diving into the BRD I realized there were several full startups, charging thousands if not tens of thousands of dollars monthly for what we were trying to build. When I brought this up to my manager and showed them examples, they said ya that BRD probably has to be redone"
Alternativas ao Empromptu comparadas
| Ferramenta | Ideal para | Faixa | Preço de entrada publicado | Unidade de cobrança | Excedente publicado? | Avaliações de precisão embutidas? | Testar com seus dados antes do lançamento? | HIPAA / BAA | SOC 2 | Hospedagem própria ou on-prem | Nível gratuito |
|---|---|---|---|---|---|---|---|---|---|---|---|
| eesel AI | Contratar um colega de suporte | Contratar | A partir de US$ 299/mês (500 créditos) | Crédito (1 ticket ou chat) | Excedente opcional com teto, US$ 0,80 por crédito extra | Simulação sobre tickets antigos | Sim | HIPAA no Enterprise com BAA assinado, fale conosco | SOC 2 Type II certificado | Não | 100 créditos grátis, sem cartão |
| Gemini Enterprise Agent Platform | Construções reguladas com BAA assinado | Construir | Apenas consumo, sem taxa por usuário | Tokens mais medidores por componente | Sim, tabela completa | Serviço de avaliação, personas sintéticas | Apenas sintético | Sim, o BAA cobre | Sim | Google Cloud, VPC-SC, CMEK | US$ 300 de crédito |
| Glean | IA para toda a empresa sobre o conhecimento interno | Contratar | Não publicado, a página agora redireciona | Flex seat mais FlexCredits | Tarifa do crédito não publicada | Avaliação de agentes na plataforma | Limitado | Avaliação HIPAA | Type 2 | Implantação privada | Não |
| Arize AX | Medir um app que você já executa | Medir | US$ 0 Free, US$ 50/mês Pro | Spans de rastreamento mais GB ingeridos | Não | Sim, LLM como juiz | Offline sobre os seus conjuntos de dados | Apenas Enterprise | A partir do nível Pro | Phoenix, ELv2 | Sim, 25k spans |
| Langfuse | Avaliações de código aberto sob seu controle | Medir | US$ 0 Hobby, US$ 29/mês Core | Unidades: traces, observações, pontuações | Sim, US$ 8 por 100k | Sim, juízes e experimentos | Offline sobre os seus conjuntos de dados | Região preparada para HIPAA, Pro+ | Sim | Sim, licença MIT | Sim, 50k unidades |
| Lovable | Lançar o protótipo rápido | Construir | US$ 25/mês Pro | Créditos | Sim, US$ 0,30 por crédito | Não | Não | Não, não assina BAA | Type II mais ISO 27001 | Não | Sim, com teto |
| Replit | Construir e hospedar em um só lugar | Construir | US$ 20/mês Core | Checkpoints por esforço | Apenas pacotes de créditos | Não | Não | Não documentado | Type II | Enterprise de locatário único | Sim, limitado |
| Bolt | O primeiro rascunho mais barato | Construir | US$ 25/mês Pro | Tokens | Não publicado | Não | Não | Redigido como preparado, não certificado | Type 2 | Enterprise com nuvem própria | Sim, 300K diários |
Dois padrões saltam dessa tabela. Apenas três das oito publicam uma tarifa de excedente, e os três construtores de protótipos contra os quais o Empromptu se posiciona publicam todos um preço, enquanto não entregam nada que meça se uma resposta está sequer correta. Nessa lacuna o Empromptu tem razão. A discussão é só sobre quem deve preenchê-la.
Se você está lançando uma rede mais ampla do que essas oito, os levantamentos do eesel sobre apps de IA para o trabalho e construtores de agentes sem código cobrem as prateleiras vizinhas.
Dimensione a fatura do Empromptu antes de comparar
Antes da lista, uma aritmética que vale a pena fazer. O Empromptu é um dos poucos fornecedores aqui que publicam tanto a tabela de preços quanto a tabela de consumo de créditos, então converter dólares em operações não exige uma ligação com o comercial. Uma resposta de chat são 10 créditos, uma chamada de pesquisa na web são 10, uma execução de otimização são 10, e operações pequenas como aplicar um prompt ou criar uma avaliação são 1 cada.
Insira os seus próprios volumes:
O que vale a pena observar: o nível "Most Popular" Launch a US$ 199 tem a pior tarifa por crédito de toda a tabela, a US$ 0,0796 contra US$ 0,078 do Build. O que os US$ 199 realmente compram é capacidade e não volume: implantação em produção, domínio personalizado, exportação para o GitHub, e depois avaliações básicas mais observabilidade, tudo começa nesse nível. O único desconto real por volume chega no Operate, onde os créditos caem cerca de 37% para US$ 0,0499 cada.
A 10 créditos por chat, o plano gratuito equivale a 10 conversas por mês e o Build a 50, então uma carga conversacional consome a franquia dez vezes mais rápido do que as operações de construção. Vale a pena comparar com uma tarifa fixa por conversa antes de se comprometer, como fiz nesta análise de custos de suporte com IA.
Mais um piso para planejar: o Edge Case Detection, o gráfico de dispersão que encontra seus grupos de falhas, precisa de aproximadamente 15 a 20 execuções de otimização antes de mostrar um padrão, pela própria declaração da documentação. A 10 créditos cada, são de 150 a 200 créditos gastos antes de o recurso dizer qualquer coisa, contra um nível gratuito de 100 créditos. E o próprio recurso só começa no plano Operate de US$ 499.
1. eesel AI
Ideal para: equipes que querem o trabalho de suporte feito e não uma plataforma para fazê-lo.
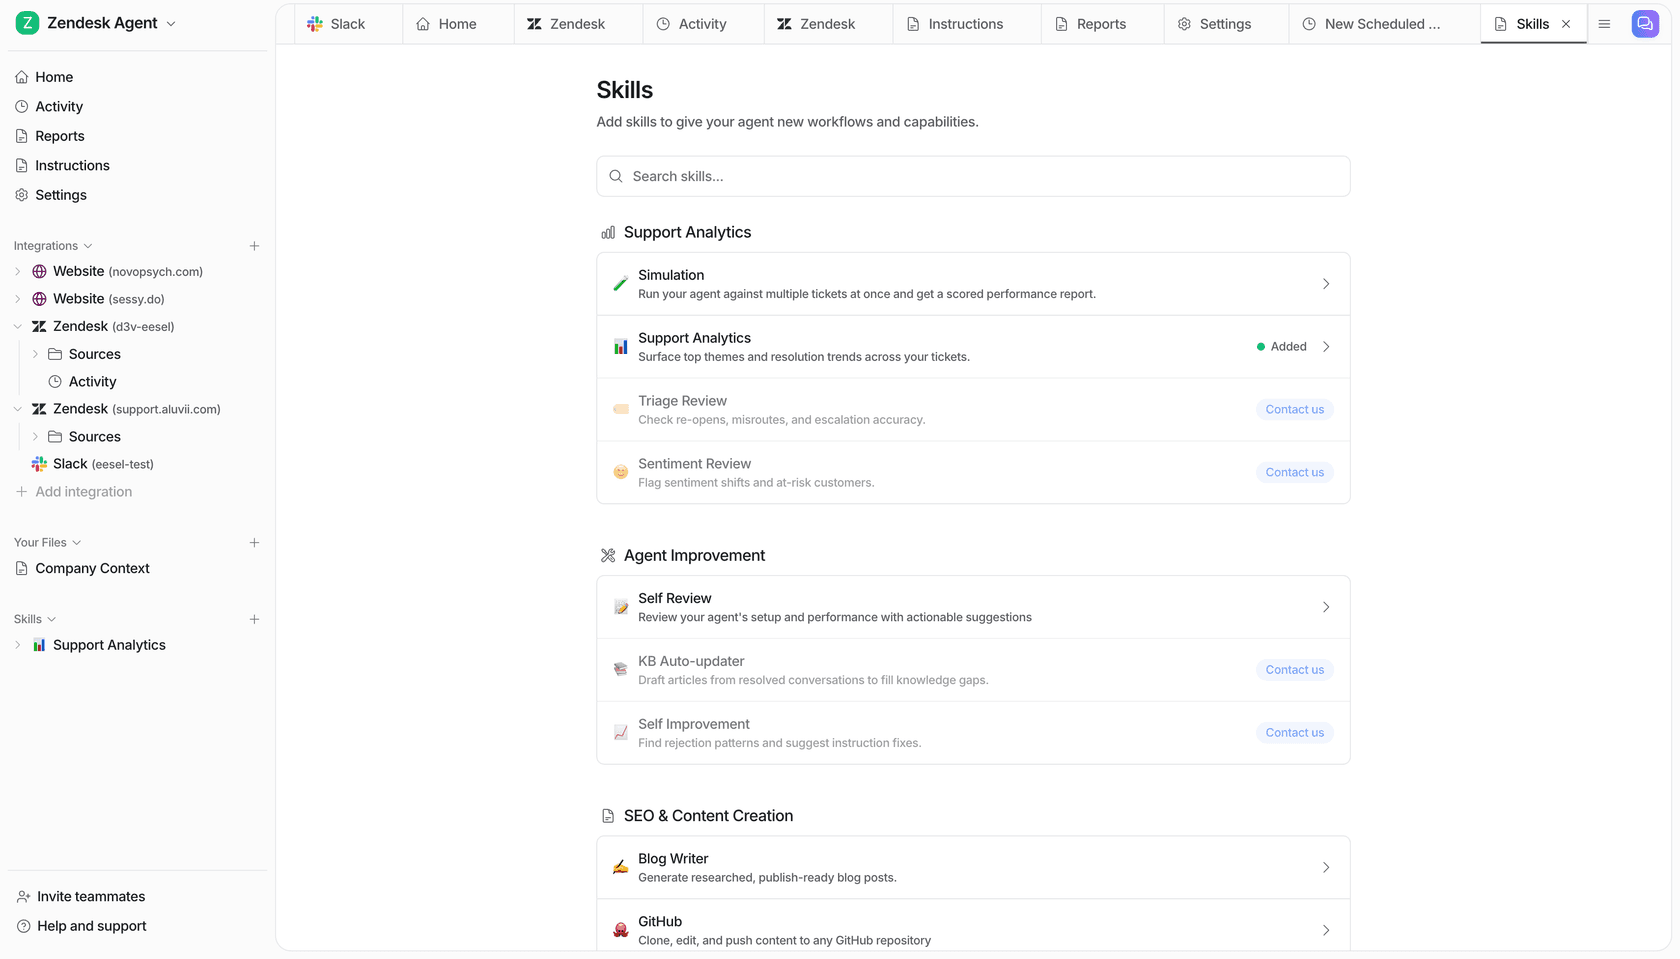
Eu trabalho nesta, então leia o restante com isso em mente. O posicionamento honesto é este: o Empromptu é a infraestrutura, o eesel é o funcionário. O eesel é uma plataforma de colegas de IA, e o elenco atual é um agente de IA para helpdesk e um redator de blog com IA. Um colega não é algo que você constrói. Você o contrata, e ele chega já sabendo trabalhar uma fila.
O que faz. O colega de helpdesk se conecta ao helpdesk que você já usa, ingere a central de ajuda, os tickets antigos e os seus documentos internos, e depois redige ou resolve tickets dentro da mesma ferramenta onde seus agentes já estão. Limites de confiança e exclusões por tipo de ticket decidem no que ele mexe. O escalonamento para um humano é o padrão para tudo fora do escopo.
A parte que importa para esta comparação. Antes de entrar no ar, ele roda uma simulação sobre seus tickets históricos e devolve uma previsão. Então a medição acontece com os seus dados. Não com os do fornecedor. O raciocínio por trás desse projeto está em nossa análise de construir ou comprar, e o lado das barreiras de proteção em prevenção de alucinações em suporte.
Preços
| Plano | Créditos por mês | Preço |
|---|---|---|
| Free | 100 | US$ 0, sem cartão |
| Teammate | 500 | US$ 299/mês |
| Teammate | 1.000 | US$ 499/mês |
| Teammate | 2.500 | US$ 999/mês |
| Teammate | 5.000 | US$ 1.899/mês |
| Rascunho de post de blog | Por post | US$ 4 cada |
Um crédito é um ticket ou um chat, independentemente de quantas respostas acabem sendo necessárias. Não há taxa de plataforma nem cobrança por usuário. A página de preços publica a lista completa de pacotes, e acima de 5.000 créditos você fala com a equipe. Pagar um ano adiantado dá dois meses grátis. Se os créditos acabarem, você pode ativar o excedente com um teto mensal que você define (US$ 0,80 por crédito extra). SSO e MFA são complementos a partir de US$ 199 por mês, e HIPAA com BAA assinado está disponível no Enterprise falando com a gente. O plano gratuito dá 100 créditos sem cartão de crédito.
Vantagens
- Simulação sobre os seus próprios tickets antigos antes do lançamento, e essa é a lacuna em toda opção da faixa de construir aqui.
- A unidade é um ticket, então a fatura acompanha o trabalho e não um crédito que você precisa converter primeiro.
- Roteamento baseado em confiança e exclusão por tipo de ticket, que é a objeção que mais ouço de líderes de suporte.
- No ar em um helpdesk em minutos em vez de uma sprint.
Desvantagens
- HIPAA é um acordo do plano Enterprise (BAA assinado) que você configura falando com a equipe, e não há opção de autoatendimento. Para uma pequena equipe de saúde, isso é uma barreira real.
- É restrito a tarefas específicas. Se o objetivo é construir uma aplicação de IA arbitrária, esta é a faixa errada, e o Empromptu se encaixa melhor.
- Você paga por tarefas, quer o resultado tenha sido perfeito ou não, como em qualquer ferramenta de IA cobrada por créditos.
Minha opinião: se o app de IA que você ia construir é um agente de suporte, então não o construa. Um cliente disse melhor do que eu consigo:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, from our case study
Pule quando o caso de uso for um pipeline de processamento de documentos ou um painel preditivo. Ambos estão na própria lista de coisas construíveis do Empromptu, e nenhum é o que um colega de helpdesk faz.
2. Gemini Enterprise Agent Platform
Ideal para: construções reguladas que precisam de um BAA assinado e de um histórico real de conformidade.
Observe primeiro a mudança de nome, antes de sair procurando: o que antes era o Vertex AI Agent Builder agora redireciona para a Gemini Enterprise Agent Platform, que o Google descreve como "an evolution of Vertex AI". O Agent Engine agora é o Agent Runtime, e o Vertex AI Search é o Agent Search.
O que faz. Tudo aquilo para que o nível Enterprise do Empromptu acena, só que desagrupado e com preço por componente: inferência de modelos, um RAG Engine, Vector Search, grounding, um serviço de avaliação, barreiras de proteção e um ambiente de execução de agentes gerenciado. A montagem fica por sua conta.
Conformidade, que é a razão real para escolhê-la. A cobertura do BAA de HIPAA lista expressamente a Agent Platform, o Agent Search e a IA generativa na plataforma. SOC 2 e ISO/IEC 27001:2022 estão ambos no escopo, e o FedRAMP High está disponível por meio do Assured Workloads. VPC Service Controls e CMEK também são suportados, embora o RAG Engine seja aqui a célula fraca: sem garantia de residência, e CMEK apenas no modo Spanner.
Preços
| Medidor | Tarifa |
|---|---|
| Gemini 3.1 Pro Preview | US$ 2,00 entrada / US$ 12,00 saída por 1M de tokens, abaixo de 200K de contexto |
| Gemini 3.7 e 3.6 Flash | US$ 0,75 entrada / US$ 3,75 saída por 1M, subindo para US$ 1,50 / US$ 7,50 em 1 jan. 2027 |
| Grounding com o Google Search | US$ 14 por 1.000 consultas de grounding, 5.000 grátis por mês |
| Grounding com os seus dados | US$ 2,50 por 1.000 prompts |
| Vector Search | US$ 3,00 por GiB processado, US$ 0,45 por GiB de inserções em streaming, mais horas de nó a partir de US$ 0,0938/h |
| Agent Compute | US$ 0,085 por hora de vCPU, 50 horas grátis por mês |
| Crédito para novos clientes | US$ 300 |
Vantagens
- A resposta de conformidade de que um comprador regulado realmente precisa, por escrito, com um BAA.
- Sem preço por usuário nem taxa de plataforma. Consumo puro, então um mês tranquilo é um mês barato.
- Todas as tarifas são publicadas, inclusive as incômodas.
- A escada de preços do Gemini 3 dá um nível de modelo barato para os 80% entediantes do tráfego.
Desvantagens
- O precipício de contexto de 200K reprecifica a requisição inteira a tarifas de contexto longo, inclusive os tokens abaixo do limite.
- Não existem conectores de helpdesk. Nem Zendesk, nem Freshdesk, nem Gorgias, nem Front. Toda integração é código que você escreve e depois mantém.
- O serviço de avaliação simula personas sintéticas, não os seus tickets históricos, então o que ele diz é como o agente lida com um cliente imaginado.
- Vários medidores ainda não começaram a cobrar, então a fatura de hoje não é o regime estável.
- O Google anuncia seu app empacotado como "no IT setup", o que é uma admissão discreta sobre a plataforma.
Minha opinião: a resposta certa quando você tem uma equipe de plataforma e um responsável de conformidade, e a errada se você esperava dispensar os dois. Os custos de Vector Search também escalam muito: o próprio exemplo do Google precifica um bilhão de vetores em US$ 5.910 por mês. Leia nosso passo a passo do pipeline RAG antes de assumir que a metade da recuperação é a fácil, e pese as alternativas ao Gemini se você ainda não está no Google Cloud.
3. Glean
Ideal para: levar IA a todo o conhecimento interno de uma empresa, com as permissões intactas.
O que faz. Busca corporativa mais agentes sobre mais de 275 conectores, e a história de permissões mais forte desta lista. O mecanismo tem nome, "permission mirroring": os conectores ingerem as ACLs e as participações em grupos de cada fonte no momento da varredura, e o Glean avalia o usuário conectado contra essas permissões espelhadas no momento da consulta. Os agentes rodam com a identidade do usuário que os aciona, não a do autor.
Conformidade. SOC 2 Type 2, ISO 27001:2022, ISO/IEC 42001:2023 para gestão de IA, um relatório de avaliação HIPAA, GDPR e TX-RAMP Nível 2. O FedRAMP não é reivindicado em lugar nenhum, o que vale notar, porque o TX-RAMP soa parecido sem ser a mesma coisa. Para ver como isso se compara com opções mais leves, veja nosso levantamento de ferramentas de recuperação de conhecimento.
Preços
| Item | O que está publicado |
|---|---|
| Preços de planos | Nenhum. glean.com/pricing agora retorna um 301 para a página inicial |
| Unidade de cobrança | Enterprise Flex Seats por usuário por mês, mais FlexCredits agrupados |
| Tarifa em dólar do FlexCredit | Não publicada |
| Consultas em Fast Mode | Ilimitadas |
| Thinking Mode, modelos padrão | 100 por usuário por semana incluídas, depois medidores |
| Glean Agent Run | ~7 FlexCredits na mediana, ~114 no p90 |
| Deep Research | ~33 na mediana, ~144 no p90 |
| Taxas de plataforma | Duas taxas anuais para todo o site: Glean Protect+ e Premium Support |
Vantagens
- O permission mirroring é real, não um filtro colocado depois.
- Mais de 275 conectores, então o trabalho de integração já está feito.
- O Glean publica seu próprio cronograma de implantação de aproximadamente 1 a 3 semanas, o que é incomumente franco.
- Criar, testar e compartilhar agentes não é medido. Só as execuções.
Desvantagens
- A página de preços sumiu. Todo valor em dólar agora vem de uma conversa comercial.
- Os FlexCredits são uma tabela completa denominada numa unidade sem preço, então você pode comparar operações entre si, mas não com dinheiro.
- Os seats são "designed to be deployed to every employee", o que eleva o piso.
- Duas taxas anuais de plataforma para todo o site, além dos seats.
Minha opinião: a compra certa quando o problema é o acesso ao conhecimento em toda a empresa e há um processo de compras à altura. Se o problema é uma única fila de suporte, é um instrumento pesado, e nossa análise dos preços do Glean e as avaliações do Glean detalham onde ele cai. Note também que o p90 de um Agent Run é dezesseis vezes a mediana, então uma carga que parece barata no piloto pode ser faturada de forma bem diferente em produção.
4. Arize AX
Ideal para: medir uma aplicação de IA que você já construiu e executa por conta própria.
O fundador do Empromptu citou esta diretamente no Hacker News, classificando-a entre as ferramentas que "require dedicated teams most startups don't have". Meio certo. O nível gratuito da Arize e o projeto de código aberto Phoenix colocam avaliação de verdade ao alcance de um único engenheiro. A outra metade é razoável, porque isto mede em vez de construir.
O que faz. Rastreamento, avaliação e observabilidade para apps com LLM. Avaliadores LLM como juiz, avaliações personalizadas, além de conjuntos de dados e experimentos, online e offline. O Phoenix é o núcleo de código aberto sob a ELv2, hospedável por conta própria localmente, no Docker ou no Kubernetes.
Preços
| Plano | Preço | Incluído | Retenção | Implantação |
|---|---|---|---|---|
| AX Free | US$ 0 | 25k trace spans/mês, 1 GB de ingestão | 15 dias | SaaS |
| AX Pro | US$ 50/mês | 50k trace spans/mês, 10 GB de ingestão | 30 dias | SaaS |
| AX Enterprise | Sob medida | Sob medida | Sob medida | SaaS ou hospedagem própria |
| Phoenix (OSS) | Grátis, ELv2 | Sem medidor | Sua | Sua infraestrutura |
Vantagens
- Usuários, avaliações, experimentos e filas de anotação são ilimitados em todos os níveis. O medidor são spans, não pessoas.
- O Phoenix é um projeto de código aberto sério, e a hospedagem própria mantém traces sensíveis na sua própria infraestrutura.
- Avaliação offline contra os seus próprios conjuntos de dados, que é o mais próximo de um teste pré-lançamento que a faixa de medir oferece.
- A escolha da região de dados é idêntica em todos os níveis em vez de ser um upsell.
Desvantagens
- Não há tarifa de excedente publicada em lugar nenhum. A página diz "included 25k/month" e para.
- HIPAA, SSO, logs de auditoria, avaliadores de código personalizados e hospedagem própria são todos restritos ao Enterprise.
- SOC 2 Type II e GDPR começam no Pro, não no Free.
- A própria tabela da Arize se contradiz sobre o Signal: a linha da Core Platform dá uma franquia ao Free e ao Pro enquanto a seção de Observabilidade lista a detecção de modos de falha como exclusiva do Enterprise.
- Nunca constrói nem hospeda o seu app. A documentação declara o pré-requisito sem rodeios: você precisa ter dados fluindo e um provedor de LLM configurado primeiro.
Minha opinião: a escolha certa quando o app já existe e o que falta são números honestos sobre ele. Trate-a como um complemento de um construtor e não como substituta, junto com o conjunto mais amplo de ferramentas de rastreamento de LLM e o ciclo de ajuste em otimização de LLM. Ela não vai dizer se você deve lançar. Só o que aconteceu depois de lançar.
5. Langfuse
Ideal para: equipes que querem a camada de avaliação e querem ser donas da máquina onde ela roda.
O que faz. Rastreamento, gerenciamento de prompts, conjuntos de dados, experimentos, filas de anotação e pontuação com LLM como juiz. Quanto ao limite, a documentação é refrescantemente literal: uma tarefa é "the application code that you want to test". As únicas coisas que executam dentro do Langfuse são o playground e os experimentos de prompts, além das chamadas do juiz.
A hospedagem própria é a manchete. O Langfuse OSS tem licença MIT e é gratuito com uso ilimitado, e roda na mesma infraestrutura da nuvem deles, sem limites de escalabilidade. Nove recursos de governança exigem uma chave de licença enterprise: RBAC no nível de projeto, rótulos de prompts protegidos, políticas de retenção, logs de auditoria, mascaramento de dados no servidor, personalização da interface, criadores de organização, a API de gerenciamento de organizações com SCIM e a API de gerenciamento de instâncias. Para uma equipe regulada que quer tudo dentro da própria VPC, esta é a resposta mais limpa de toda a lista.
Preços
| Plano | Preço | Unidades incluídas | Excedente | Usuários | Acesso aos dados |
|---|---|---|---|---|---|
| Hobby | Grátis, sem cartão | 50k/mês | Nenhum | 2 | 30 dias |
| Core | US$ 29/mês | 100k/mês | US$ 8 por 100k | Ilimitados | 90 dias |
| Pro | US$ 199/mês | 100k/mês | US$ 8 por 100k | Ilimitados | 3 anos |
| Complemento Teams | +US$ 300/mês | Complemento | - | - | - |
| Enterprise | US$ 2.499/mês, compromisso anual | 100k/mês | US$ 8 por 100k | Ilimitados | 3 anos |
Uma unidade é um trace, uma observação ou uma pontuação. O excedente graduado é de US$ 8 por 100k até 1M, e depois US$ 7, US$ 6,50 e US$ 6 conforme o volume sobe.
Vantagens
- Hospedagem própria MIT sem teto de uso, o que é raro e muito generoso.
- A tarifa de excedente é publicada, graduada e fácil de modelar.
- Usuários ilimitados em todos os níveis pagos.
- Independente de framework, então fica ao lado do que você construiu em vez de substituí-lo.
Desvantagens
- Todos os níveis pagos incluem as mesmas 100k unidades e o mesmo excedente de US$ 8. O que a escada de US$ 29 a US$ 199 a US$ 2.499 compra é retenção e limites de taxa, segurança e suporte. Nunca volume.
- As próprias avaliações cobram: pontuações do juiz, filas de anotação e experimentos contam todos como unidades.
- HIPAA é uma "HIPAA-ready region" no Pro e acima, que é uma opção de implantação e não uma certificação.
- Okta SSO e RBAC no nível de projeto no Cloud Pro exigem o complemento Teams de US$ 300/mês, então um time Pro que precisa de Okta custa na verdade US$ 499/mês.
- O preço do Enterprise com hospedagem própria soma-se ao seu plano ClickHouse, pela própria declaração do Langfuse.
Minha opinião: minha recomendação padrão na faixa de medir, e em grande parte por causa da licença. Se o que atraiu você no Empromptu foi a implantação on-premise e ser dono das próprias ferramentas, o Langfuse entrega essa metade por completo, e experimentar não custa nada. A outra metade, o app em si, você ainda precisa escrever. Nosso comparativo entre LangChain e LangGraph cobre o que costuma ir nessa lacuna.
6. Lovable
Ideal para: ter um protótipo funcionando na frente de alguém ainda esta tarde.
A própria página de comparação do Empromptu argumenta que "vibe coding tools get you to demo. They don't get you to production." Especificamente no ponto da precisão, é uma leitura justa do que o Lovable de fato entrega.
O que faz. Você descreve um app no chat e recebe de volta uma aplicação full-stack funcional, com hospedagem, autenticação e banco de dados. A sincronização com Git no GitHub e no GitLab vem em todos os planos, Free incluído, e o código é seu por escrito.
Sobre avaliações, com precisão. Não há arnês de avaliação, nem conjunto de dados de referência, nem métrica de precisão, nem simulação, em nenhum plano. O que ele entrega são testes de software (testes de navegador, Vitest, testes de edge functions) e varredura de segurança, que são fáceis de confundir com avaliações. O que medem é se o app roda. Não se a IA está certa. O RAG também é um alvo de construção aqui: você recebe modelos de embeddings para que a recuperação seja sua para construir, e não há ingestão gerenciada nem relatório de qualidade de recuperação.
Preços
| Plano | Preço | Créditos | Observações |
|---|---|---|---|
| Free | US$ 0 | 5 créditos diários de construção, limitados a 30/mês | Sem download de código, sem domínios personalizados |
| Pro | US$ 25/mês | 100/mês | Edição e download de código liberados |
| Business | US$ 50/mês | 100/mês | Mesmos créditos do Pro, adiciona SSO, RBAC, central de segurança |
| Enterprise | Taxa de plataforma mais volume, só sob consulta | Baseado em volume | Sem créditos diários de construção |
O excedente é publicado: US$ 0,30 por crédito no Pro e US$ 0,60 no Business. Os créditos do plano expiram após dois meses, as recargas após doze. Ambas as escadas vão até 10.000 créditos, a US$ 2.250/mês no Pro e US$ 4.300/mês no Business.
Vantagens
- O caminho mais rápido de uma ideia a algo clicável.
- Tarifa de excedente publicada nos dois níveis, o que nem todos aqui conseguem.
- SOC 2 Type II, ISO 27001:2022 e GDPR com DPA.
- Membros ilimitados em todos os planos, e sincronização com Git até no Free.
Desvantagens
- HIPAA está explicitamente fora. A documentação empresarial declara que o Lovable não assina BAAs e não é compatível com HIPAA, o que o exclui para o comprador central de saúde do Empromptu.
- Sem opção de VPC, locatário único ou hospedagem própria. É multilocatário com isolamento lógico e fixação de região.
- O Business custa exatamente o dobro do Pro por créditos idênticos, então você paga por recursos de governança.
- As recargas carregam um ágio de cerca de 20% sobre a tarifa de crédito implícita na assinatura.
Minha opinião: use-o para a demonstração e decida separadamente quem é dono da produção. Nossa avaliação do Lovable tem a versão mais longa, e o Emergent é o par mais próximo se esse formato atrai, mas a resposta de conformidade não.
7. Replit
Ideal para: construir, hospedar e executar a coisa em um só lugar.
O que faz. Um ambiente de desenvolvimento em nuvem completo, com um agente que escreve, executa e implanta. Download em zip, sincronização bidirecional com o GitHub e acesso a shell tornam a propriedade do código real, com uma ressalva: administradores do Enterprise têm uma chave "Ban source code export".
Sobre avaliações. Pesquisei todo o índice da documentação do Replit, todas as 412 entradas, e há zero ocorrências de "eval" e nenhuma página sobre precisão, RAG, recuperação, embeddings, ground truth, benchmarking ou alucinação. Três recursos parecem avaliações sem ser: o App Testing controla um navegador real mas verifica se o app roda, a revisão de código integrada verifica a qualidade do código e a varredura de segurança verifica a postura de vulnerabilidades.
Preços
| Plano | Preço | Unidade | Incluído | Excedente |
|---|---|---|---|---|
| Starter | Grátis | Créditos diários de agente | Quantidade nunca publicada | Builds Lite, 1 app, expira em 30 dias |
| Core | US$ 20/mês, US$ 18 anual | Checkpoints por esforço | "$20 towards most powerful models" | Pacotes de créditos |
| Pro | US$ 100/mês, US$ 90 anual | Checkpoints por esforço | "$100 towards most powerful models" | Pacotes de créditos, acumulam por 2 meses |
| Níveis Pro superiores | US$ 215 / US$ 425 / US$ 825 / US$ 2.000 | Igual | Quantidade de créditos não indicada por faixa de preço | Igual |
| Enterprise | Sob medida | Seats mais uso | Não publicado | SSO/SAML, locatário único, IPs estáticos |
Os pacotes de créditos são a única via de excedente: US$ 100 por US$ 100, US$ 300 por US$ 290, US$ 500 por US$ 480, US$ 1.000 por US$ 950. Expiram em seis meses.
Vantagens
- Um só ambiente para construir, testar, hospedar e implantar.
- Portabilidade real do código por download em zip e sincronização com o GitHub.
- O gasto com modelos é repassado à tarifa pública de API do provedor, sem margem.
- O SOC 2 Type II é do próprio Replit, não herdado.
Desvantagens
- O medidor é o "esforço", e esforço não tem tarifa publicada. A documentação do Replit linka um app estimador em vez de uma tabela de preços.
- HIPAA está totalmente ausente da documentação, do whitepaper de segurança e da central de confiança.
- A ISO 27001 na lista de conformidade pertence ao Google Cloud, listada como garantia de infraestrutura e não como própria do Replit.
- A documentação se contradiz sobre os nomes dos modos de agente, com Free/Power/Max em algumas páginas e Lite/Economy/Power em outras.
- Locatário único e SSO são barreiras do Enterprise só sob consulta.
Minha opinião: a história de construir e hospedar mais forte entre os três construtores de protótipos, e também a mais difícil de prever em fatura. Um medidor que você não consegue orçar é um problema real num projeto regulado, onde o orçamento precisa ser aprovado antes de qualquer coisa começar. Nossa análise dos preços do Replit e a avaliação do Replit trazem a leitura mais profunda.
8. Bolt
Ideal para: o primeiro rascunho mais barato possível, com propriedade limpa do código.
O que faz. Construção de prompt para app no navegador, da StackBlitz, com sincronização bidirecional com o GitHub, importação de repositórios e implantação fora da plataforma. A propriedade é declarada com clareza: todo o código que você cria é seu. Supabase e Netlify também estão documentados como alternativas ao Bolt Cloud, então a costura do lock-in fica na infraestrutura e não no código.
Sobre avaliações. Nenhuma. Li o índice completo da documentação, e não há lá nenhuma página sobre avaliações ou testes, nenhuma sobre pontuação de precisão, benchmarking ou RAG. O único recurso em forma de medição é uma auditoria de segurança do app que ele construiu, e para uma saída errada a rede de segurança é a reversão pelo histórico de versões.
Preços
| Plano | Preço | Tokens | Observações |
|---|---|---|---|
| Free | US$ 0 | 300K/dia mais 1M/mês | O site fica offline no limite, suporte apenas por Discord |
| Pro | US$ 25/mês, US$ 216/ano | 10M/mês | Sem limite diário, domínios personalizados |
| Pro 50 | US$ 50/mês, US$ 540/ano | 26M/mês | |
| Pro 100 | US$ 100/mês | 55M/mês | |
| Pro 200 | US$ 200/mês | Não publicado | Confirmado em um exemplo de documento de cobrança |
| Teams | US$ 30/mês por membro | Por nível, por seat, nunca agrupados | Necessário para o seu próprio design system |
| Enterprise | Só sob consulta | - | SSO, logs de auditoria, AWS ou Azure próprios |
Vantagens
- O ponto de entrada real mais barato da faixa de construir, com um nível gratuito utilizável.
- A propriedade e a portabilidade do código são declaradas com clareza e sustentadas por sincronização bidirecional.
- O Enterprise permite trazer a sua própria AWS ou Azure, o que importa para o controle de dados.
- Um caminho de importação documentado a partir do Lovable, se você começou por lá.
Desvantagens
- O medidor é o token do modelo, e a própria FAQ do Bolt diz que a maior parte do uso vem de sincronizar o sistema de arquivos do projeto com a IA, então o custo sobe conforme a base de código cresce.
- Os tokens do plano expiram em dois meses e só sobrevivem enquanto você continua pagando. Cancele e os tokens acumulados morrem no fim do ciclo.
- A tarifa de recarga não é publicada e só é visível após o login.
- HIPAA e FedRAMP são redigidos como "ready" e não certificados, e só o SOC 2 Type 2 traz uma alegação real de conformidade. O GDPR não aparece em lugar nenhum na documentação do produto.
- O desconto anual se contradiz entre as páginas, com "up to 28%" em preços e 10% no documento de cobrança.
Minha opinião: a forma mais barata de descobrir se a ideia vale ser construída, e a menos adequada para sustentá-la depois. Se é a empresa controladora que você está pesquisando, nossas páginas de preços da StackBlitz e alternativas à StackBlitz cobrem esse lado.
Como é na prática um número de precisão medido
Passei tempo suficiente perto de filas de suporte ao vivo para saber que o bot que soa confiante é o perigoso. É por isso que todo rollout do eesel simula primeiro contra tickets históricos, antes de tocar em um cliente.
Eis o que saiu de um deles, para uma joalheria online alemã que atende cerca de 1.000 tickets por mês entre Zendesk e Shopify. Em 284 chats reais mais uma validação cruzada de 100 tickets, foi isto que o relatório disse: 93% de precisão na triagem, 100% de detecção de spam com zero falsos positivos numa caixa de entrada que tinha 22% de spam, 88% de precisão direcional dos rascunhos e uma taxa de erro factual de 7%. Por categoria, a utilidade dos rascunhos foi de 93,8% em devoluções e reembolsos, 96,4% em reclamações de garantia e 100% em consultas sobre produtos.
Veja o que torna isso diferente de "98%". O conjunto de dados é nomeado. O volume também. E os erros são publicados no mesmo fôlego que os acertos, porque uma medição sem taxa de erro anexada é um número de marketing.
Esse é o padrão que eu exigiria de todo fornecedor desta lista, o eesel incluído. Peça o conjunto de dados e depois insista em refazer a medição com o seu.
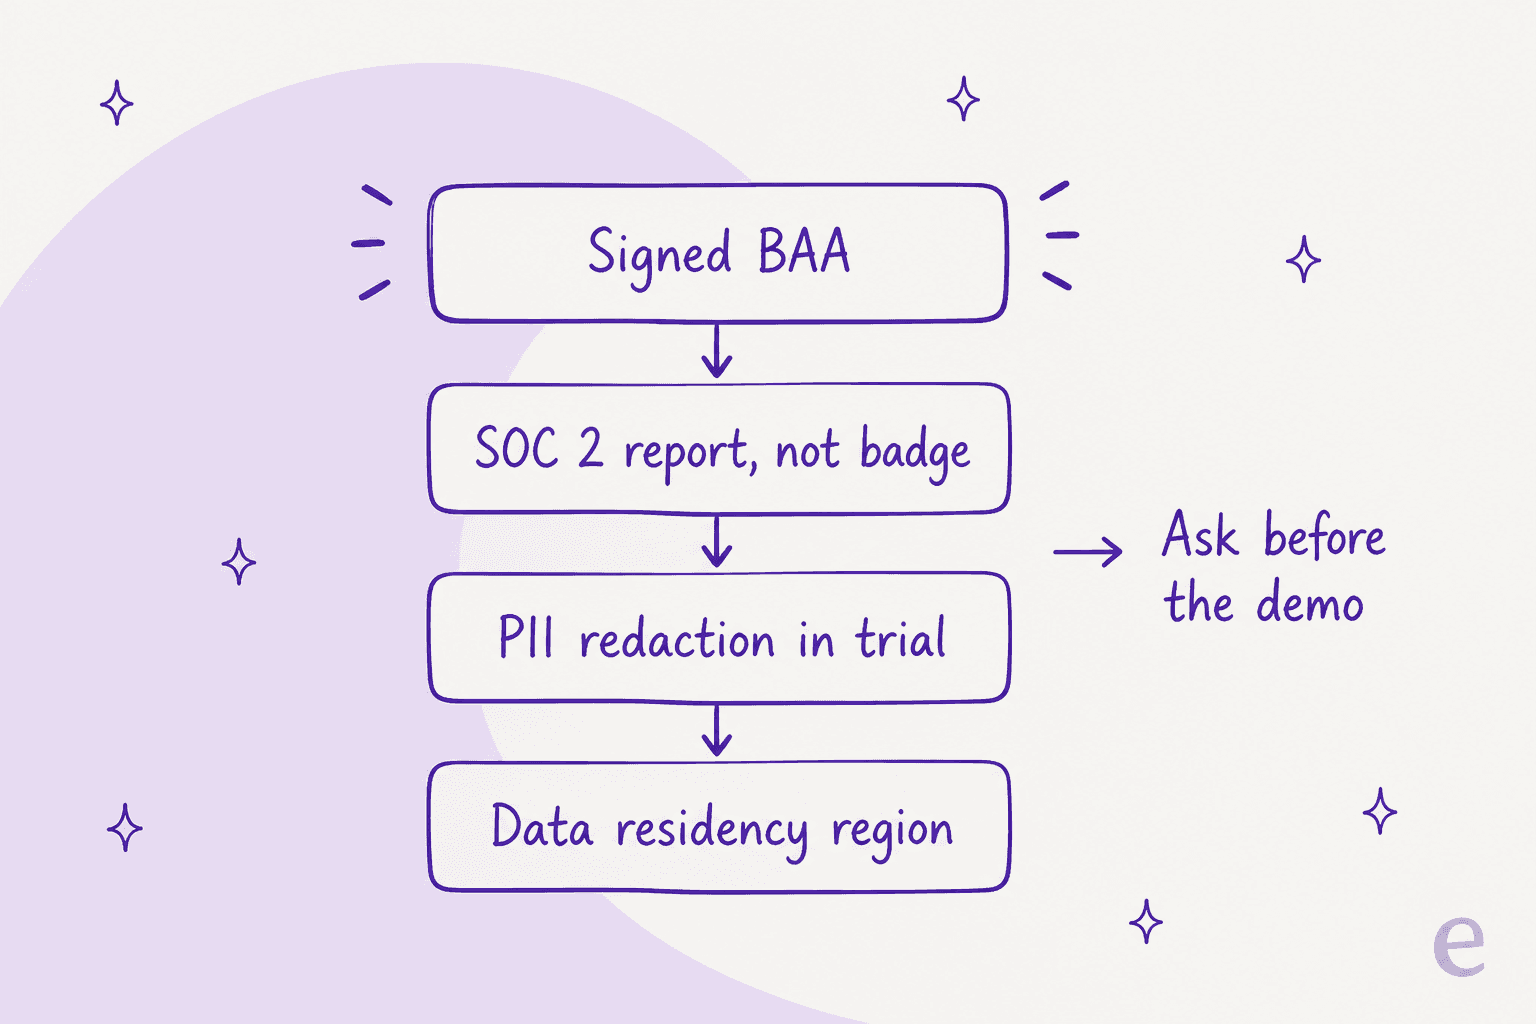
E se a compra é para uma equipe regulada, passe pelos quatro portões acima antes da demonstração, e não depois. O eesel já perdeu negócios nos quatro. Uma plataforma de saúde dos EUA no Zendesk travou de forma categórica em HIPAA e BAA durante a própria chamada. Uma plataforma de podcasts no Freshdesk não pôde prosseguir sem SOC 2. Uma empresa de mídia com cerca de 1.000 tickets por semana fez da redação de PII no teste sua principal objeção. Essas conversas custam muito menos na semana um do que na semana seis, qualquer que seja o fornecedor que você escolher no fim. Minhas notas sobre IA compatível com HIPAA e plataformas compatíveis com HIPAA listam as perguntas que valem ser enviadas com antecedência.
Experimente o eesel
Se a aplicação de IA no seu roadmap é um agente de suporte, o caminho mais rápido é não construí-la. O colega de IA para helpdesk do eesel se conecta ao helpdesk que você já usa, aprende com a sua central de ajuda e tickets antigos, e começa a redigir ou resolver dentro da fila onde seus agentes já vivem. Os planos começam em US$ 299 por mês para 500 créditos (1 crédito por ticket atendido), sem taxa de plataforma e sem seats, mais um plano gratuito de 100 créditos para começar e sem cartão de crédito.
A parte relevante para tudo o que foi dito acima: você simula primeiro com os seus próprios tickets históricos e vê a previsão antes que um cliente a veja. Limites de confiança e exclusões por tipo de ticket decidem no que ele pode mexer, o que torna o rollout gradual por design em vez de uma chave de tudo de uma vez.

Quer a previsão com os seus próprios tickets antes de se comprometer com qualquer coisa? Experimente o eesel de graça, ou leia como o eesel mede o ROI do suporte com IA para saber o que procurar no relatório.
Perguntas frequentes
Quais são as melhores alternativas ao Empromptu em 2026?
Quanto custa o Empromptu?
O Empromptu é compatível com HIPAA?
/security quanto /trust retornam 404. Para uma implantação regulada, peça o BAA assinado e o relatório SOC 2 real antes da demonstração. Nossas notas sobre IA compatível com HIPAA e SOC 2 para chatbots de suporte mostram o que pedir.