

Tencent Hunyuan Hy4(「Hy4 preview」)は、チャットではなく仕事をこなすために作られた大型のオープンウェイトモデルです。総パラメータ770B、トークンあたり49B稼働、1Mトークンのコンテキスト、Apache 2.0ライセンスのMixture-of-Expertsモデルで、2026年8月28日に、コーディング、オフィス生産性、ゲーム開発、科学研究向けとして公開されました。
数字で見ると、Tencent自身のブラインドテストではKimi K3とGLM-5.3をわずかに上回りますが、公開ベンチマークではこの2つと勝ち負けを分け合い、たいていClaude Opus 5やGPT-5.6の後ろに回ります。正直な評価は「中国勢の他のフラッグシップとほぼ同等」で、本当の強みは2つです。1つは、100万トークンあたり入力0.834ドル・出力2.501ドルと、フラッグシップ級のオープンモデルで最安であること。もう1つは、重みが本当にオープンであることです。
あらゆる議論を支配する問題は、大きすぎてローカルでは動かせないことです。量子化しても重みだけで約924GBが必要なので、ノートPC向けではなくデータセンターかAPI向けのモデルです。素のモデルであるため、多くのチームはダウンロードではなく、APIやそれを基にした製品を通じてHy4に触れることになります。特定の仕事を最初から最後までこなすAIが欲しいなら、Hy4を含むどのベースモデルよりも、eeselのようなすぐに働けるチームメイトのほうが適しています。
Tencent Hy4とは何か
Tencentは2026年8月28日にHy4 previewを公開し、オープンソース化しました。同社はこれを「built for real-world productivity tasks, delivering outstanding performance across coding, office work, and scientific research」と呼んでいます。TencentのHunyuanチームの最新モデルで、Hy3シリーズに続くものであり、初日からオープンウェイトで公開されました。
位置づけは重要です。汎用AIチャットボットと競う親しみやすいアシスタントとしては売り出されていません。Tencentは自社のCodeBuddyとWorkBuddyと共同で設計し、ソフトウェアエンジニア、ゲーム開発者、金融アナリスト、セキュリティ専門家の業務データで学習させました。主な機能は、長時間にわたるデバッグ、散らかった複数ファイルの文脈をドキュメントやスプレッドシートに変換すること、1つのプロンプトからプレイ可能なゲームのプロトタイプを生成すること、分子動力学や純粋数学の研究課題を推論することなどです。
Hugging Faceのモデルカードに基づく、重要なスペックは次のとおりです。
| 項目 | 値 |
|---|---|
| アーキテクチャ | Mixture-of-Experts(MoE) |
| 総パラメータ数 | 770B |
| トークンあたりの稼働パラメータ数 | 49B |
| レイヤー数 | 78(Dense 1 + MoE 77) |
| ルーティング / 共有エキスパート | ルーティング256 + 共有1、top-8を有効化 |
| コンテキスト長 | 1Mトークン |
| アテンション | Gated DeepSeek Sparse Attention(Gated DSA) |
| ライセンス | Apache 2.0 |
| バリアント | BF16 instruct + 公式FP8ビルド |
正直さを感じさせる点として、Tencentはこれを「preview」と明記し、欠点も率直に挙げています。モデルカードは、Hy4が複雑なタスクで必要以上に長く推論することや、「a tendency to over-verify its own work」があることを認めています。早く出して改善を重ねるこのやり方は、Hy3がpreviewから最終版の間に大きく強化されたのと同じアプローチです。
Mixture-of-Expertsの設計はどう動くのか
多くの人が注目する770Bと49Bという2つの数字は、Mixture-of-Expertsモデルの核心的な仕組みを表しています。Hy4がなぜ高速なのに運用が悪夢なのかを説明してくれるので、理解しておく価値があります。
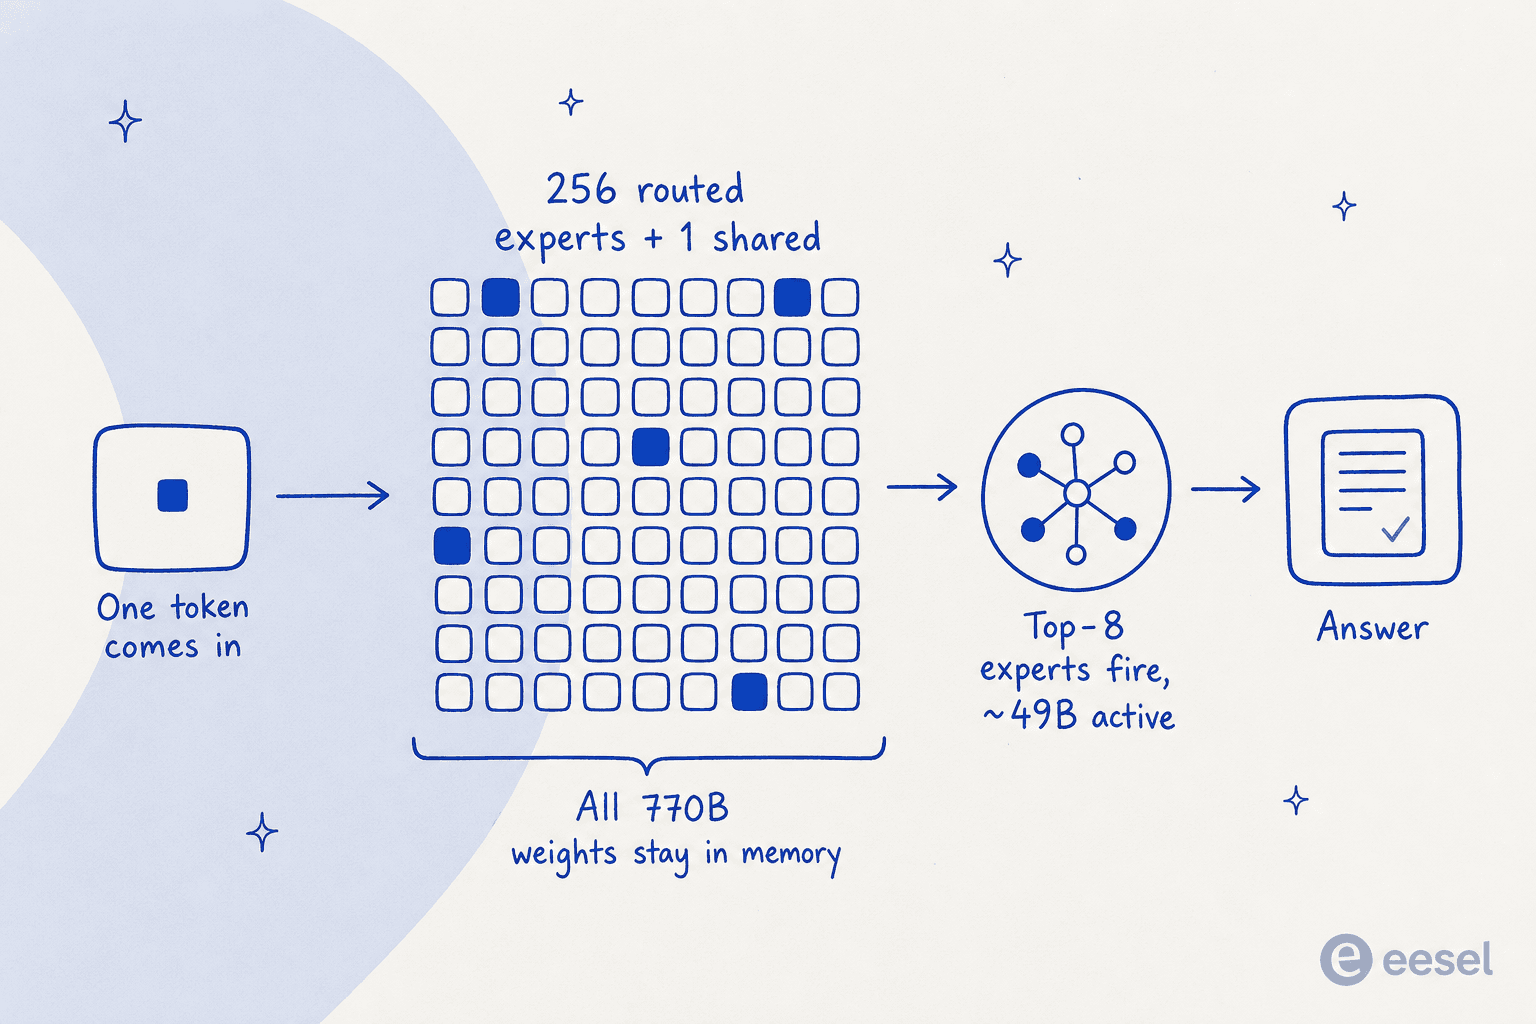
骨格は78レイヤーです。最初の1層は通常のDenseレイヤーで、残り77層はそれぞれ256のルーティングエキスパートと1つの共有エキスパートを持ちます。トークンが入ると、ルーターがそのトークンに最も関連する上位8つのエキスパートを選び、それら(と共有エキスパート)だけが実際に計算します。つまりモデルは770Bパラメータでも、トークンごとに稼働するのは約49Bです。これが推論スループットを現実的に保っています。トークンごとに770BのDenseモデル分の計算コストを払うわけではありません。
内部では、TencentはDeepSeekとGLMのアイデアを活用しています。アテンションには再利用可能なインデックスキャッシュを備えたGated Sparse Attentionを使い、小さなバッチサイズでの生成を高速化する投機的デコーディング向けに、ネイティブのマルチトークン予測レイヤーが追加されています。重要なのは次のセクションの落とし穴です。MoEが節約するのは計算であって、メモリではありません。770B分の重みはすべて同時にGPUメモリに載せる必要があります。
ベンチマークを正直に読む
Tencentの発表資料は「GLM-5.3とKimi K3を上回る」と主張しており、技術的には事実ですが、聞こえほど強い話ではありません。この主張は社内のブラインド評価によるものです。社内の専門家163人が203のエンジニアリングタスクでモデルの出力を評価し、それぞれ4.00点満点で採点しました。
| モデル | ブラインド評価の平均(/4.00) | Hy4の直接対決結果 |
|---|---|---|
| Hy4 preview | 2.99 | - |
| Kimi K3(Moonshot) | 2.94 | Hy4の勝ち51.2% / 引き分け7.9% / 負け40.9% |
| GLM-5.3(Z.AI) | 2.92 | Hy4の勝ち46.8% / 引き分け12.8% / 負け40.4% |
ベンダー自身の4点満点で0.05点の差は、統計的には誤差のようなものです。Tencent自身も、これは"bounded by its tasks, model versions, raters, and procedure... not an independent public benchmark"だと断っています。GLM-5.3との比較では、Hy4の勝ちが負けを上回るのは47対40にすぎません。リードの顔をしたほぼ互角です。
公開ベンチマークのチャートのほうが全体像を語っており、正直に見るべきなのはこちらです。
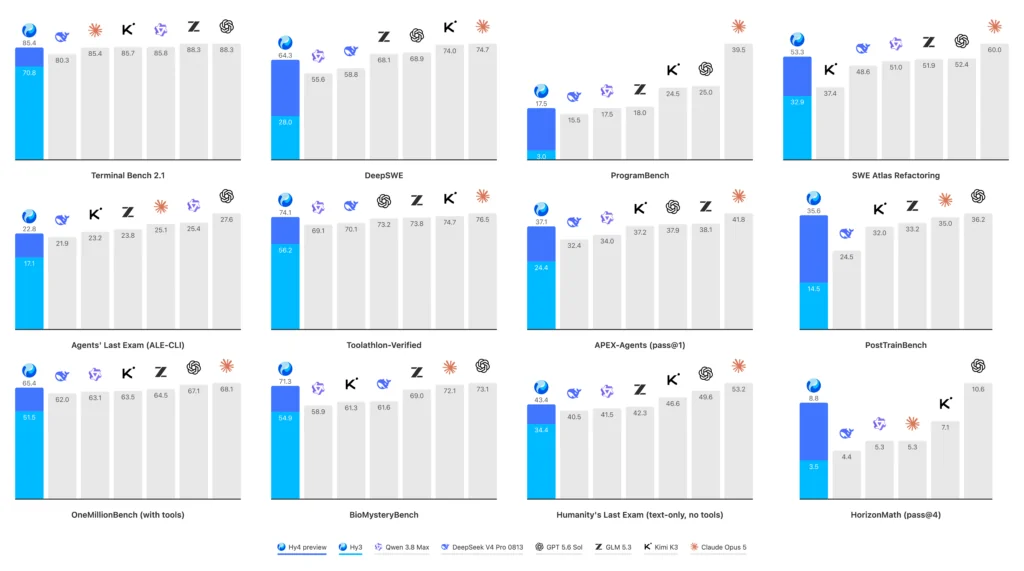
Hy4は強いスコアもいくつか出しています。GPQA Diamondで92.3、Terminal Benchで85.4、SWE-bench Multilingualで82.9で、HorizonMathとBioMysteryBenchではオープンモデルの中で首位です。しかし12のパネル全体を見ると、たいていClaude Opus 5かGPT-5.6が上にいて、Hy4はKimi K3、GLM-5.3、Qwen 3.8 Maxと並ぶ中位集団に収まっています。コミュニティはこの見せ方にすぐ気づきました。
Why do they always highlight benchmarks where it scored less than other models the same as the ones where it scored better? It's so misleading. I can't even tell which benchmarks it actually beat other models.

独立した位置づけについては、Hy4はArtificial Analysisのインテリジェンス指数にまだ掲載されていないため、引用できる中立的な総合スコアはありません(参考までに、そのボードの現在の首位であるClaude Opus 5は63です)。これまでの第三者のシグナルは、LMArenaのコーディングリーダーボードだけです。
Hy4 preview by @TencentHunyuan just landed ~#5 in the Code Arena: WebDev with 1633 pts (AutoEval)... Among open models, Hy4 preview is ~#3, compared to Hy3 at #7.
Hy3からの本物の飛躍ですが、「AutoEval」という但し書きに注意してください。Arenaによると、人間のライブ投票ではなく報酬モデルが自動で投票したものなので、暫定的な結果として扱うべきです。私の見立てでは、Hy4は中国勢の他のフラッグシップとほぼ同水準の、確かに強力なオープンモデルで、「上回る」という表現はほぼ互角の結果に対するマーケティングです。さらに詳しい直接比較は、同じ階層を扱うQwen 3.8 Max対Kimi K3の比較をご覧ください。
実際に動かせるのか
これは発表時のどのスレッドでも話題の中心になった質問で、答えは厳しいものです。MoEは計算を節約しますが、770B分の重みはすべてGPUメモリに置く必要があります。
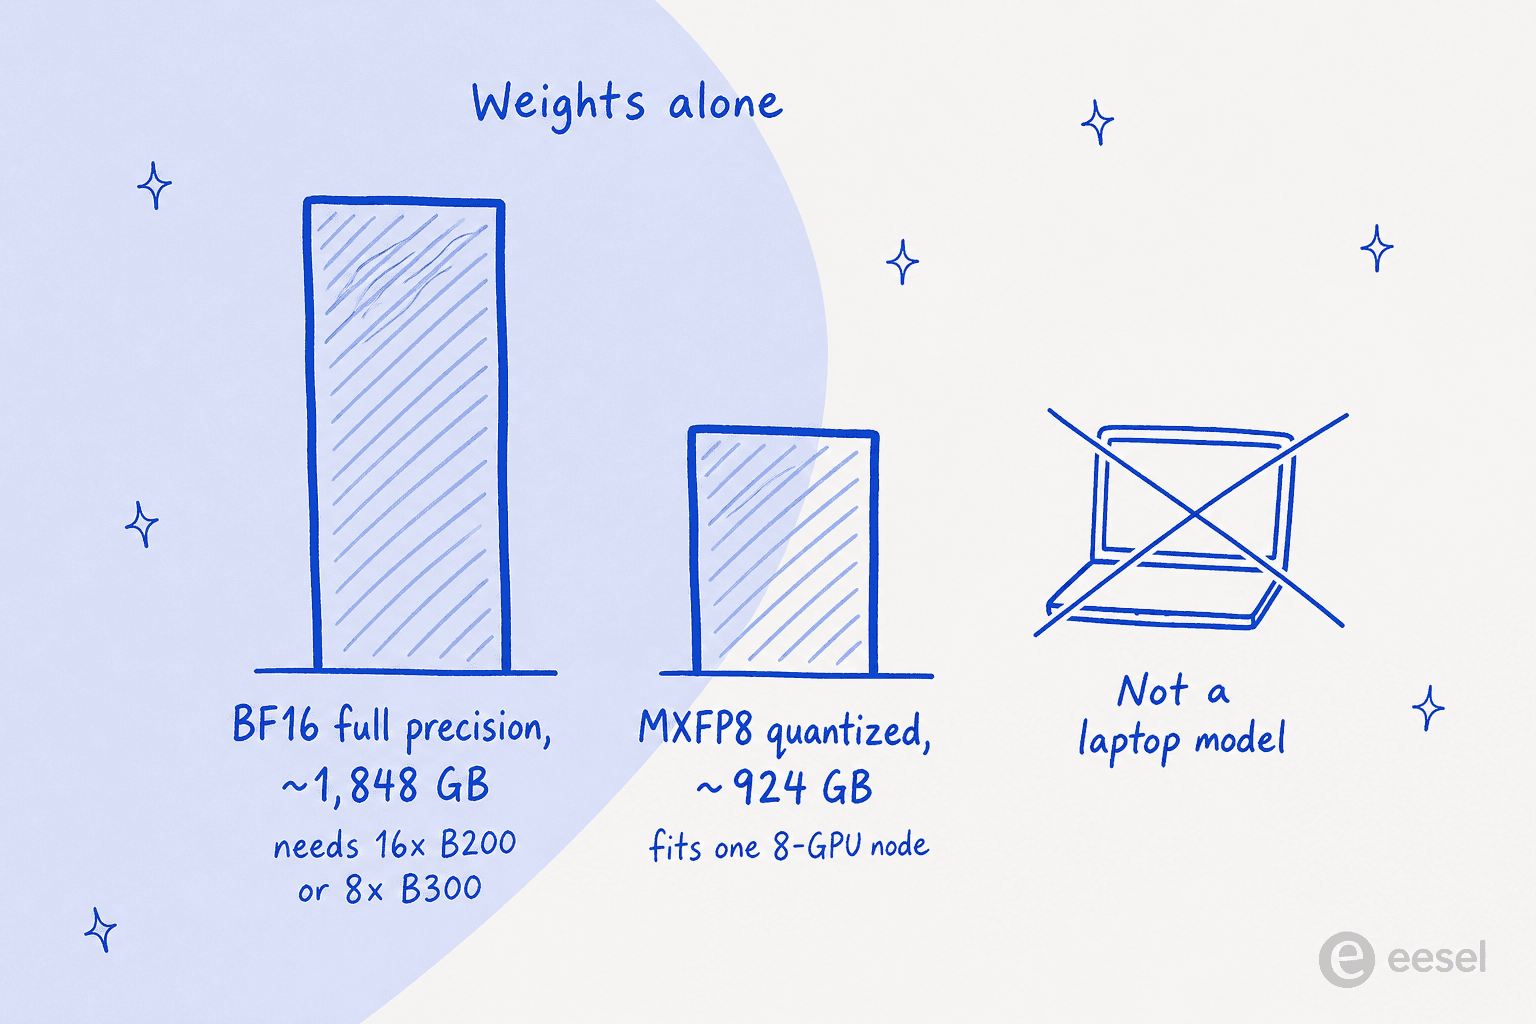
公式のvLLMレシピによると、BF16の完全な重みは約1,848GBです。その結論は率直で、「16x B200 or 8x B300 minimum for weights + KV cache」が必要です。MXFP8の量子化ビルドではそれがほぼ半分の約924GBになり、最新の大容量VRAMアクセラレータ8基のノード1台に収まります。そのため、デフォルトのサービング例ではテンソル並列サイズ8が使われています。公式のFP8チェックポイントと、さらに圧縮するためのAngelSlimという量子化ツールキットもありますが、どれも家庭用マシンで届く範囲にはなりません。趣味で大型モデルを動かすr/LocalLLaMAの住人たちも、ほとんどが諦めました。
I don't know who around here runs 780b models, but I am happy for them :)
コミュニティ自身の量子化計算も厳しく、Q4ビルドで約450〜512GB、256GBのマシンに収まるのは1〜2ビットの量子化だけです。あるコメントはこう述べています。256GBあるなら、"you'll probably be much better off with GLM-5.3-Flash Q4"。つまりほとんどの人にとって、「オープンウェイト」はライセンス上の事実であり、実用上の事実ではありません。Hy4はAPI経由で使うことになります。
価格と他モデルとの比較
Hy4のAPI料金は、100万トークンあたり入力0.834ドル、出力2.501ドル、キャッシュヒット0.042ドルです。フラッグシップ級のオープンモデルの中では最安です。
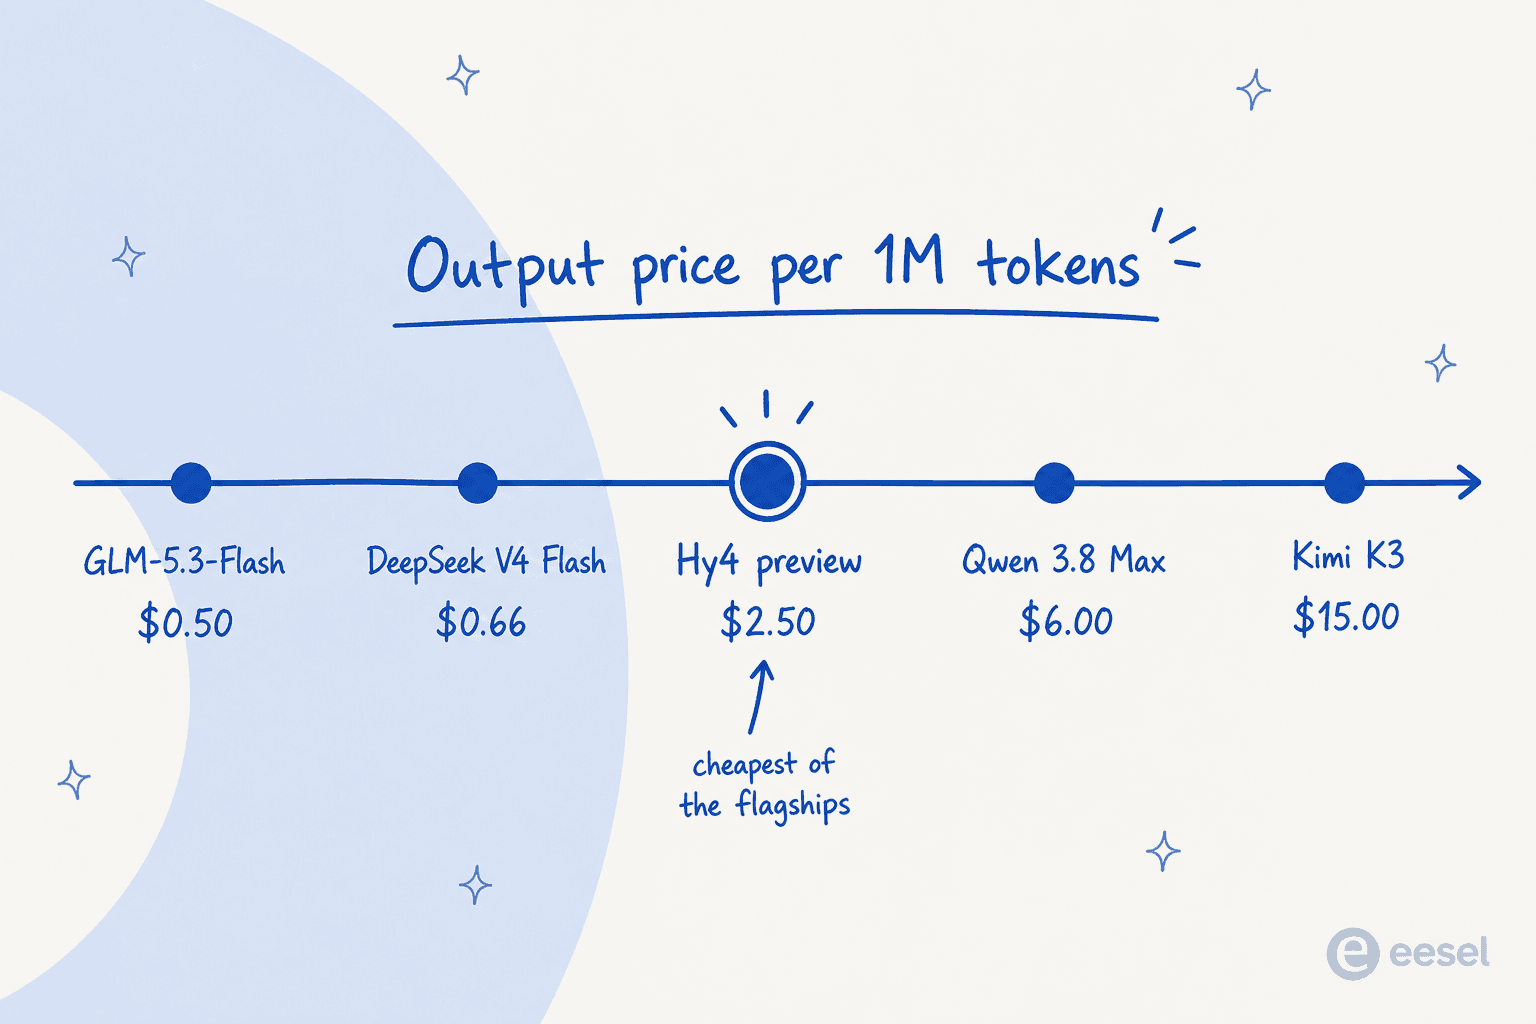
現在のオープンウェイト勢と比べた全体像は次のとおりです(いずれも100万トークンあたり、2026年8月30日時点で確認)。
| モデル | 入力 | 出力 | キャッシュヒット入力 | 重み |
|---|---|---|---|---|
| Hy4 preview(Tencent) | $0.834 | $2.501 | $0.042 | Apache 2.0 |
| GLM-5.3-Flash(Z.AI) | $0.15 | $0.50 | $0.03 | オープン |
| DeepSeek V4 Flash | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 | MIT |
| GLM-5.3(Z.AI) | $1.40 | $4.40 | $0.26 | オープン |
| Qwen 3.8 Max | $2.00 | $6.00 | $0.25 | カスタム |
| Kimi K3(Moonshot) | $3.00 | $15.00 | $0.30 | オープン |
つまりHy4は、GLM-5.3、Qwen 3.8 Max、Kimi K3(出力料金はHy4のほぼ6倍)を余裕で下回ります。ただし価格の底ではありません。DeepSeek V4 FlashとGLM-5.3-Flashはどちらもはるかに安く、DeepSeekのオフピーク料金ならHy4のごく一部のコストで済みます。すでにHunyuanを使っている人には、落とし穴もあります。
But the new HY4 pricing is roughly 5-6x higher than HY3, so you're looking at about a 400-500% increase in input/output cost.
料金表で唯一の本当のお買い得は、100万トークンあたり0.042ドルのコンテキストキャッシュで、あるユーザーはGLM-5.3よりずっと低いと指摘しています。大きな固定コンテキスト(コードベースや長い文書)を何度も読み直すワークロードなら、このキャッシュ料金がHy4の面白いところです。近い価格帯のモデルのコスト内訳は、DeepSeek V4 Flashの料金ガイドとKimi K3の料金ガイドも参考になります。
今日Hy4を使うには
8GPUノードを用意しないなら、実際に使える入口は次のとおりです。
- API: モデルIDは
hy4-previewで、Tencent Cloud TokenHubとOpenRouterで提供されています。OpenAI形式とAnthropic形式の両方のAPIに対応し、OpenRouterではゼロリテンション(データ非保持)ポリシーで提供されます。学習への利用に関する規約が曖昧な中国系の自社APIもあるなか、これは嬉しい強みです。 - 2週間無料: Hy4は公開時からWorkBuddyとCodeBuddyで無料で、両方でのHy3の無料利用も9月30日まで延長されました。TencentのYuanbaoやimaアプリ内でも使えます。
- オープンウェイト: Hugging Face、GitHub、ModelScope、GitCodeで公開されており、BF16版とFP8版があります。
公開時に出回った件を整理しておきます。サードパーティのコーディングCLIはOpenRouter経由でHy4をすぐに取り込みましたが、それらはTencent公式の無料チャネルではありません。公式の無料提供はWorkBuddyとCodeBuddyだけです。
自己改善という切り口
公開時の発表で最も未来的な主張は、見落としやすいものです。Tencentによると、Hy4は自身の開発に貢献し、「automated optimization of training methods, data strategies, evaluation frameworks, and low-level operators」に参加しました。同社はこれを「early-stage recursive self-improvement loop」と呼んでいます。確認できる具体的な内容は、Hy4が自身の推論スタックのボトルネックを分析し、その結果の最適化でエンドツーエンドのスループットが31.8%向上した、というものです。
壮大な「自己改善」という枠組みは割り引いて受け取るべきでしょう(演算子の融合を提案するモデルは、自分自身を再設計するモデルからはほど遠い)。ただ、31.8%というスループットの数字は具体的で本物で、時間が経っても評価されやすいタイプのエンジニアリングの成果です。また、最終的な正式版はこのpreviewよりずっと強力になるだろうという、コミュニティで繰り返される期待も後押ししています。
And this is a PREVIEW? The actual release must actually be fable level or higher then?
では、誰がHy4を使うべきか
ここまで見てきた上での率直な結論です。Hy4は、Kimi K3やQwen 3.8 Maxに対して実質的な価格優位を持ち、コーディングと科学のベンチマークも強く、寛容なApache 2.0ライセンスを備えた、本格的なオープンウェイトのフラッグシップです。自分で管理できるインフラ上でAIエージェントを構築し、本当にオープンなライセンスが欲しく、APIの予算かハードウェアがあるなら、特にロングコンテキストでキャッシュを多用するコーディング作業では、有力な選択肢です。
ただし、2つのことは冷静に見てください。最安の選択肢ではなく(そこはDeepSeekとFlash系モデルが勝ちます)、独走するリーダーでもありません(中国勢の仲間とは同水準で、クローズドな最前線には及びません)。そして重要なのは、Hy4はインフラだということです。プロンプトに答える素のモデルです。あなたのビジネスを知らず、あなたのツールの中に住んでおらず、自分では仕事をしません。強力なモデルと、実際に仕事をこなすものとのこのギャップこそが、次のセクションの要点です。
eeselを試す
大事な違いはこれです。Hy4はモデルで、eeselはあなたが採用するチームメイトです。Hy4のようなベースモデルは素の知性を提供しますが、それを配線し、プロンプトを書き、データにつなぎ、見守るのはあなたです。eeselはAIチームメイトのプラットフォームで、特定の仕事向けにすぐに働けるチームメイトを採用できます。それぞれが、その役割に必要なスキル、連携、会社のコンテキストを備えて着任します。
現在のラインナップは、既存のサポートキューに加わり、注文を調べ、チケットにタグを付け、すでにお使いのヘルプデスク内で返信を下書きまたは送信するAIヘルプデスクチームメイトと、リサーチ、執筆、SEOを一度にこなすAIブログライターです。どちらも過去のチケット、ヘルプセンター、ドキュメントで学習し、MLチームがなくても数分で稼働します。モデルではプロンプト入力欄が残されるところを、チームメイトは仕事をすでに理解した状態で現れます。
素のモデルにはできないことがもう1つあります。eeselのチームメイトを本番に出す前に、過去のチケットでシミュレーションできるため、スイッチを入れて祈るのではなく、実際にどう動くかを事前に把握できます。無料で試せて、クレジットカードも営業電話も不要です。推論クラスタを運用することではなく、実際の仕事を終わらせることが目的なら、eeselから始めてみてください。