2026年版 Tencent Hy4のおすすめ代替モデル8選

Rama Adi

Katelin Teen
最終更新 August 30, 2026
要点
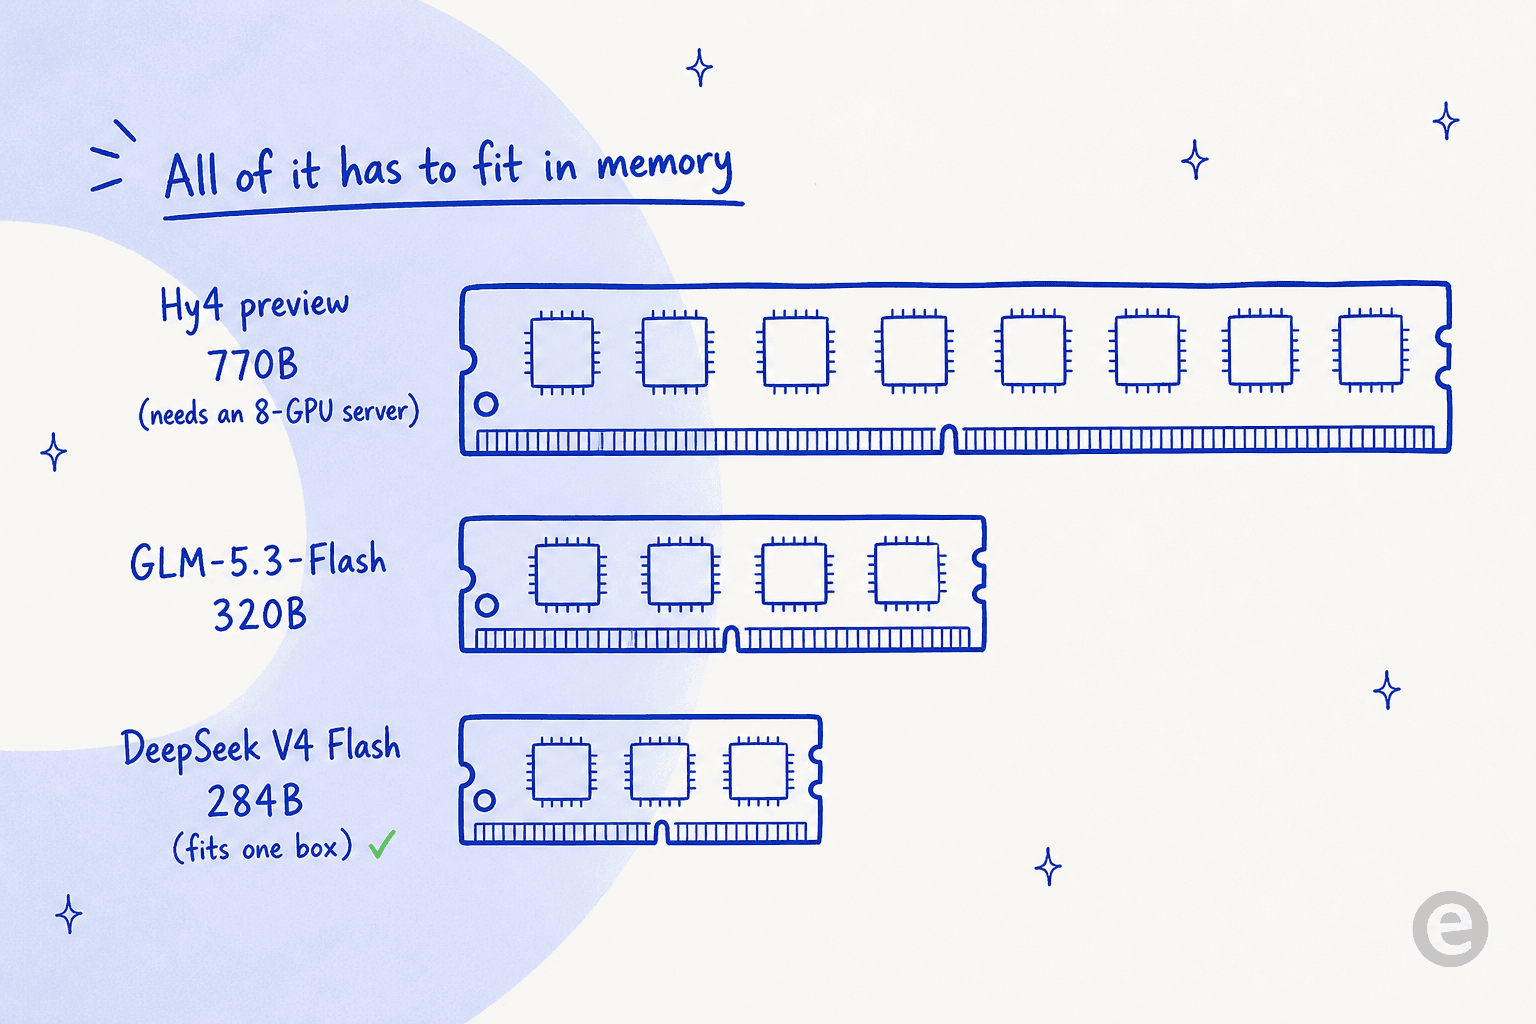
Tencent Hy4 previewは本当に強力なオープンウェイトモデルです。770Bのエキスパート混合(MoE)で、ほかの中国のフラッグシップよりも価格を抑え、WebDevコーディングアリーナではオープンモデルの上位に入ります。問題は、おそらく自前では動かせないことです。MoEモデルなので1トークンあたり49Bパラメータしか動きませんが、770B全体を同時にGPUメモリに載せておく必要があり、8基GPUのサーバーが要ります。さらにHy3より約5〜6倍高価で、まだプレビューです。
つまり本当の問いは「Hy4は良いか」(良いです)ではなく、「手持ちのハードウェアと予算でHy4級の結果を出せるモデルはどれか」です。私のおすすめは次のとおりです。
- GLM-5.3-Flash - 総合的に最良の代替。320B、ネイティブマルチモーダルで安価。
- DeepSeek V4 Flash - 価格の下限。MITライセンスで、セルフホストできる小ささ。
- GLM-5.3 - Hy4の品質に最も近い(Tencentが自社ベンチマークで比較しているモデル)。
- Kimi K3 - 長いエージェント型コーディングの実行に最も強い。
- Qwen 3.8 Max、DeepSeek V4 Pro、Claude Opus 5、GPT-5.6 は、マルチモーダル、長いコンテキスト、インフラ不要というニーズを補います。
もう一点。モデルが欲しい理由がカスタマーチケットへの対応なら、自分で組み立てる必要はありません。eeselは、すでにフロンティアモデル上で動くAIヘルプデスクチームメイトで、既存のツールに接続し、本番前に過去のチケットでテストできます。
なぜHy4の先を探す人がいるのか
まずHy4には公平であるべきです。それだけの価値があります。TencentのHunyuanチームは本物のフロンティア級オープンウェイトモデルを出しました。総パラメータ770B、アクティブ49B、100万トークンのコンテキストウィンドウ、Hugging Faceで公開されたオープンウェイト、そしてGLM-5.3、Qwen 3.8 Max、Kimi K3より安い価格です。Code Arena WebDevリーダーボードでは約5位、オープンモデルの中では約3位で、Hy3から+115ポイントの跳躍でした。ハードウェアがあるなら強い選択肢です。
ここからが複雑で、私が毎週これらのモデルで開発していて直面する部分です。MoEモデルが節約するのはトークンあたりの計算であって、メモリではありません。ルーターは各トークンについて770Bのうち49Bしか動かさないので高速ですが、770B全体はロードされて常駐している必要があります。実際にはMXFP8ビルドで約924GBの重みとなり、B300クラスの8基GPUノードに相当します。H100を8枚(640GB)積んだマシンでは収まりません。r/LocalLLaMAのコミュニティも同じ結論でした。素晴らしいモデルだが、自宅では動かせない、と。
2つ目の問題はコストです。Hy4はフラッグシップのライバルより安いものの、置き換え対象のモデルからは大幅な値上げなので、既存のHy3ユーザーは、Kimiと比べて安く見えても実際の請求額の増加に直面します。3つ目は成熟度です。プレビュー段階であり、Tencent自身も、このモデルが考えすぎたり確認しすぎたりする傾向があると述べています。
これらはHy4が悪いモデルだという意味ではありません。実際に展開できる人が限られているモデルだということです。それ以外の人にとっては、以下の代替モデルが、手の届くハードウェアでかなりのところまで連れて行ってくれます。
Hy4はこれらの代替モデルと実際にどう比べられるか
おすすめに入る前に、直接比較を見ておく価値があります。これはTencent自身がローンチ時に出したベンチマーク表で、有用なのは、そこに載っているライバルがまさにこの記事で取り上げるモデルだということです。Qwen 3.8 Max、DeepSeek V4 Pro、GPT-5.6 Sol、GLM-5.3、Kimi K3、Claude Opus 5です。
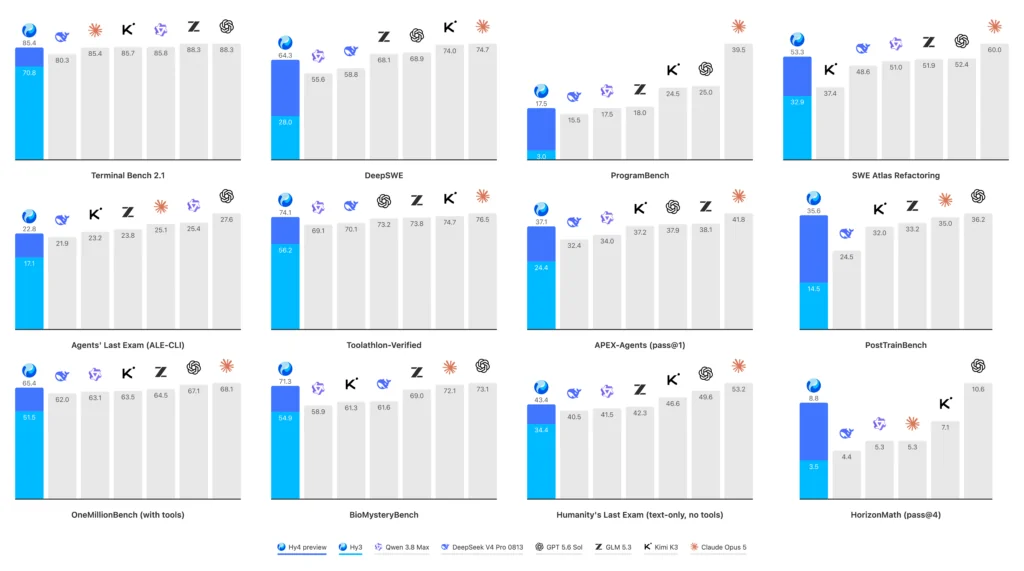
正直な注意点が2つあります。第一に、これはベンダー自身の表なので、結論ではなく出発点として読んでください。第二に、Hy4はまだ独立したArtificial Analysisインデックスに載っておらず、引用できる中立的な知能スコアがありません。Tencent自身の社内ブラインド評価ではHy4が2.99/4.00で、Kimi K3(2.94)、GLM-5.3(2.92)と接戦でした。コーディングCLIコミュニティはこれをほぼ三つ巴の引き分けと読み、Hy4の本当の強みは価格だとしています。
選定基準
私はeeselで連携やモデル周りの基盤を作っているので、本番でどのモデルを動かすかを選ぶことは毎週の大きな仕事です。リーダーボードの数字は簡単な部分です。実際に決め手になるのは、重みが収まるか、1か月分の実トークンはいくらか、出荷できるライセンスか、そして一度の巧みな回答ではなく長いエージェント実行に耐えられるか、という問いです。そこで次の観点で重み付けしました。
- 展開しやすさ - ハイパースケーラーだけでなく、普通のチームが現実的に動かせる、または支払えるか。
- 100万トークンあたりの価格 - ベンダー自身の料金表から。プロモやピーク/オフピークの癖も明記。
- ライセンスとオープンウェイト - セルフホストできるか、何が許されるか。
- 実際の能力 - 見出しのスコアだけでなく、コーディングとエージェントの強さ。
以下の価格と仕様はすべてベンダー自身のページから取得し、2026年8月30日に確認したものです。数値が独立したものではなくベンダー内部のベンチマークの場合は、その旨を記しています。
代替モデルの一覧
| モデル | 向いている用途 | 総 / アクティブパラメータ | コンテキスト | 入力 $/1M | 出力 $/1M | オープンウェイト | ライセンス |
|---|---|---|---|---|---|---|---|
| GLM-5.3-Flash | 総合的に最良 | 320B / 18B | 1M | $0.075* | $0.25* | あり | オープン(HF) |
| DeepSeek V4 Flash | 最安 | 284B / 13B | 1M | $0.22-0.44 | $0.66-1.32 | あり | MIT |
| GLM-5.3 | Hy4に最も近い | 非公開 | 1M | $1.40 | $4.40 | あり | オープン(HF) |
| Kimi K3 | エージェント型コーディング | 2.8T / 104B | 1M | $3.00 | $15.00 | あり | "other" |
| Qwen 3.8 Max | マルチモーダル + エコシステム | 2.4T / 95B | 1M | $2.00 | $6.00 | あり(ベース) | qwen3.8-max |
| DeepSeek V4 Pro | 長いコンテキストでの想起 | 49Bクラスがアクティブ | 1M | $0.66-1.32 | $1.98-3.96 | あり | オープン |
| Claude Opus 5 | インフラ不要 | 非公開 | 1M | $5.00 | $25.00 | なし | プロプライエタリ |
| GPT-5.6 | マネージドAPIの段階料金 | 非公開 | 長コンテキスト階層 | $0.20-5.00 | $1.20-30.00 | なし | プロプライエタリ |
*GLM-5.3-Flashは50%のローンチプロモ(定価$0.15 / $0.50)中で、2026年9月9日に終了します。DeepSeekはオフピークからピークまでを表示しています。米国/EUのスケジュールなら、ほとんどが低いオフピーク料金で請求されます。料金はすべて各ベンダーの料金ページに基づき、2026年8月30日に確認しました。
並べてみるとパターンが際立ちます。2つの「Flash」モデルはフロンティア級より桁違いに安く、クローズドAPI(Opus 5、GPT-5.6)は価格は最上位ですが、その代わりに何も要求しません。同じ構図を出力価格で見ると次のとおりです。おしゃべりなエージェントでは、これが実際に痛い請求になることが多いです。
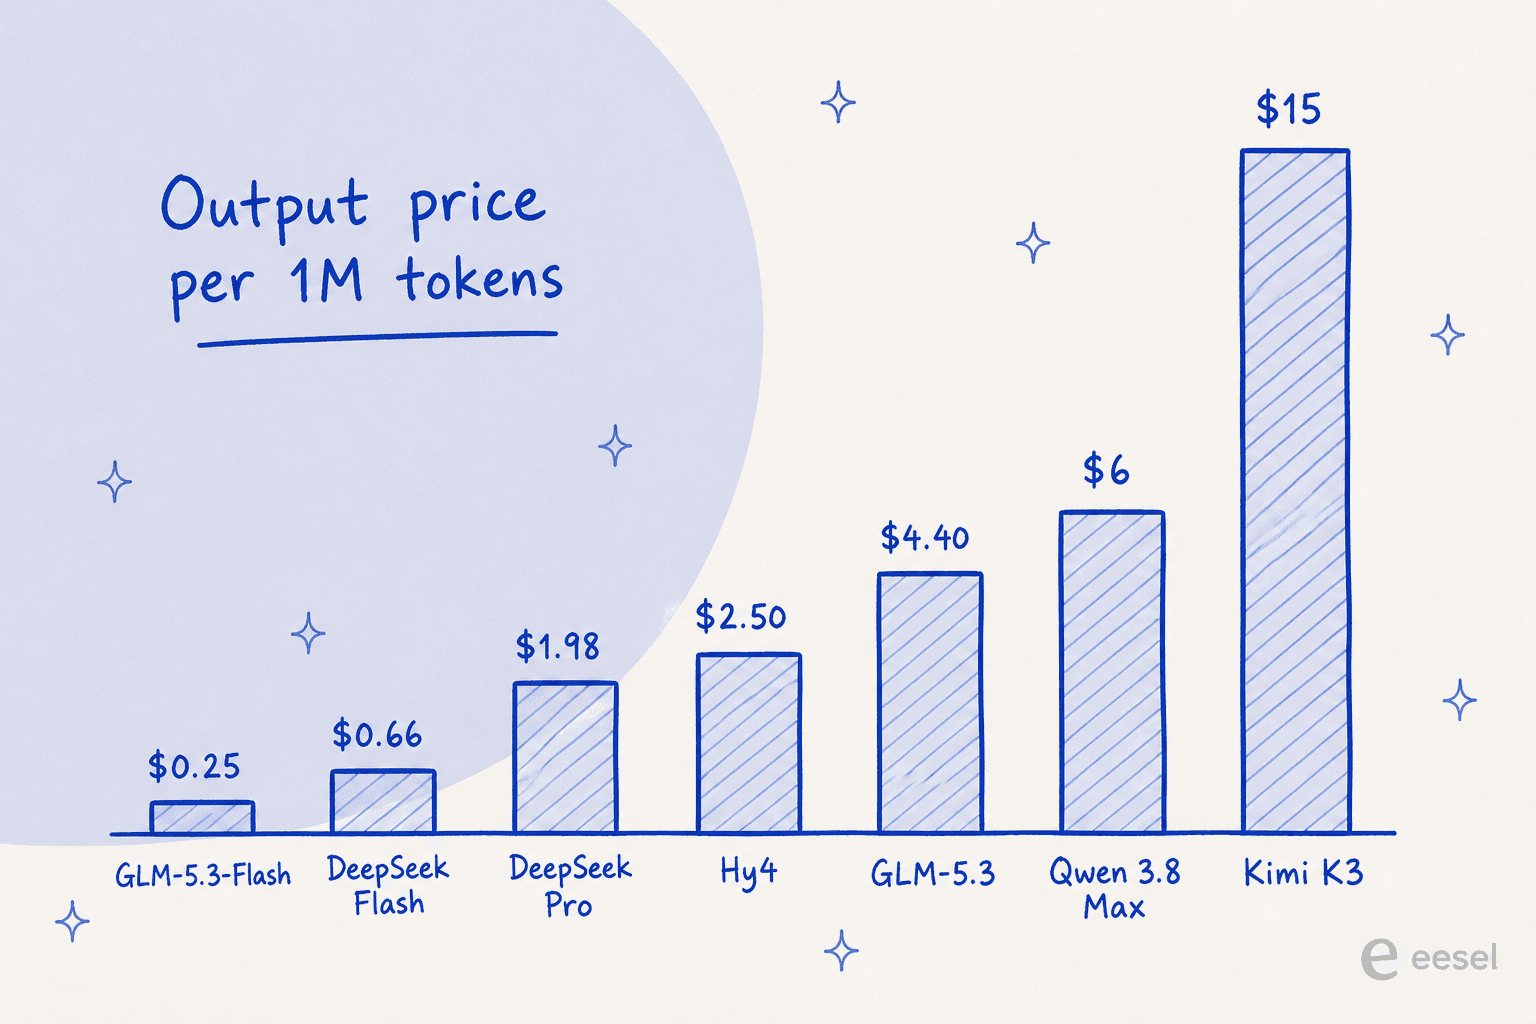
地図上のどこに自分がいるか分からなければ、この簡単なツールで選択肢までご案内します。
1. GLM-5.3-Flash
向いている用途: 実際に動かせるハードウェアでHy4級の品質を、現実的に最も低い価格で求めるチーム。
私が最初に手に取るのはこれです。Z.ai(旧Zhipu AI)のGLM-5.3-Flashは、アクティブ18Bのみの320B MoEモデルで、GLM-5ラインで初のネイティブマルチモーダルモデルとして、テキスト、画像、動画を扱います。Z.aiのうたい文句は「フロンティアの知能、フラッシュのコスト」で、数字は後半を裏付けています。Artificial Analysisの知能インデックスで57を記録し、割引時でタスクあたり約$0.045と、以前は約10倍かかった水準です。
多くの人にとってHy4に勝る理由は単純です。総パラメータ320BはHy4の半分以下の規模なので、提供ははるかに容易です。また「ox-alpha」という名前でOpenRouterでひっそりテストされ、その週に最も使われたモデルになり、すべて中国製チップで提供されました。Z.ai自身のCode BenchではClaude Opus 4.8の29.5に対して29.0で、ほぼ互角です。
長所: ネイティブマルチモーダル(テキスト、画像、動画)、Hugging Faceのオープンウェイト、そしてこのリストで間違いなく最良の価格対能力比。
短所: ベンチマークの比較はZ.ai自身のもので、見出しの価格はローンチプロモです。Z.aiは一部のライバルほどきれいにパラメータ数やコンテキストの完全な仕様表を公開していません。
料金: 50%ローンチプロモ中は100万トークンあたり入力$0.075 / 出力$0.25(定価$0.15 / $0.50)で、プロモは2026年9月9日に終了します。キャッシュ入力は$0.015です。月$18からのGLM Coding Planにも含まれています。
結論: Hy4の代替を1つだけ試すなら、これにしてください。より安く、かつより小さく、かつマルチモーダルという珍しいモデルで、Hy4は気に入ったが8基GPUのサーバーを正当化できなかったチームに私が勧める選択です。
2. DeepSeek V4 Flash
向いている用途: トークンあたりのコストを徹底的に下げたい場合と、グループの中で最もセルフホストに優しいライセンス。
DeepSeek V4 Flashは価格の下限で、その差は大きいです。アクティブ13Bの284B MoEモデルで、本物のMITライセンスで公開されています。重みは約167GBで、このリストの中で、設備の整ったチームなら1万ドル未満で自宅で動かせる唯一のフロンティア級モデルです。オフピークでは100万トークンあたり入力約$0.22 / 出力約$0.66で、Hy4の出力単価の約4分の1です。
知っておくべき癖があります。DeepSeekの料金表は時間帯で分かれており、ピーク時間は中国の営業時間(UTC 01:00-04:00と06:00-10:00)に沿っています。米国やEUのサポートキューは主にDeepSeekのオフピーク時間帯に動くので、デフォルトで料金表の安い側を払うことになります。唯一の正直な欠点は冗長さです。独立したテストでは、答えに至るまでに競合よりかなり多くの出力トークンを消費することが分かっており、タスクあたりで見ると、トークン単価の節約は少し縮みます。
長所: 大差で最安、MITライセンス、セルフホストできる小ささ。
短所: 冗長(同等モデルより出力トークンが多い)。またDeepSeekの有料APIの規約は、学習への利用について明示的に安全とは言わず触れていません。データの所在地は中国本土です。自社の顧客データを公式APIに流すなら重要な点です。
料金: キャッシュミス時の入力はオフピーク$0.22 / ピーク$0.44、出力は$0.66 / $1.32、キャッシュヒット時の入力は$0.007から(DeepSeekの料金ページによる)。
結論: 決め手が請求額なら、これがあなたのモデルです。冗長さを予算に織り込み、規約をよく読むまでは顧客の個人情報を公式エンドポイントに流さないでください。
3. GLM-5.3
向いている用途: Hy4の実際の品質に最も近いもの。Tencentが自社の比較対象に選んだモデルです。
TencentがHy4はフロンティア級だと示そうとしたとき、並べた2つのモデルのうちの1つがGLM-5.3でした。Tencent自身のブラインド評価では、Hy4が2.99、GLM-5.3が2.92と僅差でした。言い換えれば、Hy4の実世界の品質に最も近いモデルが欲しいなら、これが明らかな候補です。しかも長期の複雑なコーディングで確かな実績のある系譜の製品です(前身のGLM-5.2は、Terminal-Benchで80%を超えた初のオープンウェイトモデルでした)。
入力側ではHy4より安く、出力側では同じ水準なので、ほぼ同等のモデルに割増料金を払うことはありません。Z.aiはGLM-5.3の正確なパラメータ数を一部のライバルほど明確に公開していないため、集計サイトを引用せず、その数字は載せません。
長所: Hy4に最も近いベンチマーク上のライバル、オープンウェイト、長期のコーディングでの強い実績、1Mコンテキスト、OpenAIおよびAnthropic互換のエンドポイントで既存のツールにそのまま組み込める。
短所: 5.3単体についてのZ.aiの公開仕様は総/アクティブパラメータの情報が乏しく、Hy4同様、セルフホストには大きなモデルです。
料金: 100万トークンあたり入力$1.40 / 出力$4.40、キャッシュ入力$0.26(Z.aiの料金ドキュメントによる)。GLM Coding Planでも利用できます。
結論: 目標が「プレビューの懸念なしに、実際に展開できるHy4が欲しい」なら、GLM-5.3が最も安全な乗り換え先です。同等性の高い代替です。
4. Kimi K3
向いている用途: 価格より深さが重要な、長くツールを多用するエージェント型コーディングの実行。
Moonshot AIのKimi K3はここで最大のモデルです。総2.8T、アクティブ104B、1Mトークンのコンテキストで、オープンウェイトは予定どおり公開されました。Artificial Analysisの知能インデックスでは57で、ローンチ時は4位前後でした。Tencent自身の対戦形式の数字では、Hy4が最も決定的に勝てていないモデルです(Hy4の勝率は51.2%にとどまる)。長いエージェントセッションでは本当に優れています。
知っておくべきことは、Kimi K3は高価で、使い方を縛るという点です。推論はどのレベルでもオフにできず、努力レベルを下げても安くなりません(どのレベルも同じ単価で課金されます)。100万トークンあたり入力$3 / 出力$15はClaude Sonnetの領域で、キャッシュミス時のHy4の出力単価の約23倍です。難しい複数ステップの作業なら見合いますが、単純な呼び出しには過剰です。
長所: フロンティア級のエージェントとコーディング能力、ネイティブな画像認識、巨大な1Mコンテキスト、Hugging Faceのオープンウェイト。
短所: この比較で最も高価、推論をオフにする方法がなく、公開された画像URLは受け付けません(base64またはファイルIDのみ)。
料金: 100万トークンあたり入力$3.00 / キャッシュヒット$0.30 / 出力$15.00(Moonshotによる)。コンシューマー向けアプリのプランは無料から月$199まであります。
結論: タスクが本当に難しく長いエージェント実行で、品質がすべてのときにKimi K3を選びましょう。日常的な作業なら、上記のより安いモデルが10分の1の請求額で同じ仕事をします。
5. Qwen 3.8 Max
向いている用途: マルチモーダルの作業と、中国のラボの中で最も深いエコシステム。
AlibabaのQwen 3.8 Maxは2.4T / 95BのMoEモデルで、8月上旬に一般提供が始まり、1Mコンテキストとネイティブな画像・動画入力を備えます。Artificial Analysisのボードでは6位(インデックス約58)で、LMArenaのWebDevとビジョンのボードでも強いです。ほかと一線を画すのはエコシステムです。Qwenは世界最大級のオープンモデルファミリーを持ち、ほぼどんな予算にも小型の兄弟モデルがあり、ホスト版のMaxはオープンなベースの上にビジョン、非思考モード、組み込みツールを追加しています。
私がいつも添える公平性の注記です。完全オープンなベースの重み(Qwen3.8-2.4T-A95B)は公開されましたが、ビジョン入力と1Mのデフォルトコンテキストが加わるホスト版Maxと機能的に同等ではありません。また、ファミリーの中でApacheライセンスの寛容なモデルは、Max本体ではなく小型のQwen3.8-27Bです。
長所: ネイティブマルチモーダル、巨大で手厚くサポートされたモデルファミリー、実際のツールエコシステム、オープンなベースの重み。
短所: MaxのライセンスはApacheではなく、ホスト版とオープン版で機能が異なり、出力$6はGLMやDeepSeekの選択肢より高価です。
料金: 100万トークンあたり入力$2.00 / 出力$6.00、暗黙的キャッシュ$0.25(QwenCloudによる)。
結論: マルチモーダル入力と幅広いモデルファミリーが重要な場合や、さまざまなモデルサイズにわたって1つのラボで標準化したい場合はQwen 3.8 Maxを選んでください。純粋な価格対能力ではGLM-5.3-Flashが依然として上回ります。
6. DeepSeek V4 Pro
向いている用途: 小型のFlashでは厳しい、長いコンテキストでの想起や「干し草の山の中の針」探し。
DeepSeek V4 Flashが予算重視の選択なら、DeepSeek V4 Proは想起重視の選択です。Flashよりアクティブなパラメータが多く(49Bクラス)、それが重要な場面で表れます。DeepSeek自身のモード横断表では、ProはFlashをSimpleQA-Verified(57.9対34.1)と1Mコンテキストでの針探しの両方で上回っています。LMArenaの人間の好みランキングでも、ProはFlashの上に位置しています。非常に長い文書を読んで正確な事実を引き出す仕事に向いたモデルです。
努力レベルをルーティングする人に伝えておく落とし穴が1つあります。DeepSeekの公開マッピングでは、Proへのlowリクエストがhighで処理されるため、安価なProの実行はなく、満額を支払い、推論を下げることもできません。コスト管理が重要なら、Proの想起が必要でない限りFlashにとどまる理由になります。
長所: Flashより強い想起と長いコンテキストでの検索、オープンウェイト、非中国のスケジュールに有利な同じ時間帯別料金。
短所: 低い努力レベルでの安価なPro実行はできず、キャッシュミス時にFlashの約3倍の単価です。
料金: キャッシュミス時の入力はオフピーク$0.66 / ピーク$1.32、出力は$1.98 / $3.96(DeepSeekの料金ページによる)。
結論: ほとんどのチームはFlashから始め、Flashが明らかに力不足な特定のワークロード(長文書へのQA、正確な想起)でのみProに移るべきです。全面的にProに支払わないでください。
7. Claude Opus 5
向いている用途: 最高水準の品質を求め、運用するインフラを一切持ちたくないチーム。
率直に捉え直すと、多くのチームにとって770Bのオープンウェイトモデルの本当の代替は、別のオープンウェイトモデルではなく、そもそも動かさないことです。Claude Opus 5はAnthropicのフラッグシップで、知能インデックスで1位(スナップショットにより61〜63でわずかな差)にあり、メモリに載せるものは何もありません。APIを呼べば、フロンティア級の答えが返ってきます。
引き換えになるのは価格とオープン性です。100万トークンあたり入力$5 / 出力$25で、オープンウェイトの選択肢より桁違いに高く、セルフホストできる重みもありません。コミュニティからは、Opus 5が同じ努力レベルで前モデルより多くの出力トークンを使う傾向があるとの指摘もあり、定価が同じでもタスクあたりのコストは上がりましたが、反論として、成功したタスクあたりのコストで見るという見方もあります。安い選択ではなく、手間がかからず、リーダーボードの最上位にある選択です。
長所: フロンティア最先端の品質、長いコンテキストの追加料金がない1Mコンテキスト、運用するインフラがゼロ。
短所: オープンモデルよりトークン単価がはるかに高く、重みは非公開で、高い努力レベルでは冗長になりがち。
料金: 100万トークンあたり入力$5 / 出力$25(Opus 4.8から変更なし)、バッチは50%オフ、キャッシュ読み取りは0.1倍(Anthropicによる)。
結論: ボトルネックがトークン予算ではなくエンジニアリング時間なら、Opus 5がすっきりした答えです。お金を払ってGPUのことを二度と考えなくて済むようにします。
8. GPT-5.6
向いている用途: 段階的なラインナップを持つマネージドAPIで、呼び出しごとにコストと能力を調整したい場合。
もう1つのマネージドAPIの答えがGPT-5.6で、強みは幅広さです。OpenAIは単一の価格ではなく、階段を用意しています。安価で大量の処理向けのgpt-5.6-lunaは100万トークンあたり入力$0.20 / 出力$1.20、中間のgpt-5.6-terraは$2 / $12、最上位のgpt-5.6-solは$5 / $30です。すべての呼び出しにフラッグシップ価格を払わず、仕事に合わせてモデルを選べるので、トラフィックが簡単なリクエストと難しいリクエストの混在なら、本当に役立つ手段です。
織り込んでおくべき構造上の落とし穴が1つあります。OpenAIはコンテキストのしきい値を超えると、2倍の形の長コンテキスト階層を課金します。xAIも同じパターンで、AnthropicとGoogleは採用していません。ワークロードが長いコンテキスト中心なら、実効単価は見出しの価格より高くなります。また、GPT-5.6 Solは知能インデックスでOpus 5のすぐ後ろにあり、予算型の代用品ではなく本物のフロンティア選択肢です。
長所: 呼び出しごとのコストを調整できる段階的なラインナップ、成熟したAPIとツールのエコシステム、運用するインフラがゼロ。
短所: 重みは非公開で、長コンテキスト階層により大きなコンテキストの呼び出しでは単価がおよそ2倍になる。
料金: 100万トークンあたり$0.20 / $1.20(luna)から$5 / $30(sol)まで、長コンテキストの乗数あり(OpenAIによる)。
結論: マネージドAPIという発想は好きだが、Opus 5の一律料金は簡単なトラフィックには重いと感じるなら、GPT-5.6の階層のほうが柔軟な選択です。決める前に、長コンテキストの追加料金を試算してください。
2つのファミリーを1枚の図で
一歩引いて見ると、ここにある選択肢はすべて2つの陣営のどちらかに入ります。自分で動かすか安く借りられるオープンウェイトと、何も動かさないマネージドAPIです。この地図は、同僚に10秒で選択を説明するときの私のやり方です。
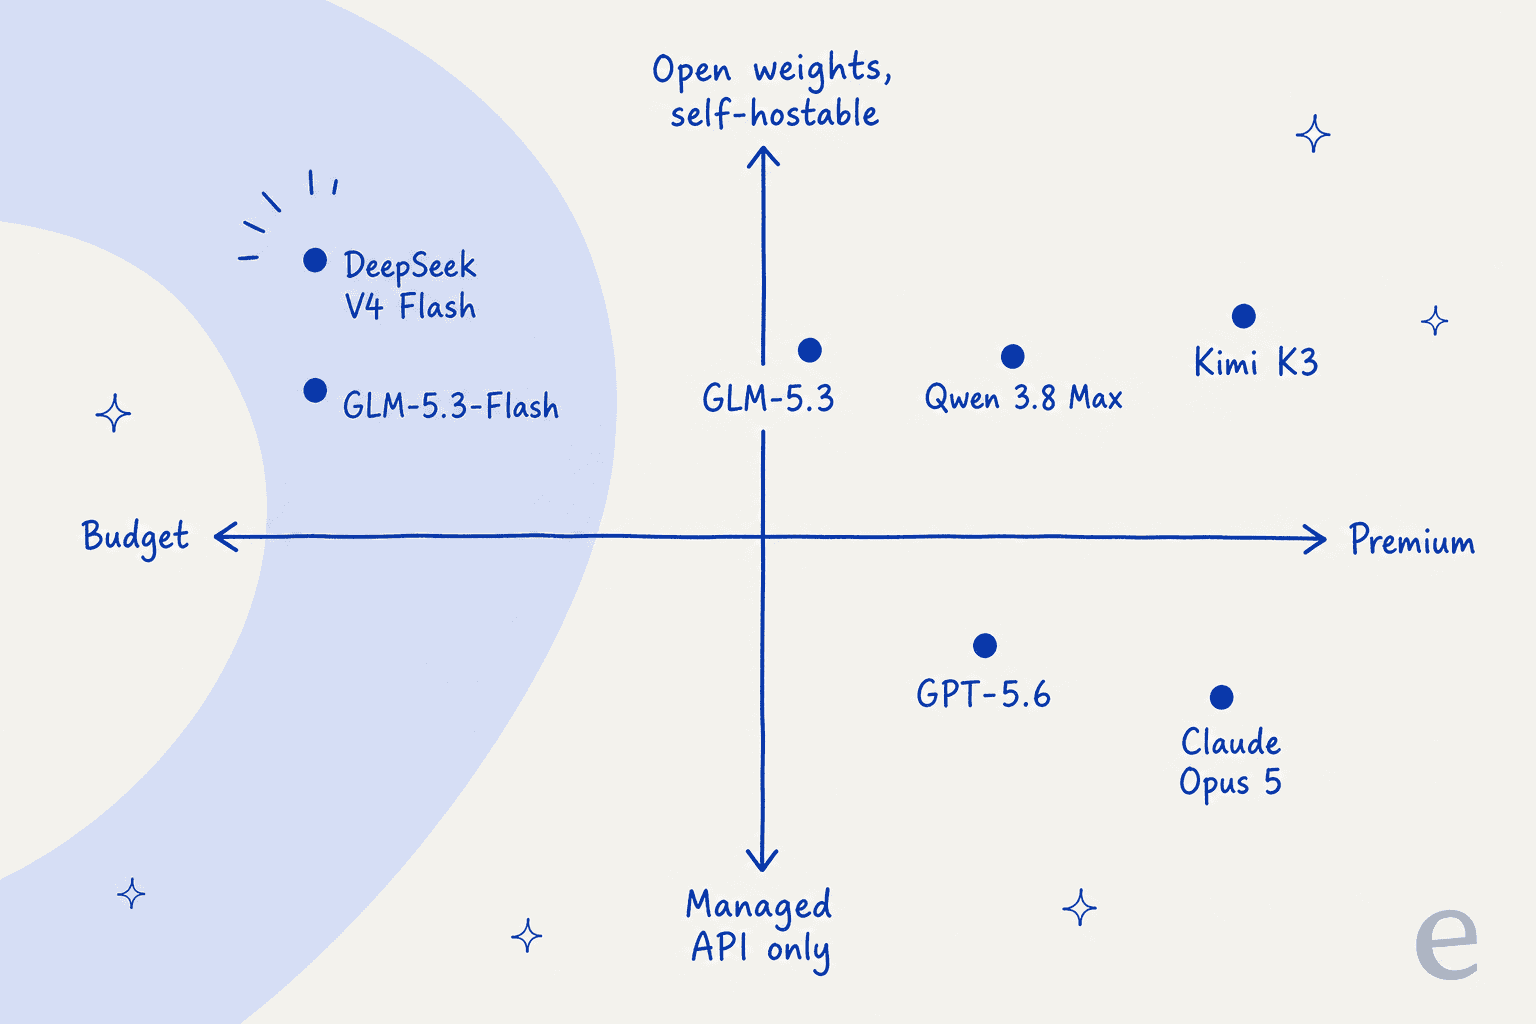
制御権とコストがHy4から離れた理由なら、上段のオープンウェイトの行にとどまり、GLM-5.3-FlashかDeepSeek V4 Flashから始めてください。770Bのモデルを動かす手間そのものが理由なら、マネージドの行に下りて、インフラはAnthropicやOpenAIに任せましょう。
eeselを試す
このリストのどのモデルにも共通するのは、素のインフラだということです。Hy4やその代替を選ぶのはエンジンを選ぶことです。その周りに車を組み立てる作業は残ります。ヘルプセンターへの接続、ガードレール、連携ツール、そして実際の顧客に回答する前のテスト手段です。
モデルを探している理由がカスタマーサポートなら、eeselはその構築を丸ごとスキップできます。すでにフロンティアモデル上で動くAIヘルプデスクチームメイトなので、モデルを選ぶことも、ホストすることも、VRAMに収めることもなく、モデルの品質を受け継げます。ZendeskやFreshdesk、Slackなどのツールに接続し、過去のチケットとヘルプセンターから学習します。そして、自信満々の間違った答えを返すボットを見てきた者として私が最も重視するのは、誰かにライブで回答する前に、実際の過去のチケット数千件でシミュレーションできる点です。

サポートエージェントを作るためにモデルを比較してここにたどり着いたなら、モデルそのものが必要なのか、完成したチームメイトが必要なのかを考える価値があります。eeselを無料で試せ、既存のヘルプデスクに数分で接続できます。