

Tencent Hy4 previewは印象的なオープンウェイトモデルですが、ほとんどの人にとっては自分で動かすものではなく借りて使うものです。総パラメータ770B、トークンあたり49Bがアクティブ、1Mトークンのコンテキストウィンドウを持つMixture-of-Expertsモデルで、2026年8月28日にApache 2.0のオープンウェイトとしてHugging Faceで公開されました。
ベンチマークではオープンモデルの最上位に入ります。GPQA Diamondで92.3、SWE-bench Multilingualで82.9%、Tencent自身のブラインド評価ではKimi K3とGLM-5.3をわずかに上回りました。ただし、自社公開のチャートでは、これらのライバルと勝ち負けを分け合っているため、「最高のオープンモデルと同等」が正直な読み方であり、「すべてに勝つ」ではありません。
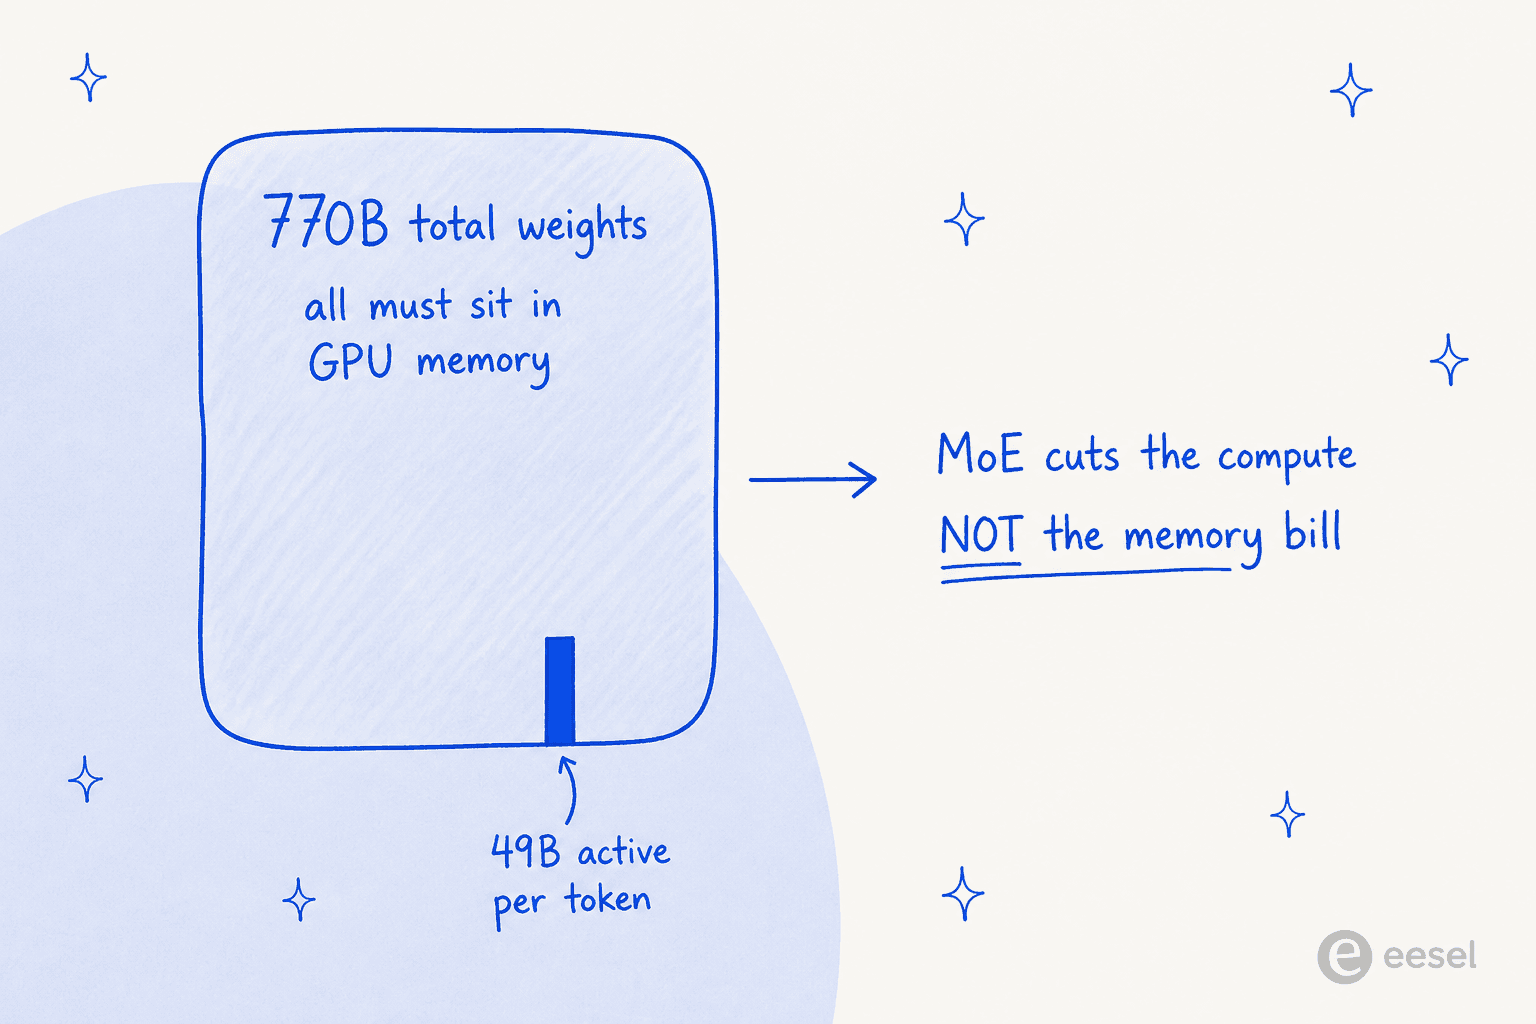
問題は動かすことです。MoEはトークンあたりの計算量を減らしますが、メモリの請求額は減らしません。770Bの重みすべてがGPUメモリに載る必要があるため、フルモデルには16x B200または8x B300が必要です。API経由では100万トークンあたり入力$0.834 / 出力$2.501で、Qwen 3.8 MaxやKimi K3より安いものの、置き換え対象のHy3の5〜6倍高く、DeepSeek V4 Flashはさらに大幅に安いままです。
誰向けか。エージェント型のコーディングやリサーチツールを作っていて、オープンウェイトと寛容なライセンスを求め、ハードウェアを持っている(または借りられる)チームです。サポートチケットへの返信やブログ記事の作成といった成果だけが欲しいなら、自分で770Bモデルを立ち上げるより、完成済みのAIチームメイトのほうが近道です。
Tencentが実際にリリースしたもの
私はこうしたモデルの上で動くAIエージェントを仕事として作っているので、新しいオープンウェイトのフラッグシップは、一週間の中でいちばん楽しみにしている部分です。ここ数年、デモ映えするモデルと本番のキューを生き延びるモデルを分けるものを見てきましたが、Hy4はそのギャップを測るのに良い試験台です。
リリース内容を手短にまとめます。TencentのHunyuanチームは2026年8月28日にHy4 previewをリリースしオープンソース化し、「built for real-world productivity tasks... across coding, office work, and scientific research.」と位置づけています。7月のHy3シリーズの後継で、Tencentは以前と同じ「まずプレビュー、後で正式版」というペースで出しています。
モデルカードから、主な仕様です。
- 総パラメータ770B、トークンあたり49Bがアクティブ(Mixture-of-Expertsの設計)。
- 78層、256のルーティングされたエキスパートに加え1つの共有エキスパート。各トークンは上位8つのルーティングされたエキスパートを起動します。
- 1Mトークンのコンテキストウィンドウ。
- Apache 2.0ライセンス。BF16モデルと公式のFP8量子化版が同時に提供されます。
興味深かった点が一つあります。Tencentによると、Hy4は自身の開発に参加し、学習手法や低レベルのオペレーターに関する実験を提案・実行したほか、自身の推論スタックを自律的に最適化してスループットを31.8%向上させたといいます。Tencentはこれを「an early-stage recursive self-improvement loop.」と呼んでいます。実際の成果にマーケティング的な枠組みをかぶせたものですが、覚えておく価値のある主張です。
770B / 49Bの計算は実際どう働くか
Mixture-of-Expertsが初めてなら、二つの大きな数字は矛盾して見えます。770Bのモデルが、なぜ「49B」分でしかないのか。答えは、MoEがネットワークを多数のエキスパート用サブネットワークに分け、トークンごとにルーターが少数だけを選んで実際に動かすからです。つまりトークンあたりの計算量は約49Bのモデルのように振る舞い、これがHy4を十分な速度で提供できる理由です。
落とし穴は、アクティブな数が小さいからハードウェアも小さくて済むと思い込むことです。そうではありません。ルーターは次のトークンでどのエキスパートでも選び得るため、770Bの重みすべてがGPUメモリに常駐しなければなりません。MoEが安くするのは計算であって、マシンではありません。
内部には、仕様表が示す以上のエンジニアリングがあります。アテンションにはGated DeepSeek Sparse Attentionが使われ、層をまたいでスパースなインデックスを再利用するIndexCacheを備えています。さらに投機的デコーディング用に、ネイティブのマルチトークン予測層が追加されています。DeepSeekやGLMのアーキテクチャ論文を追っていれば、多くが見覚えのあるものでしょう。これ自体が、オープンウェイトの最前線が同じ工夫へいかに速く収束しているかの表れです。
ベンチマークを正直に読む
Hy4はベンチマークで好成績です。Hugging Faceに表示される検証済みスコアでは、GPQA Diamondで92.3、SWE-bench Multilingualで82.9%解決、SWE-bench Proで65.7、Deep SWEで64.3に達します。オープンウェイトモデルとしては強力なコーディングと推論の数字で、コミュニティも注目しました。全ベンチマークのスレッドのあるコメントが、その空気をまとめています。
For a 770B parameters model, it's impressive.

Tencentが前面に出す比較は社内のブラインド評価で、163人の専門家が203のエンジニアリングタスクの出力を評価し、4.00点満点で採点したものです。Hy4は2.99で、Kimi K3(2.94)とGLM-5.3(2.92)を上回りました。実際の結果ではありますが、Tencent自身のテストであり、4点満点で0.05点の差はノックアウトではなくほぼ同点です。
同社の公開チャートはもっと全体像を語っており、要約を鵜呑みにせず実際に見る価値があります。Claude Opus 5やGPT-5.6 Solに対しては、Hy4(濃い青)は通常下回ります。Kimi K3やGLM-5.3に対しては、ベンチマークごとに勝ち負けが入れ替わります。
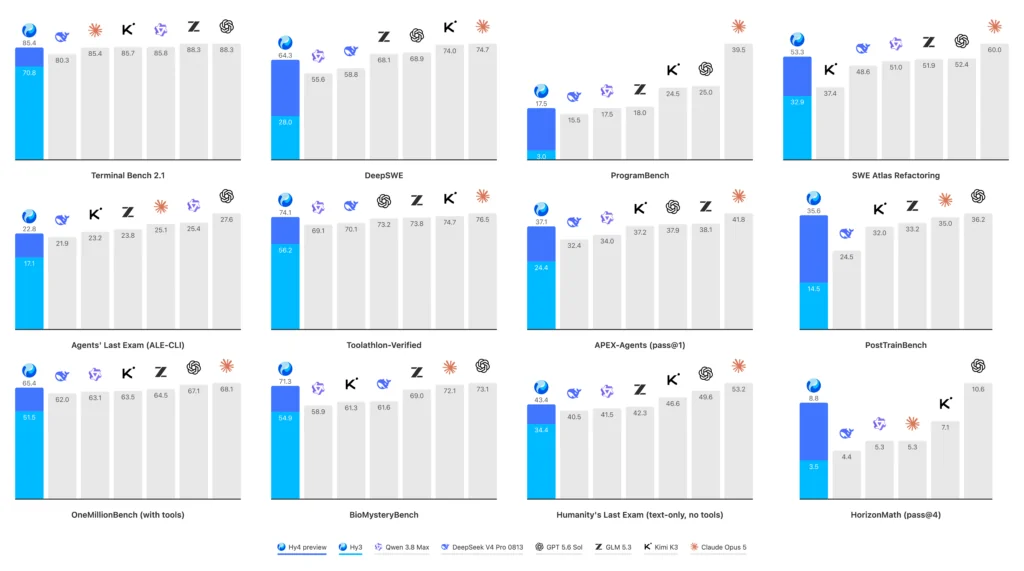
r/LocalLLaMAのスレッドで最も鋭い読者は、マーケティングがしなかった数え直しをしました。
I don't think their own chart backs the beats glm and kimi line. Against kimi k3 it's behind on 7 of the 12 benchmarks... The beats claim comes from the internal blind test where wins only beat losses 47 to 40 against glm.
独立した情報として、公式のArenaアカウントは、Code ArenaのWebDevリーダーボードでHy4が1,633ポイントで約5位、オープンモデルの中ではおよそ3位だと報告しました。ただしこれは初期のAutoEval順位(実際の人間の投票の代わりに報酬モデルが投票するもの)であり、確定した順位ではないと断っています。また、Artificial Analysisのインデックスにはまだ載っておらず、引用できる独立した知能スコアはありません。私の見立てでは、これは強力なトップ層のオープンモデルであり、新しい1位ではありません。「全部に勝つ」という枠組みは割り引いて考えたい部分です。
Tencentが率直に認めていて好感が持てる点がもう一つあります。このプレビューは必要以上に長く推論し、自分の作業を過剰に検証します。Hy3プレビューが、最終版で50〜100%向上したと伝えられる前にそうだったように、意図的に早く出しているのです。
実際に動かせるのか?
ここで「オープンウェイト」というラベルが複雑になります。興奮する前に理解すべき最大のポイントです。オープンウェイトとApache 2.0ライセンスは、Hy4をどこで動かしても許されることを意味します。動かせるかどうかを決めるのはハードウェアです。
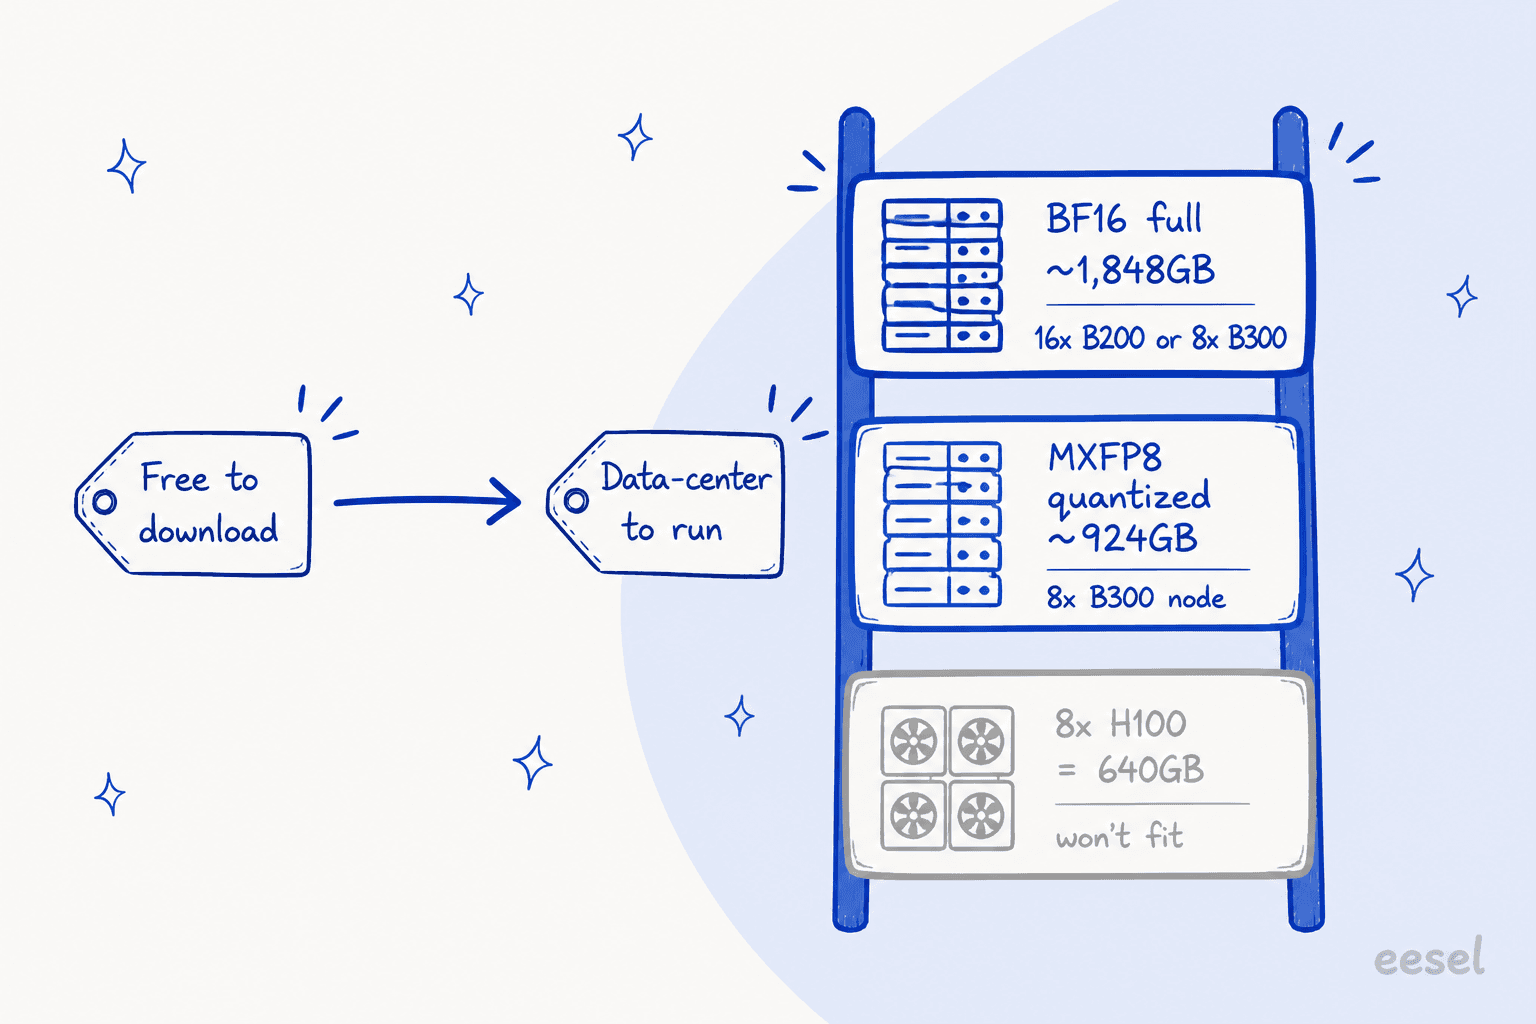
vLLMのレシピははっきりしています。BF16の完全な重みは約1,848GB。MXFP8の量子化された重みでも約924GBです。レシピ自身の下限は「16xB200 or 8xB300 minimum for weights + KV cache.」。8x H100ノード1台(640GB)では収まりません。これはデータセンター向けのモデルで、それ以上でも以下でもありません。
趣味で大型モデルを自宅で動かすr/LocalLLaMAの人たちは、称賛と諦めを半々にして受け止めました。
The amount of people who can drop $5-10k to run these locally is vanishingly small.
彼らが出した実用的な量子化の計算は、試したくなったときに役立ちます。Q4 GGUFは約450GBなので、現実的な最小は512GBで、256GBのマシンには1〜2ビットの量子化しか載りません。ある詳細な内訳の言葉では「if you have 256GB, you'll probably be much better off with GLM-5.3-Flash Q4.」。これが繰り返される結論です。ローカル用途では、小さくてポストトレーニングのしっかりしたモデルが賢い選択で、Z.AIのFlashモデルは手に取るべきものとして挙がり続けています。
つまり現実的には、Hy4を「使う」とはAPIかTencentのアプリを使うことであり、自分のマシンで動かすことではありません。
Tencent Hy4の料金
APIでは、Hy4 previewは入力が100万トークンあたり$0.834、出力が100万あたり$2.501で、キャッシュ入力は$0.042です(公式発表)。比較対象とするフラッグシップ級のオープンモデルの中では、安い選択肢です。
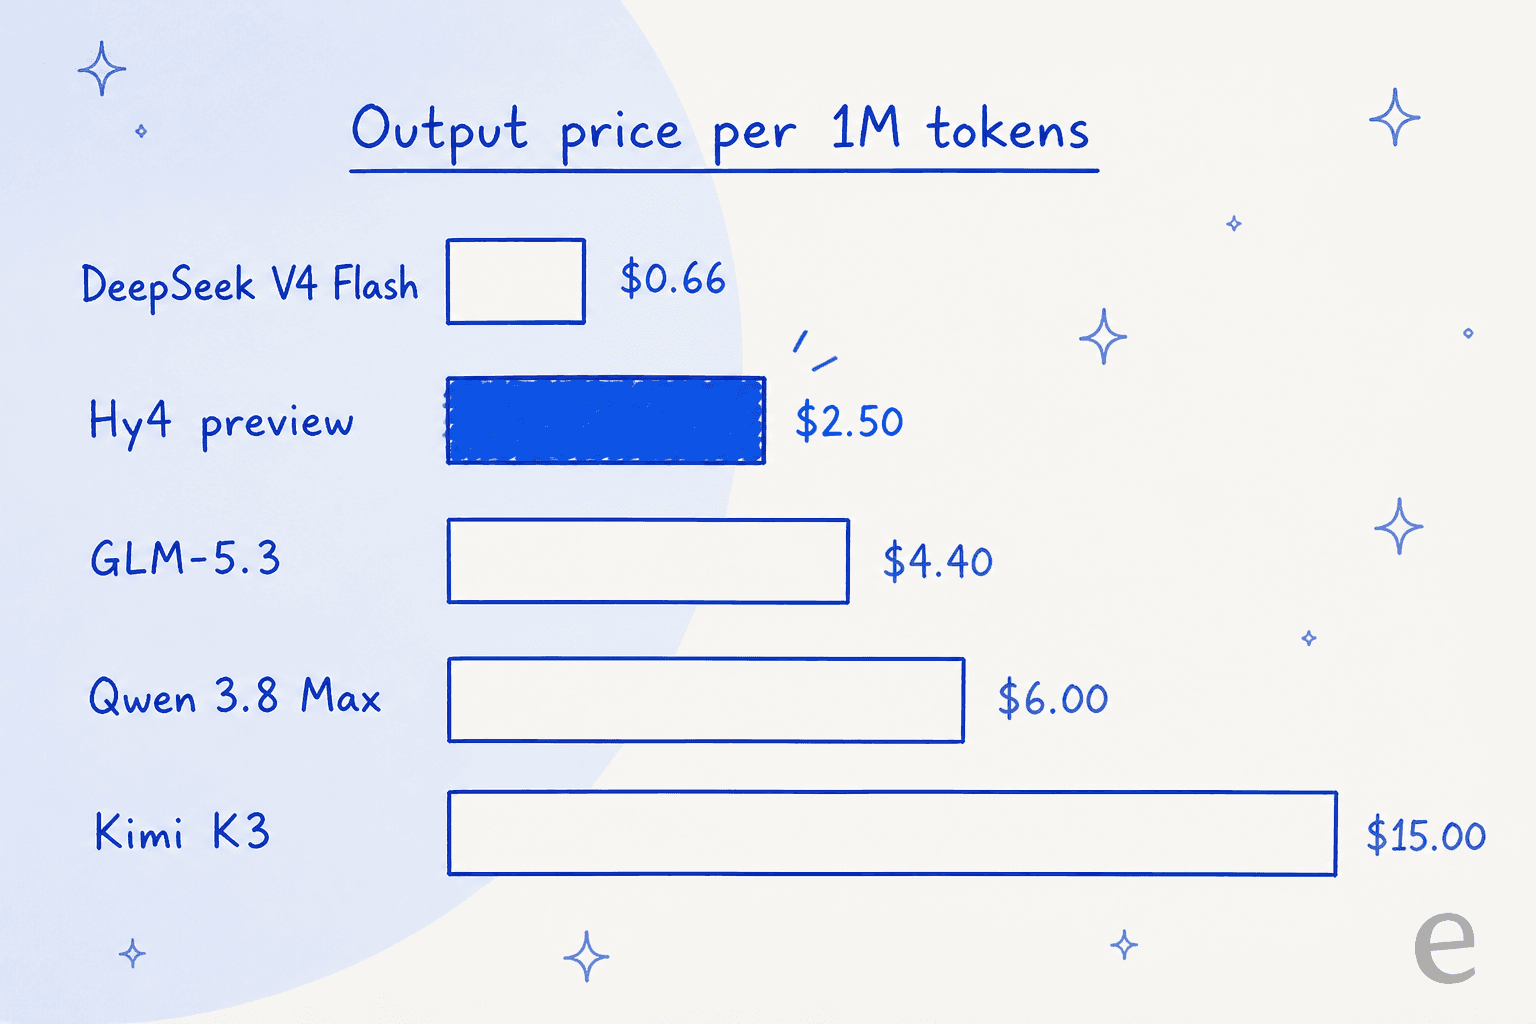
ライバルとの全体像です。すべて100万トークンあたりです。
| モデル | 総 / アクティブパラメータ | コンテキスト | 入力 | 出力 | キャッシュヒット入力 |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | 非公開 | 該当なし | $1.40 | $4.40 | $0.26 |
これに二つの正直な注意点が加わります。第一に、Hy4はHy3の約5〜6倍高いため、すでにHy3を使っている人にとっては値引きではなく、実際のコスト増です。第二に、DeepSeek V4 Flashは両方の料金でなお圧倒的に安く、多くのエージェント作業では「安くて十分」が勝ちます。ある開発者は実際にテストして、率直にこう述べました。
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
お金を払わずに試したいなら、Hy4はWorkBuddyとCodeBuddyで2週間無料で、OpenRouterにも掲載されています(データ保持ゼロのポリシー付きで、一部の中国のファーストパーティAPIより安心できる点です)。
では、Tencent Hy4は実際に誰向けか?
数日使い、コミュニティのテストも踏まえた私の結論はこうです。
Hy4を選ぶべきなのは、エージェント型のコーディング、オフィス自動化、リサーチのツールを作っていて、オープンウェイトと寛容なApache 2.0ライセンスを特に求め、フロンティア規模のモデルを動かすハードウェア(またはAPI予算)がある場合です。コーディングと数学のスコアは本物で、コンテキストウィンドウは巨大、価格は他のフラッグシップ級オープンモデルより安いです。
見送るべきなのは、ワークステーションでローカルにモデルを動かす場合(ポストトレーニングのしっかりしたFlash級モデルのほうが、わずかなメモリでよく役立ちます)、トークンあたりのコストが最大の関心事の場合(DeepSeek V4 Flashははるかに安い)、あるいは仕事が片付けばよくてどのモデルが処理するかは気にしない場合です。
この最後のケースが最もよく見かけるもので、正直に言う価値があります。「Hy4を使うべきか」と尋ねる人の大半は、実はモデルが欲しいわけではありません。サポートキューを空にしたい、ブログを書いてほしい、リサーチを終わらせたいのです。生の770Bモデルは、車のない見事なエンジンです。本番で役立つ前に、検索、ガードレール、連携、評価、フォールバックのロジックを自分で作る必要があります。それが印象的なベンチマークと実際のトラフィックを生き延びるものとの間のギャップであり、私が一日中取り組んでいる部分です。
eeselを試す:チームメイトを迎えて、モデルの配管作業を省く
私の考え方はこうです。Hy4のようなモデルはインフラです。eesel AIは従業員です。モデルを選んで周囲をすべて配線する代わりに、特定の仕事のためにすぐ働けるAIチームメイトを迎えれば、やり方をすでに知った状態で着任します。
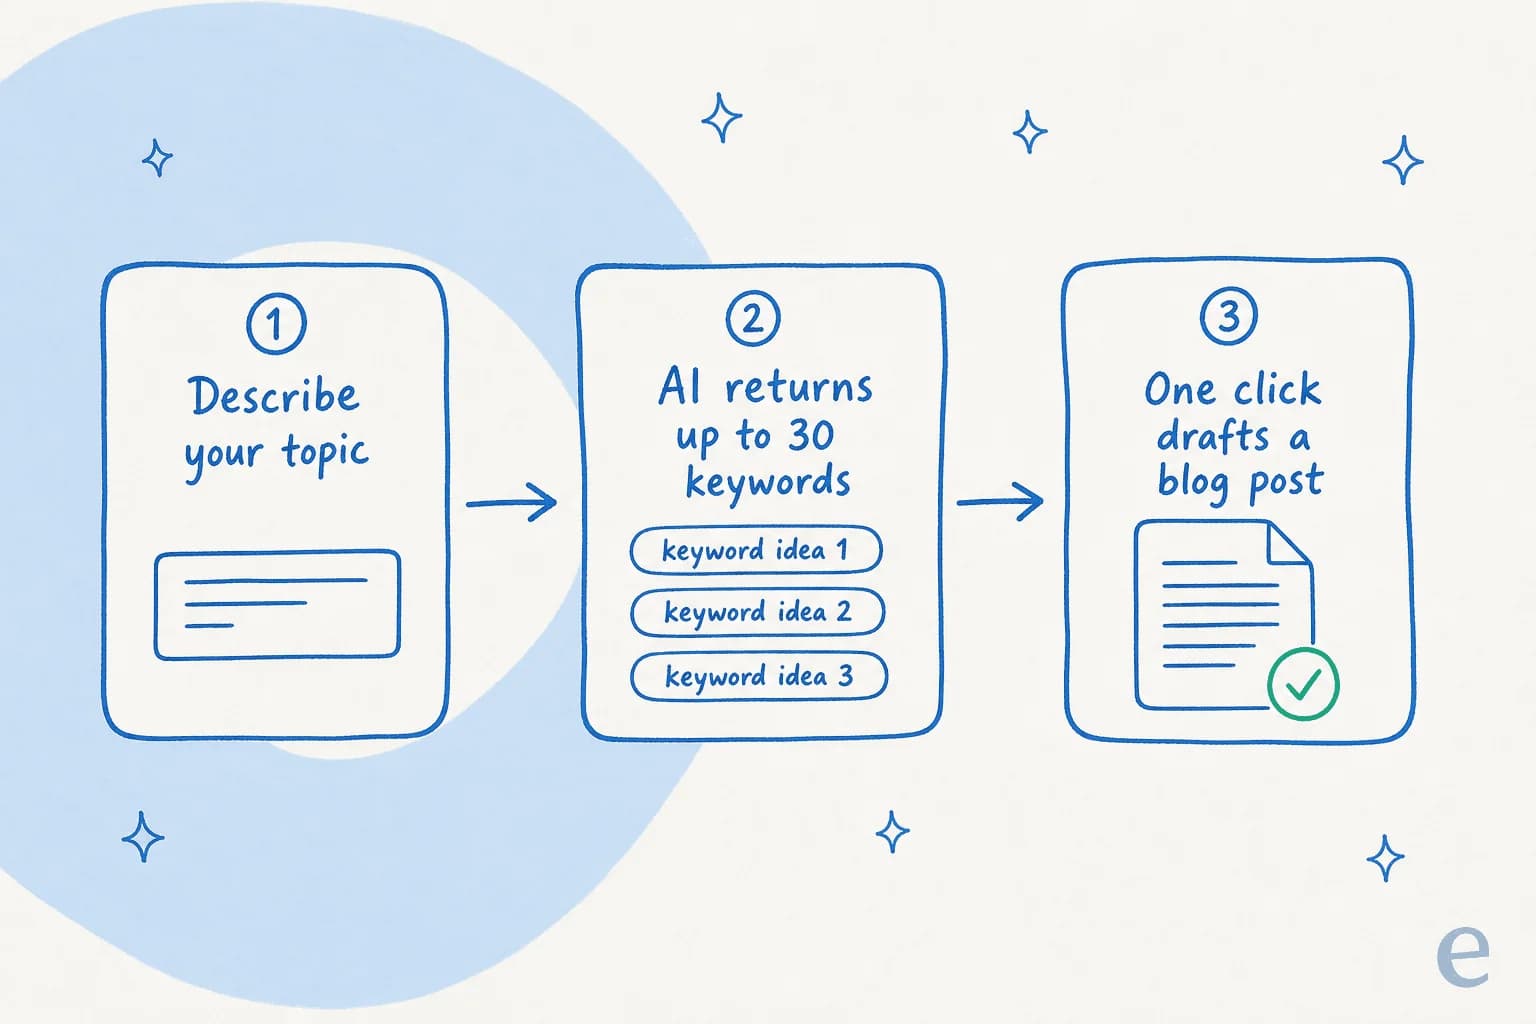
現在のメンバーは2人のチームメイトです。AIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Gorgias、共有受信箱にある既存のキューに加わり、過去のチケットとヘルプセンターで学習して、返信を下書きまたは送信します。何より重要なのは、顧客に回答する前に過去のチケットでシミュレーションできることで、スイッチを入れて祈るのではなく、どう振る舞うかを事前に把握できます。AIブログライターは、長文記事のリサーチ、執筆、SEOを一度の実行で行います。どちらも内部では最先端モデルで動くため、GPUを1枚も用意せずに、Hy4のようなモデルの能力を得られます。クレジットカードも営業電話も不要で、無料で始められます。