

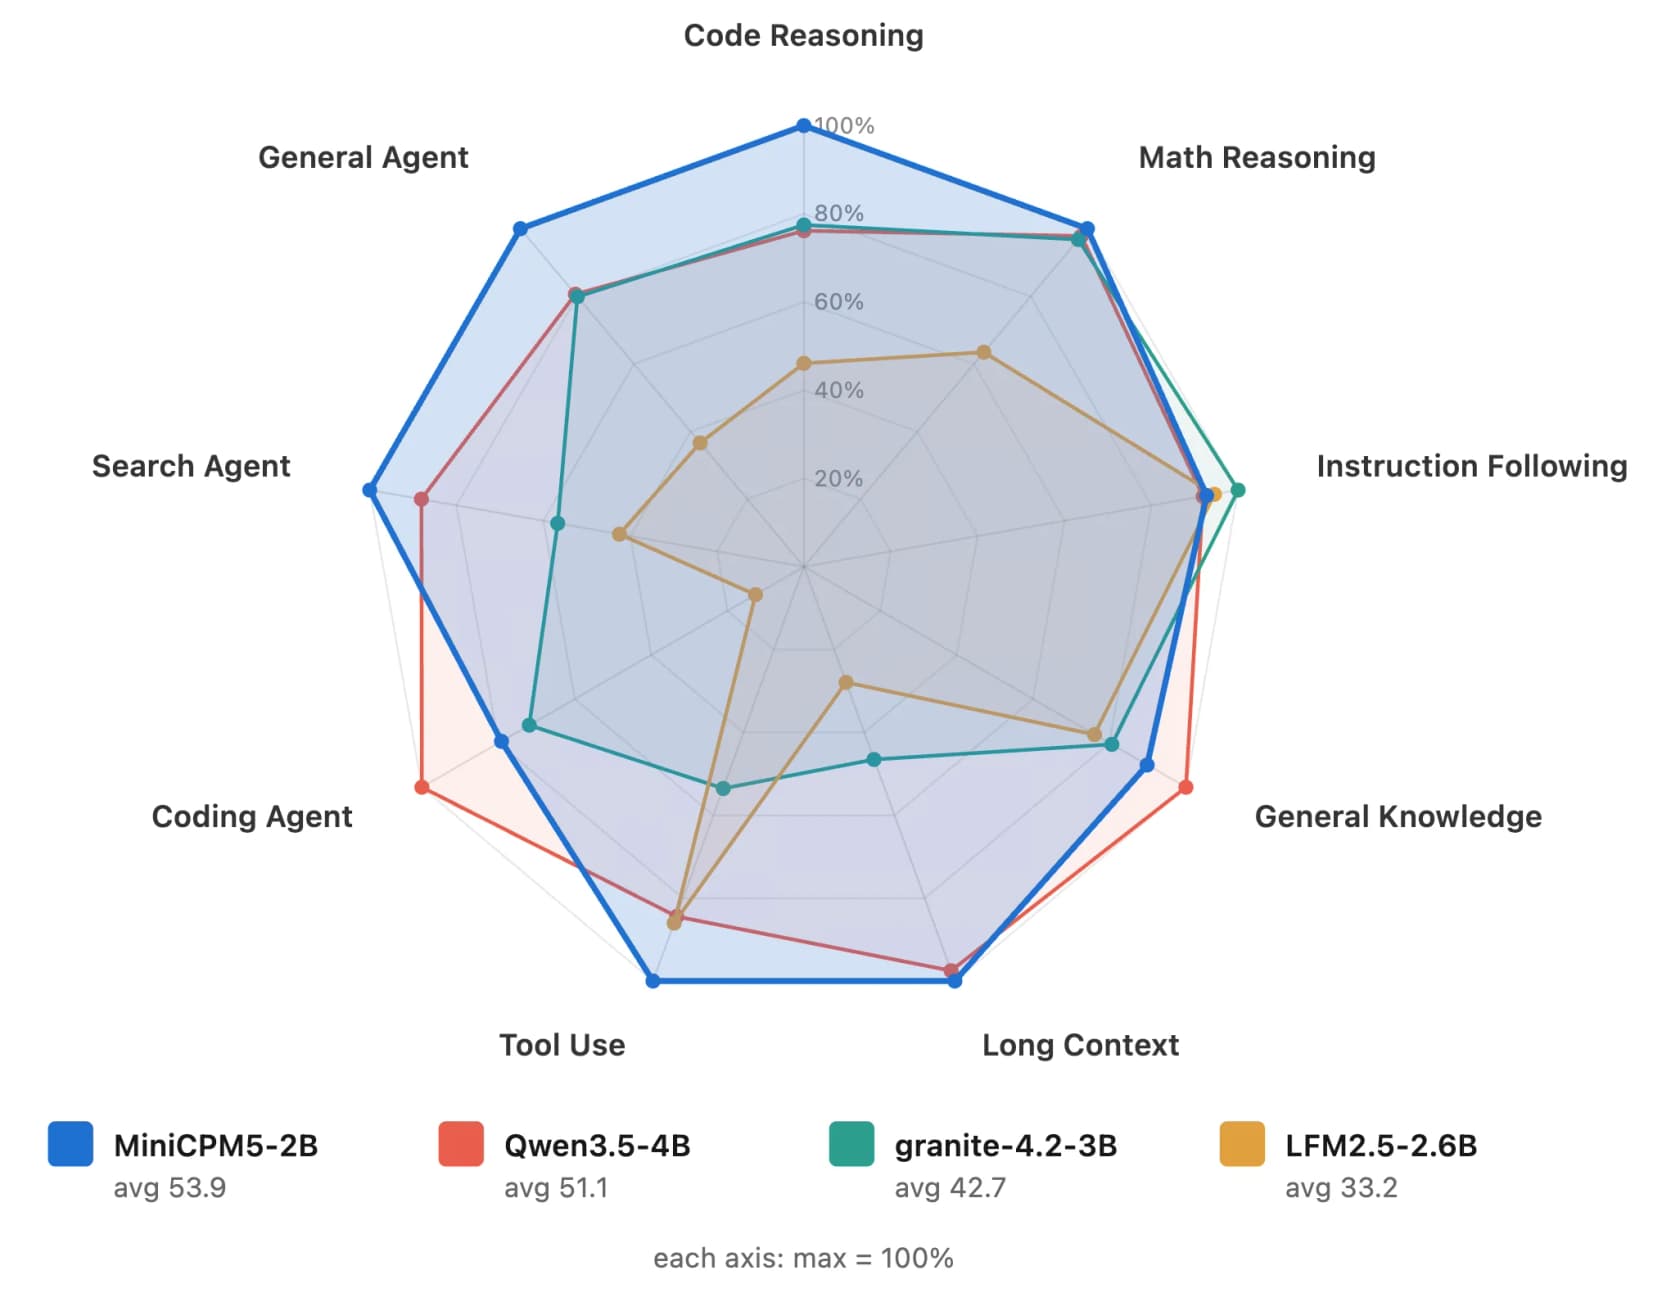
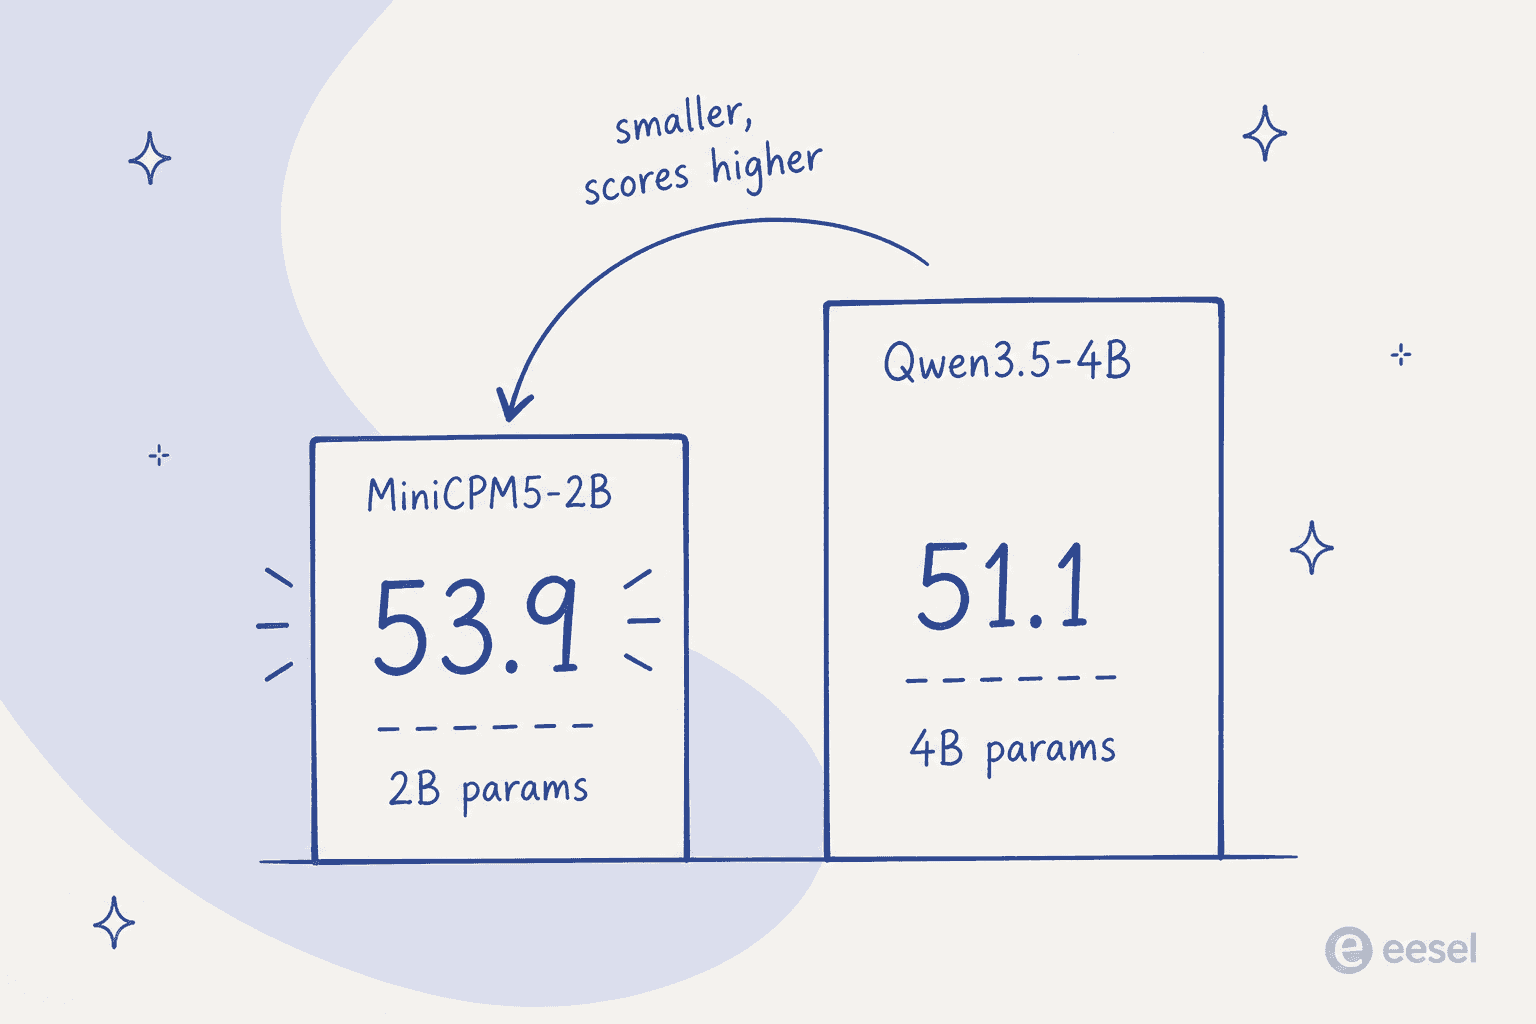
MiniCPM5-2Bは、OpenBMBが公開した25億パラメータのテキスト専用の新モデルで、自分のハードウェアで動かすことを前提に作られています。見出しの数字は本物です。34のベンチマークで平均53.9を記録し、OpenBMBはこれを2Bクラスのオープンソース最高水準と位置づけています。彼らの比較セットの中では、最も強い4BモデルであるQwen3.5-4B(51.1)をわずかに上回ります。Apache-2.0ライセンスで、ネイティブの128Kコンテキストを備え、Ollama、llama.cpp、MLXなどを通じてスマートフォン、ノートPC、ミニPCで動作します。
正直な注意点もあります。テキスト専用でビジョンはなく、英語と中国語のみで、ベンチマークでの勝利が実際のコーディング環境でも通用するのかについてはコミュニティの一部が懐疑的です。Artificial Analysis Indexのスコアにも公の食い違いがあります(独立系トラッカーは15、OpenBMB自身のツイートは23)。
誰に向いているか。ローカルアシスタント、オンデバイスツール、あるいは身軽なエージェントを作っていて、小さくて寛容なライセンスのものがほしいなら、MiniCPM5-2Bは現在の4B未満のモデルの中でも特に興味深い一つです。本番でサポートチケットを解決するAIが必要なら、生のモデルは適切なレイヤーではありません。その理由は終盤で説明します。
MiniCPM5-2Bとは実際に何か
MiniCPM5-2Bは2026年9月6日から7日ごろに、OpenBMBのMiniCPM5シリーズの2番目のモデルとして登場しました。1番目はより小さなMiniCPM5-1Bです。OpenBMB(ModelBestとも呼ばれます)はここ数年、小さく効率的なモデルを出し続けており、このシリーズの狙いはただ一つ、データセンターのGPUではなくエッジのハードウェアに本当の能力を載せることです。
重要なスペックは次のとおりで、すべてモデルカードによるものです。
| 項目 | 値 |
|---|---|
| パラメータ数 | 2,516,756,480(約2.52B) |
| アーキテクチャ | 標準のLlamaForCausalLM、42層 |
| アテンション | Grouped-query、クエリヘッド16、KVヘッド2 |
| コンテキスト長 | 131,072トークン(128K) |
| ライセンス | Apache-2.0(重みとリポジトリ) |
| モダリティ | テキストのみ、英語と中国語 |
| フォーマット | BF16、加えてGGUF、MLX 4ビット、GPTQ 4ビット |
ここでは、ある設計上の選択が目立たないところで大きく効いています。MiniCPM5-2Bは素直なLlamaForCausalLMアーキテクチャを使っているため、OpenBMBの言葉を借りれば、主要なエンジンは「no custom kernels, no model-code fork」で直接読み込めます。だからこそ、エコシステムの対応を2週間待つ通常の流れではなく、vLLM、SGLang、llama.cpp、Ollama、LM Studio、MLXでリリース初日から対応できました。新しいオープンモデルを公開当日に動かそうとしたことがあれば、この初日対応の幅が当たり前ではないことがわかるはずです。
もう一つの目玉の数字が128Kのコンテキストで、これほど小さいモデルとしては本当に大きく、後述のロングコンテキストのベンチマークは、これがスペック表だけの数字で実運用では崩れる、というものではないことを示唆しています。
ベンチマーク: 2Bは本当に4Bに勝てるのか
誰もが飛びついた主張なので、実際の表をお見せします。OpenBMBの34ベンチマークのスイート全体で、MiniCPM5-2Bは平均53.9で、Qwen3.5-4Bの51.1を上回り、比較対象となった他の2Bクラスのモデルをはるかに引き離しています。
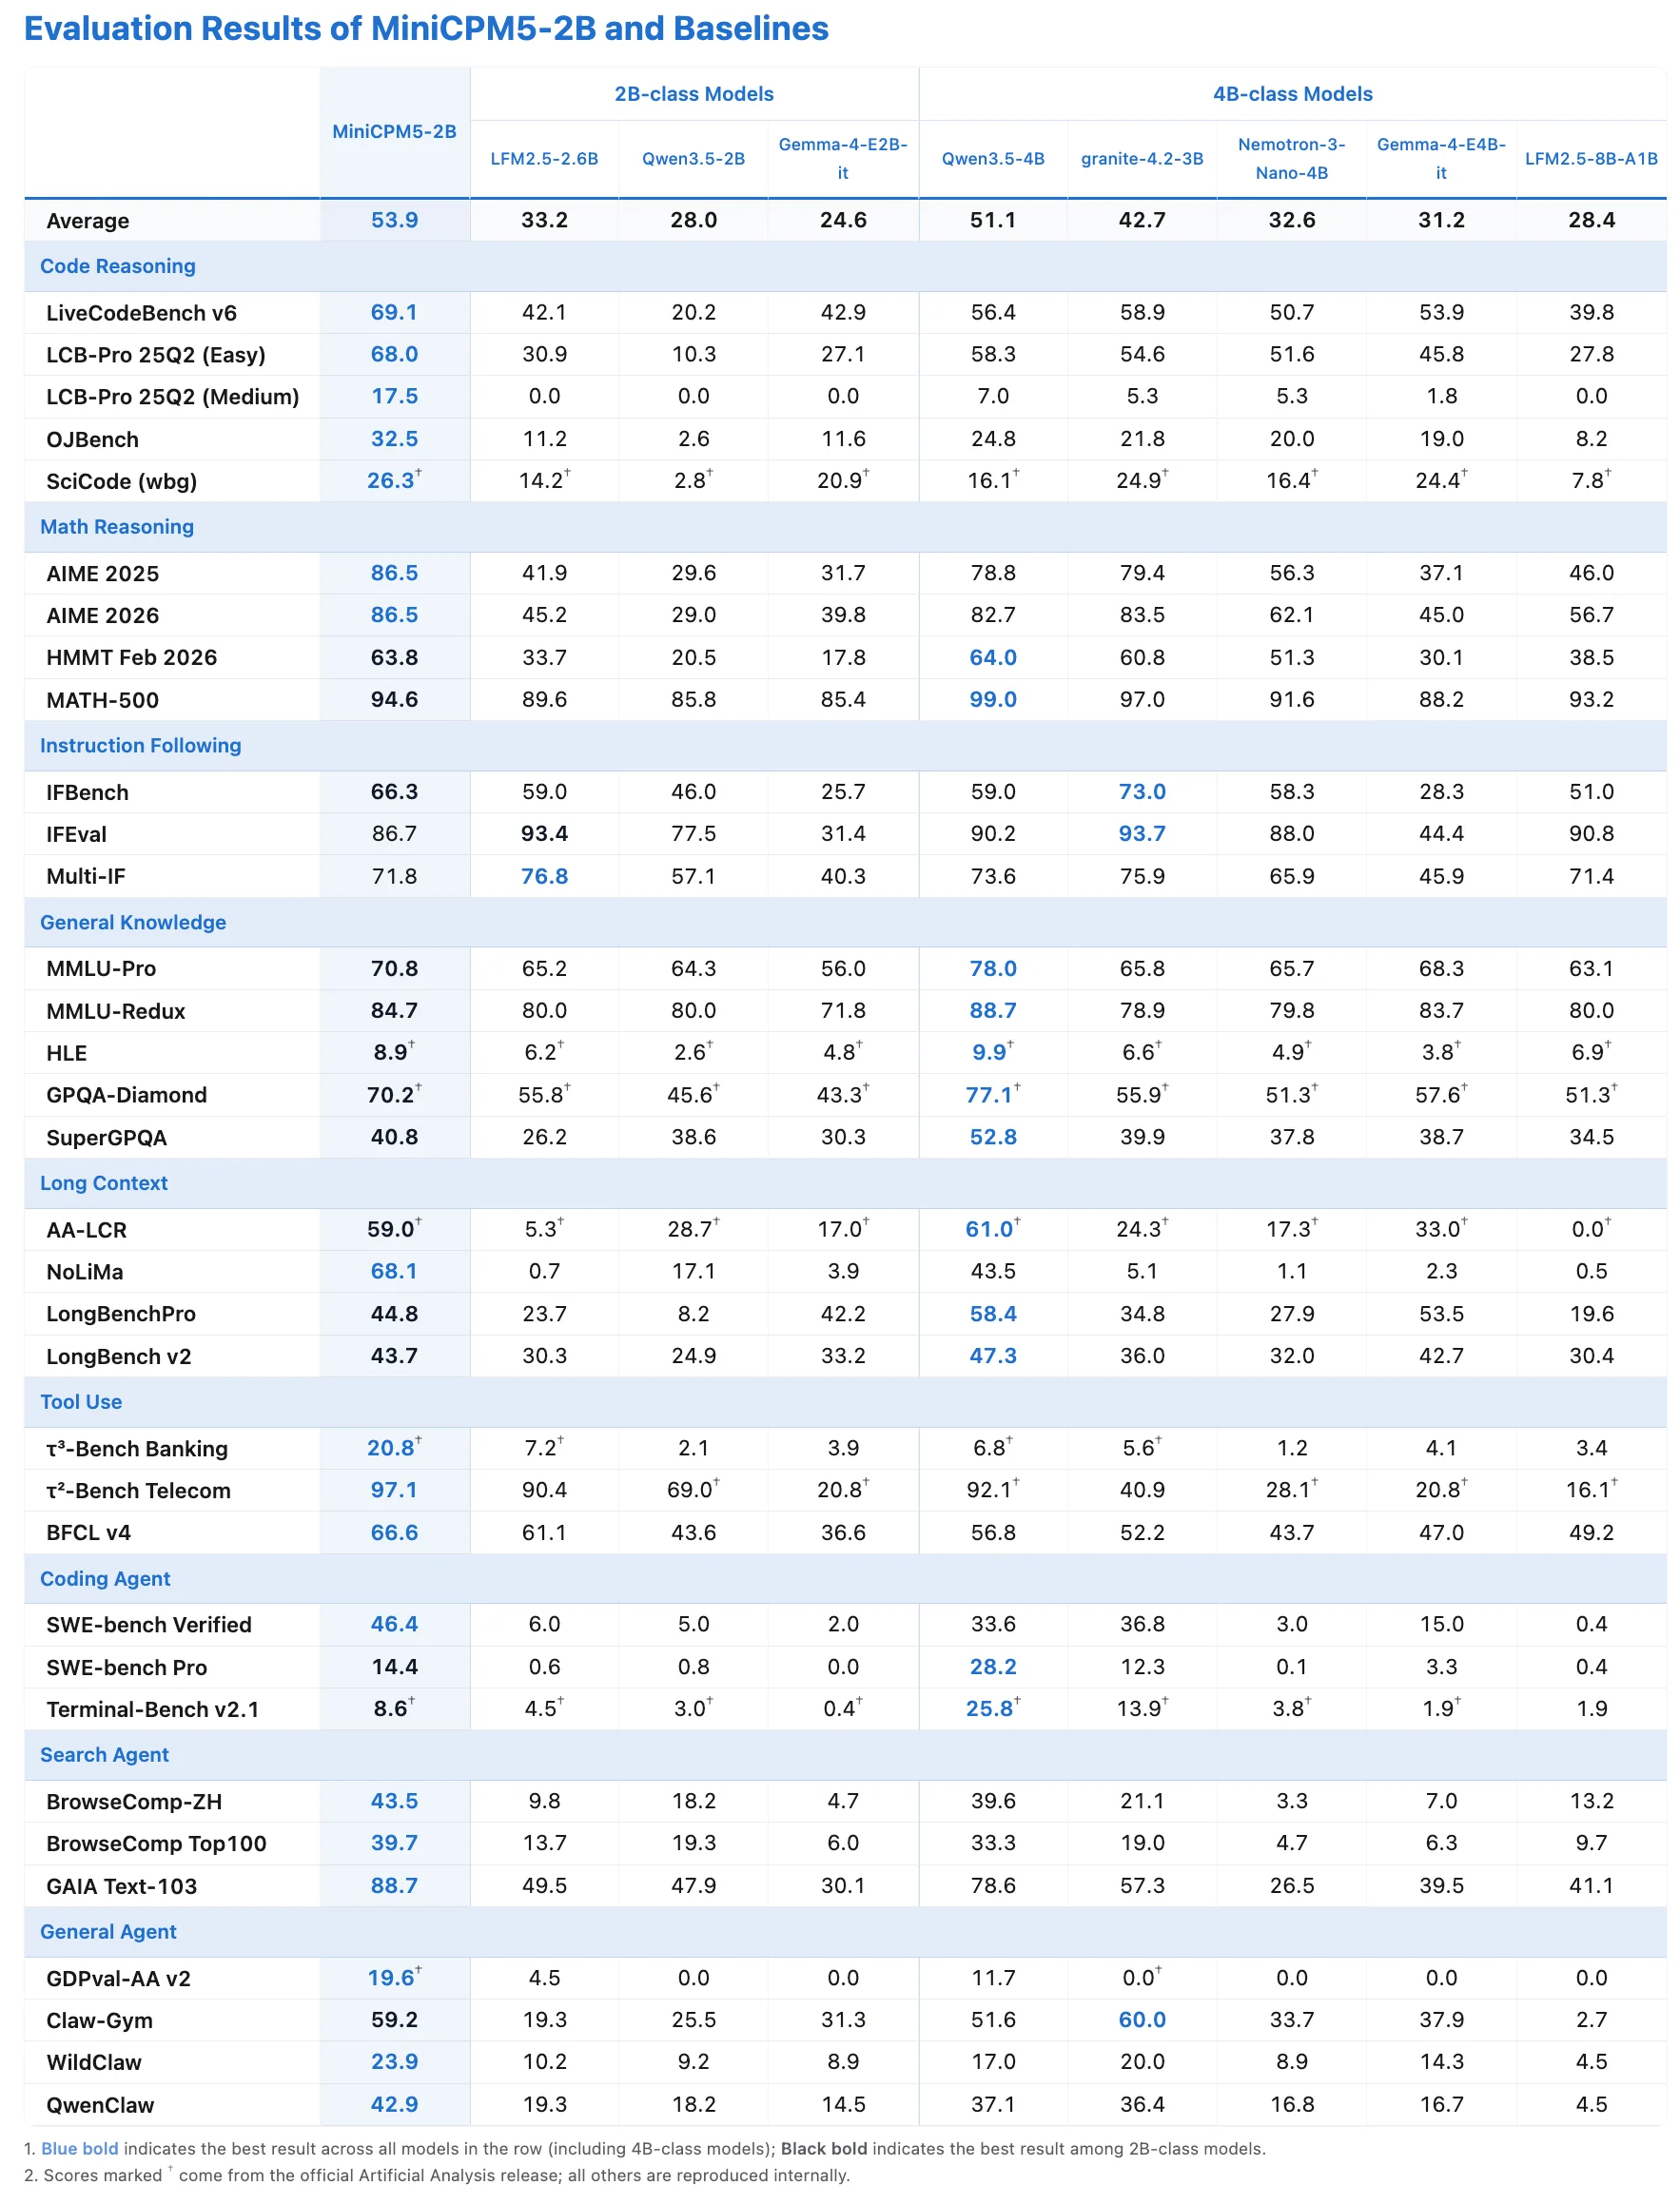
際立った行が面白いところです。数学ではMATH-500 94.6、AIME 2026 86.5に達します。コード推論ではLiveCodeBench v6 69.1、SWE-bench Verified 46.4で表のトップに立ち、どちらも4BのQwenを上回ります。ツール利用ではτ²-Bench Telecom 97.1、BFCL v4 66.6を記録し、検索エージェント側ではGAIA Text-103が88.7です。ノートPCで動かせるモデルとして、これらのエージェントとツール利用の数字が意外な点です。
ここで正直に押さえておきたい点が二つあります。第一に、これはOpenBMB自身の比較セットなので、「4Bに勝つ」というのは彼らが選んだモデルとベンチマークの範囲内で真であり、普遍的な主張ではありません。4BのQwenは知識系とロングコンテキスト系のいくつかの行(MMLU-Pro 78.0、GPQA-Diamond 77.1)では依然として勝っています。第二に、第三者の数字には実際の食い違いがあります。r/LocalLLaMAのリリーススレッドとHacker Newsの投稿はどちらも、Artificial Analysis Intelligence Indexを15と報告し、「the highest of any open weights model at 4B parameters or below」だとしています。一方、OpenBMBの公式ローンチツイートは、23に加えてAgentic Indexで20と主張しています。確認できた情報源ではこれが一致せず、おそらくバージョンか丸めの違いなので、独立した15を保守的な数字として信頼し、23はベンダーの数字として扱うのがよいでしょう。
もう一点注意しておくと、OpenBMBは、多くの人が反射的に探す従来のMMLU、GSM8K、HumanEvalのスコアを公開していません。モデルカードは新しいスイート(MMLU-Pro、LiveCodeBench、SWE-benchなど)を使っているため、古いモデルのスペック表と比べようとしても、きれいに同条件で比較できる行は見つかりません。
2Bモデルはどうやってここまで良くなったのか
私が最も興味深いと思うのはスコアではなく、それを生んだ学習レシピです。2Bモデルがマーケティングのように聞こえるのではなく、サイズ以上の力を発揮する理由を説明してくれるからです。
最終リリースは単一の学習ランではありません。OpenBMBのUltraDataデータセットでのベース学習とミッド学習の後、ポストトレーニング段階では教師あり微調整を行い、続いて数学、コード、エージェント系タスク、文章作成それぞれの専門教師による強化学習を、彼らのJustRL IIアルゴリズムで実施します。巧みなのは最後のステップで、オンポリシー蒸留によって、生徒と教師の間の全語彙の逆KLを使い、16の個別の専門家モデル(うち5つはエージェント系の専門家)を単一の2Bリリースに統合します。平たく言えば、専門家のチームを訓練し、その技能を一つの小さなモデルに圧縮し直したのです。
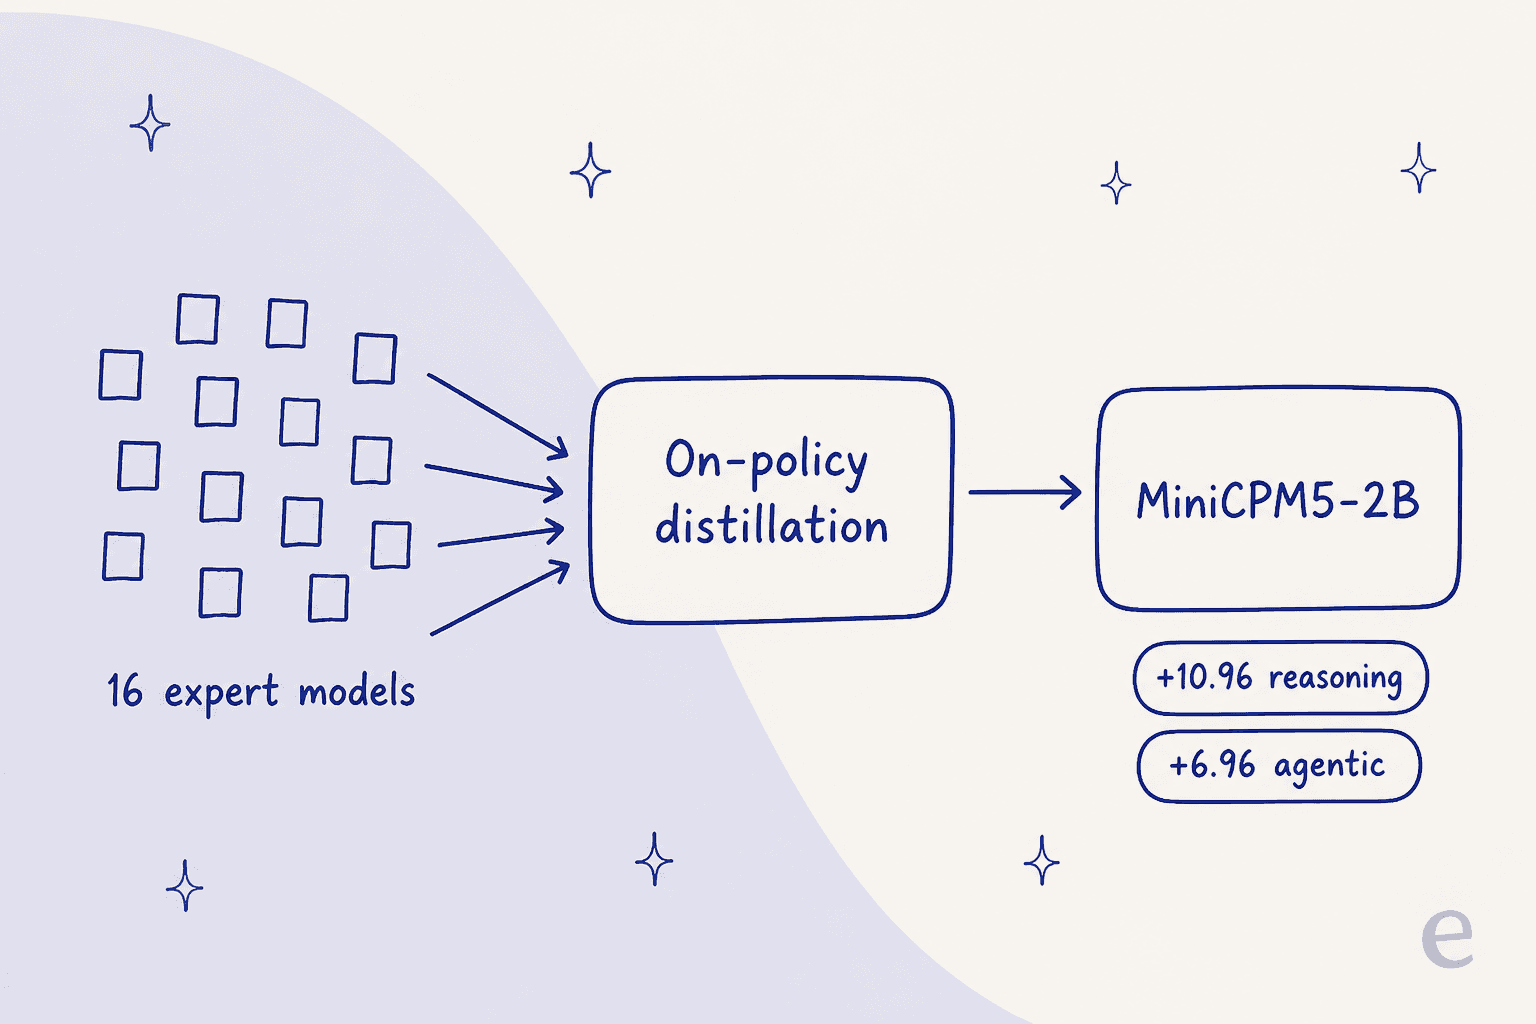
モデルカードによれば、このRLと蒸留の段階によって、SFTのみのチェックポイントと比べ、推論と一般ベンチマークは平均10.96ポイント、エージェント系タスクは6.96ポイント向上しました。ポストトレーニングの1パスとしては大きな跳ね上がりで、「小さなモデルで高スコア」という話の裏にある仕組みです。現代の小型モデルがどう作られているかを知りたいなら、このレシピは丁寧に読む価値があります。
動かす: MiniCPM5-2Bの収まりどころ
標準的なアーキテクチャを使っているため、MiniCPM5-2Bを動かすのは拍子抜けするほど退屈で、これは褒め言葉です。モデルカードにはvLLMのワンライナーが載っています。
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
ツール呼び出しを重視するなら、推奨バックエンドはSGLangです。モデルはXML形式のツール呼び出しを出力し、SGLang組み込みのminicpm5パーサーがそれをOpenAI互換のtool_callsに変換します。結果を変えずに出力を速くしたい場合のために、投機的デコーディング用のDSparkドラフトモデルもあります。ノートPCやスマートフォンでは、GGUFと4ビットのMLXビルドがOllama、LM Studio、llama.cpp、MLXで動作し、OpenBMBはIntel、Arm、Rockchipチップへの初日対応も謳っていて、Arm SME2のモバイルハードウェアでプリフィルが約1.7倍、デコードが約1.2倍向上するとしています。
オンデバイスのスループットのデモは、スペック表を超える部分です。あるテスターは1台のDGX Sparkで32の並列サブエージェントを動かし、平均931トークン/秒、ピーク1,364トークン/秒を記録しました。すべて2Bモデルでの結果です。OpenBMBは別の実行例も再共有しており、16GBのMacBookで動作し、ウェブ検索を呼び出して結果を完全にデバイス上で要約しています。こうしたワークロードは、コンパクトで高速なモデルだからこそ可能になるもので、巨大なクラウドモデルにはレイテンシやコストの面で手が届きません。
実際の評判
この手のモデルの本拠地であるr/LocalLLaMAでの反応は、おおむね歓迎ムードでした。
"Hot damn. Very promising."

ただし、批判の流れが二つ繰り返し出てきて、どちらももっともです。一つ目はビジョン非対応で、ローカル勢には明らかに痛手でした。
"Sad that there is no vision though. Having to switch to Lfm2.5-vl-3b for it is a bummer"
二つ目は、リーダーボードのスコアが有用な仕事につながるのかという健全な懐疑です。スループットのデモに対する返信の一つは率直でした。
"you get some likes here, but useful code? I don't think so"
また、実践的なテスターは、実際のコーディング環境から操作すると失敗すると報告し、その原因を量子化された2Bビルドとドラフターにあるとしました。これは小型モデルで繰り返される教訓です。ベンチマークでの勝利は、信頼できるエージェントと同じではなく、そのギャップは実際のツールループにつないだときにまさに表れます。
正直な制約
懸念点を一か所にまとめます。公平なレビューは、それらをはっきり示すものだからです。
- ビジョンも音声もなし。 このチェックポイントはテキスト専用です。マルチモーダルは別系統のMiniCPM-Vにあるため、画像タスクには2つ目のモデルが必要です。
- 英語と中国語のみ。 コミュニティのテスターが対応言語の範囲を確認しており、幅広い多言語モデルではありません。
- ベンチマークが実運用の報告を上回っている。 上記のコーディング環境での失敗は、これを土台にする前に自分で確かめるべき点です。
- 公のスコアの食い違い。 Intelligence Indexの15対23の差は未解決で、ベンダーが実施した数字には常に疑いの目を向けるべきです。
- 最初の週の採用はまだ少ない。 モデルカードでは最初の週に2,879ダウンロードで、コミュニティによるストレステストは始まったばかりです。
どれも致命的ではありません。位置づけを示しているだけです。MiniCPM5-2Bは、研究や趣味向けの優れたエッジモデルであり、オンデバイスツールの有望なベースですが、そのまま本番に置ける頭脳ではありません。
モデルとチームメイト: 2Bモデルがサポートでできることとできないこと
ここで私が重視したい捉え直しがあります。モデルのレビューを読んでいる多くの人が、こうしたものを自社のサポートキューに向けられないかとひそかに考えているからです。
生のモデルは素材であって、料理ではありません。MiniCPM5-2Bが与えてくれるのは重みと強力なベンチマークカードです。それを顧客が触れるものにするには、ホスティング、プロンプト設計、ヘルプデスクへの接続、ナレッジの投入、ツールの付与、ガードレールの追加、そして自信満々に誤った回答をしないためのテストが必要です。これは本格的なエンジニアリングプロジェクトで、良いモデルを選ぶことよりもAIエージェントを構築することに近いものです。MiniCPM5-2B、Qwenモデル、OpenAIのエンドポイントのどれを見ていても、私が指摘するギャップは同じです。モデルはインフラであり、実際の働き手は、その上に自分で構築するすべてです。
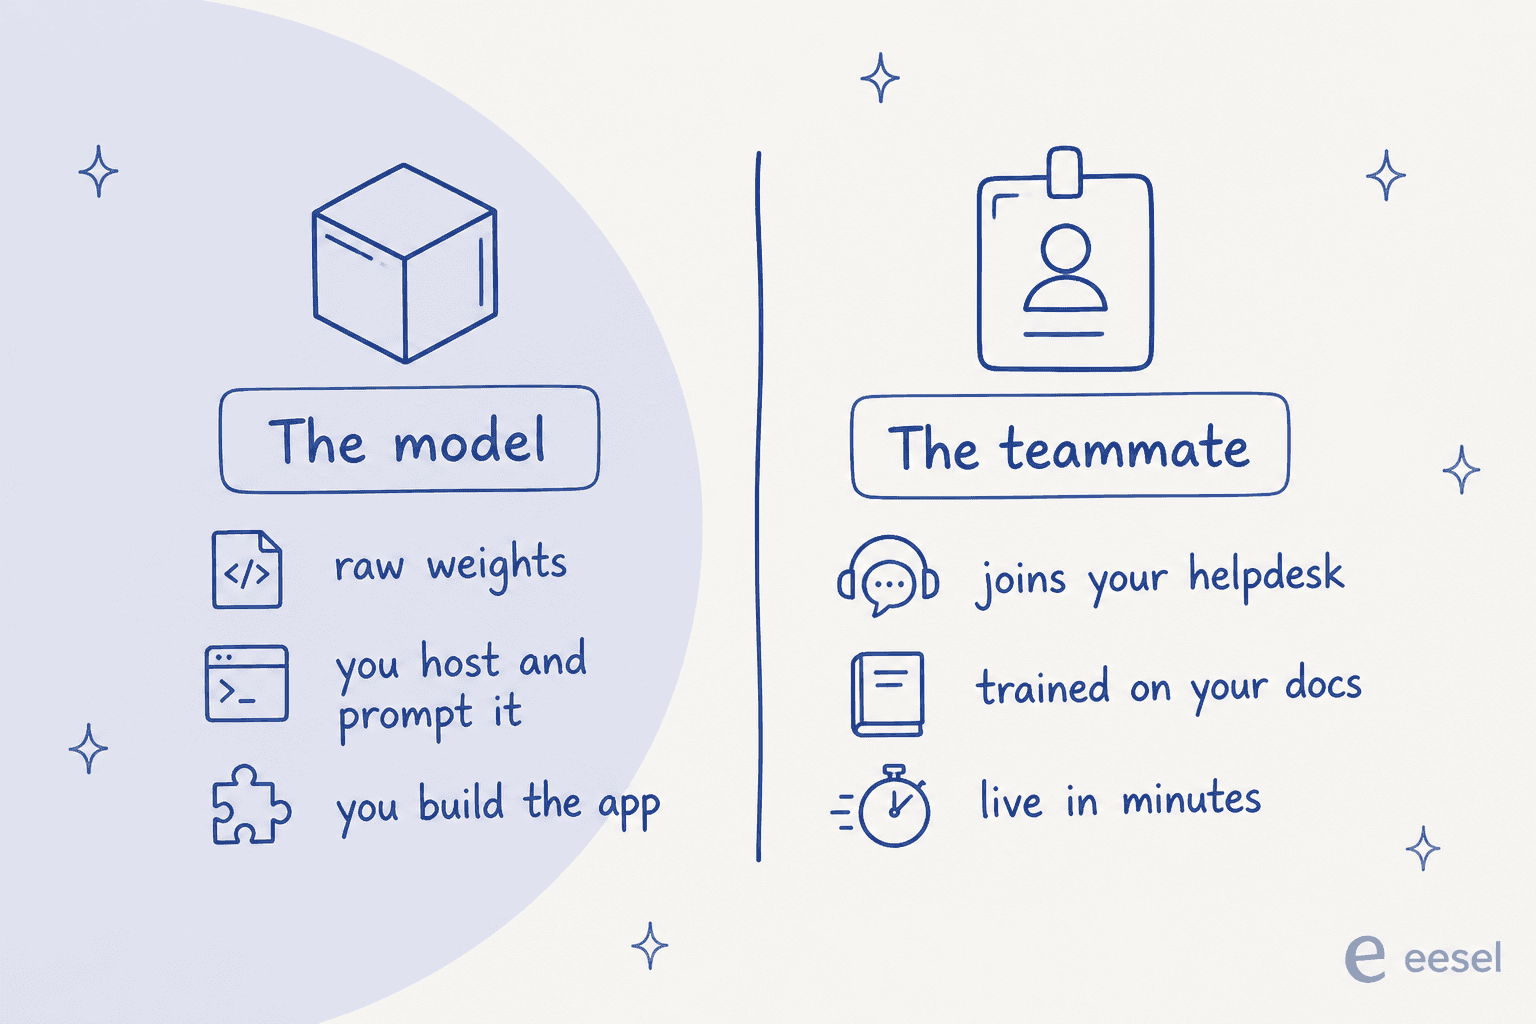
この違いこそが、eeselが存在する理由のすべてです。配線すべきモデルを渡す代わりに、特定の仕事に向けてすぐ働けるAIチームメイトを提供し、そのAIヘルプデスクチームメイトには、連携、会社の文脈、サポート用のツールがあらかじめ組み込まれています。トレードオフは現実のもので、はっきりさせておく価値があります。MiniCPM5-2Bのように、自分の重みを自分のノートPCで動かすことはできません。その代わりに得られるのは、数か月ではなく数分で実際のチケットに答えているものです。
AIサポートにeeselを試す
2Bモデルのレビューを読んだ理由が「これはうちのサポートチームの役に立つのか」だったなら、正直な答えは、モデル単体では役に立たないが、モデルの上に構築されたAIチームメイトなら役に立つ、です。
eeselは、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、Help Scoutなど)に接続し、過去のチケットとドキュメントで学習し、数分で稼働できます。見逃さないでほしいのは、実際の会話に触れる前に、過去のチケットでシミュレーションできる点です。実際の顧客にどう答えていたかを、先に正確に確認できます。これは、上で紹介したモデル懐疑派が求め続けている「信頼する前にテストする」という姿勢を、製品に組み込んだものです。また、MiniCPM5-2Bのオンデバイスという側面が気に入ったターミナルとスクリプト派のために、eeselはCLIとMCPサポートも提供しており、人間、スクリプト、あるいはClaude CodeやCursorのようなコーディングエージェントが、ダッシュボードを開かずに同じチームメイトを操作できます。
eeselを試すのは無料で、クレジットカードも営業電話も不要です。自前の推論スタックを組み終えるより前に、チームメイトがチケットに答え始めているでしょう。