

Gemini 3.6 Flashは本当に優れたワークホースモデルで、置き換え対象の3.5 Flashより安く効率的です。しかし「優れたワークホース」は一つの役割であって独占ではなく、実際に必要なものによっては、狙っている軸で上回る競合がいくつか存在します。
端的に言うと、GPT-5.6 Lunaが意外なバリュー枠の勝者で、入力・出力の両方でGemini 3.6 Flashより安いうえに、最も難しいコーディング・ナレッジ系ベンチマークで勝っています。Claude Sonnet 5は価格に目をつぶれるなら品質のリーダーです。Grok 4.5はコーディング王座をわずかに制します。Flash-Liteは予算枠の王者です。そしてGemini 3.1 ProとKimi K3が、それぞれ「もっと推論力が欲しい」「オープンウェイトが欲しい」というニーズを埋めます。
モデルを比較している理由がカスタマーサポートなら、一つだけ覚えておいてほしいことがあります。モデル選びは簡単な部分です。私はこれらのどれをも実際に動くAIヘルプデスクエージェントに変える層を作っていて、その作業のほとんどはモデルとは関係ありません。詳しくは最後に説明します。
そもそもなぜGemini 3.6 Flash以外を検討するのか
まず公平に評価しておきます。Gemini 3.6 Flashは2026年7月21日にローンチされ、実質的なアップグレードです。3.5 Flashより出力トークンが17%少なく、出力価格も100万トークンあたり9.00ドルから7.50ドルに下がっています。コンピュータ操作、チャート推論、長文コンテキストの記憶再現に優れ、それをフロンティアモデルのほんの一部の価格で実現しています。すでにGemini Flashを使っているなら、素直にアップグレードすべきです。
それでもなぜ他を探す人がいるのでしょうか?実際によく挙がる理由がいくつかあります。
- Googleは新しいフラッグシップを出さなかった。 今回のローンチにはGemini 3.5 Proが含まれず、プロダクトリードのLogan Kilpatrickは社内目標を逃したとされる中、依然として「パートナーとテスト中」だと述べています。今すぐGoogle製のフロンティア級推論が必要なら、それはまだありません。
- 中価格帯のモデルであり、安価なモデルではない。 出力7.50ドルという価格は、最も難しいテストでより高い点数を出す競合の一部よりも高くなります。
- 最も難しいコーディングやナレッジワークでは後れを取る。 Google自身の比較表(下記)でも、GPT-5.6 LunaとClaude Sonnet 5が複数のベンチマークで上回っています。
- 無料プランのデータ利用とロックイン。 無料プランでは入力内容がGoogleのプロダクト改善に利用されますし、自分たちでホストできるオープンウェイトを単純に求めているチームもあります。
これらのどれも3.6 Flashを悪いモデルにするわけではありません。それが意味するのは、「最良」のモデルとはあなたの具体的な仕事に合ったモデルだということです。ここからは実際の勢力図を見ていきます。
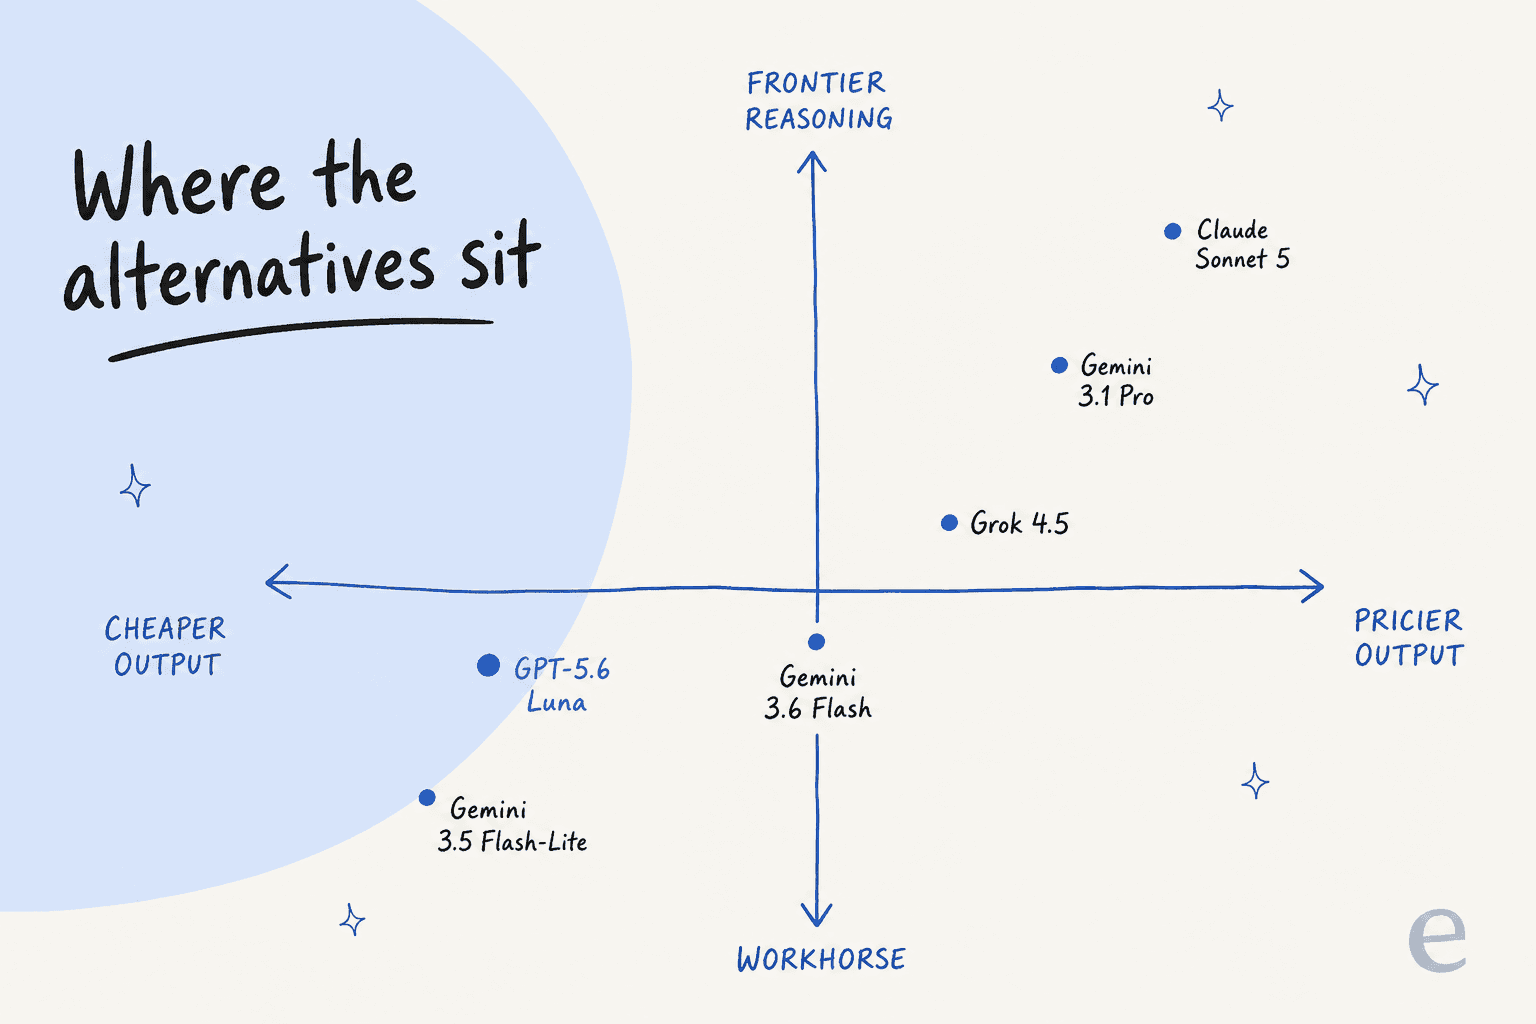
代替モデルの一覧
価格はすべて各ベンダーの標準有料プランにおける100万トークンあたりの料金です。ベンチマークの数値はGoogle自身が公開した比較によるもので、公平に言うと、自社モデルが劣る部分も隠していません。
| モデル | 入力 | 出力 | SWE-Bench Pro(コーディング) | GDPval-AA v2(ナレッジ) | 最適な用途 |
|---|---|---|---|---|---|
| Gemini 3.6 Flash(基準) | $1.50 | $7.50 | 58.7% | 1421 | オールラウンドなワークホース |
| GPT-5.6 Luna | $1.00 | $6.00 | 62.7% | 1584 | 最高のバリューと高度な推論 |
| Claude Sonnet 5 | $3.00 | $15.00 | 63.2% | 1607 | 最高の回答品質 |
| Grok 4.5 | $2.00 | $6.00 | 64.7% | 1535 | コーディング王座 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | n/a | n/a | 大量処理で最安 |
| Gemini 3.1 Pro | $2.00 | $12.00 | 54.2% | 965 | 今使えるより高度なGemini推論 |
| Kimi K3 | ~$3.00 | ~$15.00 | n/a | n/a | オープンウェイト/セルフホスト |
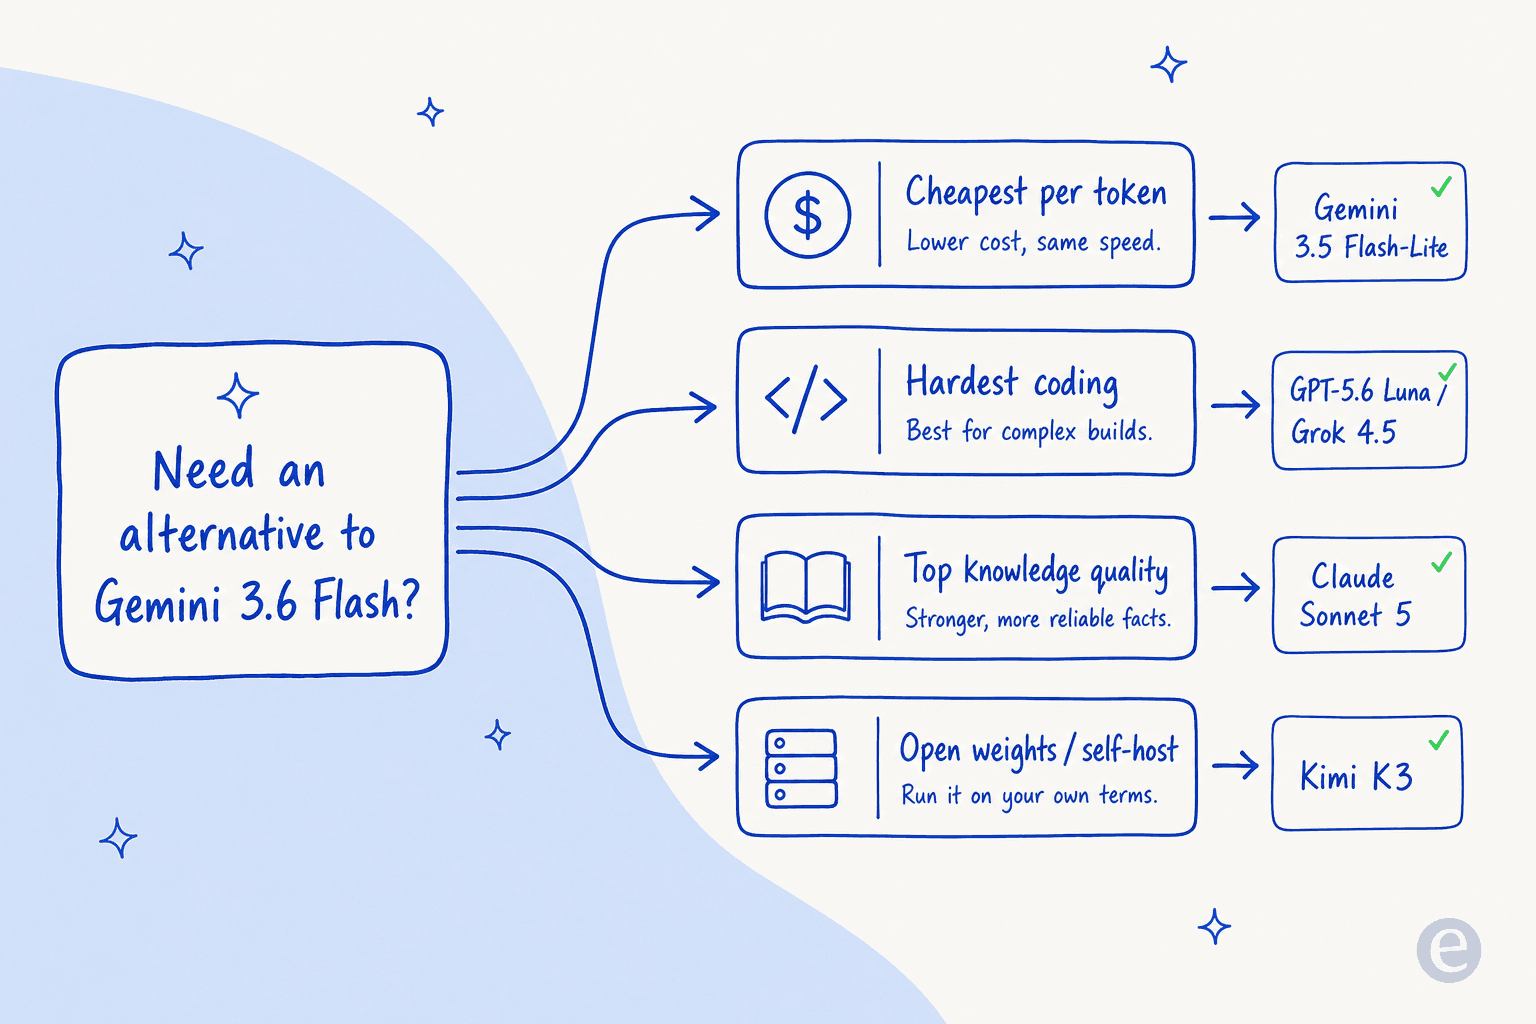
「自分にはどれが合うか」を一目で知りたいなら、このフローがほとんどのケースをカバーします。
もし自分の処理量を入力して月々の料金を見たいなら、実際にスケールする部分、つまり出力トークンの計算をこのウィジェットが代わりに行います。
1. GPT-5.6 Luna、コストパフォーマンスと高度な推論に最適
最適な対象: 最も強力なコーディング・ナレッジワークを求めつつ、Gemini 3.6 Flashより安い料金も欲しいチーム。
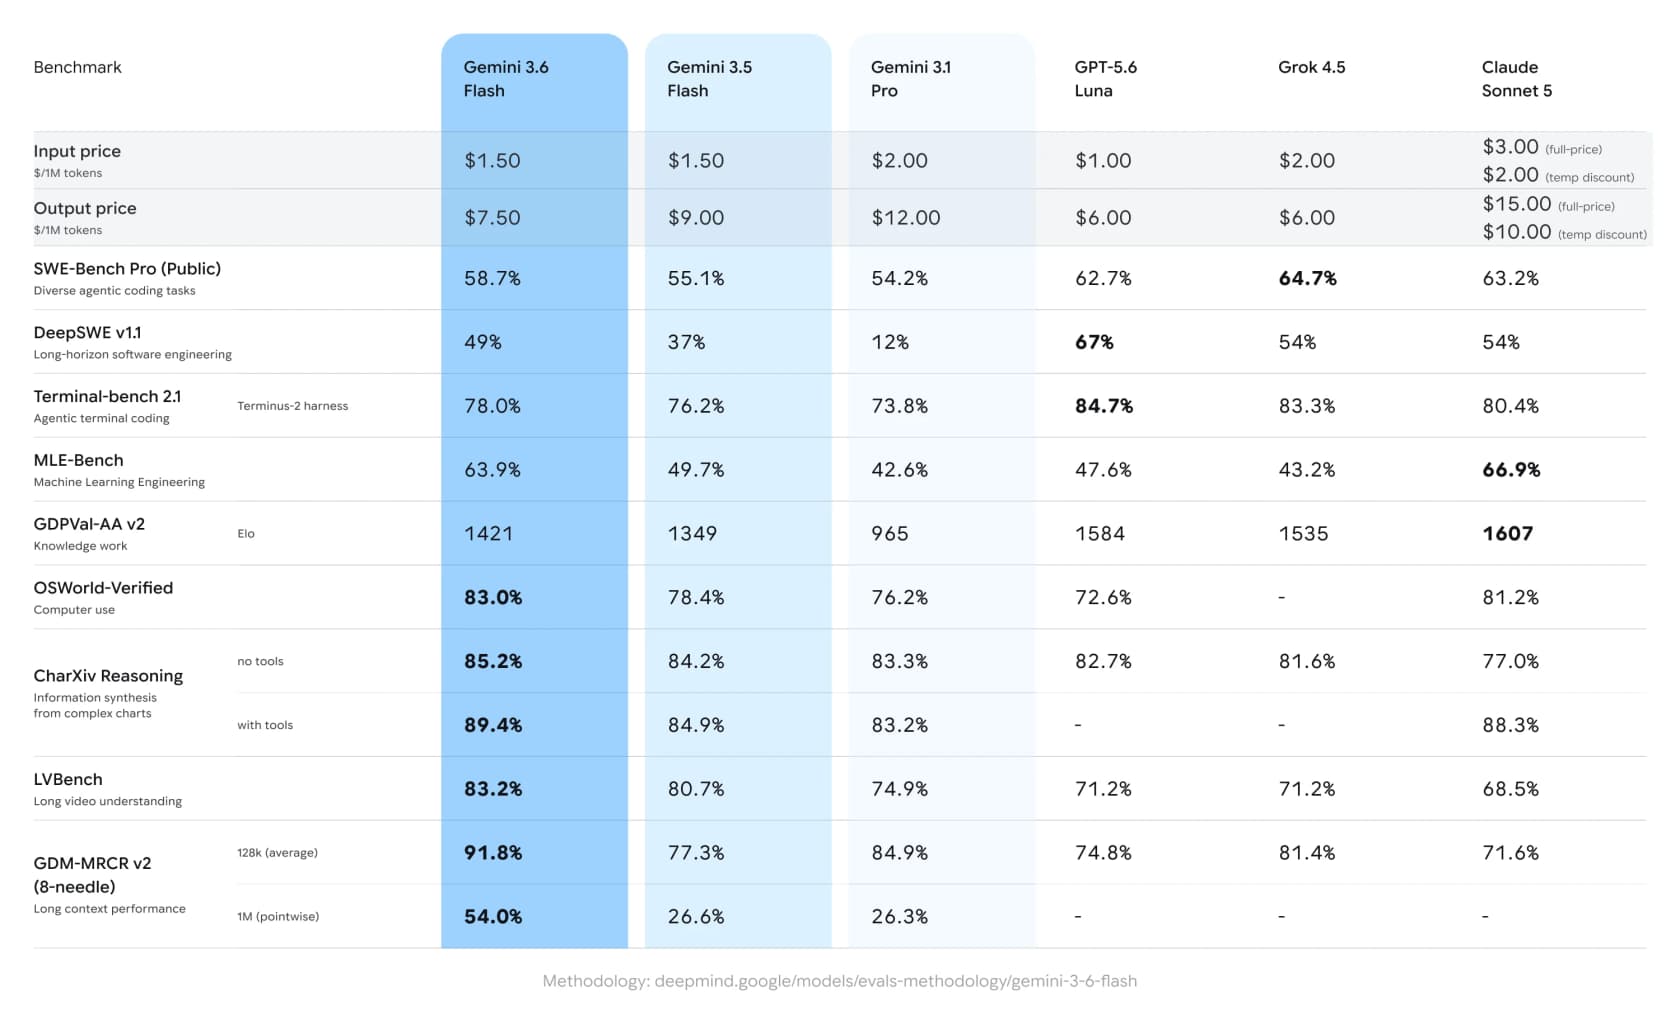
この選択が比較全体をかき乱します。OpenAIのGPT-5.6 Lunaは100万トークンあたり入力1.00ドル/出力6.00ドルで、Gemini 3.6 Flashを両方の面で下回る価格です。通常「安い」は「性能が劣る」を意味しますが、興味深いのはそうではないという点です。Google自身の表では、3.6 Flashの49%に対してDeepSWEで67%、Terminal-benchで78.0%に対し84.7%、ナレッジワークのEloスコアも1421に対し1584というスコアを記録しています。
強い点: 長期にわたるソフトウェアエンジニアリング、ターミナルでのコーディング、そして一般的なナレッジワーク。あなたのエージェントが実際のコードを書いたり編集したりするなら、これはより安く、より高性能なエンジンです。
弱い点: マルチモーダルや長文コンテキストの領域ではGemini 3.6 Flashに劣ります。コンピュータ操作(OSWorldで72.6%対83.0%)、チャート推論、長時間の動画、100万トークンの記憶再現などです。コード中心ではなくドキュメントや画面中心の作業であれば、Geminiが優位を保ちます。
料金: 100万トークンあたり入力1.00ドル/出力6.00ドル。
結論: 乗り換えを検討しているほとんどのエージェント開発者にとって、GPT-5.6 Lunaは最初に試すべき代替モデルです。安い選択肢が、みんなが競っているベンチマークでもより高性能という珍しいケースです。唯一の注意点はマルチモーダルや長文コンテキストの王者ではないことなので、テキストとコード中心のワークロードに合わせて使いましょう。
2. Claude Sonnet 5、回答品質に最適
最適な対象: 誤った回答のコストが高く、品質がコストに勝るチーム。
AnthropicのClaude Sonnet 5はここでは最も高価なモデルで、100万トークンあたり入力3.00ドル/出力15.00ドルです(現在は2.00ドル/10.00ドルへの一時的な割引中)。その分の対価があるのは、「本当に良い回答を返せているか」に直結する2つのベンチマークで頂点に立っているからです。GDPval-AA v2のナレッジワークで1607(グループ内最高)、MLE-Benchの機械学習エンジニアリングで66.9%です。SWE-Bench Proのエージェント型コーディングでも63.2%と強い数値を出しています。
強い点: ニュアンスのある推論、ナレッジワーク、丁寧な文章作成、そして安全性。出力が顧客対応や重要な場面で使われるなら、Sonnet 5の回答品質は割高な価格に値します。
弱い点: 出力価格はGemini 3.6 Flashのおよそ2倍で、マルチモーダルや長文コンテキストのテストでも大きく後れを取ります。コンピュータ操作、チャート推論、長時間動画、100万トークンの記憶再現はいずれもGeminiが優位です。処理量が増えるほど、その価格差はすぐに大きくなります。
料金: 100万トークンあたり入力3.00ドル/出力15.00ドル(現在の割引中は2.00ドル/10.00ドル)。
結論: 品質そのものが目的で、処理量が管理可能な範囲であればSonnet 5を選びましょう。トークンを数えながら大量処理を行うエージェントには、GPT-5.6 LunaやGemini自体に対して分が悪い選択です。フロンティア全体の比較についてはClaude vs ChatGPTの詳細記事もご覧ください。
3. Grok 4.5、コーディングに最適
最適な対象: 最高のエージェント型コーディングスコアを求め、中価格帯の料金でも構わないチーム。
xAIのGrok 4.5はこのグループで単独最高のコーディング数値を記録しています。SWE-Bench Proで64.7%と、Claude Sonnet 5(63.2%)やGPT-5.6 Luna(62.7%)を上回ります。入力2.00ドル/出力6.00ドルという価格は、GPT-5.6 LunaとGemini 3.6 Flashの間に位置し、出力に関してはGeminiより安価です。
強い点: 多様なエージェント型コーディングタスクで、僅差ながら全体をリードします。ターミナルコーディングでも83.3%と競争力があります。
弱い点: Googleの表ではコンピュータ操作や100万トークンコンテキストの数値が示されておらず、ナレッジワークのEloスコア(1535)もGPT-5.6 LunaやClaude Sonnet 5より低くなっています。まずはコーディング特化型と考えるべきです。
料金: 100万トークンあたり入力2.00ドル/出力6.00ドル。
結論: エージェント型コーディングが具体的な仕事で、最高のSWE-Benchスコアを求めているなら、Grok 4.5がその答えです。それ以外の用途では、より低い入力価格でバランスの取れたGPT-5.6 Lunaの方が適しています。
4. Gemini 3.5 Flash-Lite、最安の料金に最適
最適な対象: 分類、振り分け、タグ付けのような、大量かつ低い推論力で済む作業。
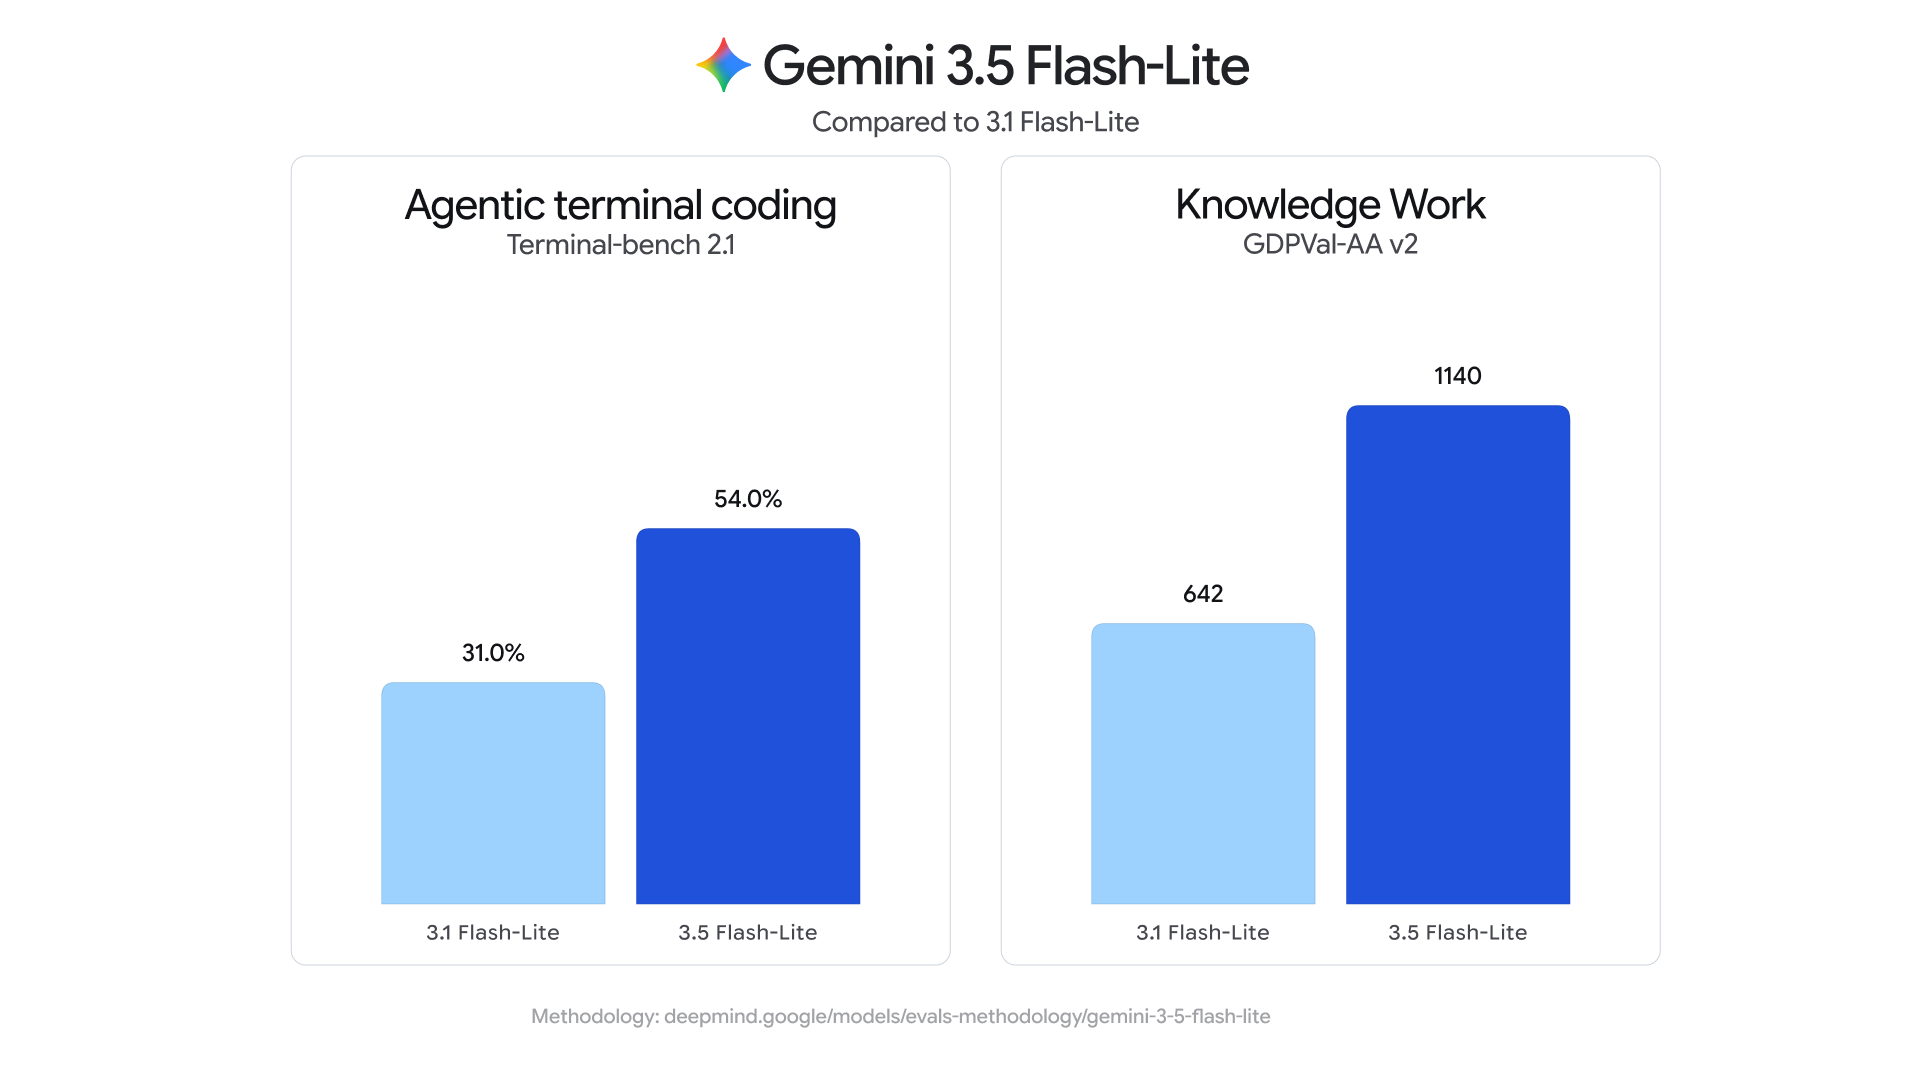
Gemini 3.6 Flashに対する不満が純粋に価格だけなら、答えは同じファミリー内のもう一段下にあることが多いです。Gemini 3.5 Flash-Liteは3.6 Flashと同時にローンチされ、100万トークンあたり入力0.30ドル/出力2.50ドルで、入力はおよそ5倍、出力はおよそ3倍安くなります。Googleによれば、旧世代の3.1 Flash-Liteをターミナルコーディングやナレッジワークで余裕を持って上回りながら、大量処理に十分な速度を保っているとしています。
強い点: トークン単価と、大規模運用時の低レイテンシ。チケットの分類、振り分け、項目の抽出には、ワークホースは不要で、安くて速いモデルが必要です。
弱い点: 高度な推論や長く複雑なエージェントの連鎖処理には作られていません。3.6 Flashの仕事をやらせようとすると、その差をすぐに感じるはずです。
料金: 100万トークンあたり入力0.30ドル/出力2.50ドル。
結論: 賢いパターンはFlashかFlash-Liteという二択ではなく、両方の併用です。単純なステップはFlash-Liteに振り分け、難しいものだけをエスカレーションします。うまく作られたAIエージェントは、まさにこの方法で料金を抑えています。
5. Gemini 3.1 Pro、今すぐ使えるより高度なGemini推論に最適
最適な対象: Geminiを使い続ける前提で、Flashより高度な推論が必要で、3.5 Proを待てないチーム。
Gemini 3.5 Proがまだテスト中である以上、実際に呼び出せる中で最も推論力の高いGeminiは3.1 Proで、100万トークンあたり入力2.00ドル/出力12.00ドルです。「Googleを離れずに一段上を目指す」ための選択肢です。
強い点: Geminiのエコシステム、ツール群、根拠づけ、Vertex/AI Studioのセットアップから外れることなく、時折発生する難しいタスクのためにFlashより重量級のモデルを使えます。
弱い点: ここは正直に言うべき部分です。Google自身の表では、3.1 Proはより高い価格にもかかわらず、ほとんどのエージェント系ベンチマークで新しい3.6 Flashに実際には負けています(DeepSWEで12%対49%、ナレッジワークのEloで965対1421)。旧世代のフラッグシップが新しいワークホースに追い越されている状態です。
料金: 100万トークンあたり入力2.00ドル/出力12.00ドル。
結論: 3.1 Proの挙動が具体的に必要で、Geminiから離れられない場合にのみ選ぶべきです。ほとんどの人にとっては3.6 Flashの方が安くて優れており、本当のPro級の答えは「3.5 Proを待つ、または今すぐ競合のフラッグシップを使う」ことです。
6. Kimi K3、オープンウェイトに最適
最適な対象: セルフホストが必要、データの保存先を管理したい、あるいはベンダーロックインを避けたいチーム。
ここまで紹介したものはすべてクローズドなAPIです。それが決定的な問題であれば、Moonshot AIのKimi K3が、本格的な100万トークンのコンテキストウィンドウとSonnet級の性能を備えたオープンウェイトの選択肢です。ホスト型APIの価格は100万トークンあたり入力3ドル/出力15ドル前後としているため、予算重視の選択ではなく、選ぶ理由はコストではなくコントロールです。
強い点: 自社のインフラで動かし、データを社内に保ち、一つのベンダーのロードマップや無料プランのデータポリシーに縛られずに済みます。
弱い点: マネージドAPIなら見えないホスティング、スケーリング、信頼性の確保という作業を自分たちで担うことになります。また、Sonnet級のホスト料金である以上、「オープン=安い」という思い込みは成立しません。
料金: ホスト型APIでは100万トークンあたり入力3ドル/出力15ドル前後。GPUがあればセルフホストは無料。
結論: オープンウェイトやデータ管理が必須要件である場合の正しい選択です。そうでなければ、上記のクローズドAPIのいずれかを使う方が、同等以上の結果を少ない手間で得られます。
モデルはサポートエージェントではない
ほとんどの比較記事が見落としている、そして私が最も気にしているポイントがここにあります。私はこれらのモデルの上に乗るものを作っているからです。「Gemini 3.6 Flashの代替」という検索でここに来た理由がサポートキューの自動化だとしたら、あなたは間違った層を最適化しています。
モデルはスタックの一番下にあるコモディティです。AIエージェントを実際の顧客に向けて安全に使えるものにするための要素はすべて、その上に積み重なっています。
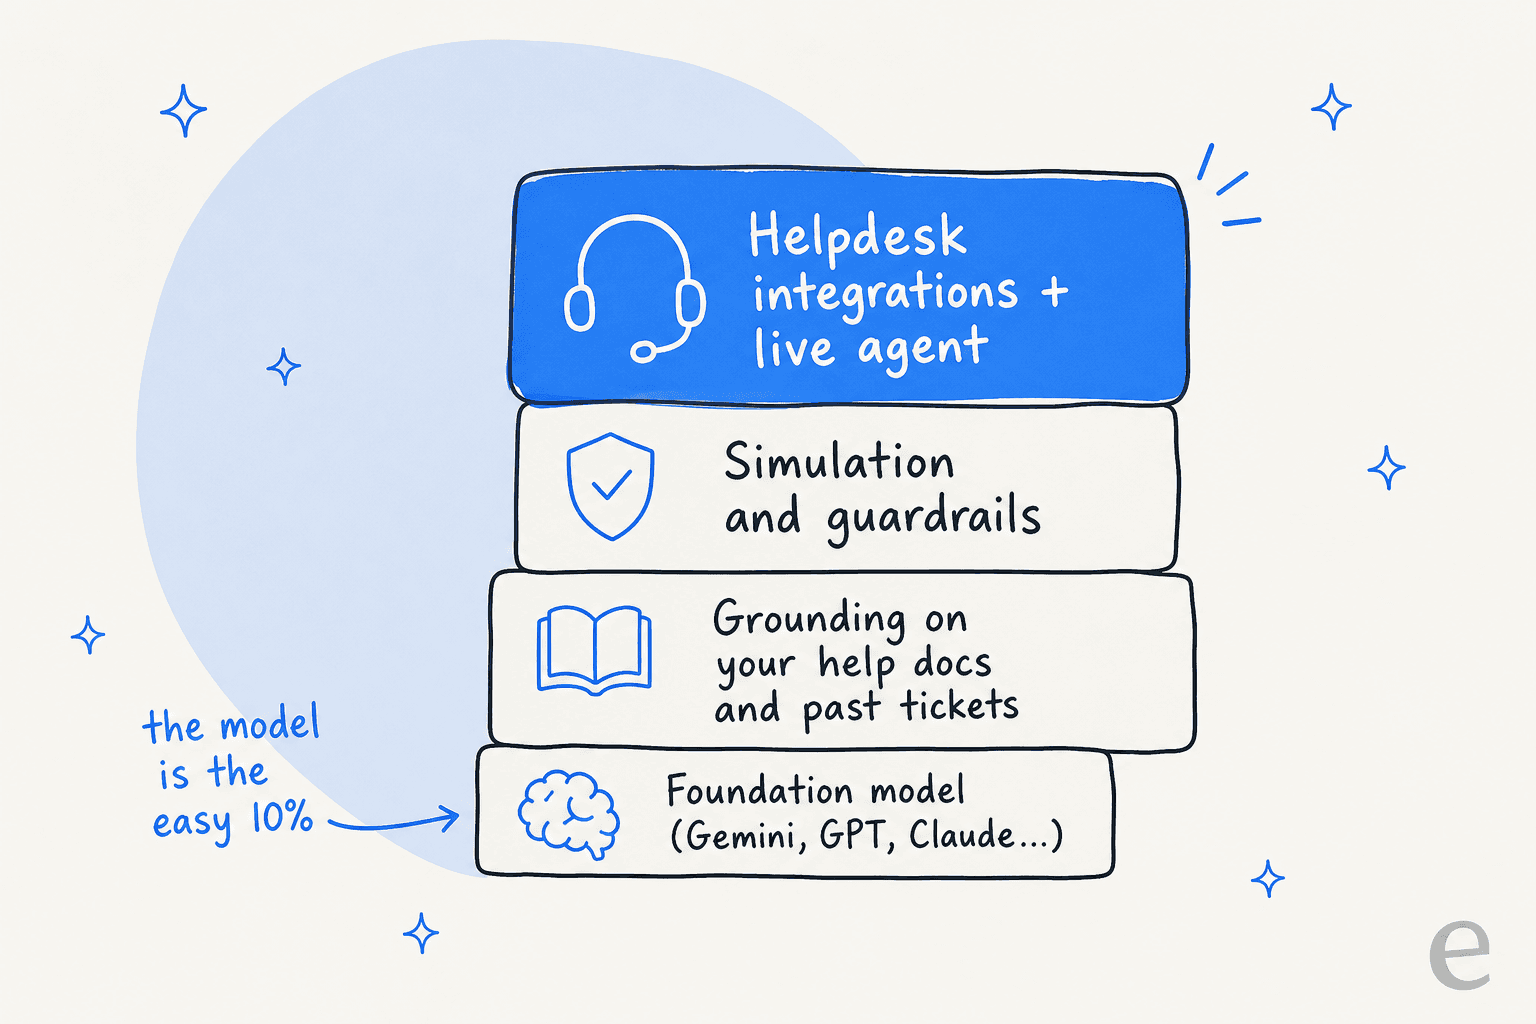
私は、自信満々に聞こえるモデルが、顧客に対してきれいに整った、完全に間違った回答を返す場面を何度も見てきました。その失敗は、どのモデルを選んだかとは関係がなく、その周りの層のすべてに関係しています。だからこそ、eeselのすべてのロールアウトは実際の一人の顧客に返信する前に過去のチケットに対してシミュレーションされ、トピックごとのカバー率と精度を確認してから、まずギャップを修正します。同じ理由から、確信度の低い回答は自動送信の返信ではなく、ドラフトになります。
その層こそが、「速いモデルが存在する」という事実を、実際にチケットの一定割合を解決する稼働中のエージェントに変えるものです。そのどれもモデルではなく、ヘルプドキュメントや過去のチケットへの根拠づけ、シミュレーション、ガードレール、そして周囲のヘルプデスク連携です。
この方向で進めるなら、本当に良い知らせがあります。優れたAIヘルプデスクエージェントはモデルに依存しないため、この比較全体があなたの問題ではなくなります。より安く優れたモデルが登場したときも、移行や意思決定なしにその恩恵を受けられます。
モデル選びをやめて、チケット解決を始めよう
モデル自体があなたが出荷しているプロダクトなら、上記の6つから仕事内容で選んでください。バリューならGPT-5.6 Luna、品質ならSonnet 5、コーディングならGrok、大量処理ならFlash-Liteです。
しかし目的が自動化されたサポートなら、eeselはモデルではない残り90%の部分を担います。過去のチケットとヘルプドキュメントから学習し、実際の履歴に対してロールアウトをシミュレーションすることで本番稼働前に解決率の数字を把握できるようにし、Zendesk、Freshdesk、Gorgiasをはじめ100以上のツールに数分で接続します。

モデルに依存しないため、Gemini 3.6 Flashのようなローンチも、あなたが実行しなければならない移行ではなく、静かなコスト削減として反映されます。料金は使用量ベースで1会話あたり0.40ドル、席数に応じた費用はかかりません。カード登録なしの無料トライアルもあります。もう一枚のベンチマーク表を読むより、自分のチケットでの動作を見たいなら、まさにそのためにシミュレーションがあります。eeselを試す。