

Tencent Hy4 previewには2つの価格があり、誰もが引用するのは小さいほうです。APIでは入力100万トークンあたり$0.834、出力100万トークンあたり$2.501で、キャッシュ入力は$0.042です(公式発表)。比較対象のフラッグシップ級オープンウェイトモデルの中では、安い席にいます。
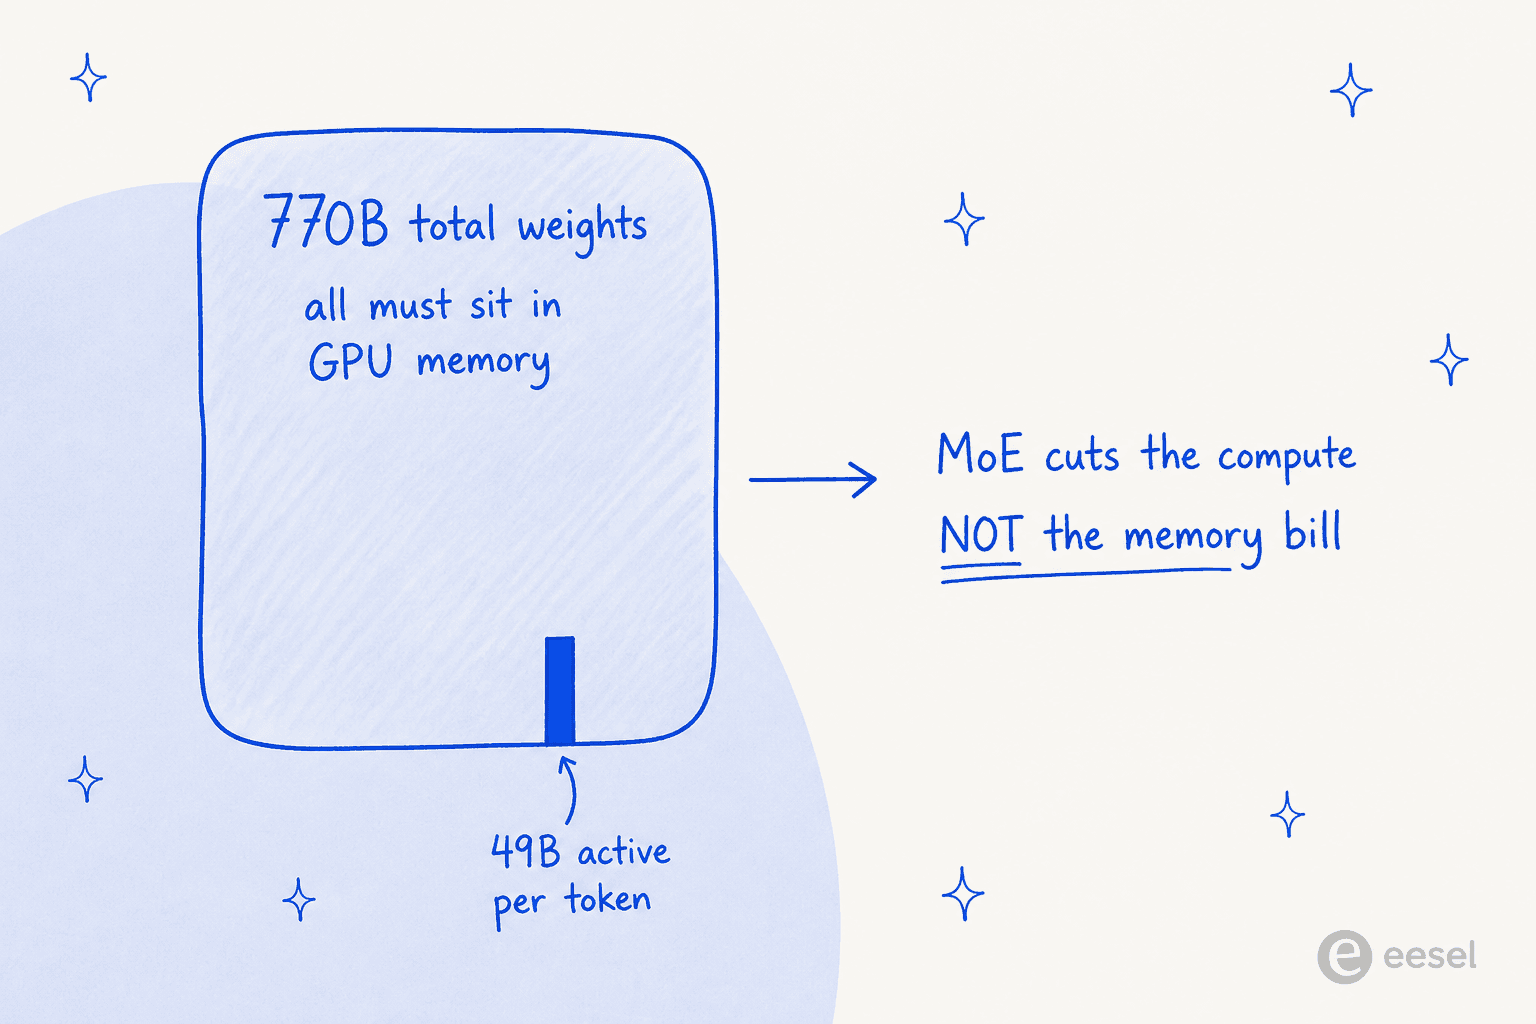
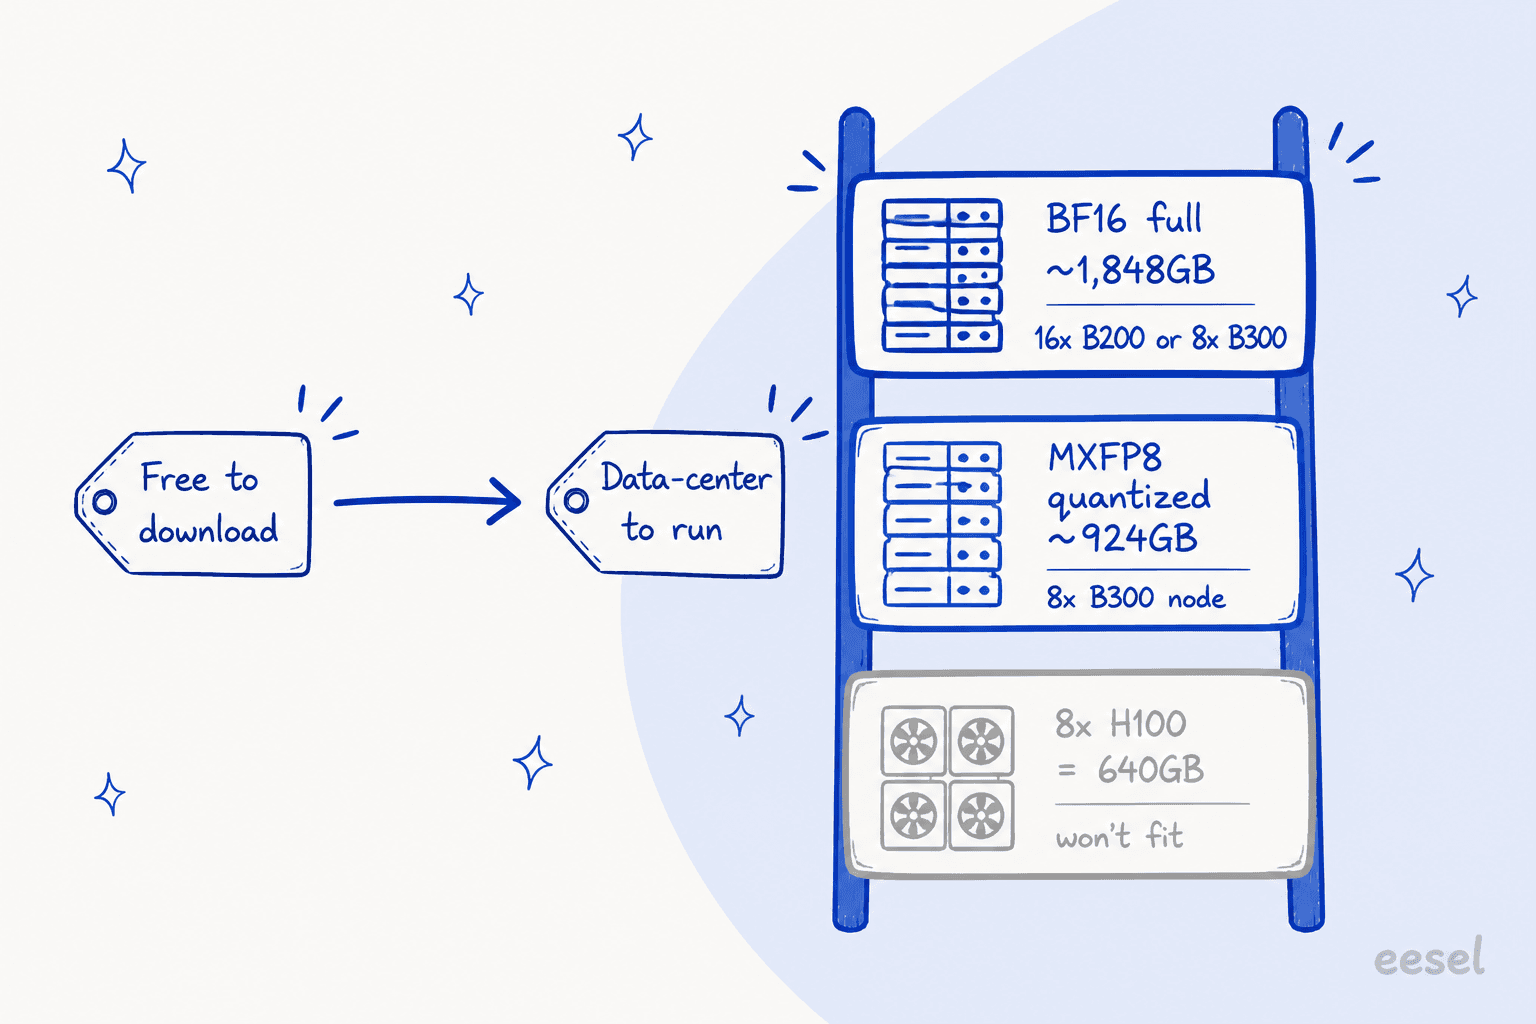
大きいほうの数字はハードウェアです。Hy4は770BパラメータのMixture-of-Expertsモデルで、MoEが減らすのはトークンあたりの計算量であってメモリの請求ではないため、770B分の重みすべてを同時にGPUメモリに載せる必要があります。自前で動かすなら16x B200または8x B300、つまりワークステーションではなくデータセンター級のノードが必要です。
そこで、Tencent Hy4の料金についての率直な見方はこうです。APIで借りるなら競争力のある価格で、Kimi K3やQwen 3.8 Maxより安いものの、DeepSeek V4 Flashのほうがはるかに安くなっています。自分で所有しようとすれば、価格は重い設備投資になります。しかも置き換え対象のHy3より5〜6倍高いので、既存ユーザーは無料アップグレードだと思い込まないほうがよいでしょう。
モデルを用意することではなく、仕事を終わらせることが目的なら、既製のAIチームメイトのほうが、ここで挙げたどの道よりも近道で、しばしば安上がりです。
Tencent Hy4のAPI料金を一覧で見る
私は一週間の大半を、買い手がこうしたツールを実際にどう探すかを考えて過ごしていますが、「Tencent Hy4の料金」は、ほぼ必ず2つの質問です。トークンはいくらか、そして全体を動かすのにいくらかかるか。簡単なほうのトークンの質問から見ていきましょう。
Tencentのローンチ発表から、公表されているAPIレートをそのまま示します。すべて100万トークンあたりです。
| メーター | 100万トークンあたりの価格 | 対象 |
|---|---|---|
| 入力 | $0.834 | 送信するすべてのトークン(プロンプト、コンテキスト、取得したドキュメント) |
| 出力 | $2.501 | モデルが返すすべてのトークン |
| キャッシュ入力 | $0.042 | 同じプロンプトの繰り返し時にキャッシュから提供される入力トークン |
この表から取り出すべき点は3つあります。
第一に、出力と入力の比率は約3:1で、推論の重いモデルとしては普通です。Hy4は推論に重きを置くモデルなので(詳しくは後述)、請求額は出力メーターに偏ります。したがって計画に使うべきは、見出しの$0.834ではなく$2.501の数字です。
第二に、キャッシュレートは$0.042と非常に安いことです。大きなシステムプロンプトや固定のナレッジベースを多数の呼び出しで繰り返すワークロード(エージェント型のほとんどがそうです)では、キャッシュヒットによって実効の入力価格が約20分の1に下がります。これは本物のレバーであり、よく作り込まれたAIエージェントと、ルールベースのチャットボットや、すべてのトークンに満額を払う素朴なラッパーとを分ける要素です。
第三に、恒久的な無料ティアはありません。試用は期間限定(Tencent自社アプリで2週間)で、その後はすべてのトークンが従量課金です。
Tencent Hy4の月額請求を見積もる
100万トークンあたりのレートは実感しにくいものです。月間のおおよその量を入力して、Hy4が他のフラッグシップ級オープンモデルと比べてどれだけかかるかを確認してください。計算ツールは、すべてのモデルでキャッシュなしの標準レートを前提としています。
誰も引用しない価格:自前で動かすコスト
ここが「オープンウェイト」が高くつくところで、Hy4がオープンソースだと盛り上がる前に最も理解しておくべき点です。Apache 2.0ライセンスは、どこで動かしても構わないことを意味します。実際にできるかどうか、そしていくらかかるかを決めるのはハードウェアです。
vLLMレシピは下限をはっきり示しています。BF16の完全な重みは約1,848GB。量子化したMXFP8の重みでも約924GBです。レシピ自身の最小要件は"16xB200 or 8xB300 minimum for weights + KV cache."です。8x H100の単一ノード(640GB)では収まりません。
おおよその数字を当てはめてみましょう。クラウドGPUプロバイダーから8x B200ノードを借りると月に数万ドル規模で、BF16の完全なレシピではそれが2つ必要です。シリコンを直接購入すれば、電源を入れる前から6桁の設備投資になります。これが自前で推論を所有したい人にとっての実際のTencent Hy4の価格で、マシンを非常に高い稼働率で回さない限り、トークンレートをはるかに上回ります。
趣味で大きなモデルを自宅で動かすr/LocalLLaMAの人たちは、称賛と諦めを半々で迎えました。
The amount of people who can drop $5-10k to run these locally is vanishingly small.

彼らが出した量子化の計算は、試してみたくなったときに役立ちます。Q4のGGUFは約450GBなので、現実的な最小メモリは512GBで、256GBのマシンに収まるのは1〜2ビット量子化だけです。ある詳しい内訳はこう率直に述べています。256GBあるなら、GLM-5.3-Flashのほうがずっと向いている、と。ローカル利用では、小さくてよく事後学習されたモデルがコストの議論で勝ち続けます。
価格面での結論:ほとんどの人にとって、Hy4を「使う」とはAPIを使うことです。セルフホストはデータセンターのプロジェクトであって、予算の一項目ではありません。
Tencent Hy4の料金と他のオープンウェイト・フラッグシップの比較
Hy4が競合に対してどこに位置するかを示します。すべて100万トークンあたりで、2026年8月30日に確認しました。
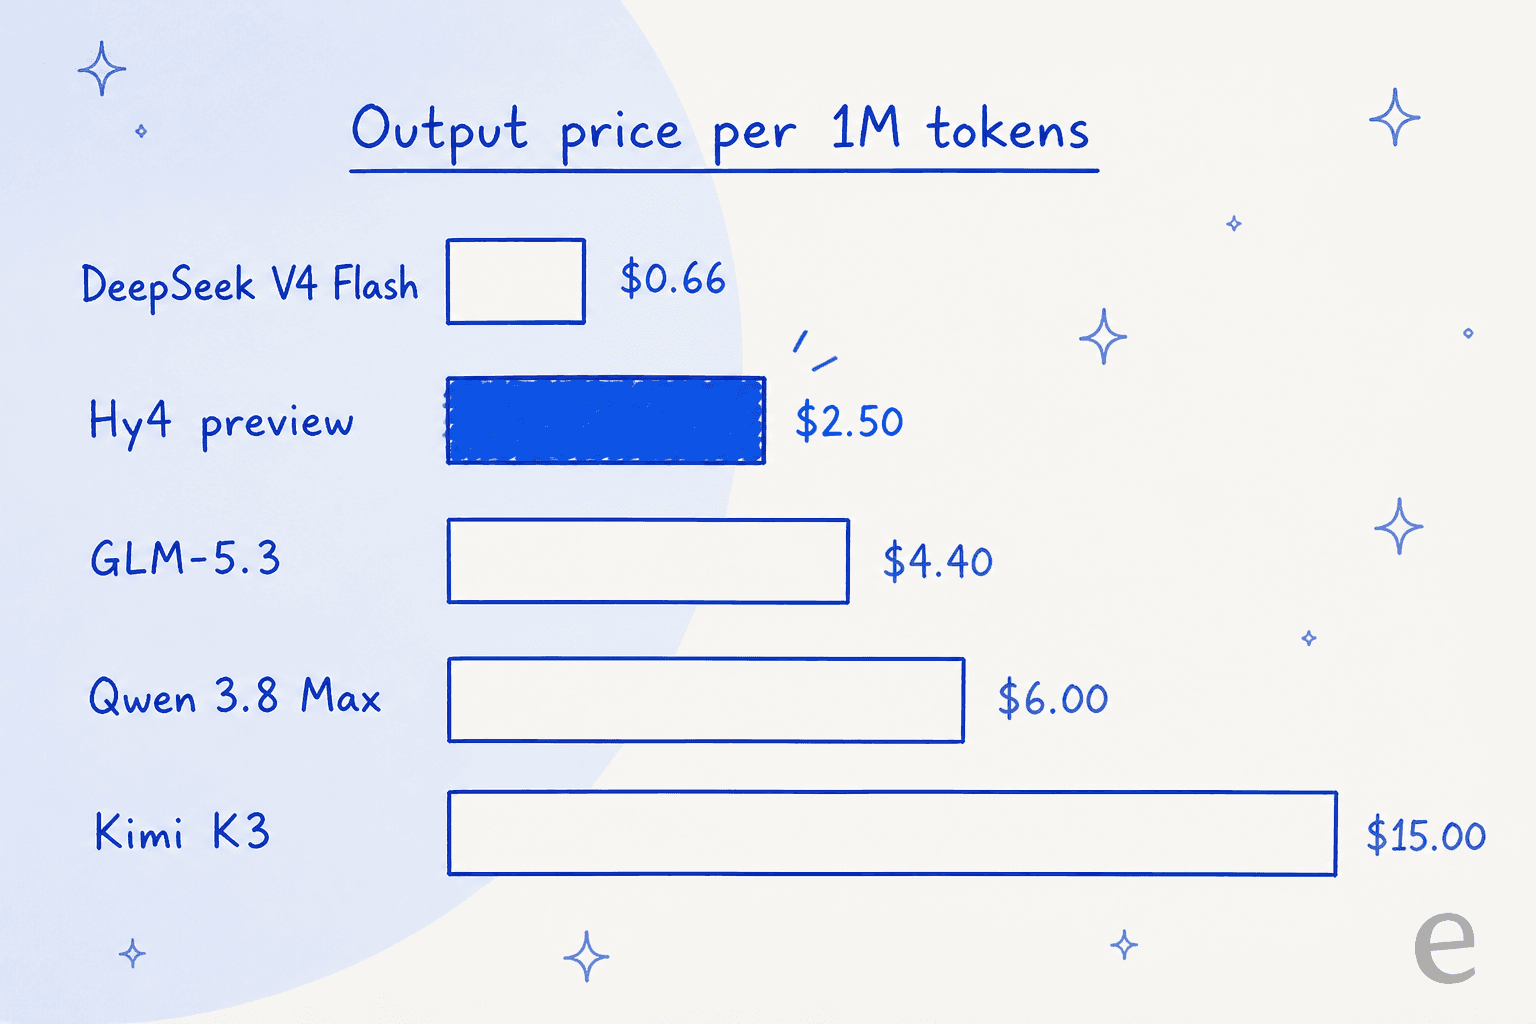
| モデル | 合計 / アクティブパラメータ | コンテキスト | 入力 | 出力 | キャッシュヒット時の入力 |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | 非公開 | なし | $1.40 | $4.40 | $0.26 |
グラフを見ればもっと早く同じことが分かります。請求の大半を占める出力メーターでは、Hy4はこのグループで2番目に安く、DeepSeek V4 Flashだけが下回ります。
この価格には、率直な留保が2つあります。
第一に、Hy4はコミュニティの価格スレッドで指摘されているとおり、Hy3より約5〜6倍高いことです。既存のHy3ユーザーにとっては割引ではなく実質的なコスト増なので、追加の性能が成果を変えるかどうかを判断すべきです。
第二に、DeepSeek V4 Flashは両方のメーターで劇的に安く、多くのエージェント型の作業では「安くて十分」が勝ちます。ある開発者は、実際にテストしたうえでこう率直に述べました。
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
これがHy4の価格上の位置づけの核心です。最安ではなく、最安を狙ってもいません。フロンティア級のコーディングスコアと1Mコンテキストを手に入れられる中価格帯の選択肢であり、DeepSeekやFlash級モデルに対する上乗せ分の価値があるかどうかは、追加の品質があなたの数字をどれだけ動かすかにかかっています。
Hy4を安く(または無料で)試す方法
予算を確保する前に試してみたいなら、低コストの方法がいくつかあります。
- ローンチから2週間無料:TencentのWorkBuddyとCodeBuddyアプリで利用できます。期間中のトークンコストはありません。
- OpenRouter:Hy4 previewをゼロリテンションのデータポリシーで掲載しています。多数のモデルを1つのAPIキーで使いたく、データの扱いを重視する場合に便利です。
- Tencent Cloud TokenHub:すでにTencentのクラウドを使っている場合の、公式の経路です。
多くの買い手にとって賢い進め方は、無料期間に小さなパイロットを実施し、実際の入力と出力の比率を測り(上の計算ツールにその数字を入れてください)、そのうえで、自分のワークロードでHy4のレートがより安いモデルに勝つかどうかを判断することです。
Hy4の価格が実際に買うものと、漏れる場所
料金表には現れない価格の機微がもう1つあります。Tencentは、このpreviewが必要以上に長く推論し、自分の作業を過剰に検証すると率直に認めています。トークン課金のモデルでは、過剰に推論するモデルは、その余分な出力トークンのすべてに支払うことになるため、請求額をひそかに膨らませます。そのため、冗長で検証の多いタスクでのHy4の実効コストは、表示レートが示すより高くなりうるのですが、これは本番に入って初めて表に出ることです。
私が繰り返し戻ってくるのは、この隔たりです。素のモデルレートが教えてくれるのは、トークンがいくらかということだけです。その仕事に何トークン必要か、プロンプトがキャッシュに当たるか、リトライにいくら使うか、すべてをつなぎ込むエンジニアリング時間にどれだけの価値があるかは教えてくれません。これらが実際の請求額を決める数字であり、ベンチマークや価格表には決して現れません。
こうした価格の背景にある仕様やベンチマークをもっと知りたいなら、Tencent Hy4のレビュー全文とHy4の概要で、何に対して支払っているのかを解説しています。
コストだけで比較しているなら、次の内訳記事が自然な続きです。
eeselを試す:トークン計算を飛ばしてチームメイトを迎える
モデル選びをするチームを何年も見てきた私は、こう捉えています。Hy4のようなモデルはインフラで、車のないエンジンです。eesel AIは従業員です。モデルを選び、GPUを用意し、トークンを計量し、検索、ガードレール、連携、評価を自分で構築する代わりに、特定の仕事のためにすぐ働けるAIチームメイトを迎えれば、やり方をすでに心得た状態で着任します。

現在のラインナップは2人のチームメイトです。AIヘルプデスクのチームメイトは、Zendesk、Freshdesk、共有受信箱にある既存のキューに加わり、過去のチケットとヘルプセンターで学習して、返信を下書きまたは送信します。顧客に1通も返信する前に過去のチケットでシミュレーションできるので、スイッチを入れて祈るのではなく、コストと挙動を事前に把握できます。AIブログライターは、長文記事のリサーチ、執筆、SEOを1回の実行でこなします。
どちらも内部ではフロンティアモデルで動くため、GPUを1台も用意せず、料金表を読むこともなく、その能力を利用できます。eesel独自の固定月額料金(500クレジットで月$299から)は、予測しなければならない素のトークンメーターではなく、見通しの立つ数字です。無料で始めることができ、クレジットカードも営業電話も不要です。
トークン単価ではなく、エンドツーエンドの計算が知りたいですか?次の記事が具体的に示します。