

La planificación de plantilla de soporte son cinco pasos en bucle: prever el volumen por intervalo de 30 minutos, multiplicar por el tiempo medio de gestión (AHT), aplicar Erlang C a los canales en vivo, añadir la merma y comprobar la previsión contra lo que ocurrió. Si te saltas uno, llega el fallo clásico: un equipo dimensionado con el promedio diario que se ahoga a las 10 del lunes.
Las cifras se mueven más de lo que la mayoría de equipos espera. Con 60 chats por media hora y 6 minutos de gestión, Erlang C pide 15 agentes en la cola para responder el 80% en 60 segundos, y un 30% de merma convierte eso en 22 personas en el cuadrante. El email y los tickets funcionan distinto, porque pueden esperar: dótalos según la ventana de SLA, no con Erlang C.
De los helpdesks que revisé, solo Zendesk incluye una previsión real (el complemento WFM). Gorgias, Help Scout y HubSpot te dan mapas de calor y exportaciones, y la previsión la construyes en otro sitio. Y un agente de IA cambia las cuentas de una forma que la mayoría de planes pasa por alto: se lleva los tickets fáciles, así que el volumen cae pero el tiempo de gestión del resto sube. eesel lleva desde 2023 con su compañero de IA para helpdesk en colas reales, y el ejemplo más claro que tengo es Norden-Frisia, una naviera alemana de ferris que planifica 10,000 interacciones al mes en temporada alta y reduce de octubre a marzo en lugar de contratar para el verano.
¿Por qué los equipos de soporte siempre van justos?
Soy Riell y trabajo la cola de soporte de eesel cada día. La pregunta detrás de este artículo suele llegar así: "contratamos a dos personas el trimestre pasado, ¿por qué seguimos desbordados cada lunes?". La respuesta casi nunca es solo la plantilla. Es que la plantilla se planificó contra un promedio diario o semanal, y los clientes no llegan en promedio.
Un equipo que recibe 400 tickets al día no recibe 50 por hora a lo largo de una jornada de 8 horas. Puede recibir 90 entre las 9 y las 10, 20 después de comer y un pico a las 6 de la tarde, cuando la gente llega a casa y revisa su pedido. Dimensionar para 50 por hora significa tener exceso de personal media jornada y estar sepultado la otra mitad. Esa es la brecha que intenta cerrar la planificación de cobertura, y la previsión es la matemática que la sostiene.
Los contact centers resolvieron esto hace décadas con la gestión de plantilla (WFM). El vocabulario intimida un poco (Erlang C, merma, ocupación, nivel de servicio), pero cada término responde a una pregunta sencilla, y puedes ejecutar todo el método en una hoja de cálculo. Lo nuevo es que la mayoría de equipos de soporte funcionan hoy sobre un helpdesk y no un sistema telefónico, y una parte creciente de su volumen va primero a un agente de IA. Ambas cosas cambian cómo aplicas el método de siempre.
¿Cómo funciona la planificación de plantilla de soporte?
Todas las herramientas WFM que revisé, de Zendesk WFM a Assembled, ejecutan el mismo proceso. Los proveedores difieren en qué algoritmo prevé el volumen y cuánto puedes ajustar, pero la forma no cambia.
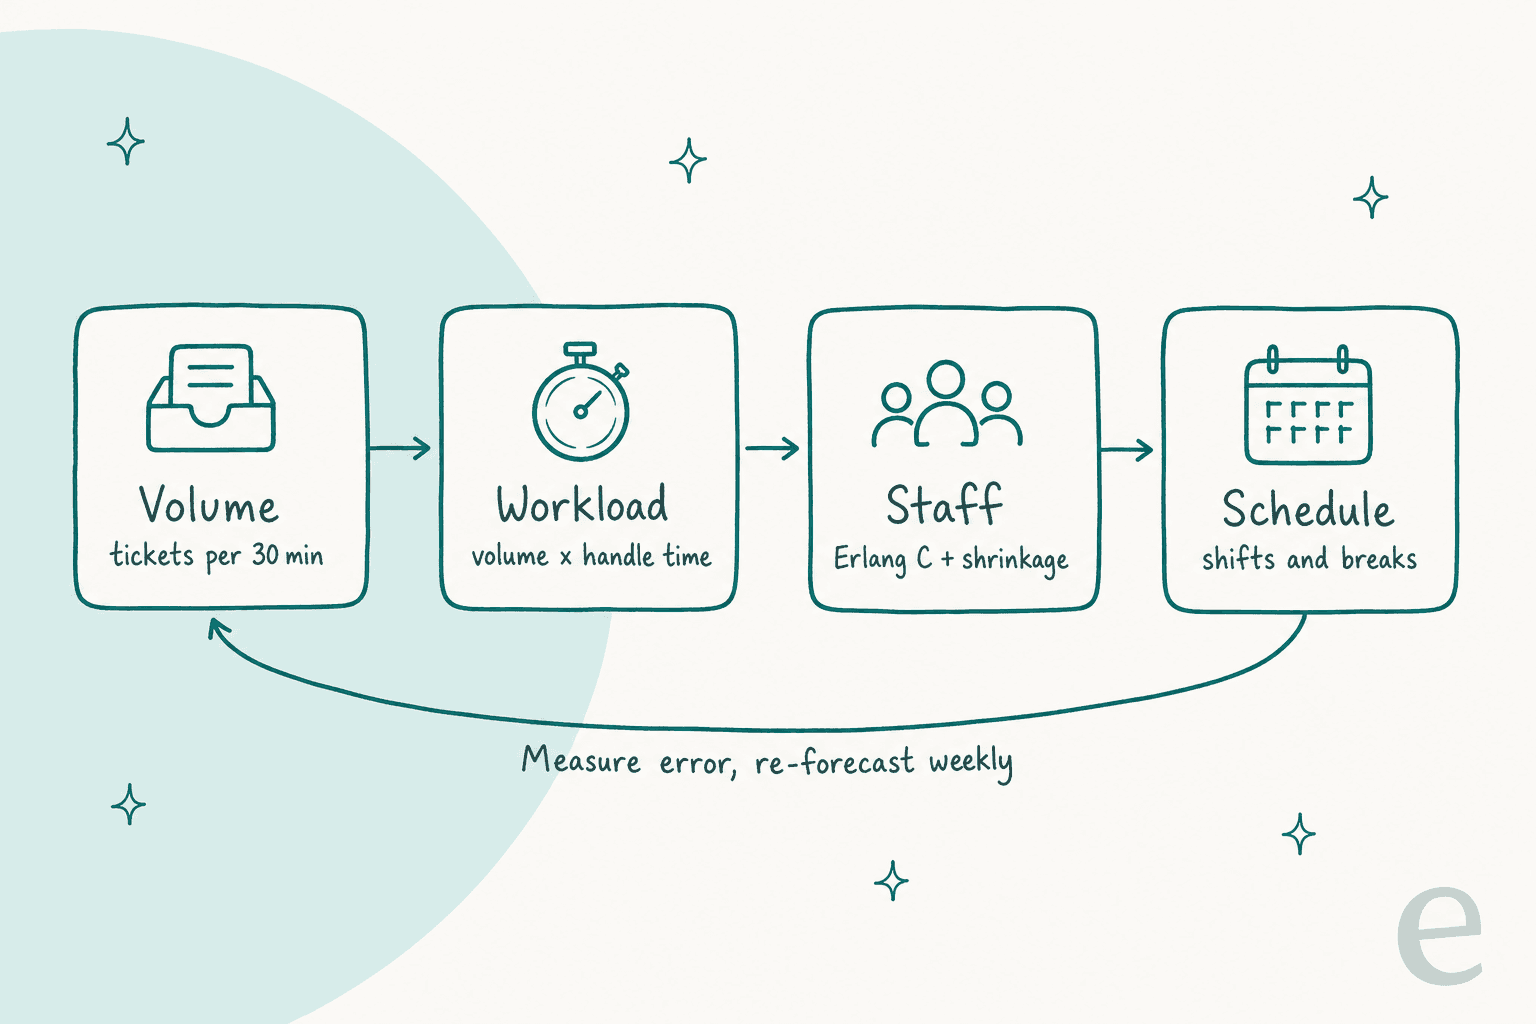
- Volumen: cuántos contactos llegan en cada intervalo de 15 o 30 minutos, por canal.
- Carga de trabajo: volumen multiplicado por el tiempo medio de gestión, para saber cuántos minutos de agente necesita cada intervalo.
- Dotación: cuántos agentes hacen falta para alcanzar tu nivel de servicio, con Erlang C en los canales en vivo, y luego ajustado por la merma.
- Cuadrante: turnos y descansos sobre el requerimiento, para que la cobertura siga la curva.
- Medir: comparar previsión y real en cada intervalo, corregir las entradas y repetir cada semana.
El resto del artículo recorre cada paso y luego mira qué puede hacer tu helpdesk por ti, cómo planificar los picos y qué cambia cuando hay un agente de IA en la cola.
¿Cómo se prevé el volumen de tickets por intervalo?
Empieza por el historial. Necesitas contactos por canal, agrupados por fecha e intervalo de 15 o 30 minutos, en tu propia zona horaria. Zendesk WFM no genera una previsión con menos de un mes de datos y por defecto incorpora seis meses (Zendesk docs). Es también un mínimo razonable para una hoja de cálculo.
El método de batalla es el promedio de N semanas: para el próximo martes de 10:00 a 10:30, promedia los últimos N martes de 10:00 a 10:30. La documentación de Assembled lo llama la opción recomendada por defecto, "generally very accurate for short term forecasting (~1 to 4 weeks)", y sugiere 8 semanas (Assembled forecast models). El algoritmo más simple de Zendesk WFM es la misma idea: el mismo tramo de 15 minutos promediado durante las últimas ocho semanas (Zendesk algorithms).
El promedio de N semanas tiene un punto ciego: no ve tendencias ni estaciones. Si el volumen crece un 5% al mes, un promedio de 8 semanas siempre va por detrás. Ahí entran los modelos más sofisticados. Assembled ofrece una variante con momentum, un modelo estacional que multiplica una línea de crecimiento de 12 meses por patrones de semana del año, día de la semana y 15 minutos, y la biblioteca Prophet de Meta. Zendesk añade XGBoost, LightGBM y una red neuronal LSTM, y elige automáticamente la mejor por flujo de trabajo. Ambos proveedores quieren un año o más de historial antes de que los modelos estacionales y de aprendizaje automático merezcan la pena.
Tres cosas mejoran una previsión más que un mejor algoritmo:
- Limpia la entrada. Zendesk WFM cuenta el spam en su volumen y cuenta un ticket de nuevo cada vez que entra en un flujo de trabajo nuevo (Zendesk best practices). MentorShow, una plataforma francesa de formación online que usa HubSpot, le contó a eesel que recibe entre
5,000y13,000tickets al mes según la época, y que "a large share is not a question at all": avisos de PayPal, respuestas automáticas, respuestas de encuestas, un miembro que escribe "merci". Prevé el trabajo, no el ruido. - Prevé a partir de un motor cuando lo tengas. Una marca DTC de suplementos que habló con eesel en una llamada de ventas gestiona unos
7,000tickets de Gorgias con30,000pedidos al mes, una proporción ticket-pedido del 25-30%, con temporada alta de noviembre a mayo. Si marketing te da una previsión de pedidos, la proporción la convierte en previsión de tickets más rápido que cualquier serie temporal. - Marca los atípicos. Una caída o una publicación viral infla el historial y luego envenena cada promedio que la incluye. Zendesk WFM te deja excluir atípicos y añadir ajustes manuales de volumen para eventos conocidos; Assembled tiene los mismos ajustes y herramientas para atípicos.
Una hoja de cálculo basta para esto en un tamaño medio, como describe una responsable de WFM con 35 agentes:
"I use salesforce reports to build Google sheets forecasts based on volume history. This allows me to analyze the historic volume for specific days of the week and days of the month. Using a rolling last 60 days report, I built several pivot tables breaking down volume by hourly intervals by days of the week. ... For context, we have 35 agents and handle around 400-600 contacts per day, 24/7"

Si aún no tienes un historial limpio, arréglalo antes de comprar una herramienta WFM. Etiqueta de forma consistente, separa los canales y asegúrate de que la clasificación de tickets pone los contactos en la cola correcta, porque una previsión por cola es tan buena como el enrutamiento que la alimenta.
¿Cómo conviertes el volumen en carga de trabajo con el tiempo de gestión?
La carga de trabajo es el volumen multiplicado por el tiempo medio de gestión (AHT): los minutos que un agente dedica a un contacto, incluido el trabajo posterior. Sesenta chats en media hora a 6 minutos cada uno son 360 minutos de agente, o el tiempo de 12 agentes si cada uno hiciera solo chat durante los 30 minutos completos. Los contact centers llaman a ese número intensidad de tráfico, medida en Erlangs: 60 × 6 ÷ 30 = 12 Erlangs.
Dos ajustes importan en los canales de soporte:
- Concurrencia en el chat. Si los agentes atienden dos chats a la vez, el tiempo de gestión efectivo por chat se reduce aproximadamente a la mitad. Pero la configuración y la realidad difieren. Un profesional de WFM sitúa la concurrencia real "between 1.2 and 1.6" donde los agentes pueden atender dos chats, y el AHT del chat en "maybe 130% of voice at least" (Reddit thread). Usa tu promedio medido, no el tope.
- El AHT varía según el tipo de ticket. Un restablecimiento de contraseña lleva un minuto; una disputa de facturación, veinte. Un promedio de ambos sirve para una mezcla estable y engaña cuando la mezcla cambia, que es justo lo que pasa cuando llega un agente de IA (más abajo).
Tu helpdesk suele informar algo parecido al AHT, aunque no siempre lo mismo. Las métricas de duración de Zendesk, por ejemplo, separan las métricas en horario laboral del tiempo natural, y el tiempo total de resolución no es tiempo de gestión. Si no puedes obtener el tiempo de gestión real, cronometra a mano una muestra de tickets durante una semana. Es mejor que adivinar.
¿Cuántos agentes dice Erlang C que necesitas?
La carga de trabajo te da el mínimo. Dotar exactamente 12 agentes para 12 Erlangs significa un 100% de ocupación y una cola que crece sin parar, porque los contactos no llegan en fila ordenada. Erlang C es la fórmula que responde a "¿cuántos agentes necesito para que el X% de los contactos se atienda en Y segundos?" con llegadas aleatorias. Zendesk WFM calcula el personal necesario por intervalo de 15 minutos con "a modified version of Erlang C" (Zendesk docs), y Assembled usa Erlang C para sus canales síncronos.
Las entradas son las tres que ya tienes más dos objetivos:
- Nivel de servicio: la proporción de contactos atendidos dentro de un tiempo objetivo, como el 80% en 60 segundos.
- Ocupación máxima: la proporción del tiempo conectado que los agentes pasan con contactos. Zendesk la expone como ajuste; planificar en torno al 75-85% es habitual, porque un 95% de ocupación quema a la gente rápido.
Aquí va el ejemplo de los 60 chats resuelto. Con 12 Erlangs, Erlang C dice que 15 agentes te dan un 80,6% en 60 segundos, una espera media de unos 38 segundos y un 80% de ocupación. Con 14 agentes, el nivel de servicio se queda bastante corto. Ese salto de 12 a 15 es el coste del azar, y se reduce a medida que crece el volumen: las colas grandes son eficientes, las pequeñas no. Con 6 chats por media hora (1,2 Erlangs) necesitas 3 agentes para el mismo objetivo, con un 40% de ocupación. Zendesk lo dice en su propia documentación: para flujos de trabajo de bajo volumen, "Erlang C may give slightly higher staffing recommendations" (Zendesk best practices).
Erlang C es para colas en vivo, no para email
Erlang C asume que un cliente está esperando en una cola ahora mismo. El chat y el teléfono encajan. El email y los tickets no, porque el cliente no está sentado esperando; espera una respuesta en horas. Un profesional de WFM planteó el problema de las colas de tickets sin rodeos:
"If you have very consistent handle times and a good way to capture it, you basically have a live queue and Erlang C works really well. Most of the time, that is pie in the sky because, for example, Zendesk tickets can take 30 seconds or 45 minutes…so how do you get a good handle time for those tickets?"
Para el soporte asíncrono, dota según la ventana de SLA. La documentación de Assembled explica por qué: su antiguo modo por intervalos asumía que el trabajo que llegaba en un intervalo de 15 minutos se despachaba en ese intervalo, lo que "significantly over-staffs async work". Su modo nuevo reparte la carga de trabajo a lo largo del objetivo de respuesta, de modo que 100 emails que llegan a las 9 con un SLA de 24 horas no necesitan todos un agente a las 9 (Assembled async staffing). Zendesk WFM hace algo parecido con el email que llega fuera de horario: redistribuye ese volumen a lo largo de la ventana de primera respuesta del siguiente periodo abierto.
En una hoja de cálculo, la versión asíncrona es sencilla: suma la carga de trabajo del día en horas de agente, divide entre las horas productivas por agente y comprueba que el atraso nunca envejece más allá de tus políticas de SLA. Si lo hace en cierta hora, esa hora necesita más gente.
Calcula tu dotación con una calculadora de Erlang C
La calculadora de abajo ejecuta Erlang C para un intervalo de 30 minutos de un canal en vivo y luego añade la merma. Cambia al modo email para las colas que pueden esperar. Los campos de IA te permiten probar qué pasa cuando un agente asume parte del volumen y los tickets restantes duran más.
Valores por defecto: 60 chats por media hora, AHT de 6 minutos, 80% atendido en 60 segundos, 30% de merma y un agente de IA que resuelve el 40%, con 8 minutos de gestión para el resto.
Con los valores por defecto, el plan solo con humanos necesita 15 agentes en la cola de chat y 22 en el cuadrante. Con la IA asumiendo el 40% de los chats y los chats restantes durando 8 minutos, son 13 en la cola y 19 programados. Una tasa de resolución del 40% recortó el cuadrante en un 14%, no en un 40%. Es lo más útil que muestra la calculadora, y la razón por la que nunca planificaría una congelación de contrataciones a partir de la cifra de desvío de un proveedor de IA.
¿Cuánta merma conviene planificar?
Erlang C te dice cuántos agentes deben estar en la cola. La merma es la diferencia entre eso y cuántos necesitas en el cuadrante: descansos, reuniones, formación, coaching, bajas por enfermedad, vacaciones y tiempo conectado pero no disponible. La fórmula es scheduled = required ÷ (1 - shrinkage). El ejemplo de Zendesk: 100 agentes productivos con un 40% de merma significan 167 en el cuadrante (Zendesk docs).
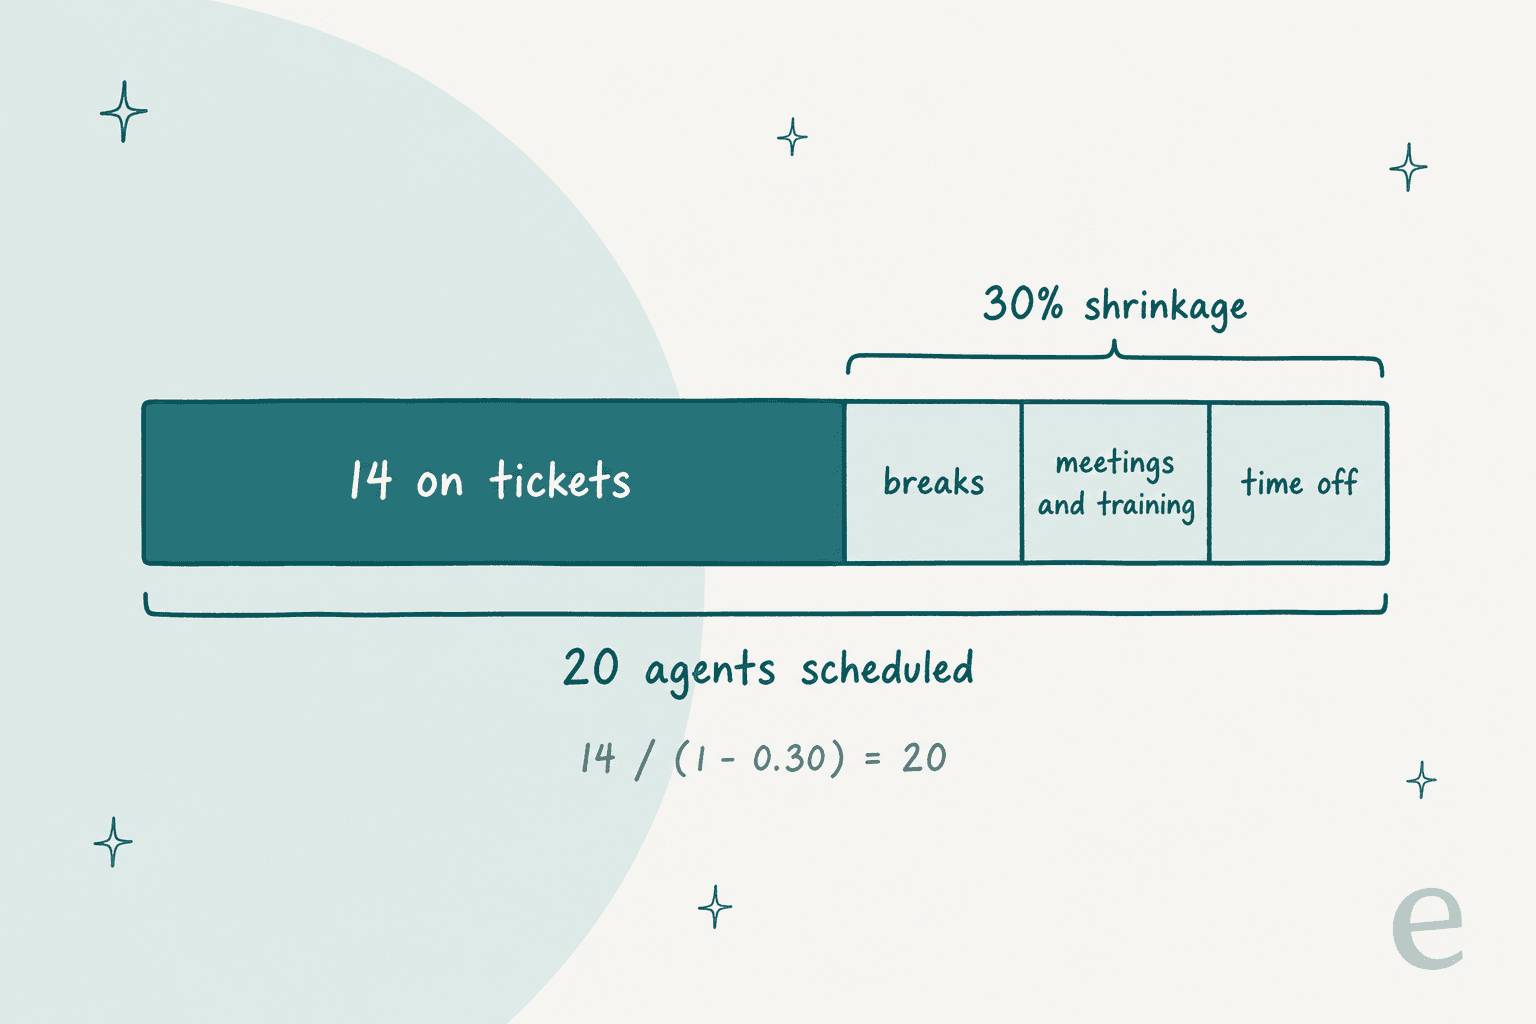
El número que usan los equipos suele ser demasiado bajo. Circulan dos definiciones, y mezclarlas es una fuente común de falta de personal:
- Merma estrecha cuenta solo el tiempo programado que no se cumplió, aproximadamente
100% - adherence. Assembled usa esta definición y programa descansos, vacaciones y reuniones por separado; su documentación da un 5-10% para voz, un 10-15% para omnicanal y un 15%+ para equipos complejos digital-first (Assembled staffing docs). - Merma total cuenta todo lo que saca de la cola a un agente pagado. Es la definición que necesitan la mayoría de previsiones en hoja de cálculo, y es mucho mayor:
"A 15% shrinkage rate seems low. Breaks alone account for approximately 6.25% on a standard 8-hour schedule. Most of our teams average shrinkage in the low 30% range once you factor in absenteeism, PTO, meetings, training, etc."
La merma también se mueve. Otro profesional de r/workforcemanagement señala que la merma del lunes suele ser la más alta y que enero es alto para su equipo (thread). Los nuevos fichajes también cuentan: alguien en sus primeros meses atiende menos contactos y más sencillos, así que un equipo que acaba de contratar a cinco personas tiene menos capacidad de la que dice su plantilla. Si contratas antes de un pico, planifica el tiempo de rampa de los agentes y un buen plan de incorporación estacional en lugar de contar a un recién llegado como agente completo en la primera semana.
¿Qué precisión debe tener una previsión de soporte?
La suficiente para que el cuadrante construido sobre ella alcance tu nivel de servicio. Suena a evasiva, pero es la prueba correcta, porque una previsión que falla un 2% en el total semanal puede estar equivocada en las horas que importan.
Las medidas habituales son el error absoluto medio (MAE) y el error porcentual absoluto medio (MAPE). El informe Forecast Management de Assembled etiqueta como "most accurate" el modelo con menor MAE y muestra también por separado el error por exceso y por defecto, ya que quizá prefieras un modelo que rara vez prevé de menos (Assembled docs). También avisa de que el MAPE falla cuando el volumen real es cero, algo habitual en intervalos pequeños. Zendesk WFM tiene una página de previsión frente a real en acceso anticipado para revisar el escenario activo.
Qué es "bueno" depende del horizonte. La regla general de un profesional:
"Unless you tie forecast accuracy to a specific business metric, you setup the forecasting team for failure. Also 3% intra-day (in)accuracy? Maybe annual 3%, 5% monthly, 10% weekly and 25%-40% daily."
Dos hábitos detectan la mayoría de problemas. Primero, revisa el intervalo, no solo el total: "Many wfm teams only look at the daily total to forecast as a kpi, which doesn't help if the call arrival pattern is wrong" (Reddit). Segundo, usa los datos reales como entradas. Si el plan asume 2 chats a la vez y un 15% de merma y el equipo entrega 1,4 y 30%, la previsión prometerá un nivel de servicio que nunca alcanzarás. Vigila el tiempo de primera respuesta y la antigüedad del atraso por intervalo junto a la previsión; son las primeras métricas que te dicen que las entradas se han desviado.
¿Qué prevén realmente Zendesk WFM y otros helpdesks?
Aquí es donde más se diferencian los equipos de soporte de los call centers. Los sistemas telefónicos llevan décadas incluyendo WFM. Los helpdesks, en su mayoría, no. Esto es lo que encontré en la documentación de cada proveedor.
Zendesk WFM
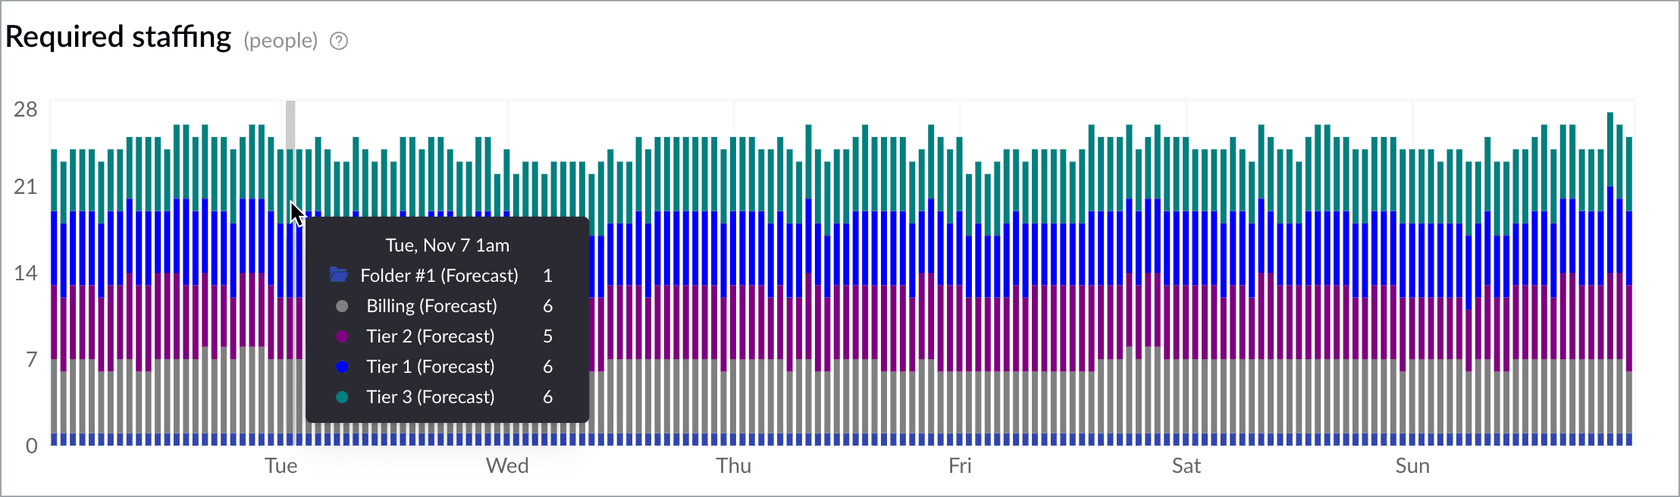
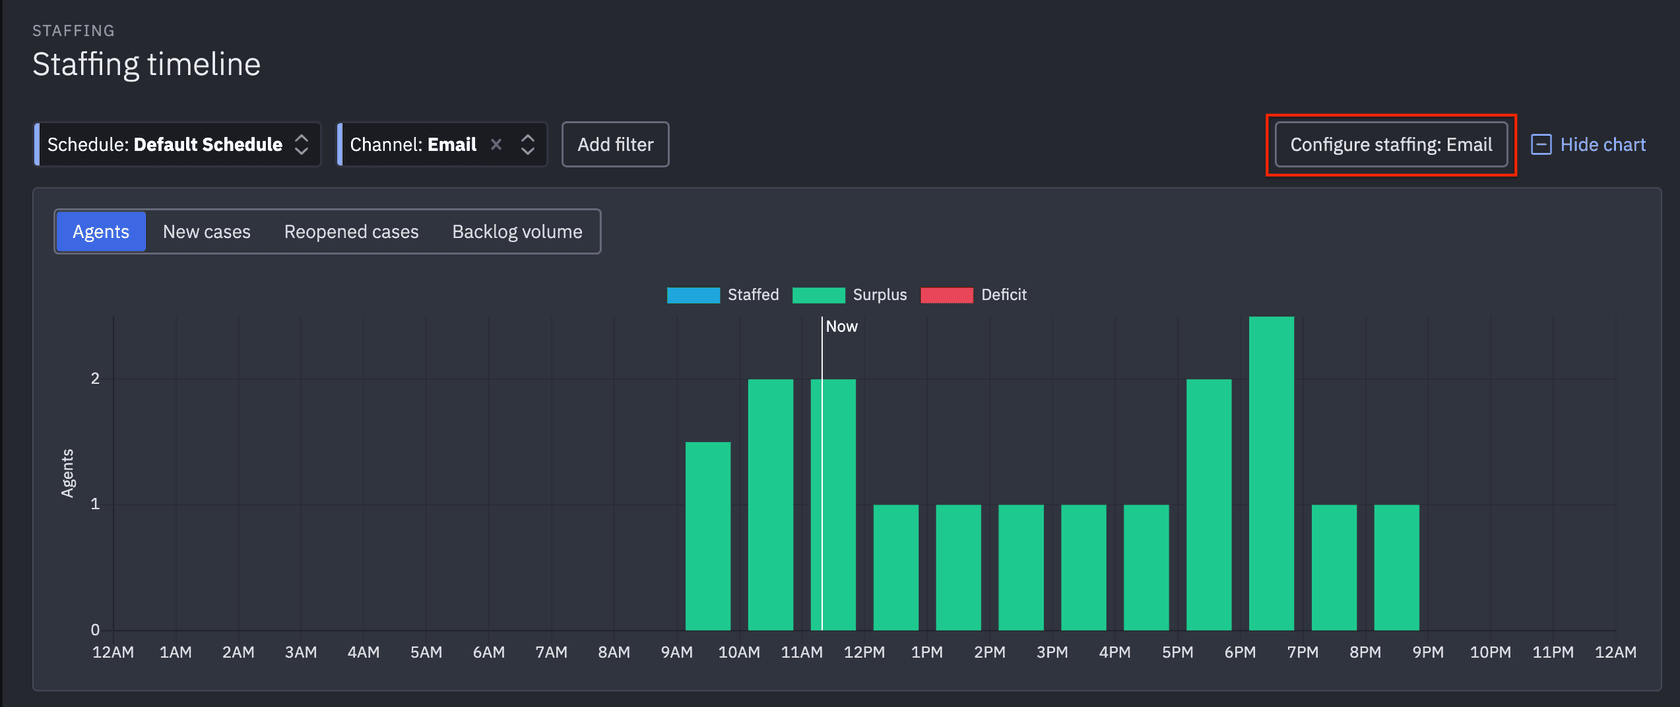
Zendesk es el único helpdesk aquí con una previsión nativa, y es de verdad. Dentro del complemento WFM tienes:
- Previsiones de volumen hasta con un año de antelación, en intervalos de 15 minutos, a partir de seis meses de datos de tickets migrados (hasta dos años si lo pides).
- Elección de algoritmo por flujo de trabajo: promedio de ocho semanas, promedio de ocho semanas con momentum, Prophet, XGBoost, LightGBM y una red neuronal LSTM. WFM los prueba todos y elige el mejor, y puedes anularlo (Zendesk algorithms).
- Personal necesario a partir de un Erlang C modificado, con ocupación, concurrencia de chat, AHT, objetivo de SLA, merma y dotación mínima (por defecto 1 FTE) como entradas.
- Escenarios para probar hipótesis sin tocar la previsión activa, además de ajustes de volumen y exclusión de atípicos (Zendesk setup guide).
Los límites que conviene conocer: WFM no prevé flujos de trabajo combinados (la solución es una carpeta que los suma), el spam cuenta en el volumen y ninguna de las documentaciones de previsión menciona separar las resoluciones del agente de IA del volumen humano, así que un despliegue de IA se modela con ajustes manuales. En cuanto al coste, el complemento se compra para todos los agentes de la cuenta, y la página de precios de Zendesk lista el Workforce Engagement Bundle (WFM más QA) a $50 por agente al mes, con pago anual (Zendesk pricing). Para ver los planes base completos, consulta mi desglose de los precios de Zendesk.
Assembled
Assembled no es un helpdesk; es una herramienta WFM independiente que se conecta con Zendesk, Salesforce, Gorgias y otros. Ejecuta el mismo proceso con modelos de N semanas, momentum, estacionales y Prophet, intervalos de dotación de 30 minutos por defecto, Erlang C para los canales en vivo y un modo de ventana de SLA para el email. La página de precios lista WFM a $25 (Core), $45 (Pro) y $75 (Enterprise) al mes, y los documentos de ayuda sitúan los modelos de previsión, los informes de precisión y la dotación asíncrona por SLA en Pro y Enterprise (Assembled pricing). El marketing de Assembled dice que sus planes de dotación tienen en cuenta la capacidad de los agentes de IA junto a los humanos, aunque no encontré un documento de ayuda que explique el mecanismo. Si estás comparando opciones, traté las alternativas a Assembled por separado.
Gorgias
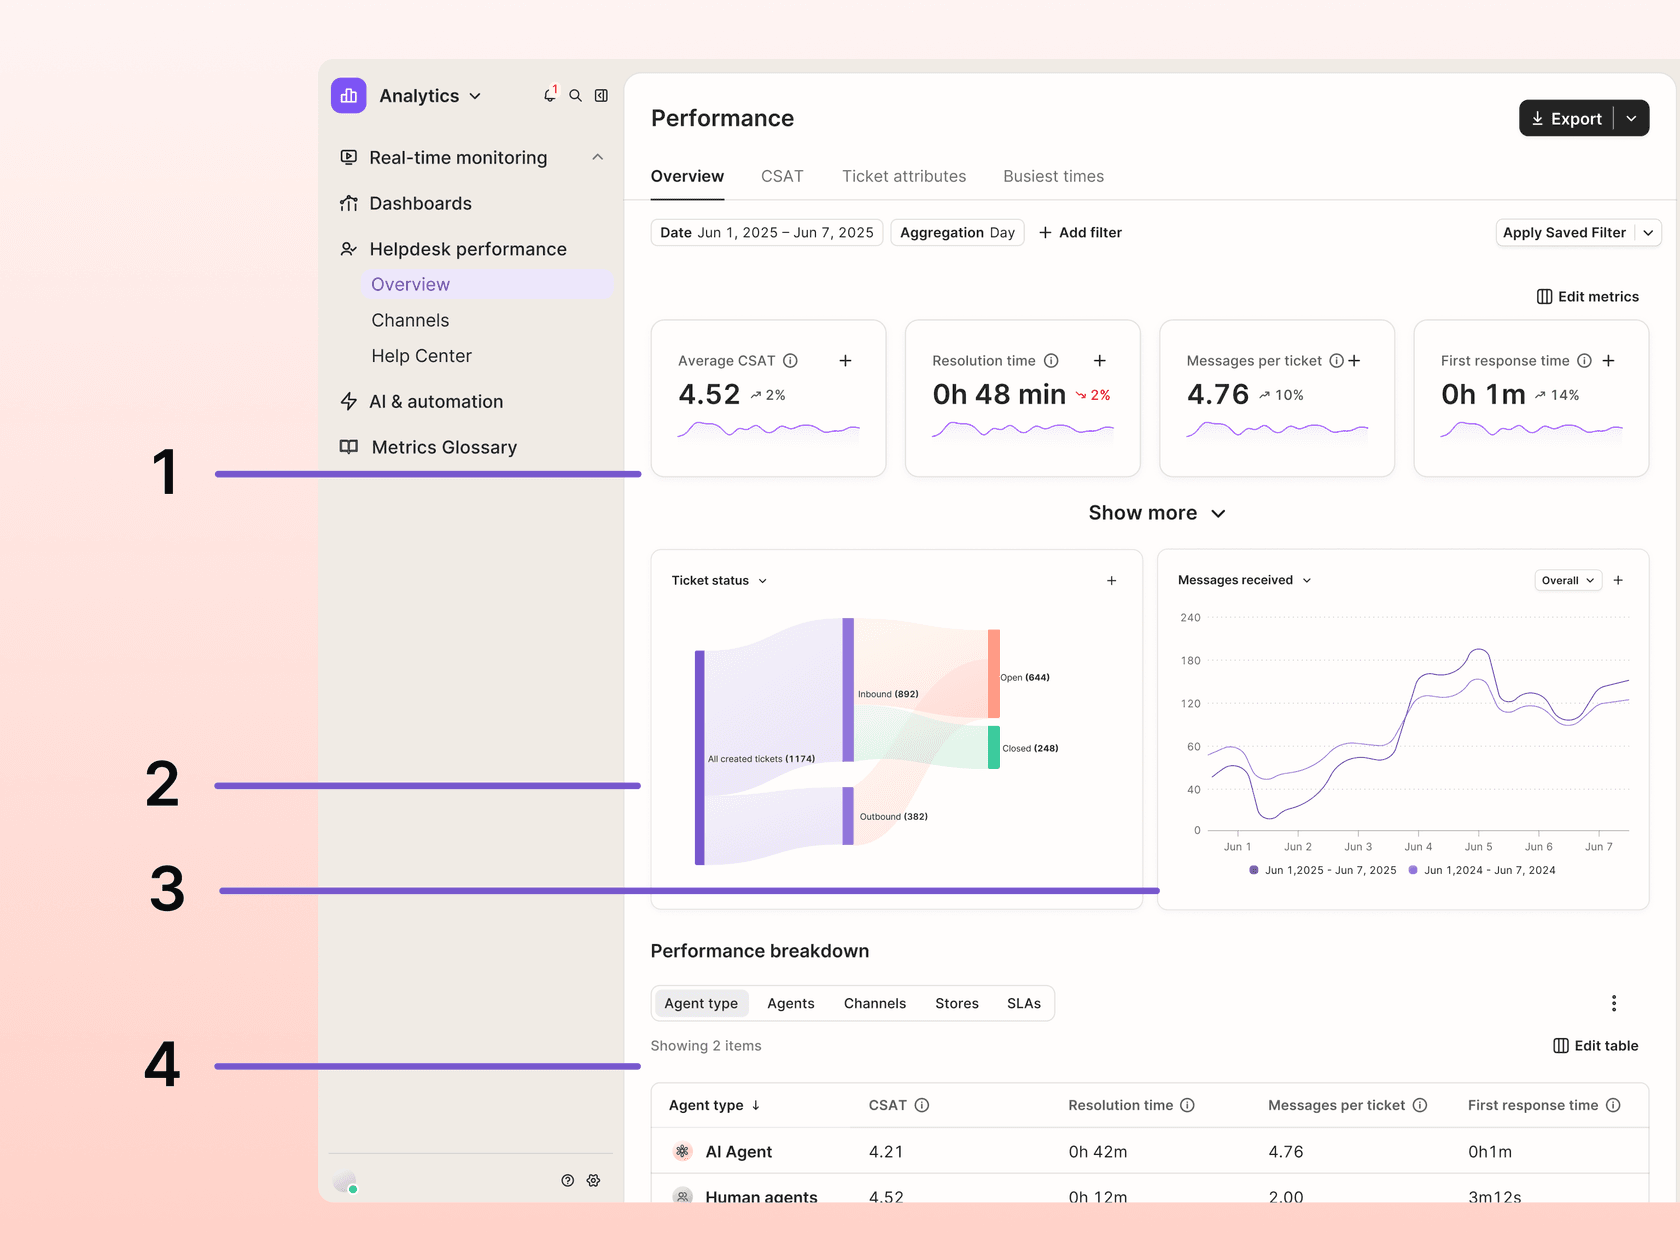
Gorgias no tiene previsión de volumen, pero sus informes te dan la mayoría de las entradas. La pestaña Busiest times muestra una métrica (tickets creados, mensajes recibidos y otras) como un mapa de calor por hora y día de la semana con tu horario laboral marcado, y el propio consejo de Gorgias es que "A dark cell outside your business hours is demand arriving when nobody is scheduled" (Gorgias docs). Los gráficos de tendencia pueden superponer el año anterior para separar un cambio real de un patrón estacional, y cada informe se exporta a CSV hasta 365 días por rango. Si usas el AI Agent de Gorgias, su informe te da una tasa de automatización que puedes usar para separar volumen de IA y humano.
Help Scout
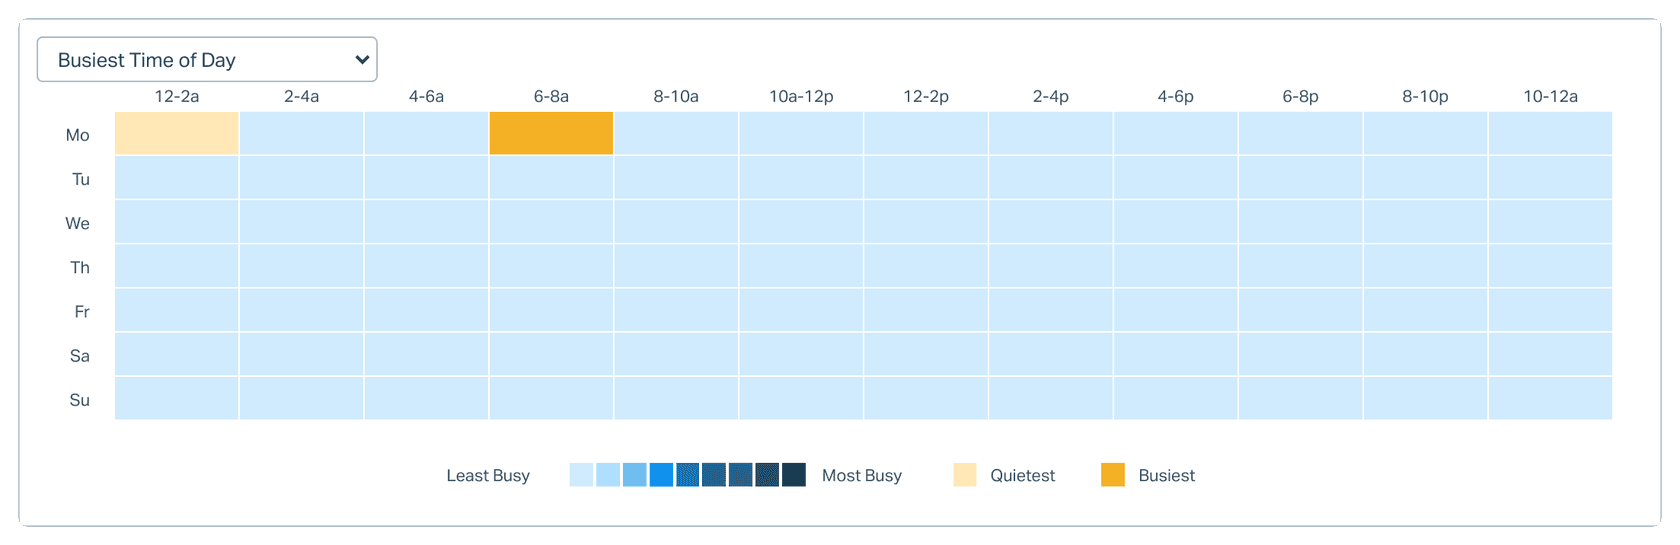
Los informes de Help Scout son solo históricos, y su documentación dice que no puedes crear informes personalizados en la aplicación. El informe All Channels incluye un mapa de calor Busiest Time of Day que Help Scout describe como "helpful for hiring" (Help Scout docs). Los planes Standard informan de dos años de historial; Plus y Pro, de toda la vida de la cuenta. La exportación es CSV o XLSX a nivel de conversación, justo lo que quieres para una previsión, con una trampa: las marcas de tiempo del XLSX están en UTC mientras que el CSV usa la zona horaria de tu empresa. Si agrupas con la equivocada, tu hora pico se desplaza. Más sobre los límites de los planes en mi artículo sobre los precios de Help Scout.
HubSpot Service Hub
La herramienta de previsión de HubSpot es una herramienta de ingresos basada en etapas de negocio, no en tickets. Lo más parecido para soporte es una opción de línea de tendencia "predictive" en los ajustes de informes de la suite de analítica de servicio, aplicada a gráficos históricos (HubSpot docs). Aun así, las entradas útiles están ahí: un informe de volumen de soporte, un informe de hora del día "to help inform team planning" e informes de planificación como Maximum available rep que muestran si había gente trabajando en los picos. Si usas el Customer Agent de HubSpot, ten en cuenta el retraso de 72 horas antes de que se fijen las resoluciones basadas en respuesta, por lo que la tasa de resolución de esta semana siempre parece baja.
Comparativa
| Previsión de volumen nativa | Detalle por intervalo | Cálculo de dotación | División de IA en informes | Exportación para hoja de cálculo | |
|---|---|---|---|---|---|
| Zendesk (complemento WFM) | Sí, hasta 1 año | 15 min | Erlang C modificado, merma, ocupación, concurrencia | No en los documentos de previsión | Sí, más importaciones |
| Assembled | Sí, 4 modelos | 15-30 min | Erlang C (en vivo), ventana de SLA (asíncrono) | Solo afirmaciones de marketing | API o importación CSV |
| Gorgias | No | Mapa de calor por hora | Ninguno | Tasa de automatización del AI Agent | CSV, 365 días por rango |
| Help Scout | No | Mapa de calor de 2 horas | Ninguno | No cubierto | CSV o XLSX, nivel de conversación |
| HubSpot Service Hub | No (solo línea de tendencia) | Informe de hora del día | Ninguno | Informes del Customer Agent | Exportación sin resumir |
Si estás en uno de los tres últimos y tu equipo tiene menos de 20 agentes, una hoja de cálculo con el método de arriba basta. Más allá de eso, o con varios canales y turnos, una herramienta WFM empieza a amortizarse en horas que no pasas reconstruyendo tablas dinámicas. Para equipos que evalúan el propio helpdesk, mi recopilación de helpdesks para tickets de alto volumen también cubre la parte de informes.
¿Cómo se planifican los picos y las temporadas altas?
Una previsión construida con promedios siempre fallará el pico, por diseño. La solución es planificar el pico como su propio escenario. Yo mantendría tres a mano para cada periodo pico: normal, +30% y +60% de volumen, cada uno con su propia dotación y cuadrante. No dotas para el peor caso; decides de antemano qué harás cuando lo veas venir (horas extra, personal polivalente de otros equipos, un plan de desbordamiento o una pausa en el trabajo no urgente).
Antes de dotar un pico, pregunta por qué ocurre:
"Why is it spiky? Do you send bills to customers all on the same day? Does your ad campaign run at a certain pattern? Identify "the why" in spikes and see if you can educate on the impacts to the call center."
La mayoría de picos tiene un motivo que alguien en la empresa ya conoce: un ciclo de facturación, un email promocional, un lanzamiento de producto, una fecha límite de envío. Lleva esas fechas al calendario de soporte y añádelas como ajustes manuales. Para el comercio minorista, mis guías sobre los picos de soporte en festivos y la IA para el Black Friday profundizan en la avalancha de noviembre a diciembre.
Los negocios estacionales afrontan la versión más difícil, porque contratar para el verano significa mantener a la gente durante el invierno. Norden-Frisia, la naviera que mencioné en el TL;DR, recibe la mayoría de las preguntas de pasajeros entre mayo y septiembre: horarios, coches, baca, bicicletas. Contratar y formar a un equipo que crece y se reduce con la temporada era caro y lento, así que antes de su primera temporada alta el equipo pasó su plan de eesel a 10,000 interacciones al mes, con el acuerdo de reducirlo de octubre a marzo. El compañero de IA responde las preguntas repetidas desde las FAQ de Zendesk, y todo lo que no puede cerrar se convierte en un ticket de Zendesk para el equipo humano. Es una decisión de plantilla tanto como de software.
Rúngne, una marca noruega de ropa de escalada que usa Gorgias, muestra la versión de semana a semana. Entre el 8 de agosto y el 8 de septiembre de 2026, eesel gestionó unos 2,100 tickets para ellos, entre unos 300 y 780 por semana. Una oscilación de ese tamaño dentro de un mes es justo lo que se le escapa a un cuadrante basado en promedios, y por eso las revisiones intradía importan incluso con una previsión decente. Los equipos que cubren varias zonas horarias también pueden suavizar los picos con soporte follow-the-sun, pasando la cola entre regiones en lugar de estirar un turno.
¿Cómo cambia un agente de IA la previsión de personal?
Esta es la parte que la mayoría de guías de previsión aún no ha alcanzado. Cuando un agente de IA responde parte de la cola, la previsión antigua se equivoca en dos direcciones a la vez.
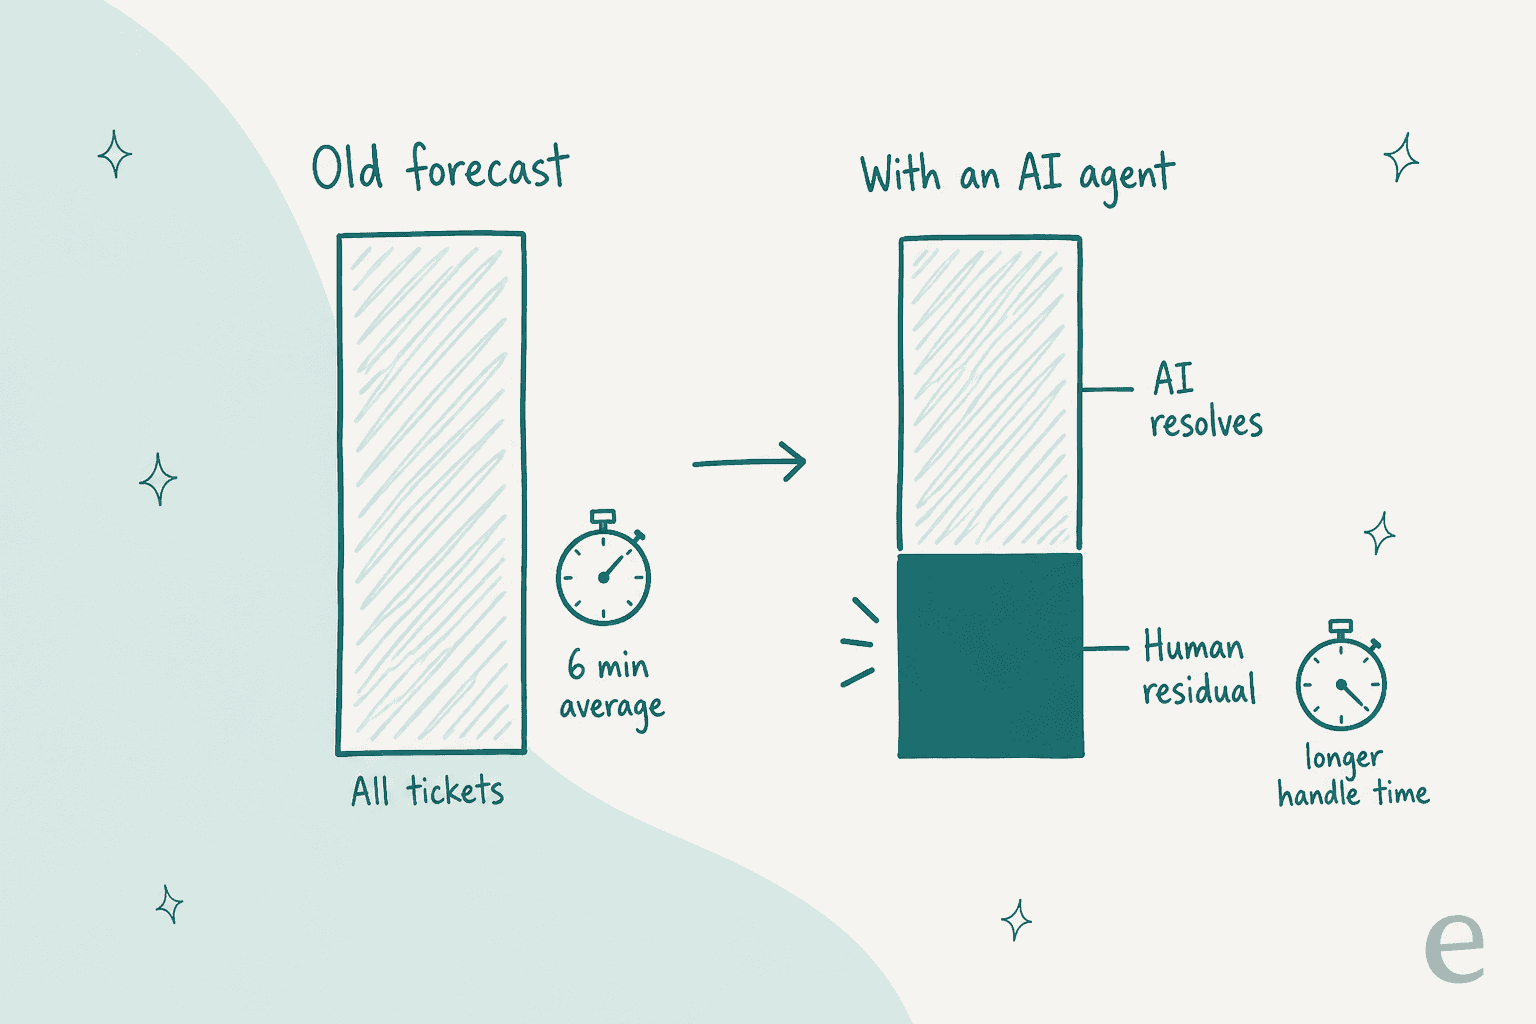
El volumen hacia tu equipo baja, porque la IA resuelve las preguntas de estado de pedido, contraseña y políticas. Pero esos eran también tus tickets más rápidos, así que el tiempo de gestión de lo que queda sube. Si restas la tasa de resolución de la IA del volumen total y mantienes el AHT antiguo, te quedarás corto de personal. La calculadora de arriba muestra el tamaño del efecto: una tasa de resolución del 40% con un cambio de AHT de 6 a 8 minutos recorta el cuadrante en un 14%.
Así preveería yo con un agente de IA en la cola:
- Prevé dos colas, no una. Las llegadas totales como antes, luego el residuo humano como serie propia, con su propio AHT medido en los tickets que la IA pasó.
- Usa resolución, no desvío. Una conversación que terminó sin una persona no siempre es un problema resuelto; algunas vuelven un día después por otro canal. La diferencia entre tasa de desvío y de resolución es el error de tu previsión.
- Vuelve a medir unas semanas tras cada cambio. Temas nuevos para la IA, un canal nuevo, un cambio de política: cada uno desplaza el residuo. El promedio de 8 semanas de Assembled se pondrá al día, pero despacio.
- No congeles contrataciones por la cifra estrella de un proveedor. Haz primero un piloto de soporte con tus propios tickets y planifica solo sobre el residuo que mediste.
La IA también necesita un alcance claro para que esto funcione. Un responsable de CX de una marca DTC con unos 7.000 tickets al mes le dijo al equipo de ventas de eesel que revisar a mano cada respuesta de la IA anularía el sentido, y añadió:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eso es también lo que hace estable la previsión. La configuración de Rúngne es un buen modelo: un agente de eesel clasifica y etiqueta cada ticket, otro deja borradores para el equipo y un tercero responde solo los temas que eligió el equipo (política de envíos y devoluciones, dónde está mi pedido, stock, preventas). En ese mes, el agente que respondía actuó en unos 280 de unos 2.100 tickets, "around one ticket in seven". Como el alcance es una lista fija de temas, el residuo es predecible: sabes qué tipos de ticket salieron de la cola humana y puedes medir el nuevo AHT de lo que se quedó. Los profesionales de WFM llegan a lo mismo en el lado de la previsión:
"I wouldn't trust an LLM to replace forecasting, Erlang/staffing calculations, shrinkage modelling or proper statistical analysis. Those should still be handled by the right models, tools and validated data. ... Basically: it would let AI explain the spreadsheet, not become the spreadsheet."
Estoy de acuerdo. Usa la IA para quitar trabajo de la cola y explicar los números, y deja la previsión en datos reales. Si te preguntas si la IA cambia más a fondo la forma de tu equipo, mis artículos sobre cómo montar un equipo de soporte con la IA primero y sobre si la IA puede sustituir a tu equipo retoman ese hilo. Para el lado del dinero, compara el coste por resolución con y sin IA.
Prueba eesel
Si tu previsión insiste en que contrates para un pico que solo tendrás tres meses, el compañero de IA para helpdesk de eesel es la otra palanca. Se incorpora a la cola que ya llevas en Zendesk, Gorgias, HubSpot o Help Scout, aprende de tus tickets pasados y tu centro de ayuda, y trabaja solo los tipos de ticket que le encargas, lo que mantiene el residuo humano lo bastante predecible como para planificar con él.
El precio también encaja con una previsión estacional. En los precios de eesel, un ticket o un chat es 1 crédito, los planes empiezan en $299 al mes por 500 créditos y una mejora de plan tiene efecto inmediato, así que subes un tamaño para el pico y bajas después, como hace Norden-Frisia cada verano. Puedes empezar con 100 créditos gratis y ver cuánto de tu cola asumiría antes de cambiar un solo turno.
