

Añade llms.txt a tu centro de ayuda si tu plataforma lo ofrece como un interruptor, pero no esperes tráfico de búsqueda a cambio. Es un mapa para agentes de IA que alguien envía a tu sitio, no una señal de posicionamiento: Google dice que sus funciones de IA no lo usan, y los operadores que registran su tráfico ven que los rastreadores de IA lo ignoran. GitBook, Mintlify, Document360, ReadMe y HelpDocs generan uno. Zendesk, Help Scout y Freshdesk no, así que tú generas un archivo curado y lo hospedas tú mismo. Una IA de soporte conectada a tu helpdesk, como eesel, lee tus artículos directamente y no necesita el archivo en absoluto.
¿Qué es llms.txt, en términos de un centro de ayuda?
llms.txt es un archivo markdown sencillo que lista tus páginas más útiles, con una nota de una línea en cada una, para que un agente de IA encuentre el artículo correcto sin tener que atravesar menús de navegación y avisos de cookies. Jeremy Howard publicó la propuesta en septiembre de 2024, y la versión 2 llegó en agosto de 2026. La propia idea de la especificación es que "el archivo en sí se mantiene lo bastante pequeño para entrar en el contexto" mientras el detalle vive detrás de los enlaces.
Construyo agentes de IA en eesel, y el mecanismo es más simple de lo que la mayoría de las guías hacen parecer. Un agente (Claude Code, Cursor, una sesión de ChatGPT en la que alguien pegó tu URL) descarga /llms.txt, lee la lista, elige los enlaces que coinciden con la pregunta, y abre esas páginas. Si cada enlace apunta a una versión markdown limpia del artículo, el agente obtiene la respuesta sin tener que analizar tu tema visual. No pasa nada más.
El formato tiene una parte obligatoria y algunas opcionales, según la especificación del formato llms.txt:
- Un H1 con el nombre del sitio. "Esta es la única sección obligatoria."
- Un resumen en bloque de cita que le dice al agente qué cubre el centro de ayuda.
- Texto libre con cualquier nota sobre cómo leer el archivo.
- Secciones H2 de enlaces, cada línea como
[nombre](url): descripción. - Una sección
## Optionalpor convención, para enlaces que un agente puede omitir cuando le falta espacio. La versión 2 eliminó cualquier significado especial de análisis para ella, según la página de cambios.
Dos detalles importan especialmente para los centros de ayuda. Primero, un archivo cubre las URL bajo su ruta, así que un centro de ayuda que vive en yourcompany.com/help puede tener su propia /help/llms.txt. Segundo, la especificación pide versiones markdown de cada página en la misma URL con .md añadido. La mayoría de los centros de ayuda alojados por un helpdesk no las ofrecen, lo que afecta qué camino de configuración elijas más abajo.
Si quieres el panorama más amplio de quién lee hoy un centro de ayuda (motores de búsqueda, motores de respuesta de IA, agentes de codificación, tu propio bot de soporte), mi checklist de legibilidad para IA cubre las correcciones de artículos que vienen antes que todo esto.
¿llms.txt ayuda realmente a un centro de ayuda?
Ayuda a un tipo de lector y no hace nada por otro. Esto es lo que dicen las fuentes primarias, objetivo por objetivo:
| Lo que quieres | ¿llms.txt ayuda? | La evidencia |
|---|---|---|
| Mejor posicionamiento en Google | No | Google dice que puedes ignorar "archivos de texto de IA innecesarios (como llms.txt)" (guía de optimización de IA) |
| Aparecer en AI Overviews o AI Mode | No | "No hay requisitos técnicos adicionales" más allá de estar indexado con un fragmento (funciones de IA de Google) |
| Citas en respuestas de ChatGPT o Claude | Sin probar | Operadores con registros de servidor informan que los rastreadores de IA no lo solicitan (citas abajo) |
| Un agente de codificación configurando tu producto | Sí | La especificación dice que los agentes "siguen los enlaces relevantes"; este es su uso más intenso |
| Un agente encontrando una respuesta en un centro de ayuda grande | Sí, si el archivo está curado | Un índice breve entra en el contexto; 4.000 enlaces no |
| Reemplazar tu sitemap | No | La especificación llama a los sitemaps la lista completa y a llms.txt "una visión curada" |
Google es inusualmente directo en esto. Su guía de IA generativa dice que no necesitas "nuevos archivos legibles por máquina, archivos de texto de IA, marcado o Markdown para aparecer en la Búsqueda de Google", porque "la propia Búsqueda de Google no los usa". La auditoría de llms.txt de Lighthouse de Chrome marca un archivo ausente como no aplicable, "ya que proporcionar el archivo es opcional por el momento", y solo te avisa cuando la solicitud devuelve un error de servidor.
La adopción sigue siendo pequeña. El HTTP Archive Web Almanac 2025 encontró llms.txt en el 2,13 % de los sitios de escritorio y el 2,10 % de los sitios móviles en su rastreo de julio de 2025, y el 39,6 % de esos archivos venían de un solo plugin de SEO de WordPress, así que una parte de ellos nunca fue una elección deliberada.
Los informes de registros de servidor concuerdan con eso:
"I can definitively say llms.txt is not used by any AI players. I run a blogging platform with around 80k blogs and /llms.txt is not requested by anything (other than humans checking to see if there's an llms.txt path)."

El argumento a favor viene de personas que entregan el archivo a un agente a propósito:
"It's a single link you can give your AI agent and ask to "read this, understand it does, implement it"."
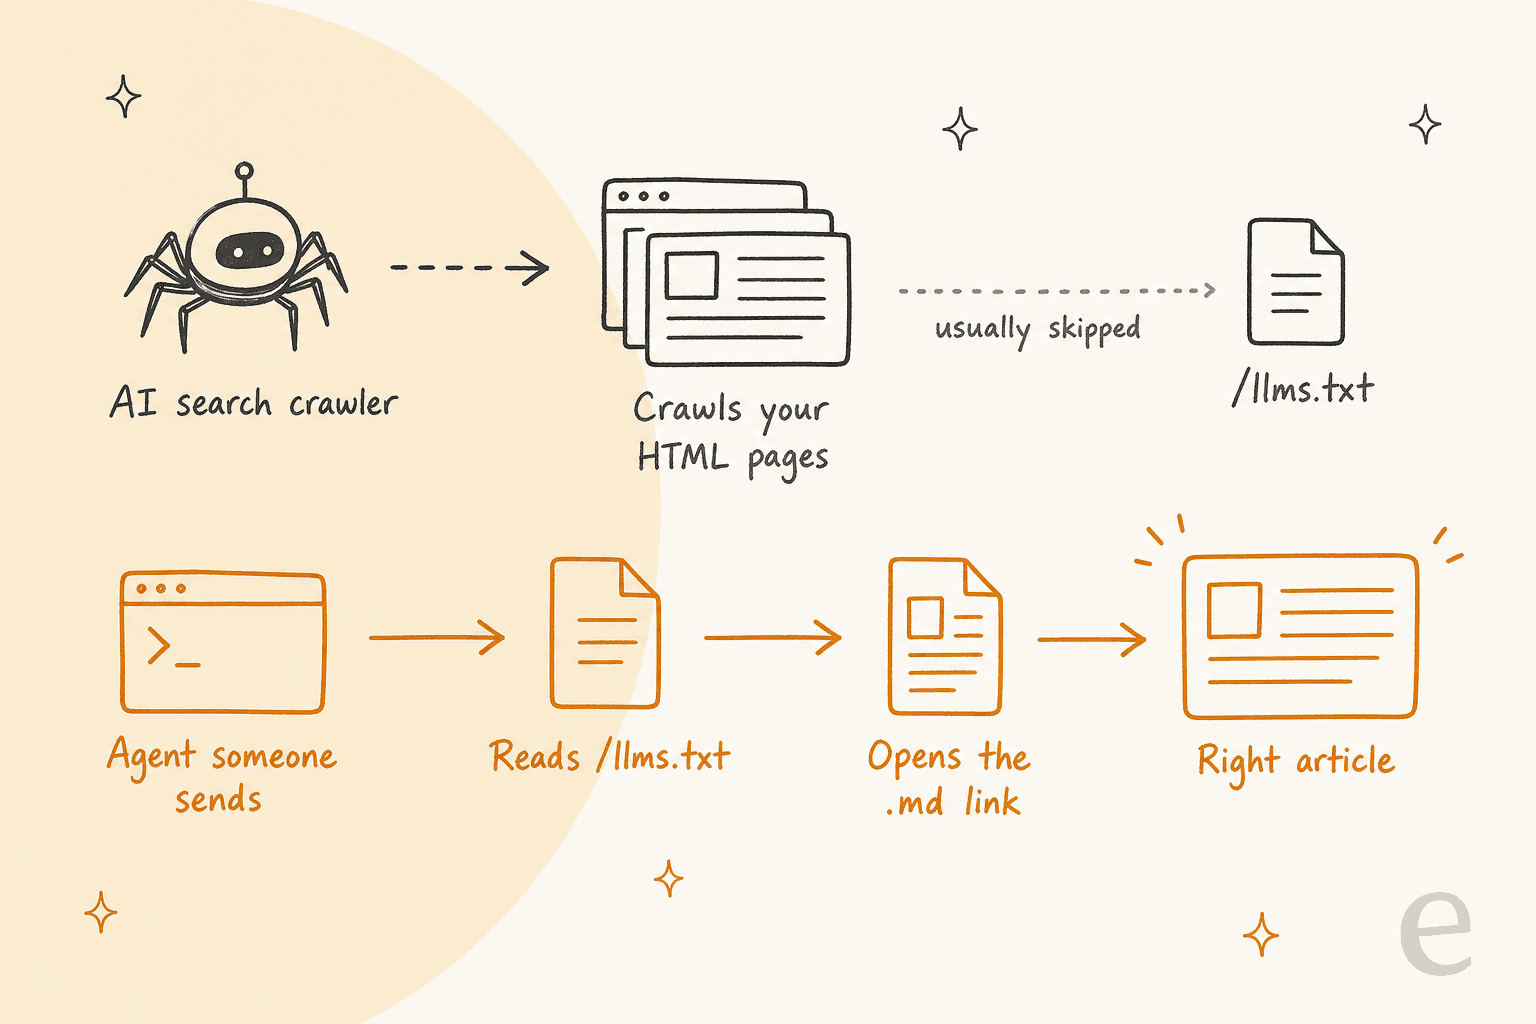
Así que el veredicto honesto: llms.txt es consultado por agentes que llegan a buscarlo, no empujado hacia índices de búsqueda. Para un centro de ayuda, ese lector es un desarrollador conectando tu API, un cliente que pegó la URL de tu ayuda en un asistente de IA, o el agente de un socio comprobando tu política de reembolsos. Si nada de eso te importa, mejor invierte la hora en tus artículos. Si tienes curiosidad por cómo eligen fuentes los motores de respuesta de IA, mi explicación de motores de búsqueda con IA cubre ese lado.
¿Qué plataformas de centro de ayuda pueden publicar /llms.txt?
Esta es la pregunta que la mayoría de las guías de llms.txt se saltan, y decide cuánto trabajo te espera. Tu plataforma de centro de ayuda cae en uno de tres grupos.
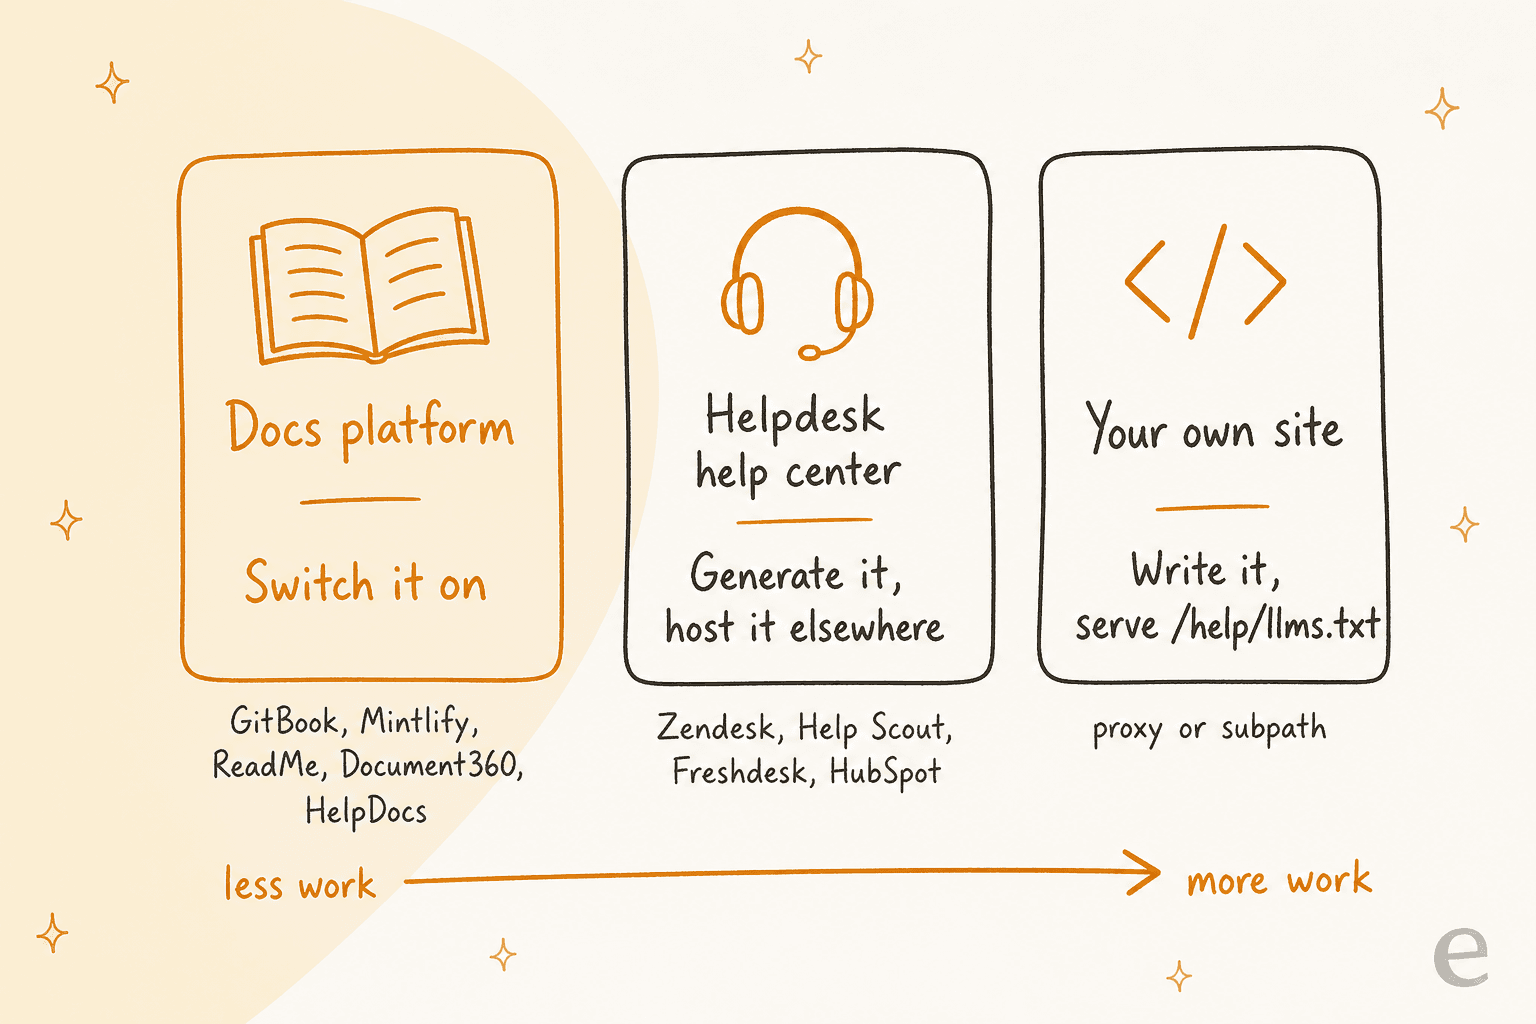
Revisé la documentación de cada proveedor el 17 de noviembre de 2026. Así están las cosas:
| Plataforma | llms.txt | llms-full.txt | Control de curación | Qué vigilar |
|---|---|---|---|---|
| GitBook | Automático, en todos los planes incluido Free | Sí | No documentado | Las páginas ocultas siguen en llms-full.txt |
| Mintlify | Automático, también en /.well-known/llms.txt | Sí | Páginas ocultas y noindex excluidas; un archivo personalizado las sobrescribe | Archivo generado limitado a 100.000 caracteres, luego dividido |
| ReadMe | Activado por defecto, todos los planes | No documentado | Páginas ocultas excluidas; archivo personalizado permitido | Un archivo personalizado detiene la actualización automática |
| Document360 | Automático, reconstruido al publicar | No documentado | Excluir un artículo de los motores de búsqueda también lo quita de llms.txt | Los artículos sin descripción aparecen solo con el título |
| HelpDocs | Interruptor en Settings, AI, todos los planes | No documentado | No documentado | Los centros de ayuda privados no obtienen archivo |
| Zendesk Guide | Sin opción nativa | Vía una app del Marketplace | La app puede excluir categorías, secciones, etiquetas | Hospedas el archivo tú mismo |
| Help Scout Docs | Sin mención en la documentación | No | n/a | Genéralo y hospédalo tú mismo |
| Freshdesk | Sin mención en la documentación | No | n/a | Genéralo y hospédalo tú mismo |
| Base de conocimiento de HubSpot | Sin mención en la documentación | No | n/a | Genéralo y hospédalo tú mismo |
Las fuentes de cada fila están enlazadas en las secciones de abajo.
Plataformas de documentación que lo construyen por ti
Si tu centro de ayuda corre sobre una plataforma de documentación, el trabajo está mayormente hecho. La documentación de GitBook dice que "publica automáticamente formatos amigables para IA", incluyendo llms.txt, llms-full.txt y versiones .md de cada página. Un detalle fácil de pasar por alto: "Hiding a page only removes it from the published table of contents", así que una página oculta sigue estando en llms-full.txt. Despublica todo lo que no quieras que los agentes lean. Mi desglose de precios de GitBook cubre qué plan necesitas para un dominio personalizado.
Mintlify te da el mayor control. Excluye páginas ocultas y noindex, te deja introducir tu propio llms.txt para sobrescribir el generado, y en sitios parcialmente autenticados lista solo páginas públicas a visitantes anónimos.
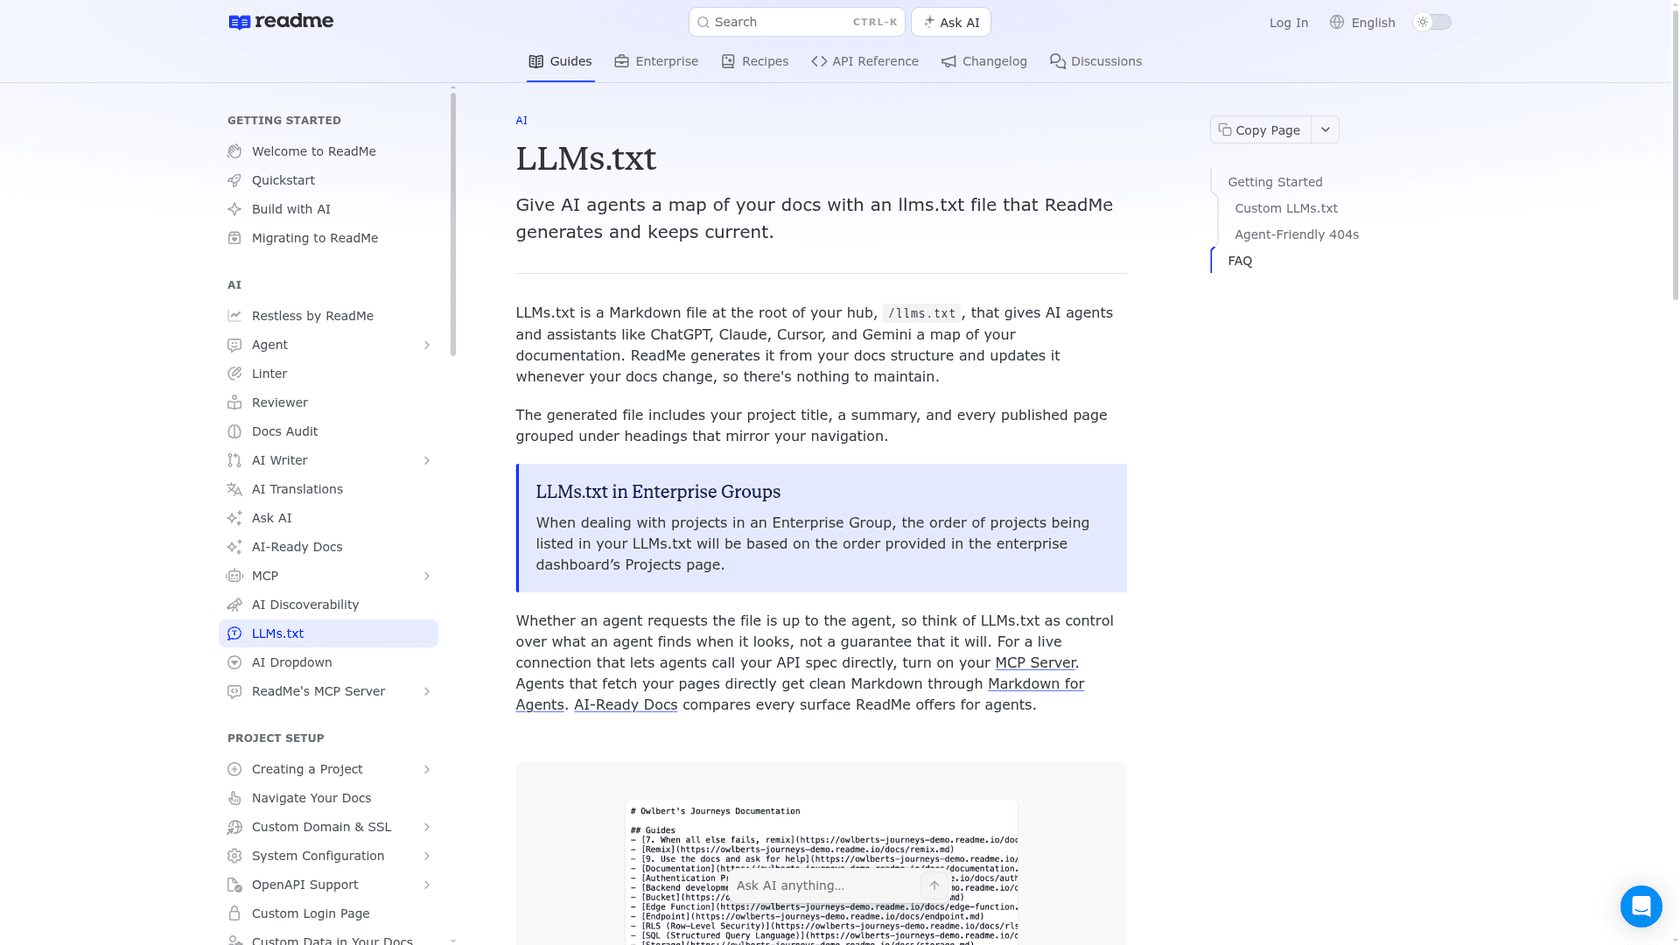
La página de llms.txt de ReadMe es directa sobre lo que el archivo puede y no puede hacer: "think of LLMs.txt as control over what an agent finds when it looks, not a guarantee that it will."
Document360 construye el archivo a partir de tu contenido publicado y lo actualiza "whenever you publish, update, or remove content." Las descripciones vienen de la descripción de búsqueda de cada artículo, así que un artículo sin descripción aparece solo con el título desnudo, lo que le da a un agente casi nada para elegir. Si estás comparando proveedores de base de conocimiento en esto, mi lista de alternativas a Document360 es un buen punto de partida.
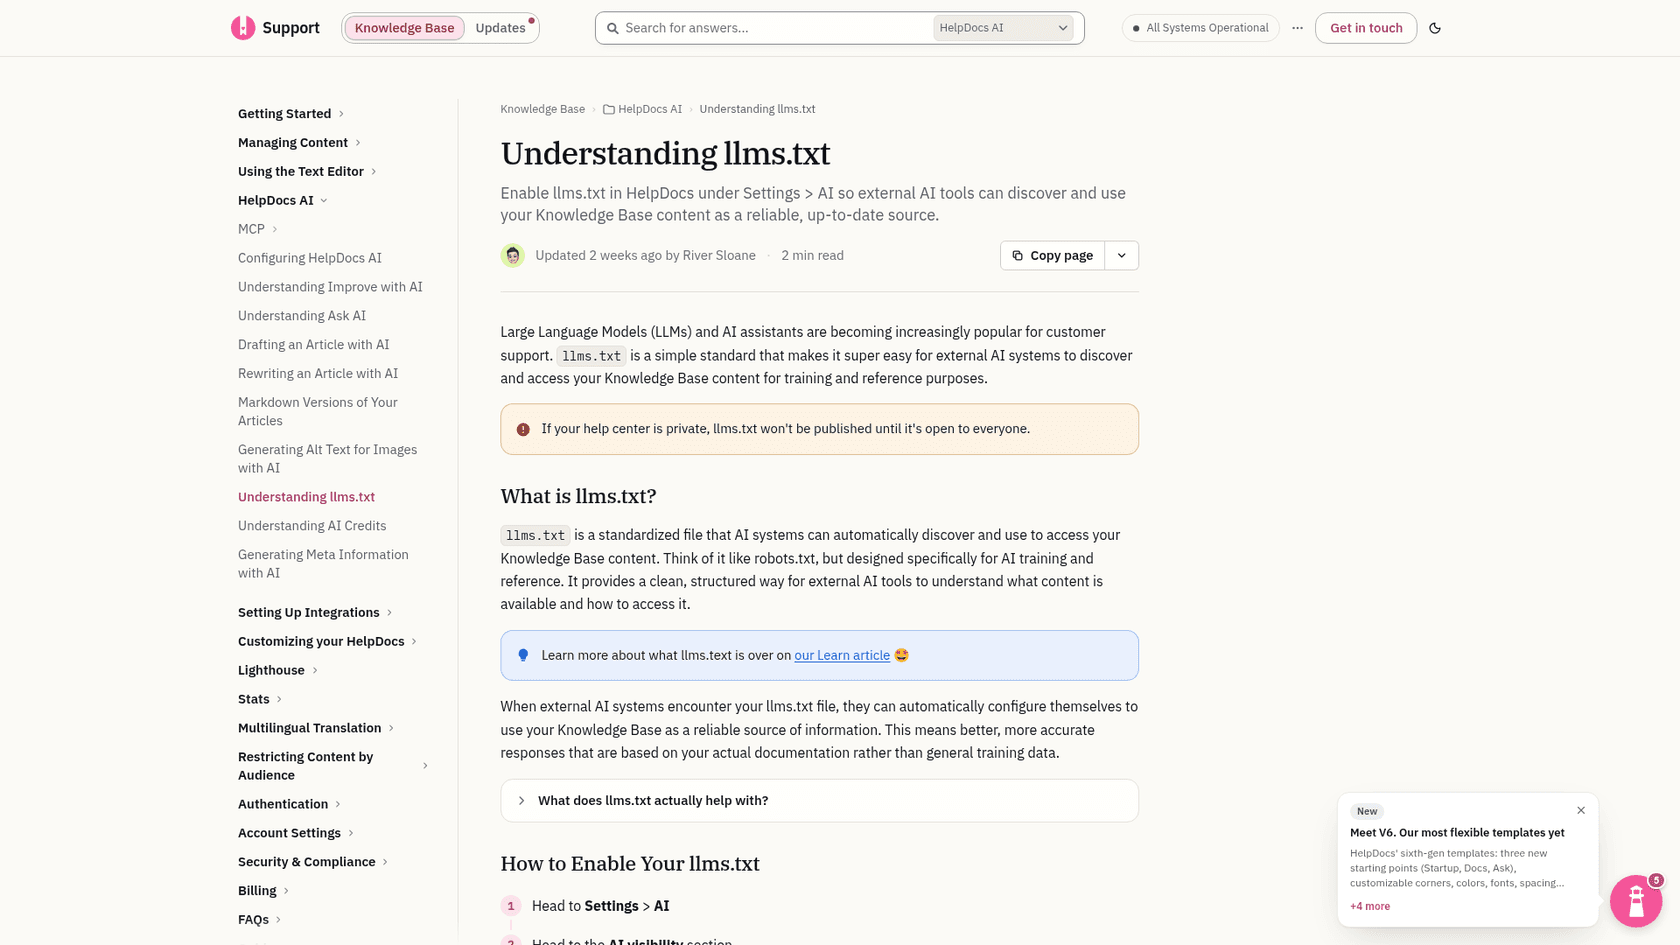
HelpDocs es la incorporación más reciente. Su actualización del 14 de octubre de 2026 hizo que los artículos en markdown y llms.txt estuvieran "available now, on every plan", y lo activas en Settings, AI, AI visibility.
Centros de ayuda de helpdesk que (todavía) no lo hacen
Los centros de ayuda incluidos con los helpdesks son una historia diferente. Busqué en la documentación de Zendesk Guide, Help Scout Docs, Freshdesk, la base de conocimiento de HubSpot, Helpjuice y Zoho Desk una función de llms.txt y no encontré ninguna. También solicité /llms.txt en el centro de ayuda propio de cada proveedor el 17 de noviembre de 2026:
| Centro de ayuda | /llms.txt el 17 de nov. de 2026 |
|---|---|
| support.zendesk.com | 404 |
| docs.helpscout.com | 404 |
| support.freshdesk.com | 404 |
| knowledge.hubspot.com | 404 |
| docs.gorgias.com | 200, con enlaces de artículo .md |
| help.shopify.com | Redirección 308 a una guía para agentes |
Gorgias es el caso atípico interesante: su propio centro de ayuda sirve un archivo con enlaces .md, pero no pude encontrar un artículo de ayuda que lo ofrezca como función para clientes, así que revisa tu propio centro de ayuda de Gorgias antes de contar con ello.
Para Zendesk, los límites están documentados. Guide te deja subir archivos .txt como recursos de tema, pero esos viven en una ruta de CDN, no en /llms.txt. El mapeo de host apunta support.yourcompany.com hacia Zendesk con un CNAME, y eso es todo lo que cambia. Mi guía de subdominio vs. dominio personalizado cubre esa configuración con más detalle.
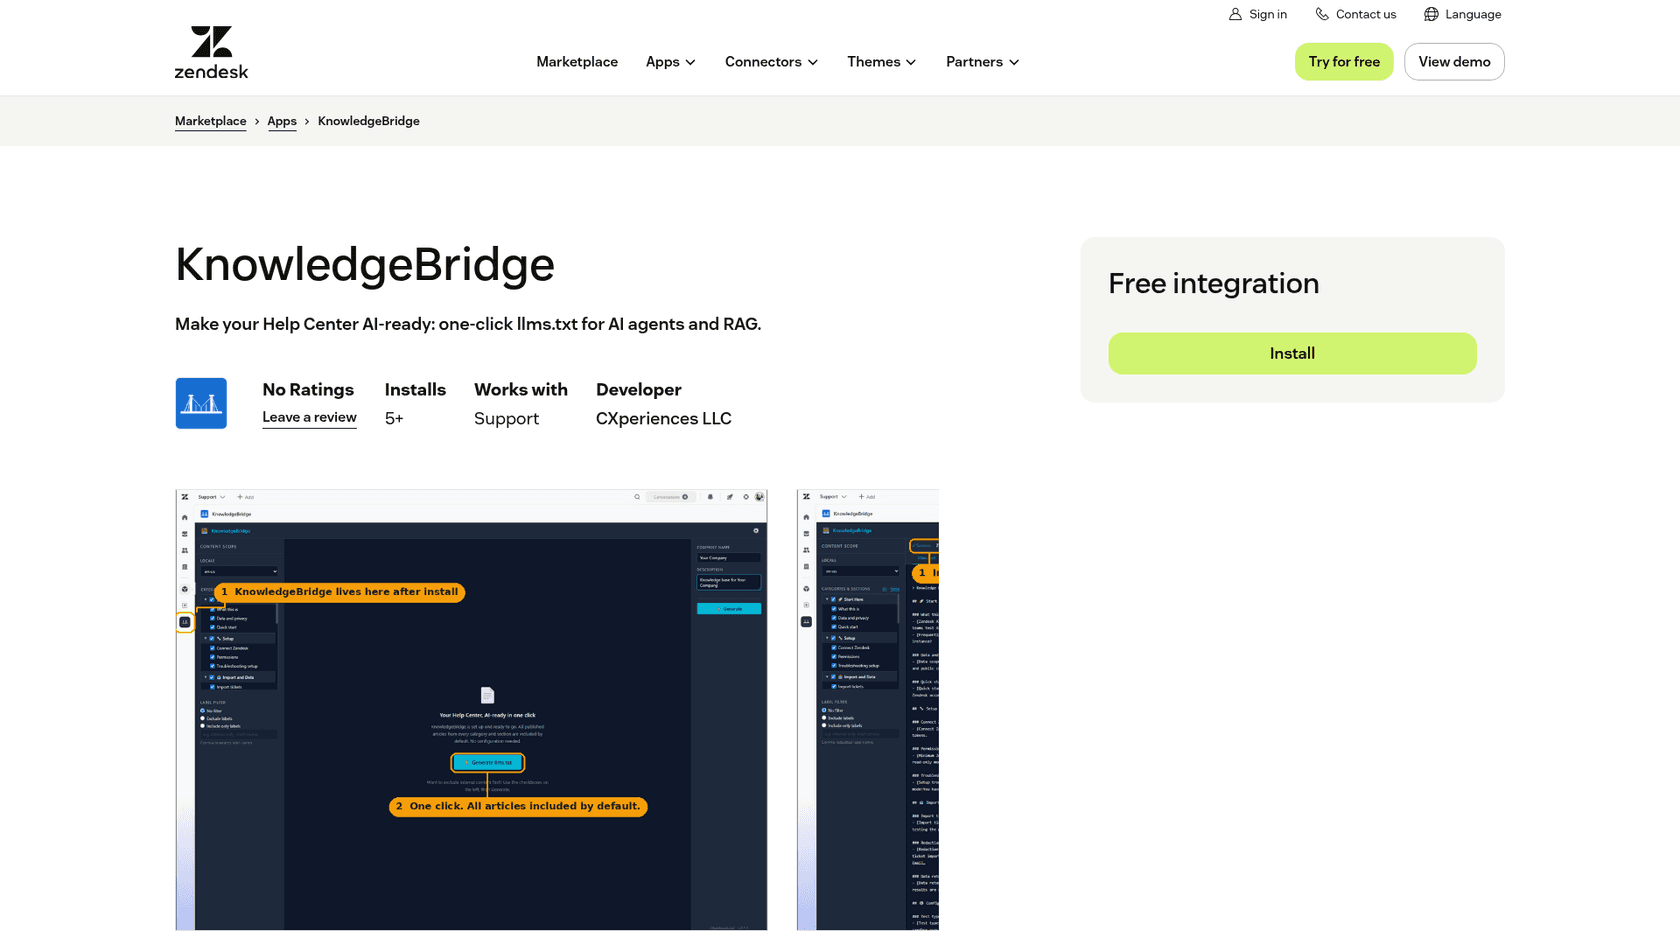
Lo más parecido a una opción nativa es KnowledgeBridge, una app gratuita del Marketplace de CXperiences LLC con más de 5 instalaciones. Construye llms.txt y llms-full.txt a partir de tu centro de ayuda y puede omitir categorías, secciones o artículos etiquetados, pero la salida es una descarga. Sus propios pasos de configuración te dicen que hospedes los archivos en tu dominio.
¿Cómo añades llms.txt a Zendesk, Help Scout o Freshdesk?
Generas el archivo en otro lugar y lo hospedas donde controles la raíz. Esta es la configuración que usaría, de principio a fin, en aproximadamente una hora para un centro de ayuda de unos pocos cientos de artículos.
- Elige dónde vive el archivo. La opción fácil es tu sitio principal:
yourcompany.com/llms.txtcon una sección## Help centerque enlaza a los artículos de tu centro de ayuda. Si tu sitio de marketing ya tiene una llms.txt (los plugins de SEO de WordPress a menudo generan una), añade la sección a ese archivo en lugar de hacer uno segundo. La opción más fuerte, si tu centro de ayuda vive bajo una subruta comoyourcompany.com/helpa través de un proxy inverso, es/help/llms.txt, ya que la especificación dice que gana el archivo más específico. - Obtén la lista de artículos públicos. El endpoint List Articles de Zendesk funciona sin iniciar sesión, y "the response lists only the articles that the requesting agent, end user, or anonymous user can view", así que una llamada anónima no puede filtrar un artículo restringido. Mi guía de la API de artículos cubre la paginación. Para Freshdesk, la API de base de conocimiento hace el mismo trabajo, y Help Scout tiene su propia API de Docs.
- Selecciona y describe. Si prefieres trabajar en una hoja de cálculo, empieza desde una exportación del centro de ayuda. Toma los 30 a 100 artículos que responden a la mayoría de tus tickets, agrúpalos bajo tus nombres de categoría reales, y escribe una línea por artículo que diga qué pregunta responde.
- Sube y enlázalo. Pon el archivo en tu sitio principal y enlázalo desde el pie de tu centro de ayuda, para que los humanos (y los agentes que empiezan en tu centro de ayuda) lo encuentren.
- Pruébalo como dice la especificación. "Test your file by asking an agent questions about your content, giving it only your llms.txt as a starting point", según llmstxt.org. Haz las cinco preguntas que tu equipo responde más y comprueba qué artículo abre el agente.
Para el paso 2 en Zendesk, esto obtiene los artículos públicos en inglés, los más nuevos primero, como líneas de lista listas para editar:
curl -s "https://support.yourcompany.com/api/v2/help_center/en-us/articles.json?per_page=100&sort_by=updated_at&sort_order=desc" \
  | jq -r '.articles[] | select(.draft == false) | "- [\(.title)](\(.html_url)): "'
Pega la salida en tu plantilla y rellena las descripciones a mano. Para ver por qué la curación importa en Zendesk: la misma llamada contra el propio centro de ayuda de Zendesk reportó 4.687 artículos en inglés el 17 de noviembre de 2026. Nadie quiere un agente leyendo esa lista.
Dos trampas específicas de Zendesk. Si restringes artículos con segmentos de usuario, la llamada anónima los descarta silenciosamente, que es lo que quieres, pero verifícalo antes de añadir cualquier artículo a mano. Y si manejas varios centros de ayuda de marca, da a cada marca su propia sección, o su propio archivo por dominio de marca, para que un agente no mezcle dos políticas de devolución.
¿Cómo debería verse la llms.txt de un centro de ayuda?
Breve, agrupada por las preguntas que hacen los clientes, y escrita para un lector sin contexto. Aquí hay una plantilla que puedes copiar:
# Acme Help Center

> Official help for Acme customers: setting up an account, billing and invoices,
> shipping and returns, and connecting Acme to other tools. Answers here are
> current; if an article and an old blog post disagree, the article wins.

Articles are written for customers, not admins. For API reference, see
https://developers.acme.com/llms.txt. To reach a person, see "Contact support" below.

## Getting started

- [Create your Acme account](https://help.acme.com/en-us/articles/101): Sign-up steps, email verification, and what the free trial includes.
- [Invite your team](https://help.acme.com/en-us/articles/102): Adding users, roles and seat limits.

## Billing

- [Change or cancel your plan](https://help.acme.com/en-us/articles/201): Upgrades, downgrades, cancellation and when changes take effect.
- [Refund policy](https://help.acme.com/en-us/articles/202): Who qualifies for a refund, the 30-day window, and how to request one.

## Shipping and returns

- [Start a return](https://help.acme.com/en-us/articles/301): The returns portal, return labels and what items can't be returned.

## Contact support

- [Contact support](https://help.acme.com/en-us/articles/401): Hours, channels and what to include so we can help faster.

## Optional

- [Release notes](https://help.acme.com/en-us/articles/501): Product changes by month.
- [Full sitemap](https://help.acme.com/sitemap.xml): Every public article.
Algunas decisiones ahí son deliberadas:
- El bloque de cita le dice al agente qué fuente gana. El contenido de soporte se contradice entre blogs, macros antiguas y artículos archivados. Una línea que diga que el centro de ayuda es la fuente vigente evita que un agente cite un blog de 2023.
- Las descripciones nombran la pregunta, no el tema. "Who qualifies for a refund, the 30-day window, and how to request one" le permite a un agente emparejar la pregunta de un cliente. "Refund information" no lo logra. Es el mismo trabajo que escribir buenas meta descripciones, y a menudo puedes reutilizarlas.
- Contactar con soporte tiene su propia sección. El centro de ayuda de Shopify hace algo similar: su archivo pide a los agentes responder primero desde los artículos vigentes y leer una guía de soporte antes de contactar con soporte en nombre de un comerciante.
- La documentación para desarrolladores recibe un puntero, no una fusión. Si tienes una API, enlaza su propia llms.txt en lugar de meter endpoints en el archivo del centro de ayuda.
¿Deberías listar todos los artículos o curar?
Curar. Todo el sentido de la especificación es un archivo que entre en el contexto de un agente, y una lista completa de artículos de un centro de ayuda maduro no lo hace. Esto es lo que pesaron tres archivos reales de centro de ayuda cuando los descargué el 17 de noviembre de 2026:
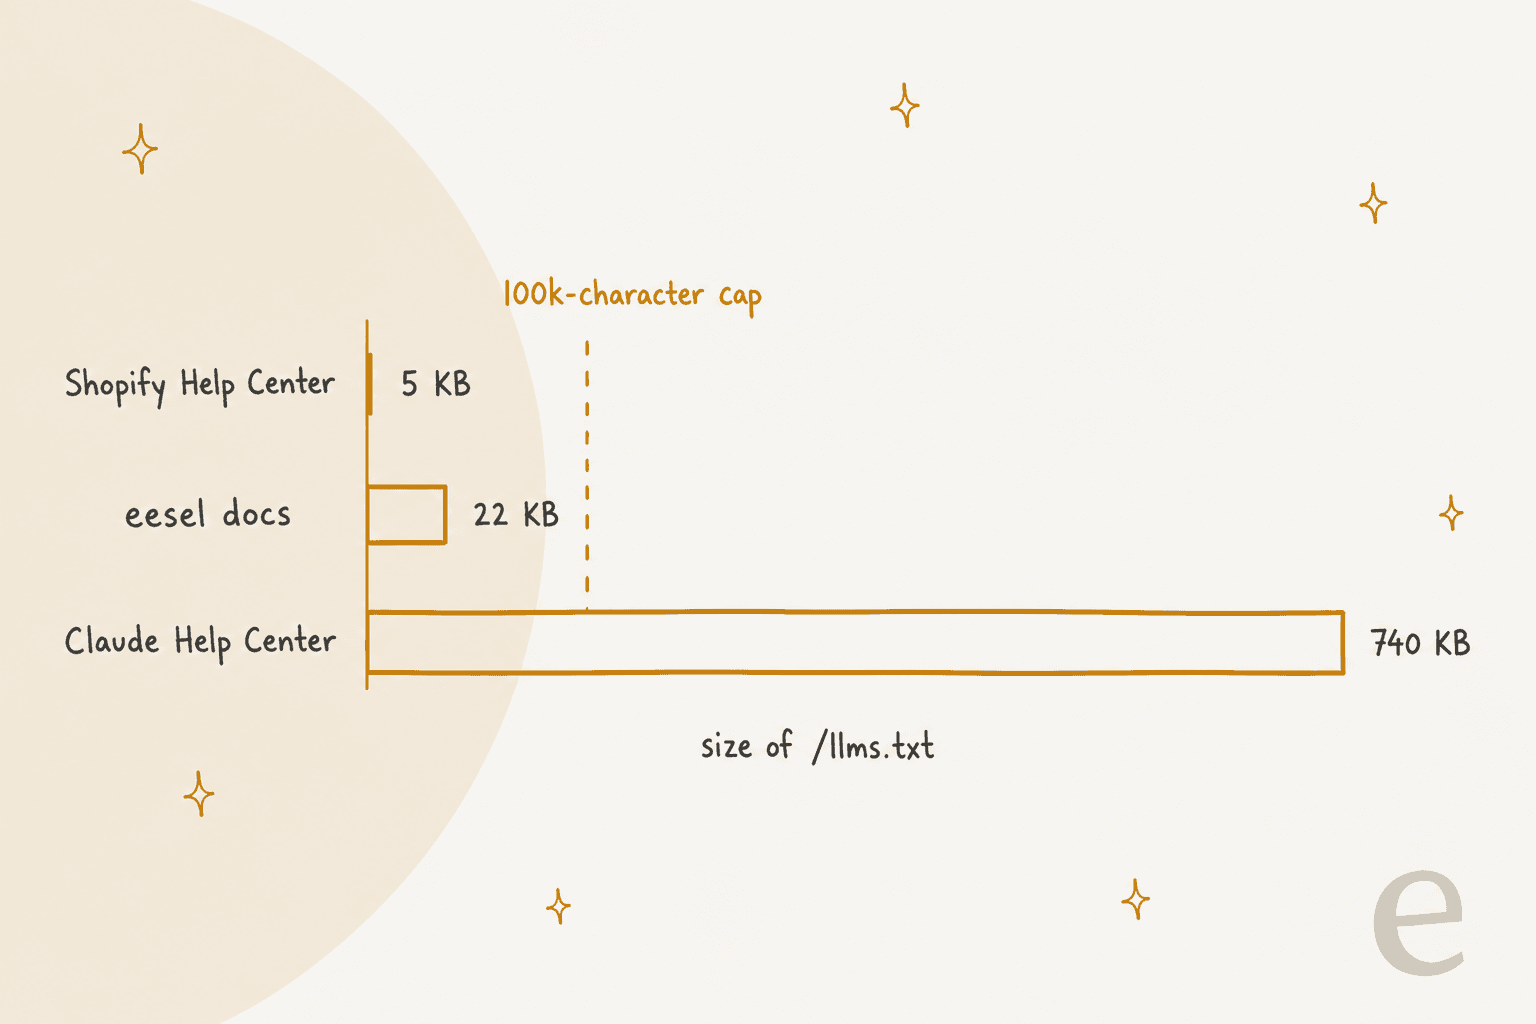
- Centro de ayuda de Claude: 740 KB, 4.528 enlaces. Cada artículo, repetido en más de 10 secciones de idioma.
- Documentación propia de eesel: 22 KB, 86 enlaces, cada uno con una descripción de una línea. Está generada por GitBook y cubre todo el centro de ayuda de eesel, que es pequeño porque la documentación del producto es pequeña.
- Centro de ayuda de Shopify: 5 KB y ninguna lista de artículos en absoluto. Es una guía para agentes: cómo obtener cualquier página como markdown, cómo funcionan las URL, y dónde está el sitemap en markdown.
Para comparar, Mintlify limita su llms.txt generada a 100.000 caracteres antes de dividirla en índices más pequeños, según su documentación de llms.txt. ReadMe ofrece una opción "Summarize Index" por la misma razón, según su página de AI Discoverability.
Después está llms-full.txt, el archivo único con el texto completo de cada página. No está en la especificación actual en absoluto; la página de cambios dice que la herramienta de expansión de contexto "is no longer part of the proposal." GitBook y Mintlify aun así producen una, y la de eesel llega a 1,3 MB. Eso es útil para un desarrollador que quiera descargar tu documentación en un repositorio, pero demasiado grande para un agente que intenta responder una sola pregunta de devolución.
Mi regla general: por debajo de unos 100 artículos, lístalos todos con descripciones. Por encima, lista los 30 a 100 principales por volumen de tickets, y apunta a tu sitemap en ## Optional para el resto, como hace Shopify al dirigir a los agentes a su sitemap en markdown. Para encontrar qué artículos cargan más peso, mapear las consultas de búsqueda y comprobar cuáles enlazan más tus agentes es más rápido que adivinar.
¿Cómo mantienes llms.txt actualizado?
Una llms.txt desactualizada es peor que ninguna, porque envía agentes con confianza a artículos movidos o eliminados. Cuánto trabajo sea esto depende del camino de configuración:
- Los archivos generados se actualizan solos. Document360 y ReadMe reconstruyen al publicar, y Mintlify llama a su versión "always up to date."
- Los archivos personalizados se congelan. ReadMe dice sin rodeos que con un archivo personalizado "your llms.txt will no longer be updated automatically." Mintlify restaura la versión generada si borras la tuya, así que siempre puedes volver atrás.
- Los archivos autohospedados necesitan un calendario. Como cualquier proceso de base de conocimiento autoactualizable, vuelve a ejecutar la extracción de artículos mensualmente, o cuando reorganices categorías. Un pequeño trabajo programado que compara la lista nueva con la antigua y marca las URL eliminadas detecta la mayoría de las roturas.
Cada vez que regeneres, revisa los enlaces. Esta línea imprime cualquier URL del archivo que no devuelva un 200:
grep -oE 'https://[^)]+' llms.txt | while read u; do
  code=$(curl -s -o /dev/null -w '%{http_code}' -L "$u"); [ "$code" != "200" ] && echo "$code $u"
done
Los artículos movidos suelen ser el culpable. Las redirecciones de Zendesk para artículos movidos mantienen funcionando los enlaces antiguos para los humanos, pero un archivo curado debería apuntar a la URL actual para que el agente no desperdicie un salto. Si los artículos desactualizados son un problema recurrente, mi guía para detectar contenido desactualizado cubre cómo detenerlos antes de que lleguen a cualquier lector, humano o IA.
Para centros de ayuda localizados, decide por idioma. Un centro de ayuda multilingüe puede llevar un archivo por idioma, o un archivo con el idioma predeterminado y una nota sobre cómo funcionan las URL de idioma, que es lo que hace Shopify.
¿Cómo sabes si algo la lee?
Revisa tus registros, porque los paneles no te lo dirán. Filtra los registros de tu servidor web o CDN por solicitudes a /llms.txt y mira los agentes de usuario. Dos de las plataformas de documentación hacen esto por ti: HelpDocs muestra solicitudes de herramientas de IA reconocidas en su pestaña de estadísticas de IA, y GitBook tiene un informe de Agents & MCP.
Ajusta tus expectativas con gente que ya ha mirado:
"What I've seen from ASNs is that visits are coming from GOOGLE-CLOUD-PLATFORM (not from Google itself), and OVH. Based on UA, users are: WebPageTest, BuiltWith, and zero LLMs based on both ASN and UA."
Las visitas que vale la pena contar son las iniciadas por un usuario, como el ChatGPT-User de OpenAI, que su documentación de rastreadores describe como visitas que una persona desencadena en lugar de rastreo automático, más las solicitudes de herramientas de codificación. Esos son los lectores para los que existe llms.txt. Si el número se queda cerca de cero después de un trimestre, esa es tu respuesta para ese centro de ayuda, y la hora está mejor invertida en los propios artículos, o en un servidor MCP, que responde preguntas en vivo en lugar de entregar una lista estática.
¿Tu IA de soporte necesita llms.txt?
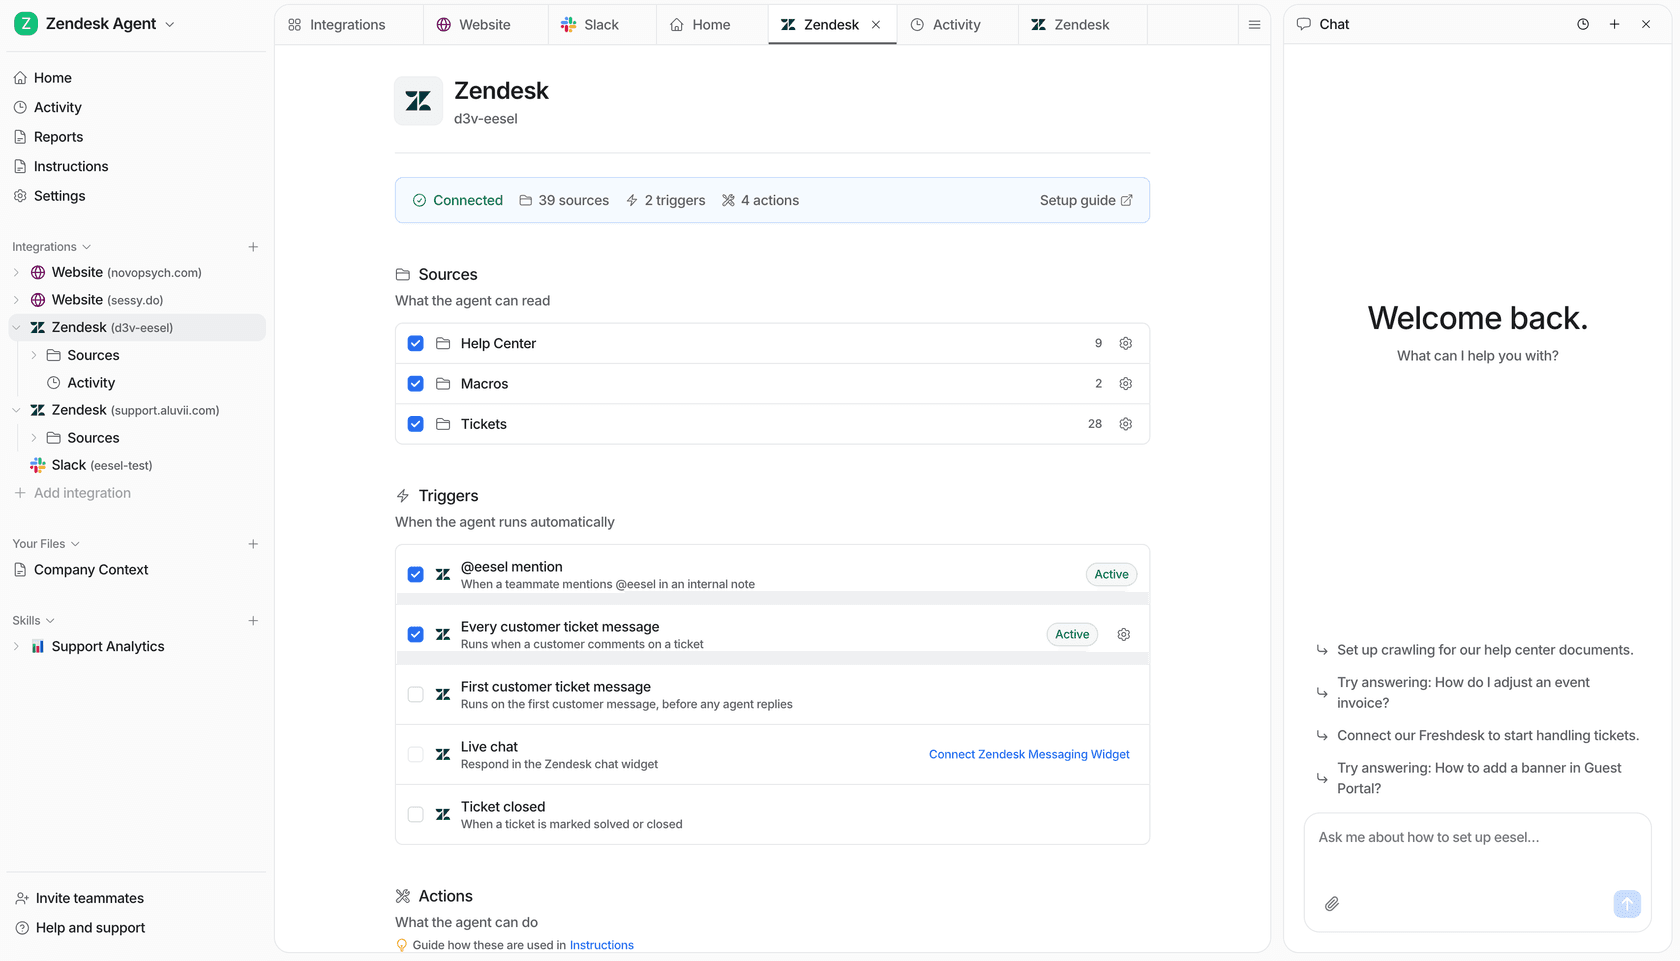
No, si se conecta a tu helpdesk. llms.txt existe para agentes externos que solo tienen tu URL. Tu propia IA de soporte no debería ser una de esas: debería leer cada artículo público directamente, además de las macros y tickets pasados que nunca llegan al centro de ayuda.
Así es como funciona el compañero de IA para helpdesk de eesel. Se conecta a Zendesk, Freshdesk, Help Scout, HubSpot o Gorgias, sincroniza el centro de ayuda como fuente de conocimiento, y redacta o envía respuestas con el artículo usado enlazado. Dokument 24, un servicio danés de documentos legales en Zendesk, lo ejecuta sobre unas 1.900 páginas de su sitio web y 640 tickets y artículos de Zendesk, y entre el 8 de agosto y el 8 de septiembre de 2026 preparó unos 680 tickets con borradores de respuesta en danés para que el equipo los enviara.
Lo que llms.txt no puede arreglar es lo que dicen los artículos. En una llamada de ventas de eesel de la que aprendí, un equipo danés de telemática vehicular en Zendesk describió un bot confirmando soporte para marcas de coches que no soportaban, porque un artículo decía que soportaban "todos los modelos". Una llms.txt perfectamente curada habría apuntado justo a ese artículo. La solución fue la frase, no el índice, por lo que una auditoría de base de conocimiento suele ganarle a un archivo nuevo. Si estás sopesando RAG frente a fine-tuning para tu centro de ayuda, aplica el mismo punto: la recuperación solo devuelve lo que dice el artículo.
eesel: deja que tu centro de ayuda responda tickets
Si la IA que más te preocupa es la que responde a tus clientes, empieza por ahí. El compañero de helpdesk de eesel aprende de tu centro de ayuda el día que lo conectas, sin necesitar llms.txt, y te muestra qué artículos producen borradores débiles. Una empresa de automatización industrial puso su biblioteca técnica detrás de un chat de eesel que responde solo desde los documentos, y los vacíos en esas respuestas van ahora directo a la lista de pendientes del equipo de documentación. Ese es el ciclo que hace mejor un centro de ayuda para cada lector, IA o humano.
Los desarrolladores pueden configurarlo sin el panel. Con la CLI de eesel, un agente de codificación puede subir un archivo de política aprobado con eesel files upload, comprobar qué contiene la sincronización del centro de ayuda, y hacer preguntas de prueba con eesel chat antes de que nada llegue a un cliente. Conectar el propio helpdesk todavía necesita que alguien con acceso de administrador lo apruebe. Prueba eesel gratis durante 7 días y pasa tus últimos diez tickets por él.
Preguntas frecuentes
¿Mi centro de ayuda necesita un archivo llms.txt?
¿Cómo añado llms.txt a un centro de ayuda de Zendesk?
/llms.txt, y el mapeo de host solo cambia el nombre de host. Genera la lista con la API del centro de ayuda (una llamada anónima devuelve solo artículos públicos) o con la app gratuita KnowledgeBridge del Marketplace, y luego hospédala en tu sitio principal con un enlace desde tu centro de ayuda. Mi guía de la API de artículos explica la llamada de listado.