

Resumo
A IA para gestão de mudanças em ITSM se paga na papelada, não na aprovação. Deixe que ela verifique cada solicitação de mudança em busca de plano de retorno ou evidência de testes ausentes antes de qualquer reunião, explique a pontuação de risco em palavras simples e, o mais útil, ligue a onda de tickets da central de serviços depois de uma mudança ruim à mudança que a causou. Uma pessoa identificada ainda aprova e executa toda mudança normal ou emergencial. É também o que ServiceNow, Jira Service Management e Freshservice oferecem hoje: a IA deles redige e sugere, e nenhuma delas aprova uma mudança automaticamente.
O motivo para apontar a IA para a papelada está na pesquisa. A equipe de SRE do Google diz que cerca de 70% das interrupções vêm de mudanças em um sistema em produção, e a DORA constatou que equipes com aprovação pesada por comitê tinham 2,6 vezes mais chance de ser de baixo desempenho, sem queda nas taxas de falha para compensar. Um porteiro mais esperto não resolve isso. O que resolve são solicitações melhores na entrada e um vínculo mais rápido quando algo dá errado.
Se a sua central de serviços roda no Jira Service Management ou no Zendesk, a eesel pode ser a colega do lado dos tickets: ela lê novas solicitações, busca mudanças recentes, deixa uma nota interna com a mudança provável e segura tudo o que for arriscado para uma pessoa. O head de TI da InDebted a usa como primeira respondente em uma central interna de JSM.
A IA pode ajudar na gestão de mudanças em ITSM?
Pode, desde que você a aponte para a metade certa do trabalho. A gestão de mudanças, que o ITIL 4 chama de habilitação de mudanças, tem duas metades: decidir se uma mudança deve acontecer e lidar com o que acontece depois que ela acontece. A IA é boa na leitura, no cruzamento e no resumo que cercam as duas. Ela não é o que você quer para decidir.
Eu construo as integrações de helpdesk da eesel, incluindo a de Jira Service Management, então passo muito tempo dentro das filas de ITSM dos outros. O padrão que vejo em centrais internas de TI é consistente. O processo de mudanças em si costuma funcionar no papel. O que consome a semana são as idas e vindas em solicitações de mudança preenchidas pela metade e a manhã de segunda-feira em que 30 tickets dizem "a VPN caiu" e ninguém na central de serviços sabe que uma regra de firewall mudou no sábado.
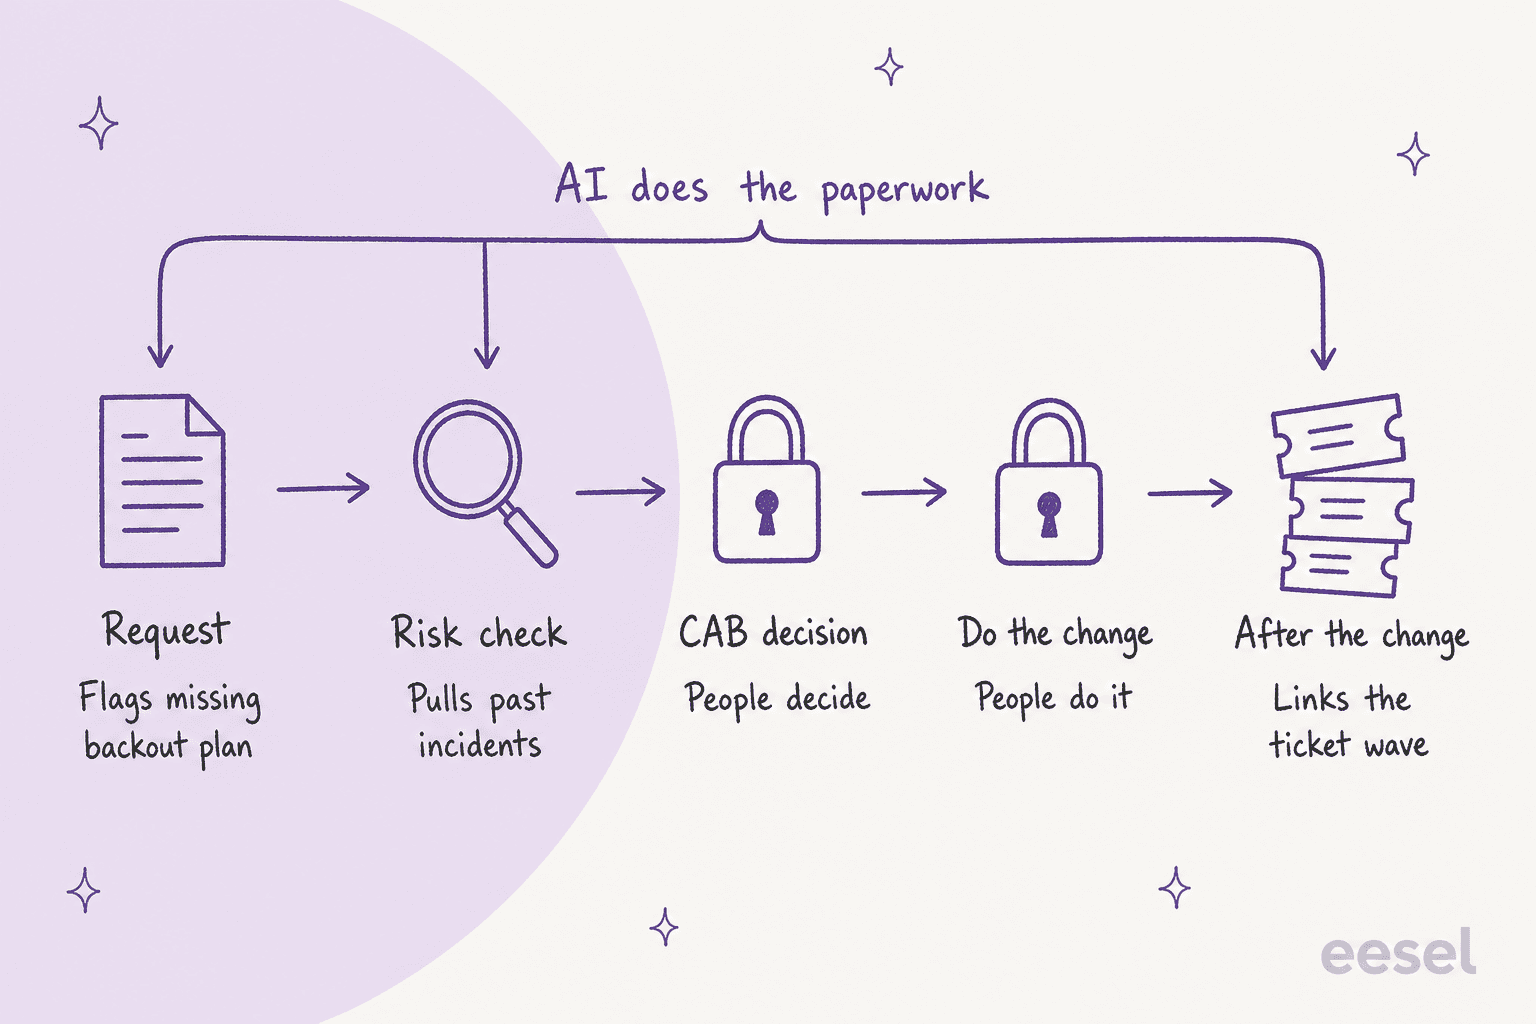
Essa imagem é o argumento inteiro. As três etapas em que a IA ajuda são as que dependem de documentos e de cruzamento de dados. As duas do meio são julgamento e mãos no teclado, e ficam com as pessoas.
Os números mostram por que as pontas importam mais do que o meio:
| Constatação | Número | Fonte |
|---|---|---|
| Interrupções causadas por mudanças em um sistema em produção | ~70% | Google SRE book |
| Taxa de falha de mudanças, elite vs baixo desempenho | 5% vs 40% | DORA 2024 report |
| Equipes de baixo desempenho quando a aprovação vai para um comitê ou gerente sênior | 2.6x mais provável | DORA 2019 report |
| Grandes interrupções por erro humano causadas por procedimentos não seguidos ou falhos | 85% | Uptime Institute 2025 |
A linha da DORA é a que deveria mudar a sua forma de pensar. A DORA buscou evidências de que a aprovação formal reduz as taxas de falha de mudanças e "não encontrou evidências para sustentar essa hipótese". Portanto, acoplar uma pontuação de risco de IA à mesma reunião do comitê só dá uma versão mais rápida de uma etapa que não tornava as mudanças mais seguras. A aposta melhor é a IA nas entradas (esta solicitação está completa?) e nas saídas (quais tickets esta mudança causou?).
Onde a IA se encaixa em cada etapa de uma mudança?
A IA se encaixa na entrada, na explicação do risco, na preparação do CAB e na onda de tickets pós-mudança. A aprovação e a implementação continuam humanas. Esta é a divisão que eu usaria, com o que as principais ferramentas de ITSM oferecem em cada etapa:
| Etapa | O que a IA faz | O que uma pessoa faz | Disponível hoje |
|---|---|---|---|
| Solicitação | Verifica plano de retorno, evidência de testes e serviços afetados ausentes | Preenche as lacunas | Avaliador de qualidade de mudanças do ServiceNow |
| Verificação de risco | Busca mudanças passadas semelhantes e seus incidentes, explica a pontuação | Responde ou confirma as perguntas de risco | Explicação de risco do ServiceNow, avaliação de risco por IA do JSM, mudanças semelhantes do Freshservice |
| Decisão do CAB | Resume cada mudança, sinaliza conflitos | Aprova ou rejeita | Resumo de mudanças e avaliador de conflitos do ServiceNow, Prevention Center do JSM (acesso antecipado) |
| Execução da mudança | Sugere um horário na agenda | Executa a mudança | Agente de agendamento do ServiceNow |
| Depois da mudança | Liga novos incidentes à mudança provável, redige a resposta de status | Confirma a causa, decide sobre o rollback | Sugestor de mudança de origem do Freshservice (acesso antecipado), IA de helpdesk como a eesel |
Duas coisas se destacam nessa tabela. Primeiro, todos os fornecedores param na mesma linha: a IA sugere, uma pessoa envia. Segundo, a linha "depois da mudança" é a mais fraca. É onde a central de serviços vive, e é de onde vem a maior parte da dor nas discussões de comunidade que li.
A IA pode verificar uma solicitação de mudança antes de o CAB vê-la?
Pode, e é por aqui que eu começaria, porque o risco é baixo e é o que mais economiza idas e vindas. Uma verificação de completude lê a solicitação e sinaliza o que falta antes que um humano gaste tempo com ela.
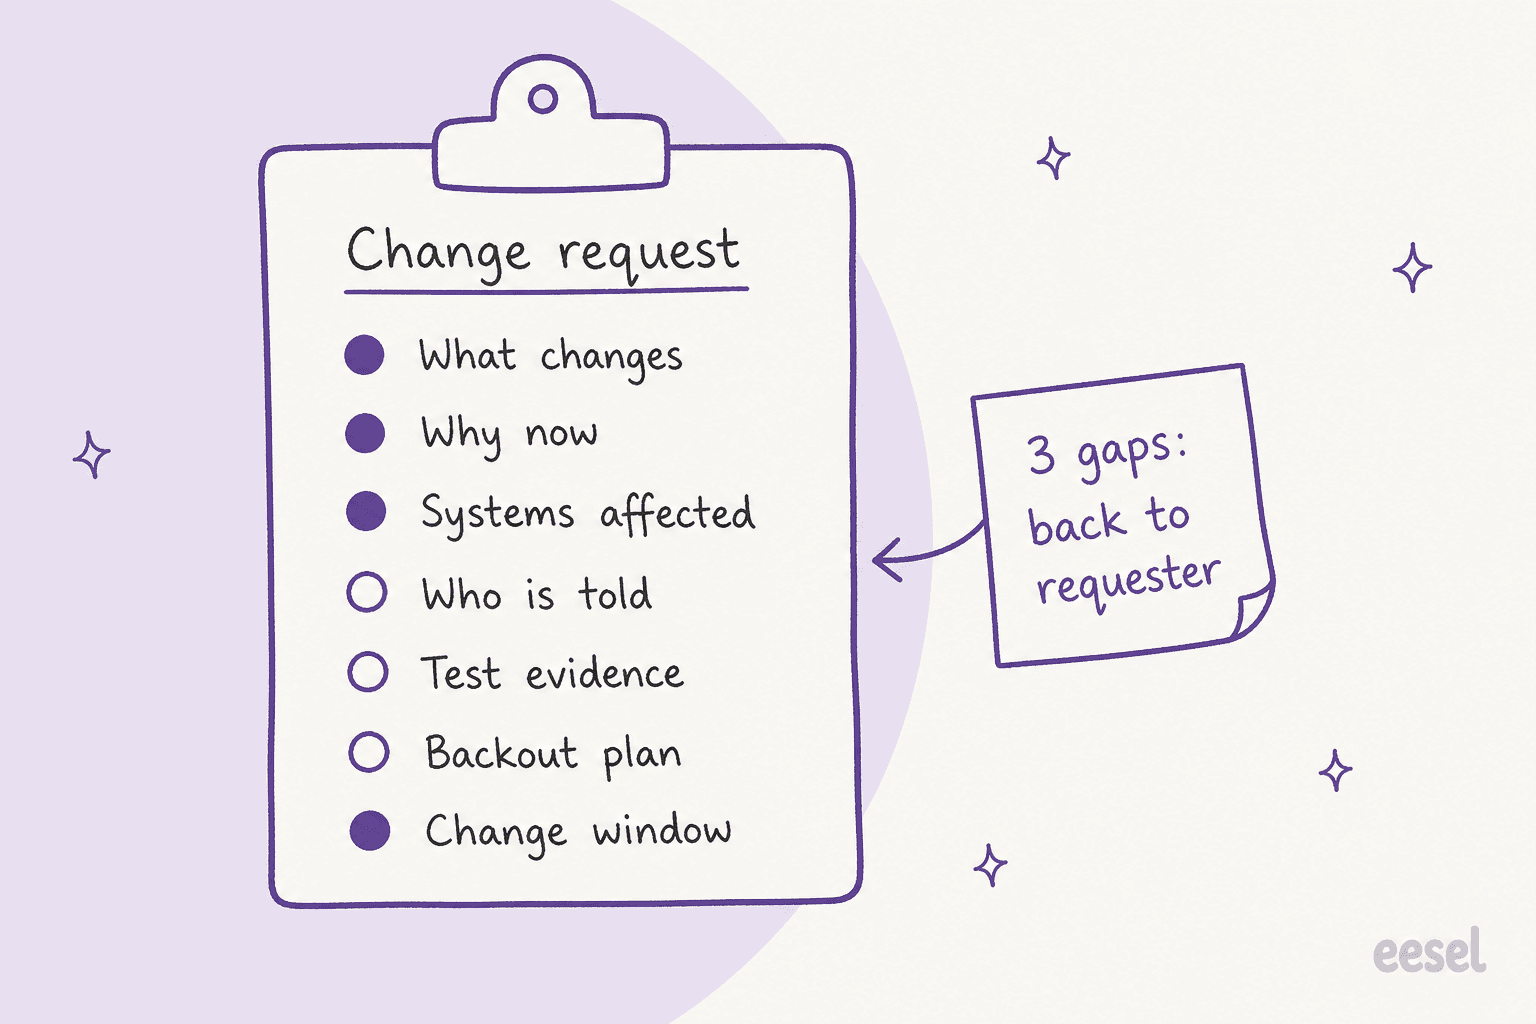
O ServiceNow oferece a versão mais completa disso. Seu avaliador de qualidade de mudanças avalia cinco partes de uma mudança (plano de implementação, plano de retorno, plano de testes, análise de risco e impacto, justificativa) em uma escala de "Excelente" a "Incompleto". Ele consulta primeiro o documento de política de mudanças da sua empresa e só recorre a mudanças semelhantes já encerradas se você não tiver um. Essa ordem importa: escreva a política, e a IA avalia segundo o seu padrão, em vez de segundo o que seu histórico de mudanças por acaso mostrar.
Por que se dar ao trabalho? Porque a pergunta sobre o rollback é a que as reuniões do CAB gastam seu tempo discutindo, e as pessoas sabem disso:
"Tipo, eles não fazem trabalho nenhum de verdade. É só uma pessoa paga para ficar numa reunião de uma hora e perguntar, no final, 'ah, tem plano de rollback?'"

Se a IA faz essa pergunta no momento em que a solicitação é enviada, a reunião não precisa fazer. Equipes menores sem ServiceNow conseguem uma versão disso de graça: um sysadmin de uma empresa pequena sugeriu que a IA produza o próprio documento de mudança ("O que você vai fazer, plano de rollback, risco etc."), segundo uma discussão no r/sysadmin. Um checklist que a IA preenche continua sendo um checklist que alguém lê.
Uma observação prática: em uma central com uma IA de helpdesk na frente, a mesma verificação pode acontecer na conversa. Quando alguém pergunta no Slack "como abro uma mudança para a migração de DNS?", o agente pode responder a partir da sua política de mudanças no Confluence e pedir o plano de retorno logo de início, para que a solicitação chegue completa. Essa é a metade de autoatendimento de uma central de ajuda de TI com IA, aplicada a mudanças.
A IA pode pontuar o risco de uma mudança?
Em parte. A versão útil explica uma pontuação de risco e traz o histórico por trás dela. A versão com a qual é preciso ter cuidado é a que entrega um número e espera que você confie nele.
Veja de perto o que cada ferramenta faz:
- ServiceNow: a pontuação de risco em si vem de um questionário com limites baseados em regras (0 a 25 Baixo, 26 a 50 Moderado, 51 ou mais Alto). A camada de IA fica por cima: ela explica a pontuação usando solicitações de mudança semelhantes e os incidentes que elas causaram, e pode pré-preencher as respostas de risco para uma pessoa revisar antes de enviar.
- Jira Service Management: a avaliação de risco por IA escreve um resumo narrativo com uma pontuação de confiança e uma classificação Baixo, Médio ou Alto. Ela verifica incidentes abertos no serviço afetado, implantações com falha, mudanças rejeitadas no mesmo serviço nos últimos 90 dias e se existem planos de teste e de rollback.
- Freshservice: as políticas de risco de mudanças são baseadas em regras, pontuando cada fator de 0 a 10 com pesos opcionais. A parte de IA do Freddy é encontrar mudanças passadas semelhantes, não produzir a pontuação.
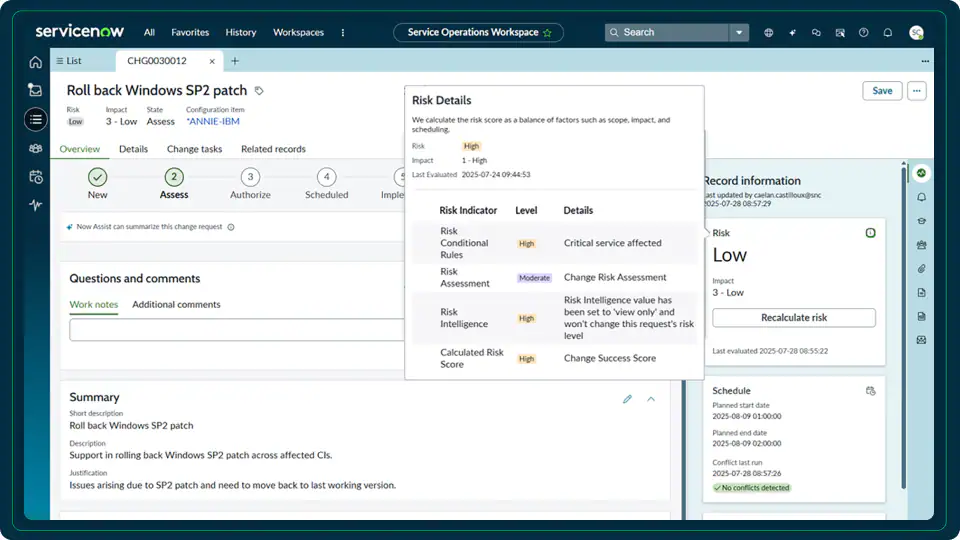
Minha opinião: trate a saída de risco da IA como um briefing, não como um veredito. A documentação do Jira é incomumente direta sobre isso. O recurso não "aprova nem rejeita mudanças automaticamente" e não "fornece previsões garantidas ou determinísticas". Há também uma peculiaridade que vale conhecer antes de o seu CAB se apoiar nisso: a avaliação é gerada por usuário, com base no que cada pessoa tem permissão para ver, então dois aprovadores podem receber resumos diferentes para a mesma mudança.
E entre com expectativas realistas sobre a precisão. A IA do ServiceNow só conhece o seu histórico se ele estiver no ServiceNow, devidamente vinculado. Um profissional explicou por que as demonstrações parecem melhores do que a produção:
"As instâncias de demonstração usadas pelo time de vendas são difíceis de acertar. Não há dados 'históricos' de verdade nelas, então não há nada para ensinar ao modelo de machine learning onde algo deveria ser atribuído."
O inverso também vale. Se as suas mudanças não estiverem vinculadas a serviços e itens de configuração, a parte de "mudanças semelhantes e seus incidentes" não tem nada para cruzar. O Jira diz abertamente que a detecção de conflitos só funciona "quando as mudanças relacionadas estão devidamente vinculadas a serviços ou ativos e incluem datas planejadas de início e fim".
A IA deve substituir o comitê consultivo de mudanças?
Não, mas deve reduzir o que o CAB analisa. O problema honesto da maioria dos CABs não é que as pessoas decidam mal. É que elas decidem sobre tudo, então passam o olho em tudo:
"Era assim que funcionava na teoria nas grandes empresas em que fiz trabalho como contratado. Na prática, porém, era uma sala cheia de outras pessoas técnicas esperando seu nome ser chamado, seguido de um carimbo. Acho que nunca vi uma mudança ser questionada pelos colegas."
Há também um custo de segunda ordem. Agrupar mudanças em torno de uma reunião semanal faz com que todas caiam de uma vez:
"O que mais gosto em levar ao CAB coisas que não deveriam passar pelo CAB é que isso junta mudanças que acontecem todas ao mesmo tempo... depois da reunião do CAB. Agora, se algo quebrar, pode ser qualquer uma das dezenas de coisas que acabaram de ser aplicadas nos 15 minutos depois da reunião."

A orientação atual da DORA sobre simplificar a aprovação de mudanças aponta na mesma direção: pare de "tratar todas as mudanças da mesma forma" e faça "análise contínua para detectar e sinalizar mudanças de alto risco logo no início, para que possam ser submetidas a escrutínio adicional". Isso é um trabalho de triagem, e triagem é o que a IA faz bem. Um bom pacote para o CAB fica assim:
- Mudanças padrão pré-aprovadas por modelo, listadas apenas para conhecimento. O Jira Service Management já aprova automaticamente mudanças padrão com uma regra de automação, e o ServiceNow as trata como pré-autorizadas.
- Solicitações incompletas devolvidas antes da reunião, com as lacunas apontadas.
- Conflitos sinalizados: duas mudanças no mesmo serviço na mesma janela, ou uma mudança dentro de um congelamento.
- As poucas arriscadas, cada uma com um resumo de um parágrafo e as mudanças passadas semelhantes que deram errado.
O resumo de mudanças do ServiceNow lê 17 campos de uma mudança (incluindo os planos de implementação, teste e retorno) e os transforma em um breve resumo, e seu avaliador de conflitos confere os CIs afetados com as janelas de bloqueio e manutenção. O Prevention Center da Atlassian reúne um resumo de mudanças, um mapa de dependências e uma verificação de choque de calendário, mas ainda está em um programa aberto de acesso antecipado, então confira o seu plano antes de planejar em cima dele.
O comitê então gasta sua hora no item 4. Essa é a versão de CAB que a DORA chama de "arquiteto de processos e farol de informação", em vez de porteiro.
O que acontece na central de serviços depois que uma mudança dá errado?
Os tickets chegam antes que alguém os conecte à mudança. Essa é a etapa que eu diria que mais importa para uma equipe de TI, e a que os fornecedores de ITSM menos cobrem.
A escala pode ser enorme. Quando a CrowdStrike lançou uma atualização de conteúdo defeituosa em 19 de julho de 2024, ela ficou no ar por cerca de 78 minutos antes de ser revertida, segundo sua própria análise, e a Microsoft estimou que ela atingiu 8,5 milhões de dispositivos Windows. A maioria das mudanças internas é bem menor, mas o formato na central de serviços é o mesmo: uma causa, dezenas de tickets que descrevem, cada um, um sintoma diferente.
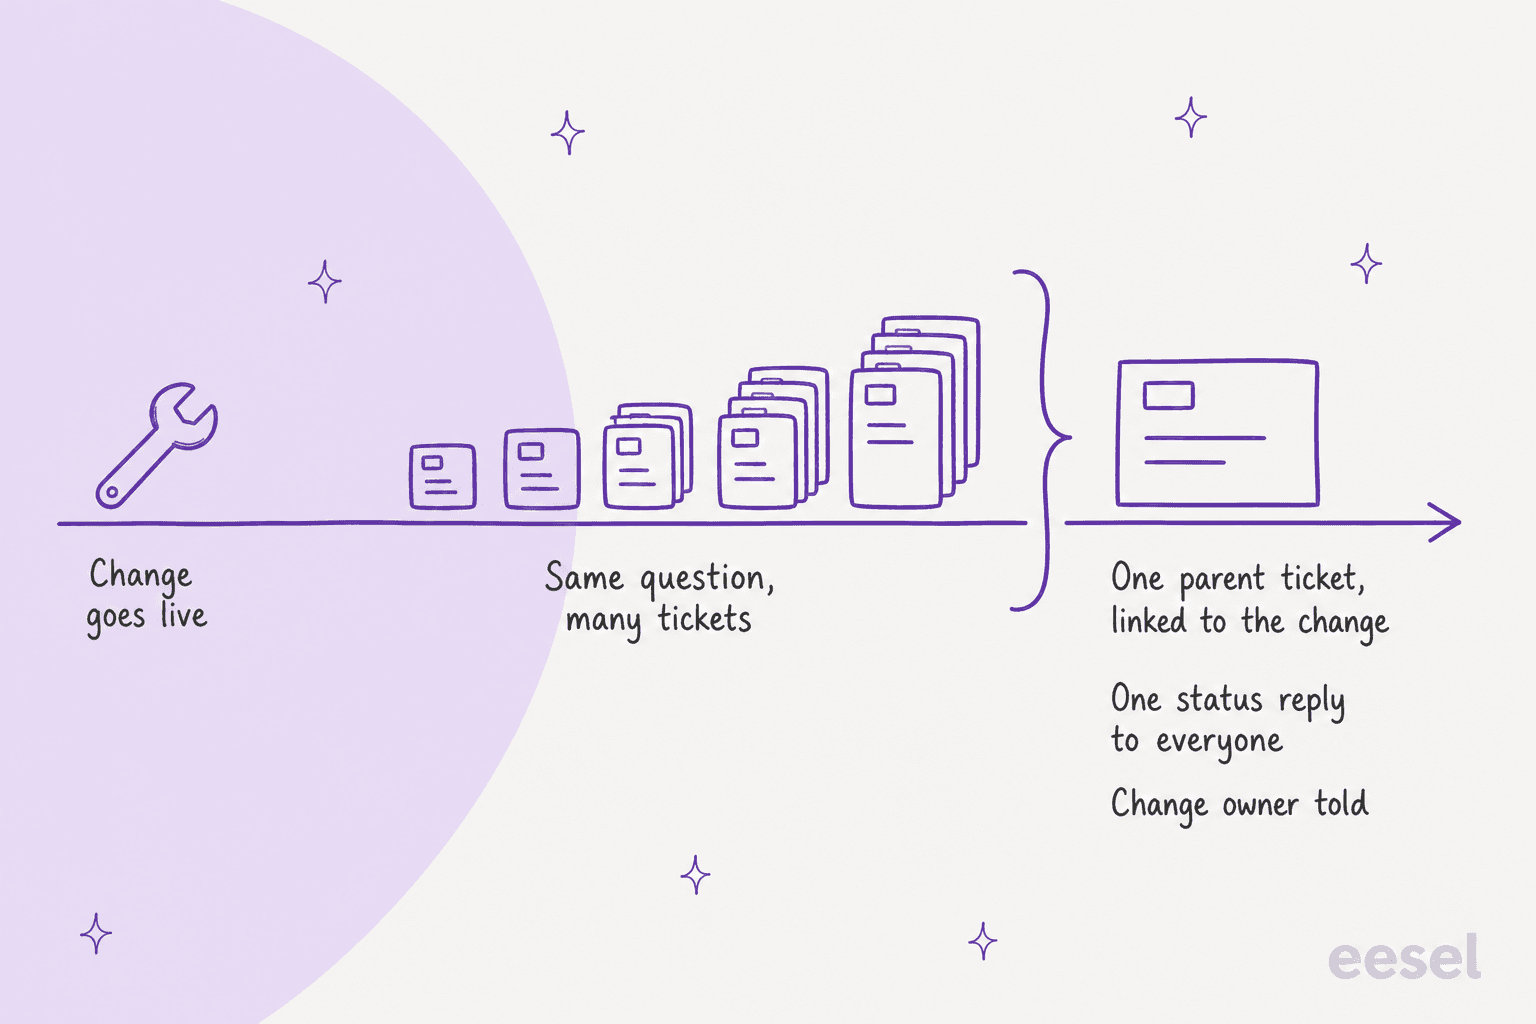
As pessoas que atendem essa central a descrevem do mesmo jeito:
"Não sei se isso vai ajudar, porque estou na Central de Serviços, mas aqui é igual. Toda vez que lançamos ou atualizamos algo, apesar de gastar tempo com testes etc., temos que começar a apagar incêndios quase imediatamente depois. É muito cansativo."
E a pior versão é a mudança de que ninguém avisou. Em uma discussão do r/sysadmin, uma mudança aprovada foi executada em um sábado em que a fábrica deveria estar fechada; o gerente de produção não tinha sido avisado de que era um dia de produção dobrada, e o usuário estimou o custo em US$ 1,5 milhão por uma interrupção de 3 horas.
Veja o que a IA pode fazer nessa primeira hora:
- Identificar o padrão. Vários tickets novos sobre o mesmo serviço em uma janela curta são um sinal, a mesma ideia da deduplicação de tickets.
- Buscar mudanças recentes nesse serviço. No Jira Service Management, mudanças são issues, então uma busca em JQL por mudanças no serviço afetado nos últimos dias responde "algo mudou?" em segundos.
- Deixar uma nota interna em cada ticket com a chave da mudança provável, para que o agente que pegar o ticket comece pela causa em vez de do zero.
- Enviar uma única resposta de status a todos os afetados, redigida uma vez e aprovada uma vez. É o mesmo trabalho das atualizações de página de status e da comunicação de incidentes graves, só que disparado por uma mudança.
- Avisar o responsável pela mudança com a contagem de tickets, para que a decisão sobre o rollback seja tomada com evidências.
O Freshservice tem o recurso nativo mais próximo. Seu sugestor de mudança de origem classifica as mudanças encerradas nos últimos 14 dias que podem ter causado um incidente, e um agente vincula a correta manualmente. Está em acesso antecipado e exige o complemento Copilot.
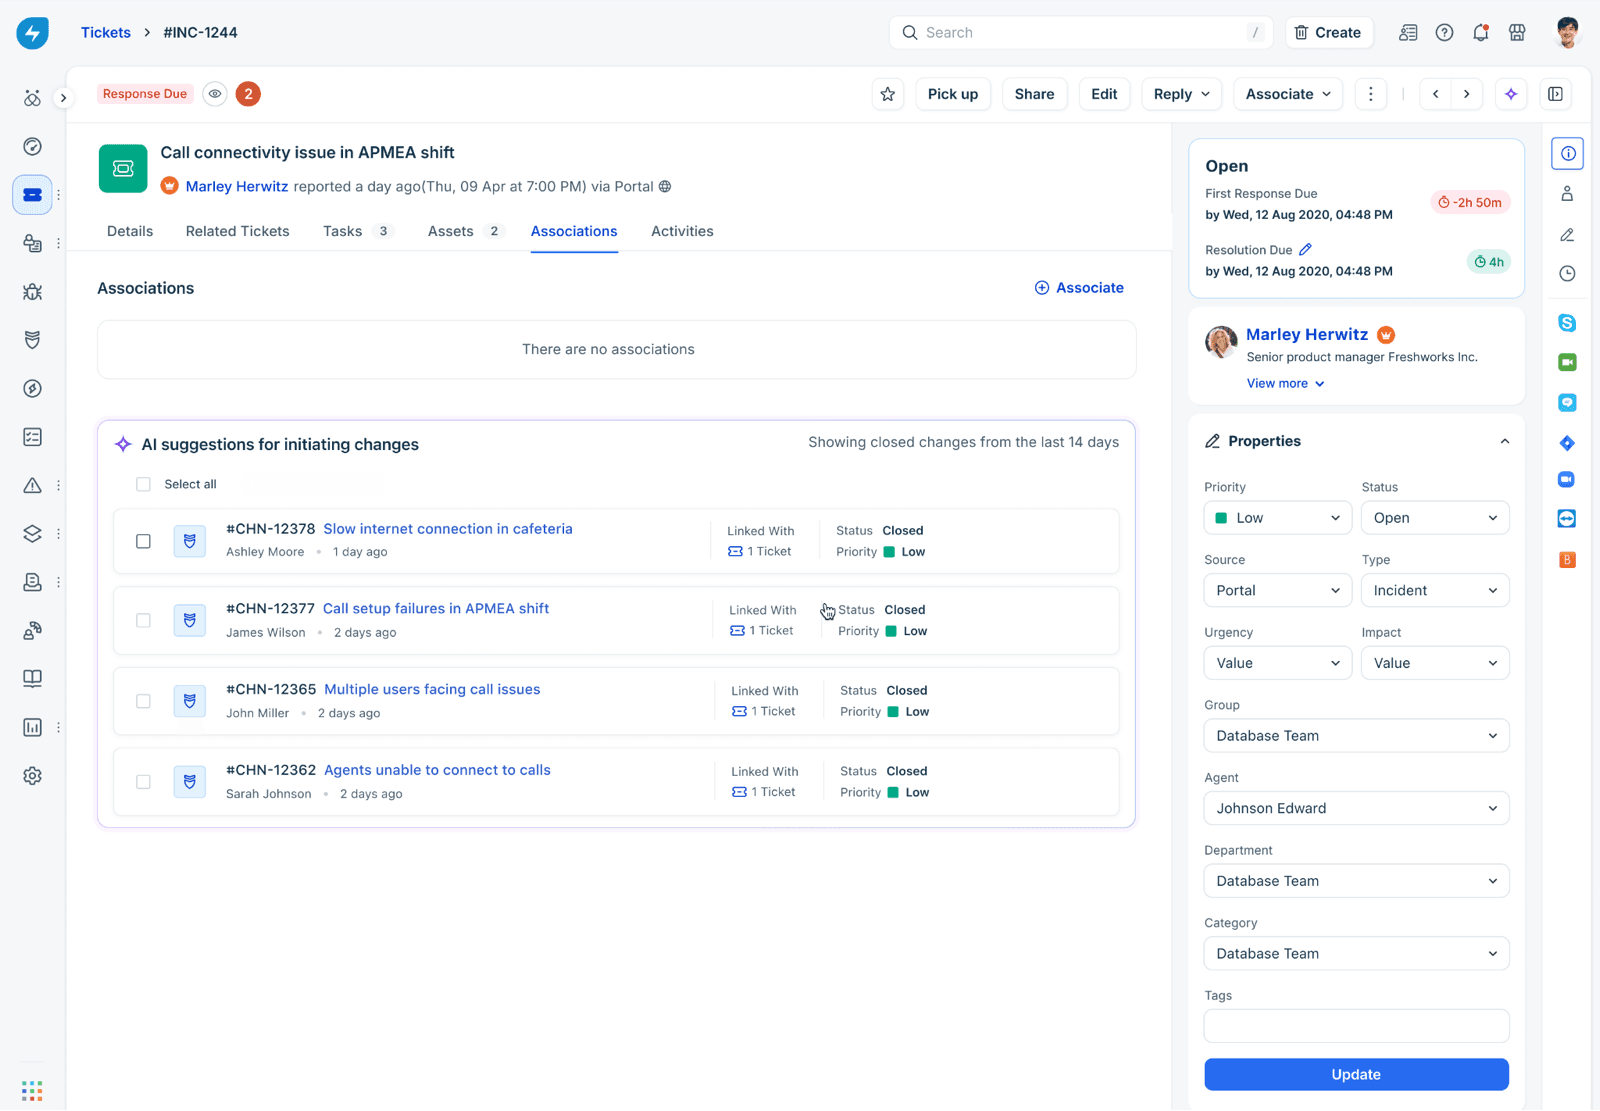
A janela de 14 dias é uma salvaguarda sensata. Uma mudança do mês passado raramente é a causa dos tickets desta manhã, e uma IA que a sugere mesmo assim só adiciona ruído.
Quais ferramentas de ITSM têm IA para gestão de mudanças?
O ServiceNow tem o conjunto mais profundo, o Jira Service Management tem a avaliação de risco mais bem documentada e o Freshservice tem o vínculo mais forte do incidente de volta à mudança. Uma IA do lado do helpdesk, como a eesel, cobre a onda de tickets e as conversas com os solicitantes, seja qual for o ITSM que guarda o registro da mudança. Veja como se comparam nos detalhes que um comprador de fato confere:
| ServiceNow | Jira Service Management | Freshservice | eesel (camada de helpdesk) | |
|---|---|---|---|---|
| Gestão de mudanças no plano | ITSM Advanced ou superior | Premium e Enterprise | Pro e Enterprise | Funciona junto ao seu ITSM |
| Preço de tabela | Apenas sob consulta | Premium $55.28/agente/mês | Pro $99/agente/mês (anual) | A partir de $299/mês por 500 créditos |
| Custo da IA | AI Agents for ITSM listado no Prime | Créditos Rovo incluídos por usuário | Complemento Copilot $29/agente/mês | Incluída, 1 crédito por ticket |
| Verificação de qualidade da solicitação | Sim, avaliador de 5 áreas | Parcial (verifica planos de teste e rollback) | Não | Na conversa, a partir do seu documento de política |
| Pontuação de risco | Pontuação baseada em regras, IA a explica | Classificação de IA Baixo/Médio/Alto | Política baseada em regras | Não |
| Ajuda com conflitos e agenda | Avaliador de conflitos, agente de agendamento | Conflitos de calendário (acesso antecipado) | Calendário de mudanças (não é IA) | Não |
| Vínculo de incidente com mudança | A explicação de risco cita incidentes passados | Verifica incidentes abertos no serviço | Sugestor de mudança de origem (acesso antecipado) | Busca em JQL e nota interna em novos tickets |
| Aprova mudanças | Não, o gerente do CAB decide | Não, os aprovadores decidem | Não, votação do CAB | Não, ações de escrita podem exigir aprovação |
| Resposta de status aos usuários afetados | Não coberto aqui | Não coberto aqui | Não coberto aqui | Redige e envia, ou segura para aprovação |
Fontes: pacotes ITSM do ServiceNow, preços da Atlassian e preços do Freshservice. A página da Atlassian tem um seletor de tamanho de equipe e de cobrança, então confira o valor atual para a sua quantidade de licenças.
ServiceNow Otto (Now Assist) para ITSM
A documentação do ServiceNow agora chama seu app de IA generativa de "ServiceNow Otto for IT Service Management", enquanto a página de preços ainda diz Now Assist. Ela lista oito fluxos agênticos de mudanças, incluindo avaliação de conflitos, avaliação de qualidade, agendamento, sugestões de CI e criação conversacional de mudanças.
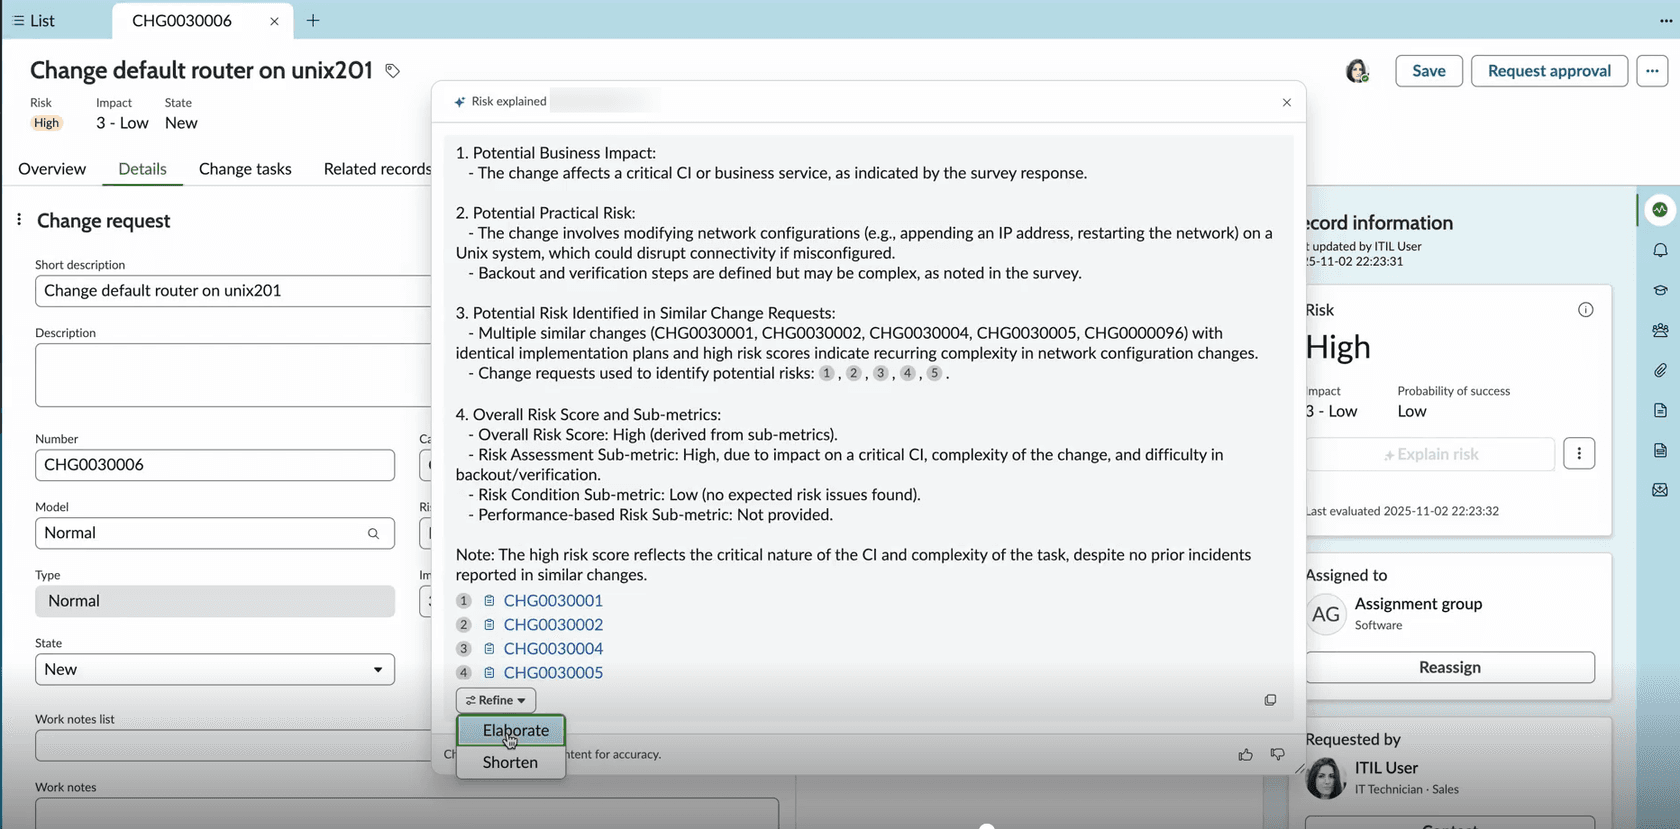
O que eu gosto: as salvaguardas são explícitas. Por padrão, todos os registros de fluxo de agente são somente leitura, e executar um por conta própria significa duplicá-lo, ativá-lo e dar-lhe um gatilho. Os agentes de conflito, qualidade e agendamento são acionados manualmente. O que planejar: o Change Management não está no pacote Foundation, e o item "AI Agents for ITSM" aparece apenas no Prime, então reserve uma conversa para pedir cotação. A opinião dos profissionais é mista, com uma resposta no r/servicenow chamando a IA de "mais discurso de vendas do que realidade" e outra esperando que ela fique razoável em um ano. Os detalhes de custo estão em nosso detalhamento de preços do ServiceNow.
Nossa opinião: escolha-o se você já está no ServiceNow ITSM Advanced ou Prime e seu CMDB está em bom estado. Só o avaliador de qualidade já vale a pena ativar.
Jira Service Management com Rovo
A avaliação de risco por IA da Atlassian, com tecnologia do Rovo (o agente por trás dela agora se chama Ops Expert), lê artigos vinculados da base de conhecimento, URLs na descrição da mudança e pipelines de implantação conectados. Ela divide o risco em dimensões técnica e operacional e sugere mitigações; aceitar uma cria uma tarefa de acompanhamento vinculada à mudança.
O que eu gosto: ela consegue rodar uma análise estática básica de código em pull requests vinculados, uma vantagem real para equipes em que as mudanças são implantações. O bloqueio de implantação pode pausar um pipeline do Bitbucket ou do Jenkins até que a mudança seja aprovada. O que planejar: todo recurso de mudanças fica no Premium ou Enterprise desde 16 de outubro de 2024, ela não é compatível com HIPAA e a saída varia por usuário conforme as permissões. Veja a IA do Jira Service Management e o Rovo para um panorama maior.
Nossa opinião: a melhor opção para equipes em que a maioria das mudanças vem de CI/CD. Se você está no Standard, a avaliação de risco por IA é um motivo para cotar o Premium, não um motivo para trocar de ferramenta.
Freshservice com Freddy AI
A IA de mudanças do Freshservice trata de histórico, não de previsão. O sugestor de mudanças semelhantes mostra mudanças correspondentes de até 6 meses atrás, com o nível de risco de cada uma e a quantidade de incidentes a que foi vinculada.
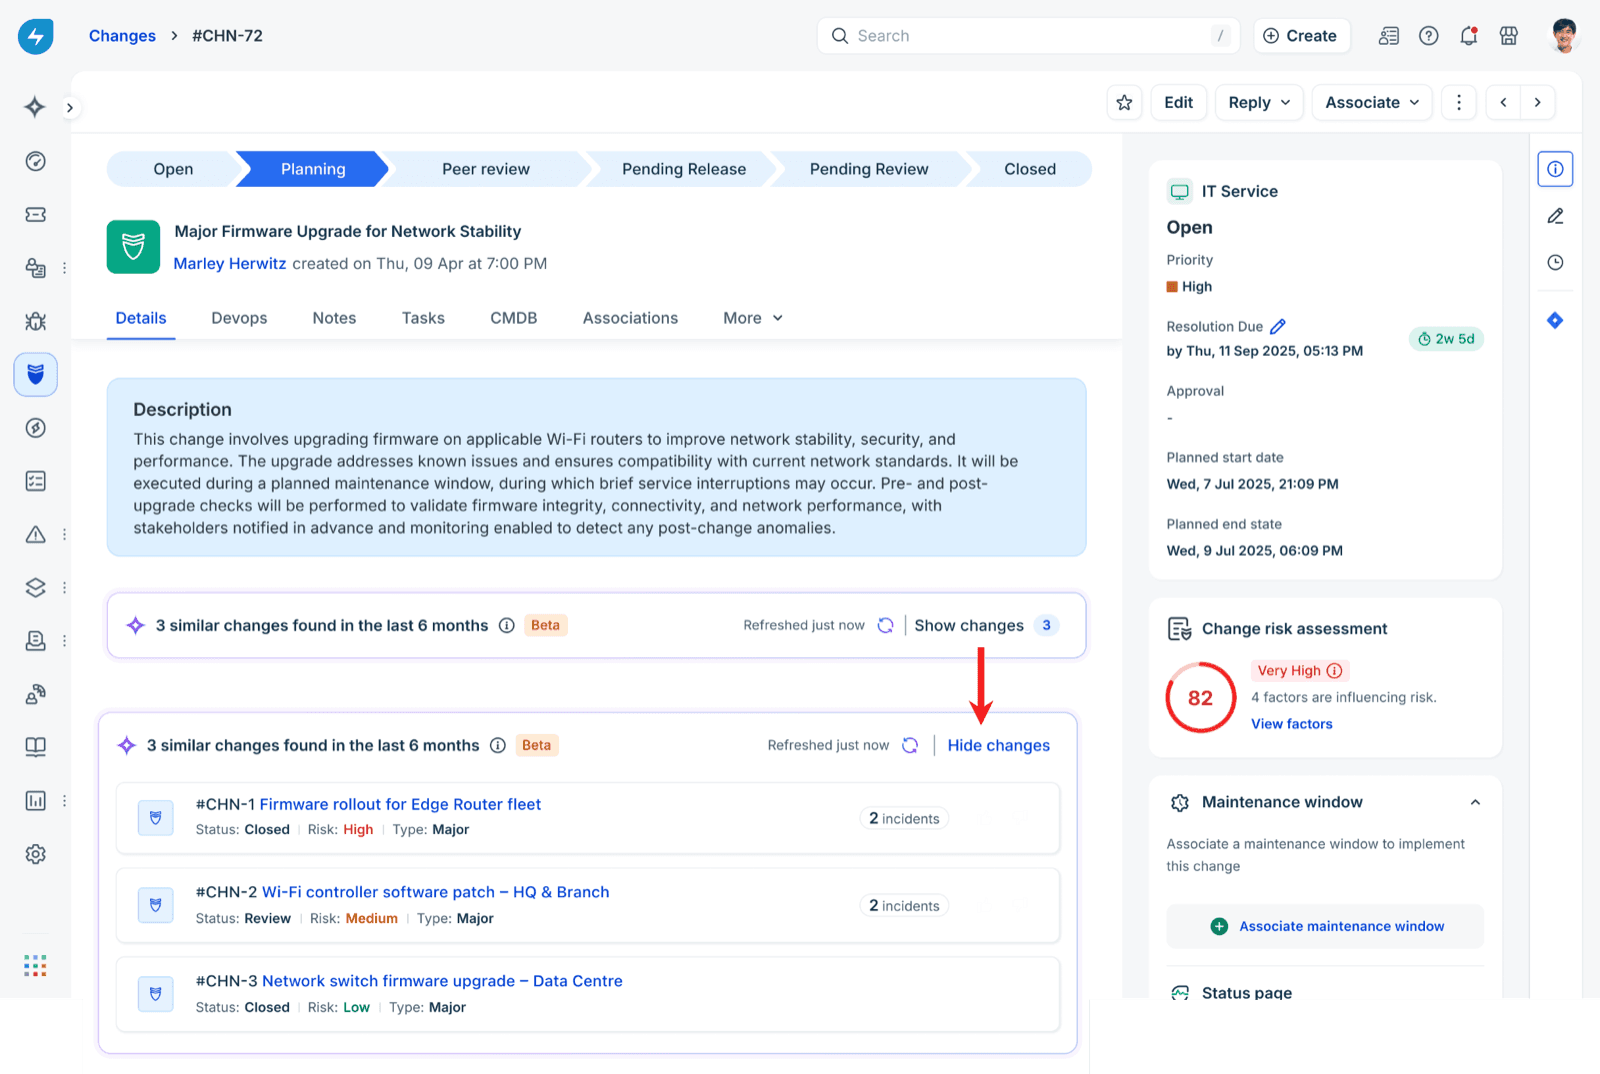
O que eu gosto: "essa mesma mudança causou 2 incidentes da última vez" é a coisa mais persuasiva que você pode colocar diante de um aprovador, e está bem no registro da mudança. O que planejar: a pontuação de risco é baseada em regras, um construtor de questionário de risco com IA está listado para uma versão futura em vez de ativo, e os dois recursos de IA para mudanças exigem o complemento Copilot. Comparando plataformas? Veja Freshservice vs ServiceNow e Freshservice vs Jira Service Management.
Nossa opinião: forte para equipes de TI de médio porte que já pagam pelo Pro. Ative o sugestor de mudança de origem assim que o seu CSM puder habilitá-lo.
eesel no lado da central de serviços
A eesel não é um ITSM e não guarda o seu registro de mudanças. É uma colega de IA que entra na fila do seu helpdesk, então seu papel na gestão de mudanças é o lado dos tickets: responder a quem pergunta como abrir uma mudança, trabalhar a onda de tickets depois de uma e manter o responsável pela mudança informado. Ela se conecta nativamente ao Jira Service Management e ao Zendesk. No JSM, ela pega novas solicitações e comentários, responde ou deixa uma nota interna, e pode buscar issues com JQL, rotulá-las, atribuí-las e movê-las pelo fluxo de trabalho. Ela lê as issues ao vivo em vez de aprender com o seu histórico do Jira, e seu conhecimento vem de fontes como o Confluence.
Para ServiceNow ou Freshservice, não há conector embutido. O caminho é a API da ferramenta por meio do Network Access, ou um servidor MCP se você tiver um, então esteja pronto para configurar isso por conta própria. Mais sobre isso em IA para ferramentas de ITSM.
Nossa opinião: adicione-a quando a dor estiver na central de serviços, não no CAB. Ela é cobrada por ticket atendido, não por licença de agente.
Como configuro a IA para gestão de mudanças?
Comece pelo passo mais barato e seguro e vá avançando. Esta é a ordem que eu seguiria em uma equipe interna de TI típica, e ela acompanha a ordem em que a sua confiança na IA deve crescer:
- Escreva a sua política de mudanças. Um documento: o que cada tipo de mudança exige, como é um bom plano de retorno, quem aprova o quê, quando são as janelas de congelamento. O avaliador de qualidade do ServiceNow lê primeiro um documento de política, e qualquer outra IA funciona melhor com um também. Coloque-o onde a sua IA possa lê-lo, como o Confluence ou o Google Drive.
- Ative a verificação de completude, em modo de sugestão. Deixe a IA sinalizar lacunas em novas solicitações por algumas semanas sem bloquear nada. Conte com que frequência uma pessoa concorda com ela.
- Vincule as mudanças a serviços e datas. A detecção de conflitos, o cruzamento de mudanças semelhantes e o vínculo de tickets pós-mudança dependem disso. É o passo pouco glamouroso que faz o resto funcionar.
- Conecte a central de serviços ao registro de mudanças. Seja o sugestor do Freshservice, uma busca em JQL no JSM ou um agente de helpdesk, o objetivo é o mesmo: um novo incidente é conferido com as mudanças recentes naquele serviço. Teste primeiro em tickets antigos; eu rodaria uma simulação com tickets passados da sua última mudança ruim antes de confiar nela ao vivo.
- Mantenha as ações de escrita atrás de aprovação. Qualquer coisa que envie uma mensagem a todos, faça a transição de um ticket ou toque no registro da mudança deve perguntar a uma pessoa primeiro, até que você a veja acertar por um tempo. Na eesel, cada ação roda por conta própria, pergunta antes ou fica desligada, e as aprovações podem chegar como um cartão no Slack.
- Trate as instruções da IA também como uma mudança. Se as regras do agente alteram como os tickets são tratados, versione-as e implante-as como qualquer outra mudança. A Swiftreg mantém suas instruções da eesel como versões numeradas, implantadas por meio do seu próprio procedimento em vez de editadas ao vivo, que é exatamente o hábito que você quer de uma equipe de TI.
- Meça três números. Solicitações incompletas devolvidas, taxa de falha de mudanças (a definição da DORA: implantações que exigem um hotfix ou rollback) e tickets por mudança com falha. Se o terceiro número cai e ninguém está cobrando planos de rollback no CAB, está funcionando. Uma configuração de relatórios de suporte facilita extrair o terceiro.

O que a IA nunca deve fazer na gestão de mudanças?
Mantenha esta lista curta e imponha-a nas permissões da ferramenta, não apenas em um prompt:
- Aprovar ou rejeitar uma mudança normal ou emergencial. Nenhum dos três grandes ITSMs permite isso, e você não deve construir um contorno.
- Executar a mudança. Sugestões de agendamento são aceitáveis; tocar na produção, não.
- Declarar a causa de um incidente. Ela pode apontar a mudança provável. Uma pessoa confirma.
- Encerrar tickets como resolvidos porque houve um rollback. Confirme com o solicitante; um rollback pode consertar o serviço e deixar para trás um estado quebrado na conta do usuário.
- Editar por conta própria os planos do registro da mudança. O agente autônomo de qualidade do ServiceNow é um bom modelo aqui: ele salva sua pontuação e suas notas "sem definir valores nos campos da solicitação de mudança".
O fio condutor é a responsabilidade. Se algo der errado, a revisão pós-incidente precisa de uma pessoa identificada que decidiu, e "a IA aprovou" não é uma resposta que os seus auditores vão aceitar. Para um olhar mais profundo sobre os níveis de acesso, veja o guia de revisão de segurança de IA.
Experimente a eesel na sua central de serviços de TI
Se as mudanças estão chegando à sua central de serviços como uma pilha de tickets confusos, a eesel pode ficar nessa fila como colega de equipe. No Jira Service Management, ela busca mudanças recentes no serviço afetado, deixa uma nota interna com a chave da mudança provável em cada novo ticket e redige uma única resposta de status para uma pessoa aprovar. Ela também responde "como abro uma mudança?" no Slack a partir da sua própria política. A InDebted a usa como primeira respondente em uma central interna de JSM e a faz resolver 15% dos tickets sozinha, com 55% como meta. No Zendesk, o Cactus Club Cafe a usa no suporte técnico interno, onde ela redigiu 790 respostas em um mês seguindo os runbooks da equipe passo a passo.
Há um plano gratuito com 100 créditos, e os planos pagos começam em $299 por mês por 500 créditos, sem taxa por licença. Experimente a eesel nos tickets de mudança do mês passado e veja o que ela teria sinalizado.