

Por que vejo o Hermes como mantenedor da KB, não como a KB
Eu trabalho na fila de suporte da eesel todos os dias, e quando uma resposta de IA dá errado, raramente o culpado é o modelo. É o artigo de ajuda. Uma gerente de suporte de um serviço de rastreamento de ônibus, com 200 a 250 tickets do Zendesk por mês, percebeu numa ligação conosco que toda a base de conhecimento fora escrita para administradores, enquanto os tickets vinham de passageiros. Cada resposta era tecnicamente correta e praticamente inútil. Outra equipe, uma fornecedora dinamarquesa de energia solar, viu um bot inventar respostas e enviá-las a clientes reais sempre que a base de conhecimento não tinha correspondência.
Então "um agente de IA consegue gerir minha base de conhecimento?" são na verdade duas perguntas. Ele consegue guardar o conhecimento e consegue mantê-lo atualizado? Para o Hermes Agent, o agente de código aberto da Nous Research, as respostas honestas são "não" e "sim, com cuidado".
O Hermes é um agente auto-hospedado, com licença MIT, que você executa na sua própria máquina ou servidor, e um dos melhores agentes de IA de código aberto que existem. Se você é novo nele, minha análise do Hermes Agent cobre o básico.
Os guias de atendimento ao cliente e de suporte de TI interno cobrem os outros dois trabalhos que as pessoas tentam dar a ele. Este trata do trabalho pouco glamoroso da gestão da base de conhecimento: manter os artigos corretos, fáceis de encontrar e completos.
O que o Hermes realmente sabe (e onde guarda)
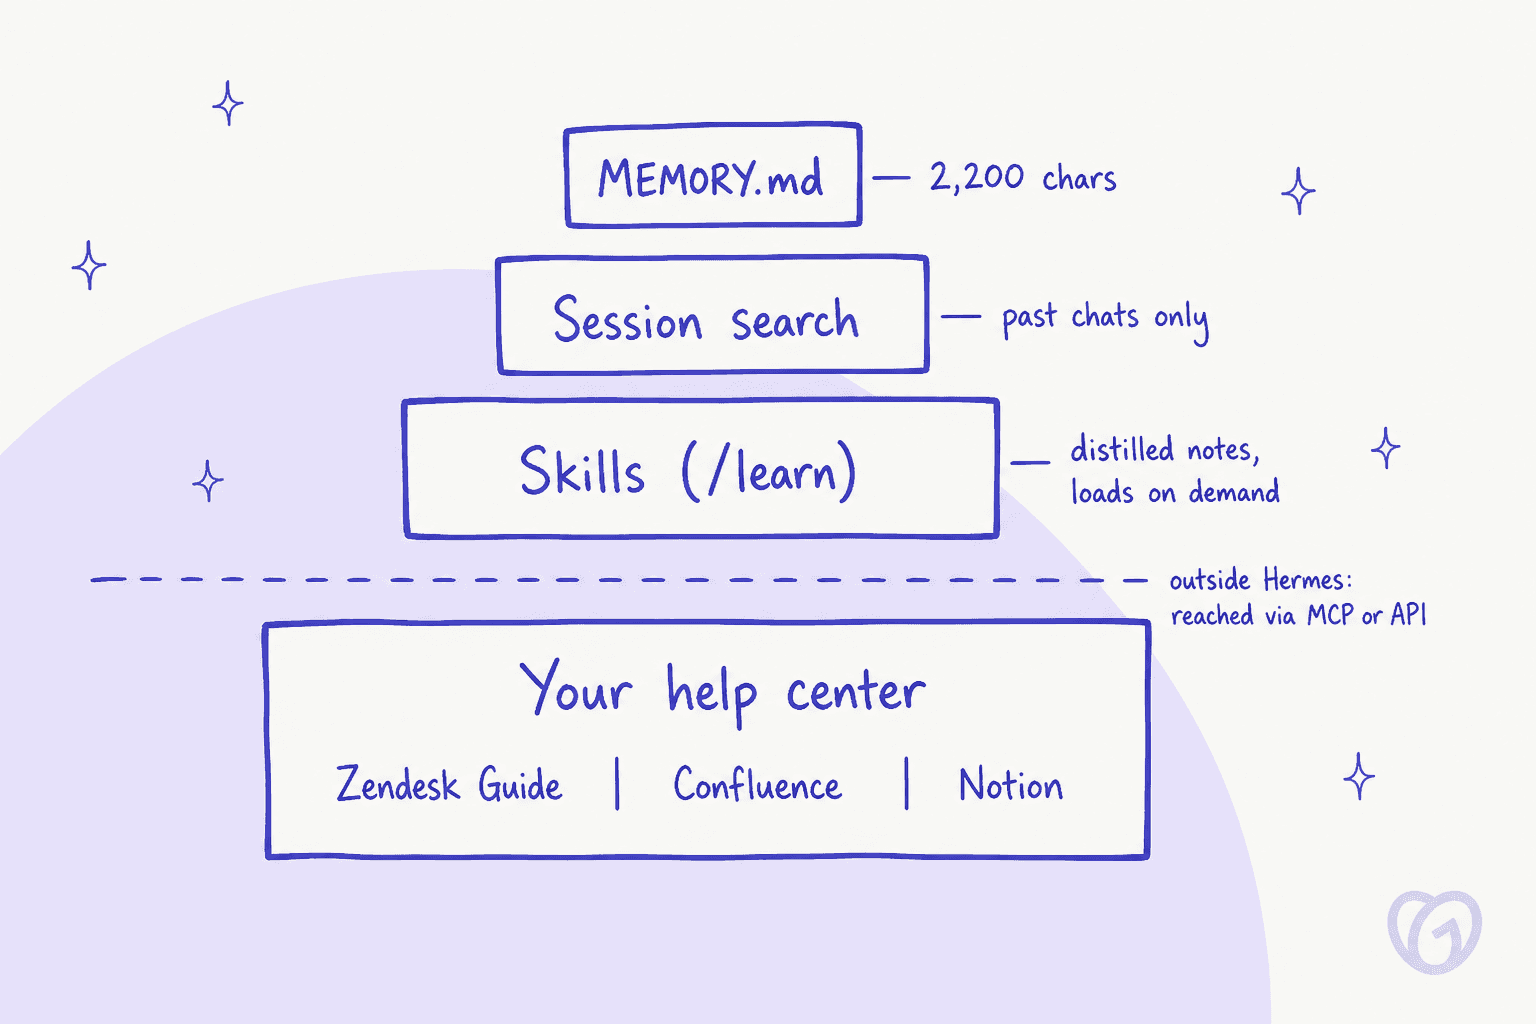
O Hermes tem quatro lugares onde o conhecimento pode ficar, e eles têm tamanhos muito diferentes. A maior parte da confusão sobre "Hermes como base de conhecimento" vem de misturá-los.
Memória: pequena de propósito
A memória persistente do Hermes são dois arquivos. O MEMORY.md guarda as anotações do próprio agente, com 2,200 caracteres (cerca de 800 tokens), e o USER.md guarda o seu perfil, com 1,375 caracteres. Isso dá mais ou menos 8 a 15 entradas. Ambos são carregados no prompt do sistema como um instantâneo congelado quando a sessão começa, e a memória não se compacta sozinha: uma escrita acima do limite devolve um erro e o agente precisa abrir espaço.
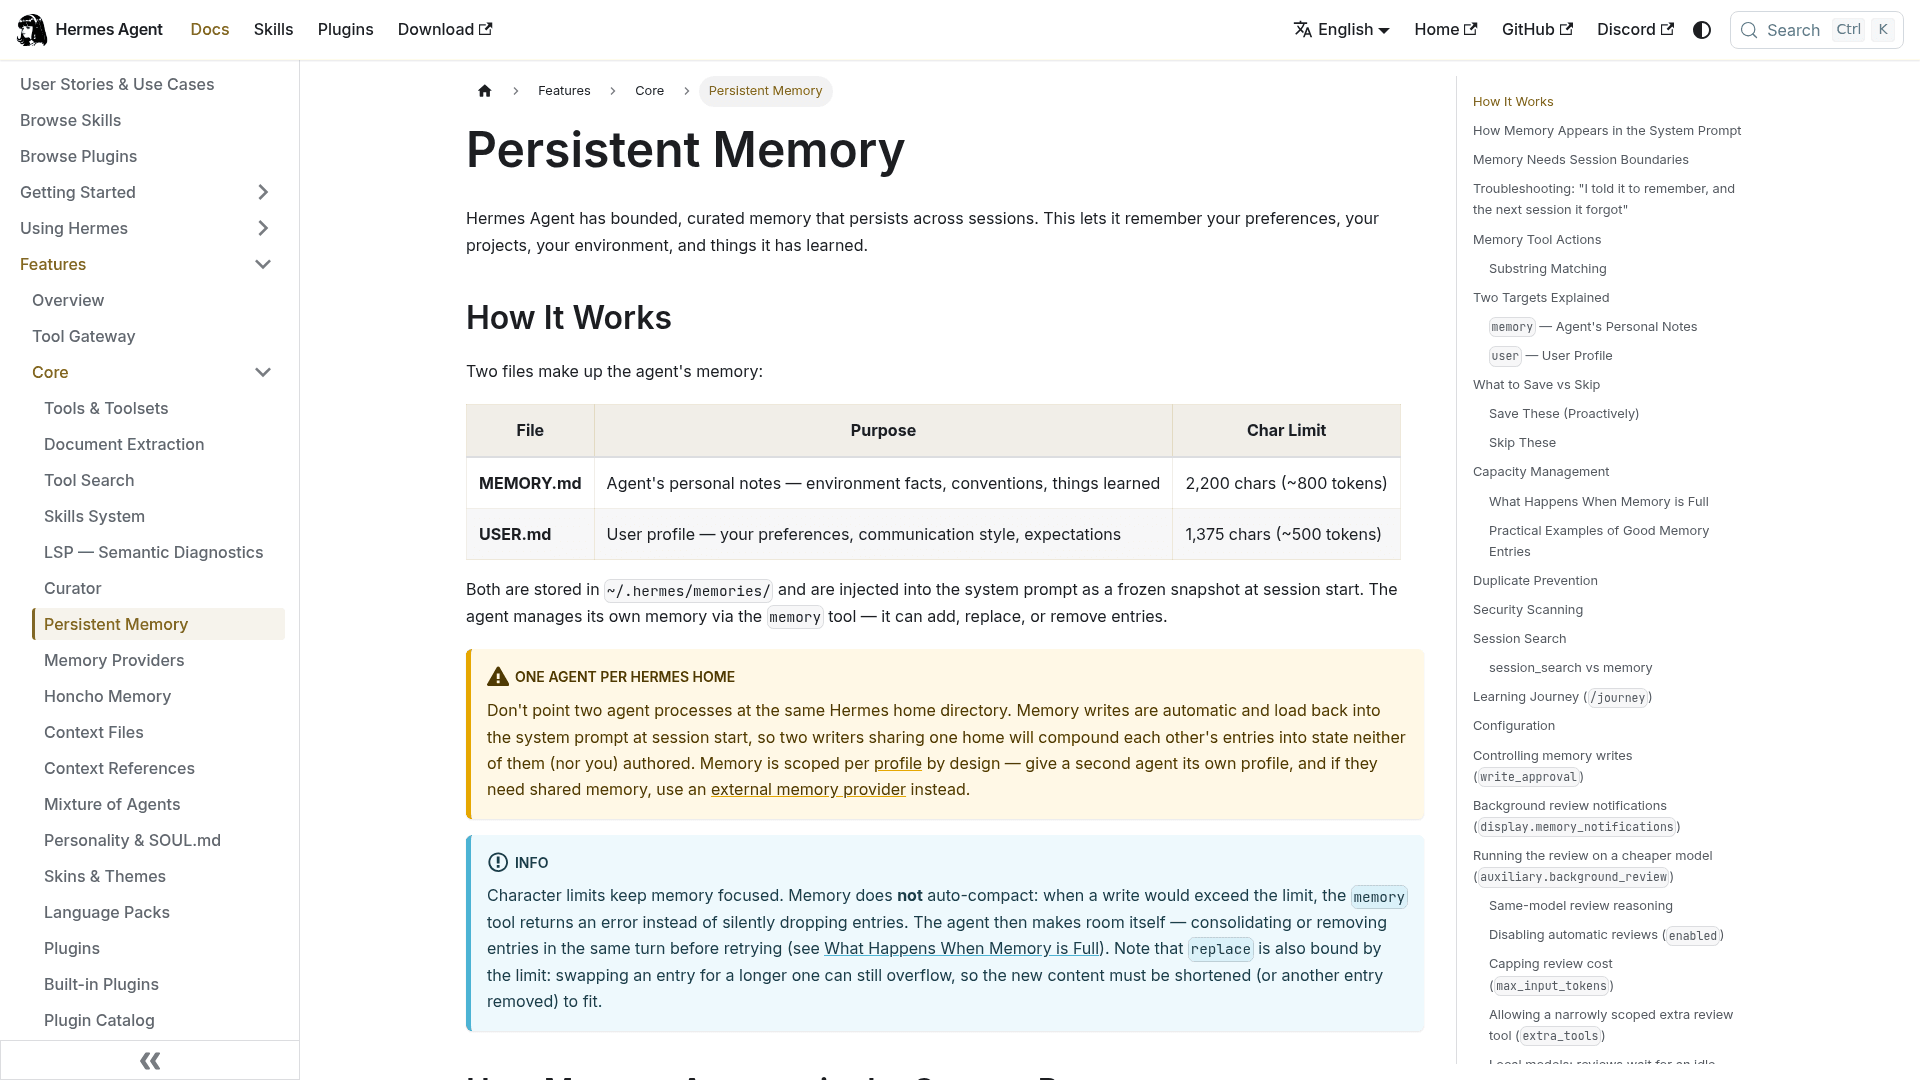
A documentação é refrescantemente direta sobre o que não pertence ali. "Raw data dumps" estão na lista do que deve ser evitado, e para qualquer coisa de que o agente precise em toda execução, a documentação diz que um skill é "often the better home than a memory entry". Um único artigo de ajuda sobre sua política de reembolso consumiria uma boa fatia desse orçamento. Uma central de ajuda não cabe, e nunca foi feita para caber.
Busca de sessões: conversas, não documentos
O session_search executa uma busca de texto completo em SQLite sobre cada conversa passada, a cerca de 20 ms por consulta, sem chamadas ao modelo. É ótimo para "a gente discutiu isso semana passada?". Ele não indexa arquivos, documentos nem a sua central de ajuda. Um documento só se torna pesquisável aqui se o texto dele apareceu numa conversa passada.
Skills: o mais próximo de uma KB integrada
Os skills são documentos de conhecimento sob demanda, carregados apenas quando relevantes. O comando /learn transforma uma pasta de documentos ou uma URL em um "skill de base de conhecimento": um SKILL.md enxuto mais um arquivo destilado por tópico em references/. Executar /learn de novo sobre o mesmo tema incorpora o material novo ao skill existente.
Duas ressalvas importam para o trabalho com KB:
- É um resumo, não um espelho. A documentação diz que a destilação "never reproduces passages of the source text". Isso é útil para ensinar o agente sobre o seu produto, mas não é uma cópia dos seus artigos que você possa citar a um cliente.
- Skills sem uso são arquivados. O curator marca skills criados pelo agente como obsoletos após
14dias sem uso e os move para uma pasta de arquivo após30. Um skill de conhecimento que você só toca numa auditoria trimestral vai desaparecer em silêncio, a menos que você o fixe comhermes curator pin <skill>.
Sua base de conhecimento de verdade: fora, acessada por MCP ou API
O Hermes não tem RAG nem busca vetorial integrados. Busca semântica sobre documentos significa optar por algo: um provedor de memória externo (OpenViking e RetainDB são os dois documentados com ingestão de documentos, e o RetainDB custa $20/month), o skill de busca opcional qmd ou um skill de banco de dados vetorial que você mesmo executa. Todo o resto fica na sua KB real, que o Hermes acessa por MCP, o protocolo de plug-ins que ele usa para ferramentas externas, ou por chamadas de API simples.
Essa divisão é todo o modelo mental. Sua central de ajuda é a fonte da verdade. O Hermes é um trabalhador que a visita, o mesmo padrão que descrevo para conectar a IA ao conhecimento da empresa.
Os três trabalhos de KB que o Hermes faz bem
Quando você para de pedir ao Hermes que seja a base de conhecimento, ele fica útil rápido. Estes são os três trabalhos que eu entregaria a ele.
1. Auditorias semanais de um wiki em markdown ou repositório de documentação
O skill llm-wiki incluído (baseado na ideia de LLM Wiki de Andrej Karpathy) constrói uma base de conhecimento em markdown com links cruzados e vem com uma passagem de lint. Esse lint verifica páginas órfãs, links quebrados, entradas de índice ausentes, contradições, desvio em relação às fontes, páginas com mais de 200 linhas e conteúdo desatualizado, definido como páginas cuja data updated é mais de 90 dias anterior à fonte mais recente que menciona os mesmos temas.
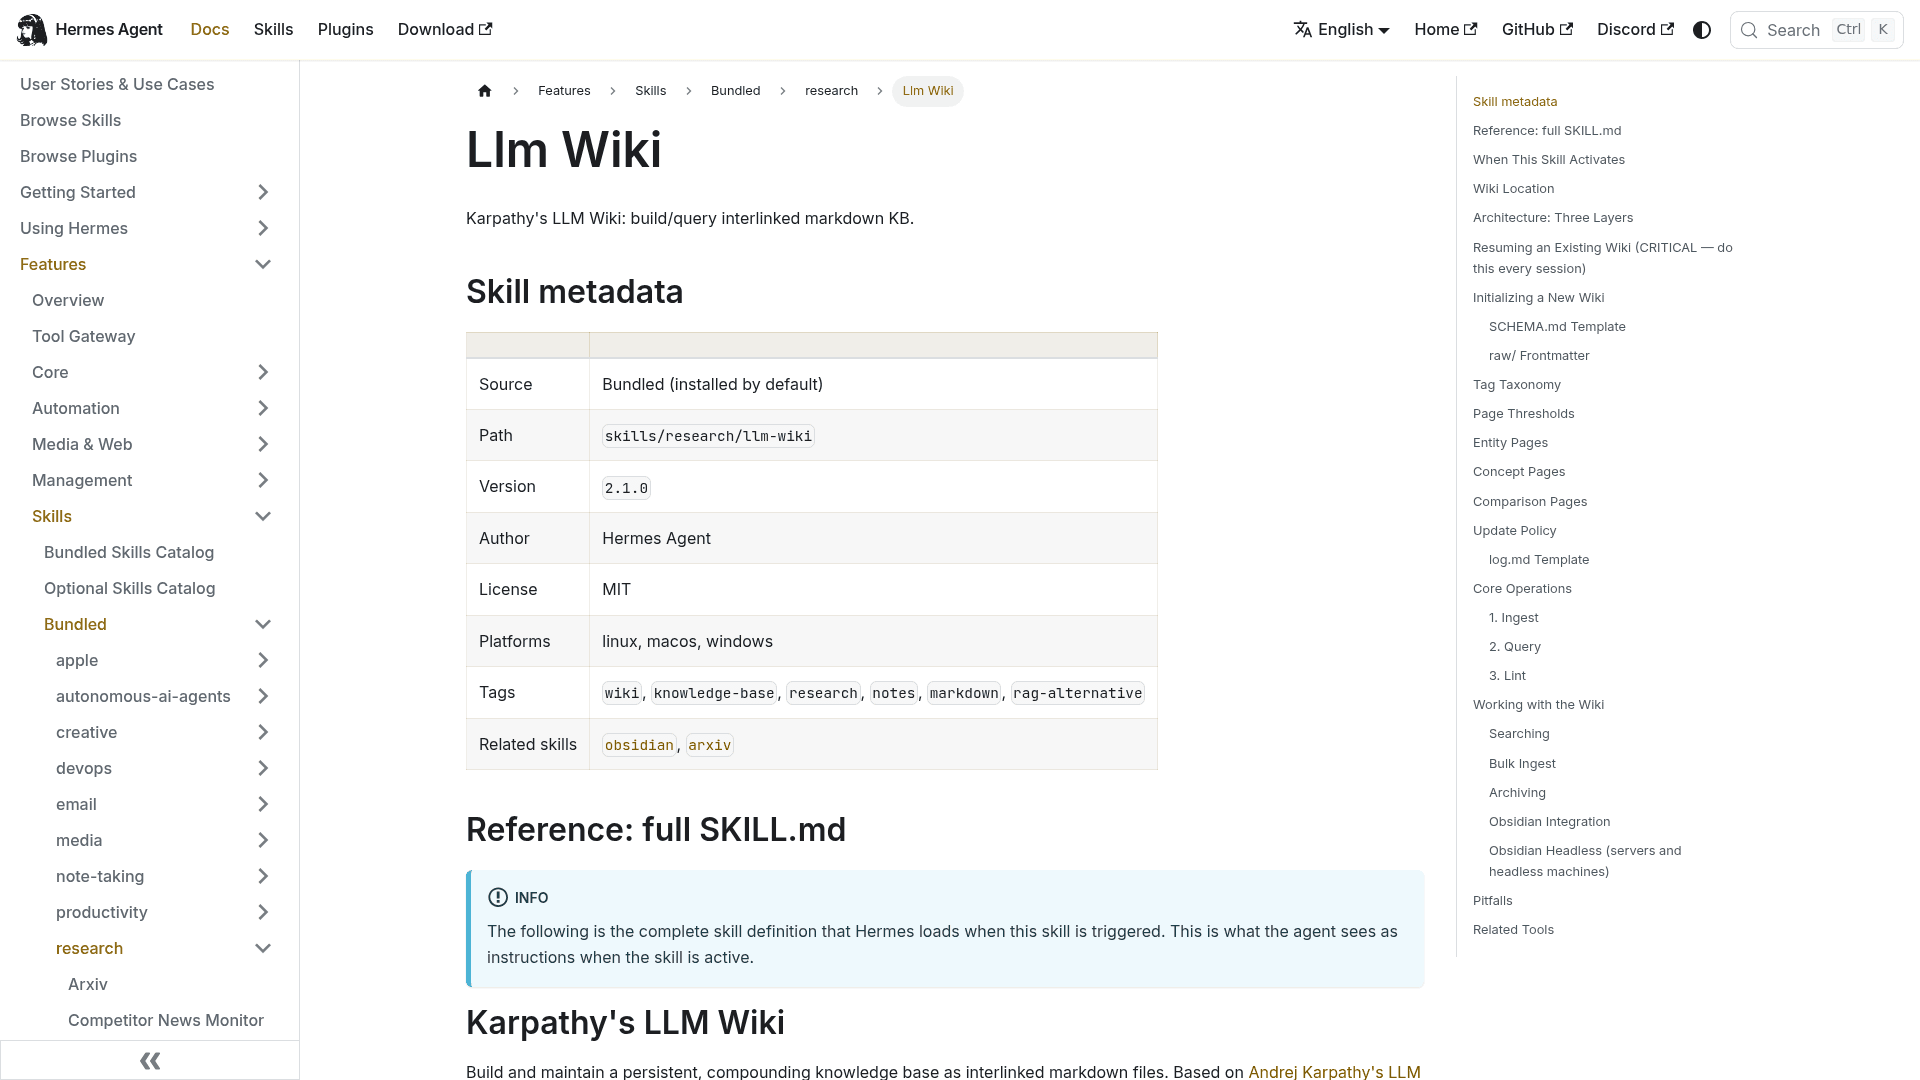
Isso é boa parte de uma auditoria da base de conhecimento de suporte de graça, se seus documentos estiverem em markdown. Para equipes de docs-as-code, as ferramentas de arquivo do Hermes fazem o resto: read_file pagina arquivos grandes (truncando após cerca de 100K caracteres), patch faz edições pontuais e devolve um diff, e search_files é ripgrep por baixo.
2. Redigir artigos ausentes ou desatualizados
O Hermes pode escrever artigos no Notion, Confluence, Freshdesk, Help Scout e GitHub por meio do servidor MCP ou da API de cada plataforma. O padrão que funciona é "redigir, não publicar": o agente escreve um artigo proposto em um lugar onde uma pessoa o revisa. Um administrador do Zendesk no Reddit descreveu o mesmo ciclo montado no Make.com anos antes de os agentes estarem na moda:
"If it can't it drafts me an article that would cover it, as well as tells me why."

A parte do "tells me why" importa. Um rascunho com o motivo anexado é revisado em minutos. Um sem motivo fica parado numa fila. Cubro mais do lado da escrita no meu guia para escrever artigos de KB com IA.
3. Aprender sozinho o seu produto antes de responder qualquer coisa
Executar /learn na sua central de ajuda pública dá ao Hermes um modelo funcional do seu produto antes de ele tocar em qualquer outra coisa. Isso é útil se você também usa o Hermes para redigir respostas em outros lugares, e é a mesma ideia de treinar a IA na sua base de conhecimento. Um comentarista do Hacker News usa exatamente essa configuração:
"Hermes uses an llm-wiki [...] as a source of information when drafting suggested replies - I have a cronjob that feeds it all emails, slack messages, meeting minutes every single day."

O Hermes consegue escrever na sua central de ajuda? Depende da plataforma
É aqui que a maioria das configurações dá errado, e é a parte que nenhuma página da documentação do Hermes cobre, já que nenhuma menciona uma central de ajuda voltada ao cliente. Se o Hermes pode propor uma mudança com segurança depende muito mais da sua plataforma de KB do que do Hermes.
O catálogo MCP selecionado do Hermes tem 62 entradas. Notion e Atlassian (Jira mais Confluence) estão nele. Google Drive, GitHub e Zendesk não estão: o GitHub ficou de fora de propósito em favor do skill gh incluído, o Google Drive exige o seu próprio cliente OAuth, e o Zendesk não recebe nenhuma menção em toda a documentação.
Onde fica a sua base de conhecimento?
Escolha sua plataforma para ver como o Hermes pode acessá-la e a configuração que o impede de publicar sozinho.
Caminho: API REST do Help Center a partir de um skill do Hermes ou de uma chamada no terminal. Não está no catálogo MCP do Hermes, e o servidor MCP da própria Zendesk ainda não tem documentação pública.
Configuração segura: dê à conta do agente um grupo de permissões sem direito de publicação, para que ele só consiga criar artigos com draft definido como true.
Atenção: o indicador de rascunho funciona por tradução. Ativá-lo em um artigo publicado o remove da sua central de ajuda. Proponha edições como um novo artigo em rascunho.
Caminho: o servidor MCP da Atlassian, que está no catálogo do Hermes. A v2 dele lista 65 ferramentas do Confluence, incluindo createConfluenceContent e updateConfluenceContent.
Configuração segura: marque o servidor como trust: untrusted no Hermes para que toda escrita peça permissão antes. Execuções sem supervisão precisam de um token de API que um administrador da organização tenha ativado.
Atenção: as ferramentas MCP não listam opção de rascunho, e a ferramenta de status do conteúdo define um rótulo de revisão, não um estado de publicação. Escreva em um espaço de espera restrito ou deixe um comentário.
Caminho: o servidor MCP hospedado do Notion, no catálogo do Hermes. A documentação do próprio Notion mostra a configuração do Hermes e a etapa hermes mcp login notion.
Configuração segura: inclua apenas notion-search, notion-fetch e notion-create-comment até confiar nele, e depois adicione uma propriedade Status como etapa de revisão.
Atenção: o login é apenas por OAuth, ainda sem token headless, e o modo rascunho cria uma página privada sem página pai.
Caminho: o servidor MCP oficial do Freshdesk (disponível de forma geral desde 10 de setembro de 2026) tem createSolutionFolderArticle e updateSolutionArticle.
Configuração segura: crie artigos com status 1, que significa rascunho. O status 2 publica.
Atenção: toda chave de API conectada recebe todas as ferramentas, e o MCP é medido: o Growth inclui 1.200 ações por ano, depois US$ 15 por 1.000.
Caminho: a API de Docs. O servidor MCP do Help Scout é somente leitura para novas conexões e não consegue editar artigos do Docs.
Configuração segura: o endpoint de salvar rascunho grava um rascunho sobre um artigo publicado "so that the published version will not be affected."
Atenção: sua chave da API de Docs precisa da permissão "Docs: Create new, edit settings & Collections".
Caminho: o skill github incluído no Hermes, que conduz a linha de comando gh, ou o próprio servidor MCP do GitHub.
Configuração segura: escreva em um branch e abra um pull request em rascunho. A proteção de branch no main é o seu botão de publicar.
Atenção: quase nada. Um token de acesso pessoal funciona para execuções sem supervisão, ao contrário do login do Notion.
Aqui está o mesmo quadro como referência rápida:
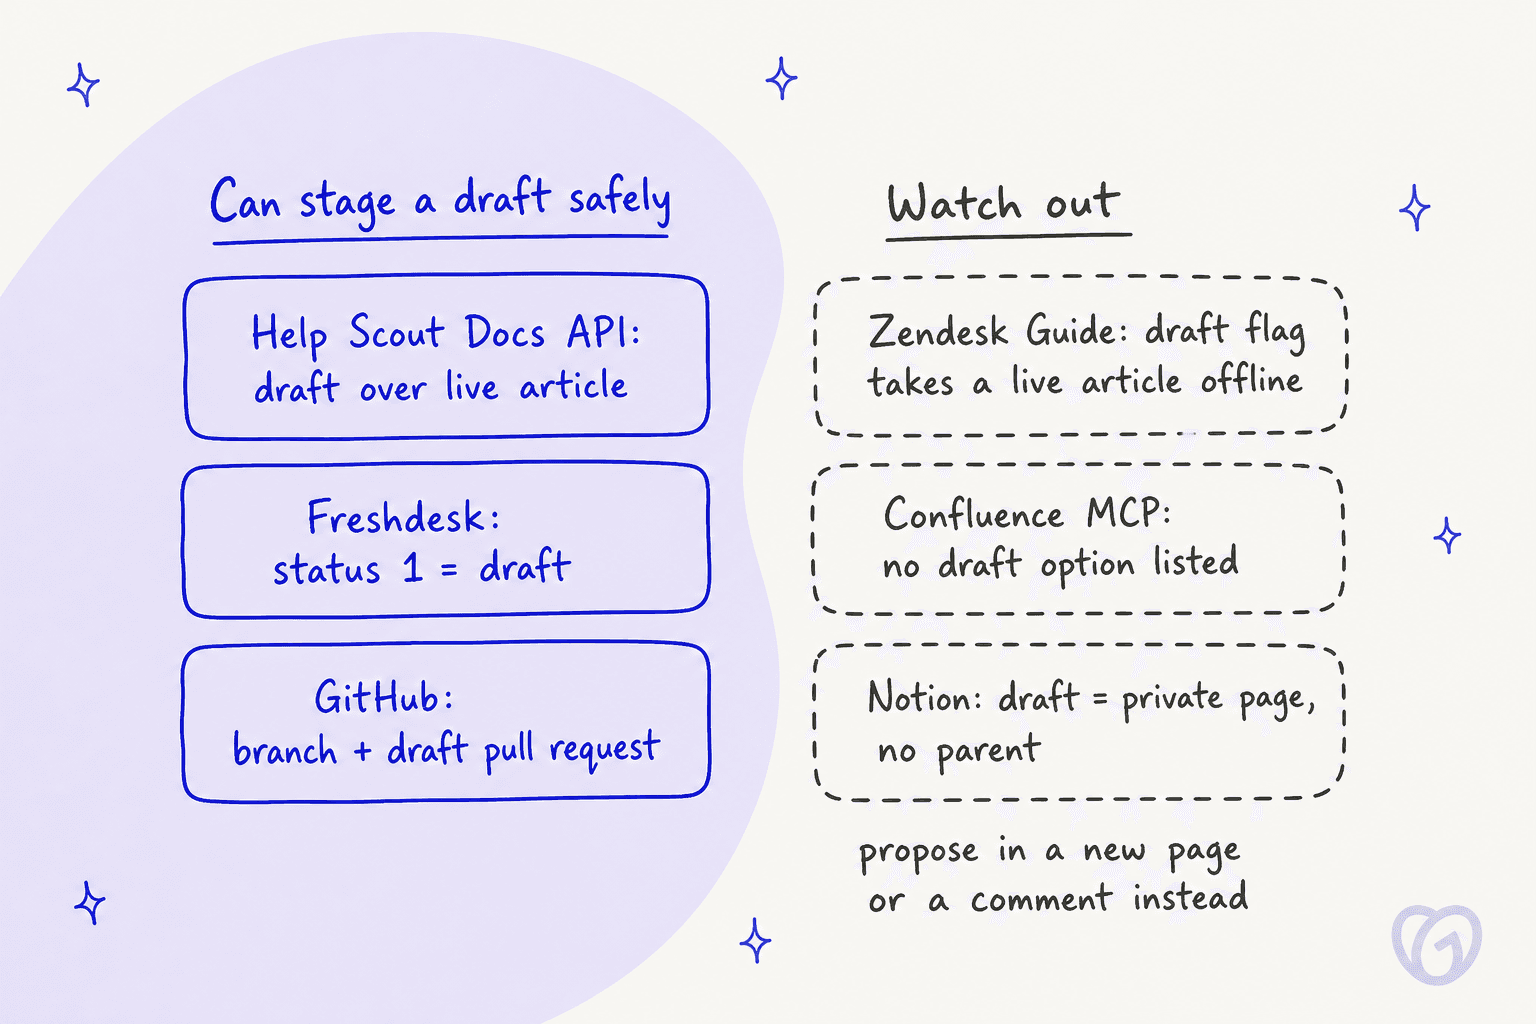
O caso do Zendesk é o que mais surpreende as pessoas. Segundo a API do Help Center, o campo draft "can be set when creating but not when updating", e as atualizações passam pelo endpoint de traduções, onde draft se aplica a toda aquela tradução. Não existe um objeto separado de "edição pendente", então um agente que vire um artigo publicado para rascunho o despublica. O lado bom: a API também diz que, sem direito de publicação, "the article must be created using draft=true". É uma boa proteção. Meu post sobre a API do Zendesk Guide percorre os endpoints, e usuários do Freshdesk podem ver o equivalente no meu guia da API da base de conhecimento do Freshdesk.
| Plataforma | Como o Hermes acessa | Pode preparar rascunho | Login | Limites que vale conhecer |
|---|---|---|---|---|
| Zendesk Guide | API REST (fora do catálogo) | Só artigos novos, draft: true | Token OAuth ou token de API | 200 a 2,500 requisições/min conforme o plano |
| Confluence | MCP da Atlassian (no catálogo) | Não listado nas ferramentas MCP | OAuth 2.1, ou token de API habilitado por admin | Escritas grátis, chamadas enriquecidas 1-10 créditos Rovo |
| Notion | MCP do Notion (no catálogo) | Página privada, sem pai | Só OAuth | 600/min Business+, 180/min nos demais |
| Freshdesk | MCP do Freshdesk | Sim, status: 1 | Só chave de API | 1,200 ações/ano no Growth, depois $15/1.000 |
| Help Scout Docs | API de Docs (o MCP é somente leitura) | Sim, rascunho sobre artigo publicado | Chave da API de Docs | 2,000+ requisições a cada 10 min |
| Repositório de docs no GitHub | skill github ou MCP do GitHub | Sim, branch mais PR em rascunho | OAuth ou token pessoal | 80 requisições de criação de conteúdo/min |
Configurando o Hermes para gestão da base de conhecimento, passo a passo
Esta é a configuração que eu executaria para uma equipe de suporte, na ordem em que eu faria. Reserve uma tarde para os passos 1 a 4 se o Hermes já estiver instalado.
Passo 1: Decida onde fica a fonte da verdade
Escolha um sistema como o lugar onde uma resposta correta vive. Se sua central de ajuda é o Zendesk Guide mas metade das respostas reais está no Confluence, o Hermes vai auditar os dois alegremente e redigir no que alcançar primeiro. É assim que dois artigos acabam discordando. Se seus atendentes também mantêm uma base de conhecimento interna separada, decida agora qual vence quando houver conflito. Um comentarista do Reddit em r/CustomerSuccess descreveu onde isso leva:
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it"
Passo 2: Conecte somente leitura primeiro
Quando você adiciona um servidor MCP, o Hermes o sonda e mostra uma lista de verificação, e só as ferramentas que você marcar vão para tools.include. Comece apenas com ferramentas de busca e leitura. Para o Notion, usando o servidor hospedado das instruções do próprio Notion para o Hermes:
mcp_servers:
  notion:
    url: "https://mcp.notion.com/mcp"
    auth: oauth
    trust: untrusted
    tools:
      include: [notion-search, notion-fetch, notion-create-comment]
Depois execute hermes mcp login notion uma vez para concluir o login OAuth.
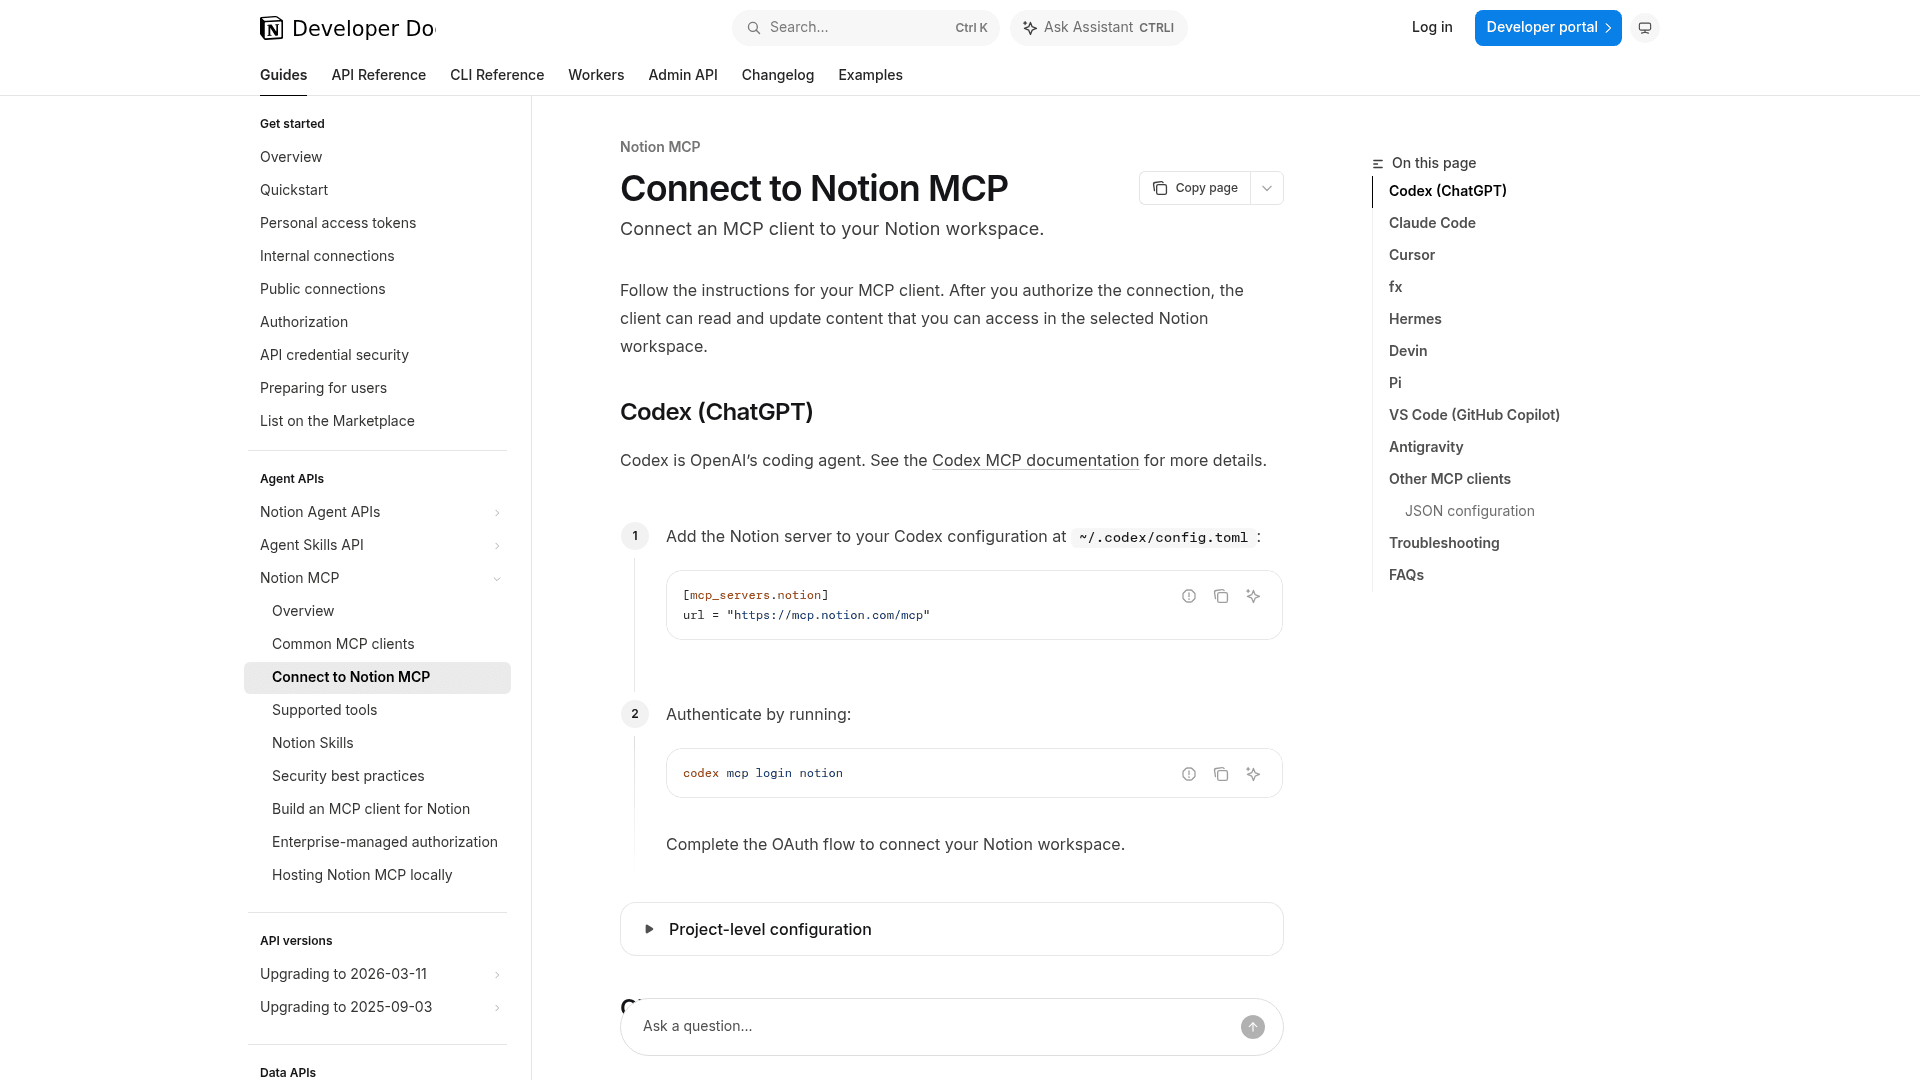
Essa linha trust: untrusted faz o trabalho pesado. Segundo a referência de configuração do MCP, em um servidor não confiável "every write-capable tool call [...] requires user approval." O padrão é full, o que significa nenhum pedido de aprovação.
Passo 3: Ative as travas de escrita que o Hermes deixa desligadas
O esquema de aprovação do Hermes é irregular, então ative estas de propósito:
memory.write_approval: truecoloca as escritas de memória em fila para revisão com/memory pendinge/memory approve <id>.skills.write_approval: truefaz o mesmo para mudanças em skills, e/skills diff <id>mostra o diff completo.checkpoints.enabled: truetira um instantâneo antes das escritas em arquivos, para que/rollbackpossa restaurar uma página markdown. Os pontos de restauração são opcionais.
Duas coisas que isso não cobre. Escritas simples em arquivos (write_file, patch) nunca pedem aprovação; a documentação de segurança diz "there is no approval prompt", apenas uma lista de caminhos bloqueados e um sandbox de escrita opcional. E os pontos de restauração só fazem instantâneo de arquivos locais, então uma página do Notion ou do Confluence alterada via MCP depende do histórico de páginas da própria plataforma para desfazer.
Passo 4: Agende uma auditoria semanal
O Hermes cron aceita agendas em inglês simples, pode anexar skills e entrega no Slack. Um primeiro trabalho poderia ser assim:
hermes cron create "every monday 9am" "Lint the support wiki. List stale pages, orphan pages and contradictions with file paths. If nothing changed since last week, reply [SILENT]." --skill llm-wiki
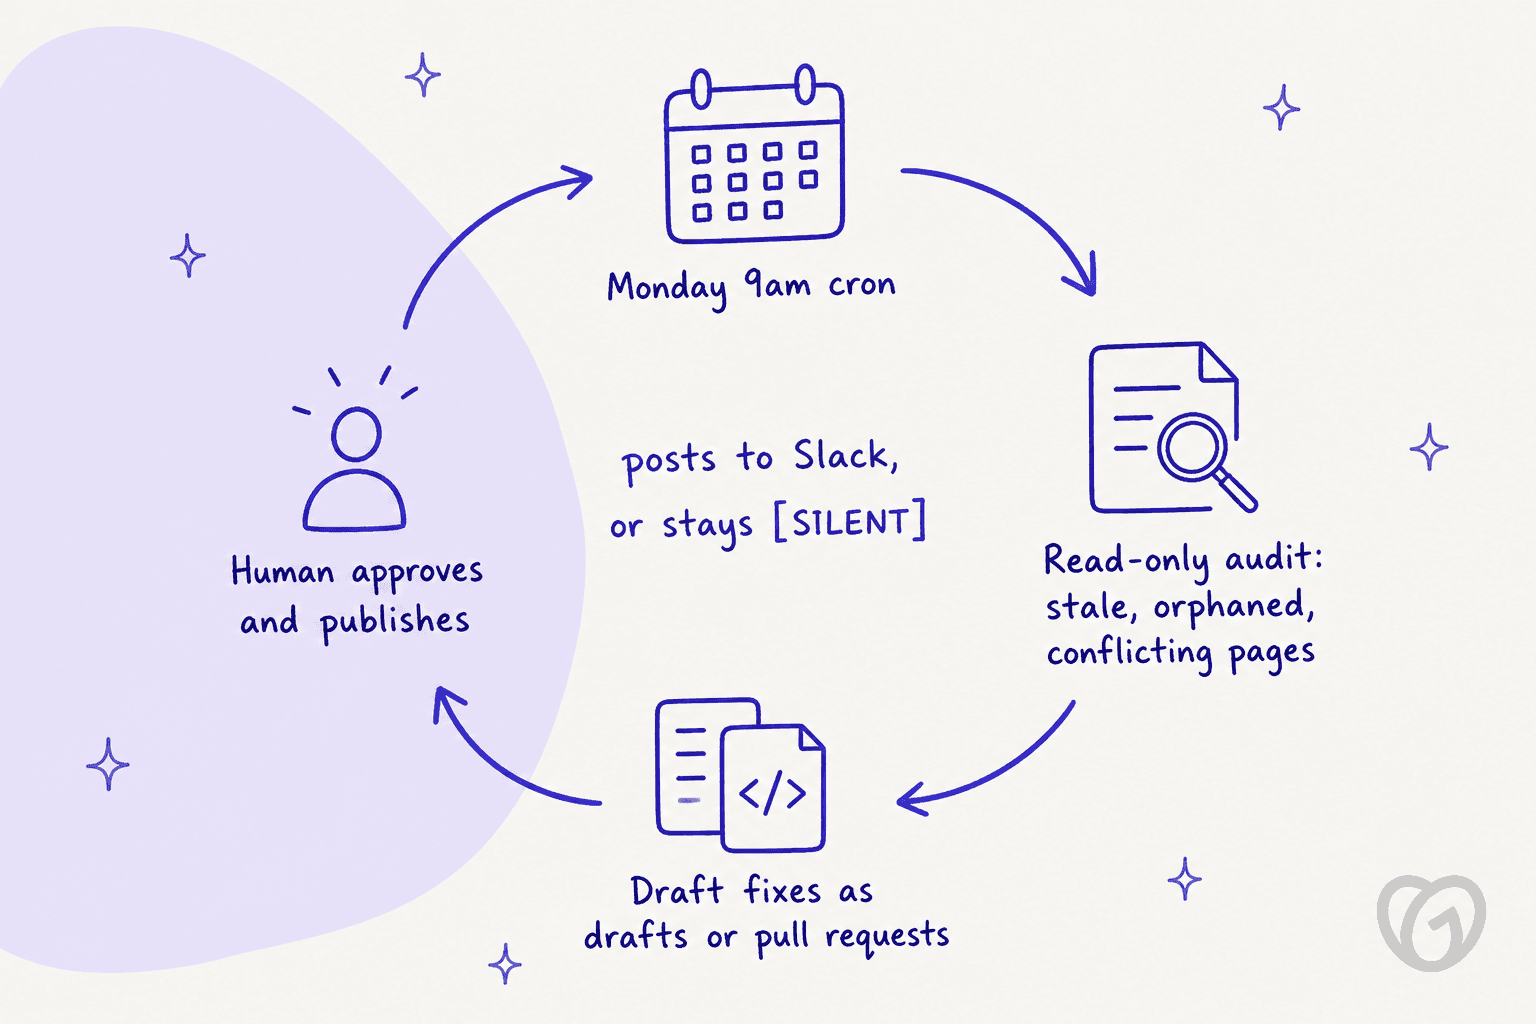
O cron se comporta bem para isso. Uma resposta contendo [SILENT] suprime a entrega, então seu canal só ouve algo quando houve mudança, enquanto trabalhos que falham sempre são entregues. Se uma chave, skill ou servidor MCP não for resolvido, o trabalho é marcado como blocked_config, envia um alerta e não faz nenhuma chamada ao modelo. No cron, comandos de shell perigosos são negados por padrão. Uma peculiaridade: cada execução do cron começa uma sessão totalmente nova, então o prompt precisa carregar tudo de que o agente precisa.
Passo 5: Adicione a redação quando a auditoria ficar entediante
Só depois de algumas semanas de auditorias que coincidam com o que você mesmo teria sinalizado eu deixaria o Hermes escrever. Adicione a ferramenta de escrita da sua plataforma, mantenha o servidor como untrusted e aponte os rascunhos para um lugar de revisão: um pull request em rascunho, um rascunho do Freshdesk, um rascunho do Help Scout ou um comentário na página do Confluence. Fixe qualquer skill de conhecimento de que o trabalho dependa para que o curator não o arquive no meio do trimestre.
Onde as bases de conhecimento geridas por agentes dão errado
Ninguém na comunidade do Hermes relata usá-lo contra uma central de ajuda voltada ao cliente ainda. Toda história é sobre um wiki pessoal ou de equipe, geralmente um vault do Obsidian. Mas os modos de falha se encaixam bem nas KBs de suporte, e vale lê-los antes de dar a um agente acesso de escrita.
Escritas sem supervisão apodrecem o wiki inteiro
Esta é a lição mais votada nos tópicos do r/hermesagent que li:
"Don't let the agent write the vault unsupervised. That's the one I wish I'd heard on day one. They will dump session recaps, fake "I remember" facts, and half finished incident notes into Obsidian like it's a trash can. Looks busy. A month later you don't trust a single file."
A própria documentação do Hermes sinaliza um risco relacionado: com modelos locais pequenos, "a sentence like 'I've added that to my memory' is just text". O agente pode dizer que salvou algo que nunca salvou, e por isso a documentação acrescenta um verificador de mutação de arquivos e diz para você "trust the verifier over the model's summary".
Agentes complementam, raramente apagam
Num tópico do Hacker News chamado "Agents don't need memory, they need documentation", um engenheiro descreveu a base de conhecimento da empresa crescendo até virar uma "completely useless giant mess of stale, outdated, duplicated, or superfluous info", mesmo com agentes fazendo a reconciliação (kaydub, Hacker News). Agentes acrescentam um parágrafo em vez de cortar um. Para uma central de ajuda, isso significa que seu prompt de auditoria deve pedir explicitamente páginas para arquivar ou mesclar, não só páginas para atualizar. Meu guia sobre conteúdo desatualizado da central de ajuda tem mais sobre como identificá-las.
As escritas falham em silêncio
"But the main problem is really that it can sometimes just not insert it."
Isso era sobre o Hermes enviar resumos de pesquisa para notas. A correção é a mesma para uma central de ajuda: verifique se o artigo existe na plataforma depois de uma escrita e faça o relatório semanal listar o que foi realmente criado, não o que o agente pretendia criar.
Em escala pessoal funciona, em escala de empresa é mais difícil
"There are a few successes on an individual level (I really like Hermes[0]) but nothing scales to a company level easily."
A memória do Hermes é restrita por perfil, e a documentação indica um provedor de memória externo para qualquer coisa compartilhada. Para um único responsável pela documentação, isso é suficiente, e é também por isso que a retenção de conhecimento do suporte não pode viver no agente de uma pessoa só. Para uma equipe de suporte de 15 em que todos esperam as mesmas respostas, a fonte compartilhada tem de ser sua central de ajuda, o que leva de volta à tabela de plataformas acima.
Ele audita o que está escrito, não o que os clientes perguntam
Esta é a lacuna que eu pesaria mais como pessoa de suporte. O lint do llm-wiki encontra páginas desatualizadas e conflitantes. Ele não consegue dizer que uma sequência de tickets no mês passado perguntou sobre uma funcionalidade sem artigo, porque nada no Hermes lê seus tickets do helpdesk para isso, a menos que você monte. Como disse um fundador no r/startups, grande parte do trabalho é saber "which legacy articles are broken by a new feature" (u/19Vicus90, Reddit r/startups). Os tickets são onde isso aparece primeiro. Meu post sobre análise de lacunas de conhecimento cobre quais helpdesks oferecem esses sinais nativamente.
Hermes versus uma opção criada para suporte na manutenção da KB
Para ser justo com o Hermes: se seus documentos são markdown em um repositório e você se sente à vontade sendo dono de um servidor, ele é um mantenedor flexível e gratuito, e o lint do llm-wiki é uma verificação de páginas desatualizadas bem pensada para um wiki em markdown. Onde ele cobra é na integração específica de suporte de que a gestão de conhecimento com IA precisa para uma equipe de suporte.
| Hermes Agent | Teammate de helpdesk da eesel | |
|---|---|---|
| Onde o conhecimento fica | Sua KB, acessada por MCP ou API que você conecta | Sua KB, conectada como fonte (Zendesk, Confluence, Notion, Google Drive, site e mais) |
| Encontra lacunas a partir de tickets | Não incluído | Relatórios mostram um cartão de "Knowledge gaps" a partir de conversas reais |
| Redige artigos ausentes | Sim, pelo caminho de rascunho da sua plataforma | O skill "Update knowledge base" redige os artigos ausentes |
| Lint de páginas desatualizadas em markdown | Sim, llm-wiki | Não é o foco |
| Revisão antes de publicar | Opcional (trust: untrusted, aprovações de escrita) | As ações passam por aprovações |
| Roda em | Sua máquina ou servidor | Hospedado |
| Custo | Software gratuito mais tokens do modelo e hospedagem | A partir de $299/month por 500 créditos, plano gratuito de 100 créditos |
A eesel não é a melhor escolha para todo mundo. Se sua central de ajuda é um site de documentação no GitHub e ninguém abre tickets sobre ele, o Hermes com um pull request em rascunho é um ciclo mais agradável. Se sua base de conhecimento existe para responder a clientes, os tickets são o melhor sinal que você tem, e é por aí que eu começaria. Para uma visão mais ampla, meus comparativos de alternativas ao Hermes e de ferramentas de base de conhecimento com IA cobrem o cenário.
Experimente a eesel para a manutenção da base de conhecimento
Se você prefere não manter um servidor para manter sua central de ajuda honesta, o teammate de helpdesk com IA da eesel se conecta ao conhecimento que você já tem. Ele conecta Zendesk, Confluence e Notion como fontes (até 15.000 páginas do Notion por conexão), responde a partir delas com uma citação em cada resposta e registra cada vez que encontrou uma pergunta que seus documentos não conseguiam responder.
Elas aparecem em Reports como lacunas de conhecimento, e o skill "Update knowledge base" redige os artigos ausentes para sua equipe aprovar. Se o cartão desse skill disser "Contact us" no seu workspace, peça à eesel para ativá-lo.

Ela também tem uma ferramenta de linha de comando, então, se você gostou do fluxo do Hermes, você ou um agente de programação como o Claude Code podem conectar fontes, ler instruções e aprovar ações retidas pelo terminal. Você pode começar de graça com 100 créditos e sem cartão na página de preços. Experimente a eesel na sua própria central de ajuda e veja quais lacunas ela encontra na primeira semana.