
Grok Botとは実際何か
Grok BotはxAIのAIチームメイトアプリで、2026年8月11日に発表され、自社ページでは「Early beta」と表示されています。各ボットは永続的で名前の付いた作業者であり、専用のクラウドコンピュータを与えられ、あなたがすでに使っているアプリにサインインし、通常のインターフェース経由でそれらを操作します。これは汎用の労働エージェントであり、サポート製品ではありません。実際にログインしたブラウザを操作する他の自律型AIエージェントと同じカテゴリーに属します。
設計目標はカバレッジです。Grok Botは「クリーンなAPIやMCPを持たないプラットフォームを含む」複数のアプリで動作するように作られており、それを実現する方法は人間のように振る舞うことです。画面を乗っ取り、あちこちクリックし、そこに表示されているものを読みます。この単一のメカニズムこそが広範なリーチを買い取っており、同時にこの記事のすべての注意点の源でもあります。
サインインのフローが製品の核心です。ボットは決してあなたのパスワードを保持しません。画面をあなたに渡し、あなた自身がパスワード、パスキー、2FAコード、CAPTCHAを入力し、その後コントロールを返します。そこから先は、xAIのドキュメントによれば、「ブラウザセッションは共有のGrok Botコンピュータ上に持続し、適切な場合には他のボットが同じサインイン済みセッションを使用できる」とのことです。プレリリース版のテスターはHacker Newsでそれをはっきりと述べています。
"It'll ask you to take over its computer to log in […] After you do you just tell the bot you're done logging in and it'll keep driving. And yea, it's a separate VM for each bot."

ここで、この記事にとって重要な詳細があります。ローンチ時に8つの名前付きボットロールが提供されました:Sales Outbound、Talent Scout、Paid Media、Expense Manager、Product Performance、Bug Reproduction、Account Health、Chief of Staffです。そのどれもサポートの役割ではなく、どれも品質保証でもありません。それでもGrok Bot自身のページにある最初のサンプルプロンプトは「Sign in to Zendesk so I can work the support queue.(サポートキューを処理できるようZendeskにサインインして)」です。製品自身がサポート業務に狙いを定めておきながら、その仕事が本当に良かったかを確認する部分のロールをゼロしか提供していません。
Grok Botはクローズしたチケットを読んでスコア付けできるか?
はい、そして設定はすぐに終わります。デスクトップアプリ(macOSまたはWindows。モバイルアプリはiOS 18以降)をインストールし、ボットを起動して、ヘルプデスクにサインインするよう指示します。テイクオーバーのフローが起動し、あなた自身がZendeskやFreshdeskにログインすると、ボットは読み取りを開始します。「これらのチケットをトーン、正確さ、解決度について10点満点で評価して」というようにスコアカードをプロンプトとして与えると、会話を開いて評価を返してくれます。
「タスクを教える」機能もあります(xAIは保存されたバージョンをRoutinesと呼んでいます)。ボットが見ている間に一度作業を行うと、その手順を保存し、後で繰り返せます。理論上は、これにQAパスを教えることもできるでしょう。しかし制限は現実的で、ワークフローを構築する前に知っておく価値があります。教えるのはブラウザ内のみで、10分の上限があり、出力は明確に「下書き」であり、ボットごとに50個のルーティンしか持てず、ルーティンごとに保存される実行記録は20件のみです。
つまり「できるか」というチェック項目は満たされています。この記事がまだ続く理由は、「チケットに数字を付けられるか」と「これでQAプログラムを運用できるか」が別の問いであり、2つ目の問いでこそ設計が無理を来し始めるからです。
サポート品質保証が本当に必要としているもの
デモが見せてくれないものがあります。QAとは会話を読んで数字を選ぶことではなく、すべてのチケットに同じ基準を適用し、エージェントが異議を唱えたときにその数字を擁護できることです。評価をコーチングできるQAに変える3つの要素があり、ログインした人間としてブラウザセッションを操作するボットには、それらを置く場所がどこにもありません。
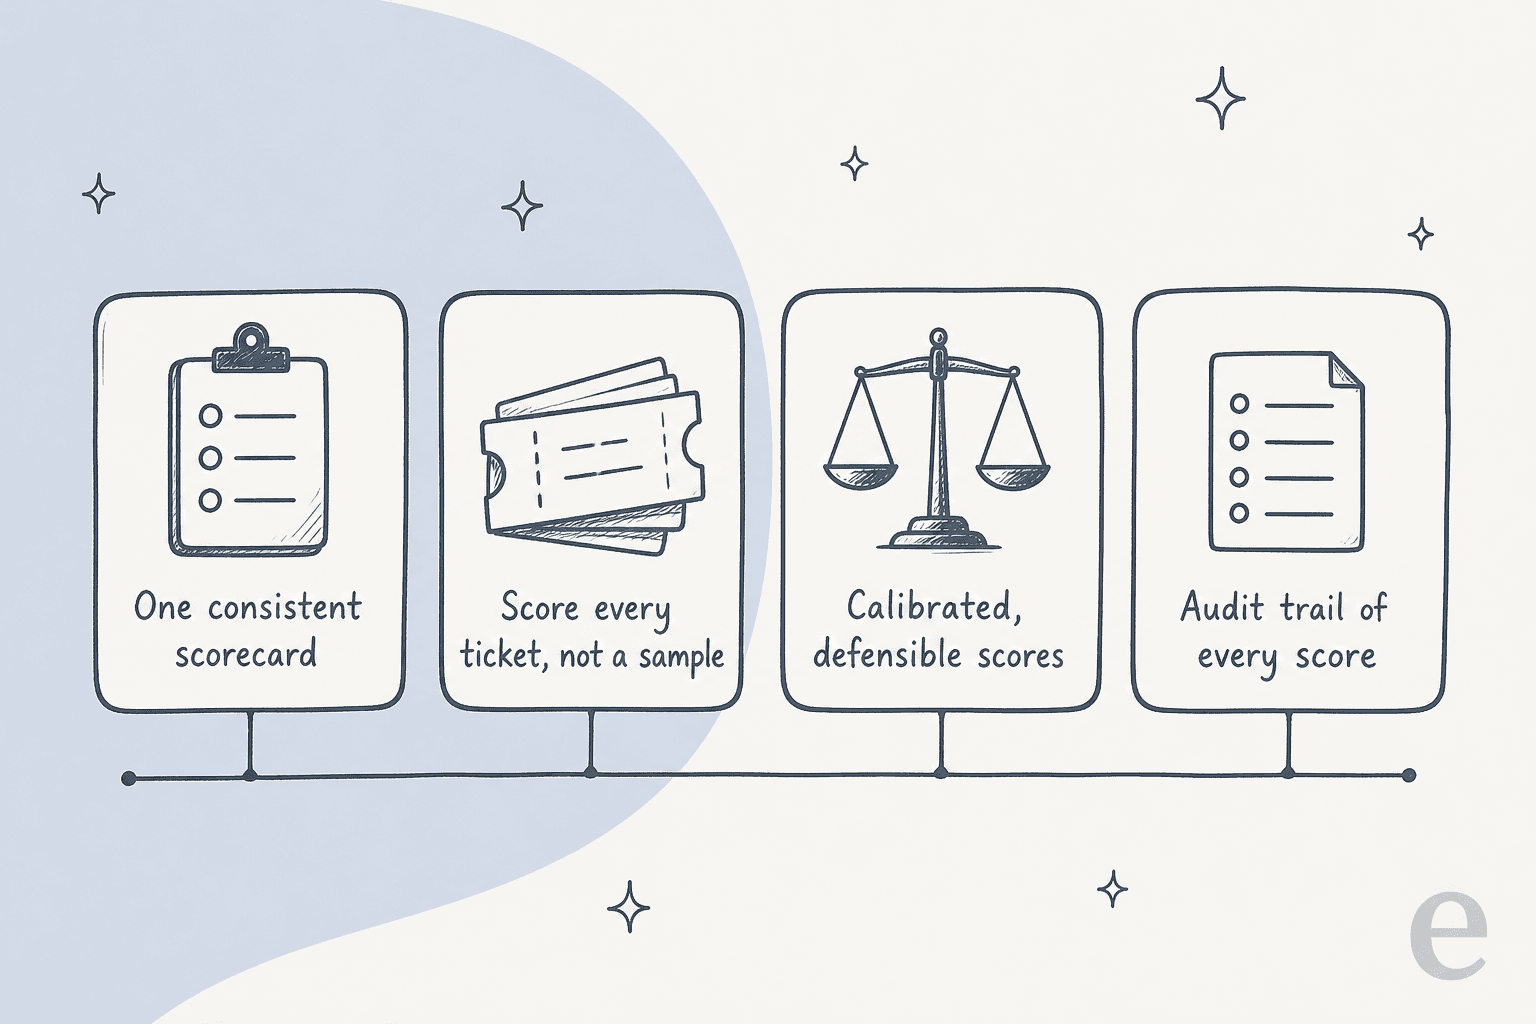
一貫した1つの評価基準。 QAとは、誰が、あるいは何がレビューしていようと、同じ会話が毎回同じスコアを得ることを意味します。これが評価者間信頼性であり、それがすべてです。Grok Botに同じチケットを2回スコア付けさせると、2つの異なる数字が返ってくることがあります。なぜなら各実行は適用された評価基準ではなく、新しい読み取りだからです。サポートチームは、毎回同じ分類とタグ付けルールを実行するツールから、その再現性を得ています。実行のたびにぶれるスコアは品質のシグナルではなく、小数点付きのノイズです。
証明可能なカバレッジ。 古いQAの問題は、人間はチケットの1〜2%しかレビューできないため、キューのほとんどが決してチェックされないことでした。AIによるQAの約束全体は、すべてをレビューすることです。Grok Botはその約束を果たせません。ブラウザセッションを操作しているため、どのチケットを開き、どれをスキップしたかの報告がありません。私が話を聞いたある購入者は、カバレッジの問題を私より上手く言い表しました。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle."
月間7,000件のチケットを扱うDTCブランドのCXリード
7,000件のチケットを目視で確認できる人は誰もいません。だからこそカバレッジは、想定するのではなく測定し、報告する必要があるのです。
監査証跡。 エージェントがスコアに異議を唱えたとき、誰かがなぜそのチケットがその数字を得たのか、トランスクリプトのどの行か、評価基準のどの項目かを再構築しなければなりません。Grok Botのスコア付けは、保持されないセッションから出てきた文章であり、そのギャップはxAI自身のドキュメントに記されています:「ボットの操作の監査ビューは近日公開予定です。」未来形です。今日の時点では、ボットが何を読んだのか、どう重み付けしたのかの記録は一切なく、争われたスコアはあなたの言葉とブラックボックスの言い分の対立になります。
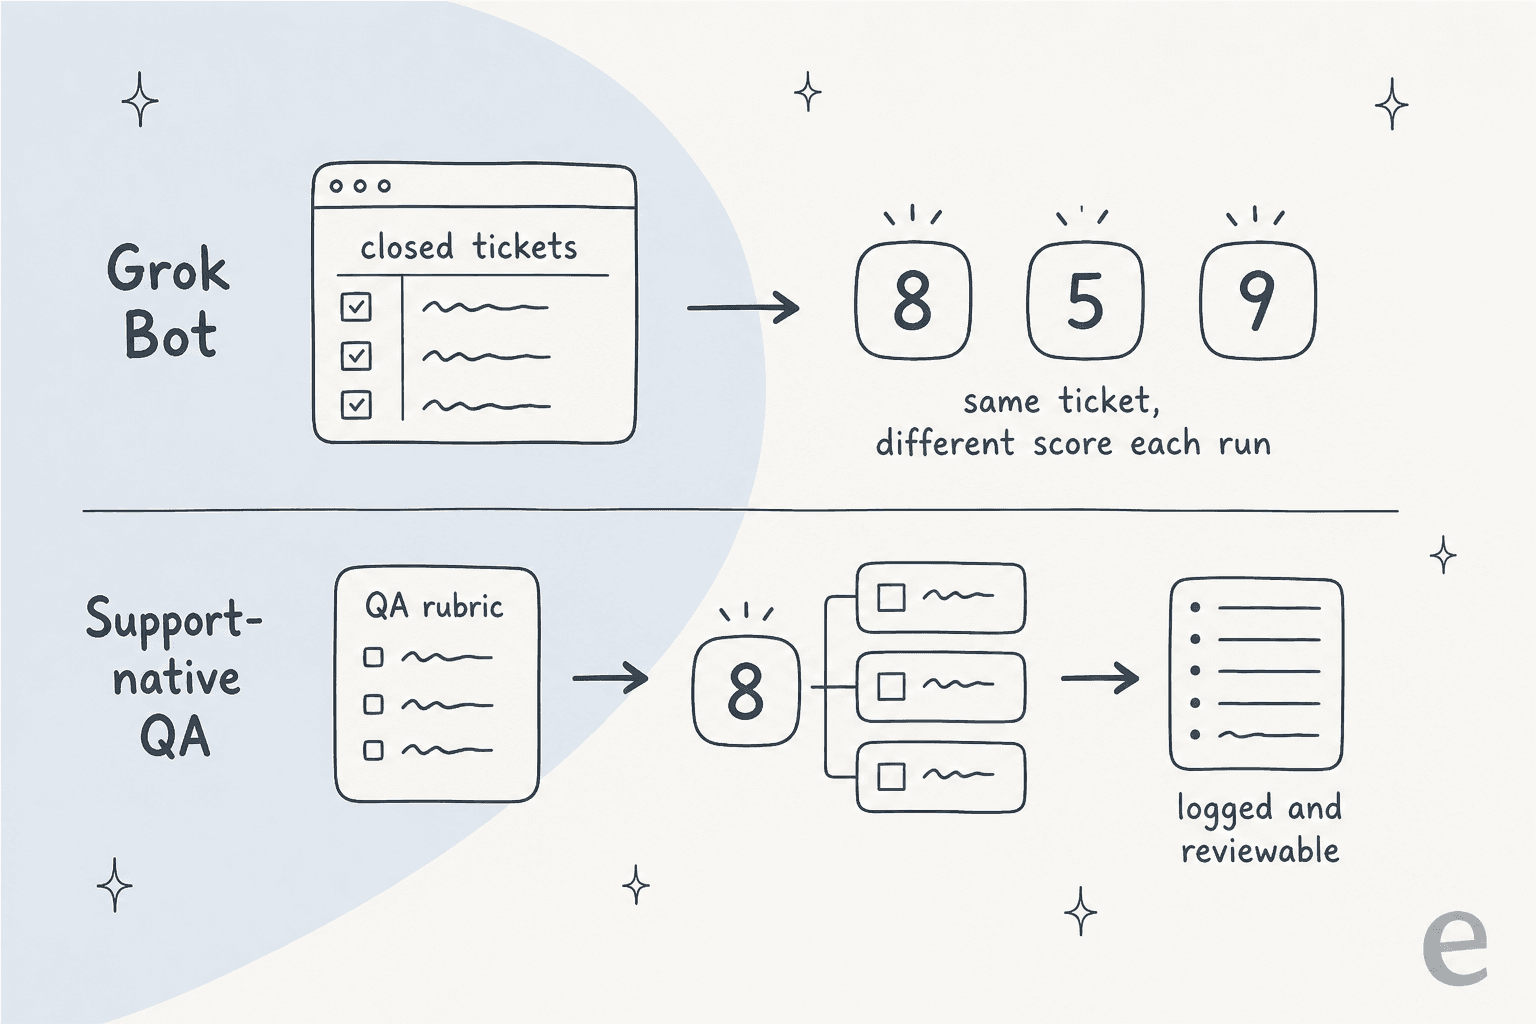
これはGrok Botが悪いという話ではありません。この特定の仕事には形が合わないという話です。そのUI操作型の設計が勝るのは、APIをまったく持たないツールに対するワークフロー自動化、つまりコールセンターRPAの正当な後継としての領域です。あなたのチームが評価される仕事の品質を採点することは、単純にそれではありません。
最初に問うべきセキュリティの疑問
コストの前に、精度の前に、多くの記事が見落としがちな問いがあります。共有のAIワーカーに、あなたのチケット履歴全体へのサインイン済みセッションを与えることは、実際には何を露出させるのでしょうか?
設計から見てみましょう。xAIのドキュメントによれば、「あなたのすべてのボットは1台のクラウドコンピュータを共有しています…そのコンピュータ上のファイル、ブラウザセッション、コマンドライン認証情報は、ボットの全ラインナップにわたって利用可能です」とあり、続けてFAQには2回、「別々のボットをセキュリティ境界として使わないように」という指示があります。つまり、QAボットが作成するヘルプデスクセッションは、あなたの営業ボット、ペイドメディアボット、そしてアカウント上の他の何にでもアクセス可能なのです。
はっきりさせておく価値のある広く誤解されている点があります。それは実際の問題ではないからです。批判者は、すべてのログインをElonのサーバーにアップロードしていると言います。そうではありません。あなた自身がハンドオフの際にパスワードを入力します。正確な異議はもっと繊細です。ボットはあなたのサインイン済みセッション内で動作するため、ログはその操作をあなたに帰属させます。あるHacker Newsのコメント投稿者はその設計を短い言葉でまとめました。
"By hijacking a real person's credentials, that person becomes the accountability sink. Very neat. Very deliberate."
ここにデータの層を重ねてみましょう。QAはクローズしたチケットに対して実行されますが、これはあなたが持つ中で最も密度の高い個人情報の集積です。名前、メールアドレス、注文履歴、時には支払い情報がすべて1か所にあり、すべてが一度に読み取られます。そのアーカイブへの永続的なサインイン済みセッションは、常設のデータ露出面です。そしてGrok Botはコンプライアンス認証を一切主張していません:SOC 2、ISO 27001、GDPR、HIPAA、PCI、FedRAMPのいずれもなく、保持期間の明記もデータレジデンシーの明記もなく、保持についてはCursorの規約に委ねられています。セキュリティレビューを経験したことのある人にとって、これは即座の却下事由です。あるコメント投稿者はローンチ当日にこうまとめています。
"Pricing: 120/200 USD per month, per employee. This is an interesting idea although I'm not sure how many companies are comfortable with giving SpaceXAI access to all your files and data. Outside of America this is, most likely, not going to fly."
あなたの履歴に対して何らかのAIを評価しているなら、データプライバシーと管理、そしてSOC 2とGDPRを満たしているかどうかの疑問こそ、最後にではなく最初に解決すべきものです。
Grok Botの費用
Grok BotはxAIではなくCursorにちなんで名付けられた2つのセルフサーブプランに加え、1つのバンドルで提供されています。全体像はこちらです。
| プラン | 価格 | 備考 |
|---|---|---|
| Cursor Ultra | 月額200ドル | ソロプラン |
| Cursor Premium Teams | 席あたり月額120ドル | 一括請求、共有スキルマーケットプレイス、利用状況分析、SAML/OIDC SSO |
| SuperGrok Heavy | 追加費用なしで含まれる | Heavyサブスクリプションにバンドル |
| 無料プラン | なし | 公開された試用期間なし |
いくつか気になる点があります。チームプランはソロプランより席あたりの価格が安く、これは珍しいことです。そして唯一明記されている割り当ては「AIトークンの拡張された上限」であり、具体的な数字はありません。ドキュメントには、割り当ては毎週で、超過分はモデルとトークンのコストに基づいて請求されるとあります。これはQAにとって重要です。なぜならチケットの全文トランスクリプトを読み返してスコア付けするのはトークンを大量に消費する作業であり、クローズしたキュー全体で行えばそれが乗算されるからです。再びこの製品を気に入っているプレリリース版のテスターの言葉です。
"Biggest downsides are token expenditure. I've used more tokens this month than not this month. That's not a typo - I've used less tokens in the last 5 years prior to this month than I have this month. Always on perpetual agents use a LOT of tokens."
より深いポイントは、あなたが実際に何に対して支払っているかです。Grok Botは席単位で課金しており、それはワーカーへのアクセスの価格であって、生み出されるレビューの価格ではありません。AIエージェントのコストを、QAが実際に節約するものと比較検討しているなら、コミットする前にその単位の違いに実際の数字を当てはめる価値があります。
サポートQAにGrok Botを使うべきか?
私からの判定というより、実際にどう考えるかという形でお伝えします。あなたに近い行を選んでください。
代わりに使うべきもの:後付けではなく組み込まれた品質
Grok Botを見た理由が「自社のサポート品質が良いと確信したい」ということだったなら、最も役立つツールは、後からトランスクリプトを採点するよう頼む汎用ワーカーではありません。それは、フロントラインの仕事を一貫した基準で行い、すべてのステップを記録することで、品質が構造的に測定可能かつ監査可能になるツールです。そのギャップを埋めるのがeeselです。
eeselはAIチームメイトプラットフォームであり、ここにフィットするチームメイトはAIヘルプデスクエージェントです。サインイン済みのブラウザを操作するのではなく、アプリとしてヘルプデスクに接続するため、すべてのチケットを同じ方法で処理し、行ったことの記録を保持します。これによりQAの問題は逆転します。出荷後に一貫性のない仕事を採点するのではなく、レビューできる一貫した仕事が得られるのです。
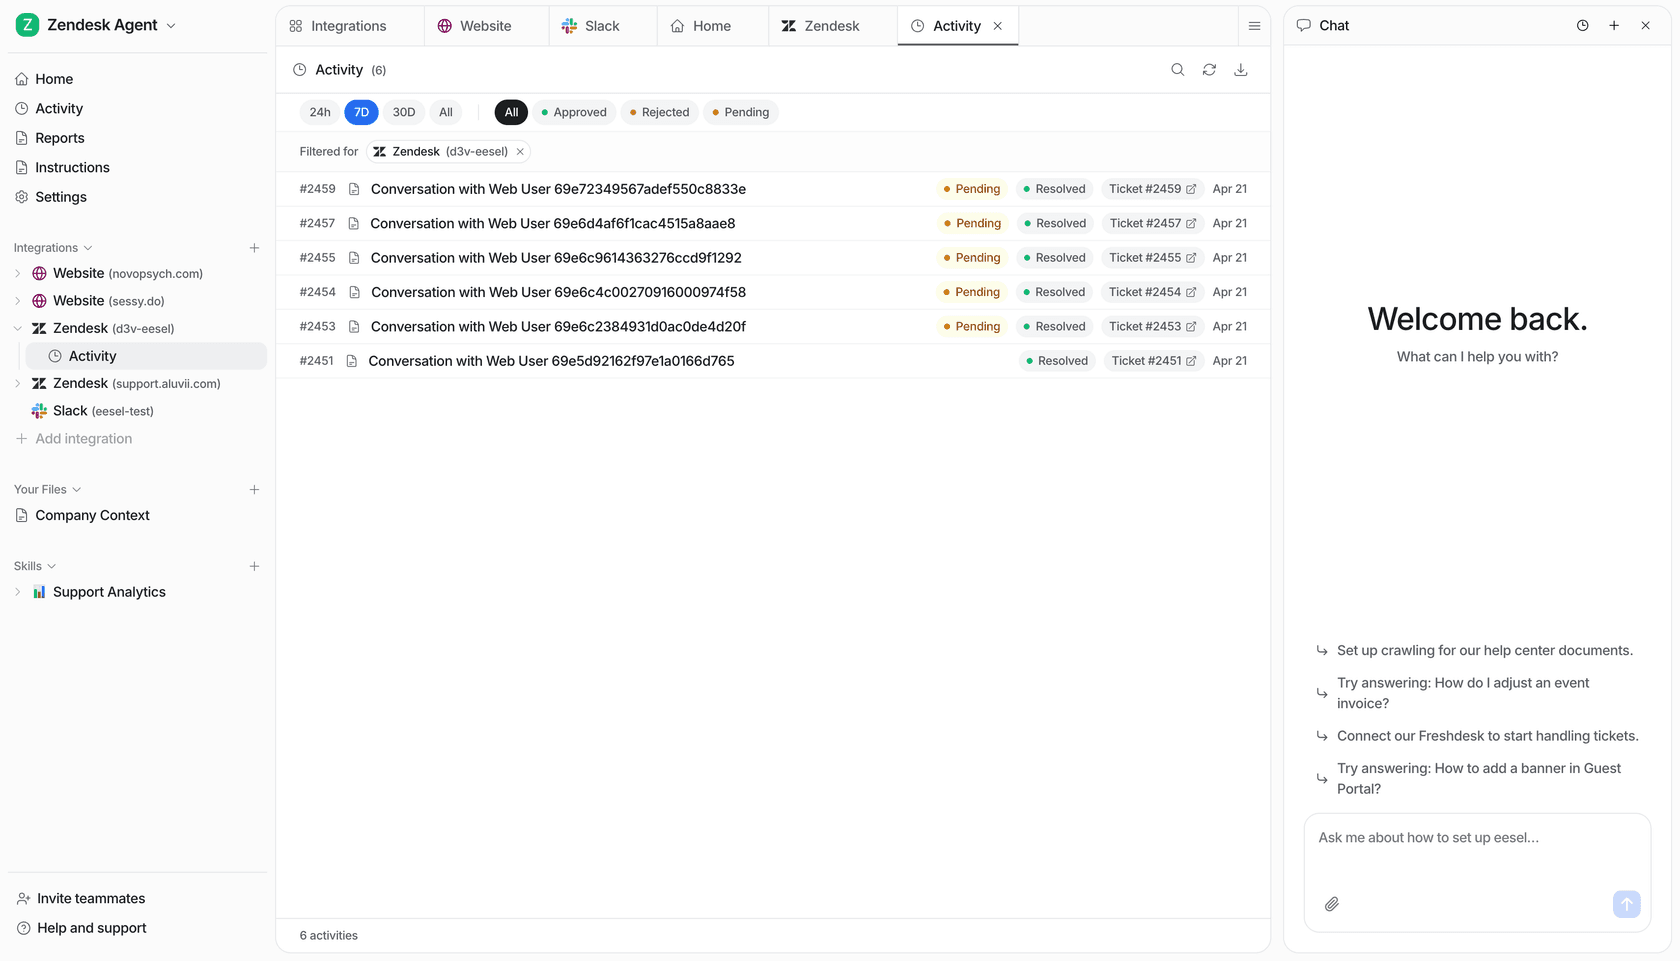
- すべてのチケットに一貫した基準。 eeselはすべての会話に同じルールと同じナレッジベースを適用するため、月曜日と金曜日の間、あるいはあるレビュアーと次のレビュアーの間で品質の基準がぶれることがありません。それはQAスコアカードが強制しようとしている再現性を、上流の仕事そのものに移したものです。
- あなたが設定する確信度のしきい値。 エージェントが返信する前にどれだけ確信を持つべきかをあなたが決めます。しきい値を超えれば返信し、下回ればきれいなハンドオフで人間に引き継ぎます。これはまさに、前述のCXリードが求めていたコントロールであり、だからこそ私たちはまず実際の過去のチケットに対するドライランを重視しています。自信ありげに聞こえるボットが静かに間違えるのを見てきたので、eeselは実際のライブチケットに触れる前に、あなたの履歴をどう処理していたか、それに対してどうスコア付けされるかを見せてくれます。
- すべてが記録され、測定可能。 すべての返信、タグ、操作が記録され、レビュー可能であり、それによって悪いやり取りを監査し、その背後にあるルールを実際に改善できます。それはまた、推測ではなく解決率、CSAT、サポートROIを測定し、向上させる方法でもあります。

そしてGrok BotにAPI、CLI、MCPがないという理由でここに来た方へ:eeselはその逆を行きます。カスタマーサポートエージェントAPIとCLIを公開しており、Claude CodeやCursorのようなスクリプトやコーディングエージェントが、ダッシュボードが示すのと同じ品質とチケットデータを、ブラウザウィンドウだけでなくターミナルやパイプラインに取り込めます。まず全体を比較したい方には、AIカスタマーサービスソフトウェア、エージェント型カスタマーサービスソフトウェア、AIヘルプデスクソフトウェアのまとめ記事が良い出発点になります。
信頼できるサポート品質のためにeeselを試す
本当の目標が、Zendesk、Freshdesk、Gorgias全体で自社のサポートが良いという確信を持つことだったなら、eeselはすでに運用しているヘルプデスクに接続する新入社員のように働き、すべてのチケットを同じ基準で処理し、あなたが設定した確信度を超えたときにのみ行動します。ライブチケットに触れる前に、直近数千件のチケットでシミュレーションできるため、実際にどう振る舞うかを事前に正確に確認できます。使用量ベースの料金で、席単位ではなく処理したチケットあたりの定額であり、無料でお試しいただけます。
要するに:Grok Botは賢い汎用ワーカーであり、QAはまさに「一度読んで判断する」ことがあなたが取り除こうとしている習慣そのものである仕事です。あなたのチームが評価される品質のためには、仕事を一貫して行い、それを証明するために作られたものを使ってください。
よくある質問
Grok Botはサポート品質保証を行えますか?
Grok Botはサポートチケットのスコア付けに適していますか?
Grok BotをQAに使う場合のコストはどのくらいですか?
Grok Botはすべてのチケットをスコア付けしますか、それともサンプルだけですか?
Grok Botを自社のサポート履歴に向けるのは安全ですか?
サポートQAにおけるGrok Botの最良の代替は何ですか?
Grok BotにはQAデータ用のAPIがありますか?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.